1 セッション、1 研究
作業はチャットセッションの中で行います。送るメッセージ 1 件がターンです。ターンは文章だけで答えるのではなく、ワークフロースキルを実行します — 文献を検索するか内蔵 Python カーネルでコードを実行し、レビュアーで自分の結果を点検したうえで、結果を成果物(レポート・表・図・原稿)として保存します。成果物はセッションに残り続けます。
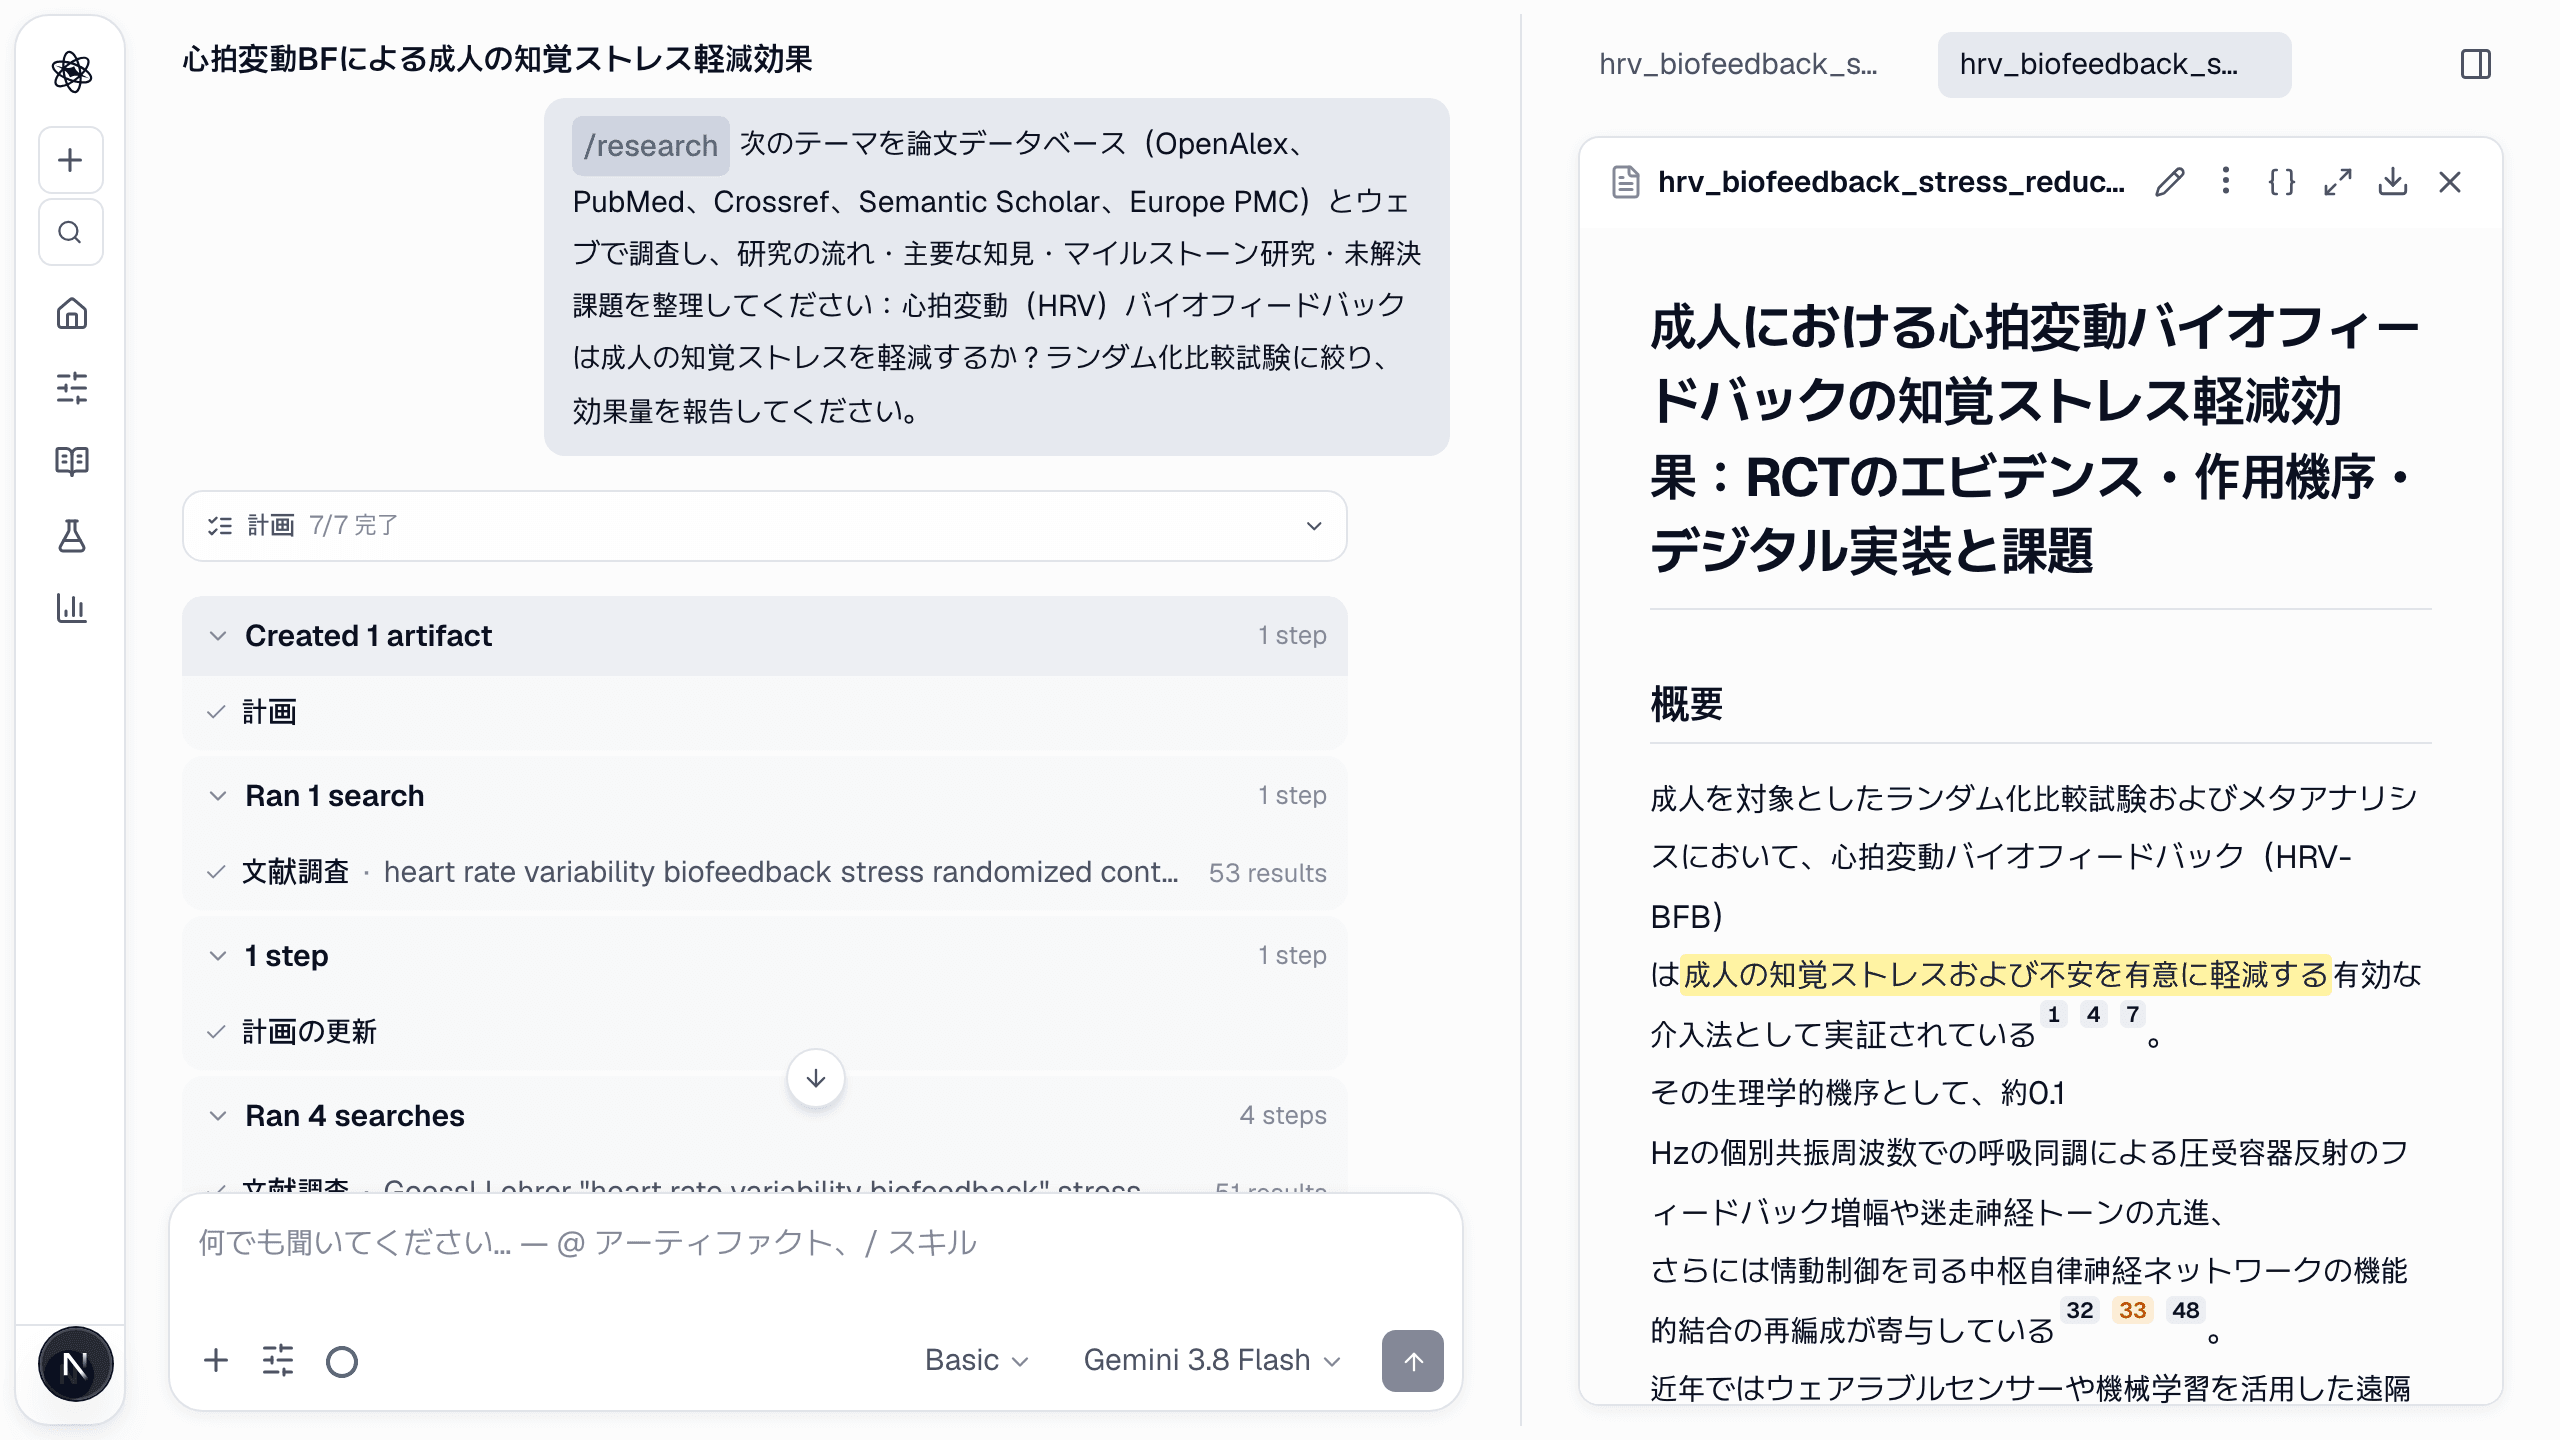
セッション内のすべてのターンは先行する成果物を参照できるので、研究を順番に進められます。設計ターンは文献レポートを読み、統計ターンはアップロードしたデータと分析計画を読み、執筆ターンはそれらすべてを引用します。
6 つの段階
| 段階 | 依頼すること | 得られるもの |
|---|---|---|
| 文献調査 | /research で質問 | スクリーニング済みの根拠表、番号付き引用のレポート、引用グラフ |
| 研究設計 | 仮説、実験 | 順位付けされた仮説;プロトコルフローと検出力分析を含む設計レポート |
| データ分析 | アップロードしたファイルを /analyze | データ品質チェック、明示的な分析計画、図付きの再現可能なレポート |
| 統計 | /stats で仮説 | 前提チェック、根拠のある検定選択、信頼区間付き効果量と達成検出力 |
| 図表 | /figure または /illustrate | 編集可能なベクター図と科学イラスト |
| 執筆・査読 | /write、/review | セッションの根拠に紐づいた Methods/Results 草稿;独立した査読レポート |
それぞれはタスクを実行するで、実際の画面はブログのステップバイステップガイドで確認できます。
何が違うのか
- プロンプトではなくスキル。 すべてのタスクは検証済みのパイプラインで実行されます — 適切な検索、適切な前提チェック、適切な出力形式。スキルカタログをご覧ください。
- 標準で再現可能。 分析は実際のコードとして実行され、すべての成果物はそれを生成したコードと入力を保持します。再現性とエクスポートをご覧ください。
- 査読済み。 別のレビュアーがターン終了前に主張・統計・引用を点検し、原稿全体に対する査読も実行できます。
- あなたの言語で。 インターフェースとエージェントの回答は選んだ言語に従います — English、한국어、日本語、中文。言語設定をご覧ください。
- 必要ならローカル優先 — 近日提供。 リリース準備中のデスクトップアプリでは、ターンをローカルモデルで実行し — マネージドトークンも第三者の AI プロバイダーも使わず — ファイルを自分のマシンに置けるようになり、自分の API キーも無料で使えます。現在はブラウザですぐに使えます — 登録して始めるだけで、インストールは不要です。
初めてですか?アカウント作成とサインイン、続いて最初のチャットへ — 最後まで 10 分です。