강도(Effort)
컴포저의 에이전트 컨트롤이 다음 턴의 강도를 정합니다. 기본은 Basic입니다.
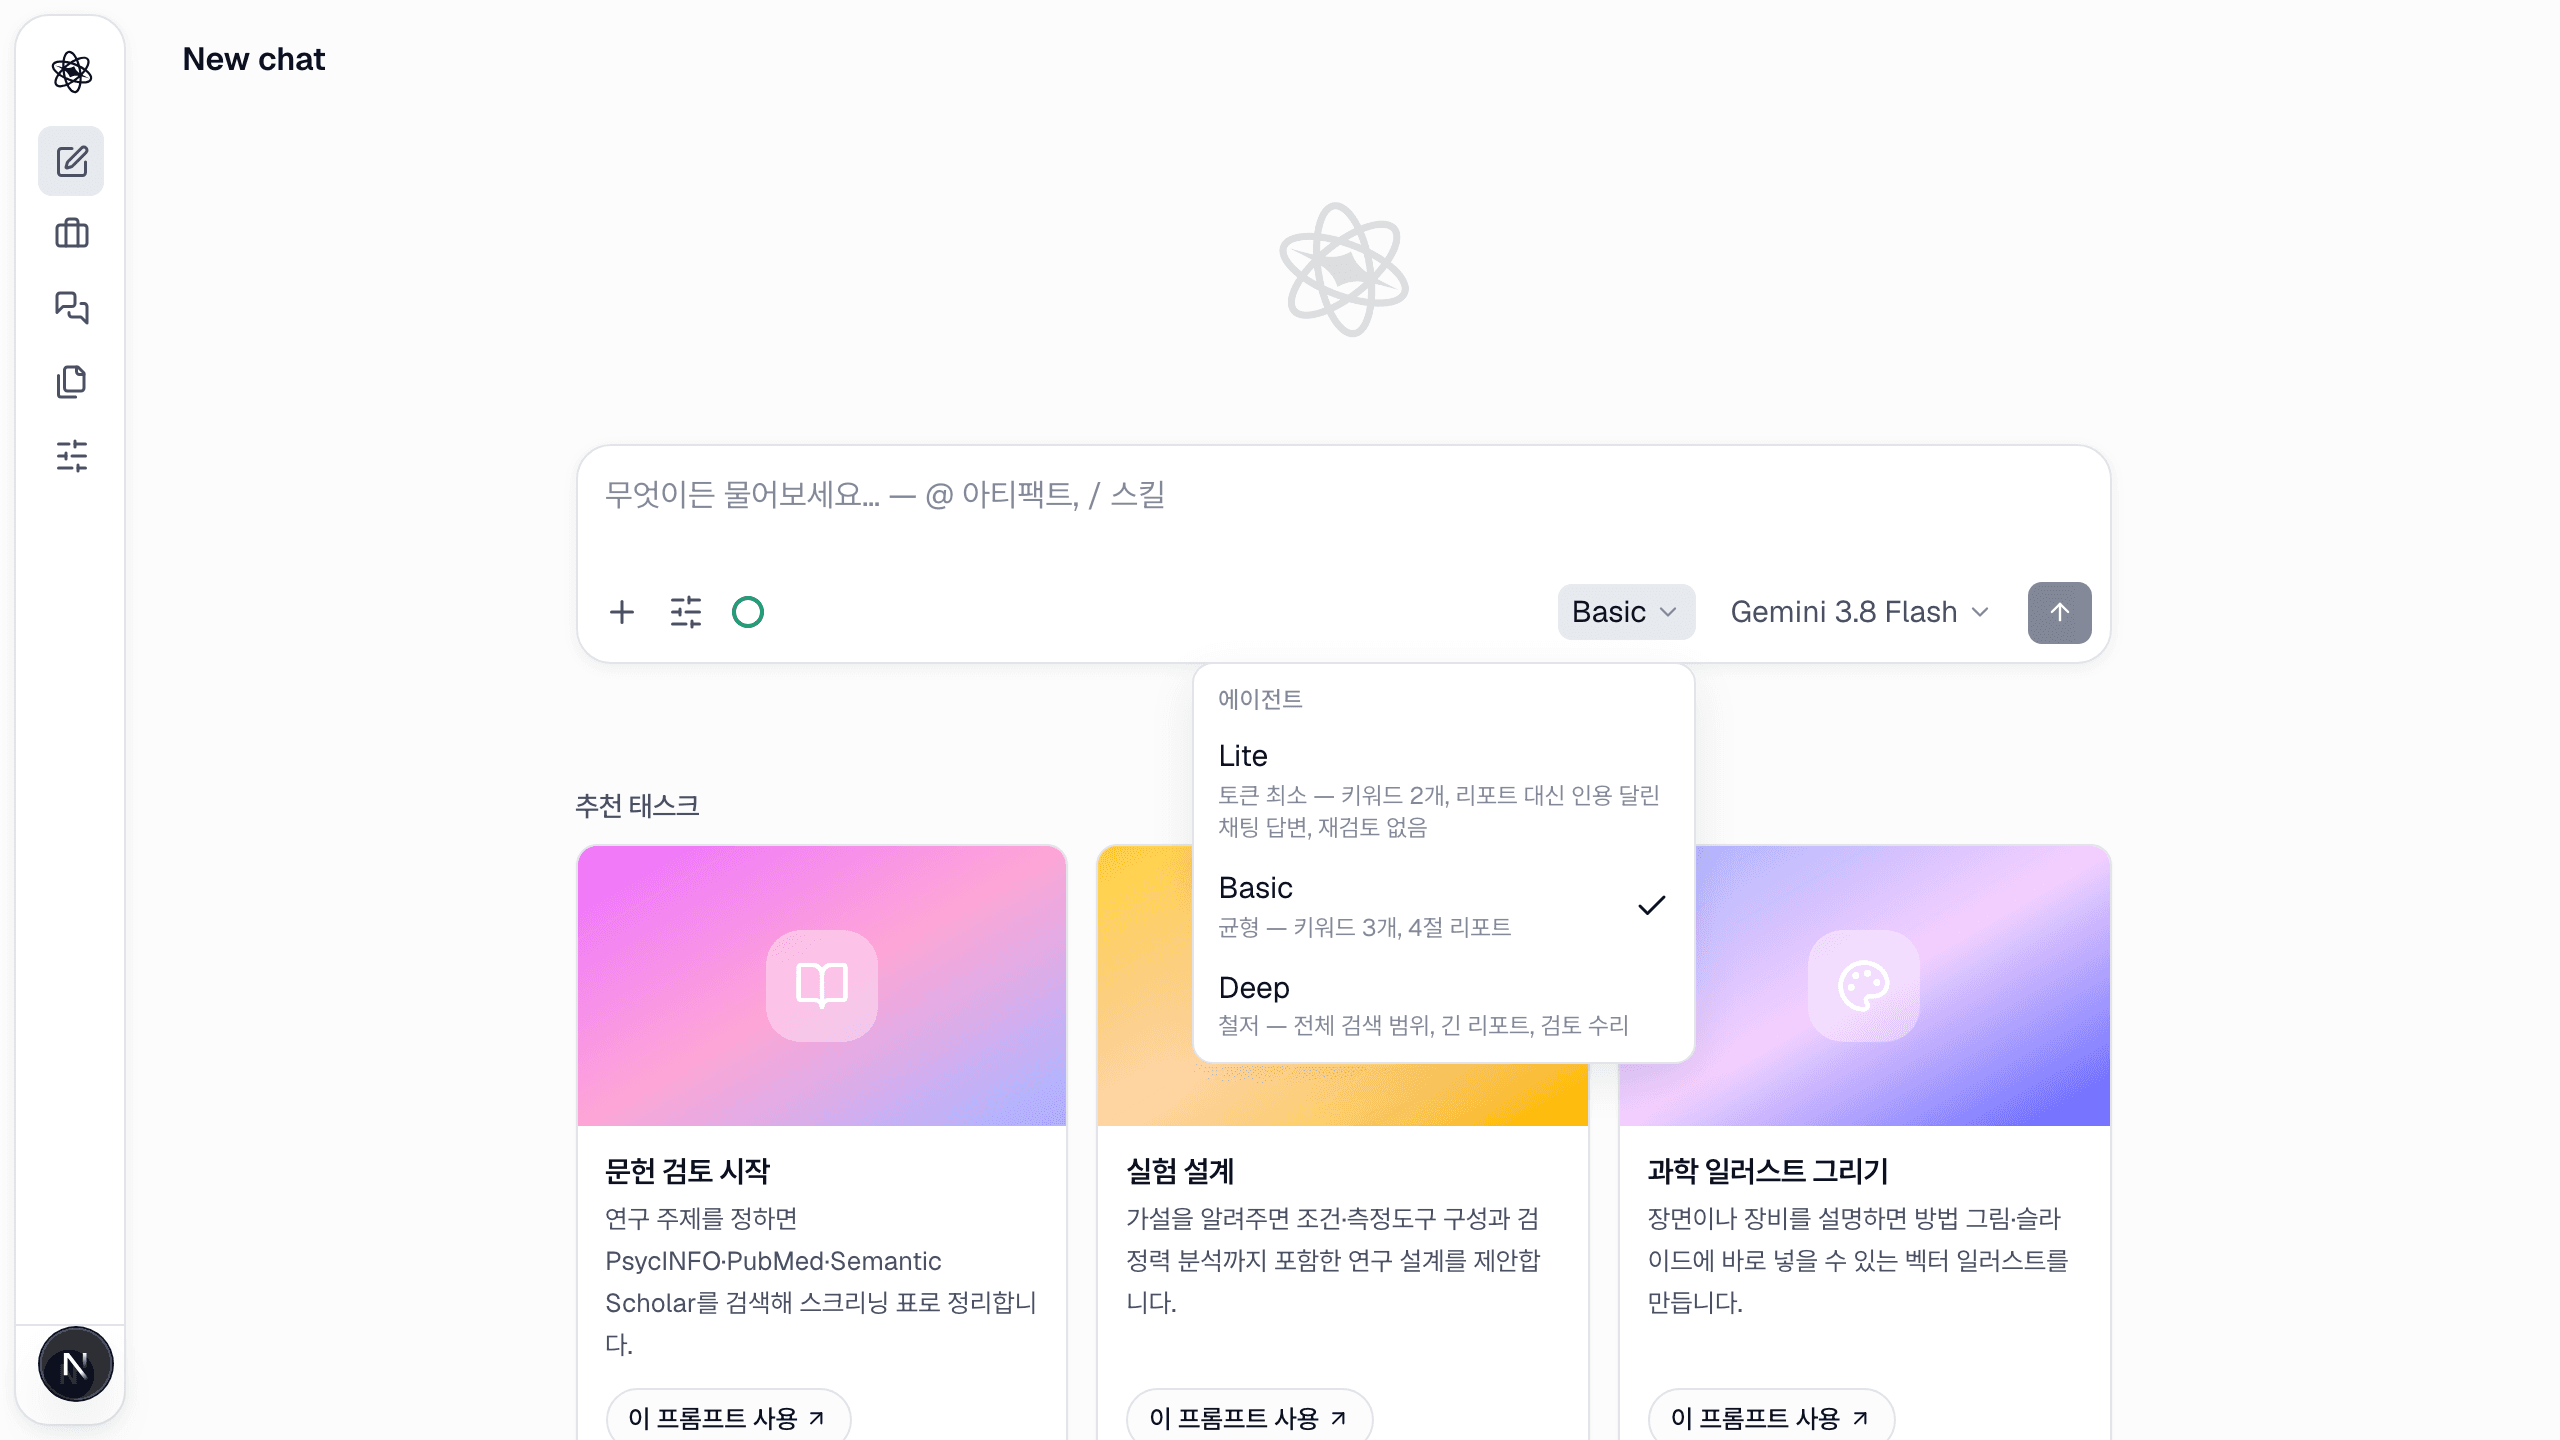
| Lite | Basic(기본) | Deep | |
|---|---|---|---|
| 턴당 검색 | 최대 4 | 최대 8 | 무제한 |
| 서브에이전트(병렬 위임) | 아니오 | 예 | 예 |
| 리포트 | 없음 — 출처가 있는 채팅 답변이 산출물 | 3~4절 리포트 | 3~6절, 더 긴 리포트 |
| 커버리지 점검과 갭 계획 | 끔 | 켬 | 켬 |
| 검토 수리 | 끔 | 켬 | 켬, 재실행 포함 |
| 턴당 단계 | 14 | 40 | 64 |
| 일러스트 품질 | 초안 | 표준 | 출판 |
| 문헌조사 턴의 전형적 비용 | ~150K 토큰 | ~400–500K | ~800K+ |
빠른 질문과 방향 잡기에는 Lite, 일상적인 연구 턴에는 Basic, 중요한 것의 마지막 손질에는 Deep을 쓰세요. 강도는 리포트 합성과 검토를 포함한 턴 전체에 적용됩니다.
모델
모델 컨트롤이 다음 턴의 모델을 고릅니다. Gemini, Claude, ChatGPT, DeepSeek, Kimi 모델은 플랜의 관리형 토큰으로 실행됩니다. 각 모델 옆 막대는 할당을 쓰는 속도입니다(1칸 가벼움, 2칸 표준, 3칸 무거움). premium 표시 모델은 Free 플랜에서 선택할 수 없고, 유료 플랜에서는 모든 모델을 쓸 수 있습니다. 에이전트 메뉴는 선택한 모델로 각 강도가 대략 몇 토큰을 쓰는지, 이번 주 토큰의 몇 %인지 보여 줍니다.
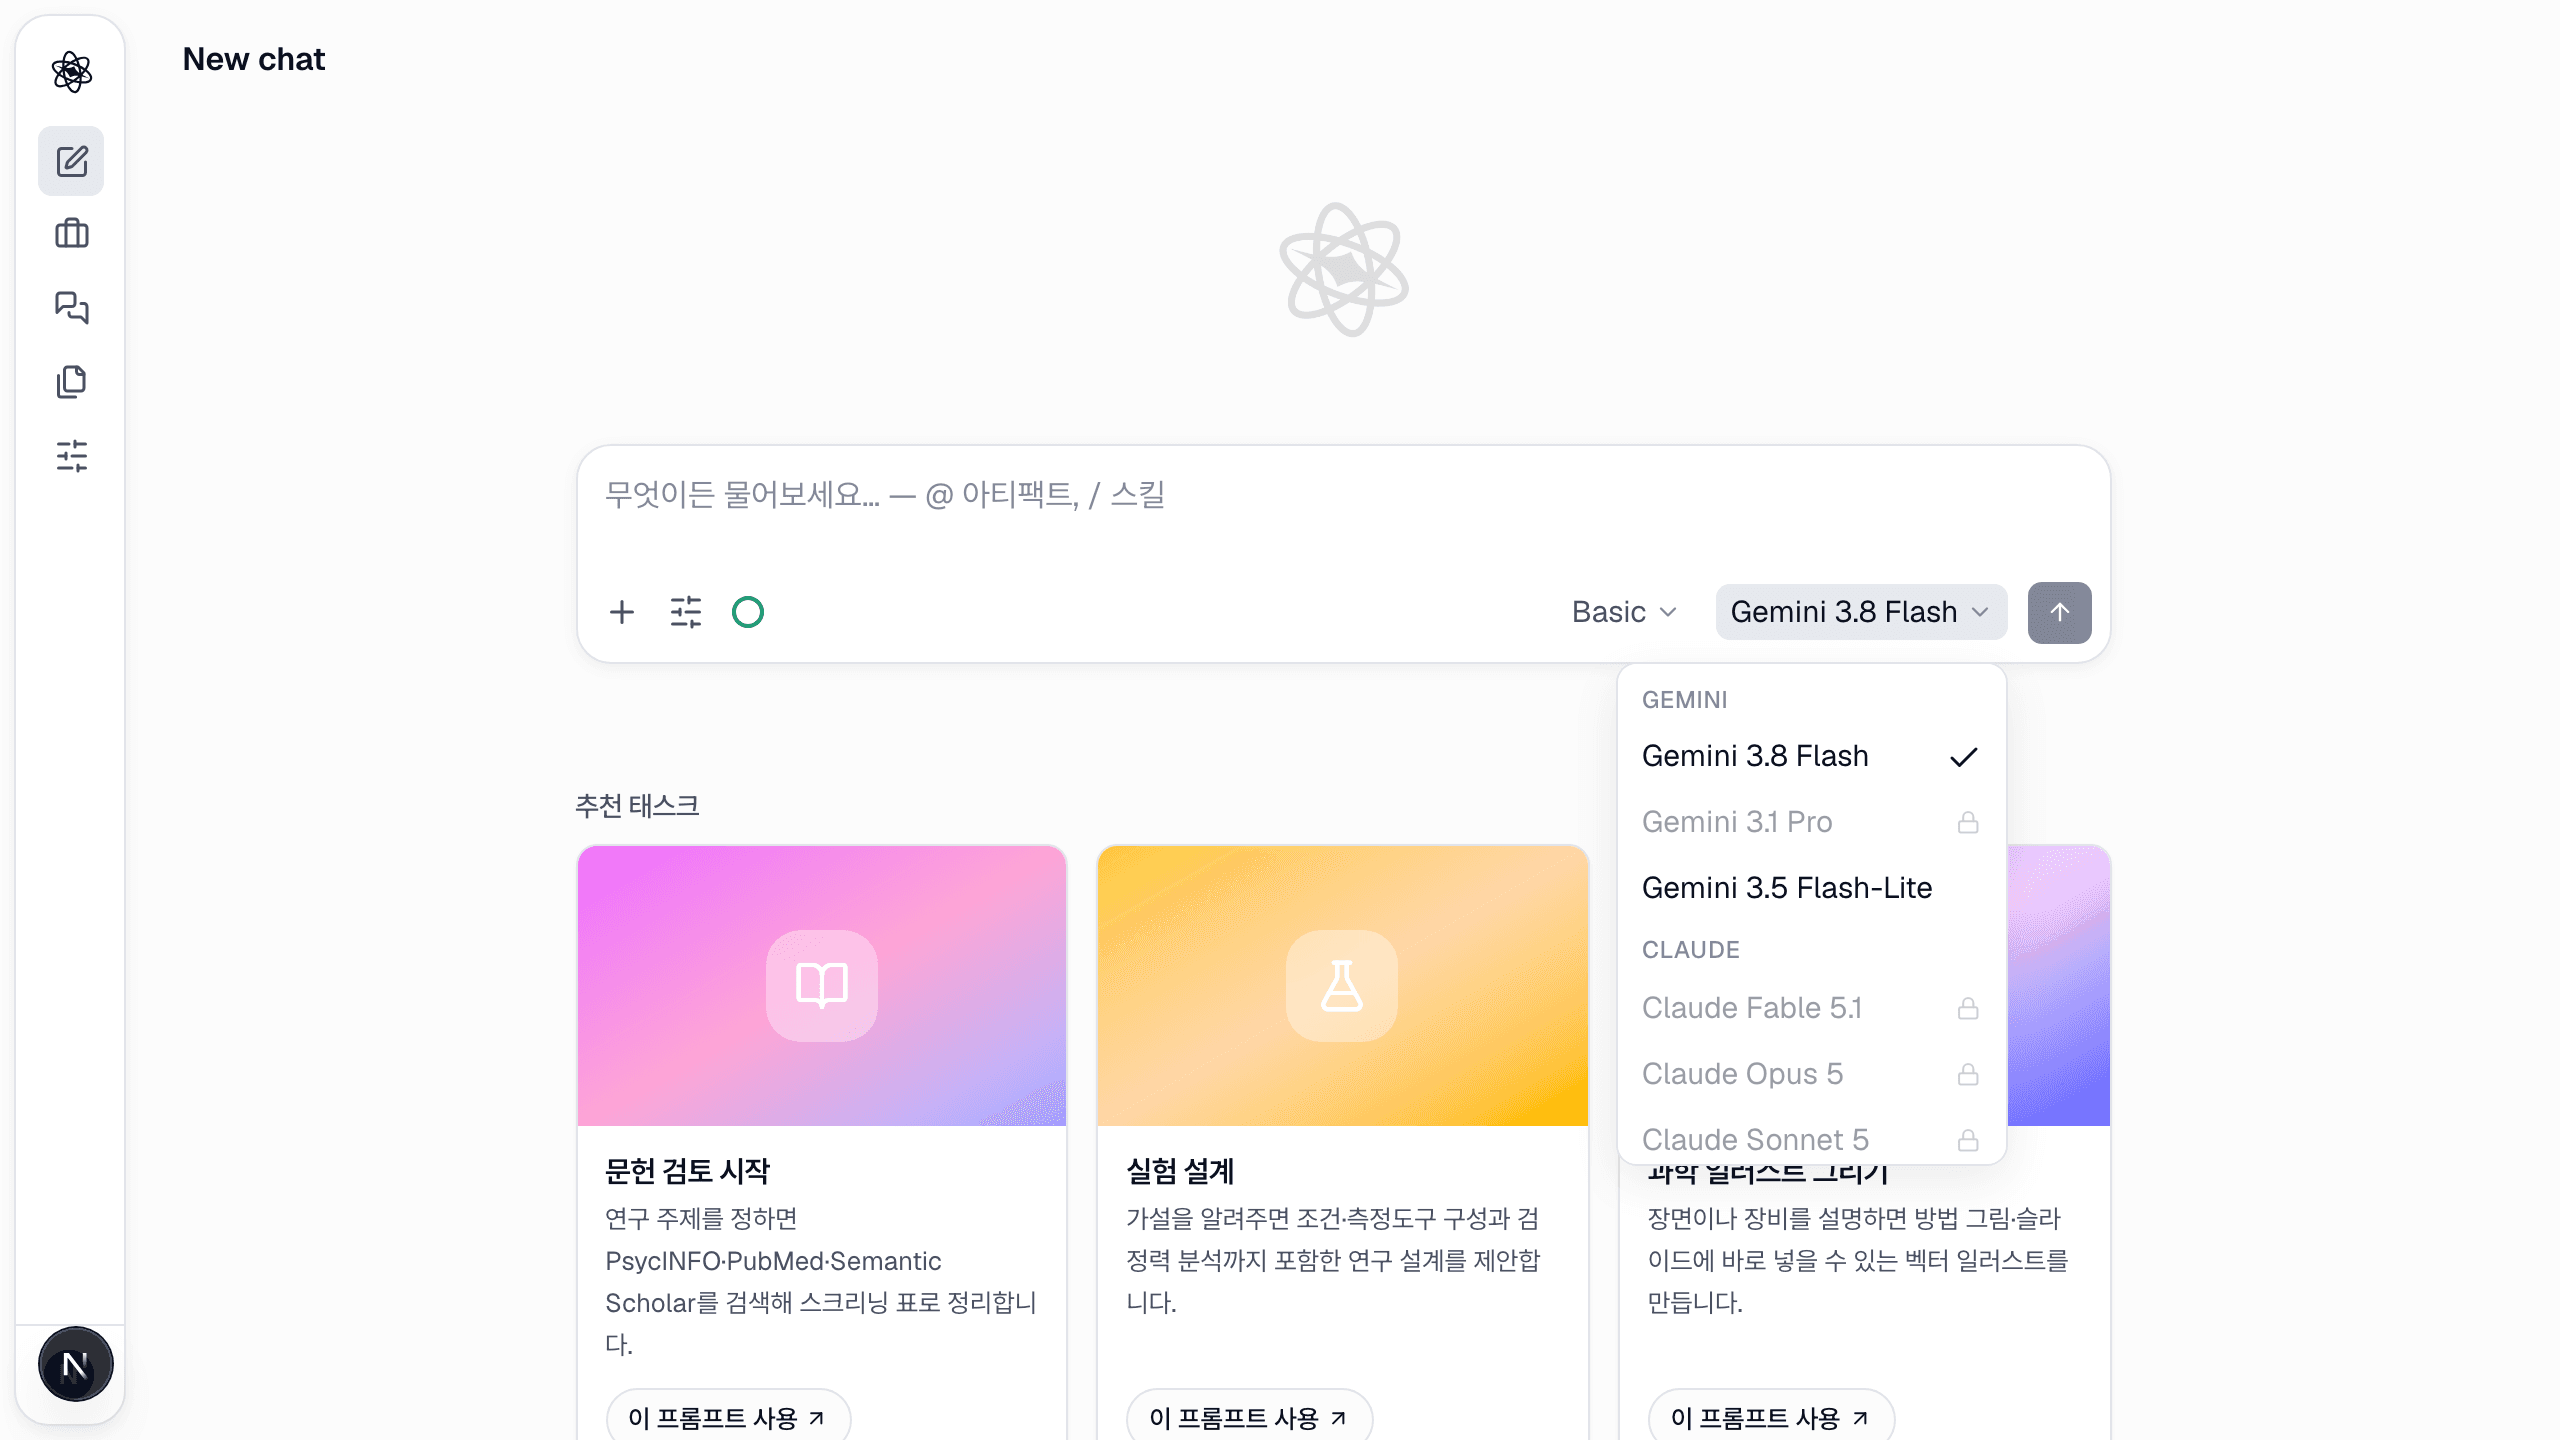
모델을 고르지 않으면 라우터가 작업별로 티어를 고릅니다: 리서치와 작성에는 더 강한 모델, 분석 코드에는 더 빠른 모델. Lite는 토큰을 아끼려고 한 티어 내립니다.
로컬 모델(데스크톱 앱)
로컬 모델은 출시 준비 중인 데스크톱 앱이 출시되면 쓸 수 있습니다. 브라우저에서는 턴이 클라우드 모델로 실행됩니다.
데스크톱 앱(macOS·Windows)에서는 내 컴퓨터에 있는 모델로 턴을 실행할 수 있습니다. 커스터마이즈 → 로컬 AI(데스크톱 전용 패널)를 열어 런타임(llama.cpp, 한 번만 내려받음)과 추천 목록의 모델을 설치하거나, 이미 실행 중인 Ollama·LM Studio 또는 OpenAI 호환 서버를 그대로 연결합니다. 설치한 모델은 컴포저의 모델 메뉴에서 이 기기에서(On this device) 그룹에 나타나며, 브라우저와 모바일에서는 이 그룹을 쓸 수 없습니다.
추천 목록은 컴퓨터의 메모리에 맞춰집니다: RAM 8~16 GB면 4B급, 24~32 GB면 8B~20B급, 64 GB 이상이면 30B급 모델입니다.
- 과금 없음. 로컬 턴은 관리형 토큰을 쓰지 않으며 Free를 포함한 모든 플랜에서 동작합니다.
- Lite와 Basic. 두 강도 모두 쓸 수 있습니다. Deep은 아직 로컬 모델에서 쓸 수 없고, Deep 턴은 안내와 함께 Basic으로 실행됩니다.
- 클라우드보다 느림. 모델이 프롬프트를 처리하는 동안 턴의 첫 단계가 오래 걸릴 수 있고, 이후 단계는 빨라집니다. 로컬 모델이 실패하면(메모리 부족, 턴 도중 앱 종료) 채팅에 클라우드 모델로 다시 보내기 선택지가 나타납니다.
- 데이터가 가는 곳. 모델은 내 컴퓨터에서 실행됩니다. 프롬프트와 도구 관찰 결과는 모델에 닿기 위해 뉴트로픽 서버의 메모리를 거치지만, 제3자 AI 제공자는 데이터를 받지 않습니다. 원본 파일은 다른 데스크톱 턴과 마찬가지로 내 기기에서만 읽힙니다.
- 민감 프로젝트. 로컬 모델을 고르면 라우팅과 요약을 포함한 모든 것이 로컬 모델에 머뭅니다. 그 밖의 프로젝트에서는 로컬 AI 패널의 라우팅·요약에 클라우드 사용(관리형 토큰 소모) 토글로 이런 작은 보조 호출만 빠른 클라우드 모델에 보낼 수 있으며, 기본은 꺼짐입니다.
자기 API 키
자기 프로바이더 키(Gemini, Anthropic, OpenAI)로 실행하는 턴 역시 관리형 토큰에서 차감되지 않을 예정입니다 — Free를 포함한 모든 플랜에서 무제한입니다. 키를 추가하는 계정별 설정은 출시 준비 중인 데스크톱 앱과 함께 제공될 예정이며, 그전까지 클라우드 턴은 관리형 토큰으로 실행됩니다. 변경 내역을 지켜봐 주세요.
검색 스킬용 연구 플랫폼 토큰(Scopus, Web of Science 등)도 커스터마이즈에 추가될 예정이며, 공개 데이터베이스에는 토큰이 필요 없습니다.
관리형 토큰
클라우드 턴은 표준 모델 기준의 관리형 토큰으로 계산됩니다. 가벼운 모델은 할당이 더 오래 가고, 무거운 모델은 더 빨리 씁니다. 각 답변은 사용한 토큰을 표시하고, 프로필 메뉴와 커스터마이즈 → 사용량은 이달의 잔액, 일일 한도, 세션별 내역을 보여 줍니다. 플랜과 토큰을 보세요.