强度等级
输入框中的智能体控件设置下一个回合的强度。默认是 Basic。
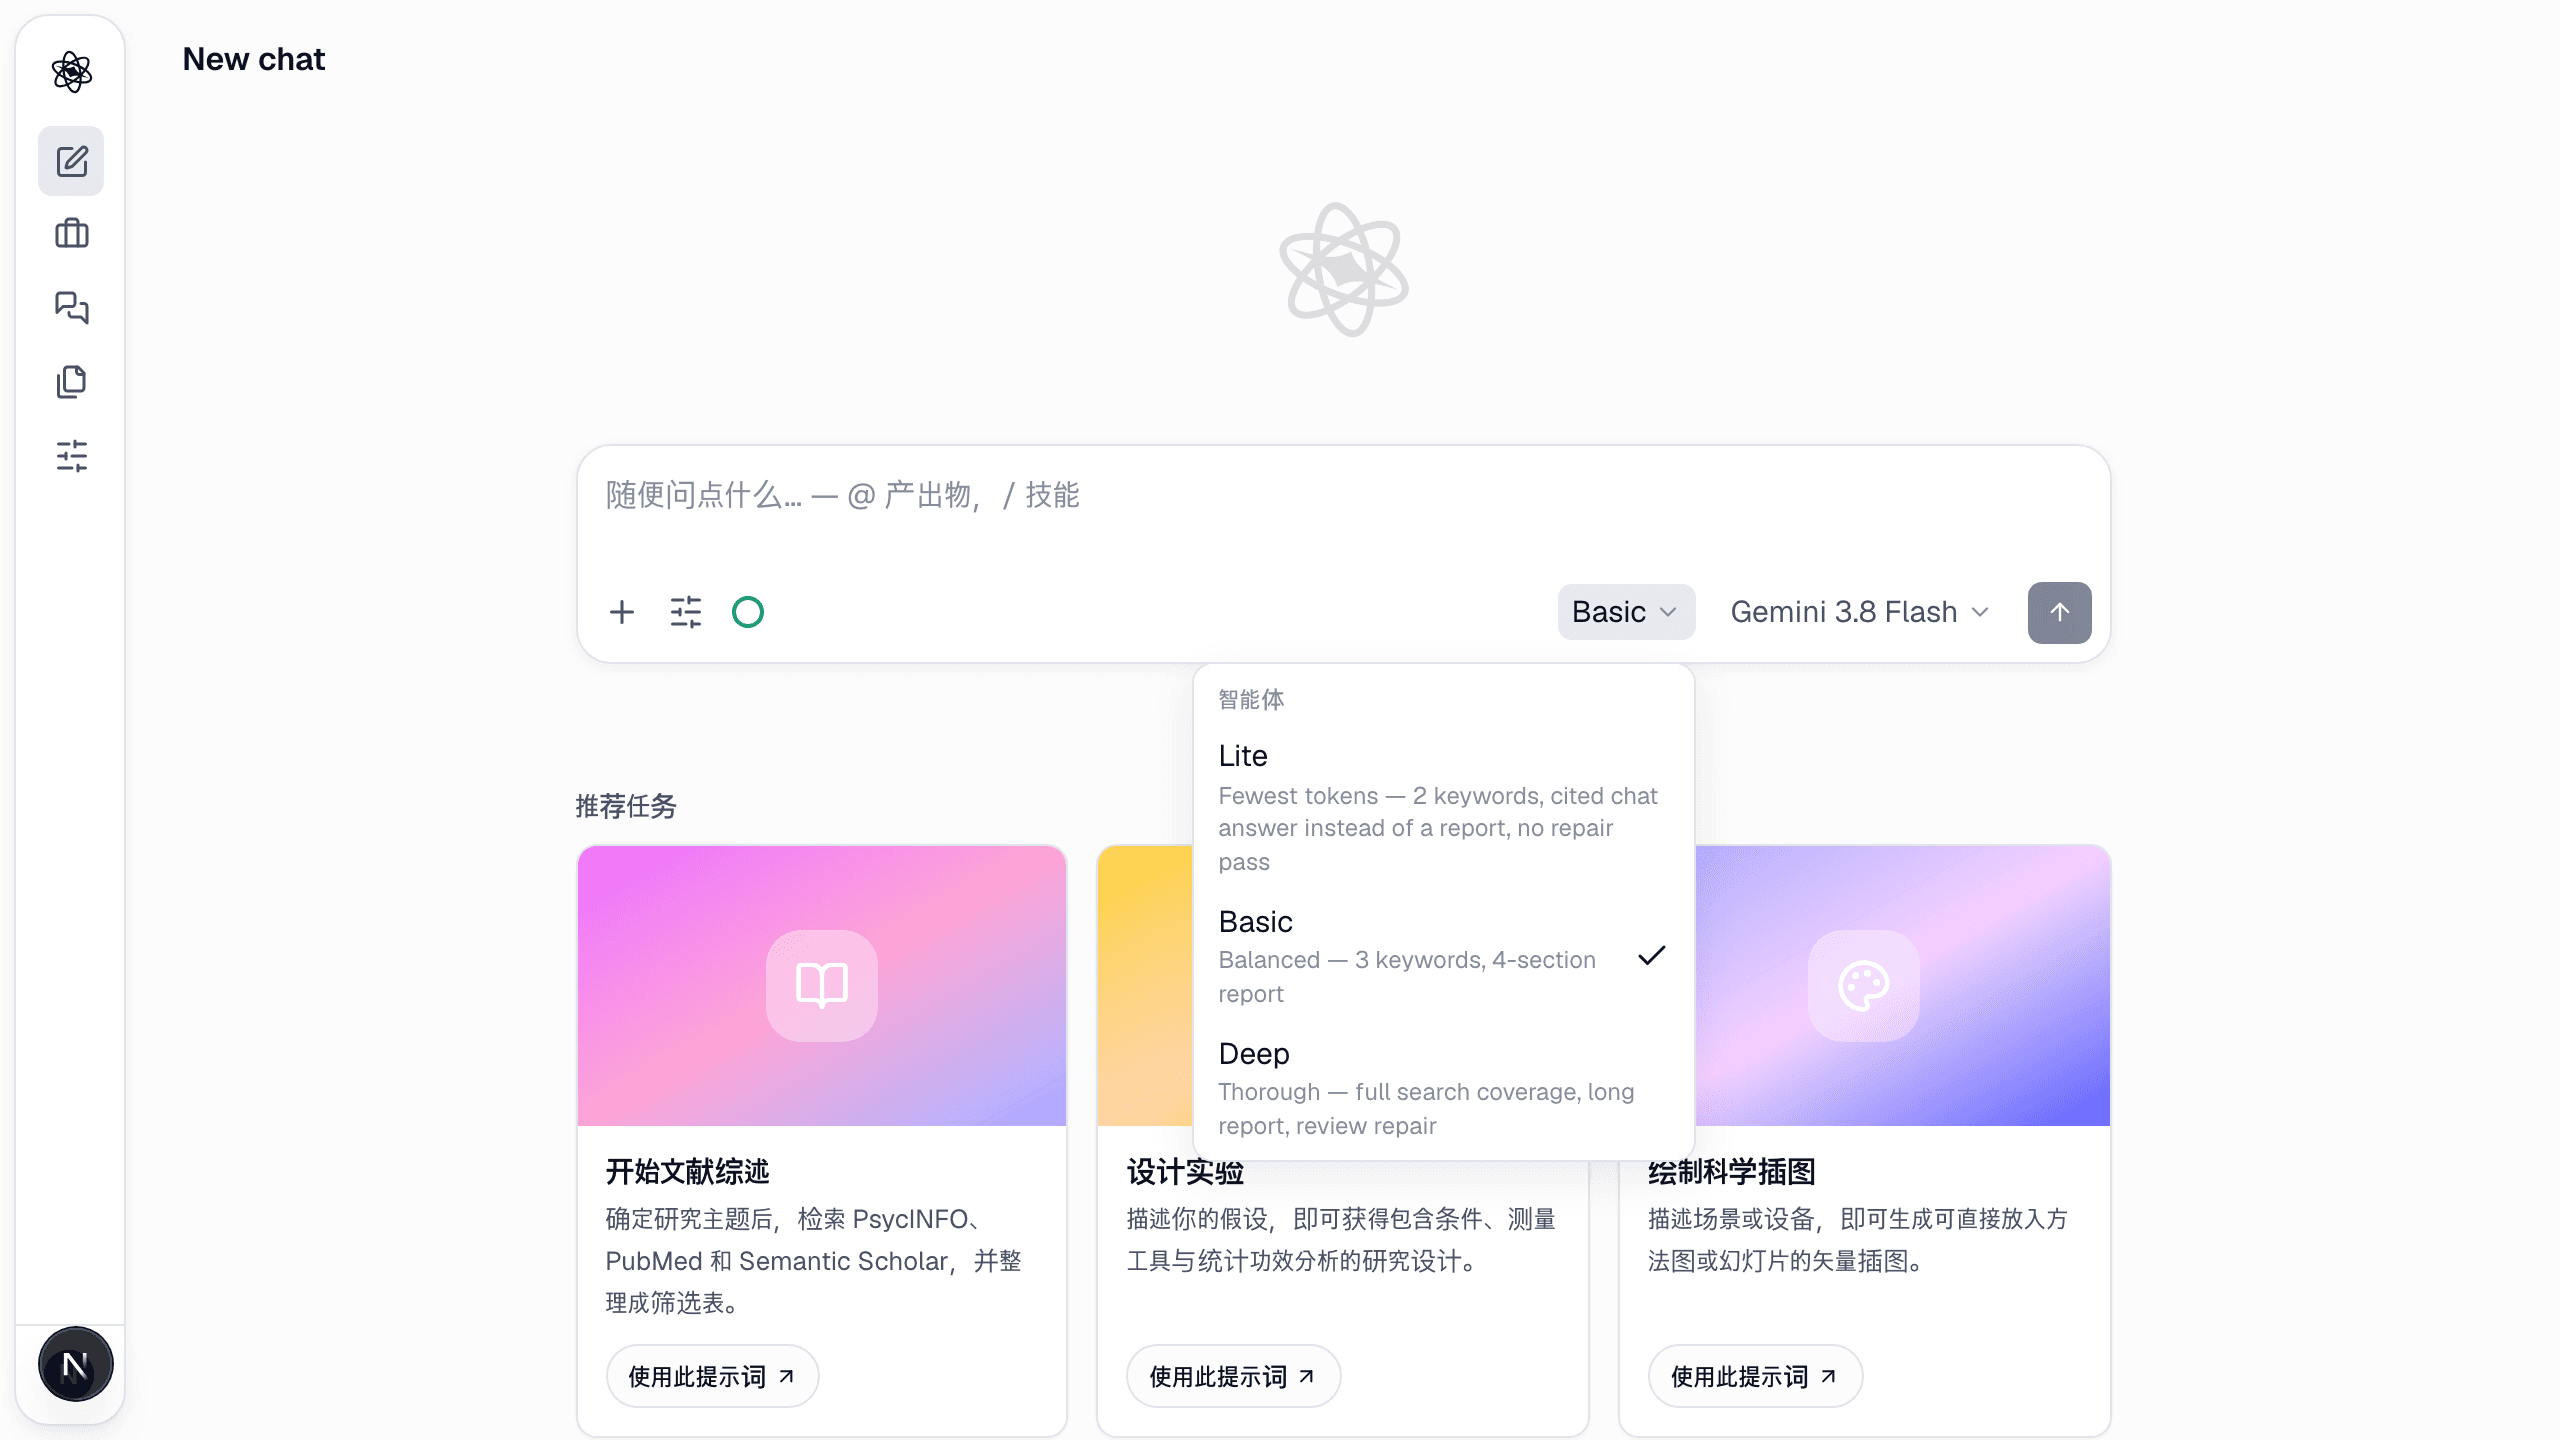
| Lite | Basic(默认) | Deep | |
|---|---|---|---|
| 每回合检索次数 | 最多 4 | 最多 8 | 不限 |
| 子智能体(并行委派) | 否 | 是 | 是 |
| 报告 | 无——有来源的聊天回答即为交付物 | 3–4 节报告 | 3–6 节的更长报告 |
| 覆盖检查与缺口规划 | 关 | 开 | 开 |
| 审查修复 | 关 | 开 | 开,含重跑 |
| 每回合步骤数 | 14 | 40 | 64 |
| 插图质量 | 草稿 | 标准 | 出版级 |
| 典型文献回合 | ~150K 令牌 | ~400–500K | ~800K+ |
快速提问和定向用 Lite,日常研究回合用 Basic,重要事项的最终一遍用 Deep。强度应用于整个回合,包括报告综合与审查。
模型
模型控件选择下一个回合的模型。Gemini、Claude、ChatGPT、DeepSeek 和 Kimi 模型使用套餐的托管令牌运行;每个模型旁的条形表示其消耗额度的速度(1 条轻量,2 条标准,3 条重型)。标记为 premium 的模型在 Free 套餐中不可选;付费套餐可使用全部模型。智能体菜单会显示以所选模型运行各强度大约消耗多少 token,以及占本周 token 的百分比。
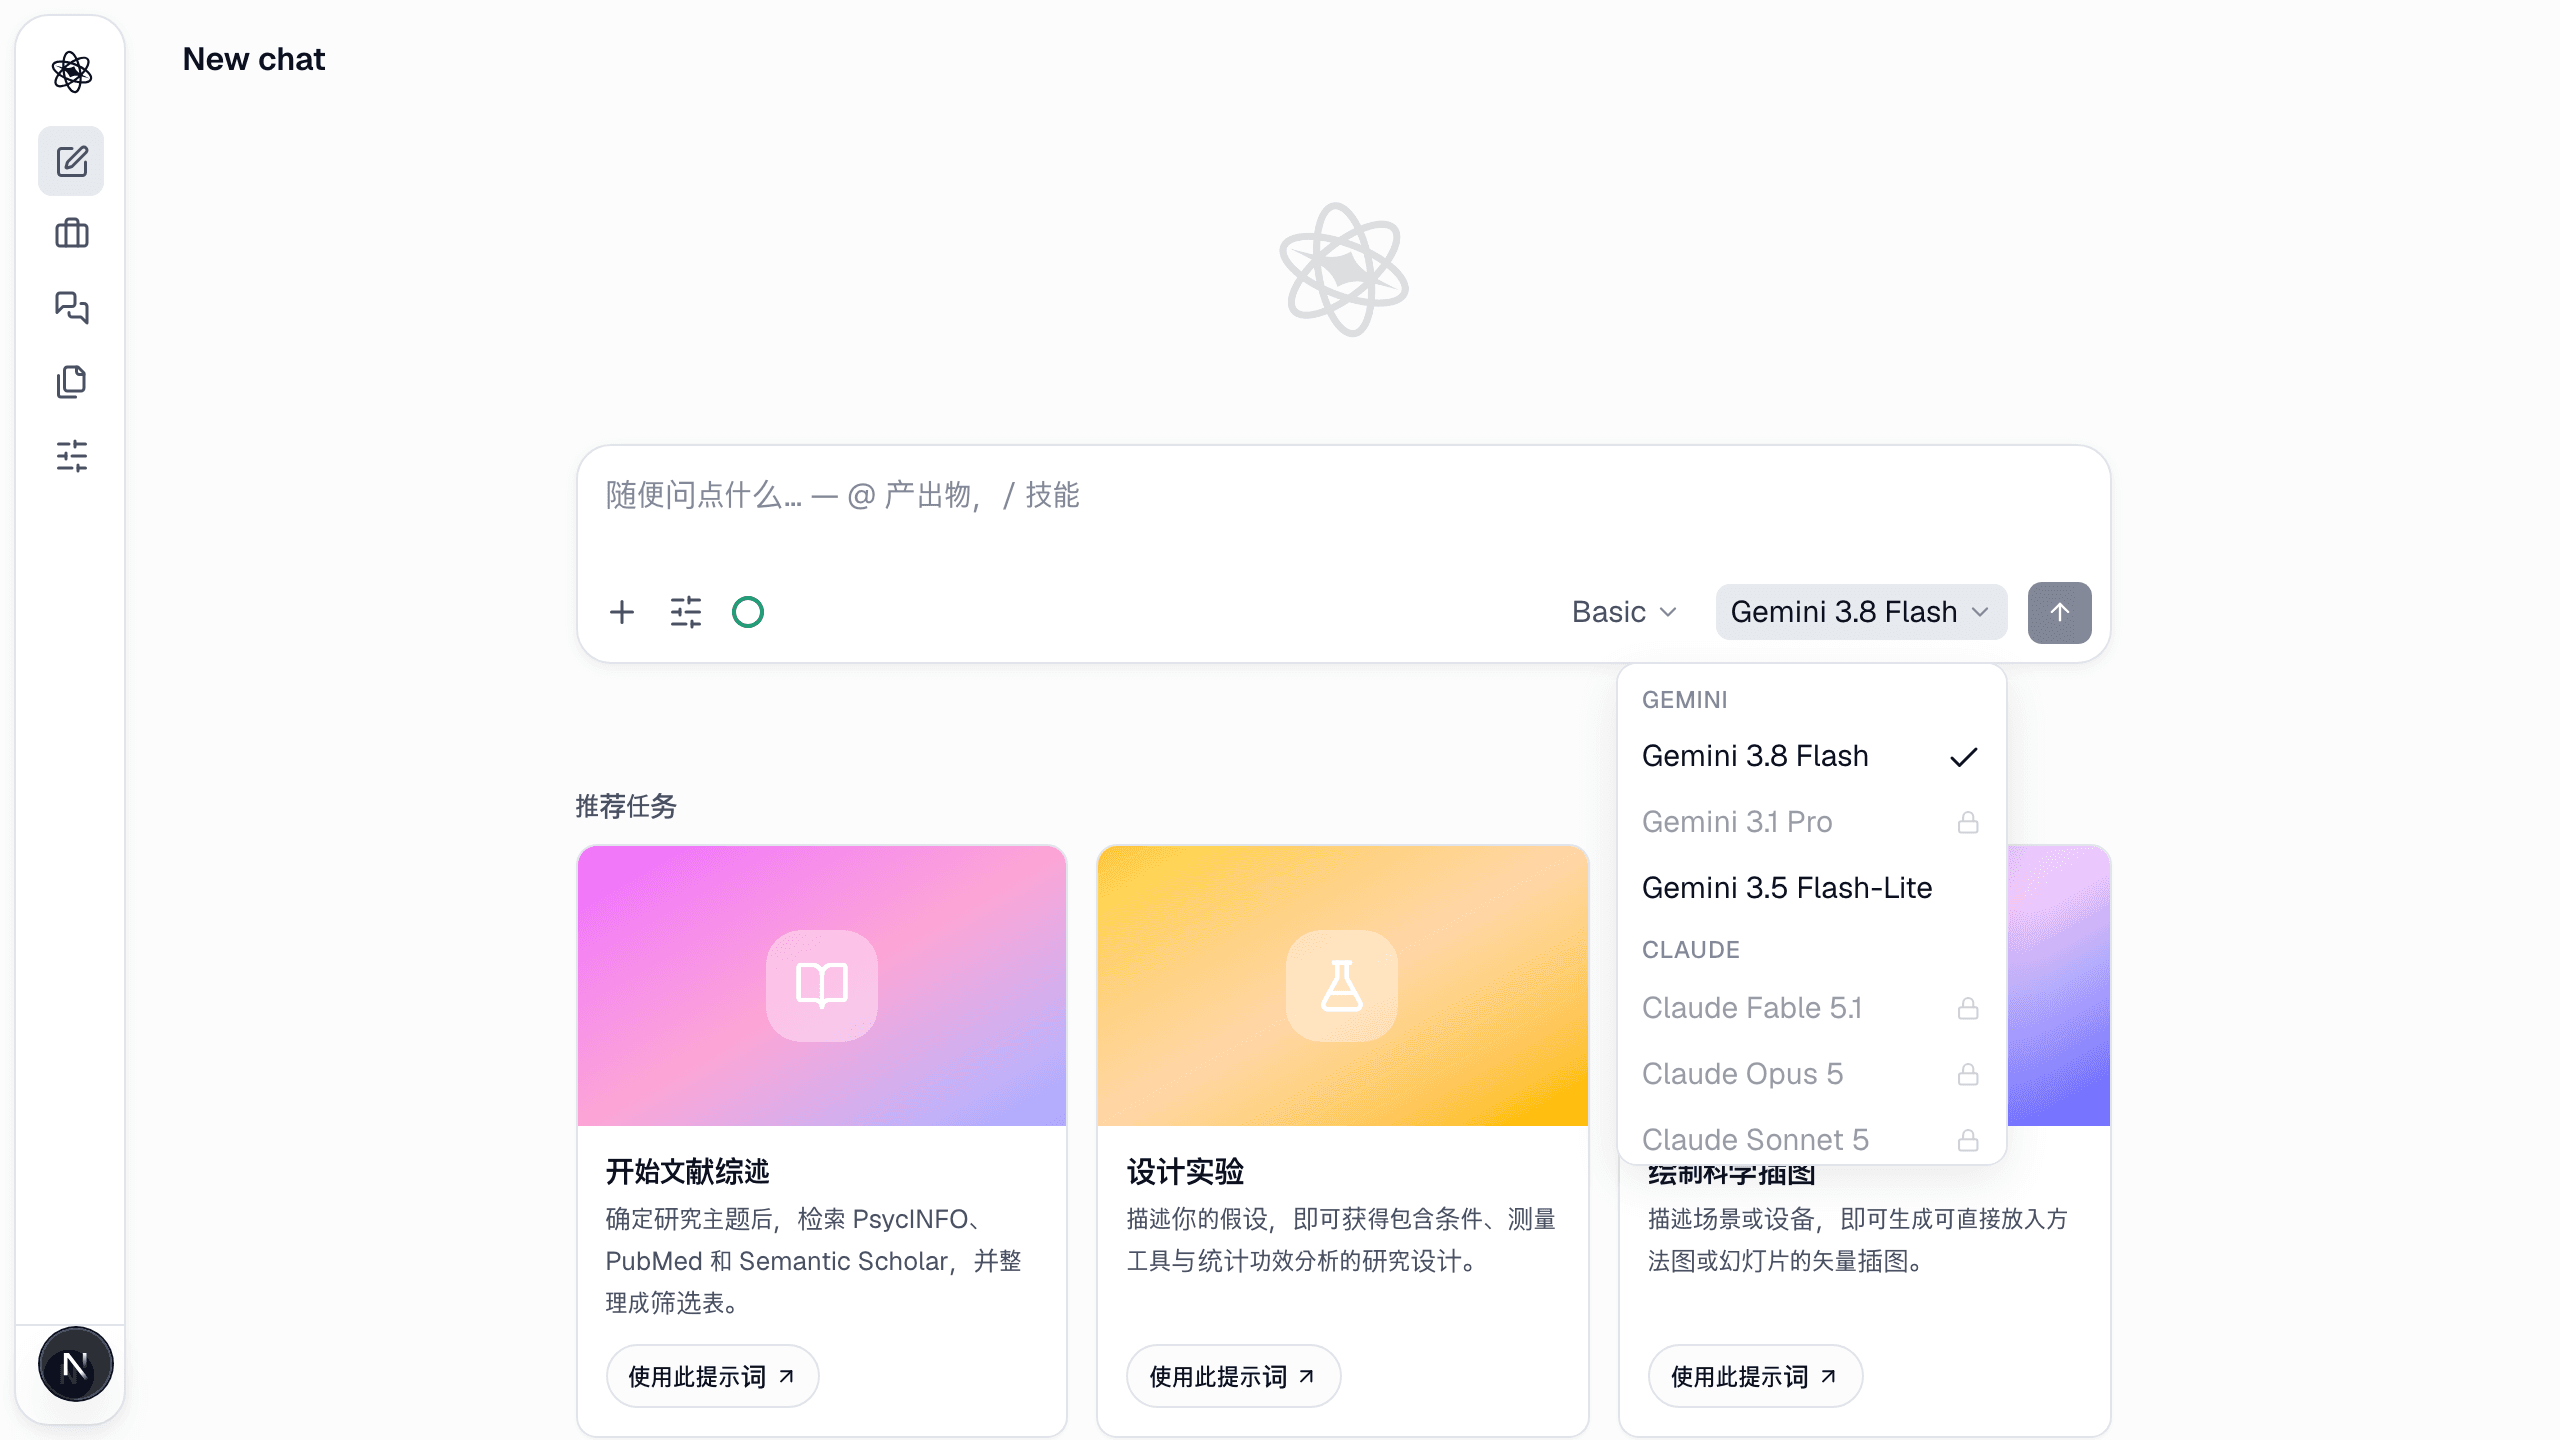
不选模型时,路由器按任务选择层级:研究和写作用更强的模型,分析代码用更快的模型。Lite 会降一档以节省令牌。
本地模型(桌面应用)
本地模型将在正在准备发布的桌面应用推出后可用。在浏览器中,回合由云端模型运行。
在桌面应用(macOS 和 Windows)中,一个回合可以由你电脑上的模型运行。打开自定义 → 本地 AI(仅桌面可见的面板),安装运行时(llama.cpp,只下载一次)和推荐列表中的模型,或者直接接入你已经在运行的 Ollama、LM Studio 或任何 OpenAI 兼容服务器。安装好的模型会出现在输入框的模型菜单的此设备上(On this device)分组中;在浏览器和移动端无法使用该分组。
推荐列表按电脑内存选定:8–16 GB 内存适合 4B 级模型,24–32 GB 适合 8B–20B 级,64 GB 及以上适合 30B 级模型。
- 永不计费。 本地回合不消耗托管令牌,在包括 Free 在内的所有套餐中都可用。
- Lite 与 Basic。 两个强度都可用;Deep 目前尚不支持本地模型——Deep 回合会以 Basic 运行并给出提示。
- 比云端慢。 模型处理提示词时,回合的第一步可能需要等待一会儿;之后的步骤会更快。如果本地模型失败(内存不足、回合中途关闭应用),聊天中会出现用云端模型重试选项。
- 数据去向。 模型在你的电脑上运行。提示词和工具观察结果会在内存中经过 Neutropic 服务器以到达模型,但没有任何第三方 AI 提供商会收到你的数据。原始文件仍然只在你的设备上读取,与其他桌面回合一样。
- 敏感项目。 选择本地模型后,包括路由和摘要在内的一切都留在本地模型上。在其他项目中,本地 AI 面板中的路由与摘要使用云端(消耗托管令牌)开关可以把这些小的辅助调用改交给快速的云端模型;默认关闭。
你自己的 API 密钥
用你自己的提供商密钥(Gemini、Anthropic、OpenAI)运行的回合同样将永远不计入托管令牌——在包括 Free 在内的所有套餐中都不限量。用于添加密钥的账户级设置将随正在准备发布的桌面应用一起推出;在此之前,云端回合使用托管令牌运行。请关注更新日志。
供检索技能使用的研究平台 token(Scopus、Web of Science 等)也将加入自定义;开放数据库无需 token。
托管令牌
云端回合按标准模型的费率以托管令牌计量:轻量模型让额度用得更久,重型模型消耗得更快。每条回答都显示所用 token;个人资料菜单和自定义 → 用量显示本月余额、每日上限和按会话的明细。见套餐与令牌。