研究ツールの多くは一つの工程しか受け持ちません。文献管理ソフトが論文を持ち、統計パッケージが検定を回し、作図ツールが図を作り、ワープロが原稿を抱える。その間の文脈を運ぶのは研究者本人です。受け渡しのたびに数値を打ち直して間違え、引用がずれ、図がプロトコルと合わなくなります。
この記事は、一つの研究をチャットから出ずに Neutropic で最後まで進めた記録です。文献調査、仮説、実験デザイン、データ分析、統計、図とイラスト、原稿、独立したレポートレビュー、ジャーナル基準の論文査読、そしてラボミーティング用スライドまで。絵コンテではなく実際のセッションです。自分で開けます。マイライブラリの例 · 研究ワークフローは、どのアカウントからも閲覧できる読み取り専用の例プロジェクトで、サイトの4言語それぞれで実行されています。研究の問いは「4週間の心拍変動(HRV)バイオフィードバックは大学生の知覚ストレス(PSS-10)を下げるか」です。以下に引用する数値は英語セッションのものです。他の言語のセッションはデザインも判定も少しずつ違っていて、受け取った結果は読んでから使うべきだという良い注意喚起になっています。
プロンプトを一つずつ追う案内は大学院生のための Neutropicにあるので、ここでは繰り返しません。この記事が見るのは、各ターンの内側で何が起きているか、そしてより重要なこととして、あるターンから次のターンへ何が引き継がれるかです。
セッションの概要
- 11ターン、チャット一つ、プロジェクト一つ。
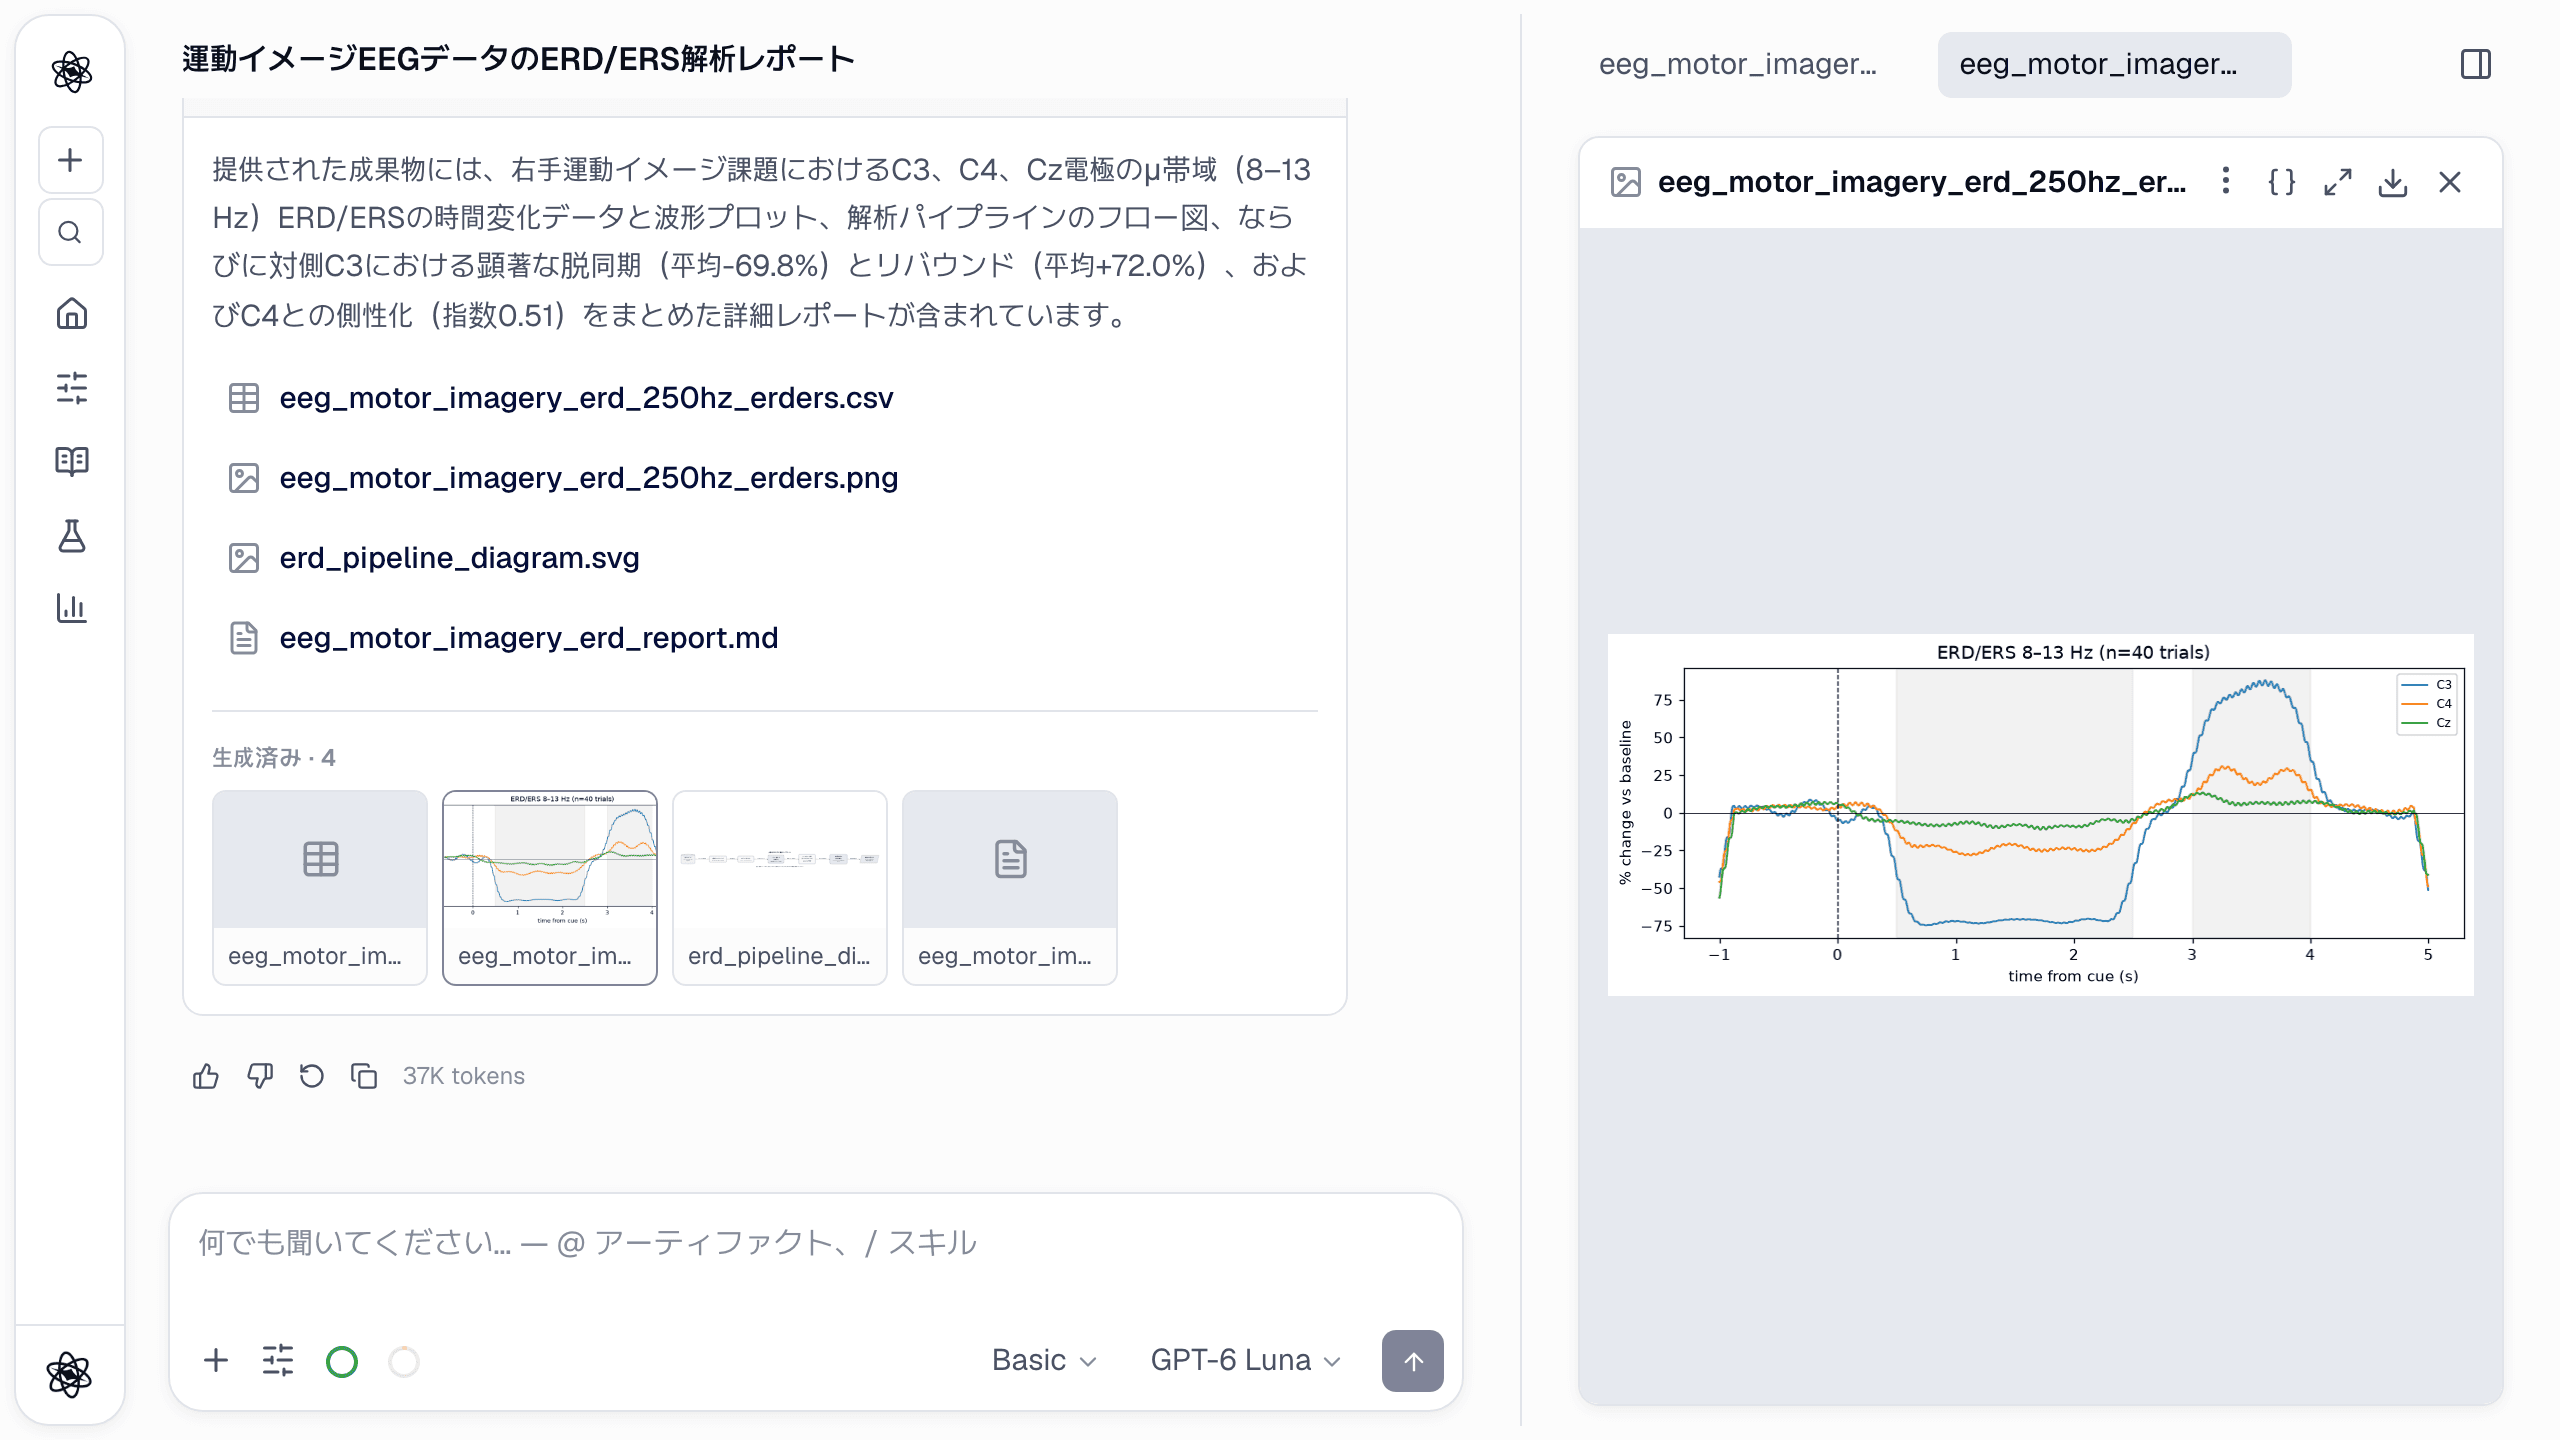
- 20を超える成果物: スクリーニング済み文献表、レビューレポート、文献ダイアグラム3点、検出力曲線とプロトコル図付きのデザインレポート、分析レポートと3パネルの結果図、統計レポート、研究フロー図、フレームワーク図付きの仮説提案書、方法のイラスト、原稿、レビューレポート、論文査読レポート、17枚のスライド。
- 管理トークン合計およそ210万、Basic エフォート。各ターンの下にそのターンの使用量が表示されます。
- 後のターンが必要とするものは、すべて前の成果物から来ます。モデルが会話を覚えているからではありません。この記事が扱う設計判断はまさにそれです。
ターンの構造
どのターンも同じ構造をしていて、読み方を覚えておく価値があります。作業を検証する場所がここだからです。
- 計画。 エージェントが短い計画を書き、進めながらチェックします(
計画 4/4 done)。飛ばした項目があればチャットがそう言います。 - ステップ。 7件の検索を実行、コードを5ステップ実行、2ページを読み込み、検証といったグループ行で、展開するとクエリ、コード、触れた文書が見えます。
- このプロジェクトの他のチャットで確定した決定をN件適用しました。 ターン冒頭のチップで、プロジェクトで先に確定した事実がいくつターン開始前に読み込まれたかを示します。クリックすると一覧が見えます。
- 作成された成果物。 そのターンが作ったファイルで、右側のパネルで開きます。
- トークン。 そのターンが使った管理トークン。
ステップ一覧は飾りではありません。後でレポートレビューのターンが「統計を再導出した」と言うとき、ステップ一覧には実際に走らせた Python があり、出力はワンクリックで見えます。
ターン1 — 文献調査
/research 次のテーマを論文データベース(OpenAlex, PubMed, Crossref, Semantic Scholar, Europe PMC)とウェブで調査し、研究のタイムライン、主要な知見、マイルストーン研究、今後の方向性を整理してください: 心拍変動(HRV)バイオフィードバックは成人の知覚ストレスを下げるか? ランダム化比較試験に絞り、効果量を報告してください。
最初のターンはセッションに材料を蓄えるターンです。エージェントは論文データベースとウェブで7回検索し、上位ヒットの先にあるページを読み、取得済みの結果を読み直して根拠を抽出してから、ようやく書きました。ステップ一覧には各クエリに結果数が付いているので、検索戦略を信じるのではなく見ることができます。
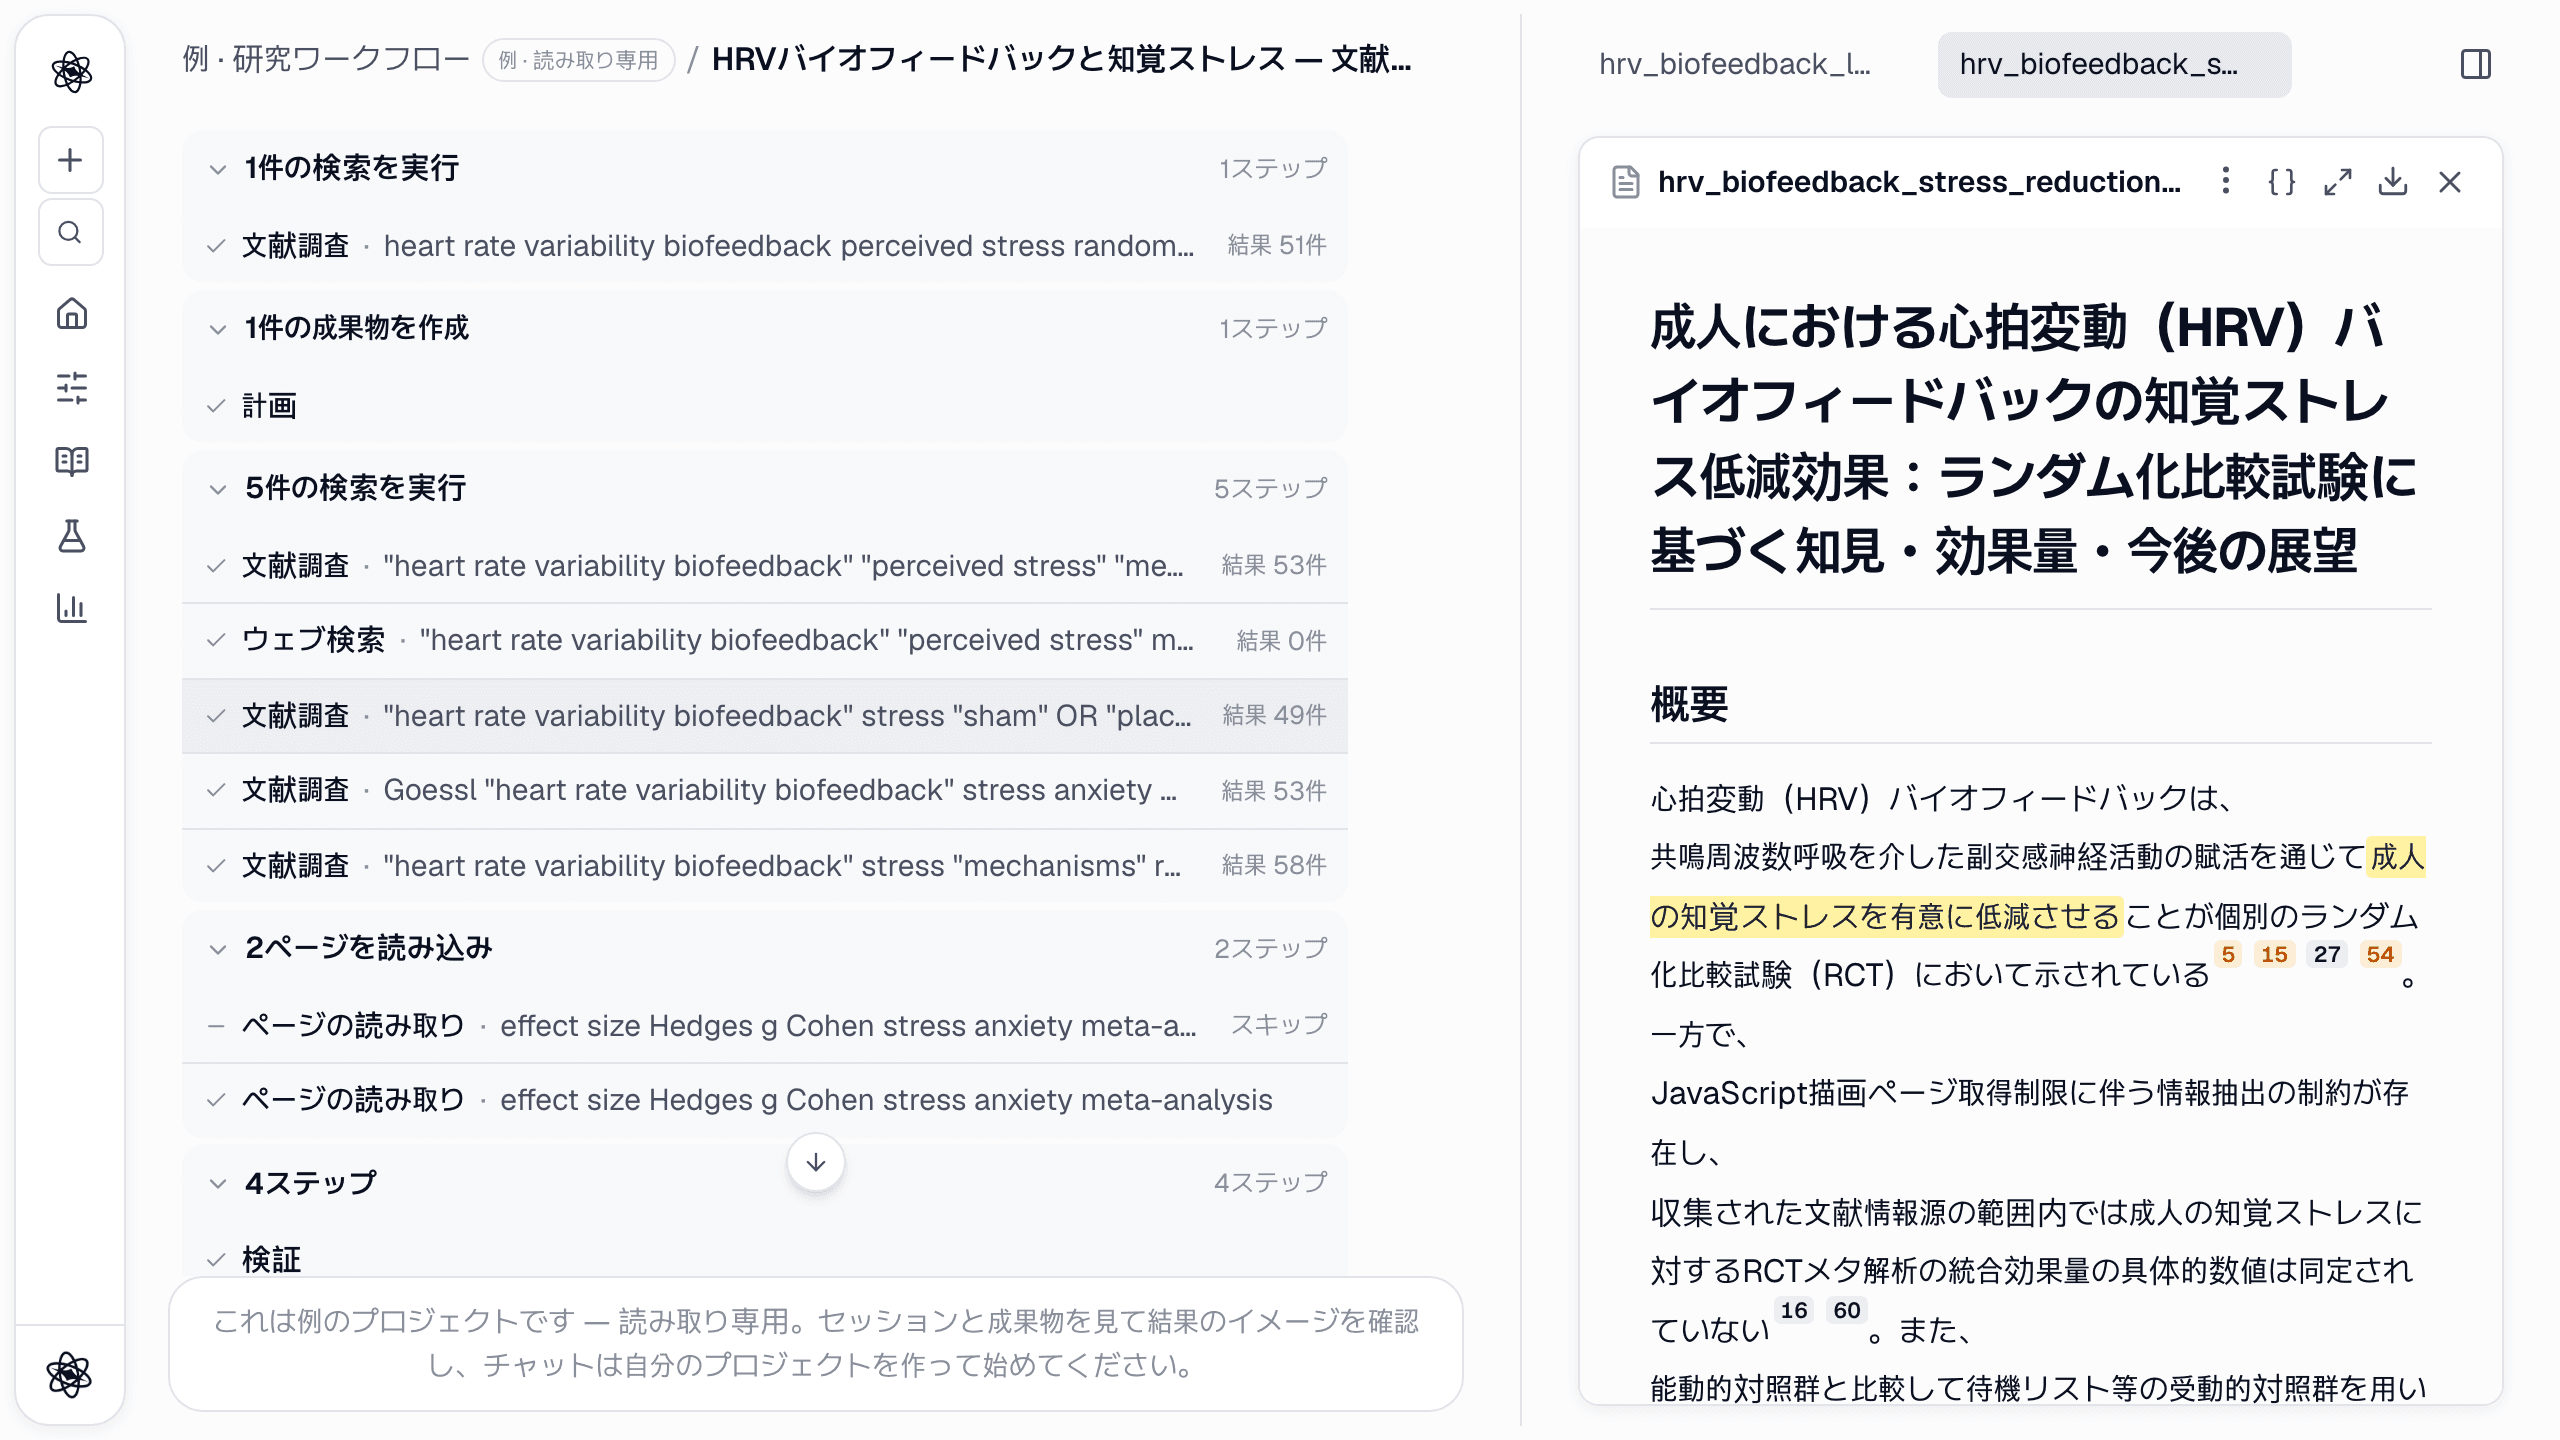
できたのは、実際に取得した出典への番号付き引用が文に付いたレビューレポート、見つけた論文のスクリーニング表(関連度スコア付き)、研究タイムライン、引用グラフ、マインドマップです。拠り所にしたメタ分析(Goessl ら 2017 など)と、バイオフィードバックを運動やマインドフルネスと比べた多群試験(van der Zwan ら 2015、de Bruin ら 2016)が、その後すべての背骨になりました。出典そのものはセッションに保存されます。これが後で効いてきます。8ターン目で原稿を書くとき、参考文献リストはこの保存庫から再構築され、本文のすべての [n] が実際に取得した論文を指します。
詳しい案内: 文献調査。
ターン2 — 実験デザイン
/experiment-design 4週間のHRVバイオフィードバックプログラムが、能動的対照群と比べて大学生の知覚ストレス(PSS-10)を下げるかを検証する2群ランダム化実験を設計してください。関連研究の方法を根拠にし、参加者・測定・プロトコルの流れ・検出力分析を含む設計レポートを作成してください。
このターンは このプロジェクトの他のチャットで確定した決定を3件適用しました で始まりました。アウトカム指標、対象集団、比較条件は最初のターンですでに固定され、デザインがそれを引き継ぎました。さらに3回検索し、同種の研究がどう行われたかを見るために van der Zwan 試験の方法を名前で探し、その上にデザインを組み立てました。
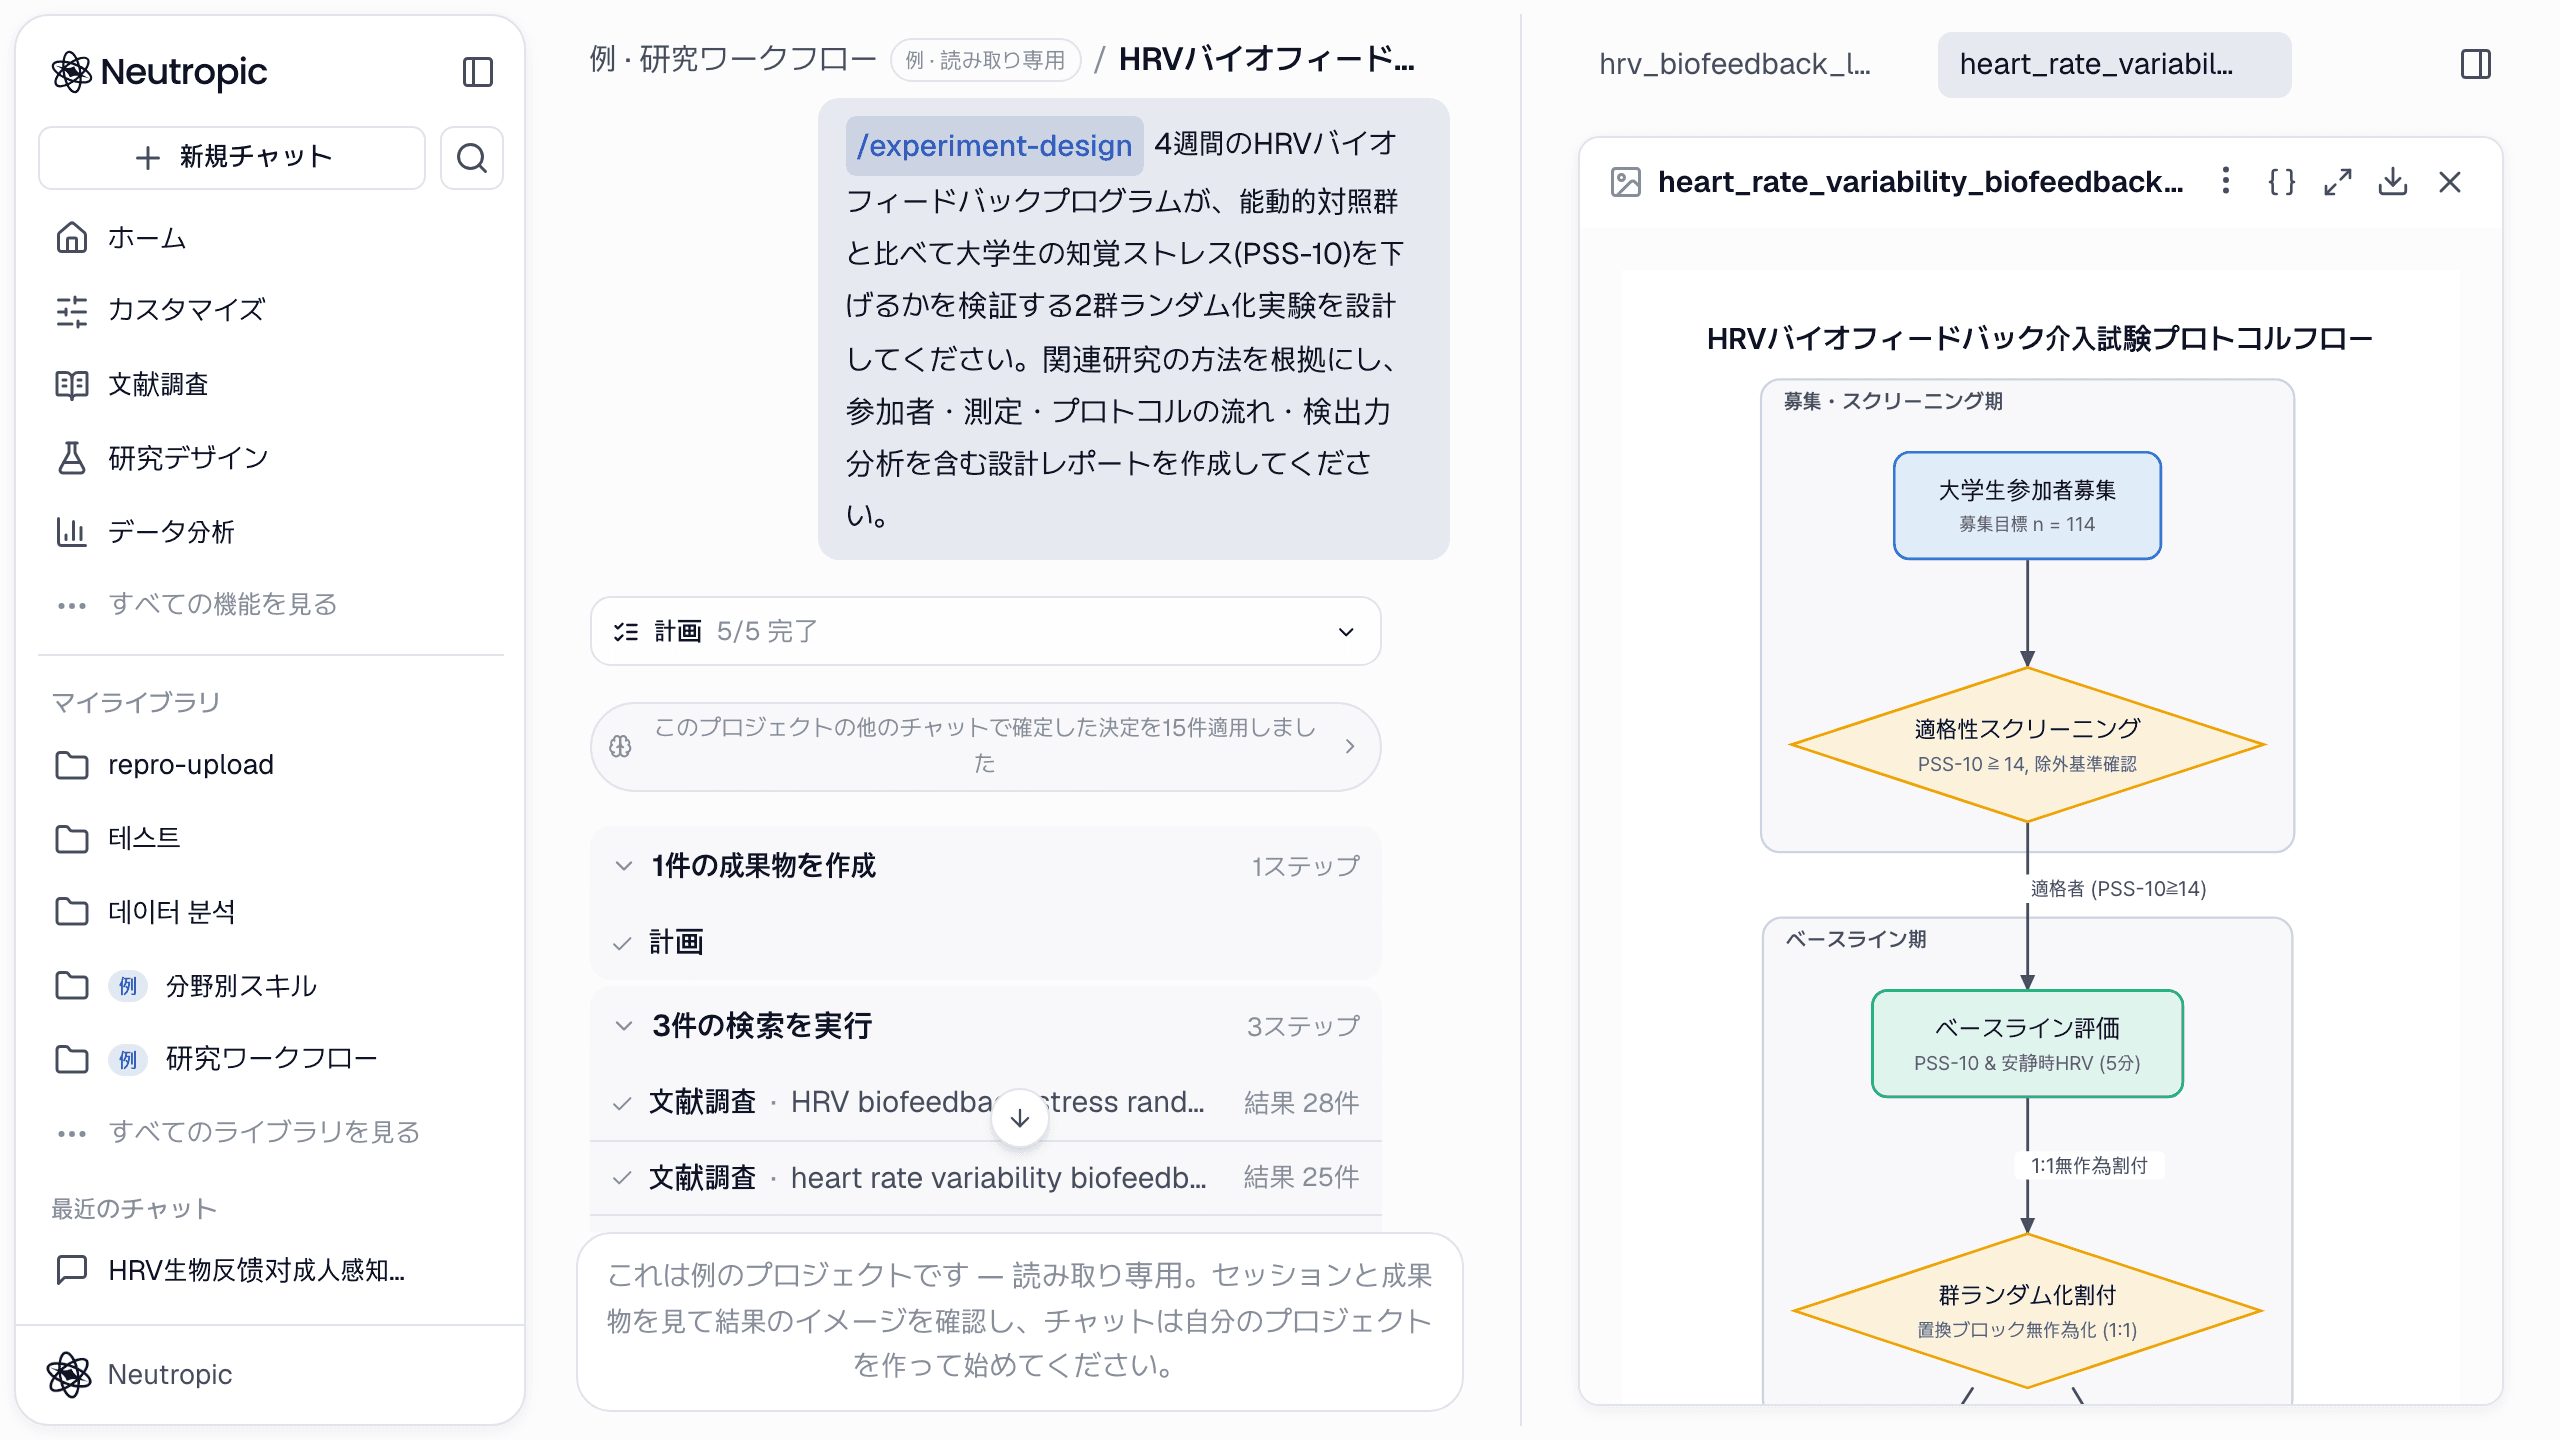
デザインレポートはセッションで最も再利用される文書です。層別ブロックランダム化の 2 × 2 混合デザイン、1日何分まで明記された両条件、測定尺度、適格基準、群あたり64名・脱落15%込みで152名募集という検出力分析、そして選択ごとに出典付きの根拠。検出力曲線、プロトコルフロー図、測定データではないと明記された期待結果チャート、参照研究のデザイン比較表が一緒に出ました。後のターンはこのファイルを名前で読みます。原稿の方法セクション、研究フロー図、スライドのすべてがここから引いています。
詳しい案内: 実験デザイン。
ターン3と4 — データ分析、それから統計
データファイル pss_trial.xlsx(参加者80名、群あたり40名のデモデータ)を + ボタンでアップロードし、2つのターンが作業しました。
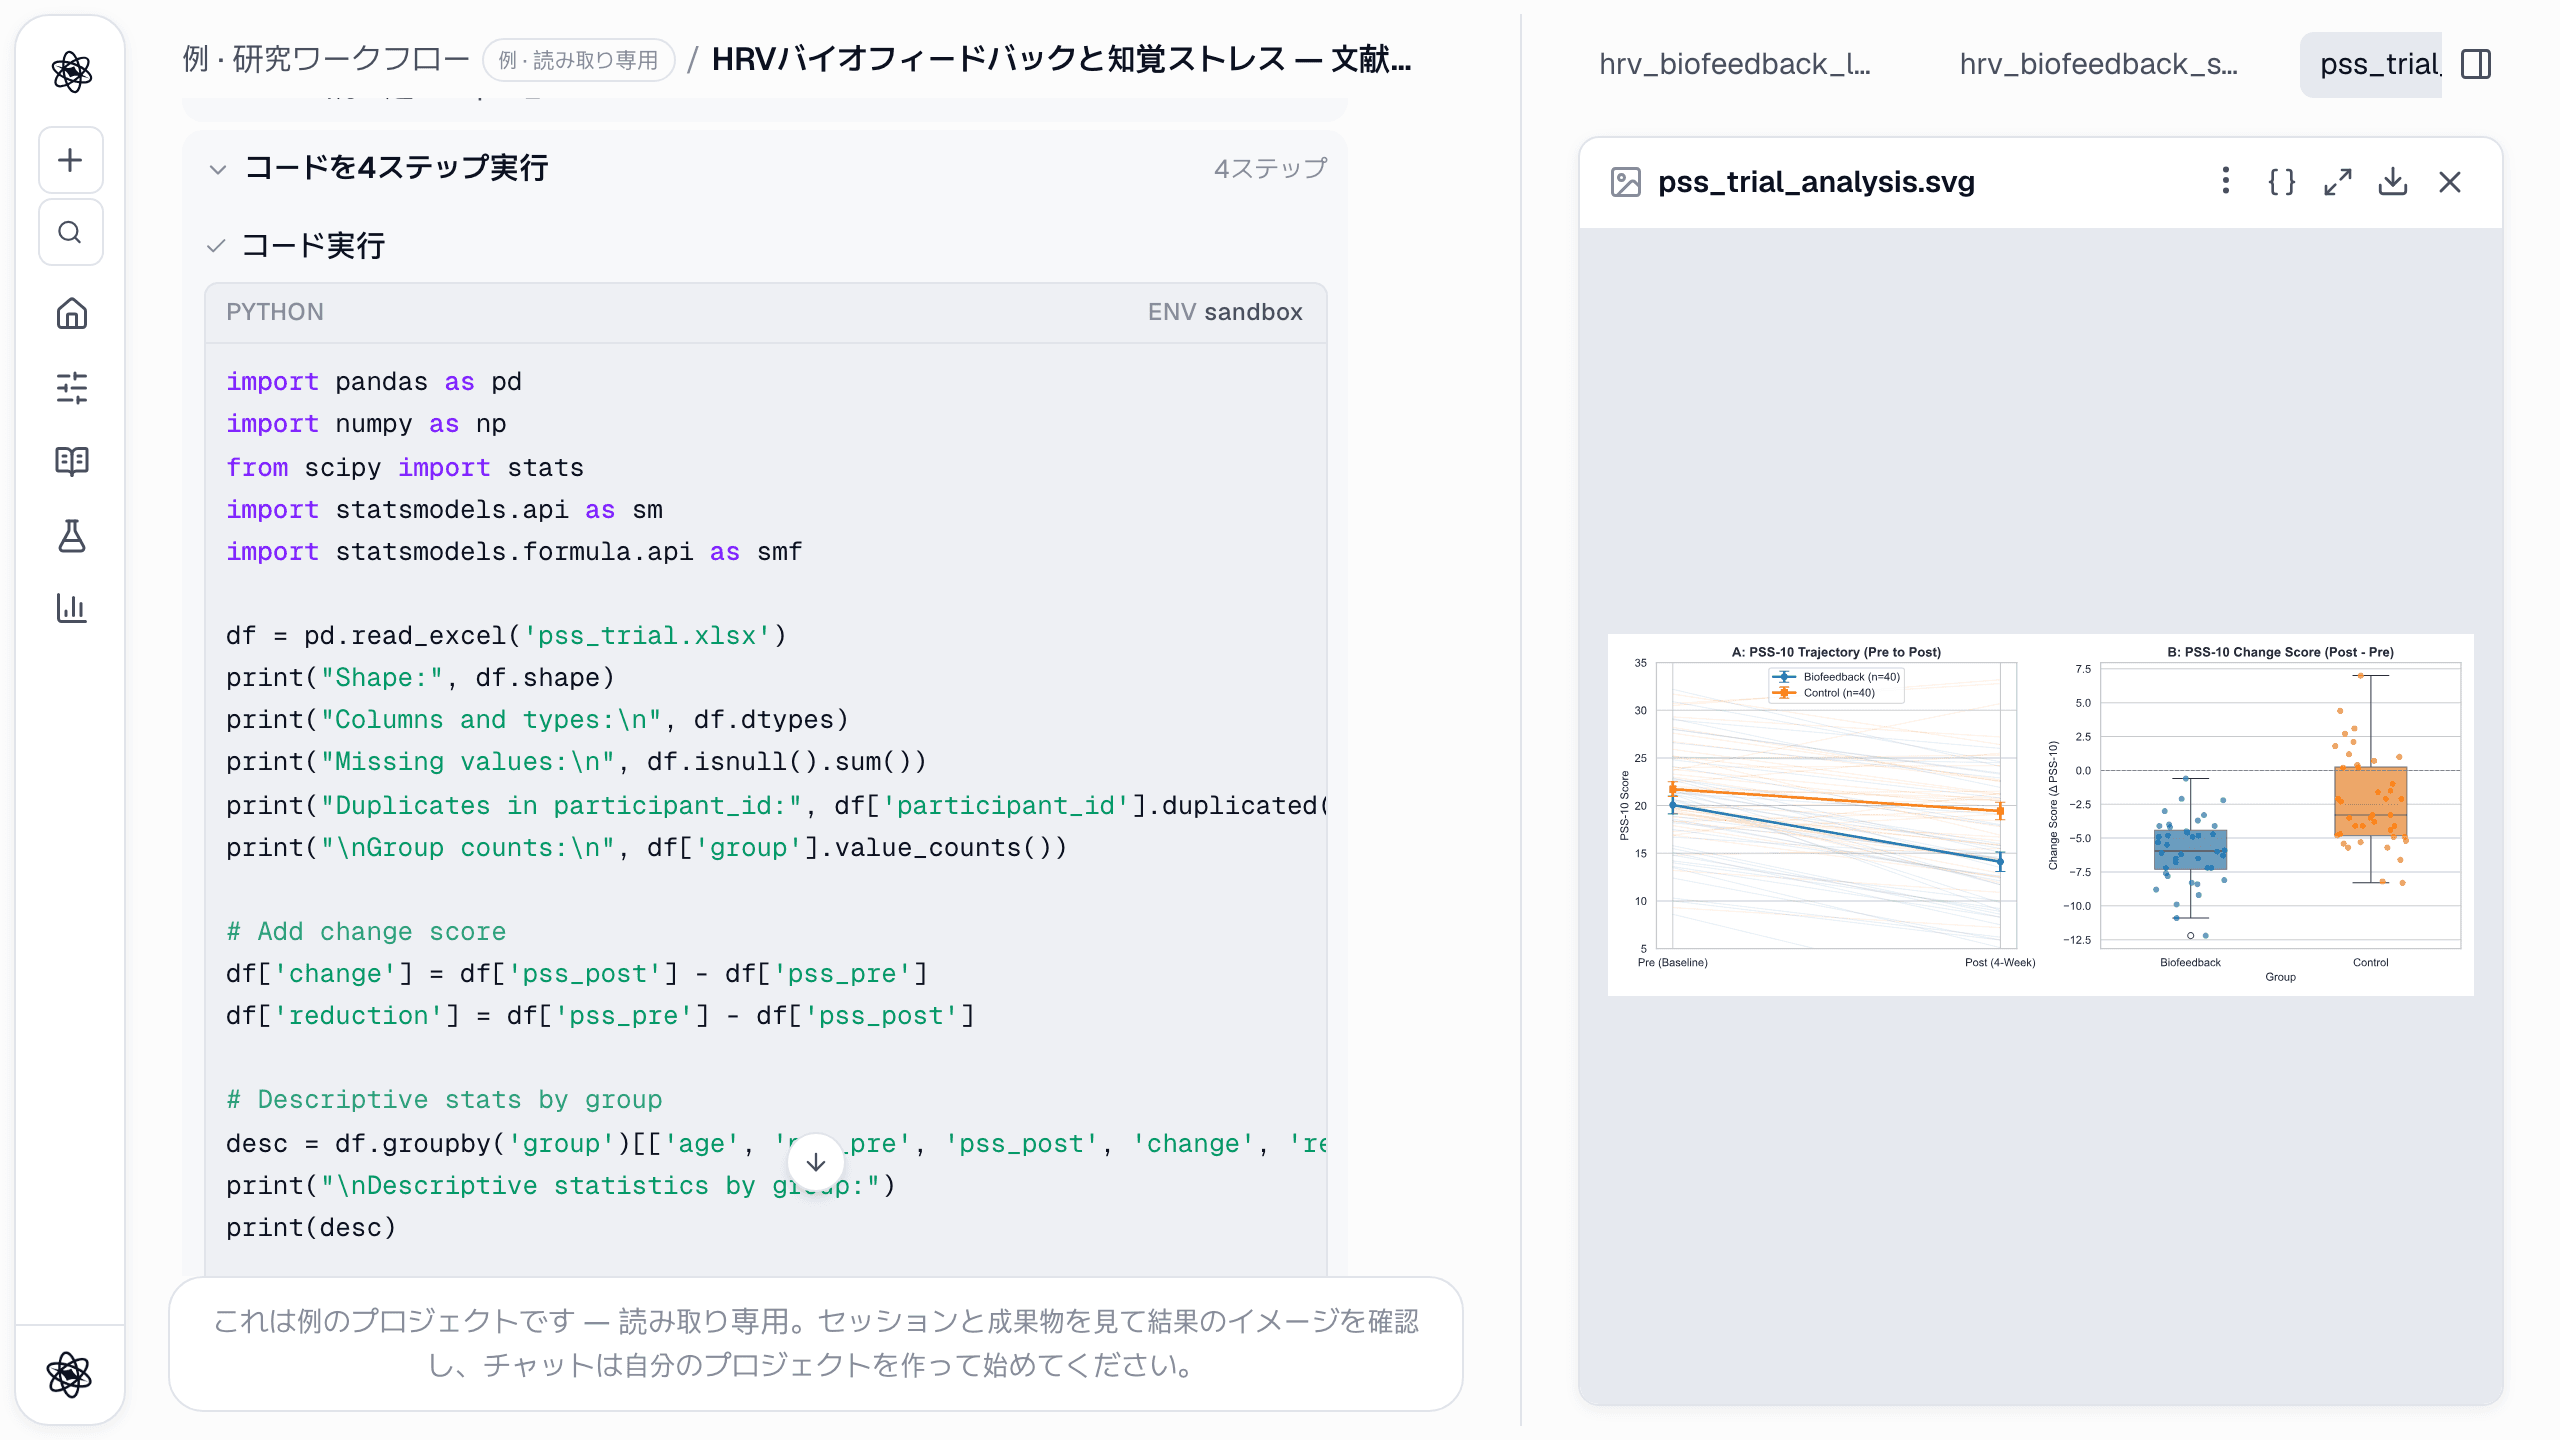
/analyze アップロードした pss_trial.xlsx(2群、PSS-10 の事前/事後)を確認してください。データ品質とベースラインの均衡を点検し、変化量を計算して、図付きの再現可能な分析レポートを作成してください。
分析のターンはサンドボックスでコードを5ステップ走らせました。品質監査(欠損なし、重複IDなし、スコアは範囲内)、年齢とベースライン PSS-10 の均衡検定、正規性と分散の確認、対応ありと独立の検定を添えた変化量、ベースライン調整 ANCOVA、参加者をランダム切片にした混合モデル、そして最後に個人の軌跡・変化量の分布・ANCOVA の当てはめを並べた3パネルの図。これらのコードブロックはすべてチャットにあり、パネルで図の再現性ボタンを押すと、それを作った正確なコード・入力・環境が見えます。
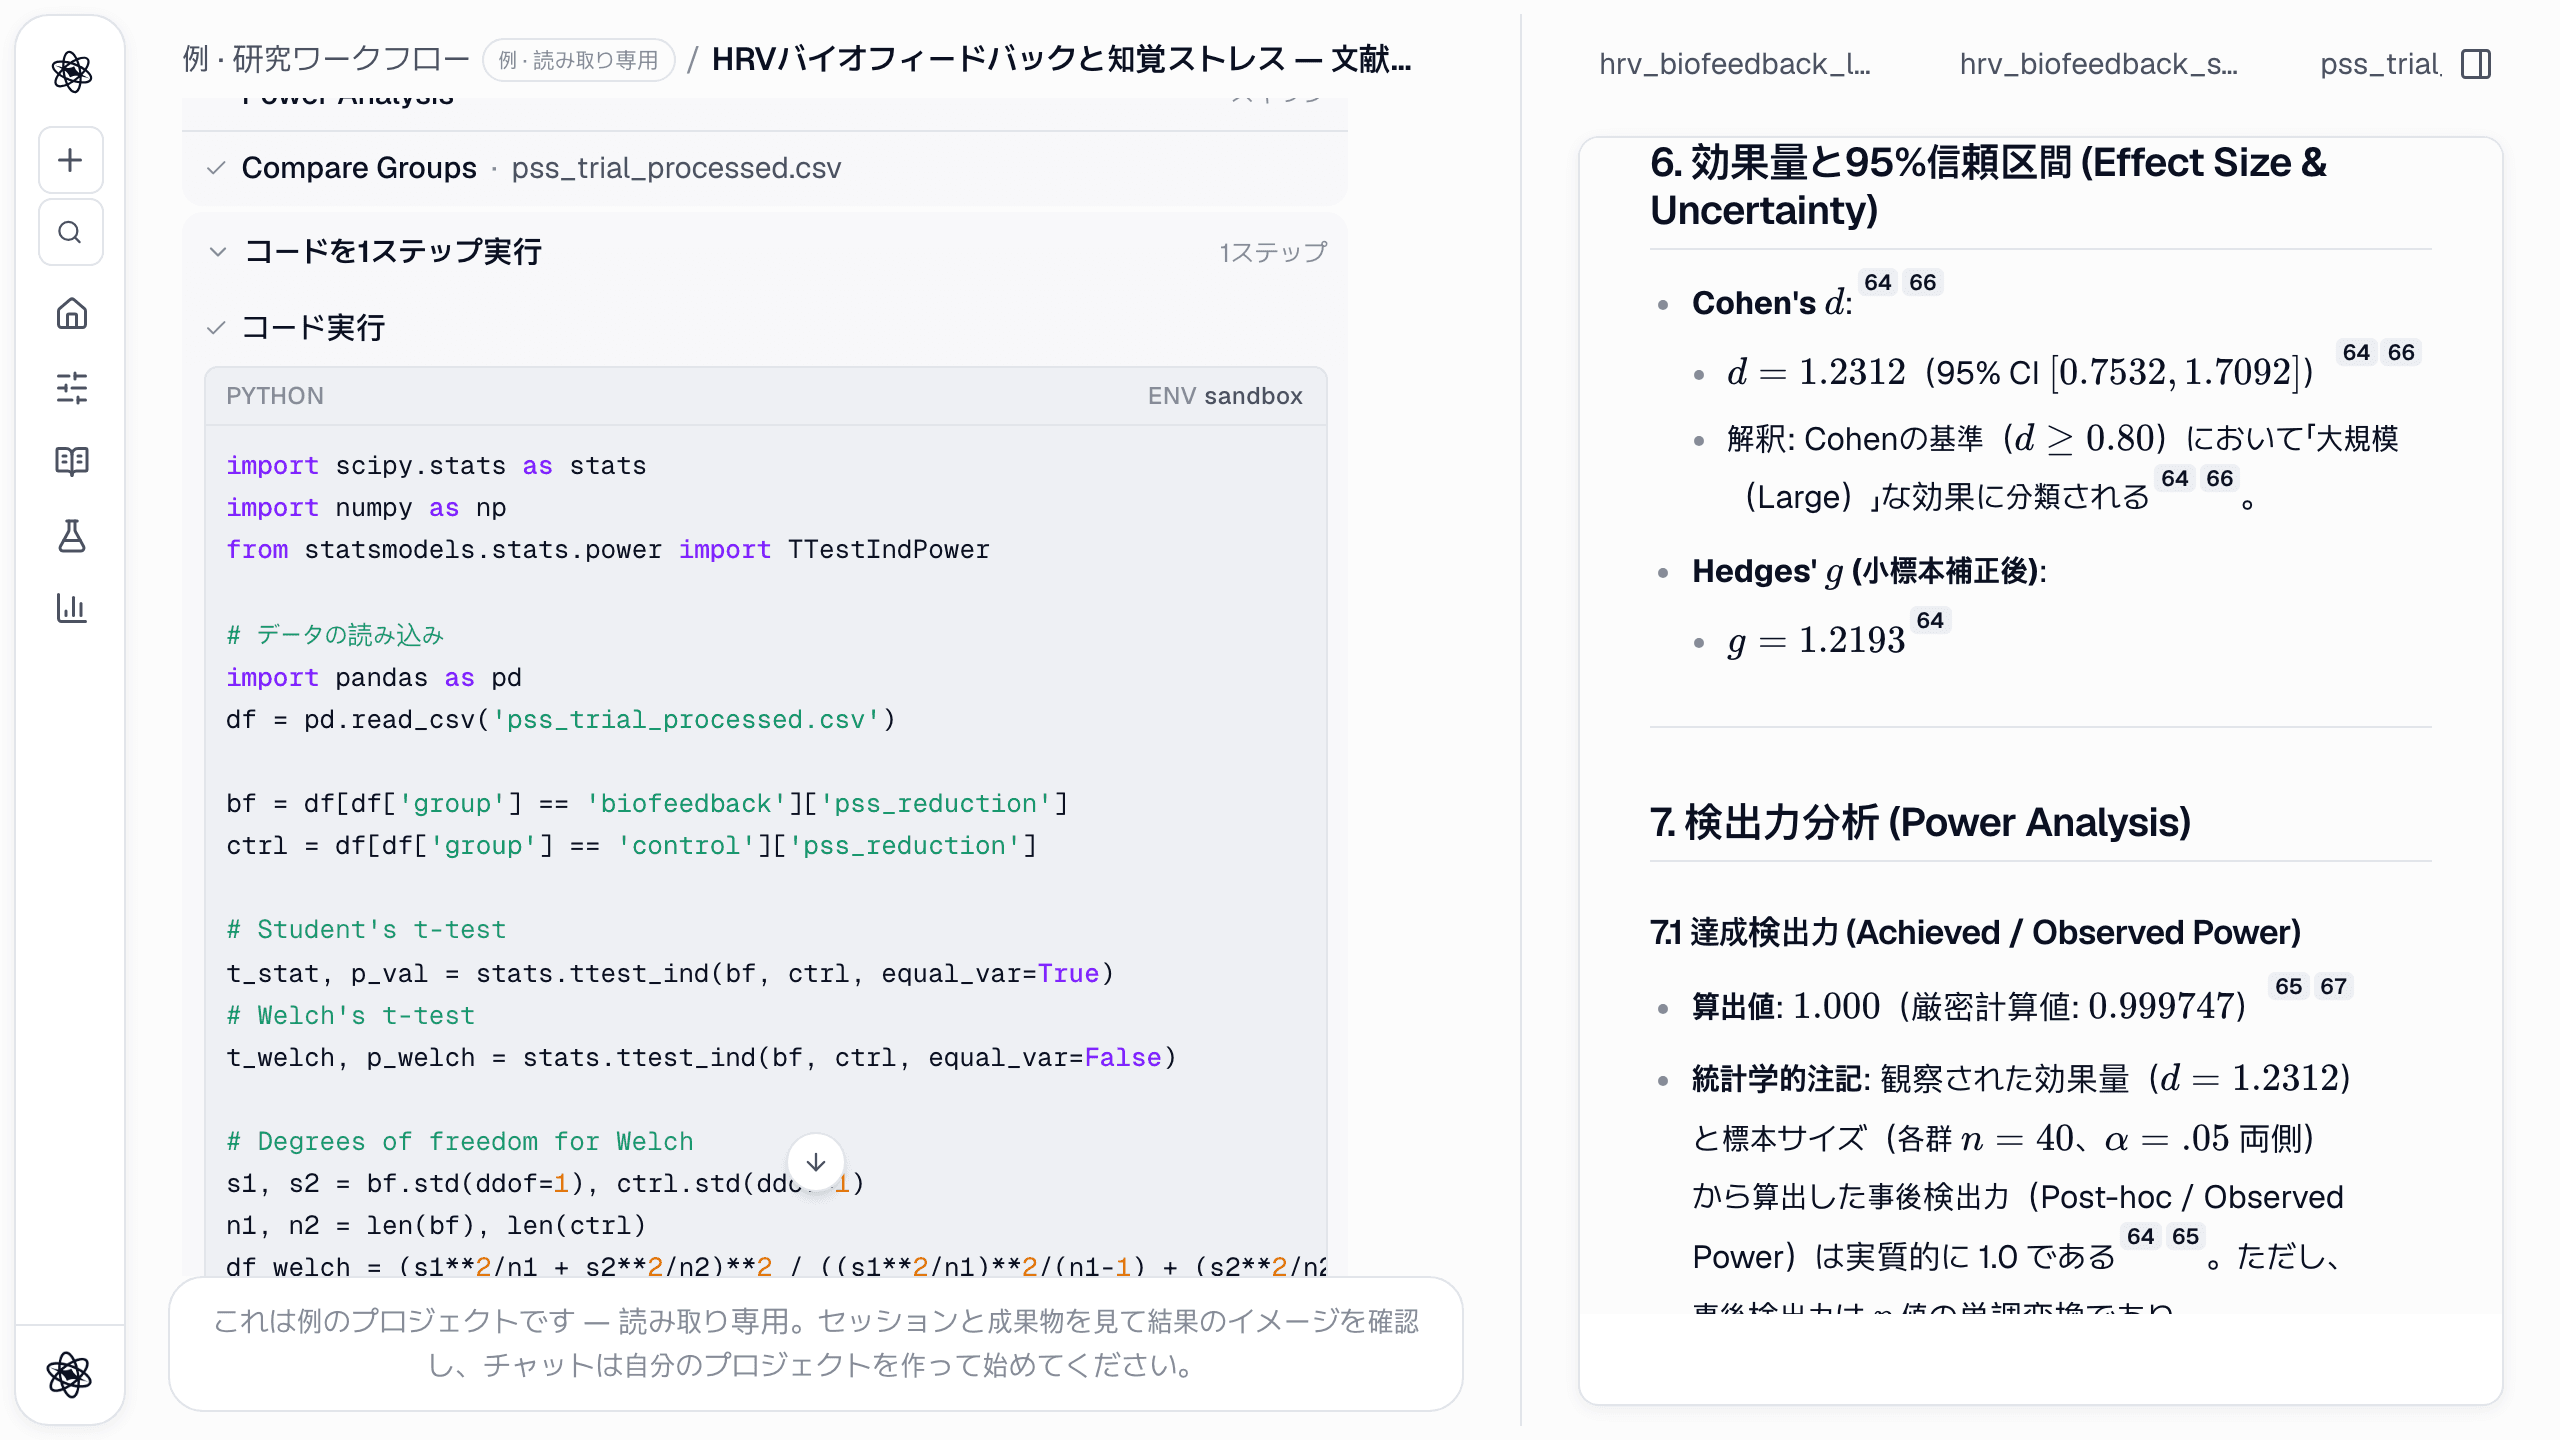
/stats pss_trial.xlsx を使い、バイオフィードバック群の PSS-10 の低下が対照群より大きいかを検定してください。デザインを特定し、前提を確認し、検定を選んで正当化し、効果量を95%信頼区間と達成検出力とともに報告してください。
統計のターンは種類が違います。自由なコードの代わりに統計ツールを連鎖させ、ステップ一覧は決定木のように読めます。データファイルの検証、Recommend Statistical Test、Compare Groups、Estimate Effect Size、Power Analysis。レポートは独立標本 t 検定に至った決定の経路をそのまま引用し(「すべての群で正規性が棄却されない → パラメトリック系; Levene p = .057 → 等分散」)、Welch と Mann–Whitney を感度チェックとして回し、d = 1.23、95%信頼区間 0.75〜1.71 を報告します。「達成検出力」1.000 は小さな p 値の帰結であって独立した事実ではないとはっきり述べ、代わりに感度分析(この N で検出力80%のときに検出できる最小の効果、d = 0.63)を報告します。
詳しい案内: データ分析、統計、レポートが自分のステップを引用する理由: すべての文に根拠を。
ターン5と7 — 図一枚とイラスト一枚
/figure このセッションで設計した実験の研究フロー図を編集可能なベクターで描いてください: 募集 → スクリーニング → ランダム化 → HRVバイオフィードバック(4週間) vs 能動的対照 → 事後テスト(PSS-10) → 3か月フォローアップ。ジャーナルのテンプレートを使ってください。
/illustrate 方法の図として使うHRVバイオフィードバックのセットアップを科学イラストで描いてください: 胸ストラップ型ECGセンサーと指先PPGセンサーを着け、ノートPCの呼吸ペーシング画面に合わせて呼吸する着席した参加者。セミフラットスタイル、白背景。
どちらも1ステップのターンで、どちらも安価です(それぞれ約3万トークン)。研究フロー図は2段組ジャーナルのプリセットでレイアウトされた本物のベクター図です。ワークスペースで編集でボックスを動かしラベルを直せ、SVG・PNG・PDF・PPTX に書き出しても図形は編集可能なままです。イラストもベクターなので、センサーストラップや服の色をパネルで変えられます。
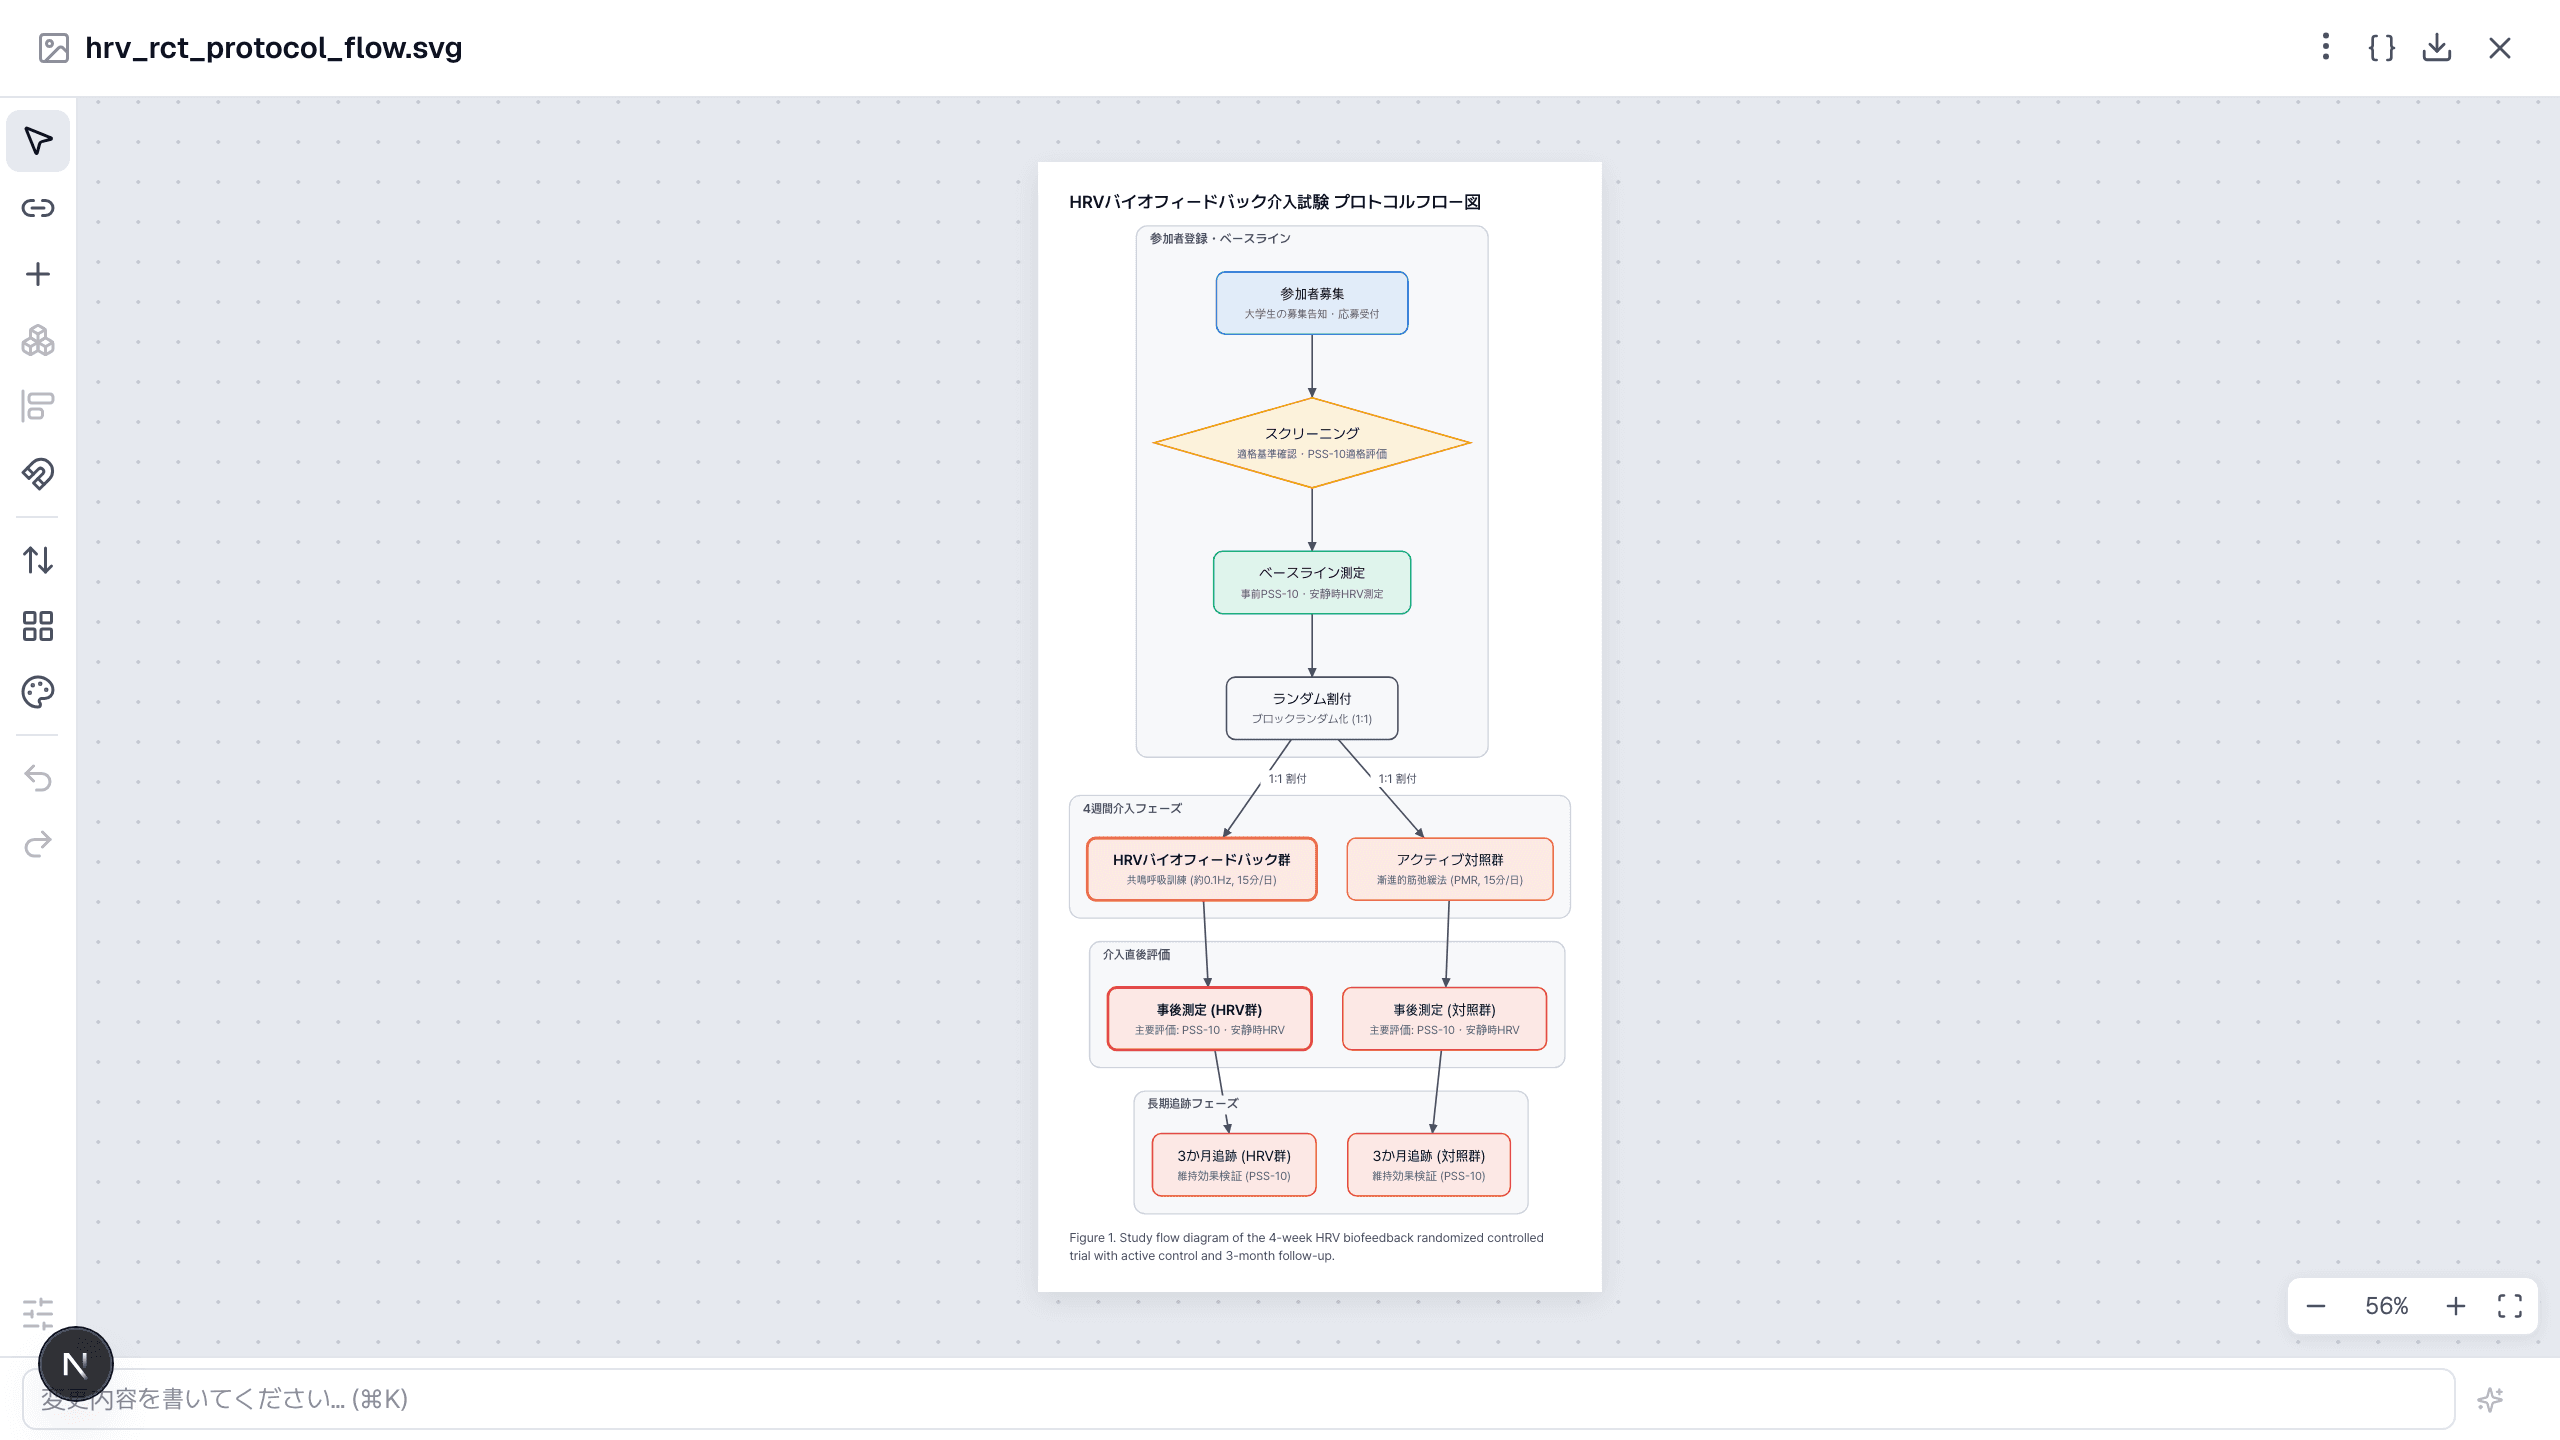
一つ気づいてほしいこと。図のプロンプトは3か月フォローアップを求め、ダイアグラムは忠実にそれを描きましたが、英語のデザインレポートにはベースラインと事後テストしかありません。セッションは成果物を読むときには互いに整合させますが、プロトコルに書かれていないものをあなたが求めることまでは止められません。図はデザインと突き合わせて読んでください。
詳しい案内: 図。
ターン6 — 仮説
/hypothesis このセッションで集めたHRVバイオフィードバックと知覚ストレスの文献をもとに研究空間をマッピングし、ギャップと矛盾する知見を列挙し、新規性・妥当性・検証可能性で順位付けした検証可能な仮説を、根拠と出典とともに生成してください。
このセッションでは仮説は分析の後、6番目に回りました。自分の研究ならレビューの直後に回すことになります。このターンは保存された文献を読み直し、メカニズムについてさらに2回検索し、先行研究の表を作り、矛盾の有無を確認し、候補仮説5つそれぞれに検出力分析を回してから、提案書とフレームワーク図を書きました。
最上位の仮説は覚えておく価値があります。再び現れるからです。同じ 0.1 Hz のオープンループの緩やかなペース呼吸に対して、クローズドループのバイオフィードバックは何かを上乗せするのか、という問いです。このセッションの試験はそれに答えられません。対照群がペース呼吸ではなく心理教育だからです。原稿、レポートレビュー、論文査読のすべてがこの点に気づきます。
詳しい案内: 仮説。
ターン8 — 原稿
/write このセッションの文献・設計・分析をもとに、原稿の方法と結果のセクションを書いてください。すべての主張は引用またはセッションの結果に結び付けてください。
セッションが報われるターンです。このプロジェクトの他のチャットで確定した決定を11件適用しました で始まりました。ステップ一覧を見ると、レビューレポートと統計レポートを名前で読み込み、一文字書く前に検証を6ステップ経て、その後執筆・文書の改訂・原稿の確認を何度も繰り返しています。
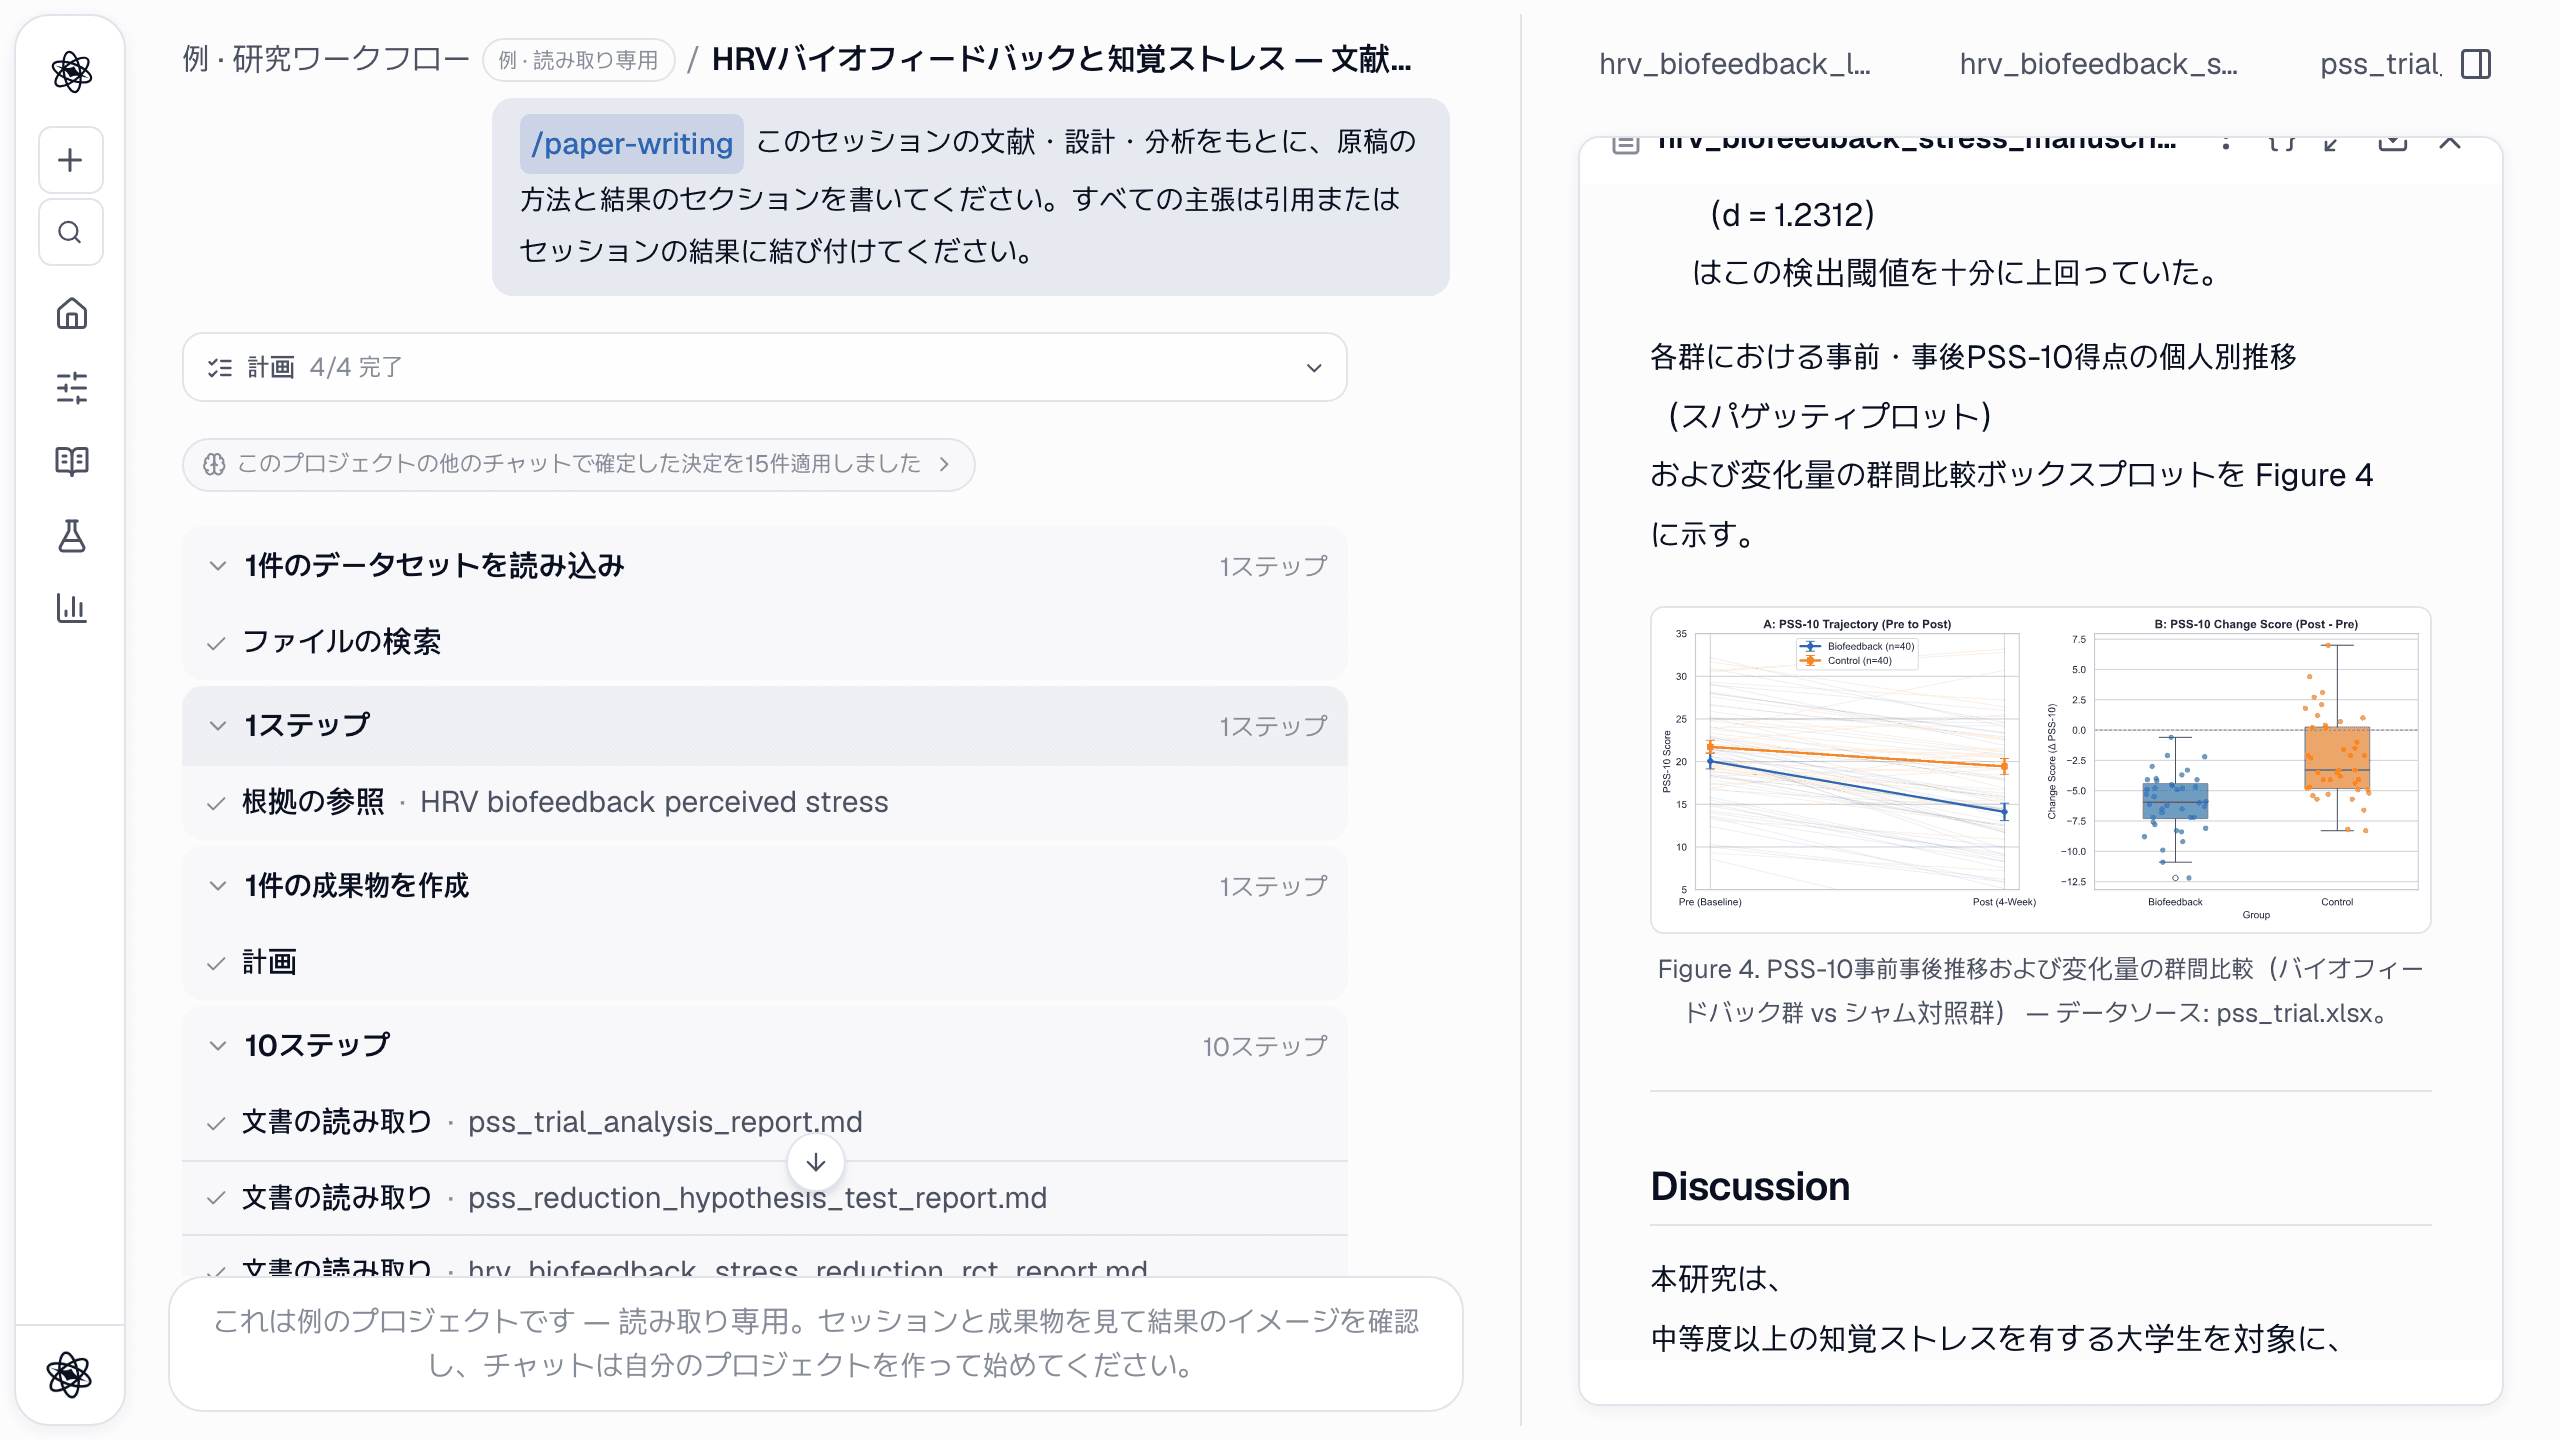
結果は、数値が統計レポートから来て、引用がスクリーニング済み文献から来る方法と結果のセクションです。チャットの記録にある3つのことが、結び付けがどう働くかを示しています。
- 「参考文献リストをこのセッションの保存された出典(6件)から再構築し、本文で引用されたすべての [n] と一致させました。」 参考文献は生成されるのではなく、照会されます。
- 「原稿が標準の図なしで保存されたため、図1(概要)と図2(プロトコル)を作る短い追加パスを行います。」 原稿の確認が図の欠落に気づき、最初の言及の後に配置する追加パスを回しました。
- 原稿の末尾には主張–根拠マップと、データが裏付けられない主張の一覧があります。持続的な迷走神経の再編、オープンループのペース呼吸に対する優位性、3か月の維持は、すべて断言ではなく未検証として分類されています。
書き出しはパネルのダウンロードボタンから DOCX、LaTeX、PDF、Markdown で。詳しい案内: 論文執筆。
ターン9 — レポートレビュー
/report-review このセッションで書いた原稿を独立してレビューしてください — 主張、方法、統計、引用された根拠、再現性 — そして優先順位付きのレビューレポートを書いてください。
レポートレビューは、セッションが自分の仕事を他人のように読むことです。ステップ一覧が「独立して」の実際の意味を示します。このターンは過去チャットから原稿とそれを作った呼び出しを検索し、データファイルを再び読み込み、ベースライン検定、対応あり検定、群間比較、効果量、ANCOVA をゼロから回し直しました。再分析は原稿と一致し(t(78) = 5.51、d = 1.23、ANCOVA F(1,77) = 29.22)、レポートはそう書いています。
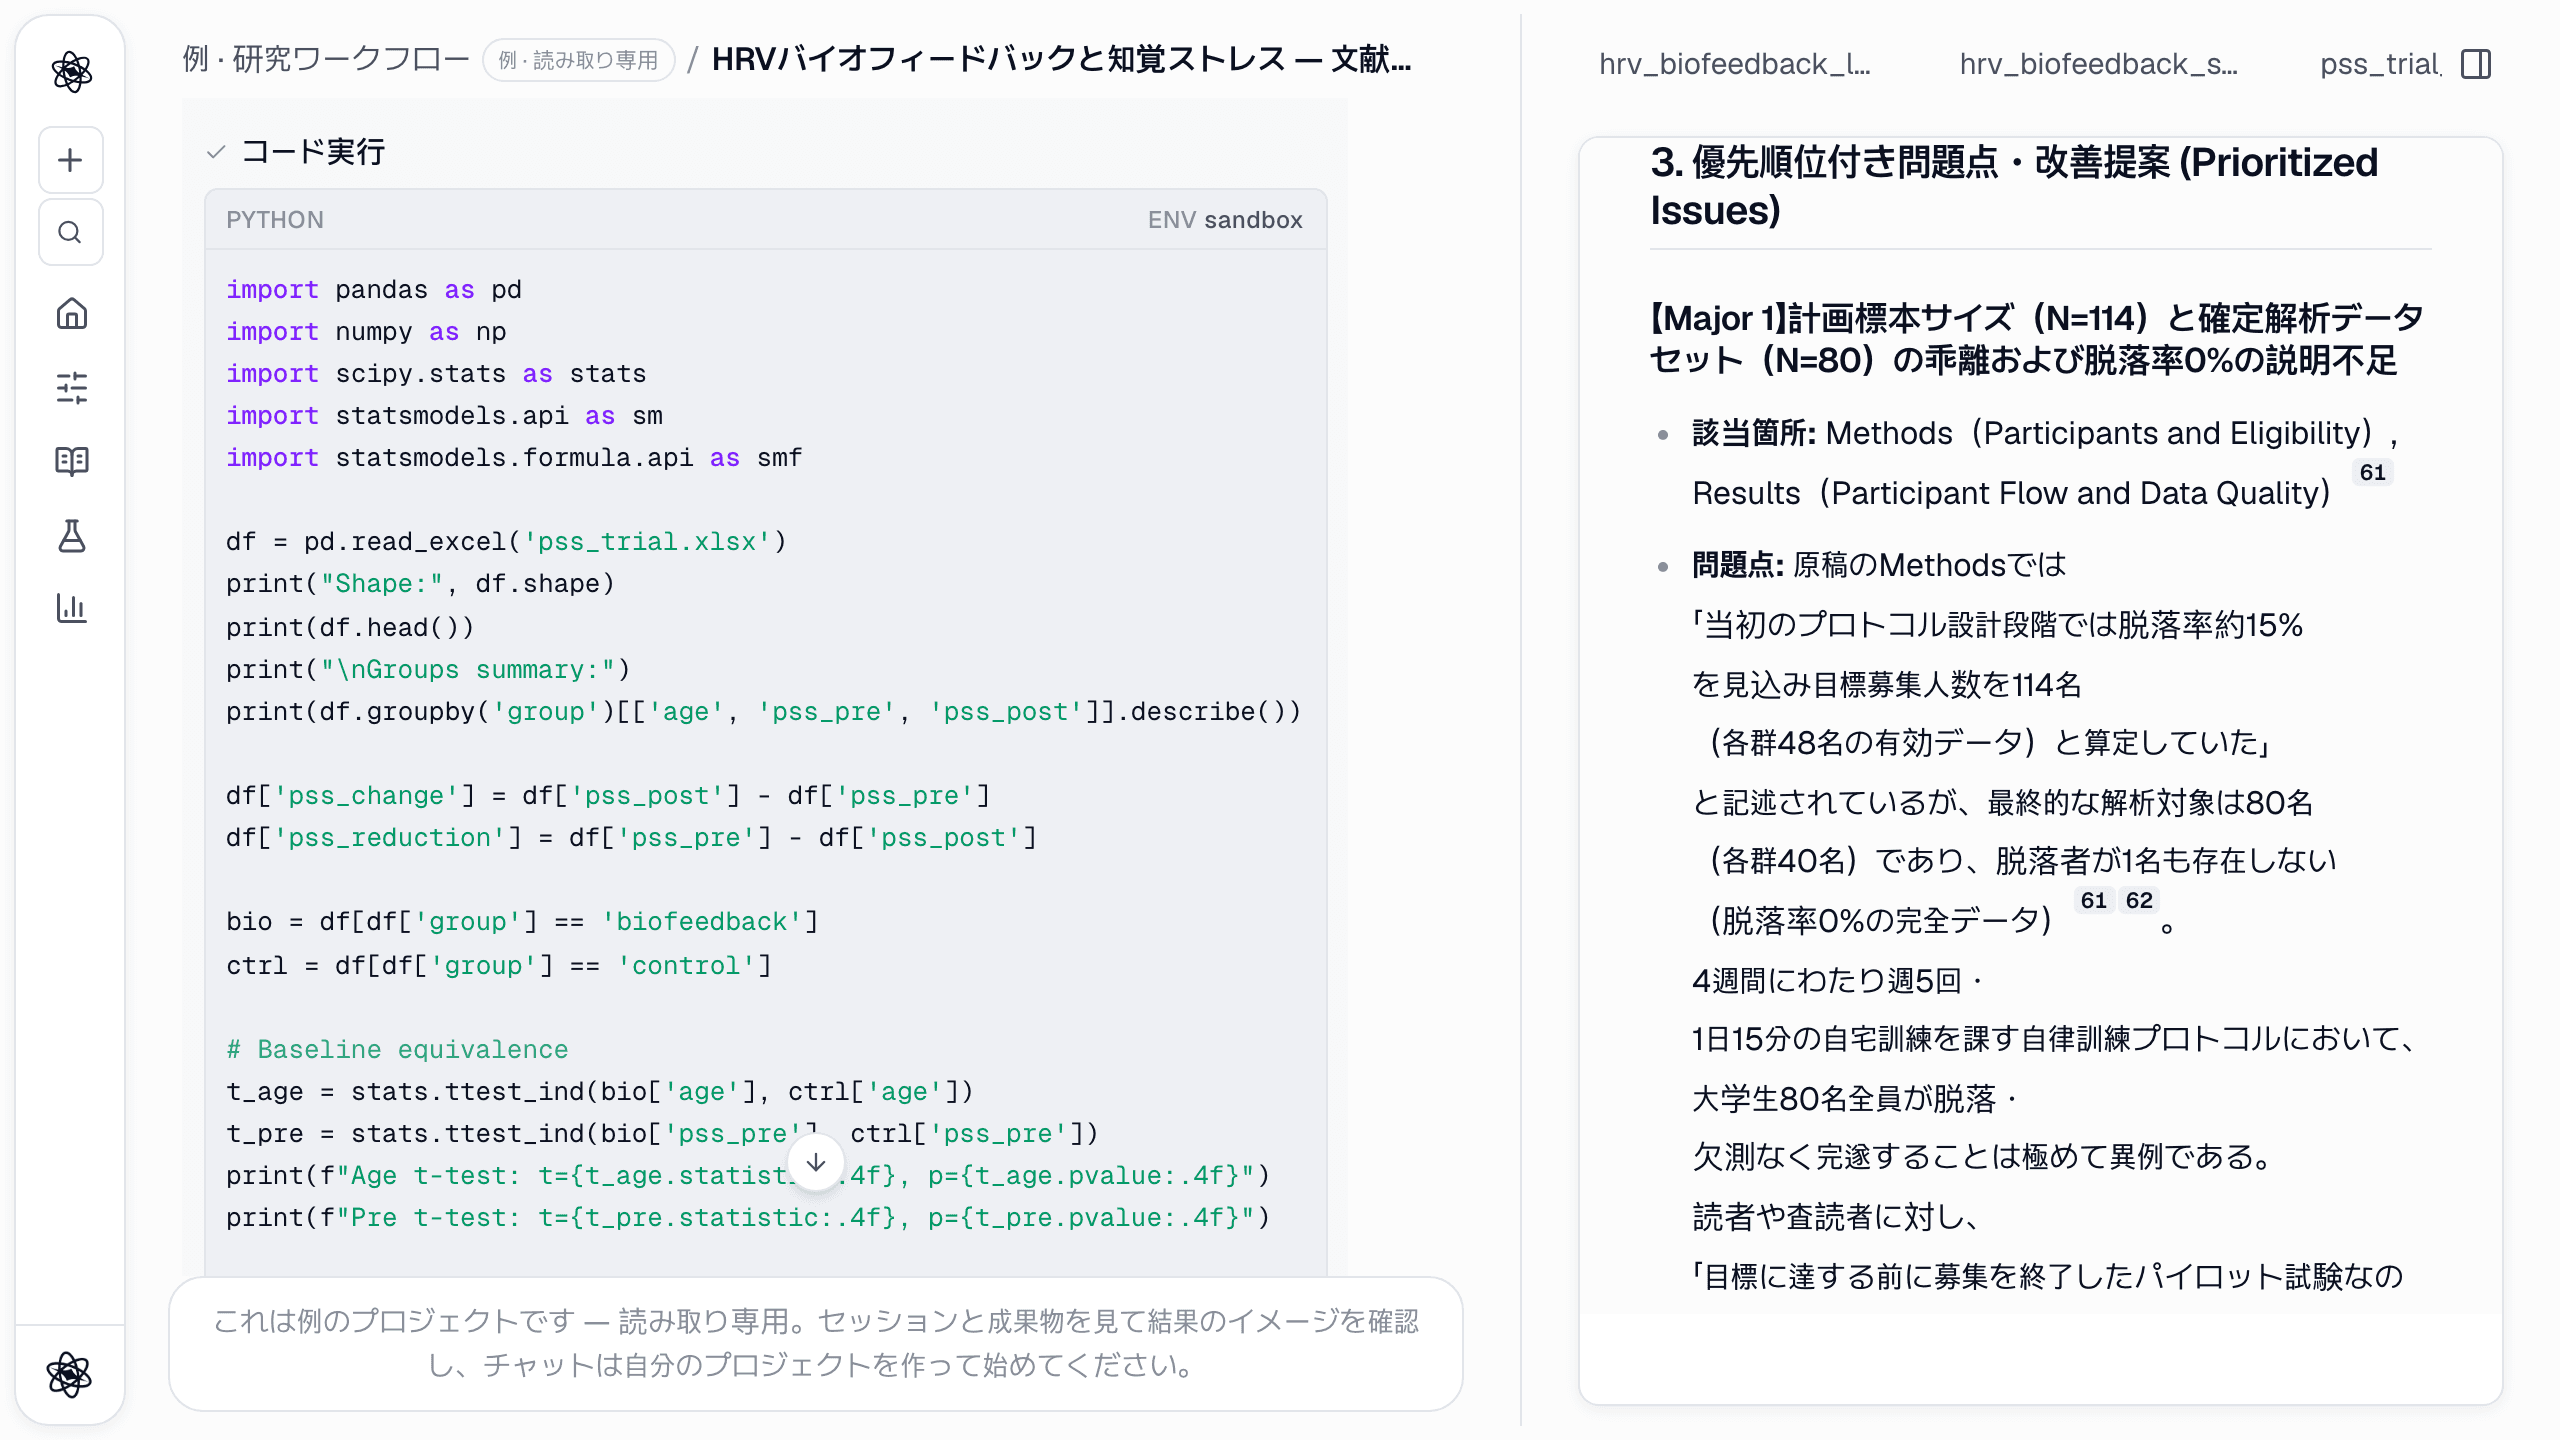
その上で、直すべきことを2つ見つけました。保存された原稿が方法セクションの文の途中で切れていたこと(成果物の実際の欠陥で、そうでなければ投稿時に著者が気づいたはずです)、そして考察で緩やかなペース呼吸の効果とフィードバックの効果を切り分ける必要があること。仮説のターンが指摘したまさにそのギャップです。このターンはステップの上限に達し、そう言いました。「このタスクのステップ上限に達しました。上に保存された結果は利用できますが、残りの計画ステップは実行されていません。」 この正直さも設計の一部です。早く止まったレビューは、早く止まったと教えてくれます。
詳しい案内: レポートレビュー。
ターン10 — 論文査読
/peer-review このセッションで書いた原稿を Applied Psychophysiology and Biofeedback の基準で査読してください:ジャーナルプロファイルと投稿規定、類似論文、査読者5名のスコア、編集判定、修正ガイド、推奨ジャーナルまで。
論文査読は読者ではなくジャーナルをシミュレートします。このターンは投稿先ジャーナルのプロファイルを作って投稿規定を抽出し、そのジャーナルが掲載した類似論文を8本見つけ、異なる役割(ジャーナル適合、方法論、分野の専門性、広い視点、悪魔の代弁者)を持つ査読者5名を招集し、編集者に意見の相違を裁定させました。
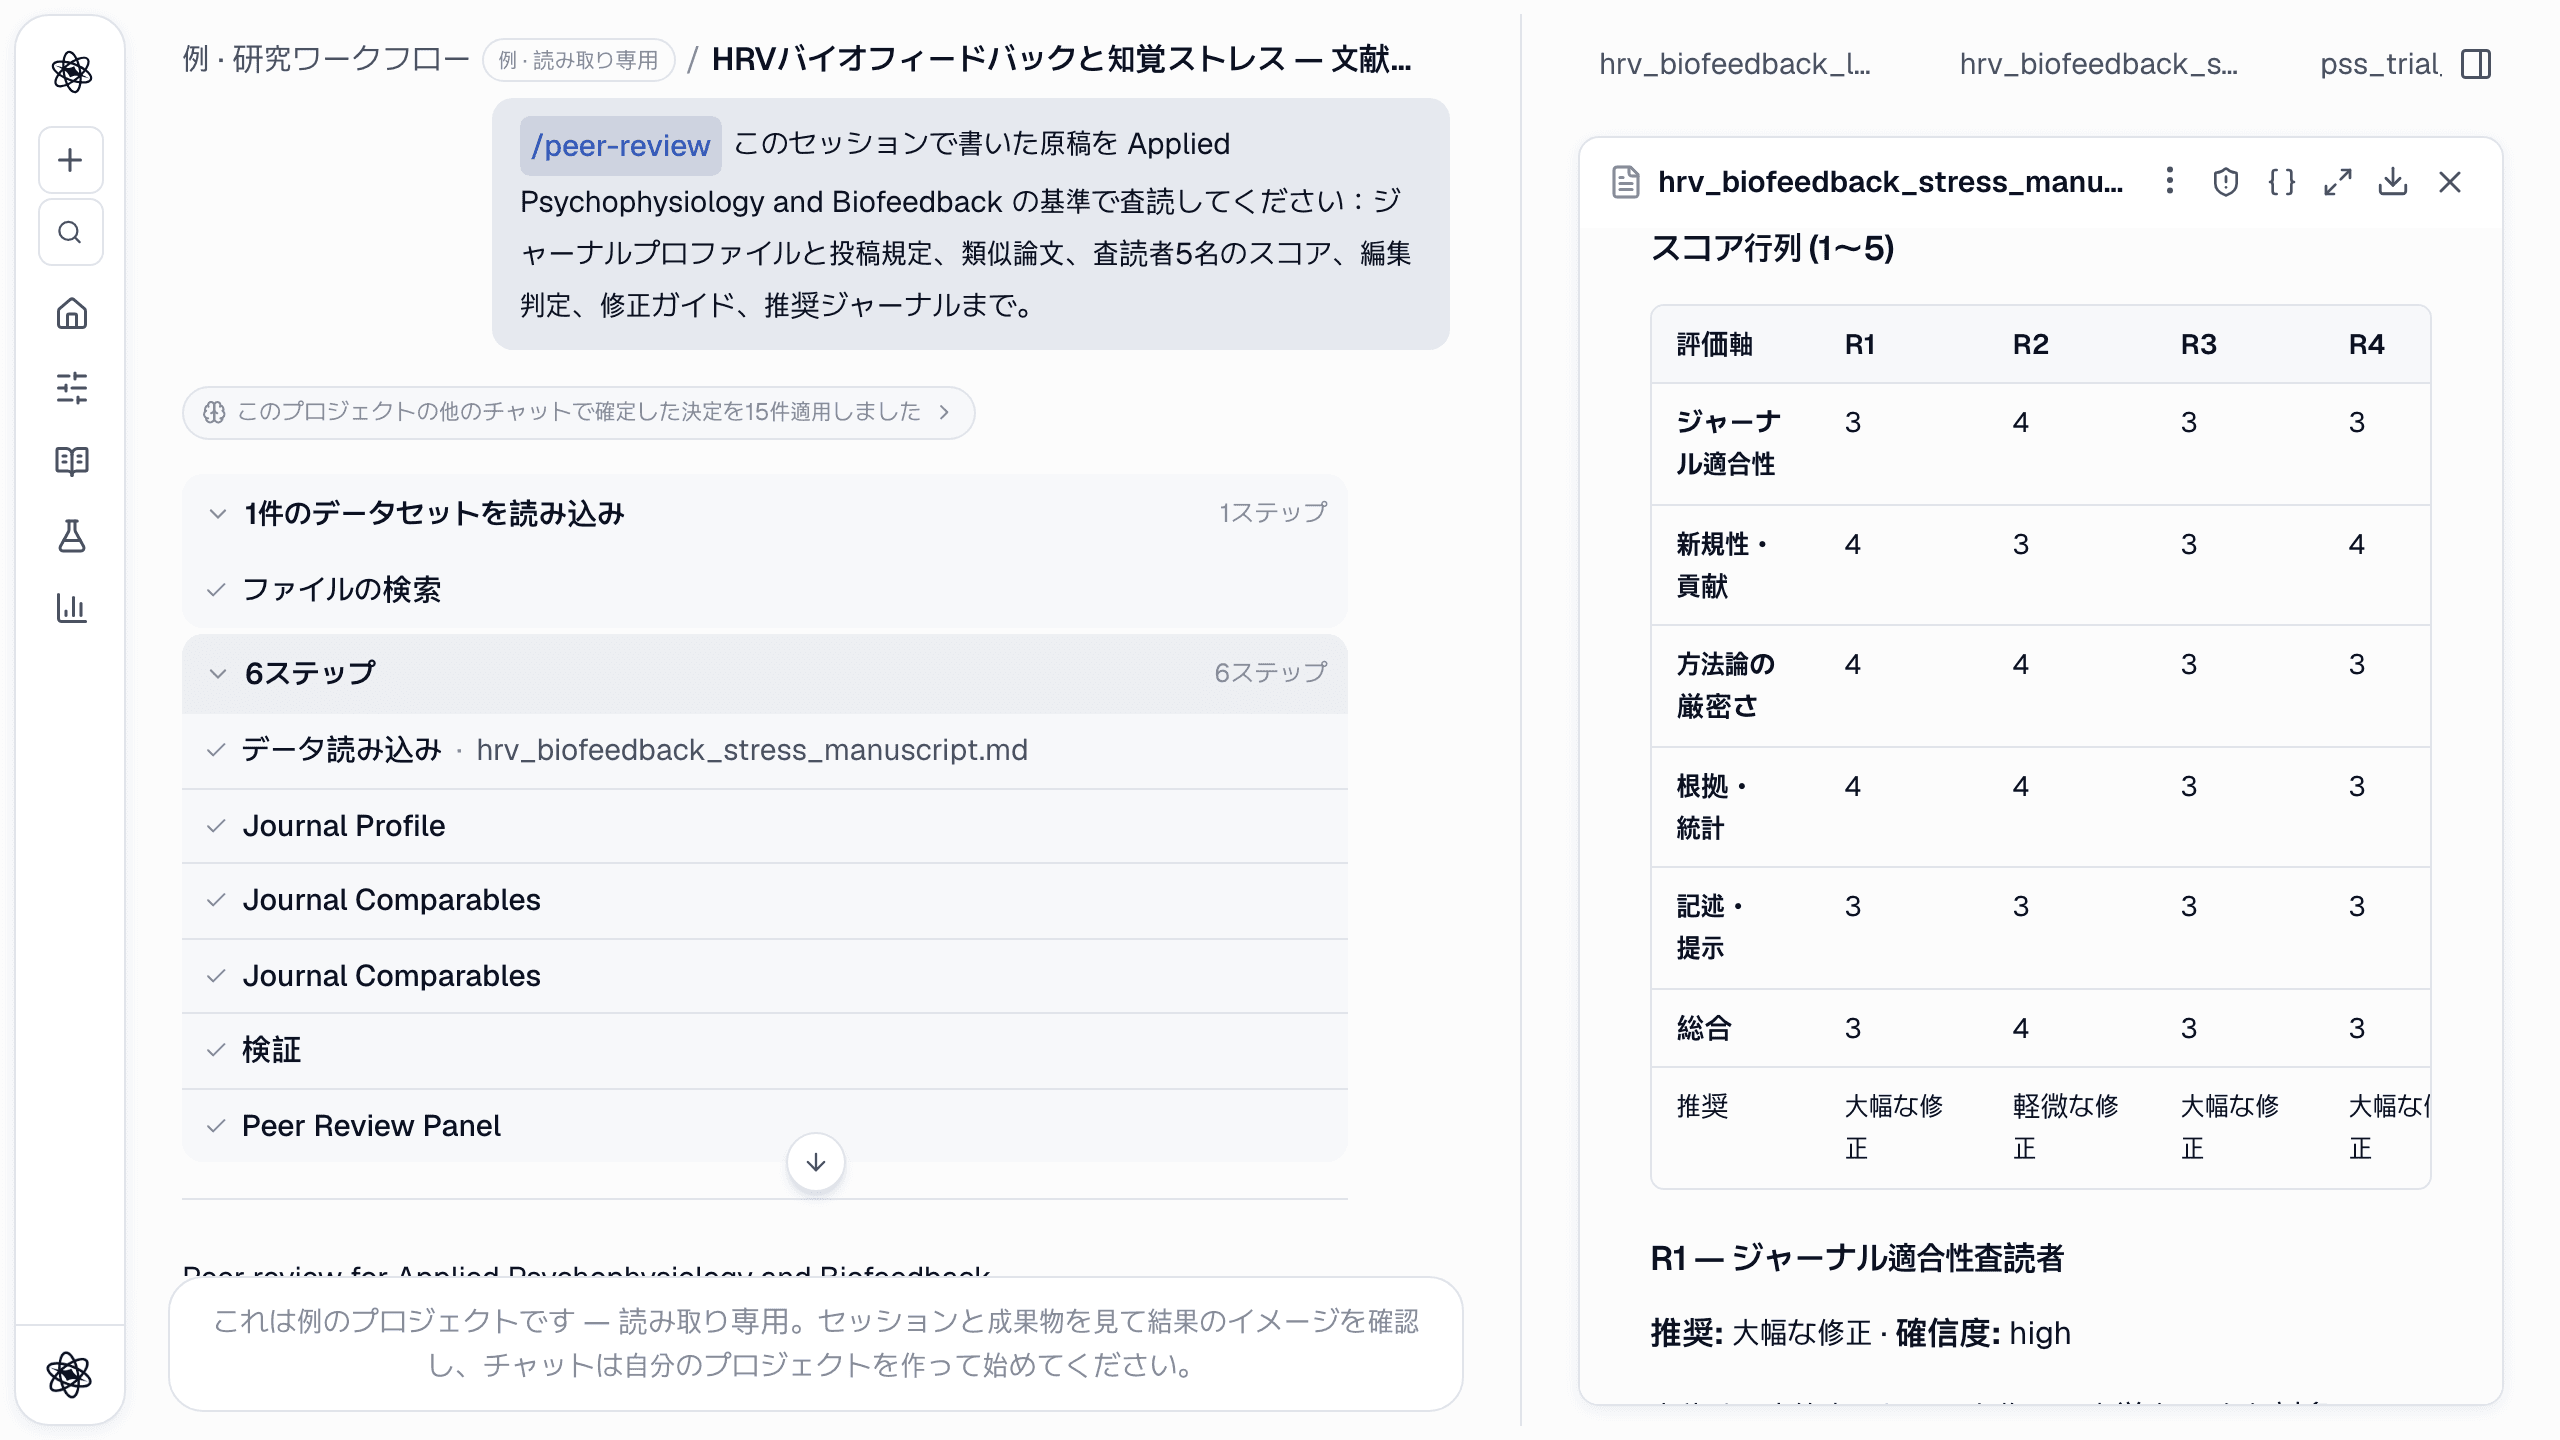
英語の原稿の判定は Major Revision で、理由は具体的です。抄録が250語の上限に対して265語でした。ジャーナルは APA 第7版を求めるのに引用が番号式でした。宣言ページがありませんでした。分野の査読者は、毎分6回に固定した呼吸プロトコルは個別化した共鳴周波数訓練ではなくフィードバック付きのペース呼吸であること、そしてアプリが脈拍データを記録していたのに原稿が一切報告していないことを指摘しました。レポートは、P0〜P2 の順序と工数見積もり付きの修正ガイド、合否が付いた投稿規定チェックリスト、決定論的チェック(参考文献6件すべて確認済み、統計10件が整合)、代替ジャーナル4誌で終わります。他の言語のセッションはそれぞれの判定に至りましたが、別の原稿を読む5名の査読者から期待されることです。
詳しい案内: 論文査読、査読者のスコアを較正した方法: 論文査読の較正。
ターン11 — ラボミーティングのスライド
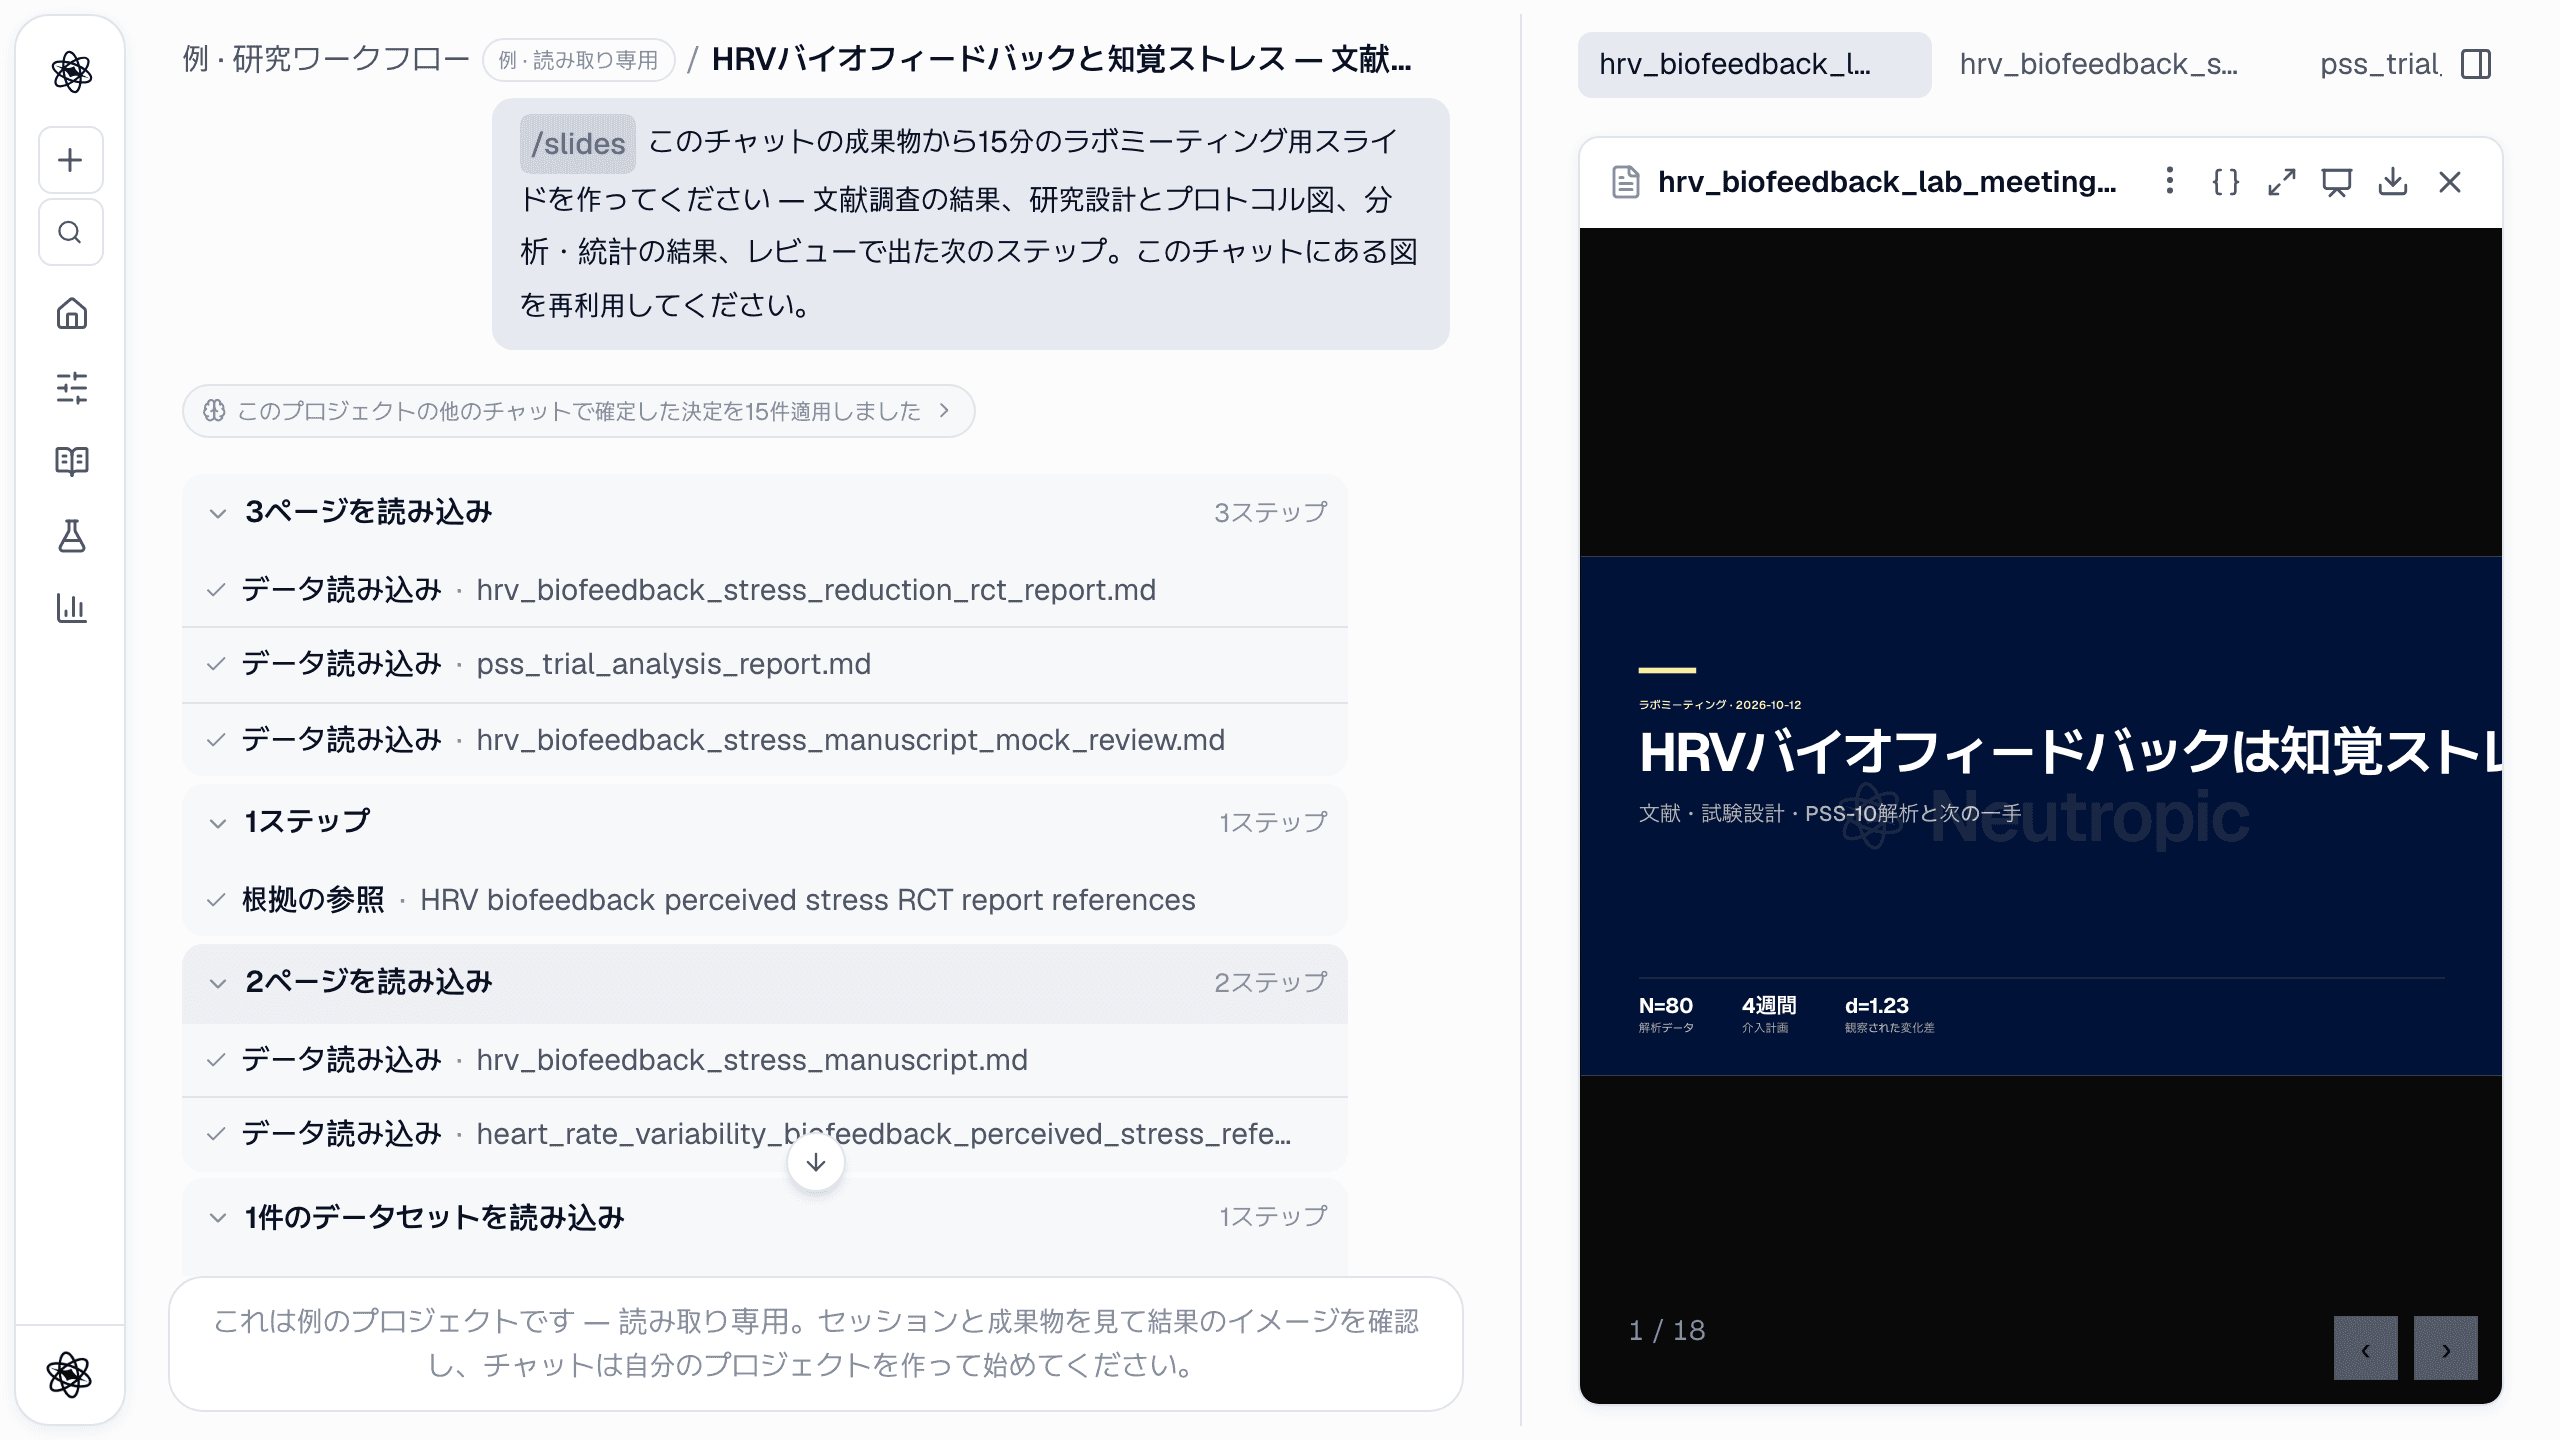
/slides このチャットの成果物から15分のラボミーティング用スライドを作ってください — 文献調査の結果、研究設計とプロトコル図、分析・統計の結果、レビューで出た次のステップ。このチャットにある図を再利用してください。
最後のターンは、セッションが何を抱えているかを最もはっきり示します。このプロジェクトの他のチャットで確定した決定を14件適用しました で始まり、デザインレポート、分析と統計のレポート、仮説、レビューと査読のレポートを読み、プロトコルフローと結果の図を再利用する17枚のスライドを作りました。自身の要約が肝心の線を引いています。スライドは「計画されたデザインの詳細と分析済みデータセットを区別し、生理的変化や3か月の結果を知見として提示しない」。どの成果物をなぜ省いたかも述べました。パネルの発表を押すと全画面で進められ、PPTX・PDF・HTML でダウンロードできます。
詳しい案内: スライド。
何がつなぎ止めたか
11ターンを振り返ると、普通は人がツールの間で担っていた仕事を、4つの仕組みが肩代わりしました。
- 成果物が記憶です。 各ターンは必要な前のファイルを名前で読み、ステップ一覧がどれを読んだかを示します。原稿は統計を覚えていたのではなく、統計レポートを読み込みました。
- 確定した決定が積み上がります。 このプロジェクトの他のチャットで確定した決定をN件適用しました のチップは、プロジェクトが何が固定されたかを学ぶにつれて 3 から 6、7、11、14 へ増えました。アウトカム、条件、サンプル、検定、ジャーナル。チャットで決定を言葉にすることが、後のターンにそれを守らせる最も確実な方法です。
- 出典は記憶ではなく保存です。 文献ターンの出典はセッションに残り、原稿の参考文献と論文査読の比較対象が実在の論文を指します。セッションは保存出典61件、うち原稿で引用9件で終わりました。
- チェックもターンです。 原稿の確認、レポートレビューの再分析、論文査読の規定チェックリストは、すべて同じチャットで同じファイルを読んでいます。この研究の唯一の科学的ギャップ、フィードバック対ペース呼吸は、仮説のターンで浮かび上がり、原稿で開示され、2つのレビューで再び提起されました。
実務的なメモを2つ。この長さのセッションはモデルにとって問題ありません。文脈は自動で管理され、手で削りたければ /compact が会話を要約します。トークンは、全体の実行で管理トークンおよそ210万を使い、大半は執筆・レビュー・スライドのターンでした。Free プランの1日上限を考えると、このようなワークフローは数日に分けることになります。有料プランは上限を上げ、プレミアムモデルを加えます。プランとトークンとトークンガイドをご覧ください。
あなたの出番
Neutropic は下書きを書き、チェックします。研究はなおあなたのものです。セッションが止まって判断を待った場所こそ、時間をかける場所です。
- 仮説を選び、デザインで実際に検証できるものにする。
- 実データをアップロードし、N を登録記録と照合する。
- 論証が依拠する3〜4本の論文を自分で読む。
- 他の人が下書きを読む前に、レポートレビューが見つけたことを直す。
- 論文査読の修正ガイドは判決ではなく、やることリストとして使う。
セッションが終わったら、書き出す代わりに共有してください。読み取り専用リンクを開けば、指導教員や共著者に成果物ごと同じ画面が見えます。
マイライブラリから例 · 研究ワークフローを開き、ステップ一覧を展開して、一つの数値(たとえば d = 1.23)を統計のターンから原稿、レビュー、スライドまで追ってみてください。