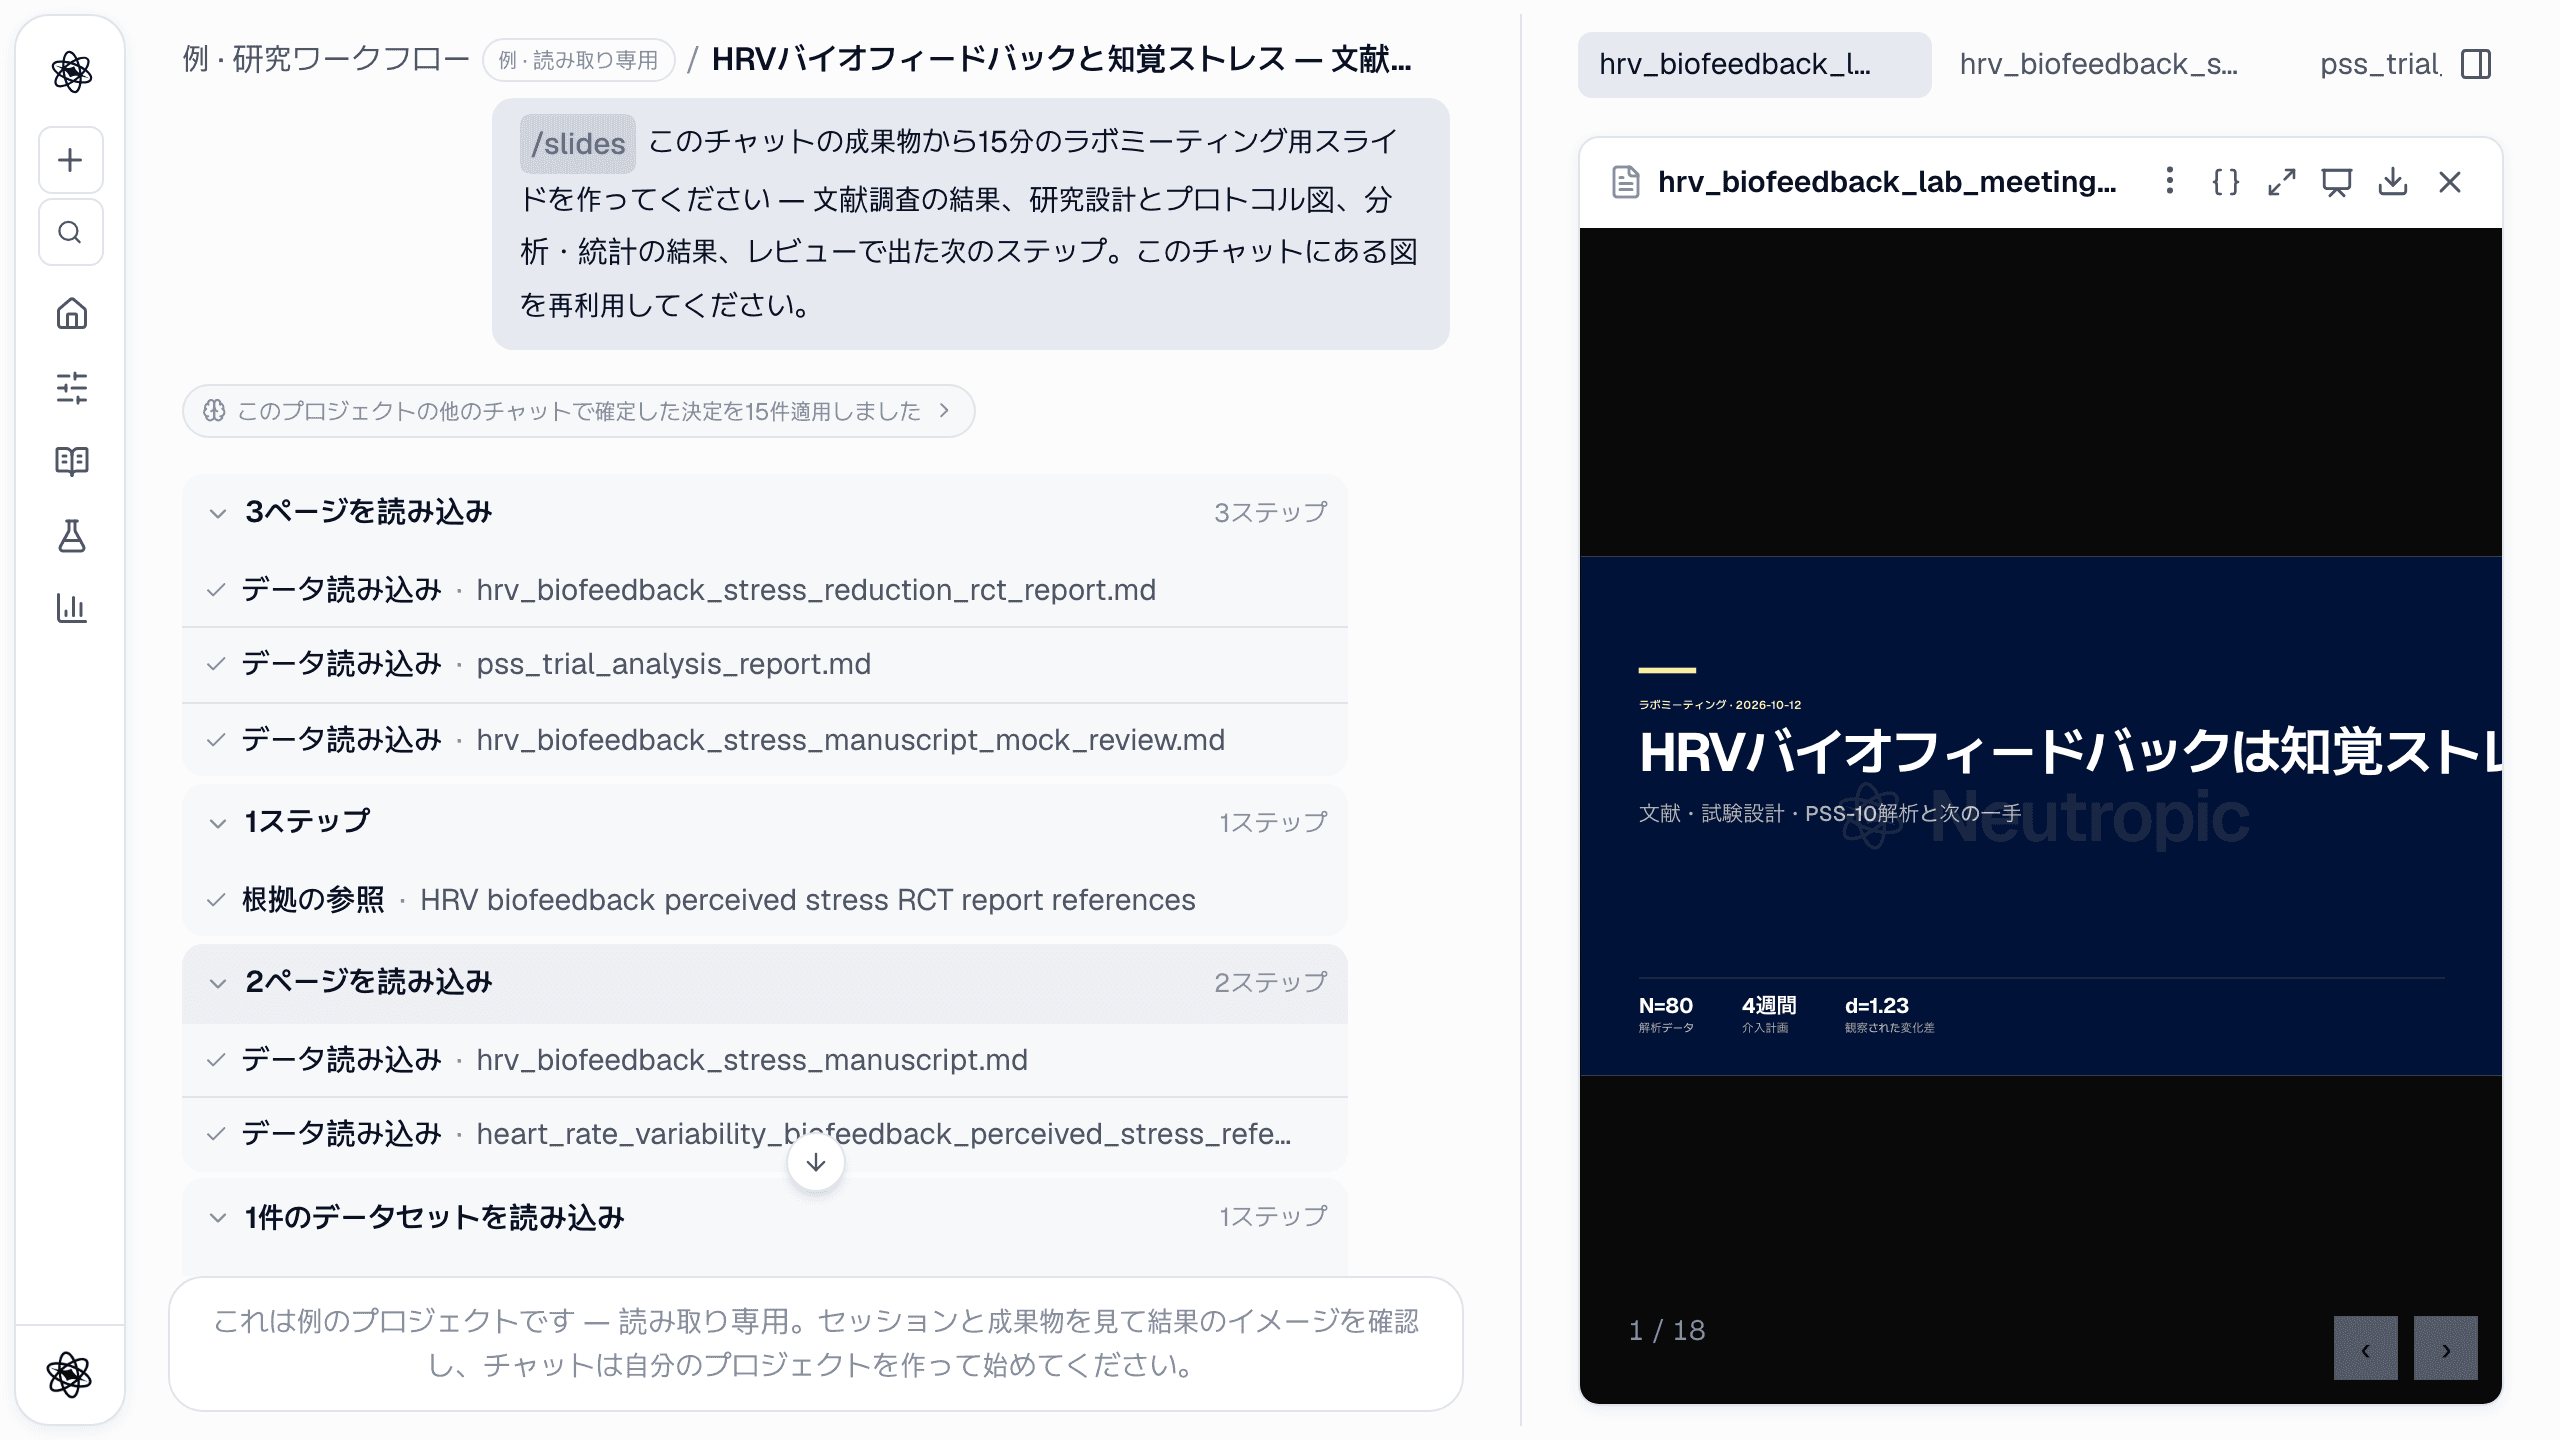
統計ソフトは、それが正しい問いであろうとなかろうと、頼まれたほぼ何でも実行します。Neutropic の仕事は違います:あなたのデザインとデータに正しいモデルを実行し、それが正しかったと証明する——二度。試験データがすでに読み込まれた同じセッションのこのステップです。
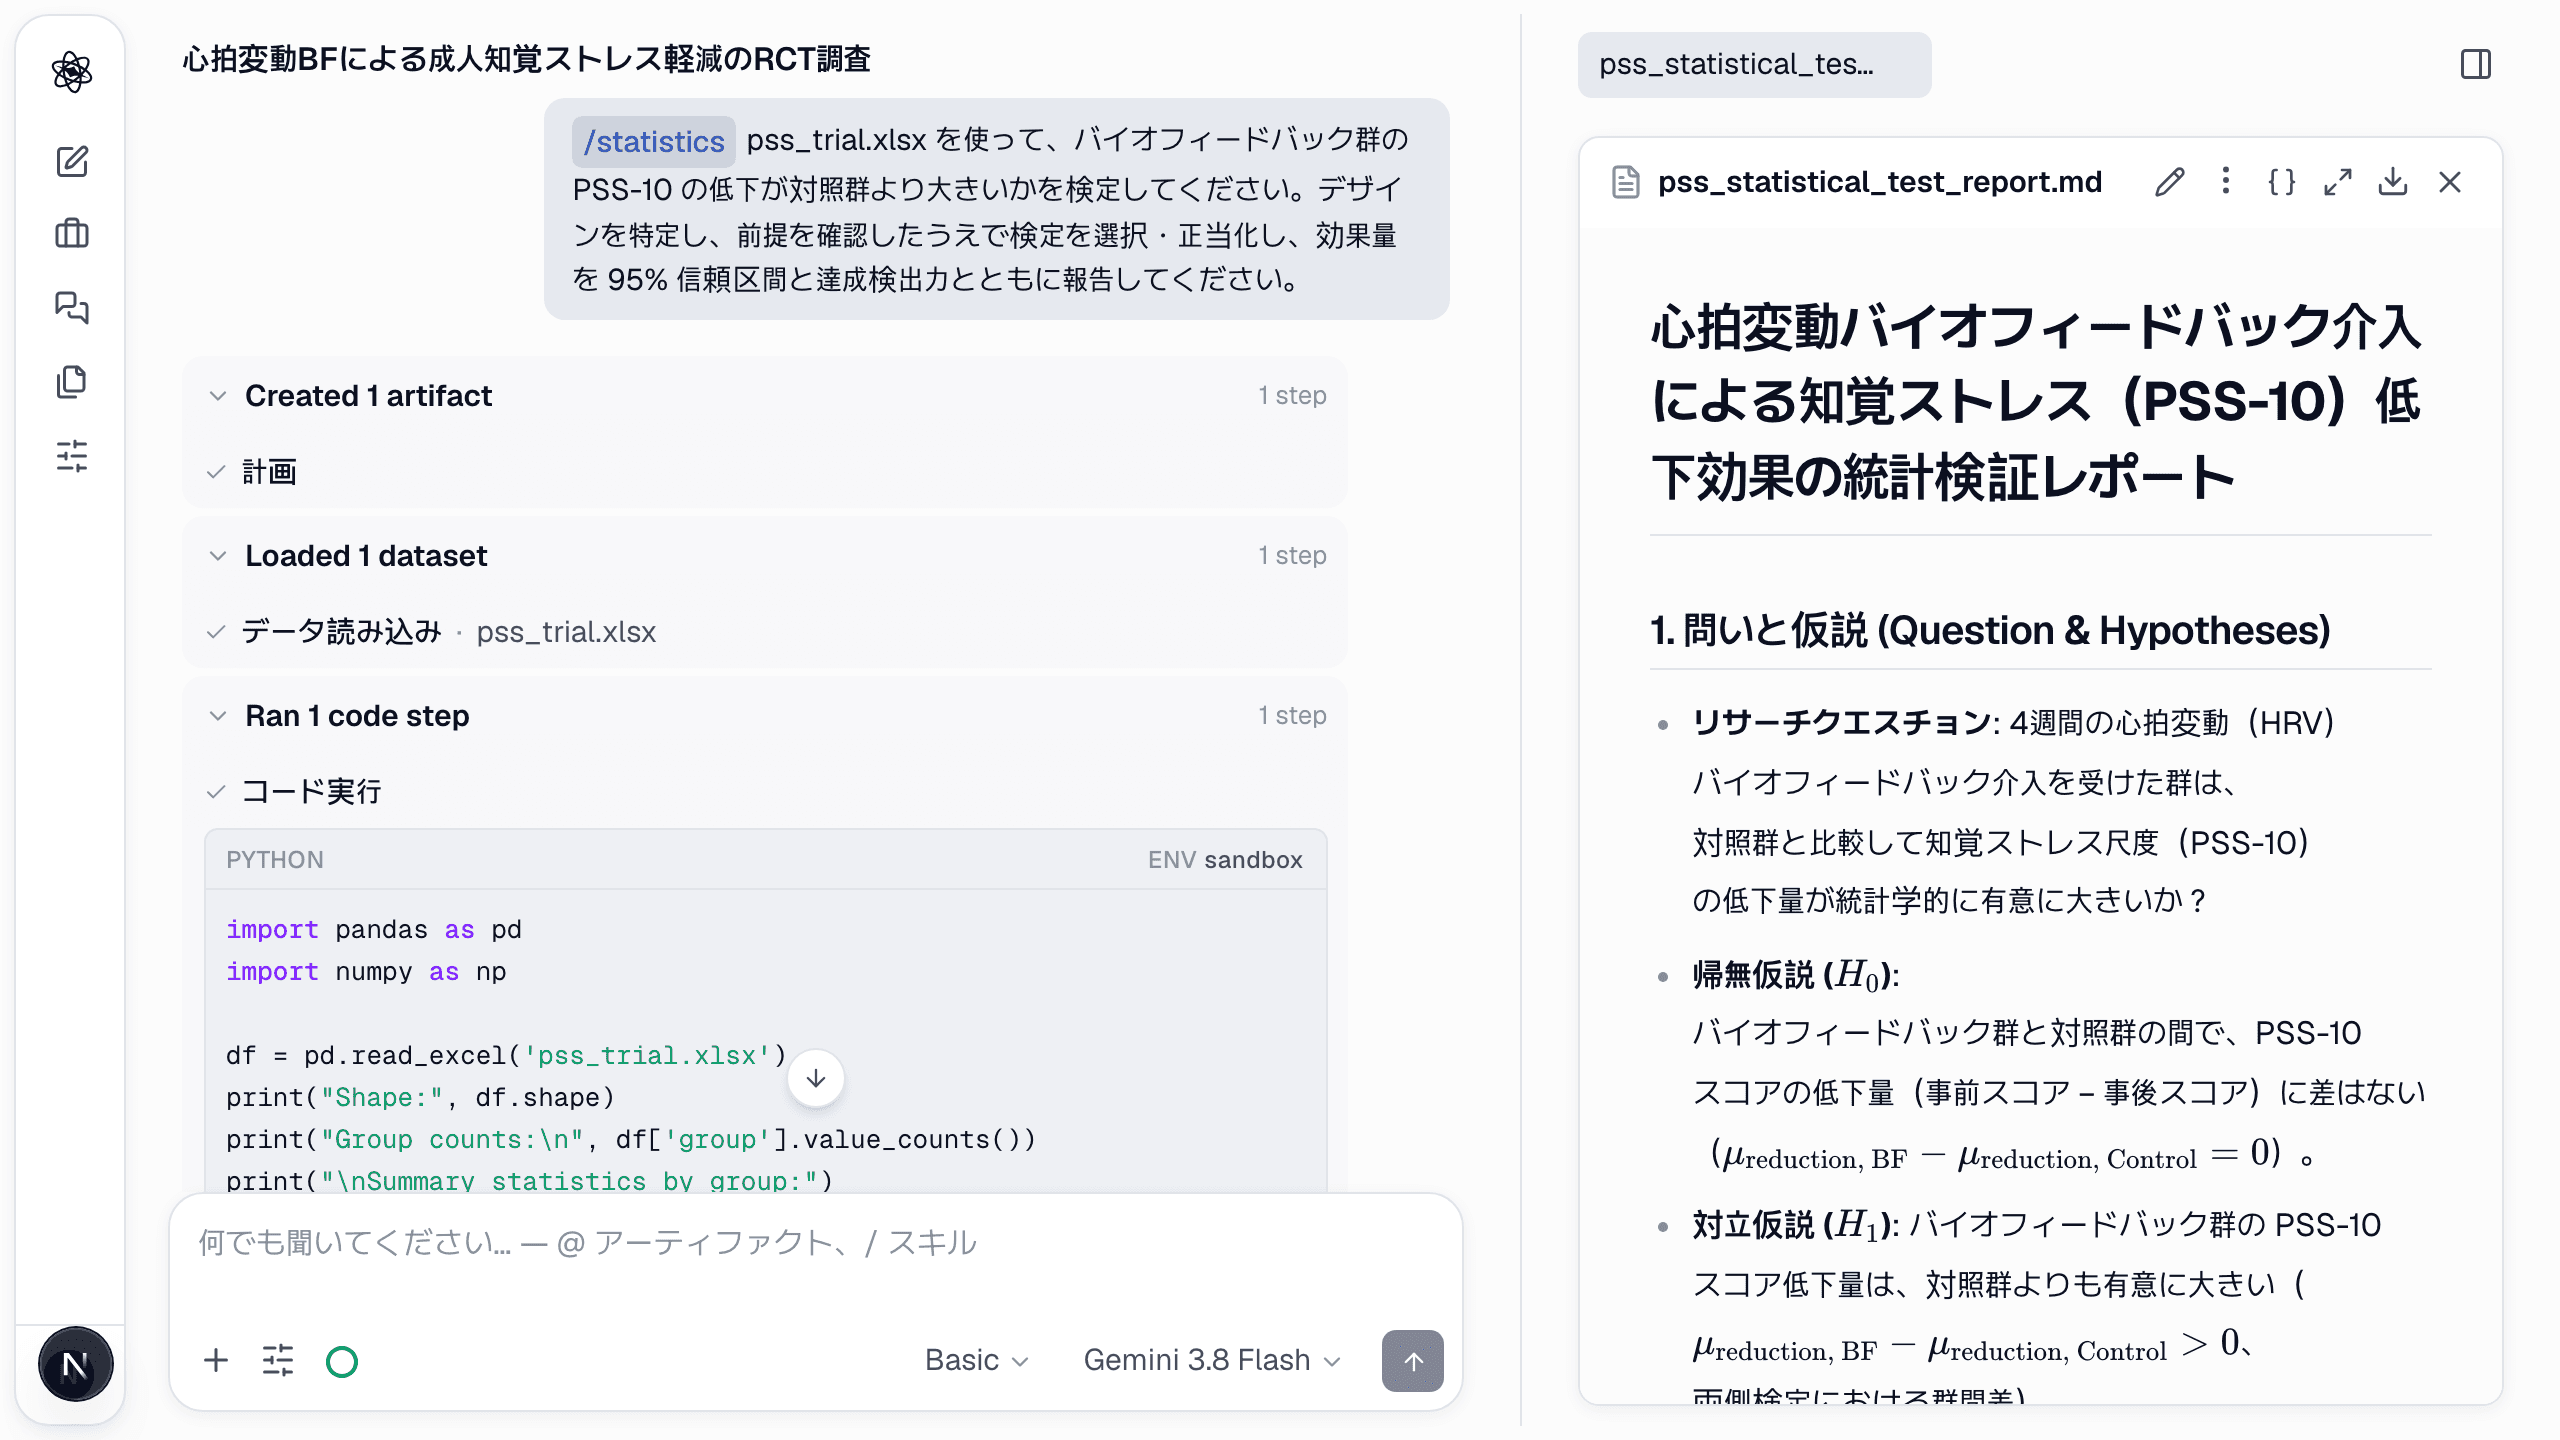
ステップ 1 — 検定ではなく問いを投げる
比較と報告してほしいことを説明すると、エージェントが手法を選びます。再アップロードなし——ファイルはすでにセッションにあります。
text
/statistics Using pss_trial.xlsx, test whether the biofeedback group shows a larger PSS-10 reduction than control. Check assumptions, choose the appropriate test, and report the effect size with a 95% CI and achieved power.
ステップ 2 — モデルはデザインに従う
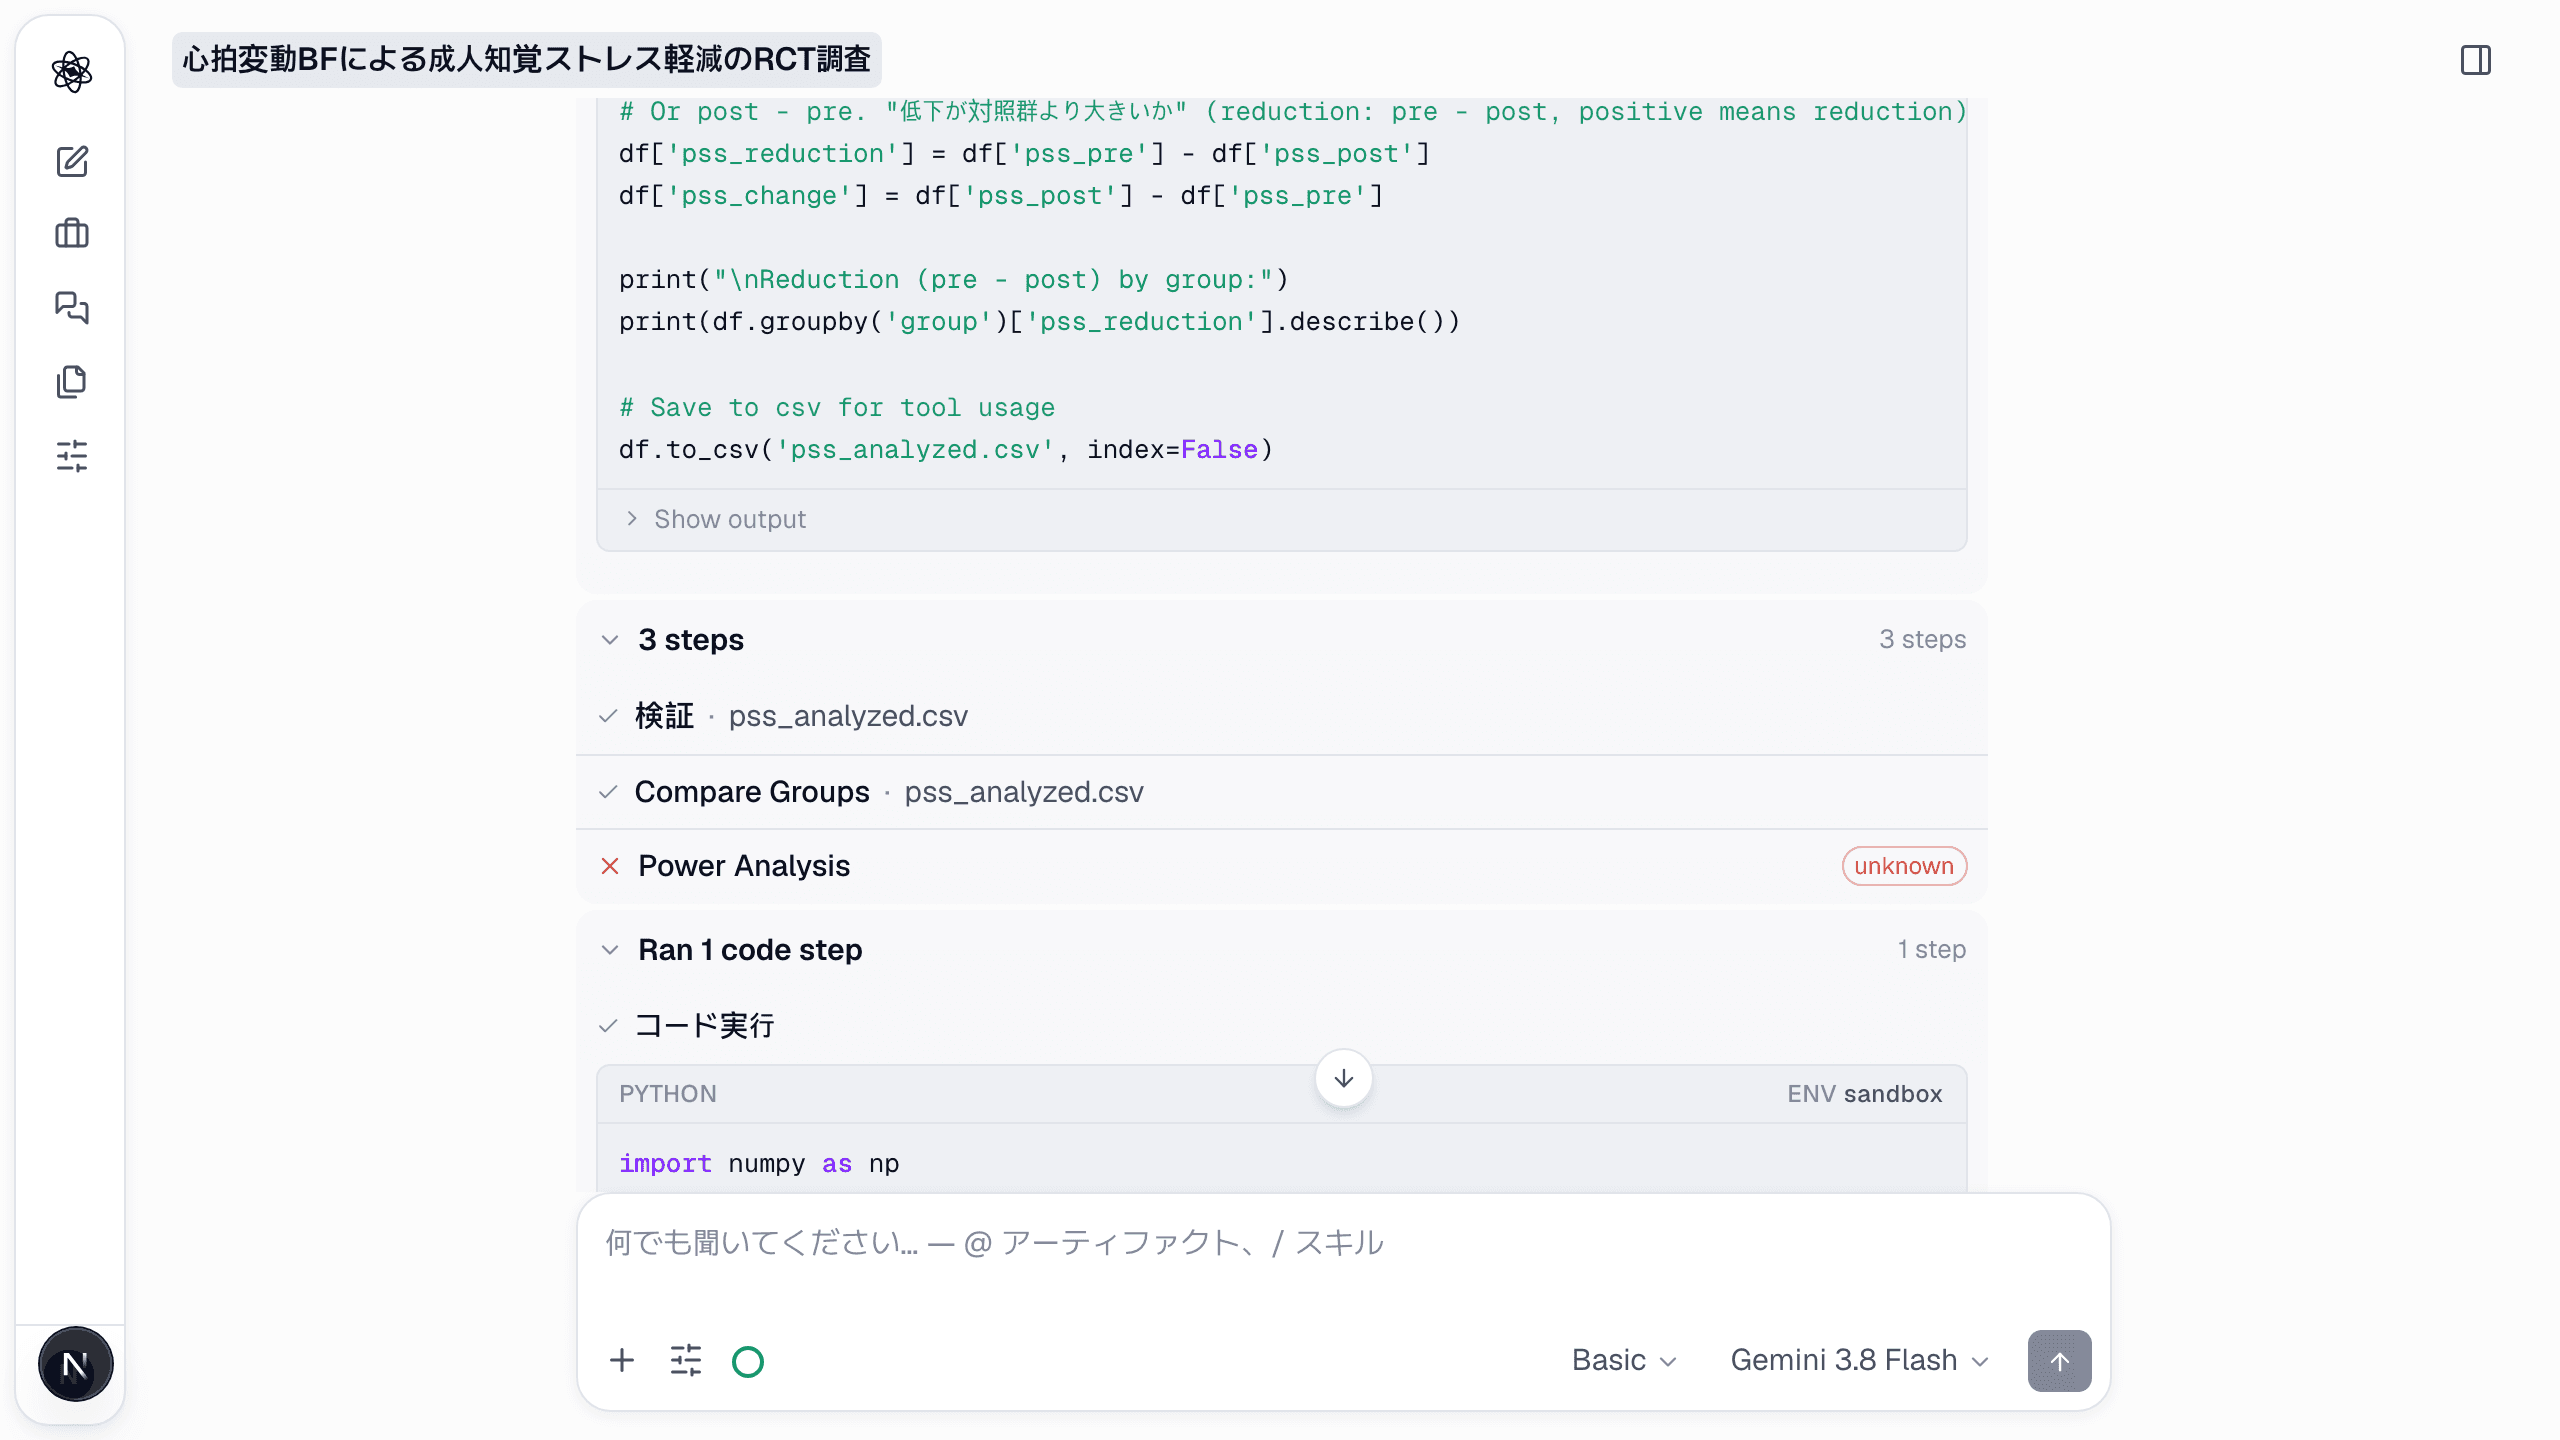
エージェントはデザイン(独立 2 群、事前/事後)を特定し、正規性と分散を監査し、それから初めて検定を選びます:Student の t と並べた Welch の t、そしてベースライン調整 ANCOVA。コードはサンドボックスで走り、結果に付いたままです。心理測定と現代的モデリングは追加機能ではなくネイティブです:
- 適合度指標を印刷するだけでなく解釈する因子分析(EFA・CFA)と SEM。
- アルファとオメガとしての信頼性、違いが重要なときはその違いを説明。
- 入れ子・縦断データのための混合効果モデル、変量効果構造を正当化。
- 小サンプルや事前知識が求めるときのベイズ推定。
ステップ 3 — p 値だけでなく、不確実性付きの効果
結果には査読者が求めるすべてが付いてきます:95% CI 付きの Cohen's d = 1.23、Hedges' g、ANCOVA の偏 η²、達成検出力、そしてデザインが 80%・90% の検出力で検出できた最小効果。
ステップ 4 — 前提は二度確認される
すべての分析は 2 つのエージェントを通ります。生成エージェントが前提チェックとともにモデルを実行し、Deep レベルでは独立したレビューエージェントが、結果がレポートに届く前にそれを崩そうとします——前提の違反、多重比較のリスク、サンプルサイズの問題、p ハッキングの兆候。不一致は隠されず示されます。
ステップ 5 — 単独で引用できるレポート
統計レポートはデータレポートとは別の文書なので、原稿で 2 つを独立に引用できます——そして結果の構造化 JSON により、執筆ステップは数字を打ち直す代わりに引用します。
問いは決して「有意か」ではありません。「注意深い査読者を通るか」です——その確認が組み込まれています。