音声は研究で得られる記録のなかでも特に情報量が多く、同時に分析がとても面倒なデータです。言葉は書き起こしサービスや研究補助者へ、声は Praat へ回ります。数値はスプレッドシートに写され、さらに R や SPSS に移されます。結果の節を書くころには、ピッチの下限をいくつにしたのか、どの版の書き起こしをコーディングしたのか、誰も覚えていません。
Neutropic では、アップロードからレポートまで音声が一つのセッションにとどまります。この記事は音声だけを深く扱います。何をアップロードできるか、各ツールが何を測るか、結果の読み方、そして限界はどこにあるかを順に見ていきます。EEG・音声・動画をまとめて紹介した記事はスプレッドシートの先へにあります。
アップロードできるファイル
録音は他のファイルと同じようにチャットに添付します。対応する音声形式は .wav .mp3 .m4a .flac .ogg .aac .aiff です。書き起こしは動画(.mp4 .mov .webm など)の音声トラックも読み取れます。アップロードは 1 GB まで可能です。
実際に使うときのポイント:
- 声の指標には WAV がいちばん確実です。 書き起こしは上の形式をすべて読めますが、ピッチ・音響ツールは WAV を前提にドキュメント化されています。声質が重要なら、圧縮ファイルは先に WAV に変換してください。
- 1 ファイルに話者 1 人が最適です。 声のツールはクリップ全体を要約します。インタビューに 2 人の声が入っていると、ピッチの統計が混ざります(限界の節を参照)。
- 録音が何かを書き添えてください。 「音読サンプル」「半構造化インタビュー、参加者 P07」「思考発話、タスク 3」のように書くと、エージェントが適切なステップを選び、レポートの表現も正確になります。
Neutropic 自身が動かす音声書き起こし
書き起こしには、OpenAI の Whisper モデルのオープンソース実装である faster-whisper を使い、Neutropic 自身のサーバーで実行します。音声を外部の書き起こし API に送ることはありません。
- モデルサイズ。
tiny、base、small、mediumから選べます。大きいほど遅く、精度は上がります。明瞭な英語以外ならsmallかmediumを指定してください。 - 言語。 Whisper が言語を検出し、その確率を示します。「日本語の音声です」のように指定すれば検出を省けます。中国語は簡体字で出力されるよう調整されています。
- タイムスタンプ付きのセグメント。 各セグメントに開始・終了時刻(秒)があります。無音は音声区間検出(VAD)フィルタで除かれるため、長い間はセグメント間のすき間として現れます。
- 分量と発話速度。 英語や韓国語のように分かち書きする言語では、単語数と毎分単語数(WPM)が出ます。分かち書きをしない中国語と日本語は、文字数と毎分文字数(CPM)で数えます。(今日まではこの 2 言語が「1 words」「2 words」と表示されていましたが、修正されました。)
結果は <ファイル名>_transcript.md アーティファクトとして保存されます。先頭にモデル・言語・長さ・分量、その下に全文とセグメント表が続きます。
/analyze interview_P07.m4a は日本語の半構造化インタビューです。Whisper の small モデルでタイムスタンプ付きで書き起こし、書き起こしは言い換えずにそのまま残してください。
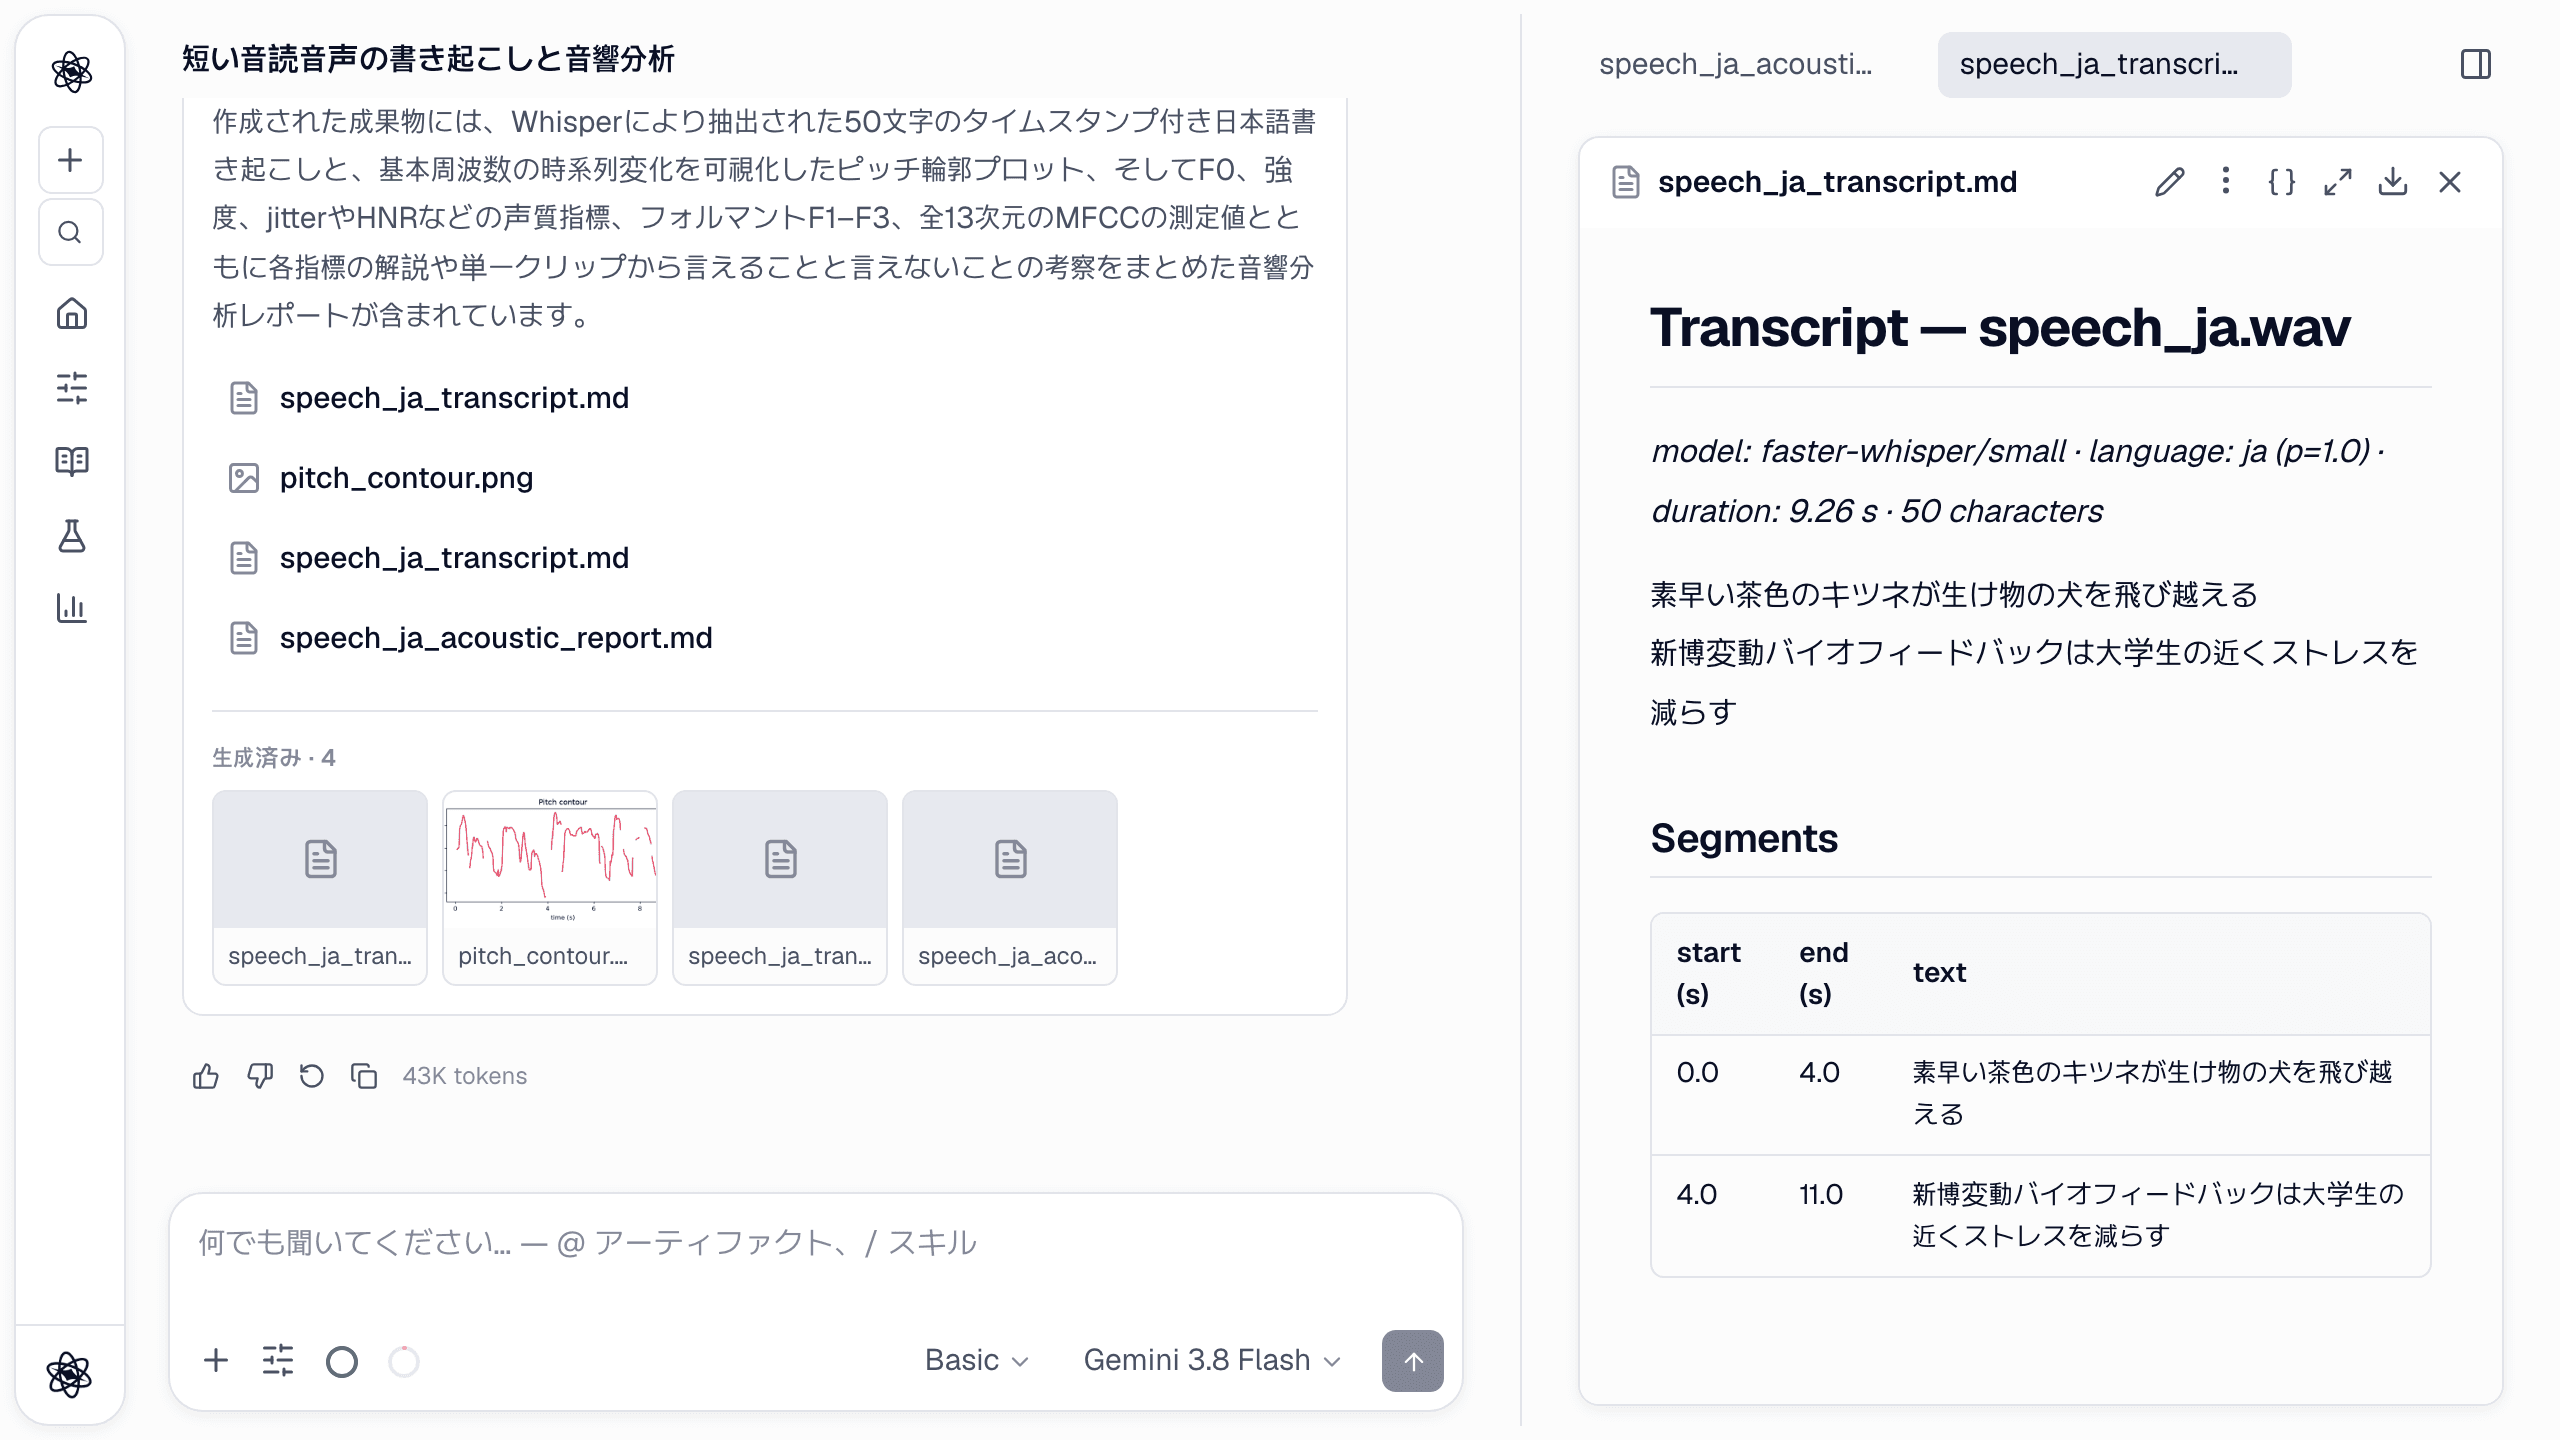
エージェントは書き起こしをそのまま引用し、言い換えた内容を音声の発言として扱わないよう指示されています。あとでテキストをコーディングするとき、この点が効いてきます。
声:ピッチ、強度、声質
voice ツールは音声を読み込み、次を返します。
- ピッチ(F0):平均・標準偏差・最小・最大・範囲(Hz)。pYIN で 65–400 Hz の範囲を追跡し、有声区間の割合も出します。
- 強度:RMS エネルギーの平均と標準偏差。録音内での相対値で、校正済みの dB SPL ではありません。
- スペクトル重心(Hz)。
- Praat(parselmouth)で測る声質:local jitter、local shimmer、HNR(dB)。
- ピッチ輪郭の画像
pitch_contour.png。
acoustic_features ツールはさらに次を加えます。
- フォルマント F1–F3(Praat、Burg 法):平均と標準偏差(Hz)。
- MFCC 13 次元:係数ごとの平均と標準偏差。
- ゼロ交差率、スペクトル帯域幅、スペクトルロールオフ。
どちらのツールも感情ラベルは付けません。voice の出力には注記があります。F0 の平均・変動や強度が高いことは一般に覚醒度の高さと結びつき、jitter・shimmer・HNR は声質を表すが、これらは特徴量であって検証済みの感情分類器ではない、という内容です。レポートもこの線を守ります。
/analyze speech_ja.wav の声を測定してください:F0 の平均・標準偏差・範囲・輪郭、強度、jitter、shimmer、HNR、さらにフォルマント F1–F3 と MFCC。各指標の意味と、このクリップ 1 本から言えること・言えないことを明記してください。
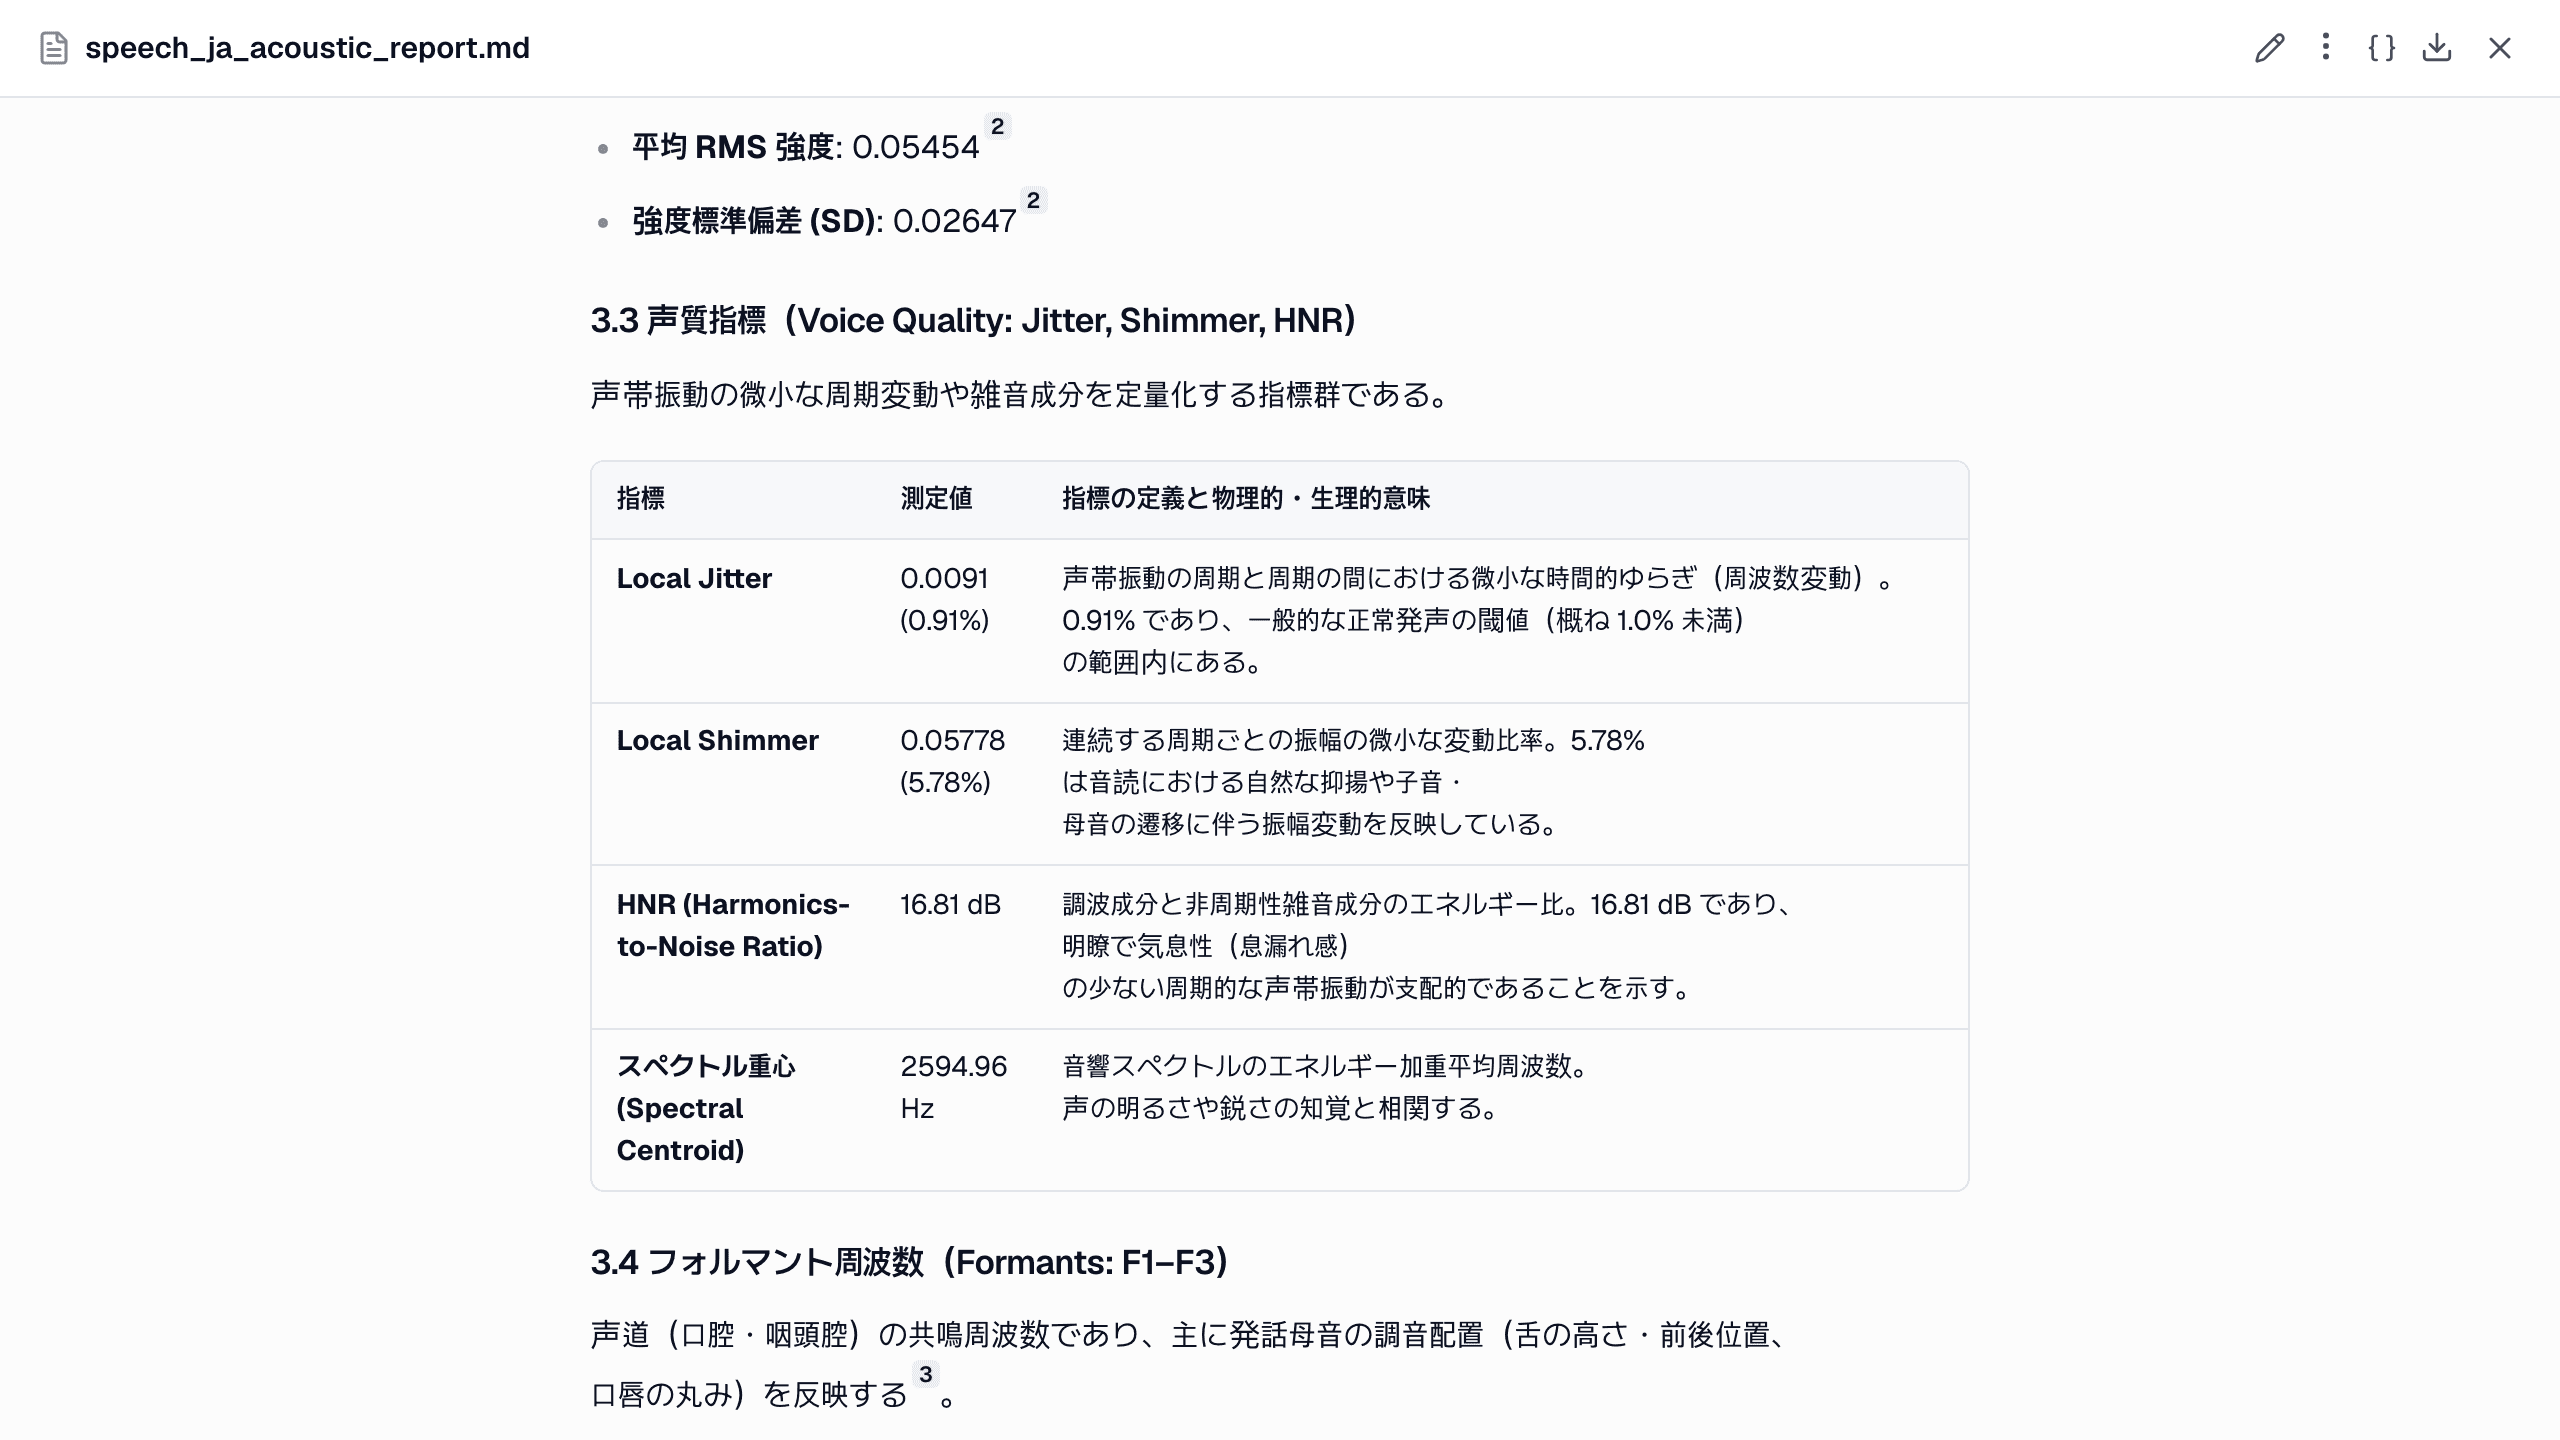
英語のサンプル(7.4 秒の合成音読)では、F0 平均 173.7 Hz(範囲 100.8–233.0 Hz)、jitter 1.2%、shimmer 6.6%、HNR 16.0 dB、F1–F3 は 676・1878・2996 Hz でした。同じクリップを Praat で別に測った参照値は F0 平均 171.7 Hz です。
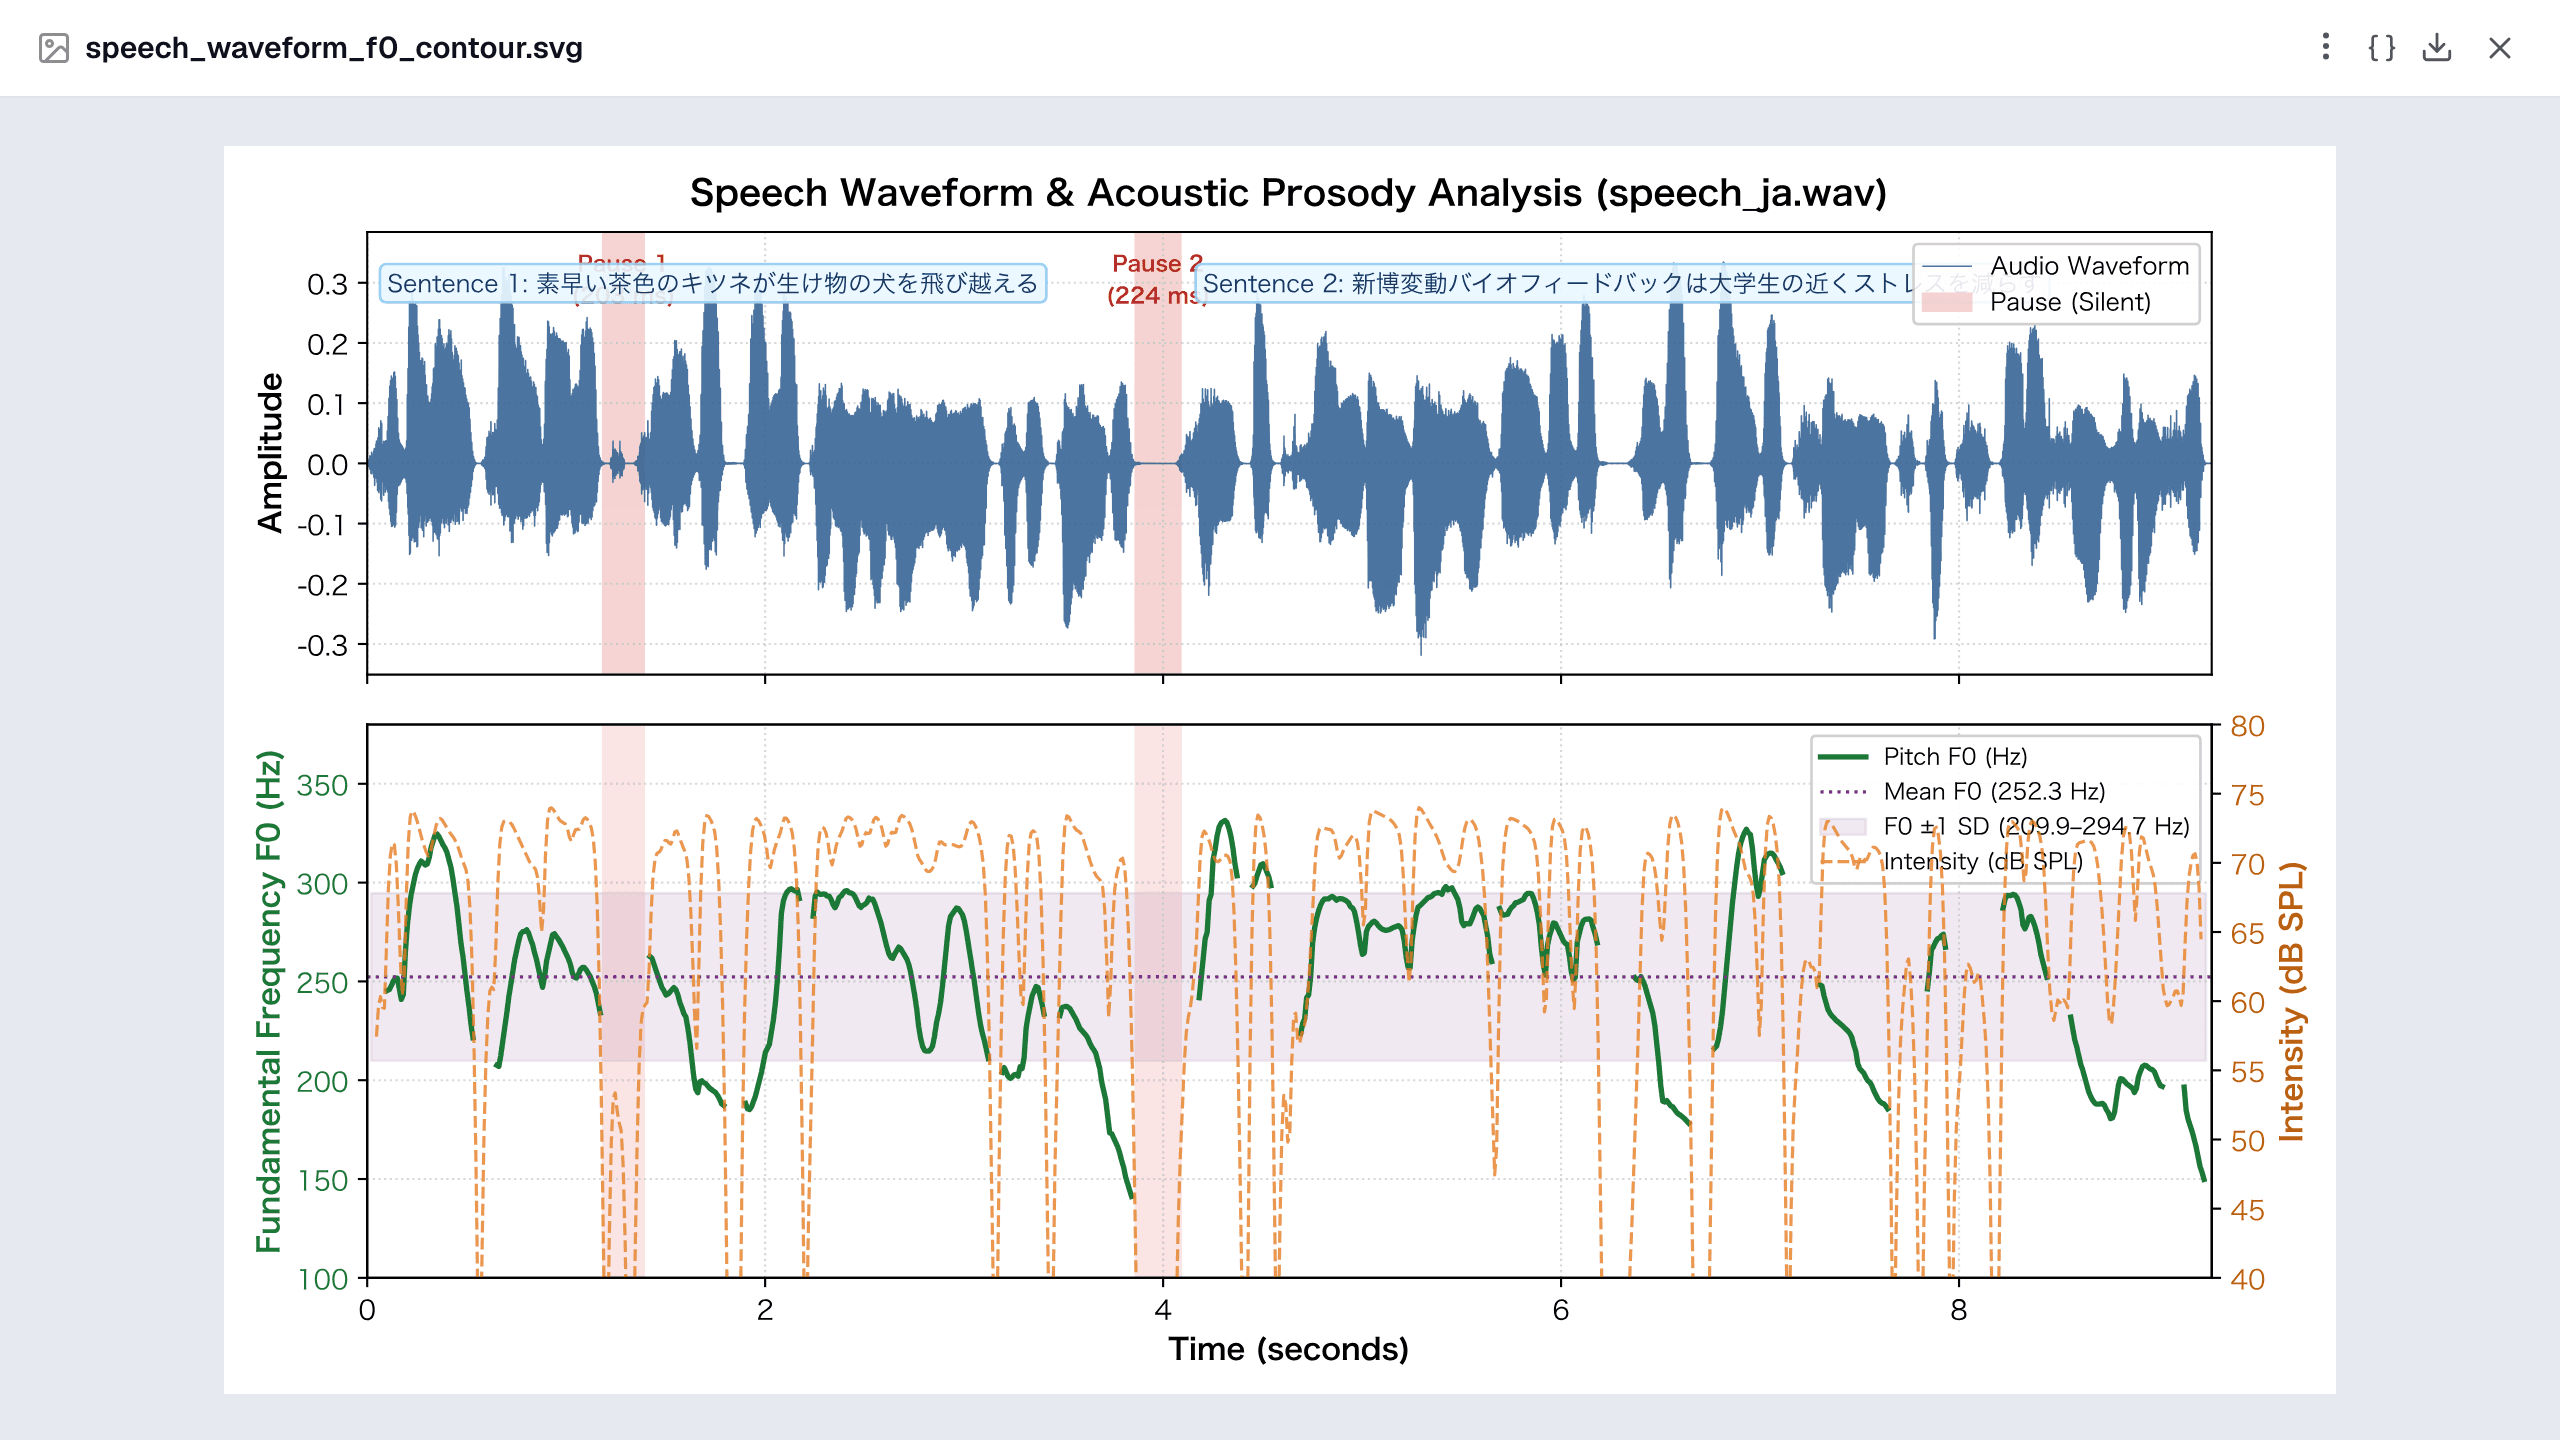
図を頼めば、既定の輪郭図より踏み込んだものも描けます。サンプルプロジェクトでは、間を示した波形と、強度曲線に重ねた F0 輪郭を描きました。
よくある研究での使い方
インタビューとテーマのコーディング。 インタビューごとに書き起こし、セグメントを参加者列のある表にまとめてもらいます。テキストツールはその表の上で動きます。text_overview(分量と頻出語)、theme_clusters(代表的な発言つきの候補テーマ。オープンコーディングの出発点)、topic_model(LDA または NMF)、sentiment(VADER、英語のみ)です。クラスタは提案として扱ってください。ツール自身も、原文と照らして確かめるべき候補テーマだと明記します。
思考発話のユーザビリティ評価。 セグメントのタイムスタンプを使えば、参加者の発言をタスクのタイムラインに合わせられます。タスクの時間枠ごとに該当する発言を抜き出してもらい、同じ研究のタスク成功率や SUS スコアと合わせて見ます。
感情のプロソディ。 条件間で F0 平均、F0 標準偏差、強度を比べます(たとえば同じ話者が読んだ中立文と感情文)。クリップ 1 本を解釈するより、話者内の比較のほうがはるかに強い証拠になります。
声のストレス。 jitter、shimmer、HNR、F0 は、ストレスや認知負荷の研究でよく扱われる音響的な相関指標です。一人ずつベースラインを録音し、課題中の録音と比べてください。クリップ 1 本だけで判断させようとすると、レポートがまずその限界を指摘します。
1 本のクリップから研究全体へ:参加者をまたぐ統計
研究で録音が 1 本だけということはまずありません。全参加者のファイル(または条件ごとのファイル)をアップロードし、各ファイルに同じ指標を求め、ファイルごとの結果を参加者・条件の列を持つ表にまとめてもらいます。そこからは統計ツールの出番です。
compare_groupsは、デザインとデータから検定を選び(対応あり・なし、パラメトリック・ノンパラメトリック)、その理由を決定トレース(decision trace)で説明します。mixedlmは、話者ごとに発話が複数ある場合など、参加者を変量効果とする反復測定を扱います。
/stats voice_features.csv は録音 1 本が 1 行です:participant、condition(baseline / stress)、f0_mean、f0_sd、jitter、shimmer、hnr。参加者内で条件を比較し、前提を確認し、効果量を報告してください。
検定の選び方は統計ガイドで詳しく説明しています。
すべての文をたどれる
分析レポートはツールの出力から書かれ、文ごとに [n] 引用が付きます。各番号は、その文の根拠となった分析ステップ(media_info、transcribe_audio、voice、acoustic_features)かデータファイルを指します。チャットには「分析レポートの 40 文に [n] 引用を付けました」のような案内が表示され、レポート末尾の参考文献には、ステップごとに引数と生の結果の冒頭が並びます。
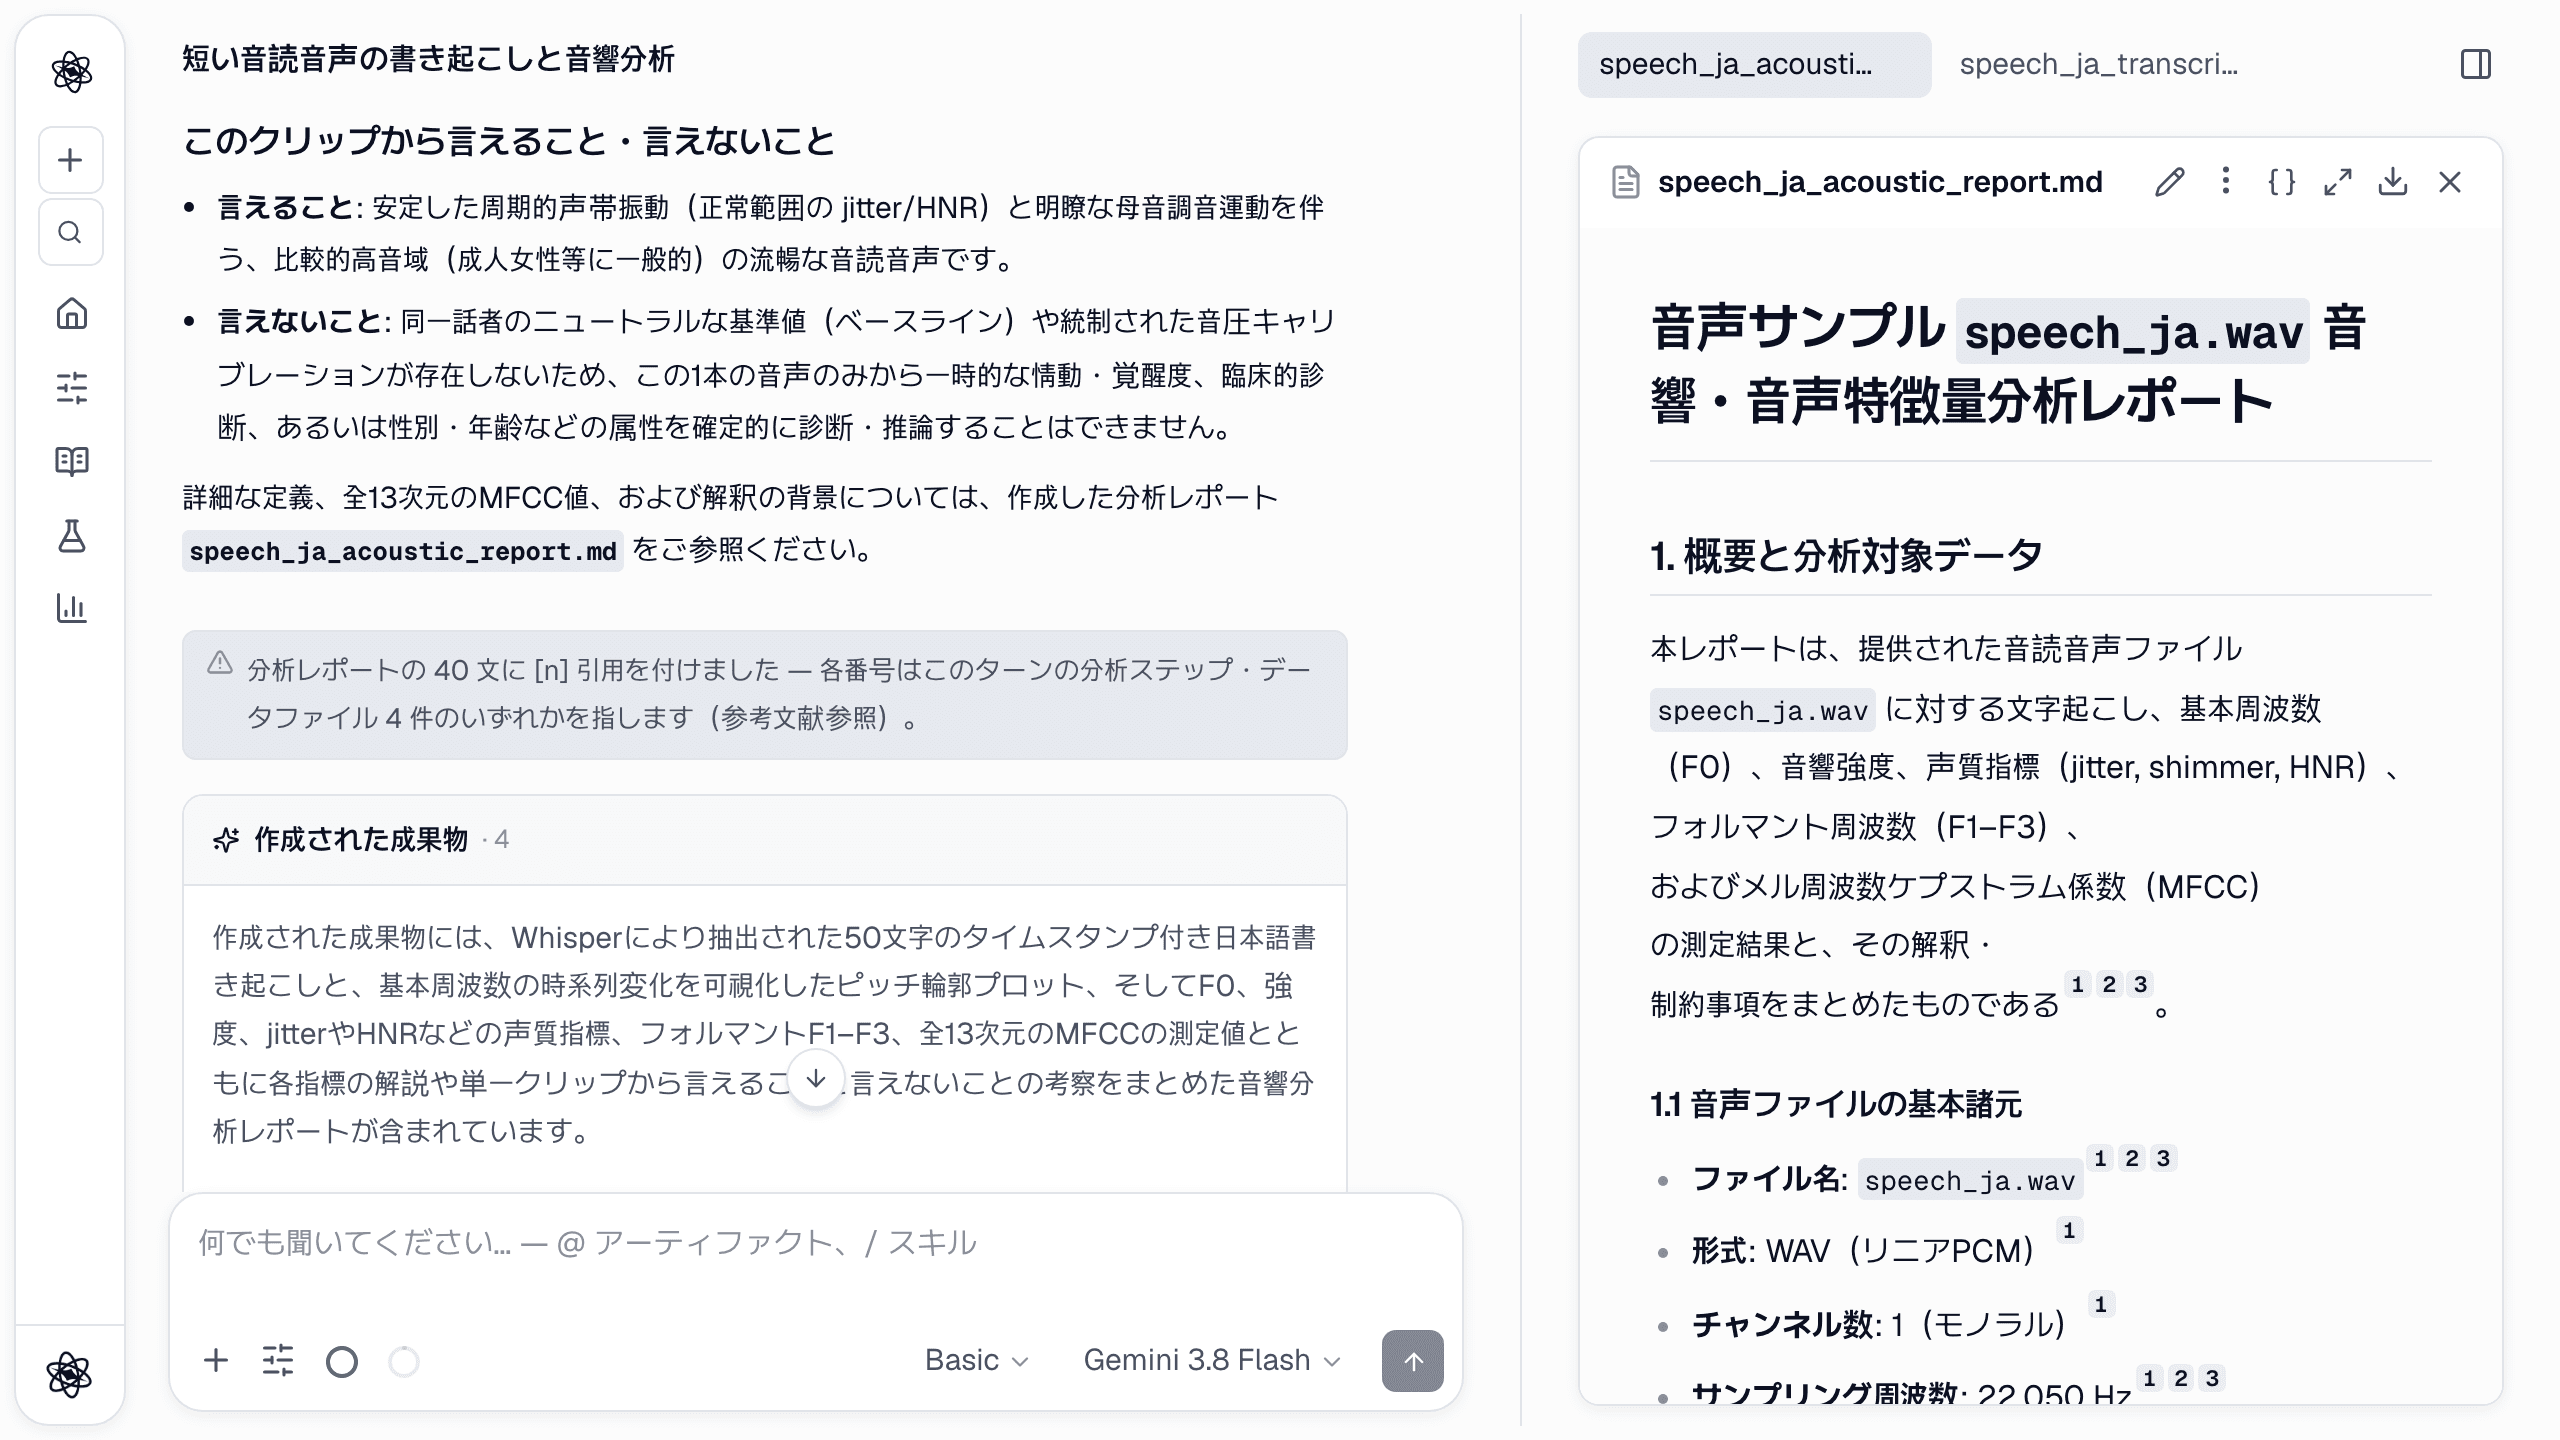
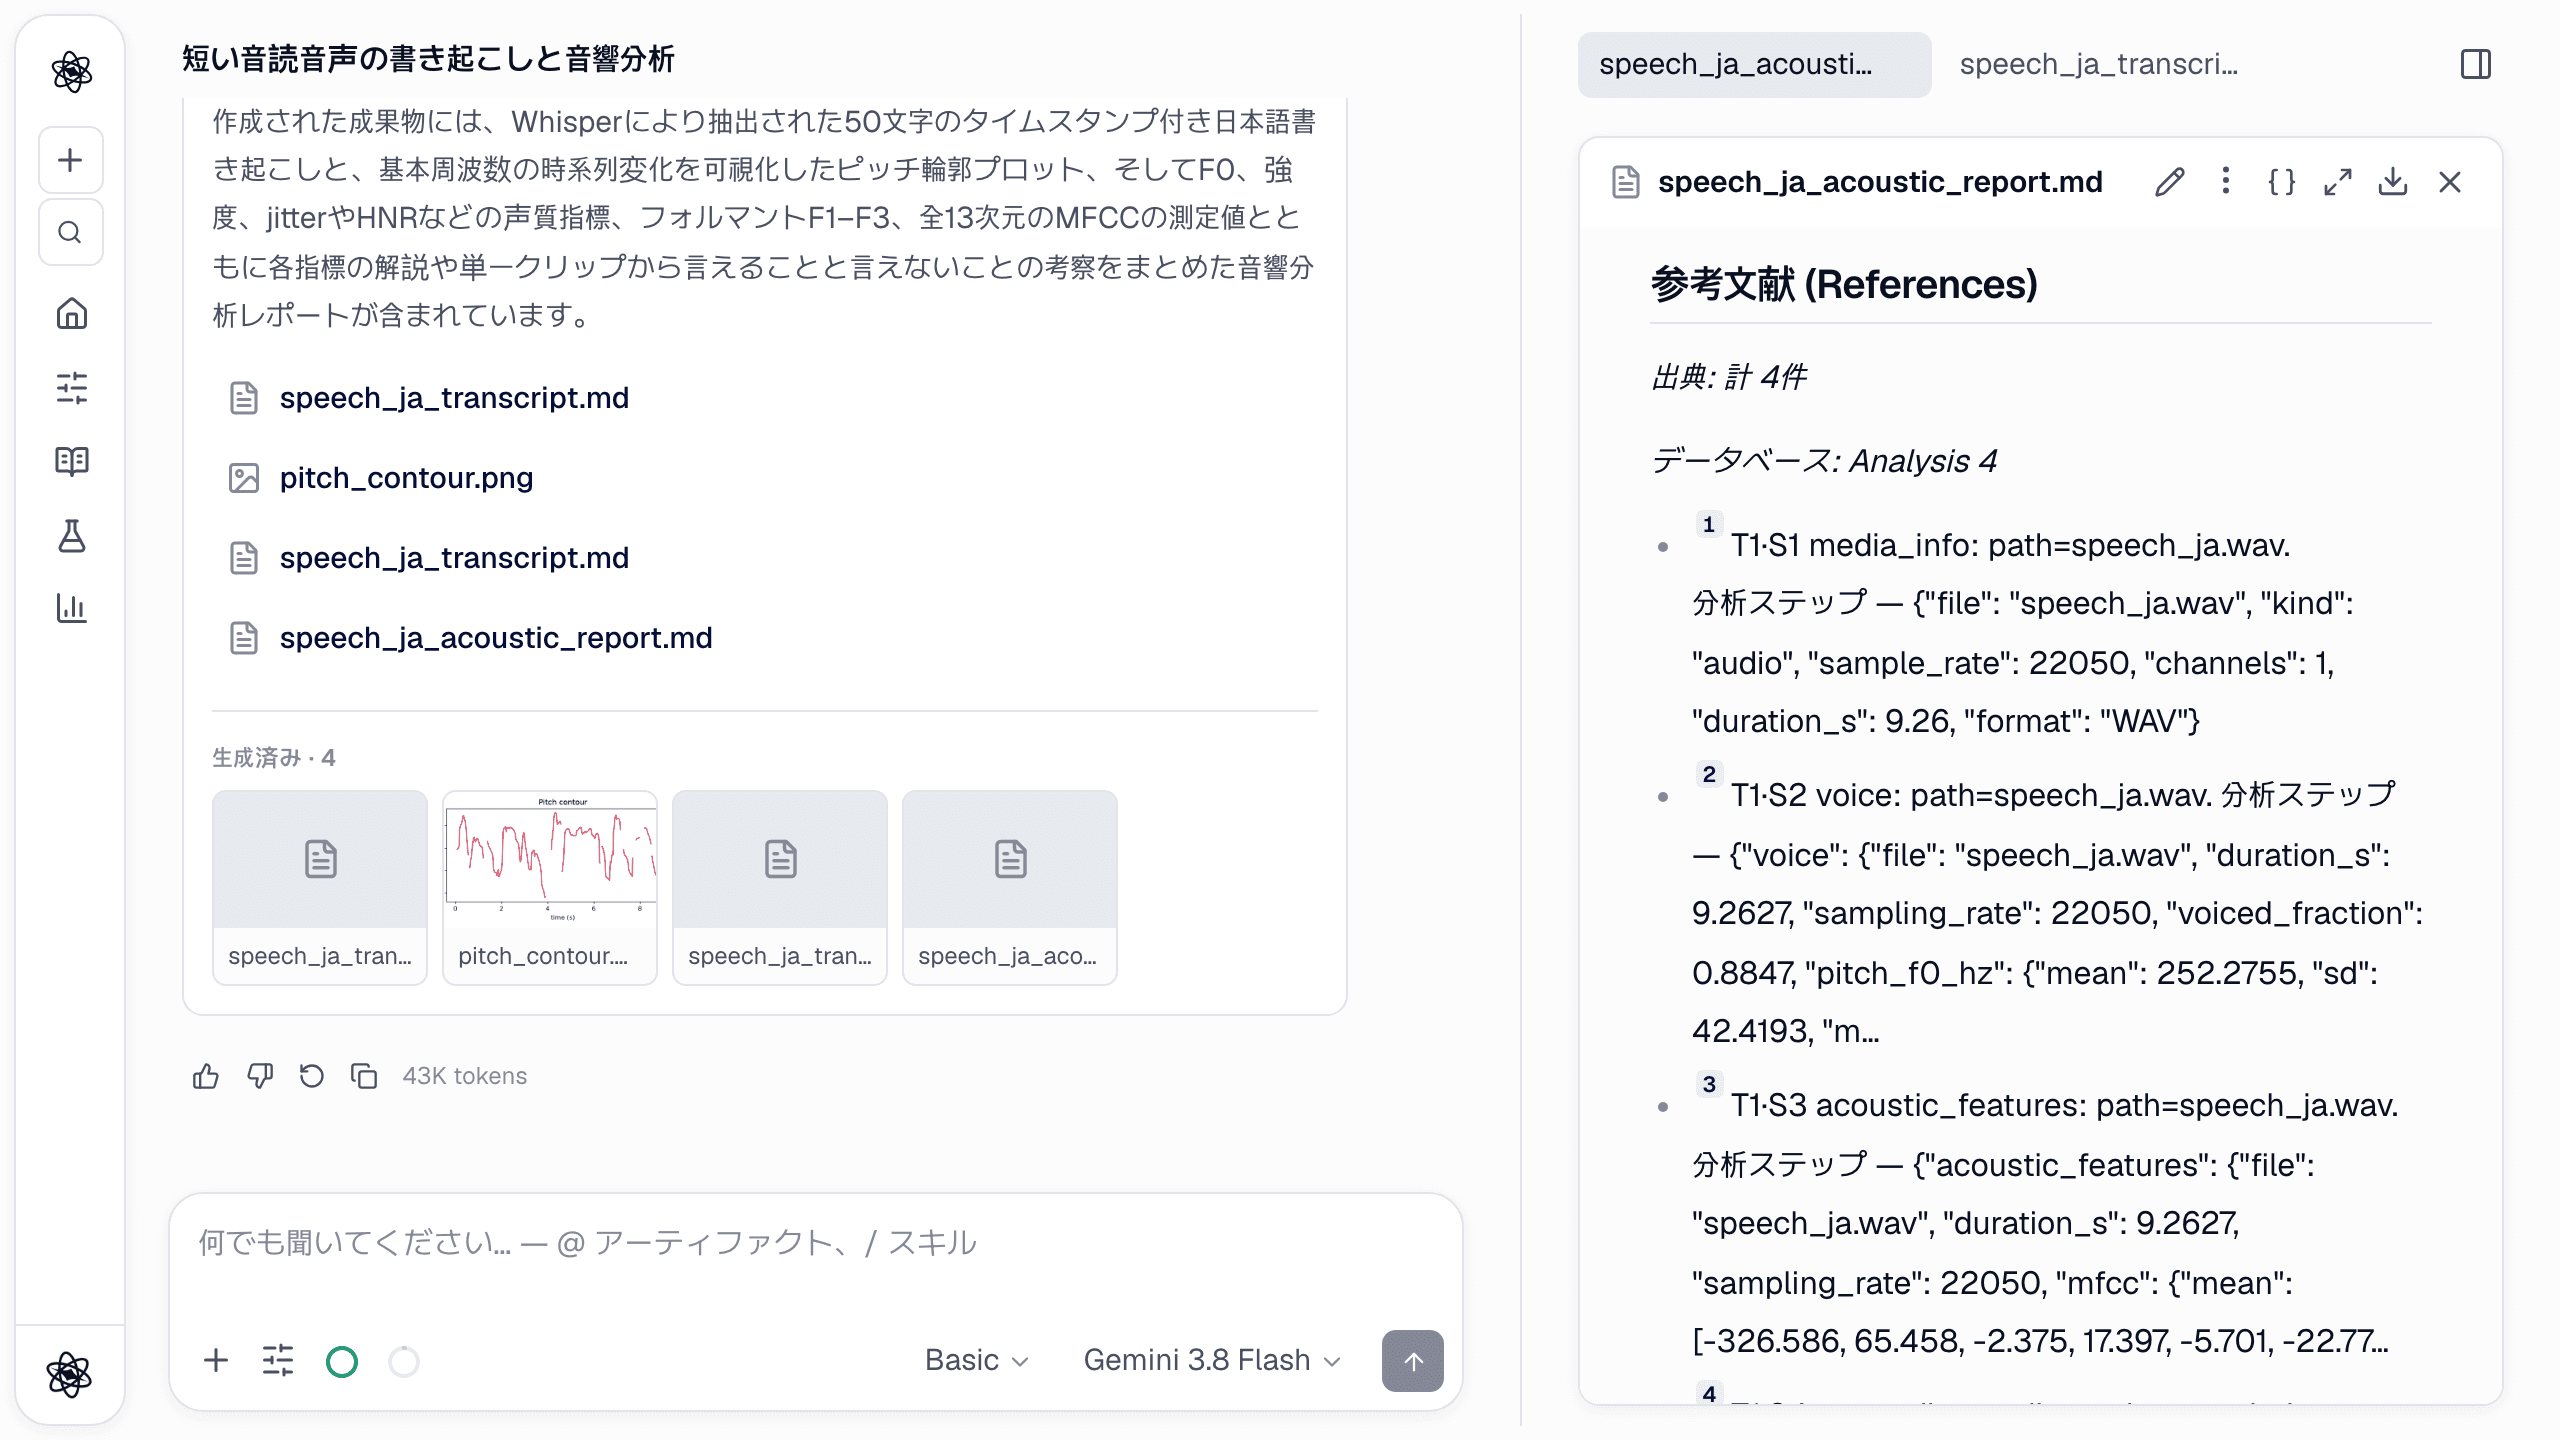
ツール呼び出しごとに名前と引数(書き起こしならファイル・モデルサイズ・言語)が記録され、図は自分を作ったコードを保持します(アーティファクトパネルの { })。ピッチや書き起こしをどう得たのかと聞かれたら、答えはセッションの中にあります。詳しくはすべての文に出典をと再現性を標準にをご覧ください。
プライバシー
人の声の録音は個人情報であり、ときに要配慮情報です。プライバシーポリシーに書かれていることは次のとおりです。
- Web アプリでは、アップロードしたファイルとそこから作られたアーティファクトはアカウントの非公開ワークスペースに保存され、分析のために Neutropic のサーバーで処理されます。
- 書き起こしはそのサーバー上で faster-whisper により行われます。音声ファイルを外部の音声認識サービスに送ることはありません。
- 選択した AI モデルは、回答に必要なもの、つまりプロンプト・ツール結果・関連する抜粋を見ます。書き起こしのテキストもここに含まれます。モデル提供元は、そのデータでの学習を禁じる契約のもとで処理します。
- あなたのコンテンツがモデルの学習に使われることはなく、いつでも削除できます。
- アップロードする録音について同意と倫理審査の承認を得ておくのは利用者の責任です。アップロード前に、録音と書き起こしから氏名などの識別情報を取り除くのがよい習慣です。
正直な限界
- 書き起こしには誤りがあります。 Whisper は優秀ですが完璧ではなく、小さいモデルは英語以外の音声でより多く間違えます。韓国語・中国語・日本語のサンプルは
smallモデルでも聞き違いがありました。「怠け者」が「生け物」に、「心拍変動」が「新博変動」に、「知覚」が「近く」に、中国語の 敏捷的 が 民间的 になりました。コーディングや引用の前に、すべての書き起こしを音声と照らして校正してください。 クリップの終わりでタイムスタンプがずれることもあります。 - 話者分離(ダイアライゼーション)はありません。 Neutropic は話者を分けません。インタビューは「インタビュアー」「参加者」のラベルなしに一続きのセグメントとして返り、声の指標も録音にいる全員をまとめて測ります。人ごとの声の指標が必要なら、話者をチャンネル別に録音するか、話者ごとにファイルを切り分けてアップロードしてください。
- 特徴量であって感情ではありません。 録音に「喜び」「ストレス」「抑うつ」といったラベルを付けるツールはありません。プロソディの解釈にはベースラインと研究デザインが必要です。
- 臨床評価ではありません。 連続発話から測った jitter・shimmer・HNR は音声障害の評価ではありません。音声障害の評価は、校正された条件で持続母音を使って行います。
- 強度は校正されていません。 音の大きさはマイクとの距離やゲインで変わるので、強度は同じ録音環境の中でだけ比べてください。
- 参照範囲はモデルが書いたものです。 レポートが測定値を一般的な範囲と比べるとき(上の表のように)、その範囲はツールの出力ではなくモデルの一般知識です。引用する文献と照らして確かめてください。
- クリップ全体の要約です。 声のツールはファイル全体を要約します。セグメントごとの指標が必要なら、音声をセグメントに切り分けるか、それを行うコードを頼み、出力を確認してください。
まずはサンプルプロジェクト(例 · 分野別スキル の音声セッション)を見るか、自分の録音を添付して説明を添えて始めてください。形式とオプションはデータ分析のドキュメントとアップロード形式にあります。