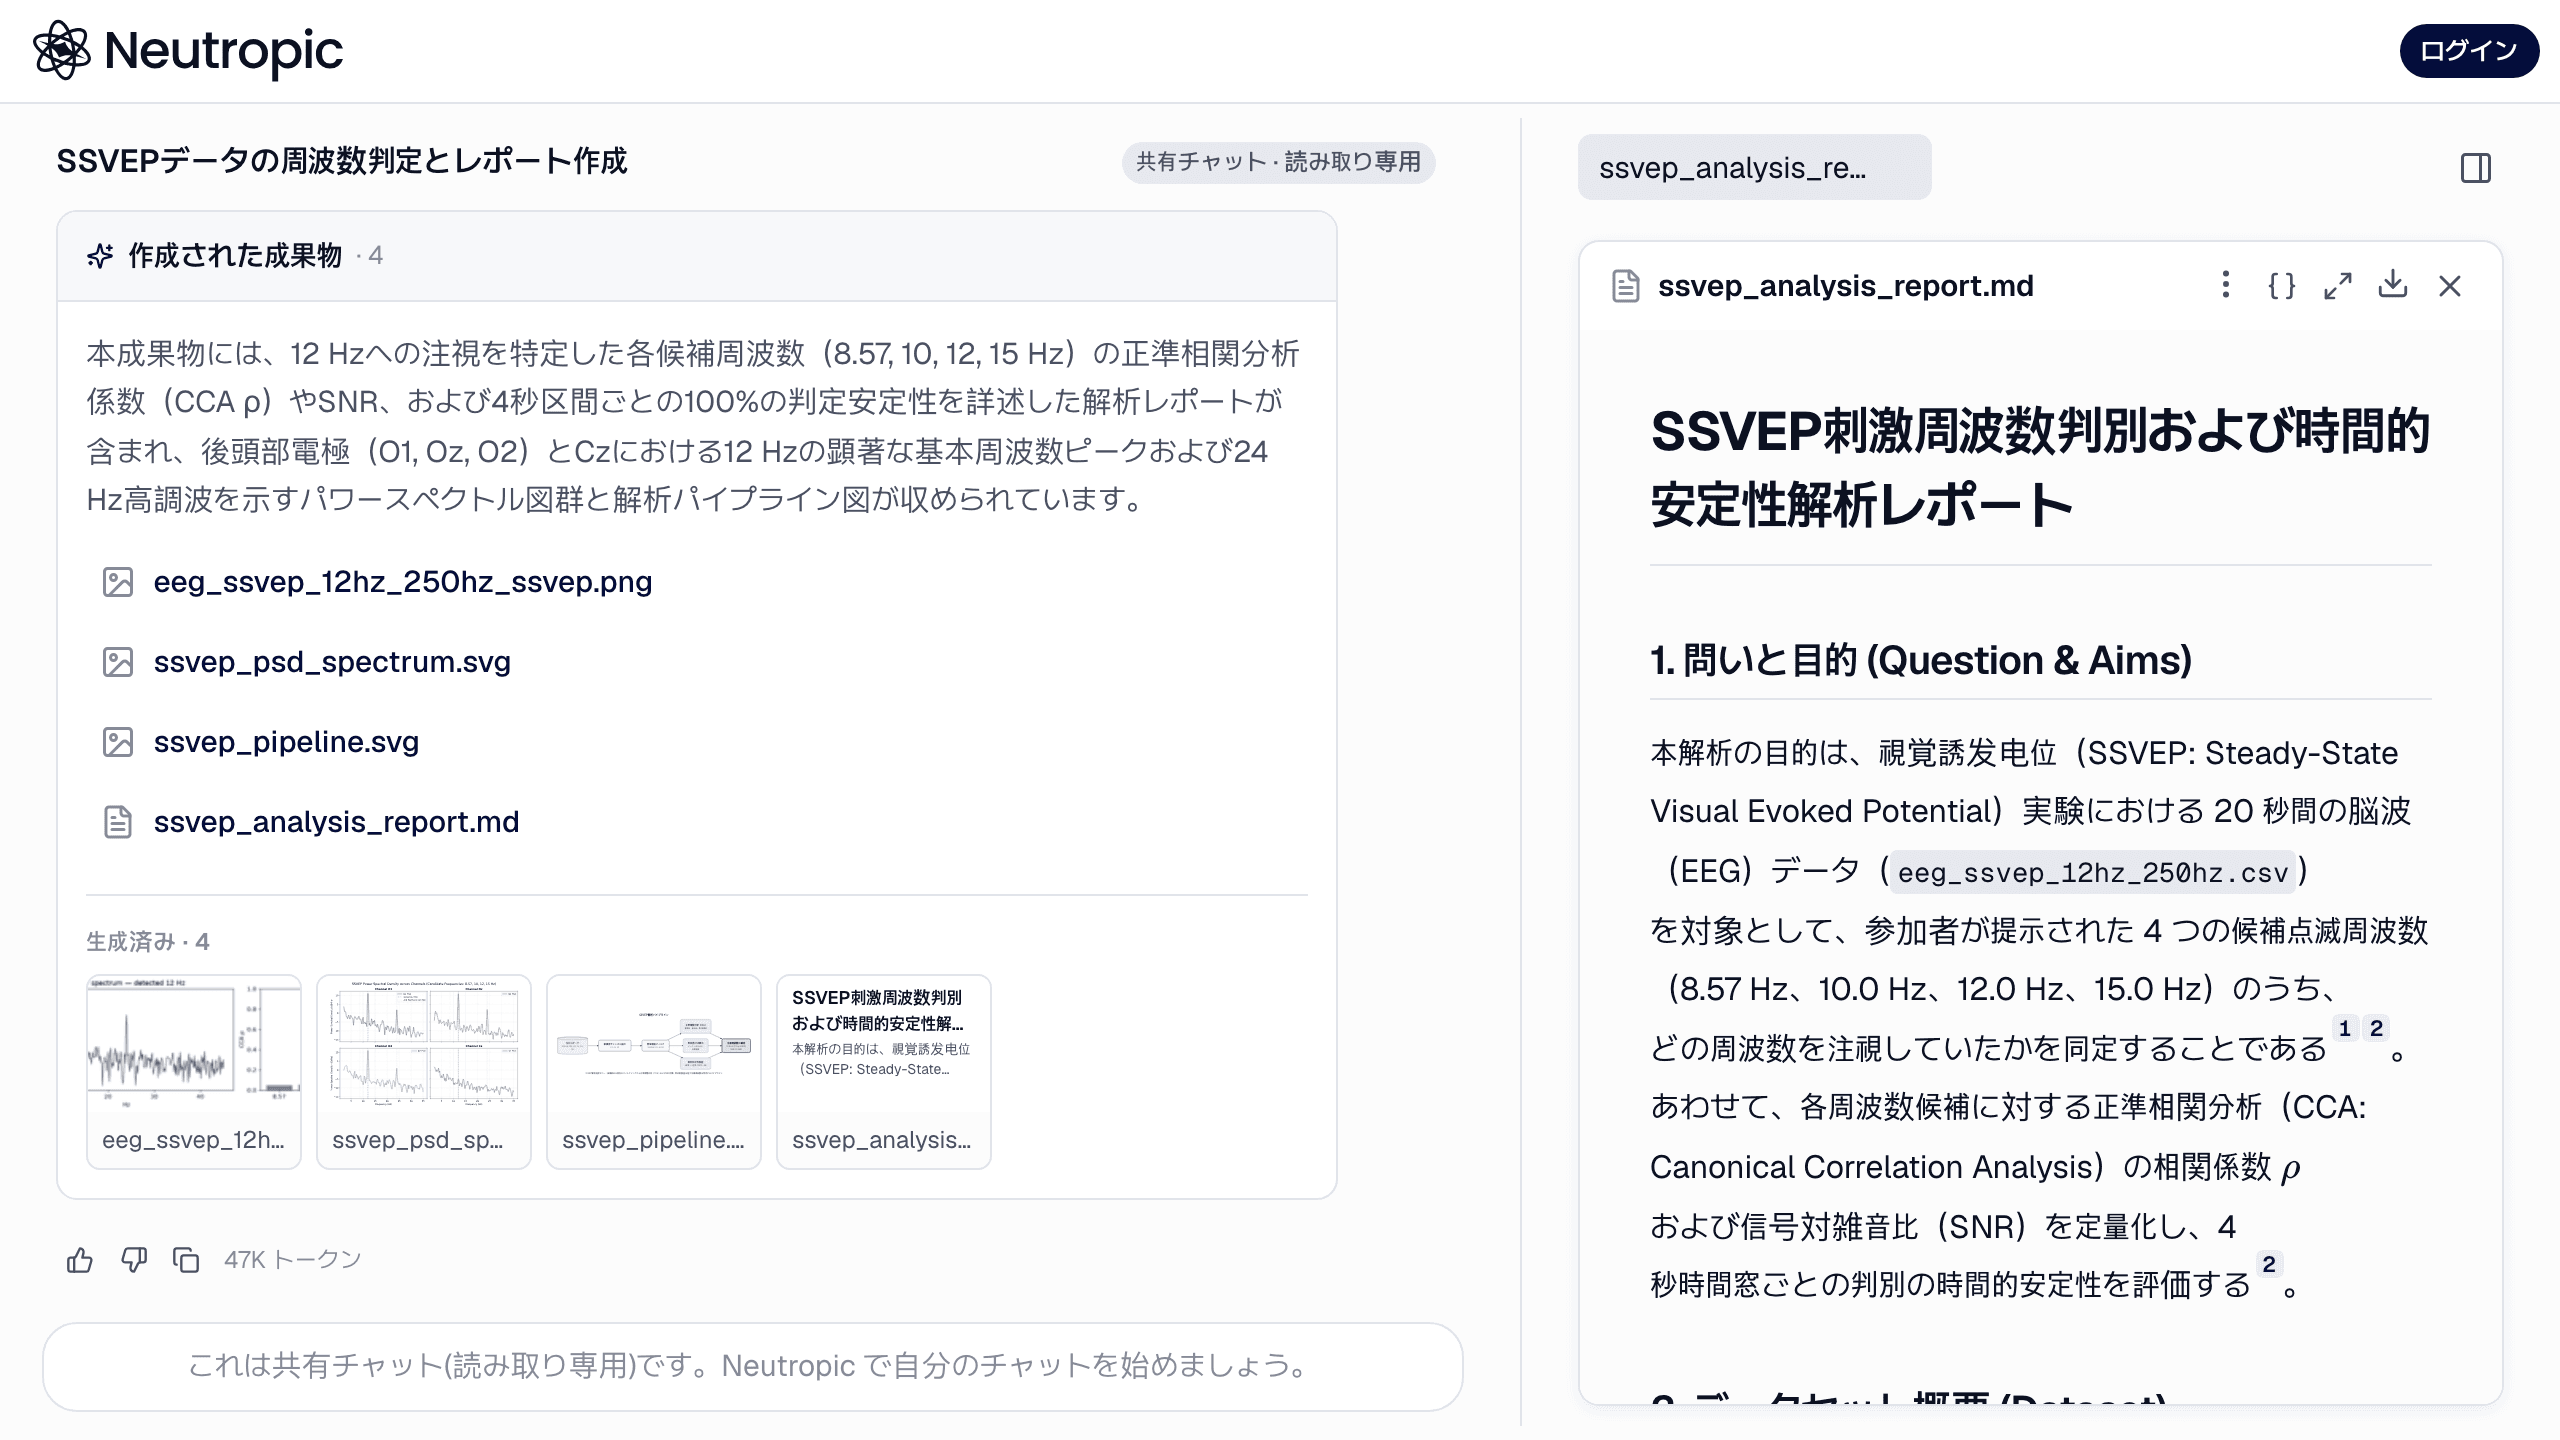
人を対象とする研究のデータは、たいてい整ったスプレッドシートから始まりません。脳波の記録、インタビュー音声のフォルダ、参加者を撮ったウェブカメラ映像、心拍の CSV といった形で始まります。そこから結果にたどり着くまでには、ふつう四つのツールと大量のつなぎコードが必要です。脳波は MNE、音声は Praat、映像は顔トラッキングのライブラリ、統計は R か SPSS で扱います。受け渡しのたびに、フィルタ設定やファイルのバージョンを見失うおそれがあります。
Neutropic はこれらの信号を、研究を計画し論文を書くのと同じワークスペースで直接解析します。測定値を出すのは決定的なツールで、言語モデルが数字を推測するわけではありません。以下のスクリーンショットは、どのアカウントでも開けるサンプルプロジェクトのセッションから撮ったものです。正解値がわかっているサンプル記録で実行しています。
脳波(EEG):生のチャンネルから成分まで、七つのツール
記録は表(CSV または XLSX)としてアップロードします。決まりは簡単です。
- 数値の列がそれぞれ一つのチャンネルで、単位は µV です。チャンネル名を 10–20 法(Fp1、Fz、Cz、Pz、O1 …)にすると、トポマップと非対称性の指標も付きます。
time_s列があればサンプリングレートを推定します。なければメッセージにレートを書いてください。- 任意の
marker列でイベントを示します。0 はイベントなし、正の整数は条件コードです。
するとデータ分析スキルが脳波ツールを順につなぎます。質問に必要なツールだけを選び、各ステップをチャットに表示します。
- eeg_info:チャンネル、サンプリングレート、イベント、電源ノイズを報告します。
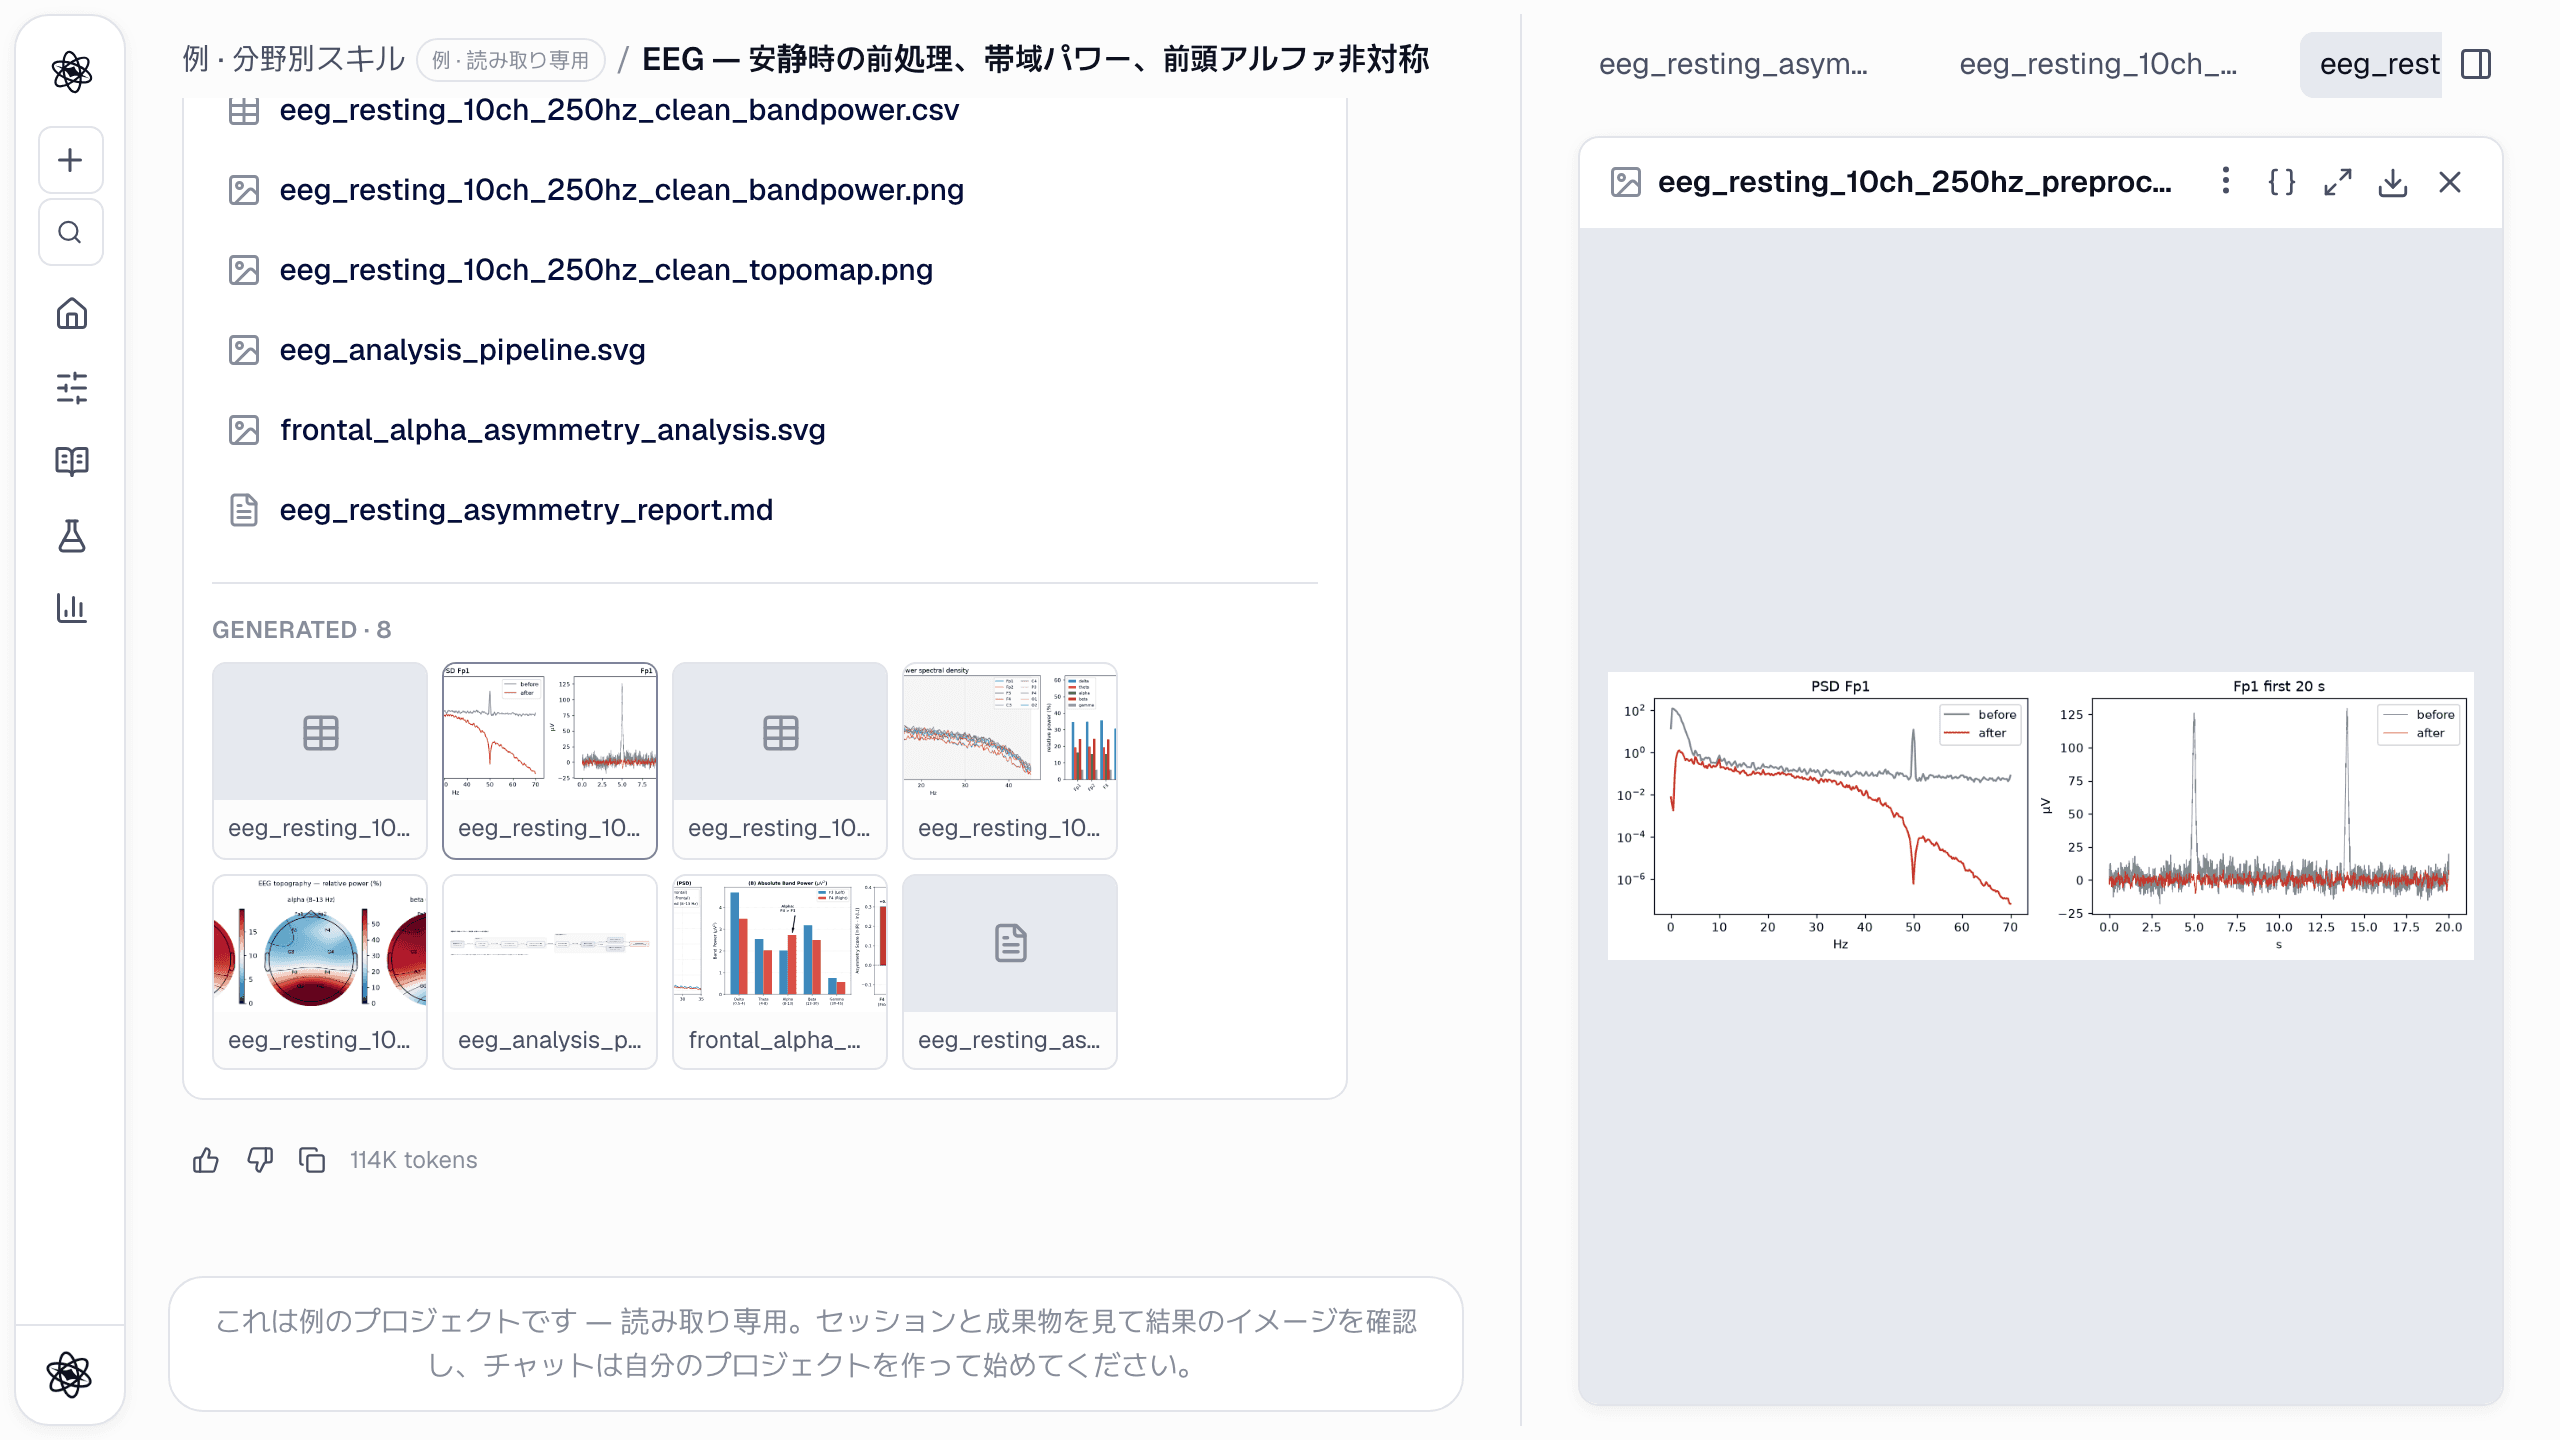
- eeg_preprocess:50/60 Hz ノッチを自動でかけ、1–40 Hz のバンドパスを通します。平均再参照は任意です。FastICA で瞬目を除去し、不良区間に印を付け、次のステップで使うクリーニング済み CSV を保存します。
- eeg_bandpower:チャンネルごとの Welch 帯域パワー、個人アルファピーク、theta/beta 比、半球間非対称性を計算します。
- eeg_topomap:帯域ごとの頭皮分布を描きます。
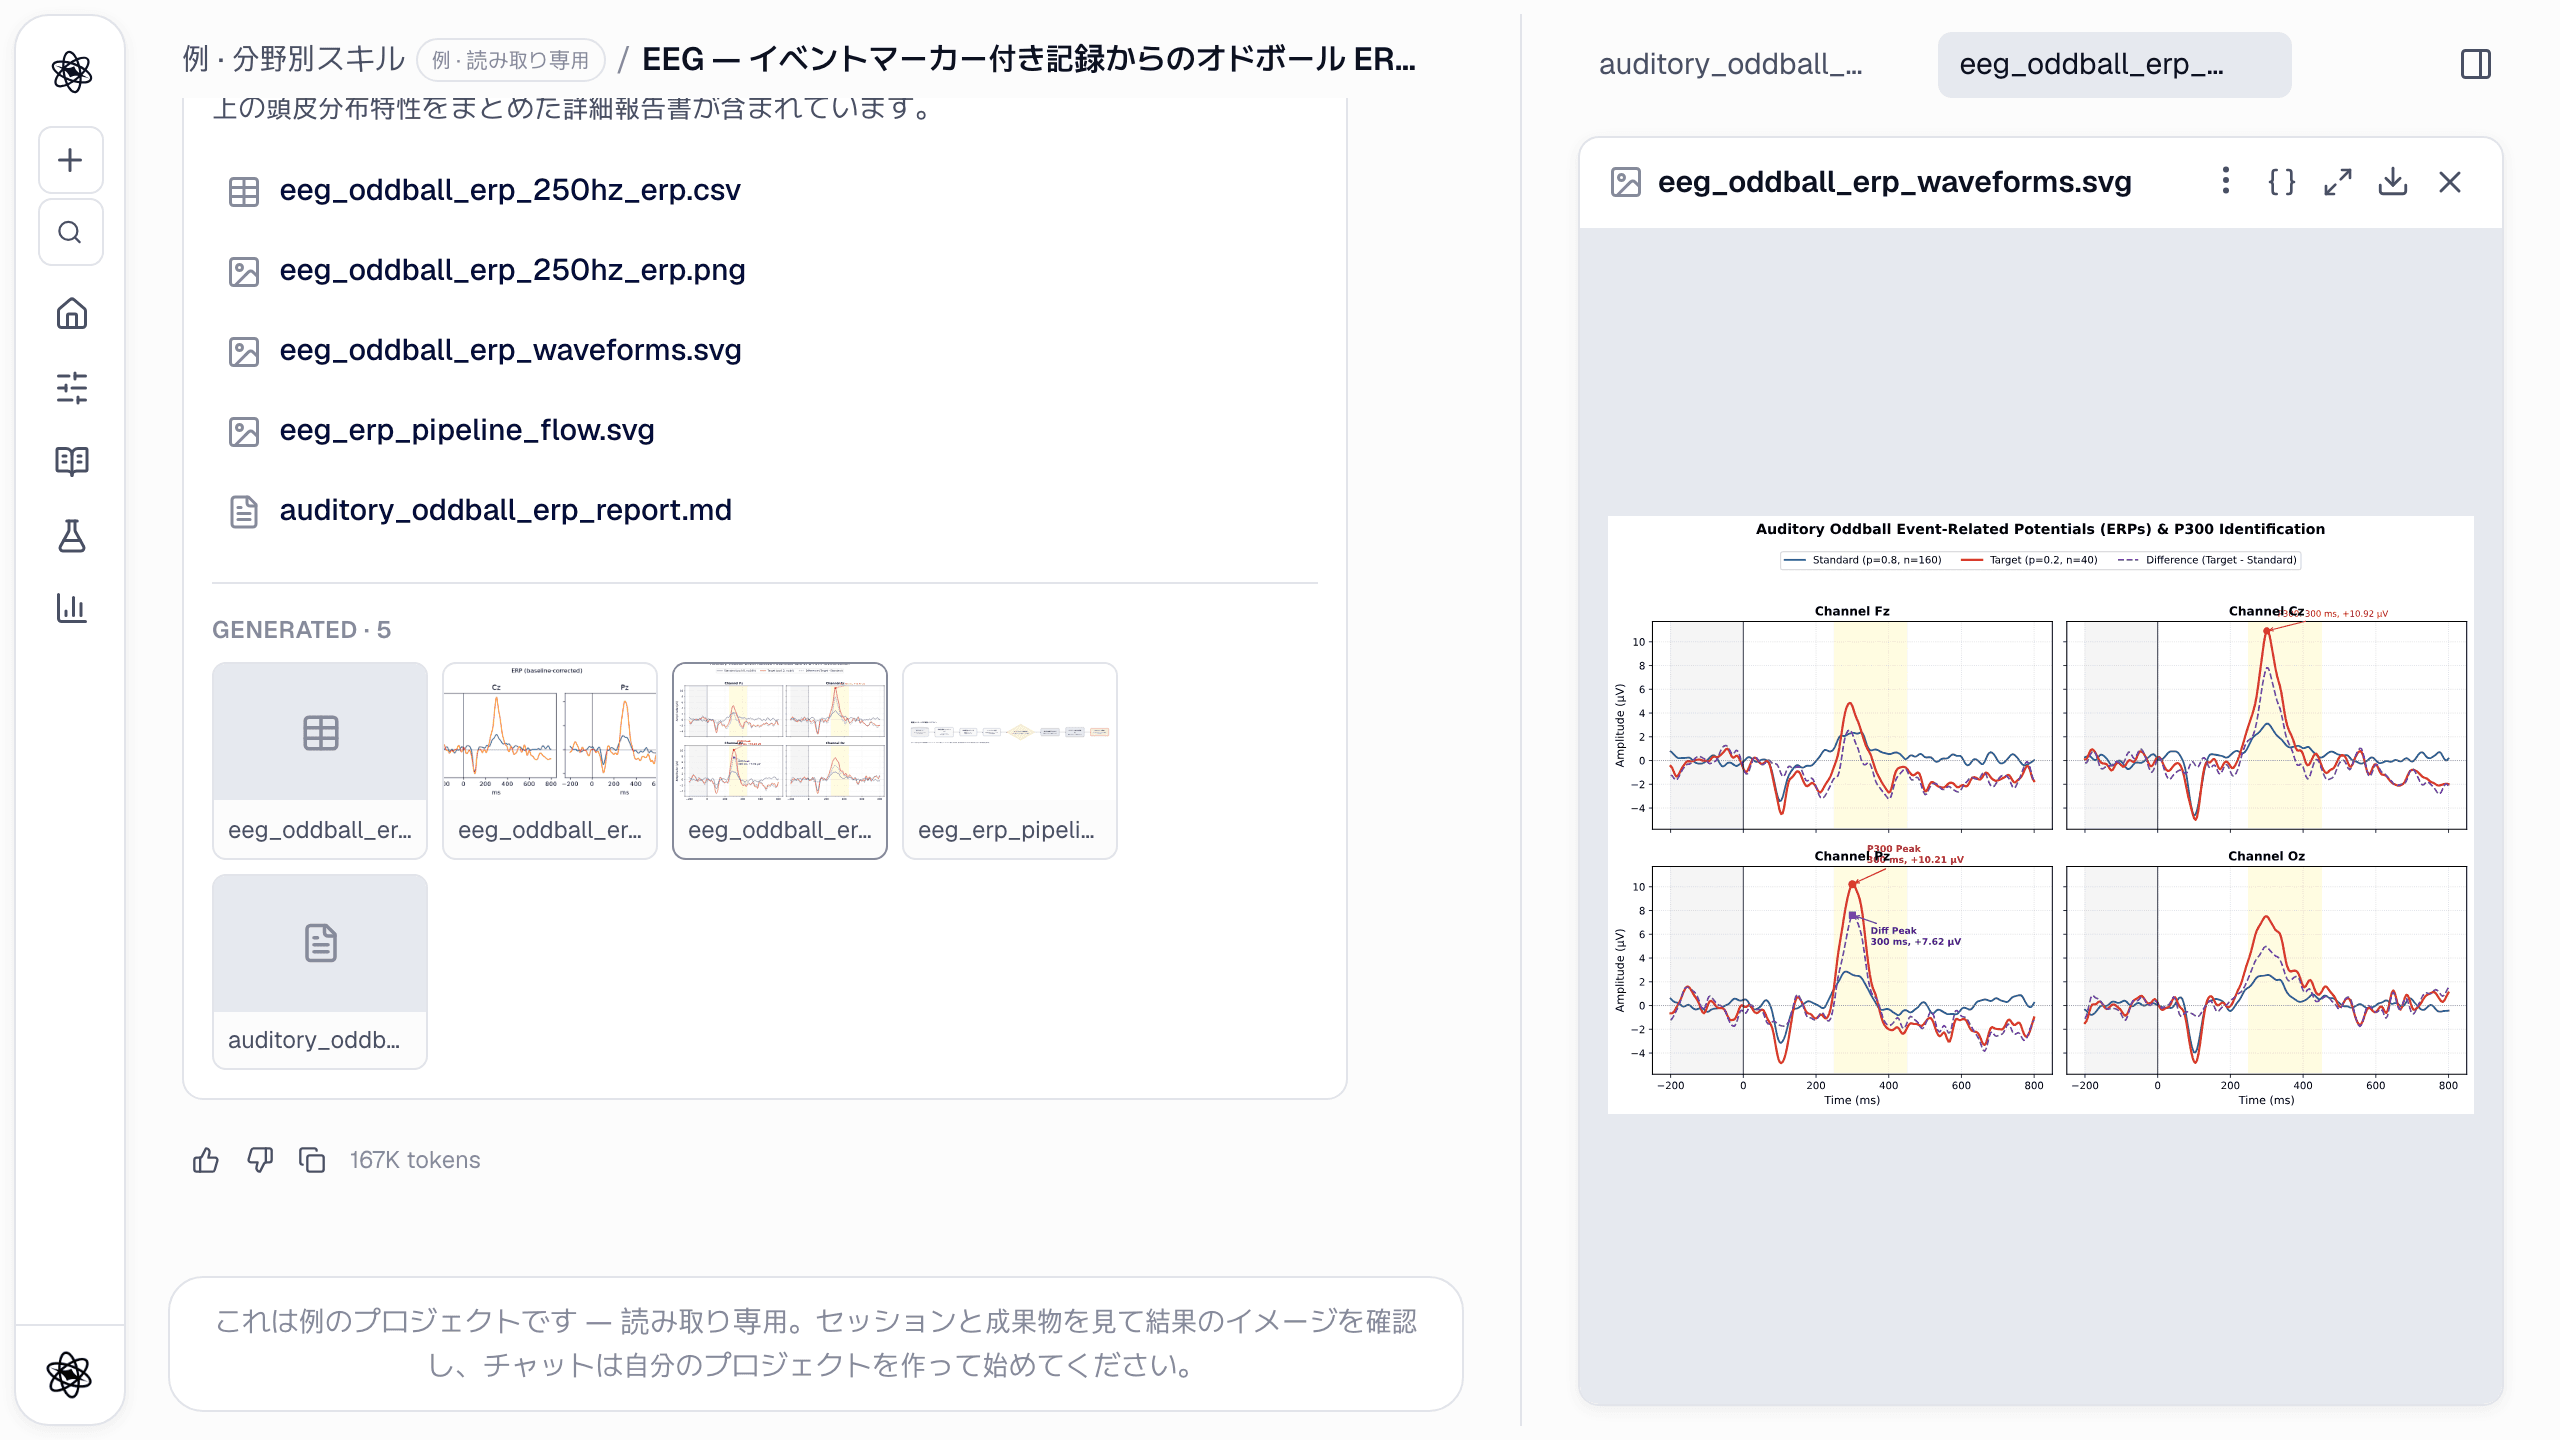
- eeg_erp:エポック化、ベースライン補正、試行の棄却、条件ごとの加算平均を行います。N1/P2/N2/P3 の潜時と振幅、差分波、SNR も出します。
- eeg_erders:課題に関連したパワー変化を % で計算します。ERD の最小値、ERS の最大値、C3/C4 の側性化も出します。
- eeg_ssvep:CCA ρ と PSD SNR で刺激周波数を検出します。勝者だけでなく、すべての候補周波数の値を報告します。
/analyze eeg_oddball_erp_250hz.csv は聴覚オドボール課題の記録です(250 Hz、Fz・Cz・Pz・Oz、marker 1 = 標準、2 = 標的)。marker でエポック化して条件ごとに加算平均し、チャンネルごとの N1・P3 の潜時と振幅、標的−標準の差分波を図付きで報告してください。
安静時の記録なら、同じ形の依頼で前処理、帯域パワー、トポグラフィーへと進みます。前処理は何を取り除いたかを示すので、クリーニングを自分で確かめられます。
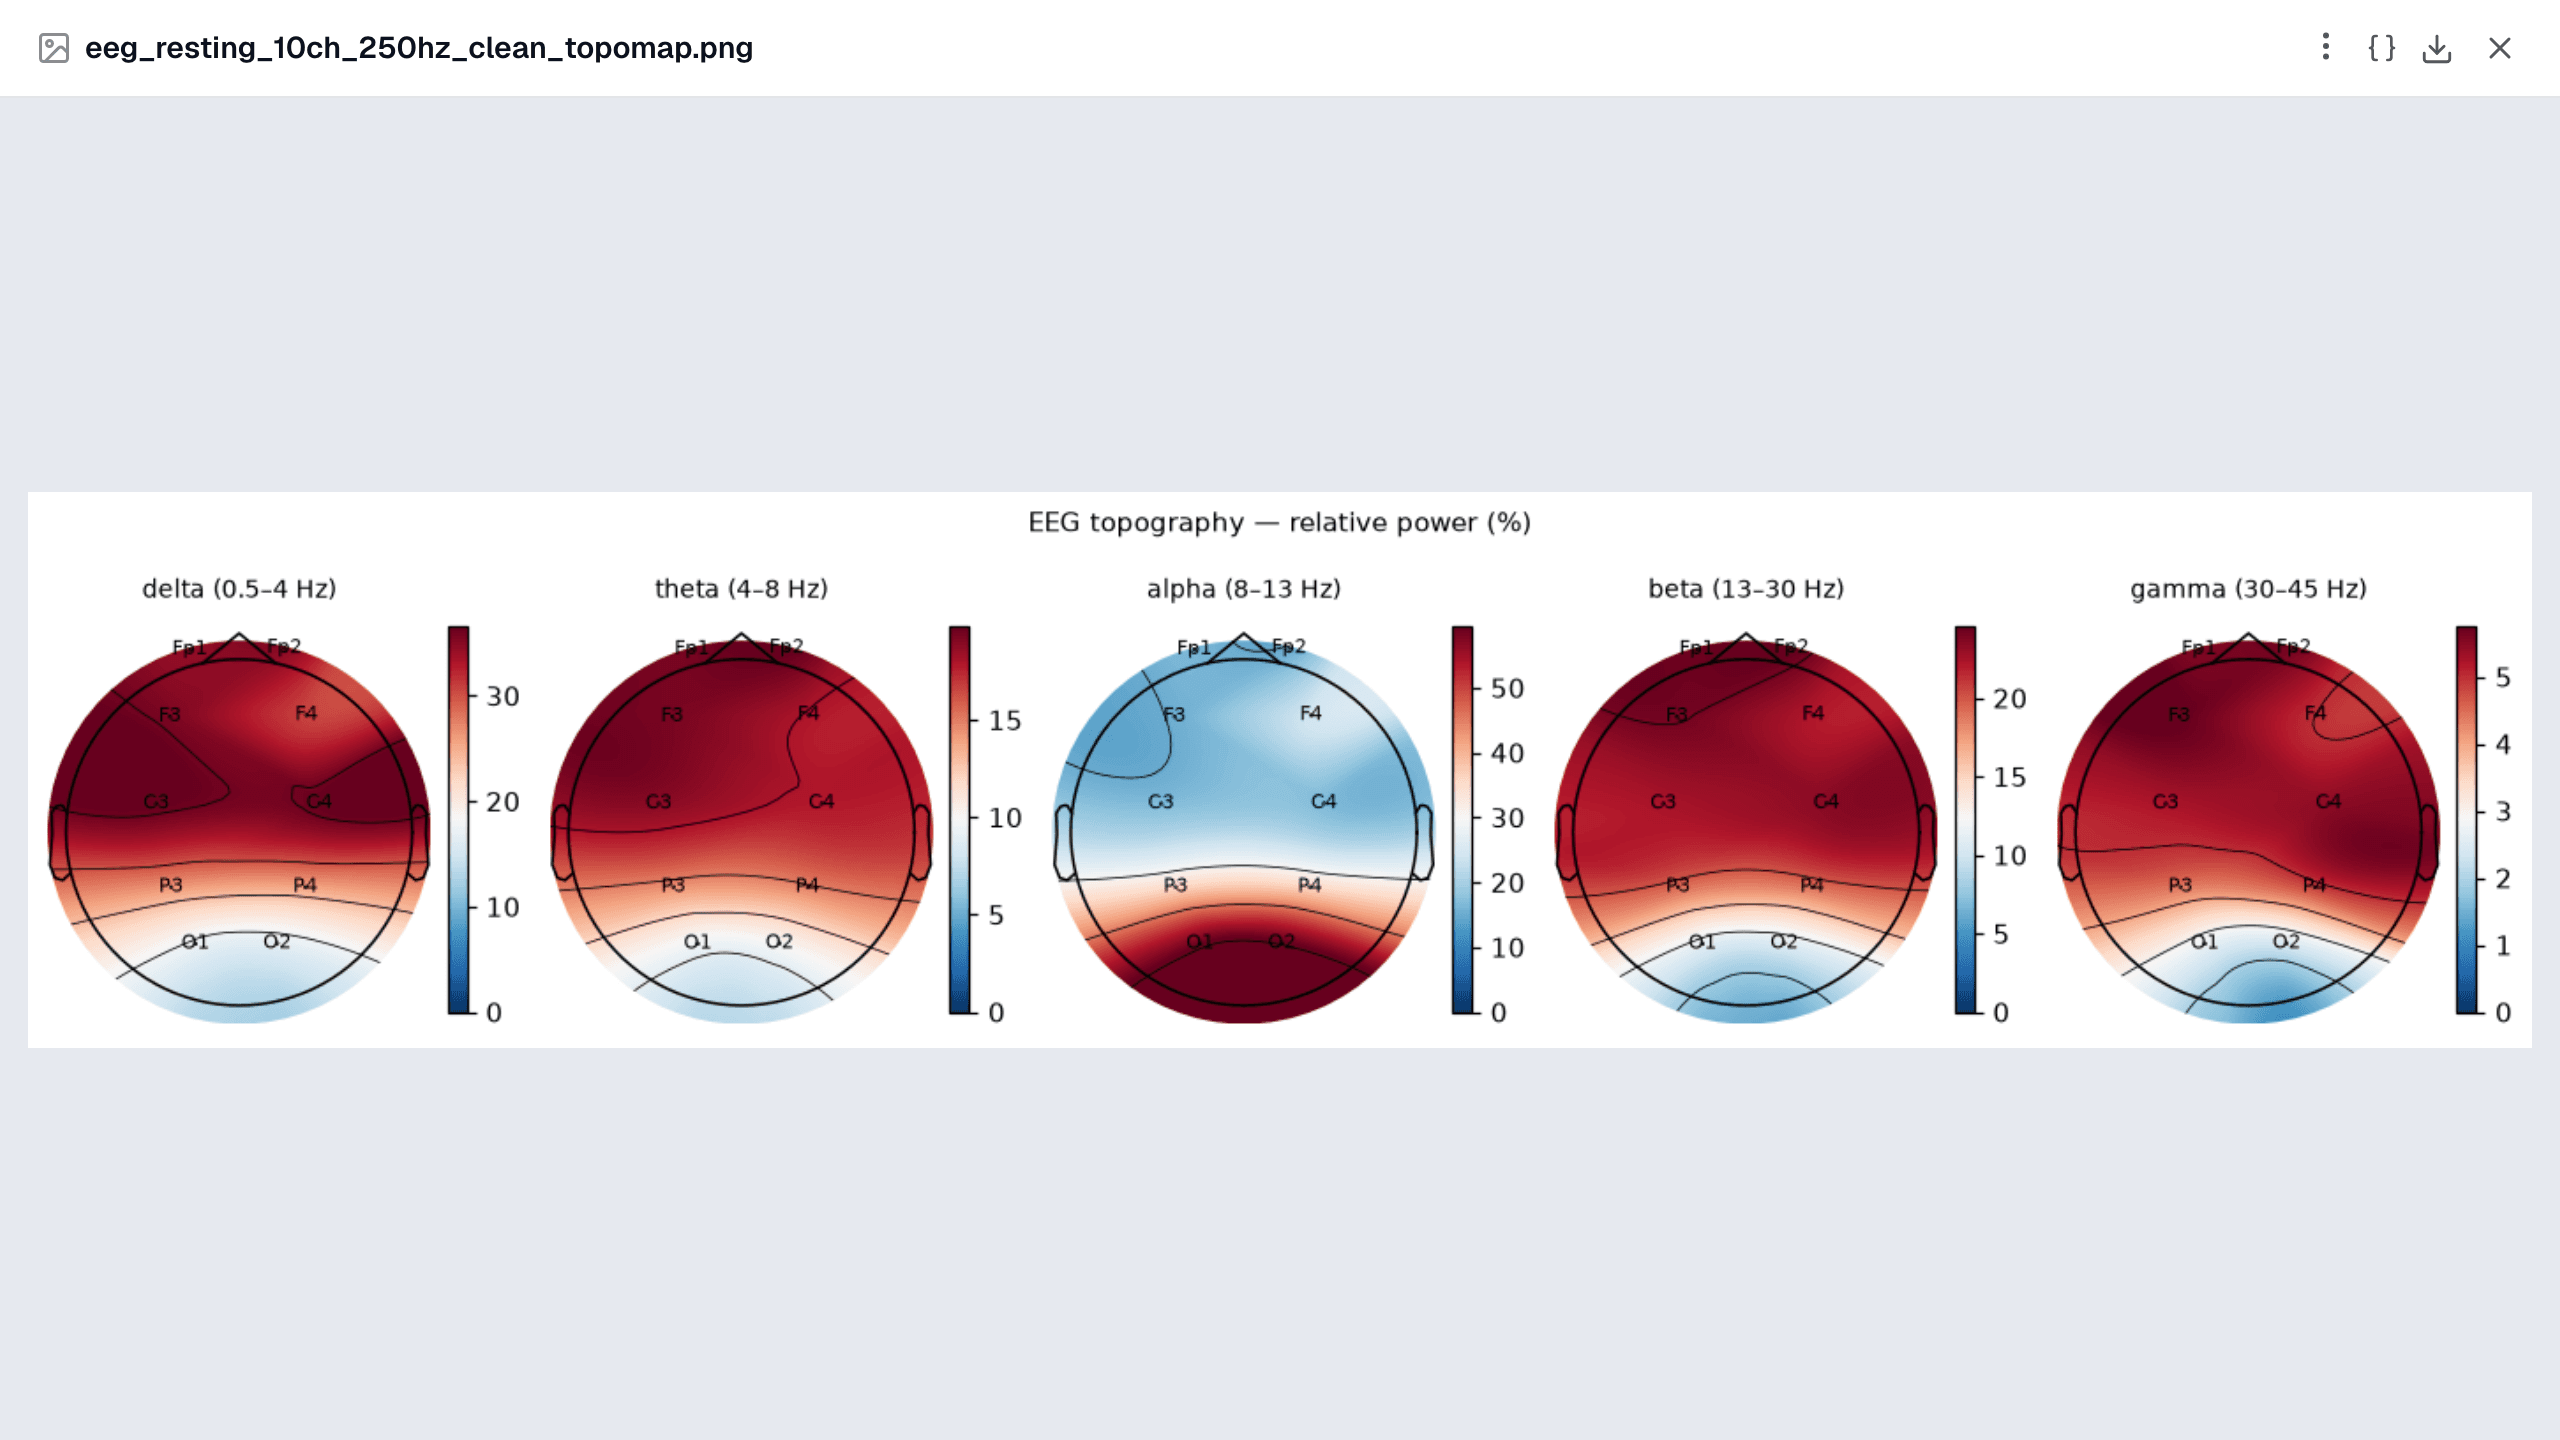
前頭アルファ非対称性の値は参照方式によって変わります。そのためエージェントは非対称性の値ごとに参照方式を明記し、1 回の安静時記録から性格特性を読み取ることはしません。
音声:文字起こしと音声特徴をローカルで
WAV、MP3、M4A、FLAC、OGG、AAC をアップロードできます。音声トラックのある動画も使えます。
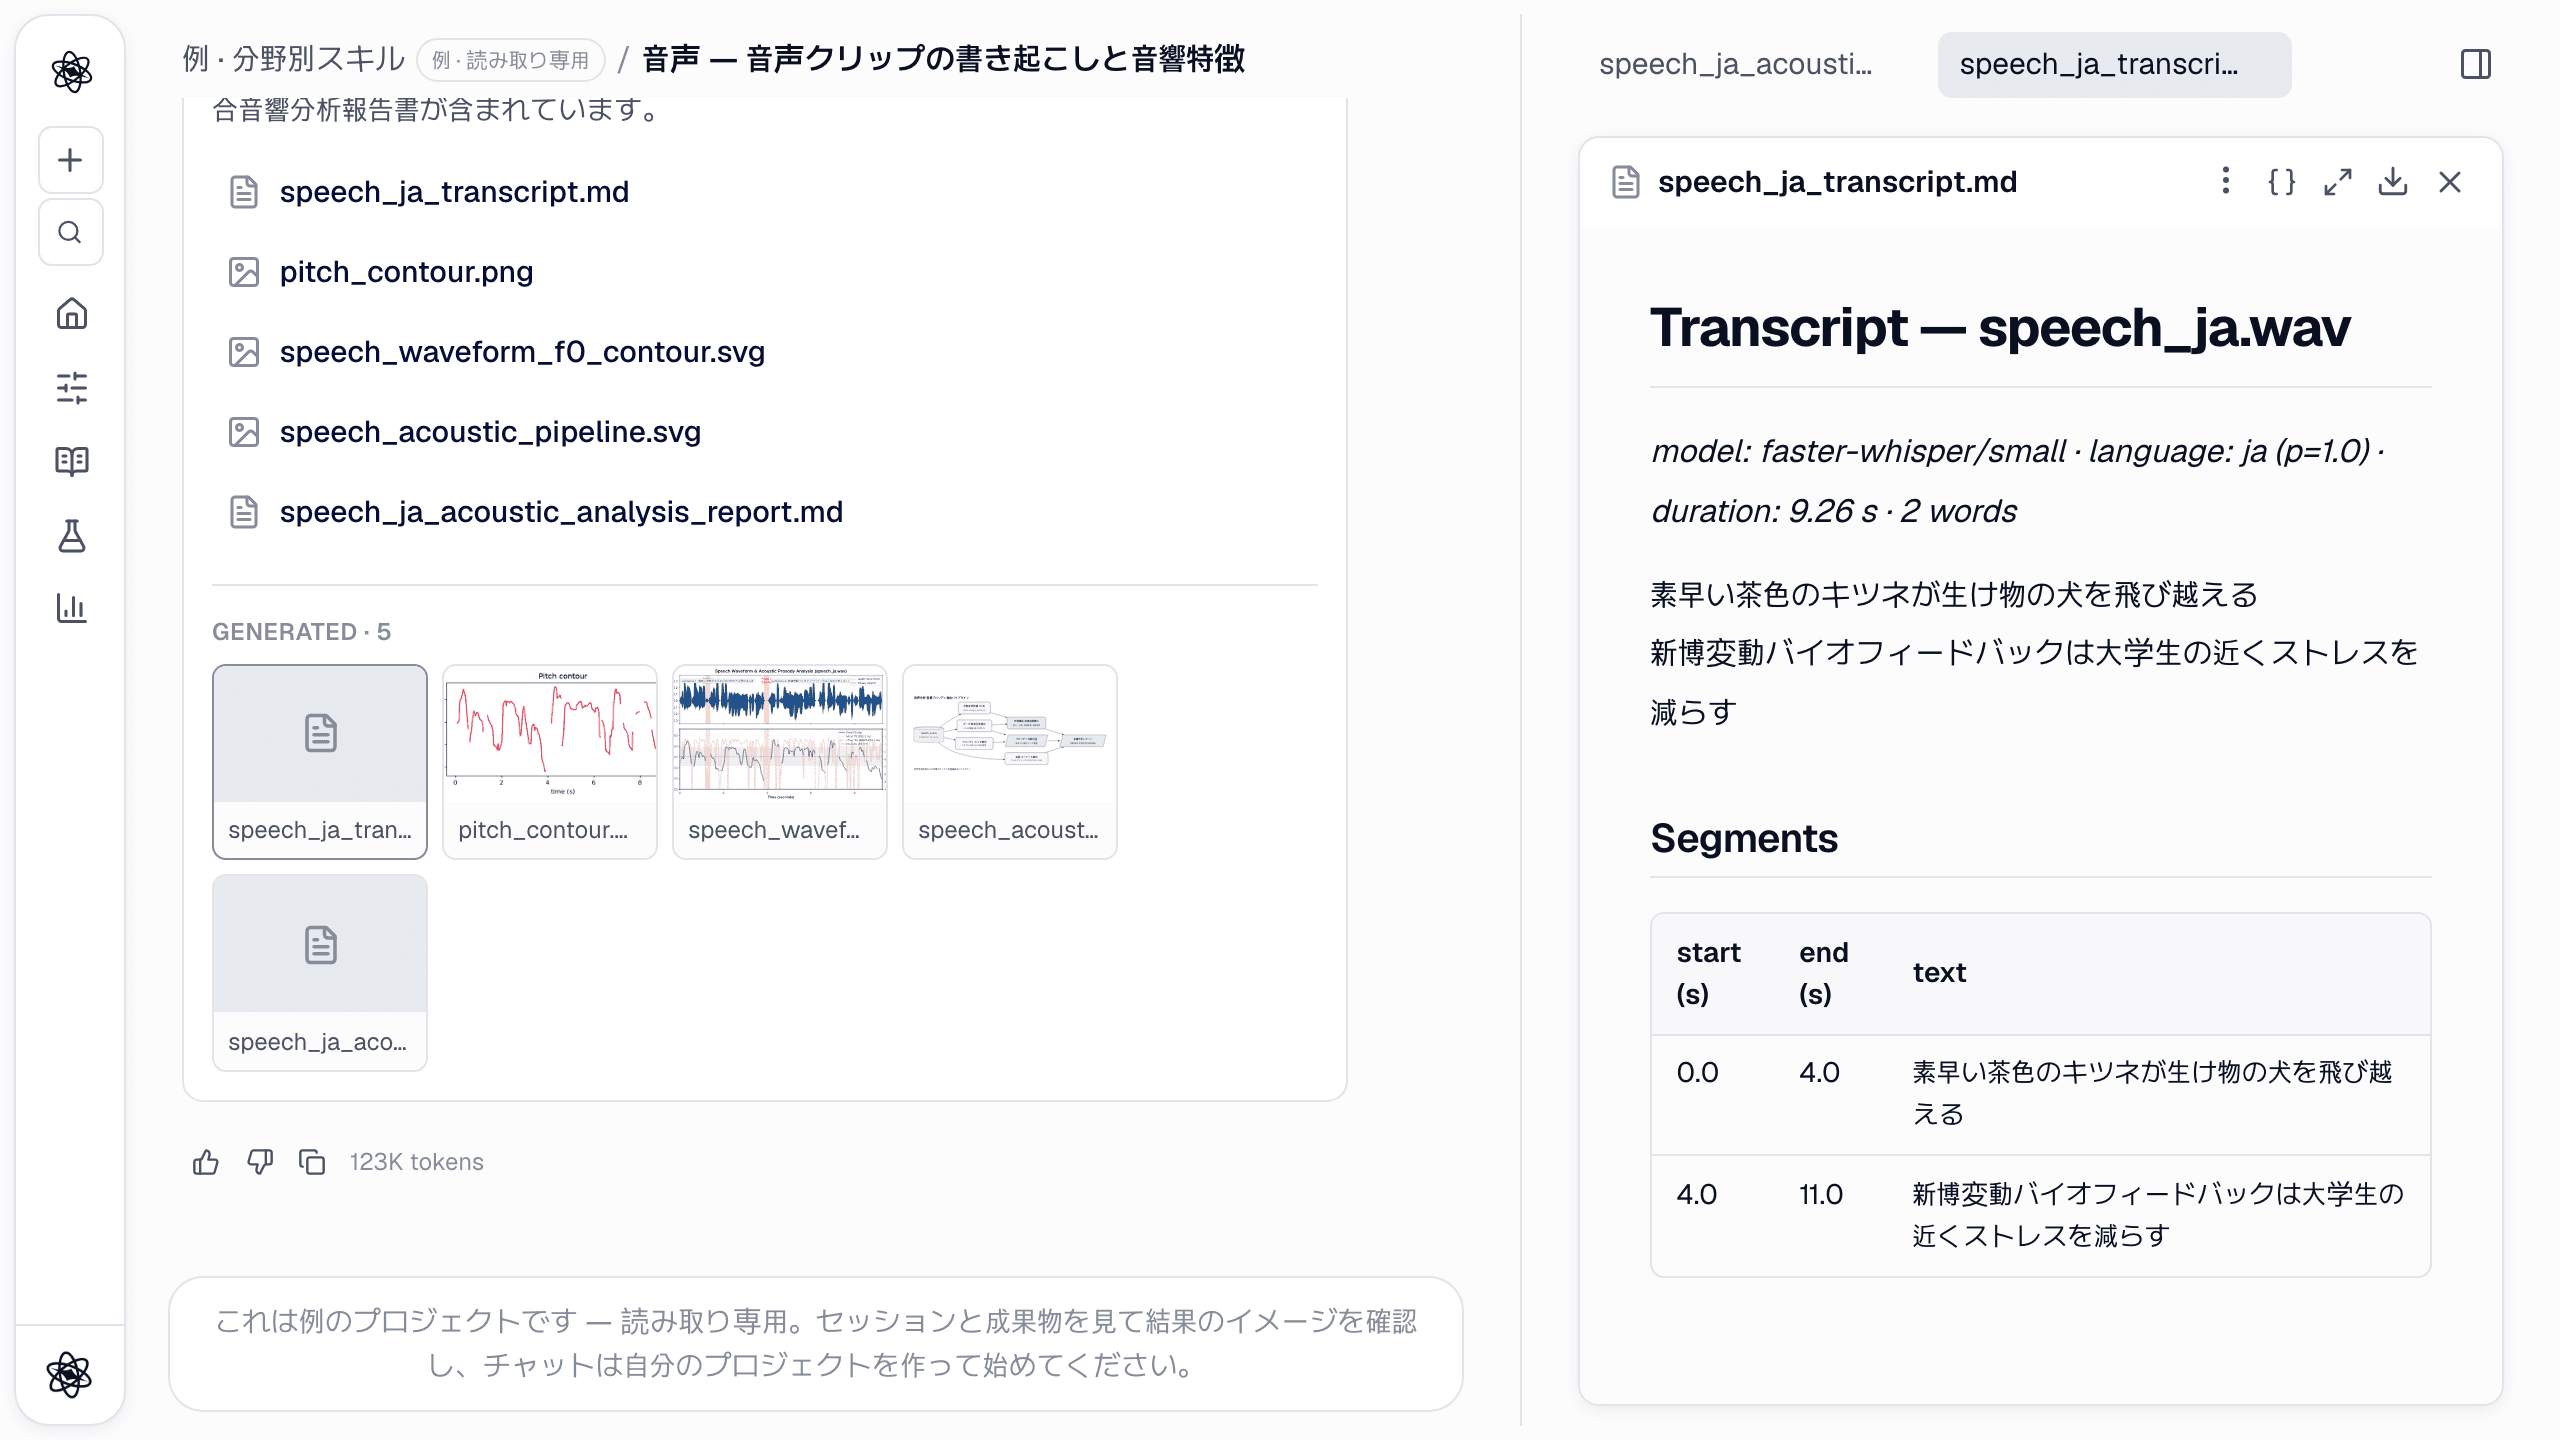
- 音声の文字起こしは faster-whisper でローカルに実行します。音声が外部の文字起こしサービスに送られることはありません。タイムスタンプ付きの区間、検出した言語とその確率、語数、発話速度を返します。
- 音声・音響特徴として、F0(平均、範囲、輪郭)、強度、jitter、shimmer、HNR、フォルマント F1–F3、MFCC を計算します。
/analyze speech_ja.wav を文字起こしし、音響特徴を抽出してください:ピッチ輪郭、強度、jitter/shimmer/HNR、フォルマント、発話速度。レポートにまとめてください。
動画と画像:顔から表情、姿勢、心拍まで
MP4、MOV、WebM、AVI、MKV の動画や静止画をアップロードできます。
- 表情ツールは顔の動作単位(AU01、AU06、AU12、AU25 …)を時間に沿って追跡し、EMFACS の感情ラベルと頭部姿勢も出します。
- 姿勢ツールは 33 個の身体ランドマークから関節角度、姿勢、動きを求めます。
- rPPG は顔の肌色のわずかな変化から心拍数を推定します。公開されている三つのアルゴリズム(POS、CHROM、GREEN)をすべて実行し、それぞれの SNR を報告します。手法どうしで結果が食い違えばすぐにわかります。
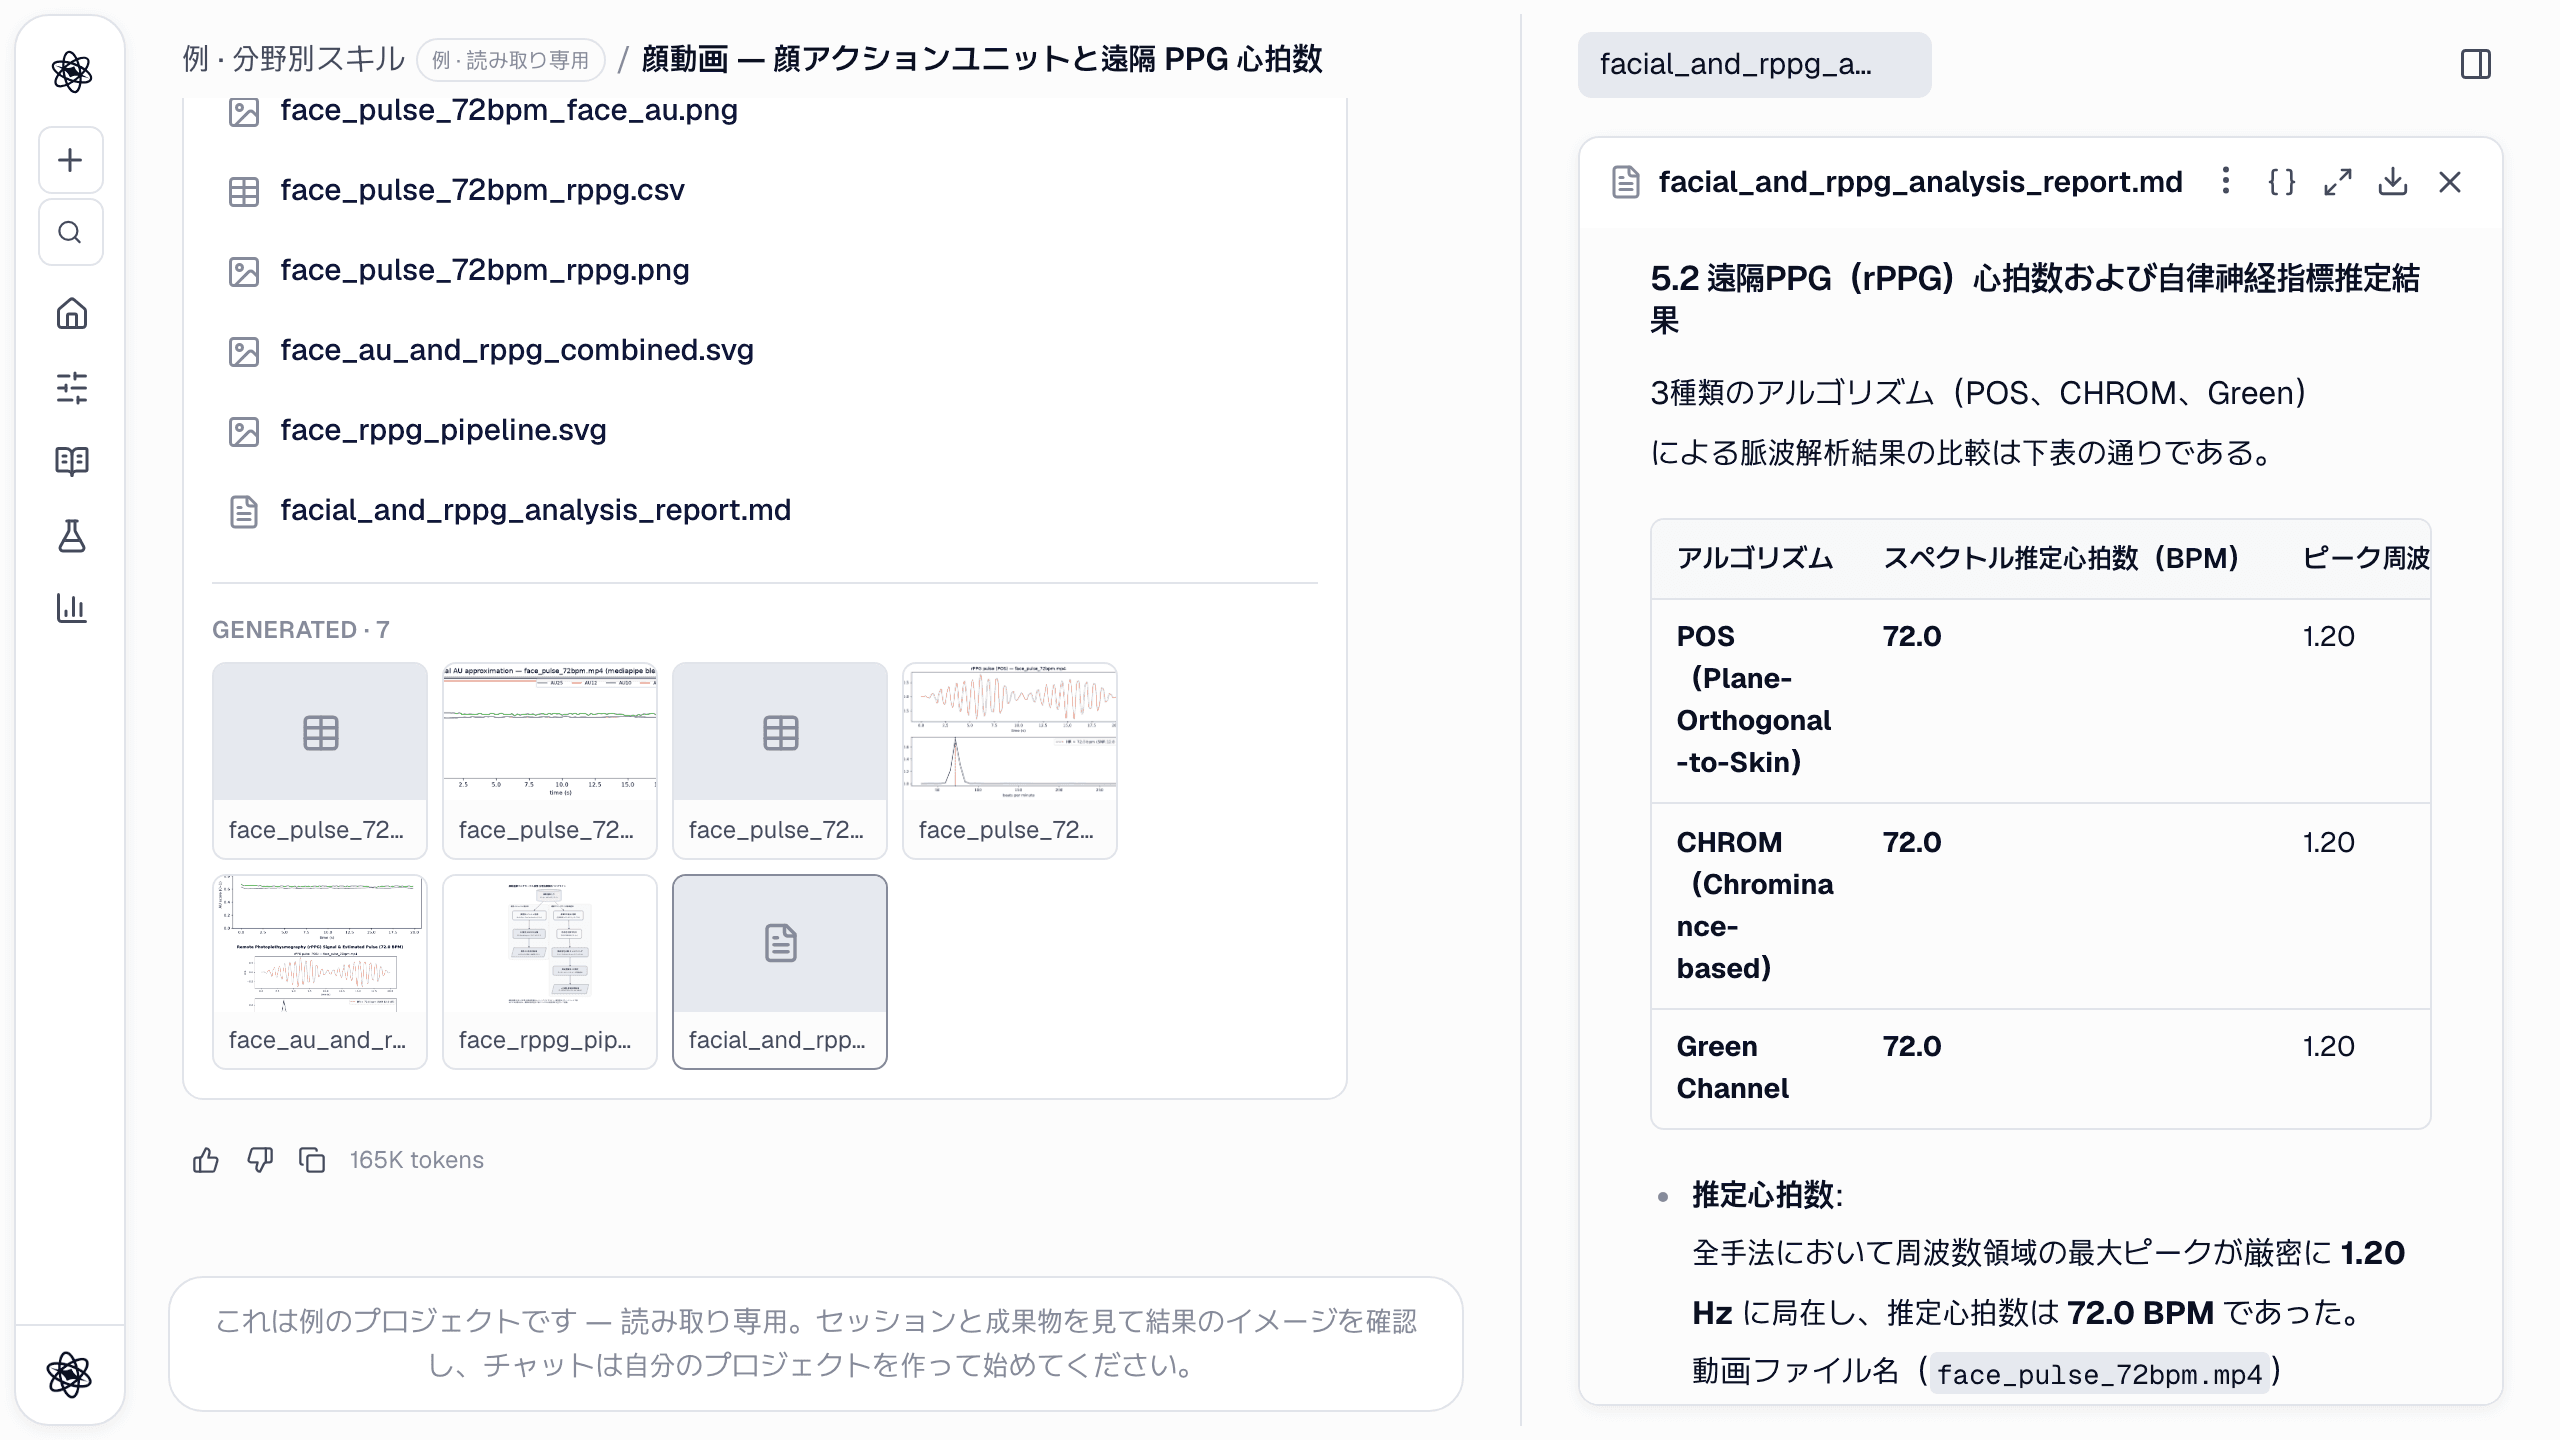
AU の時系列や脈波スペクトルを含む顔動画パイプラインの全体は、精神生理学ラボのための Neutropic で順を追って紹介しています。
生体信号の CSV
ECG、PPG、EDA、呼吸、RR 間隔のエクスポートも表です。ECG や PPG からの心拍数、EDA からの SCR 数と皮膚コンダクタンス水準、呼吸数、時間領域・周波数領域の HRV(平均 RR、SDNN、RMSSD、pNN50)を依頼できます。HRV と EDA には専用ツールがあります。図(たとえばタコグラム)とレポートが返り、レポートには記録の長さに関する注意点が付きます。
そして統計へ:理由とともに選ばれる検定
特徴の抽出で終わることはまれです。たいていは条件や群を比較する必要があります。統計スキルの compare_groups ツールは、デザインとデータから検定を選び、選んだ理由を判断の記録(decision trace)として返します。
- デザインを特定します。独立か対応ありか、2 群か多群か、1 標本かを見ます。
- 前提を確認します。群ごとの Shapiro–Wilk、Levene、反復測定なら Mauchly を確かめます。
- 規則に沿って検定を選びます。小標本(n < 50)で正規性が崩れていればノンパラメトリック検定を使います。分散が等しくなければ Welch を使います。順序尺度の結果には常にノンパラメトリック検定を使います。
- 効果量と信頼区間を報告し、事後検定を実行し、記述統計の表と箱ひげ/ストリップ図を保存します。
選択肢は Student または Welch の t、Mann–Whitney、対応のある t、Wilcoxon、一元配置または Welch の ANOVA(Tukey または Games–Howell)、Kruskal–Wallis、反復測定 ANOVA、Friedman です。分割表は chi_square、二元配置・混合・ANCOVA のデザインは anova_design が扱います。
/stats p3_by_participant.csv の 2 群で Pz の P3 振幅を比較してください。前提を確認して適切な検定を選び、その理由を説明してください。
データが歪んでいて群が小さければ、判断の記録にそのことが書かれます(例:"normality violated … n_min = 18 → non-parametric")。そのうえで、本来使うべきでなかった t 検定ではなく、Mann–Whitney U と順位双列相関の効果量が返ってきます。詳しくはスキルガイド:/statsをご覧ください。
すべての数値をたどれる
- ツール呼び出しごとに名前と引数が記録されます。図と表にはそれを作ったコードが保存され(成果物パネルの { } ボタン)、クリーニングしたデータは元のファイルを上書きせず新しいファイルとして保存されます。
- 解析レポートはツールの出力をもとに書かれます。レポートの文には [n] 引用が付き、それぞれの数値の根拠となった解析ステップやデータファイルを指します。
- 生の信号からクリーニング、特徴、検定、論文執筆までの道のりがすべて一つのセッションに残ります。論文の下書きには /write でそのまま進めます。詳しくはデフォルトで再現可能をご覧ください。
正直な限界
- EEG の入力は表です。EDF/BDF や機器固有の形式は、先に CSV に変換してください。ERP 成分の時間窓は固定です(N1 70–150 ms、P3 250–600 ms)。瞬目除去には前頭チャンネルが必要で、独立した EOG チャンネルはまだ使いません。トポマップは 10–20 名が付いたチャンネルだけを描きます。
- rPPG は古典的な手法(POS、CHROM、GREEN)のみです。深層学習の rPPG は含まれず、頭の動きが大きい場合や照明が変わる場合は SNR が下がります。
- 動作単位(AU)は顔ランドマークのブレンドシェイプから近似した 0–1 の値です。OpenFace の強度(0–5)とは尺度が異なり、AU06 も近似値です。
- 姿勢の角度は 2 次元への投影値です。
- 測定値はツールが返した値だけです。エージェントはツールの値をそのまま引用し、ツールにできなかったこと(顔が検出されない、SNR が低すぎる、言語が不確か)ははっきりそう伝えるよう指示されています。
まずサンプルプロジェクトでこれらのセッションを眺めるか、自分の記録を添付して、それが何かを説明してみてください。対応形式とオプションはデータ分析のドキュメントにまとめています。