大多数研究工具只负责一个环节。文献管理器存着论文,统计软件跑检验,绘图工具做图,文字处理器装着初稿,而在它们之间搬运上下文的是做研究的人。每一次交接都是一个出错点:数字重新敲一遍敲错了,引用对不上,图和流程不一致。
这篇文章跟随一项研究在 Neutropic 中走完全程,始终不离开这一个对话:文献调研、假设、实验设计、数据分析、统计、图表与插图、稿件、独立的报告审查、按期刊标准的论文评审,以及一份组会幻灯片。这是真实的会话,不是分镜脚本。你可以自己打开它:我的资料库里的示例 · 研究工作流是一个只读示例项目,每个账户都能浏览,网站的四种语言各跑了一遍。研究问题是:为期四周的心率变异性(HRV)生物反馈训练能否降低大学生的感知压力(PSS-10)。下文引用的数字来自英文会话;其他语言的会话给出了各自的设计和裁决,这本身就在提醒你拿到结果要先读。
逐条提示词的指南在写给研究生的 Neutropic里,这里不再重复。本文看的是每一回合内部发生了什么,更重要的是,从一个回合到下一个回合传递了什么。
会话一览
- 十一个回合,一个对话,一个项目。
- 二十多个产出物:筛选后的文献表、综述报告、三张文献图、带功效曲线和流程图的设计报告、分析报告和三面板结果图、统计报告、研究流程图、带框架图的假设提案、方法插图、稿件、审查报告、论文评审报告,以及 17 页幻灯片。
- 总计约 210 万托管令牌,Basic 投入档。每个回合底部显示自己的用量。
- 后一回合需要的一切都来自前面的产出物,而不是模型对对话的记忆。这正是本文要讲的设计决定。
一个回合长什么样
每个回合结构相同,值得学会读它,因为这就是你核验工作的地方。
- 计划。 代理写一份简短计划,边做边打勾(
计划 4/4 done)。跳过了哪一项,对话会说明。 - 步骤。 诸如执行了 7 次搜索、执行了 5 个代码步骤、阅读了 2 个页面、验证这样的分组行,展开后能看到查询、代码或读取的文档。
- 已应用本项目其他聊天中确定的 N 项决定。 回合顶部的一个标签,说明开始前加载了项目中已确定的多少条事实。点击可查看。
- 已创建的产出物。 本回合生成的文件,在右侧面板打开。
- 令牌。 本回合消耗的托管令牌。
步骤列表不是装饰。当后面的报告审查回合说它"重新推导了统计量"时,步骤列表里就有它运行的 Python,输出一点即见。
回合 1 — 文献调研
/research 请在论文数据库(OpenAlex、PubMed、Crossref、Semantic Scholar、Europe PMC)和网络上调研以下主题,并整理研究时间线、关键发现、里程碑研究和未来方向:心率变异性(HRV)生物反馈能否降低成年人的感知压力? 聚焦随机对照试验并报告效应量。
第一回合是给会话备料的回合。代理在论文数据库和网络上搜索了七次,读了最佳命中背后的页面,重读已取回的结果以提取证据,然后才动笔。步骤列表为每条查询标注了结果数,所以检索策略是可以看见的,而不是靠信任。
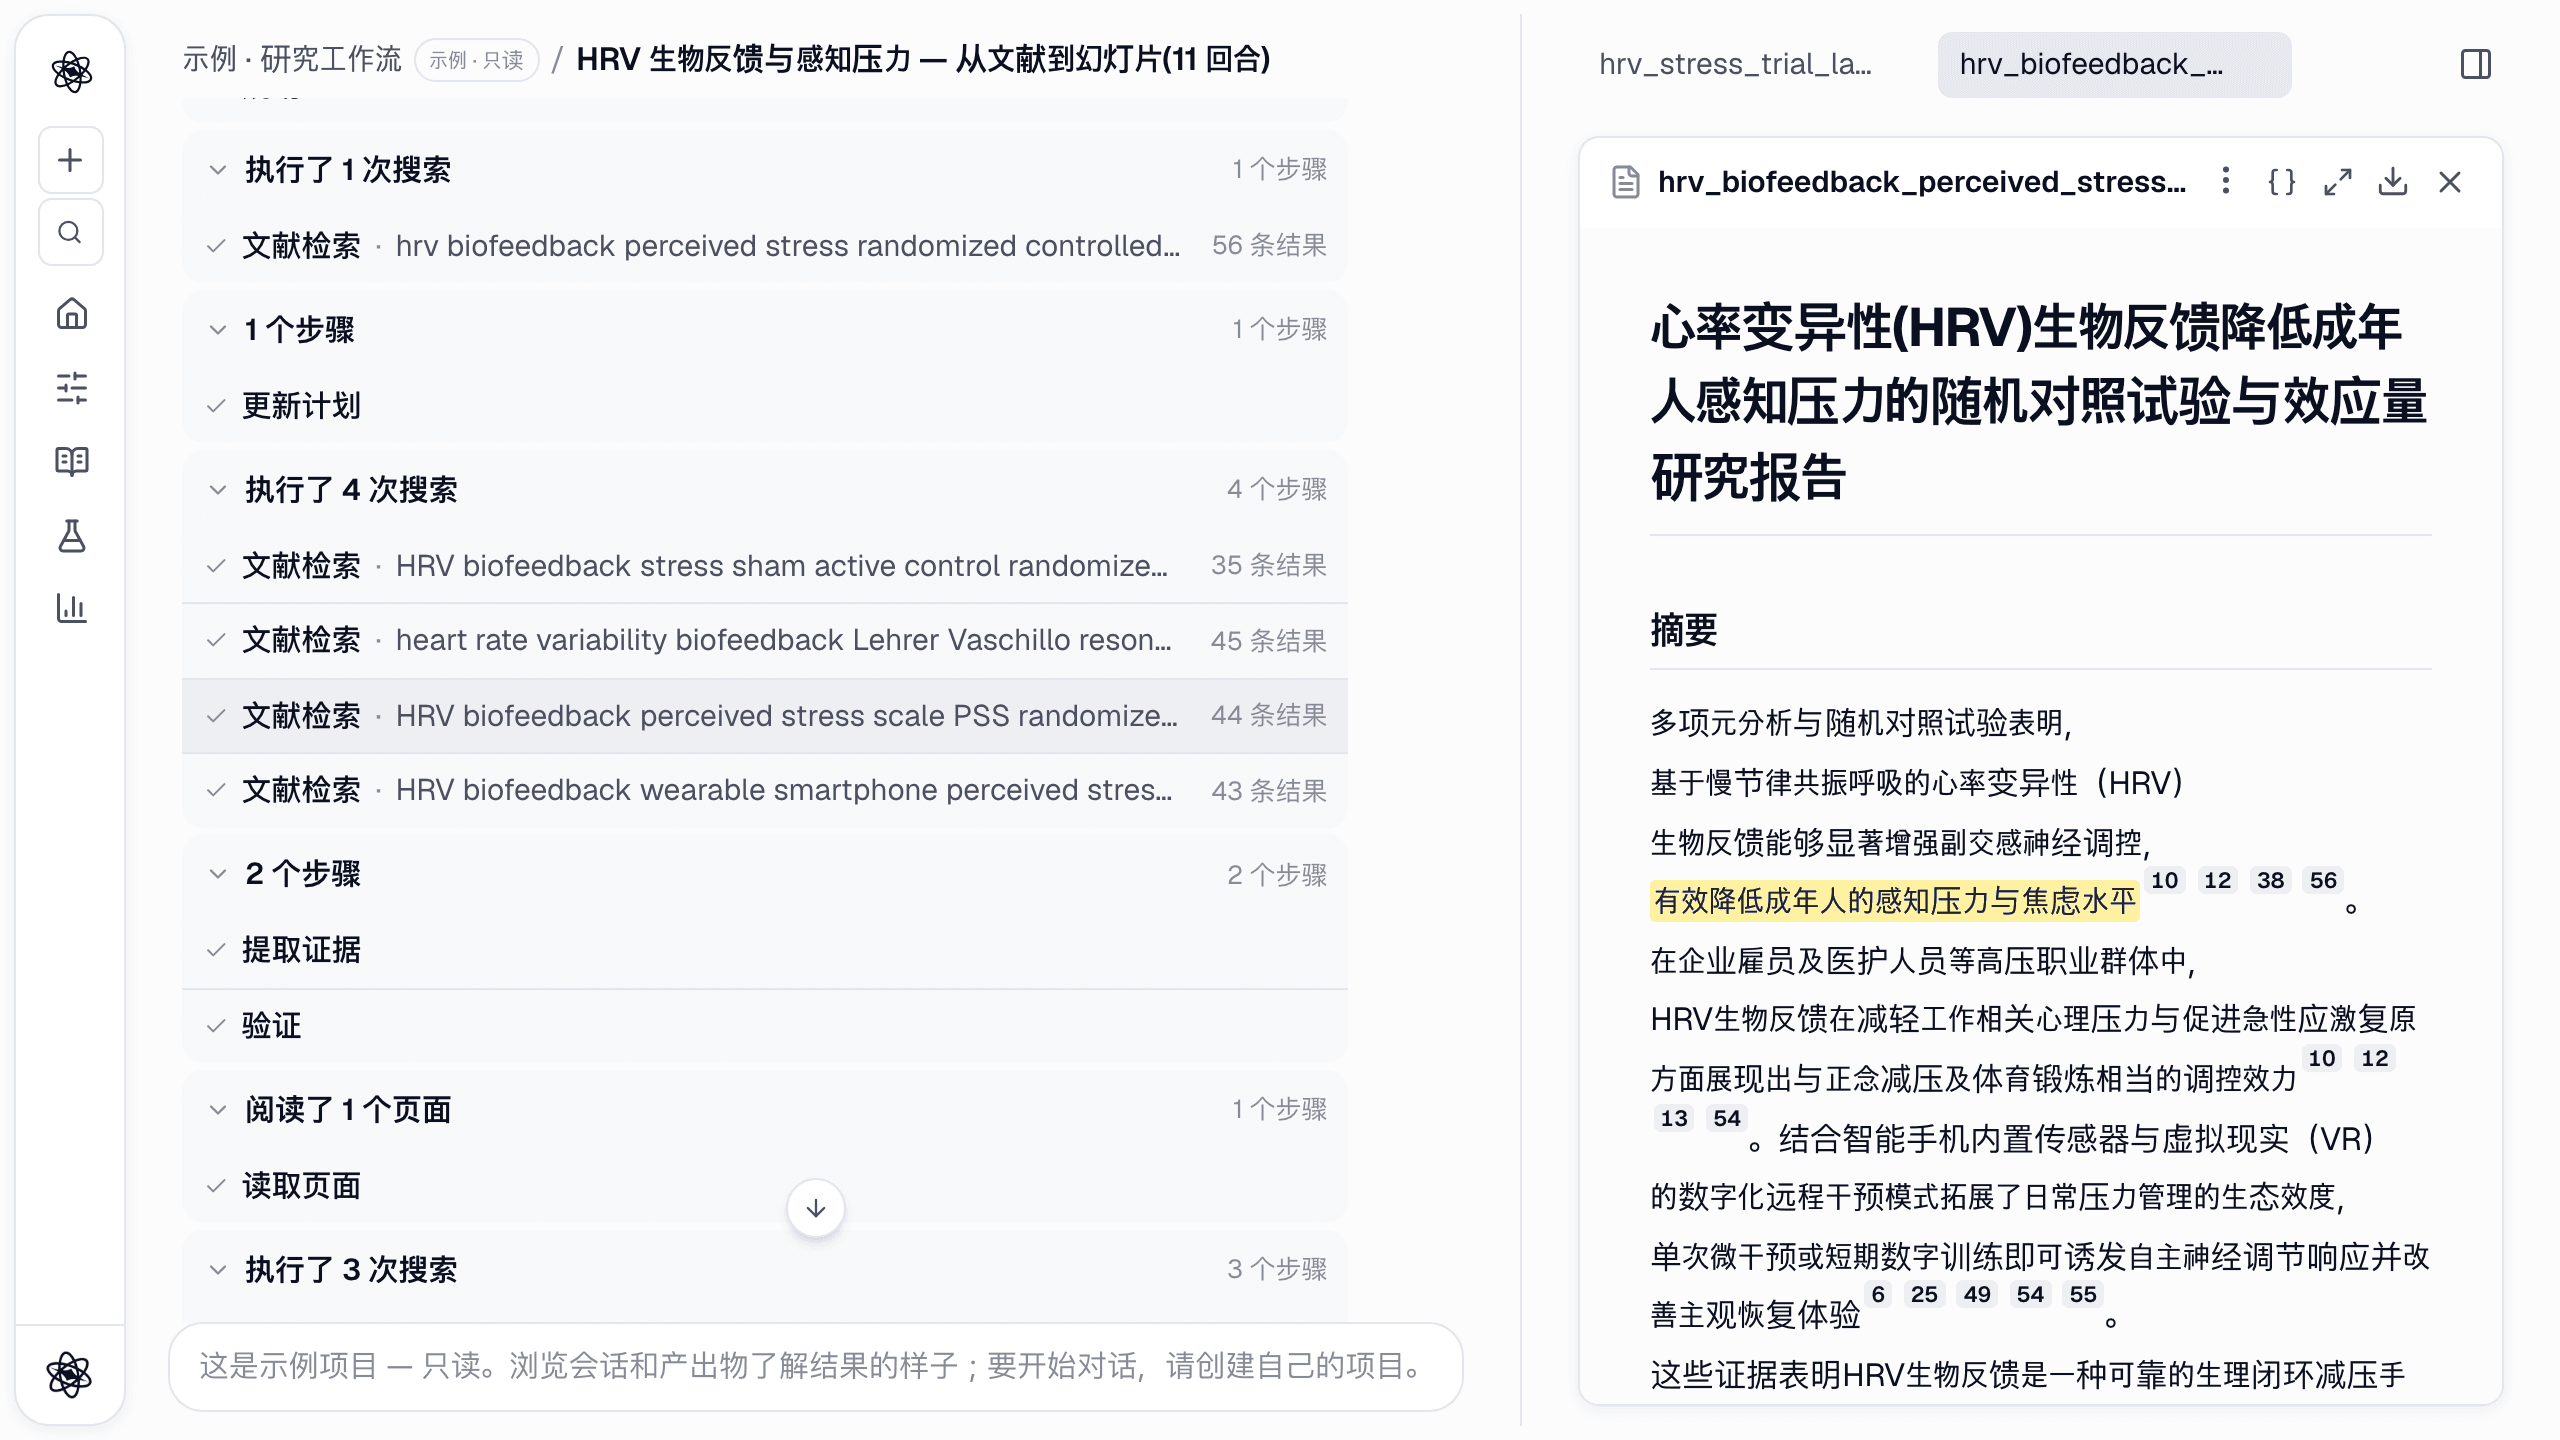
产出是一份句子带编号引用、且引用都指向实际取回来源的综述报告,加上找到的论文的筛选表(含相关性评分)、研究时间线、引用图和思维导图。它锚定的元分析(如 Goessl 等 2017)以及把生物反馈与运动、正念相比较的多臂试验(van der Zwan 等 2015;de Bruin 等 2016)成了后面一切的骨架。来源本身随会话保存。这一点后面很重要:第八回合写稿件时,参考文献列表会从这个存储重新构建,使正文里每一个 [n] 都指向真实取回的论文。
详细指南:文献调研。
回合 2 — 实验设计
/experiment-design 请设计一项两组随机实验,检验为期 4 周的 HRV 生物反馈训练相比主动对照组能否降低大学生的感知压力(PSS-10)。以相关研究的做法为依据,产出包含参与者、测量、流程和功效分析的设计报告。
这一回合以 已应用本项目其他聊天中确定的 3 项决定 开场:结局指标、人群和比较条件已经在第一回合固定,设计直接继承。随后又搜索了三次,按名称查找 van der Zwan 试验的方法以了解同类研究是怎么做的,并在此基础上搭建设计。
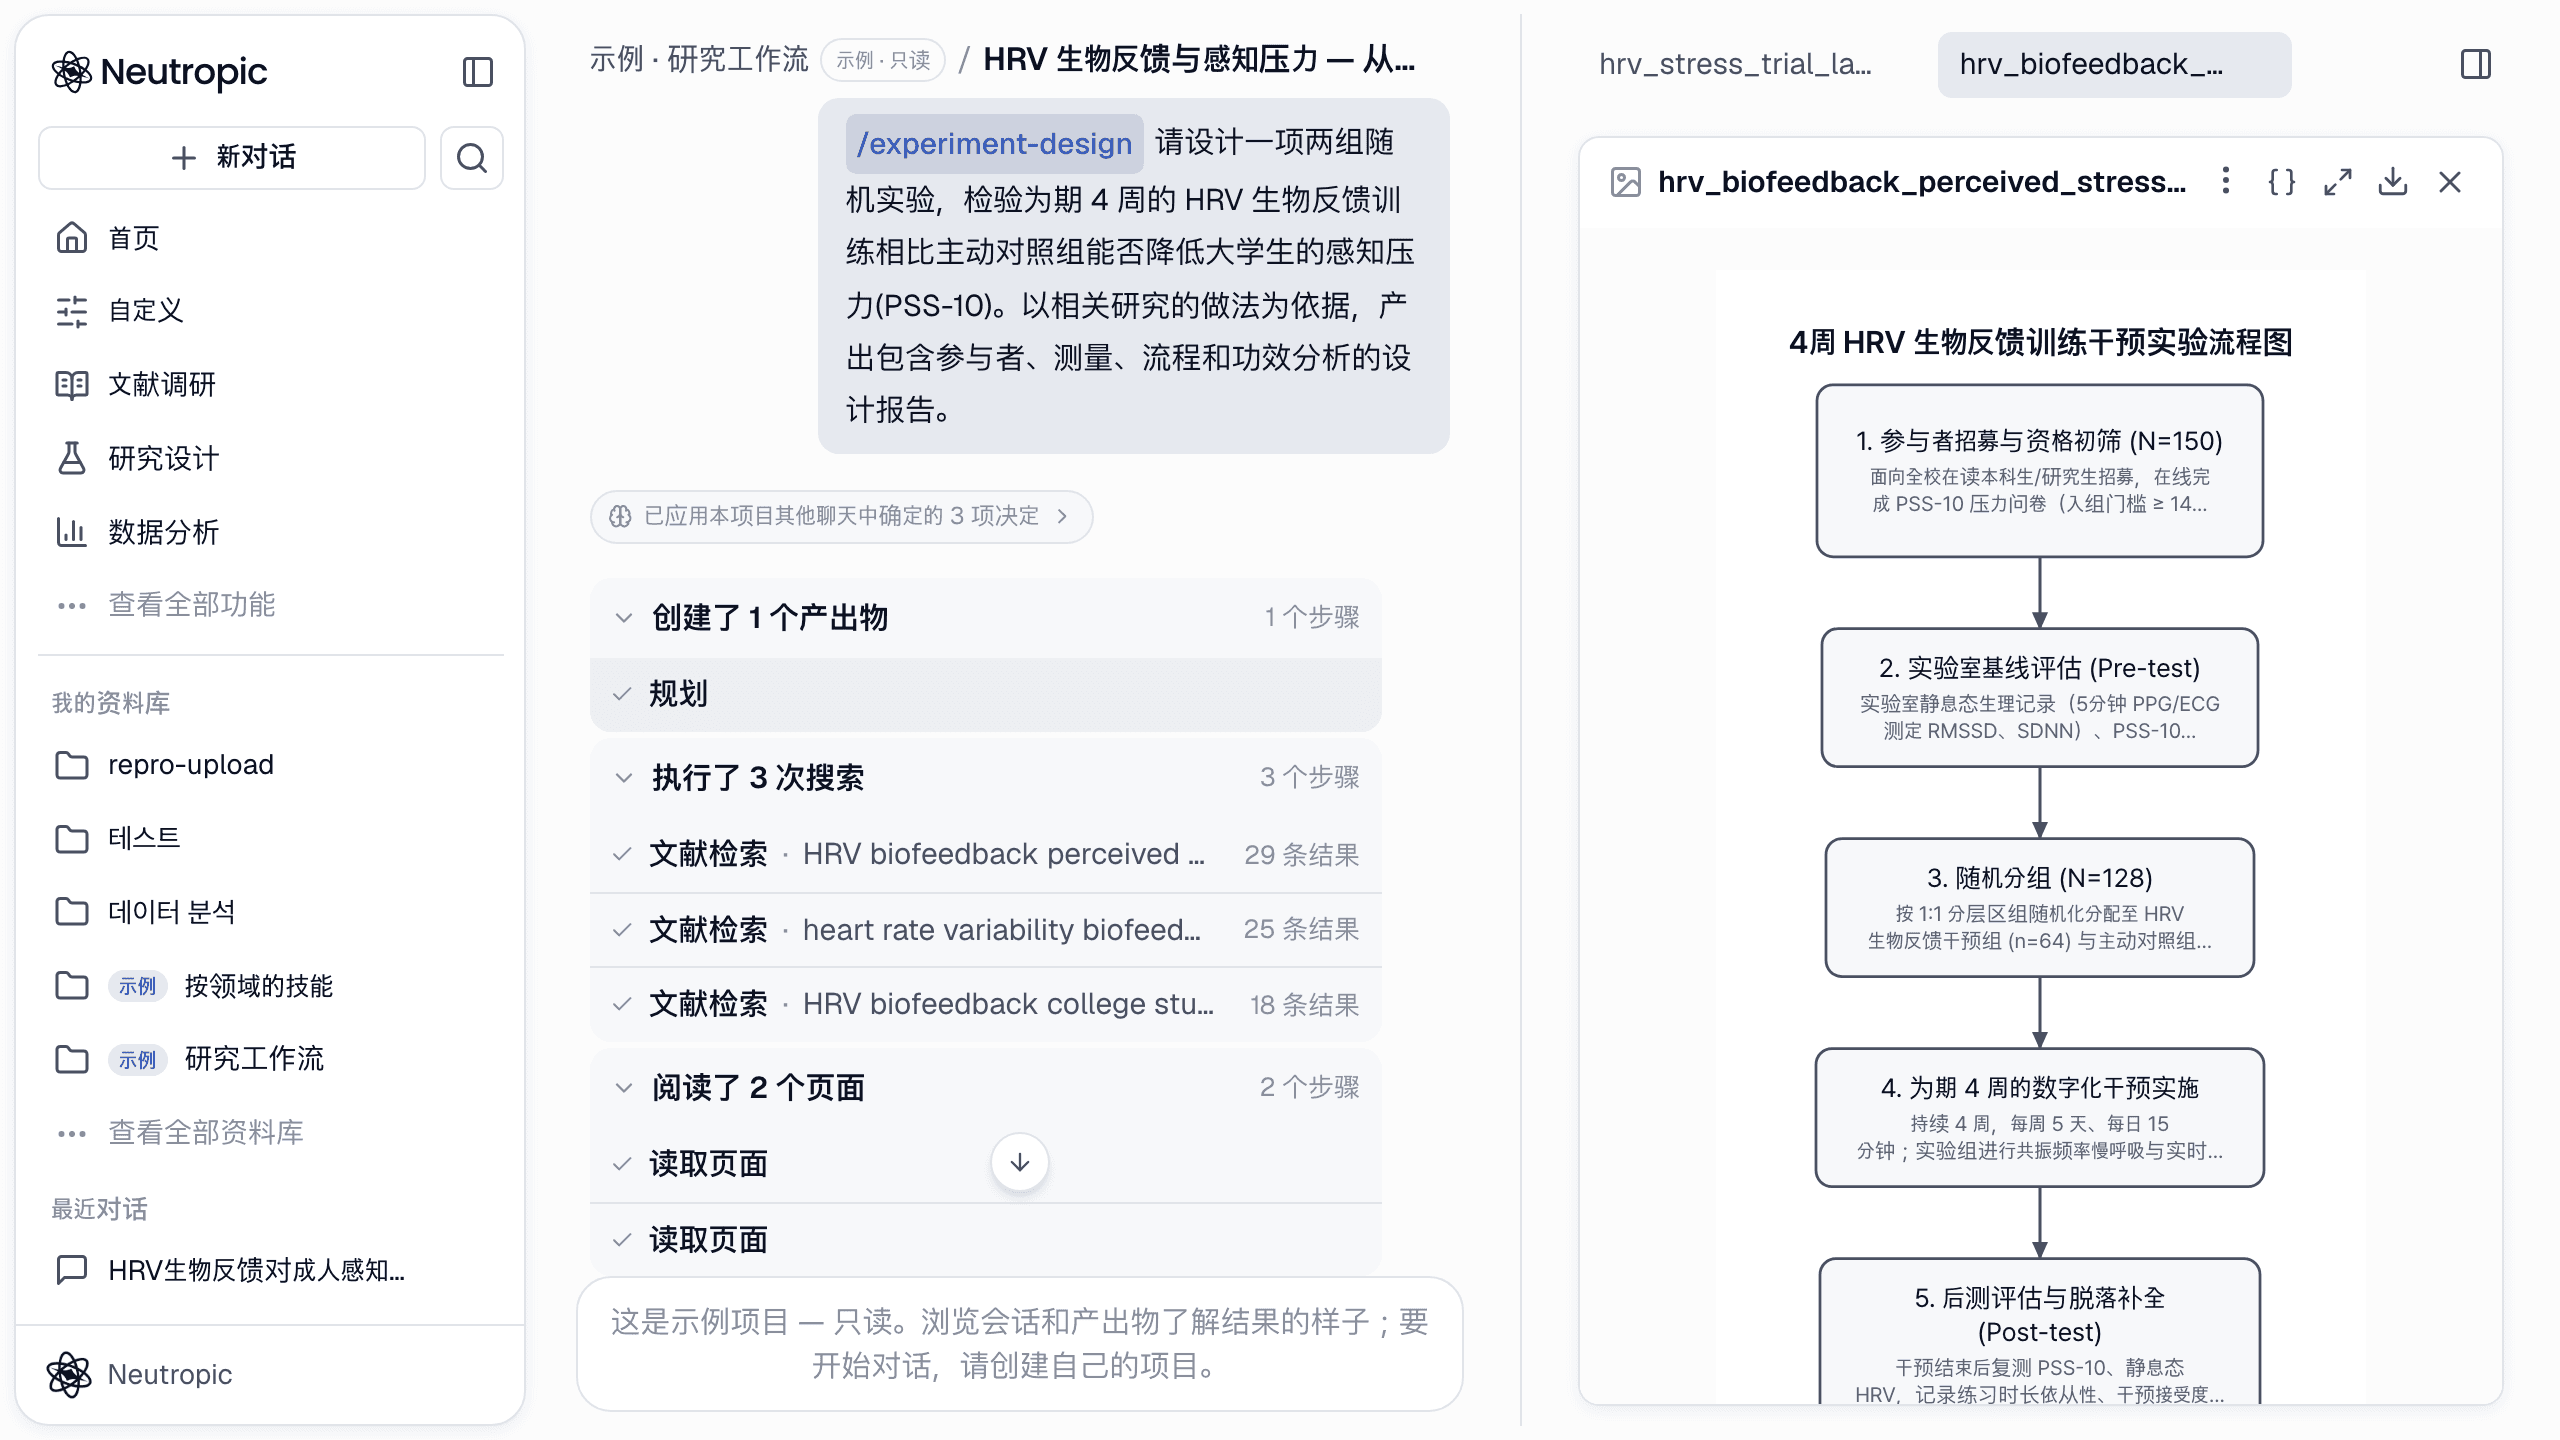
设计报告是会话里被复用最多的文档:分层区组随机的 2 × 2 混合设计,两组条件细化到每天多少分钟,测量工具,入排标准,每组 64 人、计入 15% 脱落后招募 152 人的功效分析,以及每项选择带来源的理由。随之产出功效曲线、流程图、标注为"非实测数据"的预期结果图,以及参考研究的设计比较表。后面的回合按名称读取这个文件:稿件的方法部分、研究流程图和幻灯片都从这里取材。
详细指南:实验设计。
回合 3 与 4 — 先数据分析,再统计
数据文件 pss_trial.xlsx(80 名参与者、每组 40 人的演示数据)通过 + 按钮上传,两个回合围绕它工作。
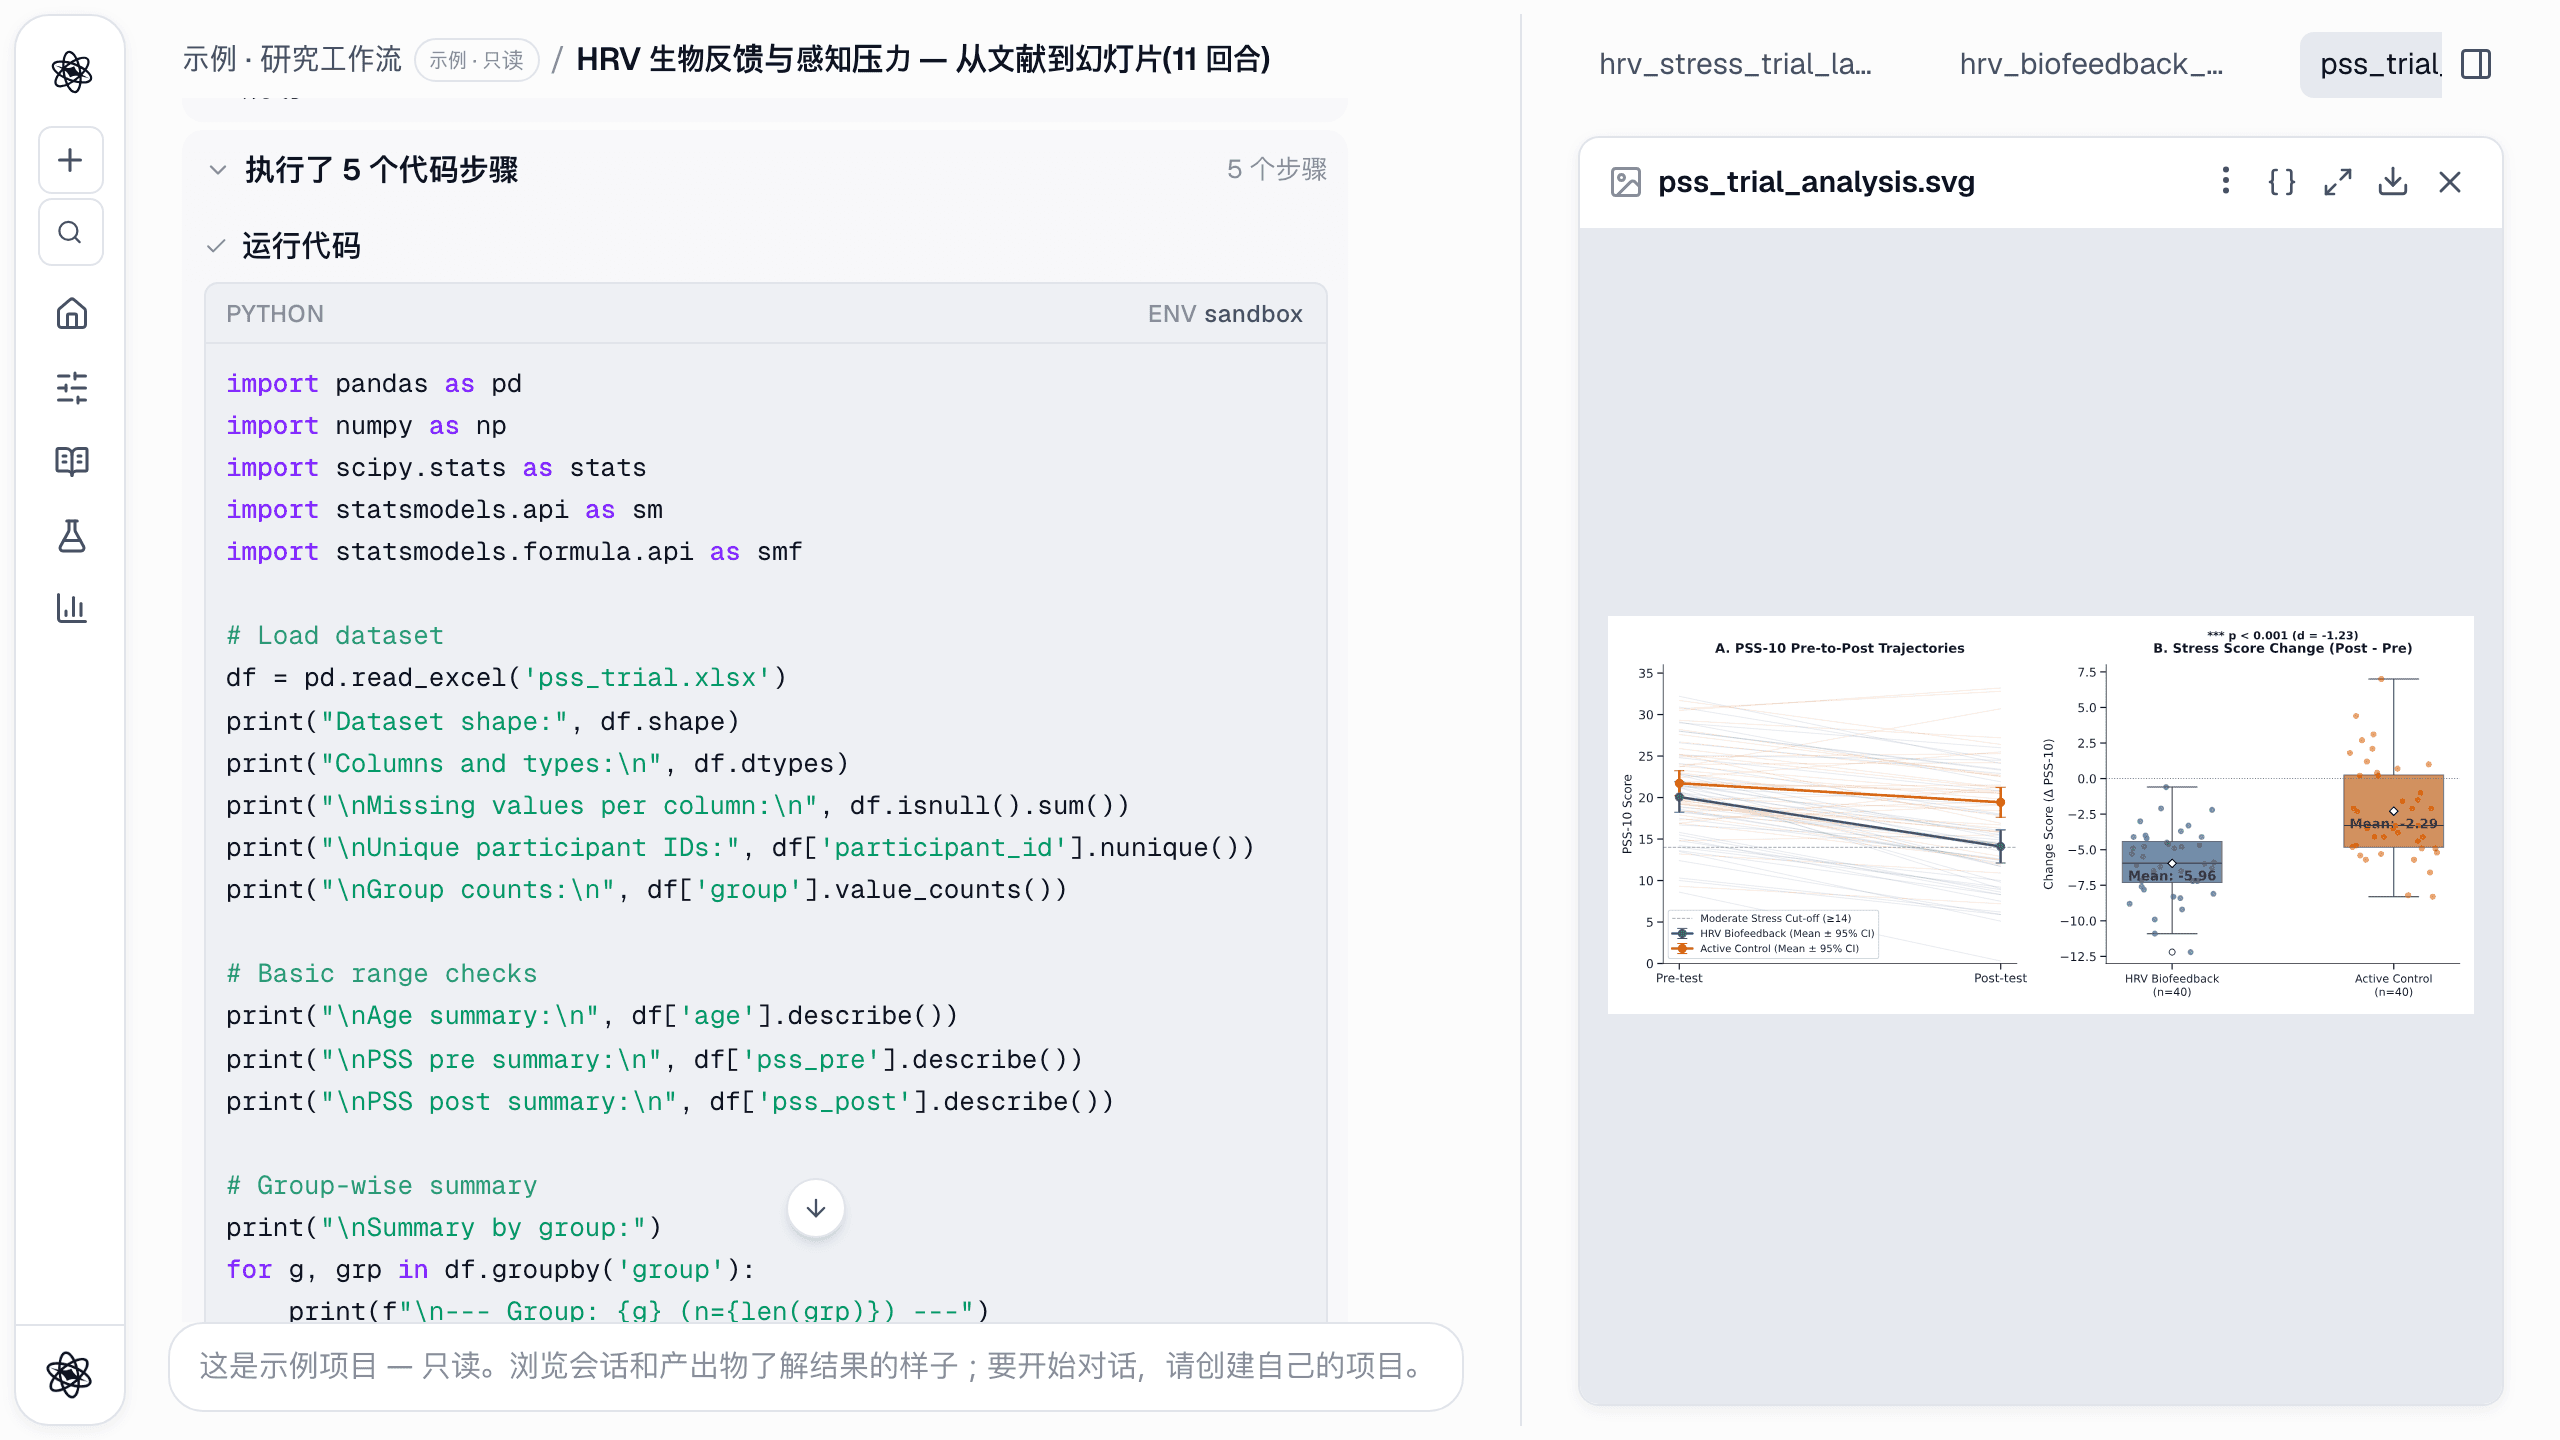
/analyze 请检查上传的 pss_trial.xlsx(两组,PSS-10 前测/后测)。核查数据质量与基线平衡,计算变化分数,并交付带图的可复现分析报告。
分析回合在沙箱里执行了五个代码步骤:质量审计(无缺失、无重复 ID、分数在范围内)、年龄与基线 PSS-10 的平衡检验、正态性与方差检验、配合配对检验和独立检验的变化分数、基线校正的 ANCOVA、以参与者为随机截距的混合模型,最后是三面板图:个体轨迹、变化分数分布和 ANCOVA 拟合。这些代码块全在对话里,面板中图的可复现性按钮会展示生成它的确切代码、输入和环境。
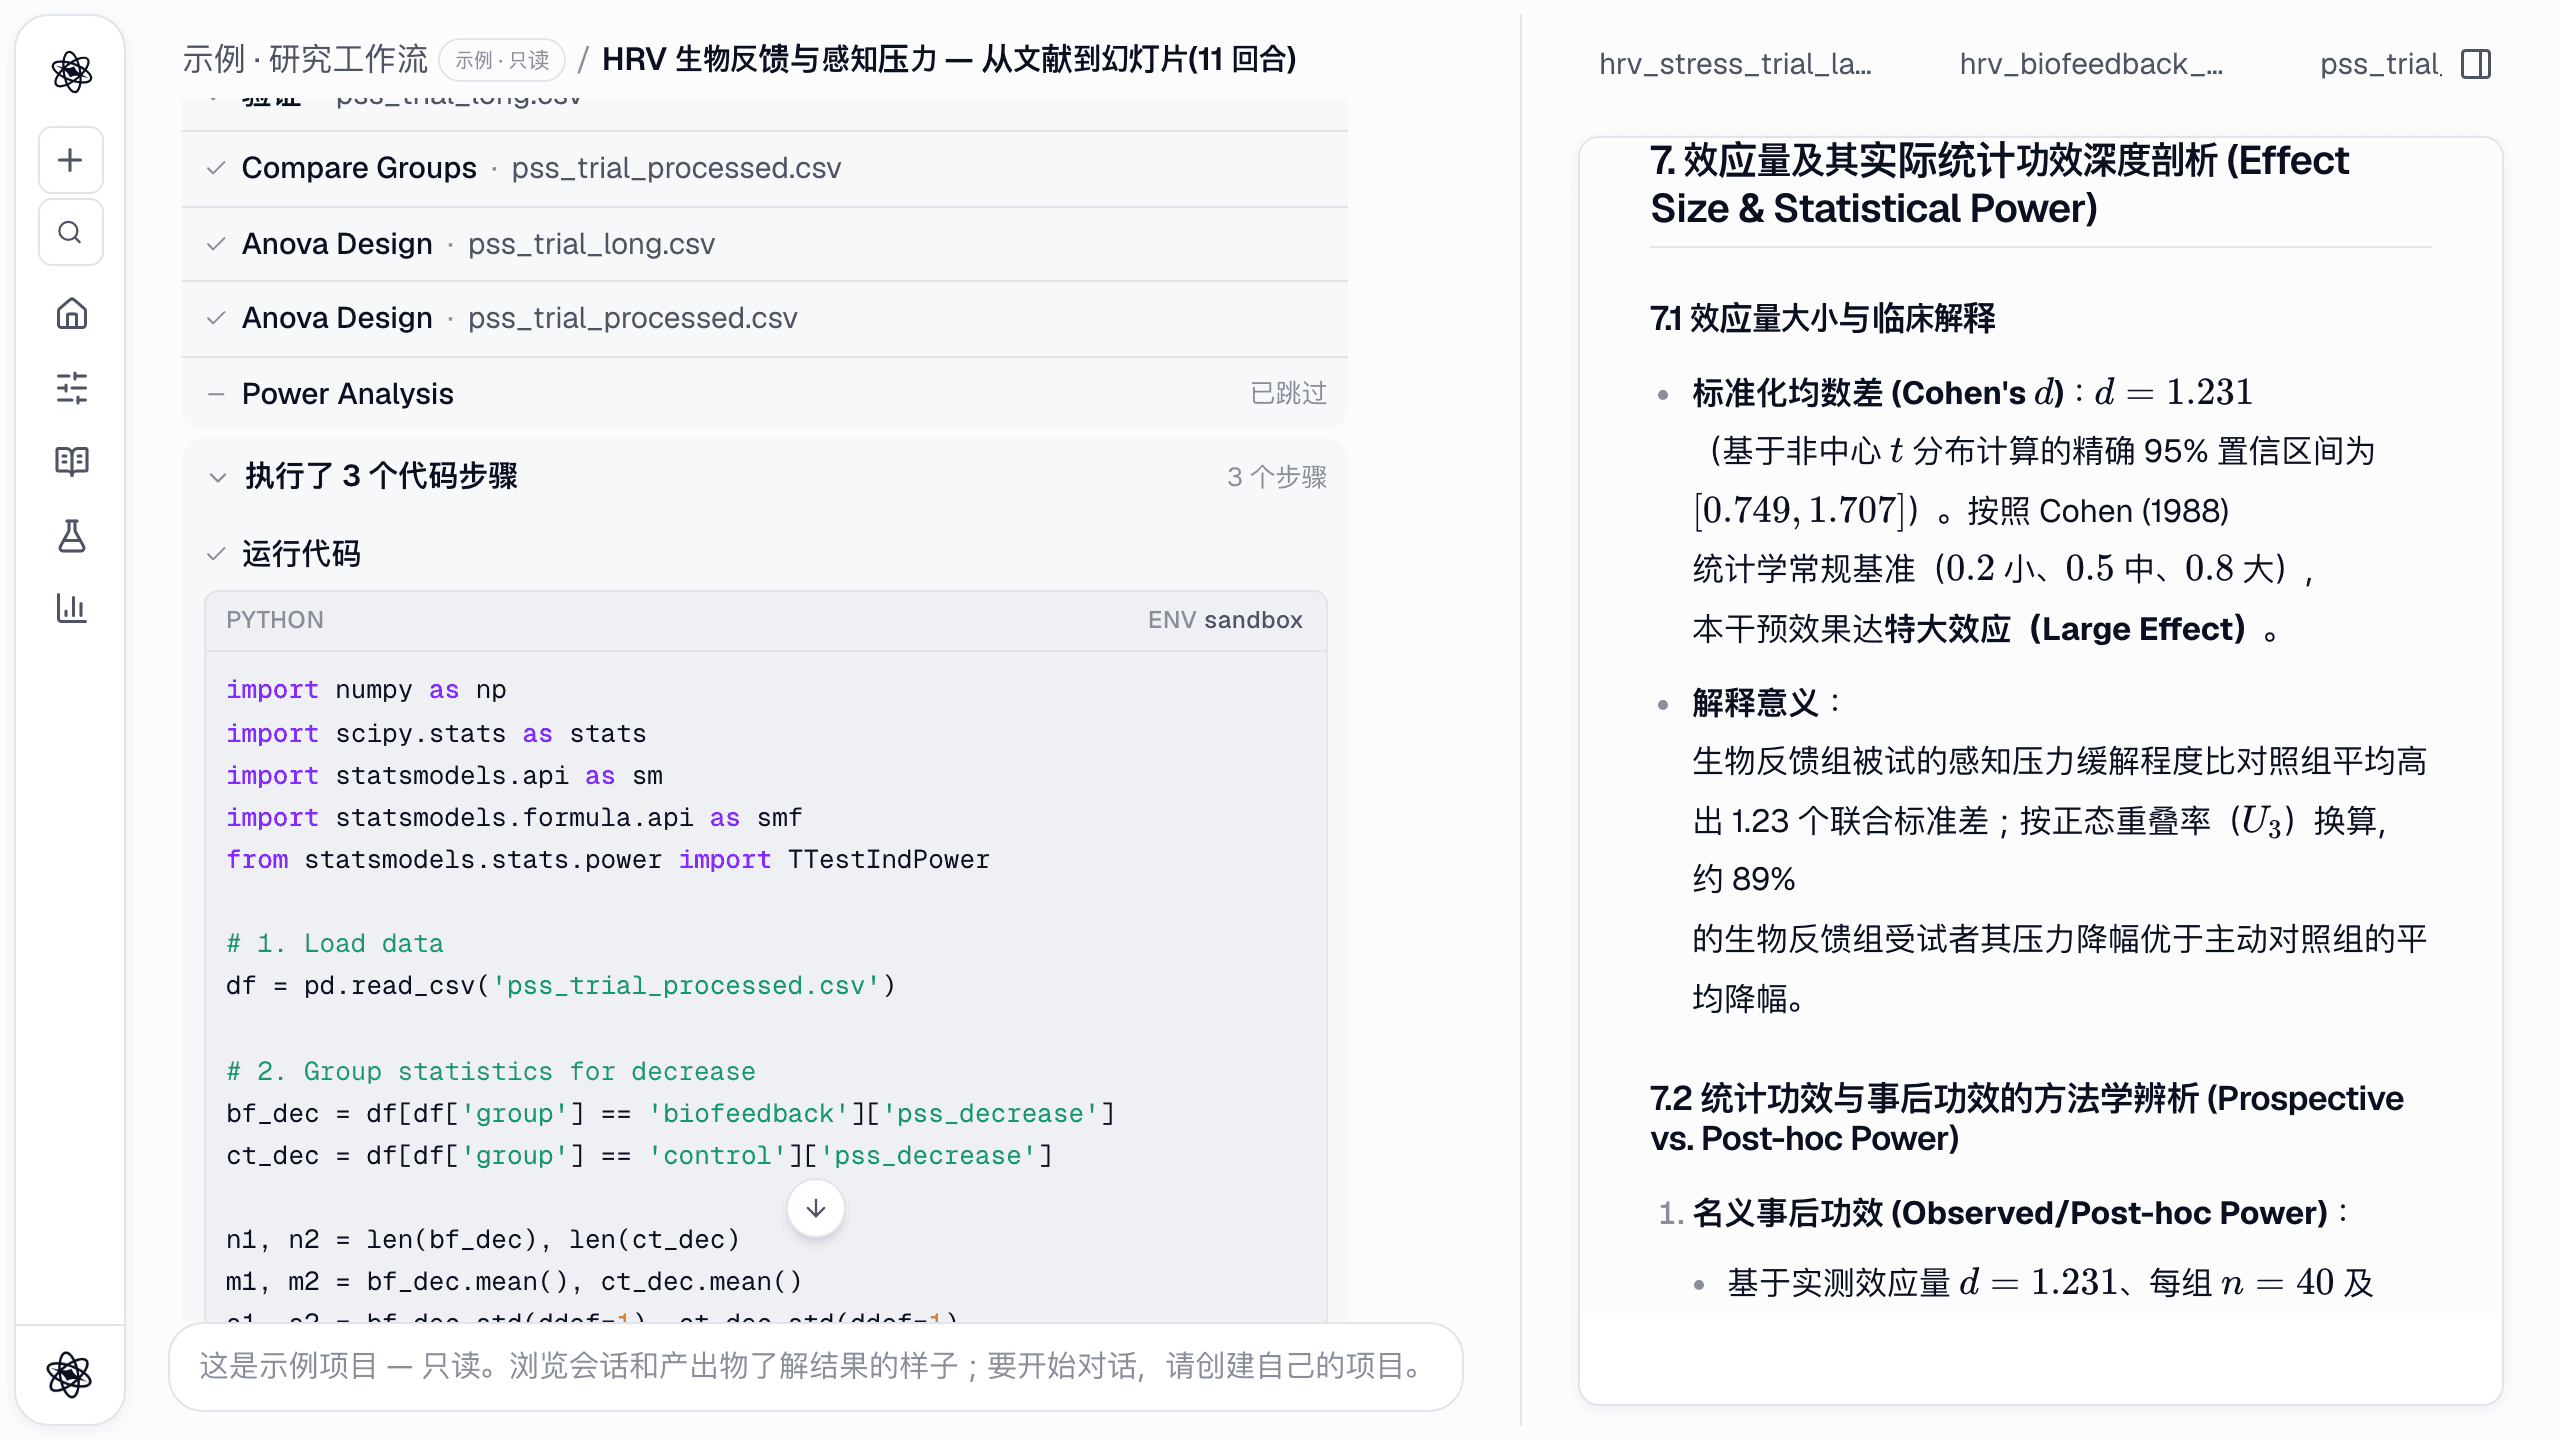
/stats 请用 pss_trial.xlsx 检验生物反馈组的 PSS-10 下降是否大于对照组。识别设计、检查假设、选择并论证检验方法,并报告效应量及其 95% 置信区间和实际功效。
统计回合是另一种类型。它不写自由代码,而是把统计工具串成链,步骤列表读起来像一棵决策树:验证数据文件、Recommend Statistical Test、Compare Groups、Estimate Effect Size、Power Analysis。报告原样引用导向独立样本 t 检验的决策轨迹("各组正态性均未被拒绝 → 参数族;Levene p = .057 → 方差齐性"),用 Welch 和 Mann–Whitney 做敏感性检验,并报告 d = 1.23,95% 置信区间 0.75 至 1.71。它还直言"实际功效"1.000 只是小 p 值的推论而非独立事实,转而报告敏感性分析(此样本量在 80% 功效下可检出的最小效应,d = 0.63)。
详细指南:数据分析、统计,以及报告为何引用自己的步骤:每一句都有依据。
回合 5 与 7 — 一张图和一幅插图
/figure 请为本会话设计的实验绘制可编辑的矢量研究流程图:招募 → 筛选 → 随机分组 → HRV 生物反馈(4 周) vs 主动对照 → 后测(PSS-10) → 3 个月随访。使用期刊模板。
/illustrate 请为方法图绘制 HRV 生物反馈实验装置的科学插图:一名坐着的参与者佩戴胸带式 ECG 传感器和指尖 PPG 传感器,跟随笔记本电脑上的呼吸节奏显示进行呼吸。半扁平风格,白色背景。
两者都是单步回合,也都便宜(各约 3 万令牌)。研究流程图按双栏期刊预设排版,是真正的矢量图:在工作区中编辑可以移动方框、改写标签,导出为 SVG、PNG、PDF 或 PPTX 时形状依然可编辑。插图同样是矢量,传感器绑带或衣服的颜色可以在面板里更换。
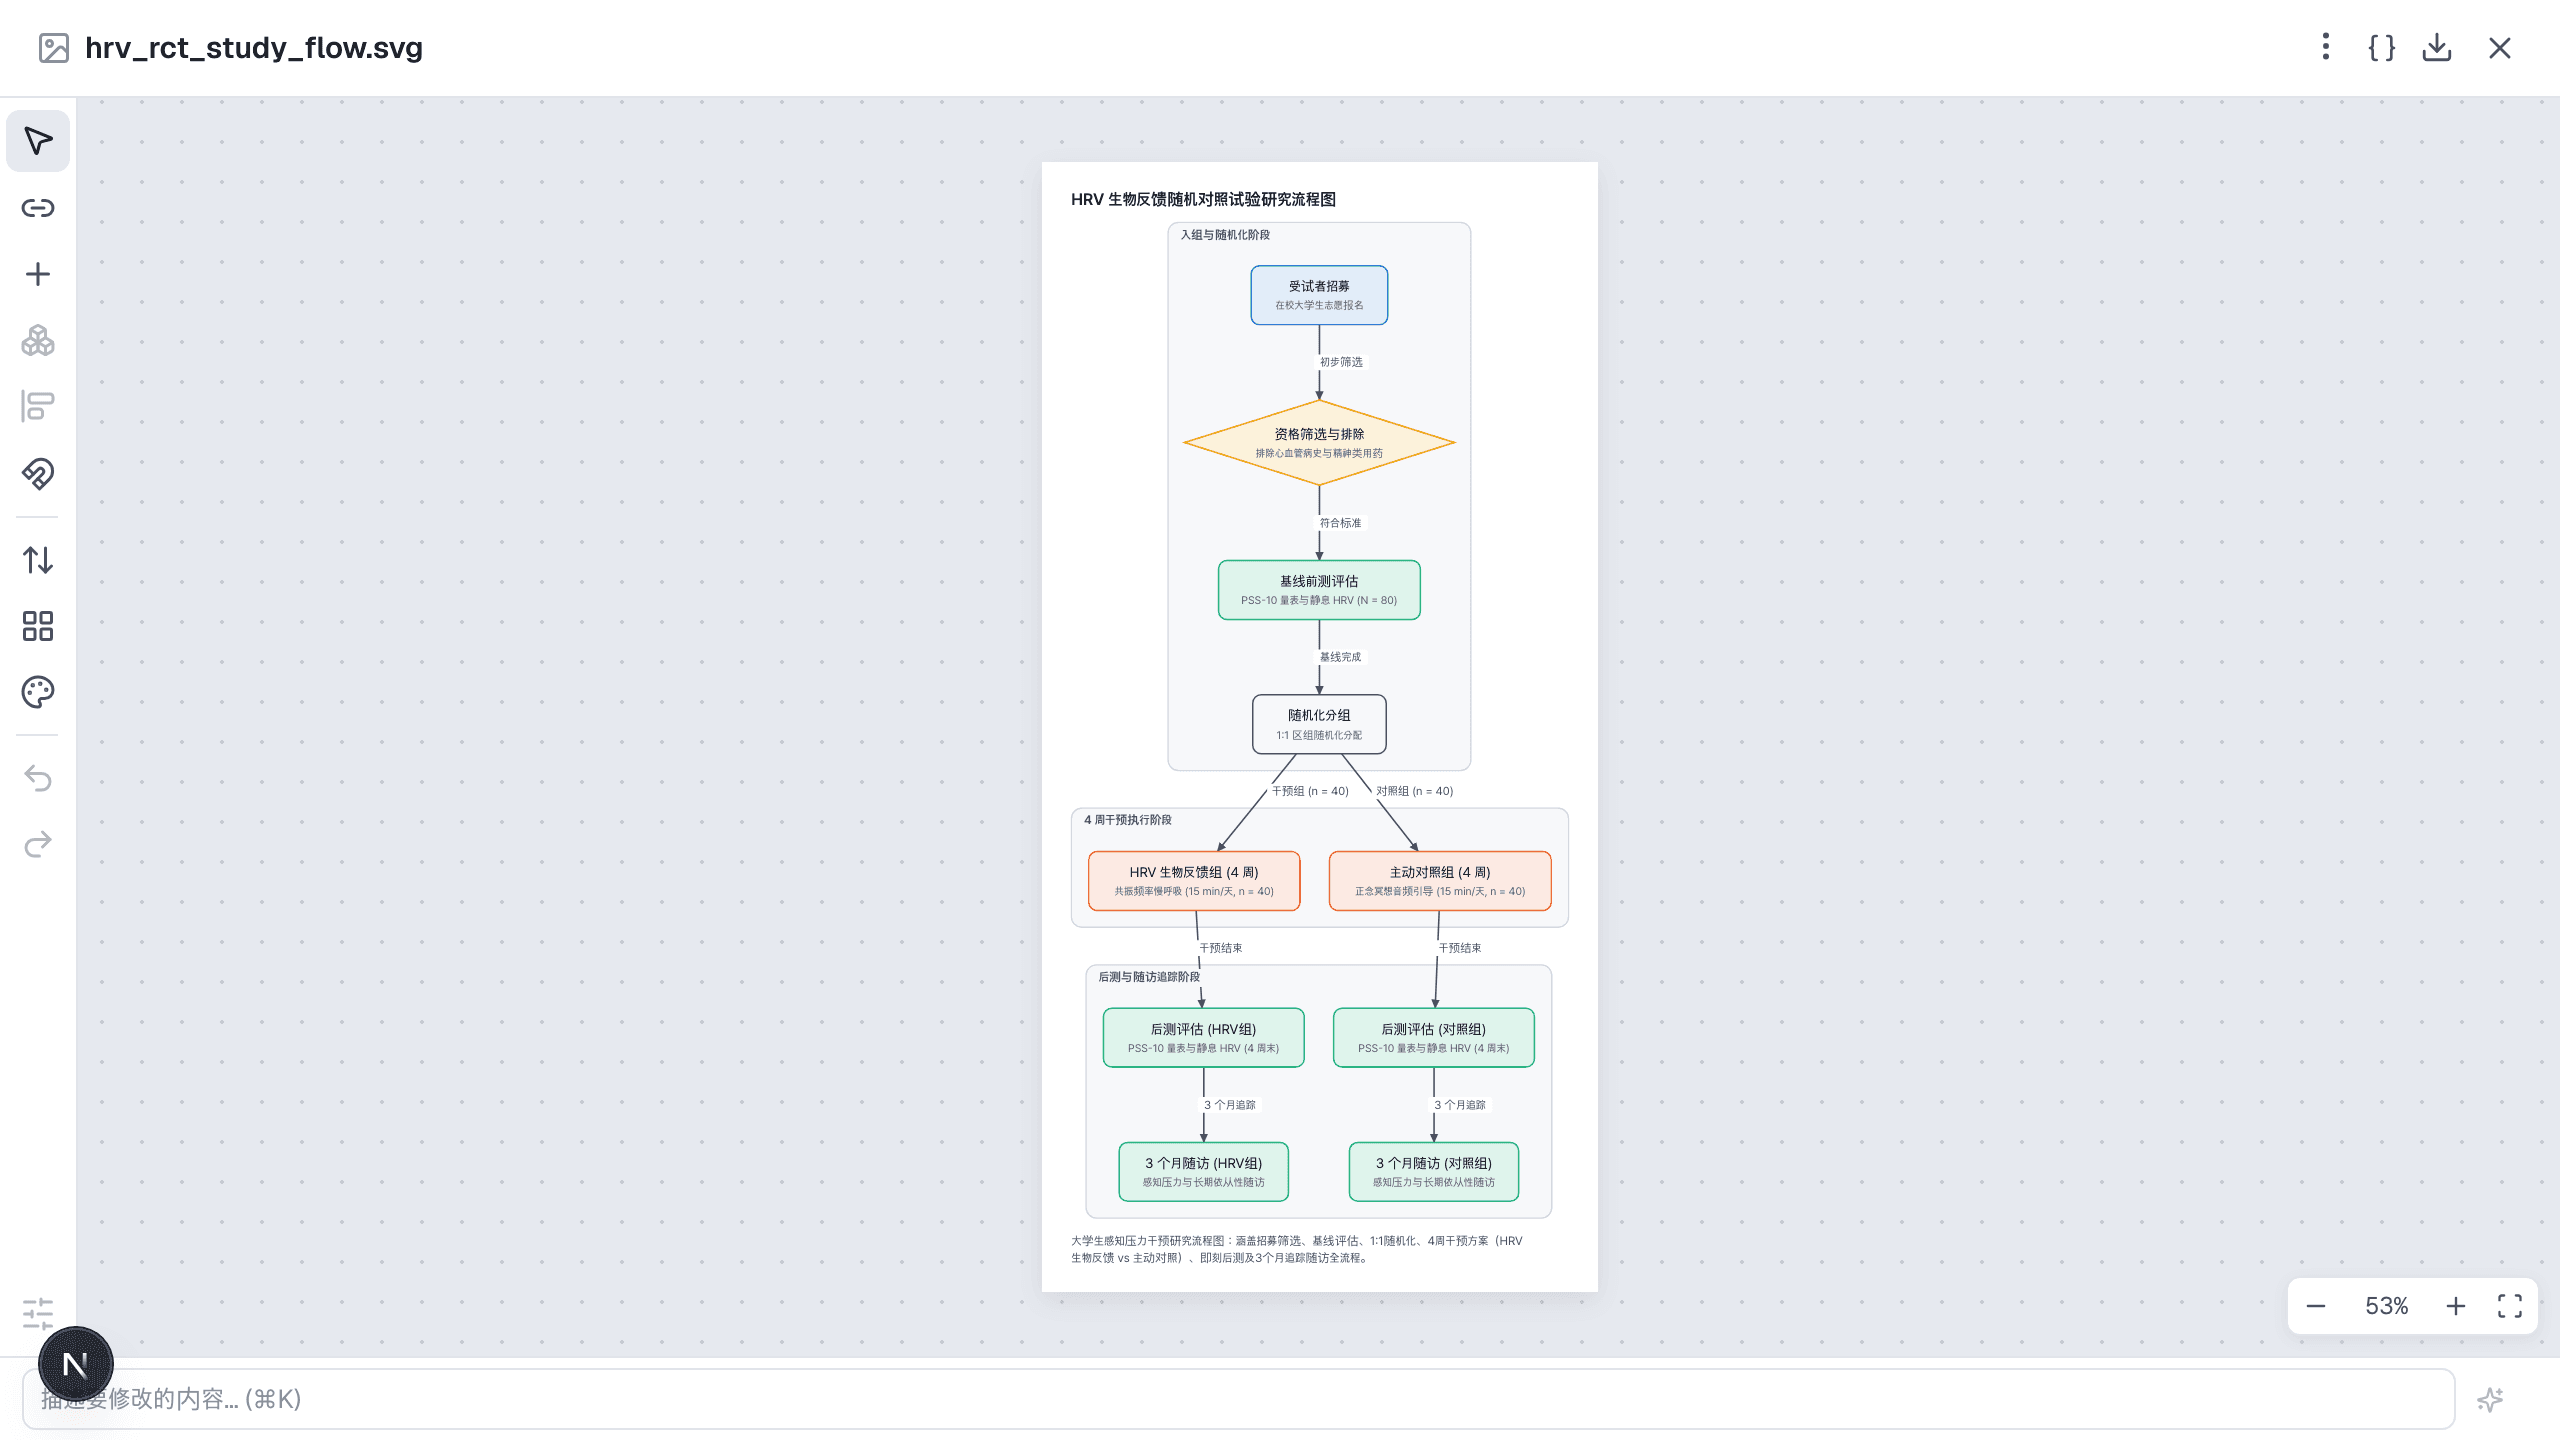
有一点值得注意:绘图提示词要求画出 3 个月随访,流程图也照画了,但英文设计报告只有基线和后测。会话在读取产出物时会让它们彼此一致,却拦不住你去要流程里没有的东西。请对照设计来读图。
详细指南:图表。
回合 6 — 假设
/hypothesis 基于本会话收集的 HRV 生物反馈与感知压力文献,绘制研究空间地图,列出空白与相互矛盾的发现,并生成按新颖性、合理性和可检验性排序的可检验假设,每条附理由和来源。
在这个会话里,假设排在分析之后,是第六回合;换成你自己的研究,应当紧接综述之后运行。这一回合重读了保存的文献,就机制再搜索两次,建立先前工作表,核查矛盾,并为五个候选假设各做了功效分析,然后才写出提案和框架图。
排在首位的假设值得记住,因为它会反复出现:在同样的 0.1 Hz 下,闭环生物反馈相比开环慢速节律呼吸是否有额外增益。本会话的试验回答不了这个问题,因为对照组是心理教育而非节律呼吸。稿件、报告审查和论文评审都注意到了这一点。
详细指南:假设。
回合 8 — 稿件
/write 请根据本会话中的文献、设计和分析撰写稿件的方法与结果部分,每一处论断都要绑定到引用或本会话的结果。
这是会话兑现价值的回合。它以 已应用本项目其他聊天中确定的 11 项决定 开场。步骤列表显示它按名称加载了综述报告和统计报告,在写下一个字之前做了六步验证,然后多轮撰写、修订文档和检查稿件。
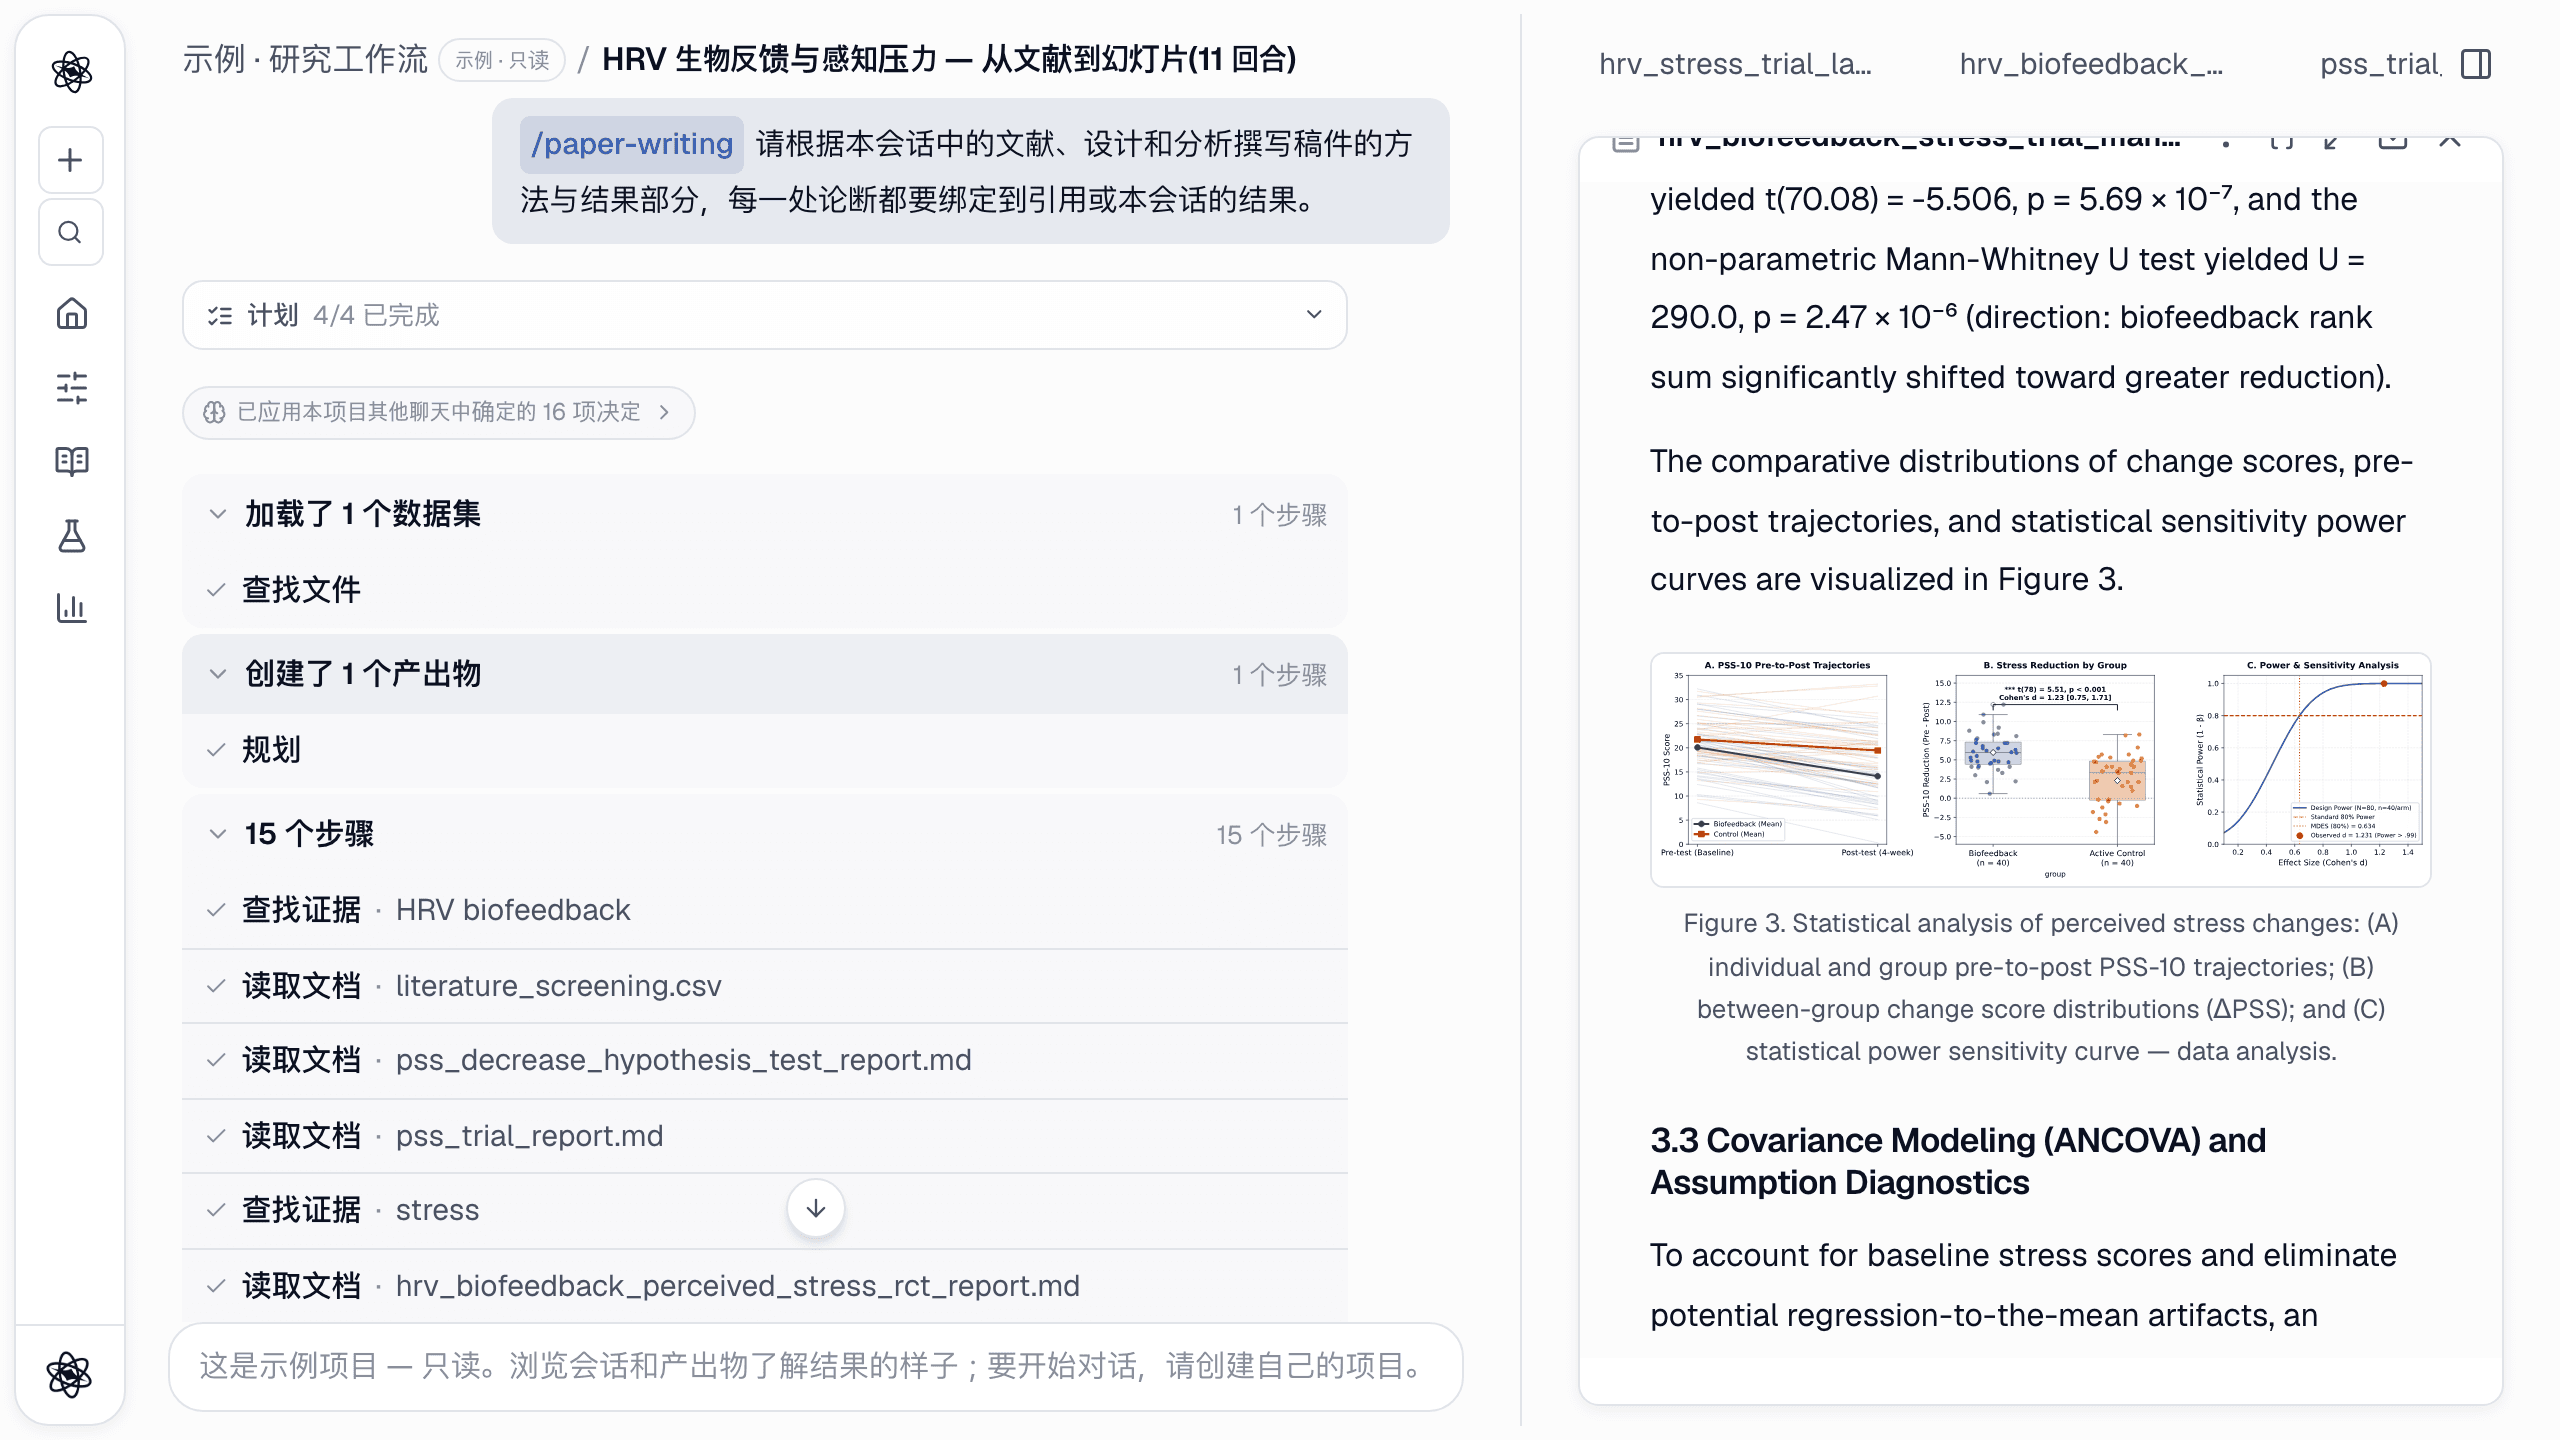
结果是一份方法与结果部分:数字来自统计报告,引用来自筛选过的文献。对话记录里的三件事说明了这种绑定如何运作:
- "参考文献列表已根据本会话保存的来源(6 条)重建,以与正文中引用的每个 [n] 匹配。" 参考文献不是生成的,而是查出来的。
- "稿件保存时缺少标准图,正在用一次简短的追加处理生成图 1(概览)和图 2(流程)。" 稿件检查发现图缺失,就追加一遍把它们放到首次提及之后。
- 稿件末尾有一张论断–证据映射表和一份数据无法支持的论断清单:持续性迷走神经重塑、相对开环节律呼吸的优势、3 个月维持效果,全部归入未检验而非断言。
导出在面板的下载按钮:DOCX、LaTeX、PDF 或 Markdown。详细指南:论文写作。
回合 9 — 报告审查
/report-review 请独立评审本会话撰写的稿件 — 论断、方法、统计、引用证据和可复现性 — 并撰写按优先级排列的评审报告。
报告审查是让会话像陌生人一样读自己的工作。步骤列表展示了"独立"在实践中的含义:这一回合在历史聊天中搜索稿件和创建它的那次调用,重新加载数据文件,从头再跑基线检验、配对检验、组间比较、效应量和 ANCOVA。重分析与稿件一致(t(78) = 5.51,d = 1.23,ANCOVA F(1,77) = 29.22),报告也如实写明。
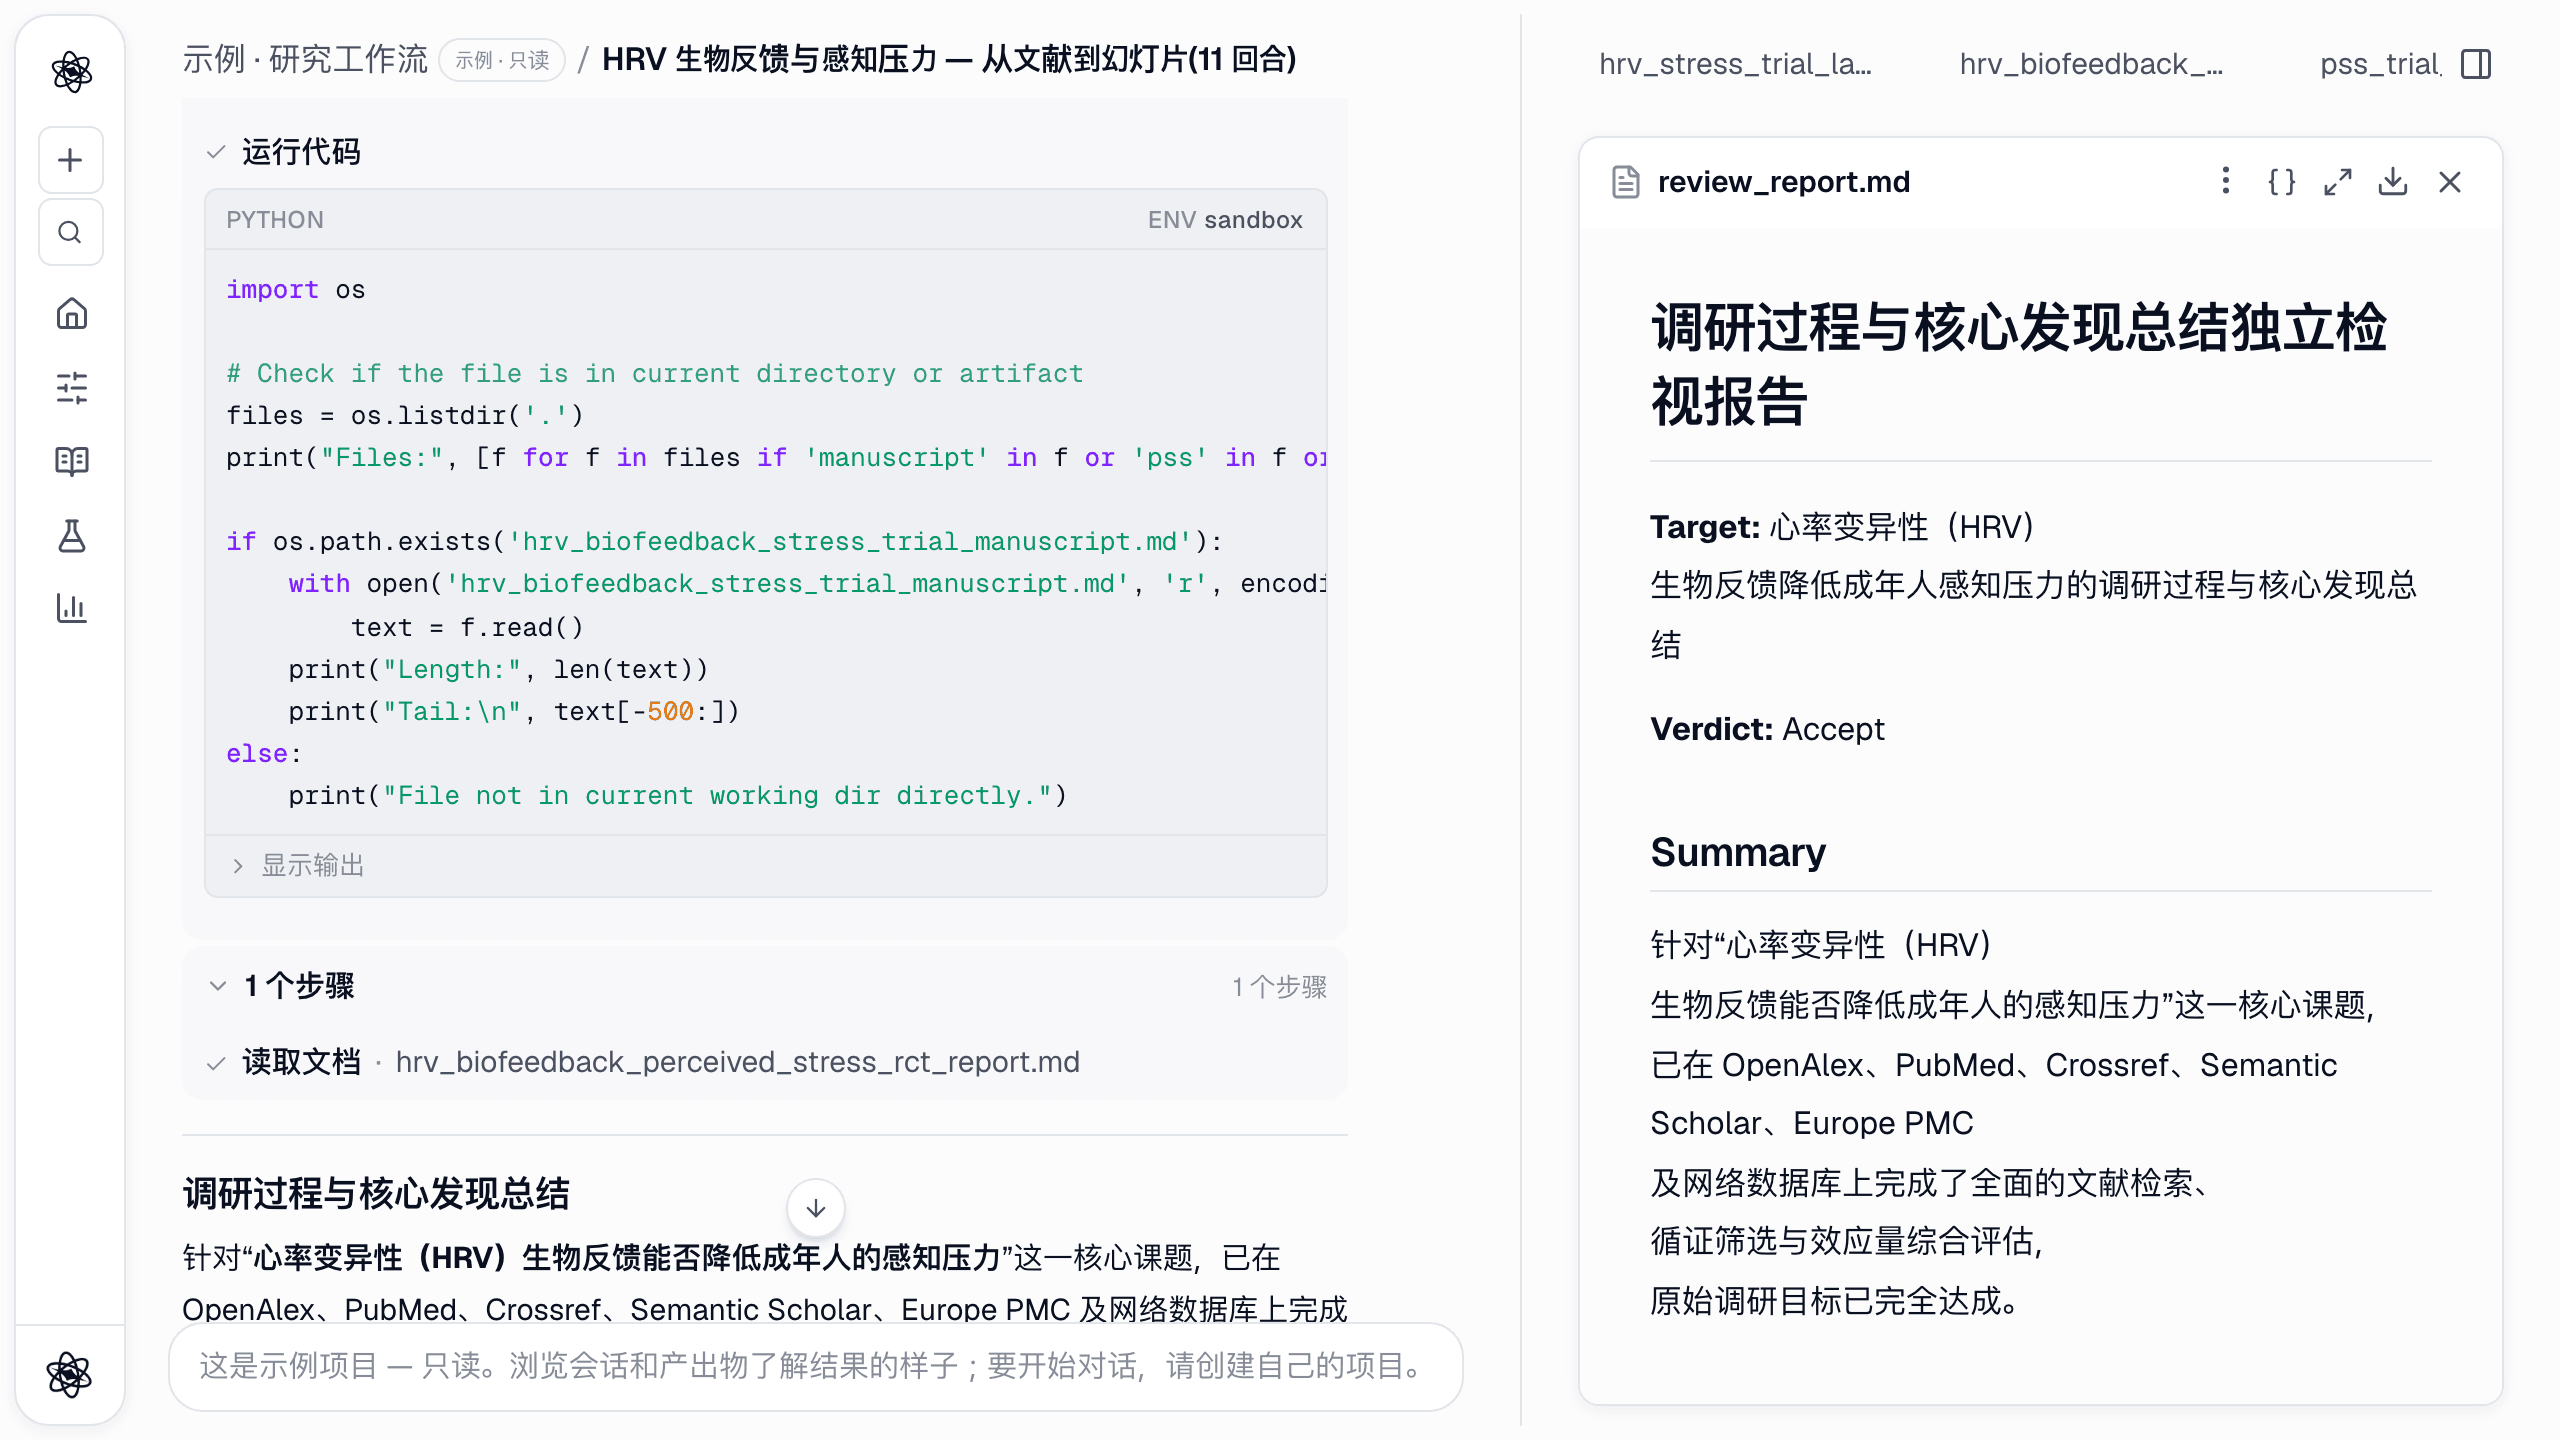
随后它找到了两处值得修的地方。保存的稿件在方法部分的一句话中间被截断(产出物的真实缺陷,否则作者要到投稿时才会发现);讨论部分需要把慢速节律呼吸的效应与反馈本身的效应分开,正是假设回合标出的那个空白。这一回合还触到了步骤上限,并直说了:"已达到此任务的步骤上限。上方已保存的结果可以使用,但剩余的计划步骤未执行。" 这种坦诚也是设计的一部分。提前停下的审查会告诉你它提前停下了。
详细指南:报告审查。
回合 10 — 论文评审
/peer-review 请按 Applied Psychophysiology and Biofeedback 期刊的标准对本会话中撰写的稿件进行评审:期刊简介与投稿规定、相似论文、五位评审人评分、编辑决定、修改指南和推荐期刊。
论文评审模拟的是期刊而不是读者。这一回合建立了目标期刊的简介并提取其投稿规定,找到该期刊发表过的八篇相似论文,召集了五位分工不同的评审人(期刊契合度、方法学、领域专家、宏观视角、魔鬼代言人),并由编辑裁决他们的分歧。
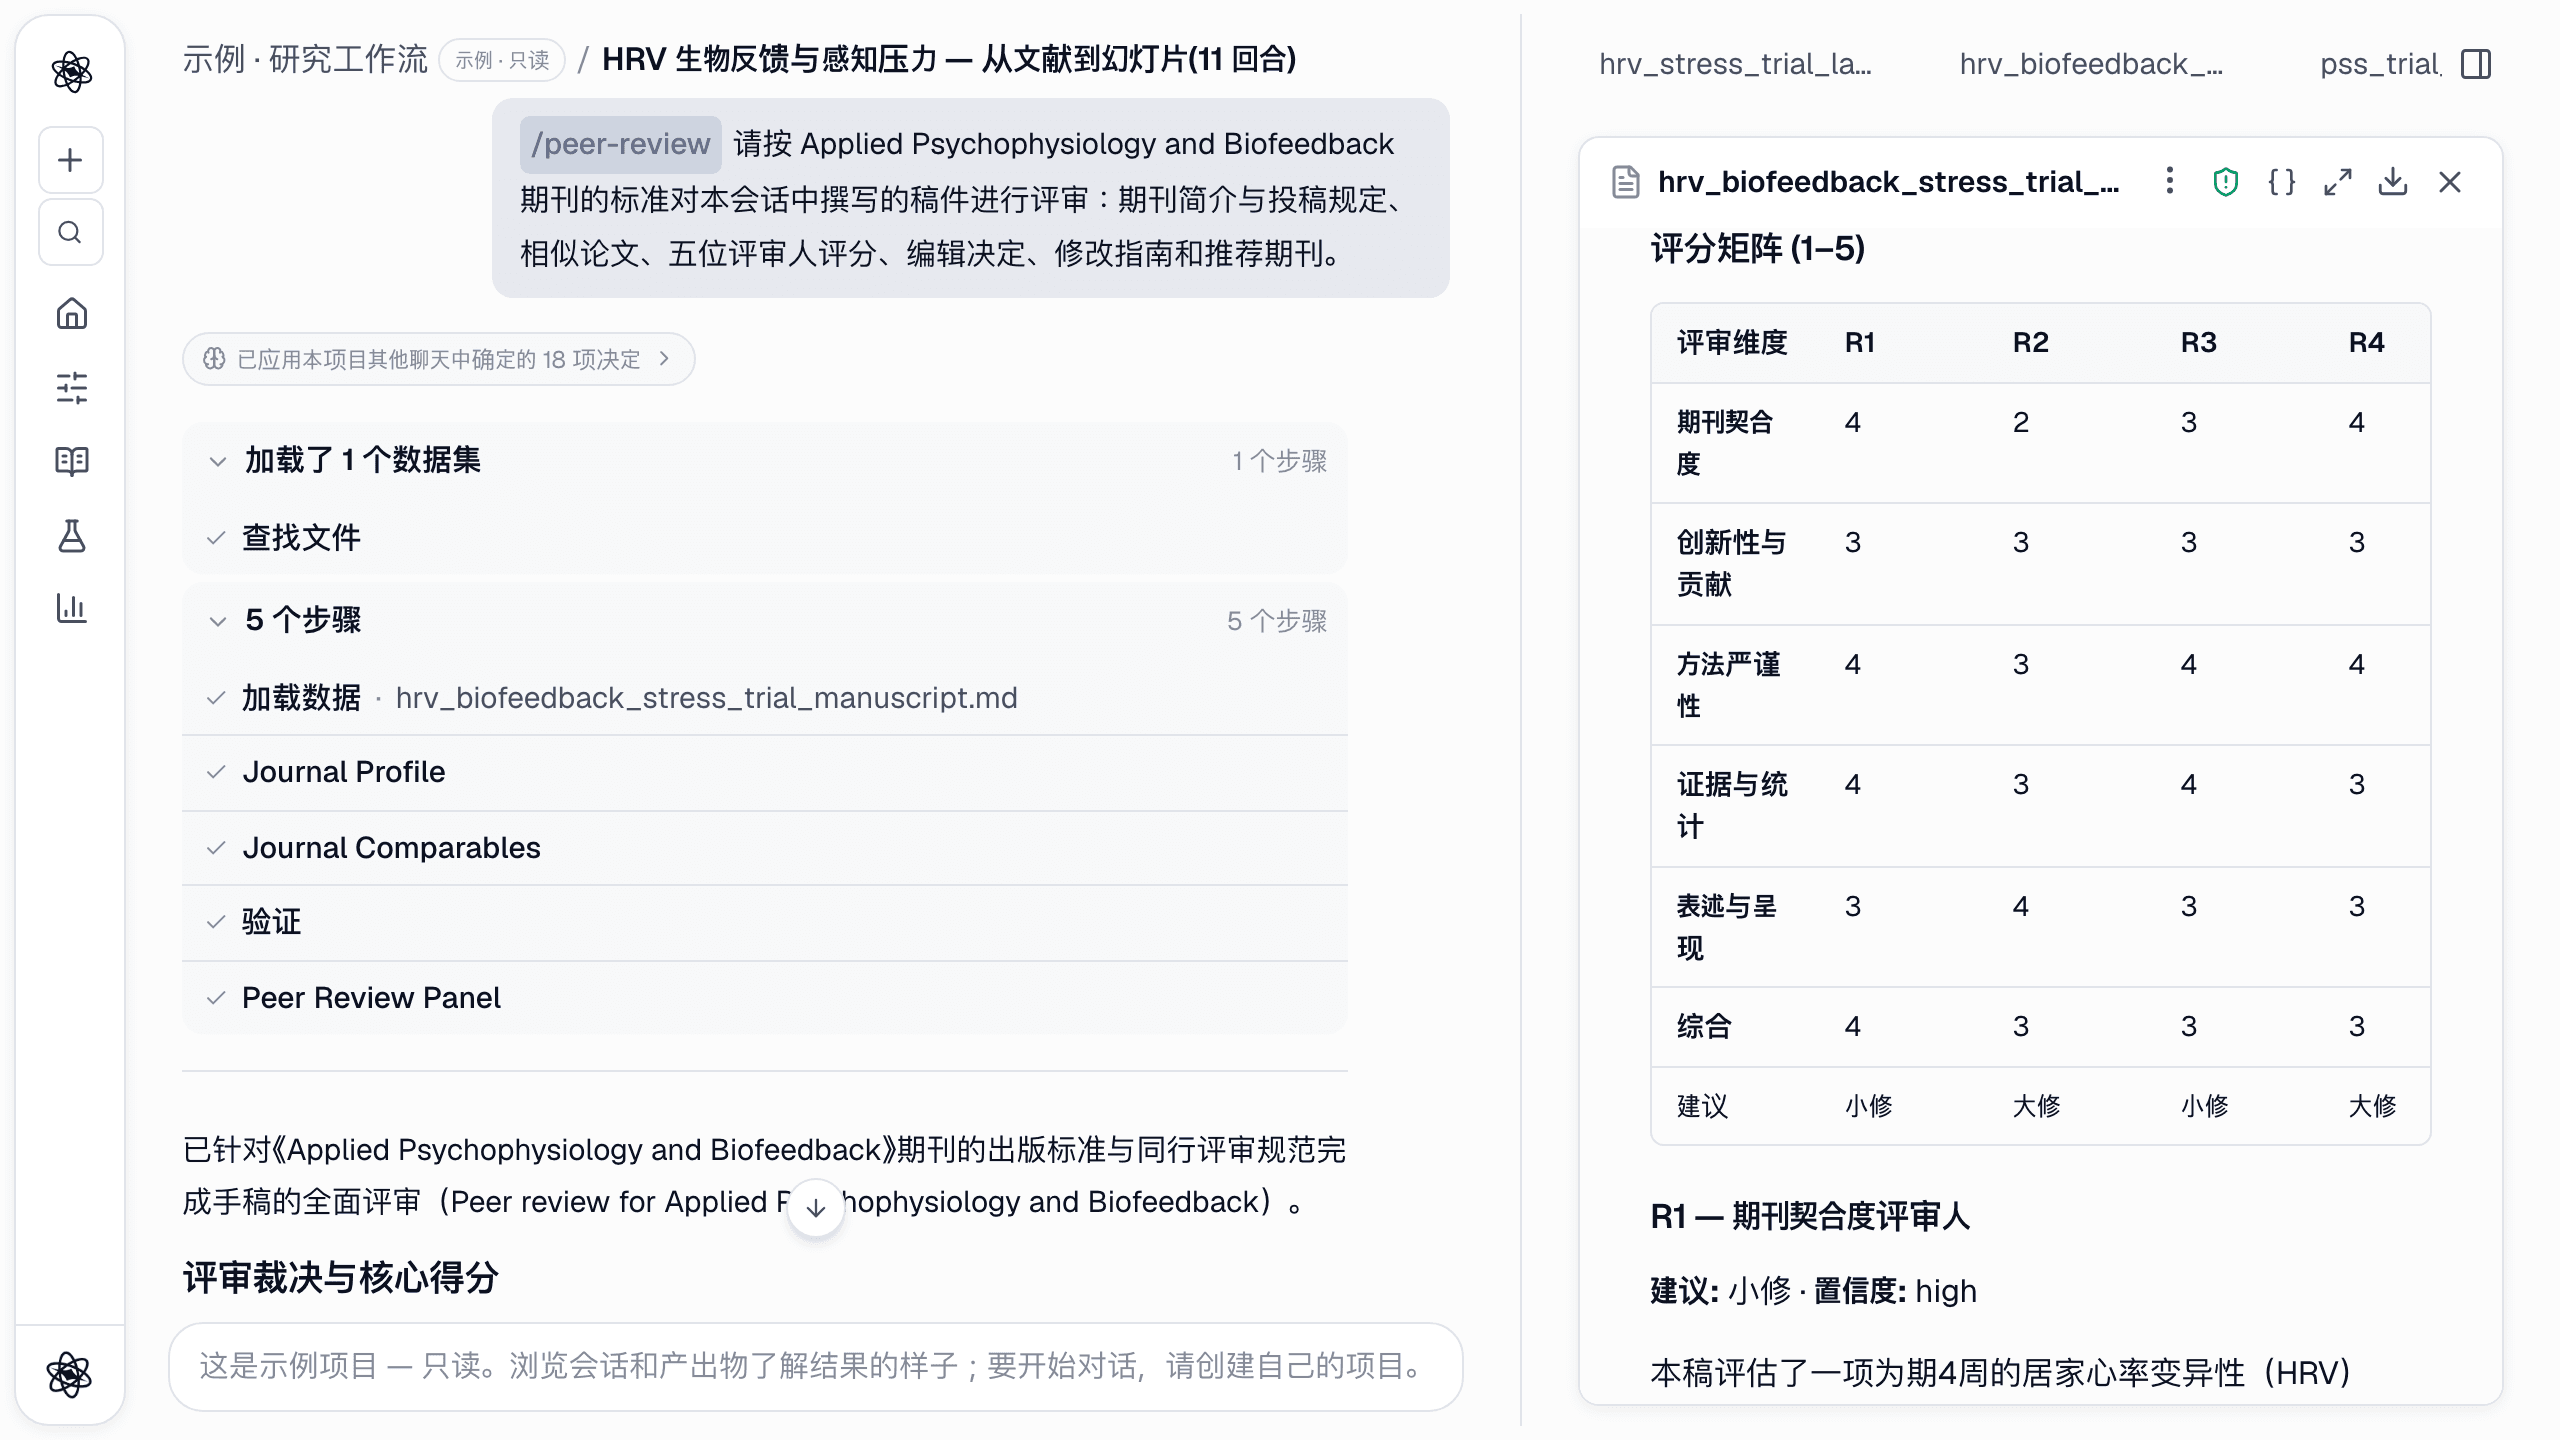
英文稿件的裁决是 Major Revision,理由很具体。摘要 265 词,超出 250 词上限。期刊要求 APA 第 7 版,而引用是数字编号式。缺少声明页。领域评审人指出,固定每分钟六次呼吸的方案是带反馈的节律呼吸,而非个体化的共振频率训练;而且 App 记录了脉搏数据,稿件却完全没有报告。报告以按 P0 到 P2 排序、附工作量估计的修改指南,标有通过/未通过的投稿规定核对表,确定性检查(六条参考文献全部核实,十项统计量一致)和四本备选期刊收尾。其他语言的会话得出了各自的裁决,五位评审人读的是不同的稿件,这本在预期之中。
回合 11 — 组会幻灯片
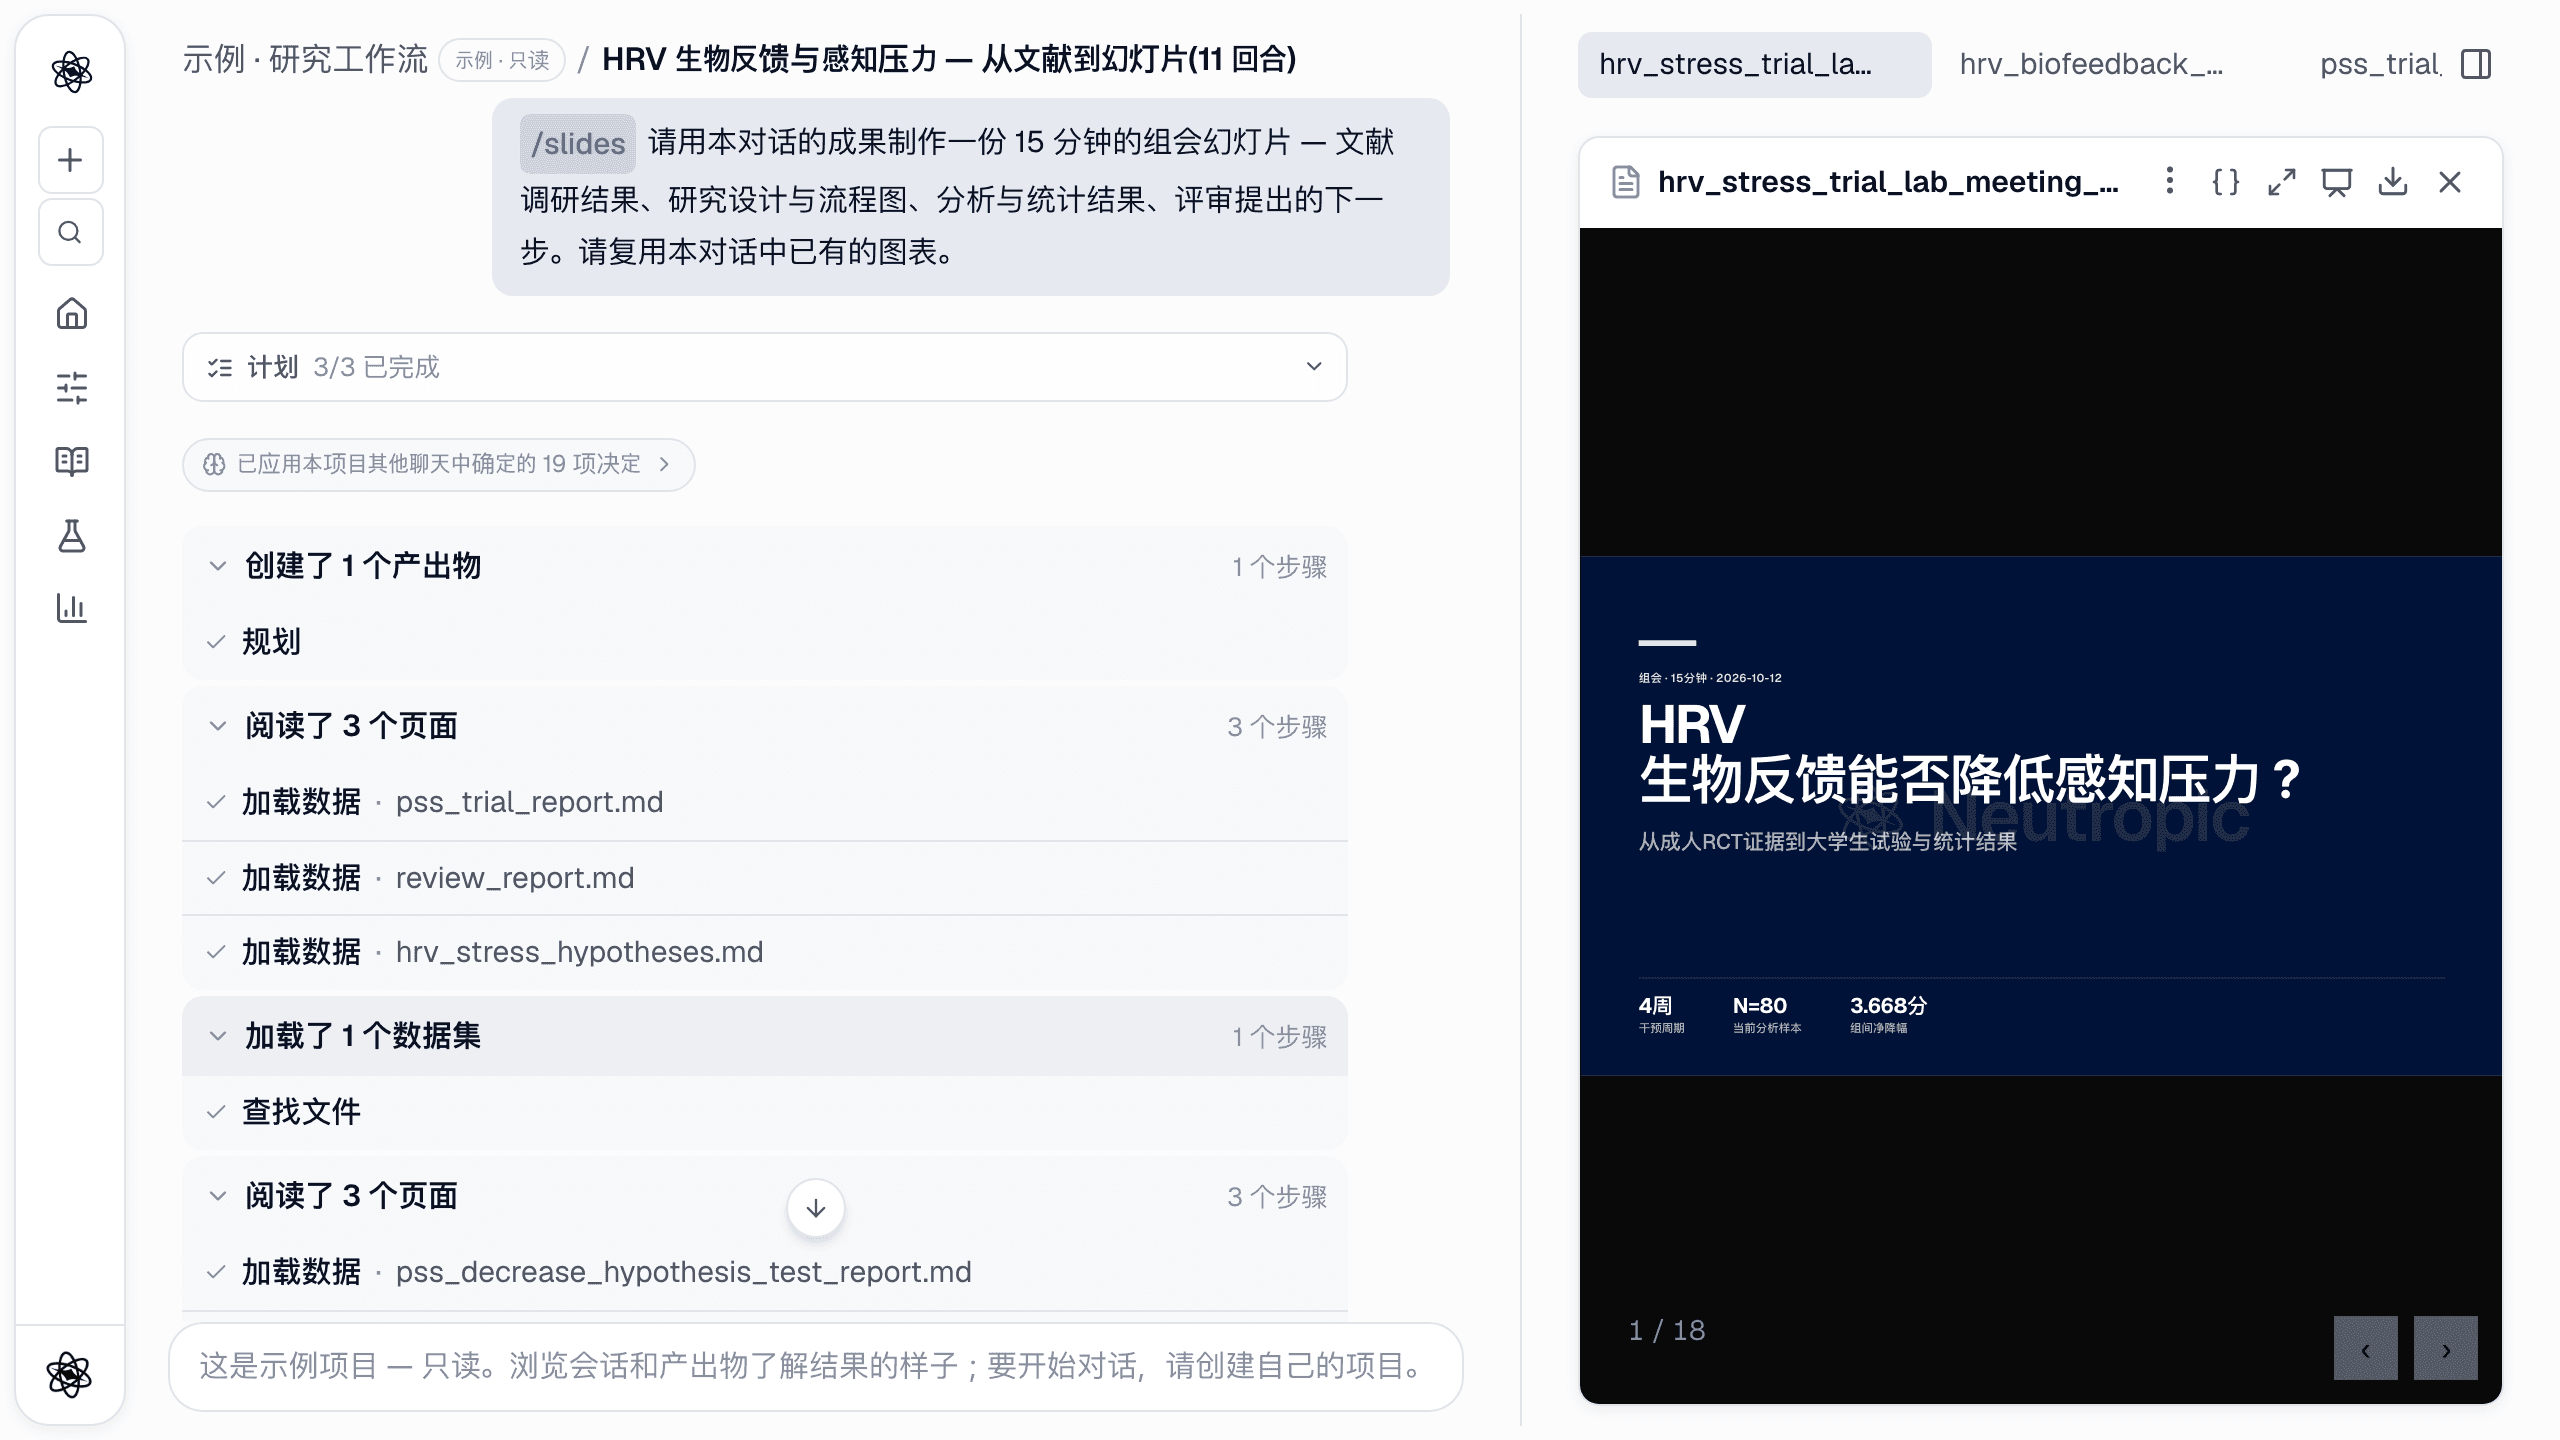
/slides 请用本对话的成果制作一份 15 分钟的组会幻灯片 — 文献调研结果、研究设计与流程图、分析与统计结果、评审提出的下一步。请复用本对话中已有的图表。
最后一回合最清楚地展示了一个会话承载着什么。它以 已应用本项目其他聊天中确定的 14 项决定 开场,读取设计报告、分析与统计报告、假设、审查与评审报告,做出一份 17 页的幻灯片,复用了流程图和结果图。它自己的总结划出了关键的界线:幻灯片"区分计划中的设计细节与已分析的数据集,不把生理变化或 3 个月结果当作发现呈现"。它也说明了省略了哪些产出物以及原因。在面板点击演示可全屏放映,或下载 PPTX、PDF、HTML。
详细指南:幻灯片。
是什么把它们串在一起
回看这十一个回合,通常由人在工具之间承担的工作,被四种机制接手了。
- 产出物就是记忆。 每个回合按名称读取它需要的早期文件,步骤列表显示读了哪些。稿件不是记住了统计量,而是加载了统计报告。
- 已确定的决定在累积。 已应用本项目其他聊天中确定的 N 项决定 标签随着项目逐渐知道哪些已固定,从 3 增至 6、7、11、14:结局指标、分组、样本、检验、期刊。在对话里把决定说出来,是让后面回合遵守它的最可靠方式。
- 来源是保存的,不是记忆的。 文献回合的来源留在会话里,所以稿件的参考文献和论文评审的对比论文都指向真实论文。会话结束时保存了 61 条来源,其中 9 条被稿件引用。
- 检查也是回合。 稿件检查、报告审查的重分析、论文评审的规定核对表,都在同一个对话里读同样的文件。这项研究唯一的科学空白,反馈对比节律呼吸,在假设回合浮现,在稿件中披露,又被两次审查再次提出。
两条实用提示。这么长的会话对模型不成问题:上下文自动管理,想手动精简时 /compact 会把对话摘要。令牌方面,整个运行用了约 210 万托管令牌,大部分花在写作、审查和幻灯片回合。考虑到免费计划的每日上限,这样的工作流要分几天跑;付费计划提高上限并增加高级模型。见计划与令牌和令牌指南。
你的位置
Neutropic 起草并检查,研究仍然是你的。会话停下来等待判断的地方,就是你该投入时间的地方。
- 选定假设,并确保设计真的能检验它。
- 上传真实数据,把 N 与入组记录核对。
- 亲自读论证所依赖的三四篇论文。
- 在别人读初稿之前,修好报告审查发现的问题。
- 把论文评审的修改指南当作待办清单,而不是判决。
会话完成后,与其导出不如分享:一个只读链接就能让导师或合作者看到同样的界面,包括全部产出物。
从我的资料库打开示例 · 研究工作流,展开步骤列表,追踪一个数字(比如 d = 1.23)从统计回合到稿件、审查和幻灯片的全过程。