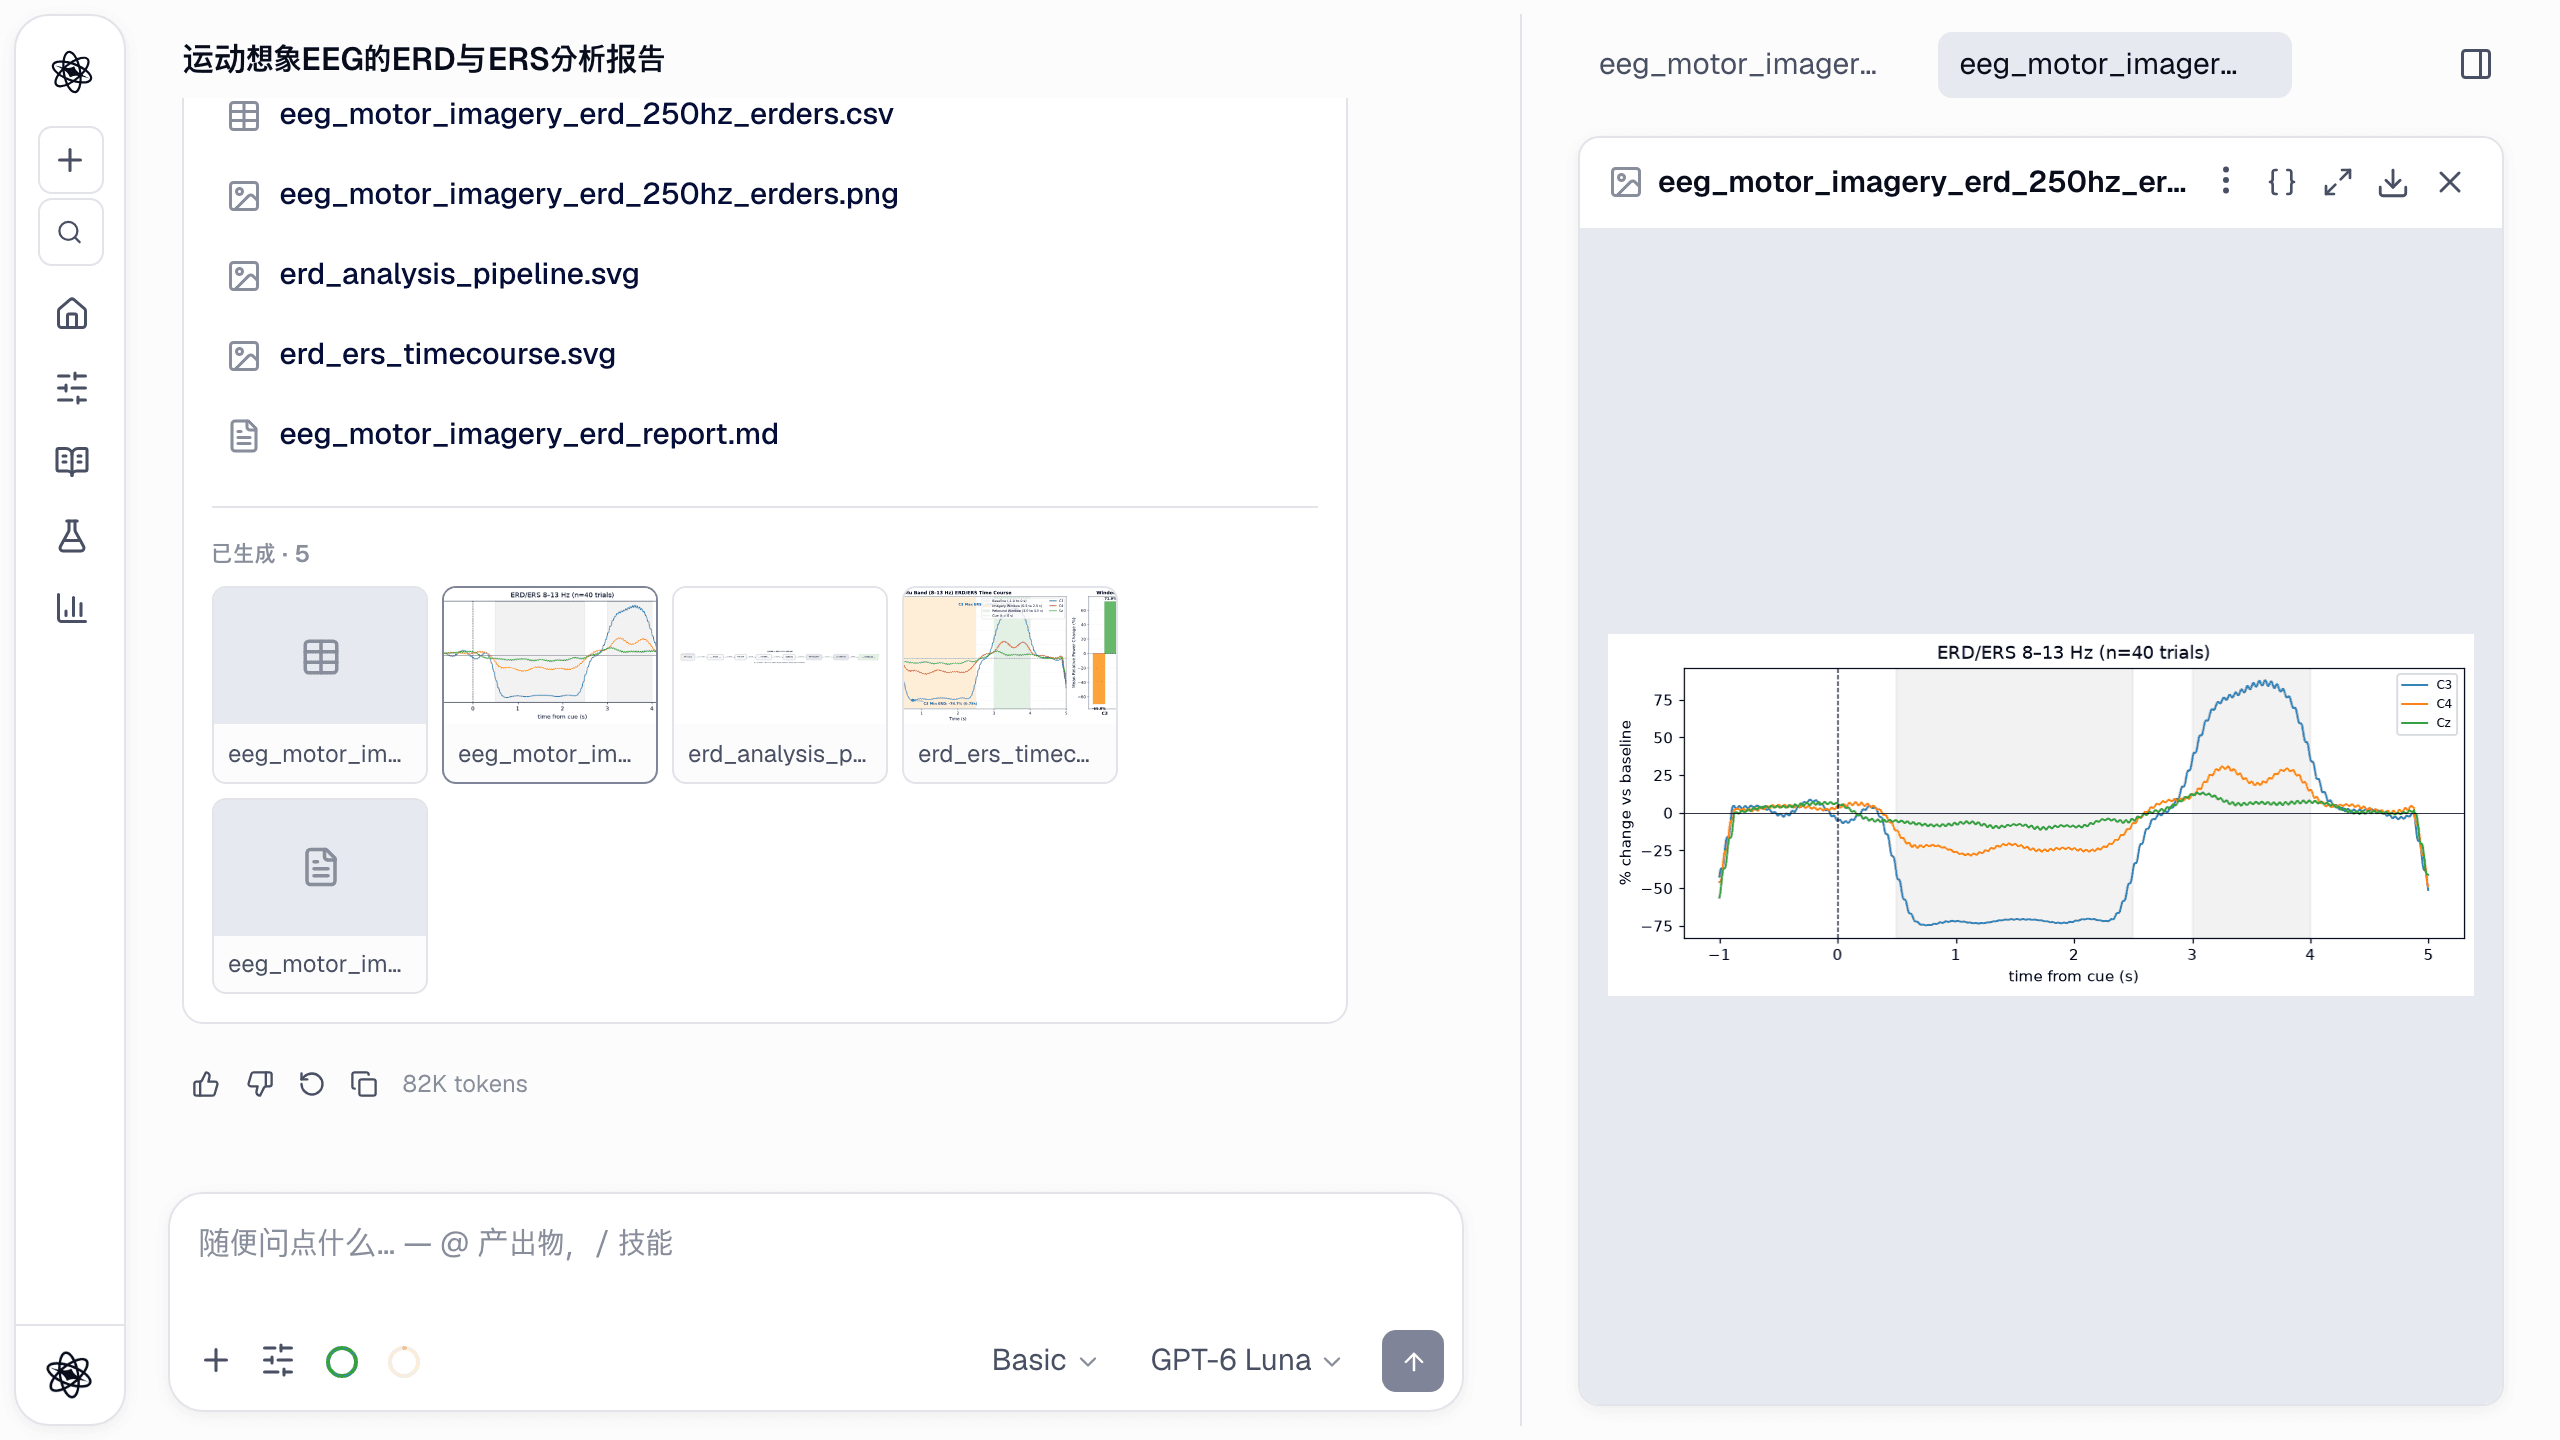
音频是研究中信息最丰富的记录之一,也是分析起来最繁琐的数据之一。话语交给转写服务或研究助理,嗓音交给 Praat,数字再复制进表格,然后导入 R 或 SPSS。等到写结果部分时,已经没人记得当时用的音高下限是多少,也不记得编码的是哪个版本的转写稿。
在 Neutropic 中,音频从上传到报告都留在同一个会话里。本文只深入讲音频:能上传什么、每个工具测什么、如何读结果、局限在哪里。EEG、音频和视频的整体介绍见超越电子表格。
可以上传什么
像其他文件一样把录音附加到对话中即可。支持的音频格式有 .wav .mp3 .m4a .flac .ogg .aac .aiff。转写也能读取视频(.mp4 .mov .webm 等)的音轨。单个文件最大 1 GB。
实际使用时的几点建议:
- 嗓音指标首选 WAV。 转写能读取上述所有格式,但音高和声学工具以 WAV 为准编写文档。重视嗓音质量时,请先把压缩格式转成 WAV。
- 一个文件一位说话人效果最好。 嗓音工具汇总的是整段录音。访谈中若有两个人的声音,音高统计会混在一起(详见局限部分)。
- 说明录音是什么。 写上"朗读样本""半结构化访谈,参与者 P07""出声思维,任务 3"之类,智能体就能选对步骤,报告措辞也更准确。
由 Neutropic 自己运行的语音转写
转写使用 faster-whisper(OpenAI Whisper 模型的开源实现),运行在 Neutropic 自己的服务器上。音频不会发送到外部转写 API。
- 模型大小。 可选
tiny、base、small、medium。模型越大越慢,也越准确。只要不是清晰的英语,建议选small或medium。 - 语言。 Whisper 会检测语言并给出概率。也可以直接指定(例如"这段音频是中文")以跳过检测。中文输出会统一为简体字。
- 带时间戳的片段。 每个片段都有起止时间(秒)。静音由语音活动检测(VAD)过滤,因此较长的停顿会表现为片段之间的空隙。
- 长度与语速。 英语、韩语等以空格分词的语言给出词数和每分钟词数(WPM)。中文和日语书写时不用空格,因此按字符数和每分钟字符数(CPM)计算。(在今天之前,这两种语言会显示成"1 words""2 words",现已修复。)
结果保存为 <文件名>_transcript.md 工件:顶部是模型、语言、时长和长度,下面是全文和片段表。
/analyze interview_P07.m4a 是一段中文半结构化访谈。请用 Whisper small 模型带时间戳转写,转写文本保持原样,不要改写。
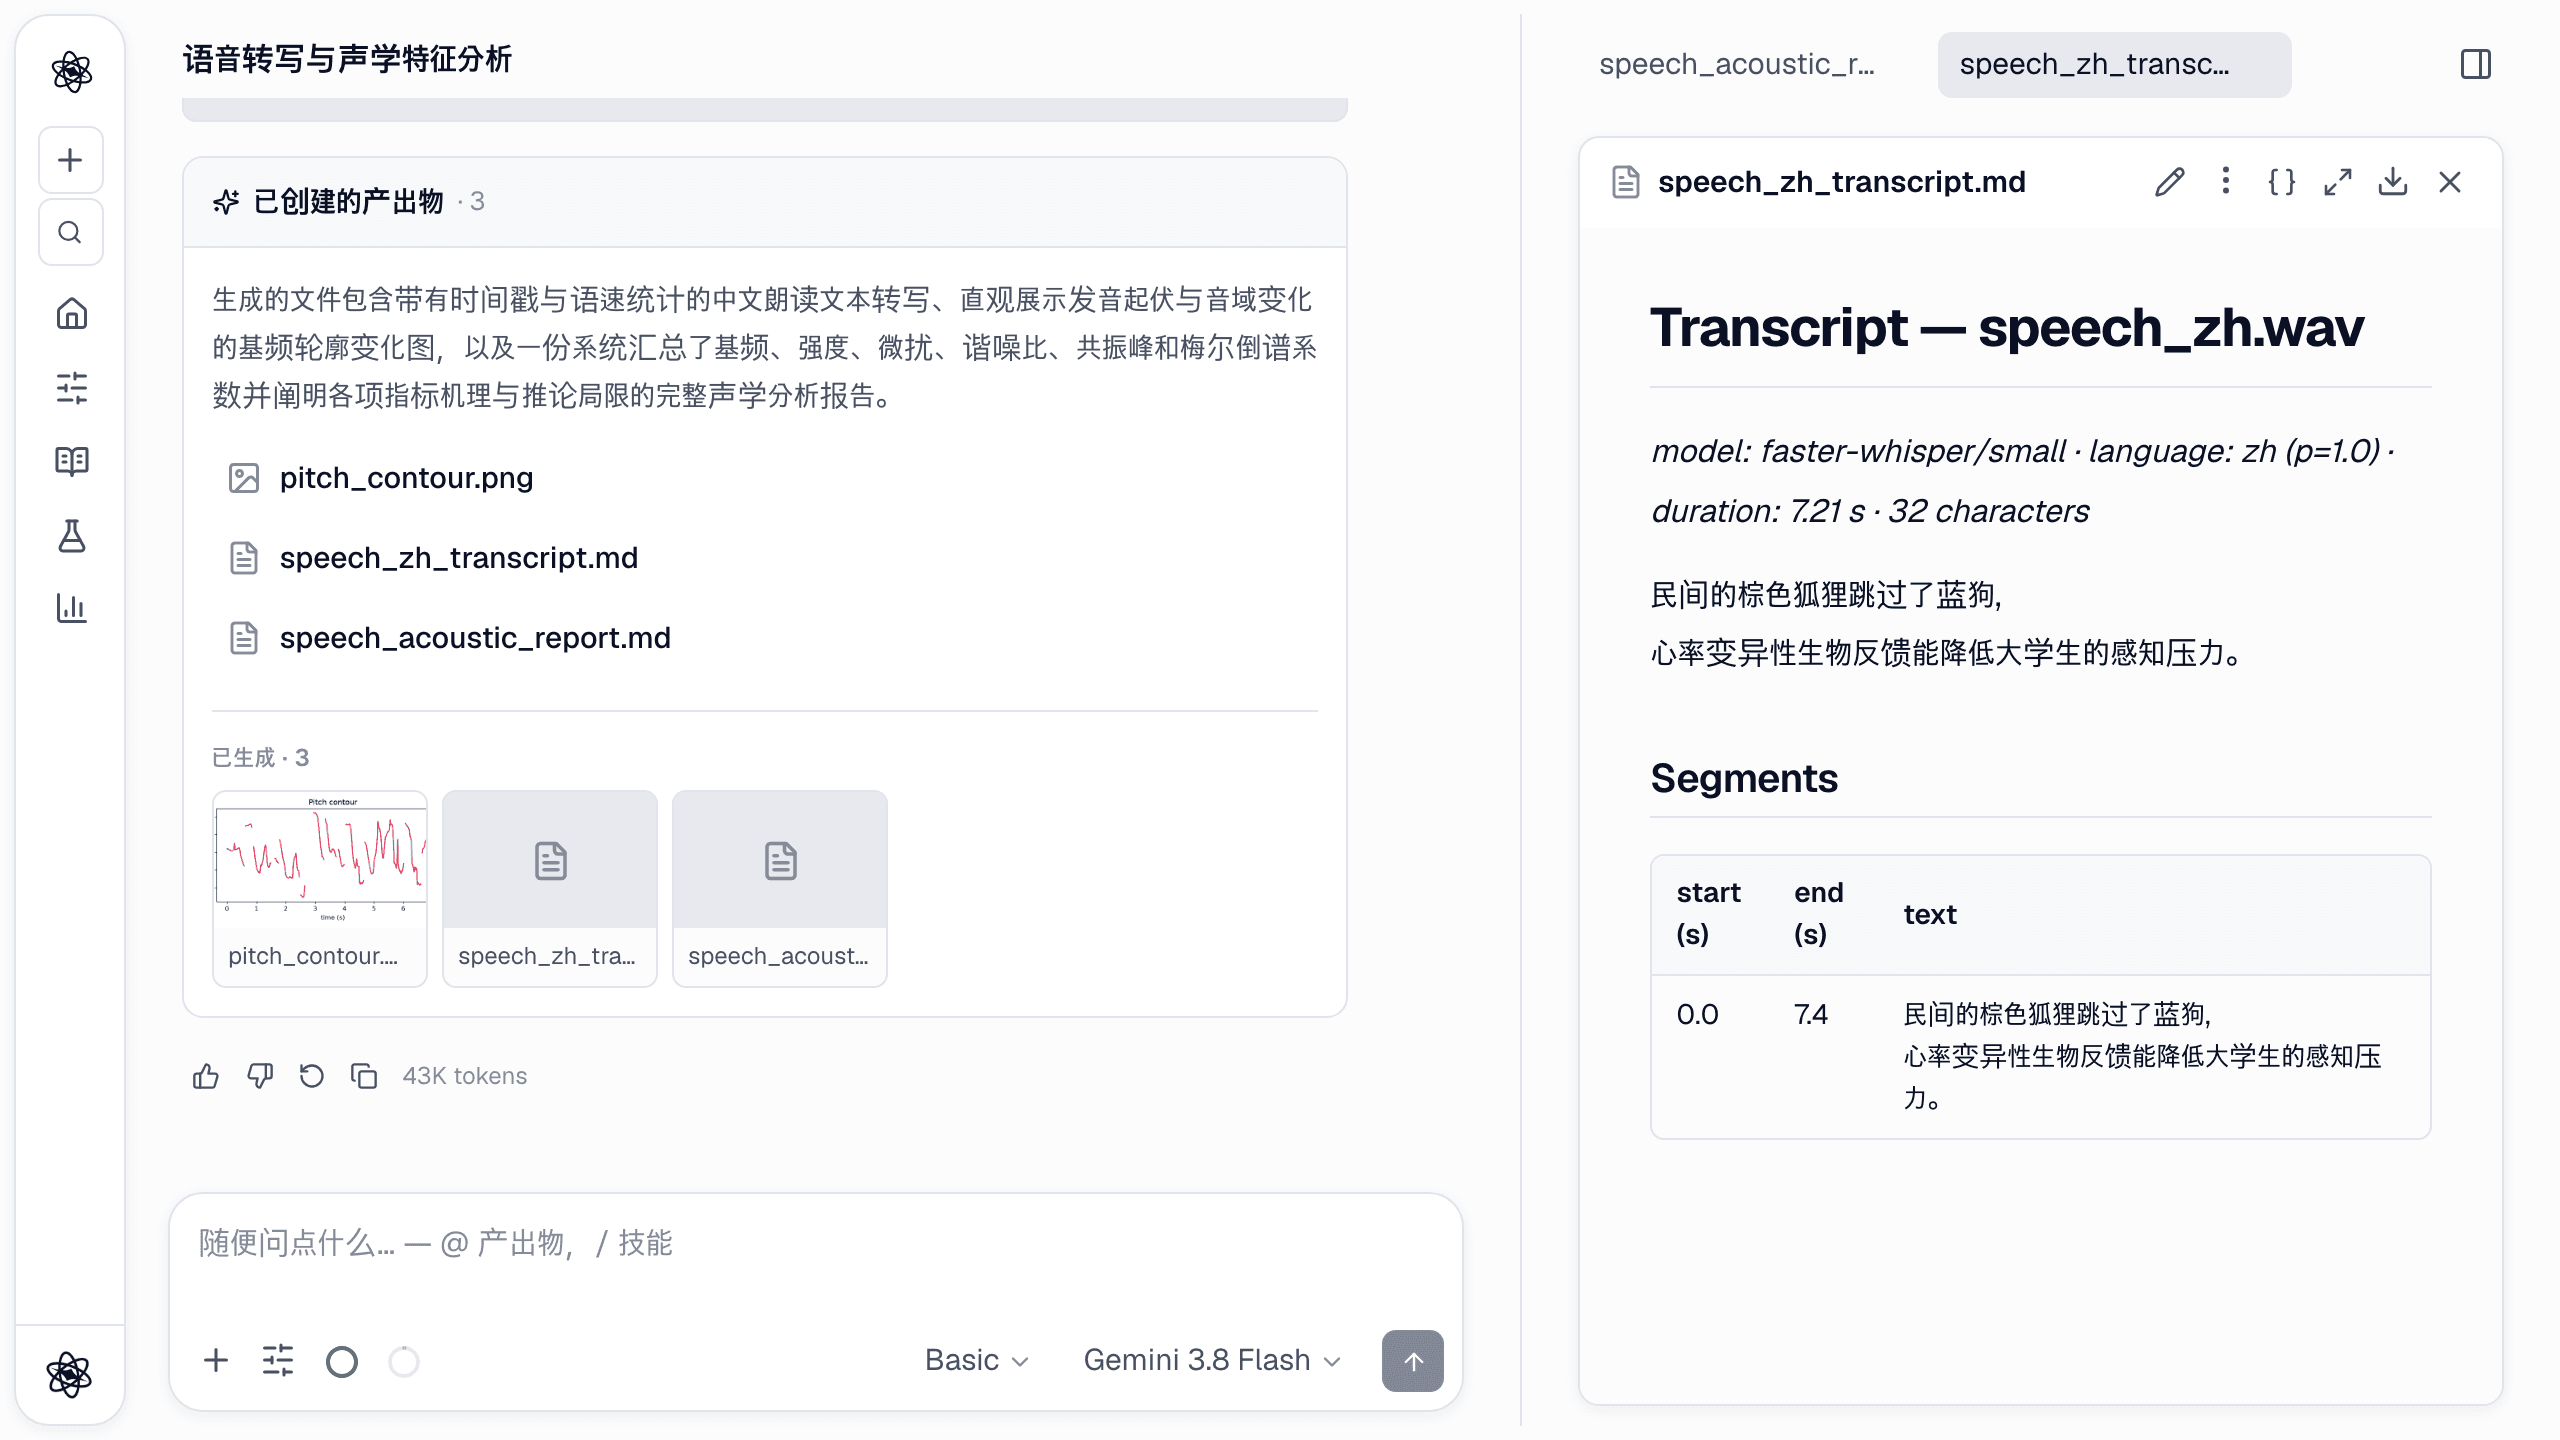
智能体被要求逐字引用转写文本,绝不把改写后的内容当作音频原话。之后对文本编码时,这一点很重要。
嗓音:音高、强度与嗓音质量
voice 工具读取音频并返回:
- 音高(F0):均值、标准差、最小值、最大值和范围(Hz),用 pYIN 在 65–400 Hz 之间追踪,另给出浊音比例。
- 强度:RMS 能量的均值和标准差。这是录音内的相对值,不是校准过的 dB SPL。
- 频谱质心(Hz)。
- 通过 Praat(parselmouth)测得的嗓音质量:local jitter、local shimmer 和 HNR(dB)。
- 一张音高轮廓图
pitch_contour.png。
acoustic_features 工具再补充:
- 共振峰 F1–F3(Praat,Burg 方法):均值和标准差(Hz)。
- 13 个 MFCC:每个系数的均值和标准差。
- 过零率、频谱带宽和频谱滚降。
两个工具都不会给录音贴情绪标签。voice 的输出自带说明:F0 均值、F0 变异和强度越高,通常意味着唤醒度越高;jitter、shimmer、HNR 描述嗓音质量;但这些只是特征,不是经过验证的情绪分类器。报告也遵守这条界线。
/analyze 请测量 speech_zh.wav 的嗓音:F0 均值、标准差、范围和轮廓,强度,jitter、shimmer 和 HNR,以及共振峰 F1–F3 和 MFCC。说明每个指标的含义,以及仅凭这一段录音能说明什么、不能说明什么。
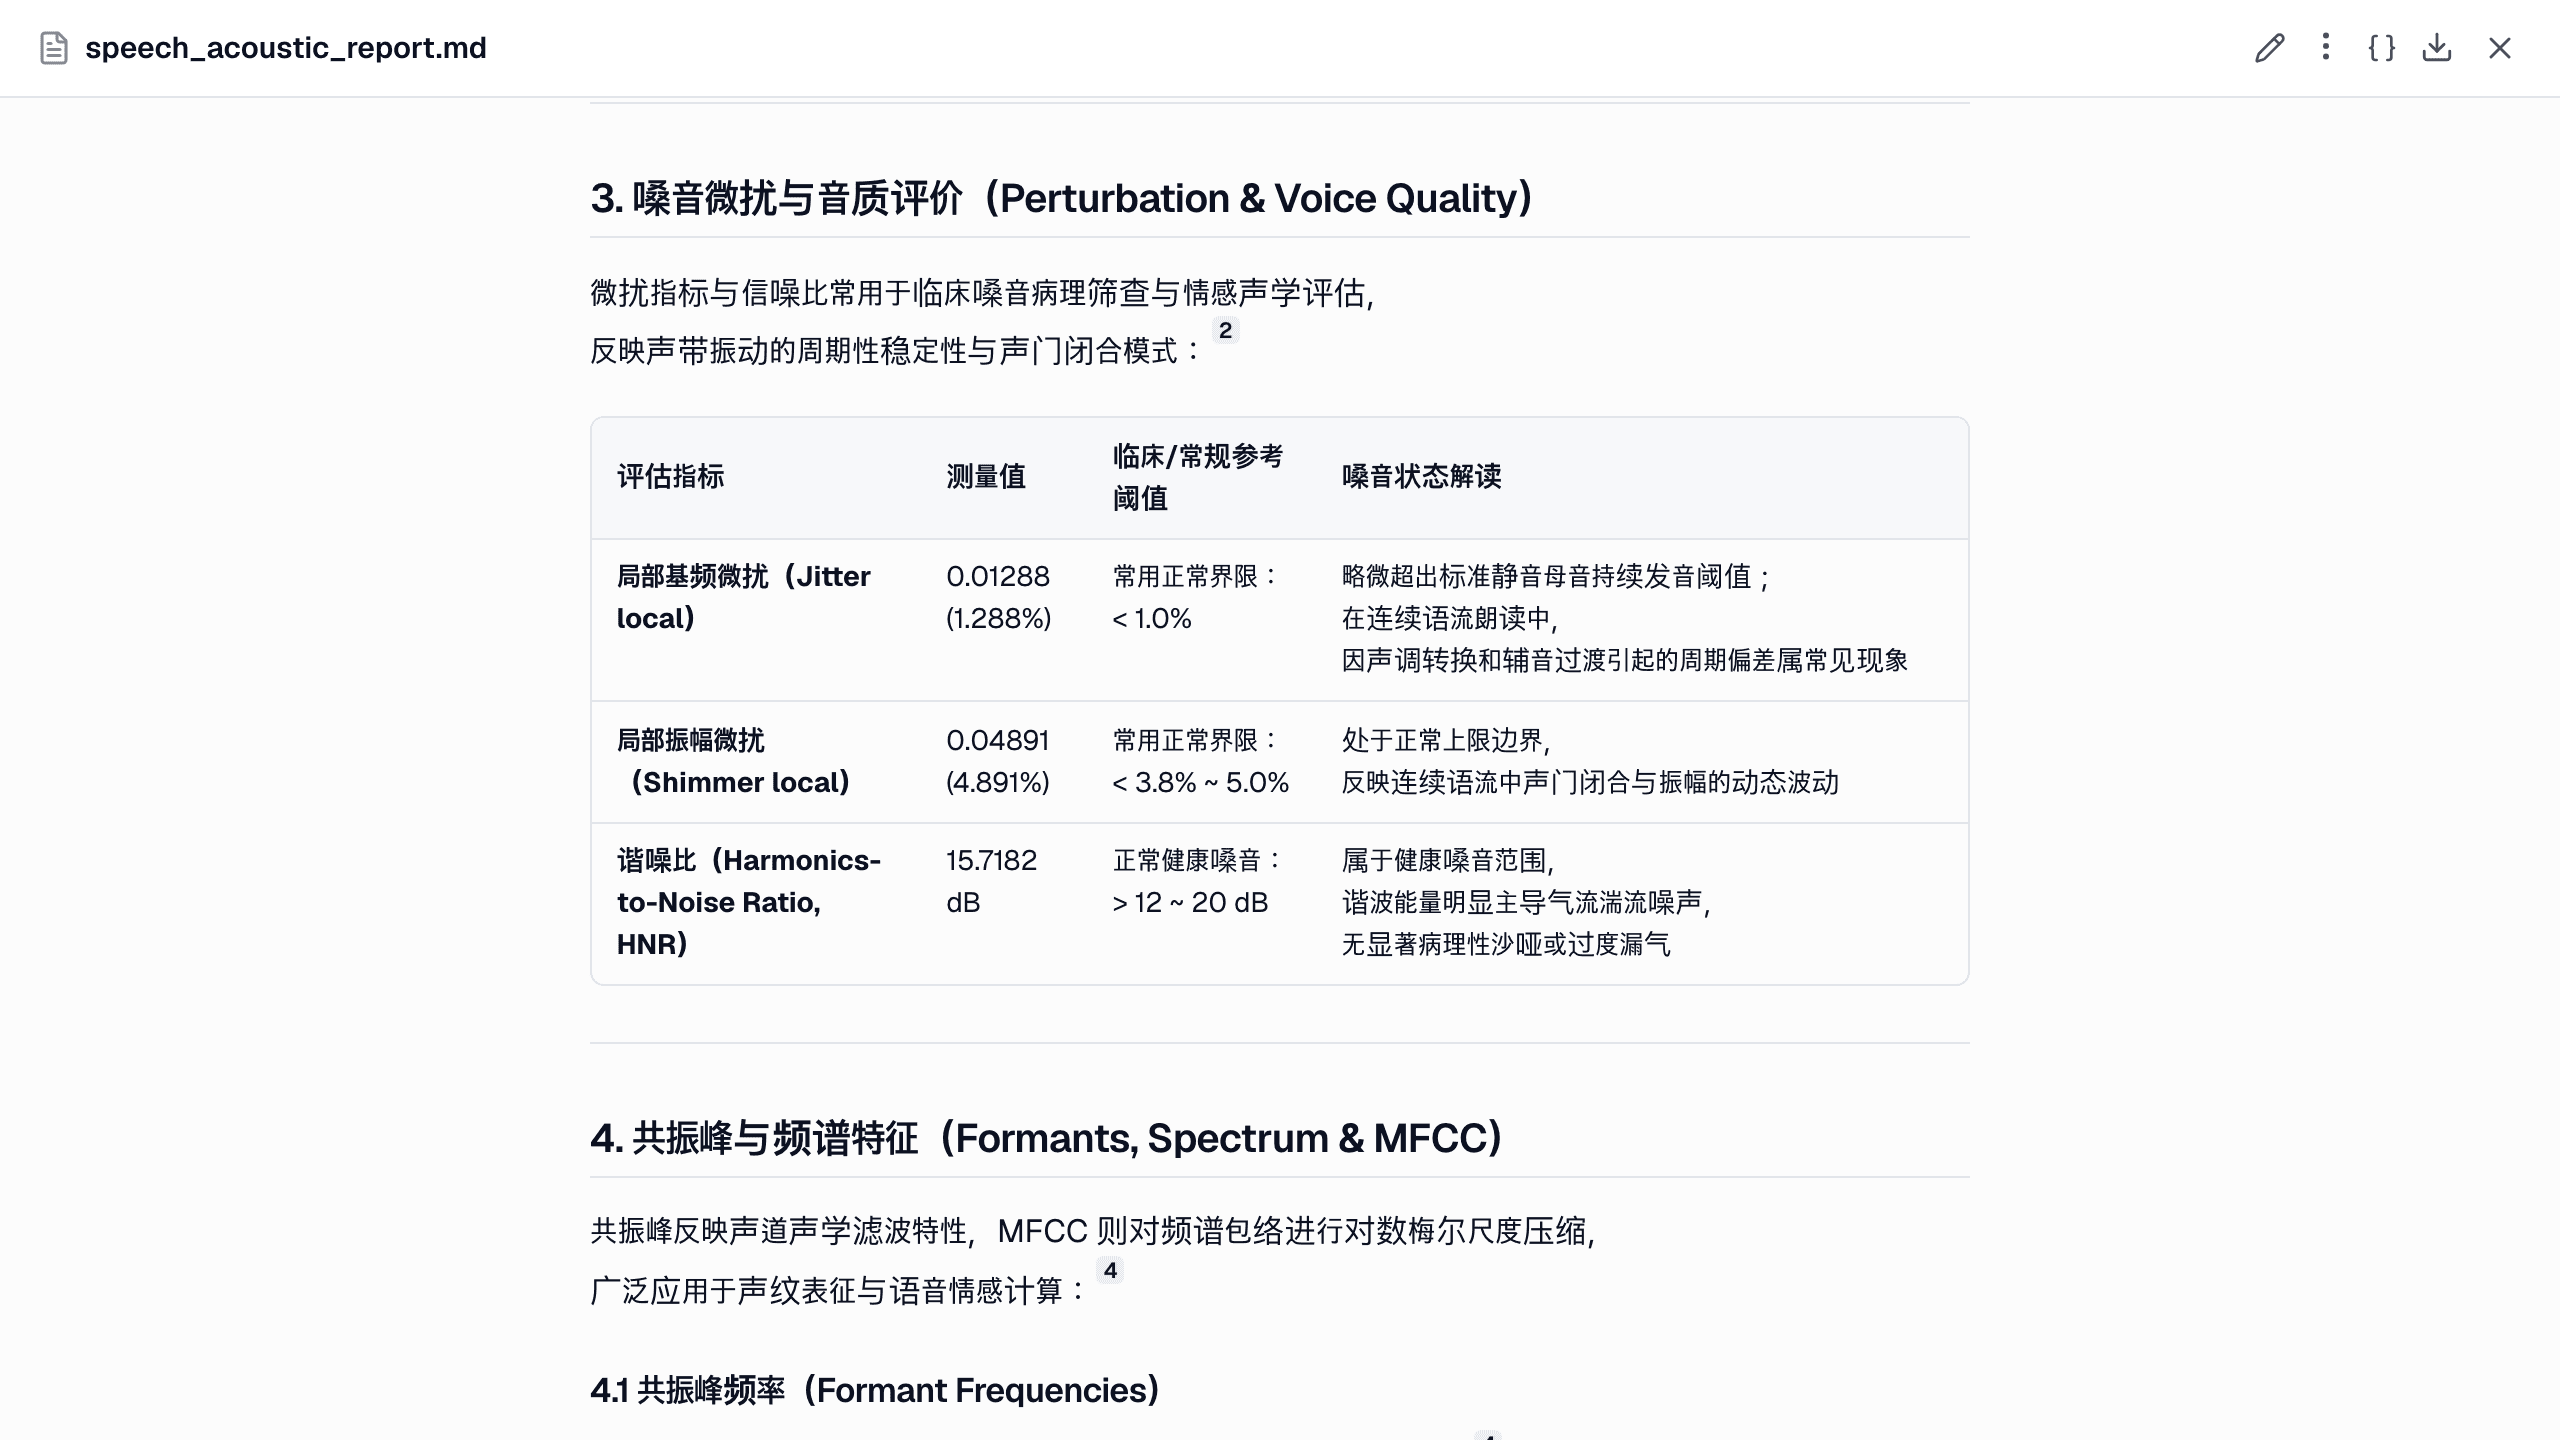
在英语样本(7.4 秒的合成朗读)上,工具返回 F0 均值 173.7 Hz(范围 100.8–233.0 Hz)、jitter 1.2%、shimmer 6.6%、HNR 16.0 dB,F1–F3 为 676、1878、2996 Hz。我们用 Praat 对同一段录音单独测得的参考值是 F0 均值 171.7 Hz。
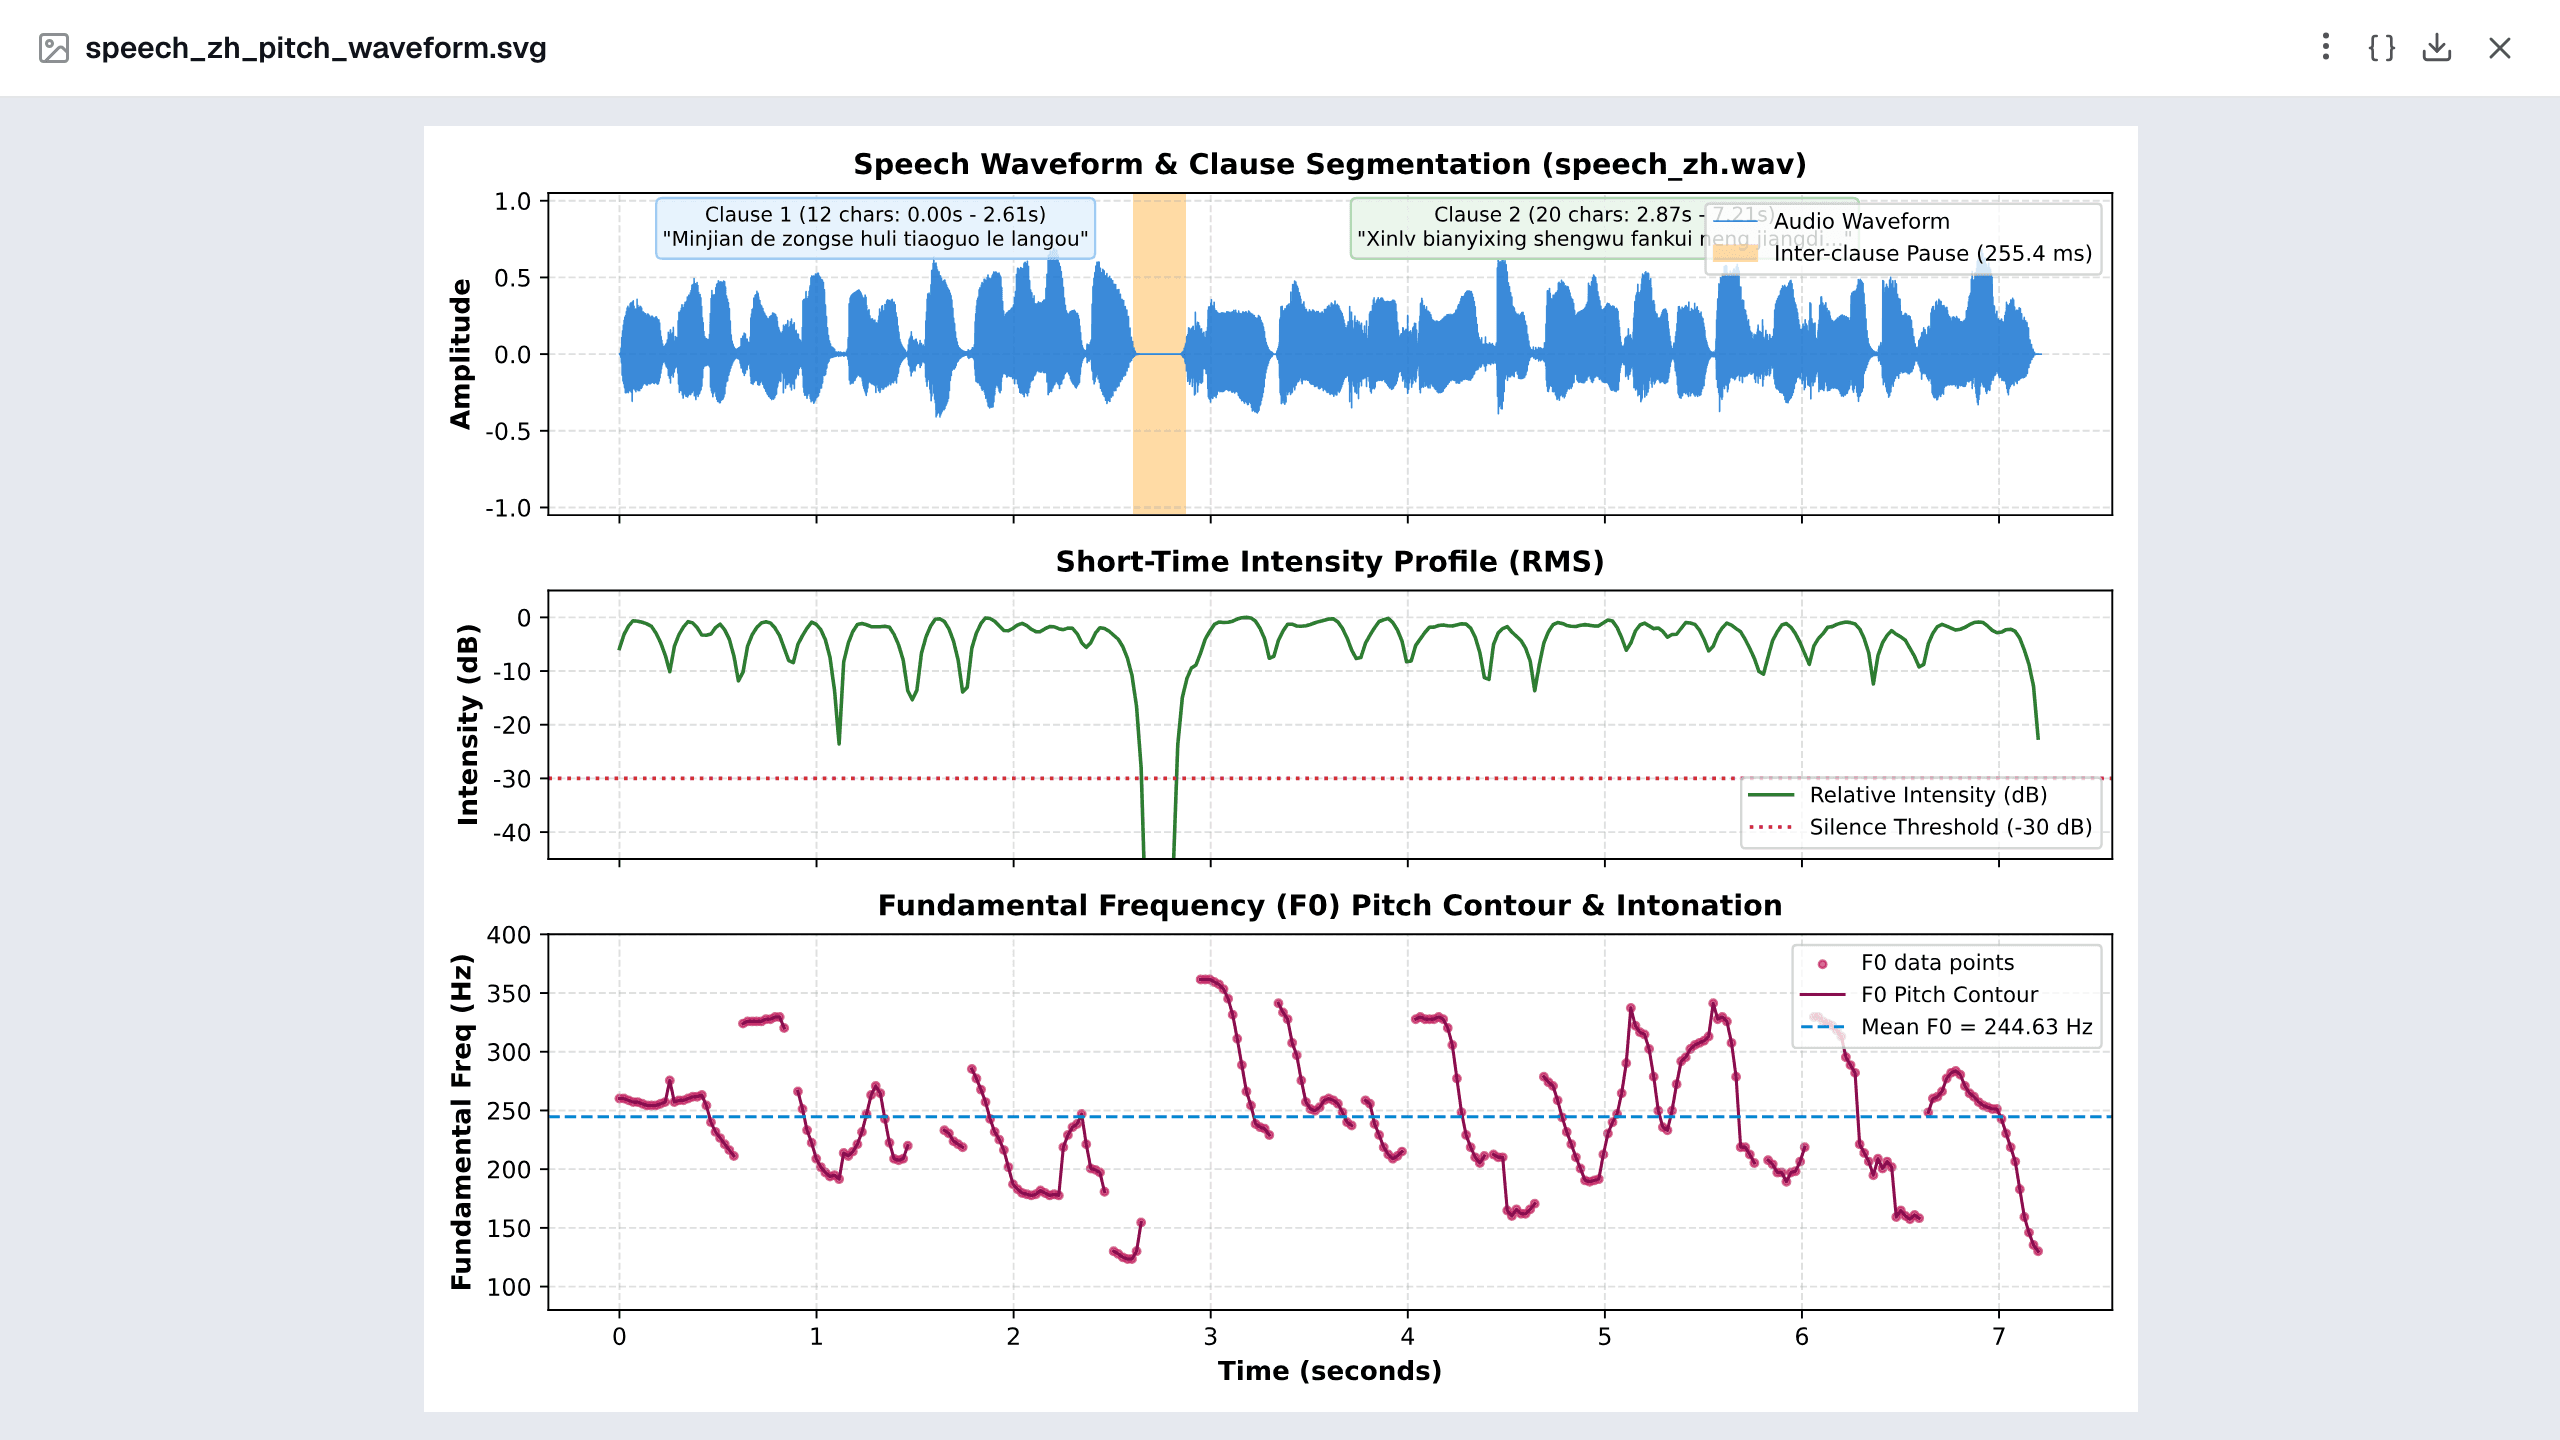
如果你要求画图,智能体可以比默认轮廓走得更远。在示例项目中,它画出了标出停顿的波形,以及叠加在强度曲线上的 F0 轮廓:
常见研究用途
访谈与主题编码。 逐个转写访谈,再让智能体把片段整理成带参与者列的表格。文本工具就在这张表上运行:text_overview(长度和高频词)、theme_clusters(附代表性引语的候选主题,可作为开放编码的起点)、topic_model(LDA 或 NMF)和 sentiment(VADER,仅限英语)。聚类结果只当作建议,工具本身也说明这些是需要对照原文核实的候选主题。
出声思维可用性测试。 借助片段时间戳,可以把参与者说的话对齐到任务时间线上。让智能体按任务时间窗提取对应片段,再结合同一研究中的任务成功率或 SUS 分数来看。
情绪韵律。 比较不同条件下的 F0 均值、F0 标准差和强度(例如同一批说话人朗读的中性句与情绪句)。说话人内部的比较远比解读单段录音可靠。
嗓音压力。 jitter、shimmer、HNR 和 F0 是压力或认知负荷研究中常见的声学相关指标。为每个人录一段基线,再把任务录音与之比较。如果只让它评判单段录音,报告会先说明这样做的局限。
从一段录音到一项研究:跨参与者的统计
研究很少只有一段录音。上传所有参与者的文件(或每个条件一个文件),对每个文件请求相同的指标,并把逐文件的结果汇总成带参与者和条件列的表。之后交给统计工具:
compare_groups根据设计和数据选择检验(配对或独立、参数或非参数),并用决策记录(decision trace)说明理由。mixedlm处理重复测量,把参与者作为随机效应,例如每位说话人有多段语句的情况。
/stats voice_features.csv 每行是一段录音:participant、condition(baseline / stress)、f0_mean、f0_sd、jitter、shimmer、hnr。请在参与者内部比较两种条件,检查前提假设,并报告效应量。
检验如何选择,见统计指南。
每句话都可追溯
分析报告根据工具输出撰写,每句话都带 [n] 引用。每个编号指向该句依据的分析步骤(media_info、transcribe_audio、voice、acoustic_features)或数据文件。对话中会出现类似"已为分析报告的 49 个句子添加 [n] 引用"的提示,报告末尾的参考文献会列出每个步骤的参数及其原始结果的开头部分。
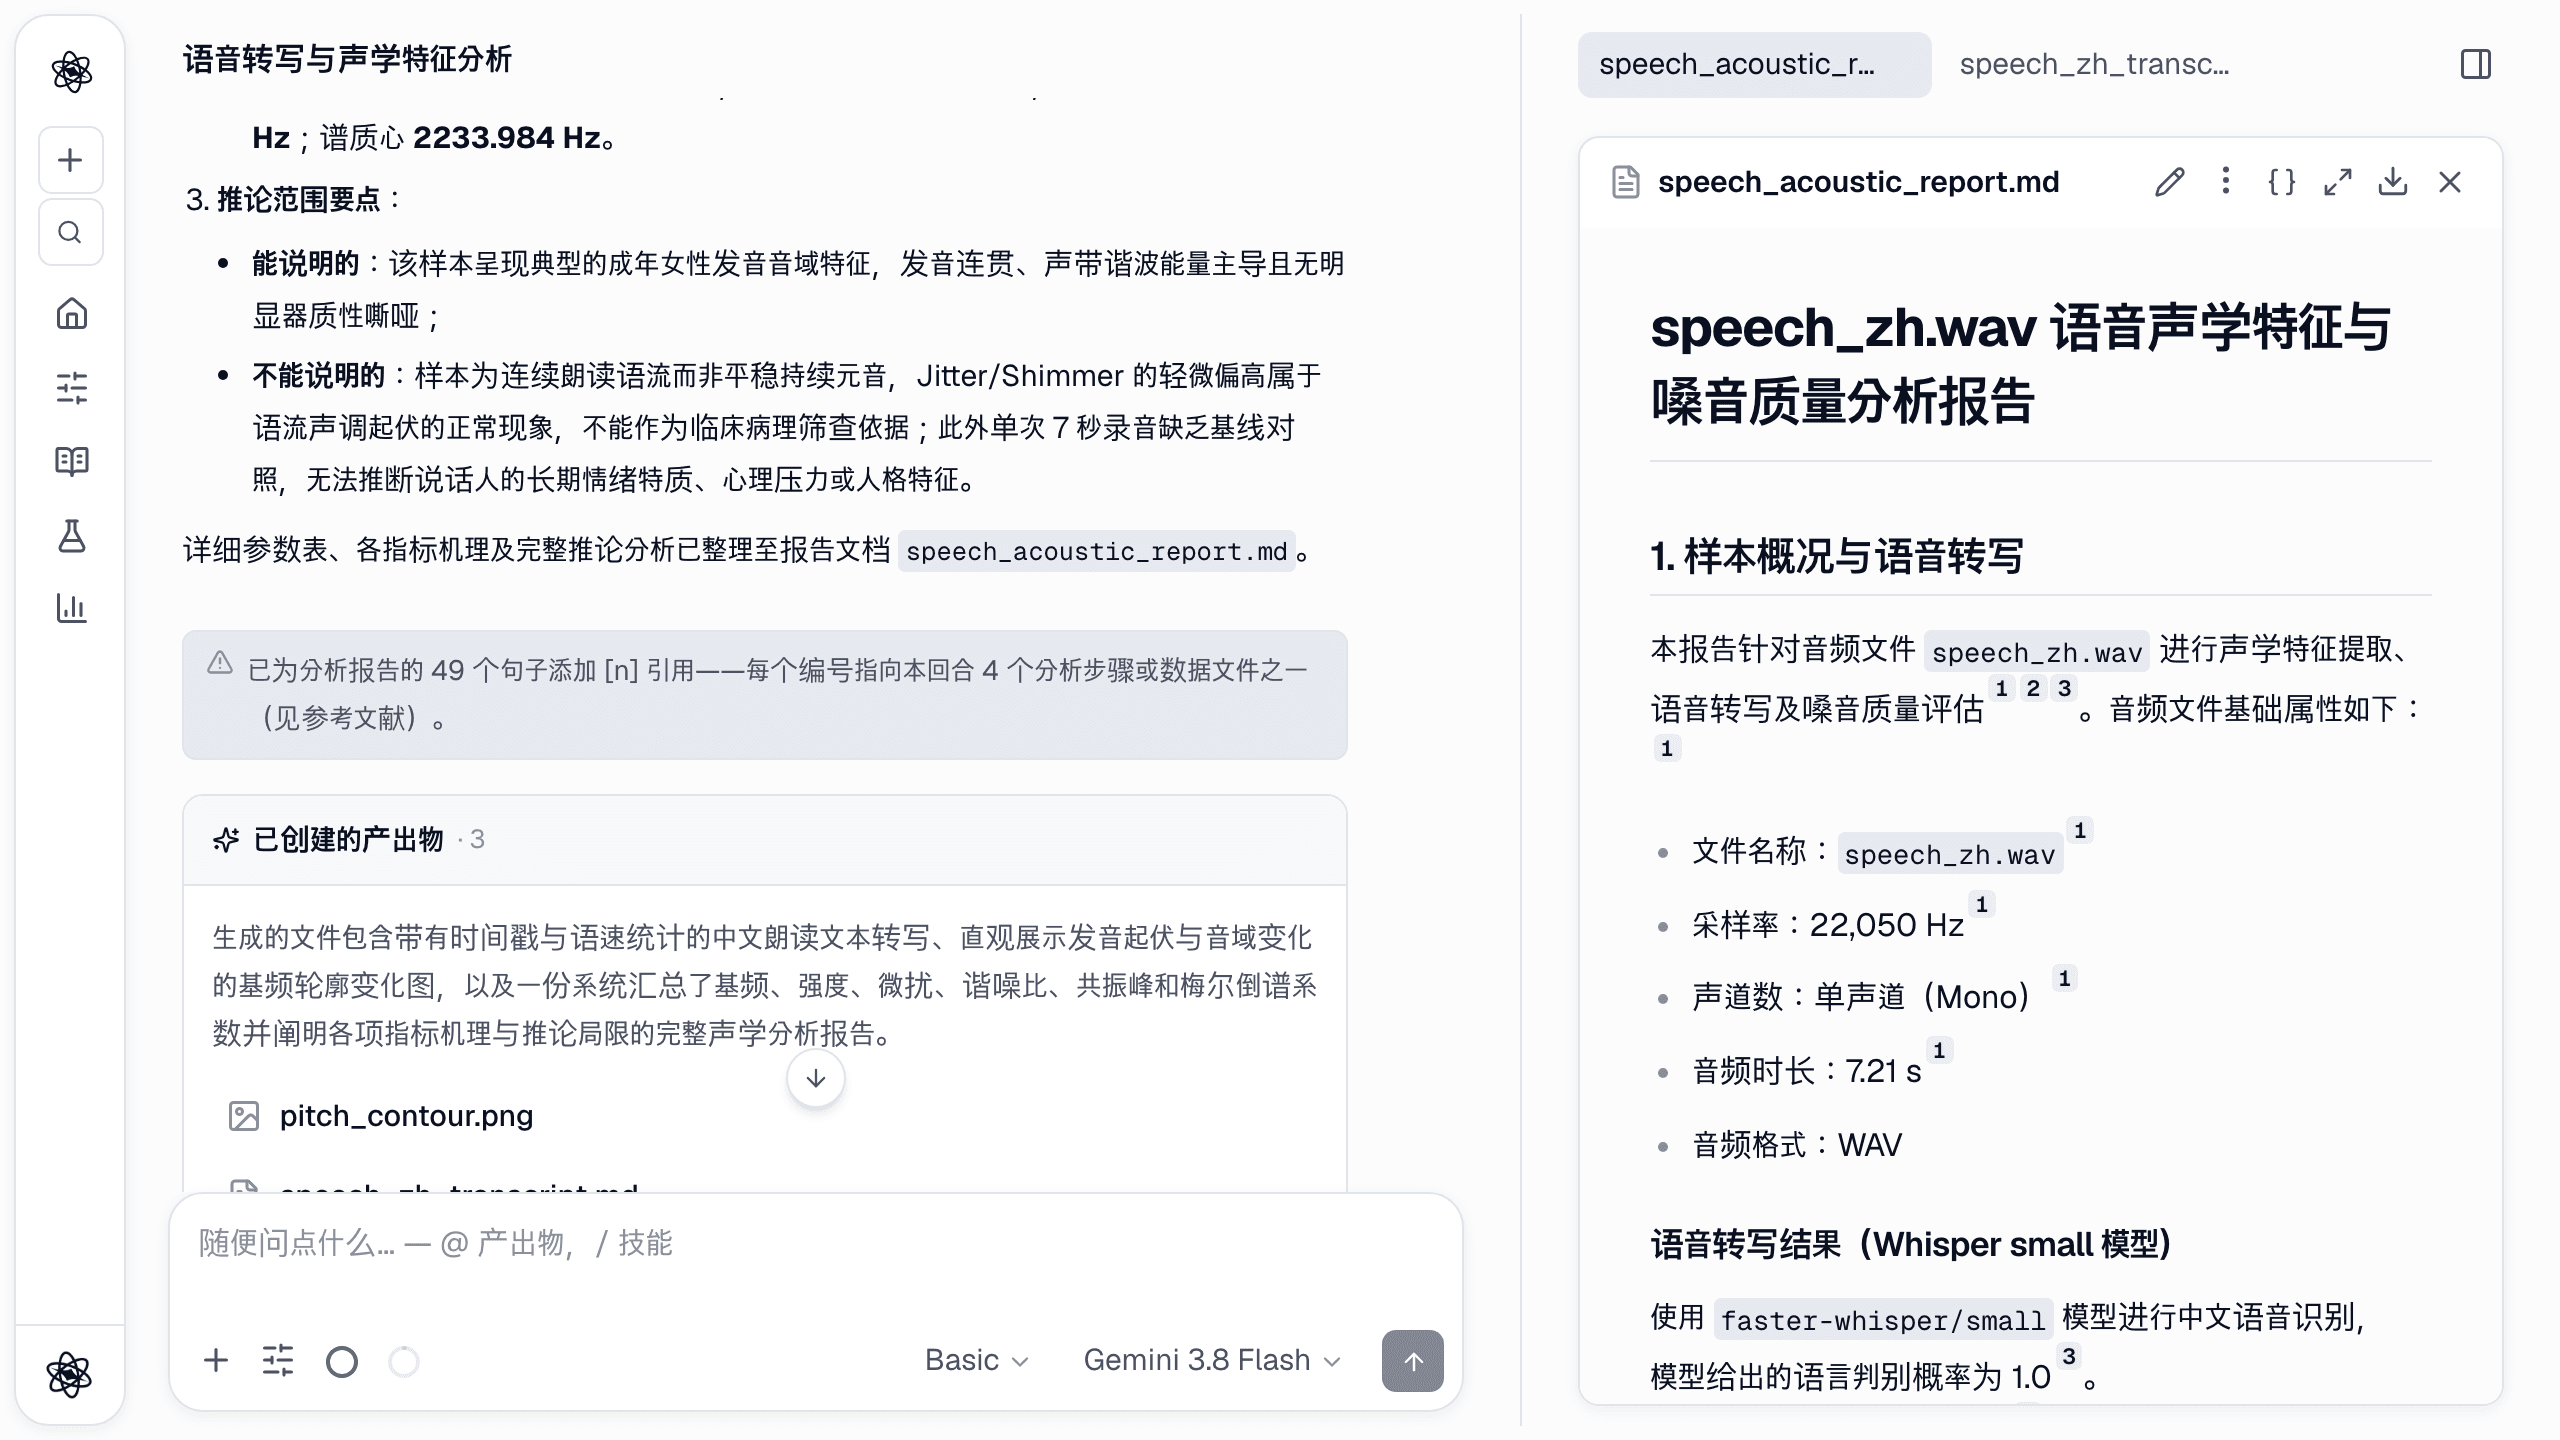
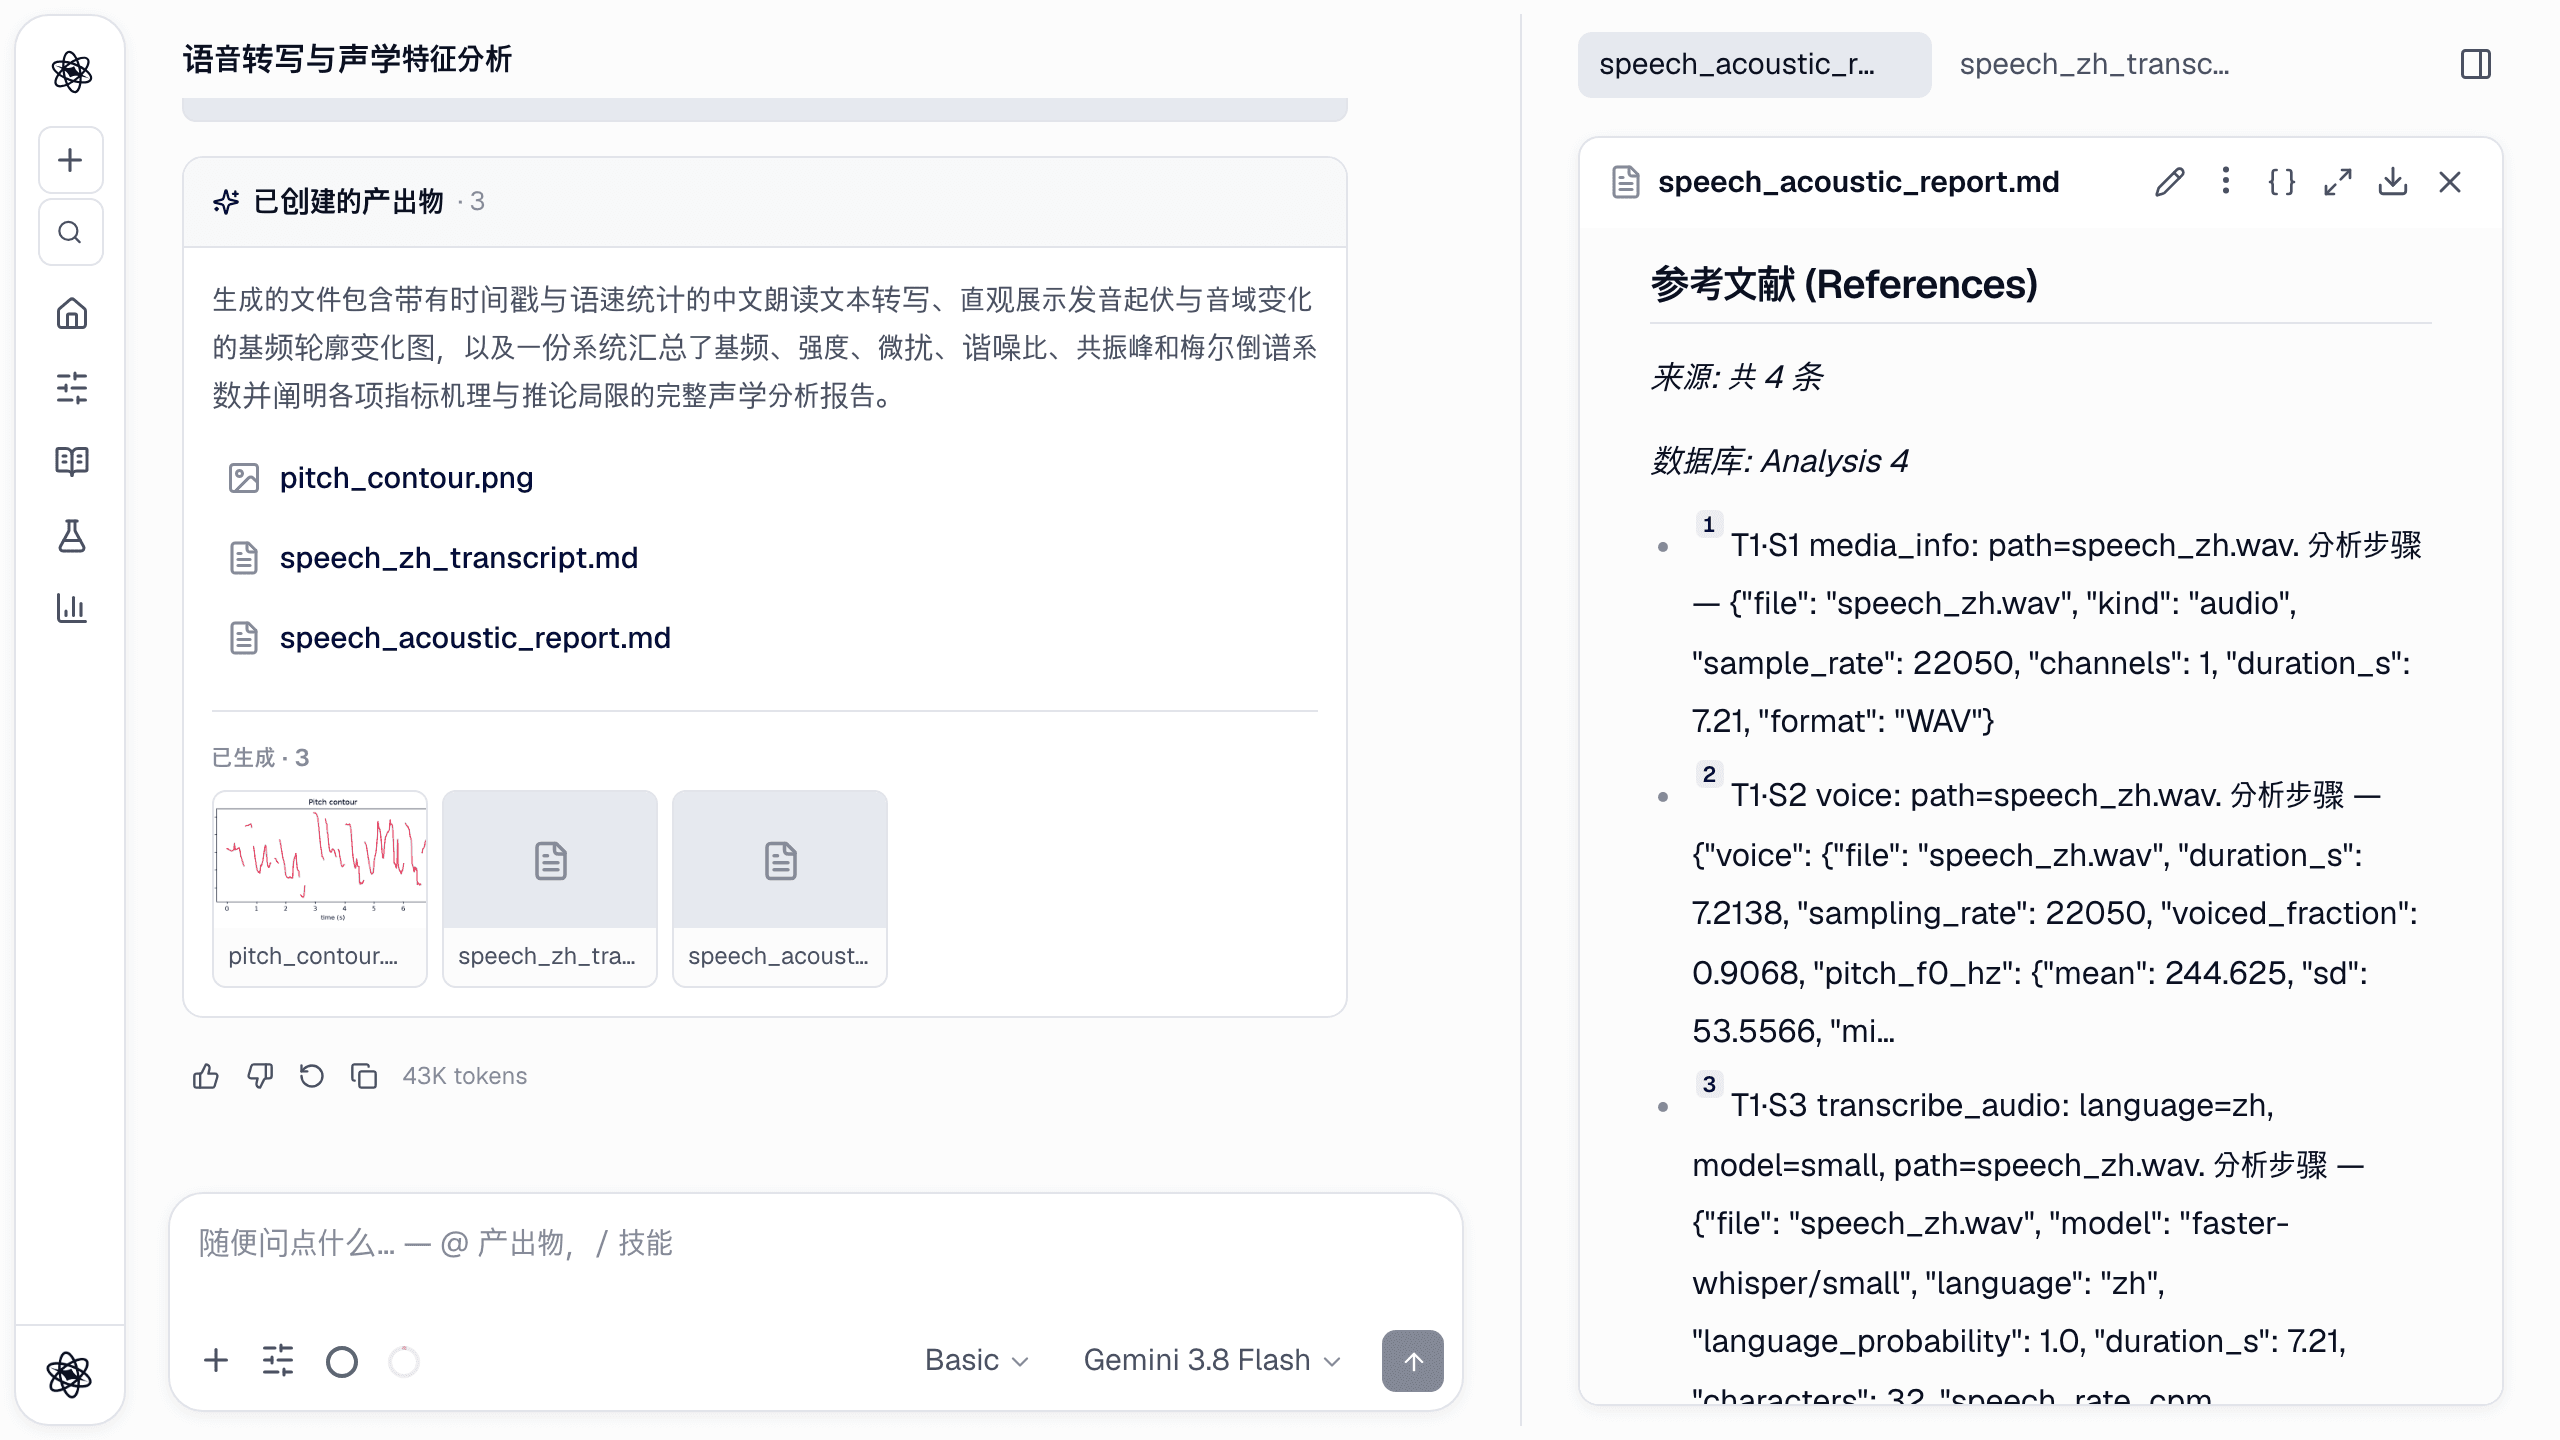
每次工具调用都会记录名称和参数(转写的话包括文件、模型大小和语言),图表也会保留生成它的代码(在工件面板中点击 { })。如果有人问音高或转写是怎么得来的,答案就在会话里。详见每句话都有出处和默认可复现。
隐私
人的录音属于个人信息,有时还是敏感信息。隐私政策中写明:
- 在网页应用中,上传的文件及由其生成的工件存放在你账户的私有工作区,并在 Neutropic 的服务器上处理以运行分析。
- 转写在这些服务器上用 faster-whisper 完成,音频文件不会发送给第三方语音识别服务。
- 你选择的 AI 模型会看到回答所需的内容,例如提示、工具结果和相关摘录,其中包括转写文本。模型提供方在禁止用这些数据训练模型的协议下处理。
- 你的内容绝不会用于训练模型,并可随时删除。
- 你需要为上传的录音取得知情同意和伦理审批。上传前从录音和转写中去除姓名等身份信息是好的做法。
坦诚的局限
- 转写会有错误。 Whisper 很强但并不完美,小模型在非英语语音上更容易出错。我们的韩语、中文、日语样本即使用
small模型也有听错的地方:敏捷的 被听成 民间的,懒狗 被听成 蓝狗,日语 心拍変動 被听成 新博変動。在编码或引用之前,请逐一对照音频校对转写。 录音末尾的时间戳也可能有偏差。 - 没有说话人分离(diarisation)。 Neutropic 不区分说话人。访谈会以一串连续片段返回,没有"访谈者""参与者"标签,嗓音指标也会把录音中所有人一起计算。若需要按人计算嗓音指标,请分声道录制,或按说话人切分文件后上传。
- 是特征,不是情绪。 没有任何工具会把录音标记为开心、有压力或抑郁。解读韵律需要基线和研究设计。
- 不是临床评估。 从连续语流测得的 jitter、shimmer、HNR 不等于嗓音障碍评估,后者要求在校准条件下使用持续元音。
- 强度未经校准。 响度取决于麦克风距离和增益,只应在同一录音设置内比较强度。
- 参考范围来自模型。 报告把测量值与常见范围比较时(如上表),这些范围来自模型的一般知识,而不是工具输出。请对照你要引用的文献核实。
- 整段汇总。 嗓音工具汇总整个文件。若需要逐片段指标,请把音频切成片段,或请求相应代码,并检查输出。
可以先看示例项目(示例 · 按领域的技能 中的语音会话),也可以直接附上自己的录音并加以说明。格式和选项见数据分析文档和上传格式。