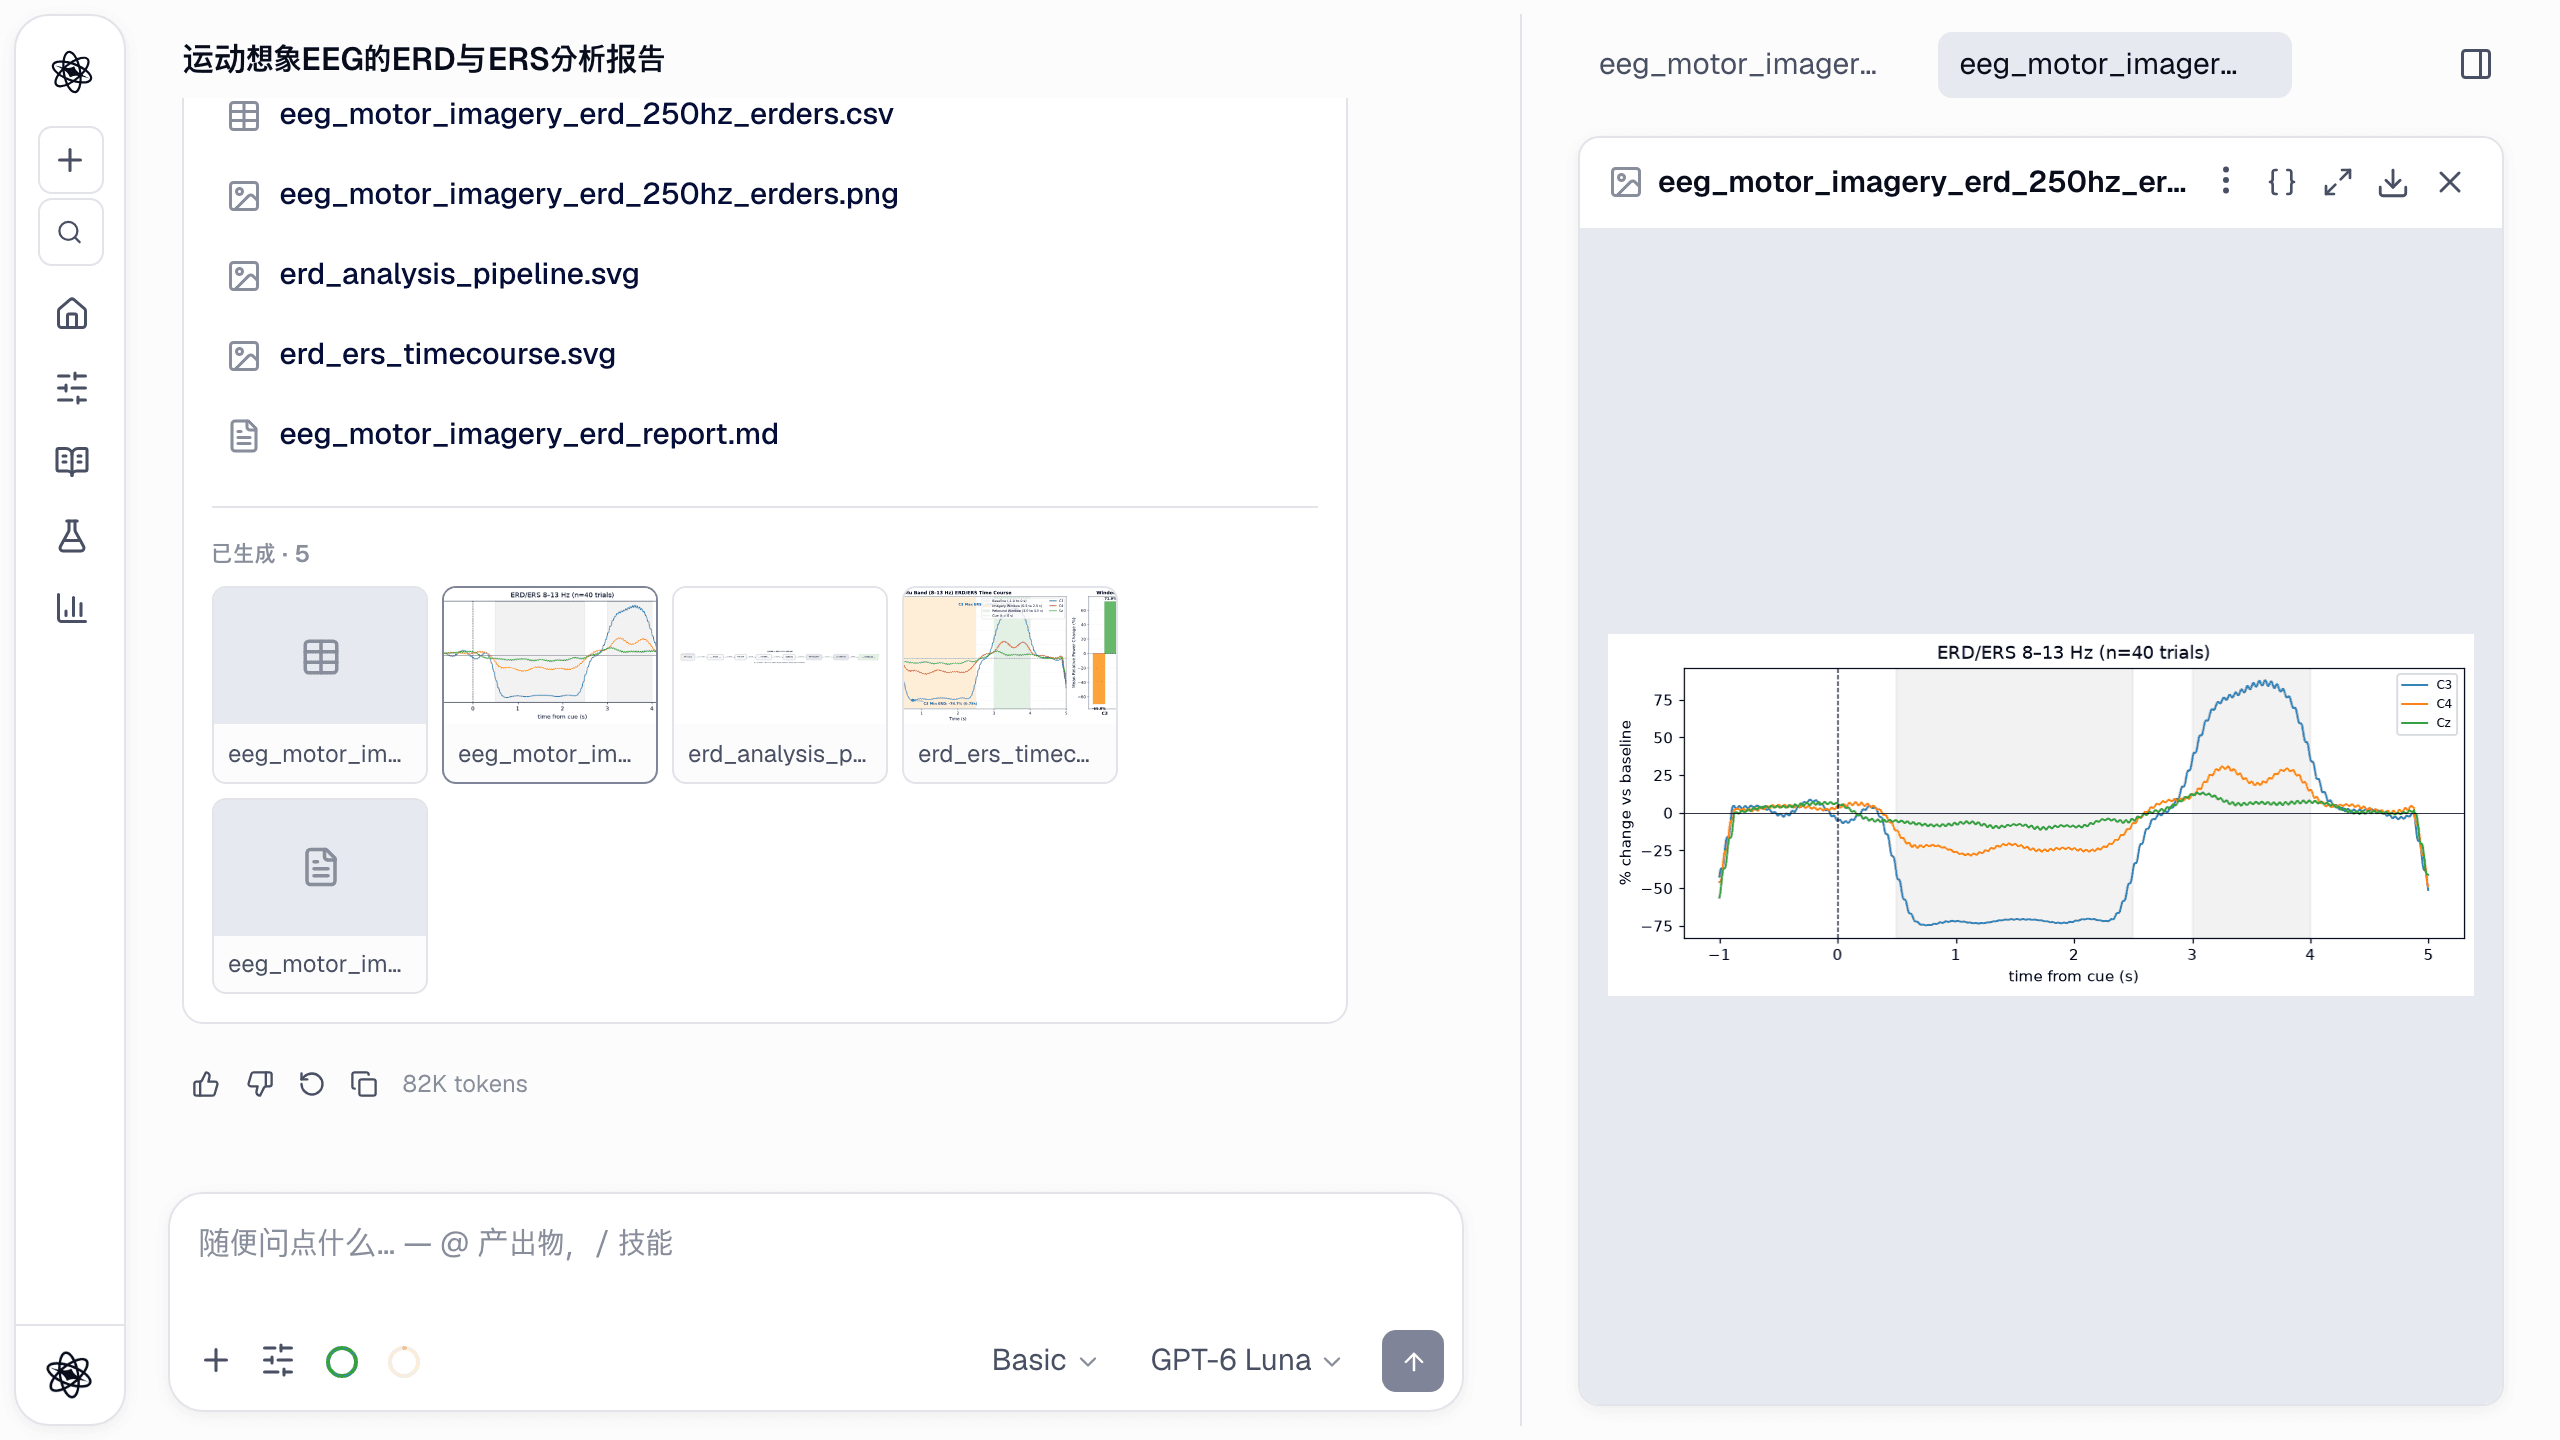
大多数分析错误不发生在模型里。它们发生得更早——悄悄丢掉行的合并、不一致应用的排除规则、变成"发现"的传感器伪迹。Neutropic 把数据准备当作分析中最需要阳光的部分。同一会话的这一步:试验已经(用示例数据)完成,电子表格进来了。
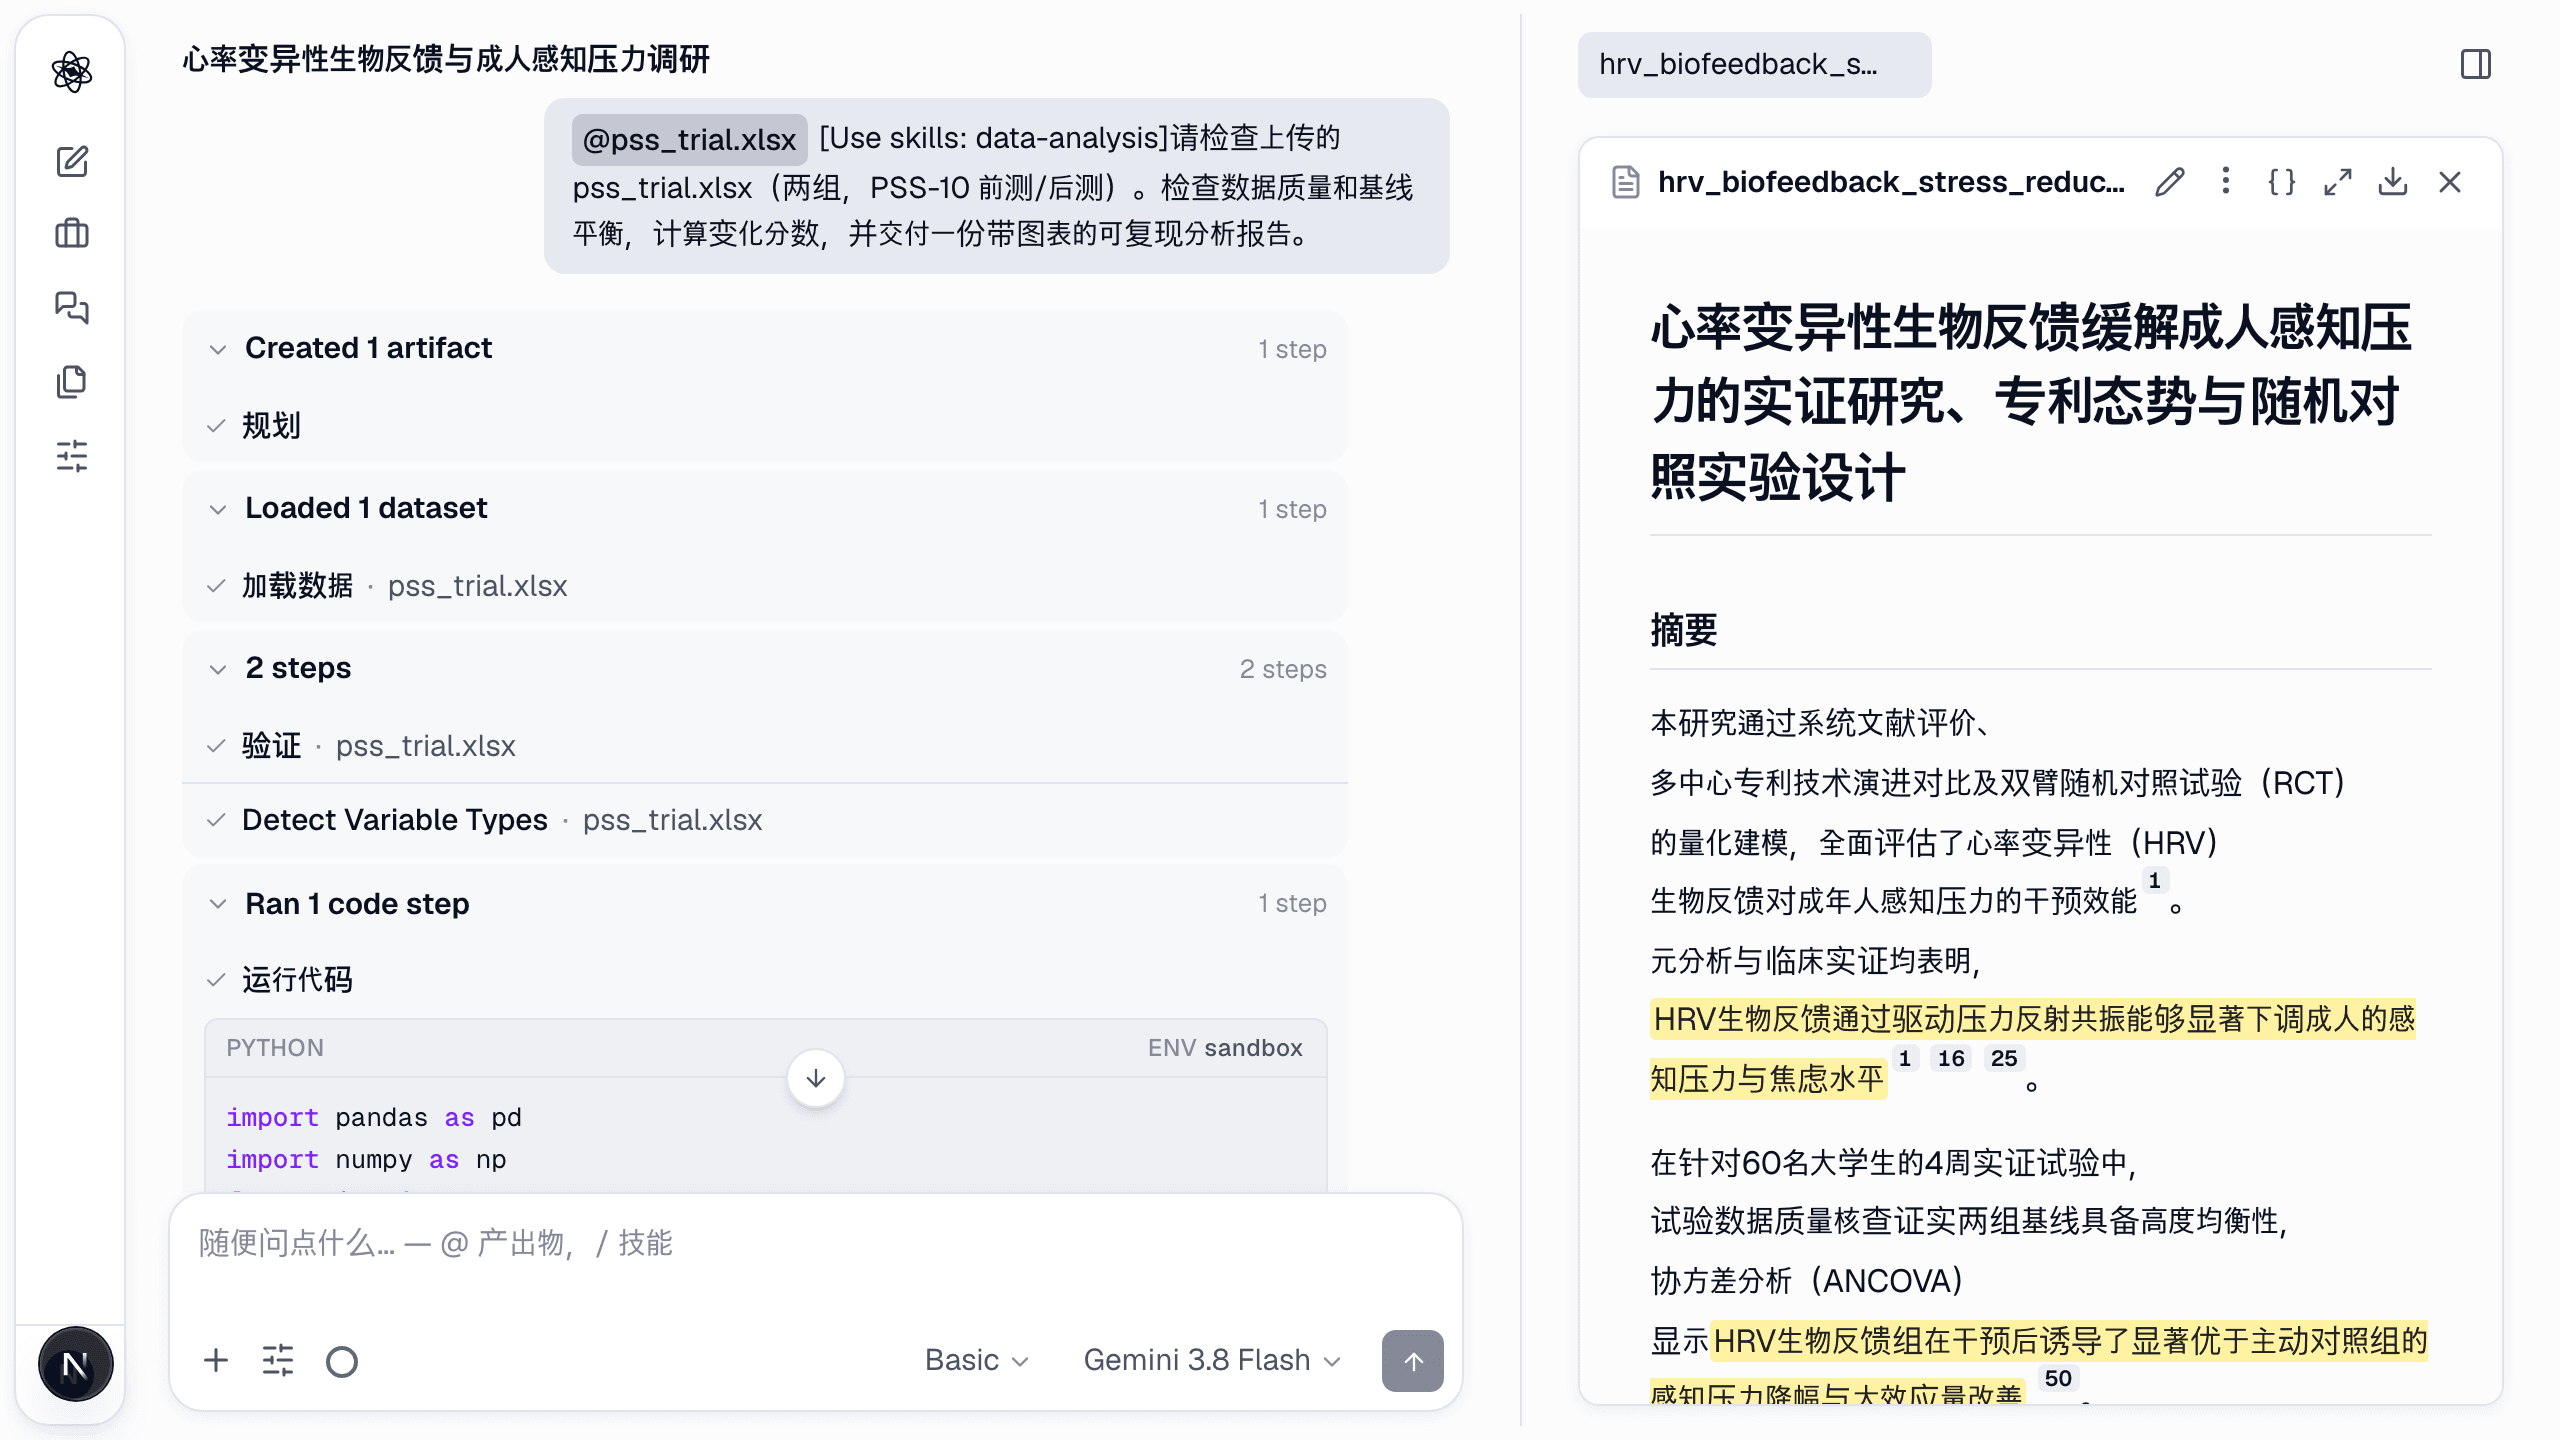
第 1 步 — 只附一次数据
按输入框的 + 附上文件——Excel、CSV、交互日志、录像和生物信号导出都可以。文件留在会话中,之后的每一步都按名称引用它。不必重新上传,也不必猜三个几乎相同的 CSV 哪个是最新的。
text
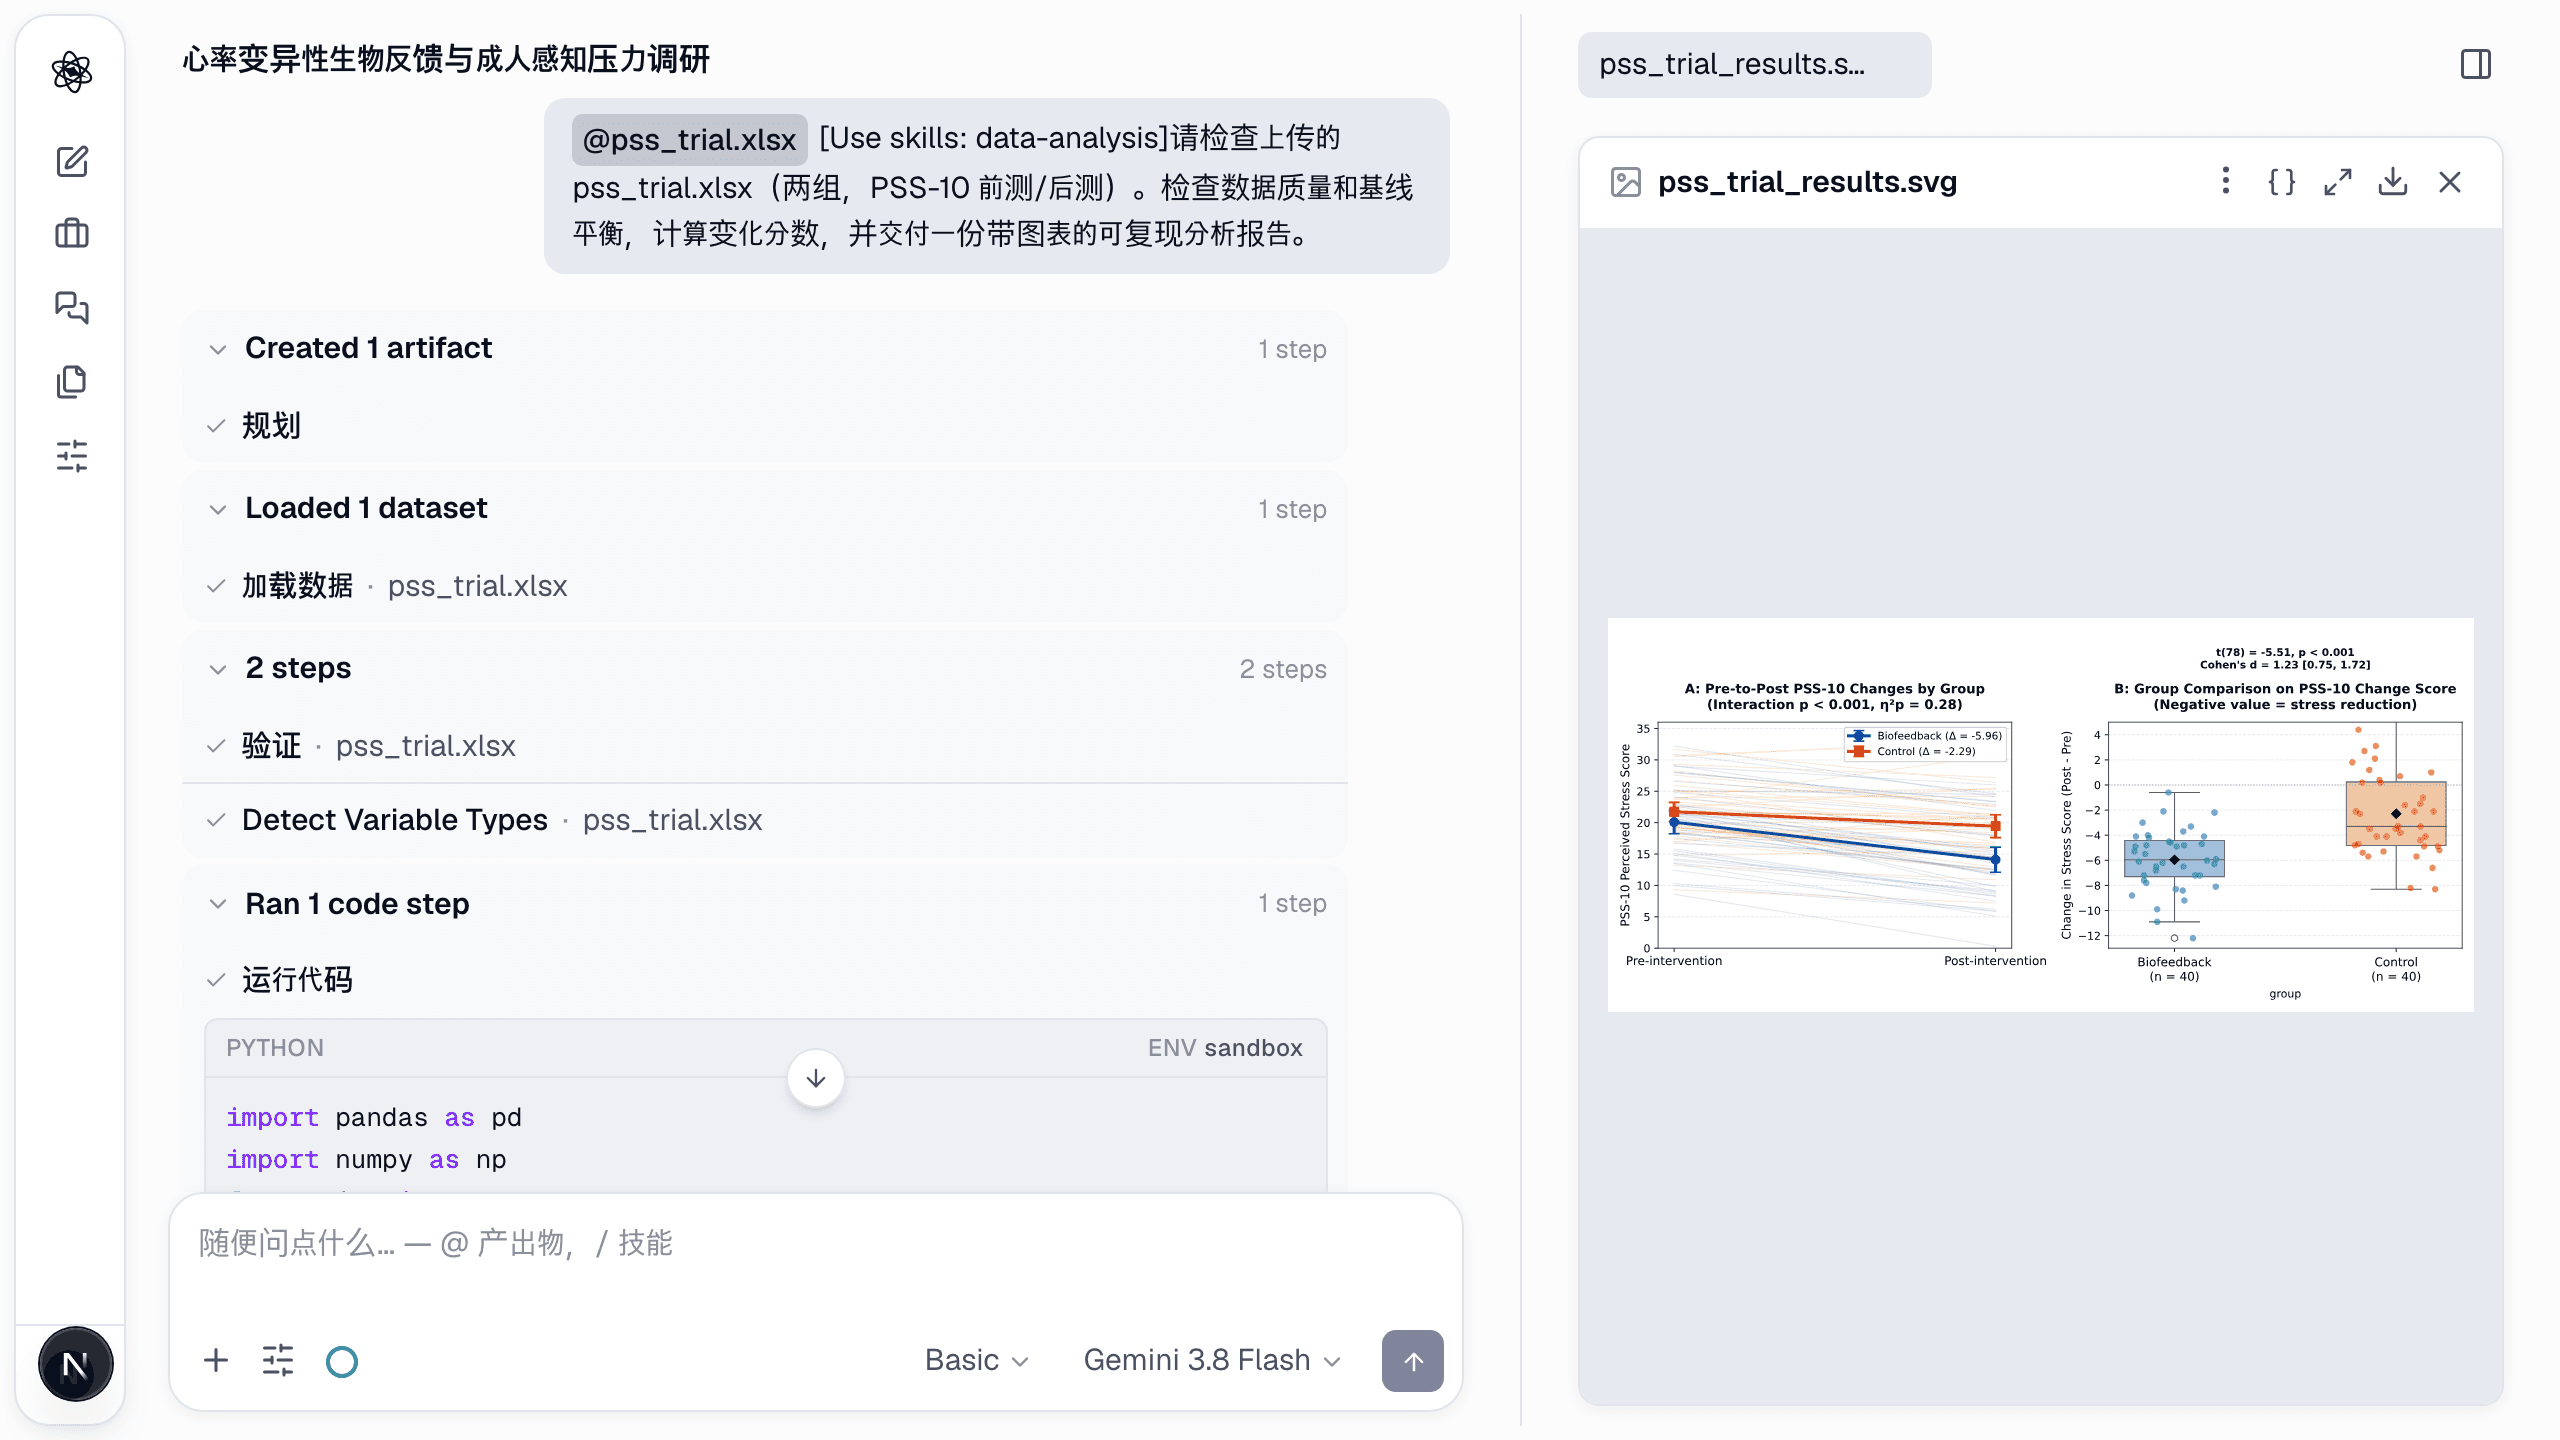
/data-analysis Inspect the uploaded pss_trial.xlsx (two groups, PSS-10 pre/post). Check data quality and baseline balance, compute change scores, and deliver a reproducible analysis report with plots.
第 2 步 — 分析前先检查
代理先读取结构——80 行、5 列、无缺失值、PSS-10 分数在范围内、组间基线平衡——并写出明确的分析计划。然后才在沙箱中运行计划,每个代码步骤在对话中可见、可展开。
- 在应用任何插补或排除之前,按变量和被试报告缺失数据。
- 排除规则以规则的形式写明、统一应用并计数。
- 多模态输入——面部表情、注视、姿态、语音、rPPG/HRV、EDA、EEG——在同一会话中得到同样的处理,从原始记录到特征。
第 3 步 — 看数据,不只看摘要
一条消息产出六个产物:数据质量报告、个体前后轨迹、变化分数分布、ANCOVA 拟合、对数据做了什么的管道图,以及结果的结构化 JSON。
第 4 步 — 阅读写明输入的报告
分析报告在报告任何数字之前先写明数据集、设计和方法学管道——审稿人可以沿着从文件到图的路径走一遍。
第 5 步 — 从构造上可复现
每个产物都记录生成它的代码和数据快照。改一条排除规则重跑,下游的每张图都从同一管道更新——清洗日志显示究竟改了什么。
准备阶段决定研究的成败。给它与模型同等的严谨,模型就会变得容易。