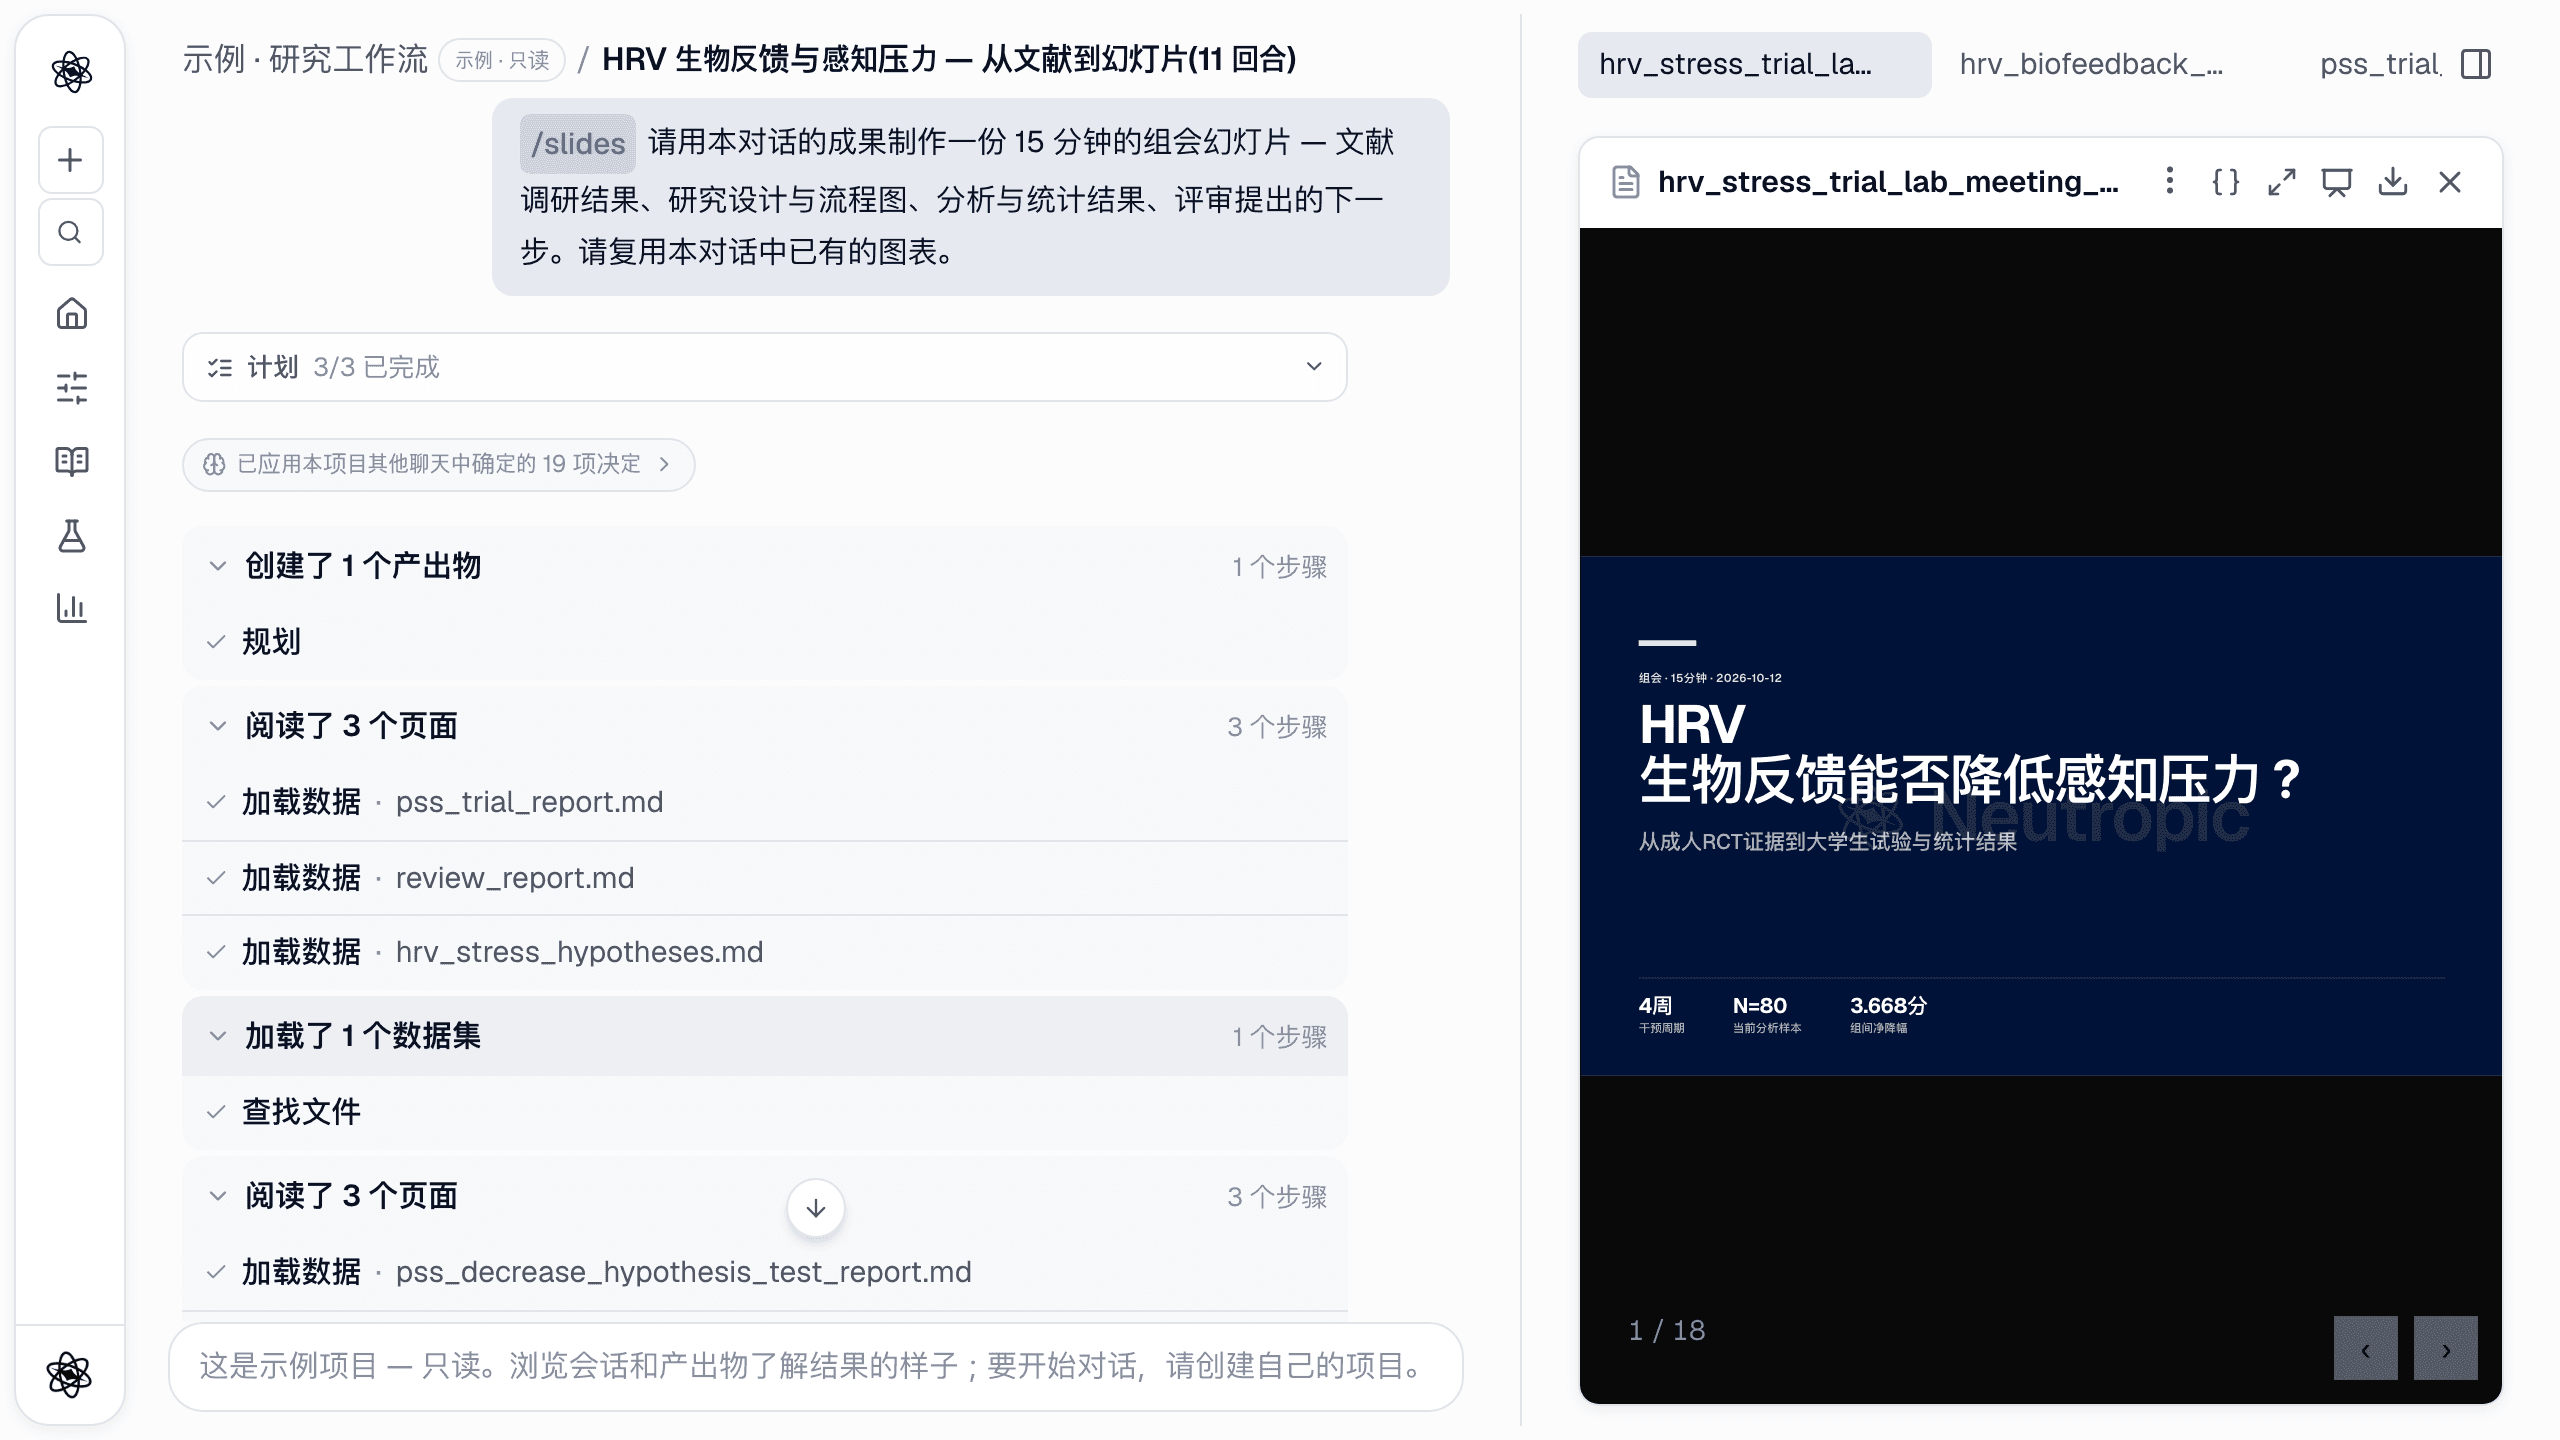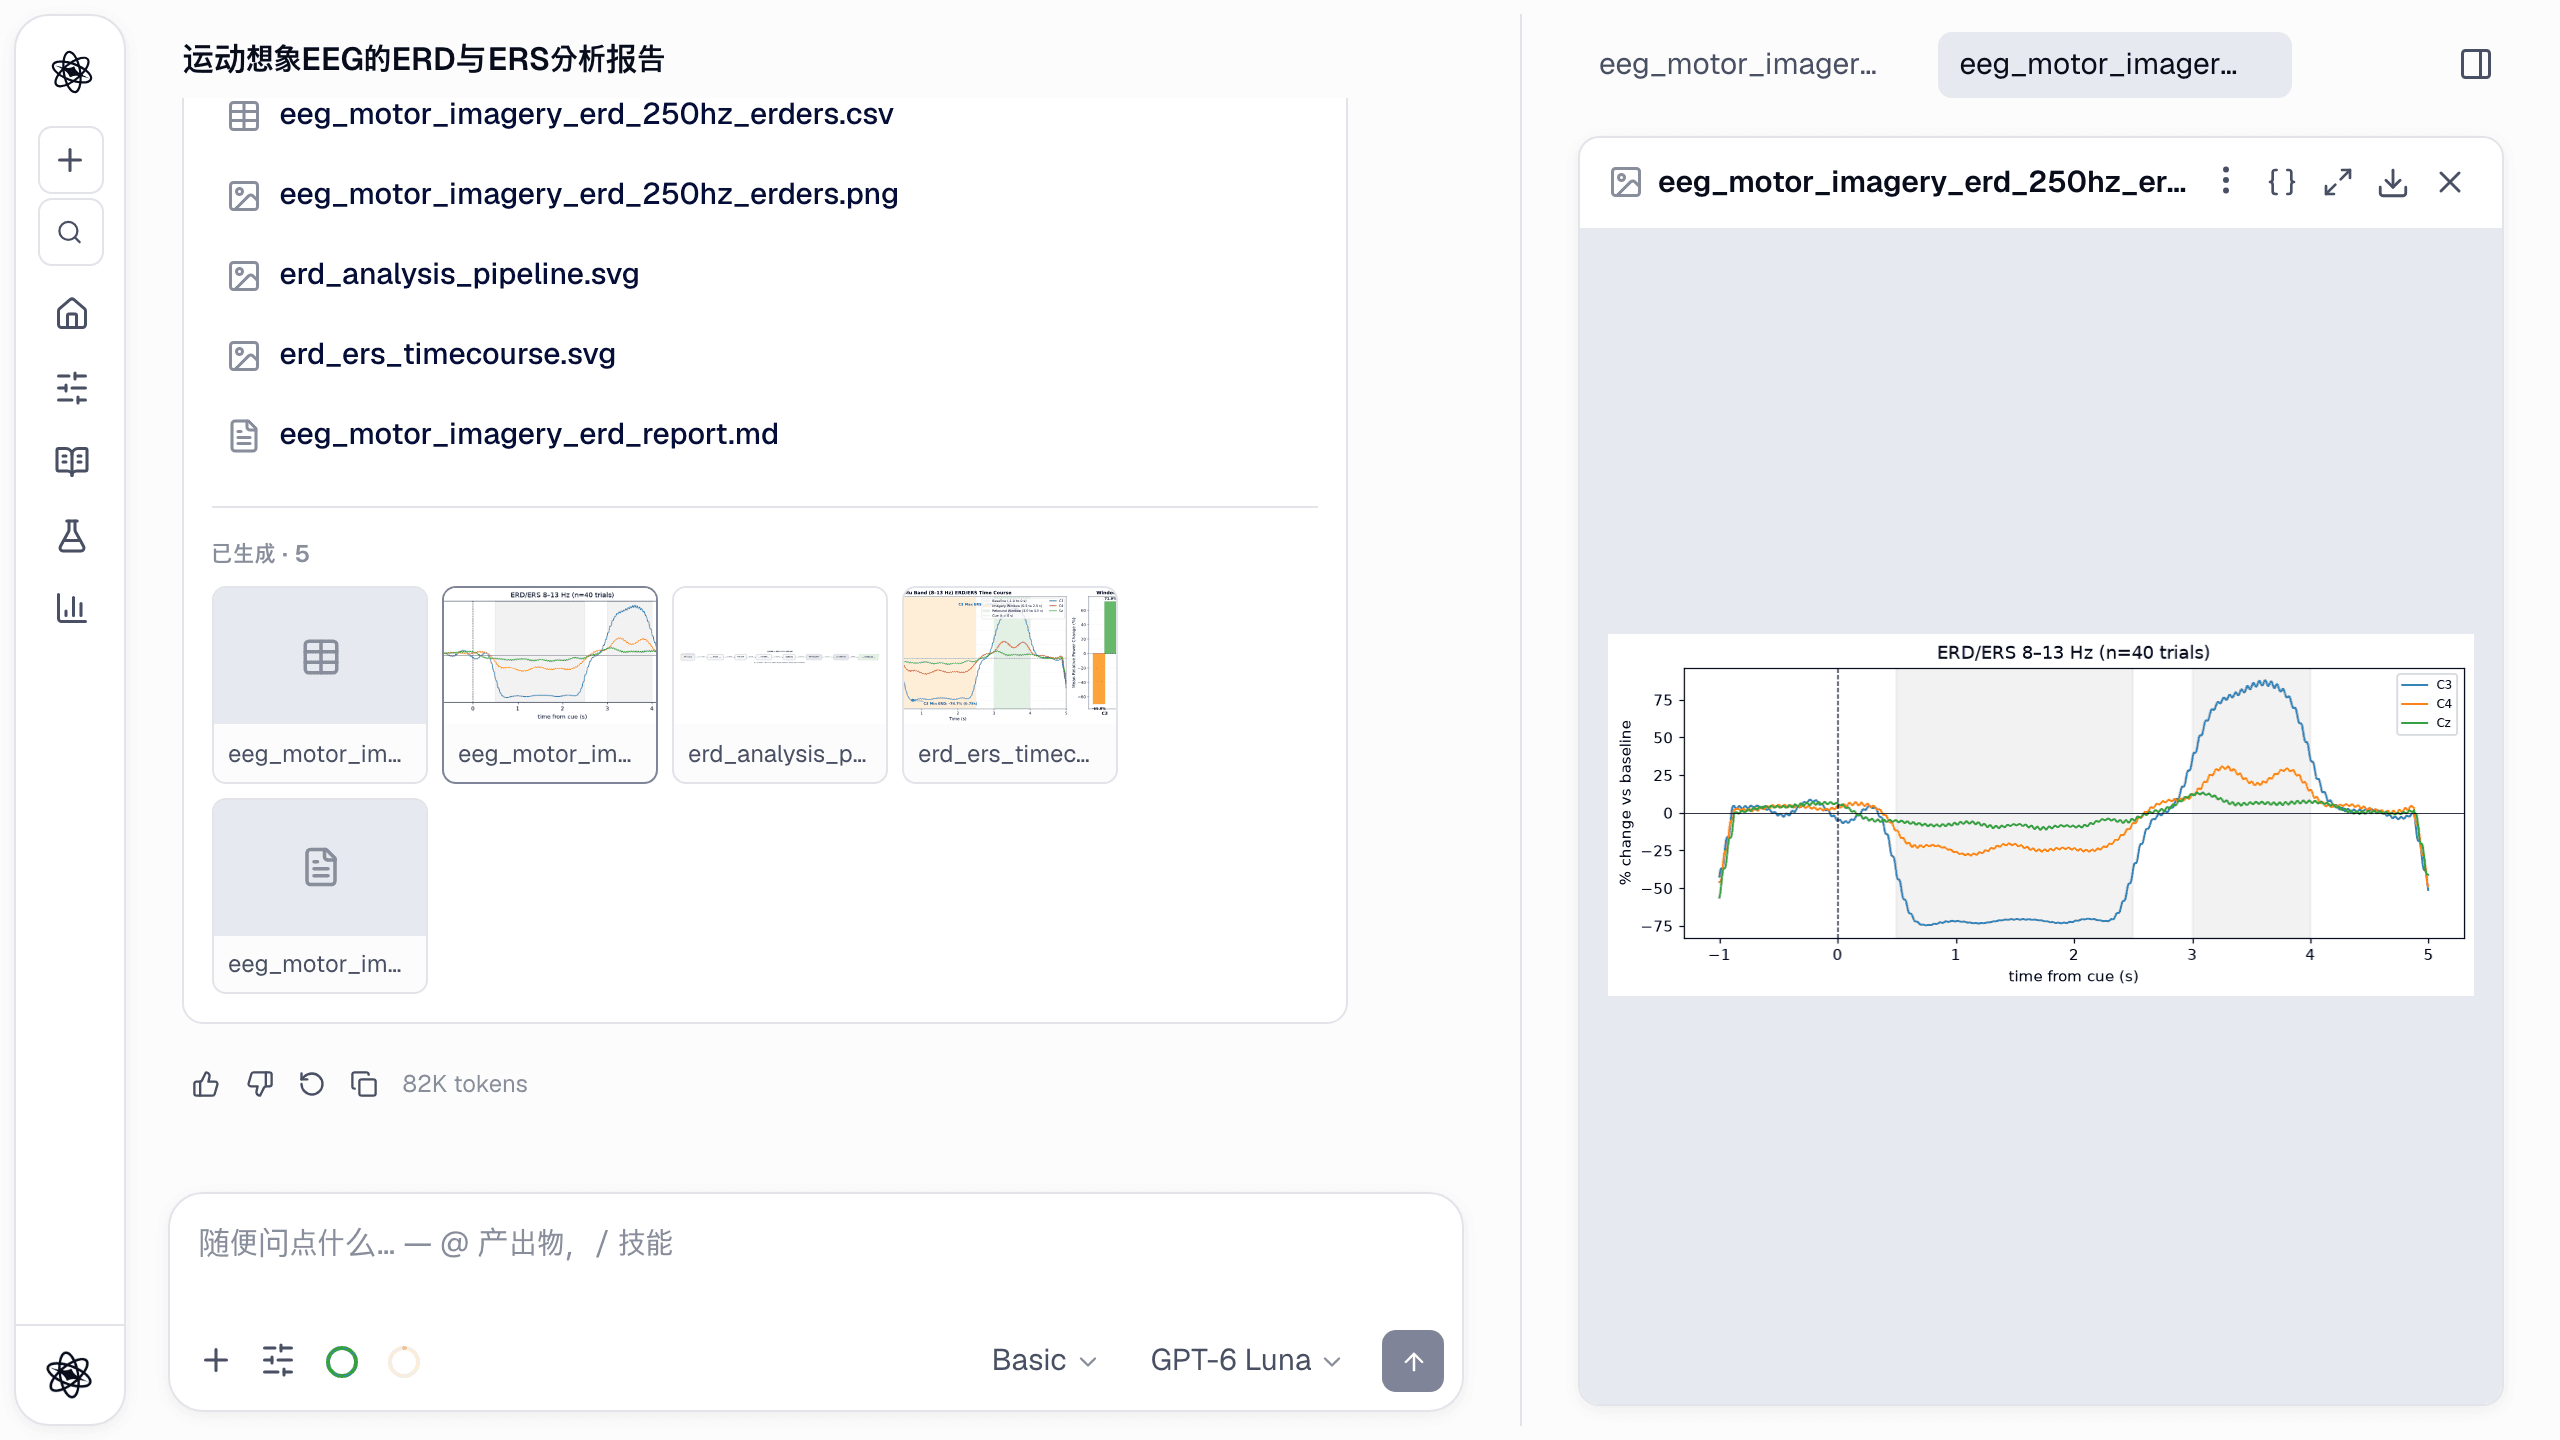
统计软件几乎会运行你要求的任何东西,无论那是否是该问的问题。Neutropic 的工作不同:为你的设计和数据运行正确的模型,并证明它是正确的——两次。这是试验数据已经加载的同一会话中的一步。
第 1 步 — 提出问题,而不是要求某个检验
描述比较和你需要报告的内容;代理选择方法。不需要重新上传——文件已经在会话中。
text
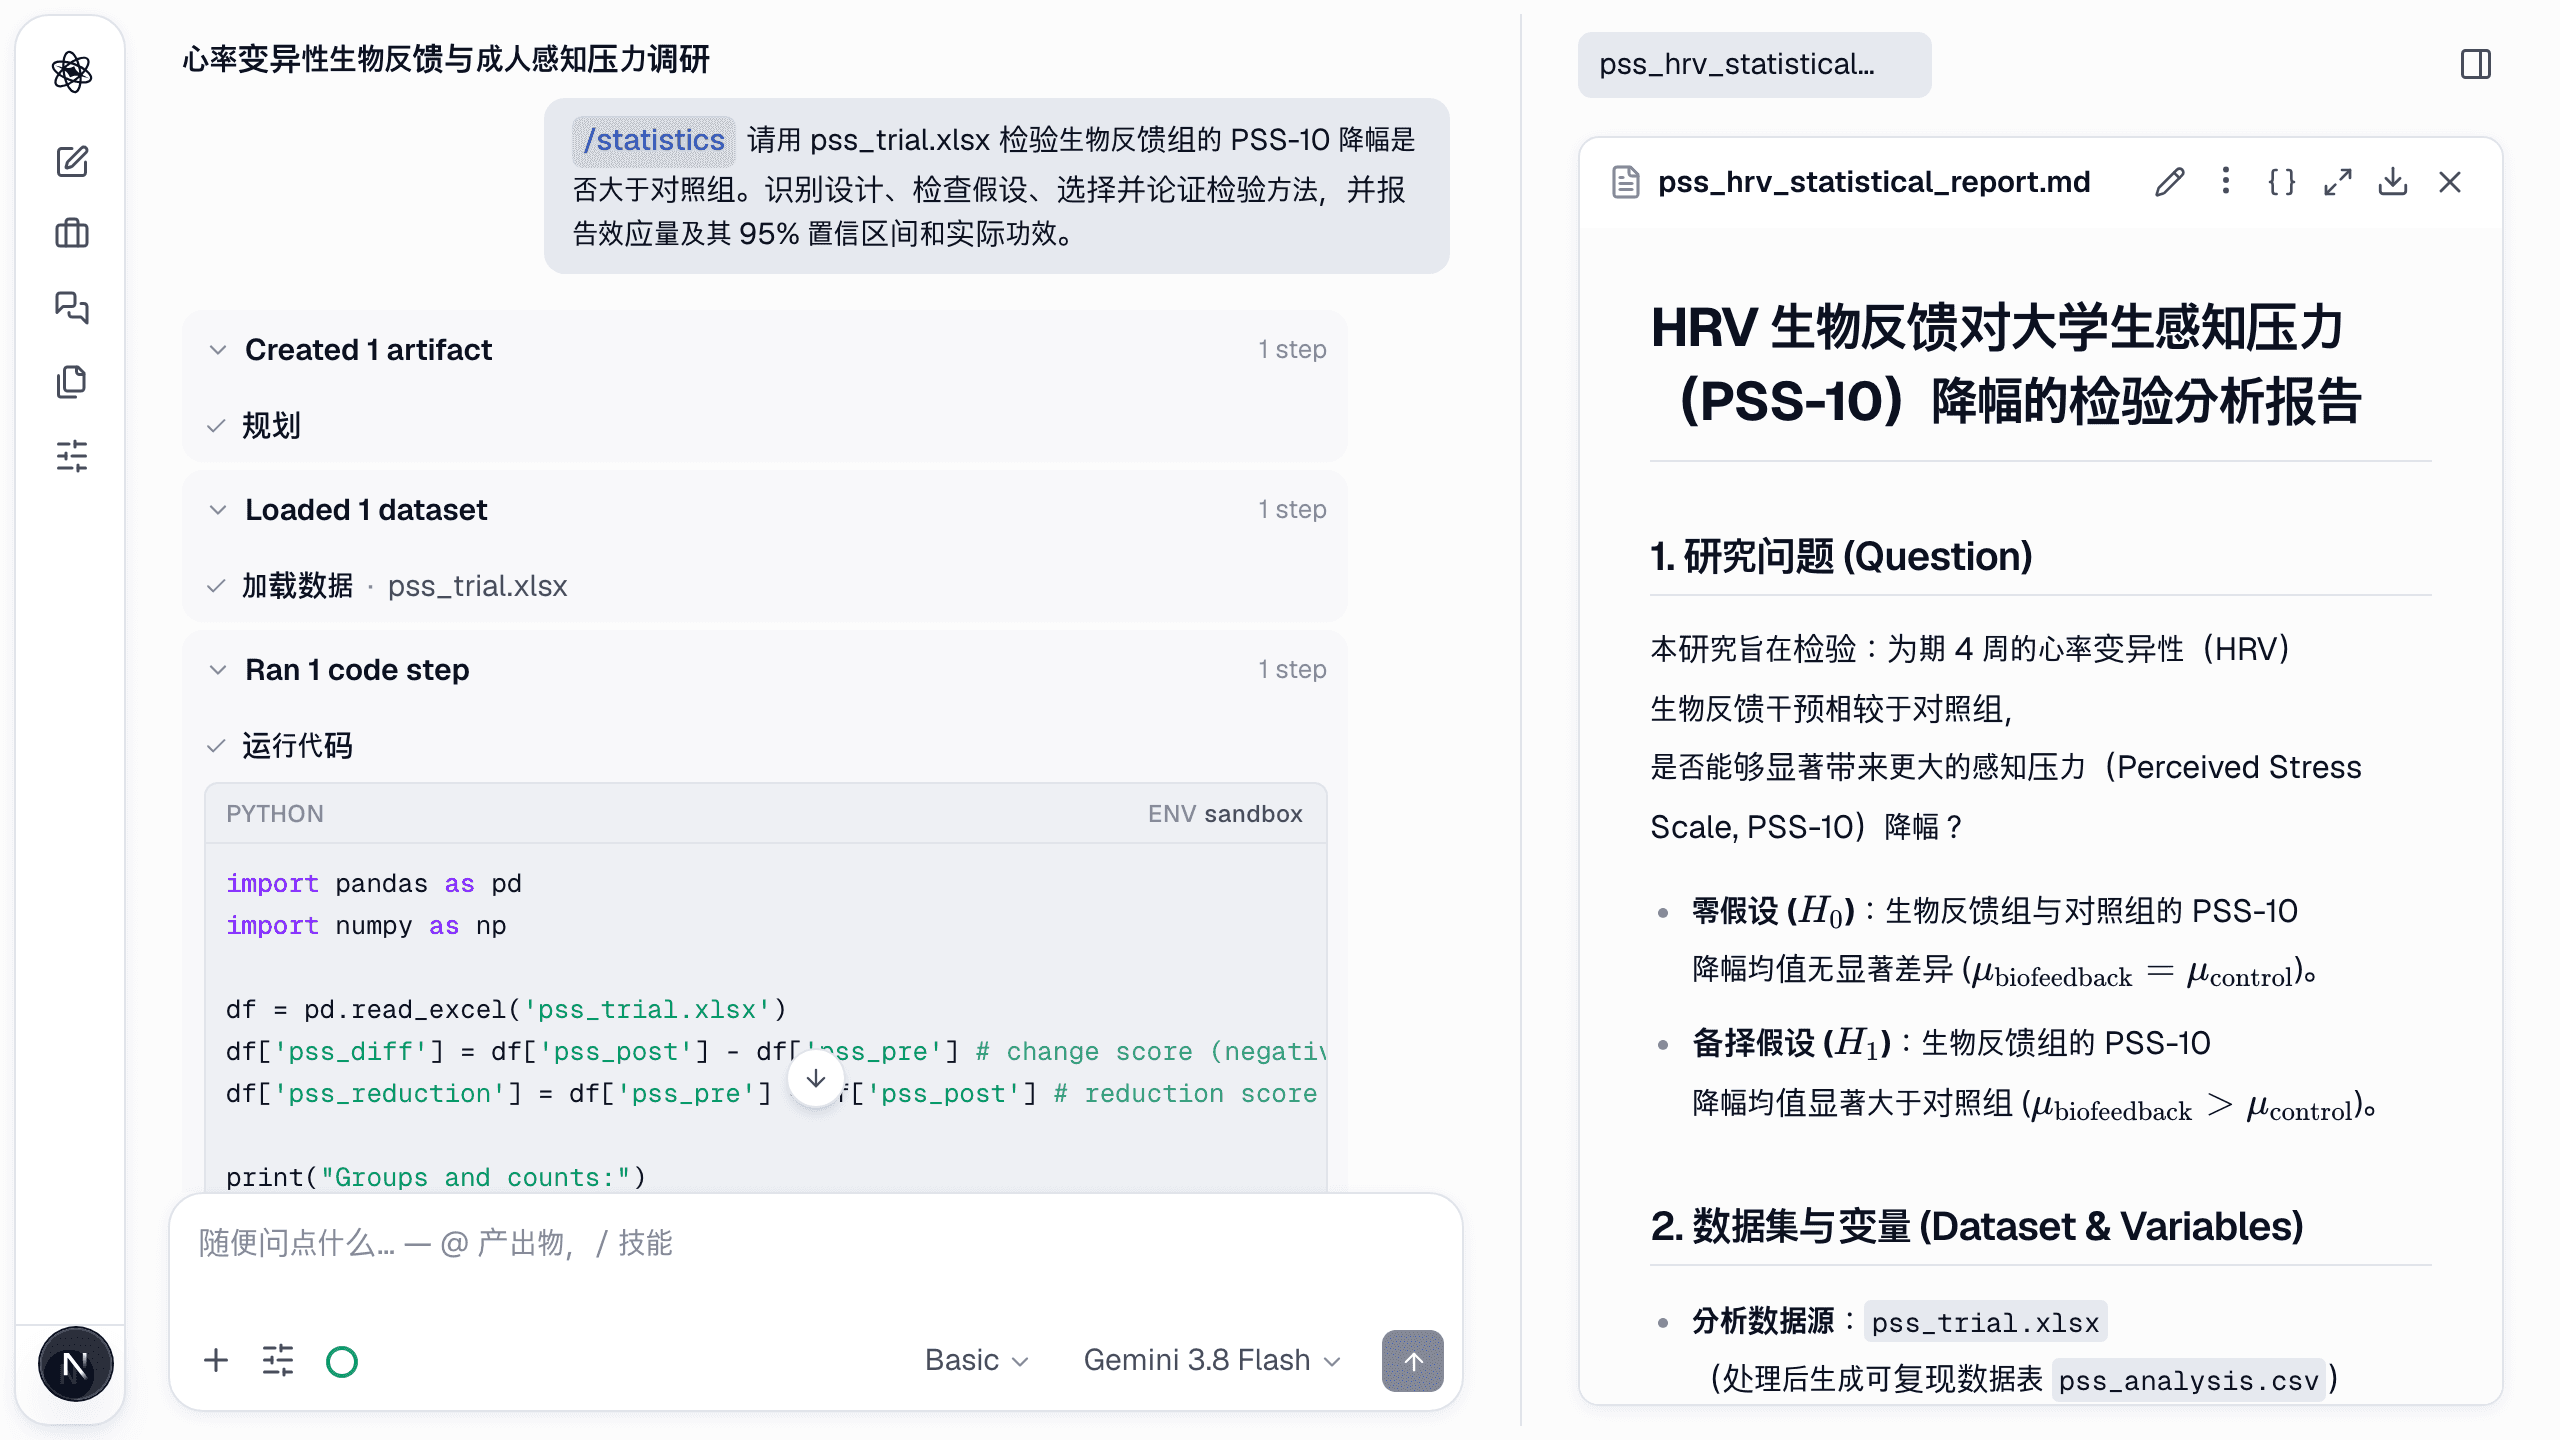
/statistics Using pss_trial.xlsx, test whether the biofeedback group shows a larger PSS-10 reduction than control. Check assumptions, choose the appropriate test, and report the effect size with a 95% CI and achieved power.
第 2 步 — 模型跟随设计
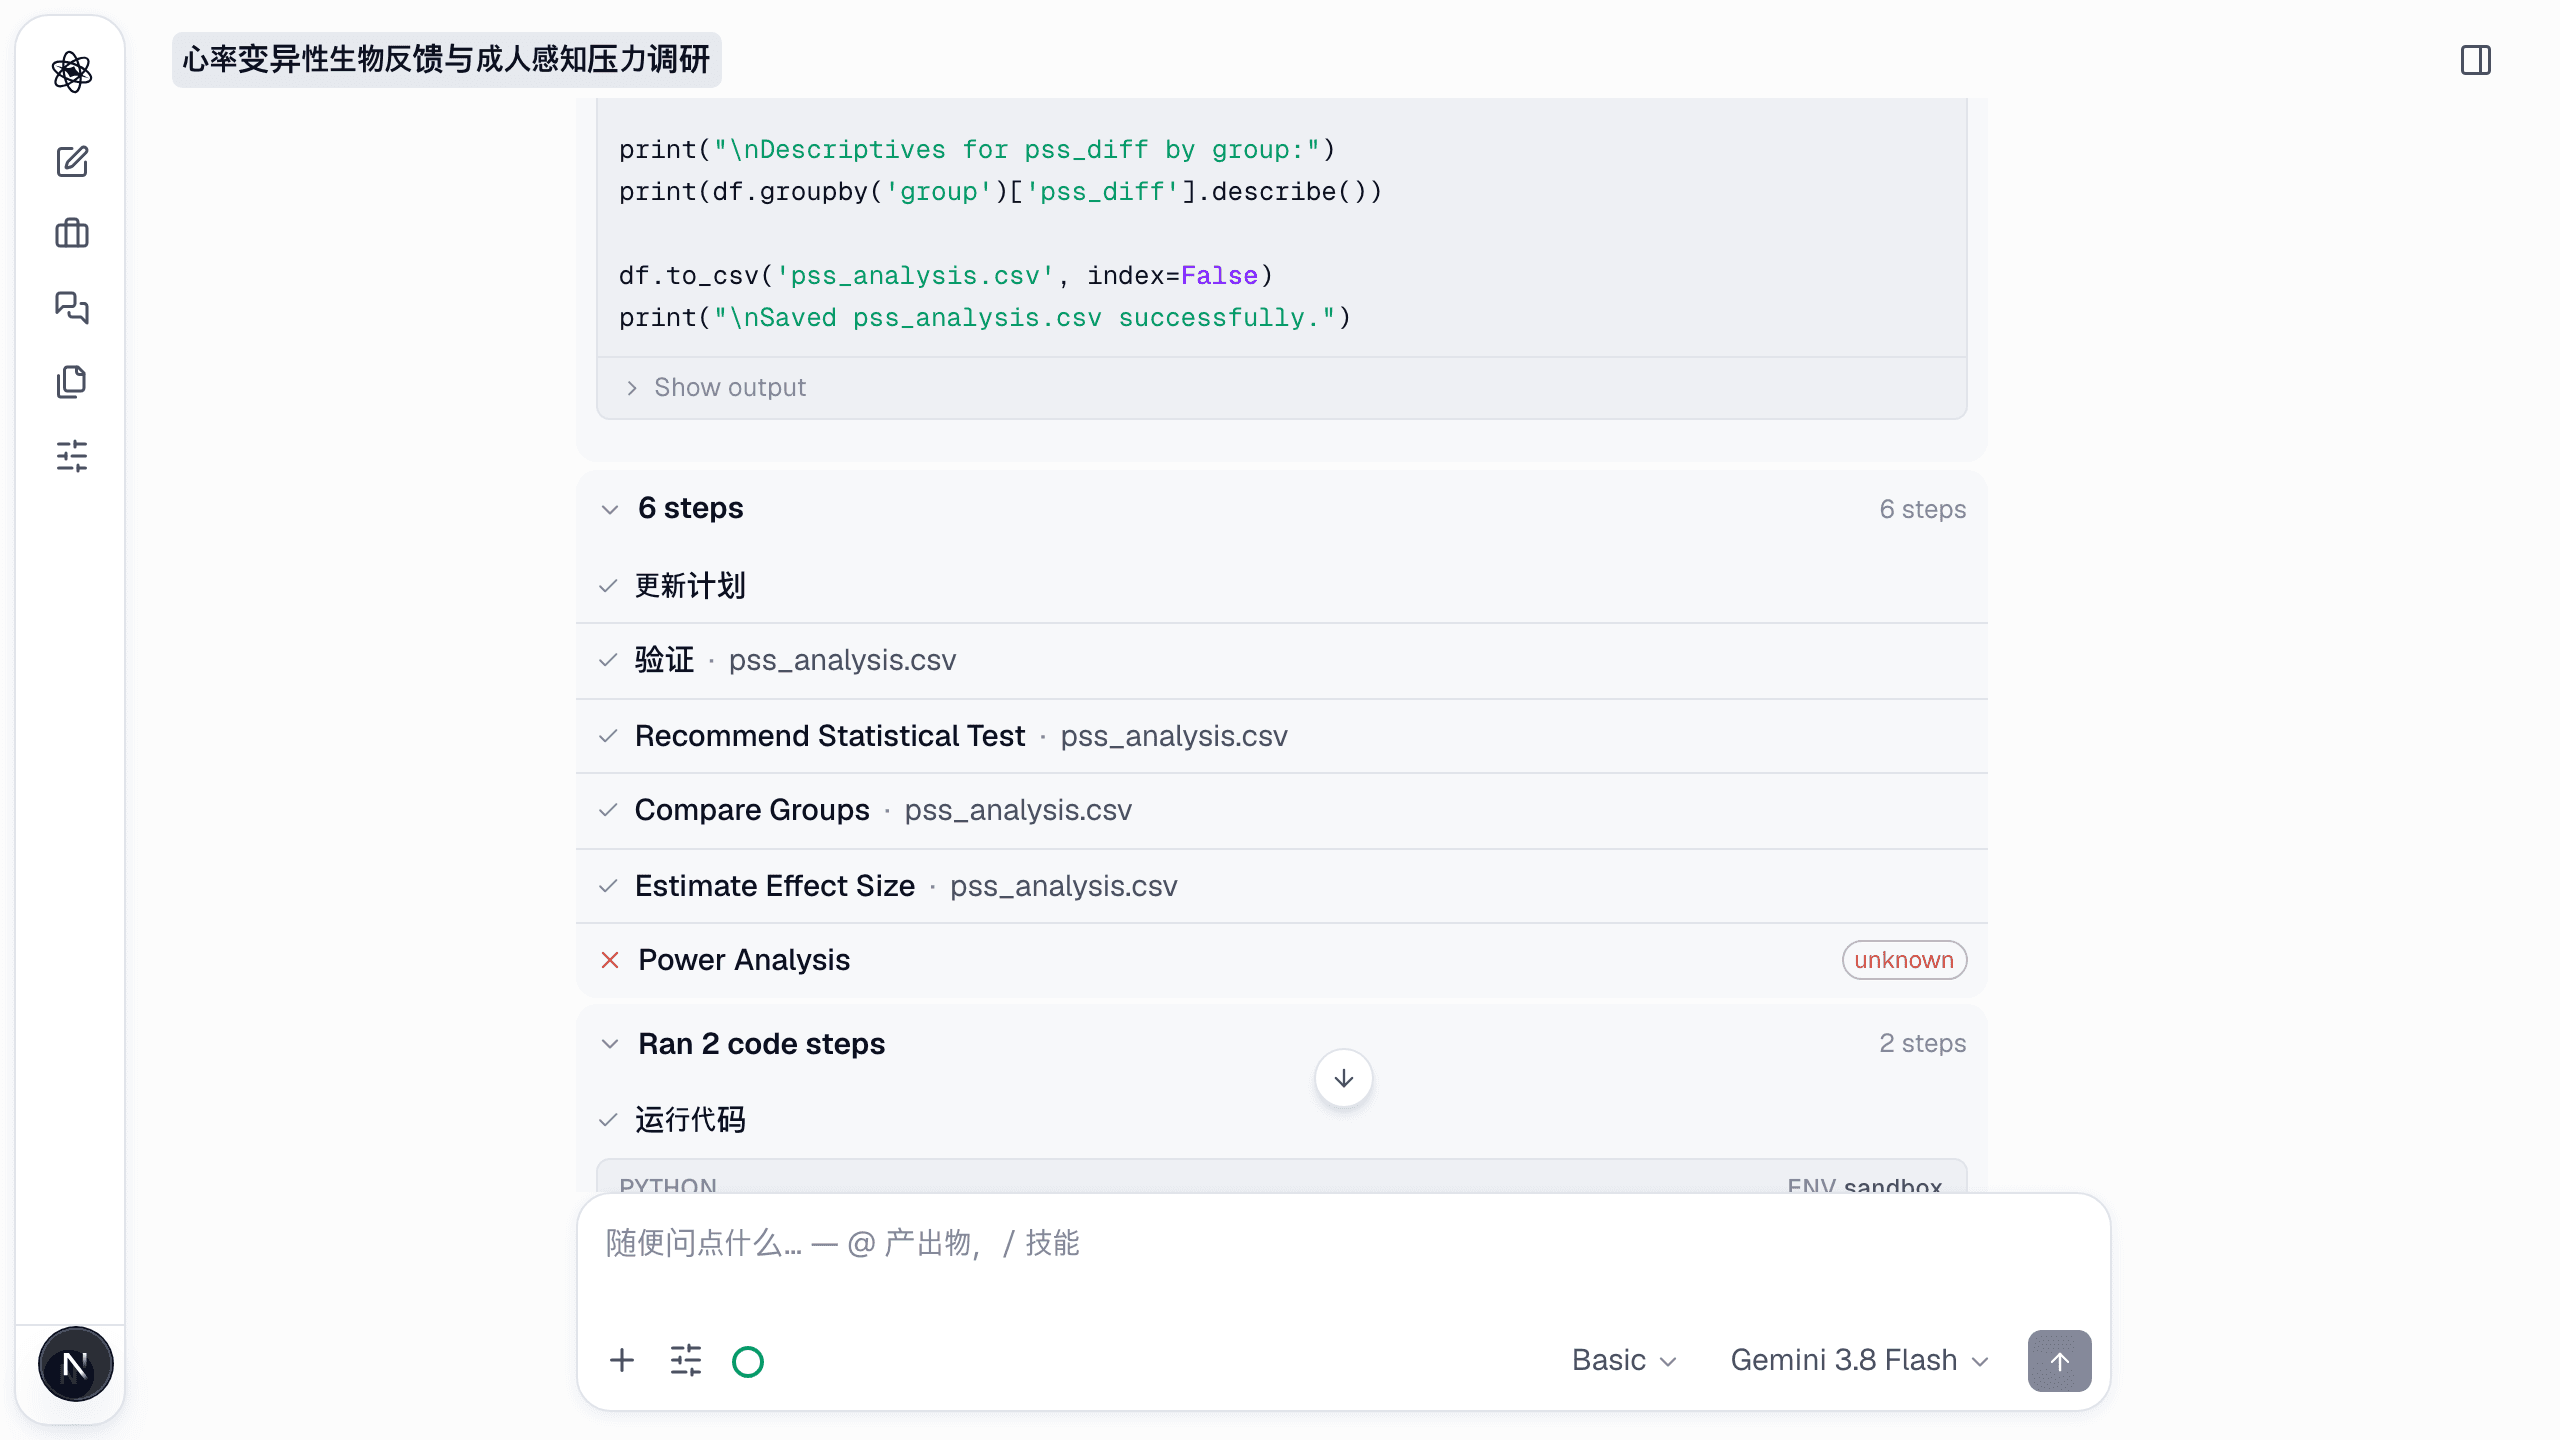
代理识别设计(两个独立组,前/后),审核正态性和方差,然后才选择检验:Welch's t 与 Student's t 并列,再加一个基线调整的 ANCOVA。代码在沙箱中运行并附着在结果上。心理测量和现代建模是原生的,不是附加的:
- 因素分析(EFA 和 CFA)和 SEM,拟合指数被解释而不只是打印。
- 以 alpha 和 omega 表示的信度,在差异重要时解释差异。
- 面向嵌套和纵向数据的混合效应模型,随机效应结构有理有据。
- 当小样本或先验知识需要时的贝叶斯估计。
第 3 步 — 带不确定性的效应,而不只是 p 值
结果附带审稿人会要求的一切:带 95% CI 的 Cohen's d = 1.23、Hedges' g、ANCOVA 的偏 η²、实际功效,以及该设计在 80% 和 90% 功效下能检测到的最小效应。
第 4 步 — 假设被检查两次
每次分析都经过两个代理。生成代理带假设检查运行模型;在 Deep 级别,独立的审查代理会在结果进入报告之前试图推翻它——假设违背、多重比较风险、样本量问题、p-hacking 迹象。分歧被展示而不是隐藏。
第 5 步 — 可以单独引用的报告
统计报告是独立于数据报告的文档,两者可以在稿件中分别引用——结果的结构化 JSON 让写作步骤引用数字而不是重新键入。
问题从来不是"显著吗?",而是"能经得起仔细的审稿人吗?"——这项检查是内置的。