文献综述是研究开始的地方,也是大多数被浪费的周数所在。用五个界面检索五个数据库,去重导出,把引文拼进一份完成即过时的文档。下面展示同样的工作在 Neutropic 的一个真实会话中如何逐步进行。问题是心率变异性(HRV)生物反馈是否能降低成年人的感知压力,下面的所有截图都来自该会话。
第 1 步 — 提问
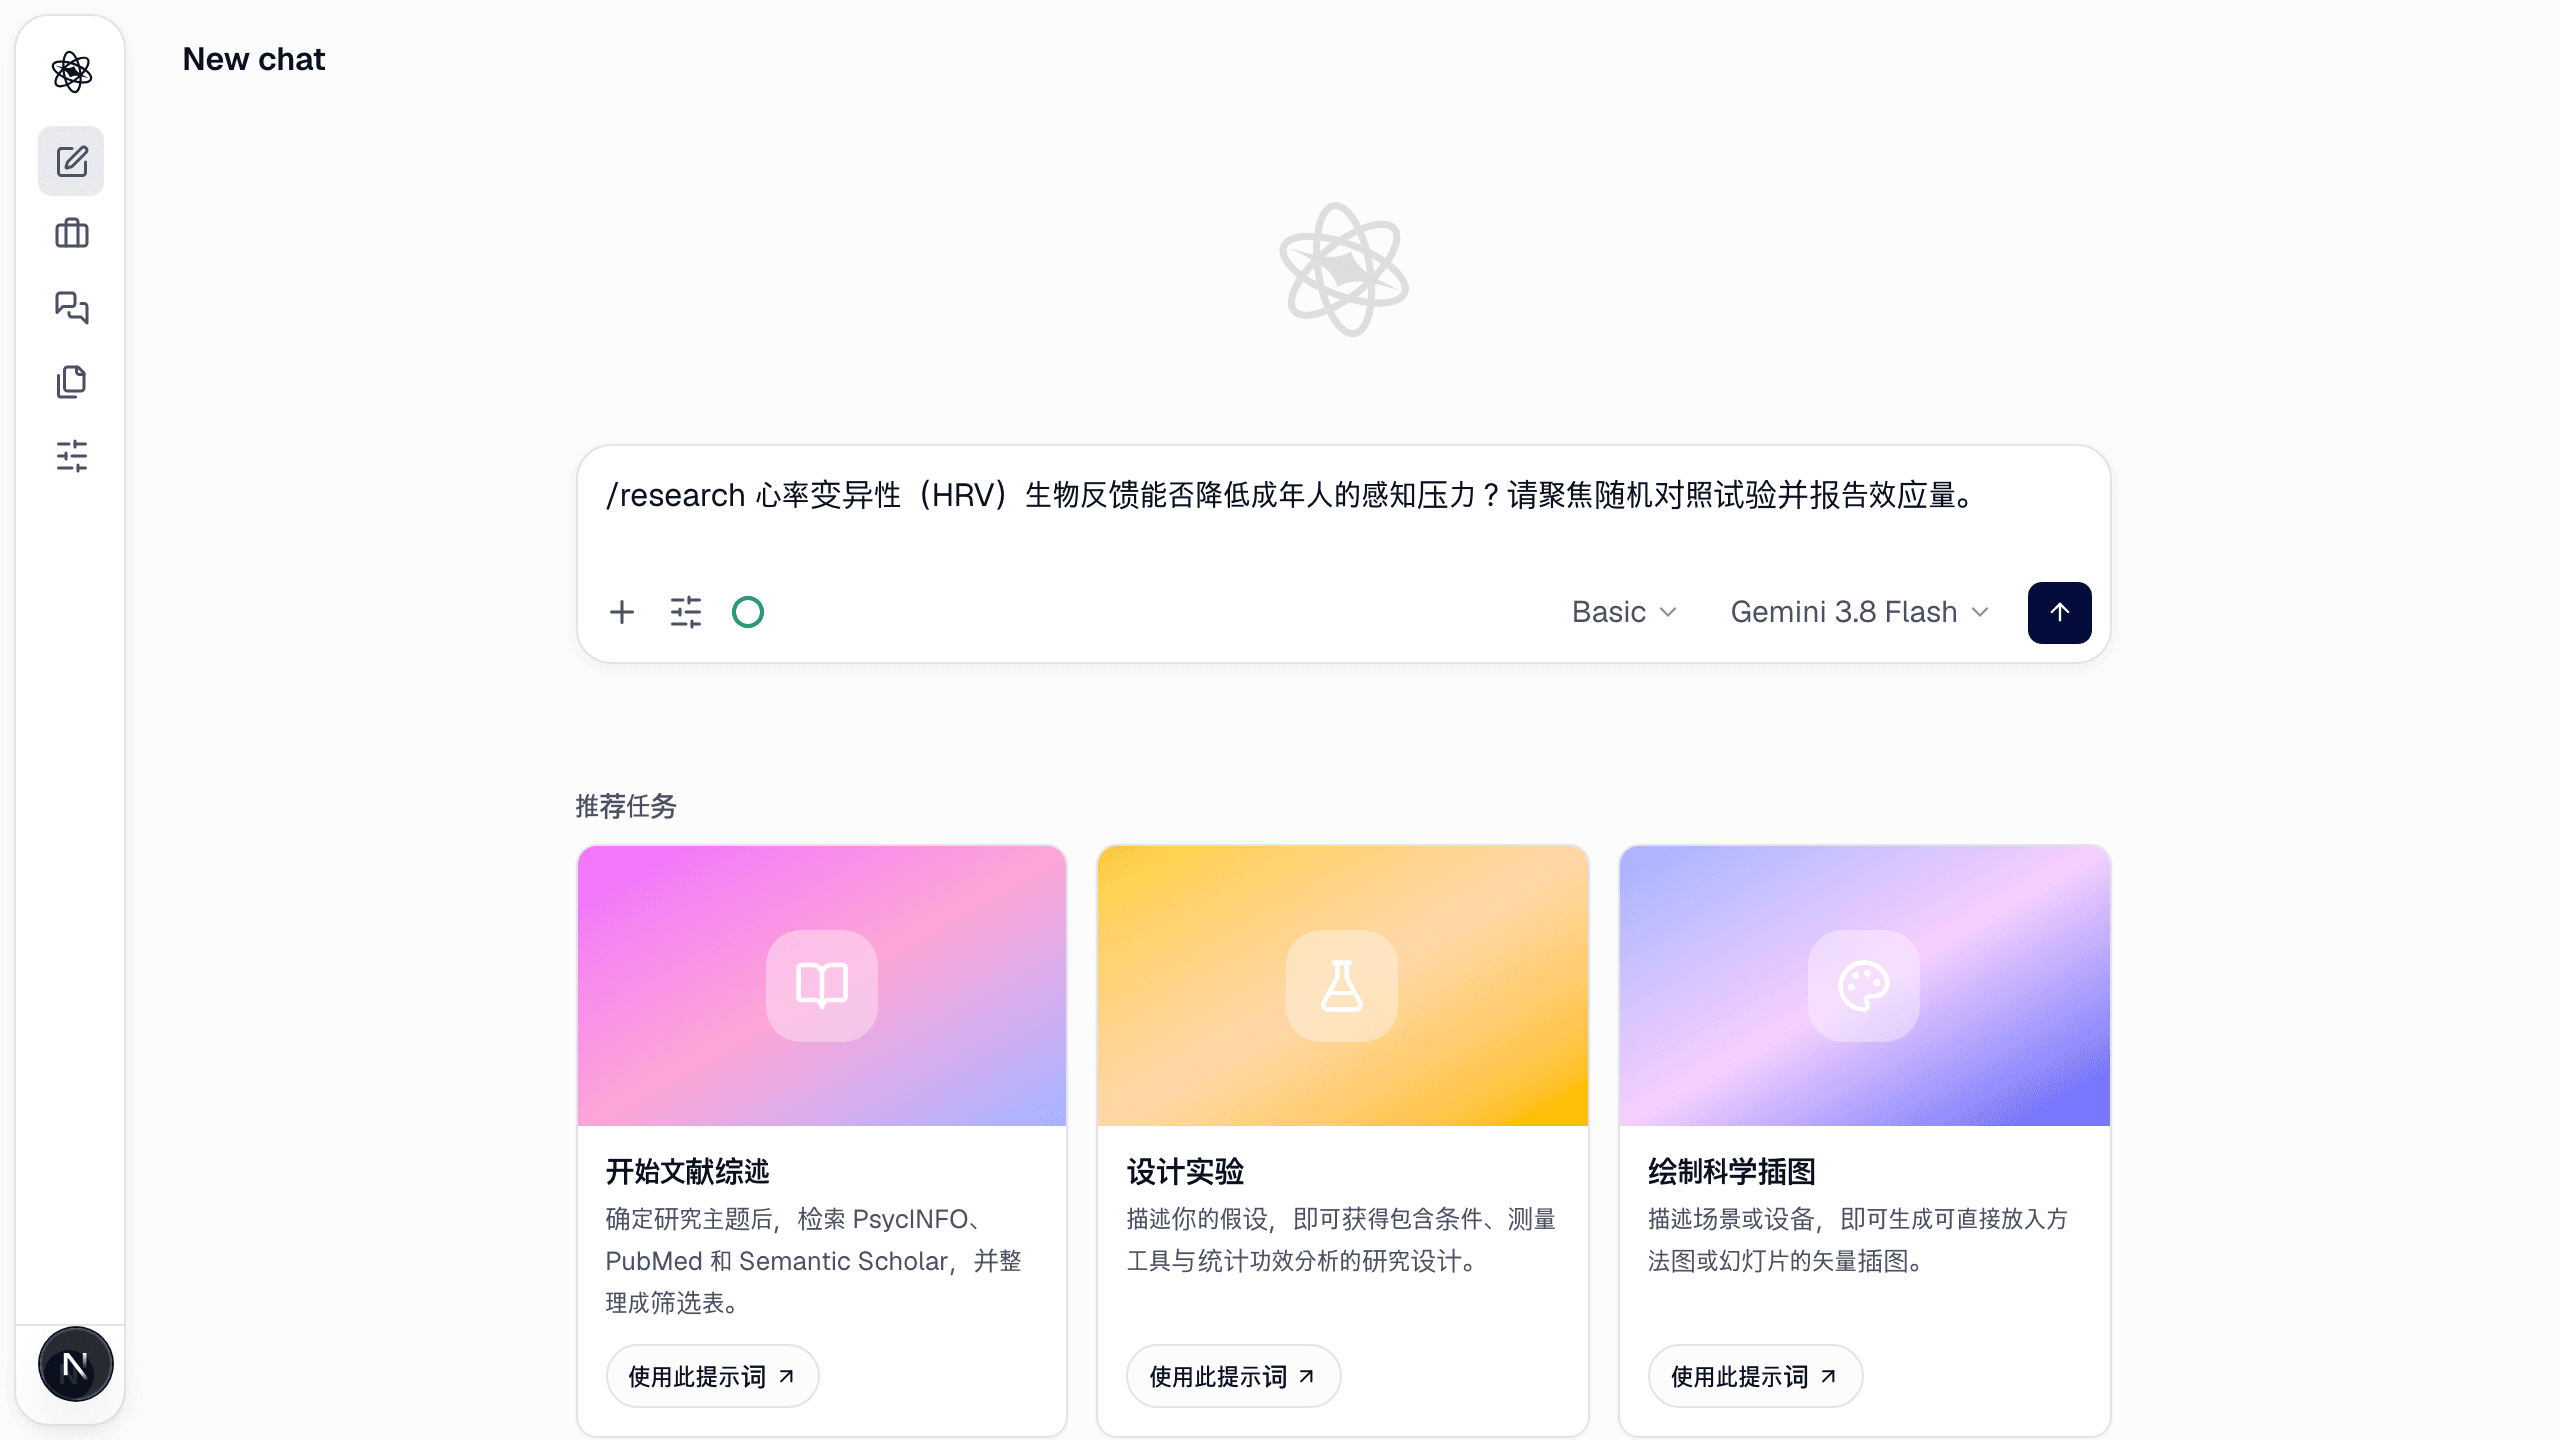
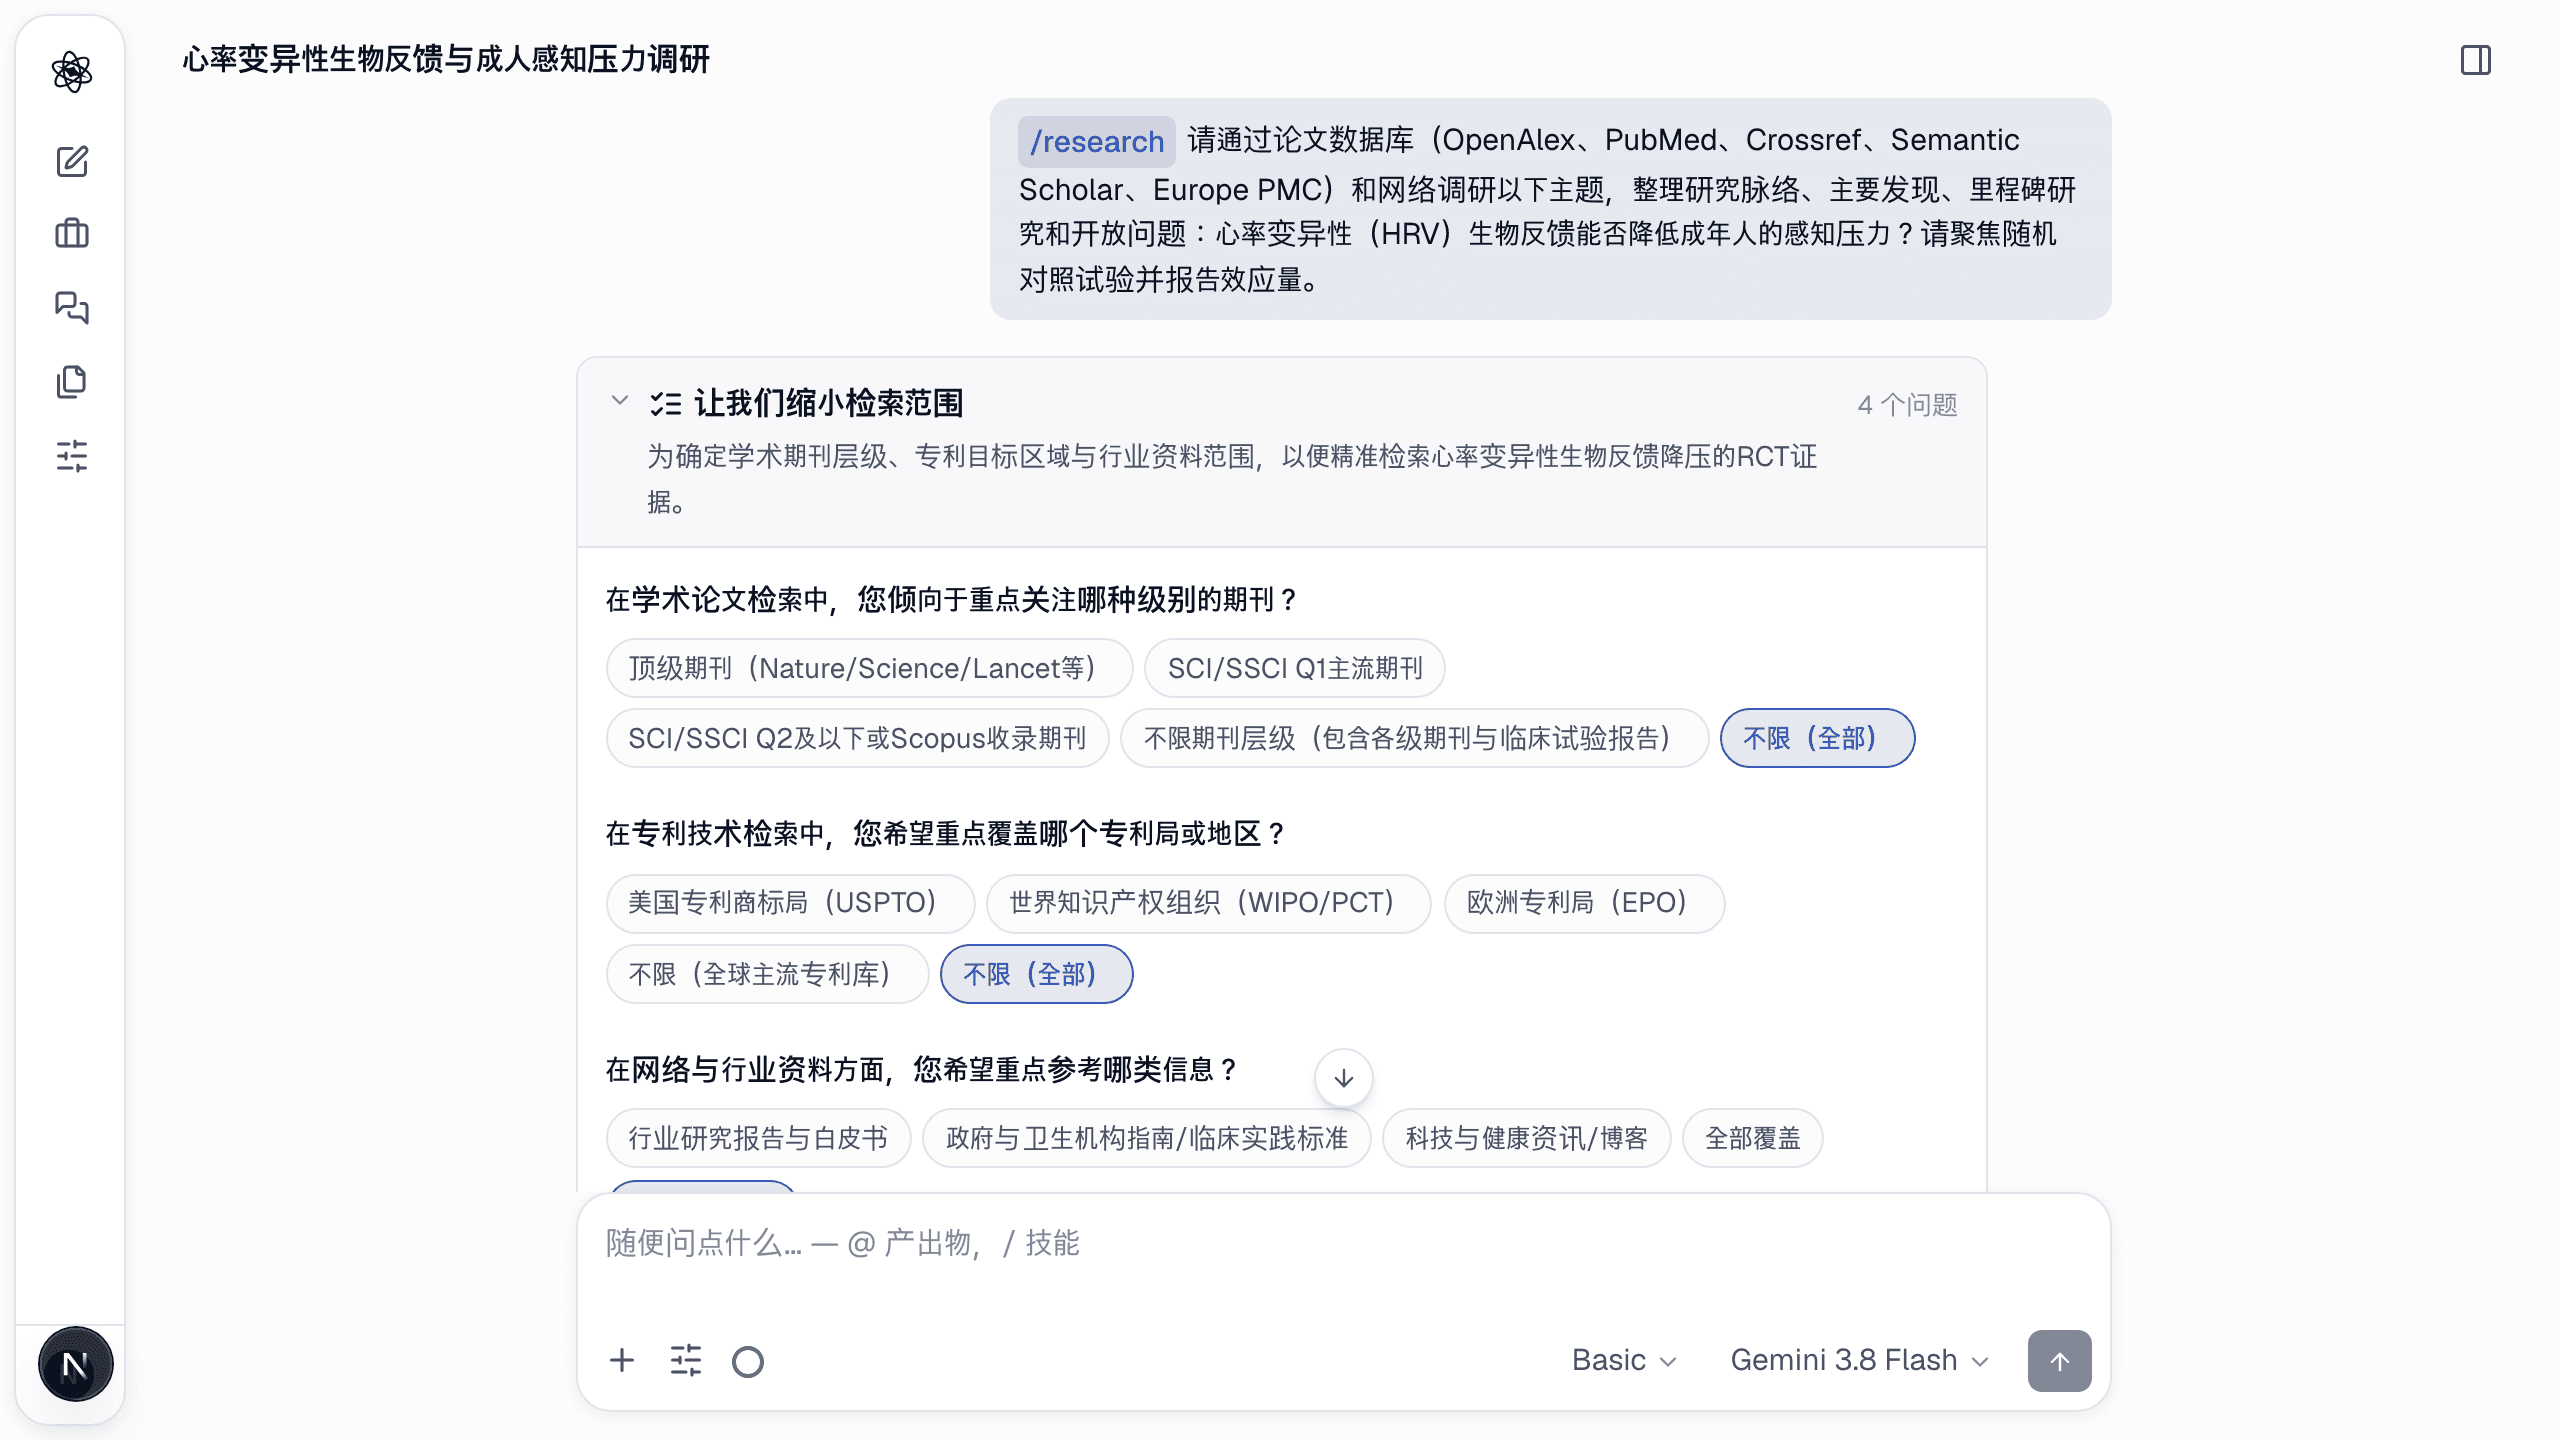
新建对话,用 /research 命令输入问题。自然语言即可;命令只是告诉代理运行哪个工作流。投入级别和模型在发送按钮旁边——第一次尝试用 Basic 就够了。
text
/research Does heart rate variability (HRV) biofeedback reduce perceived stress in adults? Focus on randomized controlled trials and report effect sizes.
第 2 步 — 范围来自问题本身
代理不会先问任何问题。来源类型、期刊等级和时间窗都取自问题本身——这里是"成年人"、"RCT"和"效应量"——它不得不做出的假设会写在摘要第一行,下一回合即可纠正。你在意的设置,请直接写进问题。
第 3 步 — 看着检索运行
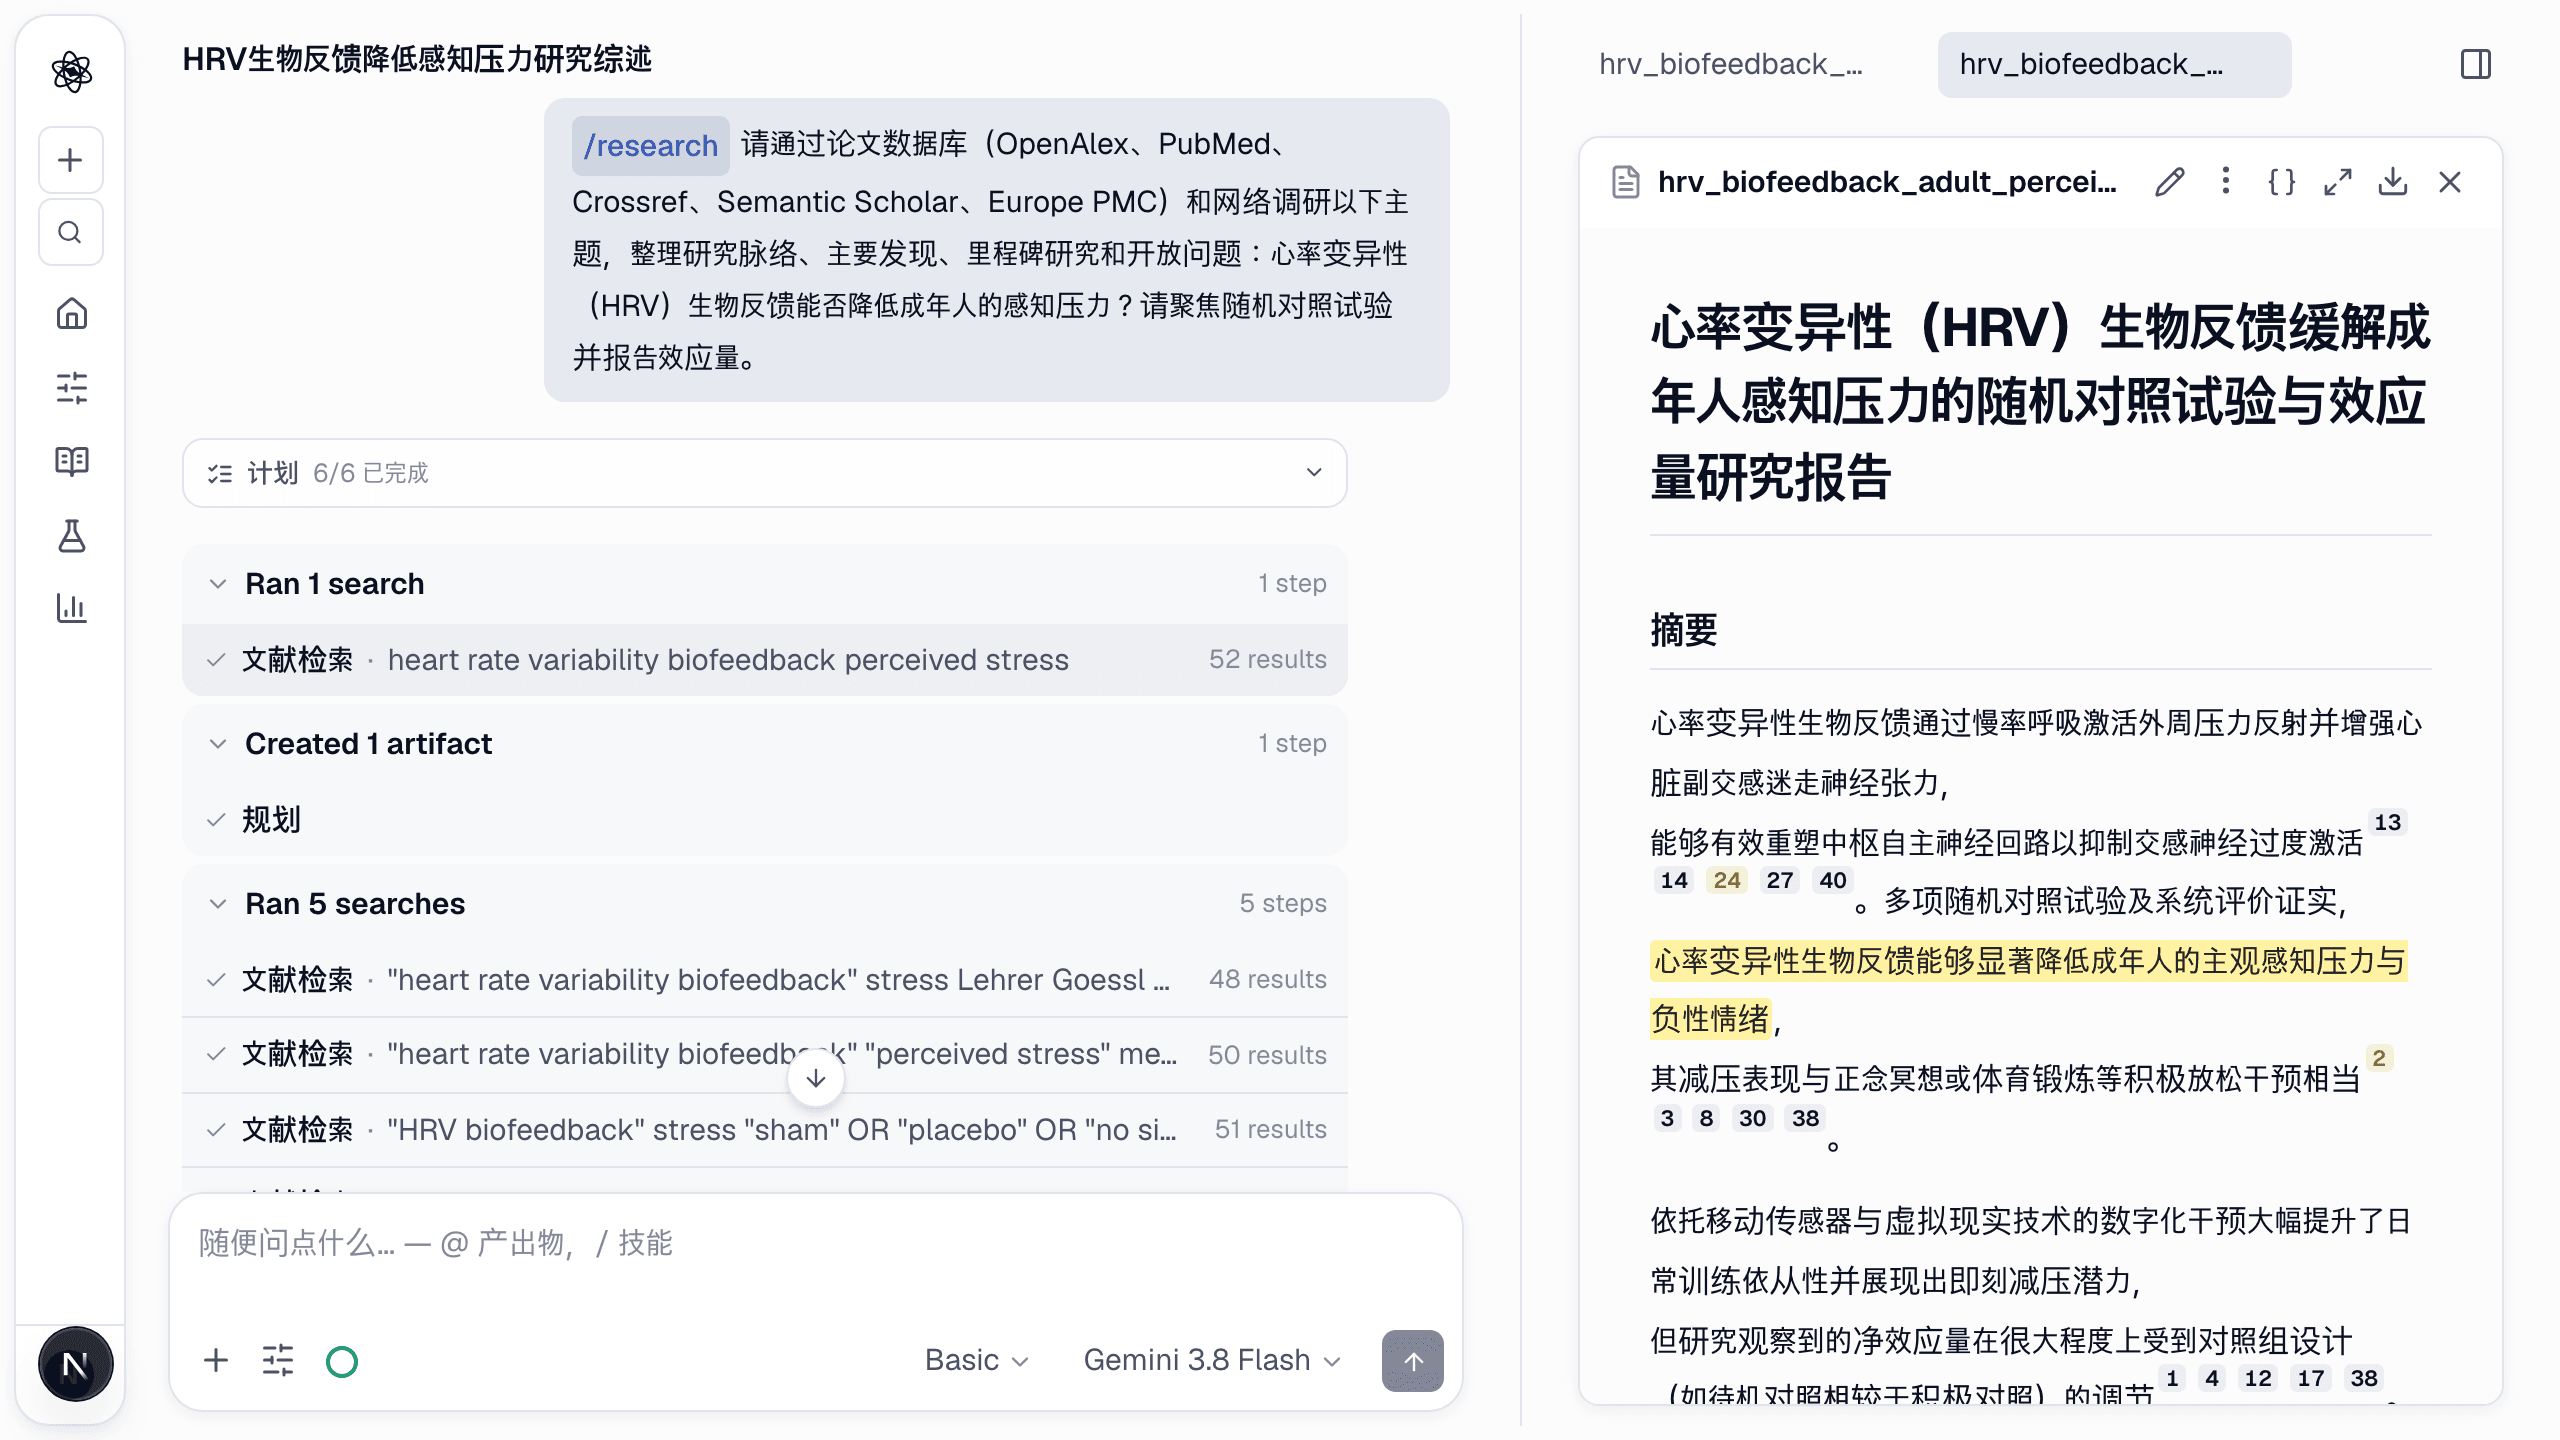
代理并行检索 OpenAlex、PubMed、Crossref、Semantic Scholar 和 Europe PMC——连接了机构访问权限时还有 Scopus、Web of Science 和 KCI——然后为按名称找到的元分析补充网络检索,并全文阅读一两页。每次检索运行时都列出查询和结果数,你能看到覆盖了什么,也可以自己重跑某条查询。
第 4 步 — 阅读每句话都负责的报告
产出不是一堆摘要,而是一份综合综述,每句话都带有指向真实、经核验来源的内嵌 [n] 引用。点击一个句子,来源面板会显示哪些研究支持它以及为什么。没有来源支持的句子被删除,而不是含糊带过。
- 归于某项研究的论断引用原始论文,而不是后来的转述。
- 一张筛选表按数据库、期刊等级和年份分解证据,引用图和研究思维导图展示来源之间的关系。
- 空白和相互矛盾的发现被明确列出——这是下一步假设构建的原料。
第 5 步 — 保持鲜活
Neutropic 的综述是一个活的产物。下个季度再跑一次,新发表的论文流入同一结构并高亮变化——你为经费申请写的综述在审稿人阅读时依然准确。而且由于来源留在会话中,后续的设计、分析和稿件可以按编号引用它们。
目标不是少读。而是把阅读花在重要的论文上,账目已经记好了。