Neutropic 的论文评审会把您的稿件交给五位评审人——期刊契合度、方法学、领域专家、更广视角和唱反调者——以及一位主编。主编给出四种决定之一:Accept、Minor Revision、Major Revision 或 Reject。这样的评审团有一种显而易见的失败方式:评审人的职责就是找问题,放任不管,他们会处处找到问题,于是每篇稿件都以 Major Revision 或 Reject 收场。一个永远不变的决定,什么也说明不了。
我们最初的实测结果全是 Reject。这有其道理——两篇是已经发表的论文,四篇是示例项目中只有一名受试者、两分钟记录的 HRV 稿件——但它们都不是答案已知的稿件。于是我们搭建了一套答案已知的测试,反复运行,直到评审团不再偏向一边。
一套答案已知的稿件
共 35 篇稿件,全部为开放获取,评审前做了盲化处理:删除期刊名、DOI、收稿/发表日期、引用格式行、许可声明和作者单位,让评审人无法利用"已经发表"这一线索。
- A — 已发表论文(8 篇)。 从 Applied Psychophysiology and Biofeedback、Frontiers in Psychology、PLOS ONE、Scientific Reports 各取 2 篇近期原创论文,按实际刊发它们的期刊标准评审。预期:Accept 或 Minor Revision,不应出现 Reject。
- B — 后来发表的预印本(6 篇)。 放入最初的预印本版本,以最终刊发的期刊为答案。预期:Minor 或 Major,且推荐期刊中包含实际刊发期刊。
- C — 撤稿论文(4 篇)。 因方法学或数据问题被撤稿。预期:Major 或 Reject,不应出现 Accept 或 Minor。
- D — 投错期刊(3 篇)。 把 3 篇 A 层论文设定为投给 Frontiers in Marine Science。预期:只有期刊契合度(fit)分数崩塌,其他分数几乎不动。
- E — 注入缺陷(14 篇)。 在 A 层论文的副本中各植入一个缺陷:删除 Methods 一节、保留检验统计量但翻转 p 值、删除伦理声明、把摘要改写成因果性夸大、把参考文献换成不存在的 DOI。预期:对应分数下降,由对口的评审人指出。
预先设定合格线的 14 项指标
第一次运行之前,我们先写下了什么算合格:
- 误拒 — 已发表论文(A)被 Reject 的比例:不超过 15%。
- 过宽 — 撤稿论文(C)得到 Accept 或 Minor 的比例:0。
- 决定顺序 — 平均总分:已发表论文 > 缺陷变体 > 撤稿论文。
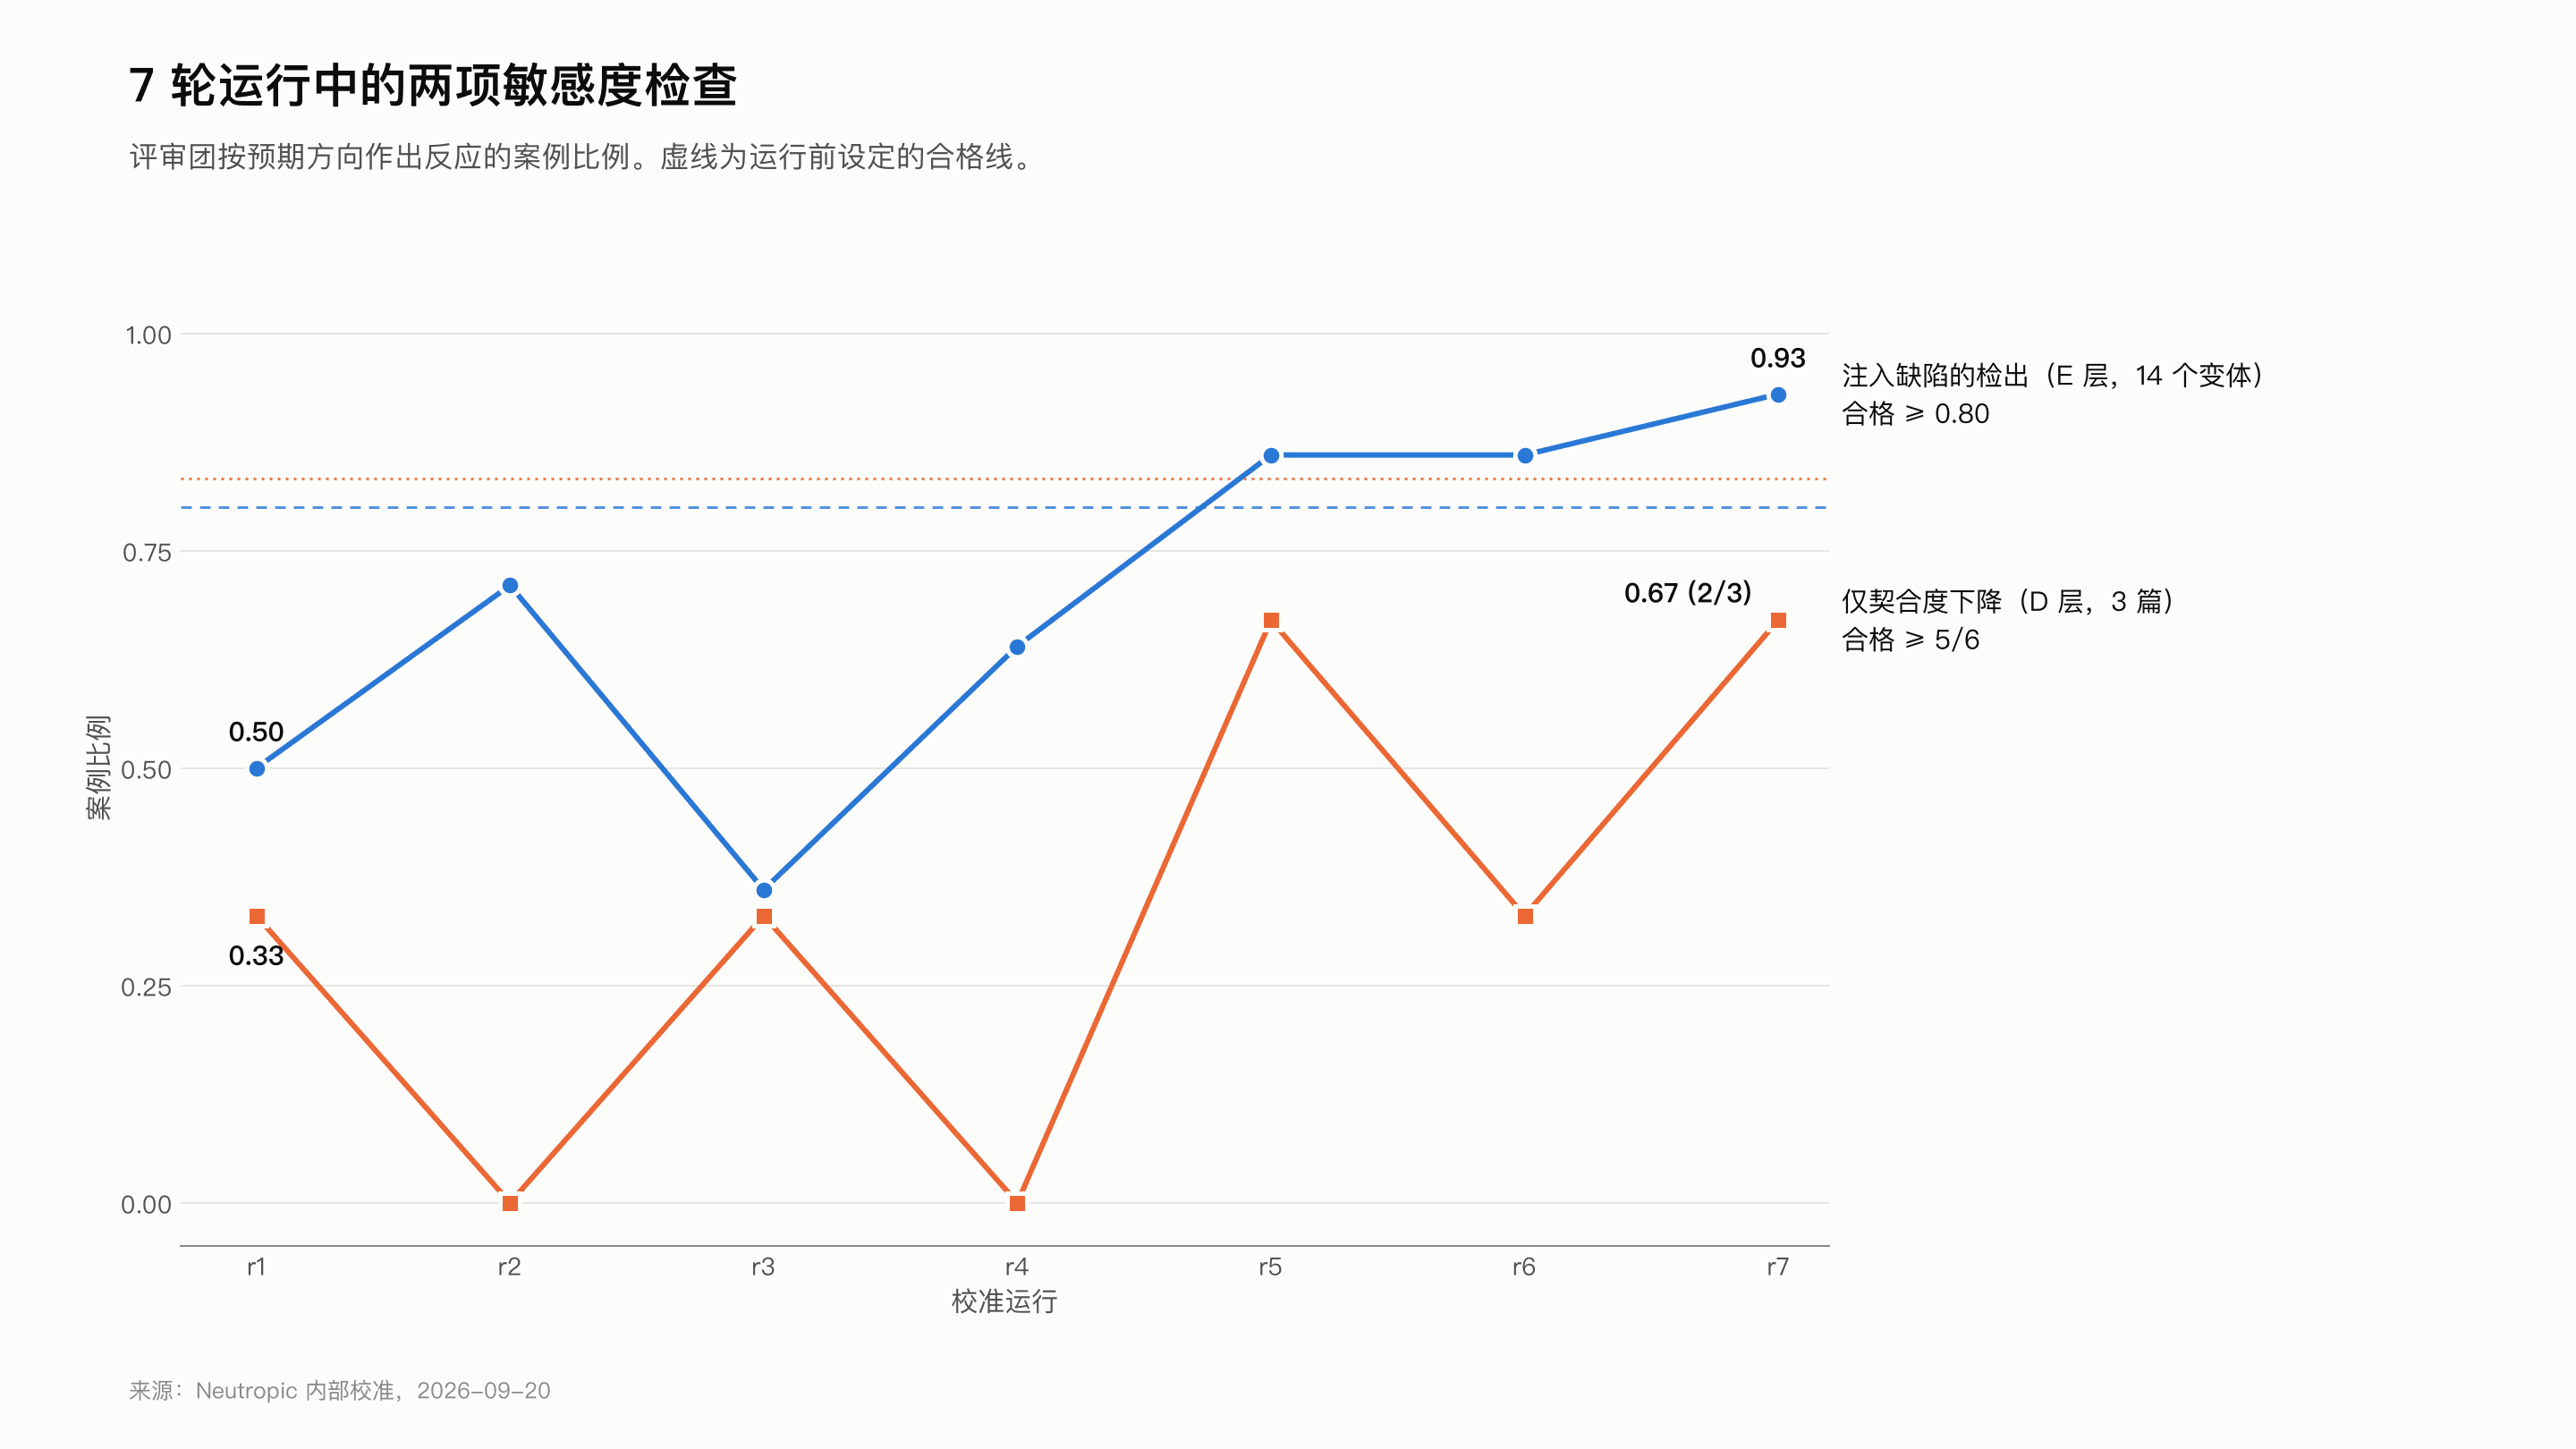
- 缺陷敏感度 — 评审团对注入缺陷作出反应的 E 变体:至少 80%。
- 维度独立性 — D 层中 fit 下降 2 分以上、其他分数变化不超过 0.5 的比例:至少 5/6。
- 可重复性(两项指标) — 同一稿件跑 3 次:决定一致率至少 80%,各分数标准差不超过 0.5。
- 评审人偏差 — 在已发表论文上,没有哪位评审人比其他人低 1 分以上(唱反调者为 0.5)。
- major 膨胀 — 每篇已发表论文、每位评审人的 major 问题数:不超过 1.0。
- 护栏介入 — 决定护栏推翻主编的比例:不超过 20%。
- 引文捏造 — 因引用的句子不在稿件中而被丢弃的意见:不超过 10%。
- 语言 — 同一论文用韩语和英语评审:决定一致,总分相差不超过 0.5。
- 档位 — 4 篇已发表论文的 Basic 与 Deep:决定一致率至少 75%。
- 期刊推荐 — 实际刊发 B 层论文的期刊出现在推荐列表中的比例:至少 50%。
基线过于严苛
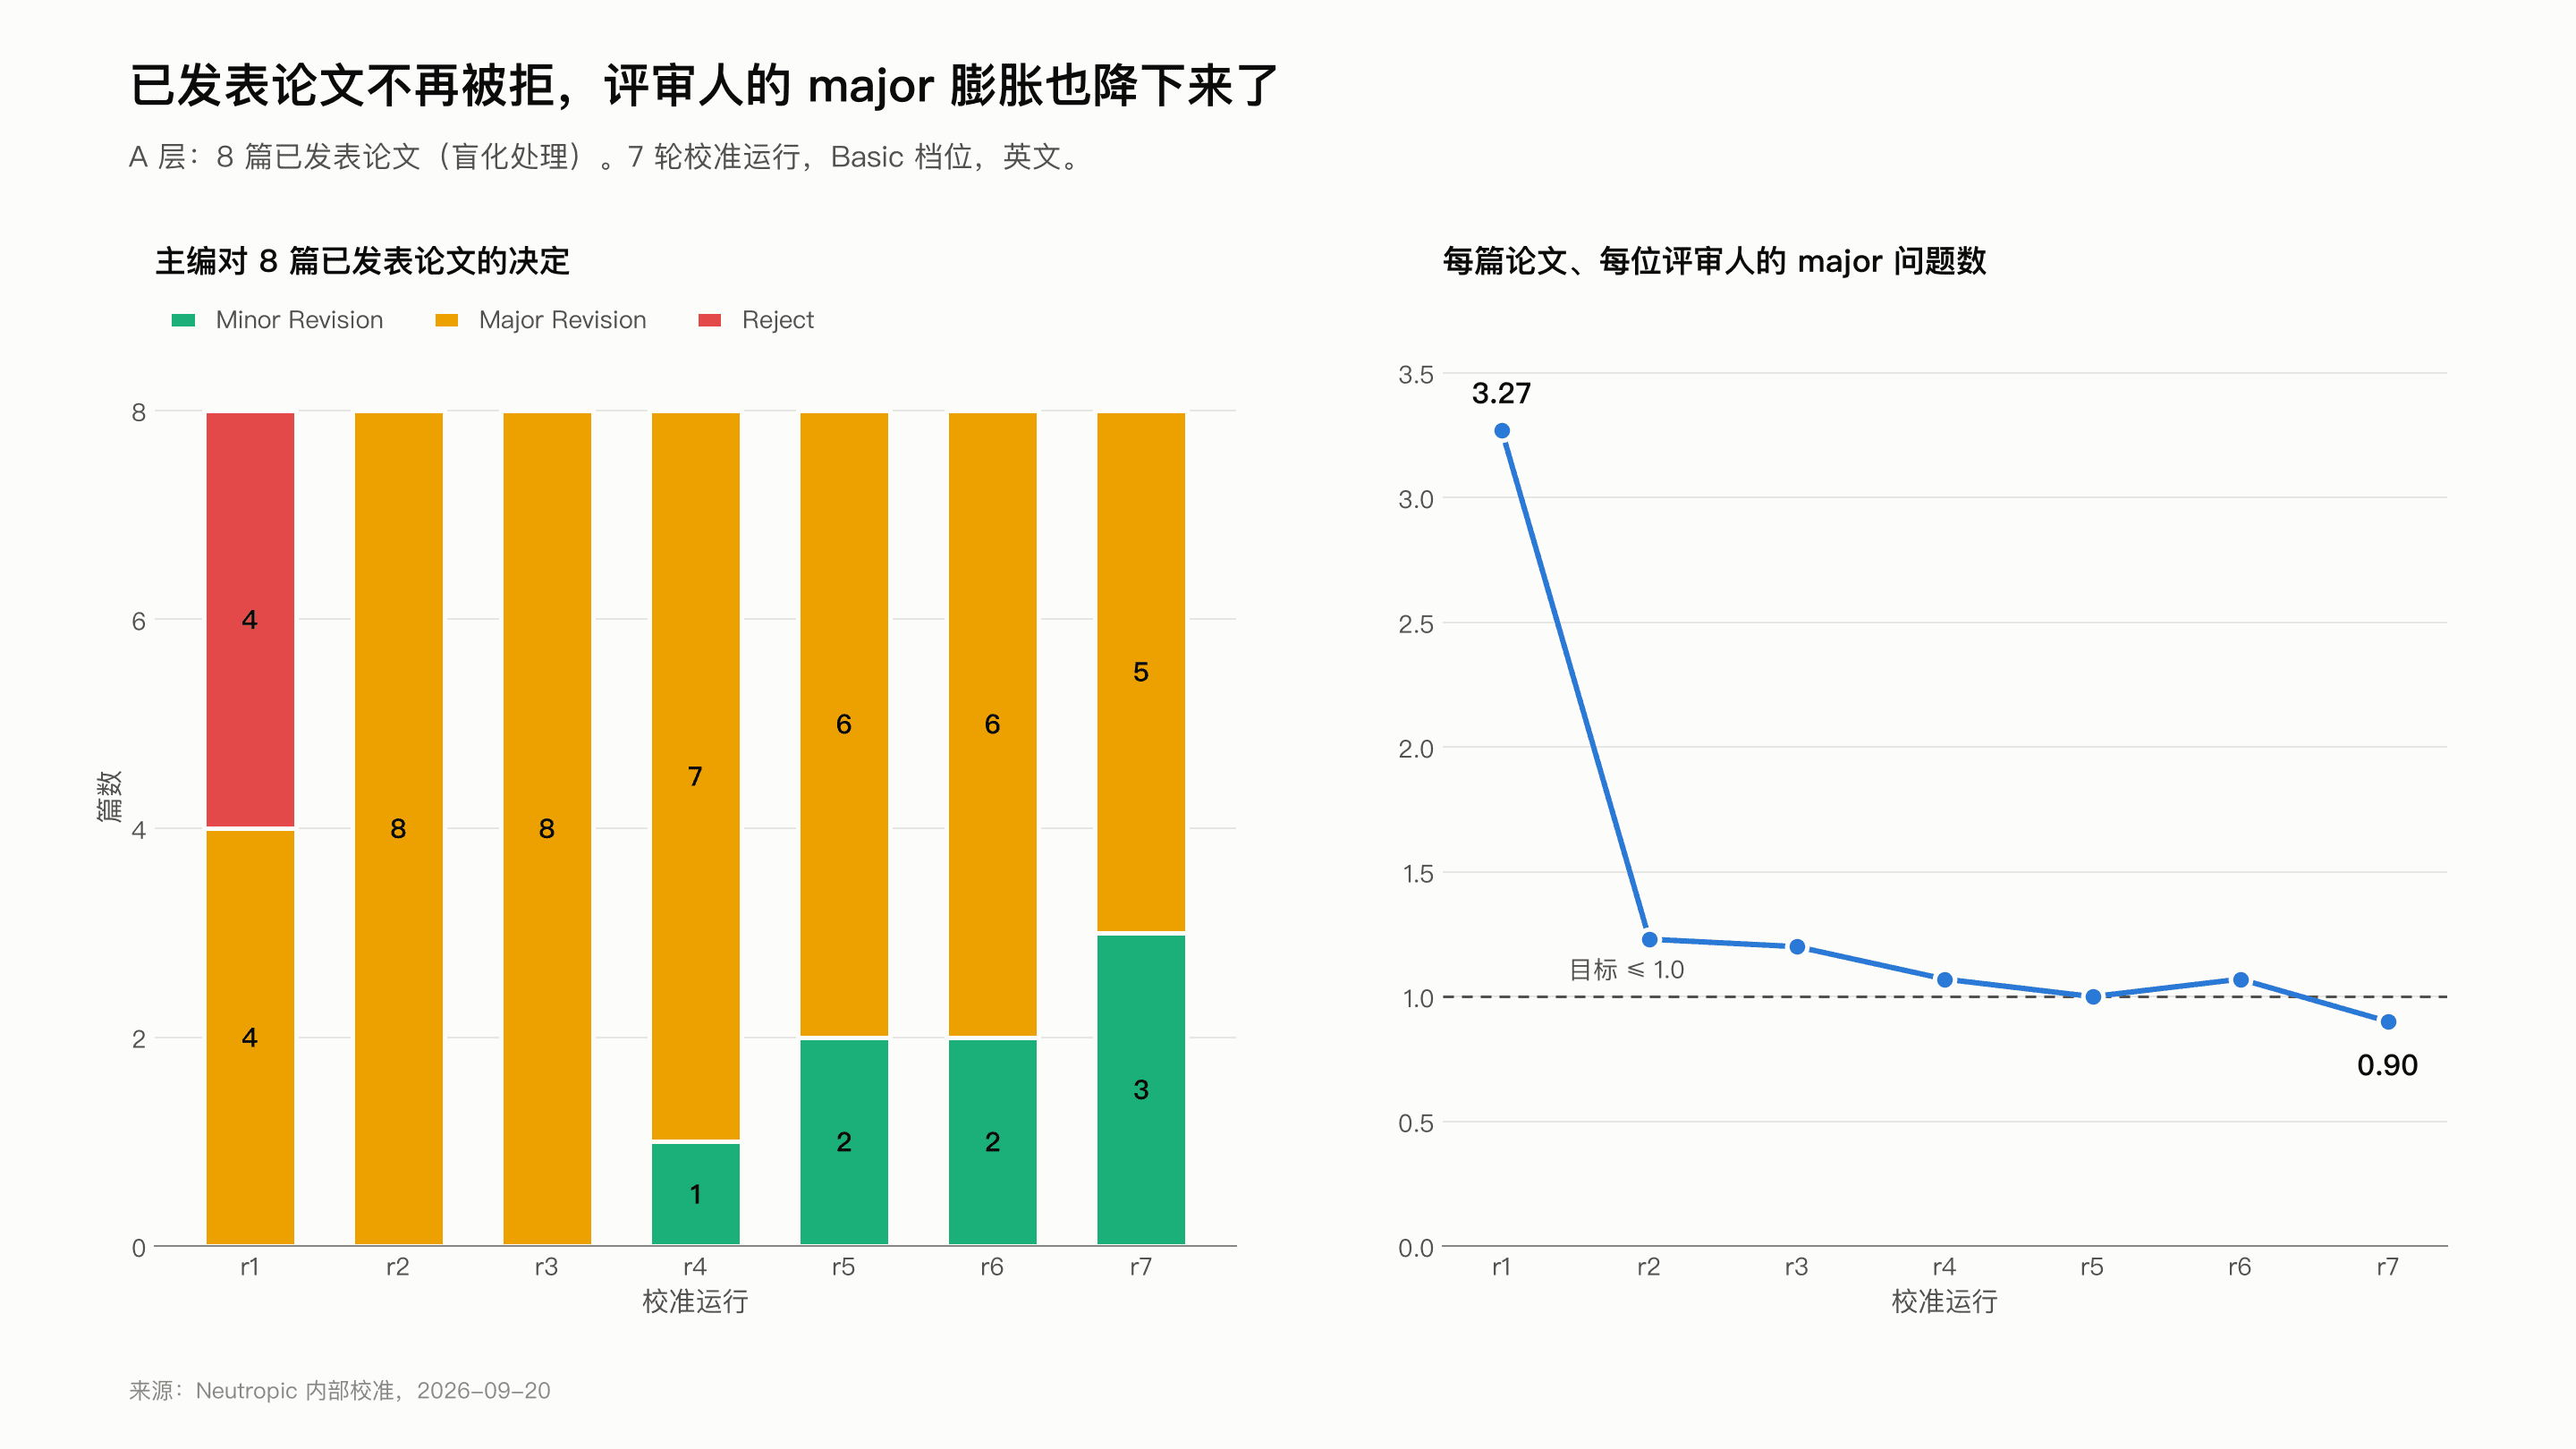
第一次运行(r1,Basic 档位,英文)证实了担忧。已发表论文中一半(8 篇中 4 篇)被 Reject,另一半是 Major Revision。每位评审人对每篇已发表论文平均提出 3.27 个 major 问题。有些方面一开始就是对的——没有撤稿论文被轻易放过,因引文无法核实而丢弃的意见只有 2%,6 篇预印本的实际刊发期刊全部出现在推荐列表中——但评审团明显偏向严苛,注入的缺陷也只抓到一半。
我们改了什么——每次只动一个杠杆
共 7 轮运行,每次改动后都重新测量。
- 所有评审人共用的校准段落(r2、r5、r6)。 major 是会使结论失效或阻碍投稿的问题;违反报告惯例属于 minor。major 最多 3 个,每个用一句话说明理由。加入评分锚点,以及"一篇可发表的普通论文得 3–4 分"。之后又加了几条:严重程度看修复需要什么;范围不符只降低 fit 分;总分取五个维度的平均(偏离时须说明理由)。r2 之后已发表论文不再被拒,每位评审人的 major 降到 1.23——但这回 8 篇全成了 Major Revision。
- 主编决定规则(r4)。 没有得到佐证的缺陷就给 Minor;Reject 只留给不补充新数据就无法修复的缺陷,或超出期刊范围的稿件。
- 唱反调者的锚点(r5、r6)。 唱反调者的职责是提出反驳,而不是把每篇稿件都打沉。我们为它设定了专属评分锚点和一条规则:按稿件的实际写法打分,替代解释最多在 evidence 上扣 1 分。它对已发表论文的平均总分从 r1 的 1.75 升到 r7 的 2.88。
- 决定护栏(r2 → r7)。 限制主编可选决定的是代码,而不是提示词。能阻止 Accept 的只有得到佐证的 major——两位评审人一致,或确定性检查的结果(与重算值不符的 p 值、未注册的参考文献 DOI)。r7 中我们补上了 r6 数据暴露的漏洞:平均 fit 不超过 1.5,或多数评审人建议 Reject 时,只允许 Major 或 Reject(r6 中有一篇超出范围的论文以 Minor 溜了过去)。
还有一处修复与措辞无关。r3、r4 没抓到翻转的 p 值,是因为根据报告的检验统计量重算 p 值的检查只在 Deep 档位运行。让它在 Basic 也运行后(r5),两个 p 值变体都被抓到了。
进展并不是一条直线。缺陷敏感度在 r3 跌到 0.36 后才回升,维度独立性在各轮之间于 3 篇中 0–2 篇来回摆动。
结果:14 项中 13 项合格
最终运行 r7(Basic,英文,全部 35 篇)加上重复、语言和档位运行的结果:
- 误拒 8 篇中 0 篇。 已发表论文:Minor Revision 3、Major Revision 5、Reject 0。每位评审人的 major 0.90。
- 过宽为 0。 撤稿论文:Major Revision 2、Reject 2。
- 决定顺序成立。 平均总分:已发表论文 3.17(A)和 3.67(B),缺陷变体 2.97,撤稿论文 2.15。
- 缺陷敏感度 14 项中 13 项(0.93)。 漏掉的一项:某篇论文中被删除的伦理声明。
- 投错期刊。 3 篇全部 Reject,fit 从 4.0–4.6 降至 1.0。
- 可重复性。 每篇稿件各跑 3 次(r6):决定一致率 90%,各分数标准差 0.08。
- 语言。 6 篇用韩语和英语评审:6 篇决定全部一致,总分相差 0.2。
- 档位。 4 篇用 Basic 和 Deep 评审:4 篇决定全部一致。
- 引文与护栏。 983 条意见中有 16 条(2%)因引用不在稿件中而被丢弃;护栏从未推翻主编。
- 推荐。 6 篇预印本的实际刊发期刊全部出现在推荐列表中。
唯一未达标:维度独立性 3 篇中 2 篇
在 3 篇投错期刊的论文中,有一篇除 fit 外 novelty 也变动了 0.6(标准为 0.5)。评审人倾向于以期刊读者群为参照来判断新颖性,这本身并不离谱。决定是对的(Reject),fit 也降到了 1.0,所以我们把它视为容许范围,而没有再加一条规则。
为什么仍有五篇已发表论文得到 Major Revision
把护栏再收紧,就能把已发表论文推向 Minor。我们没有这么做。五篇中有四篇,护栏本已允许 Minor,主编仍选择了 Major,因为多数评审人指出了真实的问题——一篇论文的结果表中有一行在本应不同的几列里重复了相同的数值,另一篇缺少综合检验(omnibus)统计量。已发表论文也并非完美无瑕,发现复制粘贴的表格行的评审人是在尽职。因此我们用误拒和 major 膨胀两项指标管理这一倾向,而把决定本身交给主编。
您应该知道的局限
- 样本小。 35 篇稿件,其中已发表论文 8 篇——一篇的结果变化就会让比例变动 12.5 个百分点。领域也以心理学、生理学和 HCI 为主。
- 人工缺陷。 E 层一次只植入一个干净的缺陷。真实稿件的缺陷往往有好几处,也更隐蔽。
- 大多为 Basic、大多为英文。 韩语和 Deep 分别只在 6 篇和 4 篇上做了比较。
- 只有一个评审模型。 所有运行都使用同一个模型,换一个模型校准结果可能不同。
- "已发表"不等于标准答案。 它只意味着某个期刊的编辑在某个时间点接受了它。
如何解读您的决定
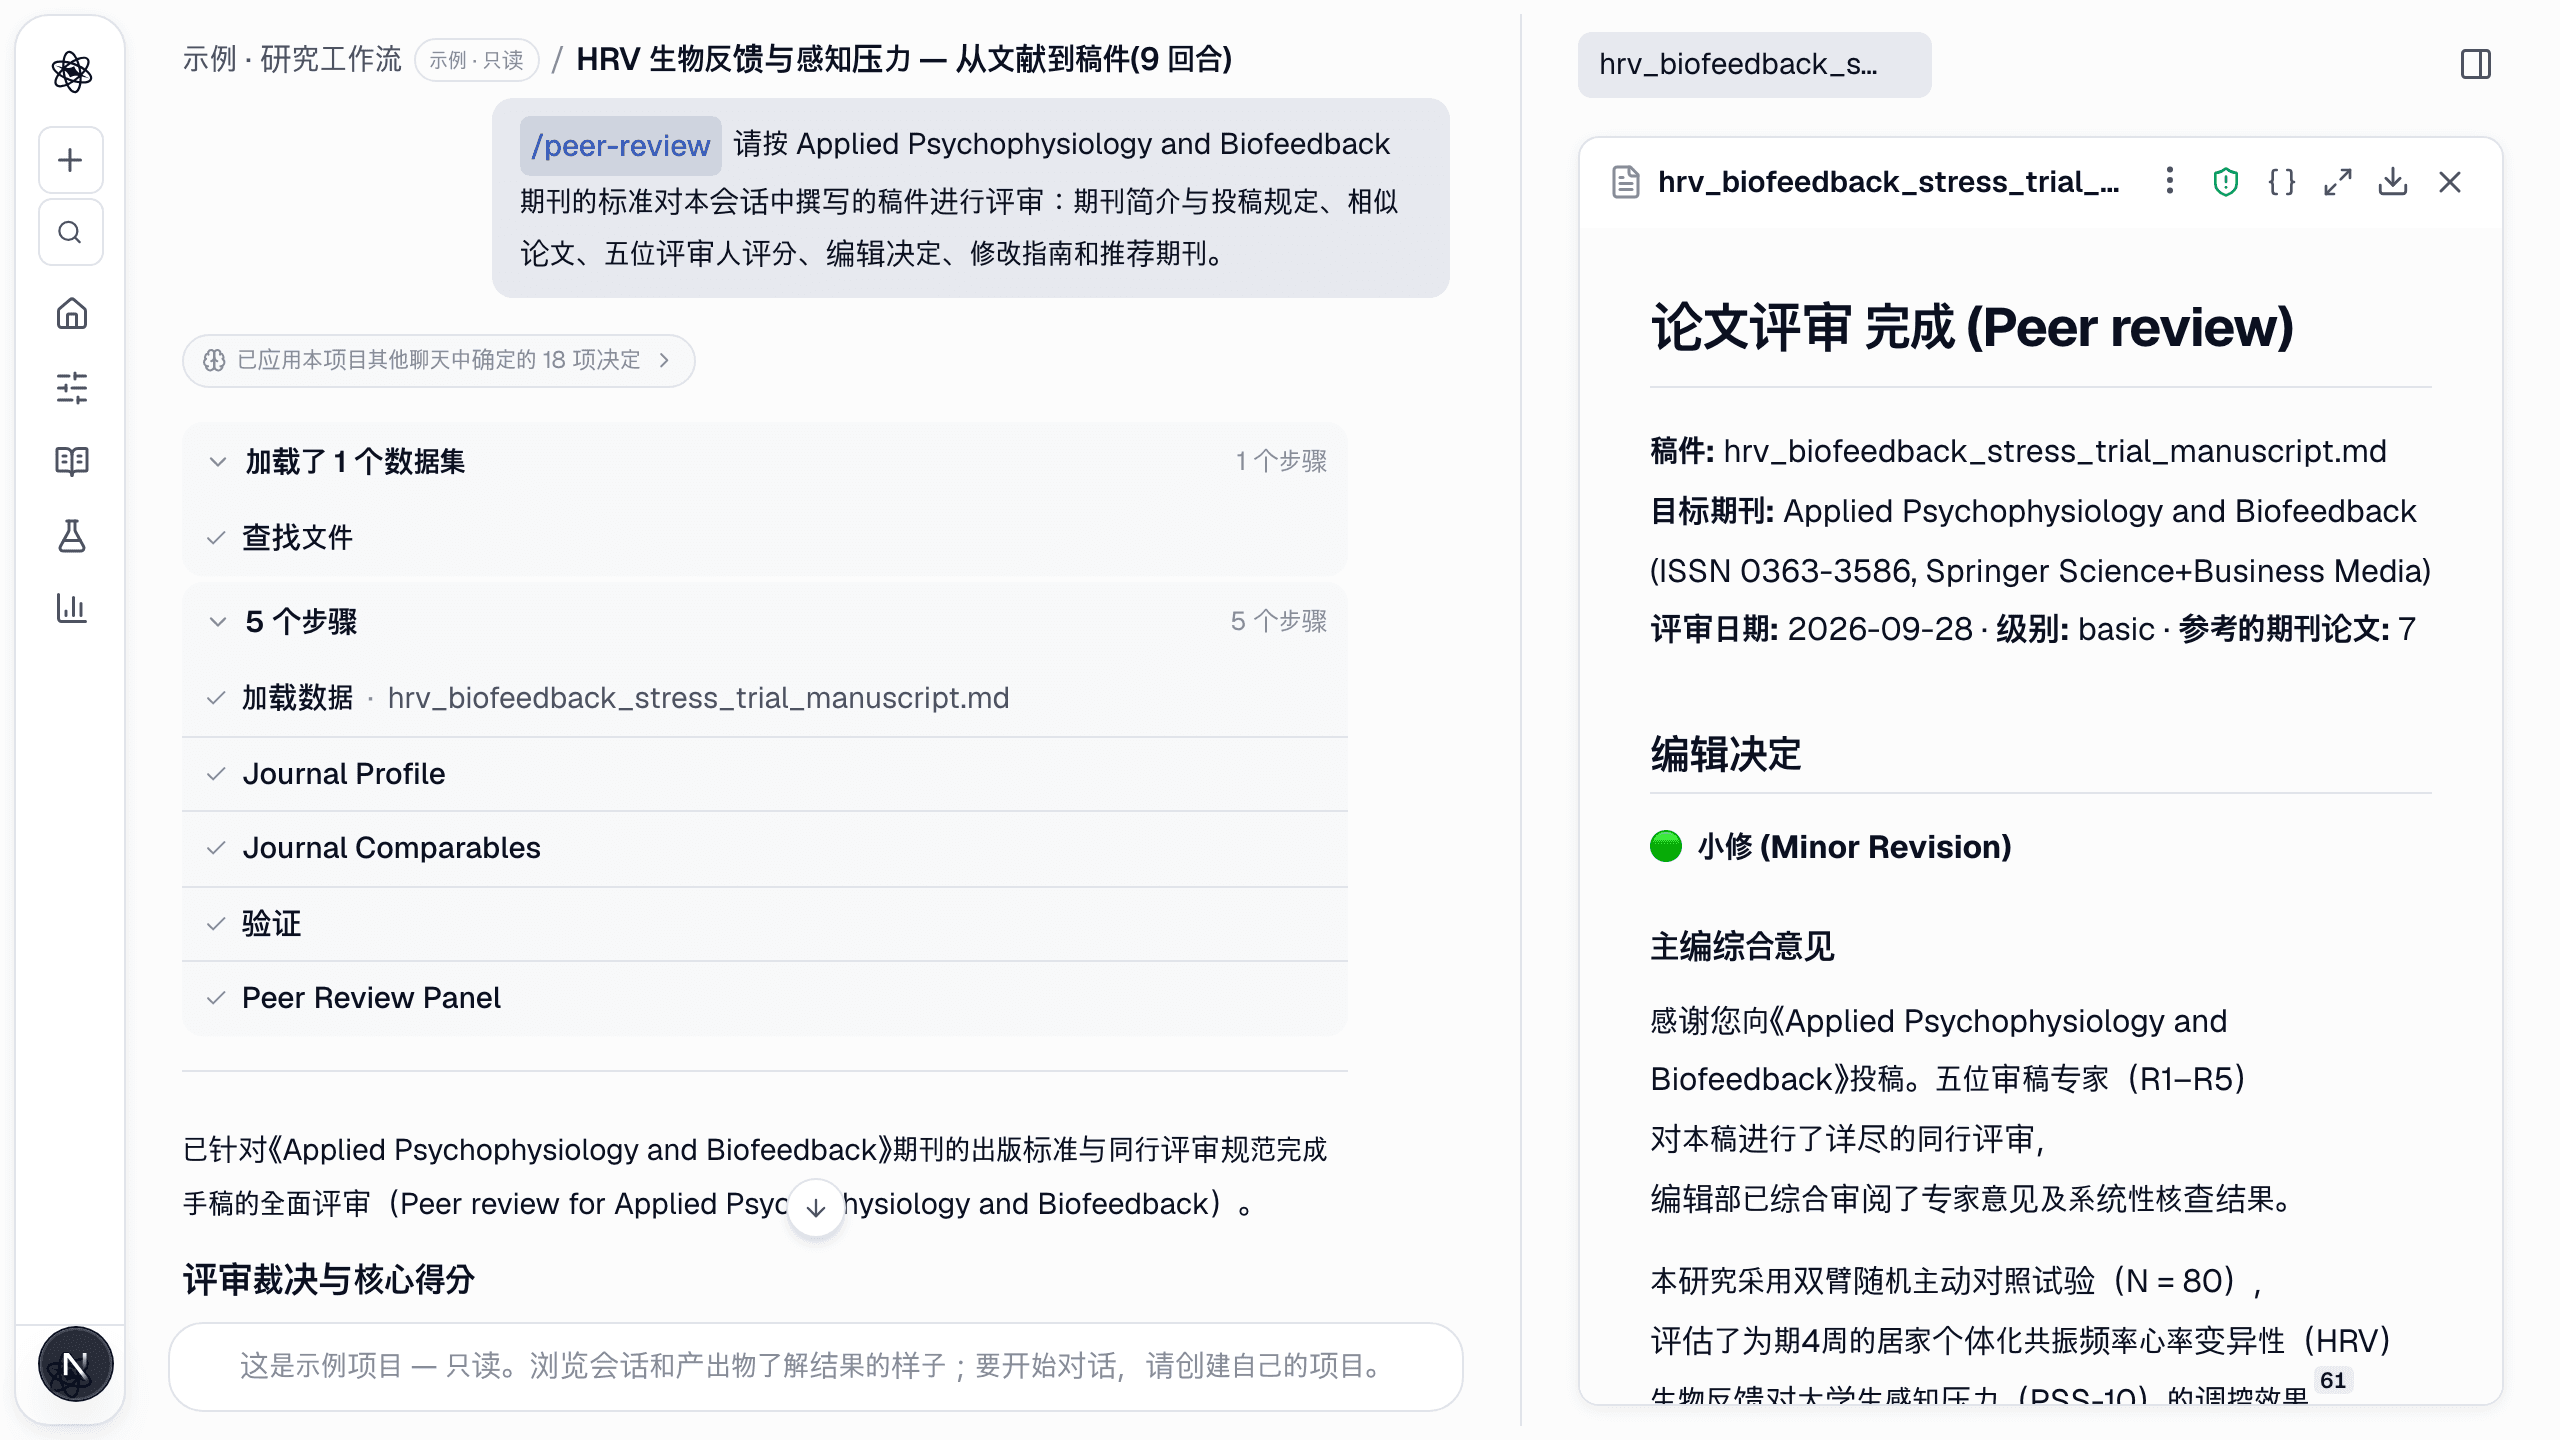
- 修改指南比徽章更重要。 先看 P0 项。
- 好论文得到 Major Revision 很正常。 8 篇已发表论文中有 5 篇得到了它。请把它读作"投稿前先改好这些",而不是"这篇论文很弱"。
- 认真对待 Reject,并先看 fit。 在最终运行中,Reject 只出现在撤稿论文和投错期刊的论文上,从未落在已发表论文上。如果 fit 分很低,问题可能出在期刊而不是稿件——看看推荐期刊。
- 分歧本身就是信息。 如果某位评审人的分数远低于其他人,请读他的 major 问题以及主编对此的裁定。
- 修改后再跑一次,比较前后的决定。
论文评审是投稿前的检查。它能告诉您一位细心的审稿人可能会问什么、稿件哪里不符合期刊规定;它不能告诉您期刊会不会录用,也不能取代真正阅读您稿件的编辑和审稿人。用它让您在那场评审前准备得更充分。