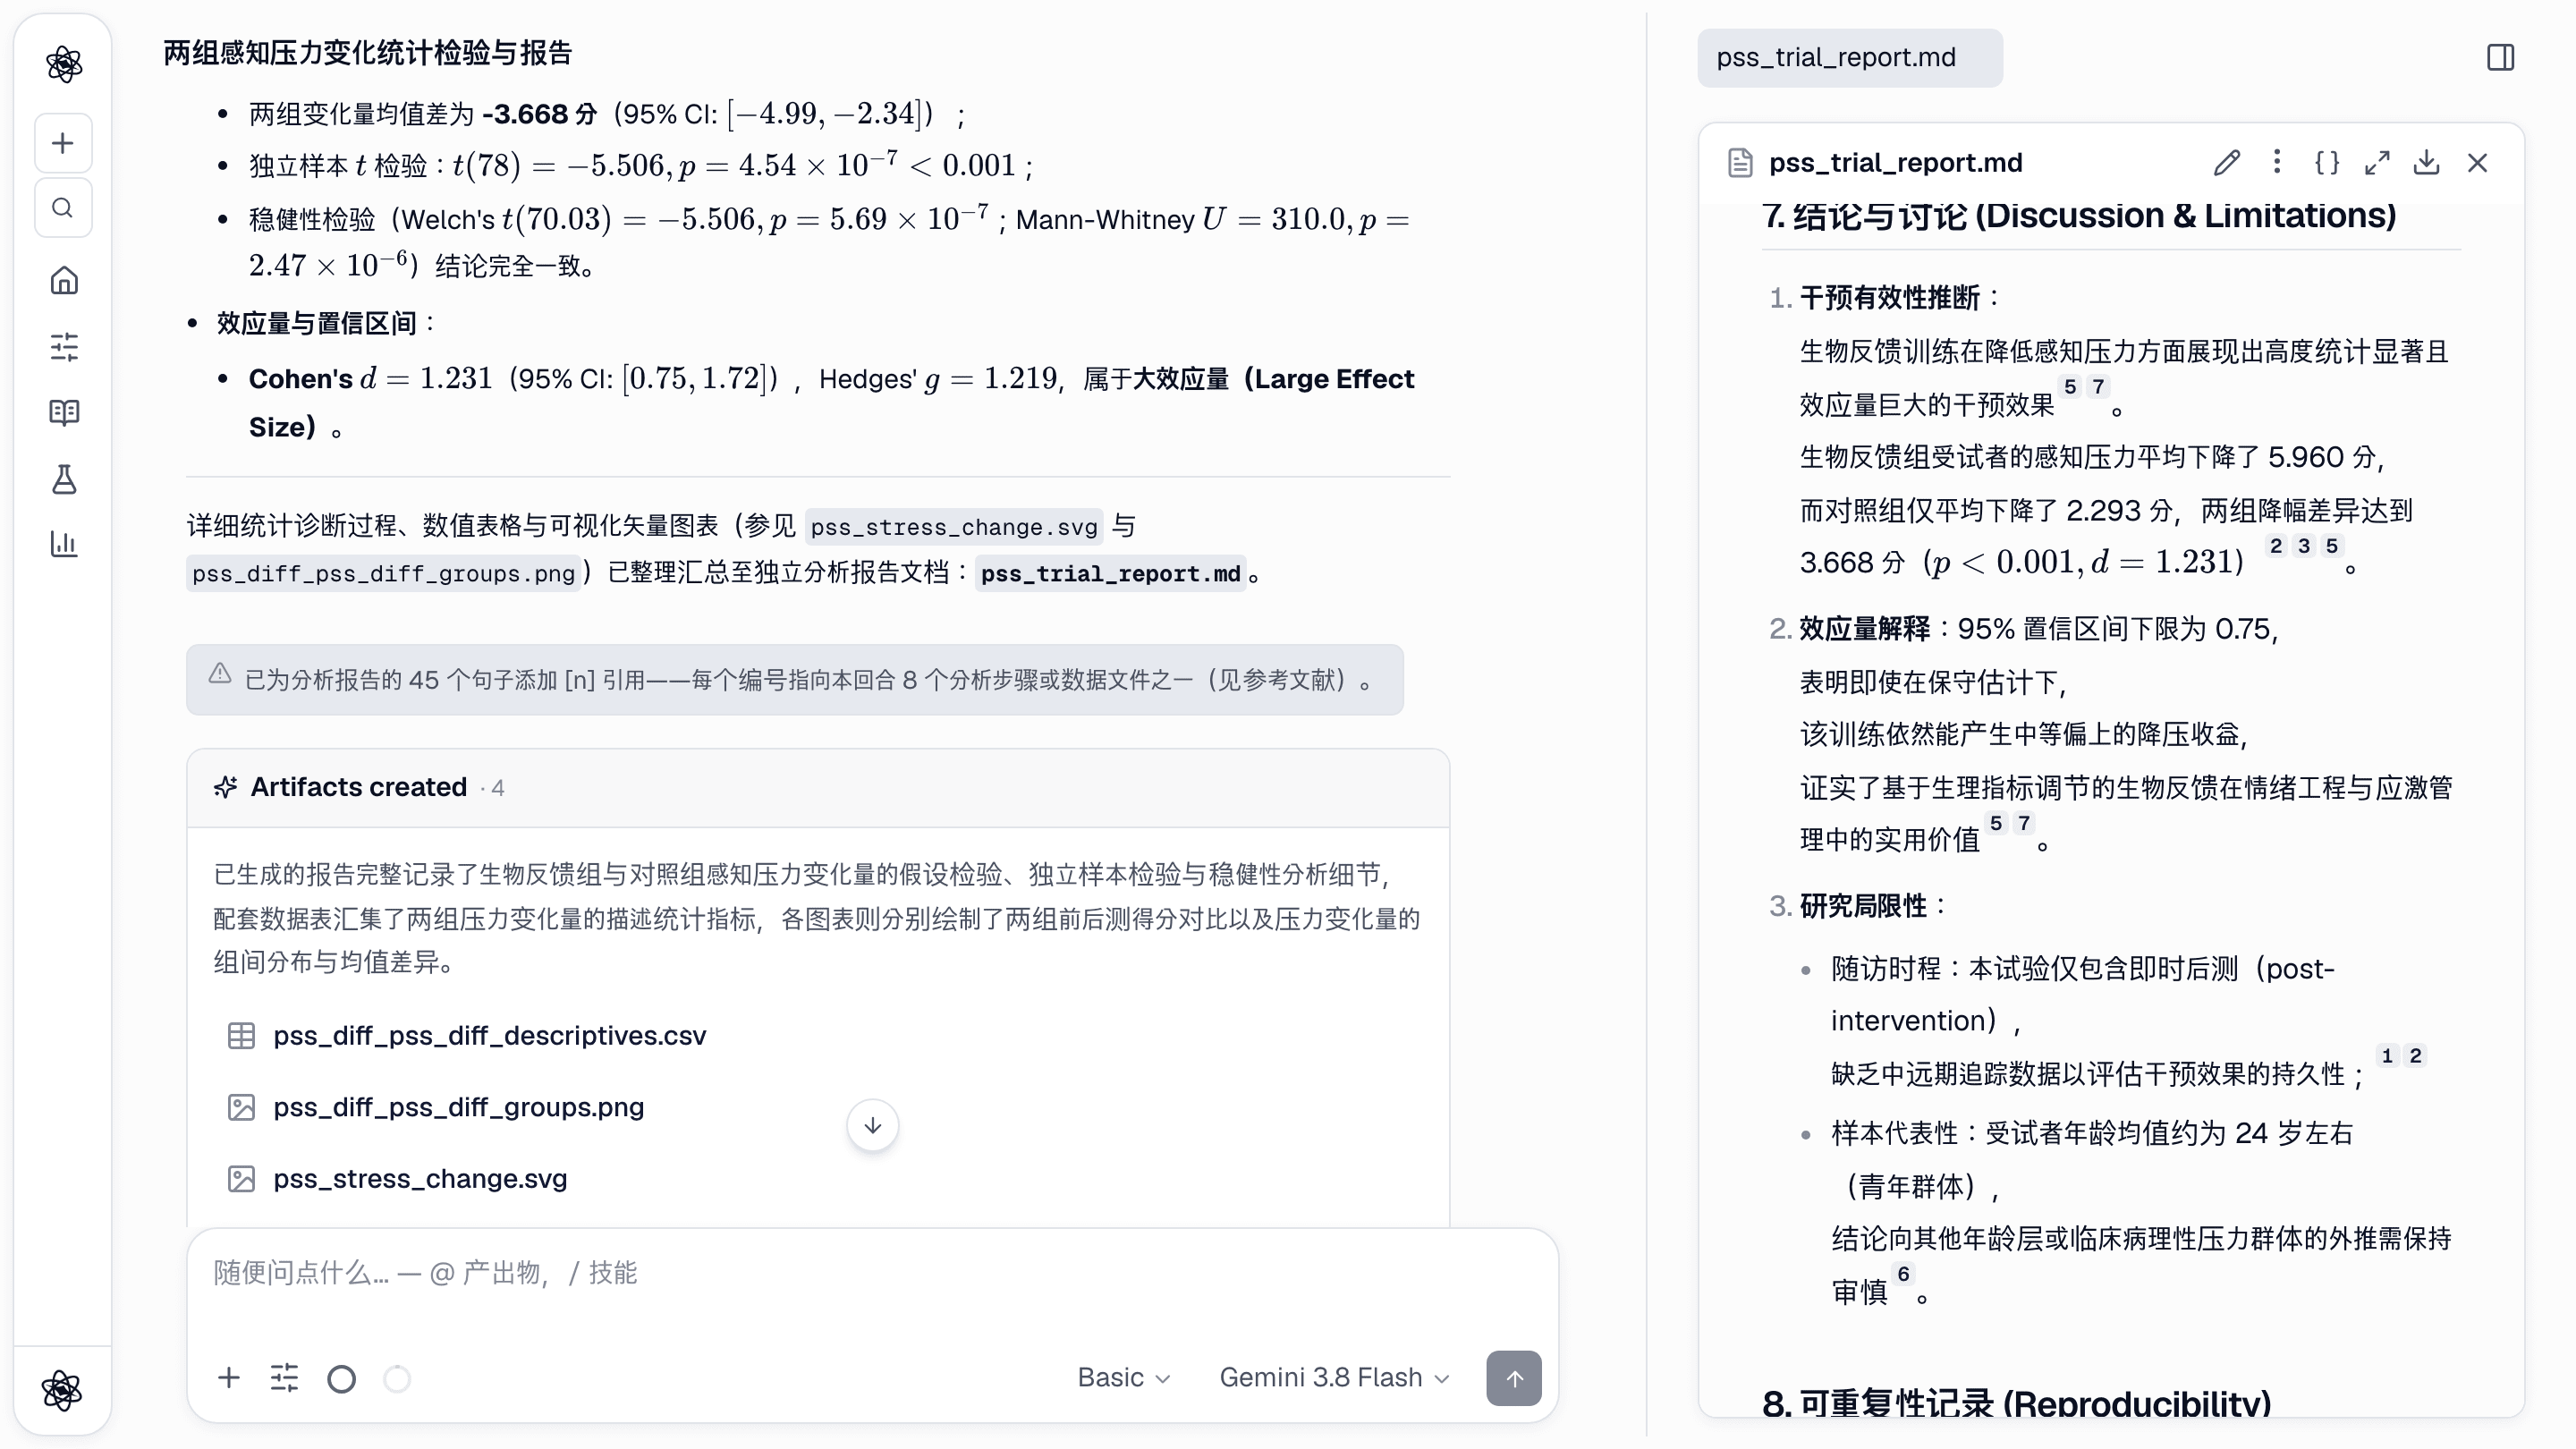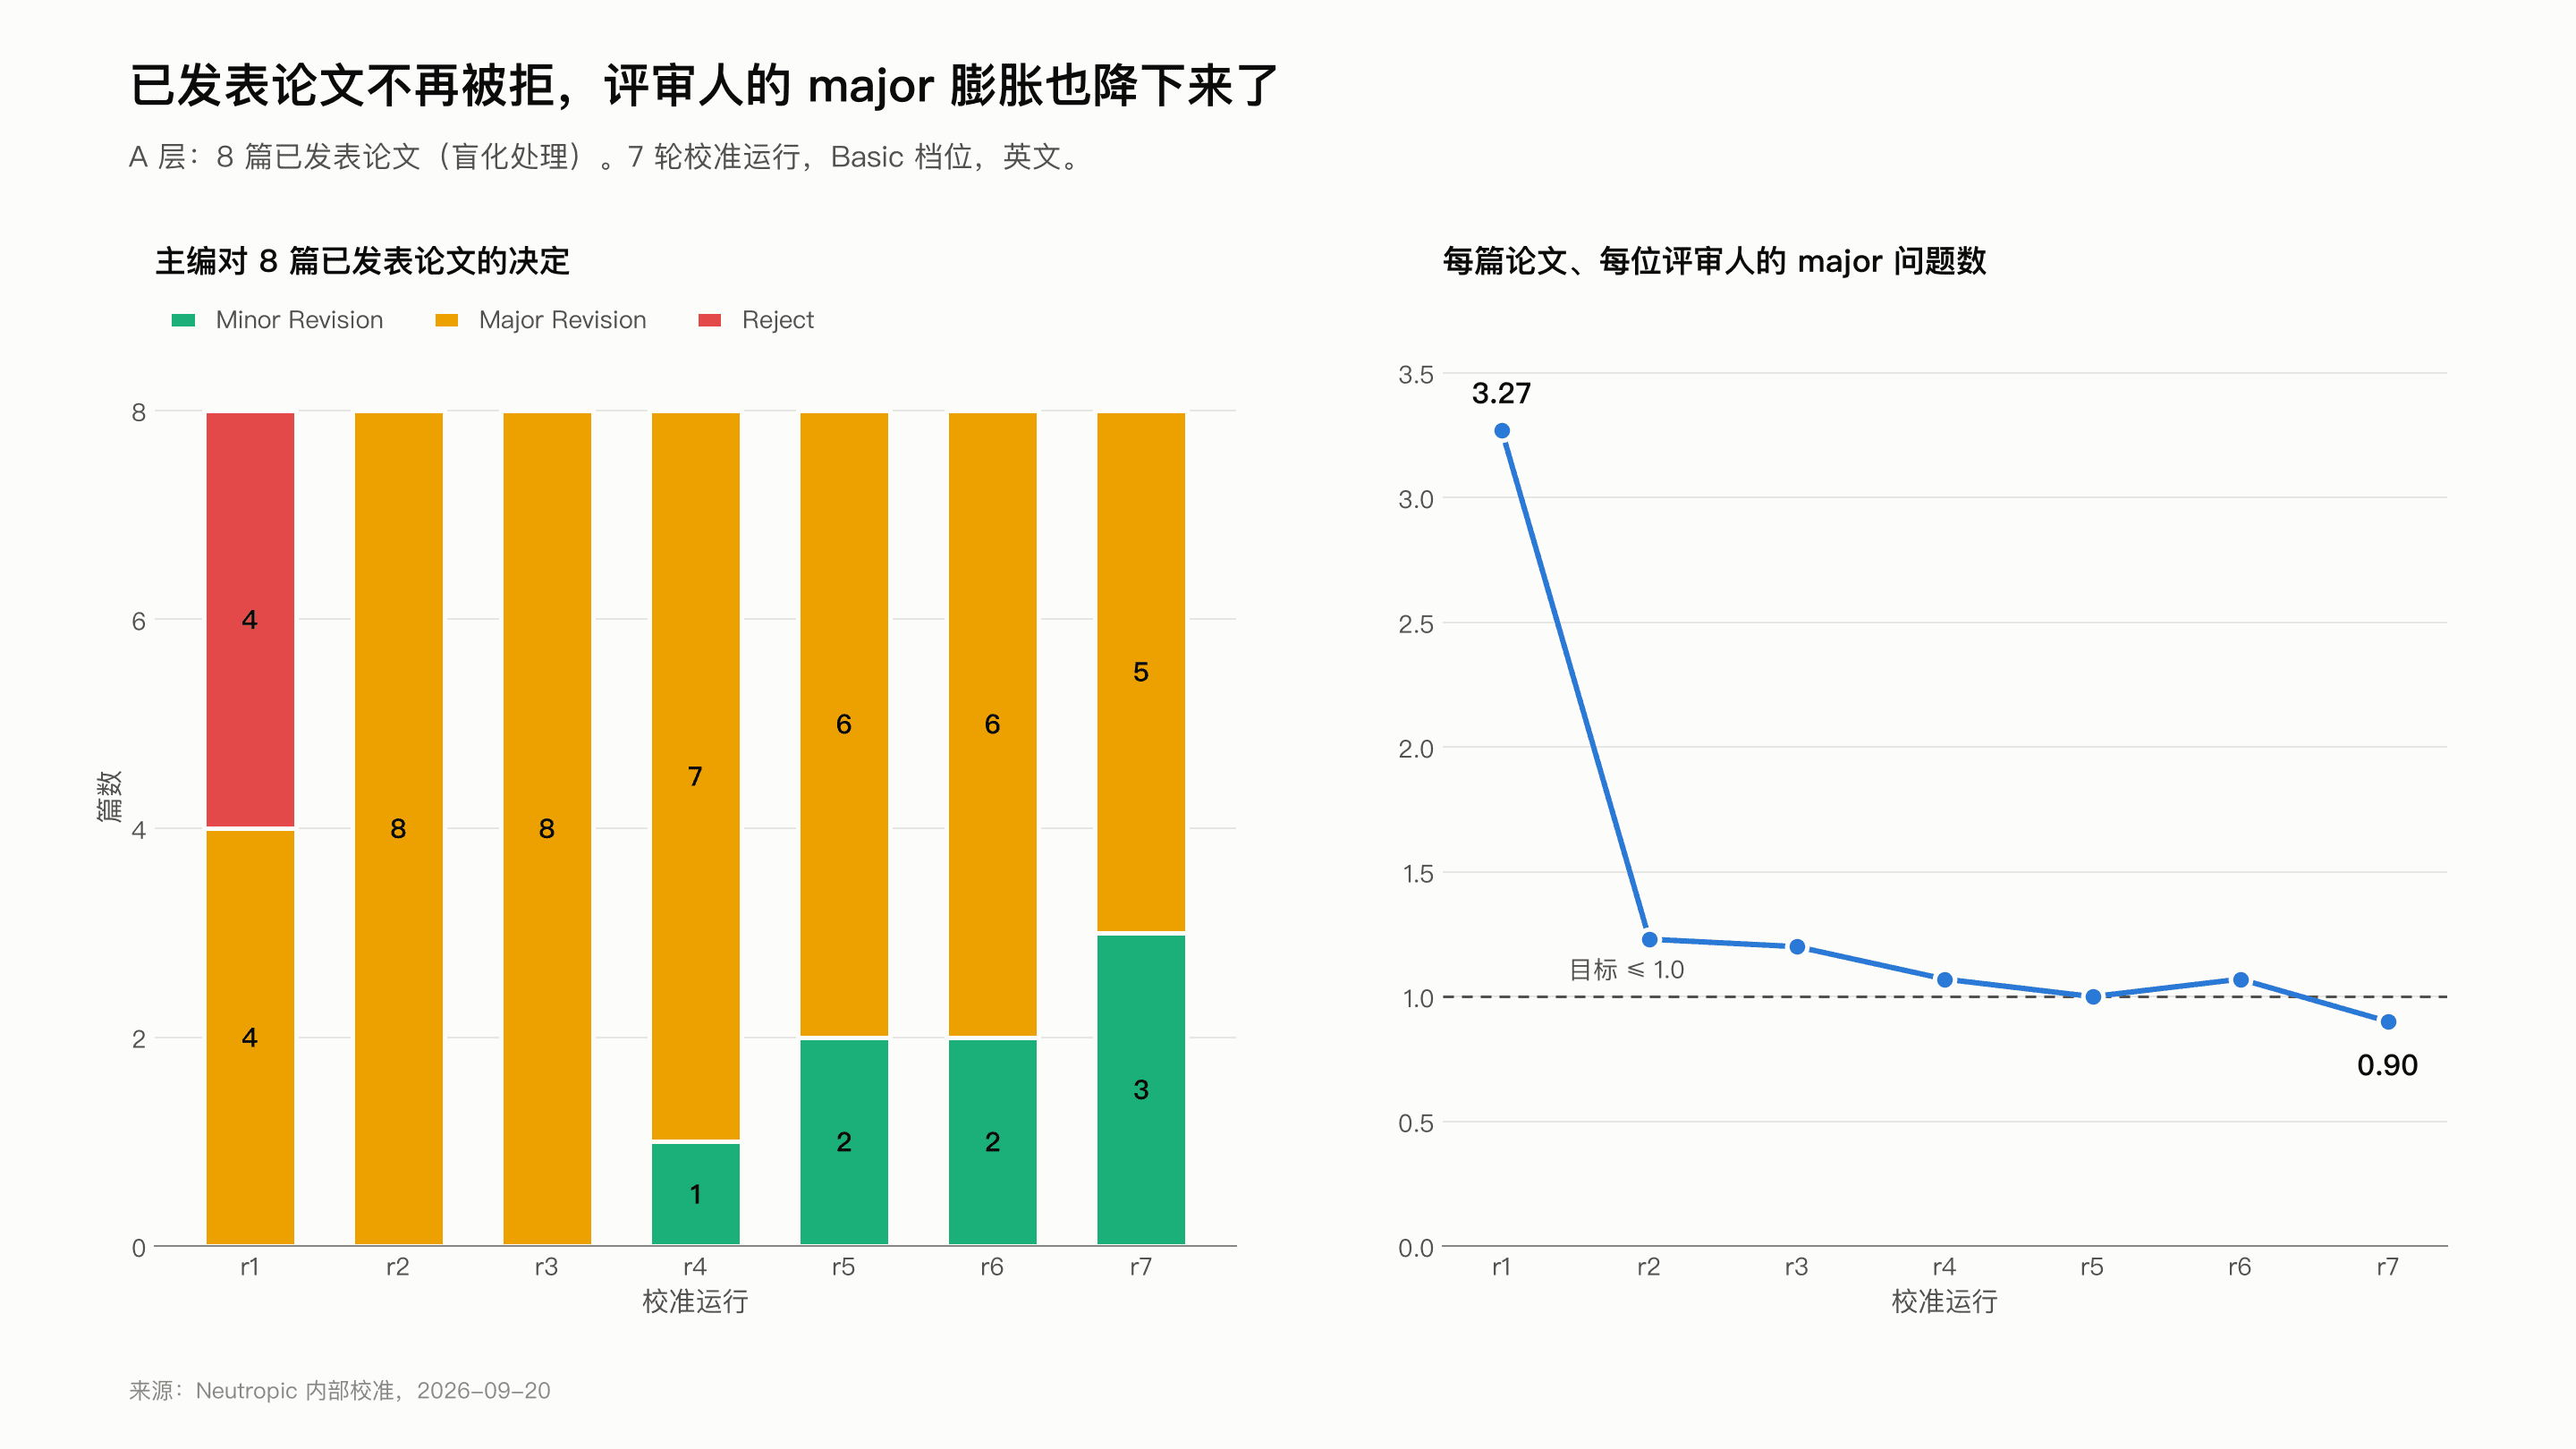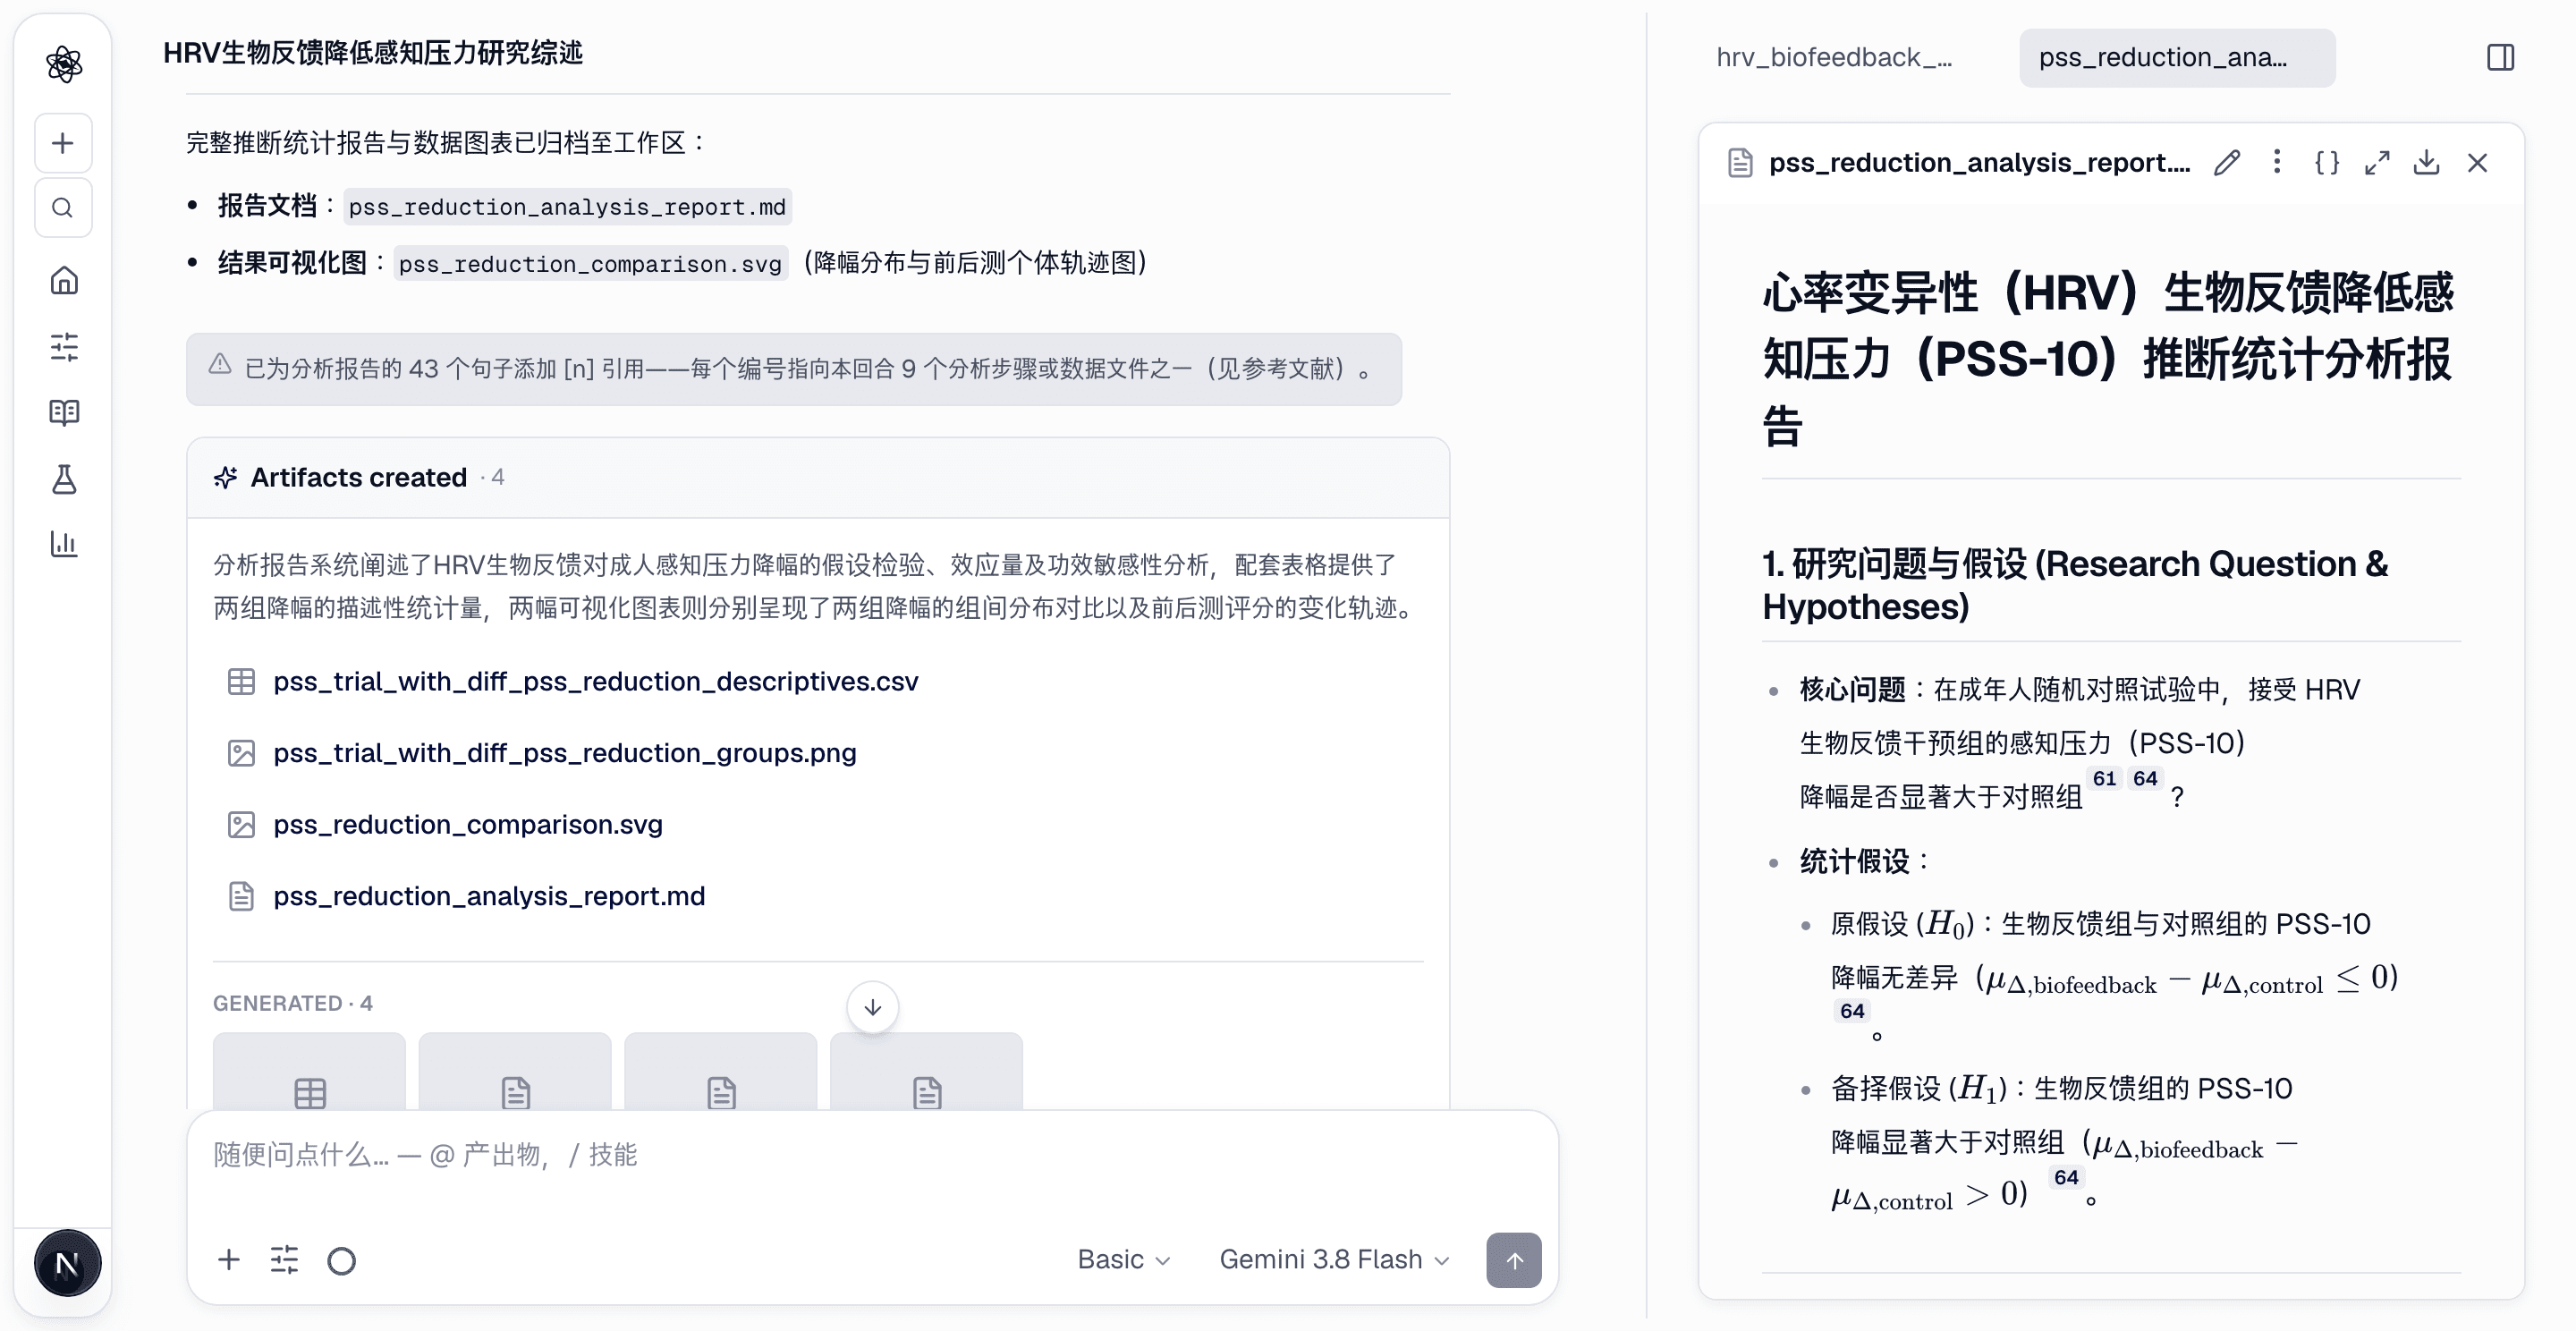
一个既生成分析又给自己打分的单一模型存在明显的利益冲突。Neutropic 把两个角色分开:生成代理运行你的分析,独立的审查代理在你依赖结果之前对其进行检查。下面是它在一份真实稿件上的表现。
审查代理检查什么
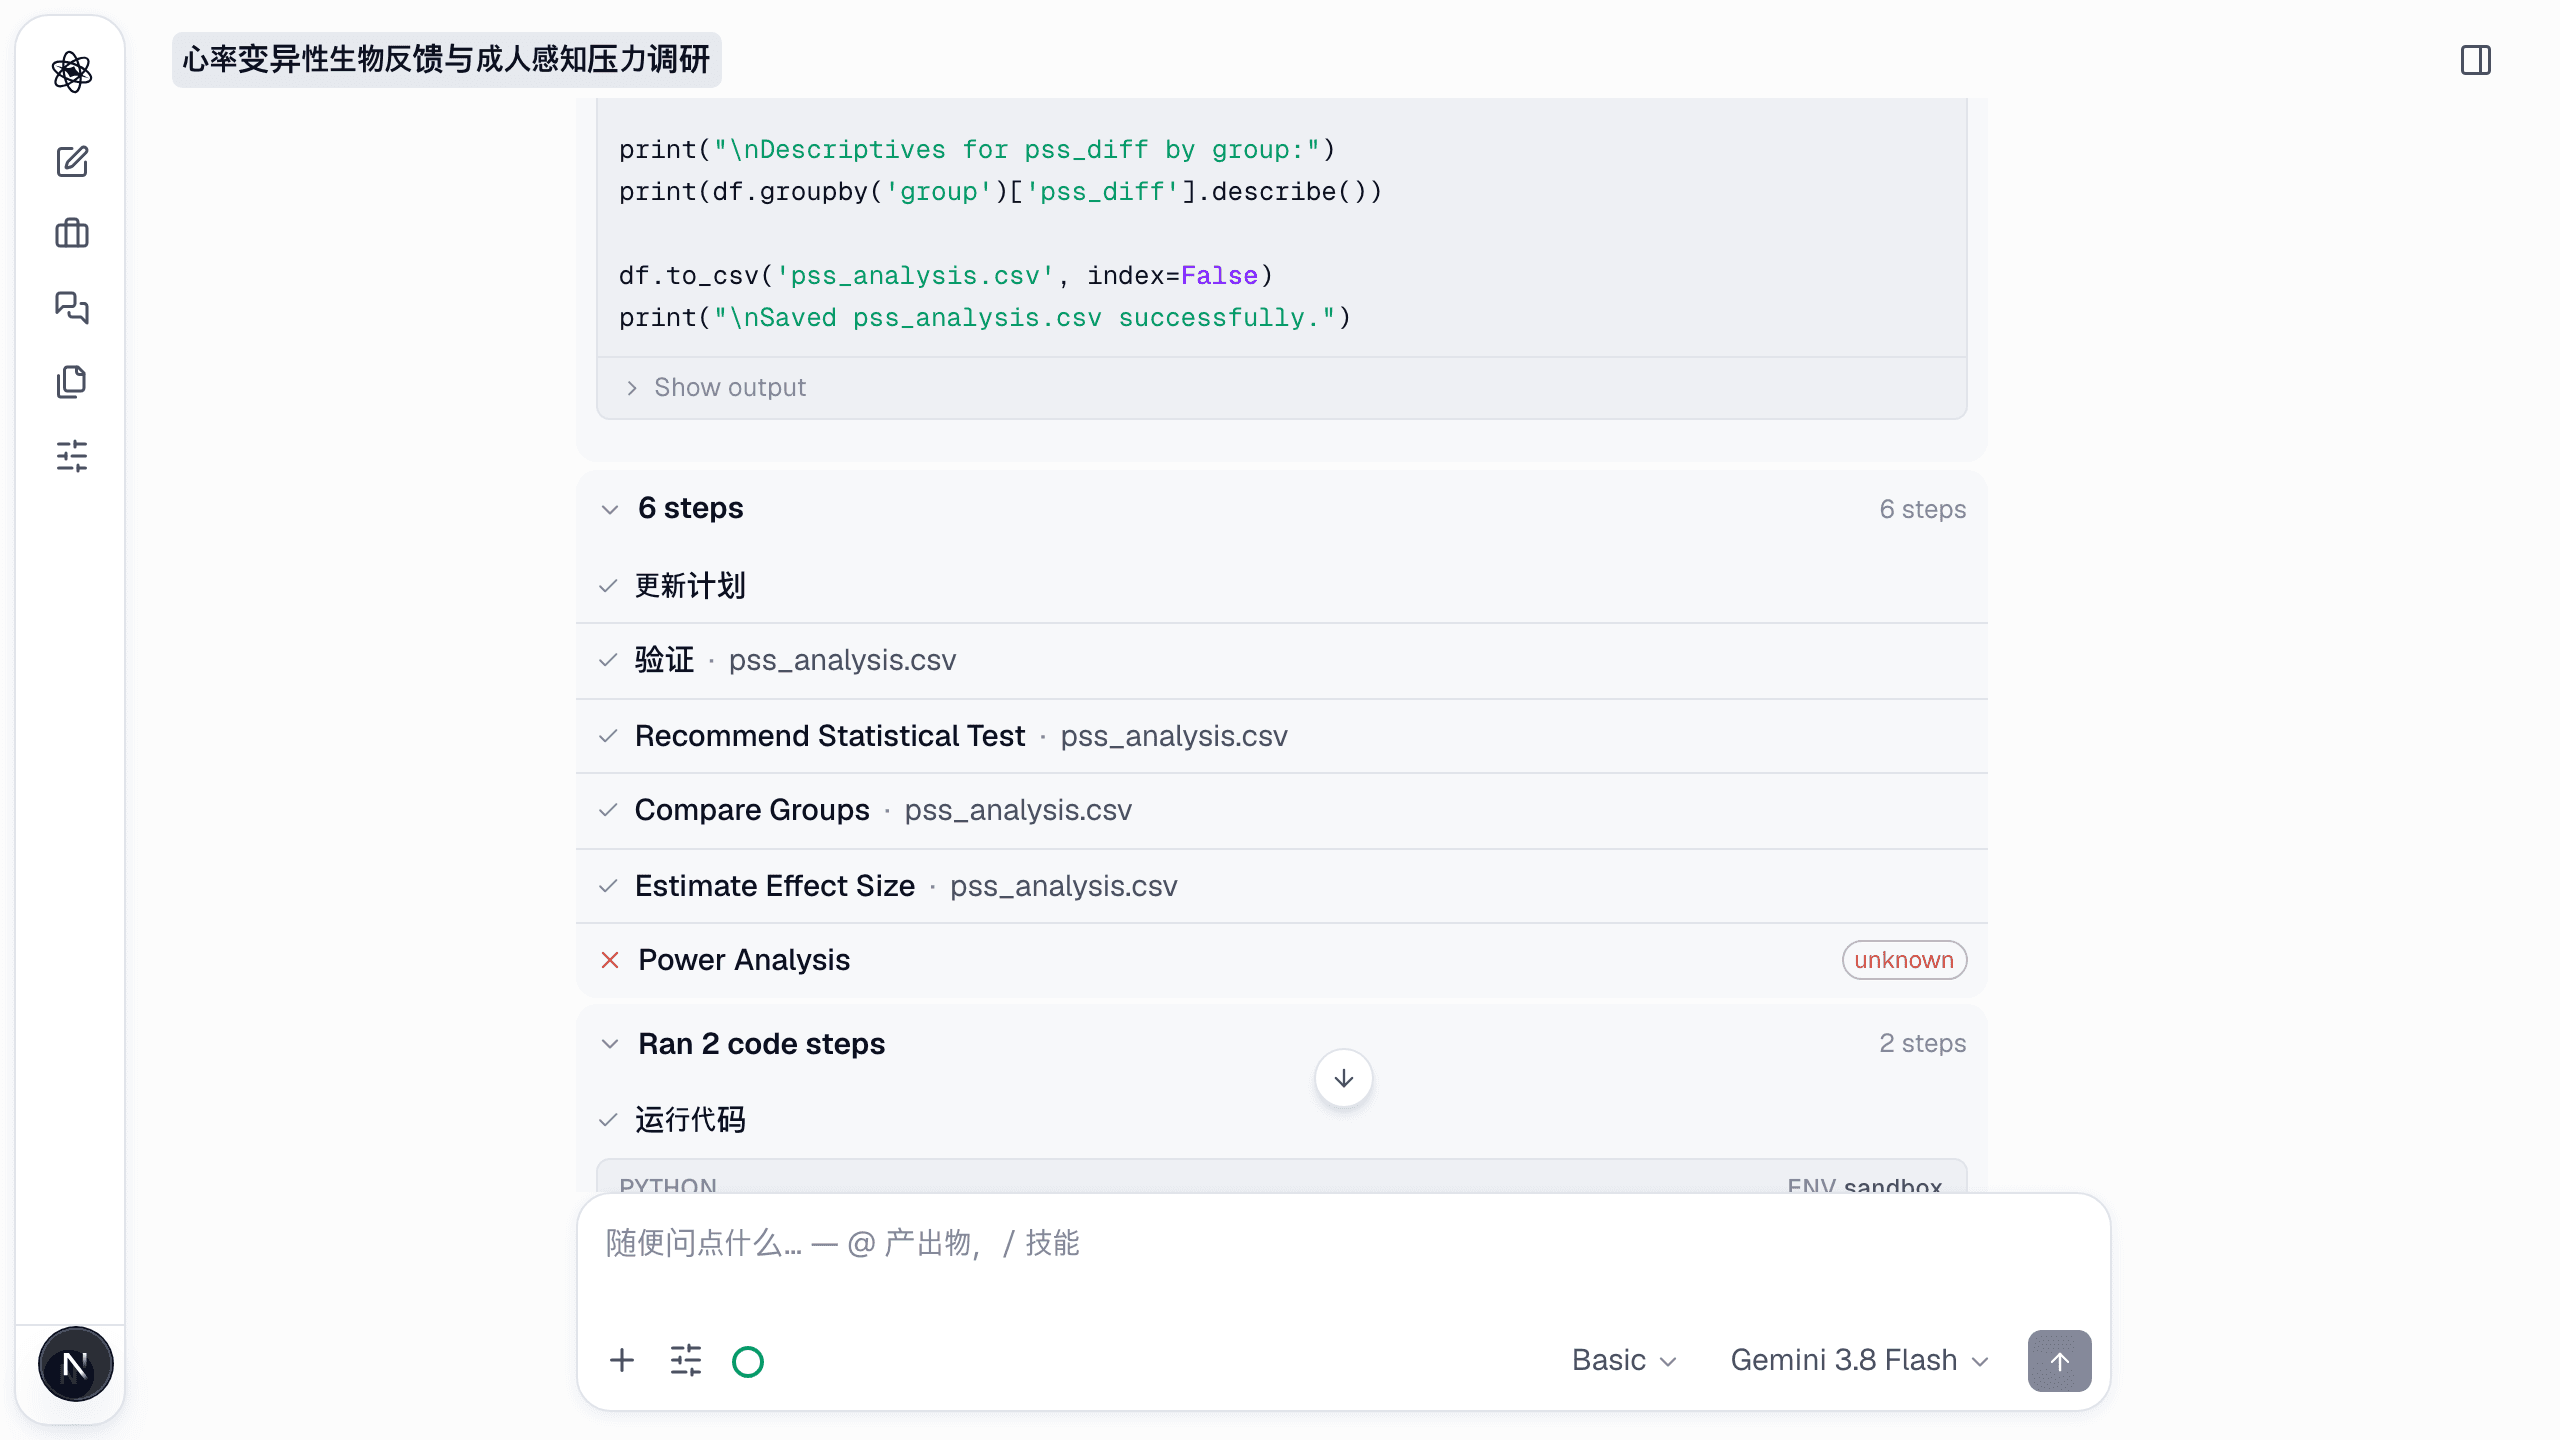
审查代理从研究设计和数据重新推导分析,然后寻找最常混进已发表论文的失败模式:
- 假设违背——正态性、方差齐性、球形性、独立性。
- 分析计划从未校正的多重比较风险。
- 相对于声称效应的统计功效与样本量。
- 分析不一致——路径与报告表格不符的中介模型、用与正文描述不同的子集计算的图表,或数据集根本算不出的正文数字。
分歧本身就是功能
当两个代理意见不一时,Neutropic 不会悄悄挑一个赢家。分歧连同双方立场和证据一并呈现给你。在我们的内部研究中,这些被标记的分歧是人类方法学家也会提出问题的最佳单一预测指标。
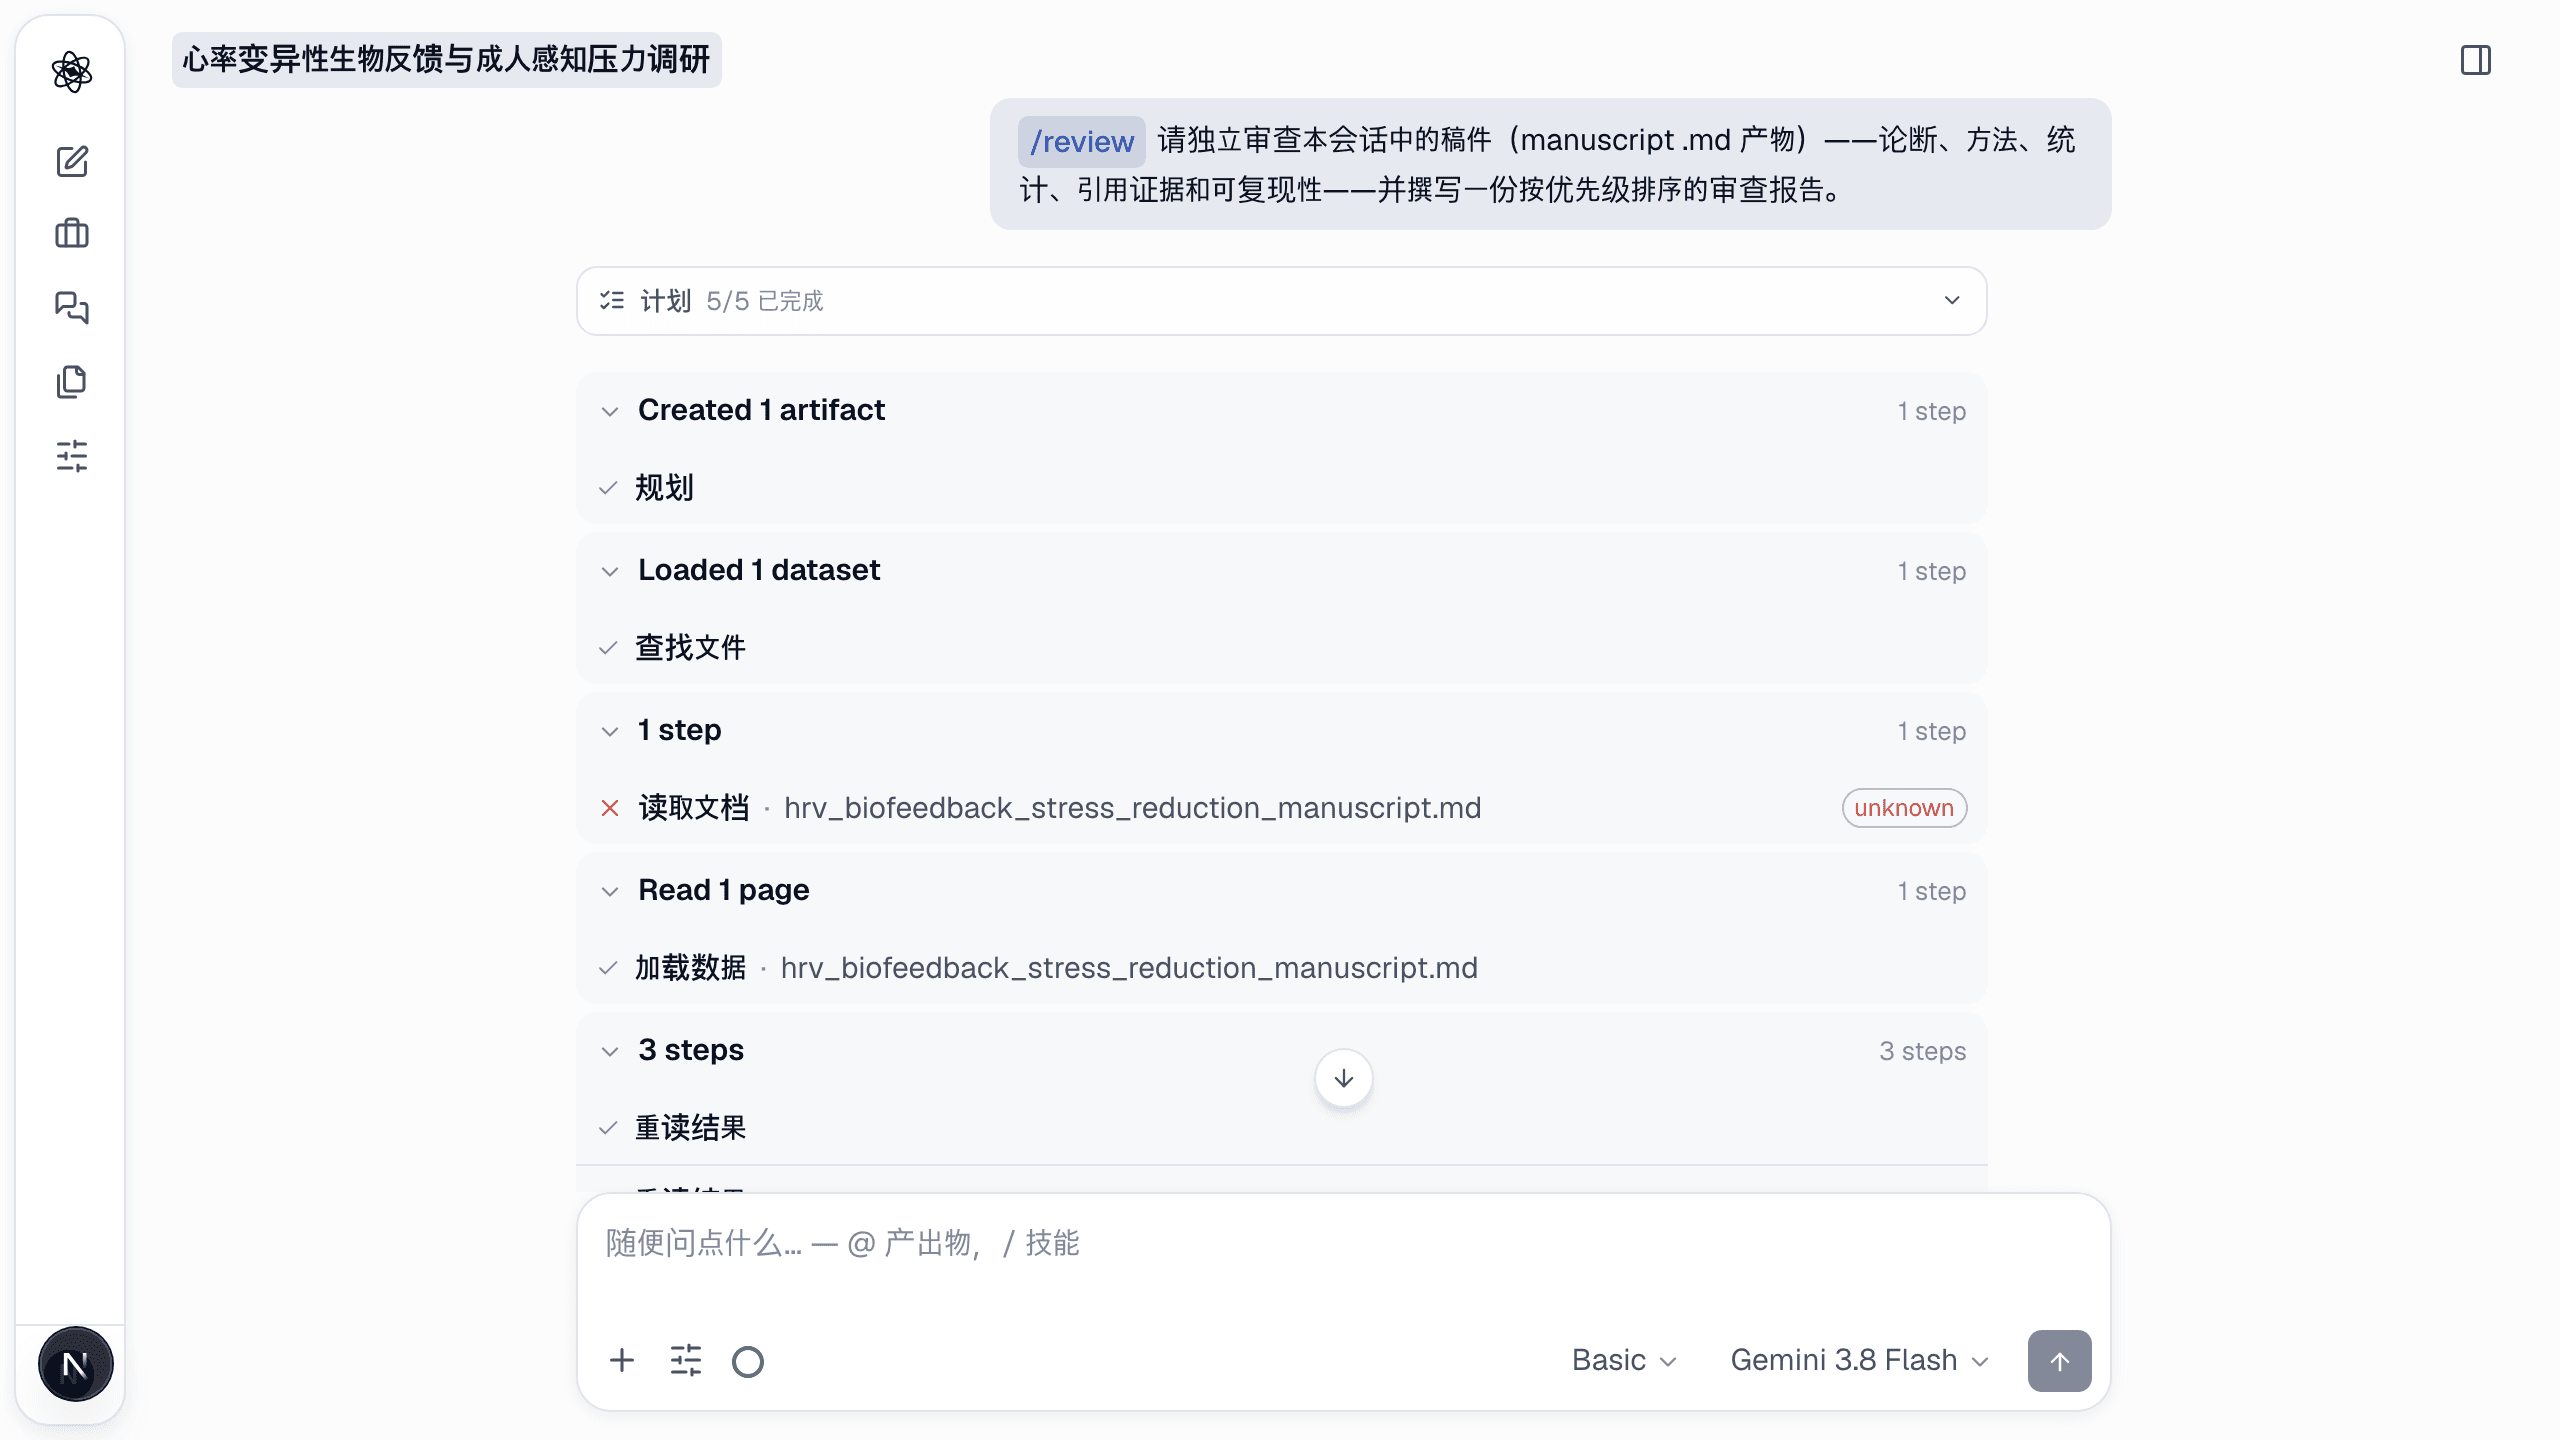
它在实际中抓到了什么
早期用户分享过这样的案例:审查代理标记了在球形性假设不成立的数据上运行的重复测量 ANOVA、用未中心化变量计算交互项的调节分析,以及功效分析使用了错误效应量族的研究。在这里展示的会话中,它发现 Methods 中引用的人口学均值与试验数据集不符——而同一段中的推断检验用数据重跑后精确到小数点后三位都吻合。
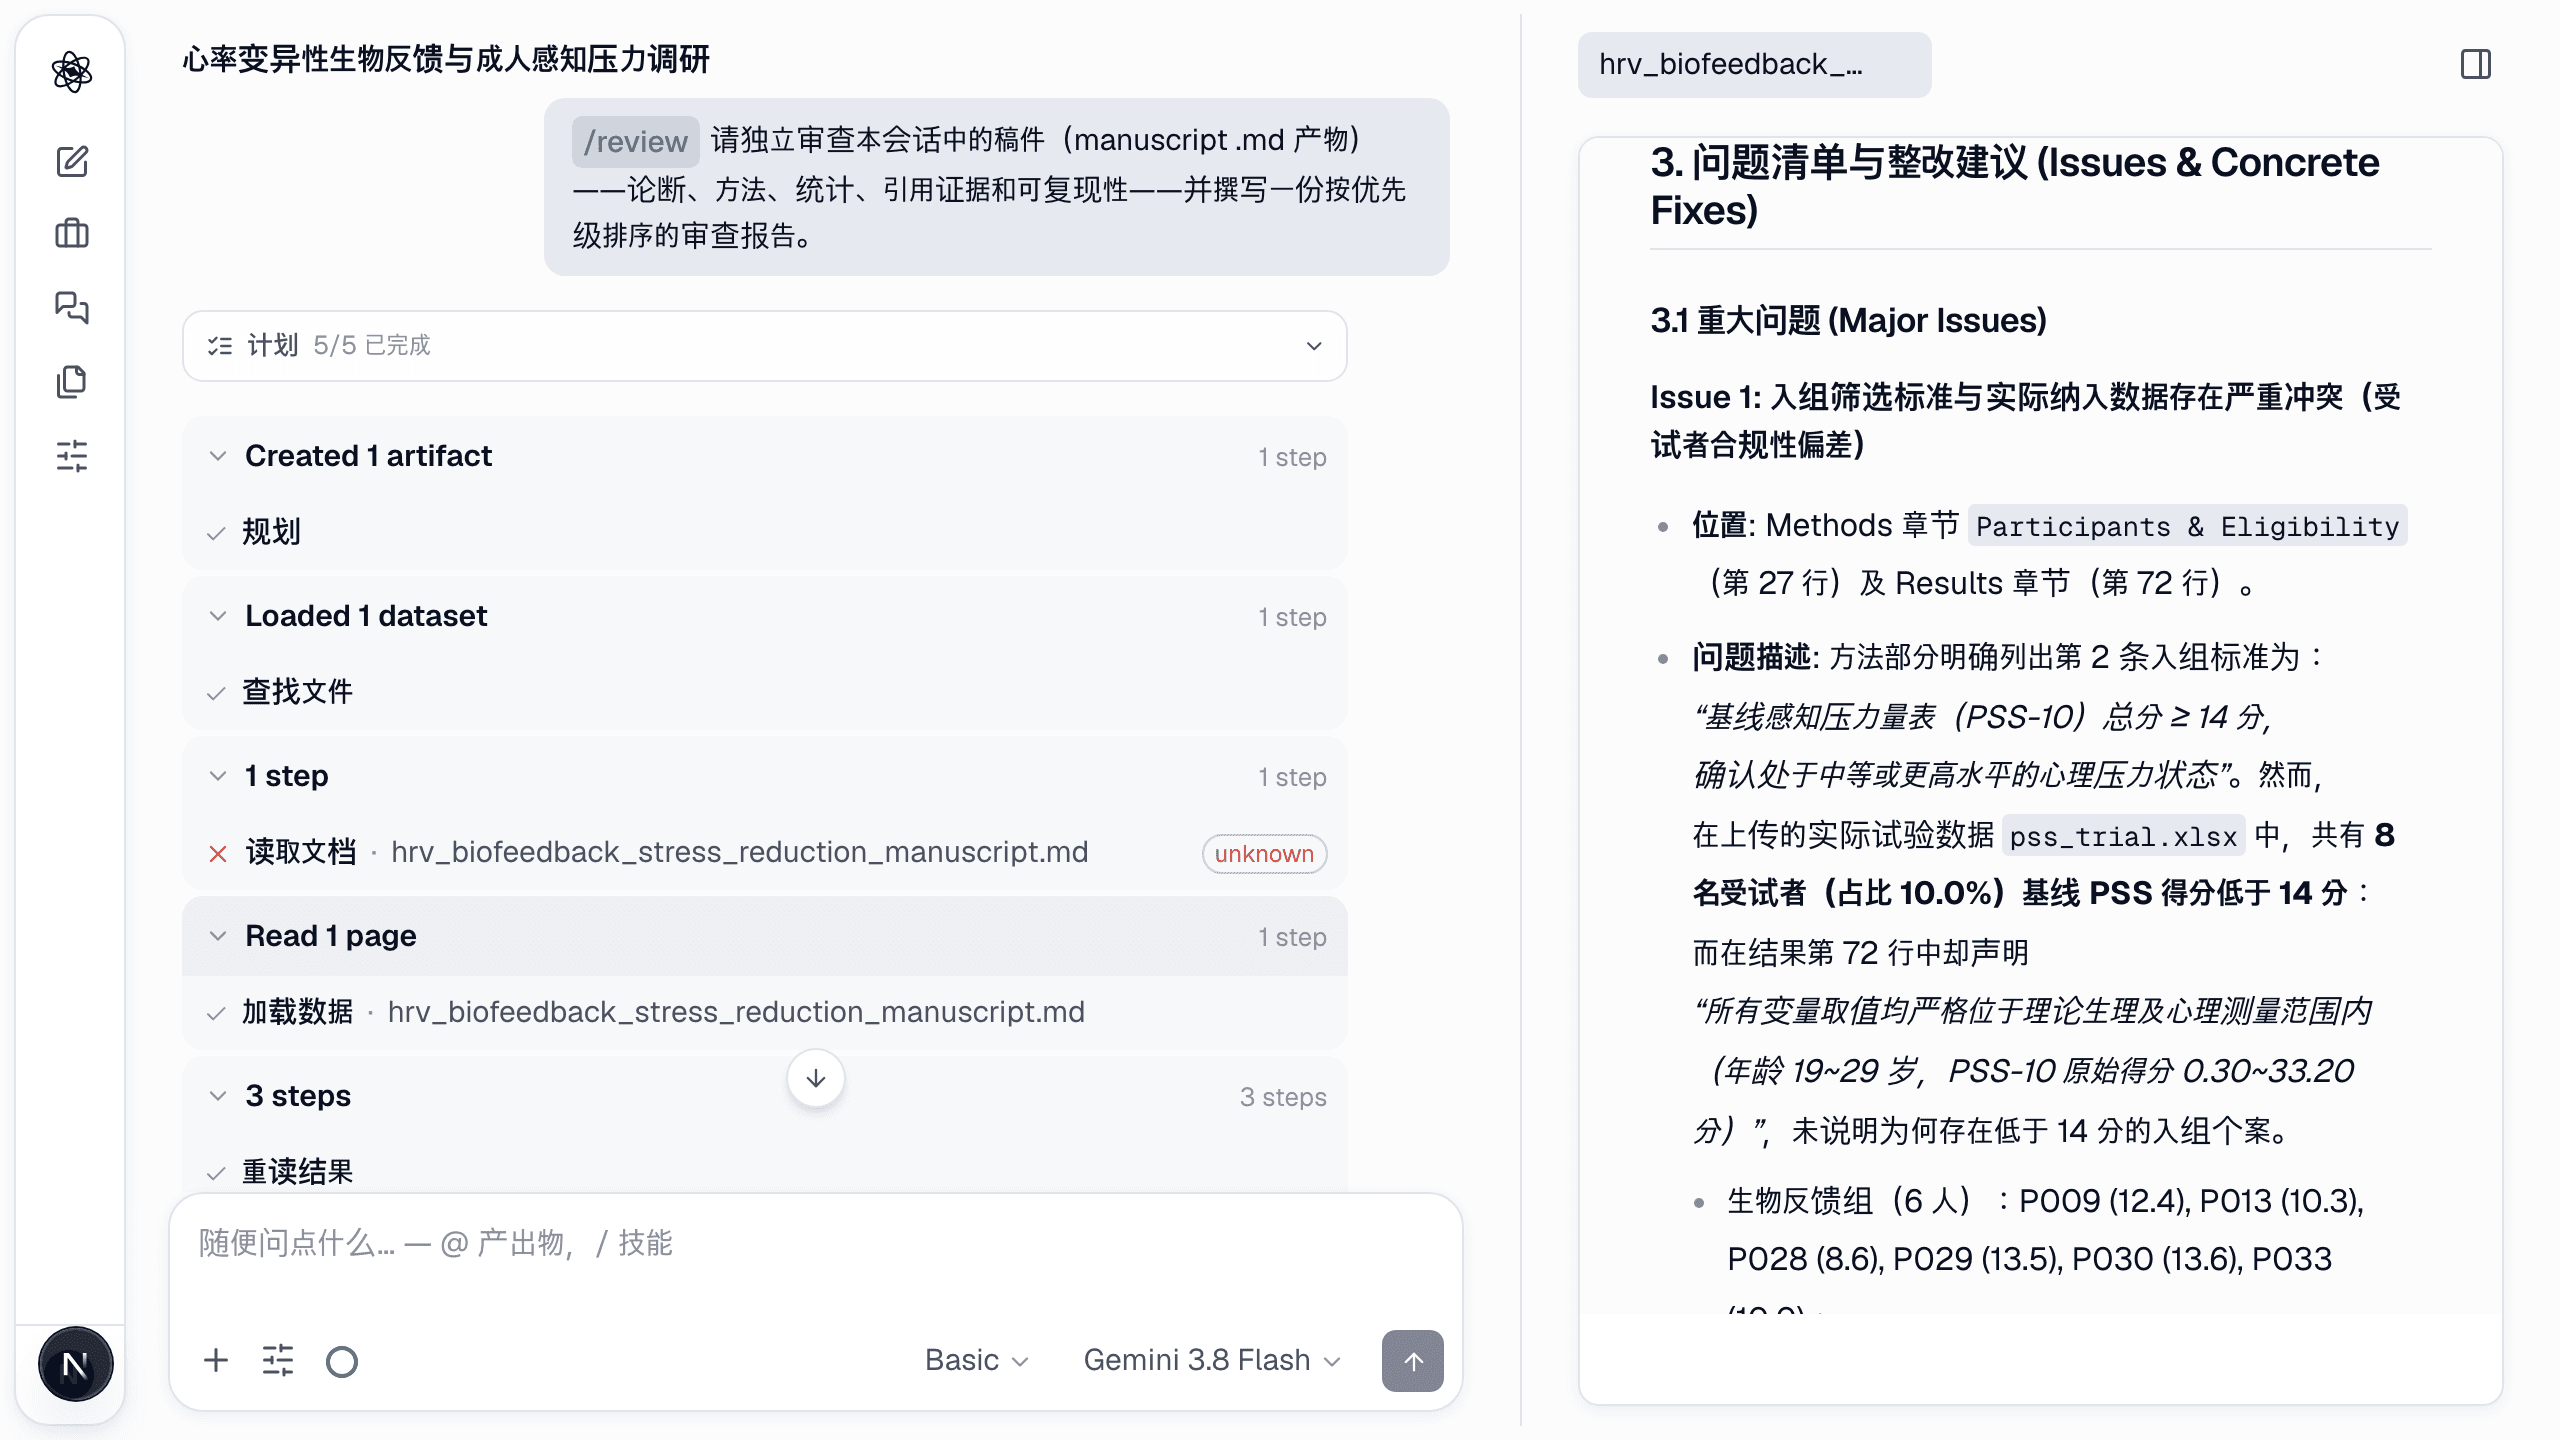
这些都不稀奇。它们是截止日期压力下的普通错误——正是第二位读者存在的意义。
严谨是默认,而非服务
你不需要预约审查或记得去要一份。在 Deep 级别,Neutropic 的每一次分析在结果被呈现为发现之前都会经过审查——就像版本控制让"备份代码"不再是一个需要决定的事。当你想要对整篇论文的审稿人式阅读时,/review 只需一条消息。