연구 도구는 대개 한 단계씩만 맡습니다. 참고문헌 관리자가 논문을 들고 있고, 통계 패키지가 검정을 돌리고, 그림 도구가 figure 를 만들고, 워드 프로세서가 초고를 쥐고 있습니다. 그 사이의 맥락은 연구자가 직접 옮깁니다. 옮길 때마다 숫자를 다시 타이핑하다 틀리고, 인용이 어긋나고, 그림이 프로토콜과 안 맞게 됩니다.
이 글은 연구 하나를 채팅 밖으로 나가지 않고 뉴트로픽에서 끝까지 진행한 기록입니다. 문헌조사, 가설, 실험 설계, 데이터 분석, 통계, figure 와 일러스트, 원고, 독립적인 보고서 검토, 저널 기준의 논문 심사, 그리고 랩미팅 발표자료까지. 스토리보드가 아니라 실제 세션입니다. 직접 열어볼 수 있습니다. 내 라이브러리의 예시 · 연구 워크플로는 모든 계정이 둘러볼 수 있는 읽기 전용 예시 프로젝트이고, 사이트의 4개 언어로 각각 실행돼 있습니다. 연구 질문은 4주간의 심박변이도(HRV) 바이오피드백 프로그램이 대학생의 지각된 스트레스(PSS-10)를 낮추는가입니다. 아래 인용한 수치는 영어 세션 기준입니다. 다른 언어 세션은 설계와 판정이 조금씩 다르게 나왔는데, 결과를 받은 뒤 읽어 봐야 한다는 점을 상기시켜 주는 좋은 예입니다.
프롬프트 하나하나를 따라가는 안내는 대학원생을 위한 뉴트로픽에 있으니 여기서는 되풀이하지 않습니다. 이 글은 각 턴 안에서 무슨 일이 일어나는지, 그리고 더 중요하게는 한 턴에서 다음 턴으로 무엇이 넘어가는지를 봅니다.
세션 한눈에 보기
- 열한 턴, 채팅 하나, 프로젝트 하나.
- 스무 개가 넘는 산출물: 선별된 문헌 표, 리뷰 보고서, 문헌 다이어그램 셋, 검정력 곡선과 프로토콜 그림이 딸린 설계 보고서, 분석 보고서와 3패널 결과 figure, 통계 보고서, 연구 흐름도, 프레임워크 그림이 딸린 가설 제안서, 방법 일러스트, 원고, 검토 보고서, 논문 심사 보고서, 17장짜리 발표자료.
- 관리형 토큰 약 210만 개, Basic 노력 기준. 각 턴 아래에 그 턴의 사용량이 표시됩니다.
- 뒤 턴이 필요로 하는 것은 전부 앞선 산출물에서 옵니다. 모델이 대화를 기억해서가 아닙니다. 이 글이 다루는 설계 결정이 바로 이것입니다.
턴 하나의 생김새
모든 턴은 같은 구조를 갖고, 이걸 읽는 법을 익혀 두면 작업을 검증하는 자리가 바로 여기라는 걸 알게 됩니다.
- 계획. 에이전트가 짧은 계획을 쓰고 진행하면서 체크합니다(
계획 4/4 done). 건너뛴 항목이 있으면 채팅이 그렇게 말합니다. - 단계. 검색 7회 실행, 코드 5단계 실행, 페이지 2개 읽음, 검증 같은 묶음 줄이고, 펼치면 쿼리·코드·읽은 문서가 보입니다.
- 이 프로젝트의 다른 채팅에서 확정된 결정 N건을 적용했습니다. 턴 맨 위의 칩으로, 프로젝트에서 먼저 확정된 사실 몇 개가 턴 시작 전에 로드됐는지 알려 줍니다. 누르면 목록이 보입니다.
- 생성된 산출물. 그 턴이 만든 파일이고 오른쪽 패널에서 열립니다.
- 토큰. 그 턴이 쓴 관리형 토큰.
단계 목록은 장식이 아닙니다. 나중에 보고서 검토 턴이 "통계를 다시 도출했다"고 말할 때, 단계 목록에 실제로 돌린 파이썬이 있고 출력은 한 번 클릭하면 보입니다.
턴 1 — 문헌조사
/research 다음 주제를 논문 데이터베이스(OpenAlex, PubMed, Crossref, Semantic Scholar, Europe PMC)와 웹에서 조사하고 연구 타임라인, 핵심 발견, 이정표 연구, 남은 과제를 정리해 주세요: 심박변이도(HRV) 바이오피드백은 성인의 지각된 스트레스를 줄이는가? 무작위 대조 시험에 집중하고 효과크기를 보고해 주세요.
첫 턴은 세션에 재료를 채우는 턴입니다. 에이전트는 논문 데이터베이스와 웹에서 일곱 번 검색하고, 상위 결과의 페이지를 읽고, 이미 가져온 결과를 다시 읽어 근거를 추출한 뒤에야 글을 썼습니다. 단계 목록에는 쿼리마다 결과 수가 붙어 있어서 검색 전략을 믿는 게 아니라 볼 수 있습니다.
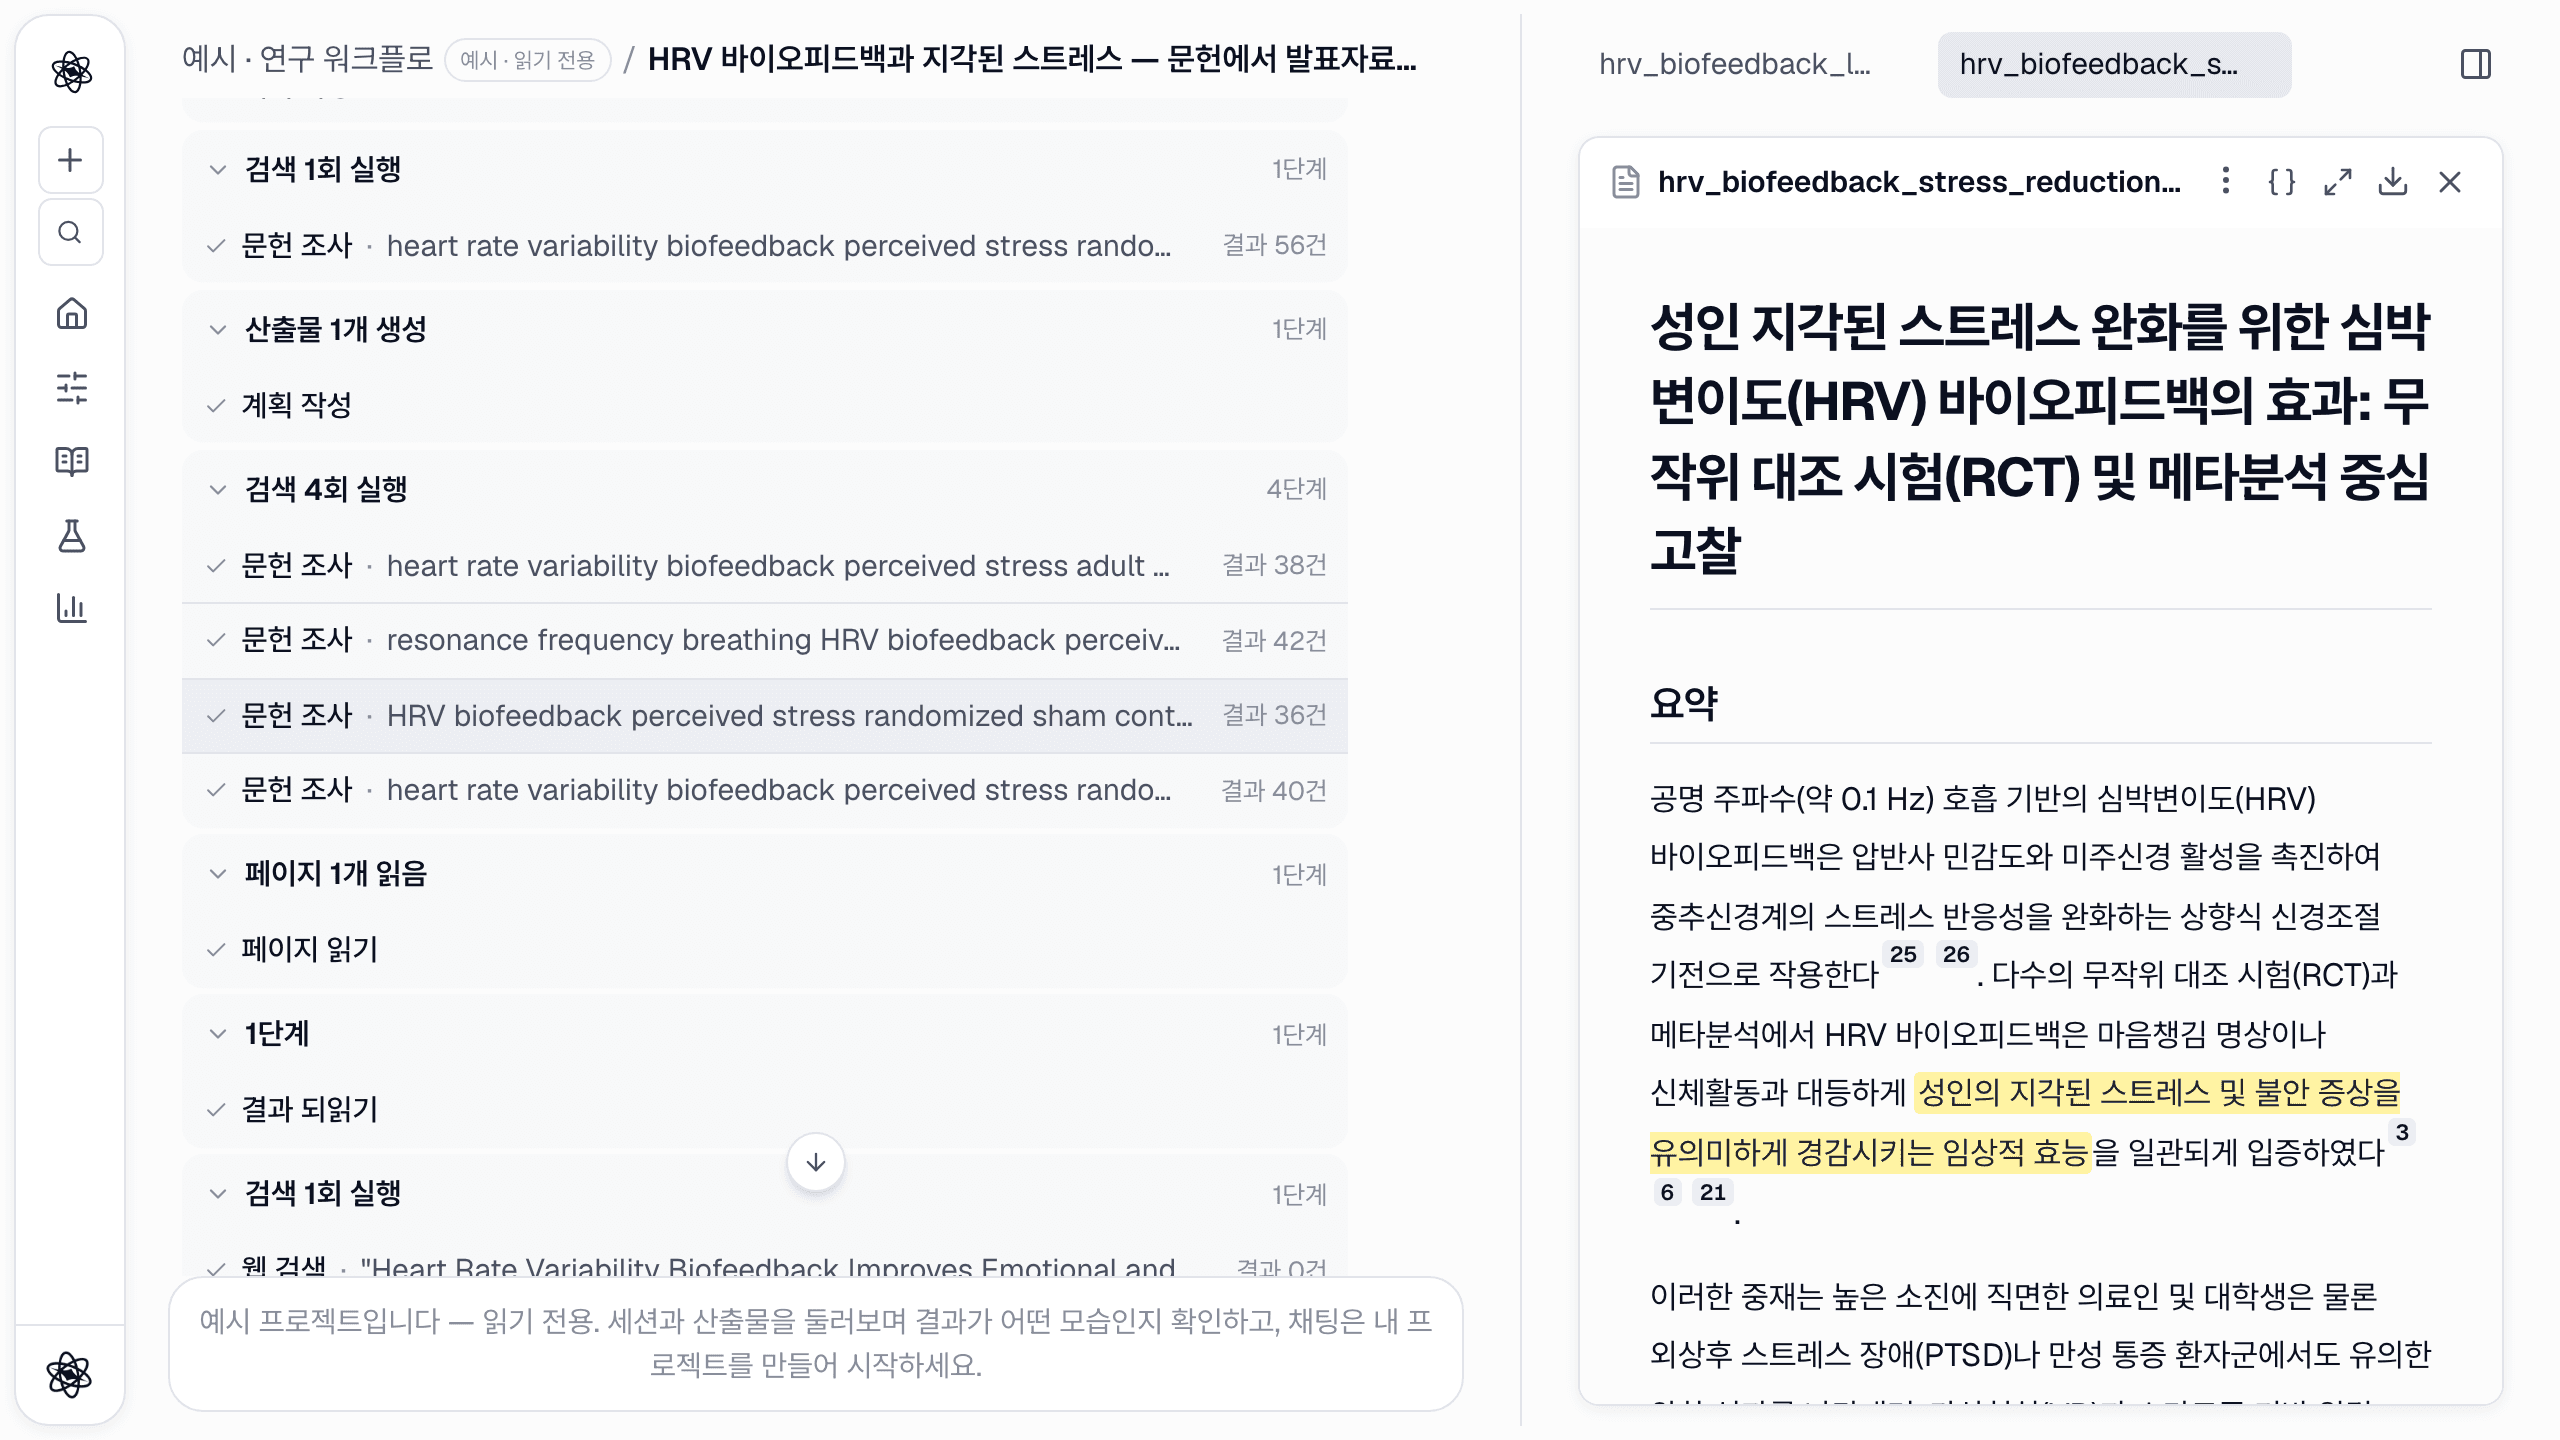
결과물은 실제로 가져온 출처에 번호 인용이 달린 리뷰 보고서, 찾은 논문의 선별 표(관련성 점수 포함), 연구 타임라인, 인용 그래프, 마인드맵입니다. 기준점으로 삼은 메타분석(Goessl 외, 2017 등)과 바이오피드백을 운동·마음챙김과 비교한 다중군 시험(van der Zwan 외, 2015; de Bruin 외, 2016)이 이후 모든 것의 뼈대가 됐습니다. 출처 자체는 세션에 저장됩니다. 이게 나중에 중요해집니다. 여덟 번째 턴에서 원고를 쓸 때 참고문헌 목록은 이 저장소에서 다시 만들어져서, 본문의 모든 [n]이 실제로 가져온 논문을 가리킵니다.
자세한 안내: 문헌조사.
턴 2 — 실험 설계
/experiment-design 4주 HRV 바이오피드백 프로그램이 능동 대조군에 비해 대학생의 지각된 스트레스(PSS-10)를 낮추는지 검증하는 2군 무작위 실험을 설계해 주세요. 관련 연구들의 방법을 근거로 삼고, 참가자·측정·프로토콜 흐름·검정력 분석을 담은 설계 보고서를 만들어 주세요.
이 턴은 이 프로젝트의 다른 채팅에서 확정된 결정 3건을 적용했습니다 로 시작했습니다. 결과 척도, 모집단, 비교 조건은 첫 턴에서 이미 고정됐고 설계가 그것을 물려받았습니다. 그 다음 세 번 더 검색하고, 비슷한 연구가 어떻게 수행됐는지 보려고 van der Zwan 시험의 방법을 이름으로 찾아본 뒤 그 위에 설계를 세웠습니다.
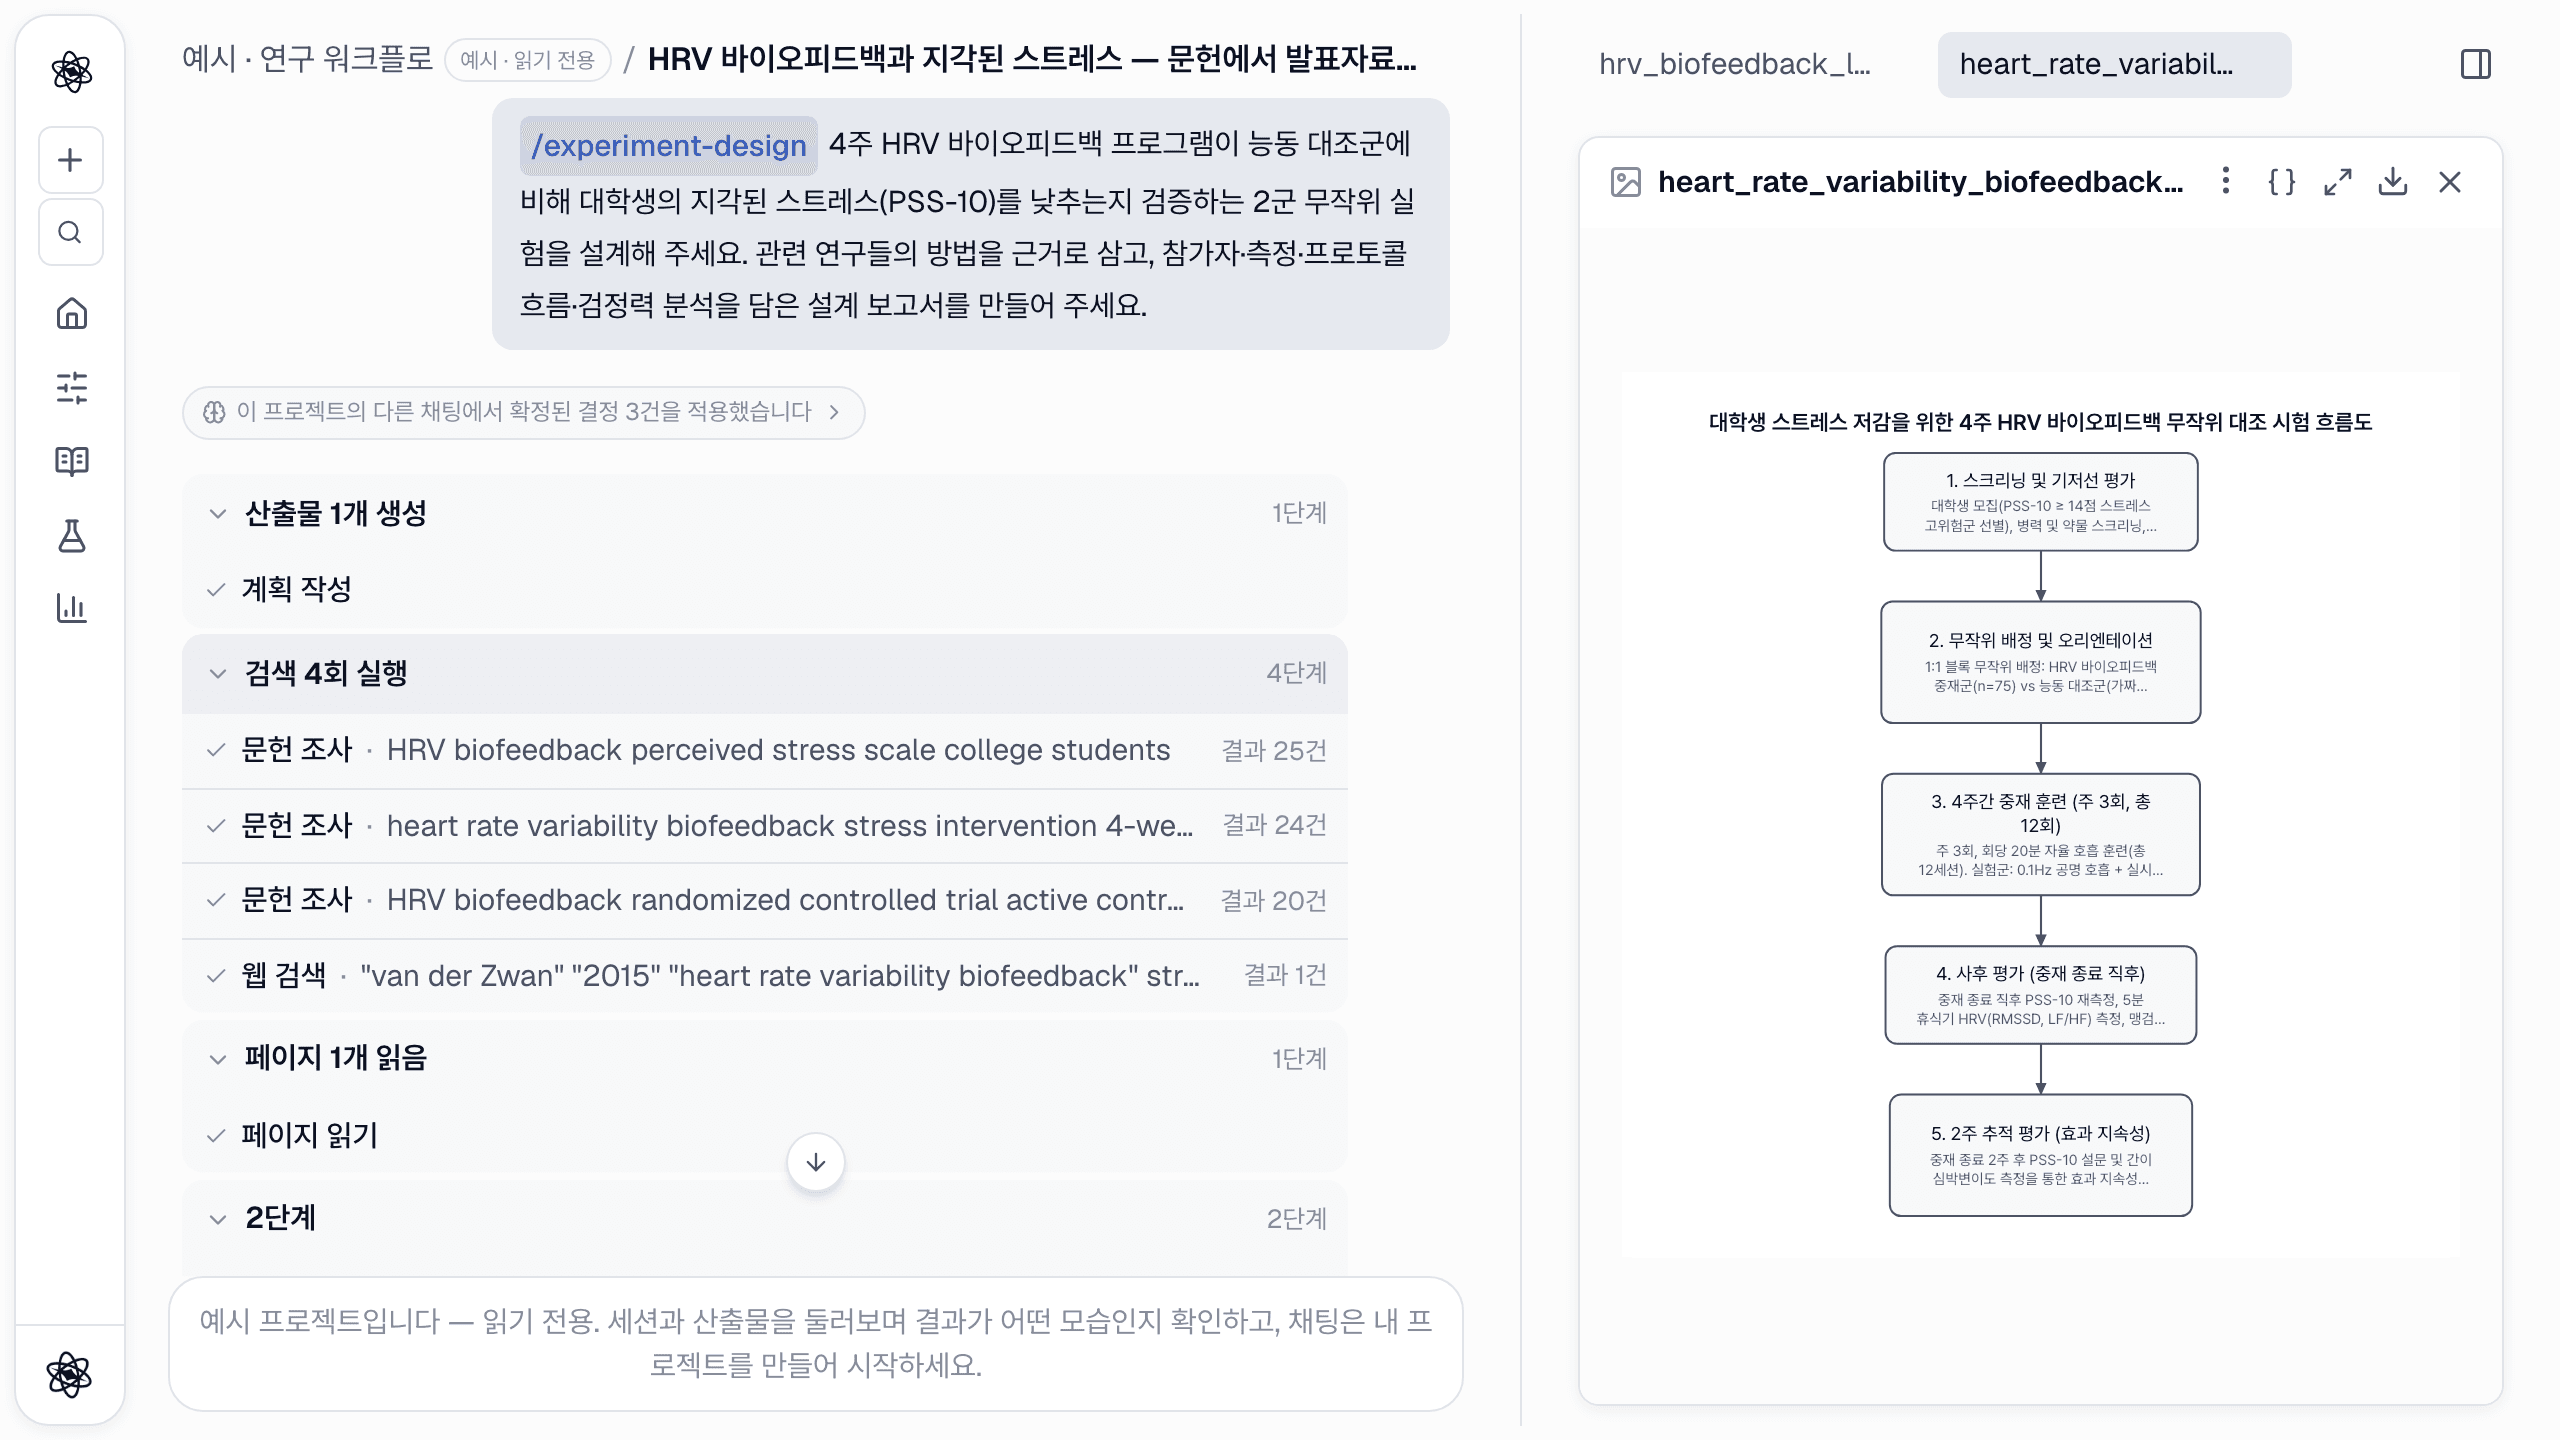
설계 보고서는 세션에서 가장 많이 재사용되는 문서입니다. 층화 블록 무작위 배정의 2 × 2 혼합 설계, 하루 몇 분까지 명시된 두 조건, 측정 도구, 선정 기준, 군당 64명·탈락 15% 감안 152명 모집이라는 검정력 분석, 그리고 선택마다 출처가 붙은 근거. 검정력 곡선, 프로토콜 흐름 그림, 측정 데이터가 아니라고 표시된 예상 결과 차트, 참고 연구들의 설계 비교표가 함께 나왔습니다. 뒤 턴들은 이 파일을 이름으로 읽습니다. 원고의 방법 절, 연구 흐름도, 발표자료가 모두 여기서 가져갑니다.
자세한 안내: 실험 설계.
턴 3과 4 — 데이터 분석, 그다음 통계
데이터 파일 pss_trial.xlsx(참가자 80명, 군당 40명의 데모 데이터)를 + 버튼으로 올리고 두 턴이 작업했습니다.
/analyze 업로드한 pss_trial.xlsx(두 집단, PSS-10 사전/사후)를 살펴봐 주세요. 데이터 품질과 기저선 균형을 확인하고 변화 점수를 계산해, 그림이 포함된 재현 가능한 분석 보고서를 만들어 주세요.
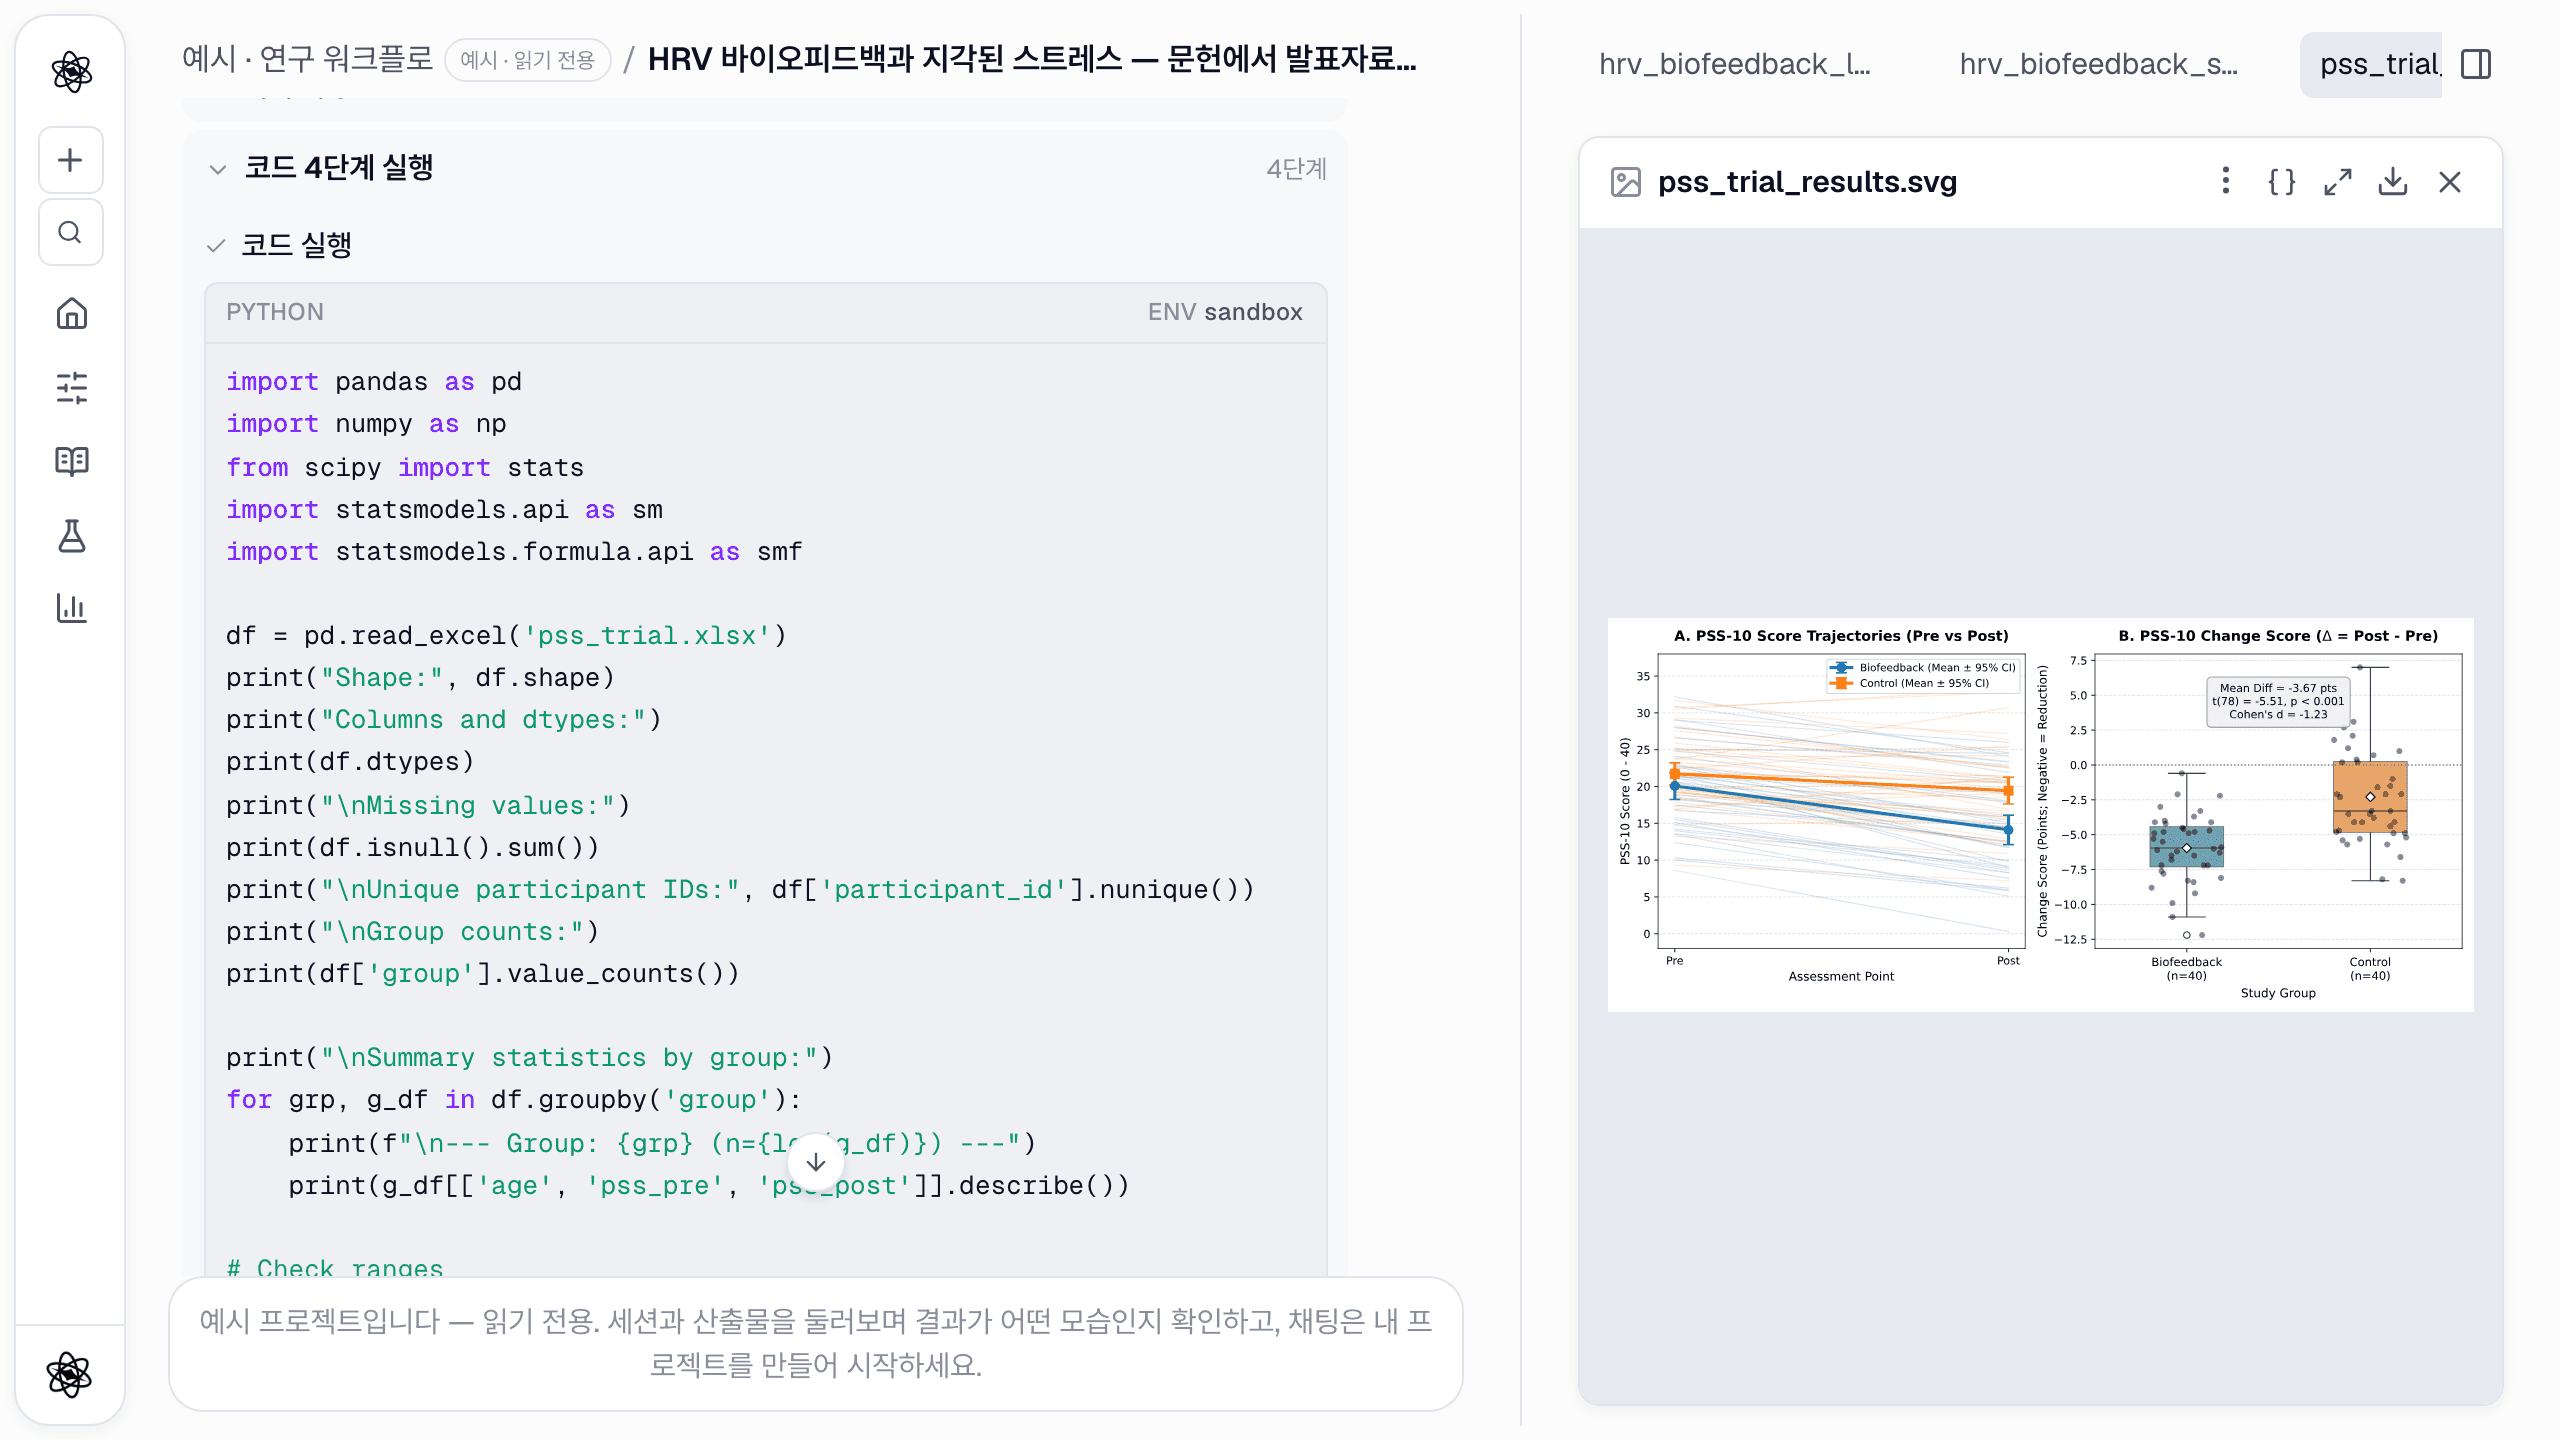
분석 턴은 샌드박스에서 코드 다섯 단계를 돌렸습니다. 품질 점검(결측 없음, 중복 ID 없음, 점수 범위 안), 나이와 기저 PSS-10 의 기저선 균형 검정, 정규성·분산 검정, 대응·독립 검정을 곁들인 변화 점수, 기저선 보정 ANCOVA, 참가자를 무선 절편으로 둔 혼합 모형, 그리고 마지막으로 개인별 궤적·변화 점수 분포·ANCOVA 적합을 담은 3패널 figure. 이 코드 블록 전부가 채팅 안에 있고, 패널에서 figure 의 재현성 버튼을 누르면 그걸 만든 정확한 코드·입력·환경이 보입니다.
/stats pss_trial.xlsx 로 바이오피드백 집단의 PSS-10 감소가 대조군보다 큰지 검정해 주세요. 설계를 파악하고 가정을 확인한 뒤 검정을 선택·정당화하고, 효과크기를 95% 신뢰구간·달성 검정력과 함께 보고해 주세요.
통계 턴은 종류가 다릅니다. 자유로운 코드 대신 통계 도구를 사슬처럼 이었고, 단계 목록이 의사결정 나무처럼 읽힙니다. 데이터 파일 검증, Recommend Statistical Test, Compare Groups, Estimate Effect Size, Power Analysis. 보고서는 독립표본 t-검정에 이른 결정 경로를 그대로 인용하고("모든 집단에서 정규성이 기각되지 않음 → 모수적 계열; Levene p = .057 → 등분산"), Welch 와 Mann–Whitney 를 민감도 검사로 돌리고, d = 1.23, 95% 신뢰구간 0.75~1.71 을 보고합니다. "달성 검정력" 1.000 은 작은 p 값의 결과일 뿐 독립된 사실이 아니라고 분명히 말하고, 대신 민감도 분석(이 N 으로 80% 검정력에서 검출할 수 있는 최소 효과, d = 0.63)을 보고합니다.
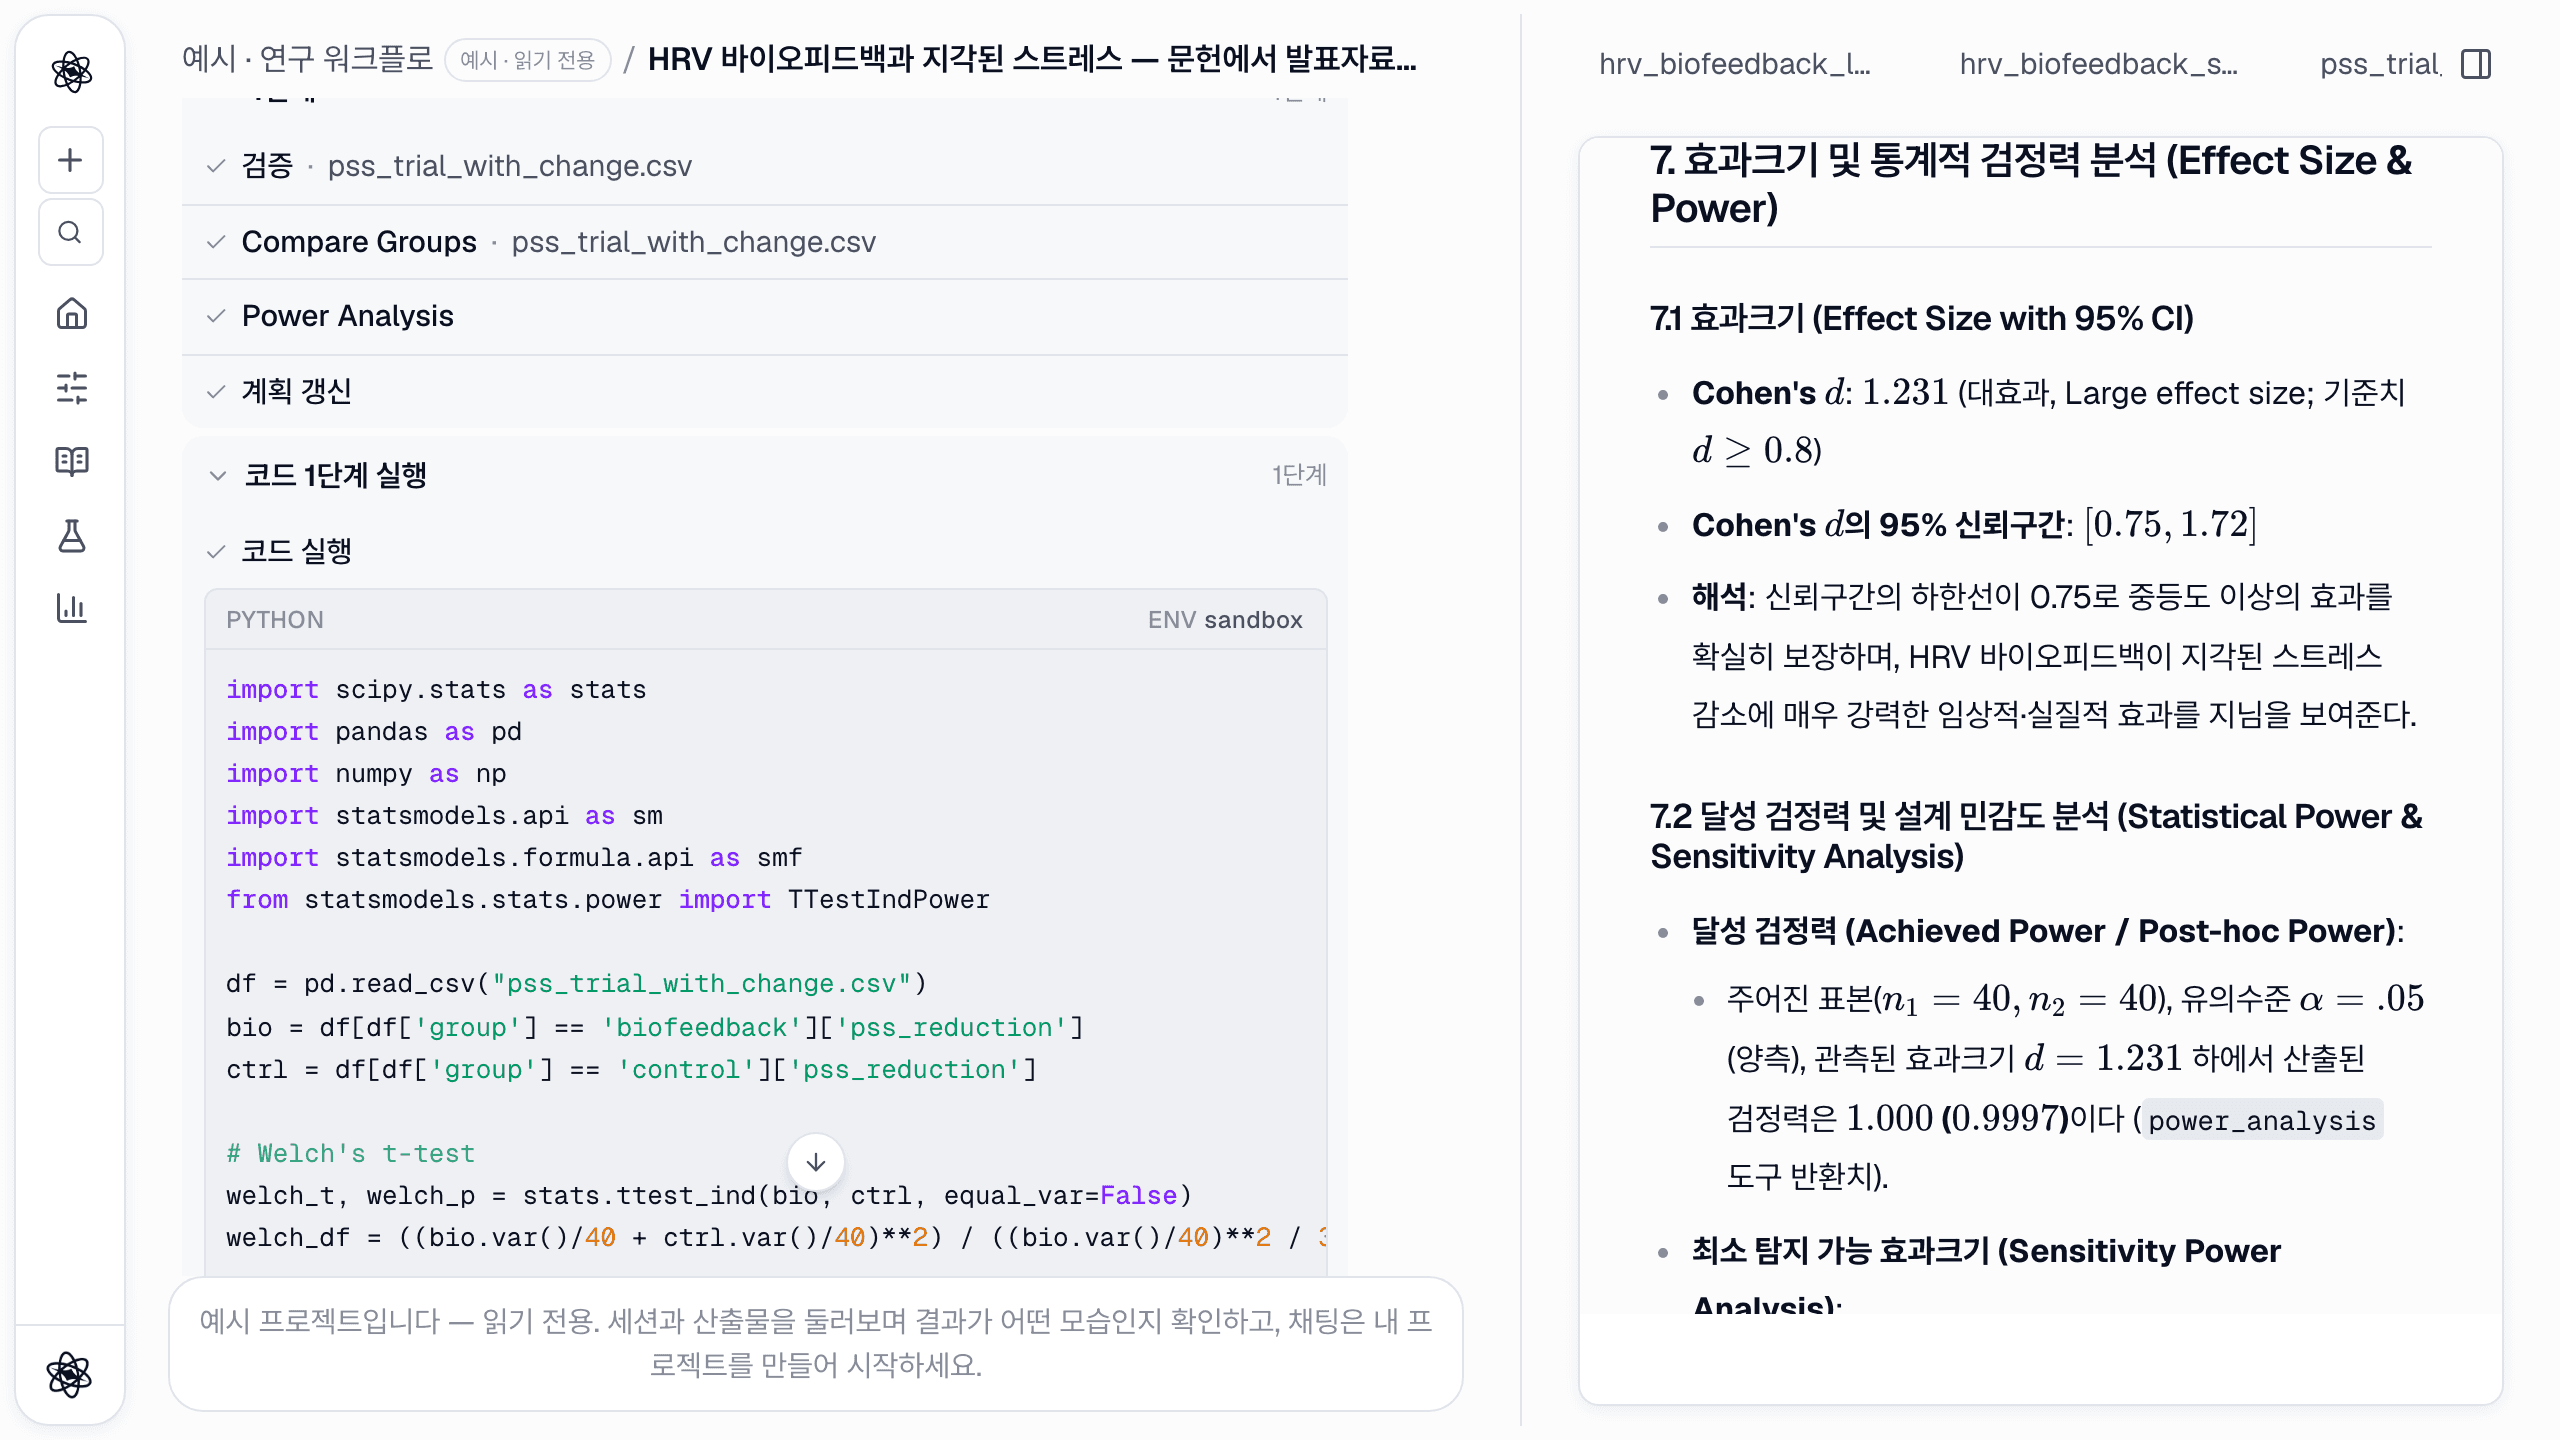
자세한 안내: 데이터 분석, 통계, 그리고 보고서가 자기 단계를 인용하는 이유: 모든 문장에 근거.
턴 5와 7 — figure 하나와 일러스트 하나
/figure 이 세션에서 설계한 실험의 연구 흐름도를 편집 가능한 벡터로 그려 주세요: 모집 → 선별 → 무작위 배정 → HRV 바이오피드백(4주) vs 능동 대조 → 사후 검사(PSS-10) → 3개월 추적. 저널 템플릿을 사용해 주세요.
/illustrate 방법 그림용 HRV 바이오피드백 장비 구성을 과학 일러스트로 그려 주세요: 가슴 스트랩 ECG 센서와 손가락 PPG 센서를 착용하고 앉아 노트북의 호흡 안내 화면에 맞춰 호흡하는 참가자. 세미플랫 스타일, 흰 배경.
둘 다 한 단계짜리 턴이고 둘 다 저렴합니다(각각 약 3만 토큰). 연구 흐름도는 2단 저널 프리셋으로 배치된 진짜 벡터 figure 입니다. 작업공간에서 편집으로 상자를 옮기고 라벨을 고칠 수 있고, SVG·PNG·PDF·PPTX 로 내보내도 도형이 그대로 편집 가능합니다. 일러스트도 벡터라서 센서 스트랩이나 옷 색을 패널에서 바꿀 수 있습니다.
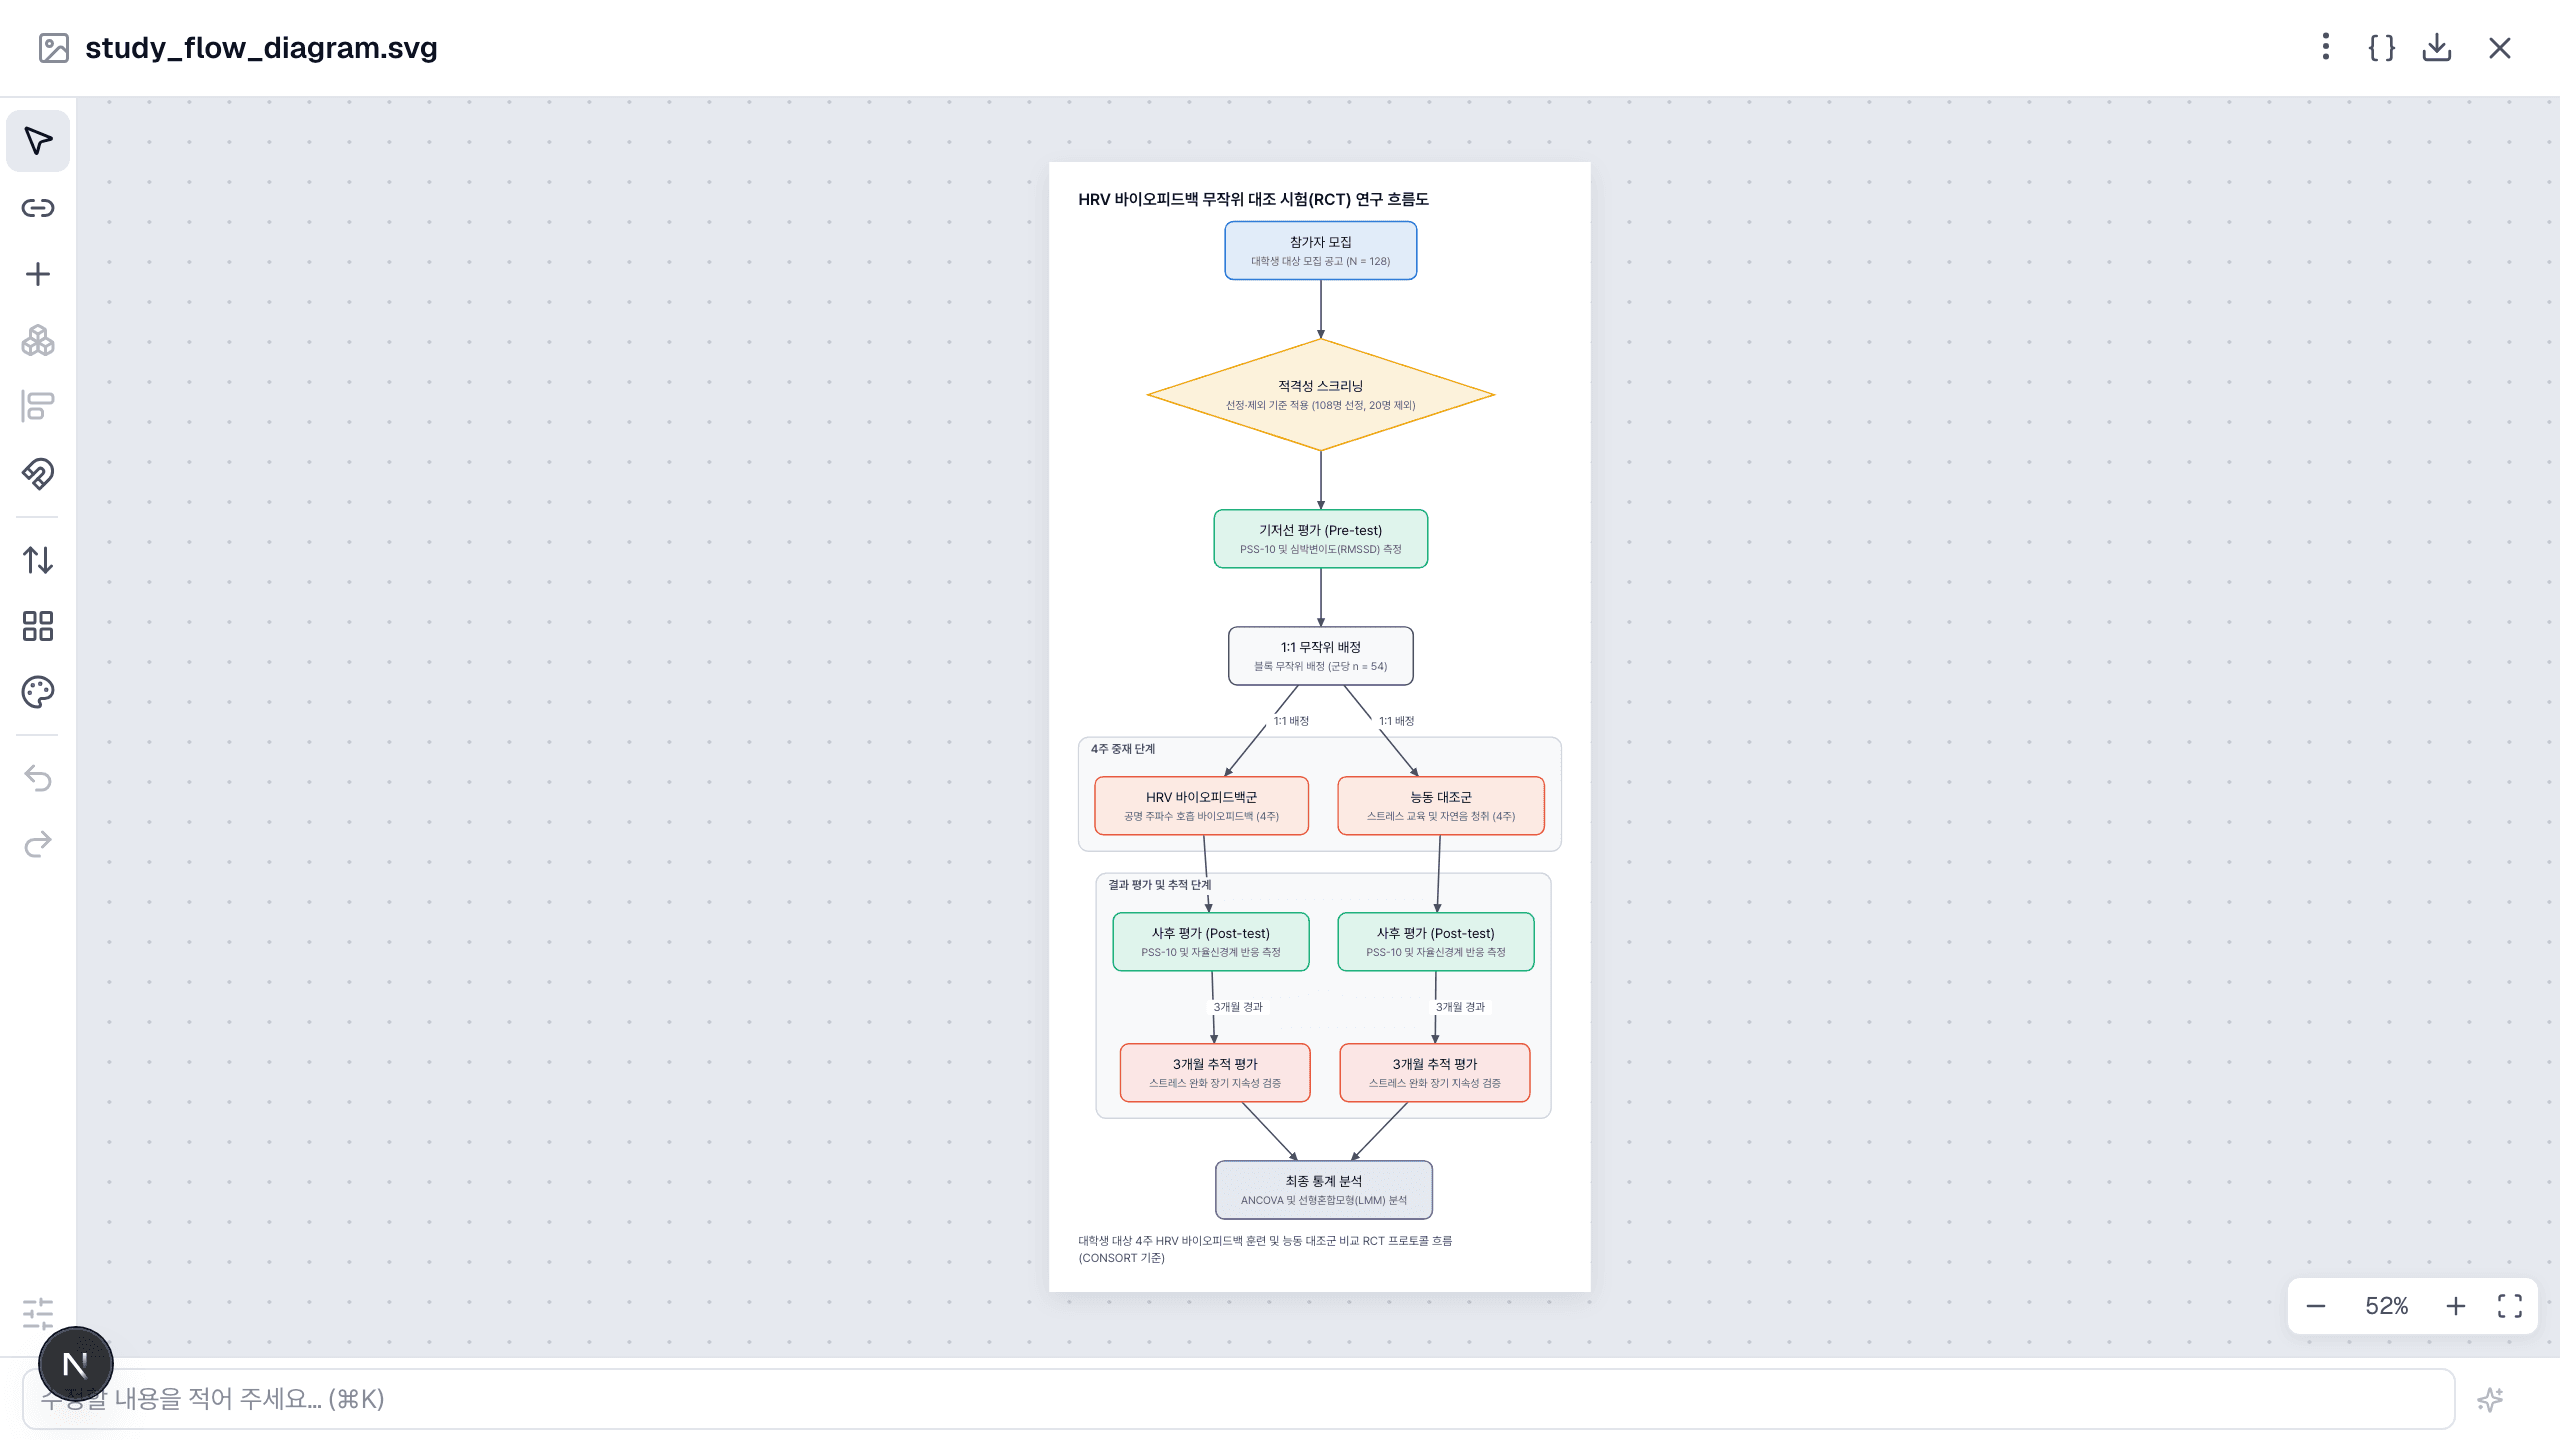
눈여겨볼 점 하나. figure 프롬프트는 3개월 추적을 요구했고 다이어그램은 충실히 그렸지만, 영어 설계 보고서에는 기저선과 사후 검사만 있습니다. 세션은 산출물을 읽을 때 서로 일관되게 유지하지만, 프로토콜에 없는 것을 당신이 요구하는 것까지 막지는 못합니다. figure 를 설계와 맞춰 읽으세요.
자세한 안내: figure.
턴 6 — 가설
/hypothesis 이 세션에서 수집한 HRV 바이오피드백과 지각된 스트레스 문헌을 바탕으로 연구 공간을 지도화하고, 공백과 상충하는 결과를 나열한 뒤, 신규성·타당성·검증 가능성으로 순위를 매긴 검증 가능한 가설을 근거와 출처와 함께 생성해 주세요.
이 세션에서 가설은 분석 뒤인 여섯 번째로 돌았습니다. 실제 연구라면 리뷰 직후에 돌리게 됩니다. 이 턴은 저장된 문헌을 다시 읽고, 기전에 관해 두 번 더 검색하고, 선행 연구 표를 만들고, 상충 여부를 확인한 뒤, 후보 가설 다섯 개 각각에 검정력 분석을 돌리고 나서 제안서와 프레임워크 그림을 썼습니다.
최상위 가설은 기억해 둘 만합니다. 다시 나타나기 때문입니다. 같은 0.1 Hz 의 개방형 느린 호흡에 비해 폐쇄형 바이오피드백이 무언가를 더하는가를 묻습니다. 이 세션의 시험은 그 질문에 답할 수 없습니다. 대조군이 호흡 안내가 아니라 심리교육이기 때문입니다. 원고, 보고서 검토, 논문 심사가 모두 이 점을 알아챕니다.
자세한 안내: 가설.
턴 8 — 원고
/write 이 세션의 문헌·설계·분석을 바탕으로 원고의 방법과 결과 절을 작성해 주세요. 모든 주장은 인용 또는 세션 결과에 결합되어야 합니다.
세션이 보답하는 턴입니다. 이 프로젝트의 다른 채팅에서 확정된 결정 11건을 적용했습니다 로 시작했습니다. 단계 목록을 보면 리뷰 보고서와 통계 보고서를 이름으로 로드하고, 한 글자 쓰기 전에 검증 여섯 단계를 거친 뒤, 작성·문서 개정·원고 검사를 여러 번 반복합니다.
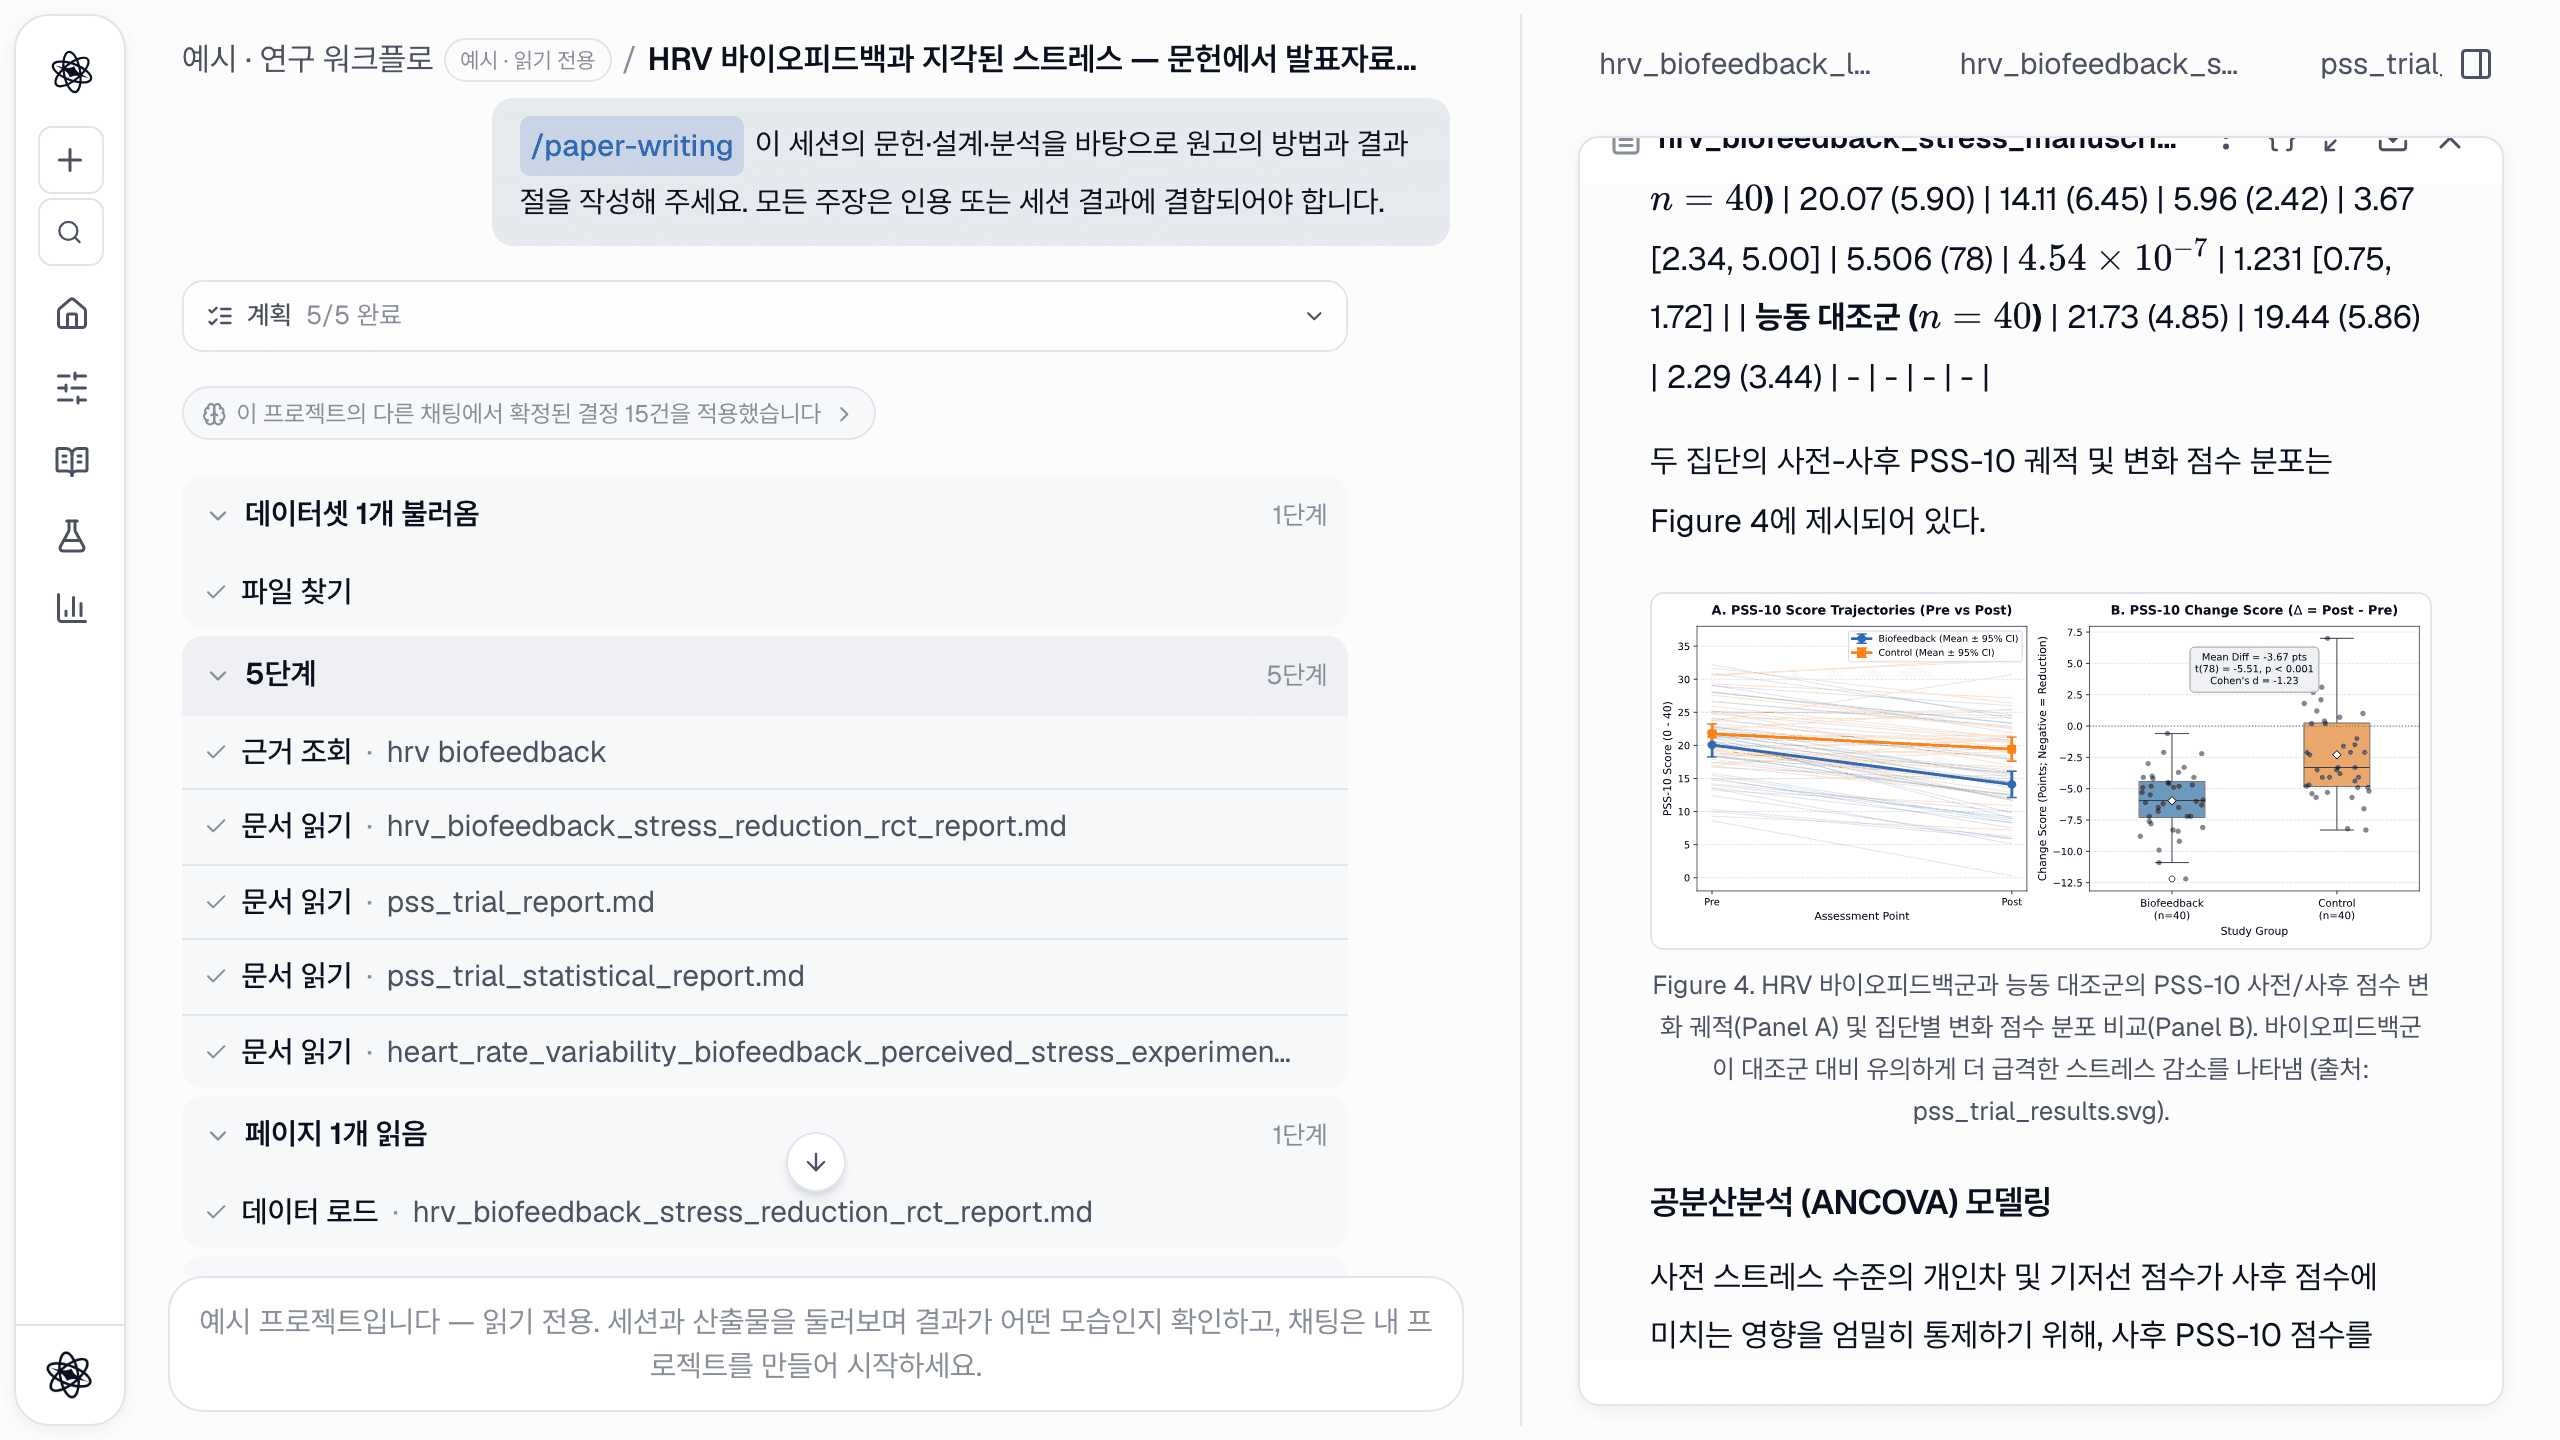
결과는 숫자가 통계 보고서에서 오고 인용이 선별된 문헌에서 오는 방법·결과 절입니다. 채팅 기록의 세 가지가 결합이 어떻게 작동하는지 보여 줍니다.
- "참고문헌 목록을 이 세션의 저장된 출처(6건)에서 다시 만들어 본문에 인용된 모든 [n]과 맞췄습니다." 참고문헌은 생성되는 게 아니라 조회됩니다.
- "원고가 표준 그림 없이 저장돼, 그림 1(개요)·그림 2(프로토콜)를 만드는 짧은 추가 패스를 돕니다." 원고 검사가 그림이 빠진 것을 알아채고 첫 언급 뒤에 배치하는 추가 패스를 돌렸습니다.
- 원고 끝에는 주장–근거 지도와 데이터가 뒷받침하지 못하는 주장의 목록이 있습니다. 긴장성 미주신경 재편, 개방형 호흡 안내 대비 우월성, 3개월 유지는 모두 단언이 아니라 미검증으로 분류됩니다.
내보내기는 패널의 다운로드 버튼에서 DOCX, LaTeX, PDF, Markdown 으로 합니다. 자세한 안내: 논문 작성.
턴 9 — 보고서 검토
/report-review 이 세션에서 작성한 원고를 독립적으로 검토해 주세요 — 주장, 방법, 통계, 인용 근거, 재현성 — 그리고 우선순위를 매긴 검토 보고서를 작성해 주세요.
보고서 검토는 세션이 자기 작업을 남처럼 읽는 일입니다. 단계 목록이 "독립적으로"가 실제로 무슨 뜻인지 보여 줍니다. 이 턴은 이전 채팅에서 원고와 그것을 만든 호출을 검색하고, 데이터 파일을 다시 로드하고, 기저선 검정·대응 검정·집단 간 비교·효과크기·ANCOVA 를 처음부터 다시 돌렸습니다. 재분석은 원고와 일치했고(t(78) = 5.51, d = 1.23, ANCOVA F(1,77) = 29.22) 보고서가 그렇게 적습니다.
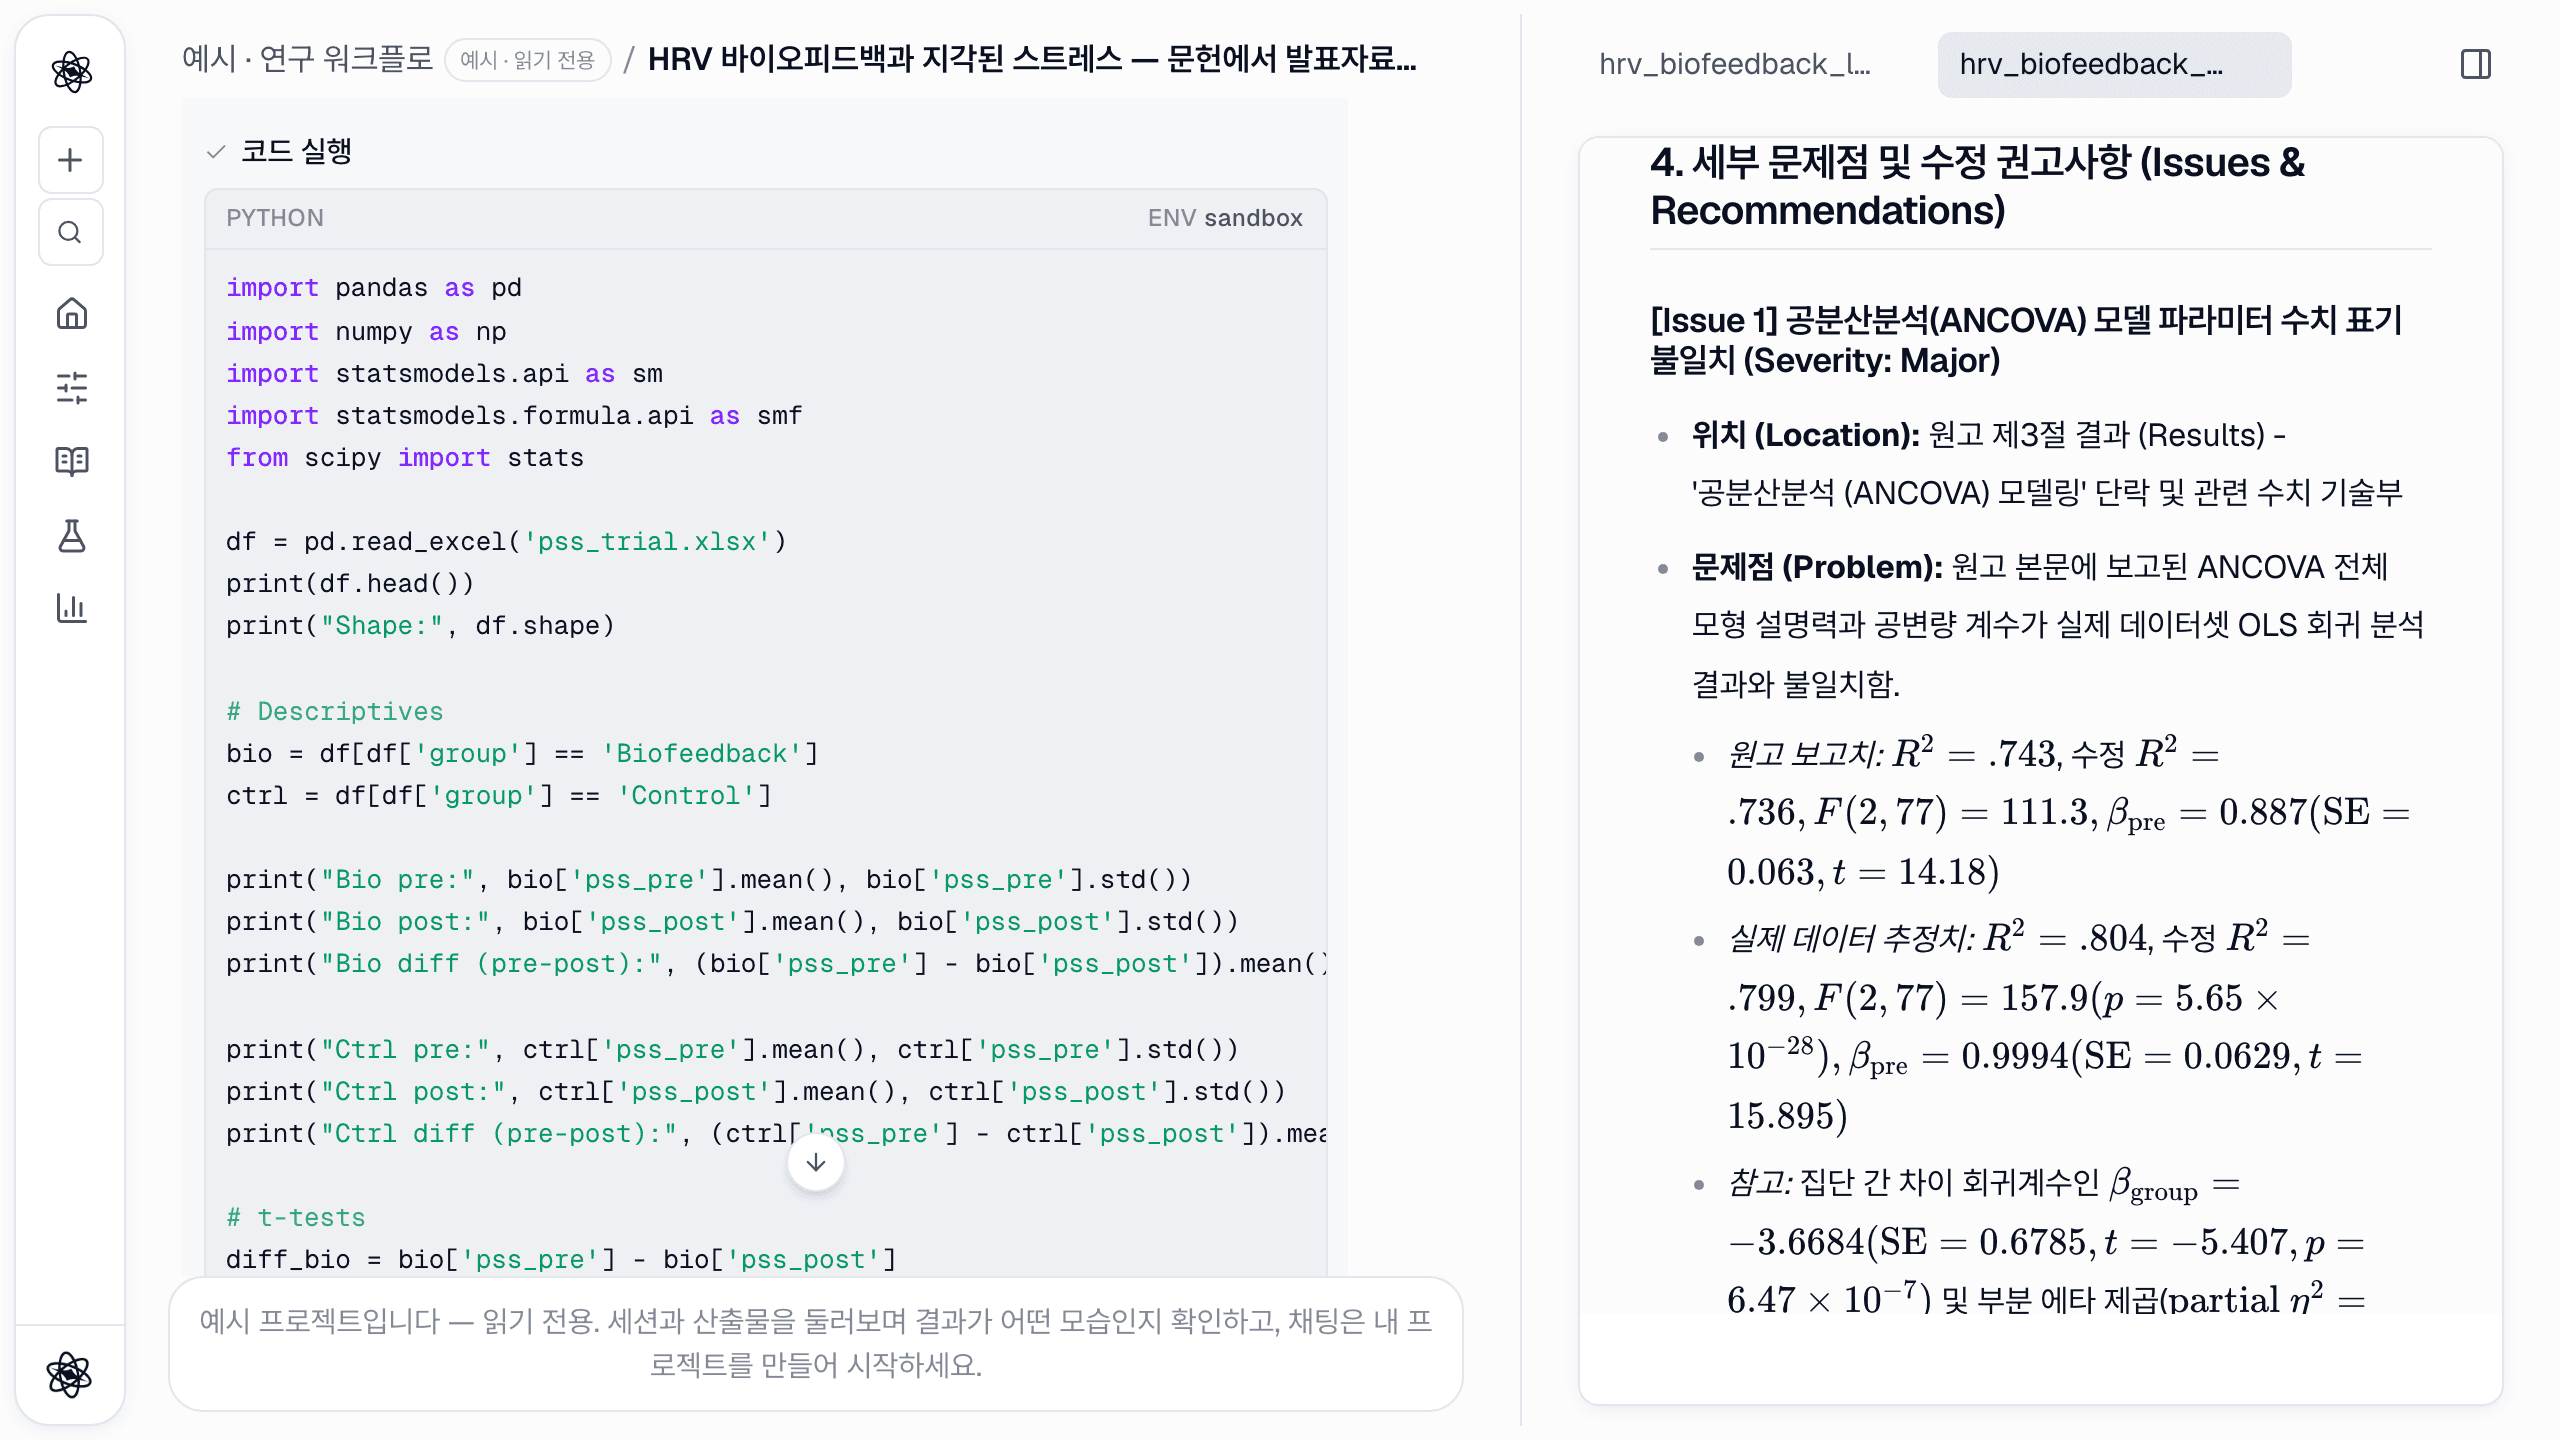
그런 다음 고칠 만한 것 둘을 찾았습니다. 저장된 원고가 방법 절 문장 중간에서 잘려 있었고(산출물의 실제 결함으로, 아니었으면 투고할 때 저자가 발견했을 것입니다), 고찰에서 느린 호흡 안내의 효과와 피드백의 효과를 분리해야 했습니다. 가설 턴이 지적한 바로 그 공백입니다. 이 턴은 단계 한도에 닿았고 그렇게 말했습니다. "이 작업의 단계 한도에 닿았습니다. 위에 저장된 결과는 사용할 수 있고, 남은 계획 단계는 실행되지 않았습니다." 이 솔직함도 설계의 일부입니다. 일찍 멈춘 검토는 일찍 멈췄다고 알려 줍니다.
자세한 안내: 보고서 검토.
턴 10 — 논문 심사
/peer-review 이 세션에서 작성한 원고를 Applied Psychophysiology and Biofeedback 저널 기준으로 심사해 주세요: 저널 프로필과 투고 규정, 비교 논문, 리뷰어 5명의 점수, 편집 결정, 수정 가이드, 추천 저널까지.
논문 심사는 독자가 아니라 저널을 시뮬레이션합니다. 이 턴은 목표 저널의 프로필을 만들고 투고 규정을 추출했고, 그 저널이 실은 비교 논문 여덟 편을 찾았고, 서로 다른 임무(저널 적합도, 방법론, 도메인 전문성, 폭넓은 관점, 악마의 변호인)를 맡은 리뷰어 다섯 명을 소집한 뒤 편집장이 의견 차이에 판정을 내리게 했습니다.
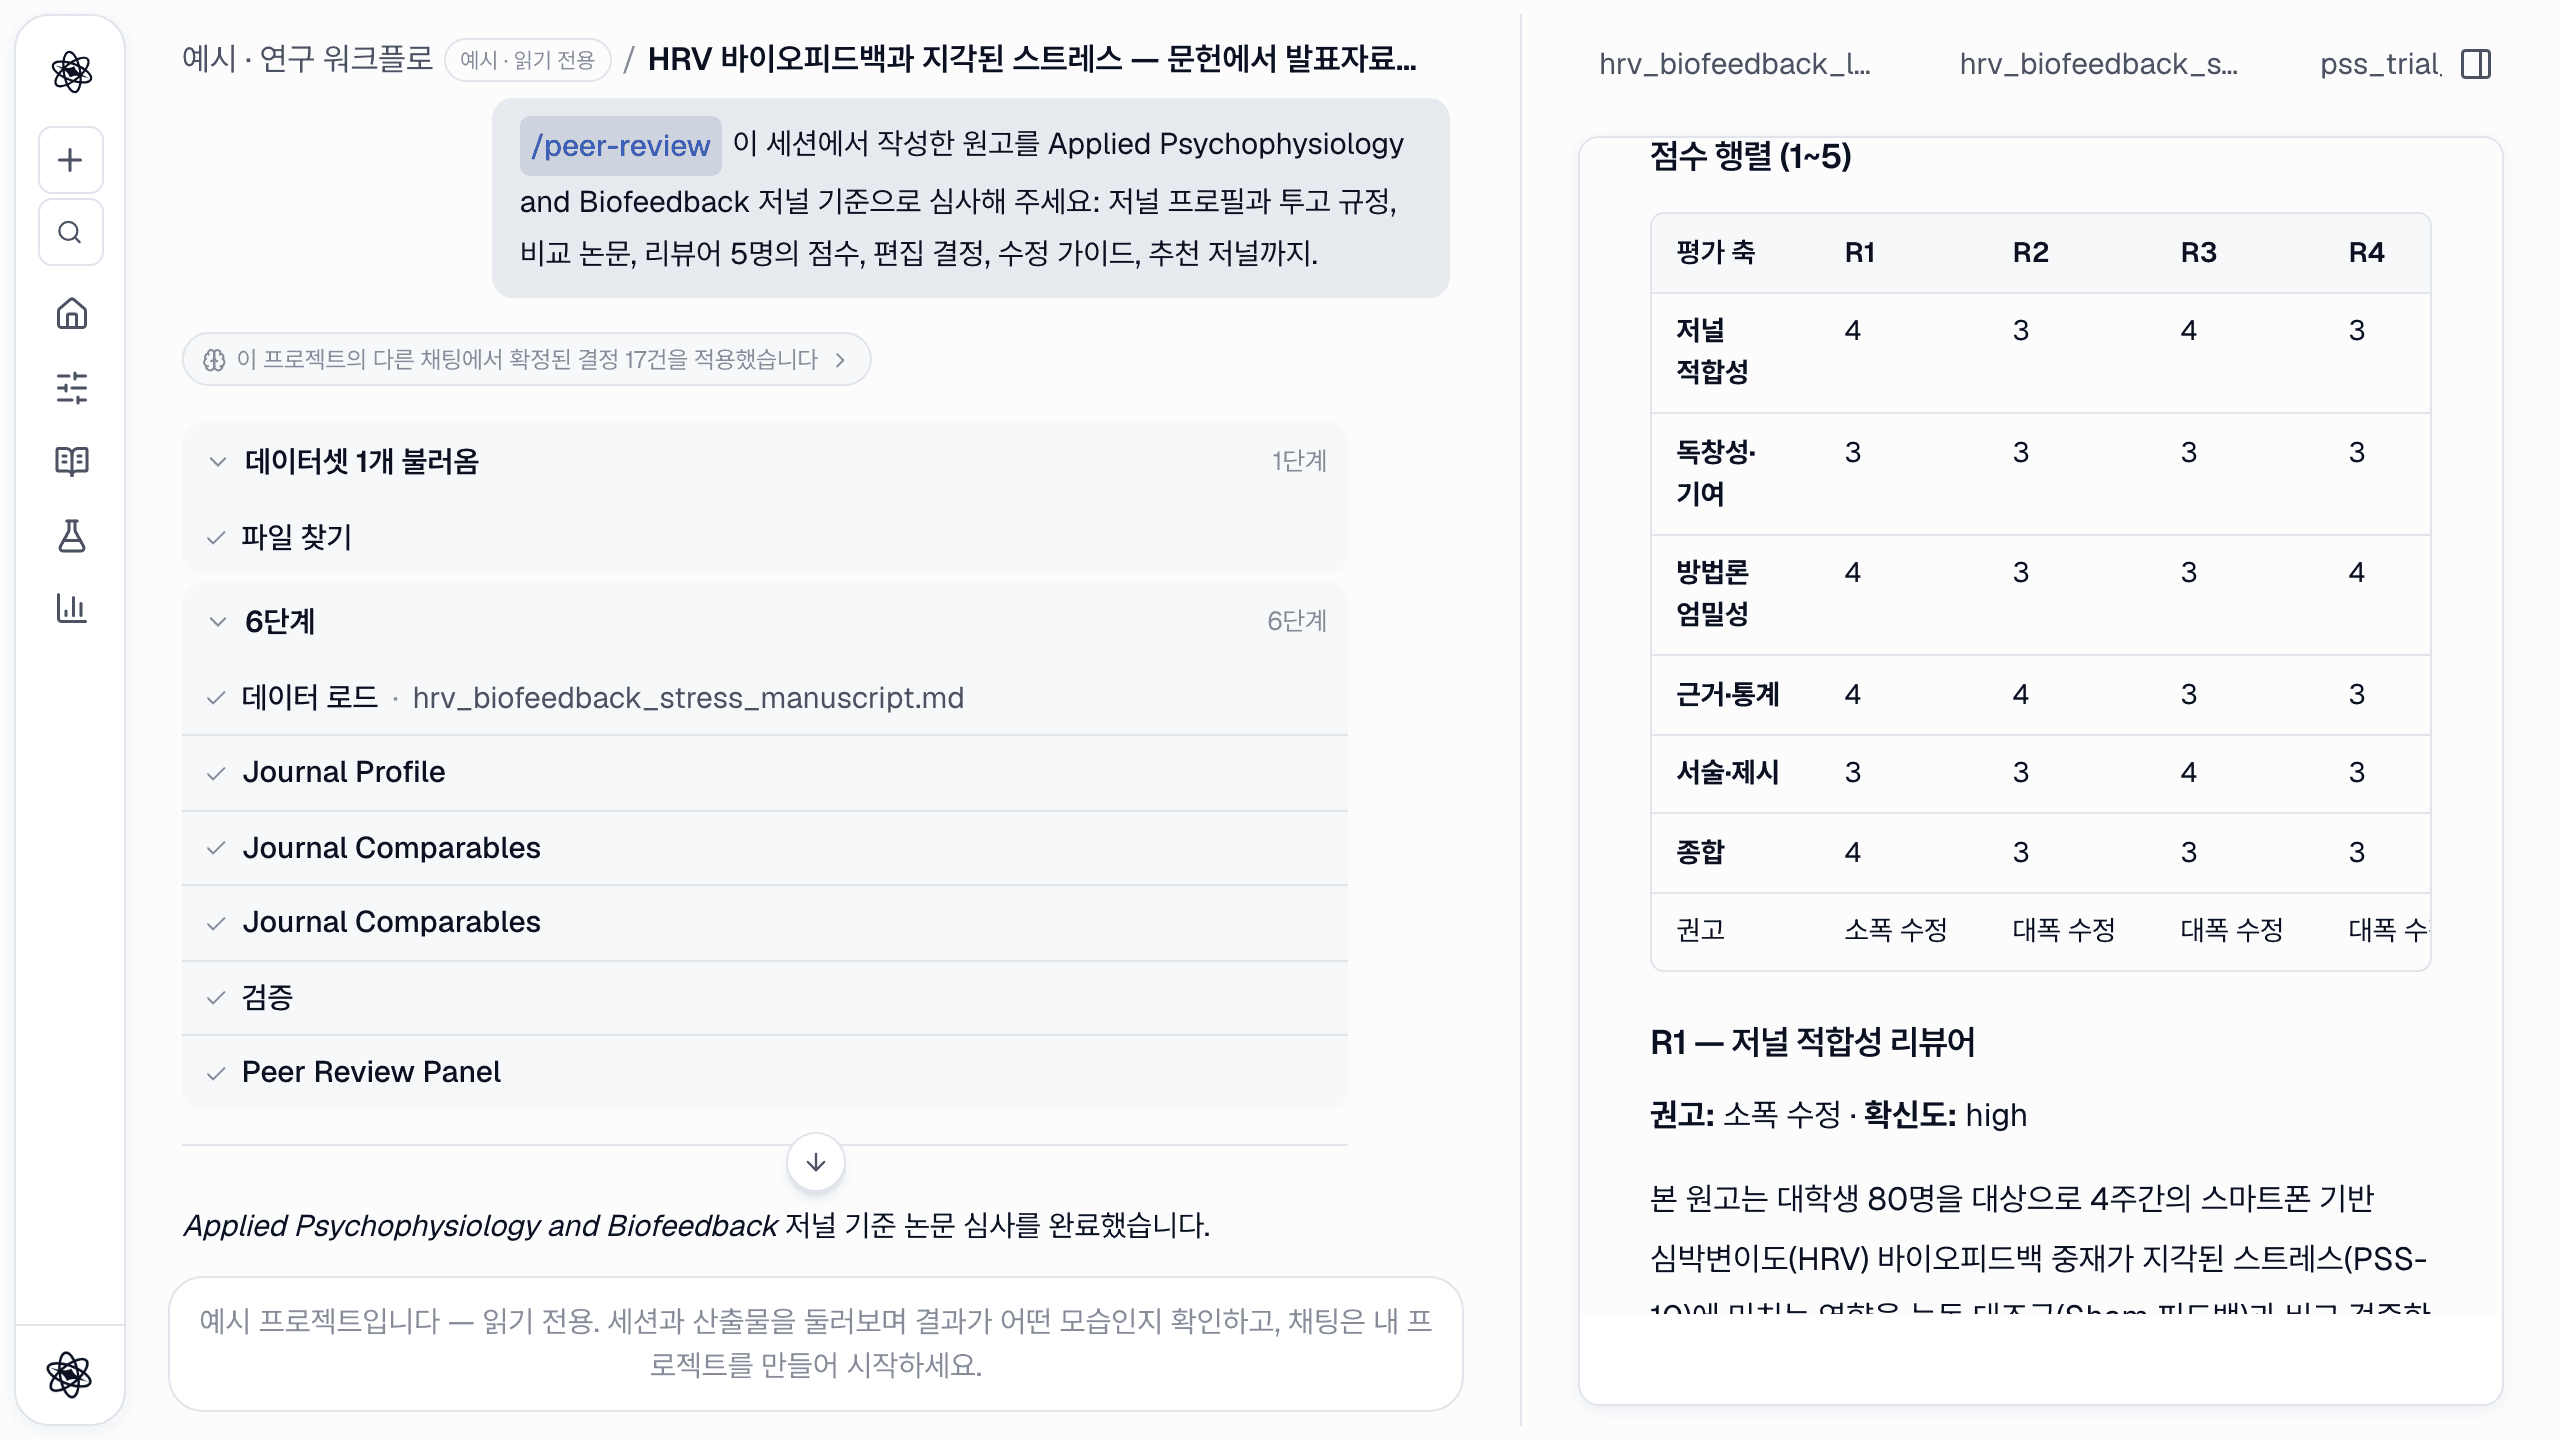
영어 원고의 판정은 대폭 수정(Major Revision)이었고 이유는 구체적입니다. 초록이 250단어 제한에 265단어였습니다. 저널은 APA 7판을 요구하는데 인용이 숫자형이었습니다. 선언 페이지가 없었습니다. 도메인 리뷰어는 분당 6회로 고정된 호흡 프로토콜은 개인별 공명 주파수 훈련이 아니라 피드백 있는 호흡 안내라는 점, 그리고 앱이 맥박 데이터를 기록했는데 원고가 전혀 보고하지 않았다는 점을 짚었습니다. 보고서는 P0~P2 순서와 노력 추정이 붙은 수정 가이드, 통과/실패가 표시된 투고 규정 체크리스트, 결정적 검사(참고문헌 6건 전부 확인, 통계 10건 일치), 대안 저널 네 곳으로 끝납니다. 다른 언어 세션은 각자의 판정에 이르렀는데, 다른 원고를 읽는 리뷰어 다섯 명에게서 기대할 법한 일입니다.
자세한 안내: 논문 심사, 리뷰어 점수를 보정한 방법: 논문 심사 보정.
턴 11 — 랩미팅 발표자료
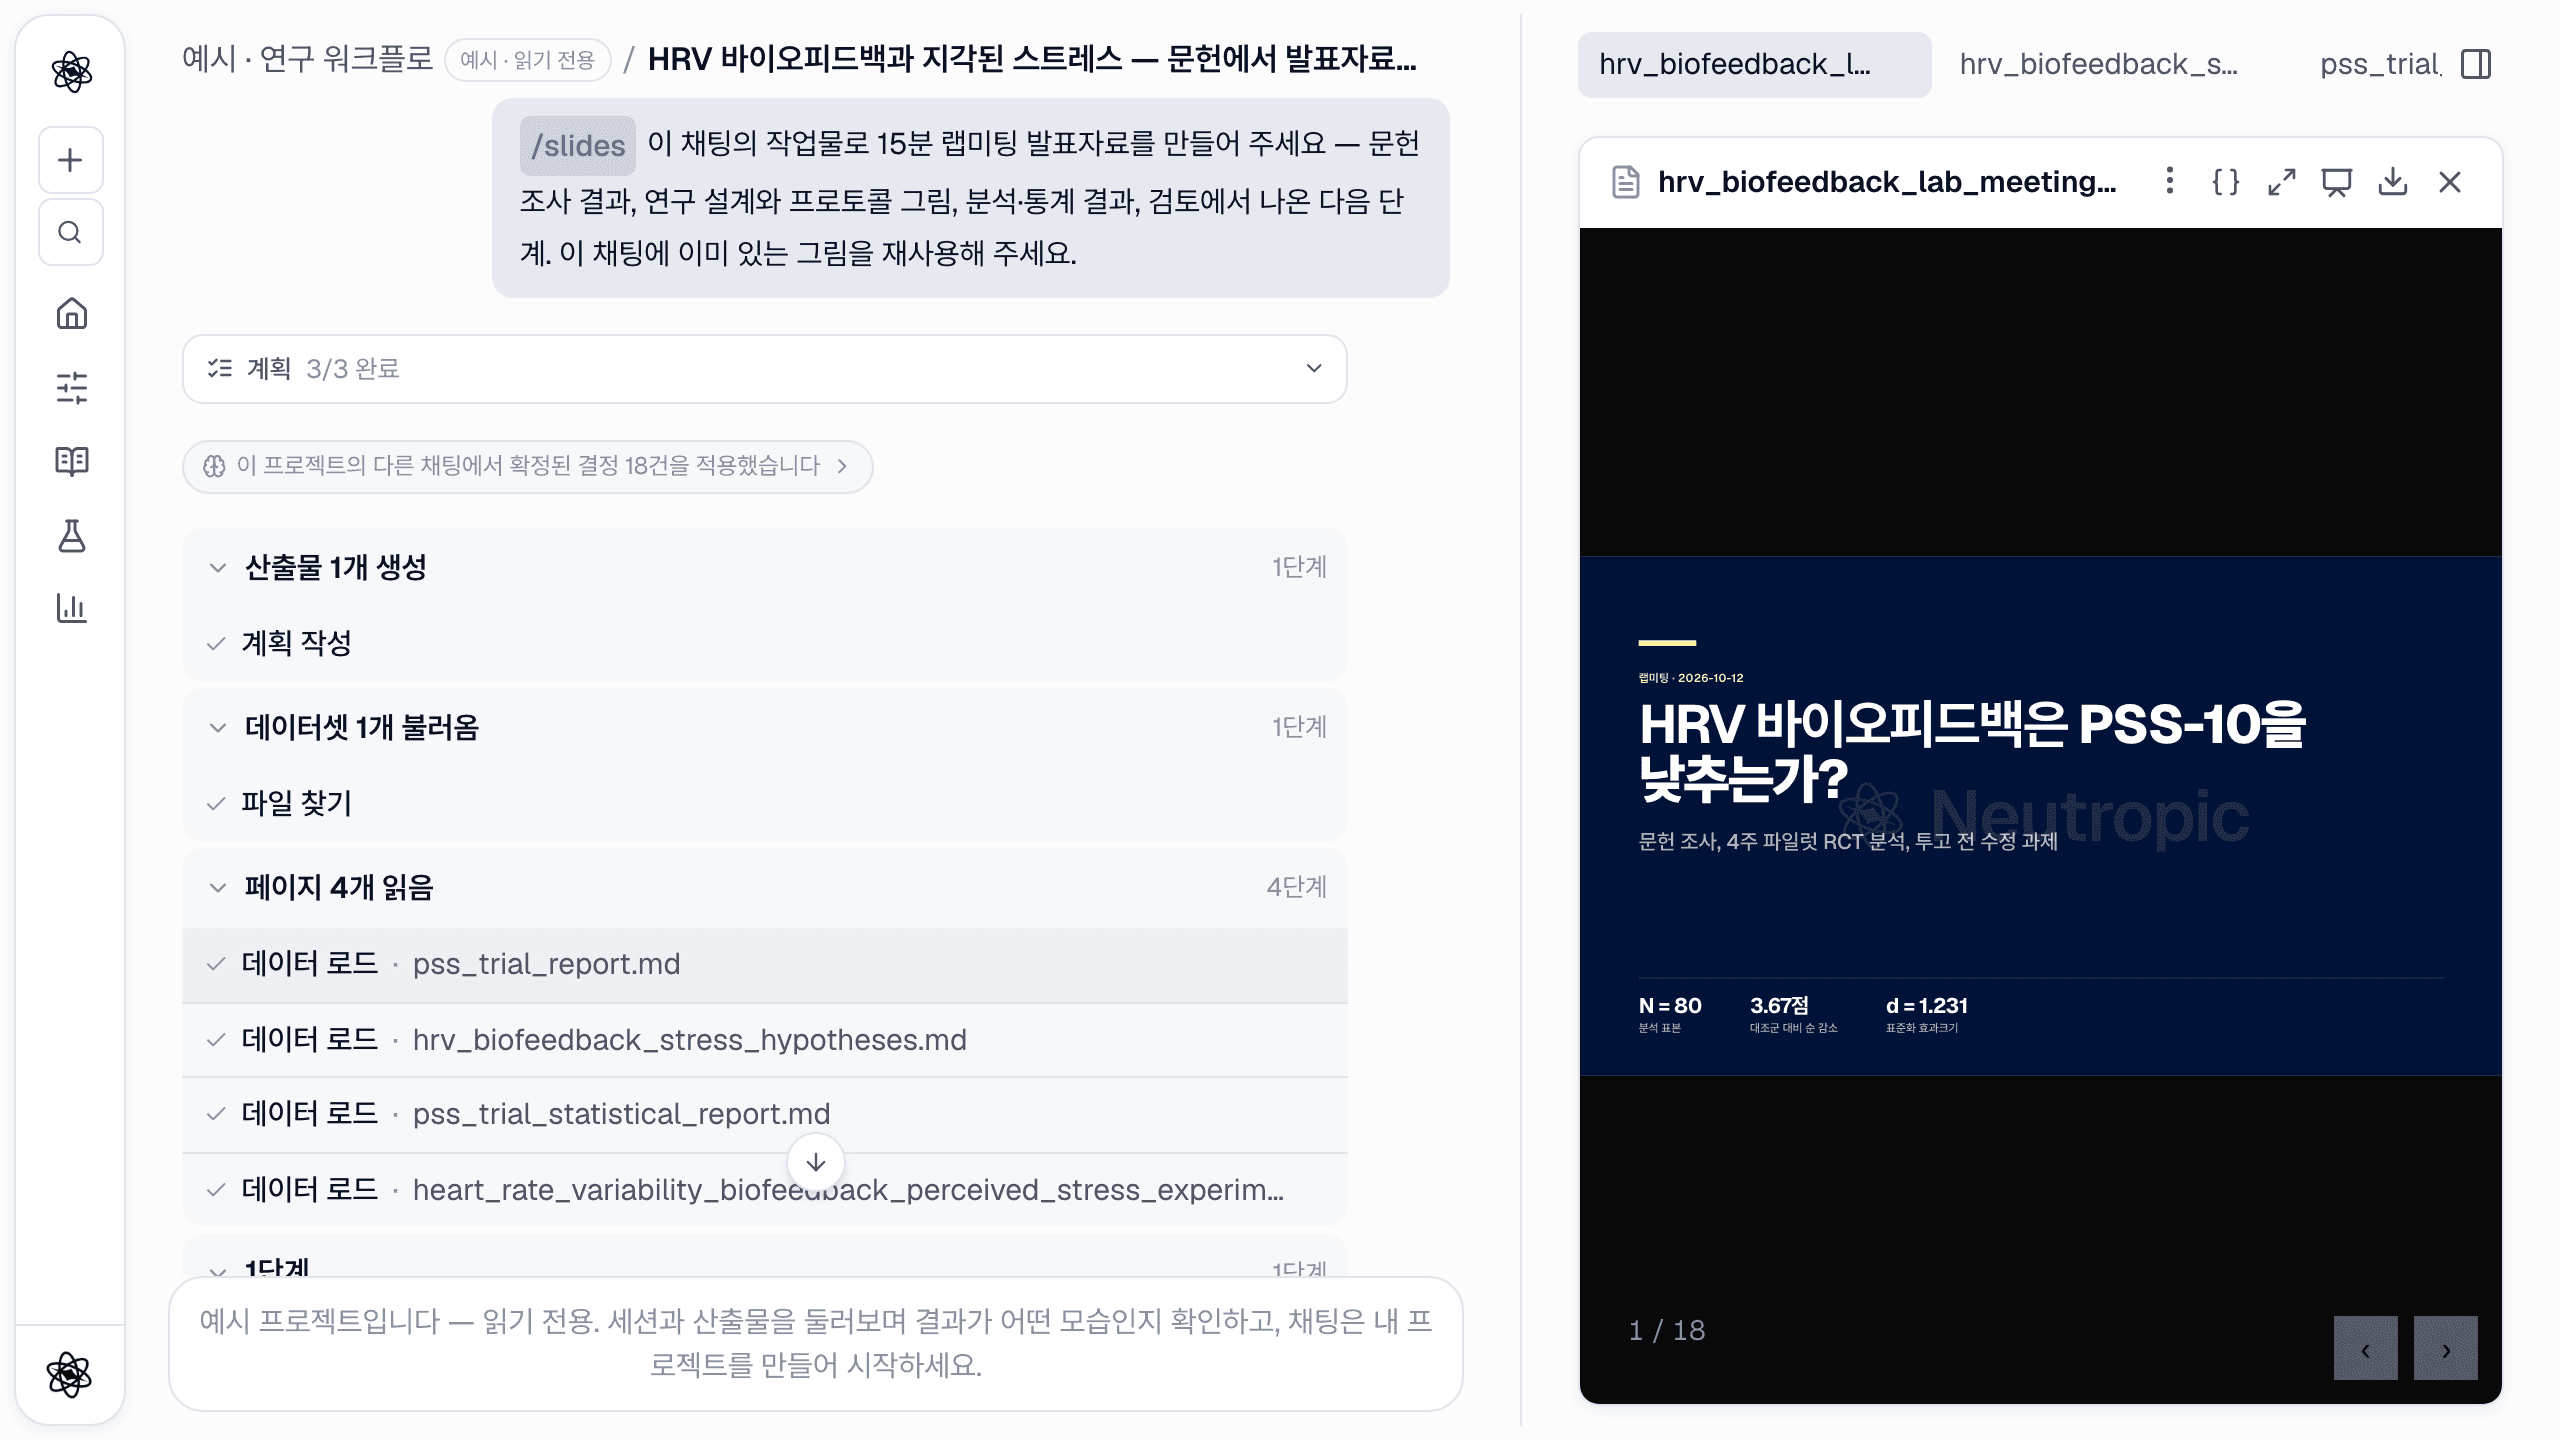
/slides 이 채팅의 작업물로 15분 랩미팅 발표자료를 만들어 주세요 — 문헌 조사 결과, 연구 설계와 프로토콜 그림, 분석·통계 결과, 검토에서 나온 다음 단계. 이 채팅에 이미 있는 그림을 재사용해 주세요.
마지막 턴은 세션이 무엇을 담고 있는지 가장 또렷하게 보여 줍니다. 이 프로젝트의 다른 채팅에서 확정된 결정 14건을 적용했습니다 로 시작해 설계 보고서, 분석·통계 보고서, 가설, 검토와 심사 보고서를 읽고, 프로토콜 흐름과 결과 figure 를 재사용하는 17장짜리 발표자료를 만들었습니다. 요약에서 중요한 선을 스스로 긋습니다. 발표자료는 "계획된 설계 세부와 분석된 데이터셋을 구분하고, 생리적 변화나 3개월 결과를 발견으로 제시하지 않는다"고요. 어떤 산출물을 왜 뺐는지도 말했습니다. 패널의 발표를 누르면 전체 화면으로 돌리고, PPTX·PDF·HTML 로 내려받을 수 있습니다.
자세한 안내: 발표자료.
무엇이 이어 붙였나
열한 턴을 돌아보면, 보통 사람이 도구 사이에서 하던 일을 네 가지 장치가 대신했습니다.
- 산출물이 기억입니다. 각 턴은 필요한 앞선 파일을 이름으로 읽고, 단계 목록이 어떤 파일인지 보여 줍니다. 원고는 통계를 기억한 게 아니라 통계 보고서를 로드했습니다.
- 확정된 결정이 쌓입니다. 이 프로젝트의 다른 채팅에서 확정된 결정 N건을 적용했습니다 칩은 프로젝트가 무엇이 고정됐는지 배우면서 3에서 6, 7, 11, 14로 늘었습니다. 결과 척도, 조건, 표본, 검정, 저널. 채팅에서 결정을 말로 밝히는 것이 뒤 턴이 그것을 지키게 하는 가장 확실한 방법입니다.
- 출처는 기억이 아니라 저장입니다. 문헌 턴의 출처는 세션에 남아서 원고의 참고문헌과 논문 심사의 비교 논문이 실제 논문을 가리킵니다. 세션은 저장된 출처 61건, 그중 원고에 인용된 9건으로 끝났습니다.
- 검사도 턴입니다. 원고 검사, 보고서 검토의 재분석, 논문 심사의 규정 체크리스트가 모두 같은 채팅에서 같은 파일을 읽습니다. 이 연구의 유일한 과학적 공백인 피드백 대 호흡 안내는 가설 턴에서 드러났고, 원고에서 공개됐고, 두 검토에서 다시 제기됐습니다.
실용적인 메모 둘. 이 정도 길이의 세션은 모델에 문제가 되지 않습니다. 맥락은 자동으로 관리되고, 직접 줄이고 싶으면 /compact 가 대화를 요약합니다. 토큰은 전체 실행에 관리형 토큰 약 210만 개가 들었고 대부분은 작성·검토·발표자료 턴에서 썼습니다. 무료 플랜의 일일 한도를 생각하면 이런 워크플로는 며칠에 나눠 돌리게 됩니다. 유료 플랜은 한도를 올리고 프리미엄 모델을 더합니다. 플랜과 토큰과 토큰 가이드를 보세요.
당신의 자리
뉴트로픽은 초안을 쓰고 검사합니다. 연구는 여전히 당신 것입니다. 세션이 멈추고 판단을 기다린 자리가 시간을 써야 할 자리입니다.
- 가설을 고르고, 설계가 실제로 검정할 수 있는 가설로 만드세요.
- 실제 데이터를 올리고, N 을 등록 기록과 대조하세요.
- 논증이 기대는 논문 서너 편은 직접 읽으세요.
- 다른 사람이 초고를 읽기 전에 보고서 검토가 찾은 것을 고치세요.
- 논문 심사의 수정 가이드는 판결이 아니라 할 일 목록으로 쓰세요.
세션이 끝나면 내보내는 대신 공유하세요. 읽기 전용 링크를 열면 지도교수나 공저자에게 산출물까지 그대로 같은 화면이 보입니다.
내 라이브러리에서 예시 · 연구 워크플로를 열고 단계 목록을 펼쳐, 숫자 하나(예를 들어 d = 1.23)를 통계 턴에서 원고, 검토, 발표자료까지 따라가 보세요.