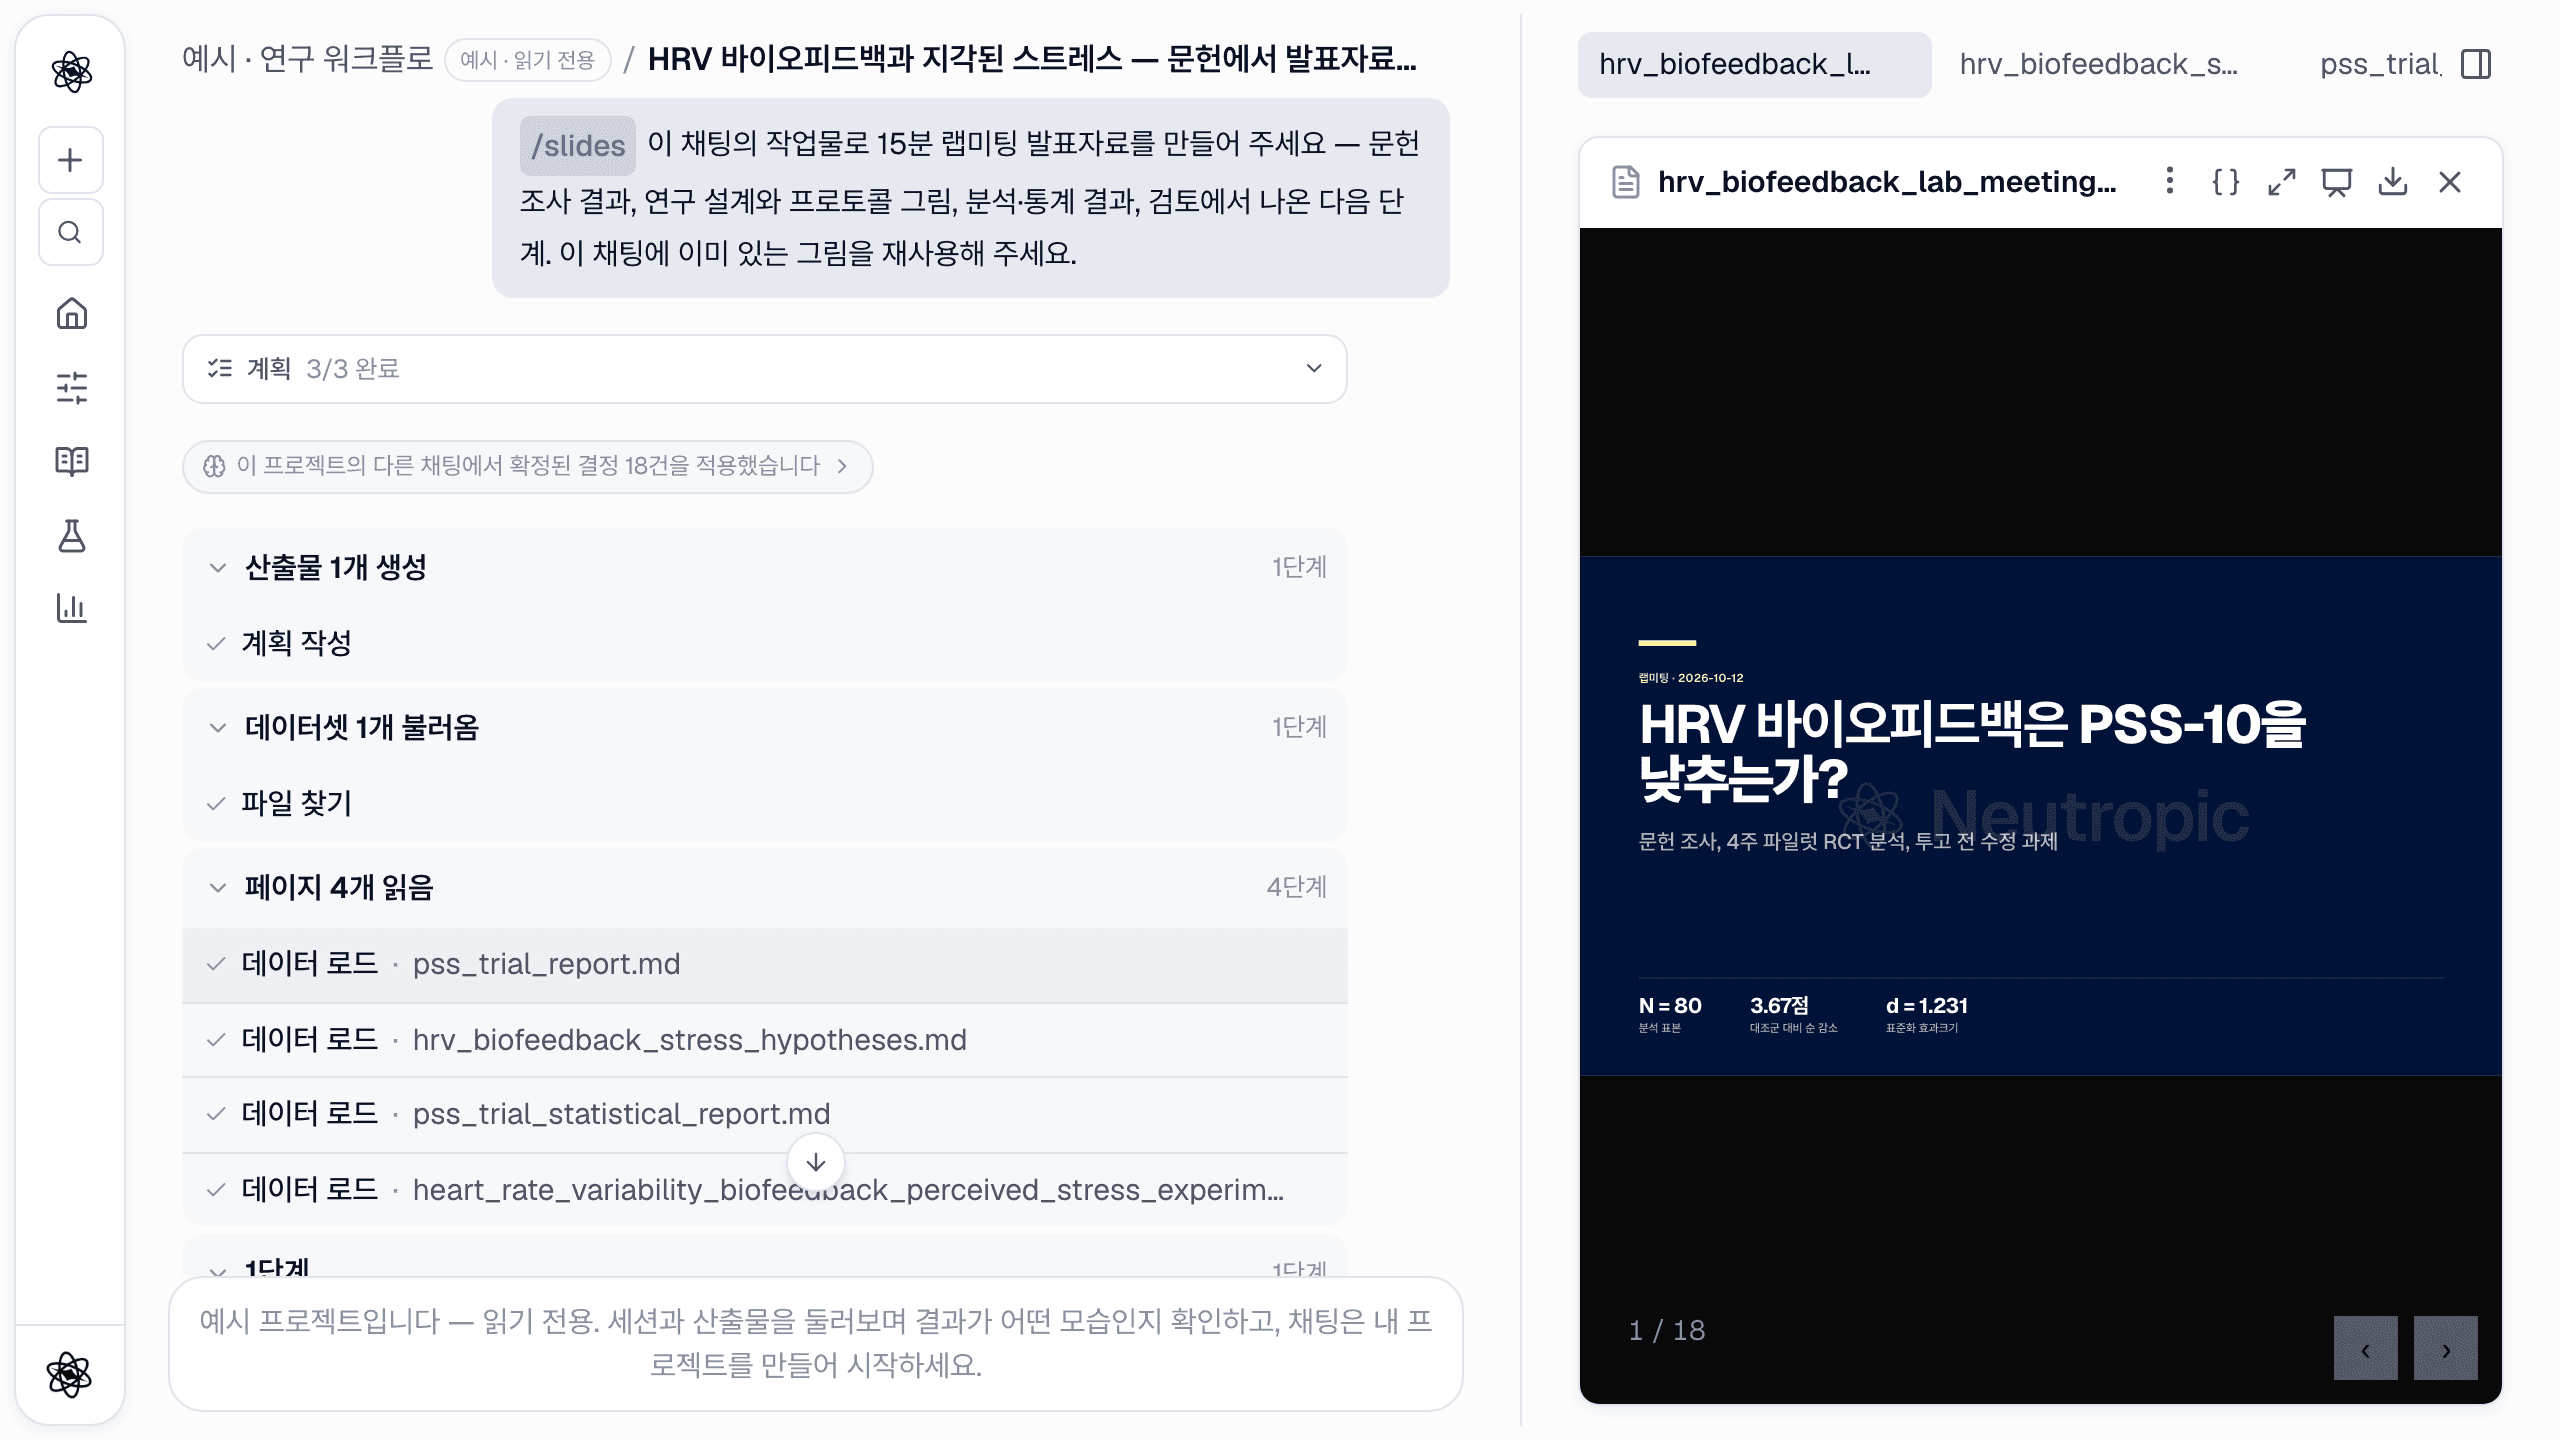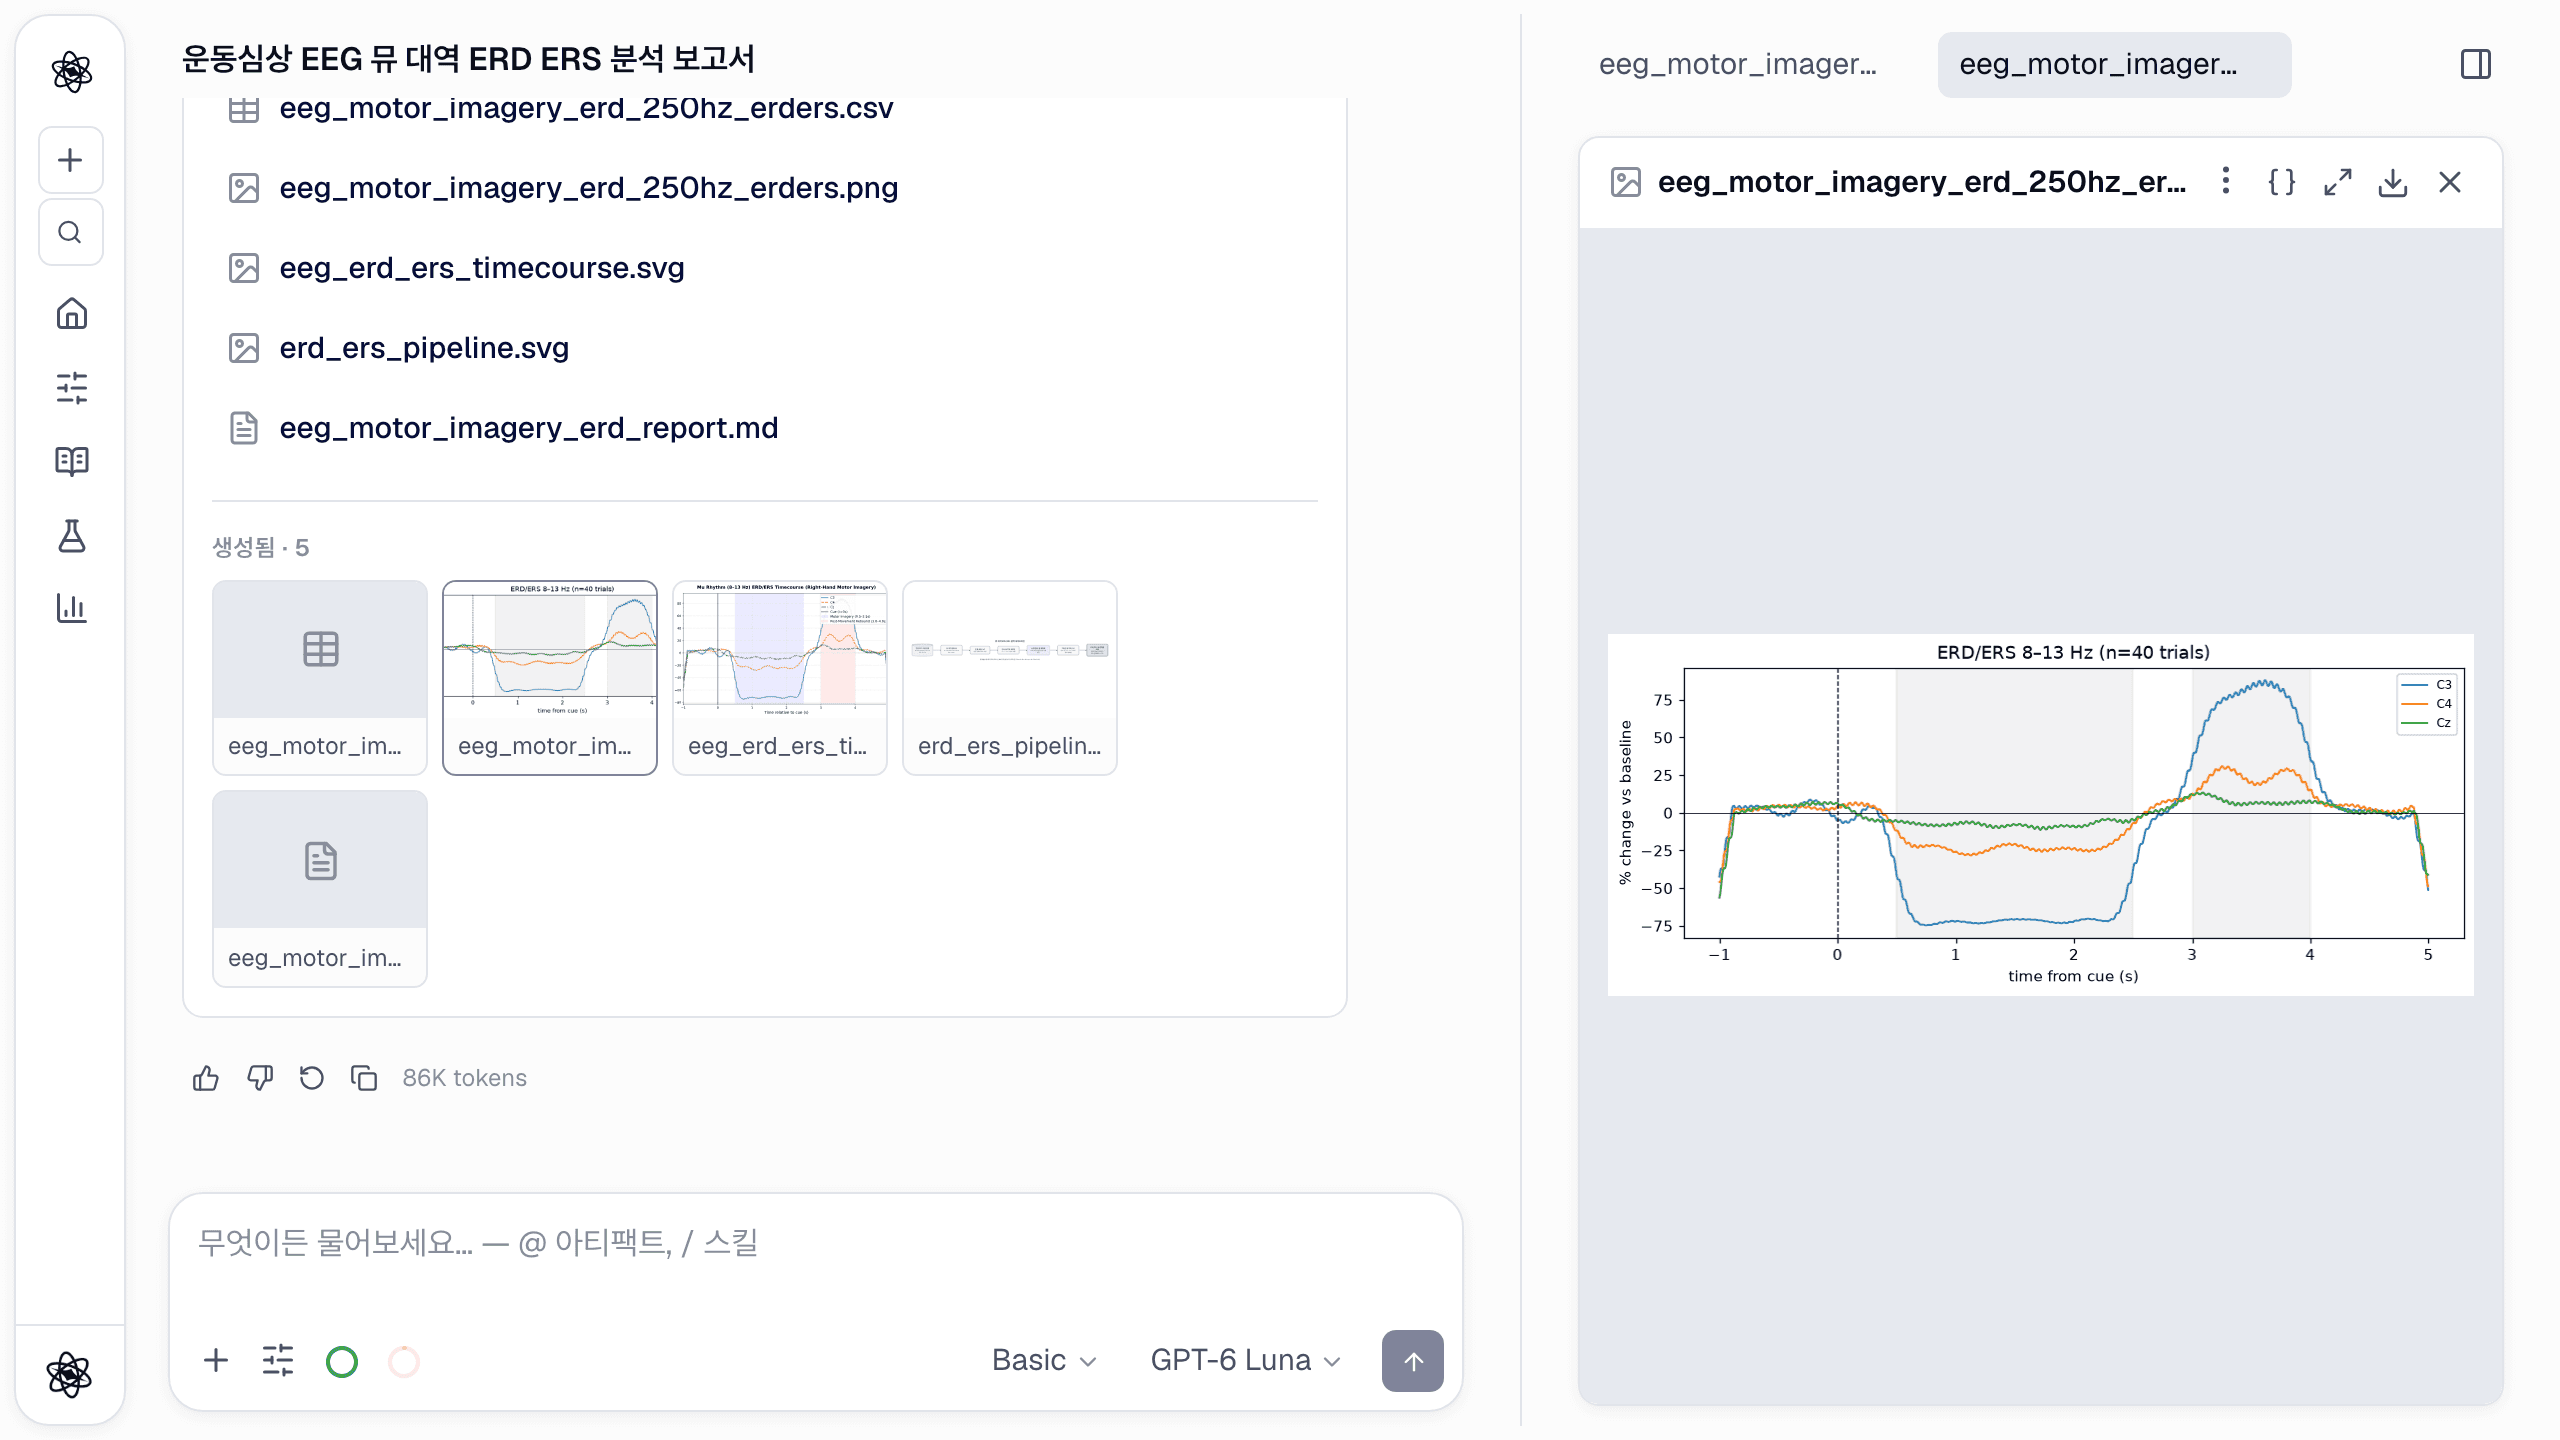
문헌 리뷰는 연구가 시작되는 곳이자 낭비되는 몇 주가 사는 곳입니다. 다섯 개 데이터베이스를 다섯 개 인터페이스로 검색하고, 내보내기를 중복 제거하고, 완성되는 순간 낡아 버리는 문서에 인용문을 꿰매 넣는 일. 같은 작업이 뉴트로픽에서는 실제 세션 하나에서 단계별로 어떻게 진행되는지 보여 드립니다. 질문은 심박변이도(HRV) 바이오피드백이 성인의 지각된 스트레스를 줄이는가이고, 아래의 모든 스크린샷은 그 세션에서 가져왔습니다.
1단계 — 질문하기
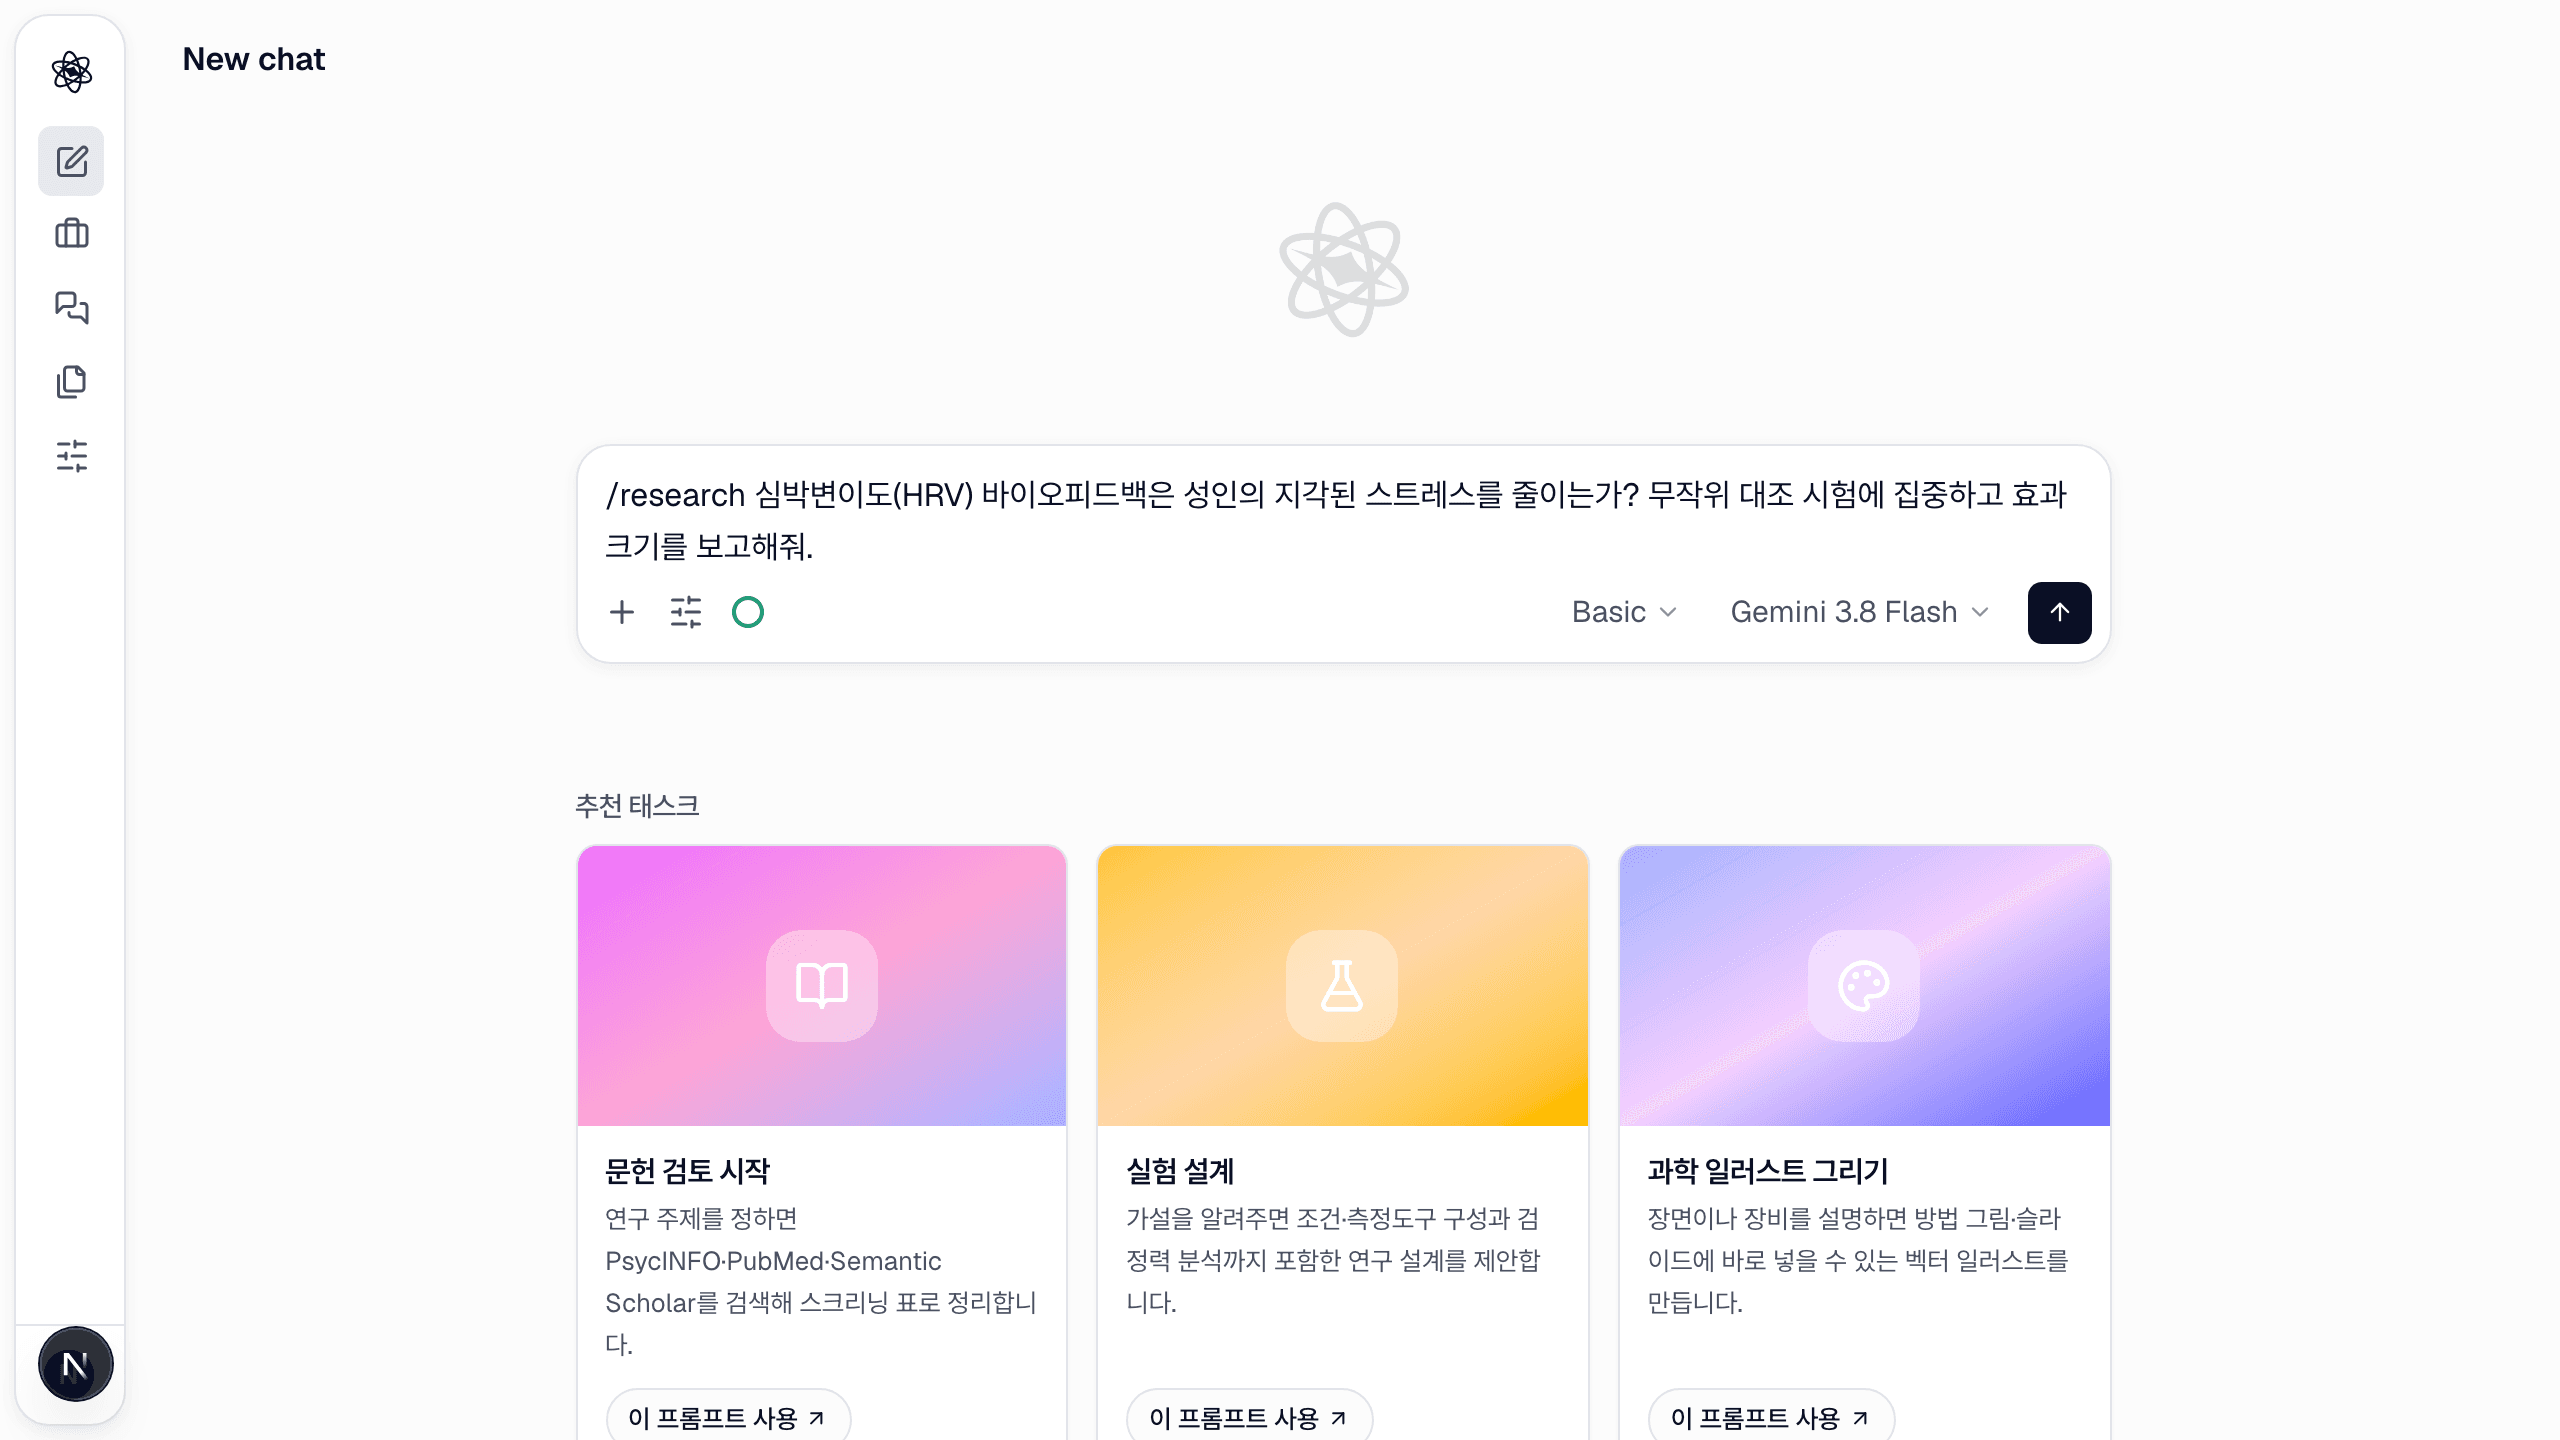
새 채팅을 열고 /research 명령과 함께 질문을 입력하세요. 자연어면 충분합니다. 명령은 어떤 워크플로를 돌릴지 에이전트에 알려 줄 뿐입니다. 수준과 모델은 전송 버튼 옆에 있습니다 — 첫 시도라면 Basic이면 됩니다.
/research Does heart rate variability (HRV) biofeedback reduce perceived stress in adults? Focus on randomized controlled trials and report effect sizes.
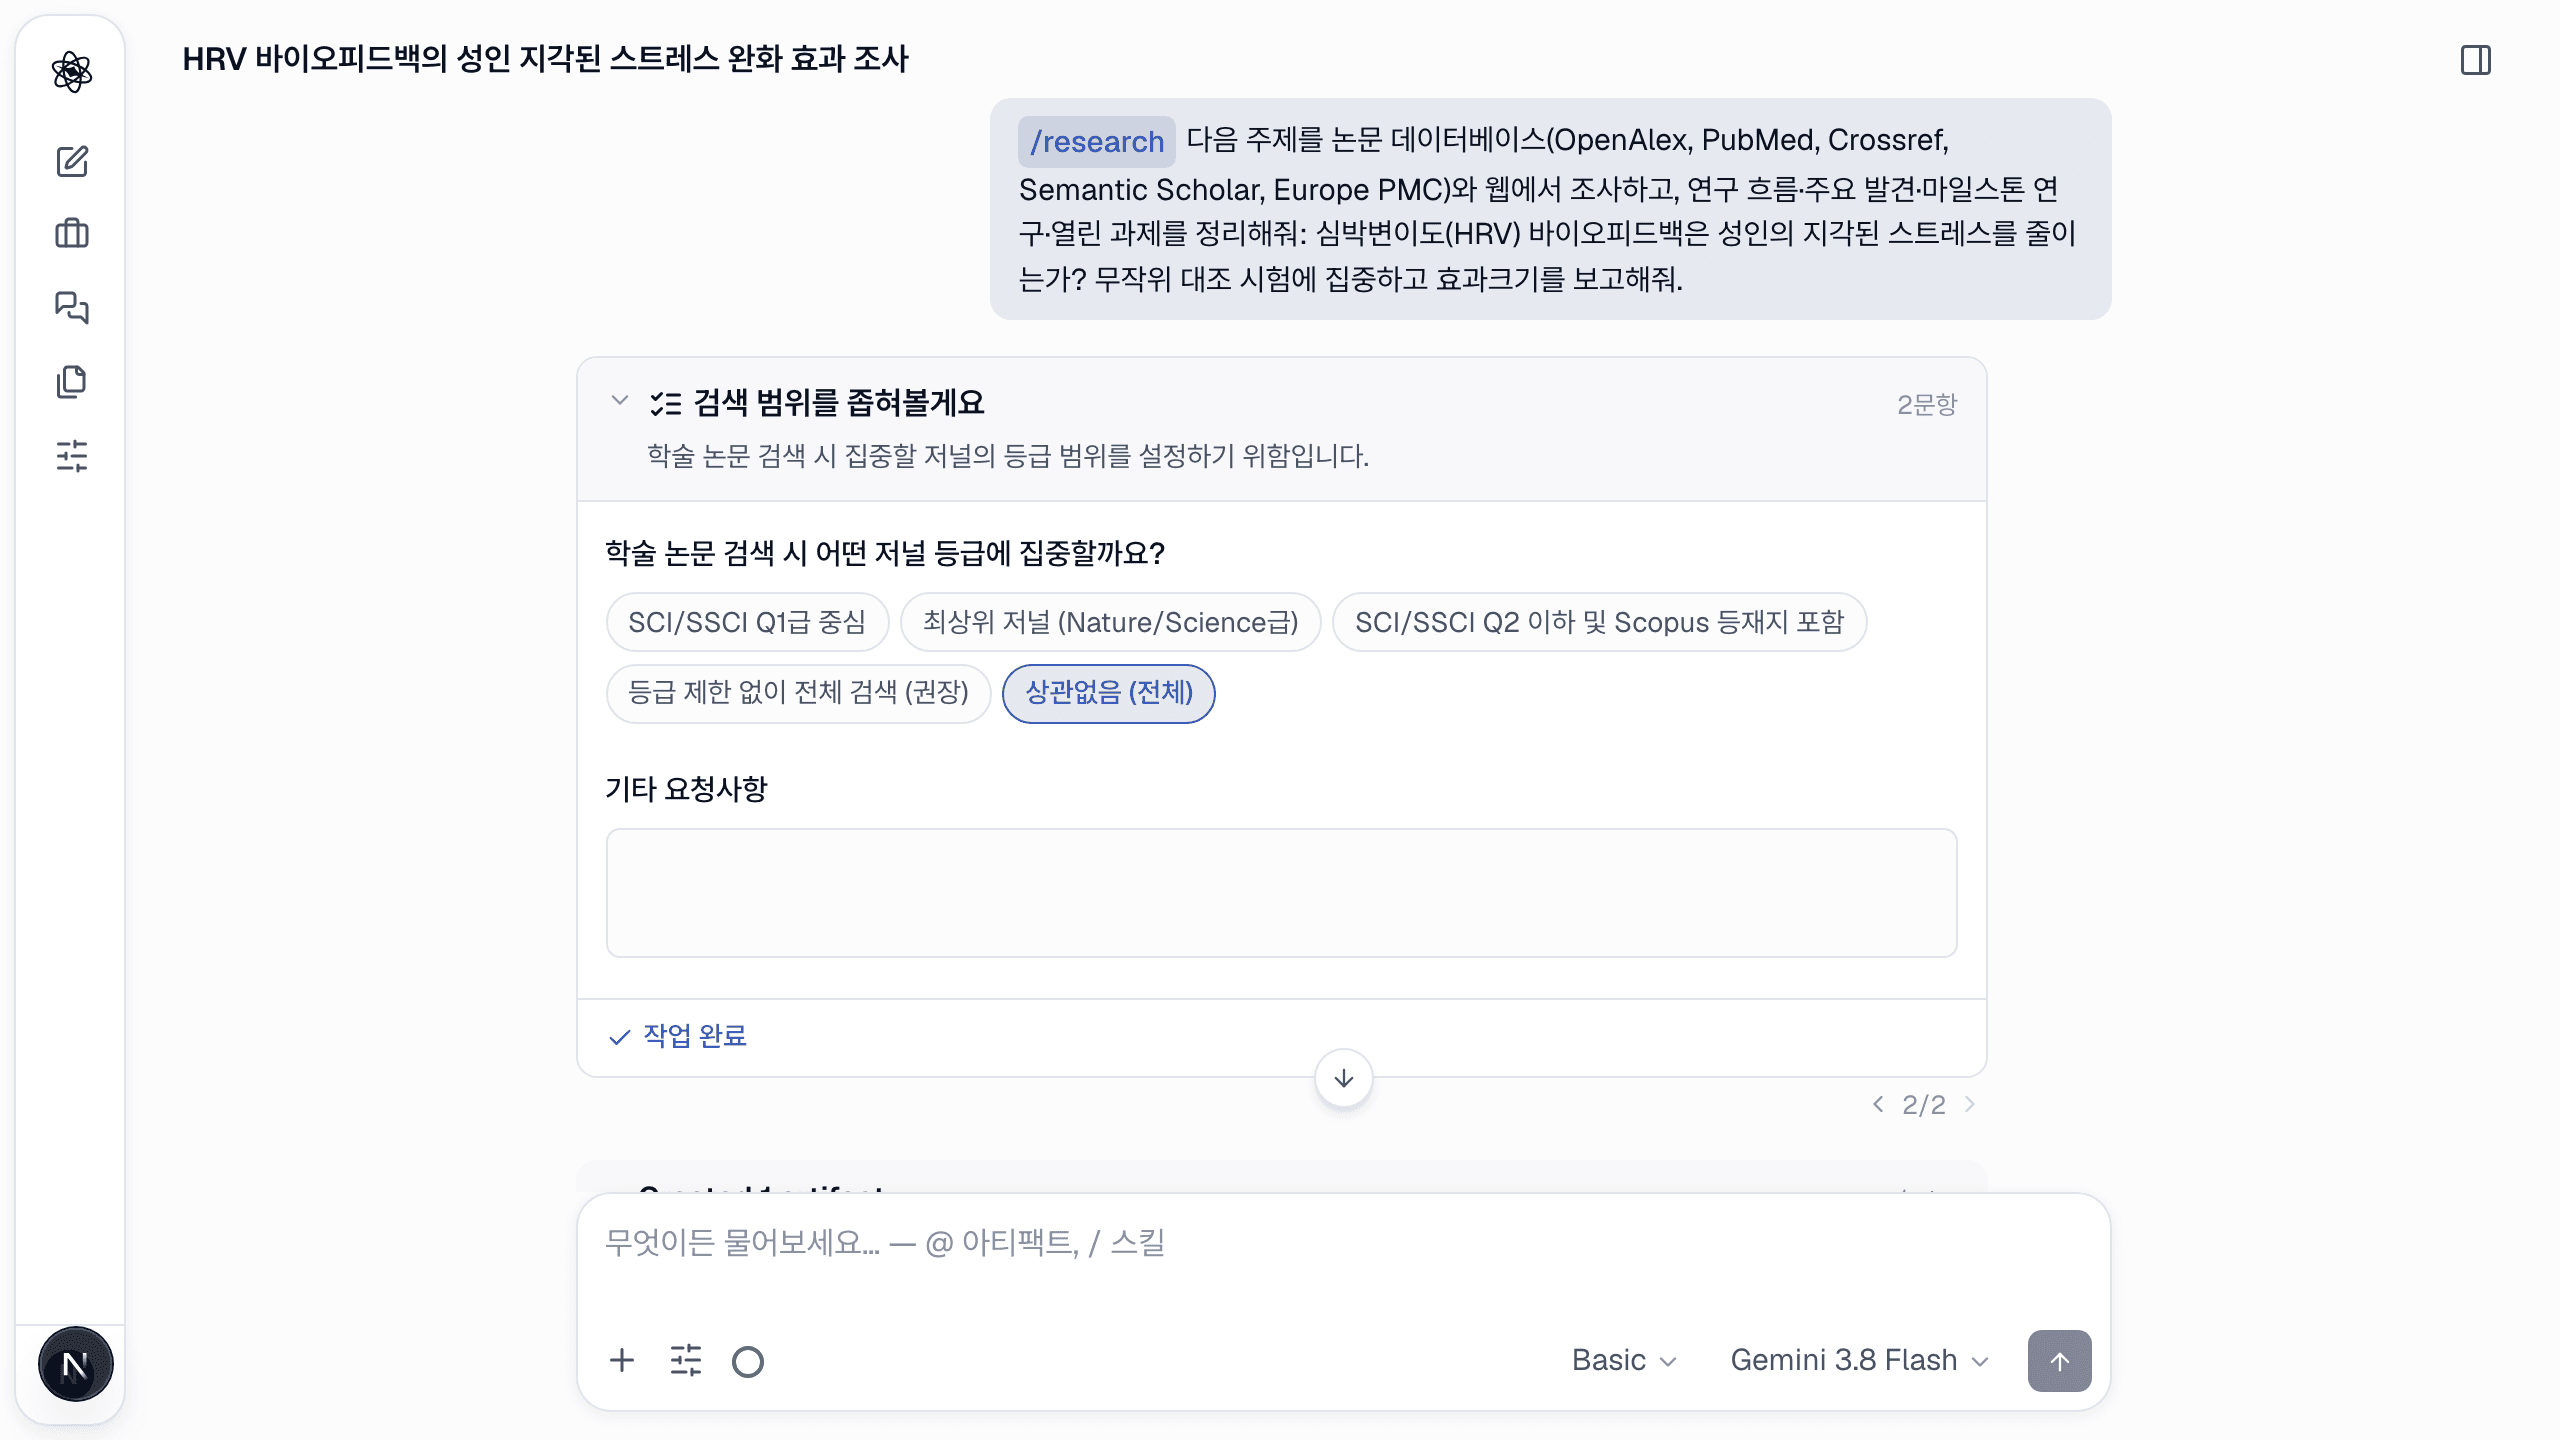
2단계 — 범위는 질문에서 나옵니다
에이전트는 먼저 아무것도 묻지 않습니다. 자료 종류·학술지 등급·기간은 질문 자체에서 — 여기서는 "성인", "RCT", "효과크기" — 읽어 내고, 가정해야 했던 것은 요약 첫 줄에 적으므로 다음 턴에서 바로잡을 수 있습니다. 신경 쓰이는 설정이 있으면 질문에 직접 적으세요.
3단계 — 검색이 돌아가는 것 보기
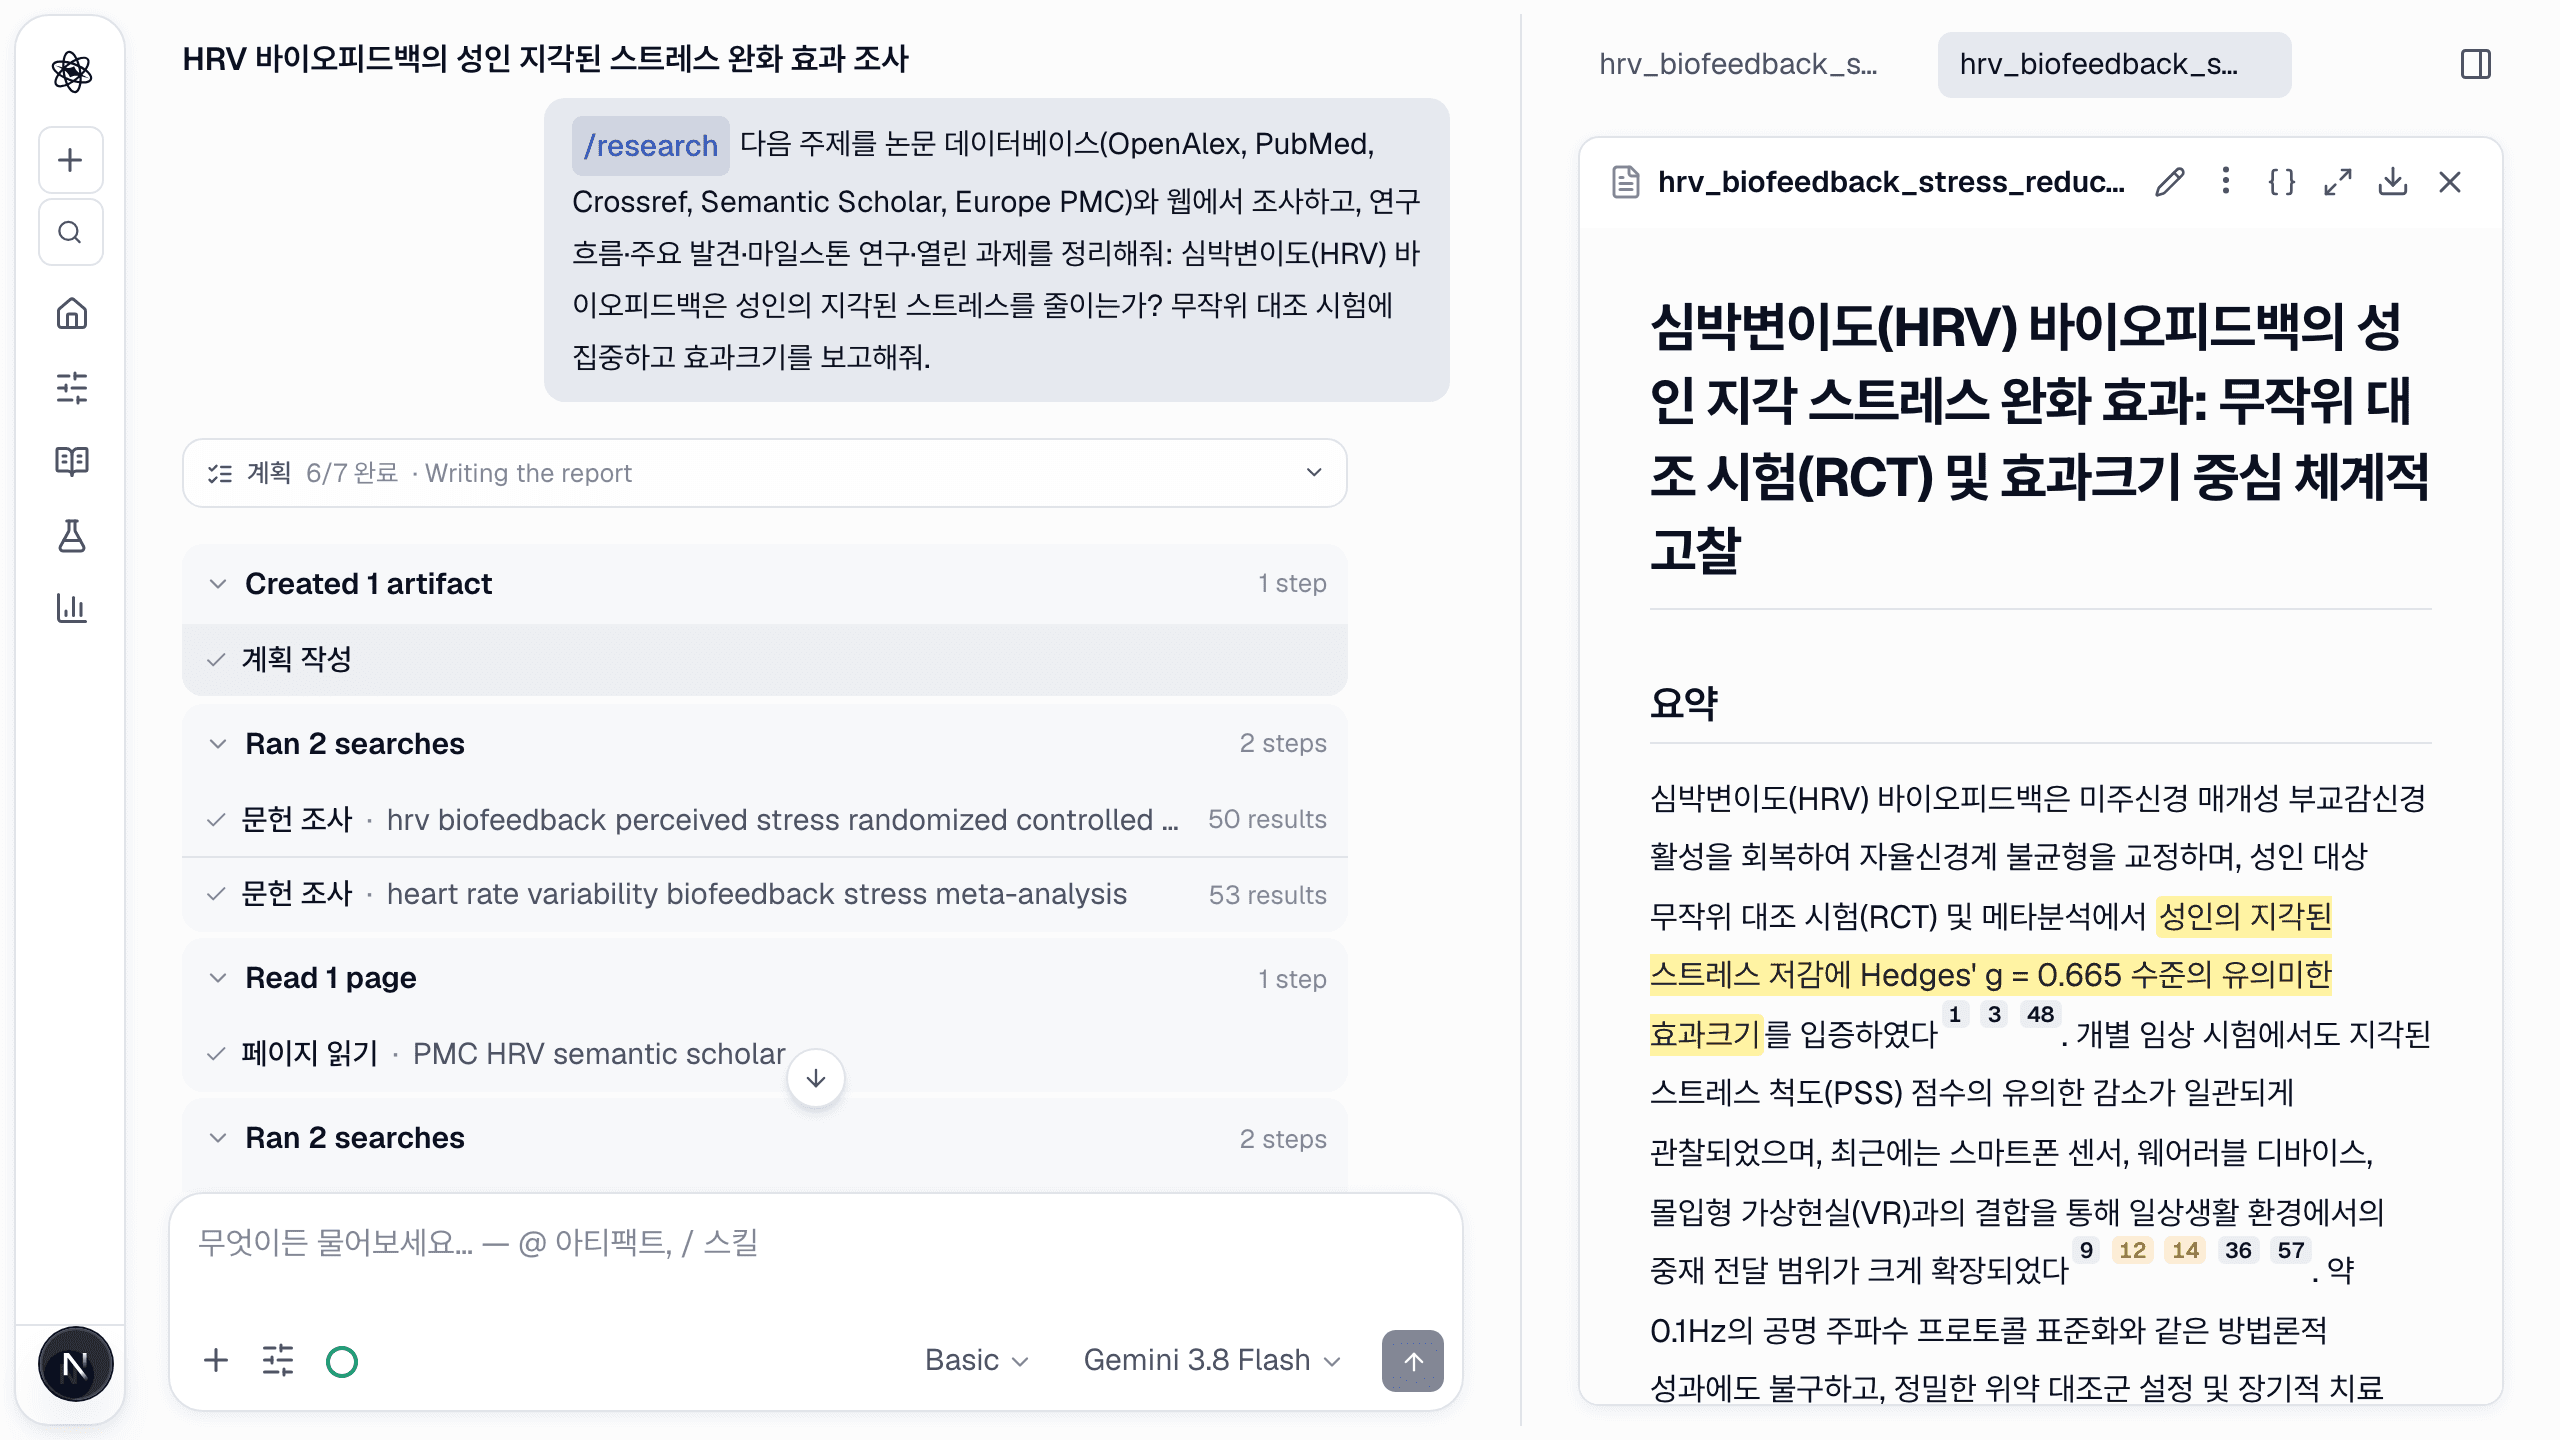
에이전트가 OpenAlex, PubMed, Crossref, Semantic Scholar, Europe PMC — 기관 접근이 연결되어 있으면 Scopus, Web of Science, KCI까지 — 를 병렬로 검색한 뒤, 이름으로 찾아낸 메타분석에 대한 웹 검색을 추가하고 한두 페이지를 전문으로 읽습니다. 모든 검색이 실행되는 동안 쿼리와 결과 수와 함께 나열되므로 무엇이 다뤄졌는지 볼 수 있고 직접 쿼리를 다시 돌릴 수도 있습니다.
4단계 — 모든 문장이 책임지는 리포트 읽기
산출물은 초록 더미가 아니라 모든 문장에 실제로 확인된 출처의 인라인 [n] 인용이 붙은 종합 리뷰입니다. 문장을 클릭하면 출처 패널이 어떤 연구가 그것을 뒷받침하고 왜 그런지 보여 줍니다. 어떤 출처도 뒷받침하지 않는 문장은 얼버무려지지 않고 제거됩니다.
- 특정 연구에 귀속된 주장은 나중의 언급이 아니라 원 논문을 인용합니다.
- 스크리닝 표가 근거를 데이터베이스·학술지 등급·연도별로 분해하고, 인용 그래프와 연구 마인드맵이 출처들의 관계를 보여 줍니다.
- 공백과 상충하는 발견이 명시적으로 나열됩니다 — 다음 단계인 가설 수립의 재료입니다.
5단계 — 살아 있게 유지하기
뉴트로픽의 리뷰는 살아 있는 산출물입니다. 다음 분기에 다시 돌리면 새 논문이 같은 구조로 흘러들어 오고 변경점이 강조됩니다 — 연구비 신청서에 쓴 리뷰가 심사자가 읽을 때도 여전히 정확합니다. 그리고 출처가 세션에 남아 있으므로 뒤따르는 설계, 분석, 원고가 번호로 인용할 수 있습니다.
목표는 덜 읽는 것이 아닙니다. 중요한 논문에 독서를 쓰되, 장부 정리는 이미 끝나 있는 것입니다.