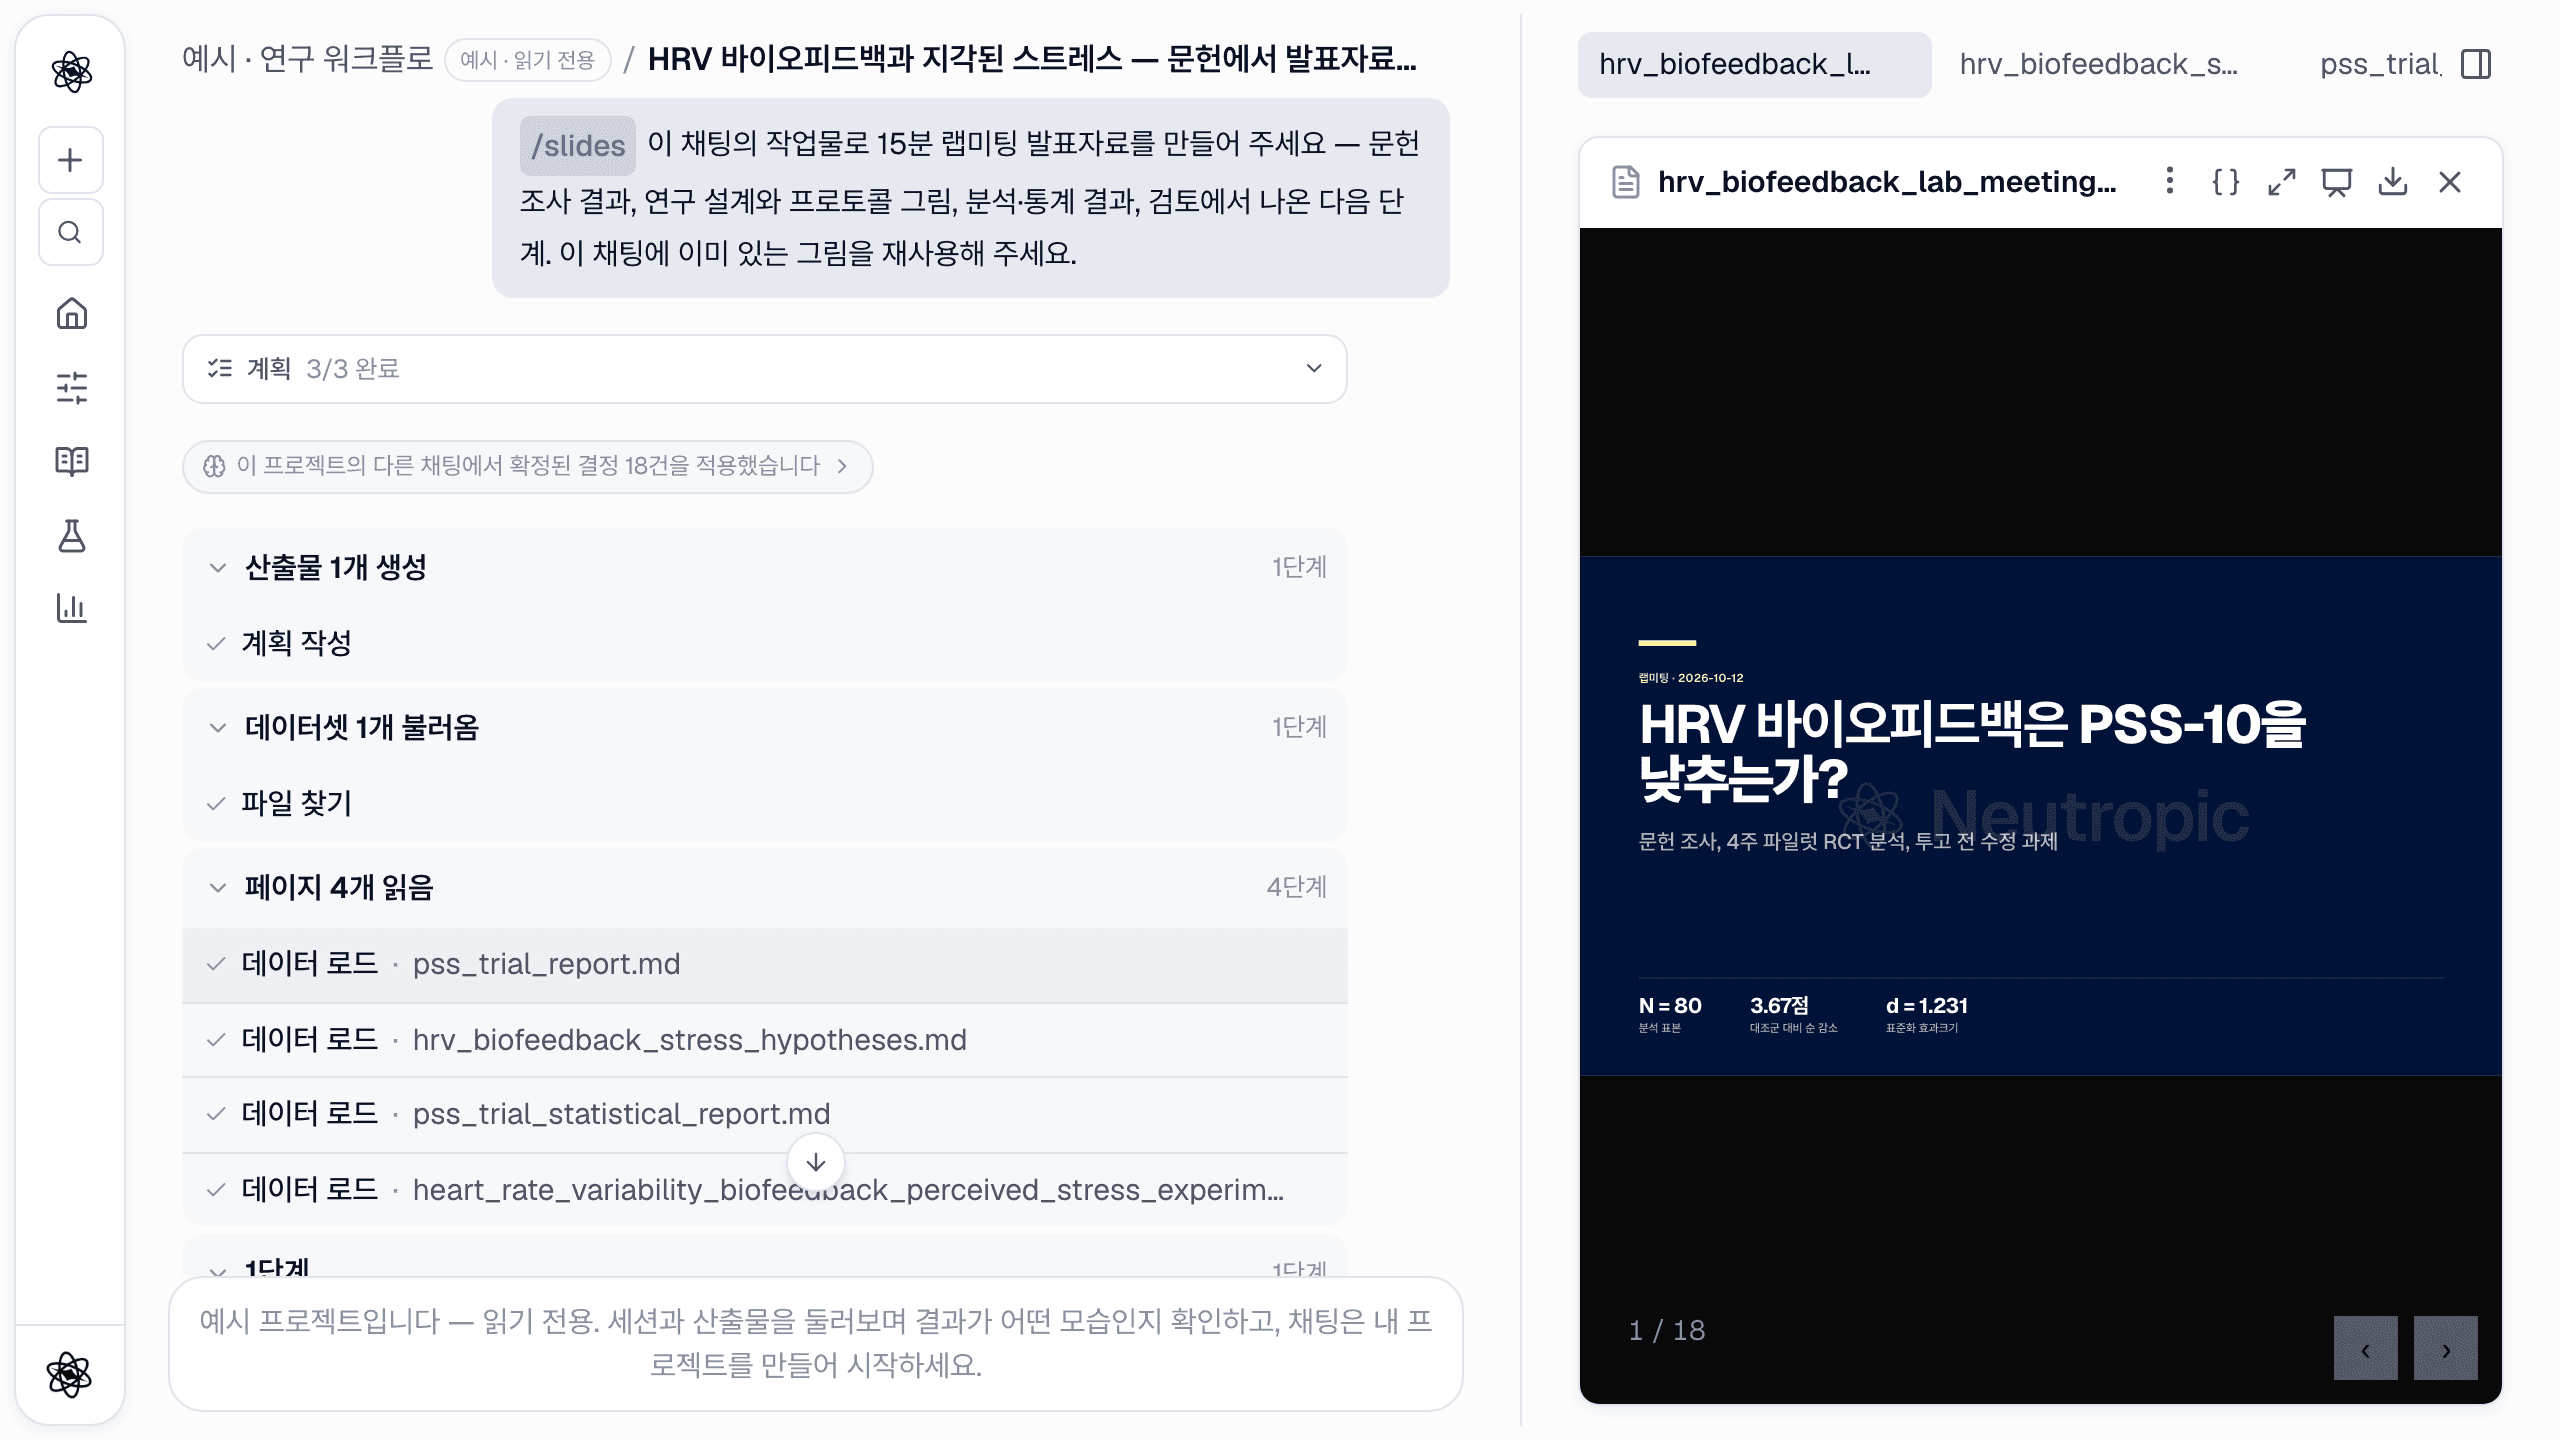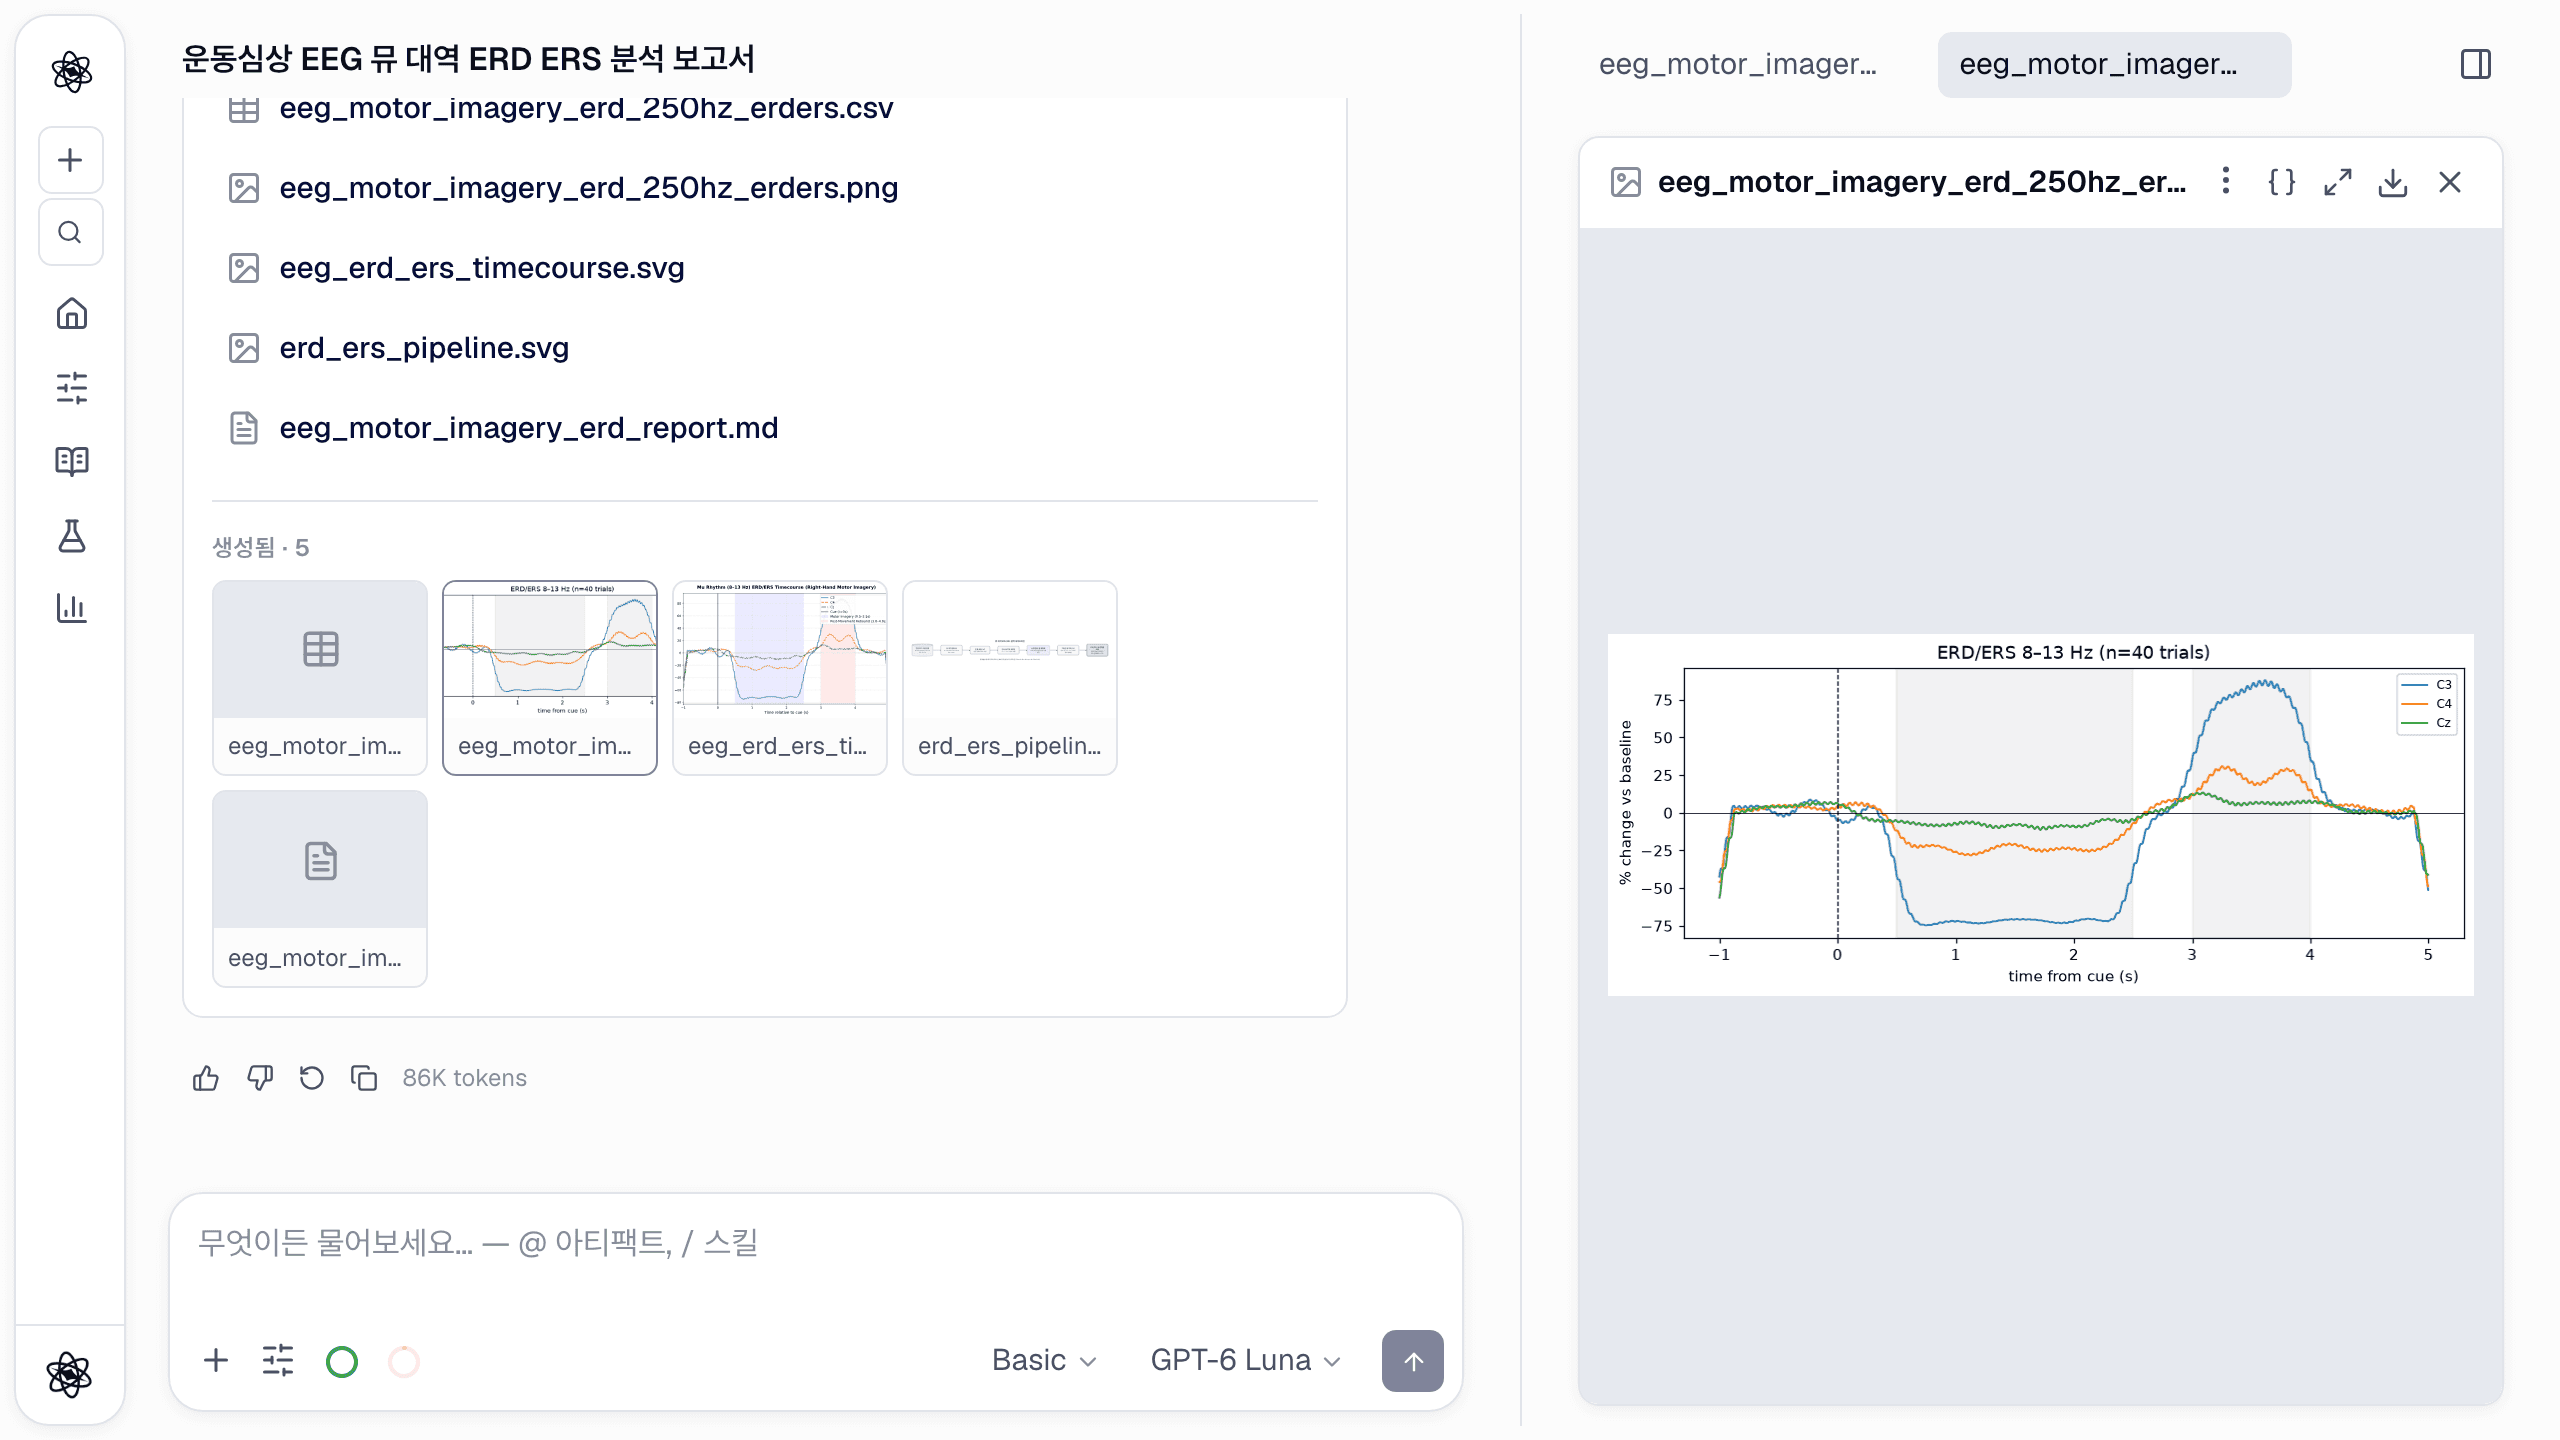
통계 소프트웨어는 옳은 질문이든 아니든 거의 무엇이든 요청하는 대로 실행합니다. 뉴트로픽의 일은 다릅니다. 설계와 데이터에 맞는 모형을 실행하고, 그것이 옳았음을 두 번 증명하는 것. 시험 데이터가 이미 로드된 같은 세션의 이 단계입니다.
1단계 — 검정이 아니라 질문을 하기
비교와 보고받고 싶은 것을 설명하면 에이전트가 방법을 고릅니다. 재업로드는 없습니다 — 파일은 이미 세션에 있습니다.
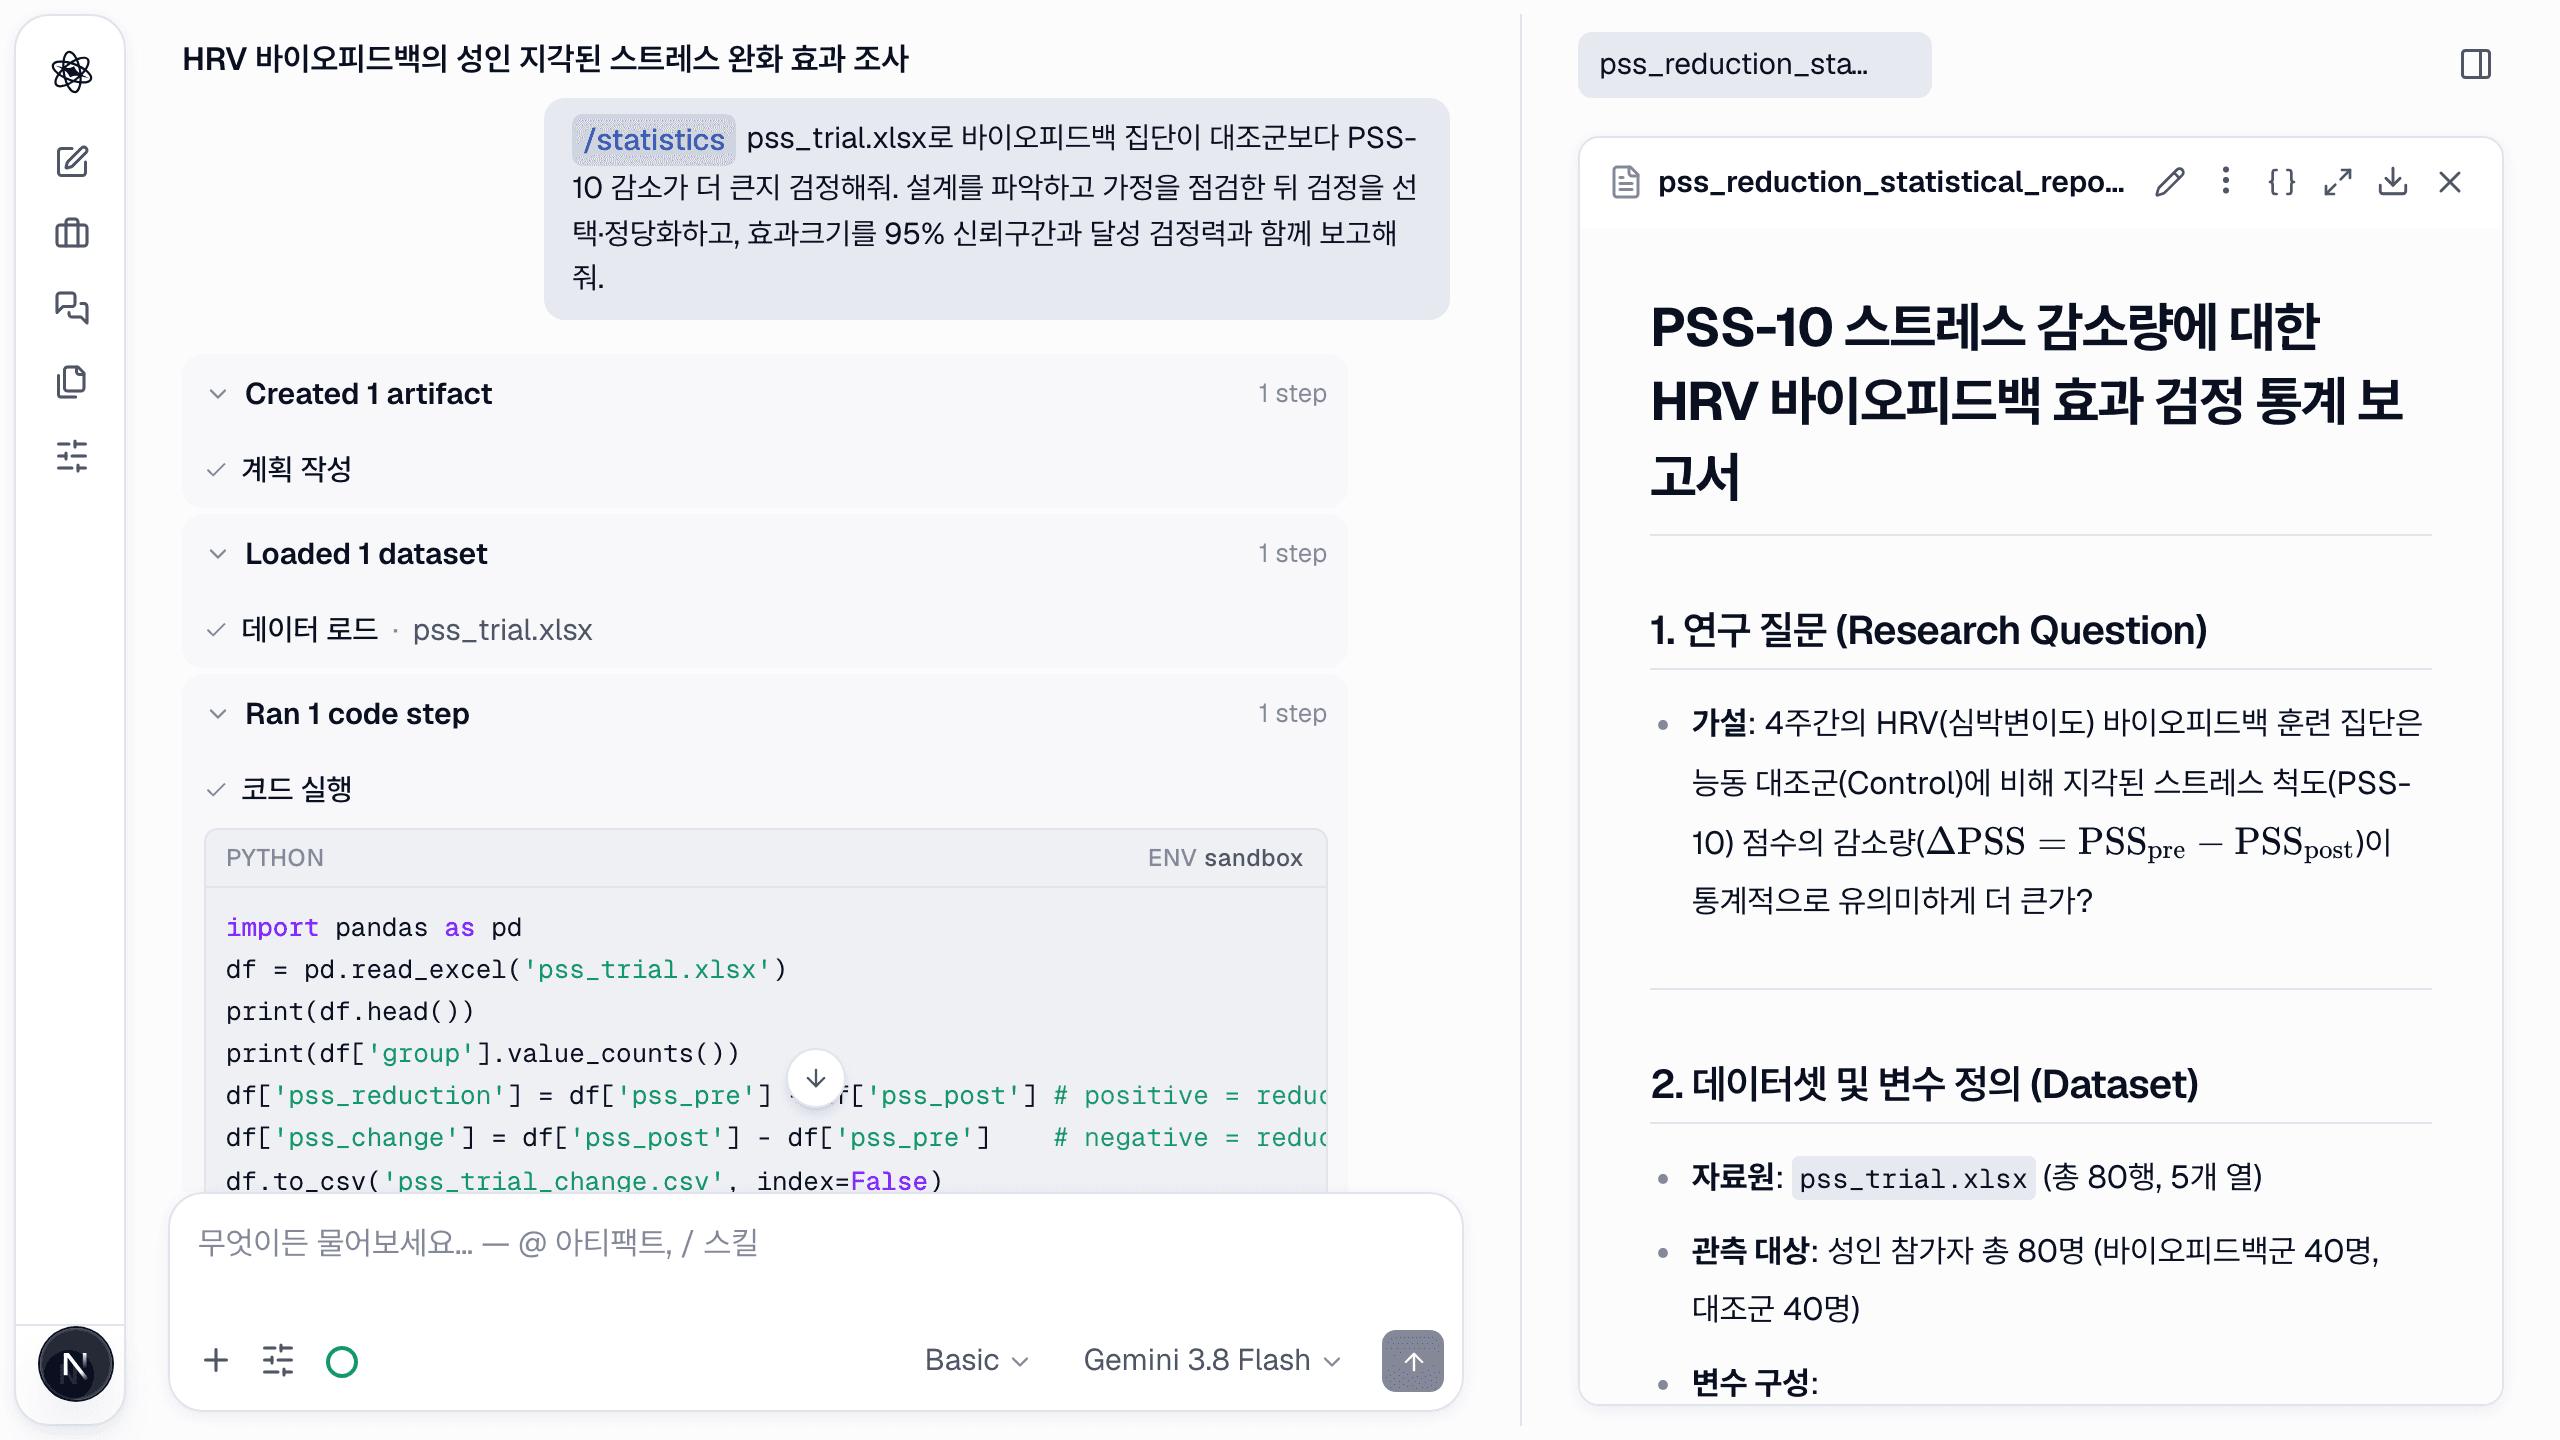
/statistics Using pss_trial.xlsx, test whether the biofeedback group shows a larger PSS-10 reduction than control. Check assumptions, choose the appropriate test, and report the effect size with a 95% CI and achieved power.
2단계 — 모형은 설계를 따릅니다
에이전트는 설계(독립 두 집단, 사전/사후)를 파악하고 정규성과 분산을 점검한 뒤에야 검정을 고릅니다: Student's t와 나란한 Welch's t, 그리고 기저를 보정한 ANCOVA. 코드는 샌드박스에서 돌고 결과에 붙어 있습니다. 심리측정과 현대적 모형화는 부가 기능이 아니라 기본입니다:
- 적합도 지수를 인쇄만 하지 않고 해석하는 요인분석(EFA·CFA)과 SEM.
- 알파와 오메가로서의 신뢰도, 차이가 중요할 때 그 차이를 설명.
- 내포·종단 데이터를 위한 혼합효과 모형, 무선효과 구조를 정당화.
- 작은 표본이나 사전 지식이 요구할 때 베이지안 추정.
3단계 — p값만이 아니라 불확실성이 붙은 효과
결과에는 심사자가 요구할 모든 것이 따라옵니다: 95% CI가 붙은 Cohen's d = 1.23, Hedges' g, ANCOVA의 부분 η², 달성 검정력, 그리고 설계가 80%·90% 검정력으로 탐지할 수 있었던 최소 효과.
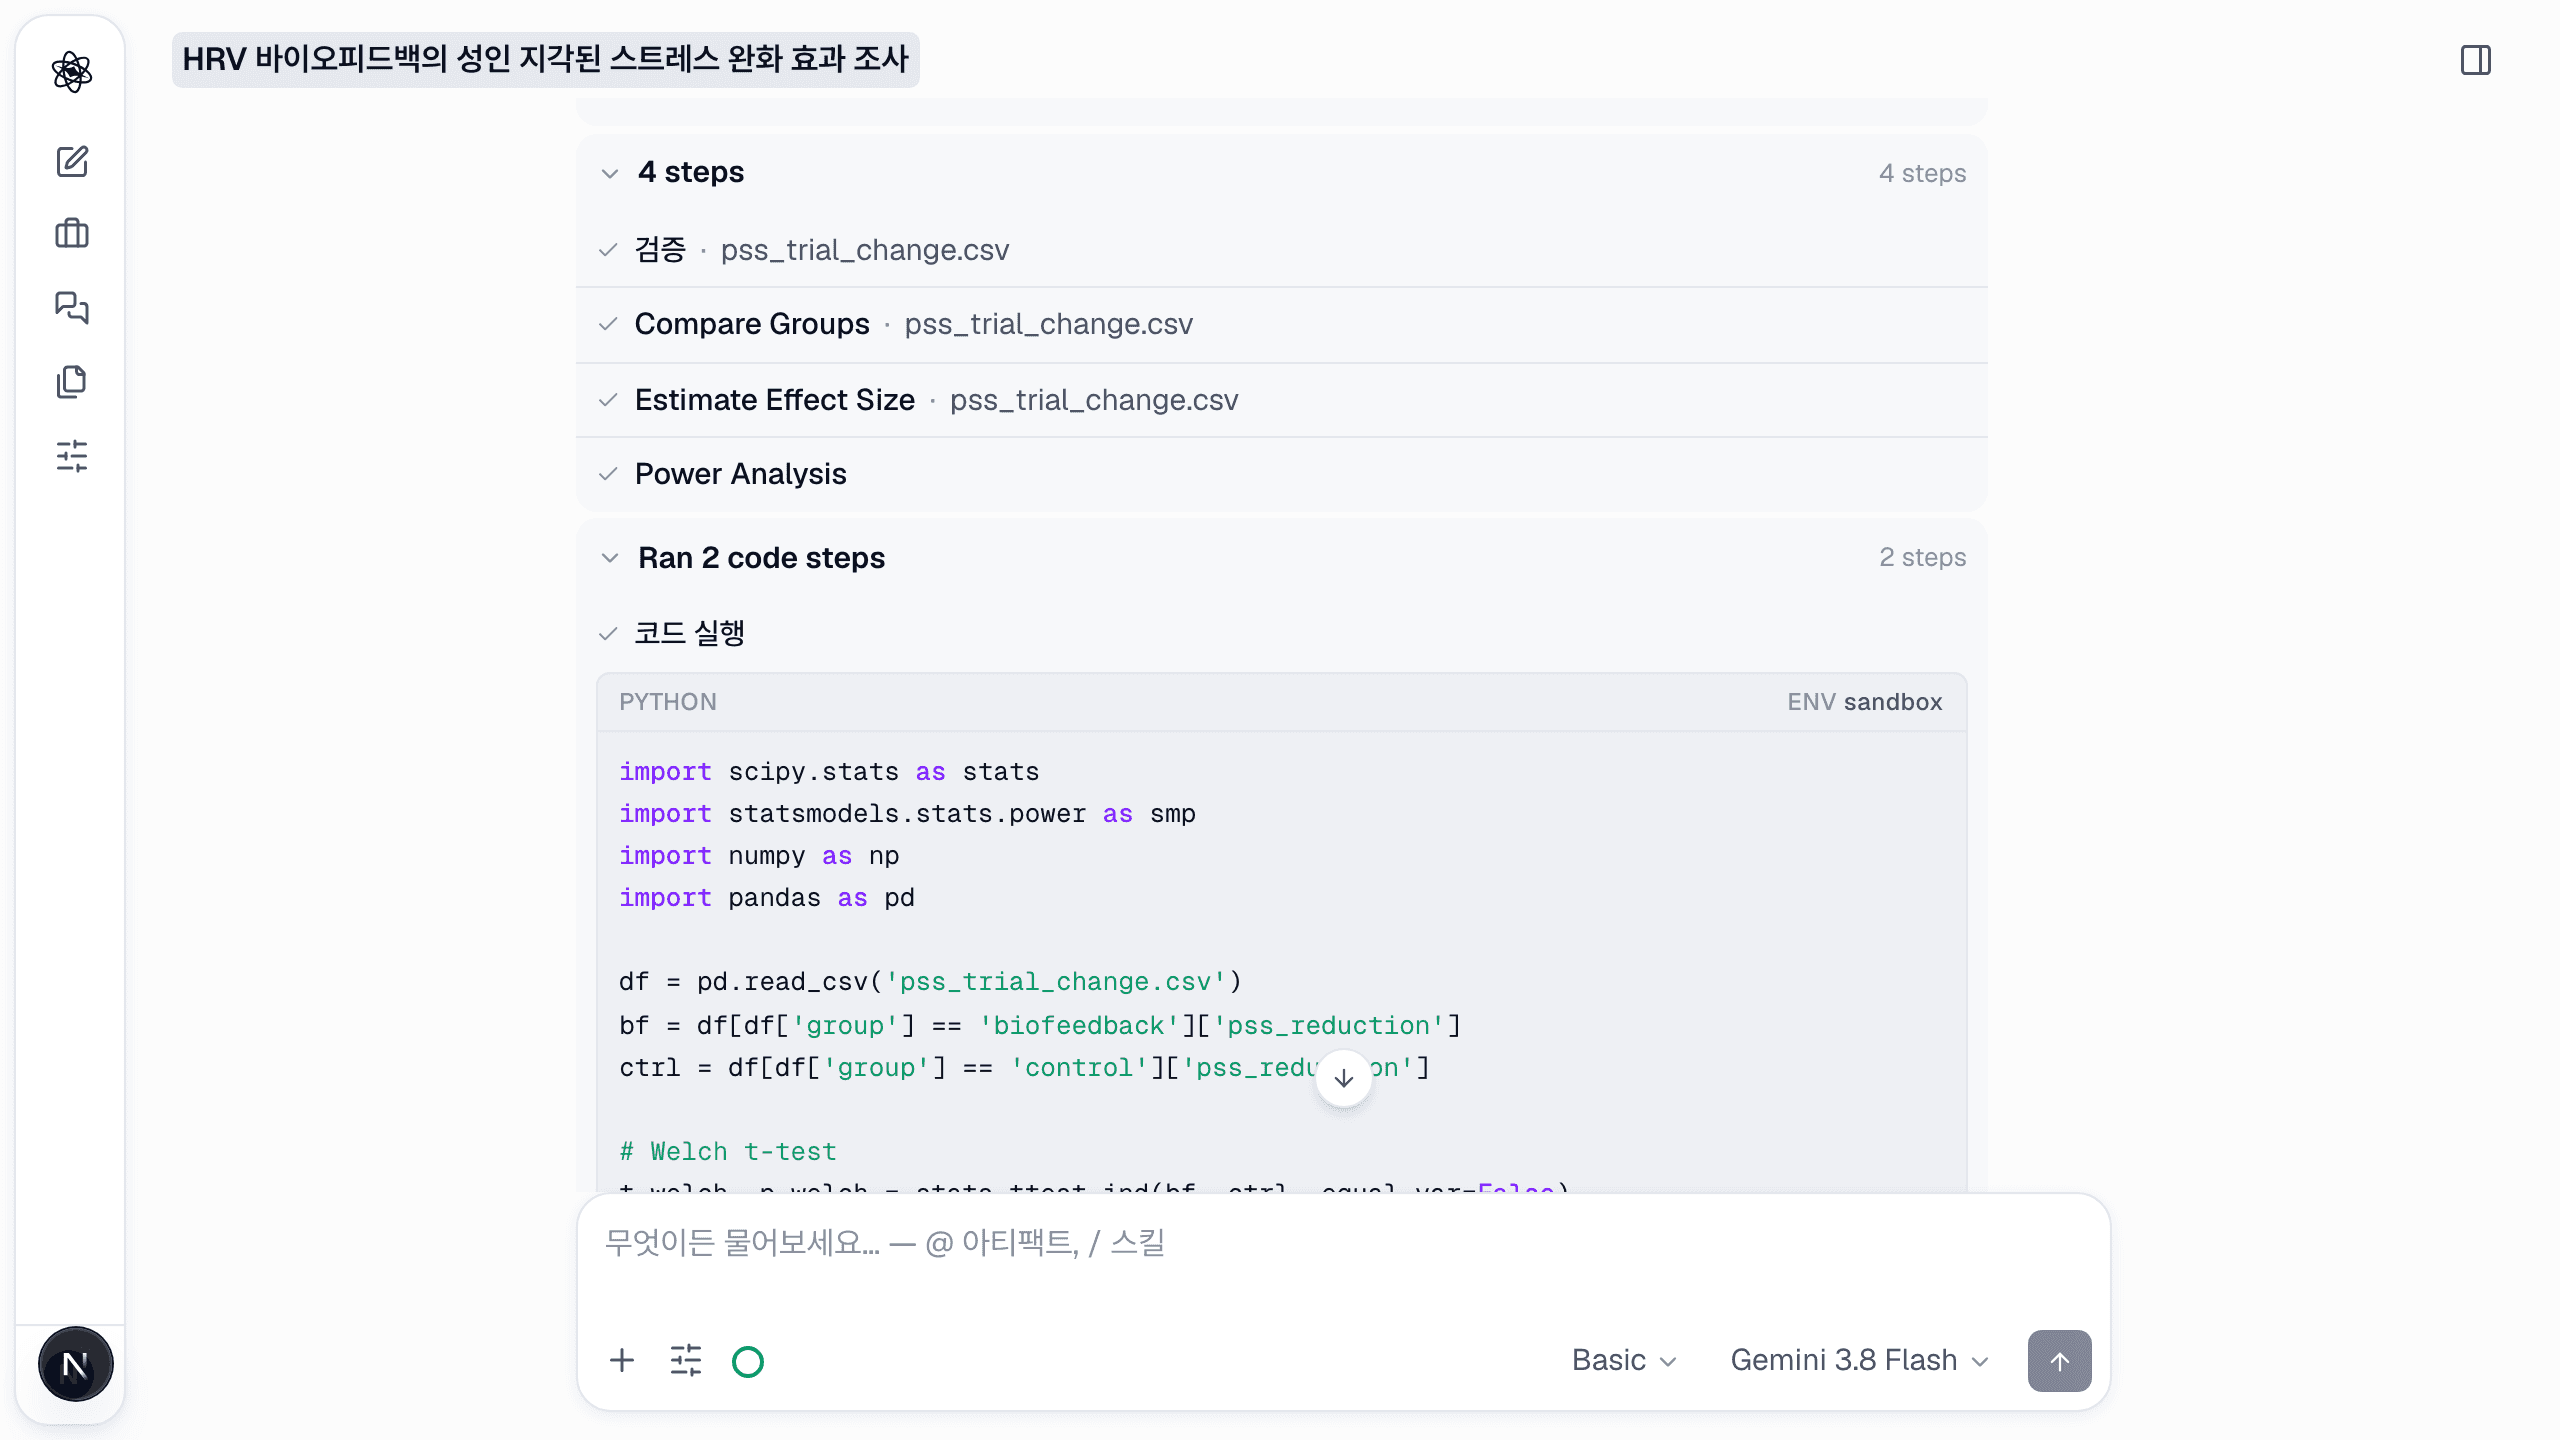
4단계 — 두 번 확인하는 가정
모든 분석은 두 에이전트를 거칩니다. 생성 에이전트가 가정 점검과 함께 모형을 돌리고, Deep 수준에서는 독립 검토 에이전트가 결과가 리포트에 도달하기 전에 그것을 깨뜨리려 합니다 — 가정 위반, 다중비교 위험, 표본 크기 문제, p-해킹 징후. 불일치는 숨기지 않고 보여 줍니다.
5단계 — 단독으로 인용할 수 있는 리포트
통계 리포트는 데이터 리포트와 별도의 문서이므로 원고에서 둘을 독립적으로 인용할 수 있습니다 — 그리고 결과의 구조화 JSON 덕에 집필 단계가 숫자를 다시 타이핑하는 대신 인용합니다.
질문은 결코 "유의한가?"가 아닙니다. "꼼꼼한 심사자를 통과할까?"입니다 — 그 점검이 내장되어 있습니다.