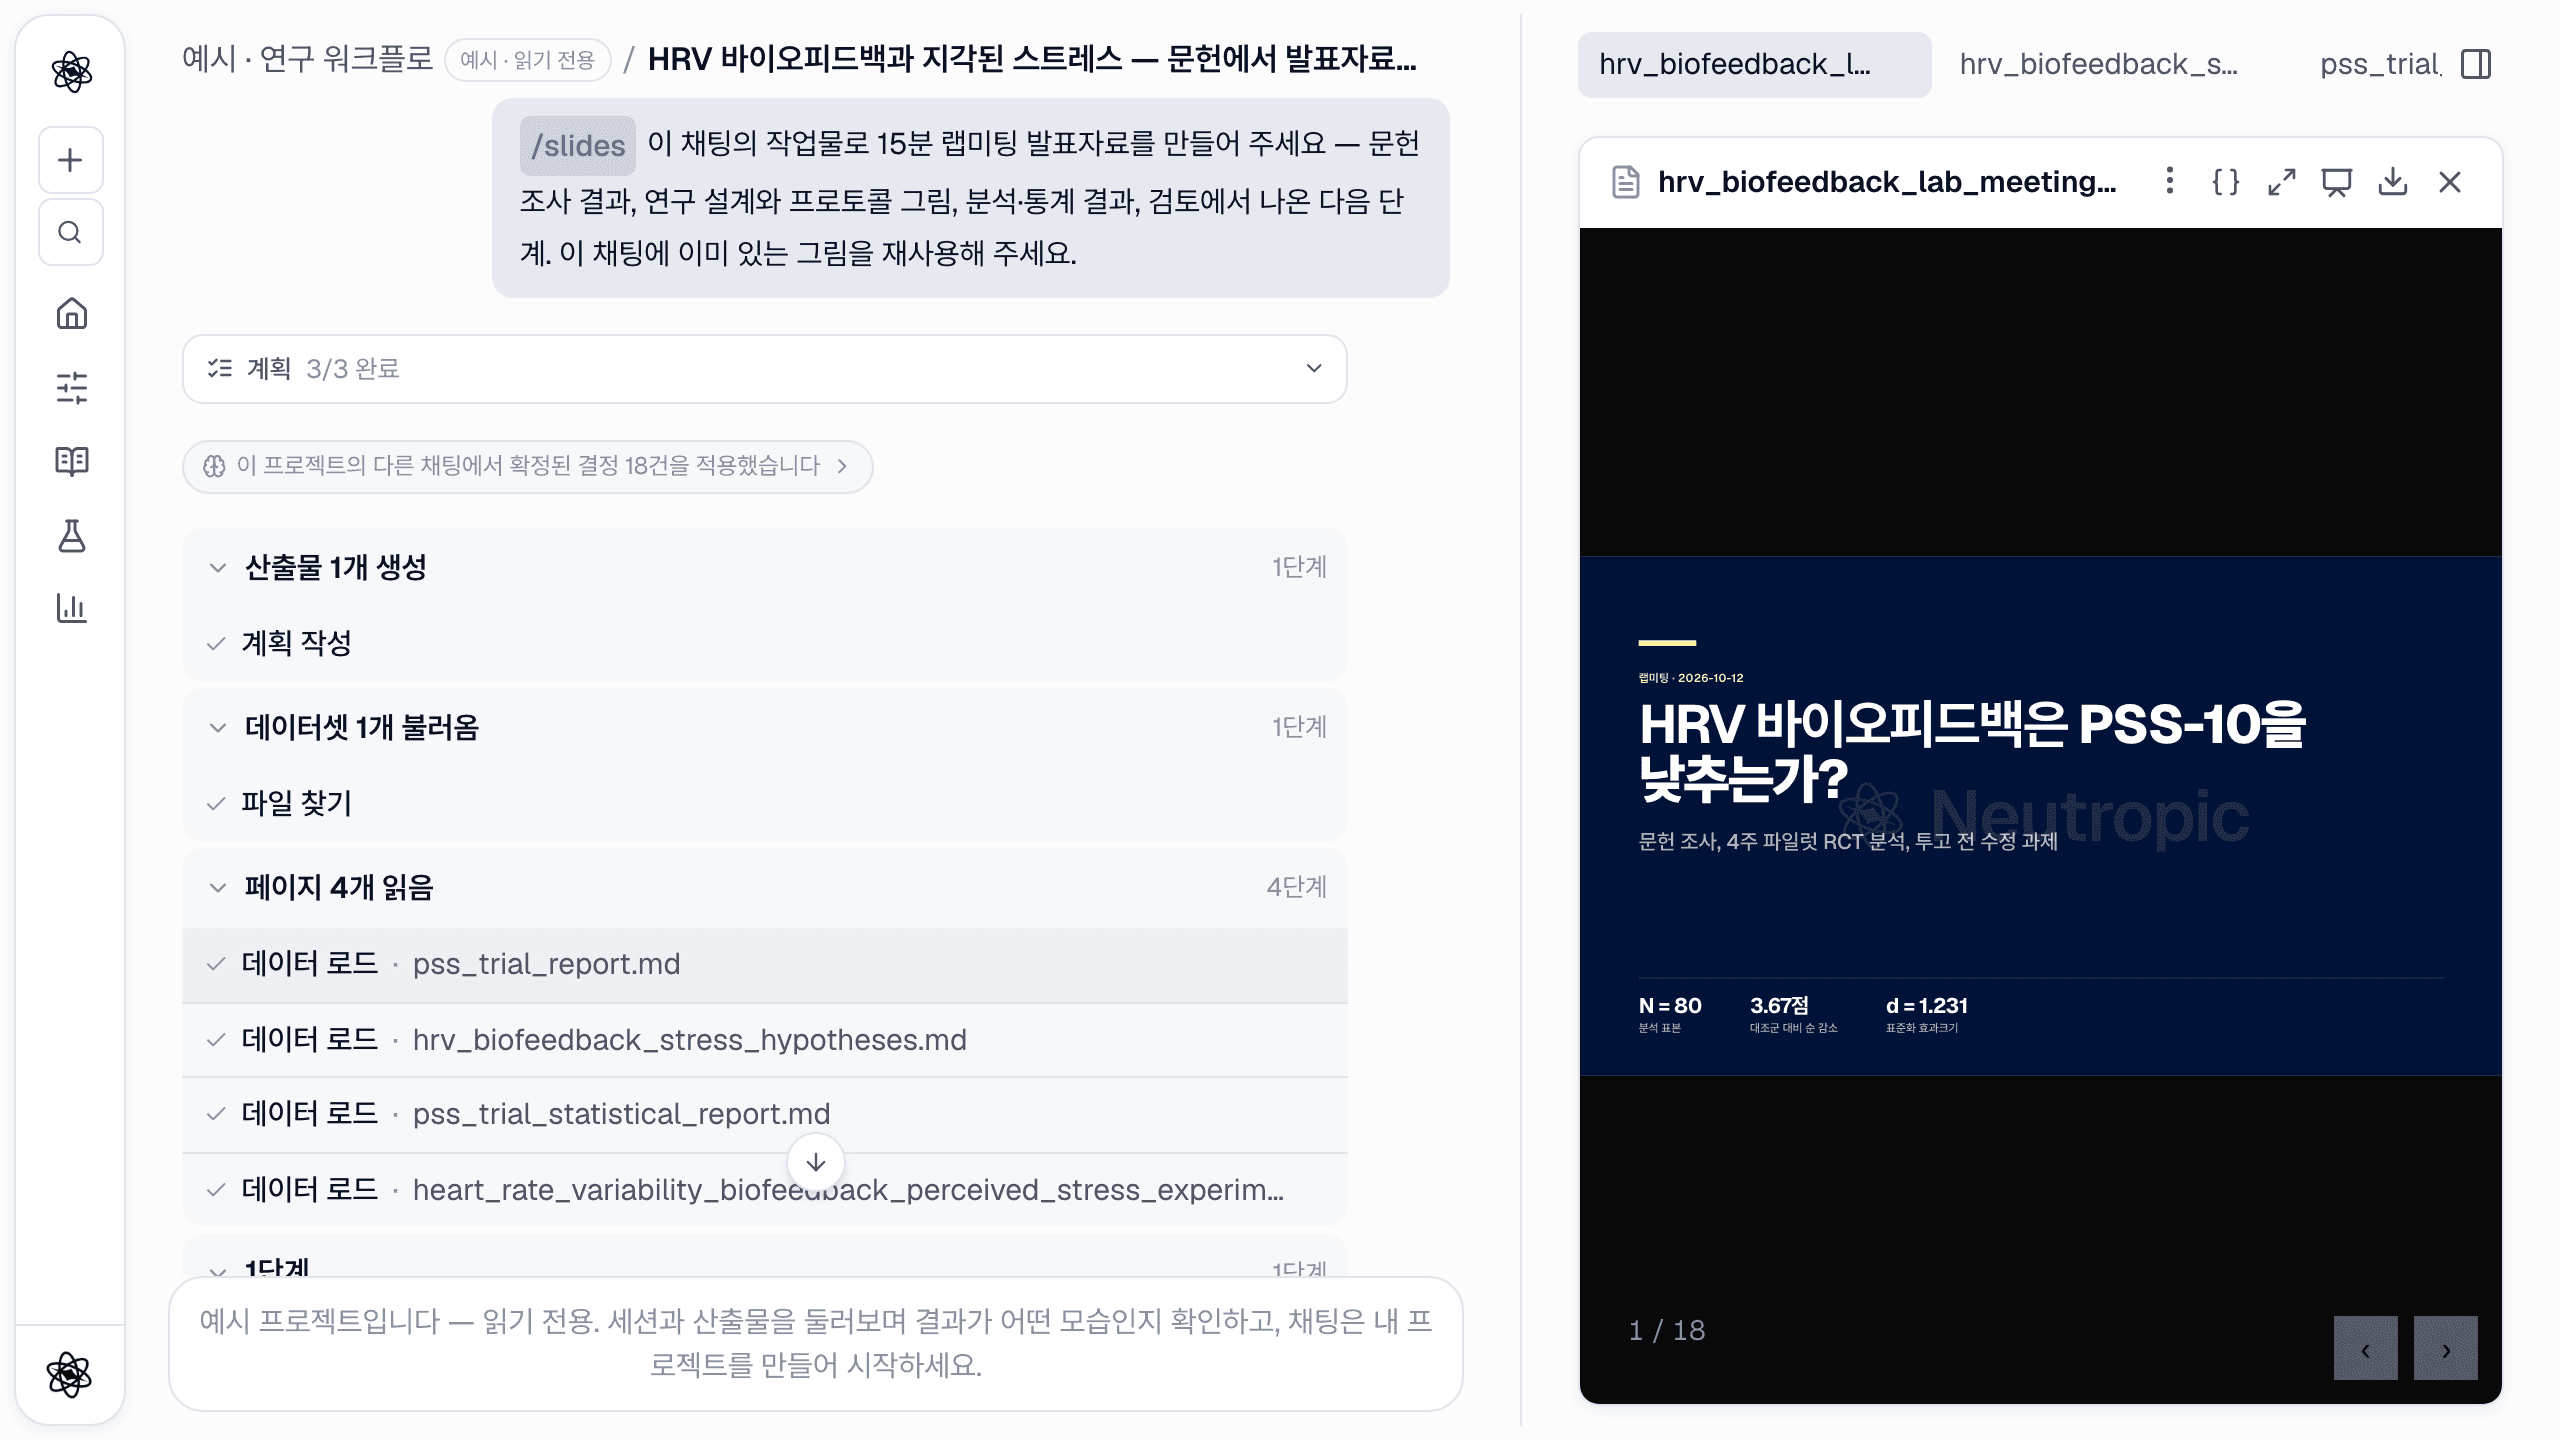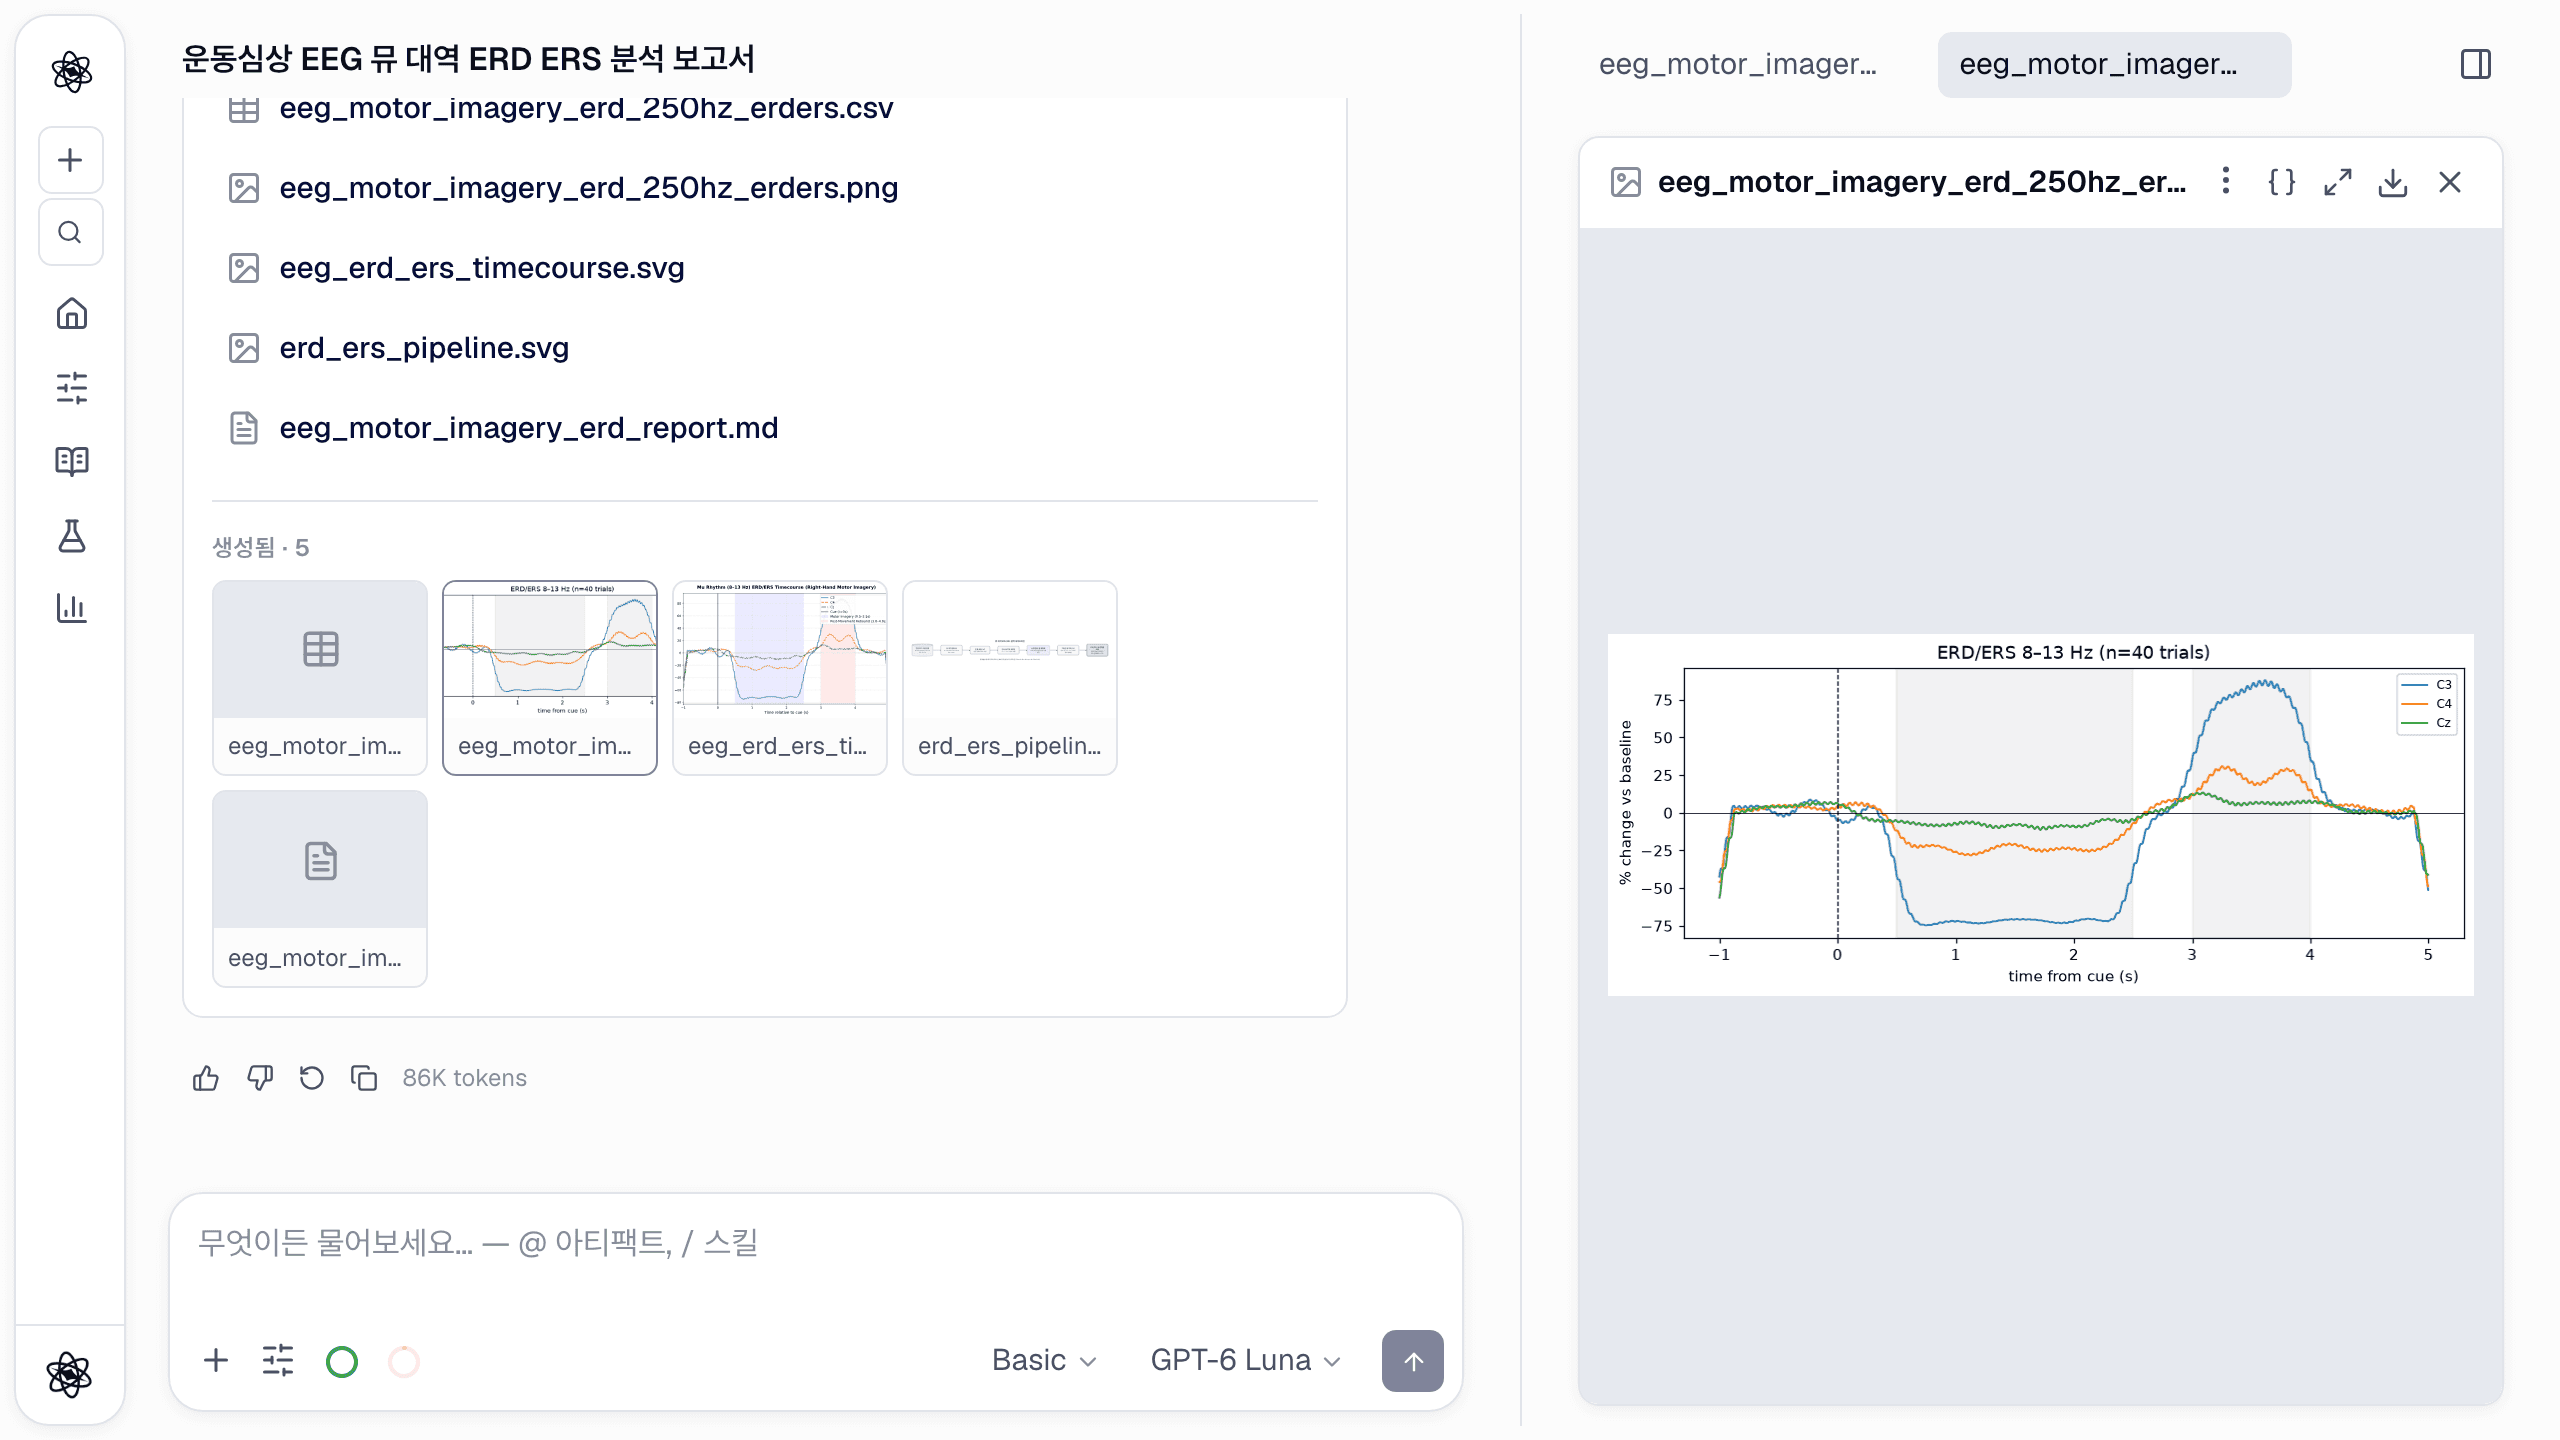
연구의 생애에서 가장 위험한 순간은 산문으로 옮겨지는 때입니다. 숫자가 다시 타이핑되고, 분석이 "마지막으로 한 번 더" 돌아가고, 원고가 자신이 설명한다고 주장하는 데이터에서 조용히 멀어집니다. 뉴트로픽은 실제로 일어난 일의 기록에서 논문을 초안함으로써 그 간극을 닫습니다. 같은 세션의 마지막 단계입니다.
1단계 — 필요한 섹션 요청하기
세션에는 이미 인용된 출처, 설계 문서, 분석·통계 리포트, 그림이 있습니다. 메시지 하나가 그것들을 원고 섹션으로 바꿉니다.
/paper-writing Write the Methods and Results sections of a manuscript from the literature, design, and analyses in this session, with every claim cited or tied to a session result.
2단계 — 스스로 쓰이는 방법 — 정직하게
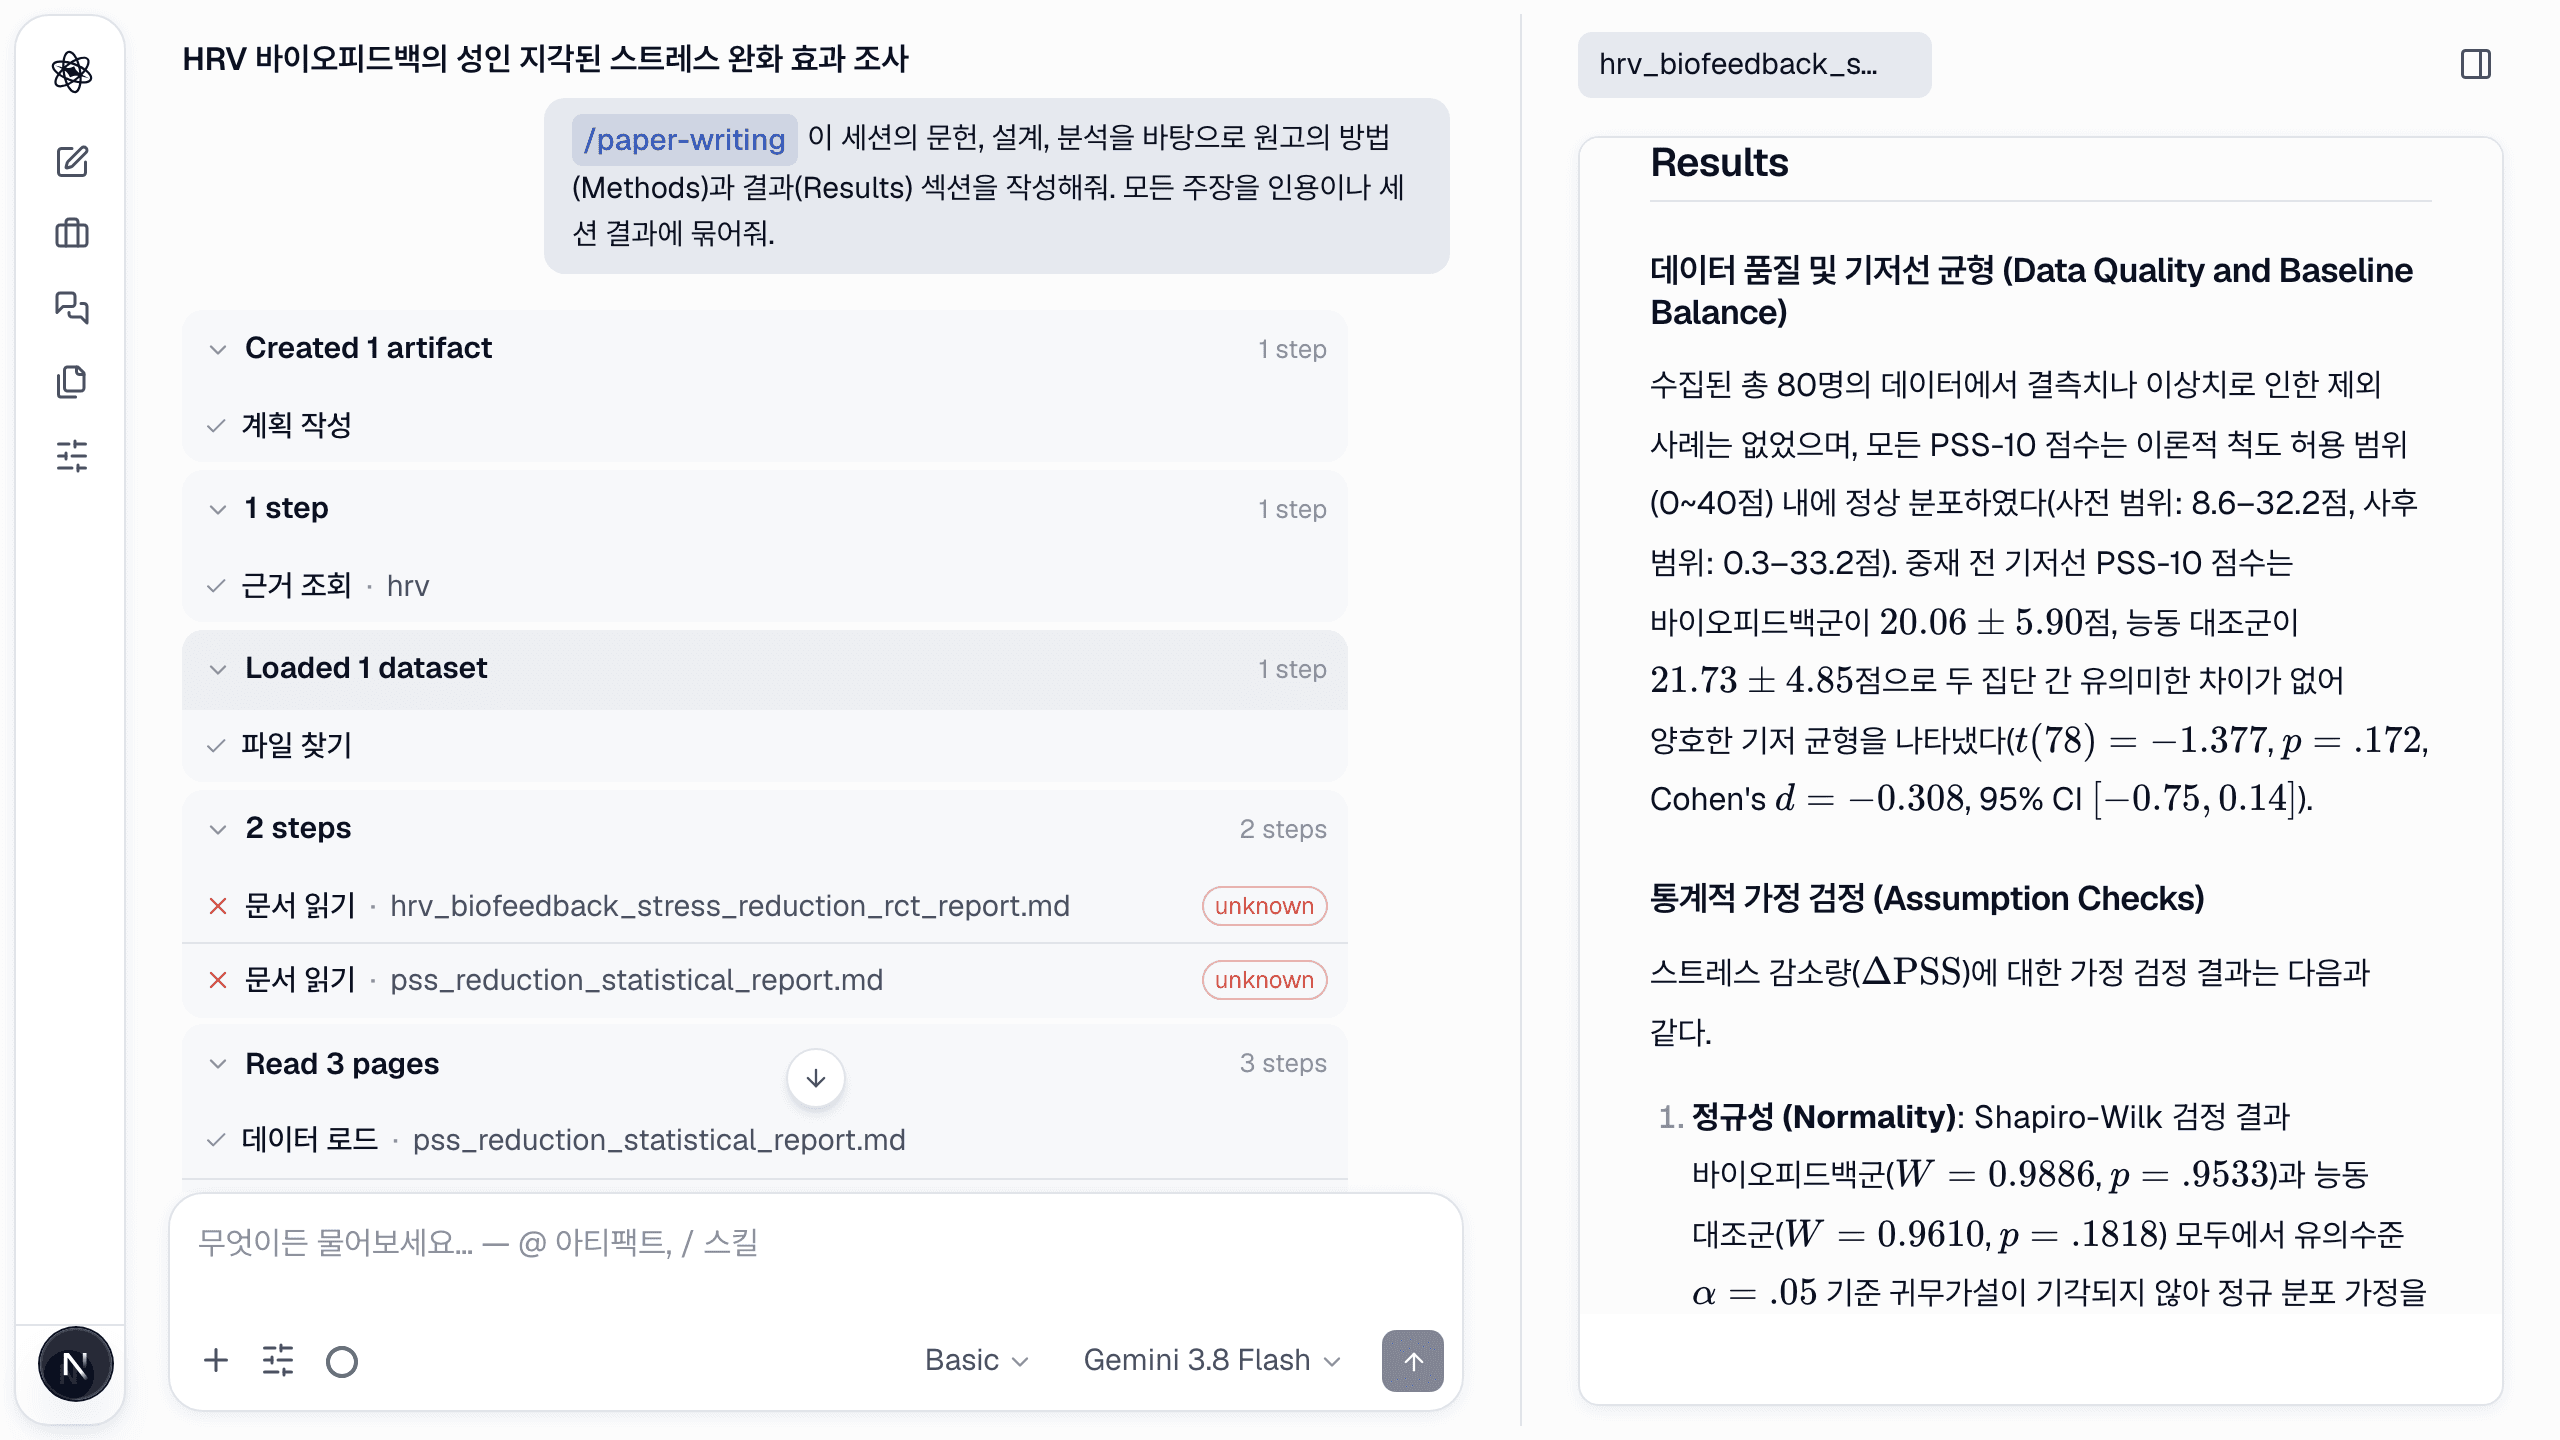
방법 섹션은 연구가 만든 산출물에서 조립됩니다: 설계 문서, 데이터 품질 리포트, 분석 계획과 그 이탈. 표본 크기, 배제 개수, 도구 세부는 기억이 아니라 기록에서 옵니다 — 초록, 방법, 표에 걸쳐 일관됩니다. 진행을 볼 수 있습니다: 집필 턴이 문장 하나를 쓰기 전에 설계 리포트, 통계 리포트, 문헌 리포트를 로드합니다.
3단계 — 분석에 묶인 결과
모든 경험적 문장이 세션 결과 — N = 80, t(78) = 5.51, Cohen's d = 1.23, ANCOVA F(1, 77) = 29.2 — 에 묶이고 모든 배경 주장이 문헌 리뷰의 [n] 인용에 묶입니다. 참고문헌 목록은 저장된 출처로부터 다시 구성되어 본문이 인용하는 것과 정확히 일치합니다.
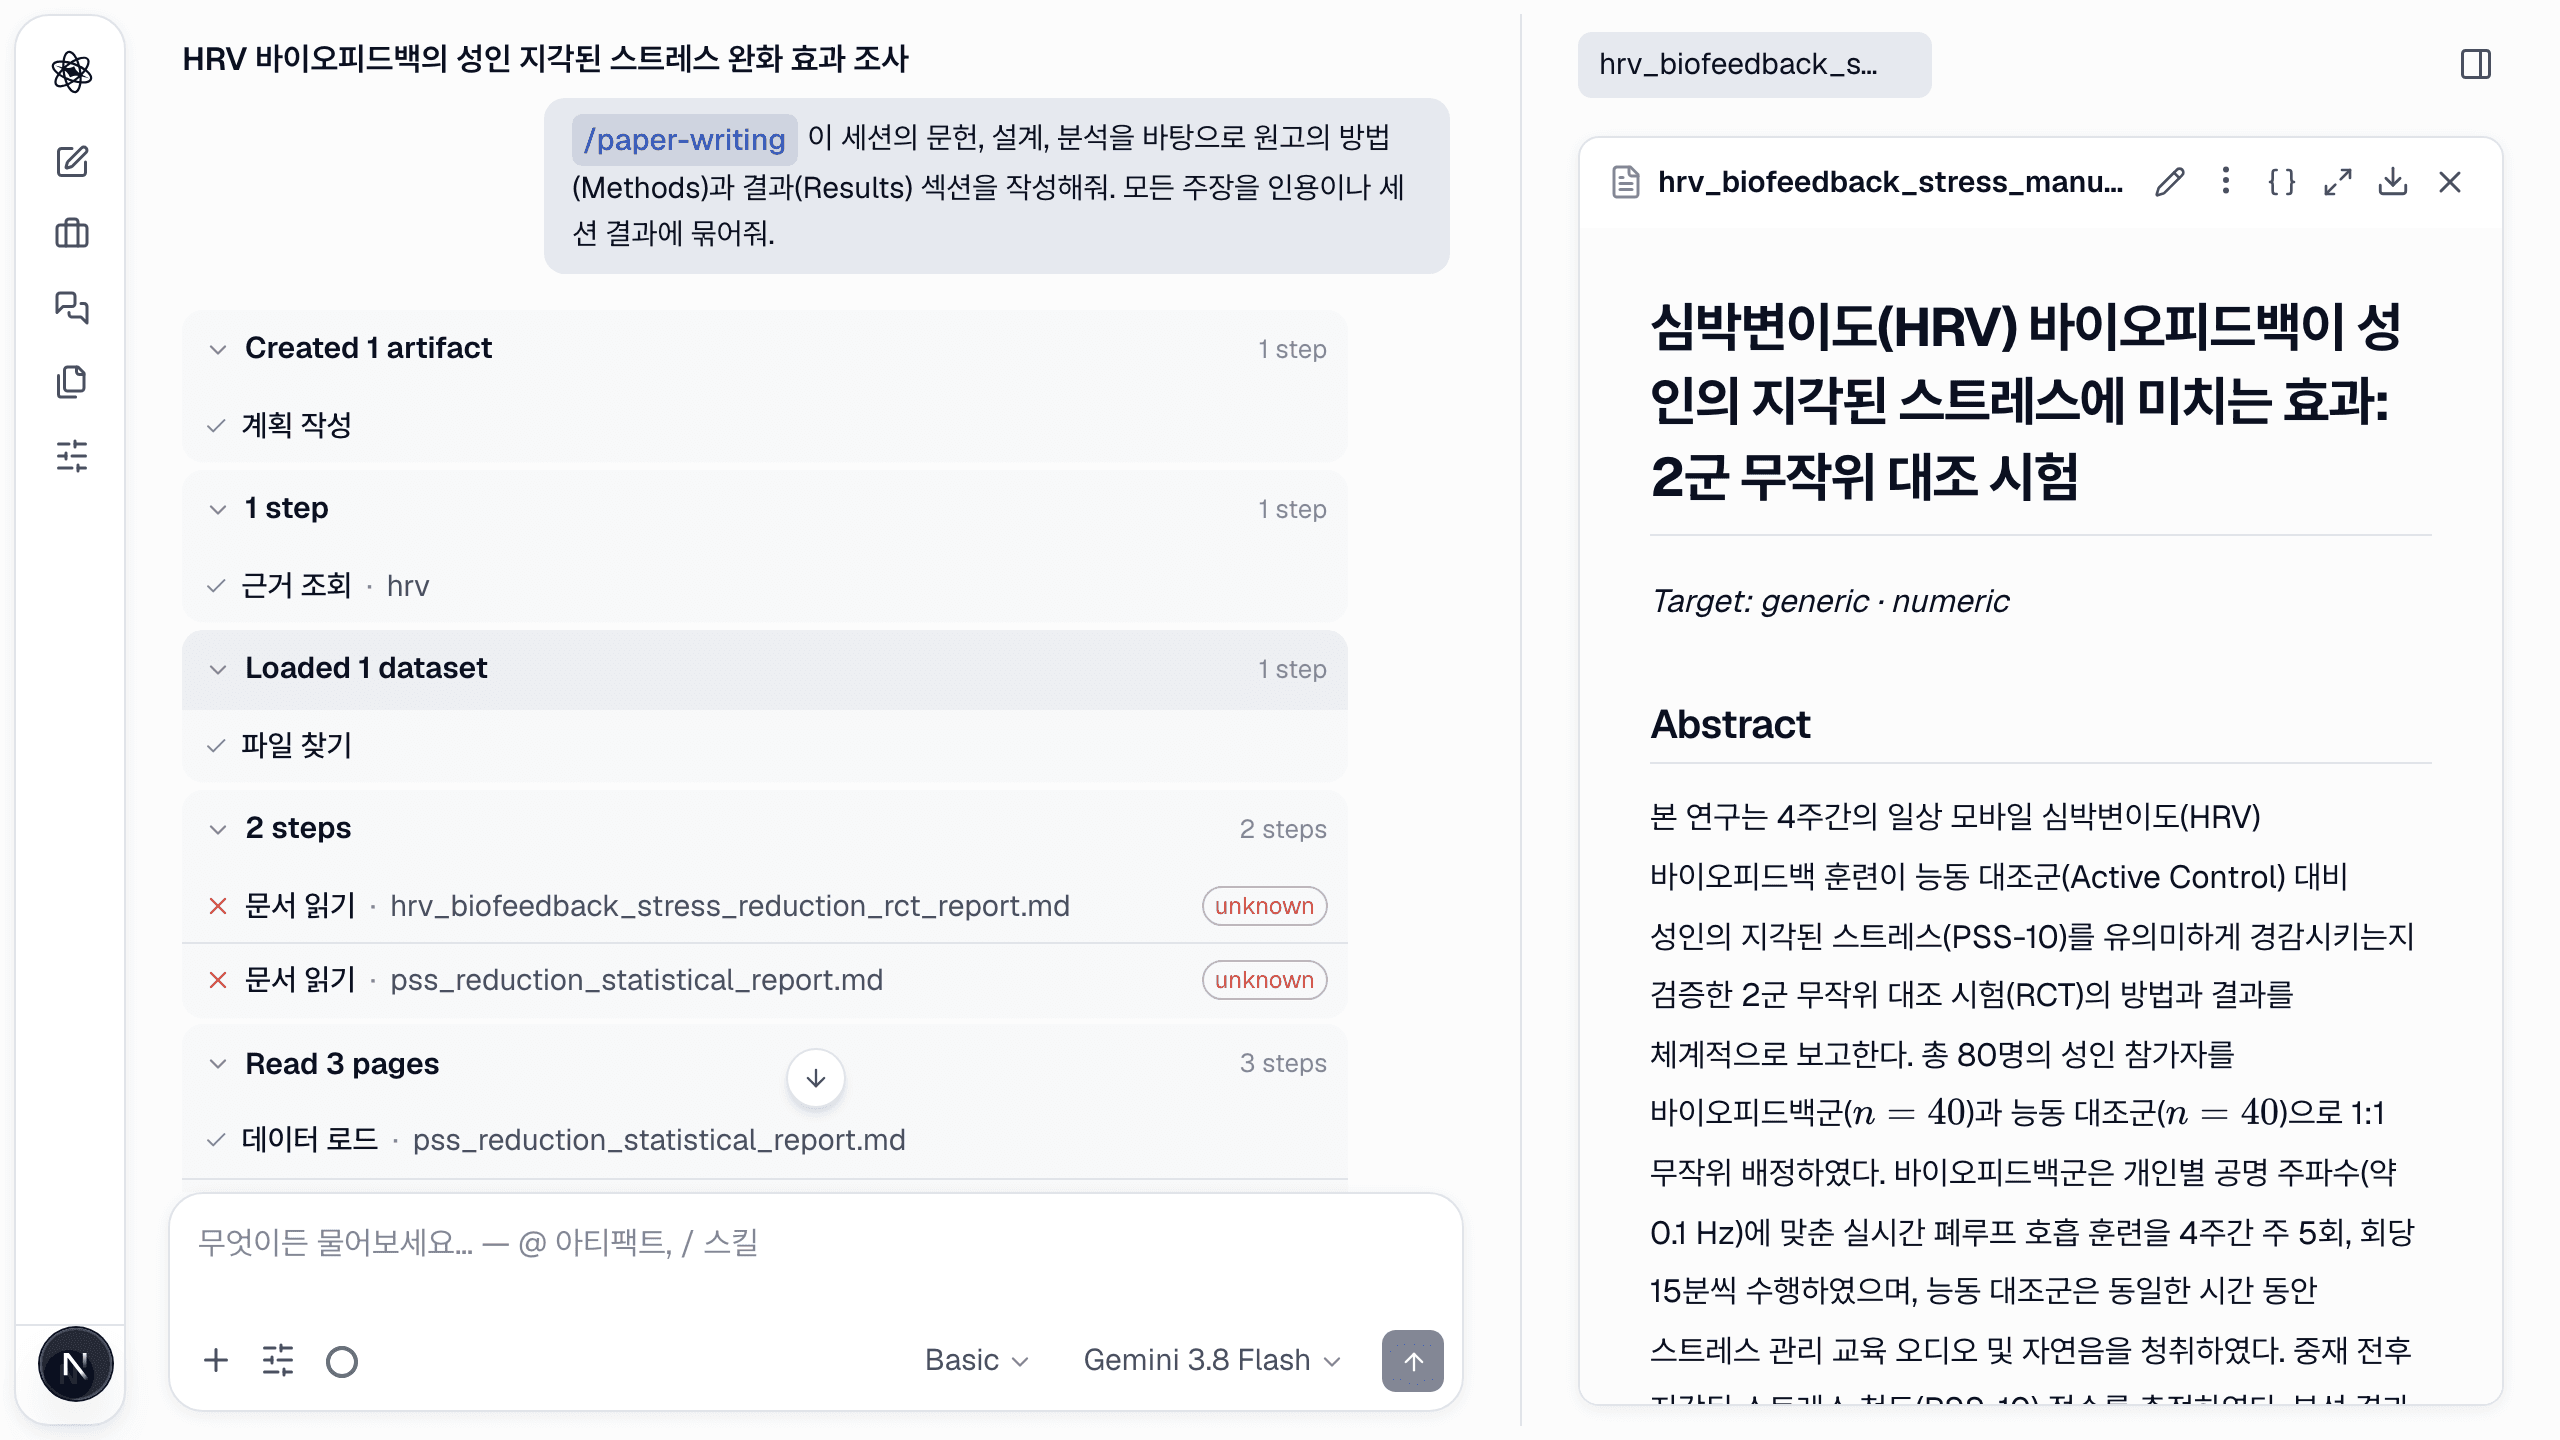

4단계 — 뒷받침되지 않는 주장은 얼버무리지 않고 공개
세션이 뒷받침할 수 없는 것은 소리 내어 말해집니다. 이 실행에서는 설계에는 있었지만 데이터셋에는 없는 이차 결과(안정 시 HRV, STAI, PSQI)가 둘러 쓰이는 대신 향후 엔드포인트로 표시됐습니다. 원고 점검이 뒷받침되지 않는 주장, 빠진 인용, 일치하지 않는 숫자를 투고 전에 고치도록 나열합니다.
5단계 — 제자리에서 개정하고, 검토받기
패널에서 문단을 선택해 변경을 설명하거나 다음으로 Discussion을 요청하세요. 주장–근거 맵은 텍스트와 함께 움직입니다: 문장을 편집하면 출처가 따라오고, 분석을 다시 돌리면 초안의 숫자가 같은 결과에서 갱신됩니다. 초안이 안정되면 /review를 돌리세요 — 심사자보다 먼저 통계를 다시 돌리고 인용을 검증하는 독립 검토자입니다.
논문은 연구와 별개의 문서가 아닙니다. 논문은 렌더링된 연구입니다 — 그리고 그것은 배관이 존재할 때만 참입니다.