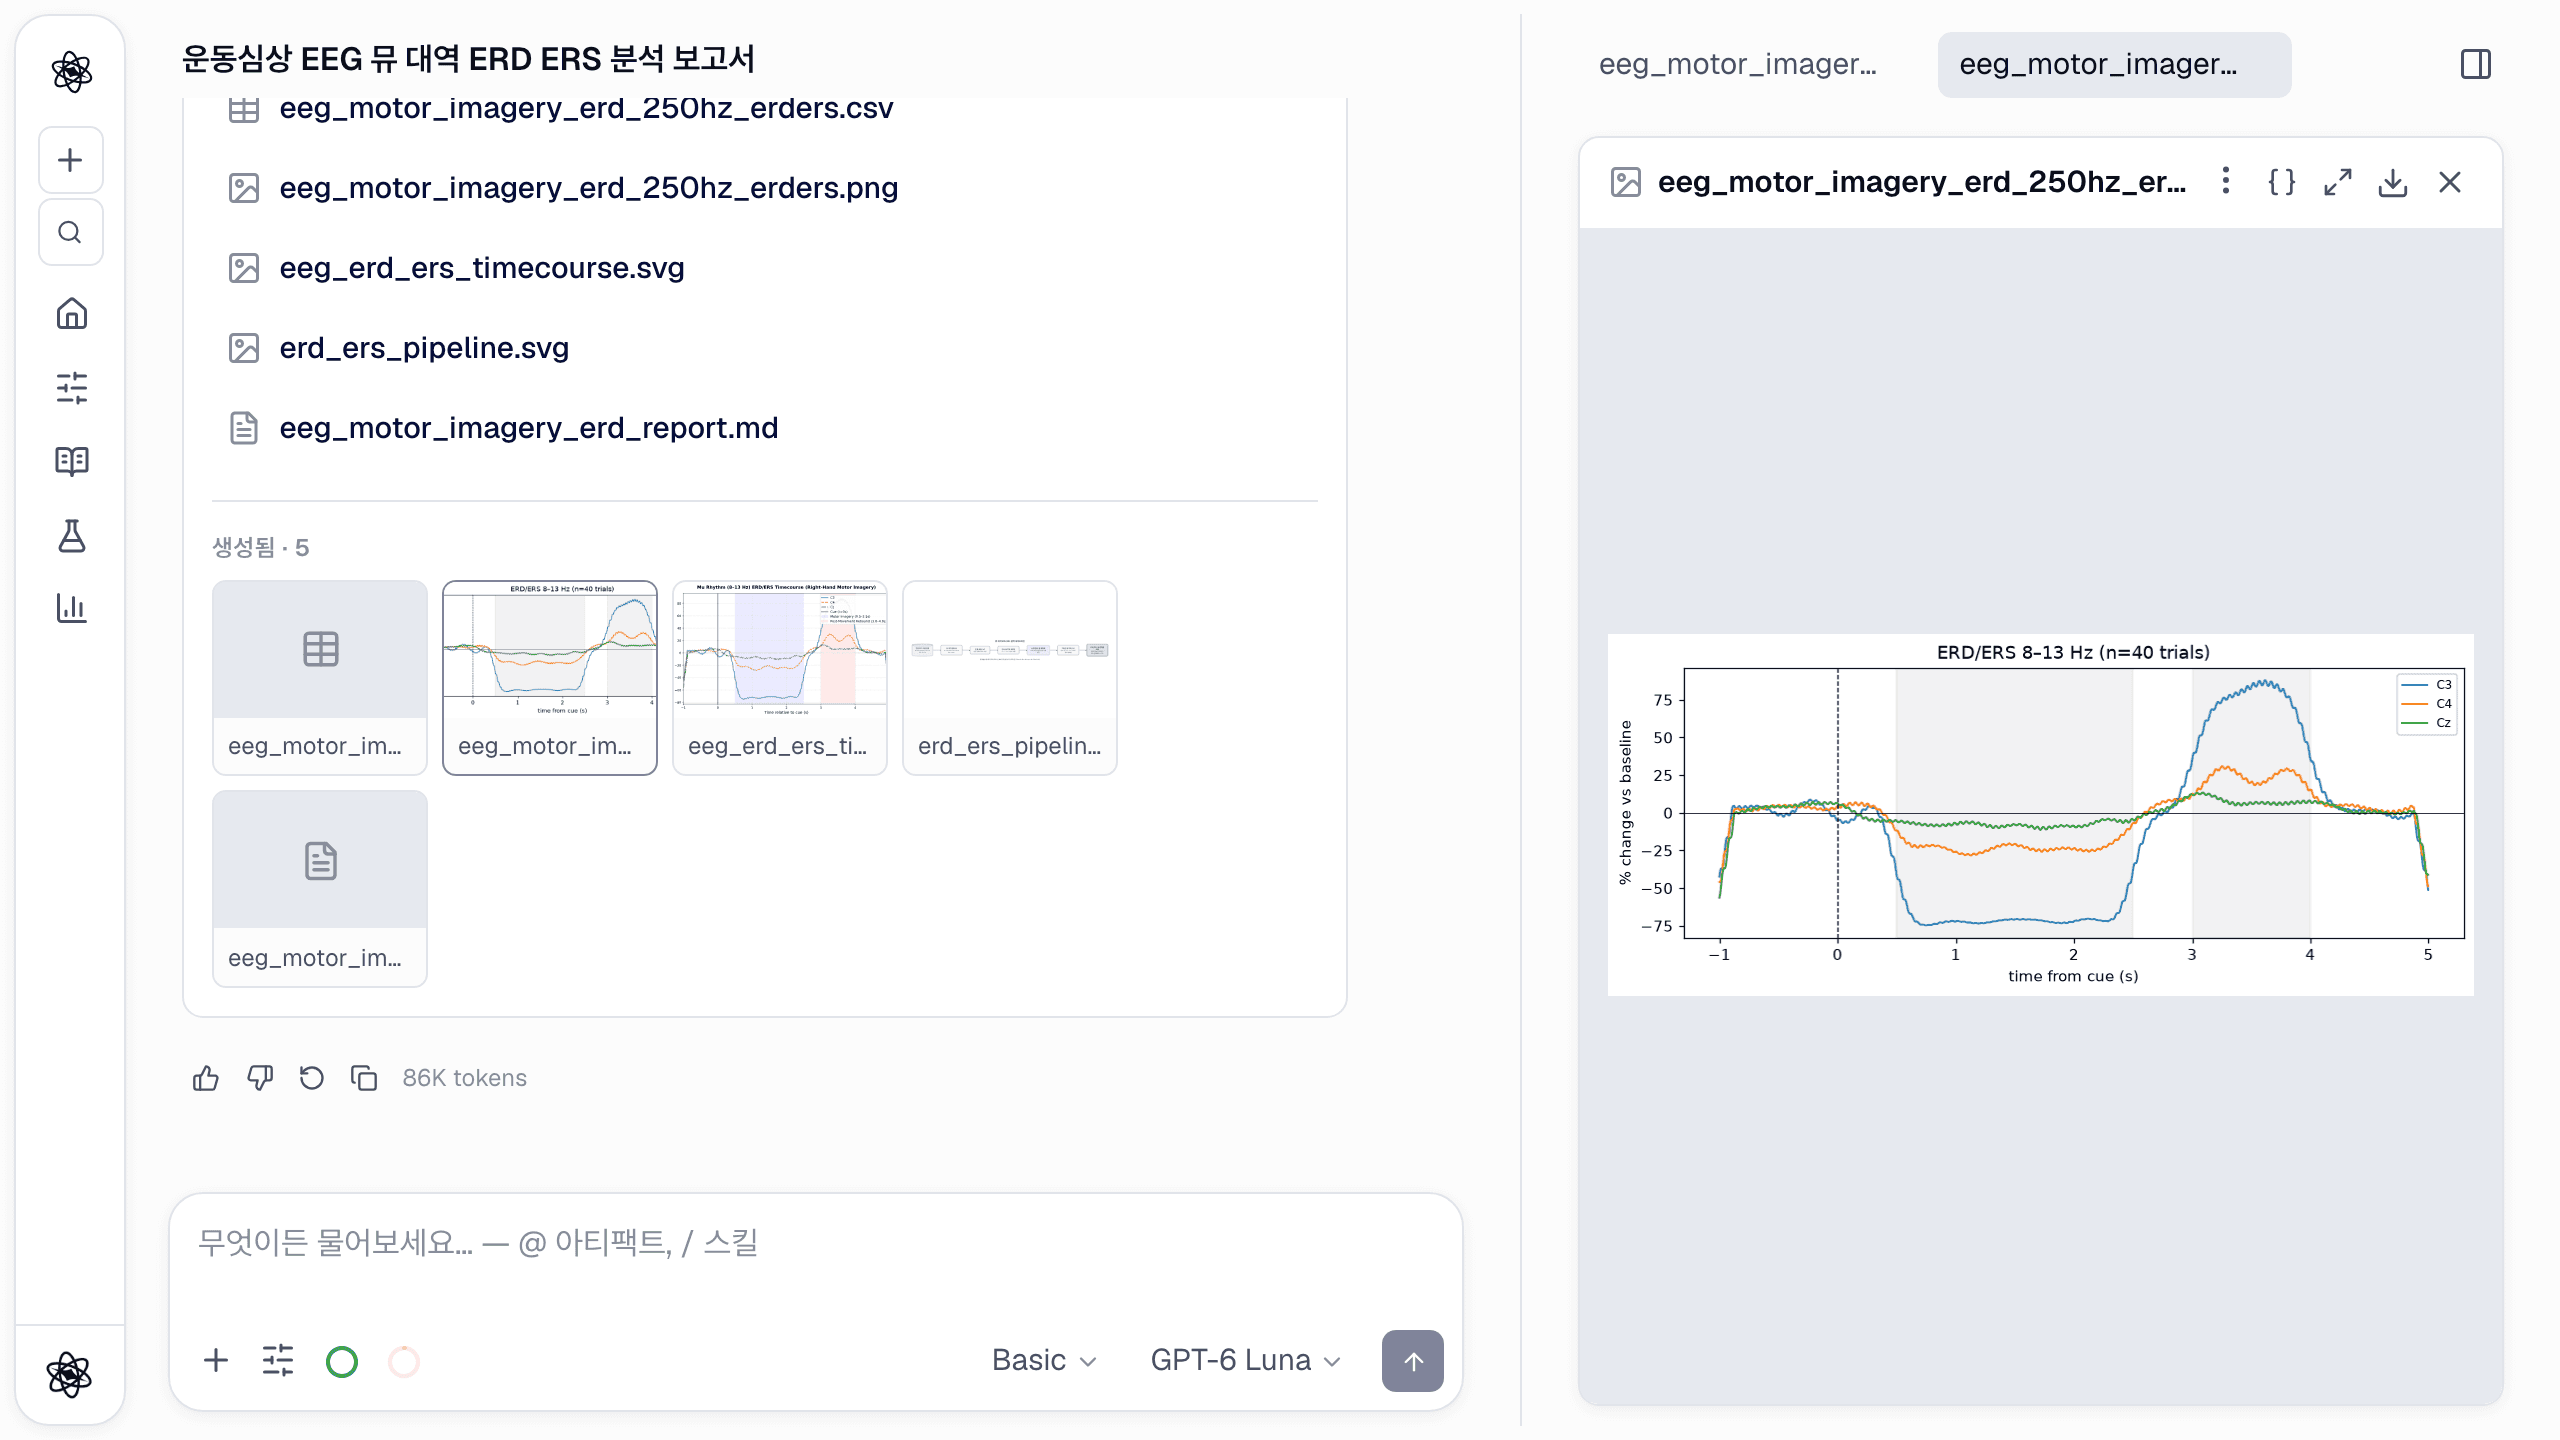
오디오는 연구에서 가장 풍부한 기록이면서 분석하기 가장 번거로운 자료이기도 합니다. 말은 전사 서비스나 연구보조원에게 가고, 목소리는 Praat 로 갑니다. 숫자는 스프레드시트로 옮겨졌다가 다시 R 이나 SPSS 로 넘어갑니다. 결과 절을 쓸 때쯤이면 피치 하한을 몇으로 뒀는지, 어떤 버전의 전사본을 코딩했는지 아무도 기억하지 못합니다.
뉴트로픽에서는 업로드부터 보고서까지 오디오가 한 세션 안에 머뭅니다. 이 글은 오디오 하나만 깊게 다룹니다. 무엇을 올릴 수 있는지, 도구마다 무엇을 재는지, 결과를 어떻게 읽는지, 한계는 어디인지 차례로 봅니다. EEG·오디오·영상을 한꺼번에 훑은 글은 스프레드시트 너머에 있습니다.
올릴 수 있는 파일
녹음 파일은 다른 파일처럼 채팅에 첨부하면 됩니다. 받는 오디오 형식은 .wav .mp3 .m4a .flac .ogg .aac .aiff 입니다. 전사는 영상(.mp4 .mov .webm 등)의 소리 트랙도 읽습니다. 업로드는 최대 1GB 까지 됩니다.
실제로 쓸 때 알아 두면 좋은 점:
- 음성 지표에는 WAV 가 가장 안전합니다. 전사는 위 형식을 모두 읽지만, 피치·음향 도구는 WAV 기준으로 문서화돼 있습니다. 음성 품질이 중요하면 압축 파일을 먼저 WAV 로 바꾸세요.
- 파일 하나에 화자 한 명이 가장 좋습니다. 음성 도구는 클립 전체를 요약합니다. 인터뷰에 두 사람 목소리가 있으면 피치 통계가 섞입니다(한계 절 참고).
- 녹음이 무엇인지 말해 주세요. "낭독 샘플", "반구조화 인터뷰, 참여자 P07", "사고 발화, 과제 3" 처럼 적으면 에이전트가 알맞은 단계를 고르고 보고서 문구도 정확해집니다.
뉴트로픽이 직접 돌리는 음성 전사
전사에는 OpenAI Whisper 의 오픈소스 구현인 faster-whisper 를 쓰며, 뉴트로픽 서버에서 직접 돌립니다. 오디오를 외부 전사 API 로 보내지 않습니다.
- 모델 크기.
tiny,base,small,medium중에서 고를 수 있습니다. 클수록 느리고 정확합니다. 또렷한 영어가 아니라면small이나medium을 요청하세요. - 언어. Whisper 가 언어를 감지하고 그 확률을 알려 줍니다. "한국어 음성입니다" 처럼 언어를 지정하면 감지를 건너뜁니다. 중국어는 간체로 나오도록 맞춰 둡니다.
- 타임스탬프가 붙은 구간. 구간마다 시작·끝 시각(초)이 있습니다. 무음은 음성 구간 검출(VAD) 필터로 걸러지므로, 긴 휴지는 구간 사이의 빈틈으로 드러납니다.
- 분량과 발화 속도. 영어·한국어처럼 띄어 쓰는 언어는 단어 수와 분당 단어 수(WPM)를 줍니다. 띄어쓰기가 없는 중국어·일본어는 글자 수와 분당 글자 수(CPM)로 셉니다. (오늘 전까지 두 언어는 "1 words", "2 words" 로 표시됐는데, 이 문제는 고쳐졌습니다.)
결과는 <이름>_transcript.md 아티팩트로 저장됩니다. 맨 위에 모델·언어·길이·분량이 있고, 그 아래 전문과 구간 표가 이어집니다.
/analyze interview_P07.m4a 는 한국어 반구조화 인터뷰입니다. Whisper small 모델로 타임스탬프와 함께 전사하고, 전사문은 한 글자도 바꾸지 말고 그대로 두세요.
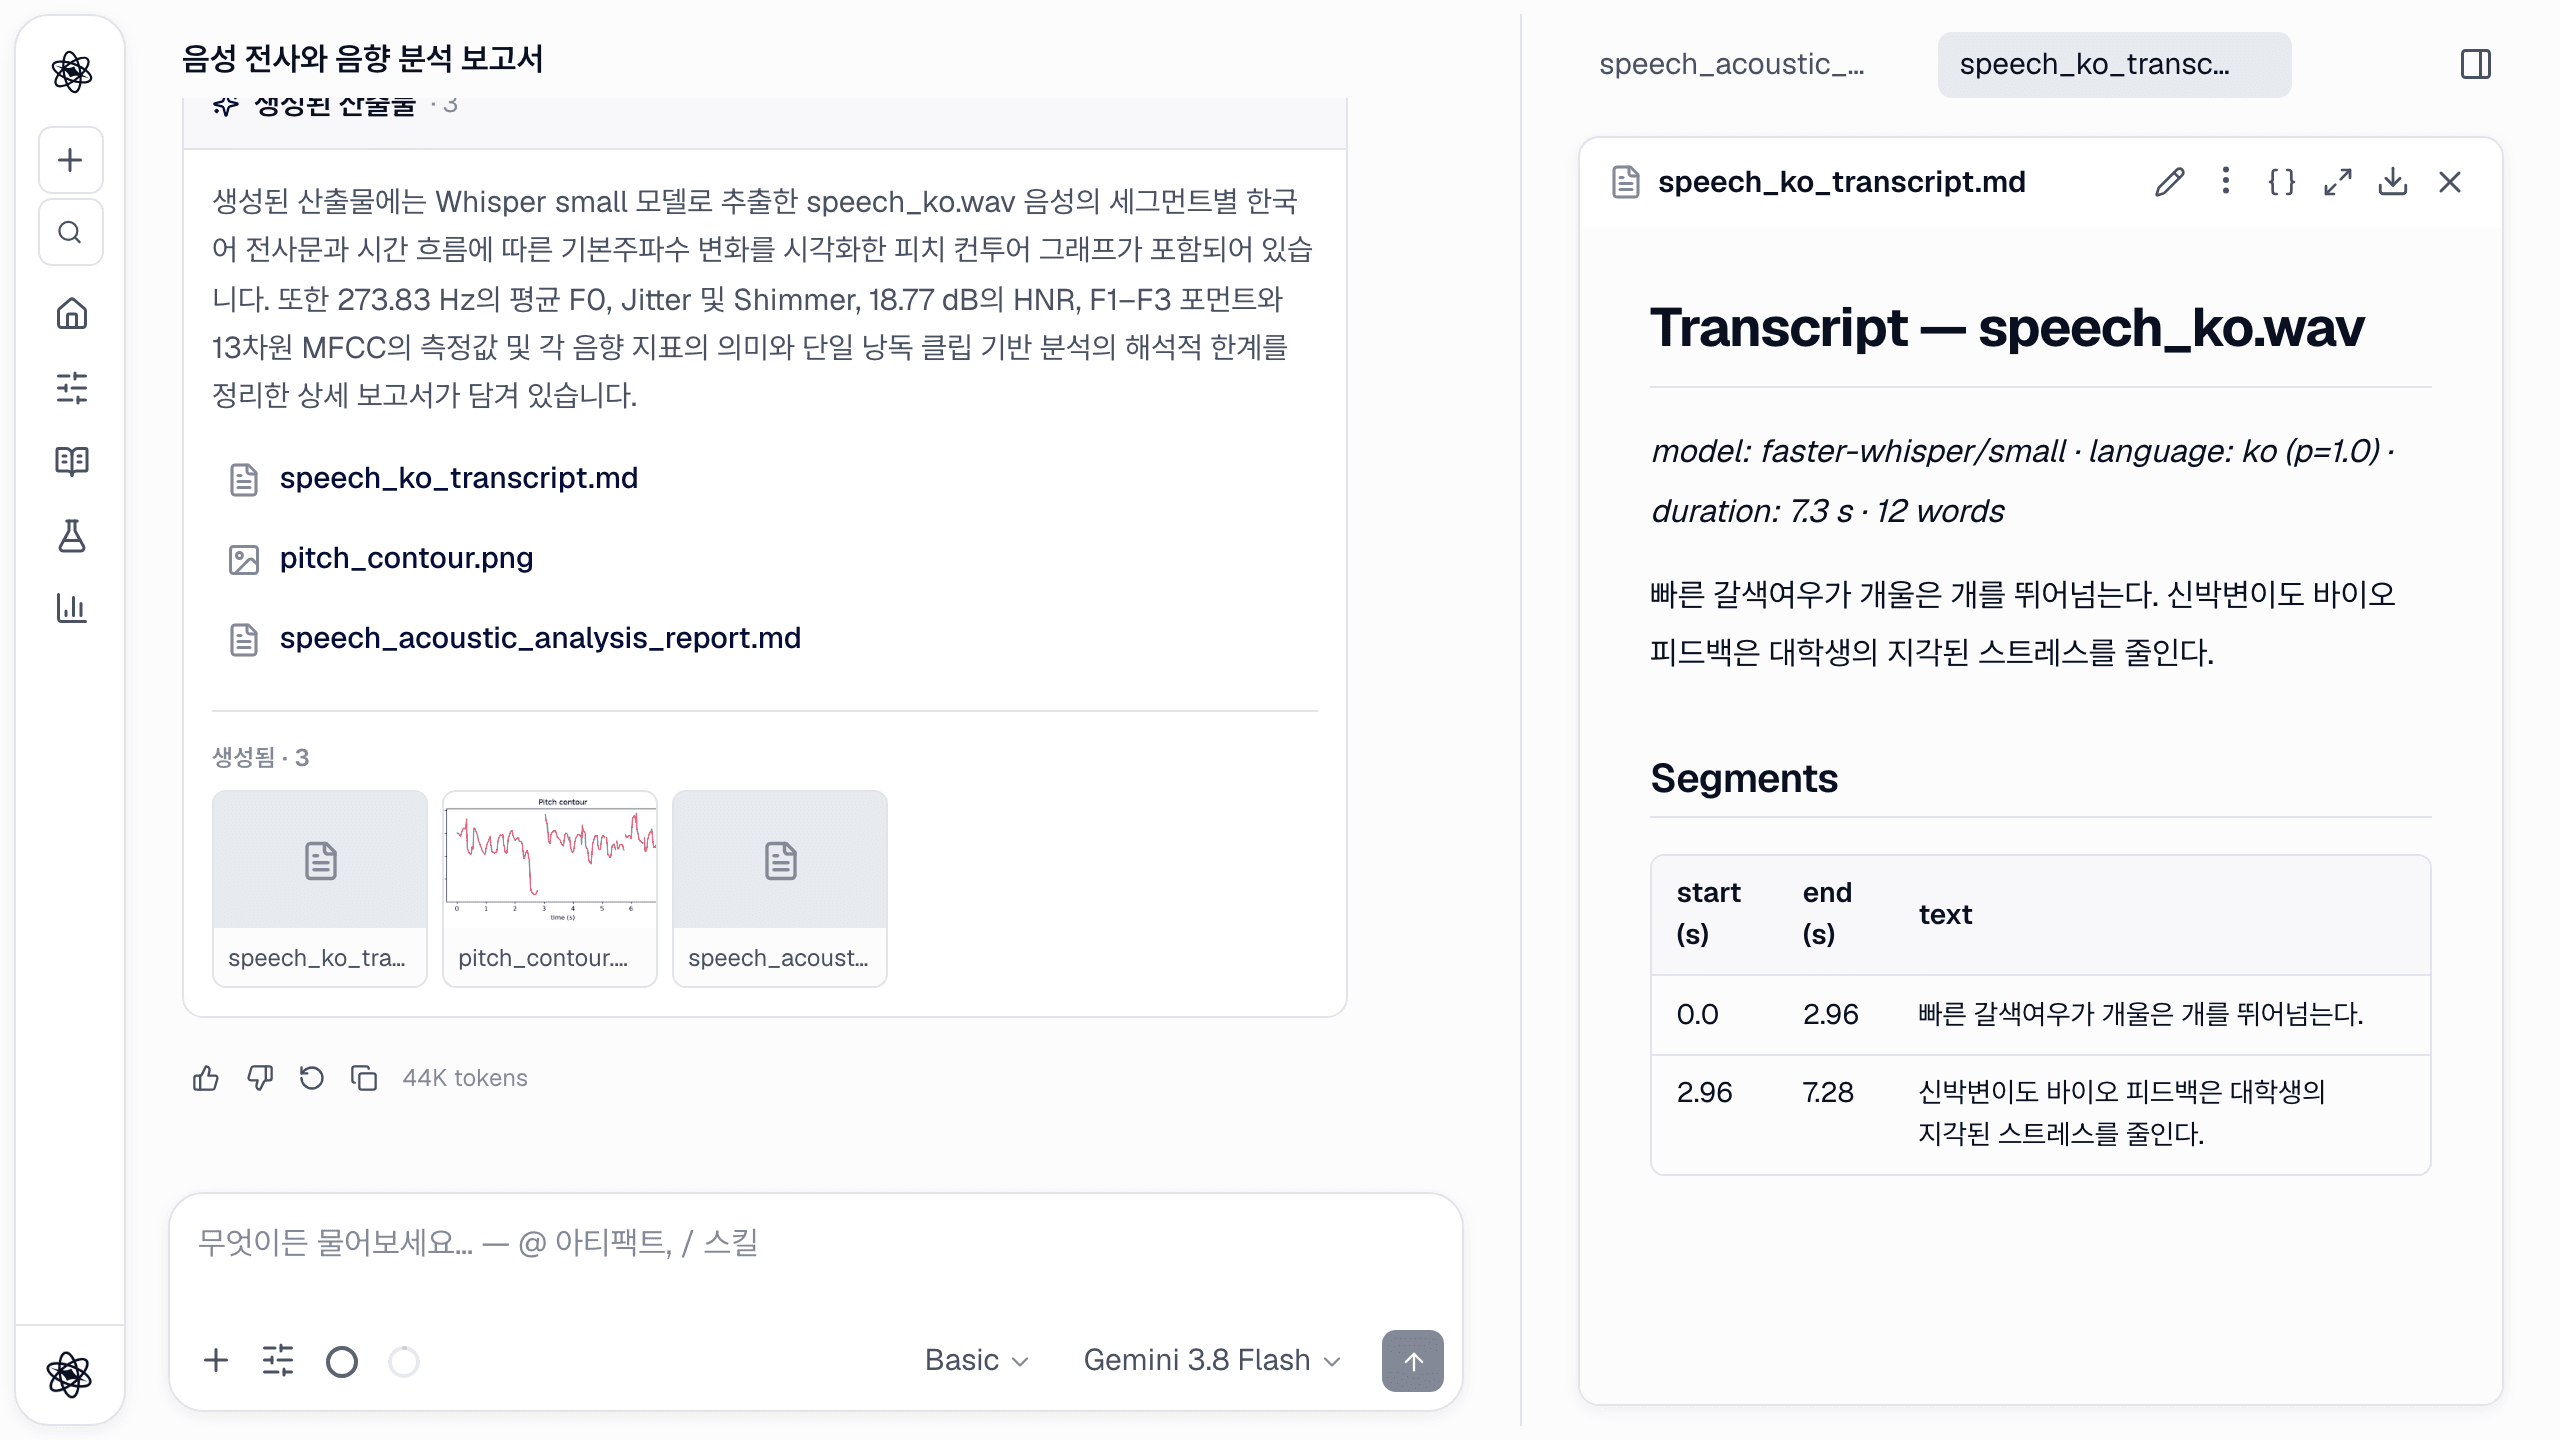
에이전트는 전사문을 그대로 인용하고, 오디오 내용인 것처럼 바꿔 말하지 않도록 지시받습니다. 나중에 텍스트를 코딩할 때 이 점이 중요합니다.
음성: 피치, 강도, 음성 품질
voice 도구는 오디오를 읽어 다음을 돌려줍니다.
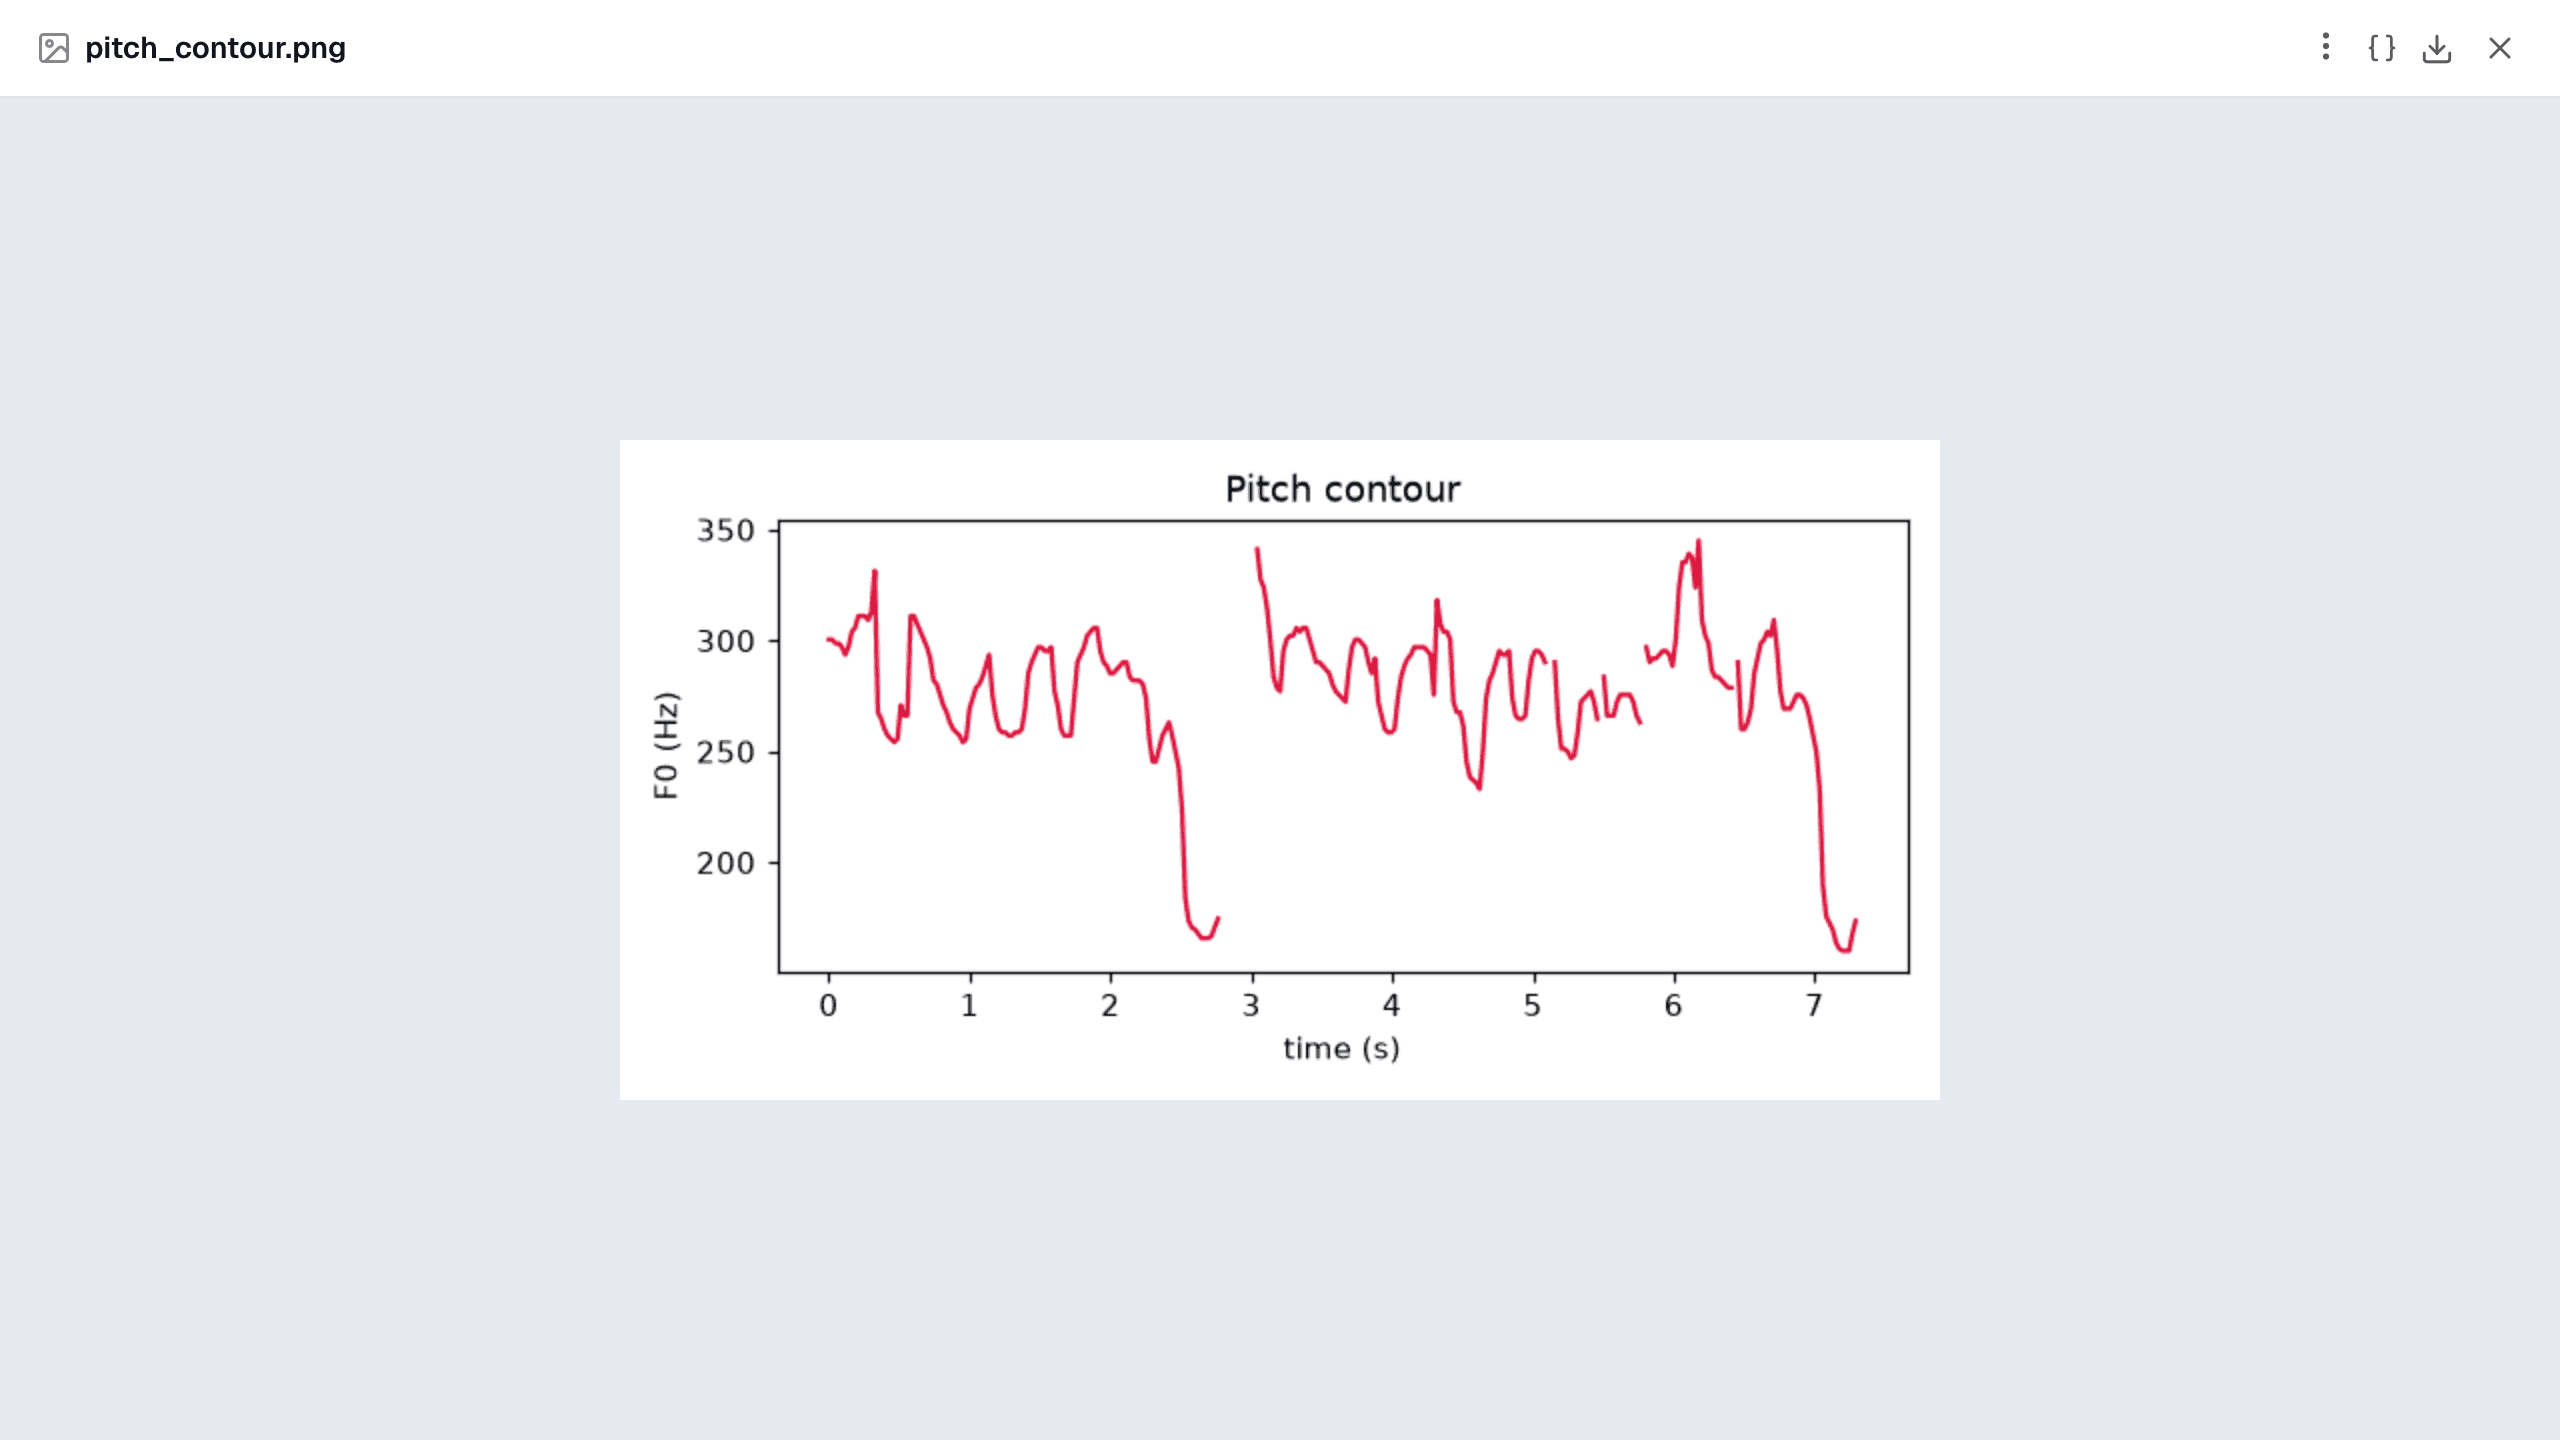
- 피치(F0): 평균·표준편차·최솟값·최댓값·범위(Hz). pYIN 으로 65–400Hz 사이를 추적하고, 유성음 비율도 함께 줍니다.
- 강도: RMS 에너지의 평균과 표준편차. 녹음 안에서의 상대값이며 보정된 dB SPL 이 아닙니다.
- 스펙트럼 중심(spectral centroid)(Hz).
- Praat(parselmouth)로 잰 음성 품질: local jitter, local shimmer, HNR(dB).
- 피치 컨투어 이미지
pitch_contour.png.
acoustic_features 도구는 여기에 다음을 더합니다.
- 포먼트 F1–F3(Praat, Burg 방식): 평균과 표준편차(Hz).
- MFCC 13개: 계수별 평균과 표준편차.
- 영교차율, 스펙트럼 대역폭, 스펙트럼 롤오프.
어느 도구도 감정 이름을 붙이지 않습니다. voice 결과에는 이런 주석이 달려 있습니다. F0 평균·변동성과 강도가 높으면 대개 각성이 높다는 뜻이고, jitter·shimmer·HNR 은 음성 품질을 나타내지만, 이것들은 특징값일 뿐 검증된 감정 분류기가 아니라는 것입니다. 보고서도 이 선을 지킵니다.
/analyze speech_ko.wav 의 음성을 측정해 주세요: F0 평균·표준편차·범위·컨투어, 강도, jitter, shimmer, HNR, 그리고 포먼트 F1–F3 와 MFCC. 각 지표의 뜻과, 이 클립 하나로 말할 수 있는 것과 없는 것을 밝혀 주세요.
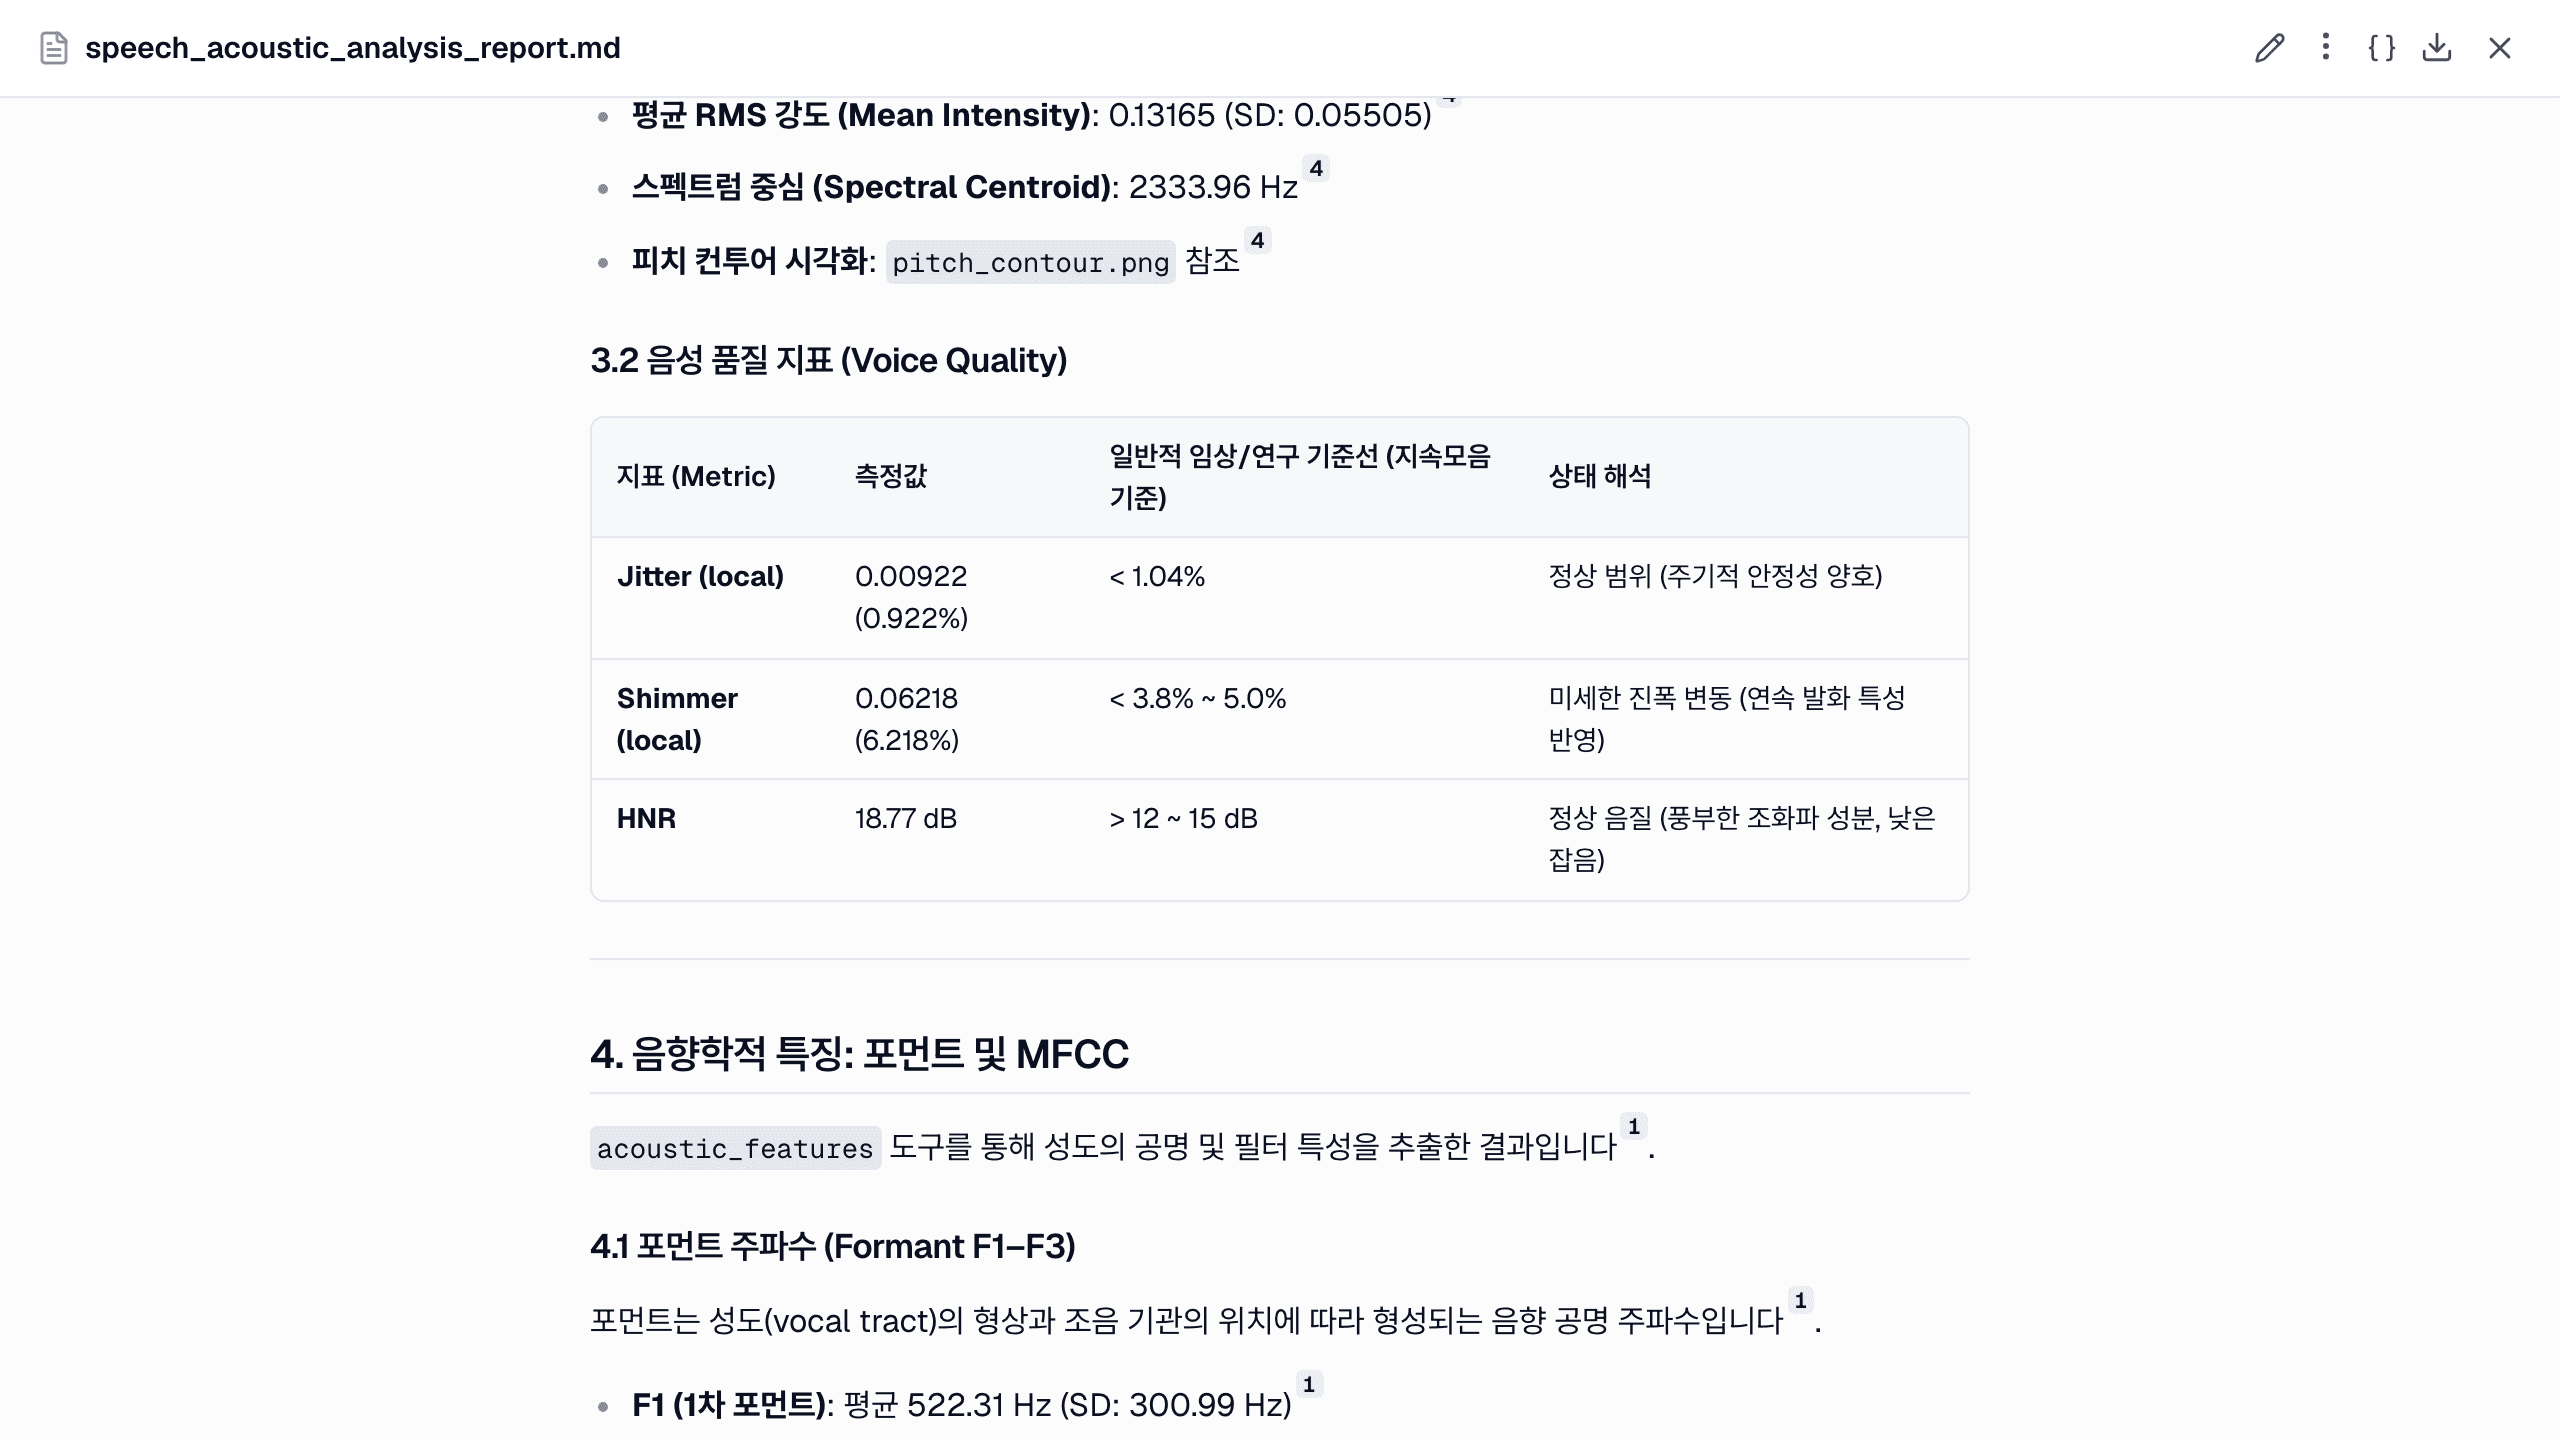
영어 샘플 클립(7.4초짜리 합성 낭독)에서 도구가 돌려준 값은 F0 평균 173.7Hz(범위 100.8–233.0Hz), jitter 1.2%, shimmer 6.6%, HNR 16.0dB, F1–F3 676·1878·2996Hz 였습니다. 같은 클립을 Praat 로 따로 잰 기준값은 F0 평균 171.7Hz 입니다.
voice 도구는 피치 컨투어를 그림으로 저장합니다. 유성음이 없는 구간에서는 곡선이 끊기므로, 문장 사이 휴지도 눈으로 확인할 수 있습니다. 파형과 강도 곡선을 함께 겹친 그림처럼 더 자세한 그림이 필요하면 그렇게 요청하면 됩니다.
자주 쓰는 연구 용도
인터뷰와 주제 코딩. 인터뷰마다 전사한 뒤, 구간을 참여자 열이 있는 표로 만들어 달라고 하세요. 텍스트 도구는 그 표에서 작동합니다. text_overview(분량·상위 어휘), theme_clusters(대표 인용문이 붙은 후보 주제, 개방 코딩의 출발점), topic_model(LDA·NMF), sentiment(VADER, 영어 전용)입니다. 군집은 제안으로만 받아들이세요. 도구 스스로도 원문과 대조해야 할 후보 주제라고 밝힙니다.
사고 발화(think-aloud) 사용성 세션. 구간 타임스탬프로 참여자의 말을 과제 타임라인에 맞출 수 있습니다. 과제 구간마다 해당하는 발화를 뽑아 달라고 하고, 같은 연구의 과제 성공률이나 SUS 점수와 함께 보세요.
정서 운율. 조건 사이의 F0 평균, F0 표준편차, 강도를 비교합니다(예: 같은 화자가 읽은 중립 문장과 정서 문장). 클립 하나를 해석하는 것보다 화자 내 비교가 훨씬 강합니다.
음성 스트레스. jitter, shimmer, HNR, F0 는 스트레스나 인지 부하 연구에서 흔히 보는 음향 상관지표입니다. 사람마다 기저선을 녹음하고 과제 녹음을 그와 비교하세요. 클립 하나만으로 판단해 달라고 하면 보고서가 그 한계를 먼저 말해 줍니다.
클립 하나에서 연구 전체로: 참여자 간 통계
연구에는 녹음이 하나만 있는 경우가 드뭅니다. 모든 참여자의 파일(또는 조건별 파일)을 올리고 파일마다 같은 지표를 요청한 뒤, 파일별 결과를 참여자·조건 열이 있는 표로 모아 달라고 하세요. 그다음은 통계 도구가 맡습니다.
compare_groups는 설계와 데이터를 보고 검정을 고르고(대응·독립, 모수·비모수), 그 이유를 결정 기록(decision trace)으로 설명합니다.mixedlm은 화자당 발화가 여러 개인 경우처럼 반복 측정을 참여자 무선효과로 다룹니다.
/stats voice_features.csv 는 녹음 하나가 한 행입니다: participant, condition(baseline / stress), f0_mean, f0_sd, jitter, shimmer, hnr. 참여자 내에서 조건을 비교하고, 가정을 확인하고, 효과크기를 보고해 주세요.
검정을 고르는 방식은 통계 가이드에 자세히 있습니다.
모든 문장을 따라갈 수 있게
분석 보고서는 도구 결과로 쓰이고, 문장마다 [n] 인용이 붙습니다. 각 번호는 그 문장의 근거가 된 분석 단계(media_info, transcribe_audio, voice, acoustic_features)나 데이터 파일을 가리킵니다. 채팅에는 "분석 보고서 문장 53개에 [n] 인용을 달았습니다" 같은 안내가 뜨고, 보고서 끝 참고문헌에는 단계마다 인자와 원 결과의 앞부분이 나옵니다.
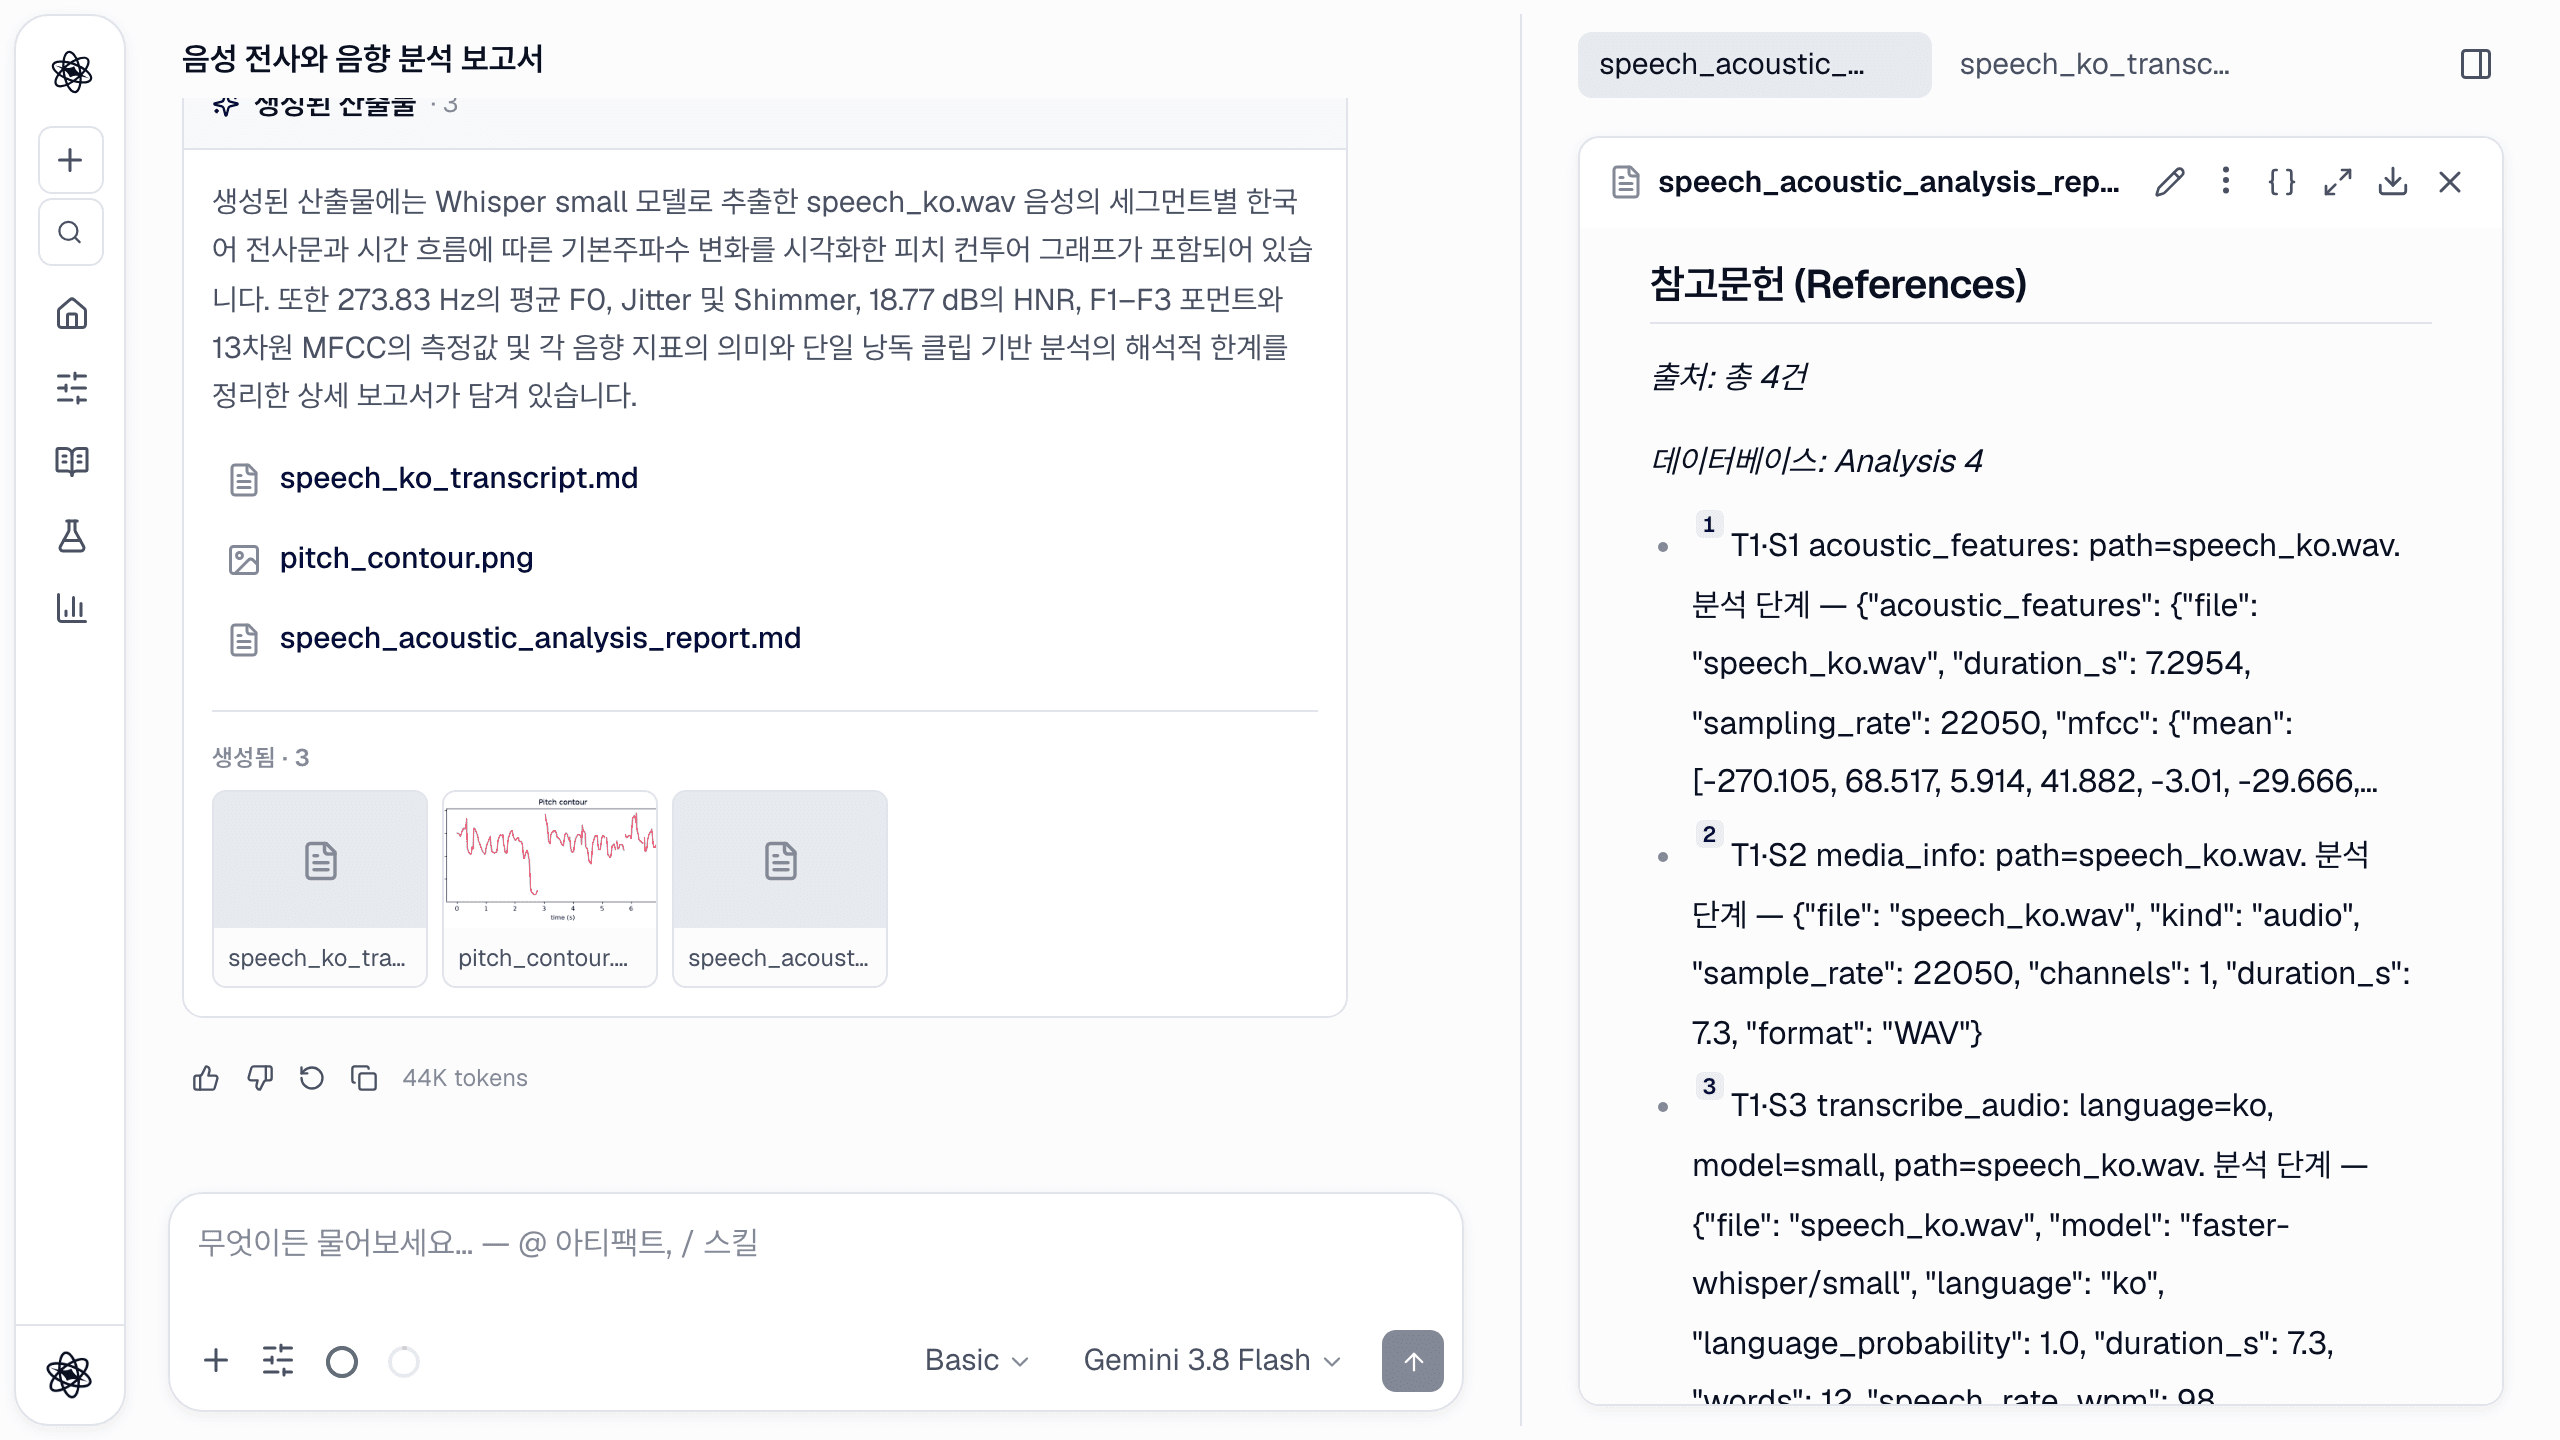
도구 호출마다 이름과 인자(전사라면 파일·모델 크기·언어)가 기록되고, 그림은 자신을 만든 코드를 함께 보관합니다(아티팩트 패널의 { } 버튼). 피치나 전사를 어떻게 얻었느냐는 질문을 받으면 답은 세션 안에 있습니다. 자세한 내용은 모든 문장에 출처를과 기본값이 재현성에 있습니다.
개인정보
사람의 목소리 녹음은 개인정보이고, 때로는 민감정보입니다. 개인정보처리방침에 적힌 내용은 이렇습니다.
- 웹 앱에서 업로드한 파일과 그로부터 만든 아티팩트는 계정의 비공개 작업 공간에 저장되고, 분석을 위해 뉴트로픽 서버에서 처리됩니다.
- 전사는 그 서버에서 faster-whisper 로 돌립니다. 오디오 파일을 외부 음성 인식 서비스로 보내지 않습니다.
- 선택한 AI 모델은 답에 필요한 것, 즉 프롬프트·도구 결과·관련 발췌를 봅니다. 전사문도 여기에 포함됩니다. 모델 제공사는 이 데이터로 학습하지 못하게 하는 계약 아래에서 처리합니다.
- 여러분의 콘텐츠는 모델 학습에 쓰이지 않으며, 언제든 지울 수 있습니다.
- 올리는 녹음에 대한 동의와 연구윤리 승인은 사용자 책임입니다. 올리기 전에 녹음과 전사에서 이름 같은 식별 정보를 지우는 것이 좋습니다.
솔직한 한계
- 전사에는 오류가 있습니다. Whisper 는 뛰어나지만 완벽하지 않고, 작은 모델은 영어가 아닌 말에서 더 자주 틀립니다. 한국어·중국어·일본어 샘플 클립은
small모델로도 잘못 들은 곳이 있었습니다. '게으른'이 '개울은'으로, '심박변이도'가 '신박변이도'로, 중국어 敏捷的 가 民间的 로, 일본어 心拍変動 이 新博変動 으로 나왔습니다. 코딩하거나 인용하기 전에 모든 전사를 오디오와 대조해 교정하세요. 클립 끝부분에서는 타임스탬프가 어긋날 수도 있습니다. - 화자 분리(diarisation)는 없습니다. 뉴트로픽은 화자를 나누지 않습니다. 인터뷰는 "면담자"·"참여자" 표시 없이 하나로 이어진 구간 목록으로 나오고, 음성 지표는 녹음에 있는 모든 사람을 함께 잽니다. 사람별 음성 지표가 필요하면 화자를 채널별로 녹음하거나 화자별로 파일을 잘라 올리세요.
- 특징값이지 감정이 아닙니다. 녹음에 기쁨·스트레스·우울 같은 이름을 붙이는 도구는 없습니다. 운율을 해석하려면 기저선과 연구 설계가 필요합니다.
- 임상 평가가 아닙니다. 연속 발화에서 잰 jitter·shimmer·HNR 은 음성장애 평가가 아닙니다. 음성장애 평가는 보정된 조건에서 지속 모음으로 합니다.
- 보정되지 않은 강도. 소리 크기는 마이크 거리와 게인에 따라 달라지므로, 강도는 같은 녹음 환경 안에서만 비교하세요.
- 참고 범위는 모델이 씁니다. 보고서가 측정값을 일반적인 범위와 비교할 때(위 표처럼), 그 범위는 도구 결과가 아니라 모델의 일반 지식입니다. 인용할 문헌과 대조해 확인하세요.
- 클립 전체 요약. 음성 도구는 파일 전체를 요약합니다. 구간별 지표가 필요하면 오디오를 구간별로 자르거나 그렇게 하는 코드를 요청하고, 결과를 확인하세요.
예시 프로젝트(예시 · 도메인별 스킬의 음성 세션)에서 먼저 보거나, 직접 녹음을 첨부하고 설명을 붙여 시작하세요. 형식과 옵션은 데이터 분석 문서와 업로드 형식에 있습니다.