사람을 대상으로 한 연구 데이터는 대부분 깔끔한 스프레드시트로 시작하지 않습니다. 뇌파 기록, 인터뷰 음성 파일 한 폴더, 참가자를 찍은 웹캠 영상, 심박 CSV 같은 형태로 시작합니다. 여기서 결과까지 가는 보통의 경로에는 도구 네 개와 많은 연결 코드가 들어갑니다. 뇌파는 MNE, 음성은 Praat, 영상은 얼굴 추적 라이브러리, 통계는 R이나 SPSS로 처리합니다. 도구를 옮길 때마다 필터 설정이나 파일 버전을 놓칠 수 있습니다.
뉴트로픽은 이 신호들을 연구를 설계하고 원고를 쓰는 바로 그 작업 공간에서 직접 분석합니다. 측정값은 언어 모델이 짐작한 숫자가 아니라 결정적 도구가 계산합니다. 아래 스크린샷은 모든 계정이 열어 볼 수 있는 예시 프로젝트의 세션에서 가져왔습니다. 정답값을 알고 있는 샘플 기록으로 실행했습니다.
뇌파(EEG): 원시 채널부터 성분까지, 도구 일곱 개
기록은 표(CSV 또는 XLSX)로 올립니다. 규칙은 간단합니다.
- 숫자 컬럼 하나가 채널 하나이고 단위는 µV입니다. 채널 이름을 10–20 체계(Fp1, Fz, Cz, Pz, O1 …)로 붙이면 토포맵과 비대칭 지표도 함께 나옵니다.
time_s컬럼이 있으면 표본율을 추정합니다. 없으면 메시지에 표본율을 적어 주세요.- 선택 사항인
marker컬럼에는 사건을 표시합니다. 0은 사건 없음, 양의 정수는 조건 코드입니다.
그러면 데이터 분석 스킬이 뇌파 도구를 이어서 실행합니다. 질문에 필요한 도구만 고르고, 각 단계를 채팅에 보여 줍니다.
- eeg_info: 채널, 표본율, 사건, 라인 노이즈를 보고합니다.
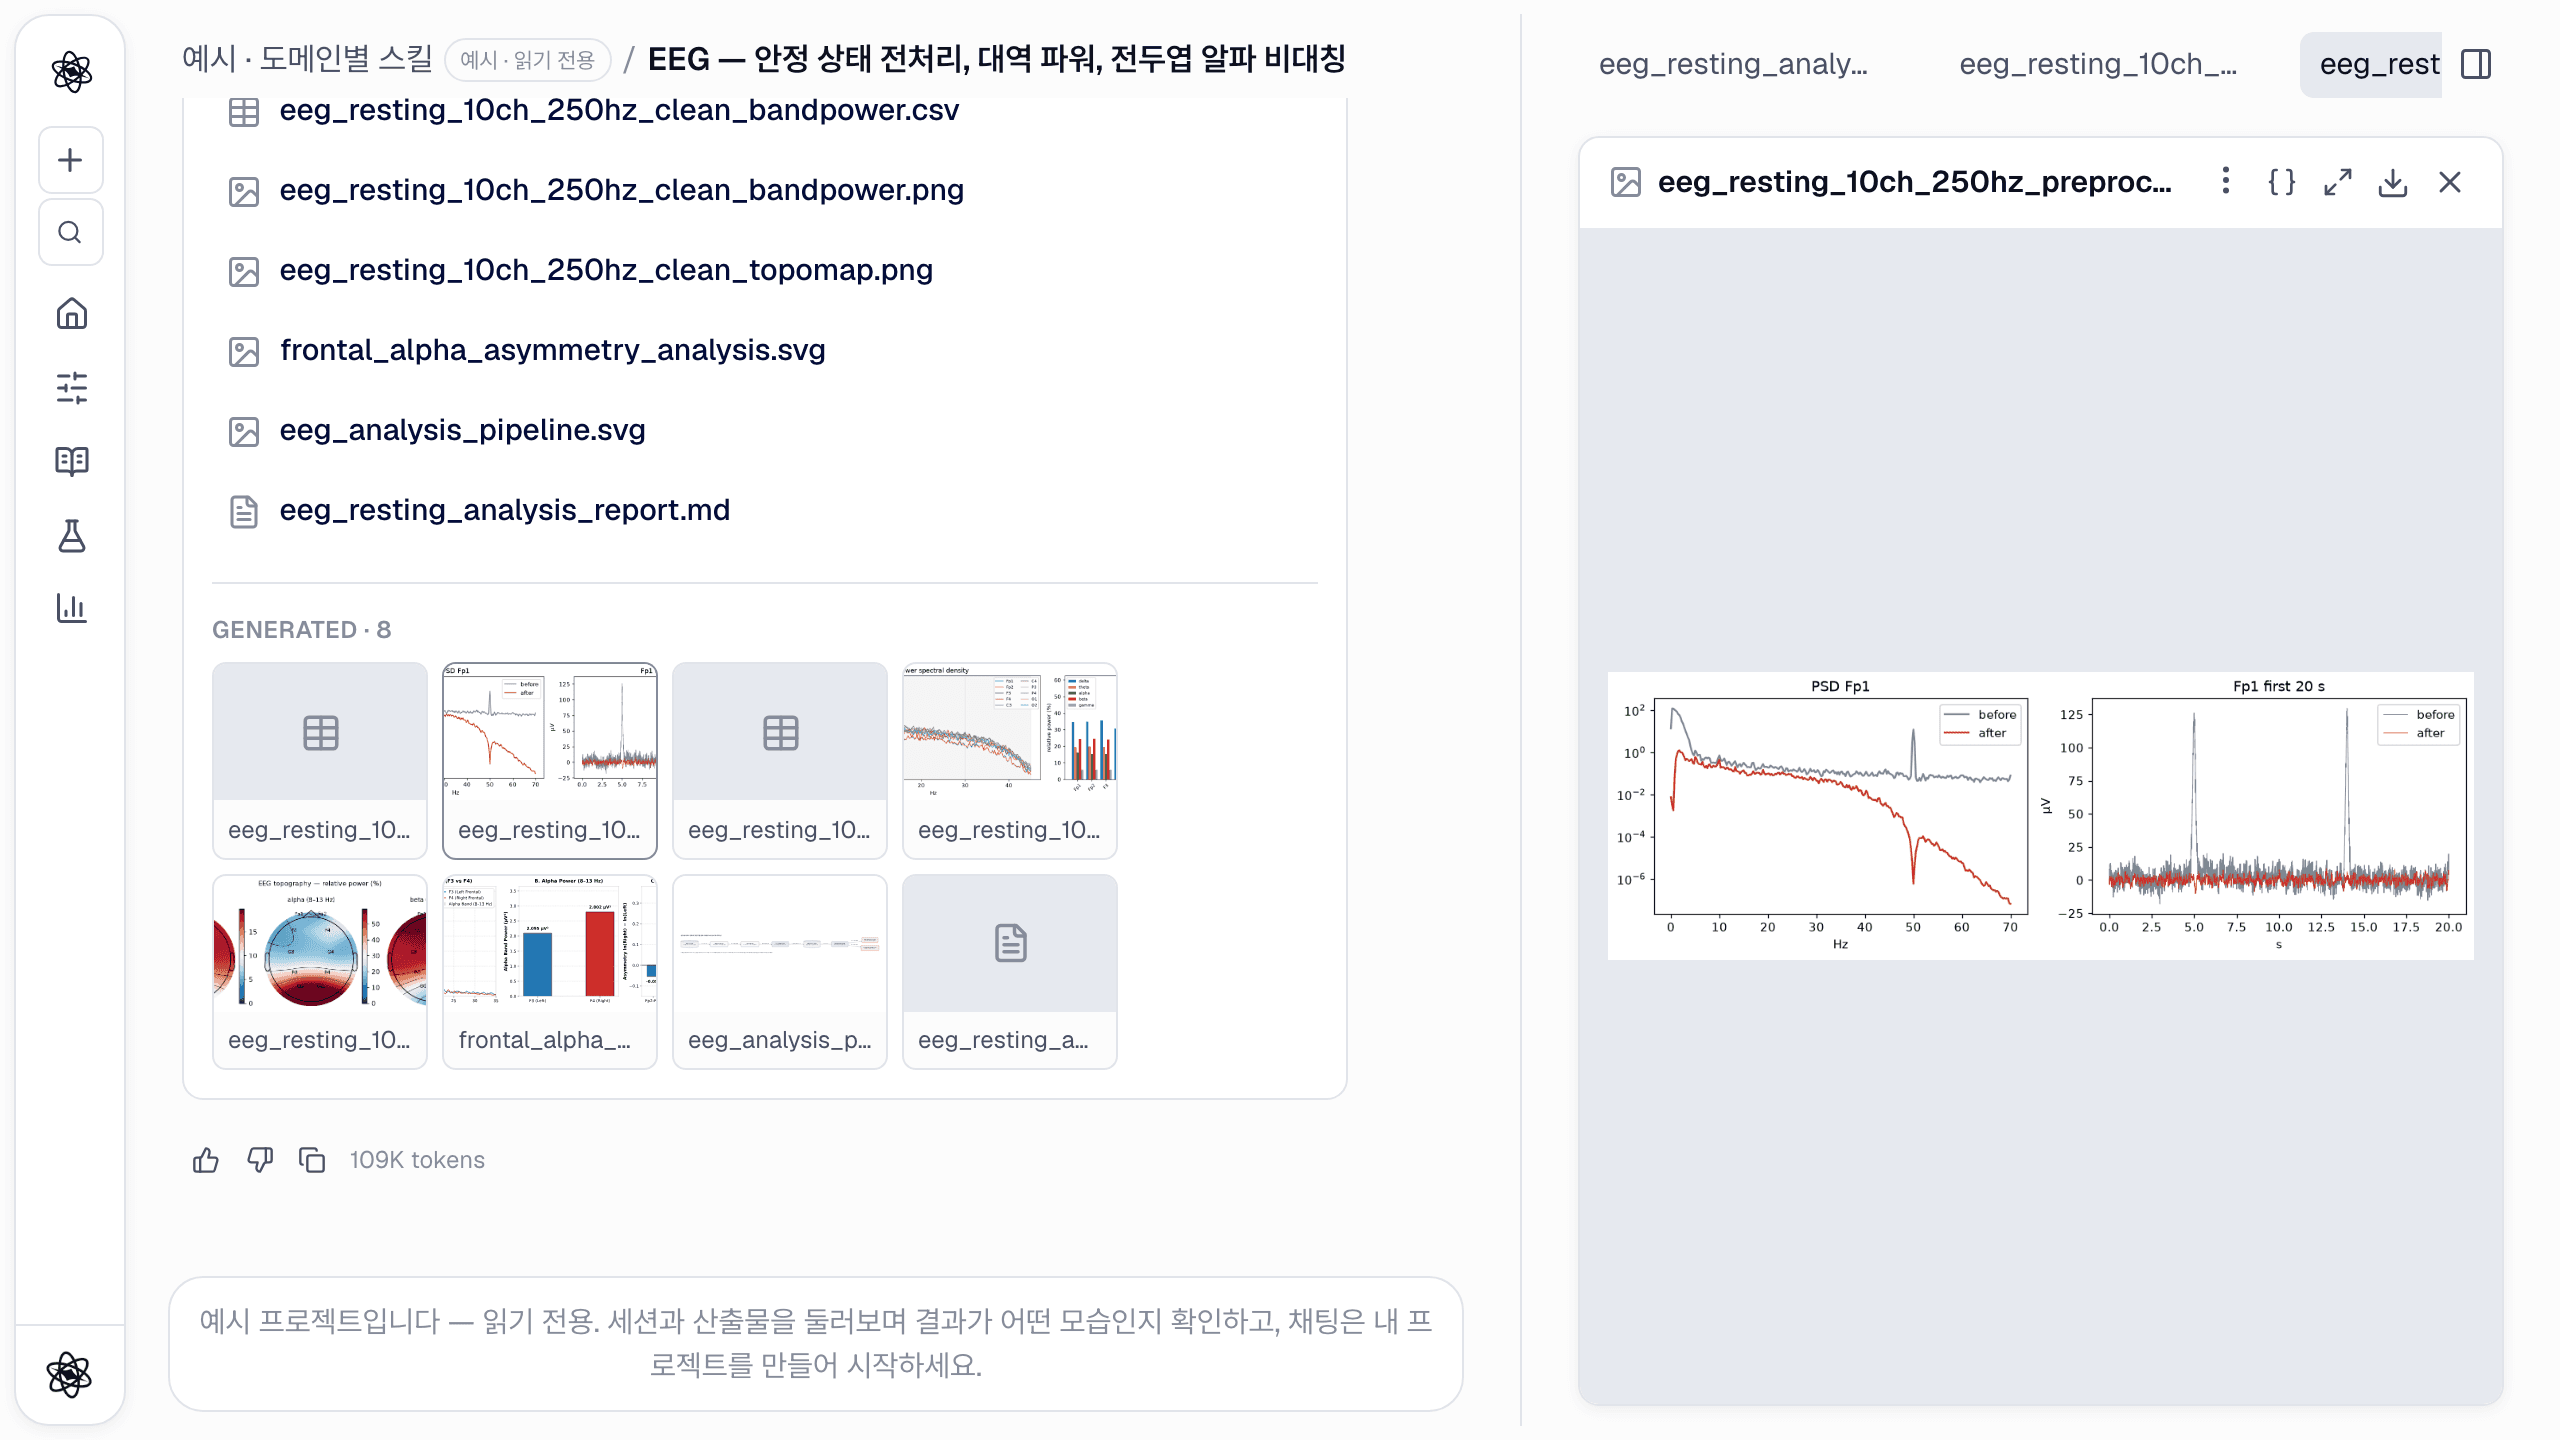
- eeg_preprocess: 50/60 Hz 노치를 자동으로 적용하고 1–40 Hz 대역통과 필터를 거칩니다. 평균 재참조는 선택 사항입니다. FastICA로 눈 깜박임을 제거하고 불량 구간을 표시한 뒤, 다음 단계에서 쓸 정제 CSV를 저장합니다.
- eeg_bandpower: 채널별 Welch 밴드파워, 개인 알파 피크, theta/beta 비, 반구 비대칭을 계산합니다.
- eeg_topomap: 밴드별 두피 분포를 그립니다.
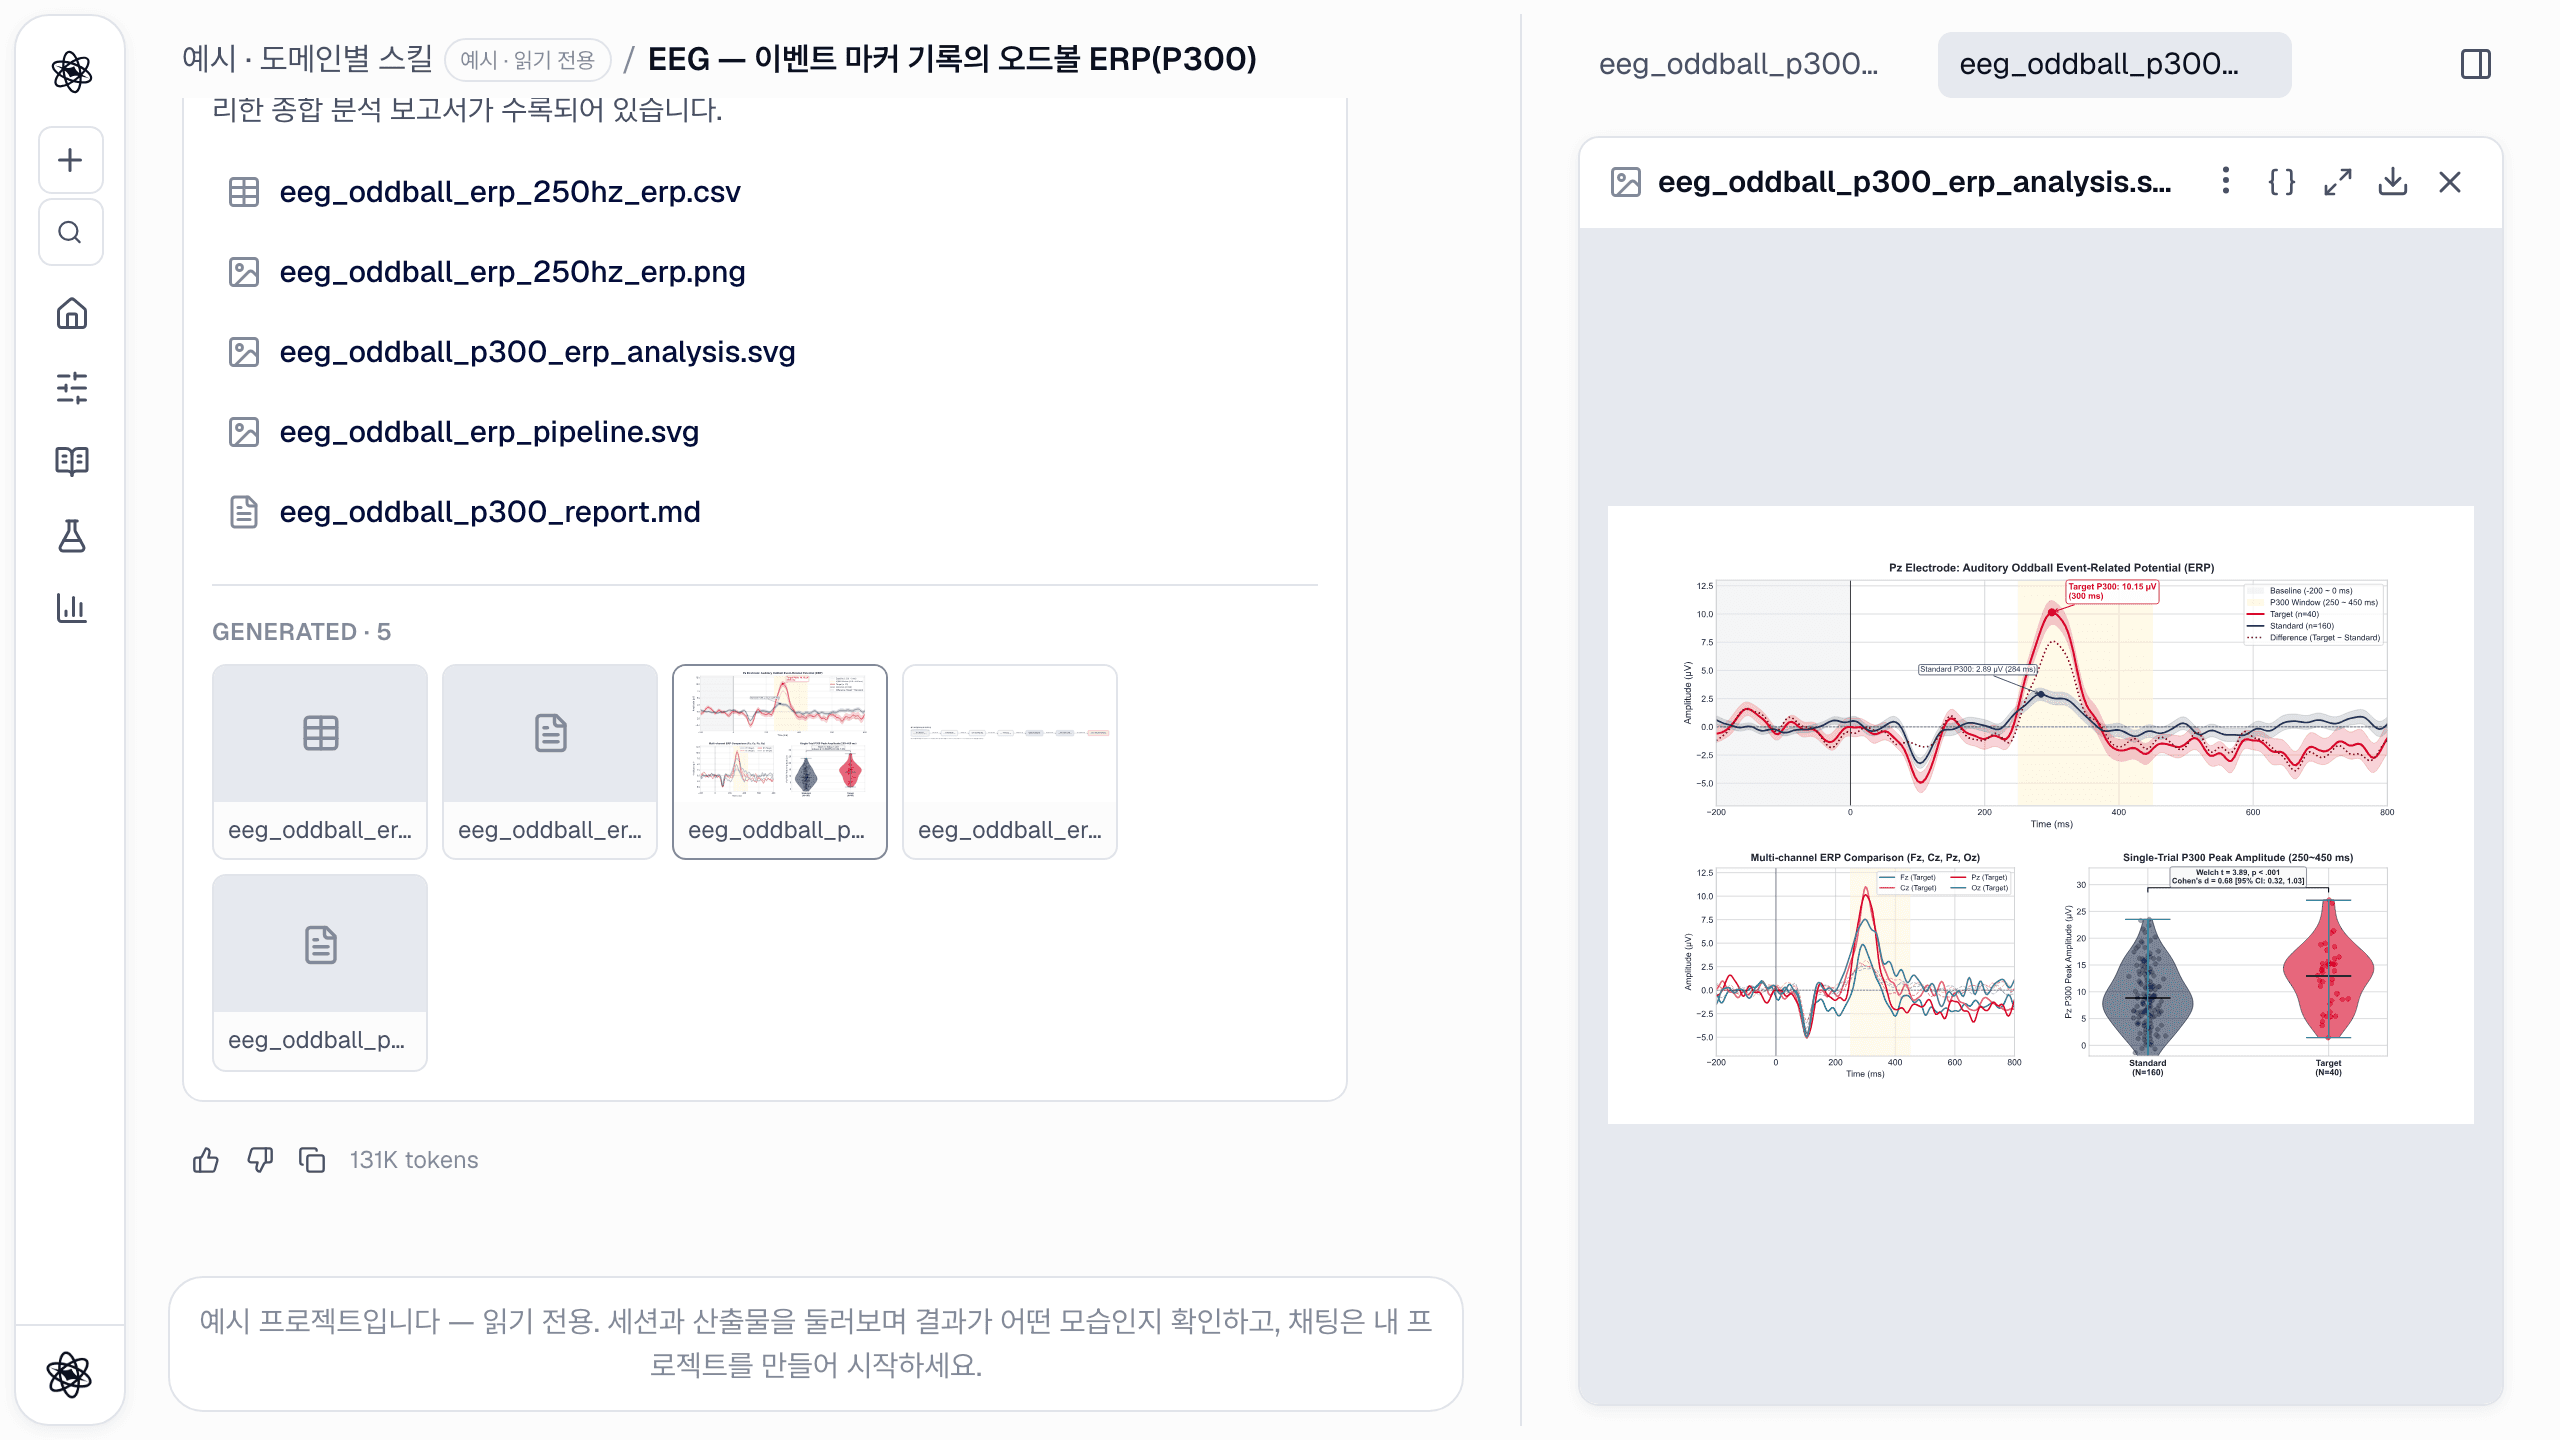
- eeg_erp: 에폭 분할, 기저선 보정, 시행 기각, 조건별 평균을 처리합니다. N1/P2/N2/P3의 잠복기와 진폭, 차이파, SNR도 냅니다.
- eeg_erders: 과제 관련 파워 변화를 %로 계산합니다. ERD 최소, ERS 최대, C3/C4 편측화도 함께 냅니다.
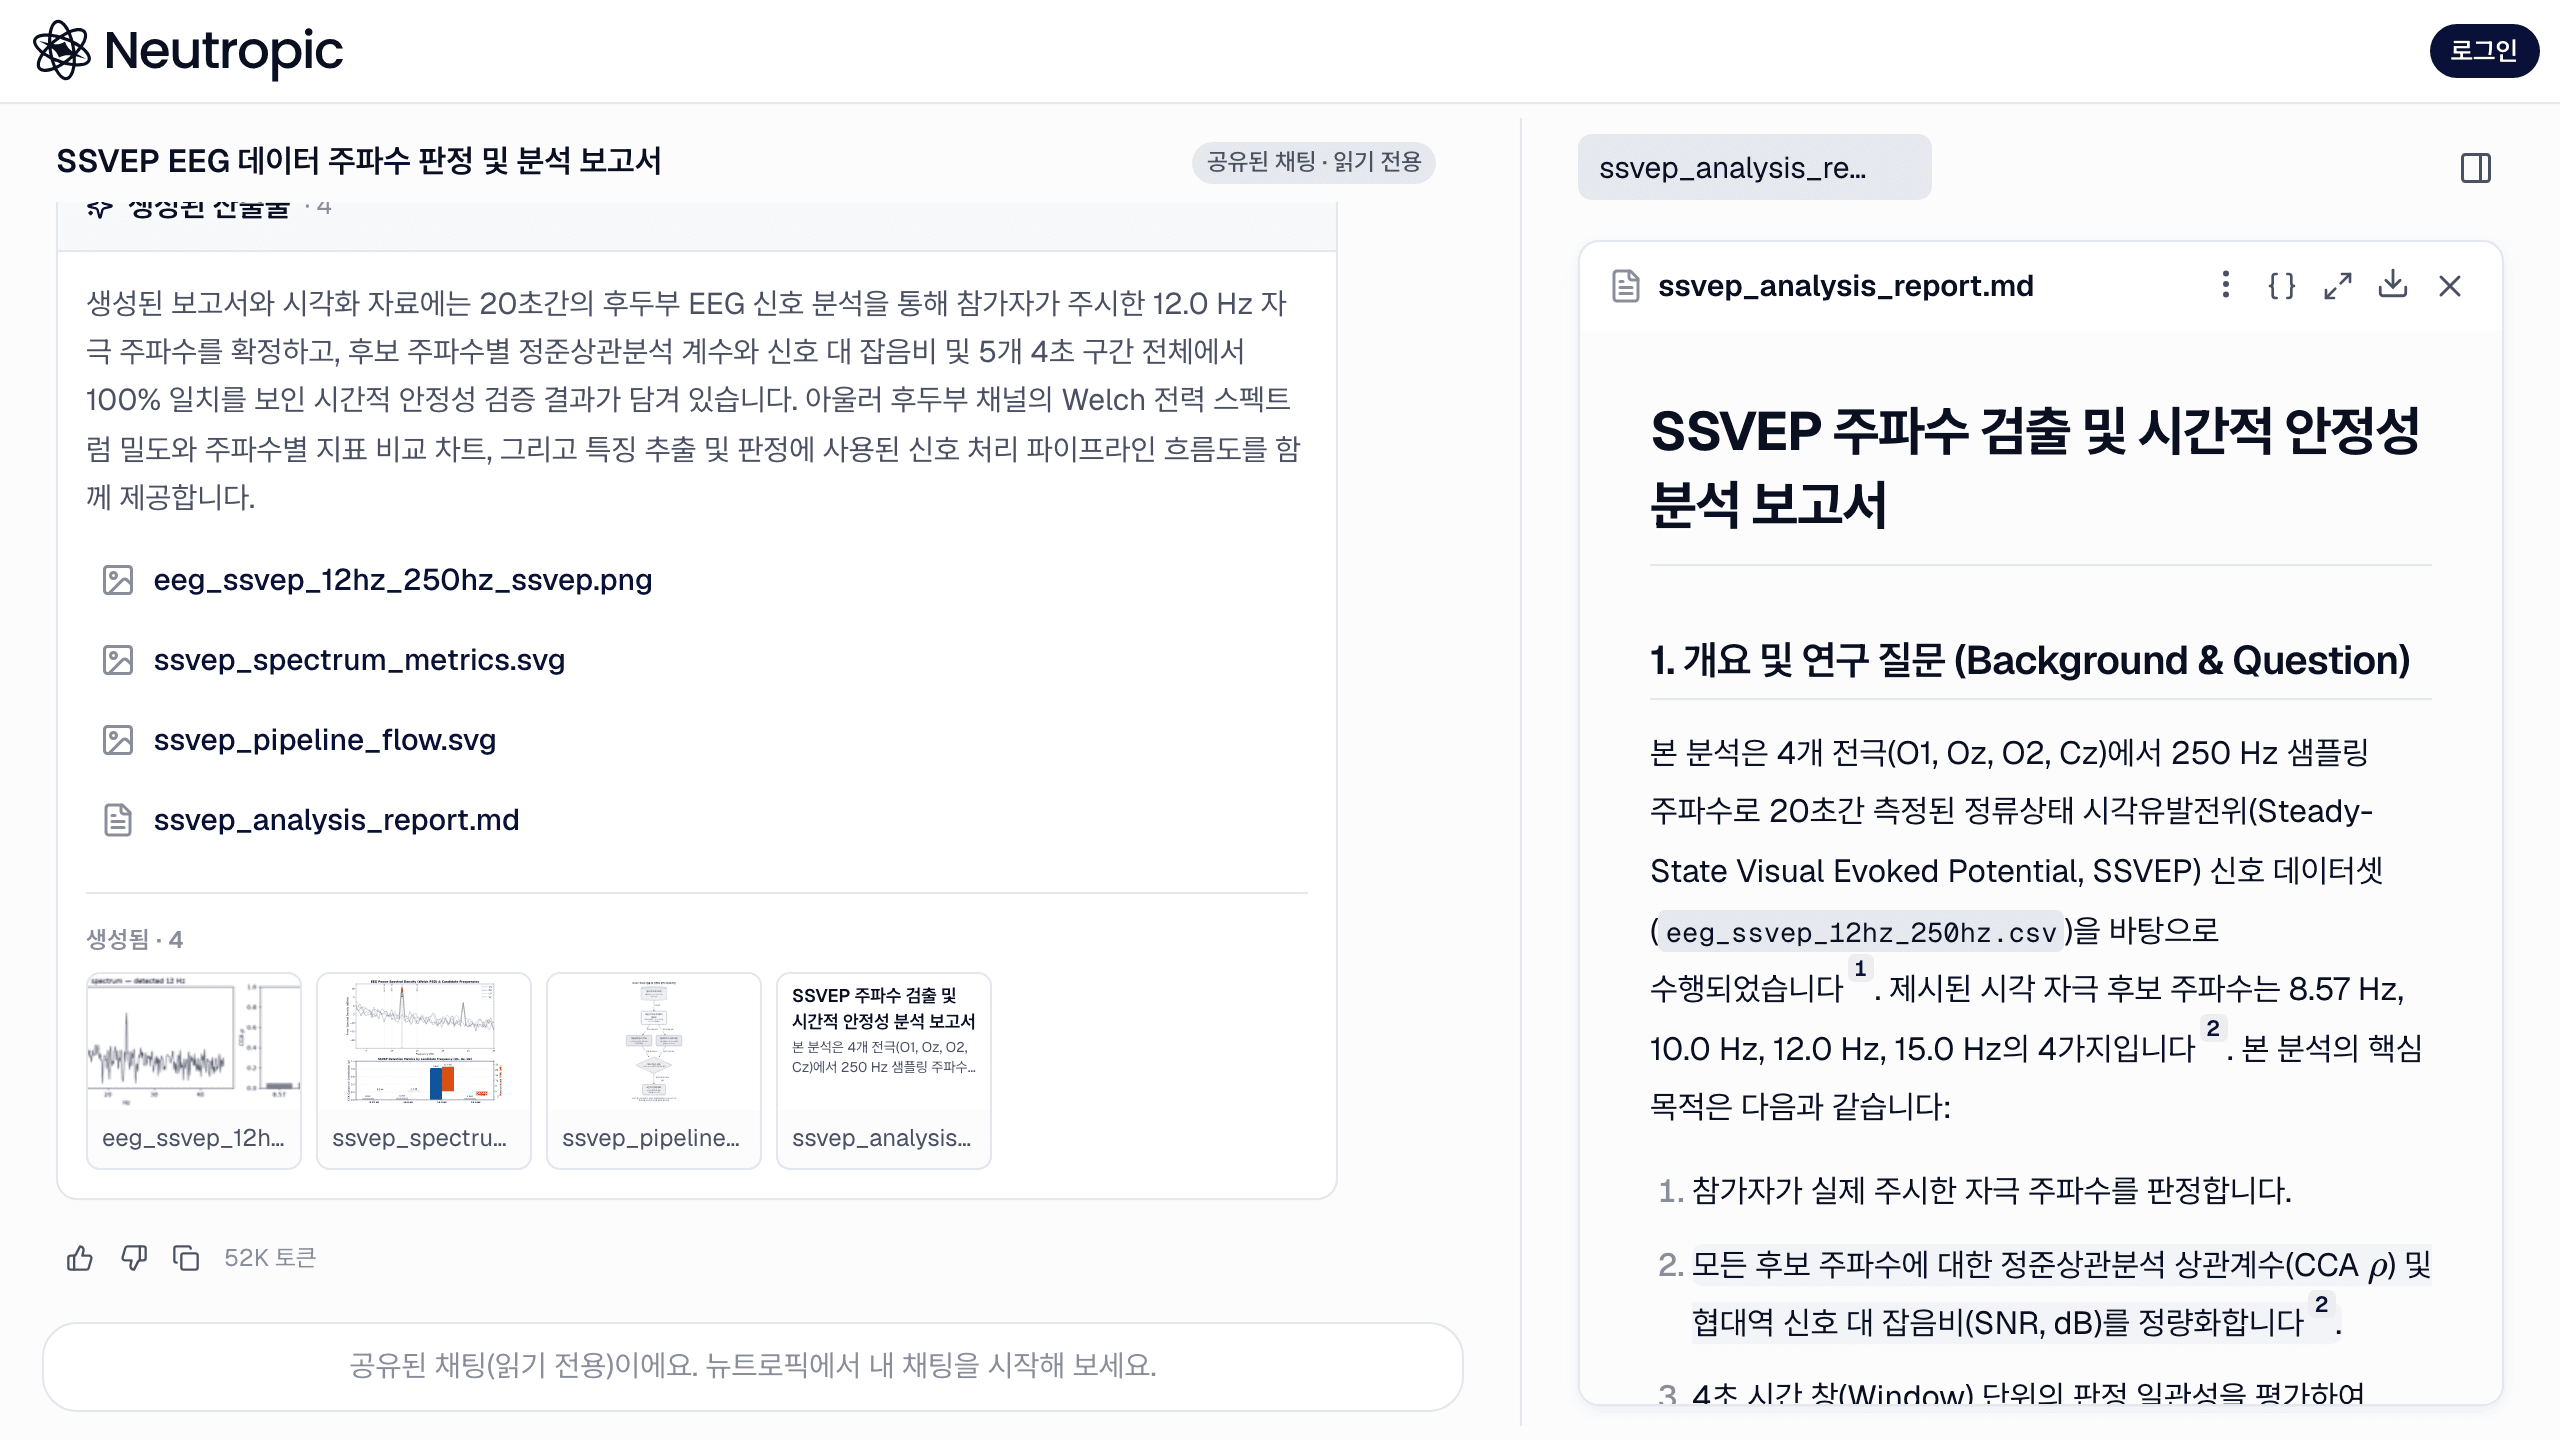
- eeg_ssvep: CCA ρ와 PSD SNR로 자극 주파수를 검출합니다. 승자뿐 아니라 모든 후보 주파수의 값을 보고합니다.
/analyze eeg_oddball_erp_250hz.csv 는 청각 오드볼 기록이야(250 Hz; Fz, Cz, Pz, Oz; marker 1 = 표준, 2 = 표적). 마커 기준으로 에폭을 나누고 조건별로 평균한 뒤, 채널별 N1·P3 잠복기와 진폭, 표적−표준 차이파를 그림과 함께 보고해 줘.
안정 상태 기록이라면 같은 방식의 요청으로 전처리, 밴드파워, 토포그래피가 이어집니다. 전처리가 무엇을 걷어냈는지 보여 주므로 정제 과정을 직접 확인할 수 있습니다.
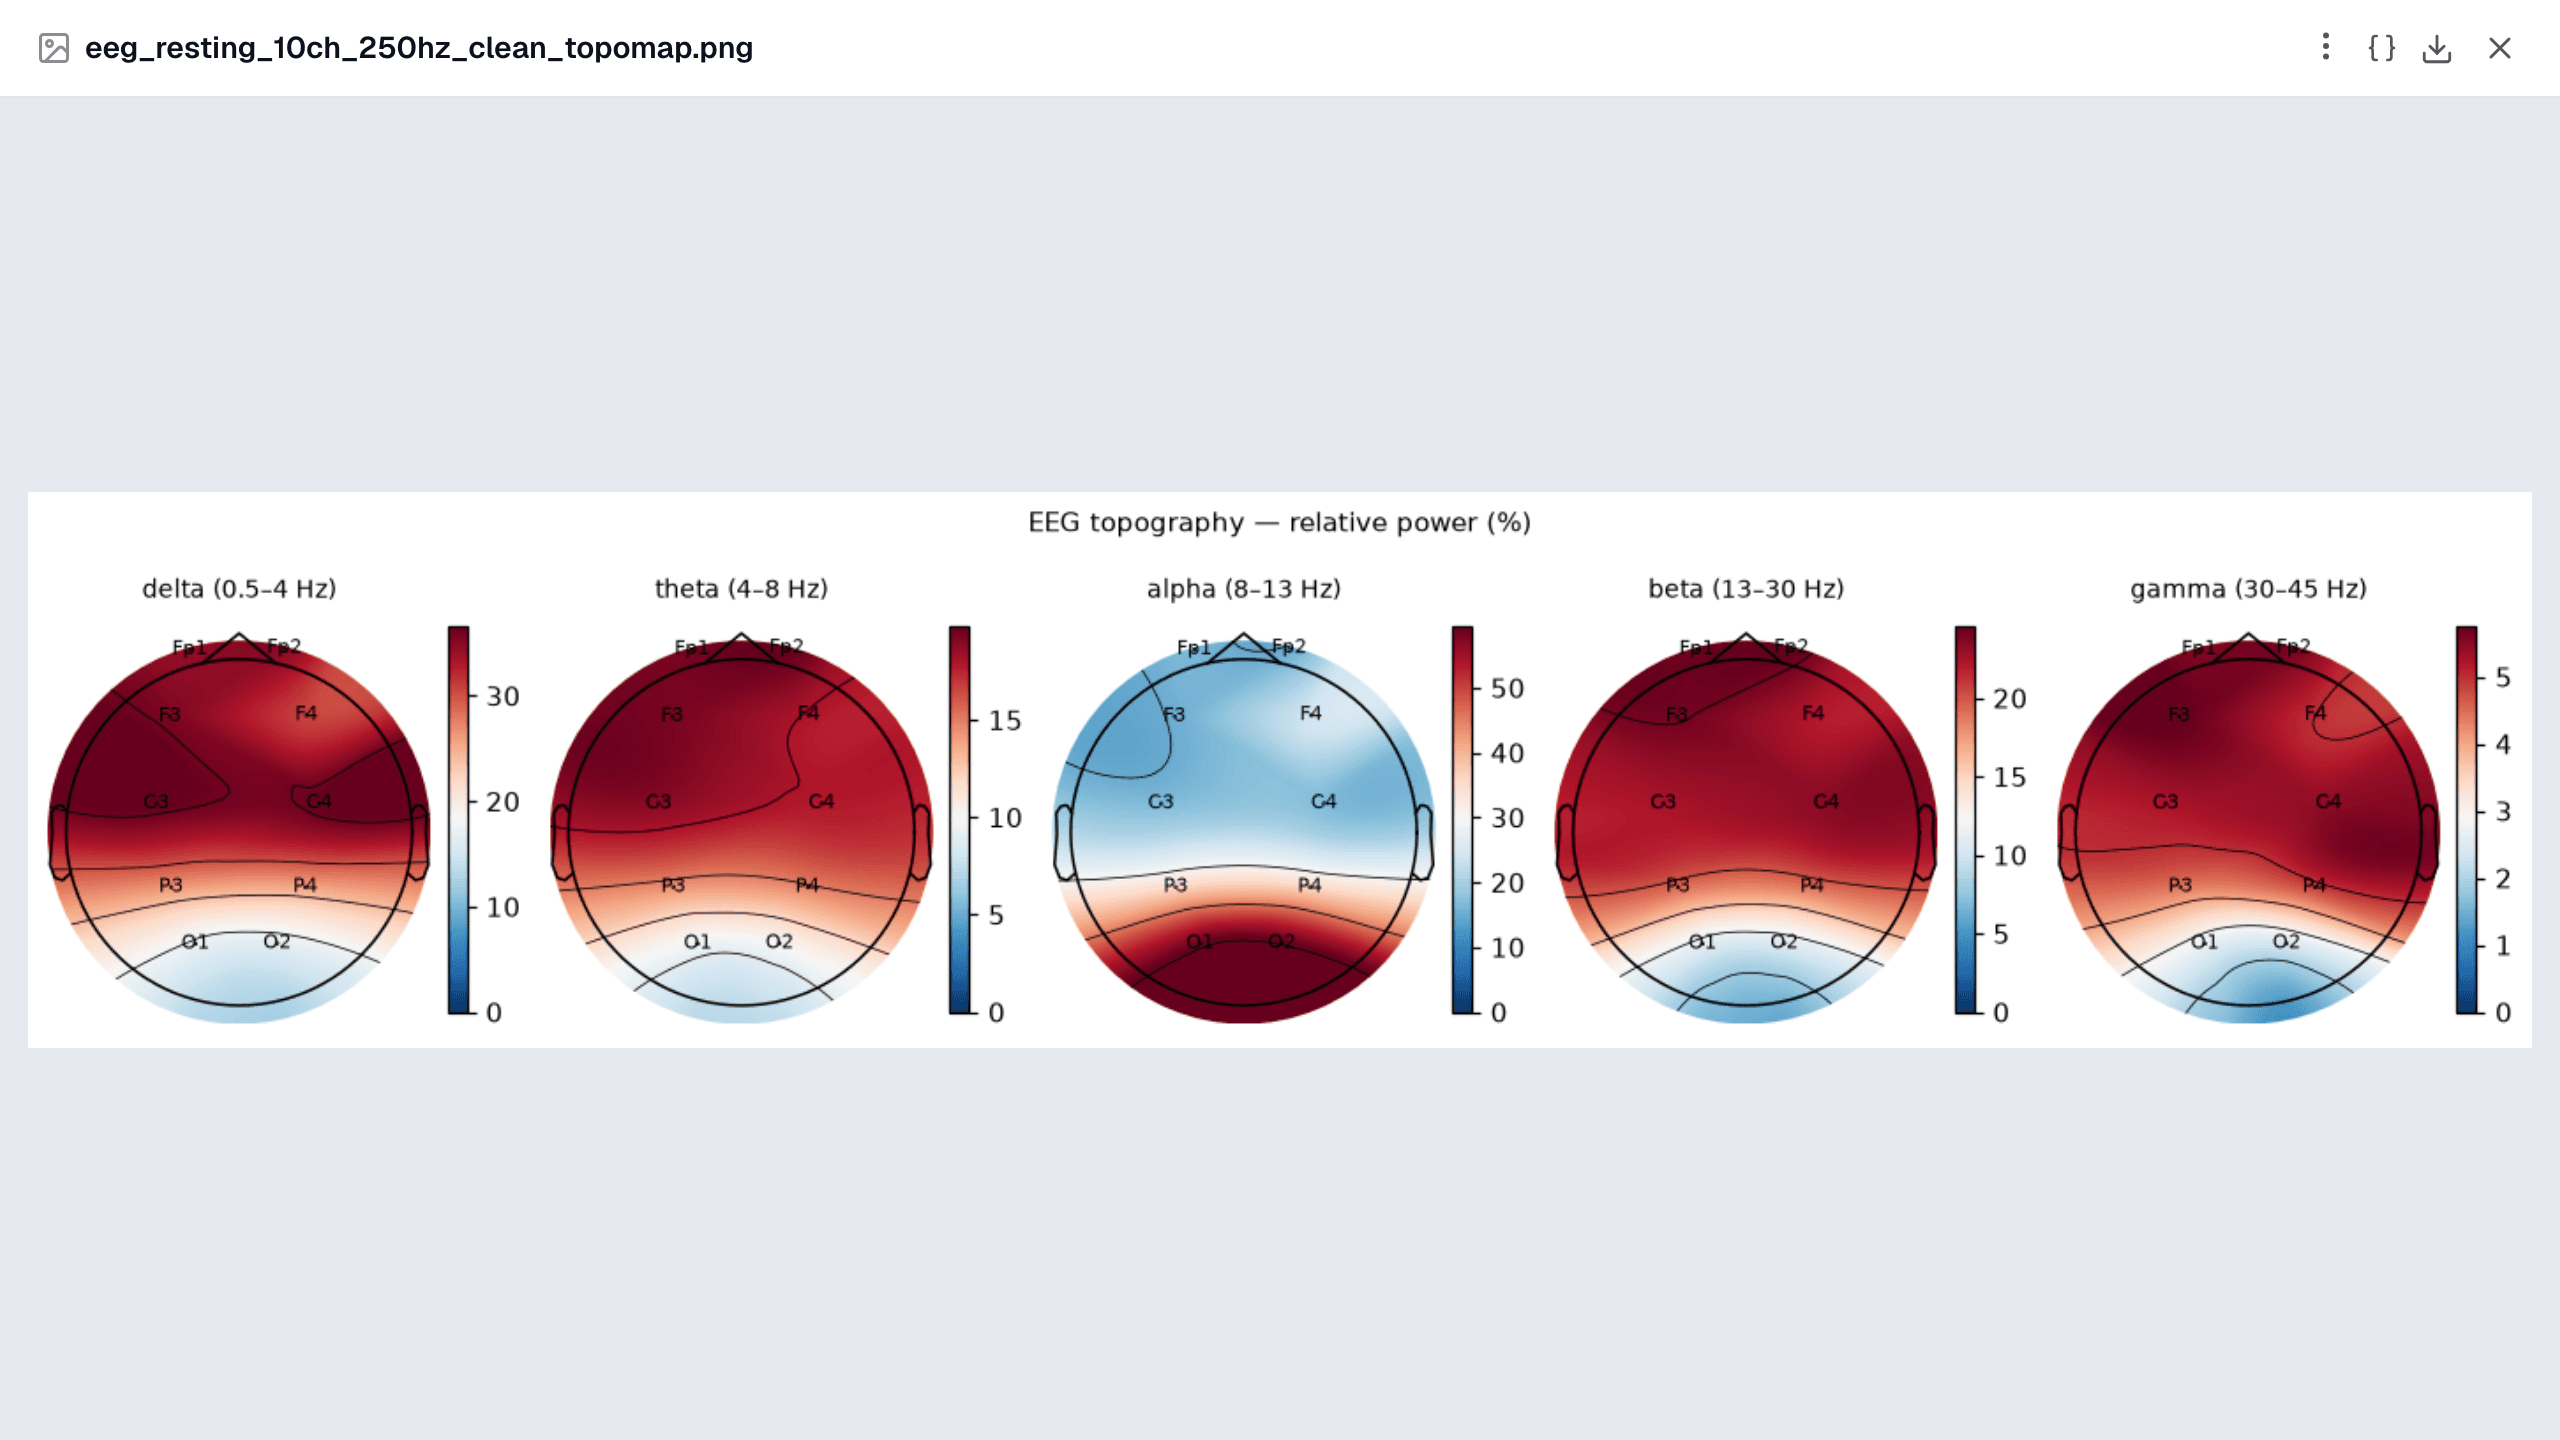
전두 알파 비대칭 값은 참조 방식에 따라 달라집니다. 그래서 에이전트는 비대칭 값마다 옆에 참조 방식을 적고, 안정 상태 기록 한 번으로 성격 특성을 해석하지 않습니다.
음성: 전사와 음성 특징, 로컬에서
WAV, MP3, M4A, FLAC, OGG, AAC 파일을 올리면 됩니다. 음성 트랙이 있는 영상도 됩니다.
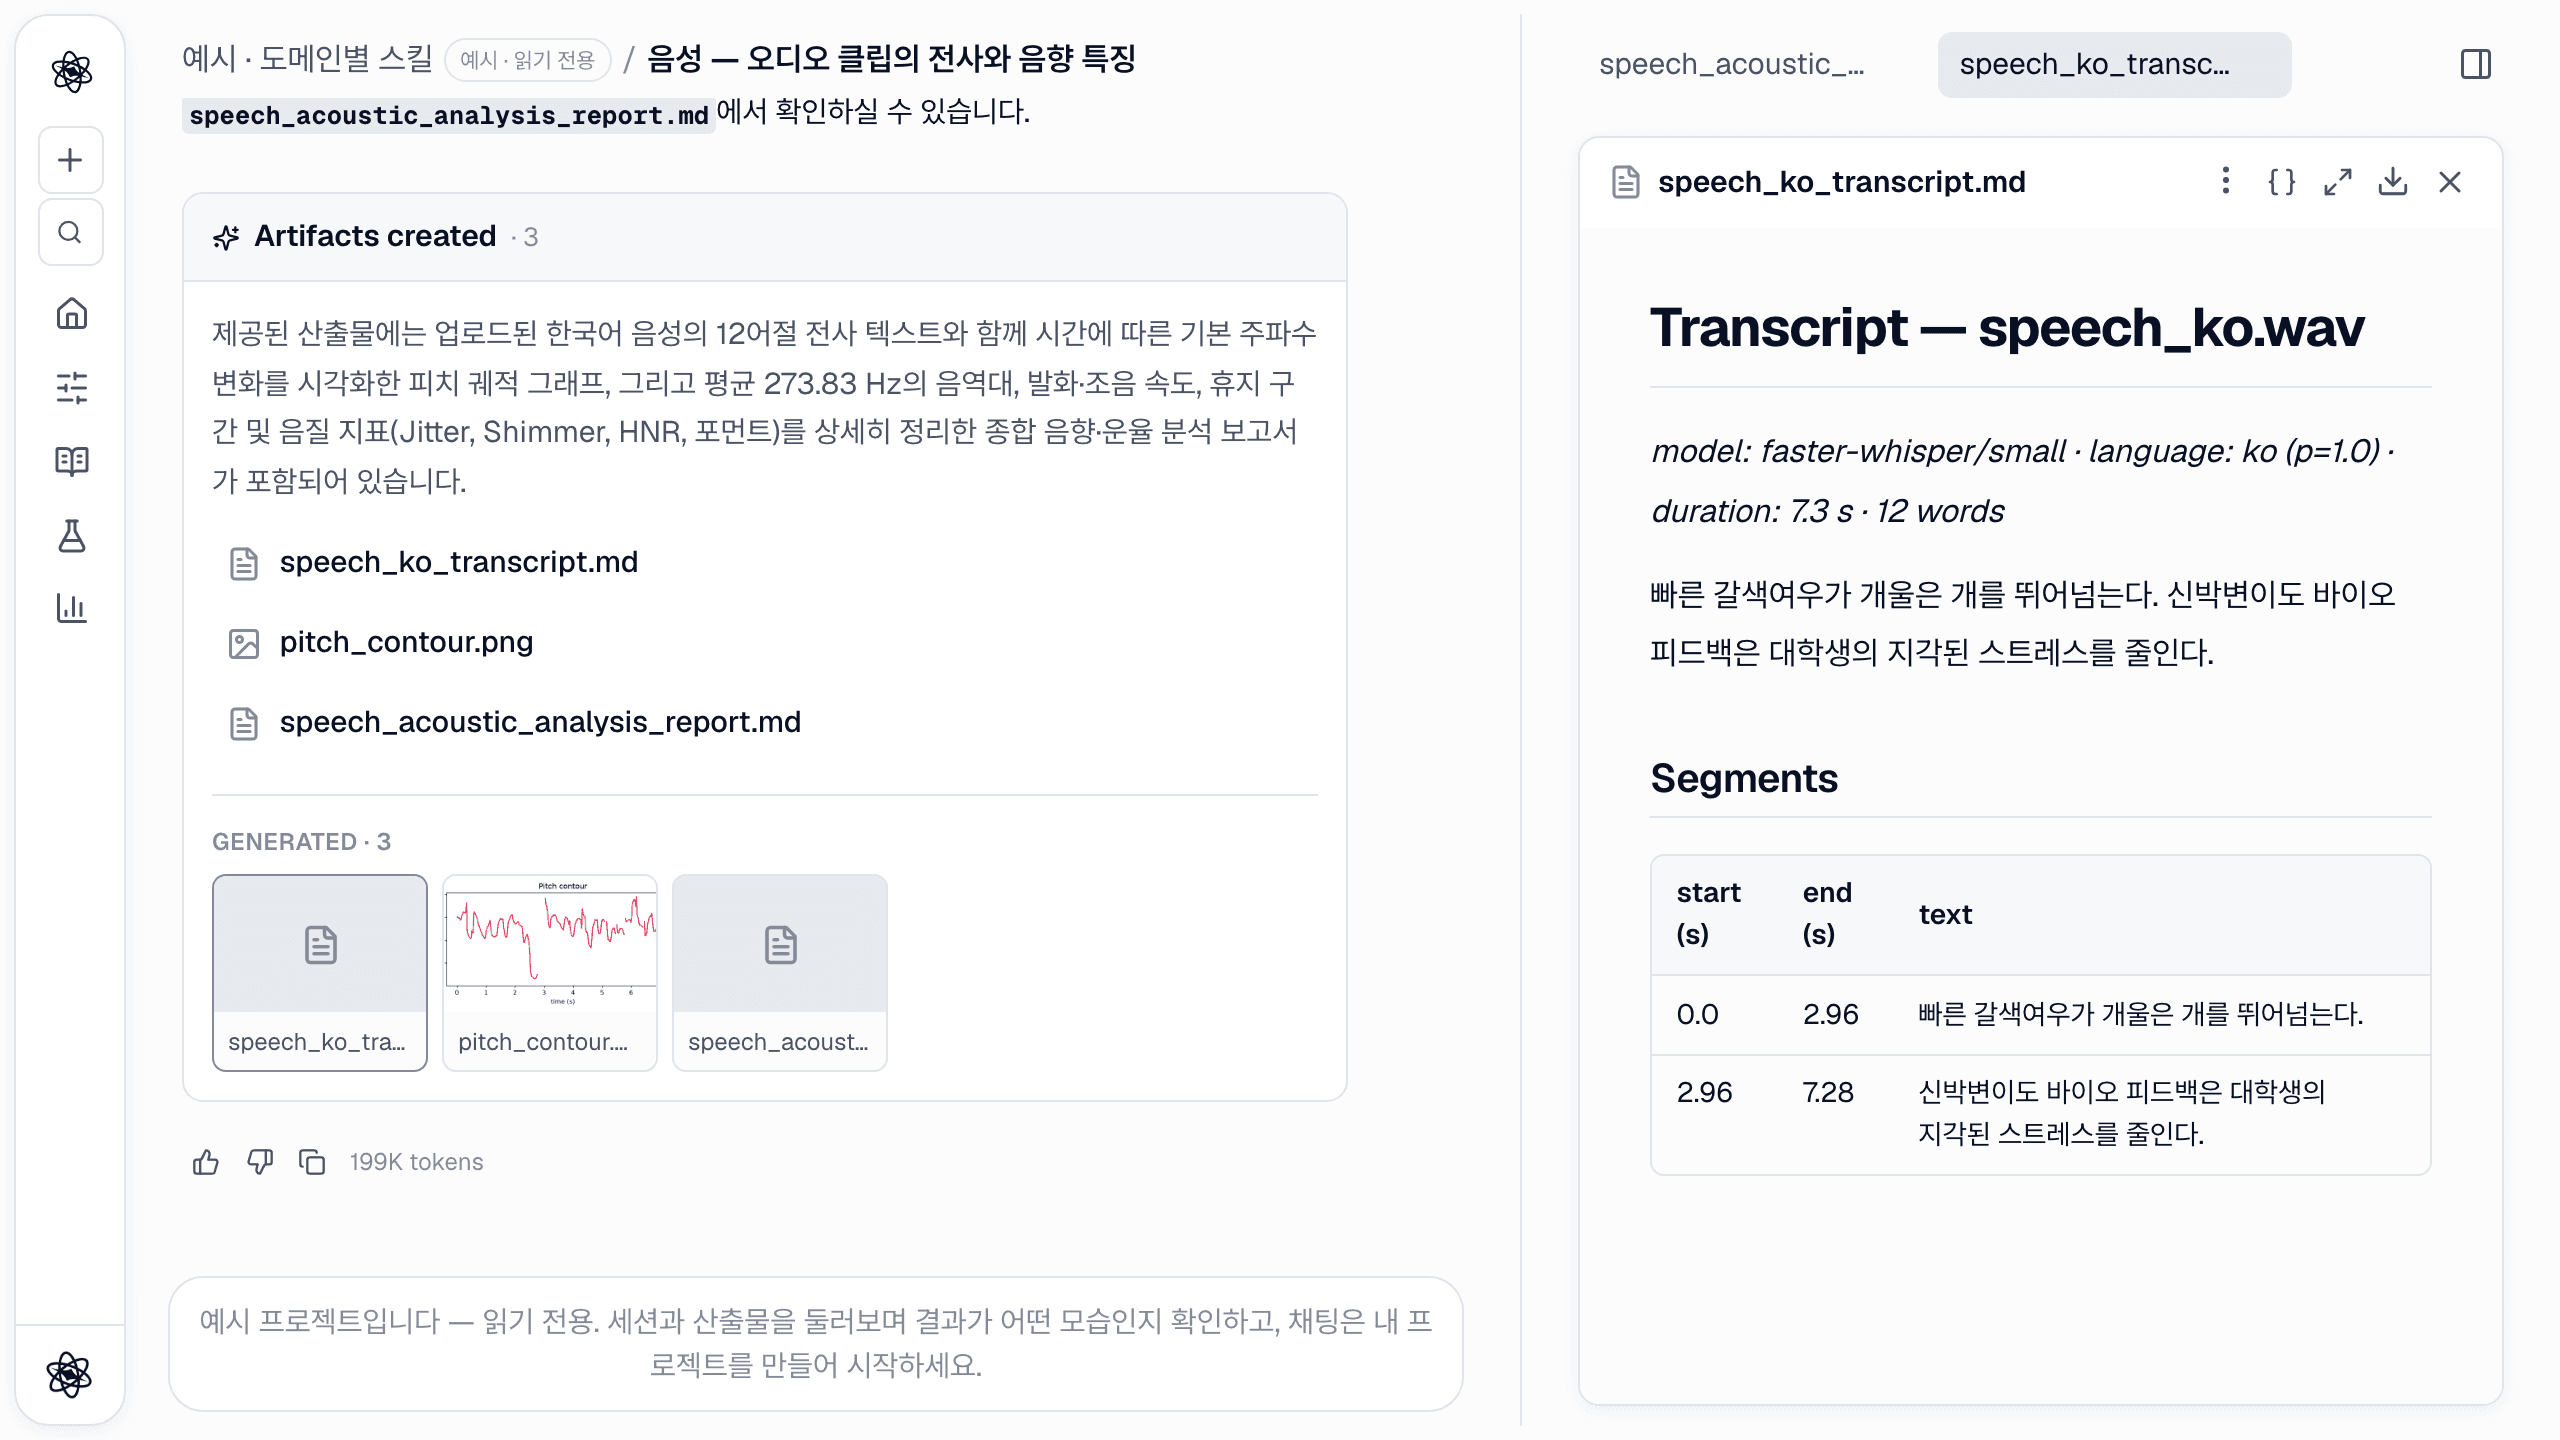
- 음성→텍스트 전사는 faster-whisper로 로컬에서 실행됩니다. 음성이 외부 전사 서비스로 나가지 않습니다. 타임스탬프가 붙은 구간, 감지된 언어와 그 확률, 단어 수, 발화 속도를 돌려줍니다.
- 음성·음향 특징으로는 F0(평균, 범위, 컨투어), 강도, jitter, shimmer, HNR, 포먼트 F1–F3, MFCC를 계산합니다.
/analyze speech_ko.wav 를 전사하고 음향 특징을 뽑아 줘: 피치 컨투어, 강도, jitter/shimmer/HNR, 포먼트, 발화 속도. 보고서로 정리해 줘.
영상과 이미지: 얼굴에서 표정, 자세, 심박까지
MP4, MOV, WebM, AVI, MKV 영상이나 정지 이미지를 올리면 됩니다.
- 얼굴 표정 도구는 얼굴 행동 단위(AU01, AU06, AU12, AU25 …)를 시간에 따라 추적합니다. EMFACS 감정 판정과 머리 자세도 함께 냅니다.
- 자세 도구는 신체 랜드마크 33개로 관절 각도, 자세, 움직임을 계산합니다.
- rPPG는 얼굴 피부색의 미세한 변화로 심박수를 추정합니다. 공개된 알고리즘 세 가지(POS, CHROM, GREEN)를 모두 돌리고 방법마다 SNR을 보고합니다. 방법끼리 결과가 어긋나면 바로 보입니다.
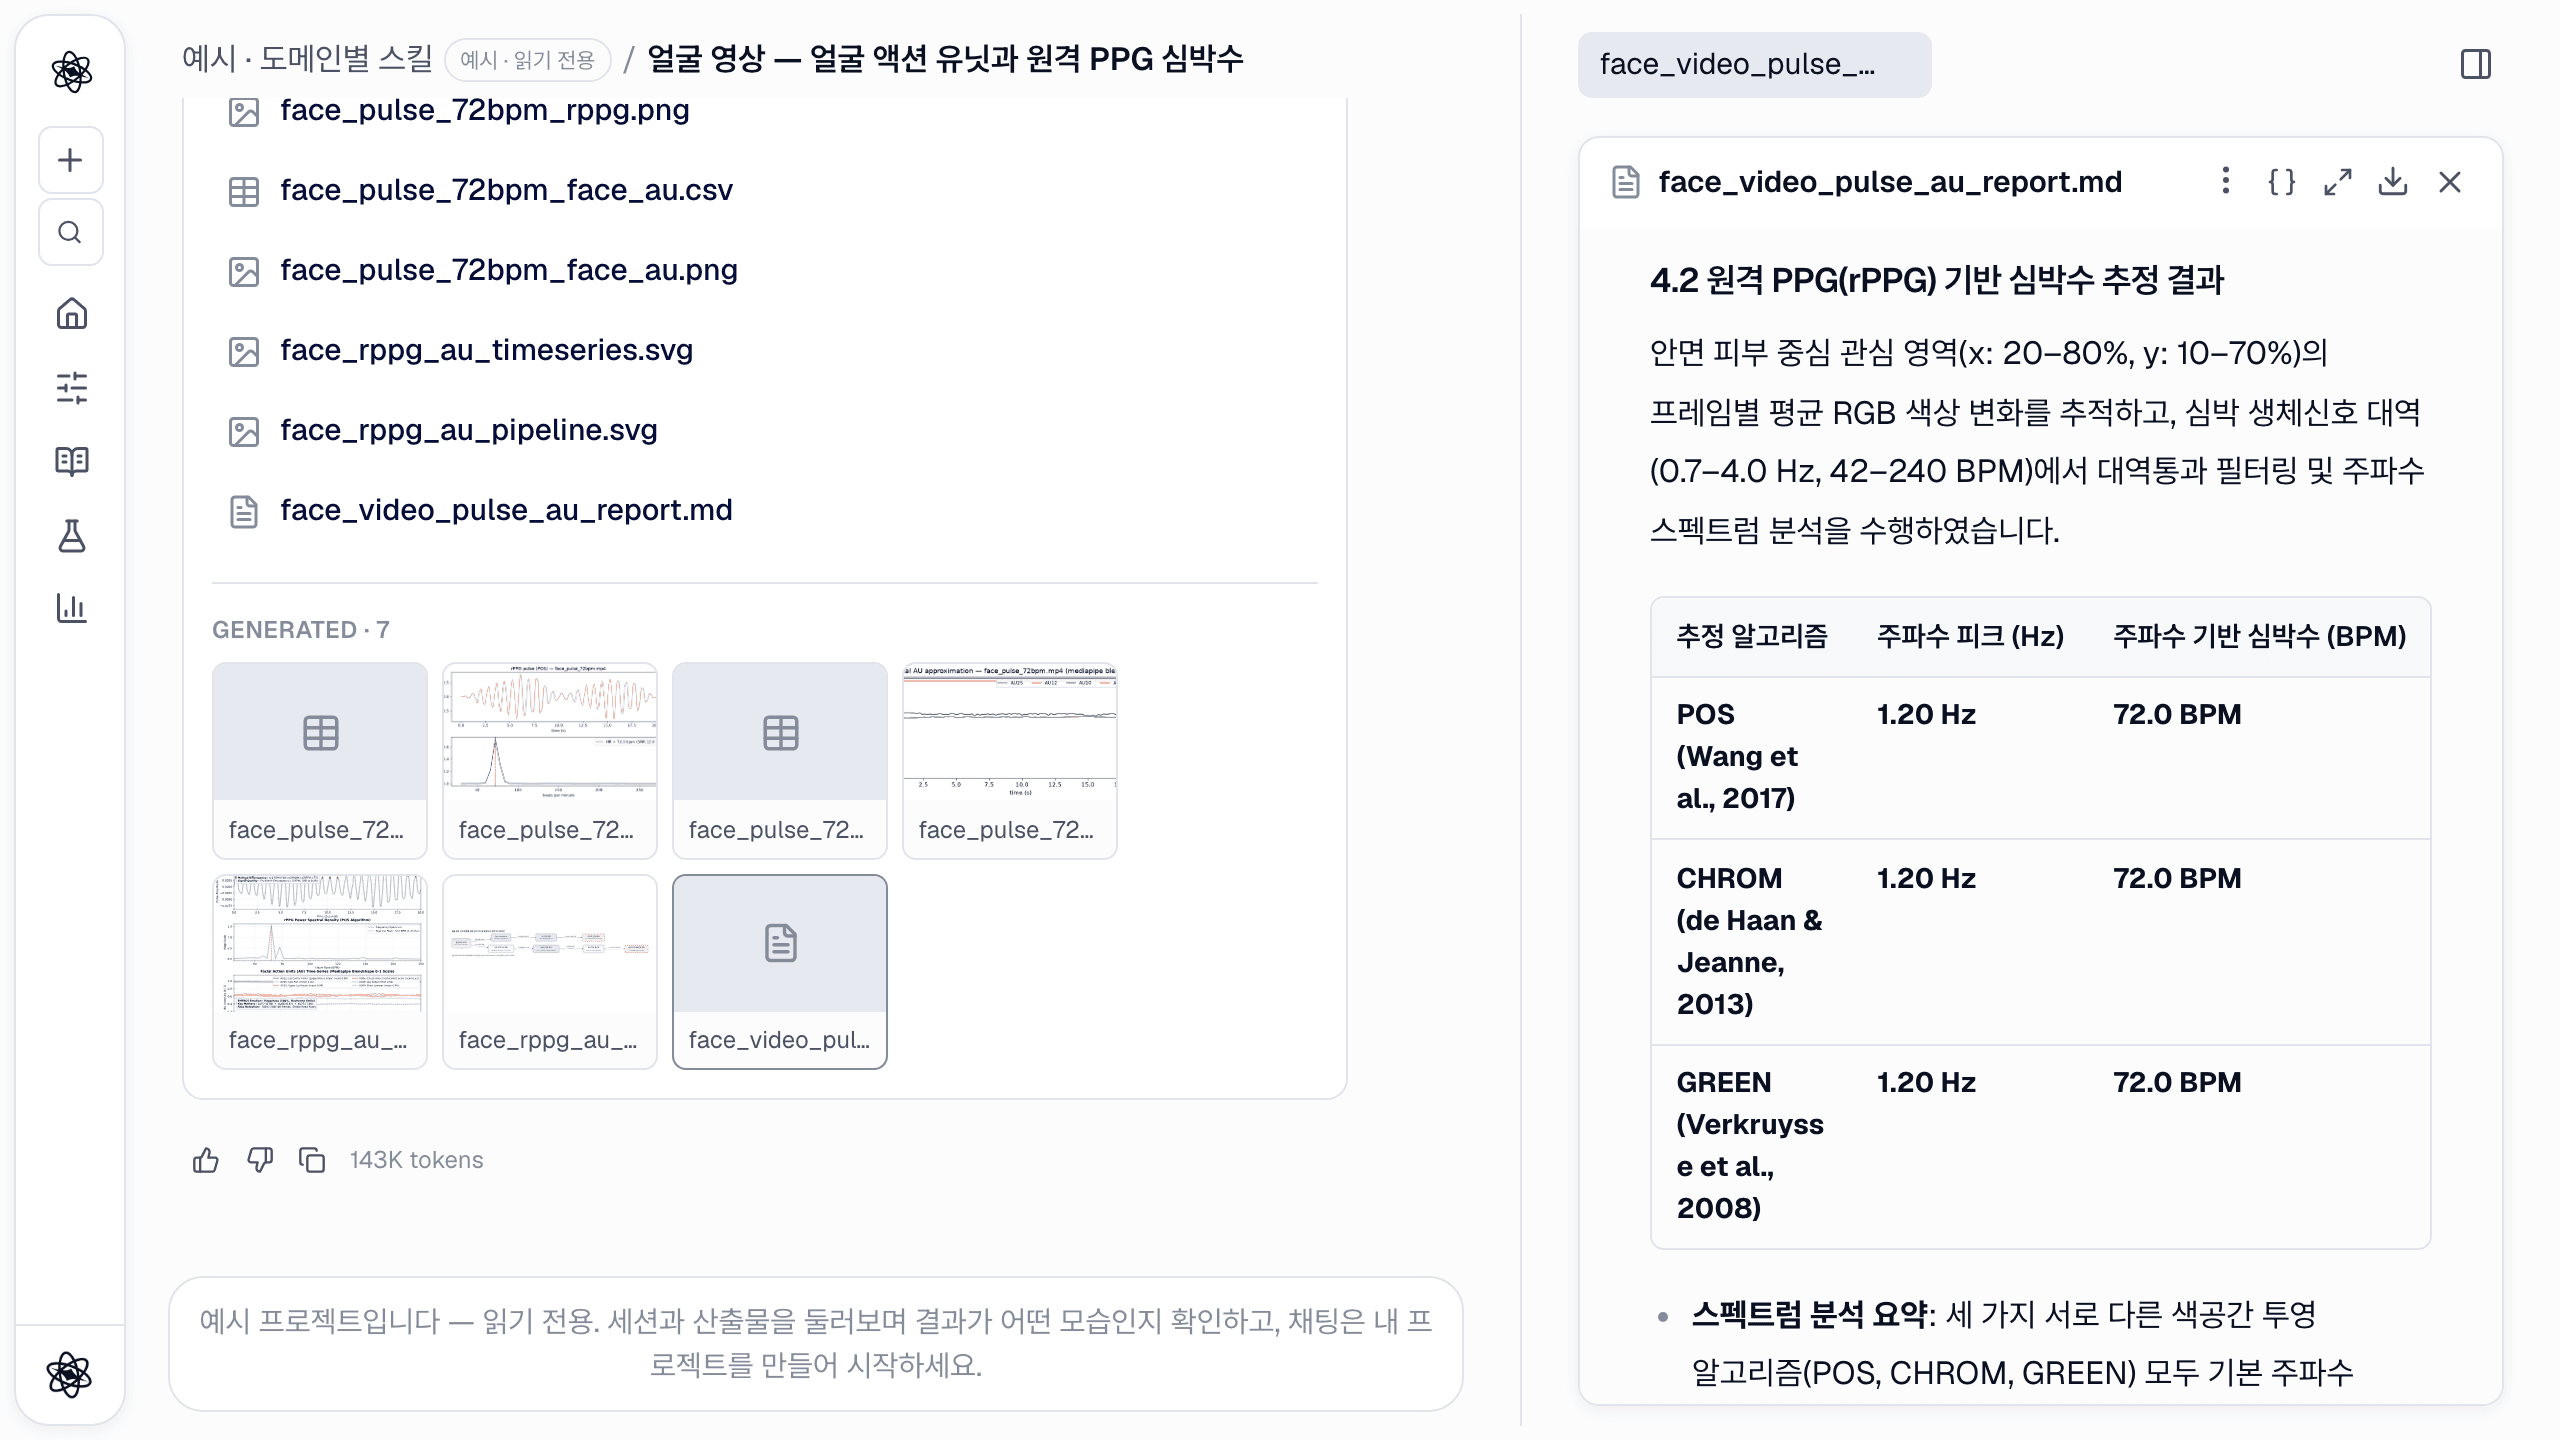
AU 시계열과 맥파 스펙트럼까지 포함한 얼굴 영상 파이프라인 전체는 정신생리학 연구실을 위한 뉴트로픽에서 단계별로 볼 수 있습니다.
생체신호 CSV
ECG, PPG, EDA, 호흡, RR 간격 내보내기 파일도 표입니다. ECG나 PPG로 심박수를, EDA로 SCR 수와 피부전도 수준을, 호흡률을, 또는 시간·주파수 영역 HRV(평균 RR, SDNN, RMSSD, pNN50)를 요청하면 됩니다. HRV와 EDA에는 전용 도구가 있습니다. 그림(예: 타코그램)과 보고서를 돌려주고, 보고서에는 기록 길이에 따른 주의점이 붙습니다.
그다음은 통계: 이유와 함께 고른 검정
특징 추출이 끝이 아닌 경우가 대부분입니다. 보통은 조건이나 집단을 비교해야 합니다. 통계 스킬의 compare_groups 도구는 설계와 데이터를 보고 검정을 고르고, 왜 그 검정을 골랐는지 결정 기록(decision trace)으로 남깁니다.
- 설계를 식별합니다. 독립인지 대응인지, 두 집단인지 여러 집단인지, 일표본인지 봅니다.
- 가정을 점검합니다. 집단별 Shapiro–Wilk, Levene, 반복측정이면 Mauchly를 확인합니다.
- 정해진 규칙으로 검정을 고릅니다. 소표본(n < 50)에서 정규성이 위반되면 비모수 검정을 씁니다. 분산이 다르면 Welch를 씁니다. 순서형 결과에는 항상 비모수 검정을 씁니다.
- 효과크기와 신뢰구간을 보고하고, 사후검정을 실행하고, 기술통계 표와 박스/스트립 그림을 저장합니다.
선택지는 Student·Welch t, Mann–Whitney, 대응 t, Wilcoxon, 일원·Welch ANOVA(Tukey·Games–Howell), Kruskal–Wallis, 반복측정 ANOVA, Friedman입니다. 교차표는 chi_square가, 이원·혼합·ANCOVA 설계는 anova_design이 맡습니다.
/stats p3_by_participant.csv 에서 두 집단의 Pz P3 진폭을 비교해 줘. 가정을 점검해서 알맞은 검정을 고르고, 왜 그 검정인지 설명해 줘.
데이터가 치우쳐 있고 집단이 작으면 결정 기록에 그 사실이 적힙니다(예: "normality violated … n_min = 18 → non-parametric"). 그러면 돌리지 말았어야 할 t 검정 대신 Mann–Whitney U와 순위 이연 상관 효과크기를 받게 됩니다. 자세한 흐름은 스킬 가이드: /stats에 있습니다.
모든 숫자를 추적할 수 있습니다
- 도구 호출마다 이름과 인자가 기록됩니다. 그림과 표에는 그것을 만든 코드가 함께 저장되고(산출물 패널의 { } 버튼), 정제한 데이터는 원본을 덮어쓰지 않고 새 파일로 저장됩니다.
- 분석 보고서는 도구 출력으로 작성됩니다. 보고서 문장에는 [n] 인용이 붙어, 각 숫자의 근거가 된 분석 단계나 데이터 파일을 가리킵니다.
- 원시 신호에서 정제, 특징, 검정, 원고까지 전 과정이 한 세션에 남습니다. 논문 초안을 쓸 때 /write로 바로 이어 갈 수 있습니다. 자세한 내용은 기본이 재현성을 참고하세요.
솔직한 한계
- EEG 입력은 표입니다. EDF/BDF나 장비 고유 형식은 먼저 CSV로 변환해 주세요. ERP 성분 창은 고정입니다(N1 70–150 ms, P3 250–600 ms). 눈 깜박임 제거에는 전두 채널이 필요합니다. 별도 EOG 채널은 아직 쓰지 않습니다. 토포맵은 10–20 이름이 붙은 채널만 그립니다.
- rPPG는 고전 방법(POS, CHROM, GREEN)만 씁니다. 딥러닝 rPPG는 포함하지 않았고, 머리 움직임이 크거나 조명이 바뀌면 SNR이 떨어집니다.
- 행동 단위(AU)는 얼굴 랜드마크 블렌드셰이프로 근사한 0–1 값입니다. OpenFace 강도(0–5)와 척도가 다르고, AU06도 근사치입니다.
- 자세 각도는 2차원 투영값입니다.
- 측정값은 도구가 돌려준 값뿐입니다. 에이전트는 도구 값을 그대로 인용하고, 도구가 하지 못한 것(얼굴 미검출, 낮은 SNR, 불확실한 언어)은 그렇다고 분명히 말하도록 지시받습니다.
예시 프로젝트에서 이 세션들을 먼저 둘러보거나, 직접 기록을 첨부하고 무엇인지 설명해 보세요. 지원 형식과 옵션은 데이터 분석 문서에 정리돼 있습니다.