研究比想象中更常和图像打交道:想核对的论文插图、需要统一描述的刺激材料、软件输出的截图,还有参与者的照片。Neutropic 用两种不同的方式处理图像。模型可以看图,告诉你它看到了什么;测量工具可以量图,返回数字以及背后的代码。弄清楚你拿到的是哪一种,就完成了大半工作。
本文两种方式都会介绍。截图来自两次新对话:一次读柱状图,一次测量两张照片。
如何把图像交给 Neutropic
- 在输入框中上传(PNG、JPG、GIF 或 WebP)。上传的文件会以 @ 标签附在消息上,模型随这条消息一起看到图像。
- 用 @ 提及已有的图像。 项目里 Neutropic 之前生成的图也可以,比如投稿前请它点评一张图表。
有几条实际限制:
- 每条消息最多附 4 张图,每张不超过 4 MB。
- 模型必须支持图像。Gemini、Claude、GPT 和 Kimi 模型支持,DeepSeek 模型不支持,问图像相关的问题时请切换模型。
- 模型只能看到当前消息附带的图像。之前上传的文件只会列出名称,代理会请你用 @ 重新附上,而不是去猜。
读一张图
以一个典型请求为例:手上有一张来自论文或同事的柱状图,但没有数据文件。
请读一下附上的图 stroop_rt_figure.png:它展示了什么?根据坐标轴估计每根柱子的均值和误差线,说明它提示了什么模式,并列出仅凭这张图无法判断的内容。
这张图是我们自己画的,所以知道真实值:一致条件下为 512 和 505 ms,不一致条件下为 598 和 561 ms,标准误分别为 14、13、17 和 15 ms。
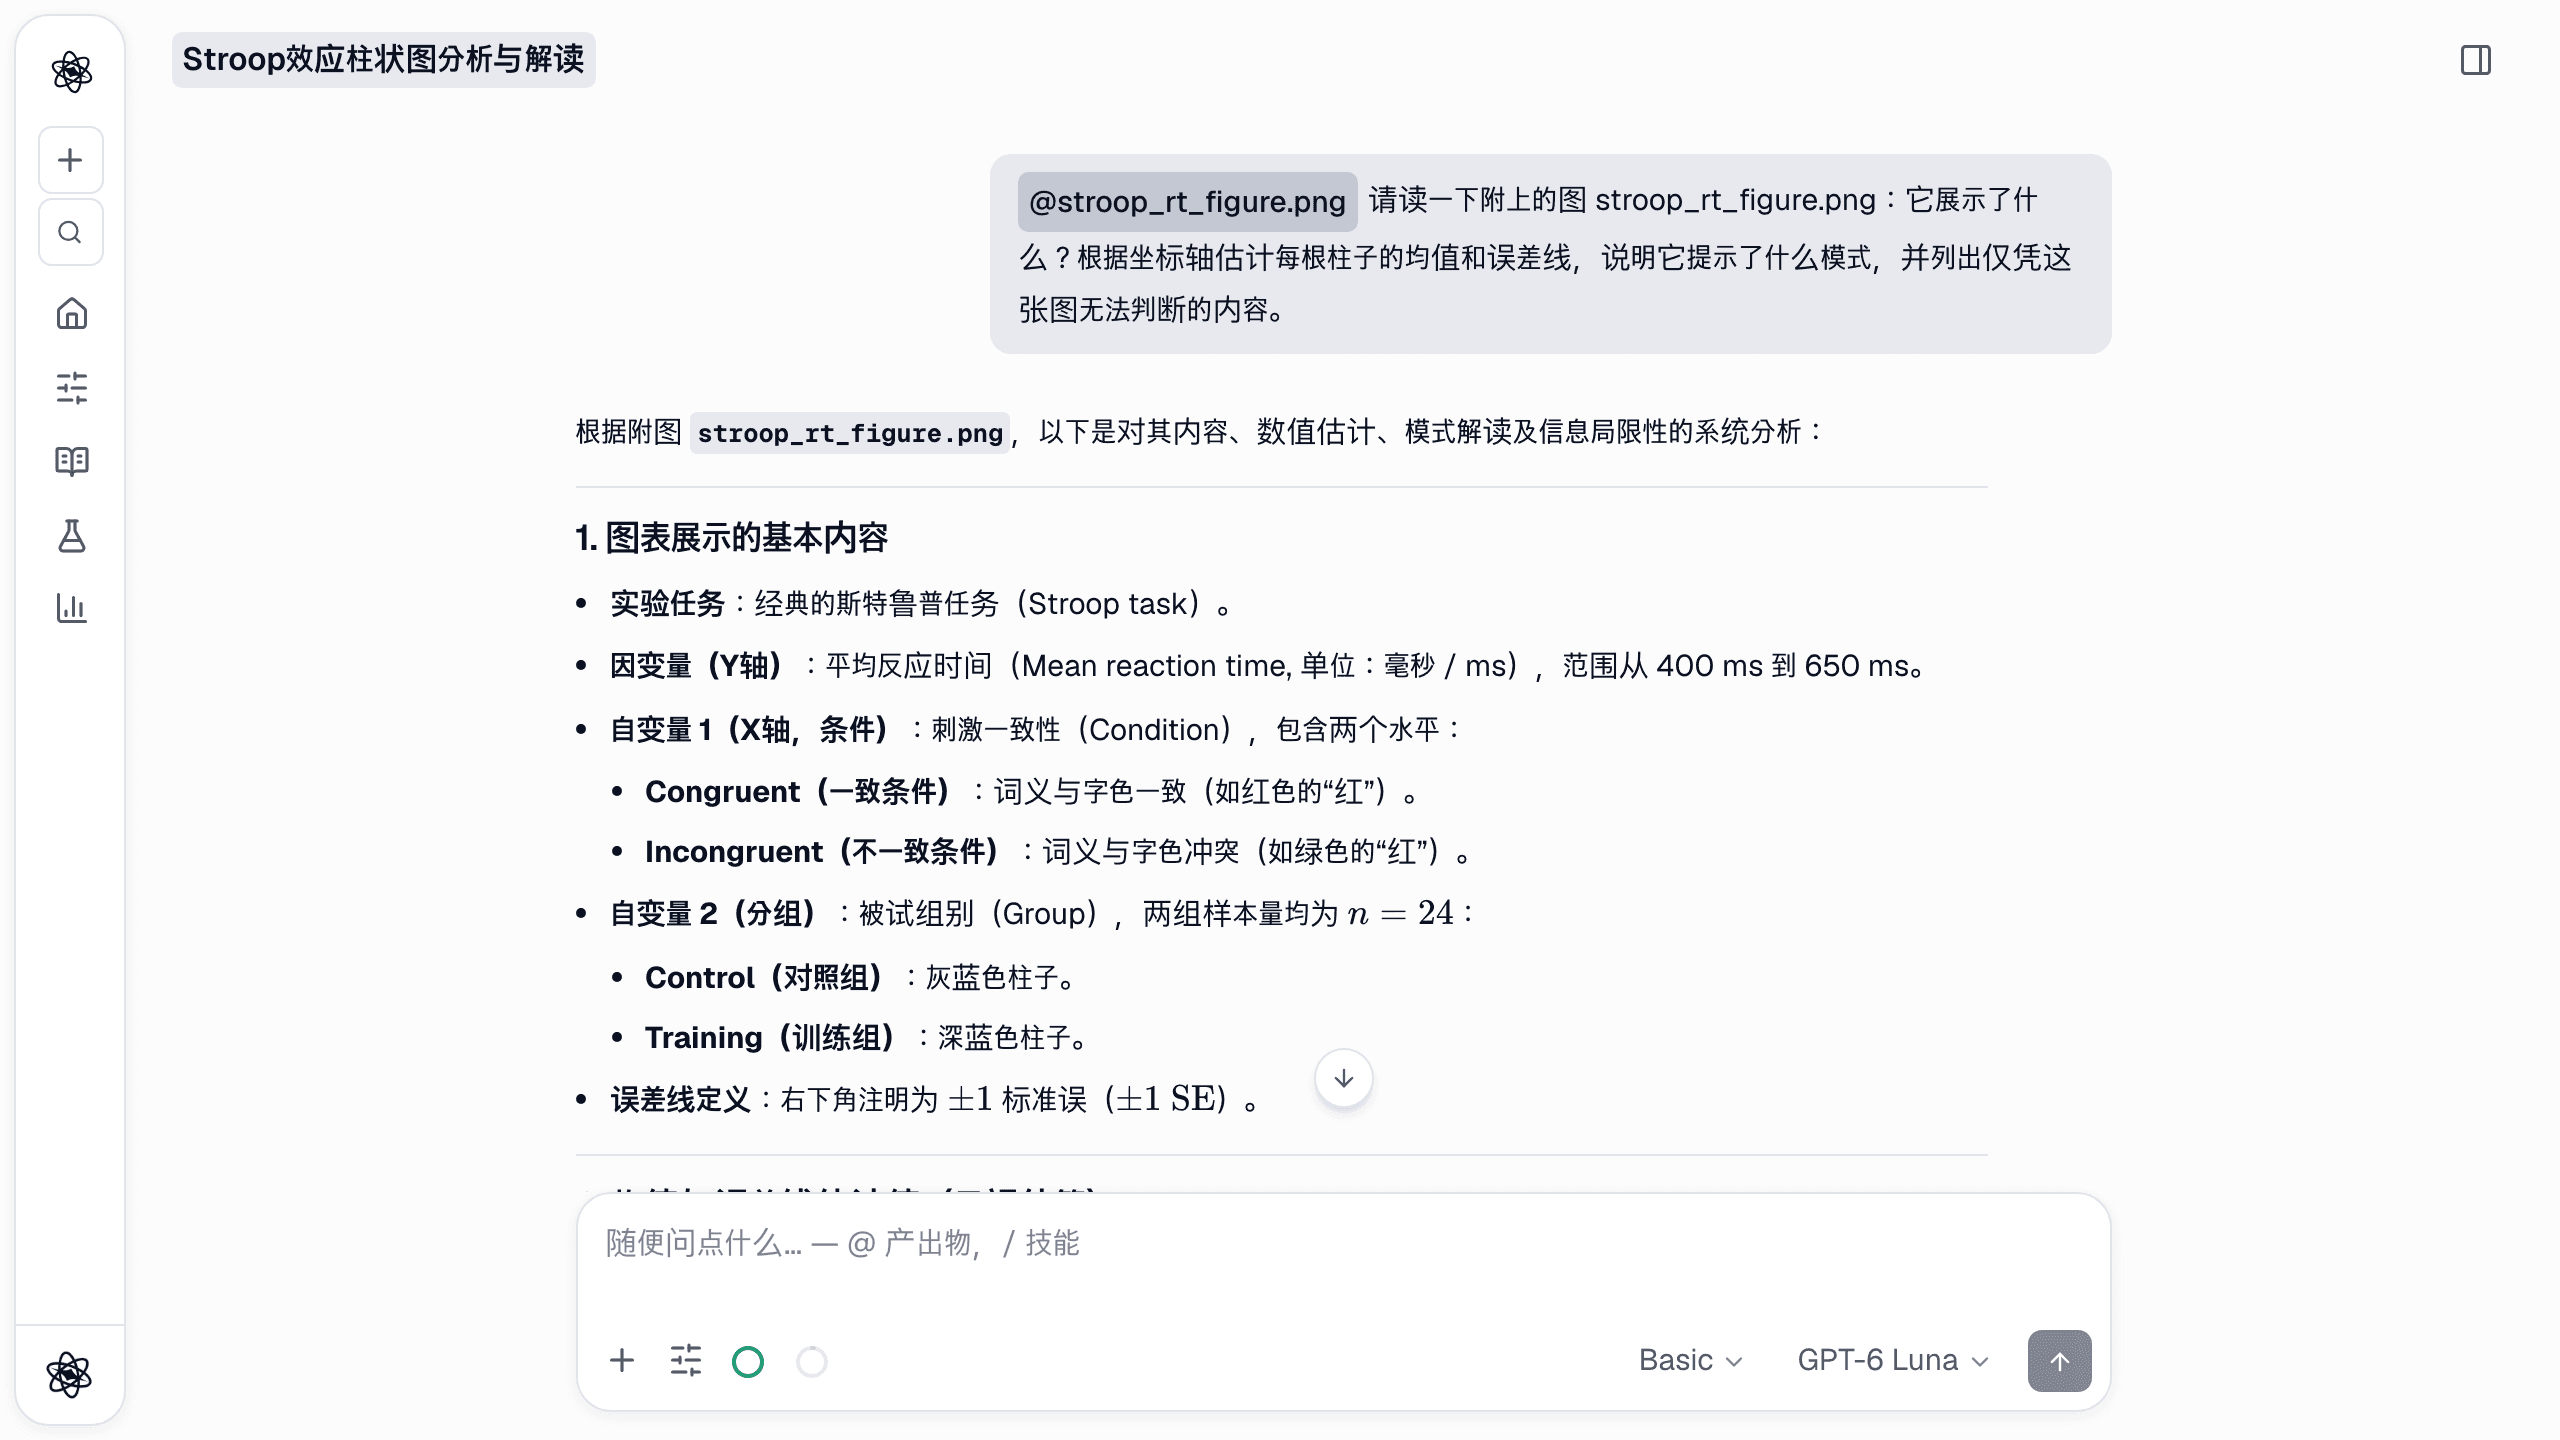
在这次运行中,代理是看图读数的:它估计各柱约为 512、505、598、561 ms,标准误约为 14、13、17、15 ms,与画图时使用的数值一致。在另一次用英文发送同一请求的运行中,代理更进一步,在沙箱中载入图像,找到坐标轴刻度,把像素换算成毫秒,再定位每根柱子的顶端。它的估计是 511.2、504.3、597.3 和 560.4 ms,与真实值的差都在 1 ms 以内,代码也随回答一起保存。
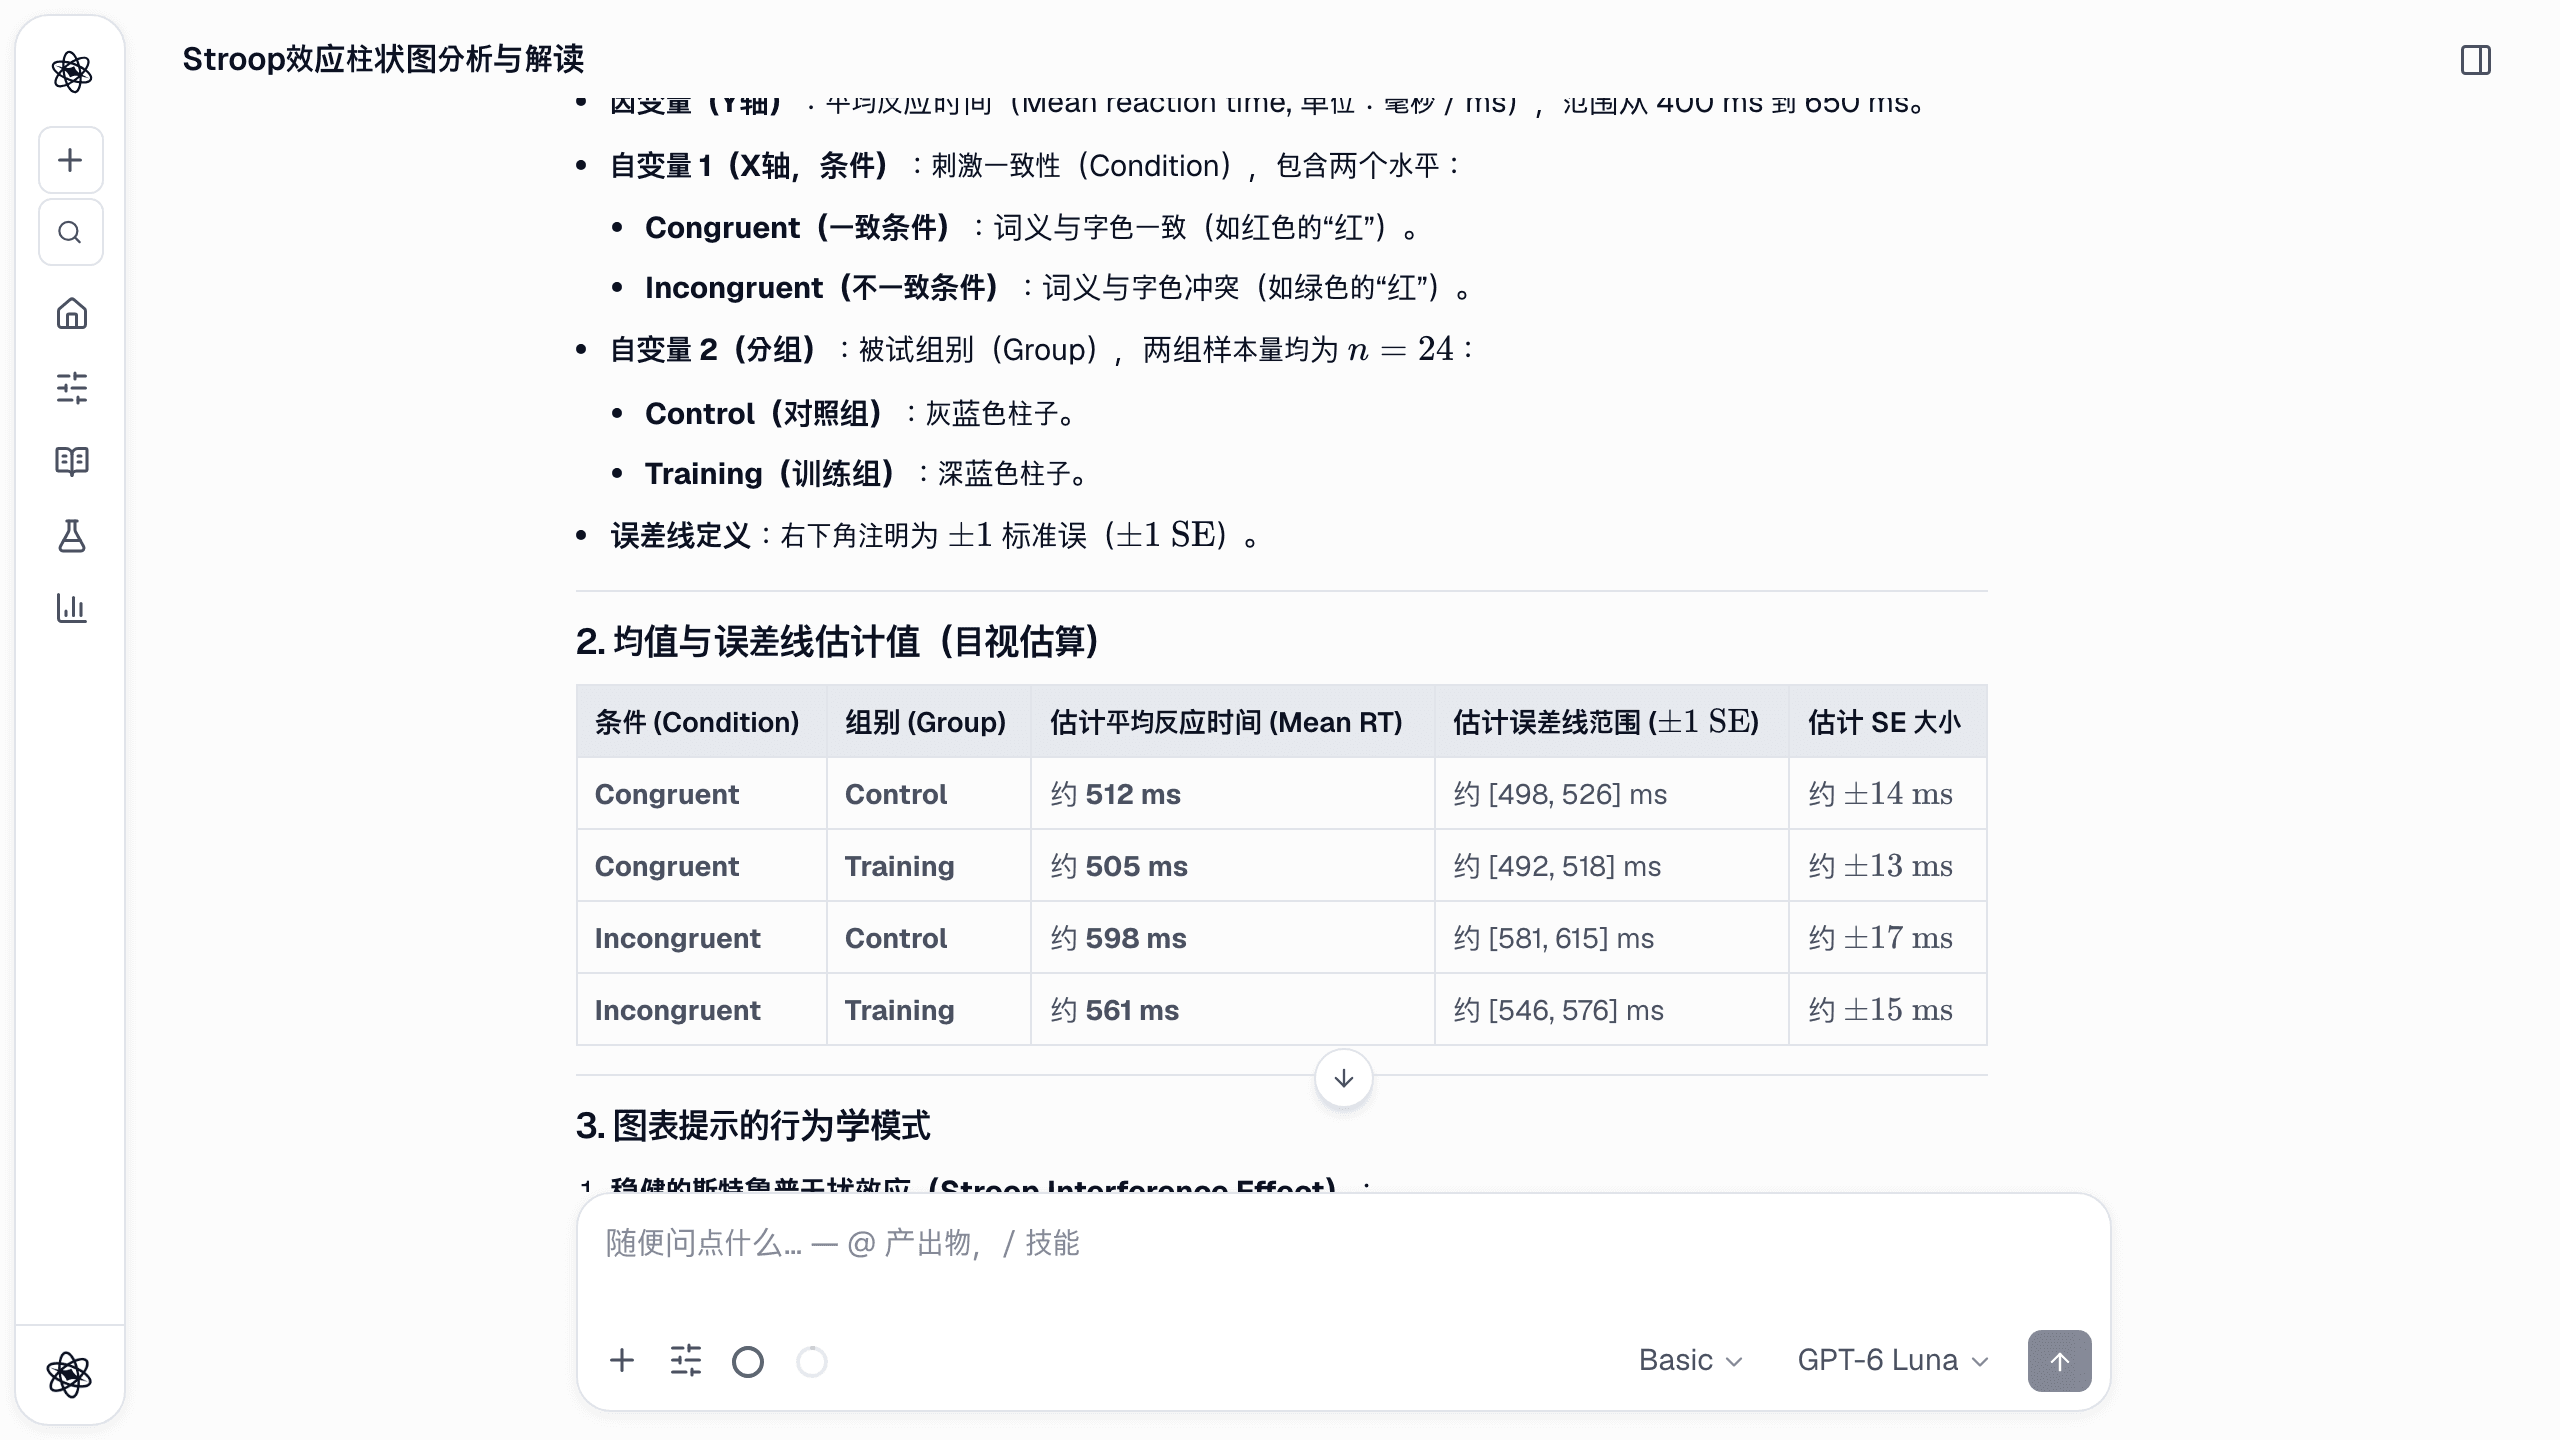
回答中更有用的一半,往往是图表说不出来的部分:
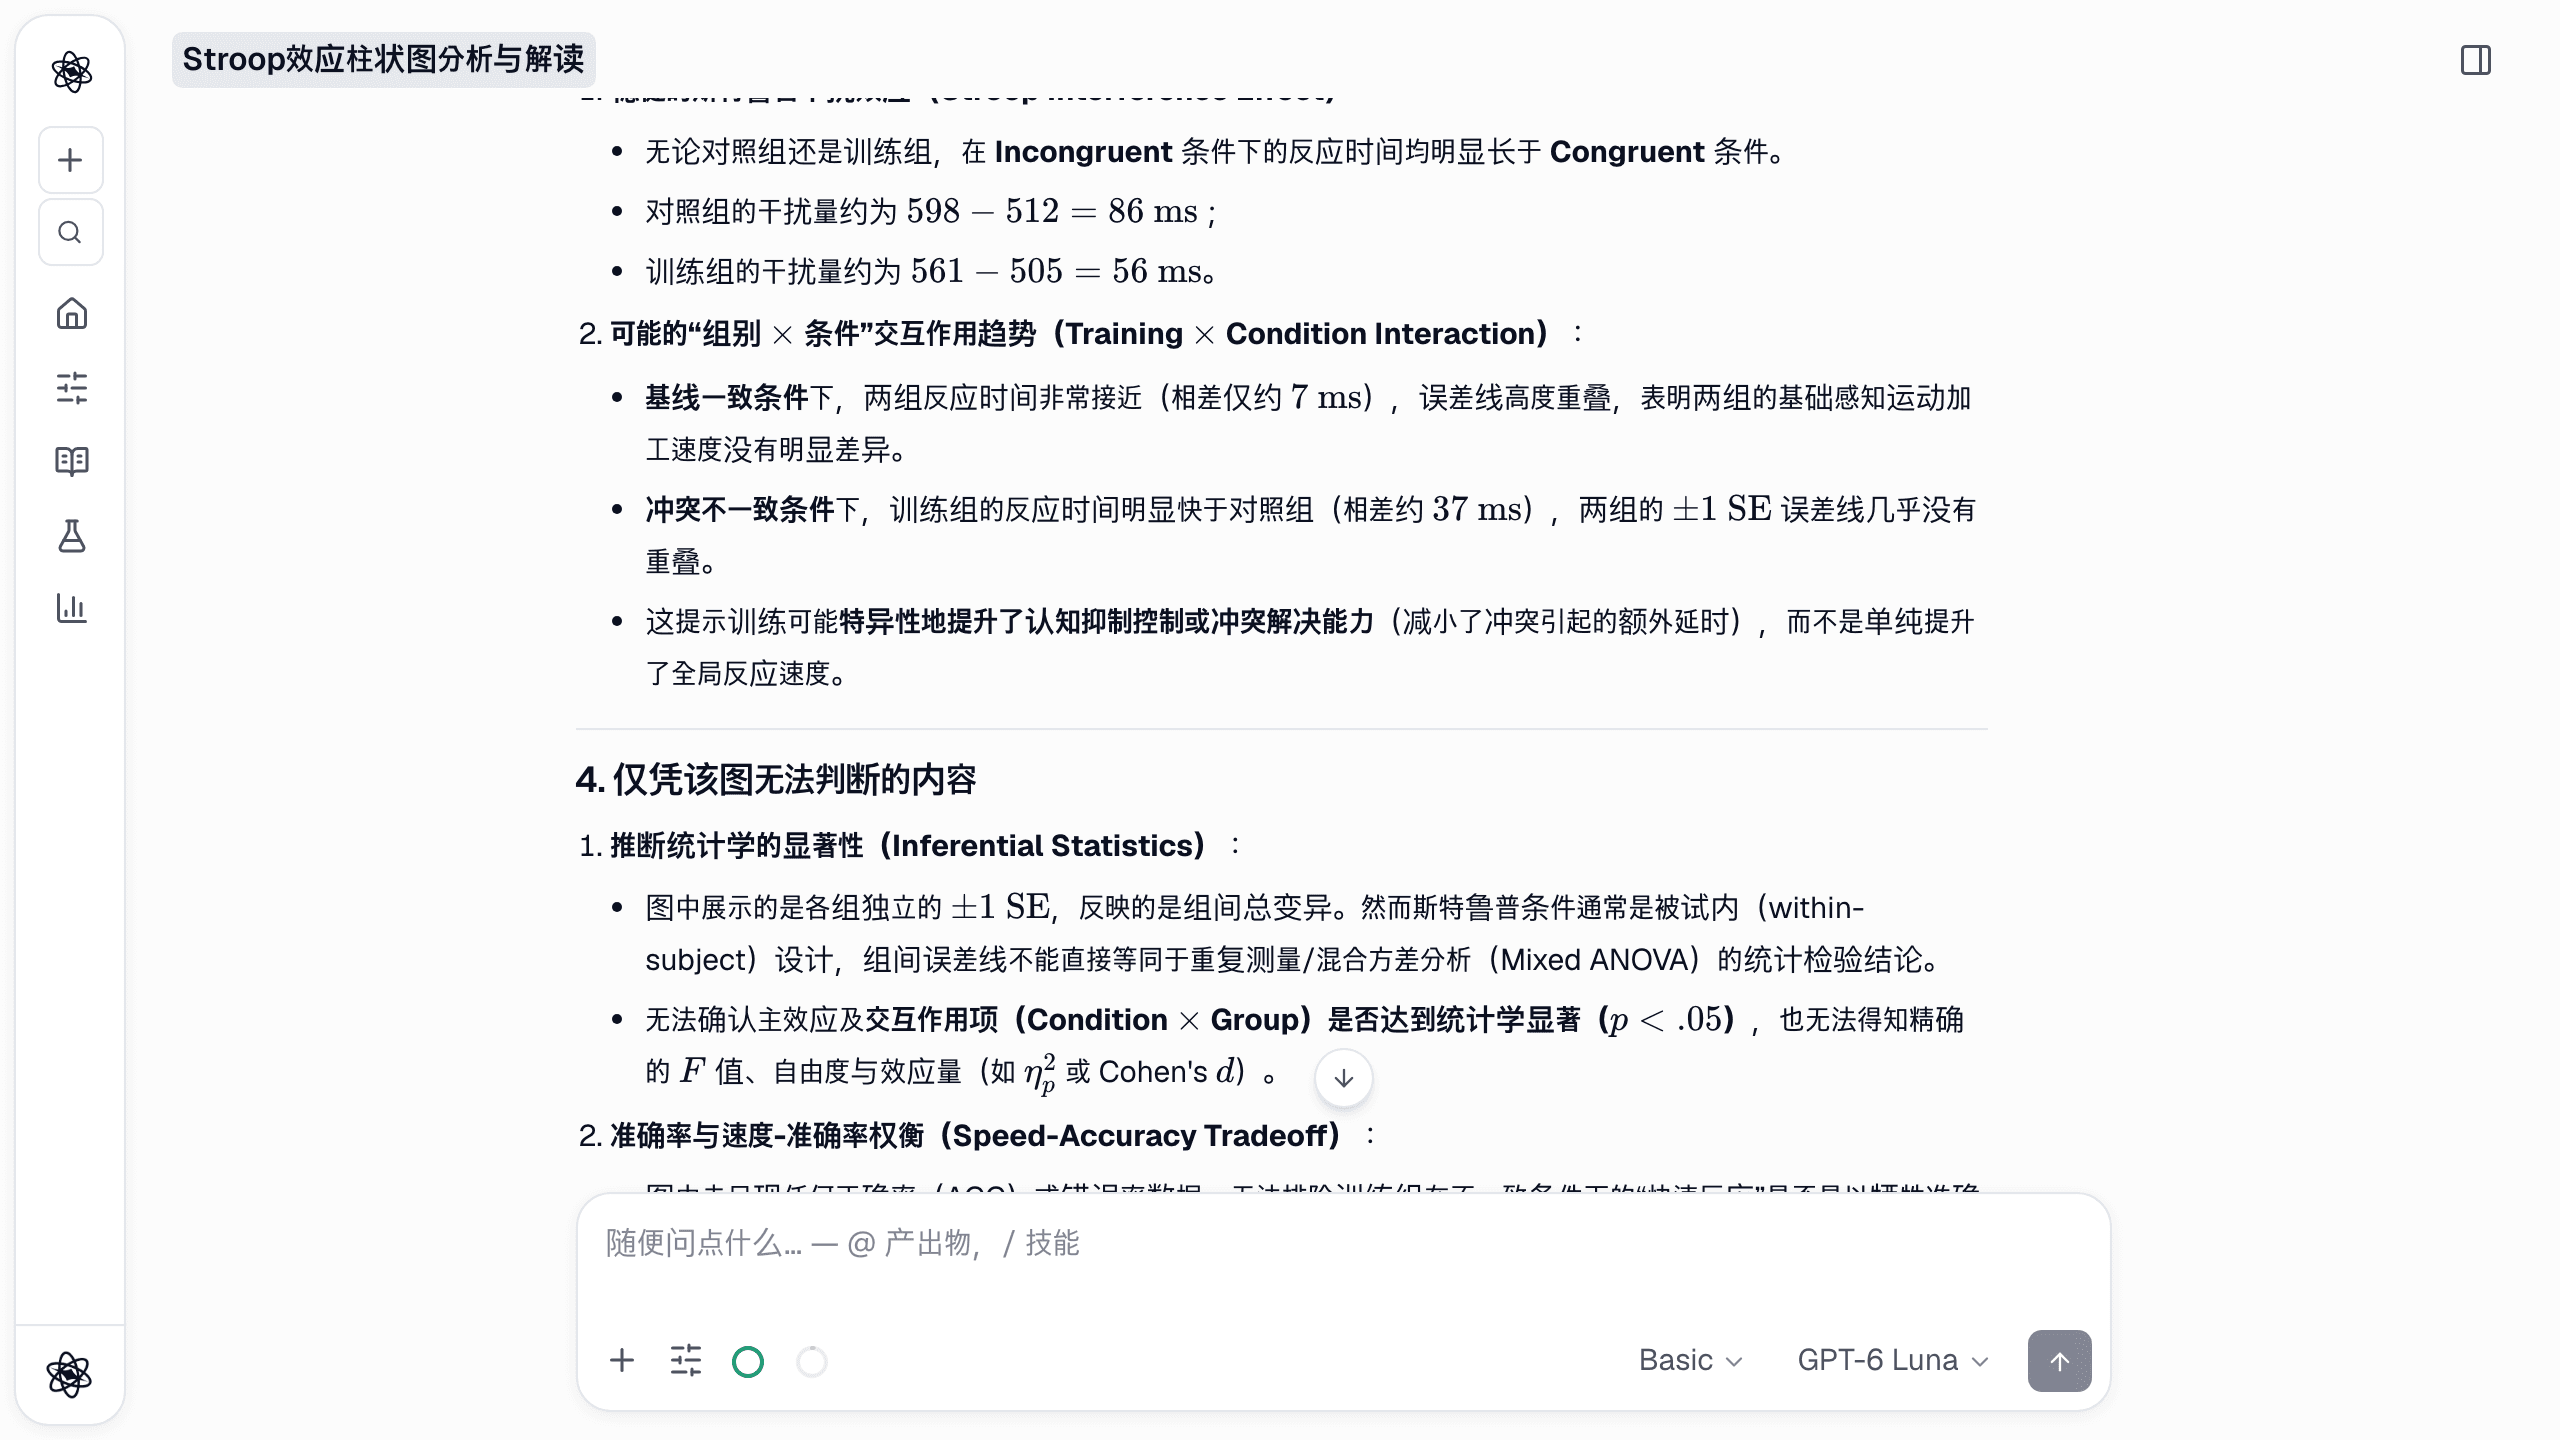
有两点需要注意。第一,从图上读出的数值是估计值,用来核对论文足够,但不能替代数据。若用于元分析,请用专门的数字化工具提取,并在报告中说明。第二,模型对视觉判读给出的"置信度"并不是经过校准的测量值,不如直接问它的推理依据。
测量照片
需要可以写进论文的数字时,请使用测量工具。处理视频的数据分析请求同样适用于照片:
/analyze 测量附上的两张照片:pose_yoga.jpg 做姿态估计(关节角度、姿势、关键点叠加图),face_smile.jpg 做面部表情测量(动作单元、情绪、头部姿态)。请简要汇总数值。
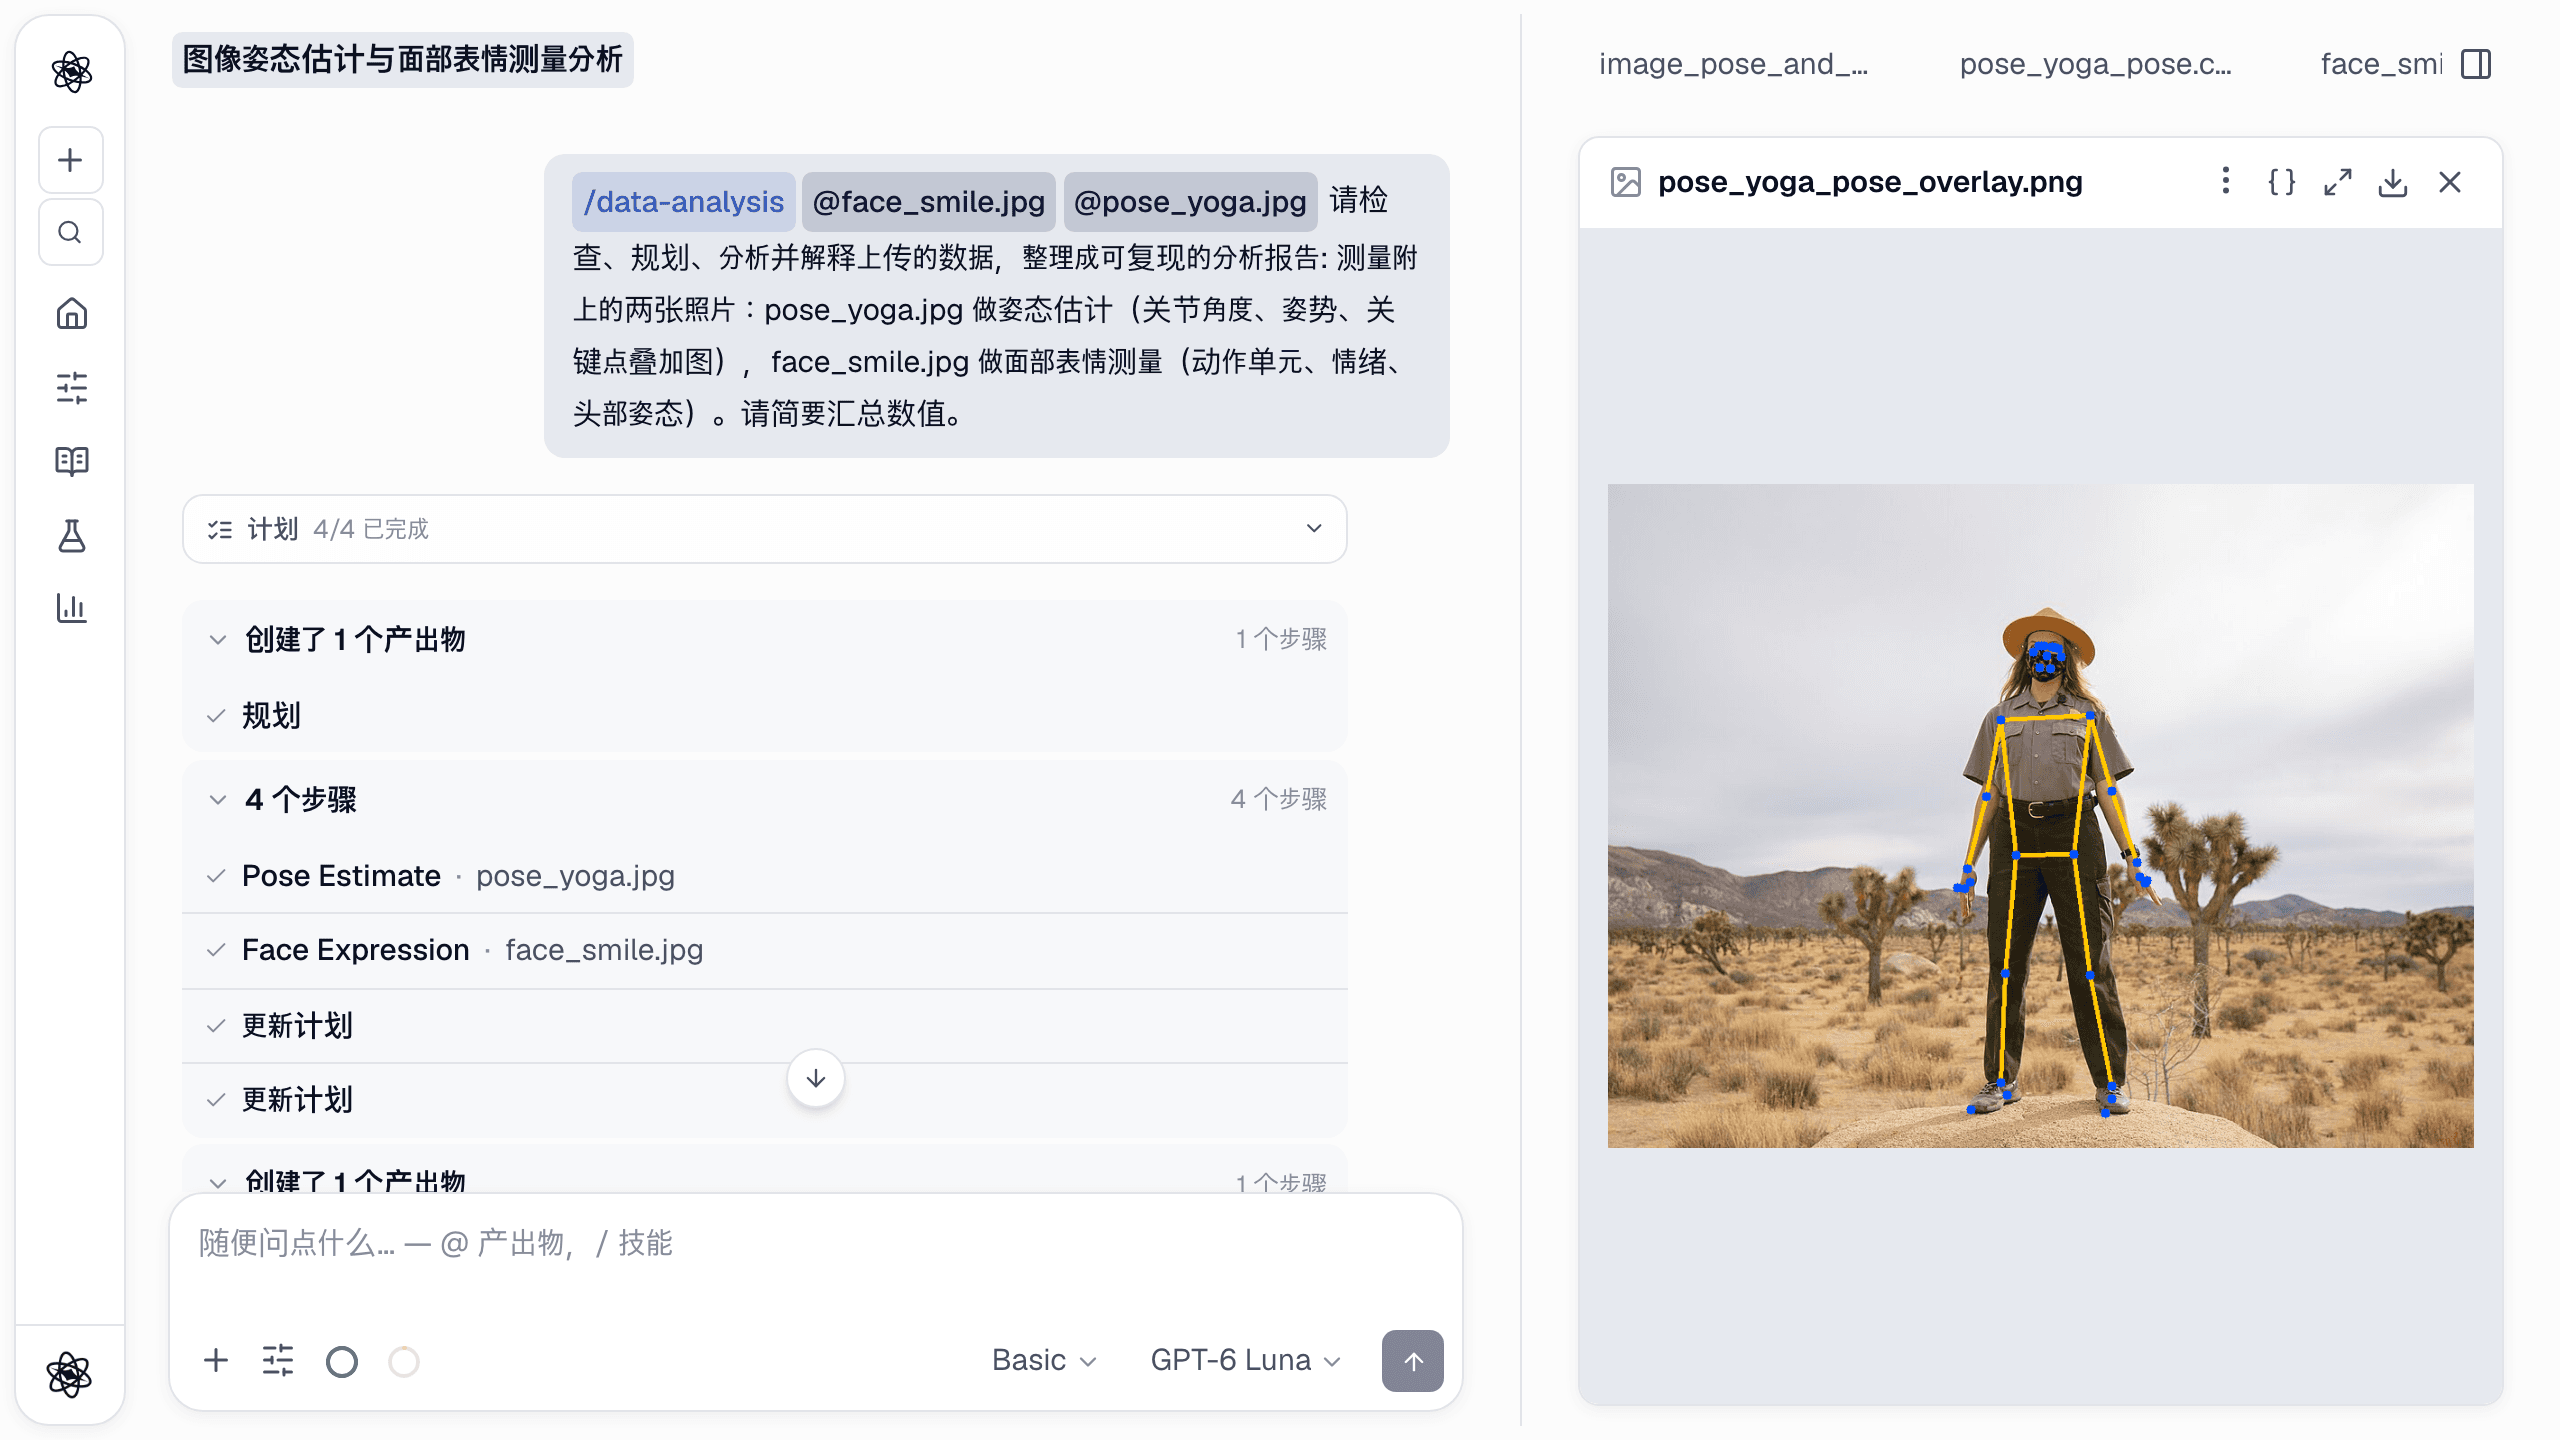
pose_estimate找出 33 个身体关键点,返回关节角度、姿势、手臂位置、躯干倾斜、朝向和叠加图。参见姿态分析。face_expression返回 0–1 尺度的 17 个面部动作单元、情绪标签和头部姿态。参见面部表情分析。
对同一张图像,两个工具每次都算出相同的数字。它们为每张图像保存一张表,报告中的句子带有 [n] 引用,指向每个数字背后的工具调用:

看与量:该用哪一种
- 用"看"(视觉) 来描述、比较、发现问题,或读取文字和大致数值。典型对象是图表、刺激材料、软件输出截图、幻灯片草稿,以及 UX 研究中的界面截图。
- 用"量"(工具) 来获得要写进结果的数字,比如 AU 强度、关节角度,或任何要在参与者之间比较的值。
- 两者结合。 让模型确认叠加图画在了正确的人身上,再报告工具给出的角度。
早期的一次内部检查说明了这个区分为何重要。在测量工具出现之前,模型读同样两张照片时,描述是对的(一张笑脸、一个双臂下垂站立的人),却附上了一个没有经过任何测量的"98% 置信度"。现在,数据分析技能要求代理原样引用工具数值,凡不是来自工具的数值都不算测量值。
研究用途
- 核对图表。 检查你审稿或引用的论文中的图,投稿前让它点评你自己的图。
- 刺激材料。 统一描述图像刺激,或为人脸刺激集测量表情数值。
- 截图。 在导出文件丢失时读取软件输出中的统计表,等数据找回后再正式核对。
- 参与者照片。 测量某一瞬间的姿势或表情,并整理成表。
坦诚的局限
- 视觉不是测量。 模型的判读是估计,可能出错,尤其是小字、密集的图和截断的坐标轴。
- 每条消息最多 4 张图,每张 4 MB,且只在支持图像的模型上可用。
- 用于照片的测量工具与视频有相同的局限:姿态角度是二维的,AU 是 blendshape 近似,每张图只处理一个人或一张脸。
- GIF 模型可以读,但测量工具不接受。测量请用 PNG、JPG 或 WebP。
有人物的照片:知情同意与隐私
首次上传前,Neutropic 会显示 上传研究数据之前 的提示,请你确认已具备处理这些数据所需的权利、同意和审批(例如 IRB 或伦理委员会)。也请留意每种分析在哪里进行:测量工具在 Neutropic 的服务器上运行,只把数字交给模型;而模型看图时,图像本身会发送给你所选的模型提供商。上传内容在你删除之前一直保存在私有工作区,不会用于训练。详情见隐私政策。