面部表情是研究能收集到的最丰富的行为数据之一,也是编码起来最费力的数据之一。训练有素的编码员用 FACS 手工编码,耗时远超视频本身的长度,大多数实验室无法对每位参与者都这样做。自动化工具能帮上忙,但要把它们的输出和研究设计、统计、论文放到一起,通常还得写一堆脚本。
Neutropic 直接从视频或照片测量面部动作单元(AU),结果就留在研究其余部分所在的同一个工作区。本文介绍 face_expression 工具计算什么、返回什么、如何在条件和参与者之间比较表情,以及这种近似的边界在哪里。截图来自示例项目(示例 · 按领域的技能)中的面部视频会话,以及一次测量单张照片的新对话。
可以上传什么
- 视频。 MP4、MOV、WebM、AVI、MKV 或 M4V。应用内预览使用浏览器播放器,想观看视频的话 H.264 MP4 最稳妥;无论哪种格式,分析都在服务器上解码。
- 照片。 PNG、JPG、WebP 或 BMP。
- 已有的 AU 结果。 如果你已经跑过 OpenFace 之类的工具,直接上传它的 CSV。数据分析技能会把它当作表格处理,统计工具可以直接使用。
然后说明你要什么:
/analyze 从 session_03.mp4 中提取随时间变化的面部动作单元和表情。画出最强的几个 AU,保存逐帧表格,并总结哪些 AU 在什么时候被激活。
测量原理
工具在每一帧上运行 Google 的 MediaPipe FaceLandmarker。它拟合一个面部网格,返回 52 个 blendshape 分数,描述面部各部位移动了多少(嘴角上扬、眉毛下压、下颌张开等),每个分数介于 0 和 1 之间。
Neutropic 把这些 blendshape 映射到 17 个 FACS 动作单元:AU01、AU02、AU04、AU05、AU06、AU07、AU09、AU10、AU12、AU14、AU15、AU17、AU20、AU23、AU25、AU26 和 AU45(眨眼)。FACS 中只有一个 AU、而网格有左右两个分数时,取较大值。有两个映射值得了解:
- AU06(脸颊上提) 同时读取脸颊眯起和眼睛眯起两个分数,因为网格把杜氏微笑的标志拆成了这两项。AU07(眼睑收紧)也读取眼睛眯起,所以 AU06 和 AU07 经常数值相同。
- AU25(双唇分开) 是闭嘴分数取反得到的。
在 AU 之上,工具还给出:
- 情绪标签。 来自 EMFACS 风格的 AU 组合(例如快乐是 AU06 + AU12)。只有核心 AU 激活时(快乐是 AU12,悲伤是 AU15,等等),并且该情绪的 AU 至少一半被激活,才会给出标签。默认激活阈值为 0.3。对视频,你会得到各标签所占的帧比例。
- 头部姿态。 由面部网格得到的偏航(yaw)、俯仰(pitch)和翻滚(roll)角,单位为度。
视频默认按每秒 5 帧采样,也可以要求其他采样率。
视频分析得到什么
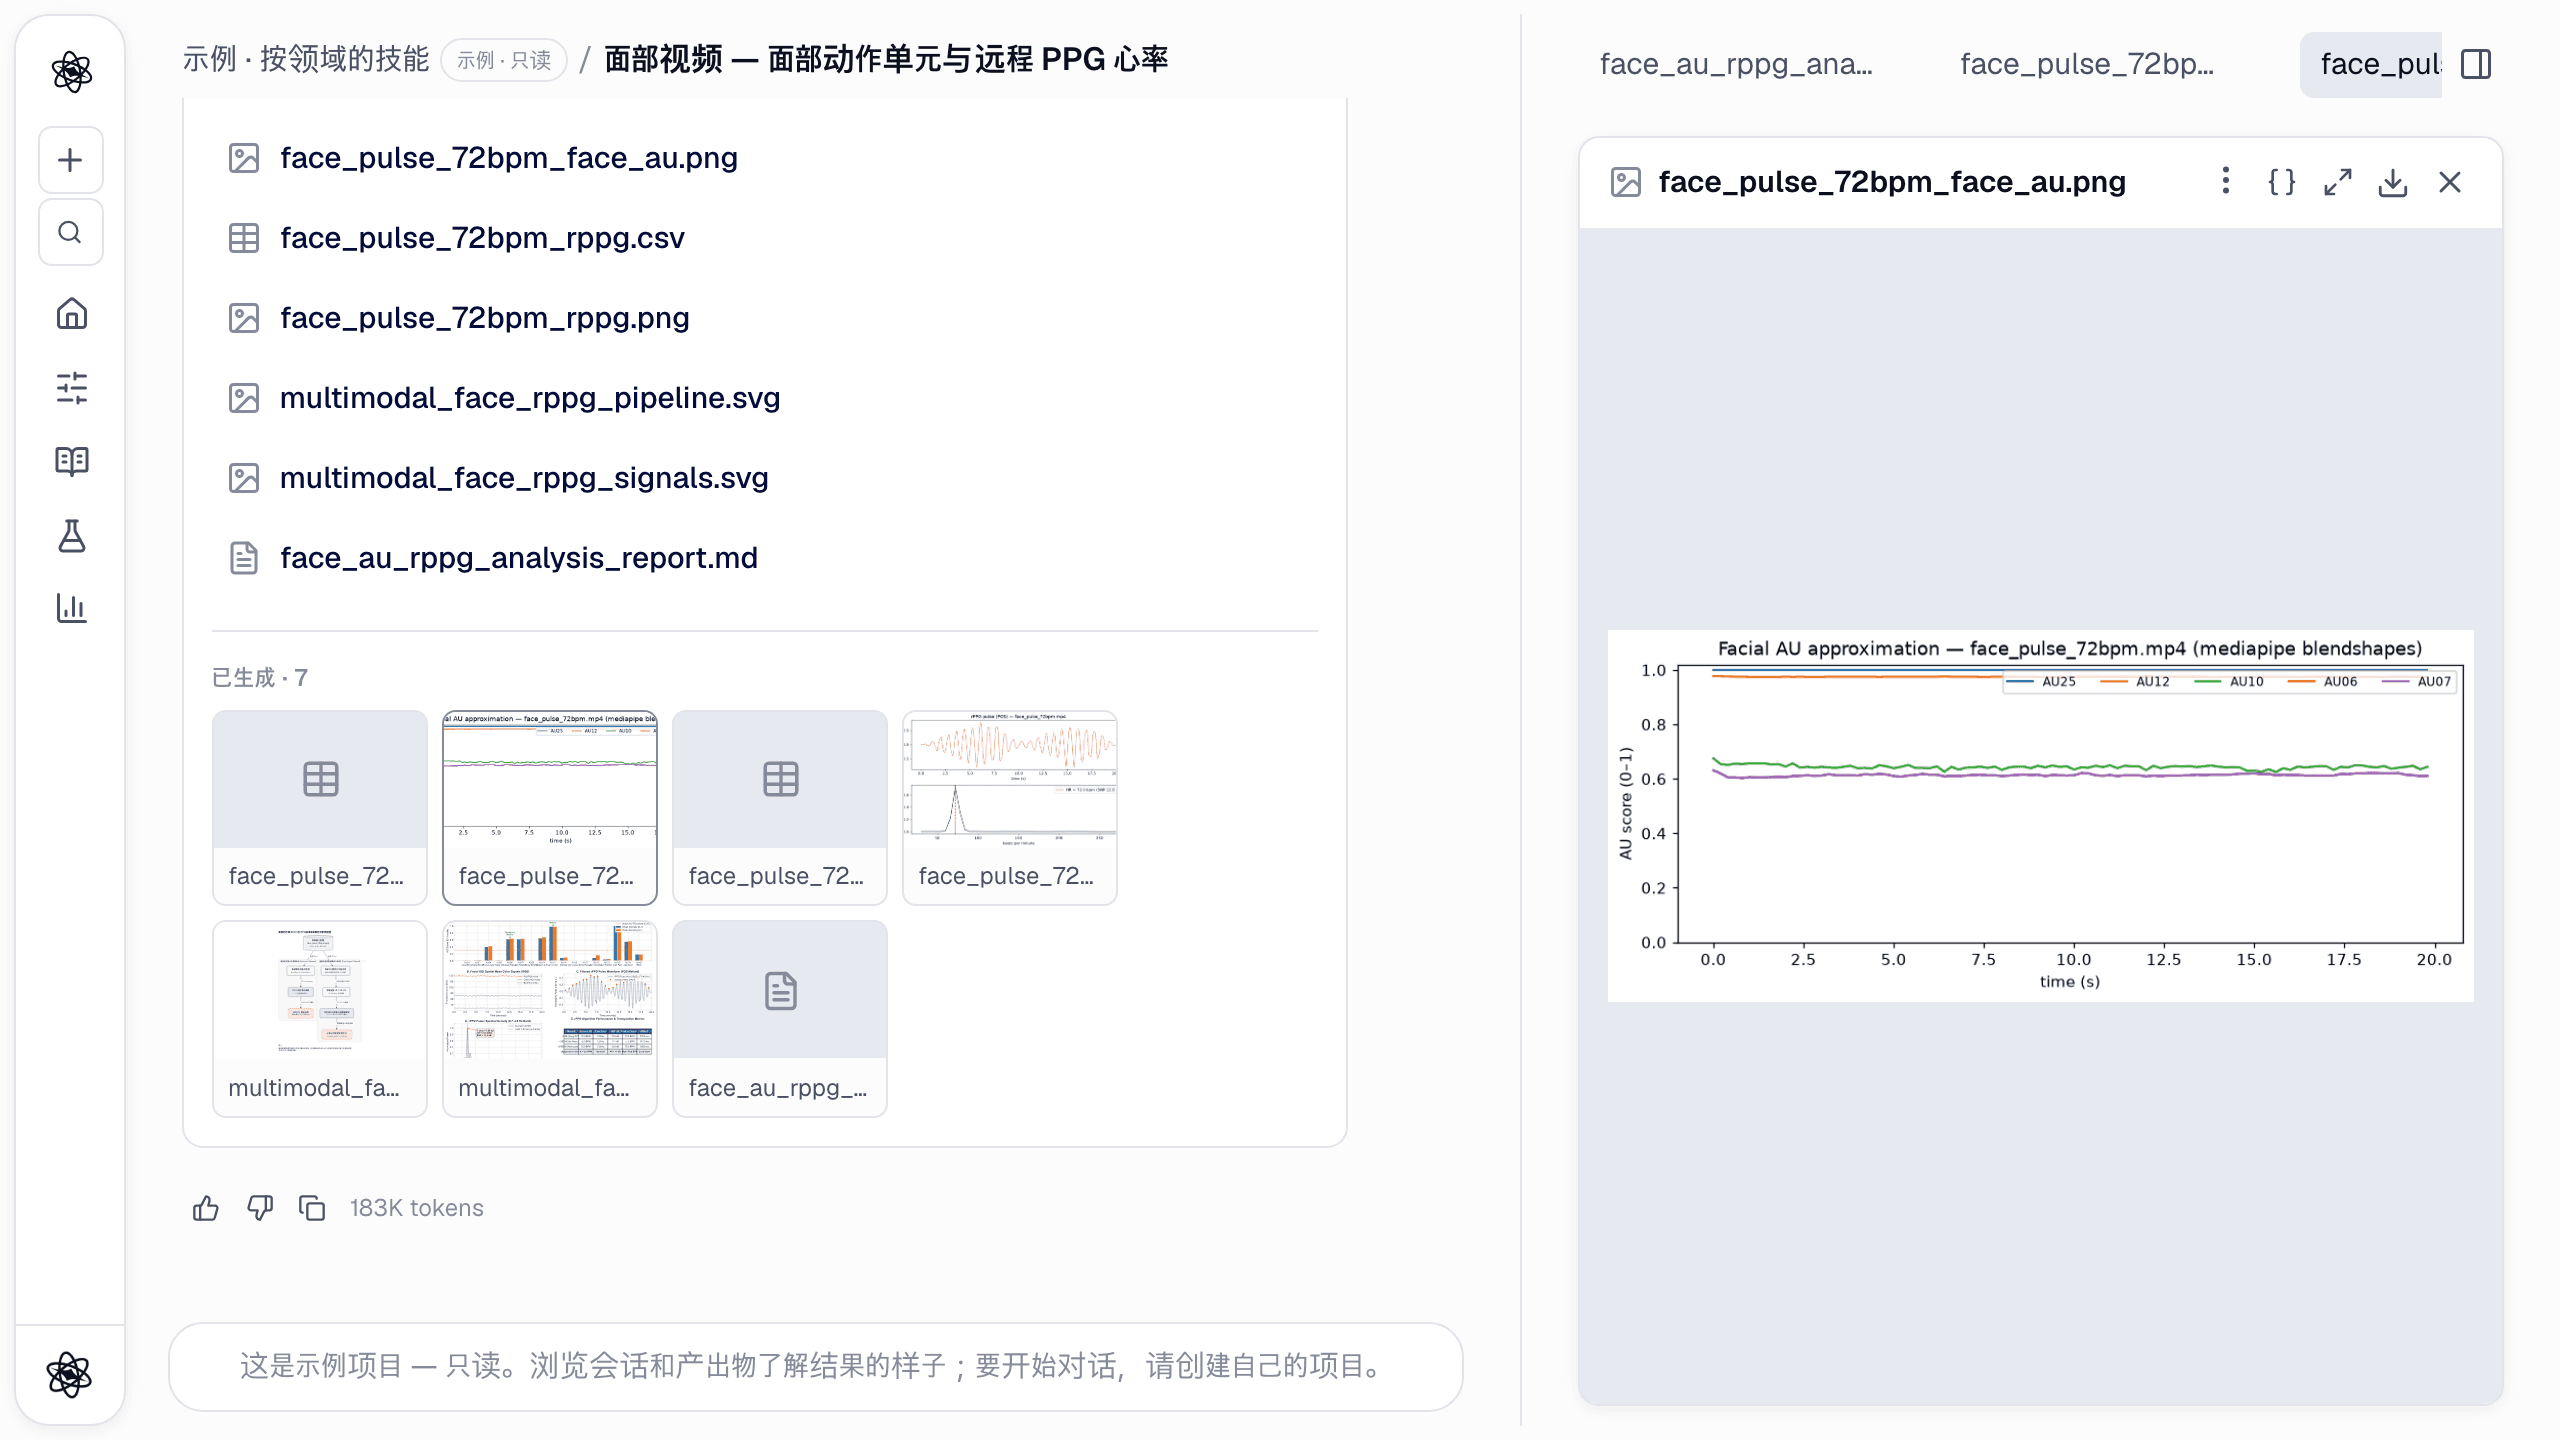
- 图(
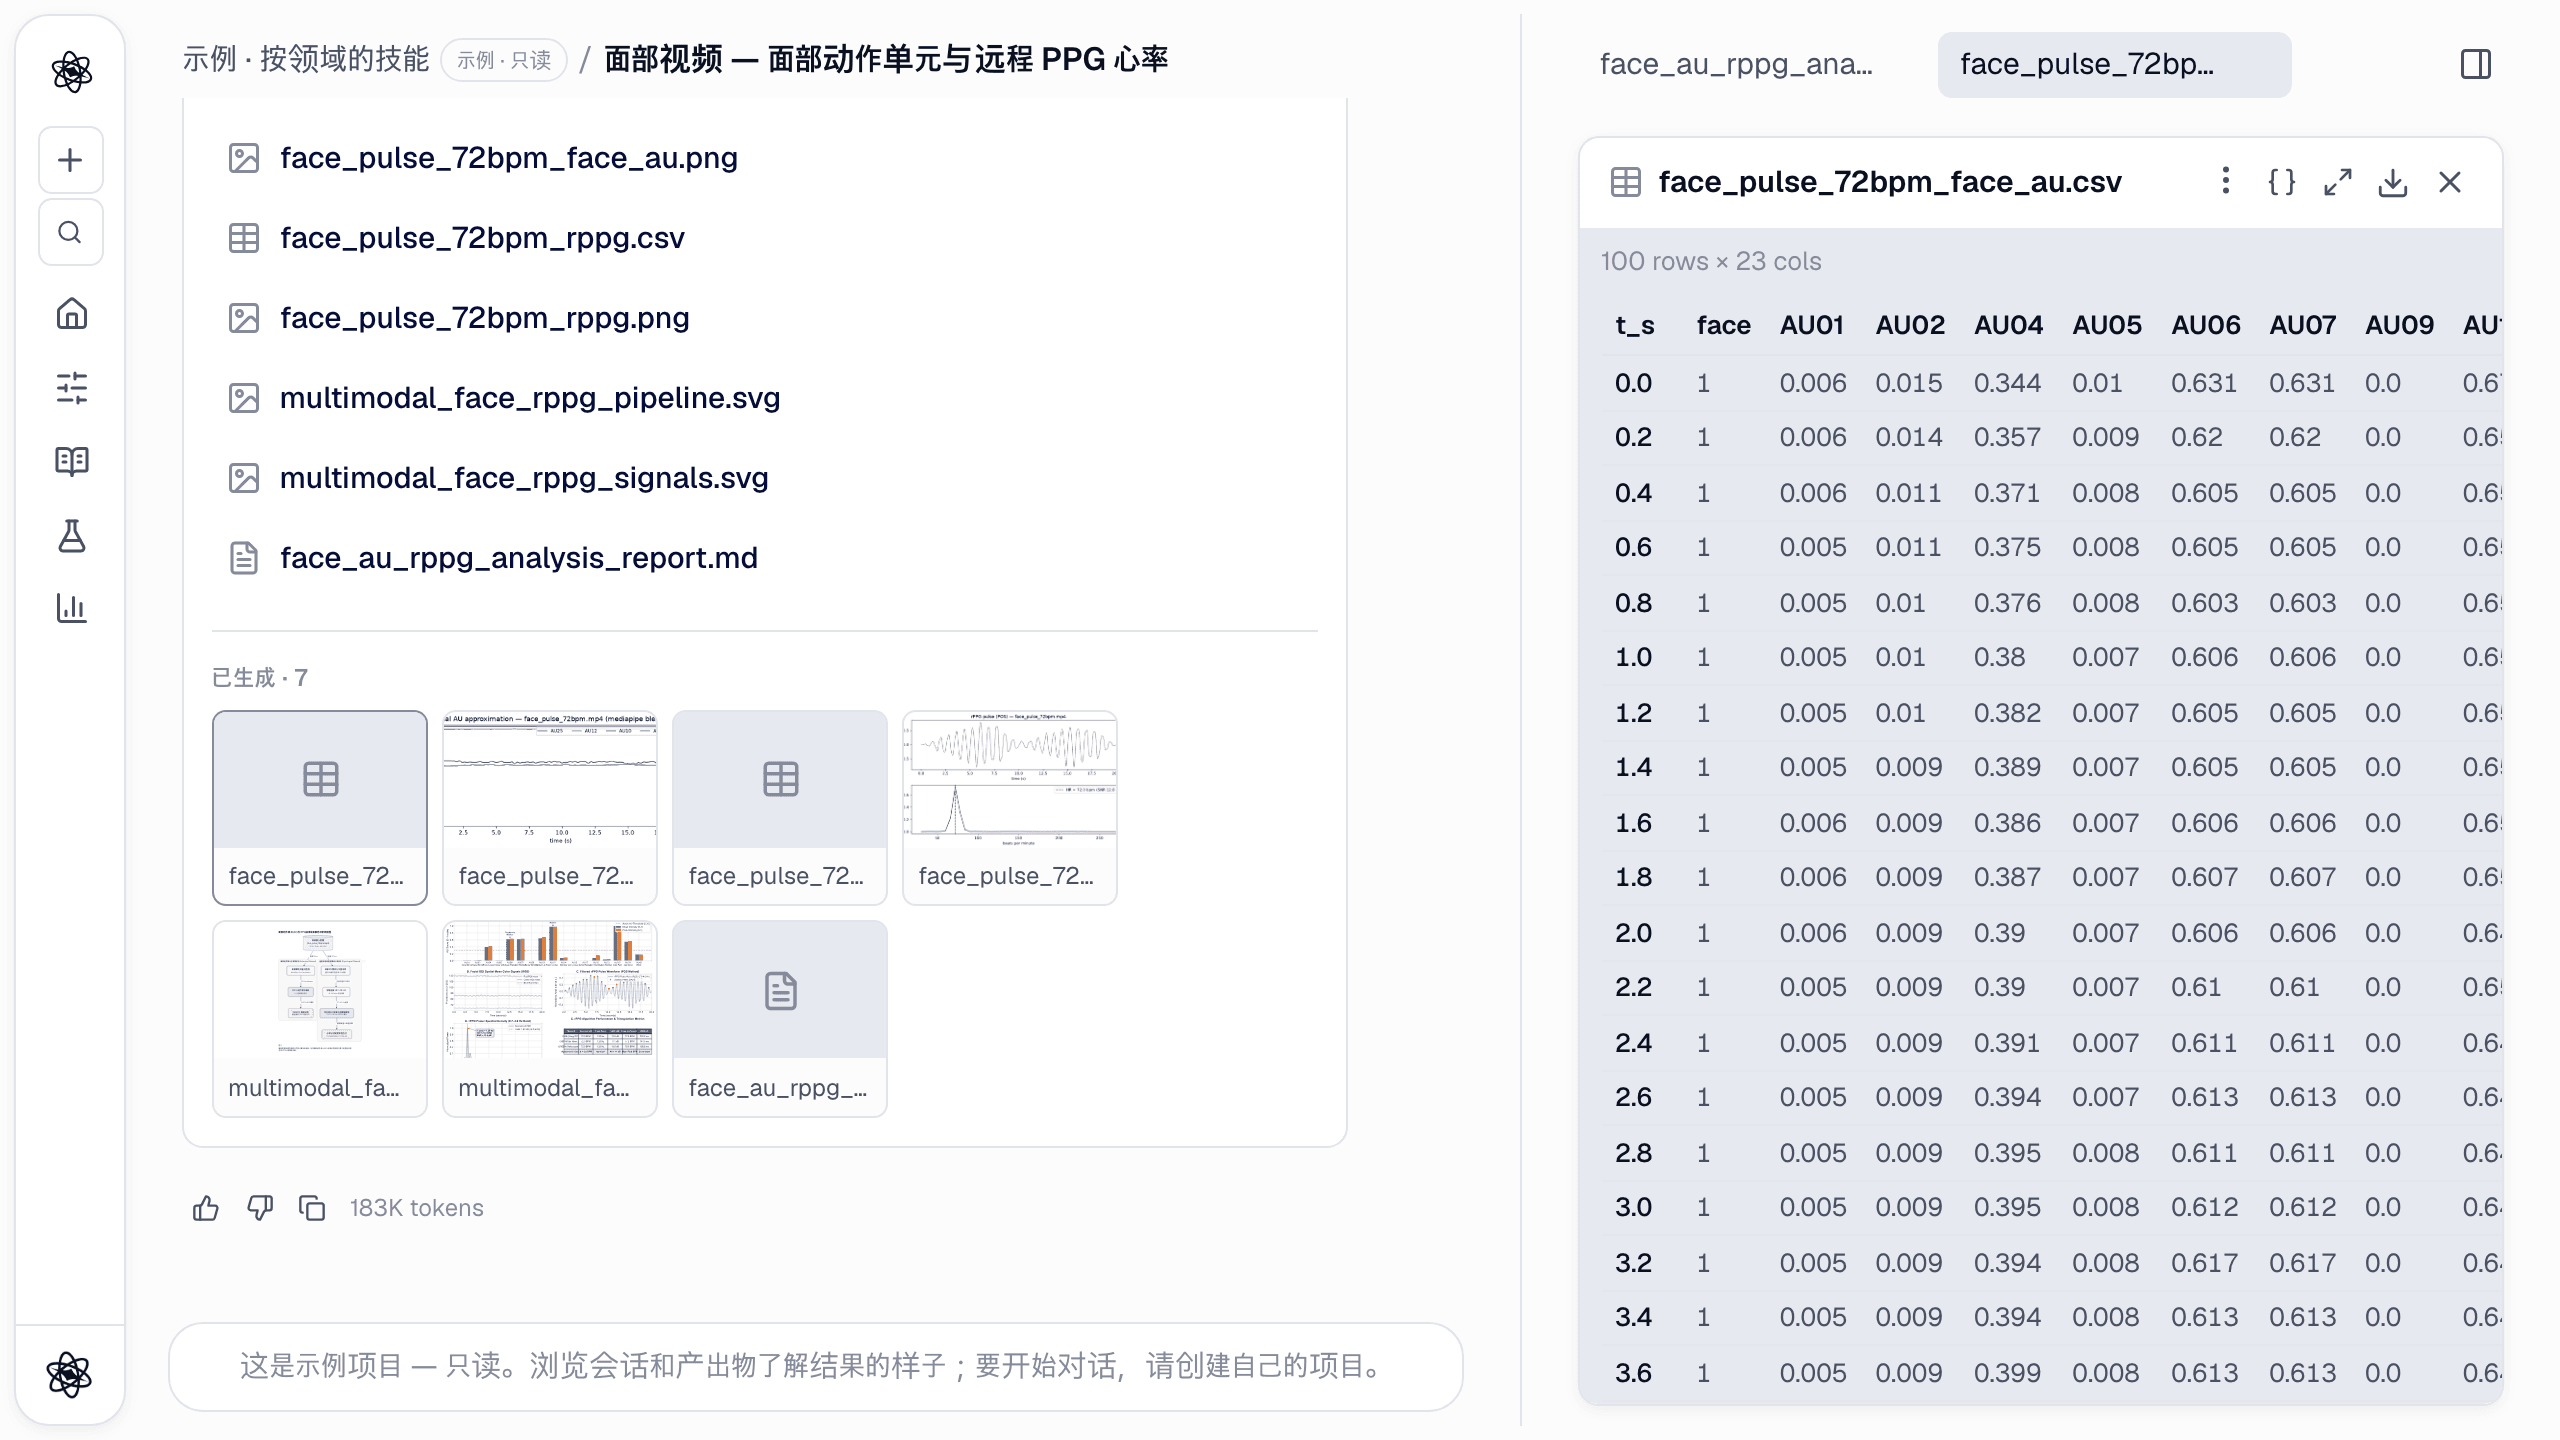
*_face_au.png):峰值最高的五个 AU,在 0–1 尺度上随时间绘制。 - 逐帧表格(
*_face_au.csv):时间、是否检测到人脸、17 个 AU 值、yaw、pitch、roll 以及该帧的情绪标签。 - 汇总数值:每个 AU 的均值和峰值、激活 AU 列表、情绪比例和平均头部姿态。
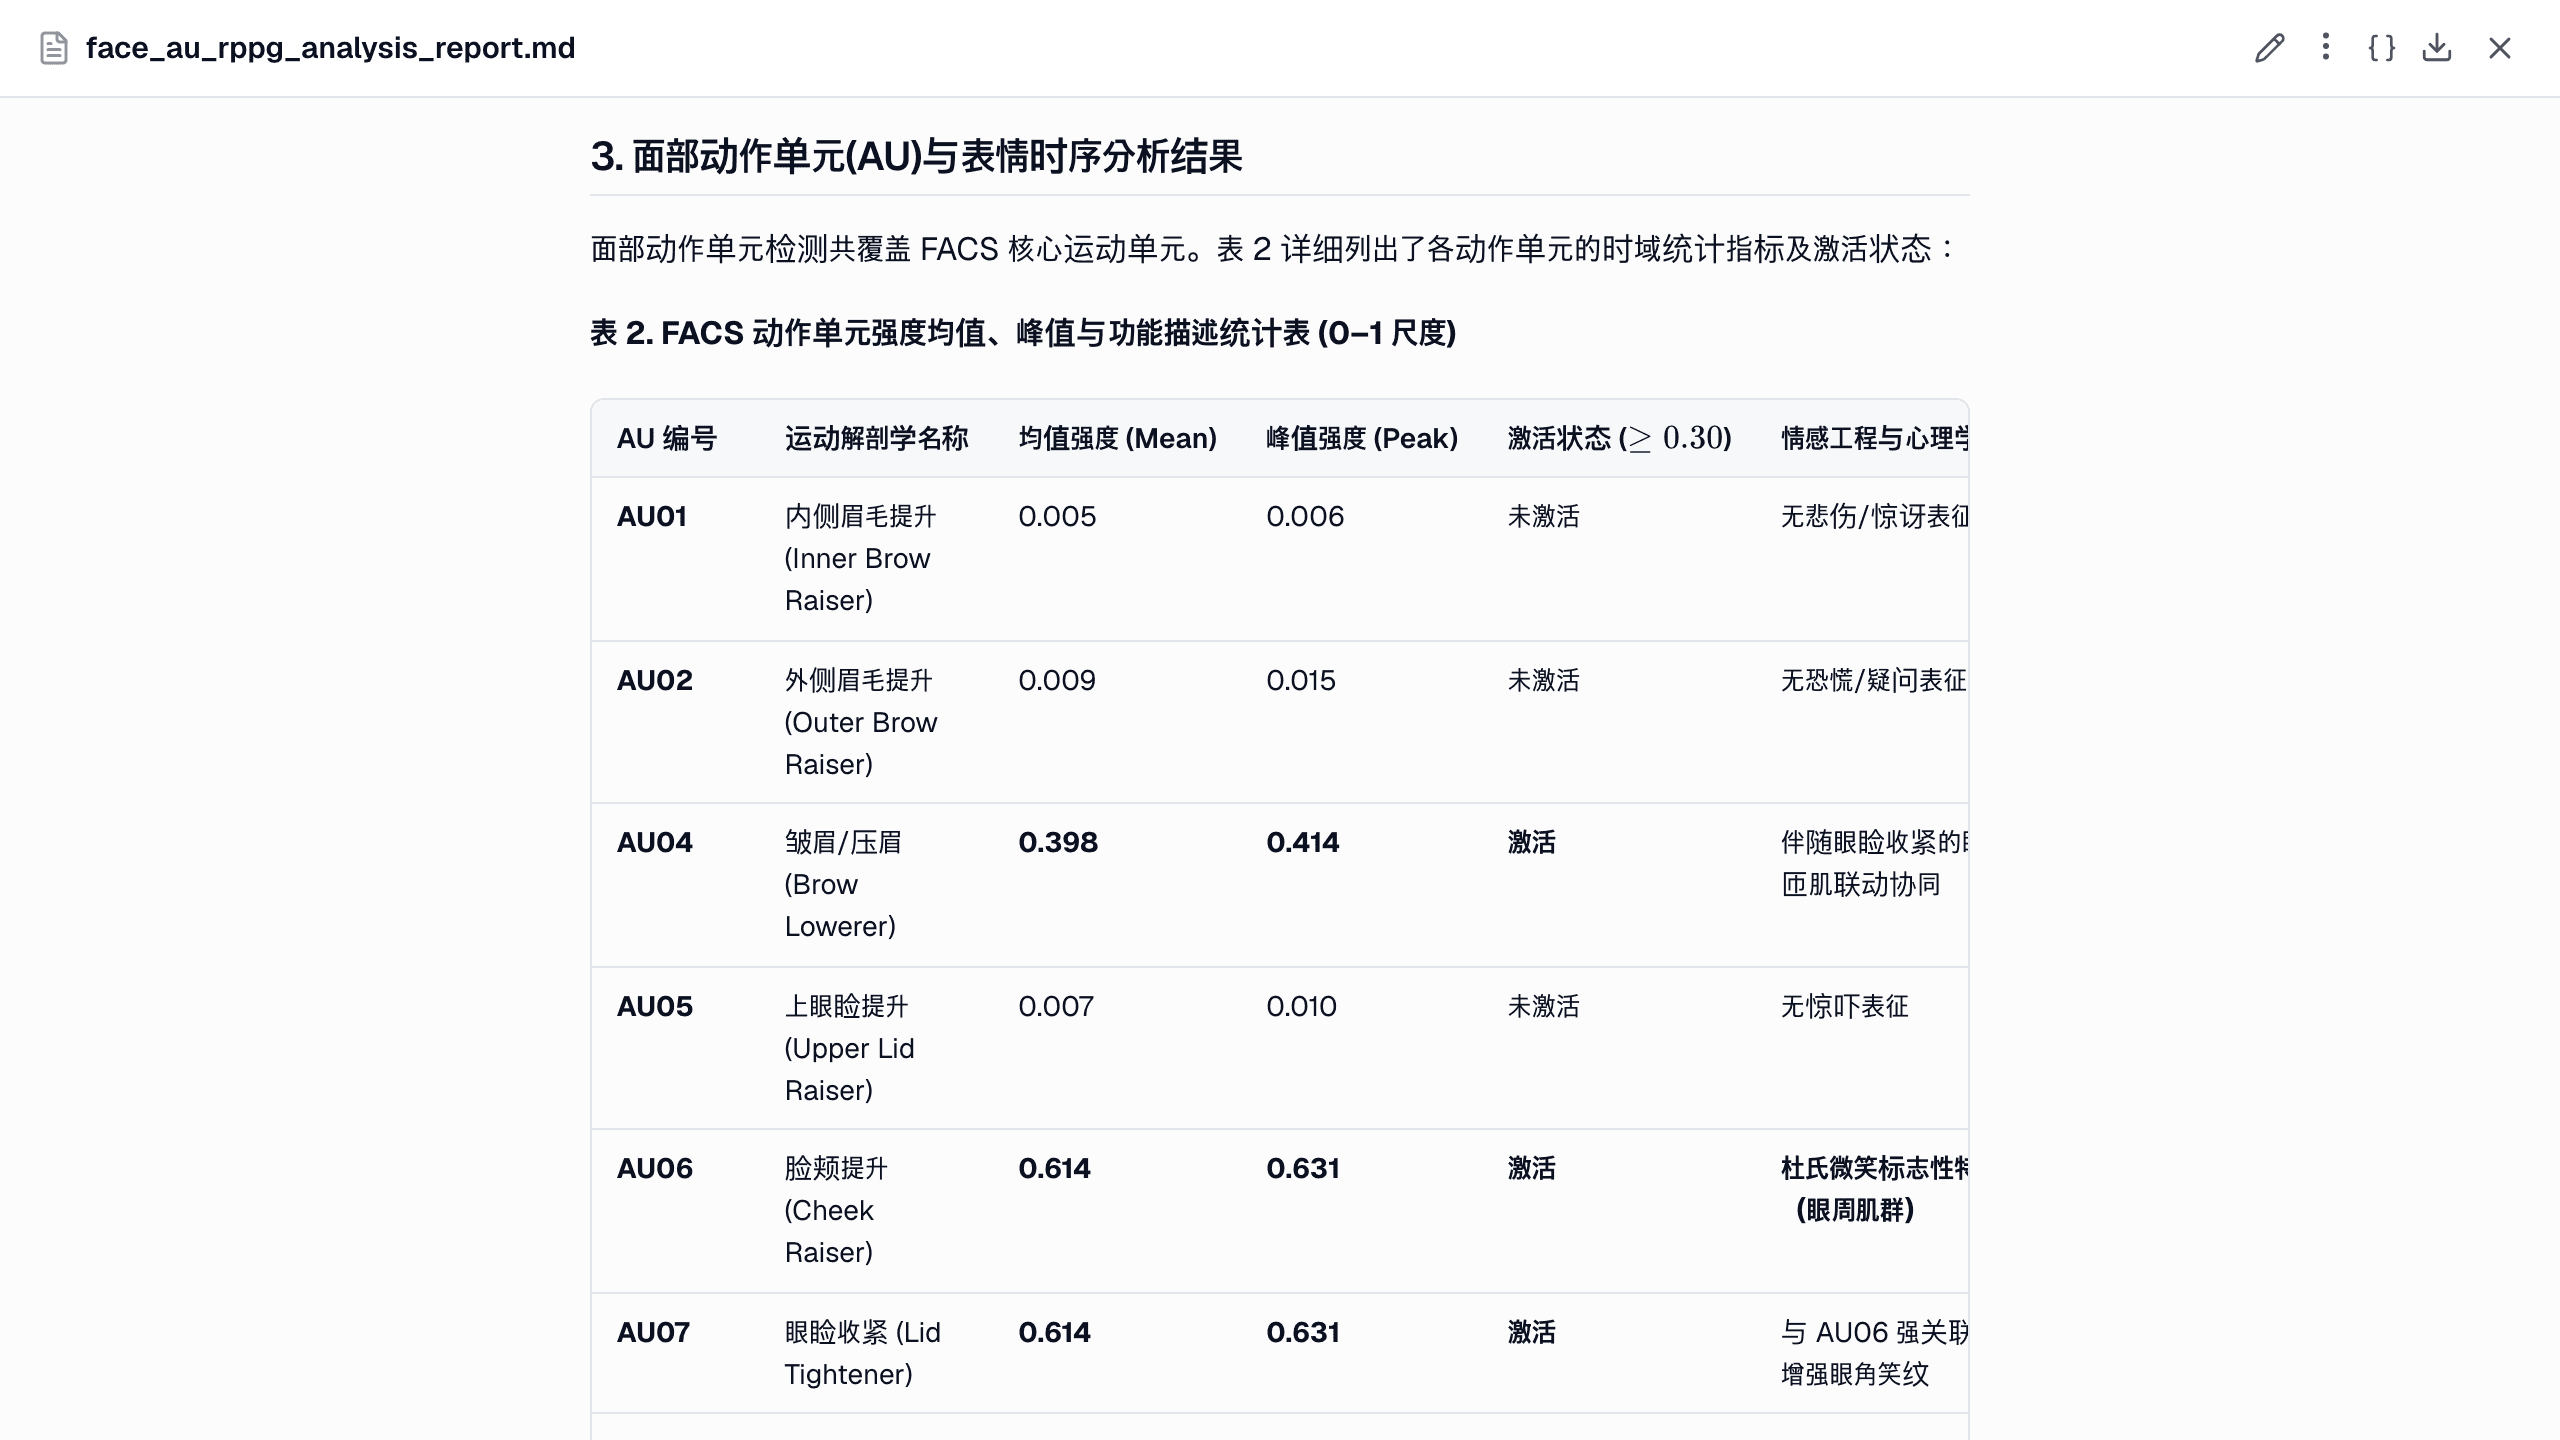
报告把每个 AU 的均值和峰值放进一张表,并标出越过阈值的 AU:
单张照片也可以
一张照片走的是同一个工具,得到的是一行而不是时间序列:
/analyze 测量 face_smile.jpg 的面部表情:动作单元、情绪和头部姿态,并简要汇总数值。
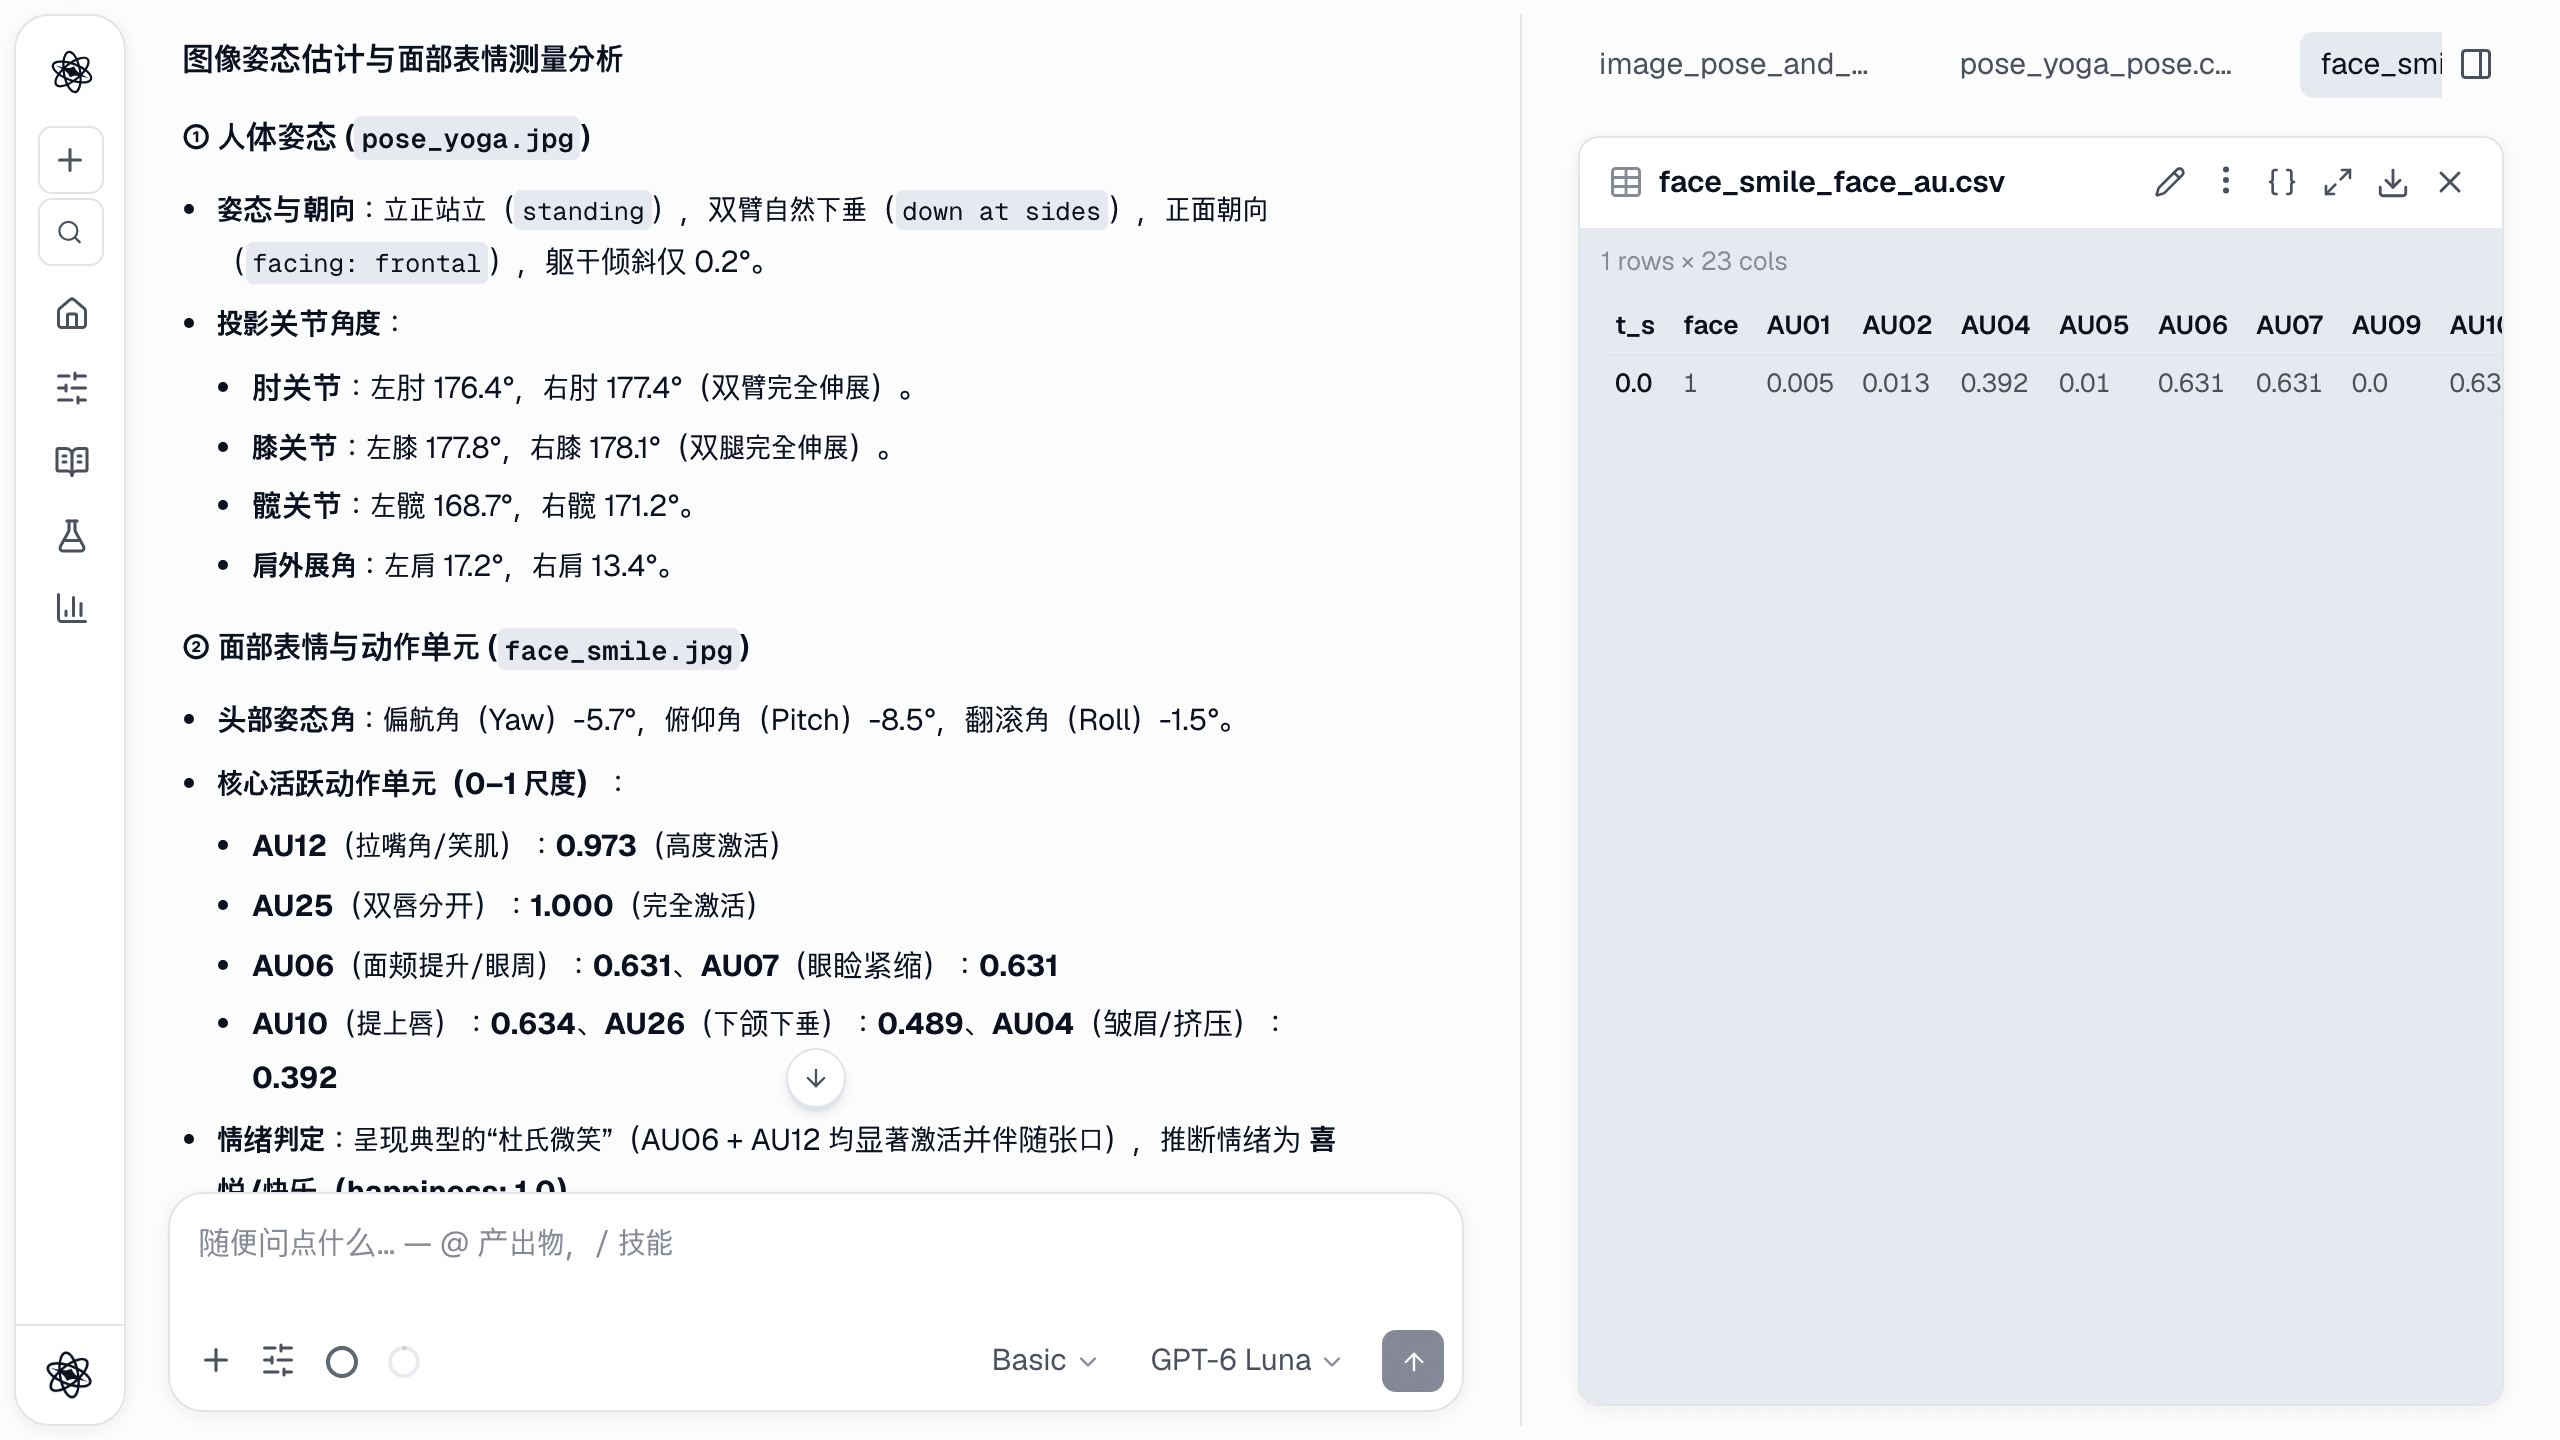
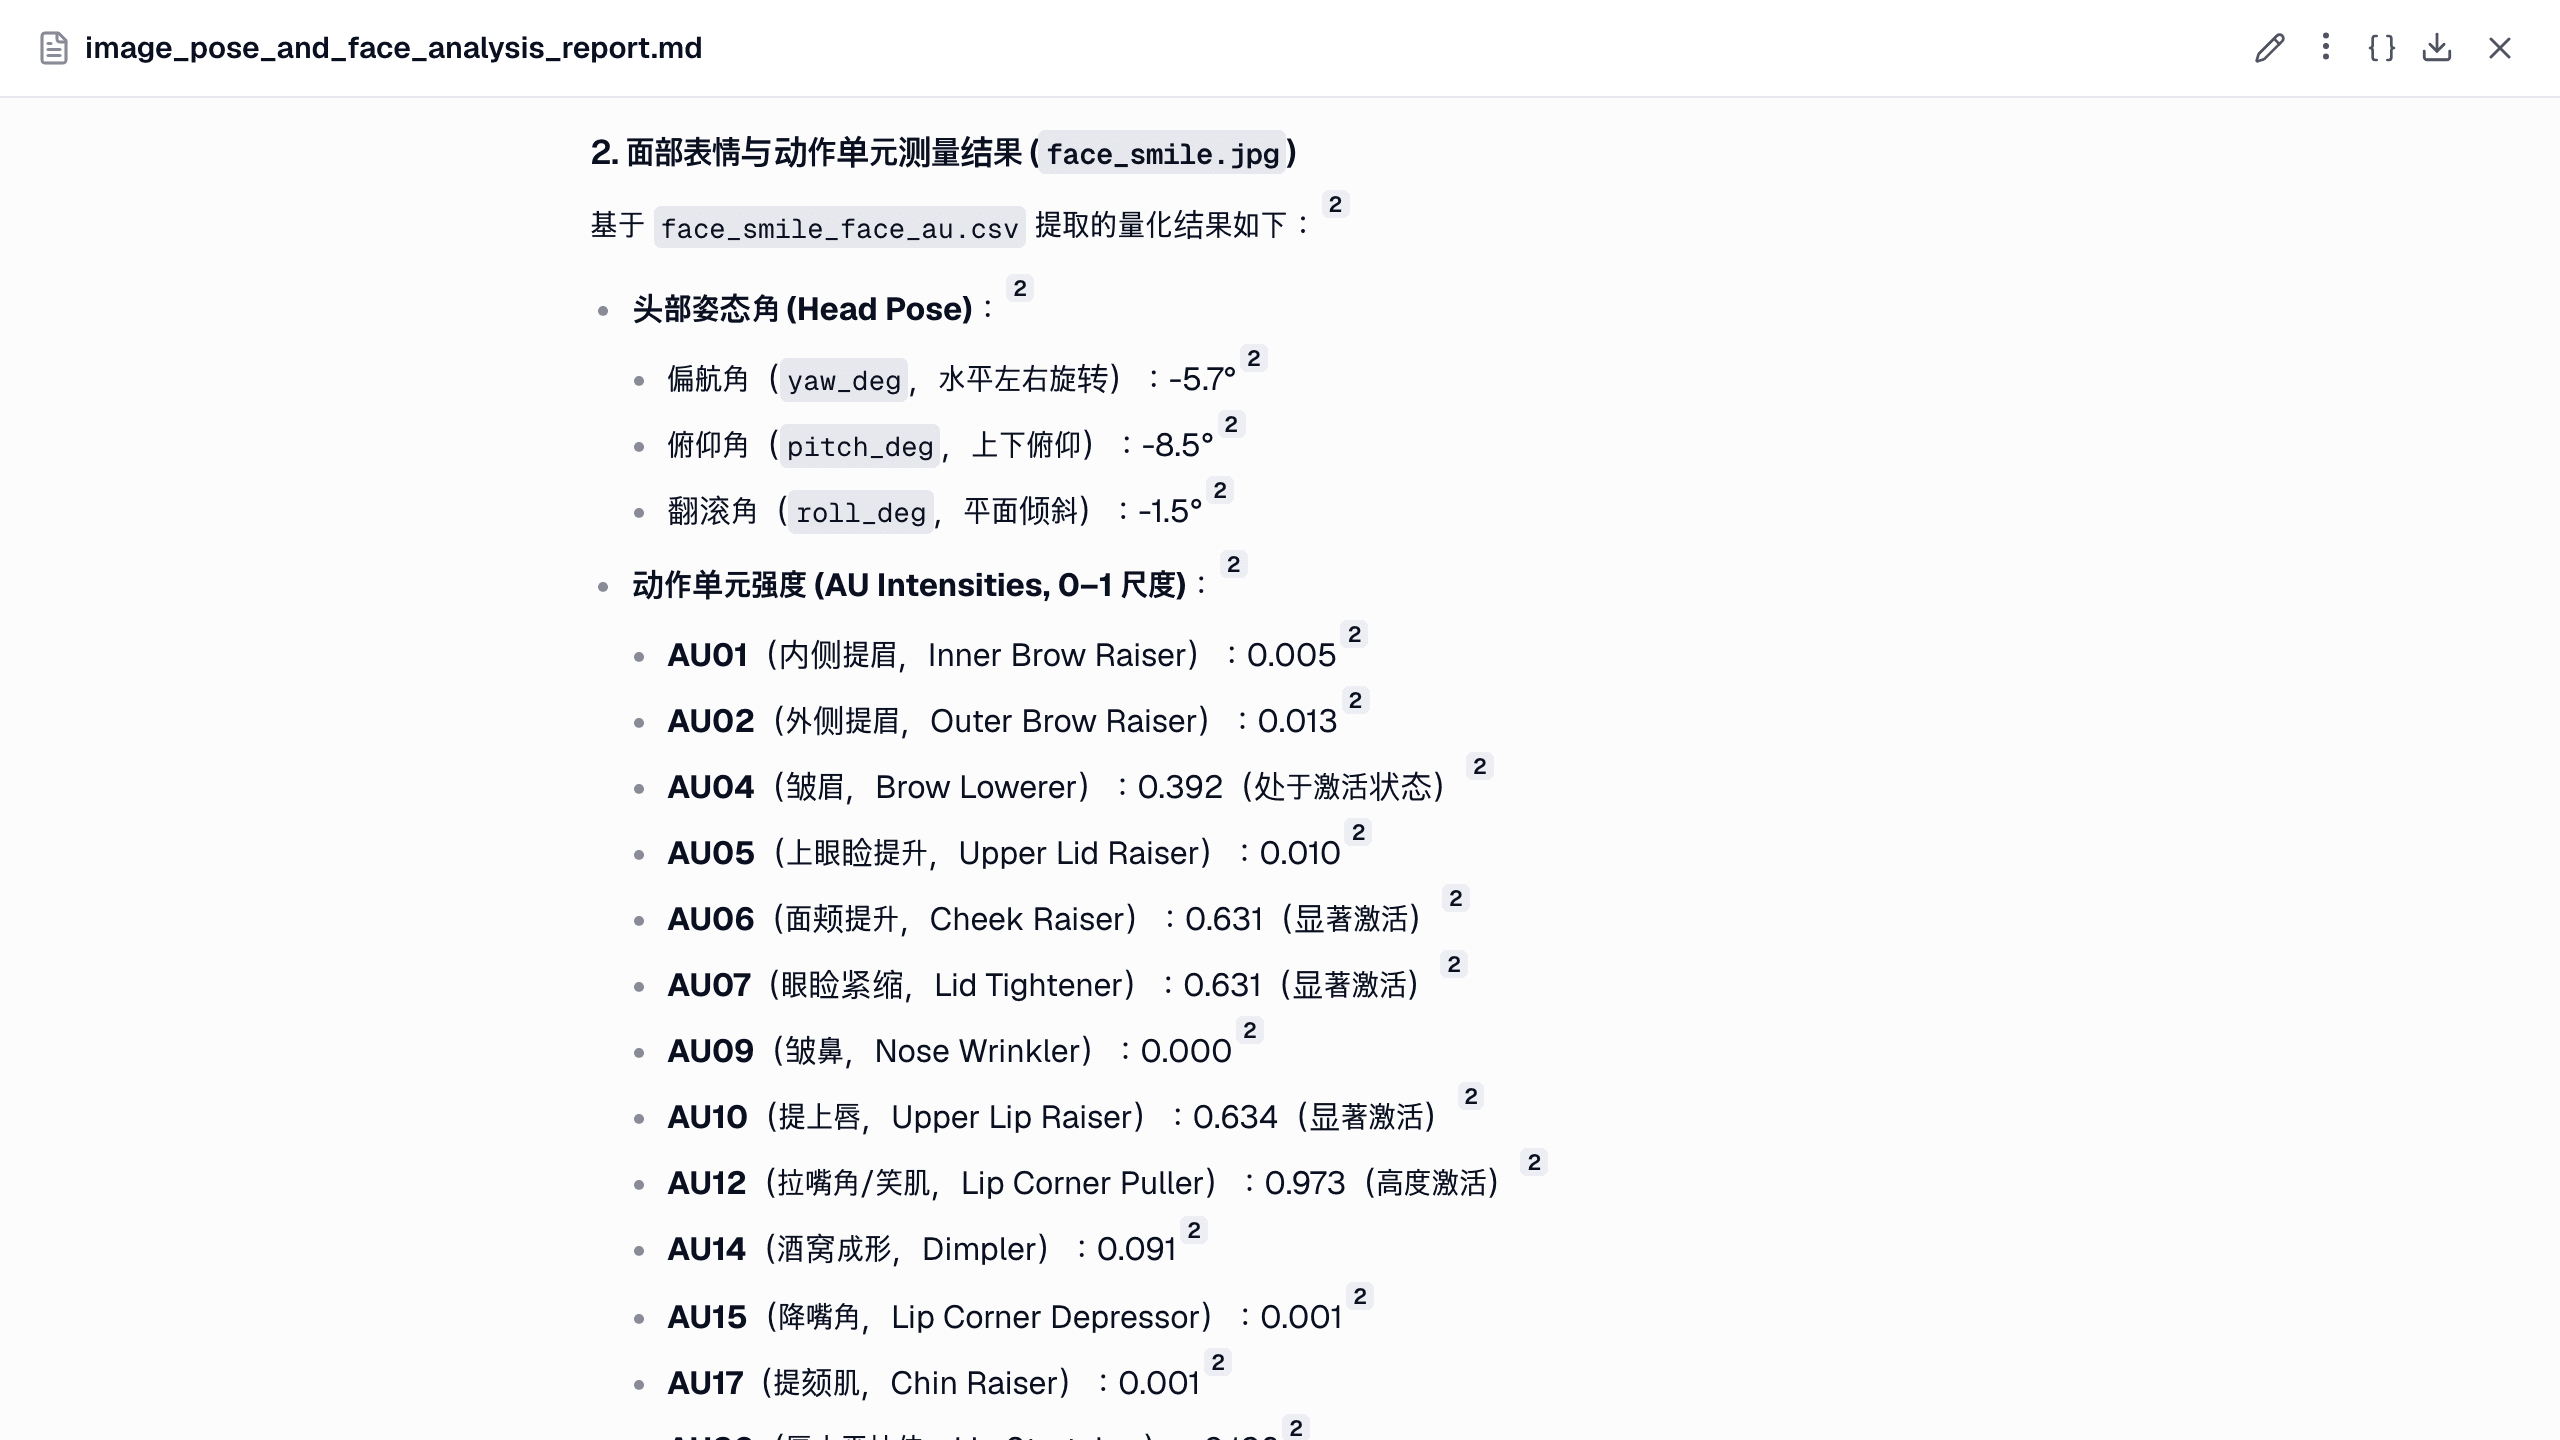
对话回答和报告使用的都是工具返回的数字,报告中的句子带有 [n] 引用,指向产生这些数字的分析步骤。这正是它和"把照片直接给聊天模型看"的区别:看图的模型能描述表情,却无法把 AU12 测到小数点后三位。两种方式各适合什么场合,见图像分析。
如何检验
内部验证使用了两个已知答案的输入:
- 一张微笑照片。 工具给出 AU12 0.97、AU06 激活,并把表情判定为快乐。早期版本还因为眉毛和眼睑相关的 AU 越过阈值,给这张照片加上了"愤怒"。现在标签要求核心 AU,正是因为这个问题。
- 用同一个微笑做成的 20 秒面部视频。 AU12 平均 0.975,AU06 平均 0.614,采样的 100 帧中有 100 帧被判定为快乐。
这些只是检查映射是否正常工作,并不是与人工 FACS 编码员对比的 AU 准确度验证。如果你的结论依赖特定 AU,请让受过训练的编码员复核一部分视频。
比较条件和参与者
表情只有在比较时才成为结果。逐帧 CSV 带有时间列,所以可以用任何事件记录(刺激开始时间、任务区块)把它切分成不同条件。接下来:
- 按参与者和条件汇总(例如观看积极与中性视频时的平均 AU12)。
- 用统计工具比较。
compare_groups会在检查假设后选择配对或独立检验,混合模型则处理参与者内部的重复试次。
/stats au_by_condition.csv 中每位参与者、每个条件(positive、neutral、negative)一行,记录平均 AU12 和 AU04。请检验各 AU 在条件间是否不同,检查前提假设,并报告效应量和图。
适合这种做法的研究包括情绪诱发研究、UX 测试(面对令人困惑的界面皱眉、看到成功提示时微笑)、课堂或游戏中的投入度,以及把同一段视频的表情与心率配对分析。参见从面部视频测心率。
坦诚的局限
- FACS 的近似。 blendshape 描述的是网格,而不是肌肉活动。数值在 0–1 尺度上,与 OpenFace 强度(0–5)不可比;AU06 和 AU07 在设计上就有重叠。
- 情绪标签是启发式的。 它们描述的是 AU 模式,不是人的真实感受。请报告 AU,把标签只当作概括。
- 每帧一张脸。 使用第一个找到的人脸,多人视频请先裁剪。
- 采样。 每秒 5 帧时,非常短暂的微表情可能落在采样之间。时间精度重要时,请要求更高的采样率。
- 姿态与遮挡。 大幅转头、口罩、捂嘴的手和昏暗光线都会降低检测率。没有人脸的帧会如实记录,而不是猜测。
拍摄参与者:知情同意与隐私
面部视频可以识别个人,表情数据也可能很敏感。首次上传前,Neutropic 会显示 上传研究数据之前 的提示,请你确认已具备处理这些数据所需的权利、同意和审批(例如 IRB 或伦理委员会)。
- 告诉参与者,他们的面部不只会被录下,还会被自动分析。
- 测量在 Neutropic 的服务器上运行,模型接收的是数字。上传内容在你删除之前一直保存在私有工作区,不会用于训练。会向所选模型提供商发送什么,见隐私政策。
- 与合作者共享时,尽量共享派生的 AU 表格,而不是原始视频。