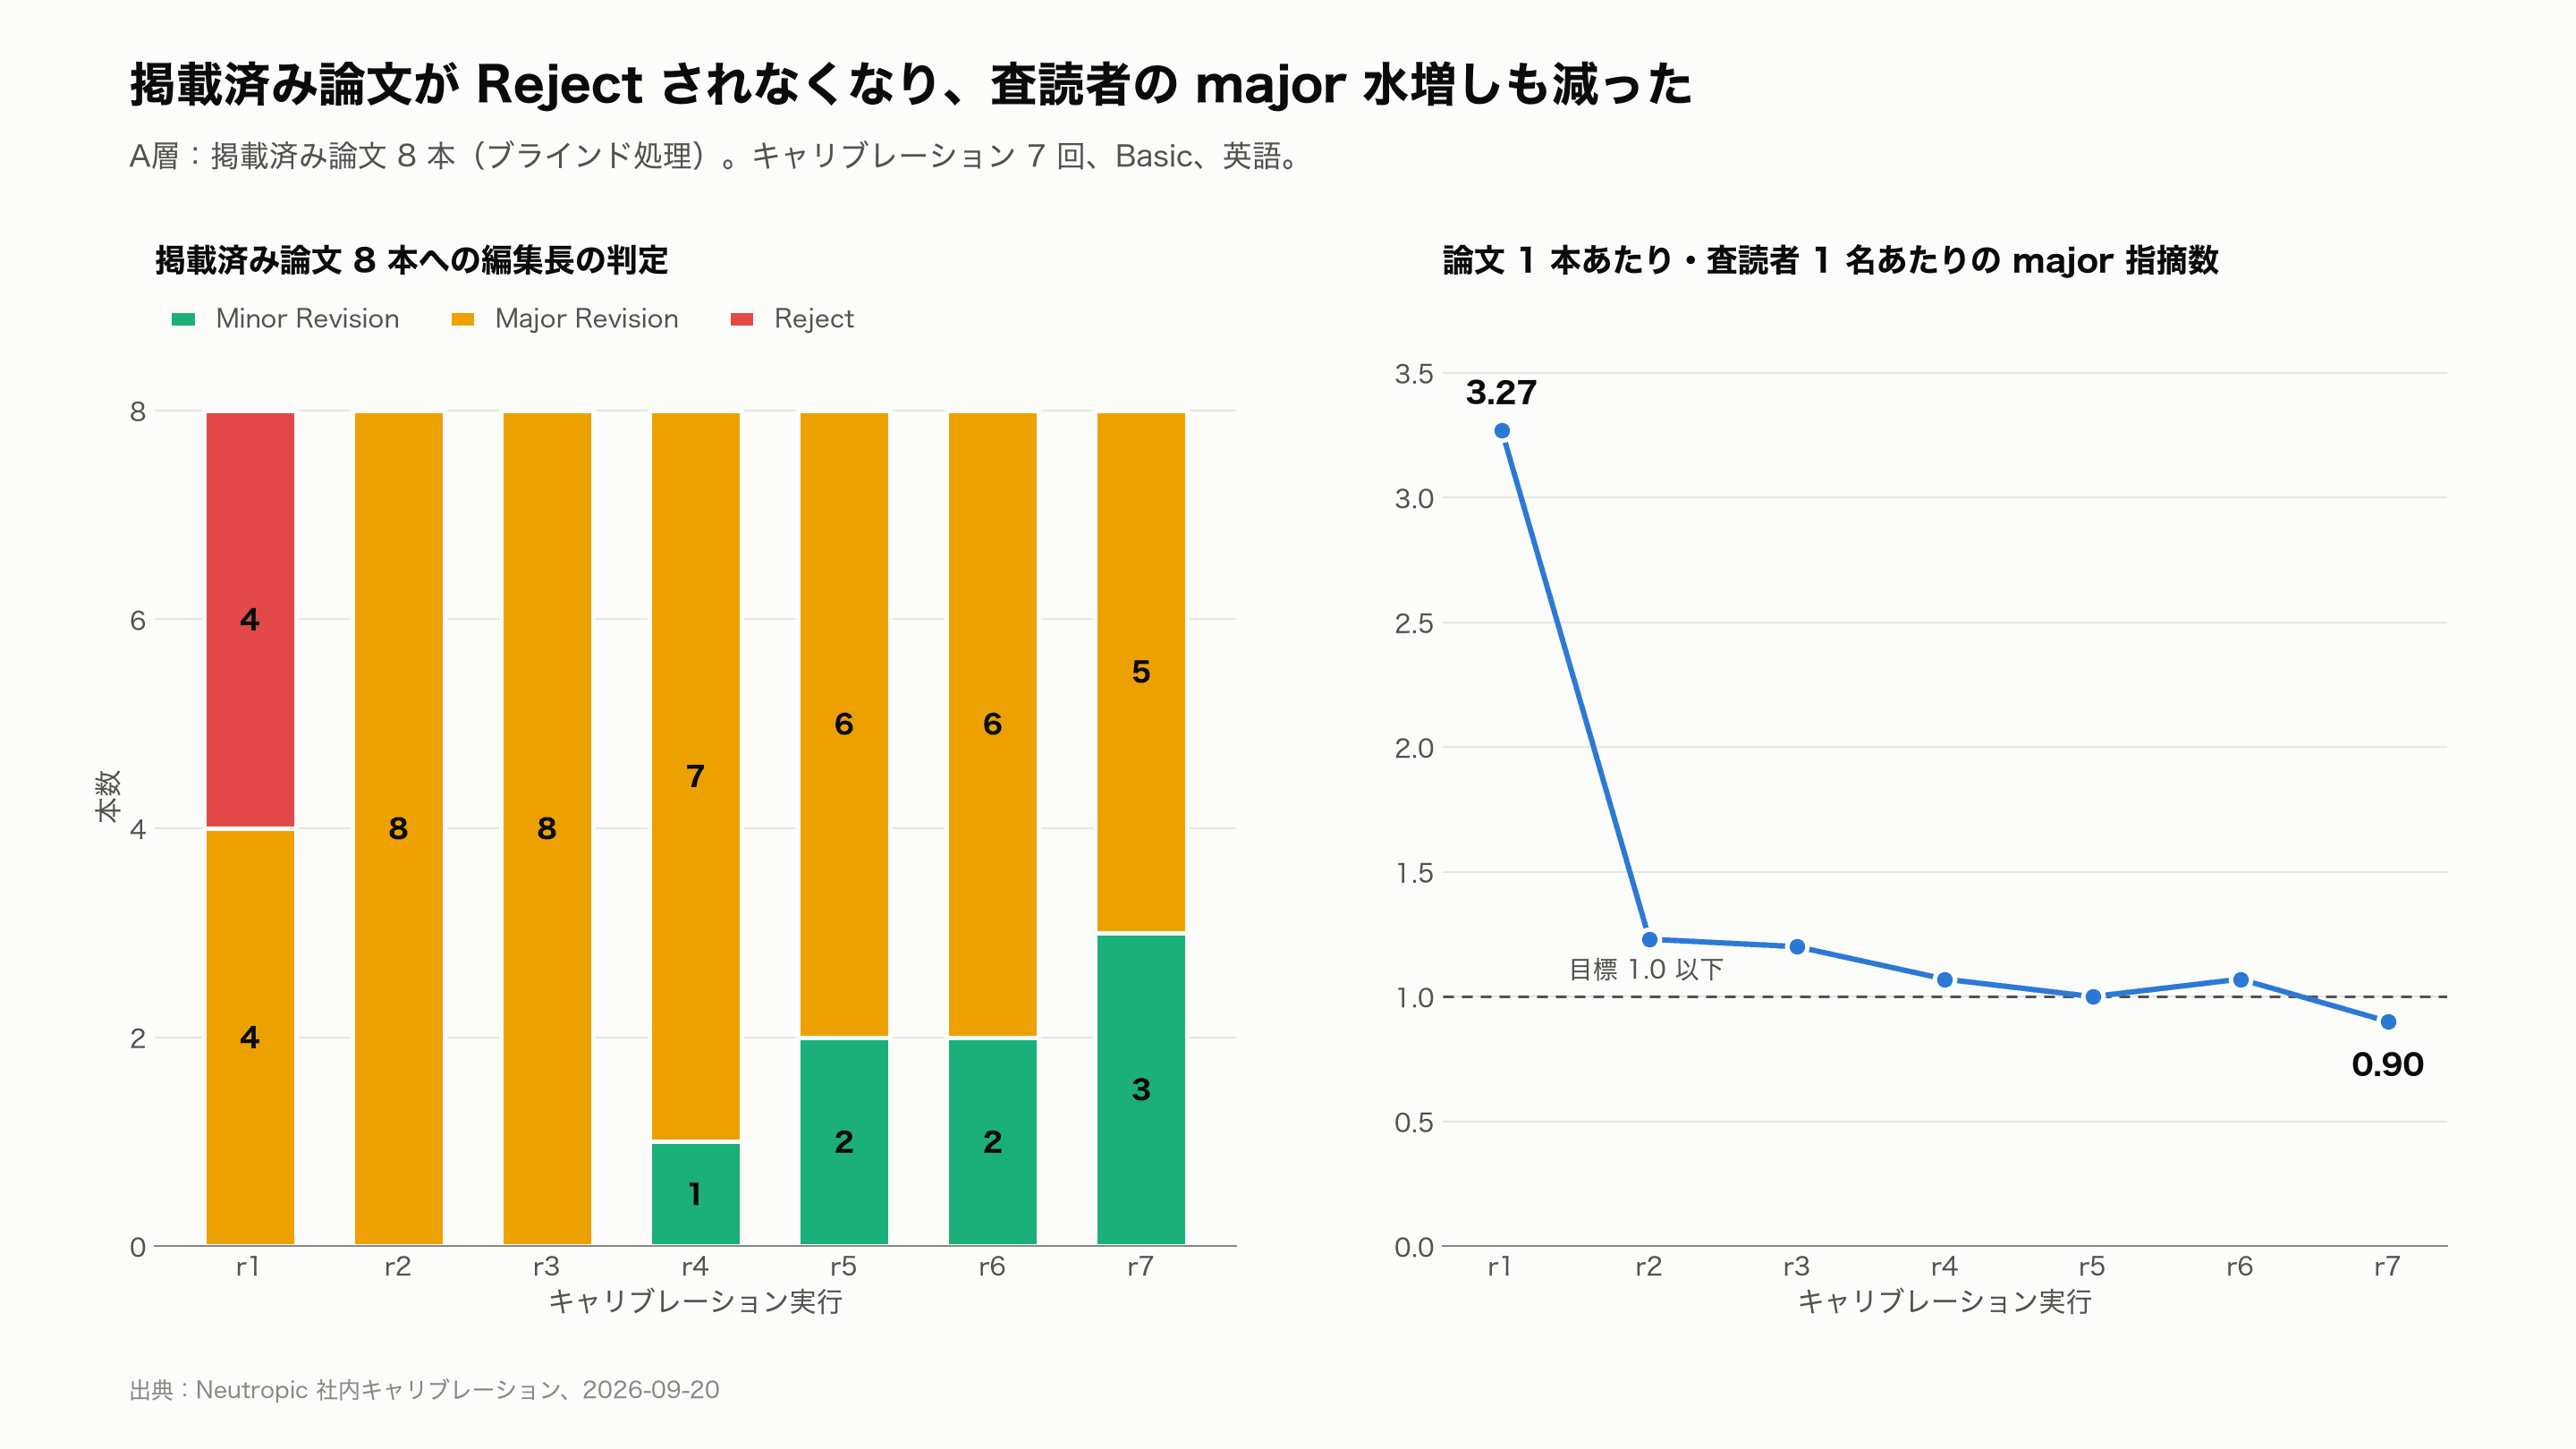
分析を作り、自分の仕事を採点もする単一モデルには明白な利益相反があります。Neutropic は 2 つの役割を分けます:生成エージェントが分析を実行し、独立したレビューエージェントが、あなたが結果に依拠する前にそれを検査します。実際の原稿でどう見えるかを以下に示します。
レビューエージェントが確認すること
レビューエージェントは研究デザインとデータから分析を再導出し、発表論文にまで最もよく紛れ込む失敗のパターンを探します:
- 前提の違反——正規性、分散の等質性、球面性、独立性。
- 分析計画が補正しなかった多重比較のリスク。
- 主張された効果に対する検出力とサンプルサイズ。
- 分析の不整合——報告された表とパスが合わない媒介モデル、本文の説明と異なるサブセットで計算された図、データセットからは出てこない本文中の数値。
不一致こそが機能
2 つのエージェントの意見が分かれても、Neutropic は黙って勝者を選びません。不一致は双方の立場とエビデンスとともにあなたに示されます。社内研究では、こうしてフラグの立った不一致が、人間の方法論者も提起する問題の最良の単一予測因子でした。
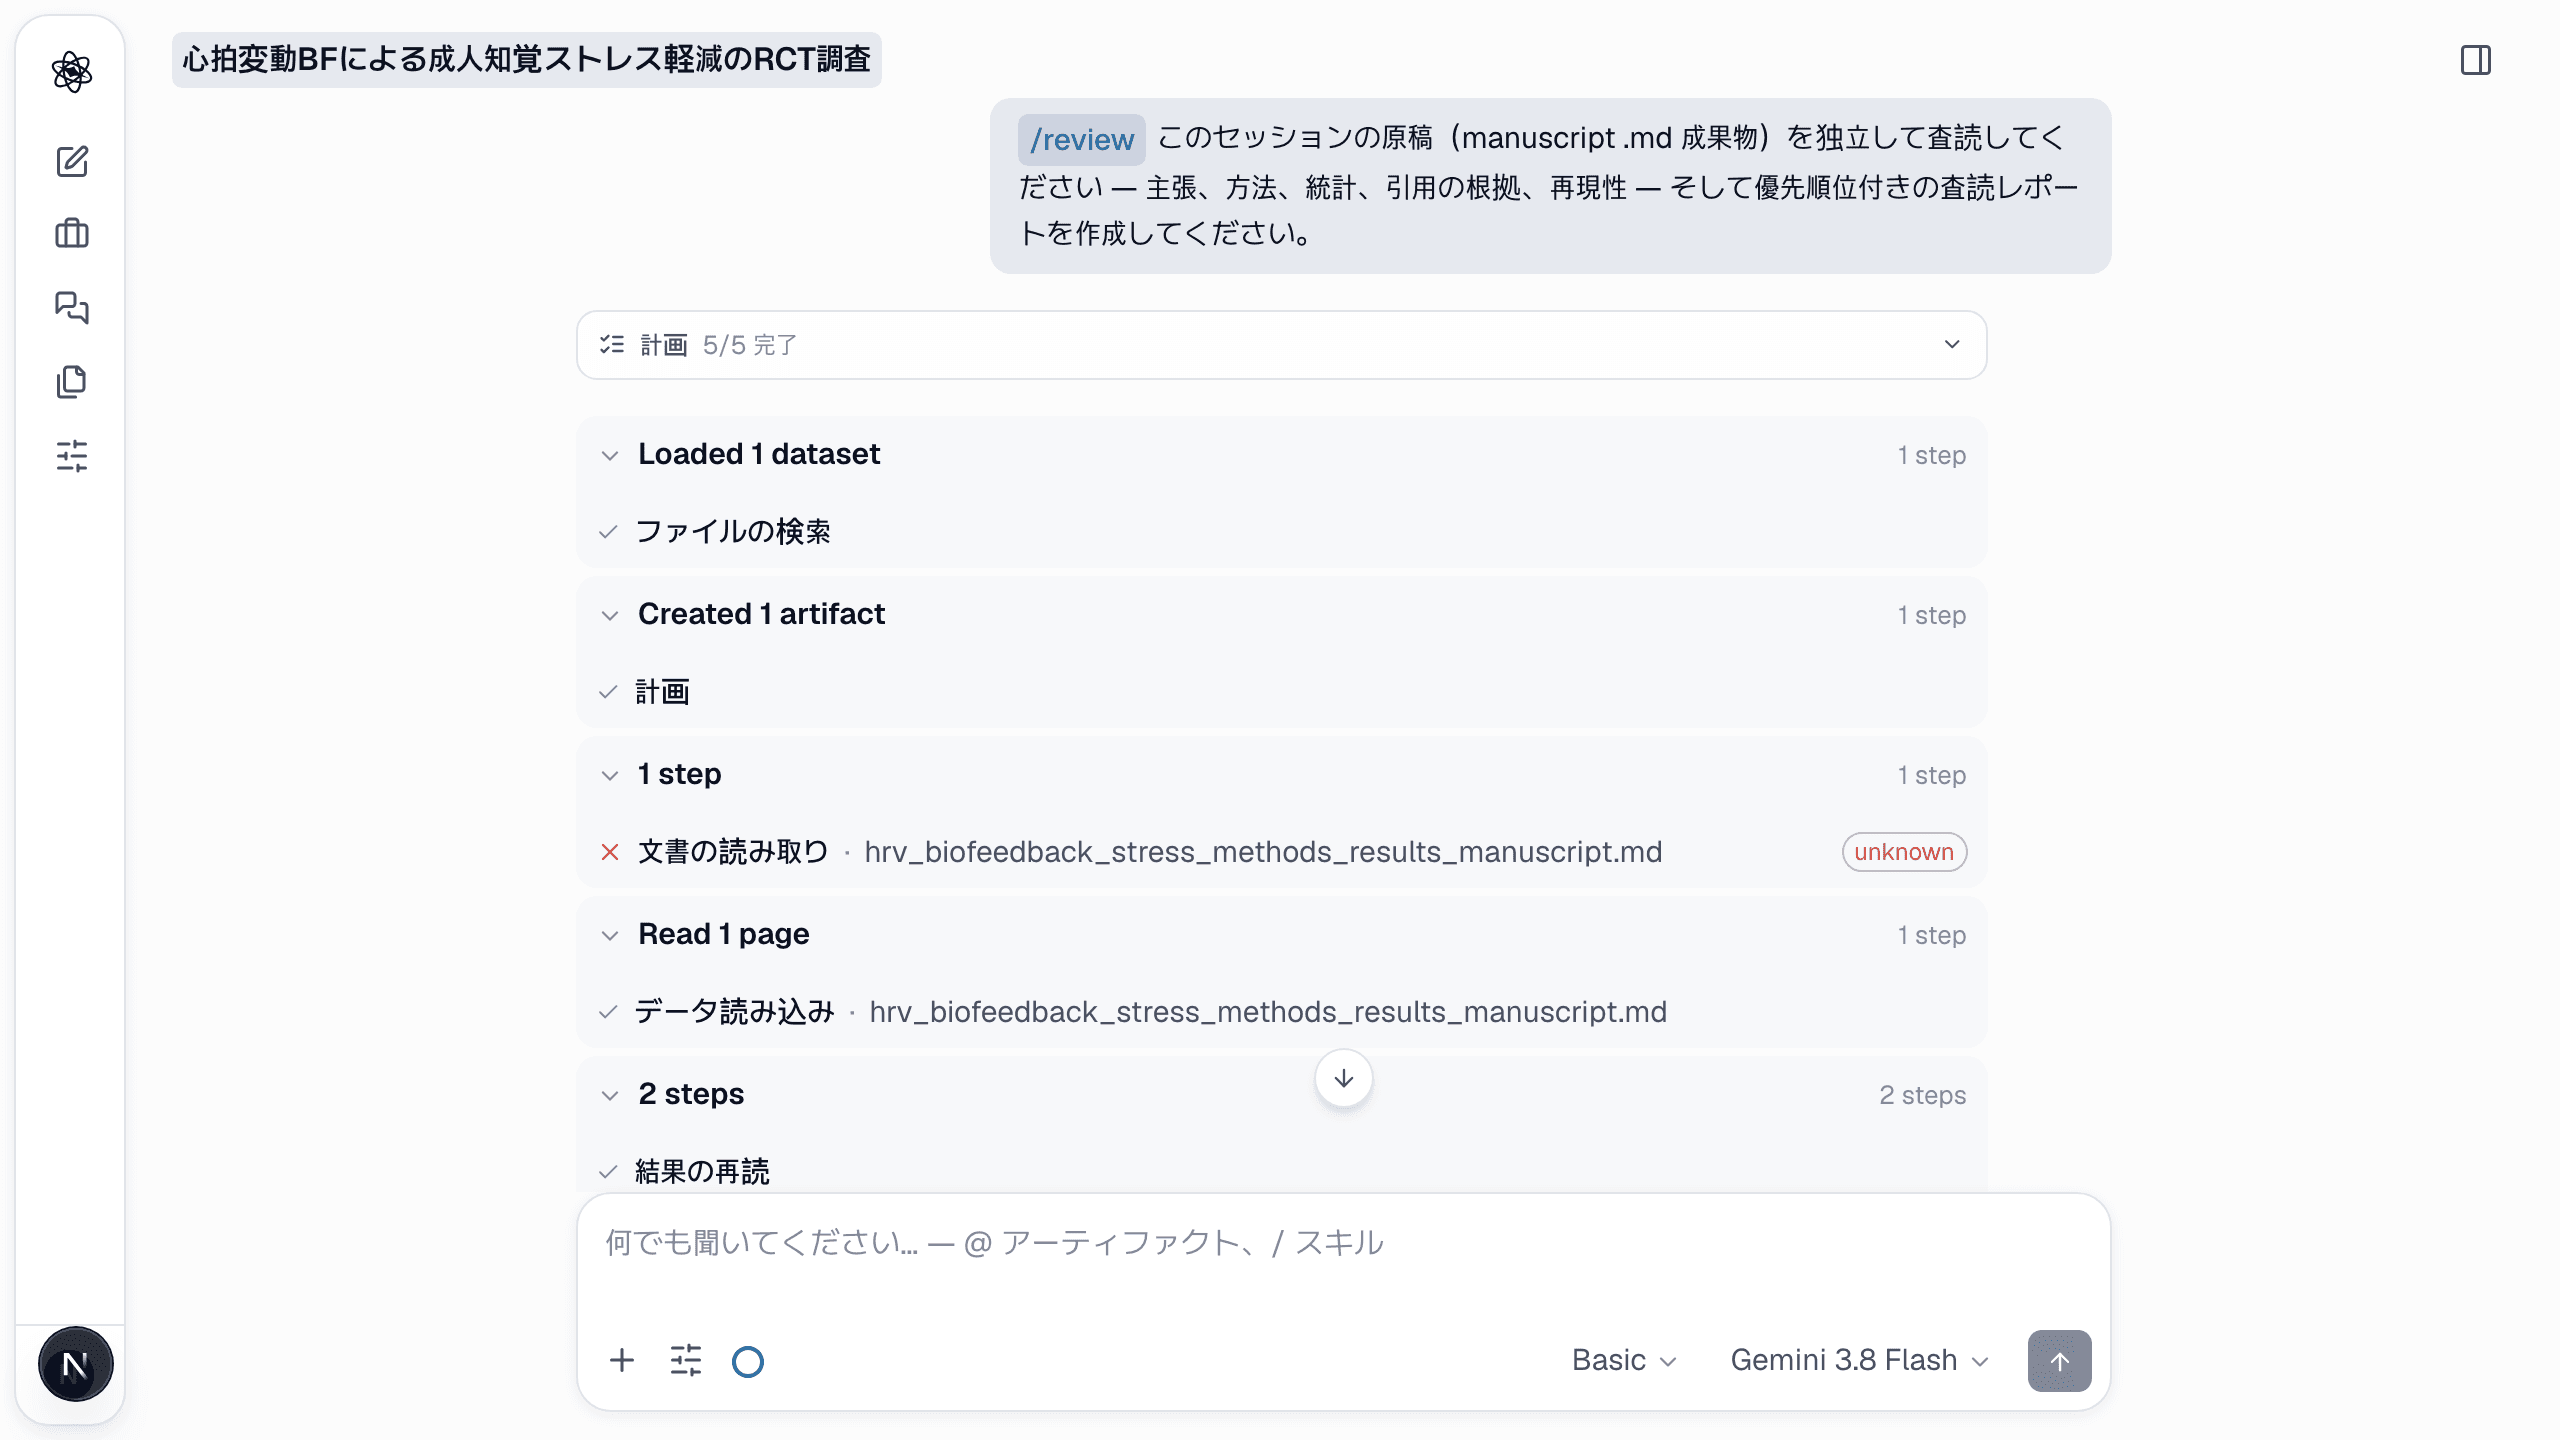
実際に捕まえたもの
初期ユーザーからは、球面性の前提が崩れたデータで実行された反復測定 ANOVA、中心化していない変数で交互作用項を計算した調整分析、報告された検出力分析が誤った効果量ファミリーを使っていた研究などをレビューエージェントが指摘した事例が寄せられています。ここに示すセッションでは、Methods に引用された人口統計の平均が試験データセットと一致しないことを発見しました——同じ段落の推測検定はデータで再実行すると小数点第 3 位まで一致したにもかかわらず。
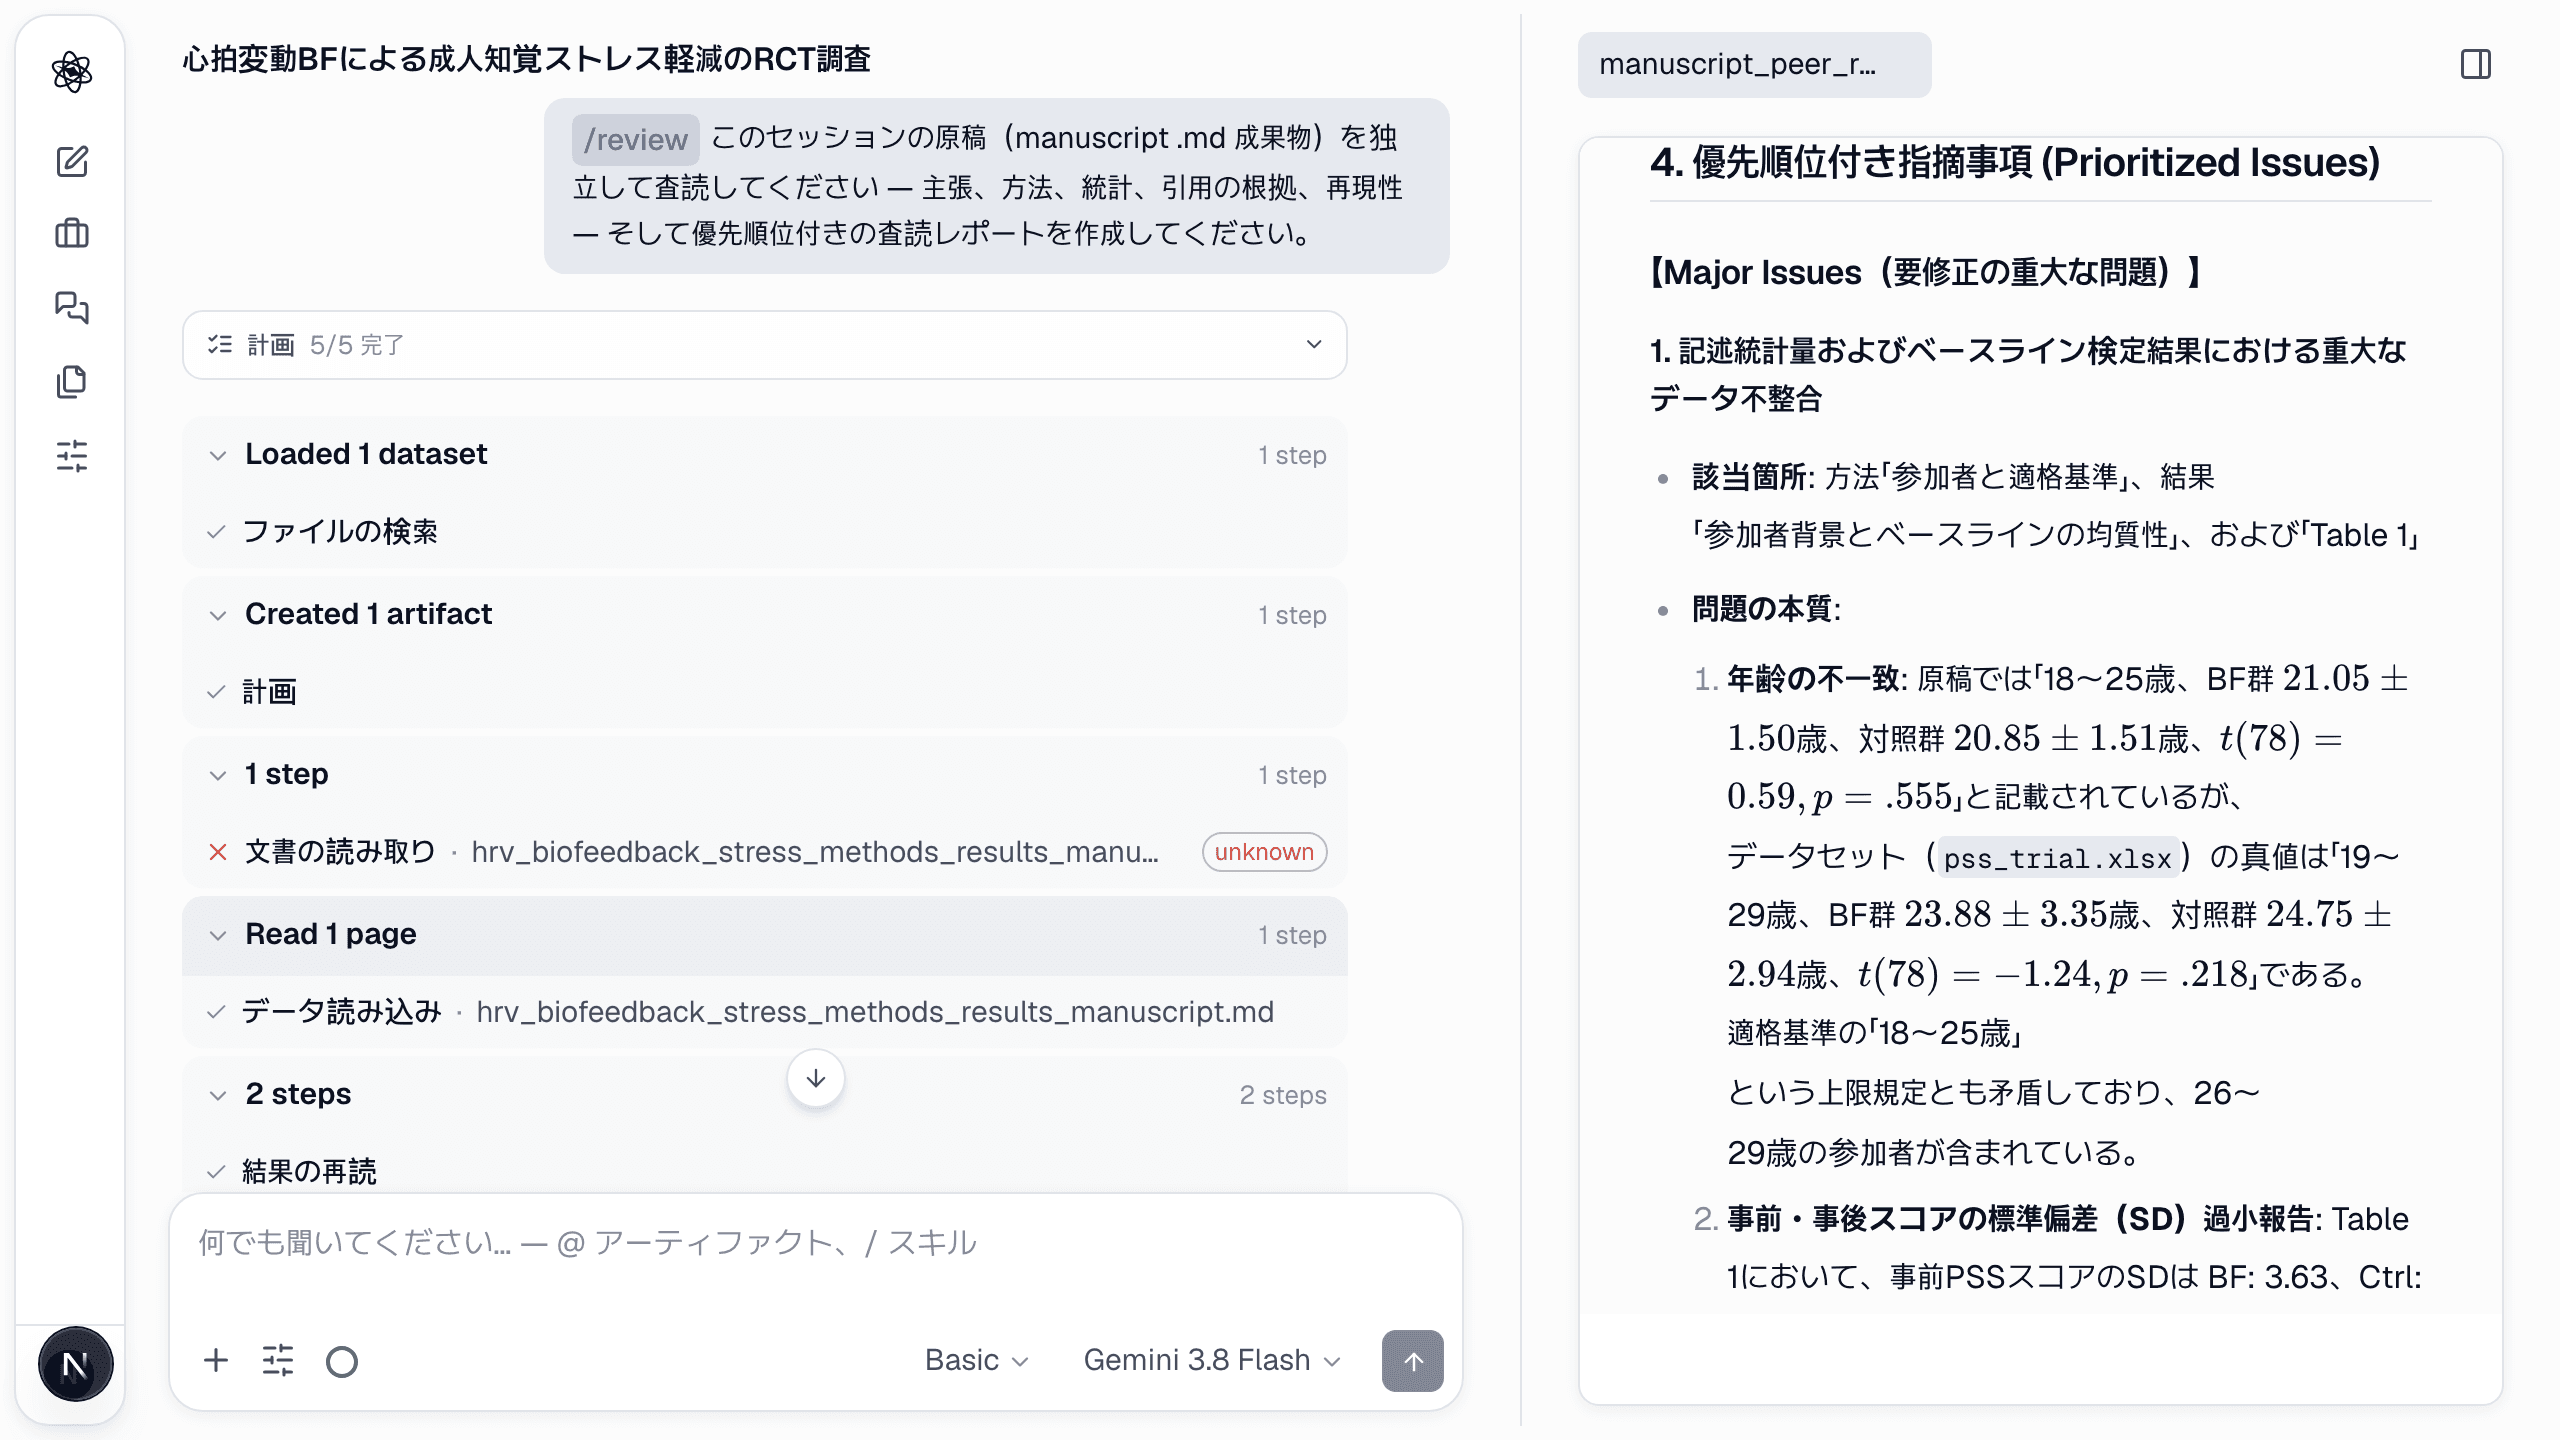
どれも特別なものではありませんでした。締切のプレッシャー下でのありふれたミス——まさに二人目の読み手が存在する理由です。
サービスではなく、デフォルトとしての厳密さ
レビューを予約したり、依頼を忘れないようにしたりする必要はありません。Deep レベルでは、Neutropic のすべての分析が結果を知見として提示する前にレビューを通ります——バージョン管理が「コードのバックアップ」を判断事項でなくしたのと同じです。論文全体に対する査読者の読みが欲しいときは、/review がメッセージ一つ先にあります。