ユーザビリティ研究は雑多な成果物の山を生みます:アンケートのエクスポート、画面録画、インタラクションログ、アイトラッキングファイル。多くのチームは、その山から学ぶより、分析可能な形に組み立てることに時間を費やしています。HCI チームが Neutropic でパイプライン全体を回す方法を紹介します——すべてのスクリーンショットは、2 つの UI バージョンの A/B 研究(サンプルデータ、参加者 48 名)に関する実際のセッションからのものです。
ステップ 1 — エクスポートを入れて、それが何か伝える
Qualtrics や CSV のエクスポートを添付し、デザインを一つのメッセージで説明します。Neutropic は SUS、NASA-TLX、UEQ の項目構造を認識し、正しい採点(逆転項目を含む)を適用し、スコアとともに信頼性付きの尺度統計を報告します——怪しいアルファがスプレッドシートの中に隠れることはありません。
/analyze usability_ab_study.csv is a between-subjects usability study of two UI versions (A vs B, 48 participants): SUS items sus1-sus10 (1-5), NASA-TLX subscales (0-100), task_time_s, and errors. Score SUS and NASA-TLX, compare the versions on SUS, workload, task time, and errors with effect sizes, and produce a summary dashboard figure.
ステップ 2 — 問いを先に述べるレポートを読む
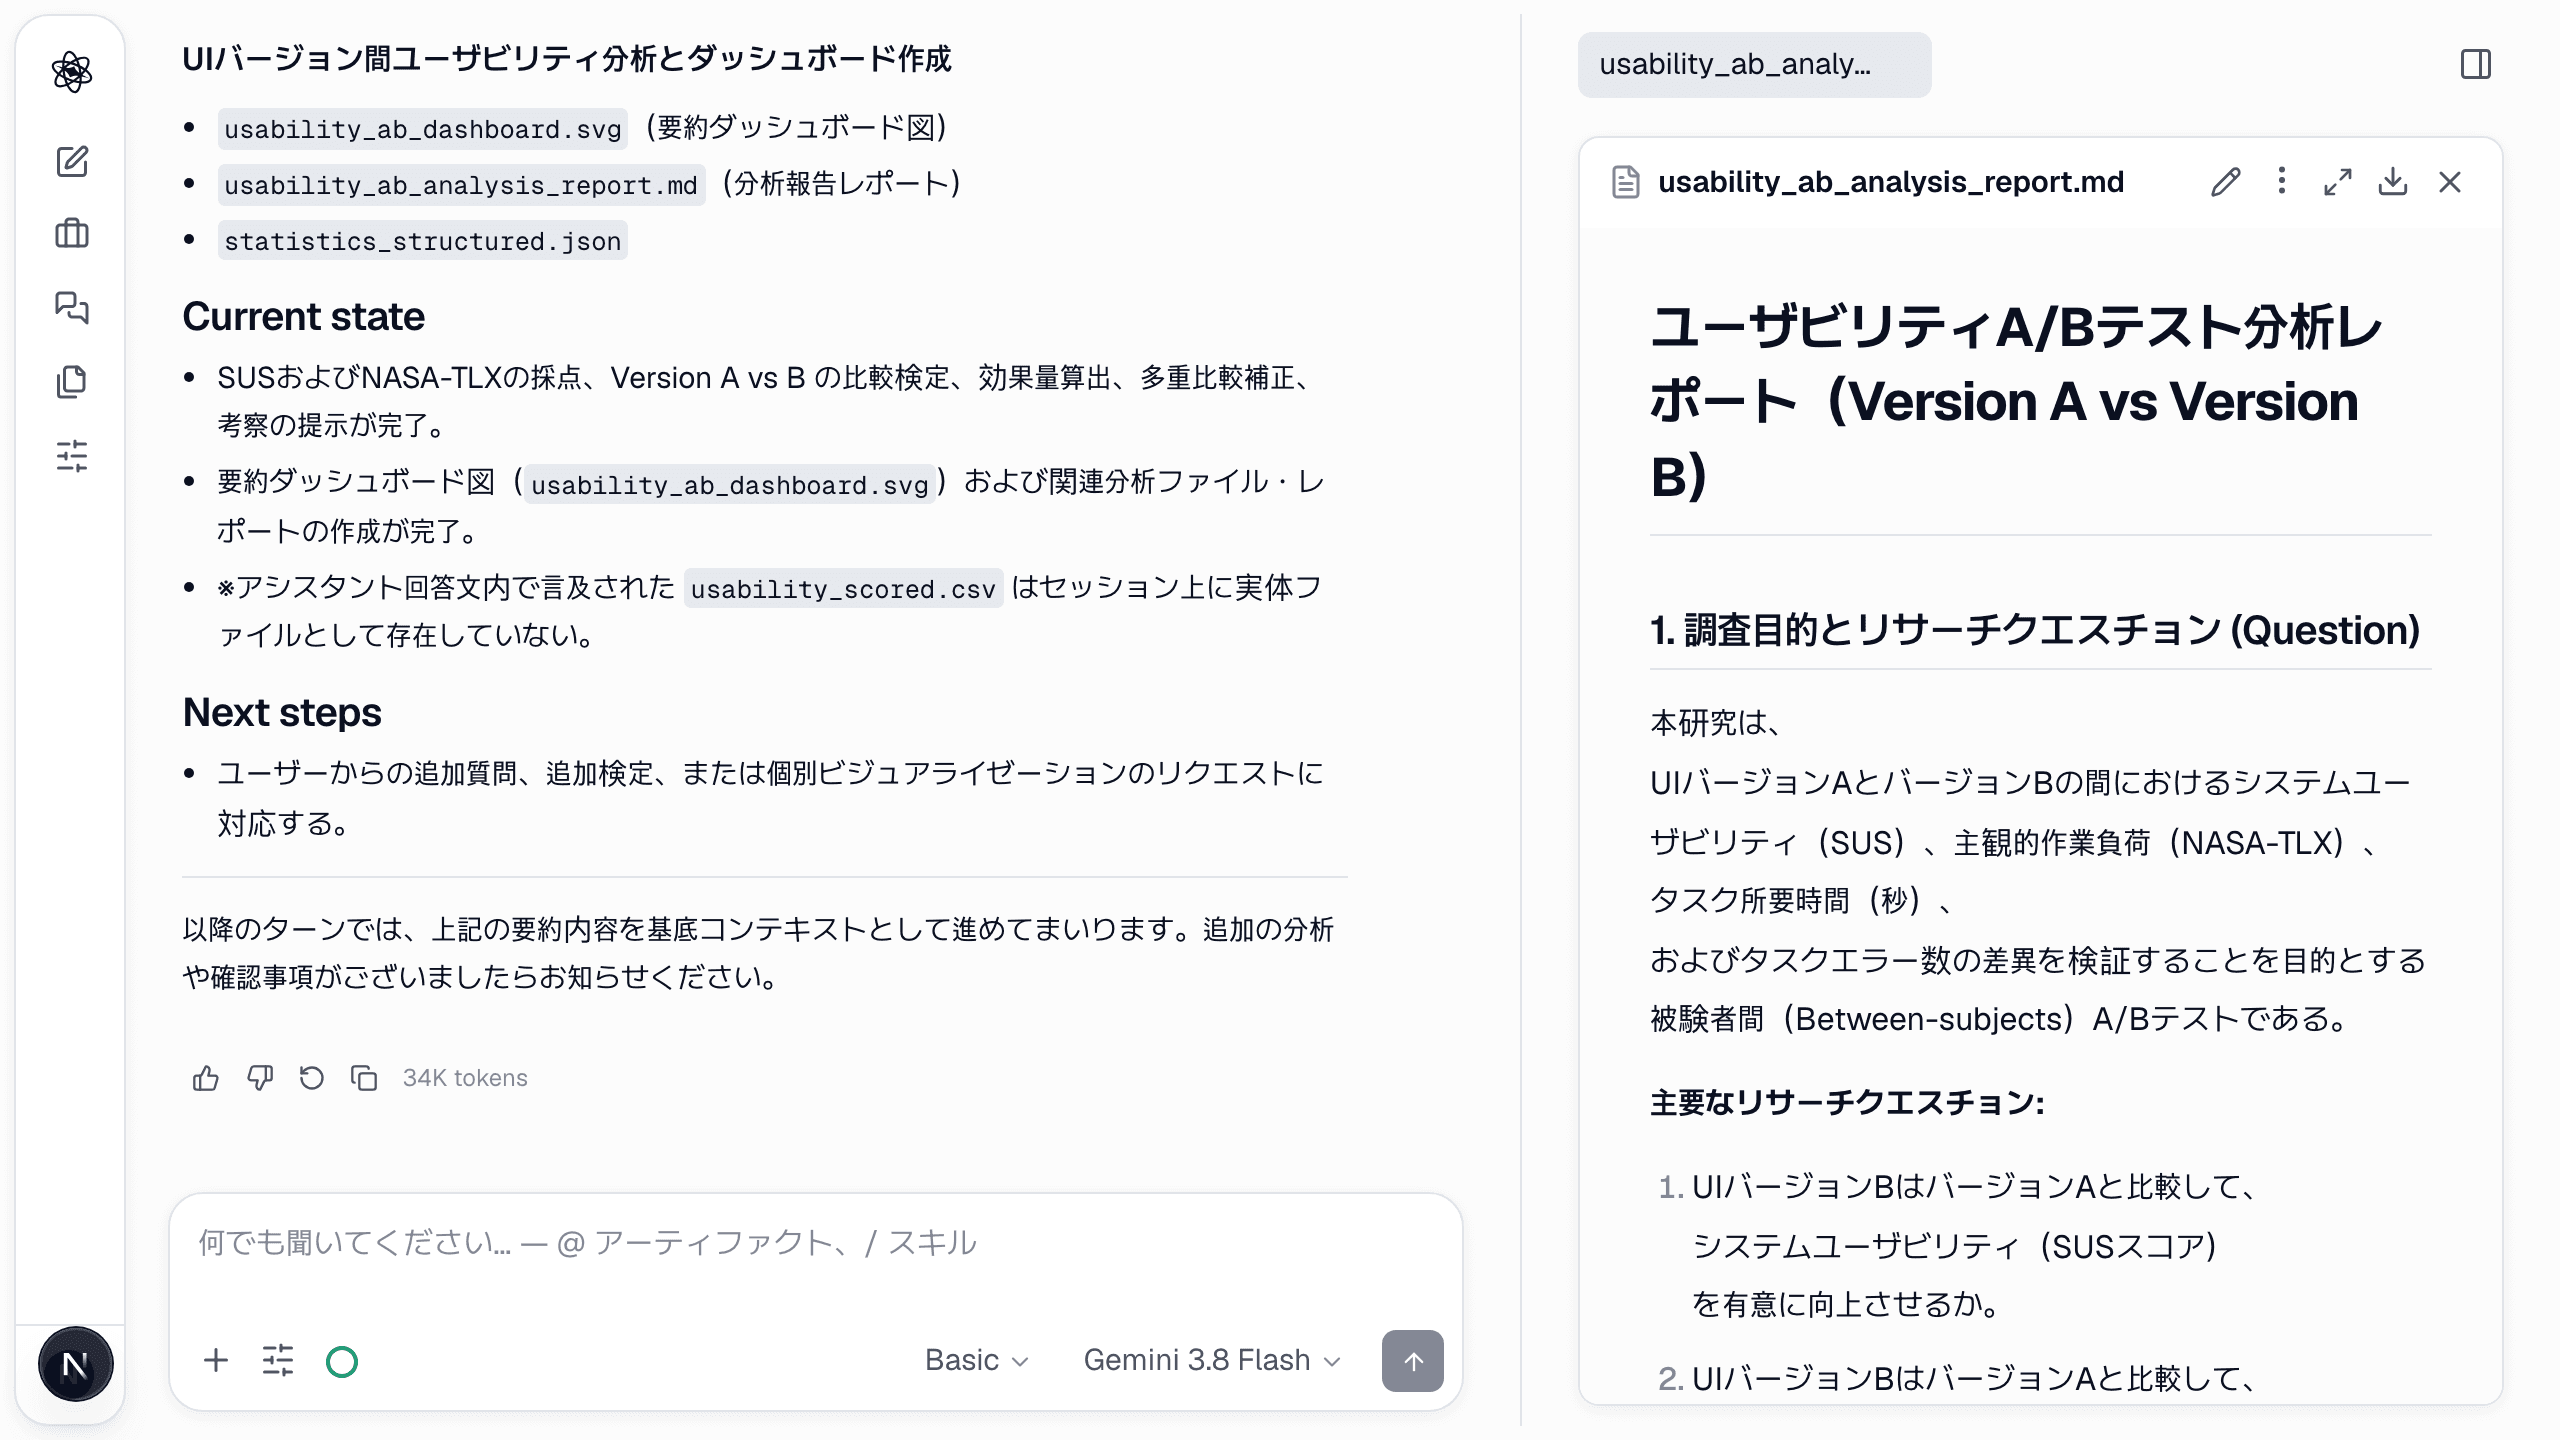
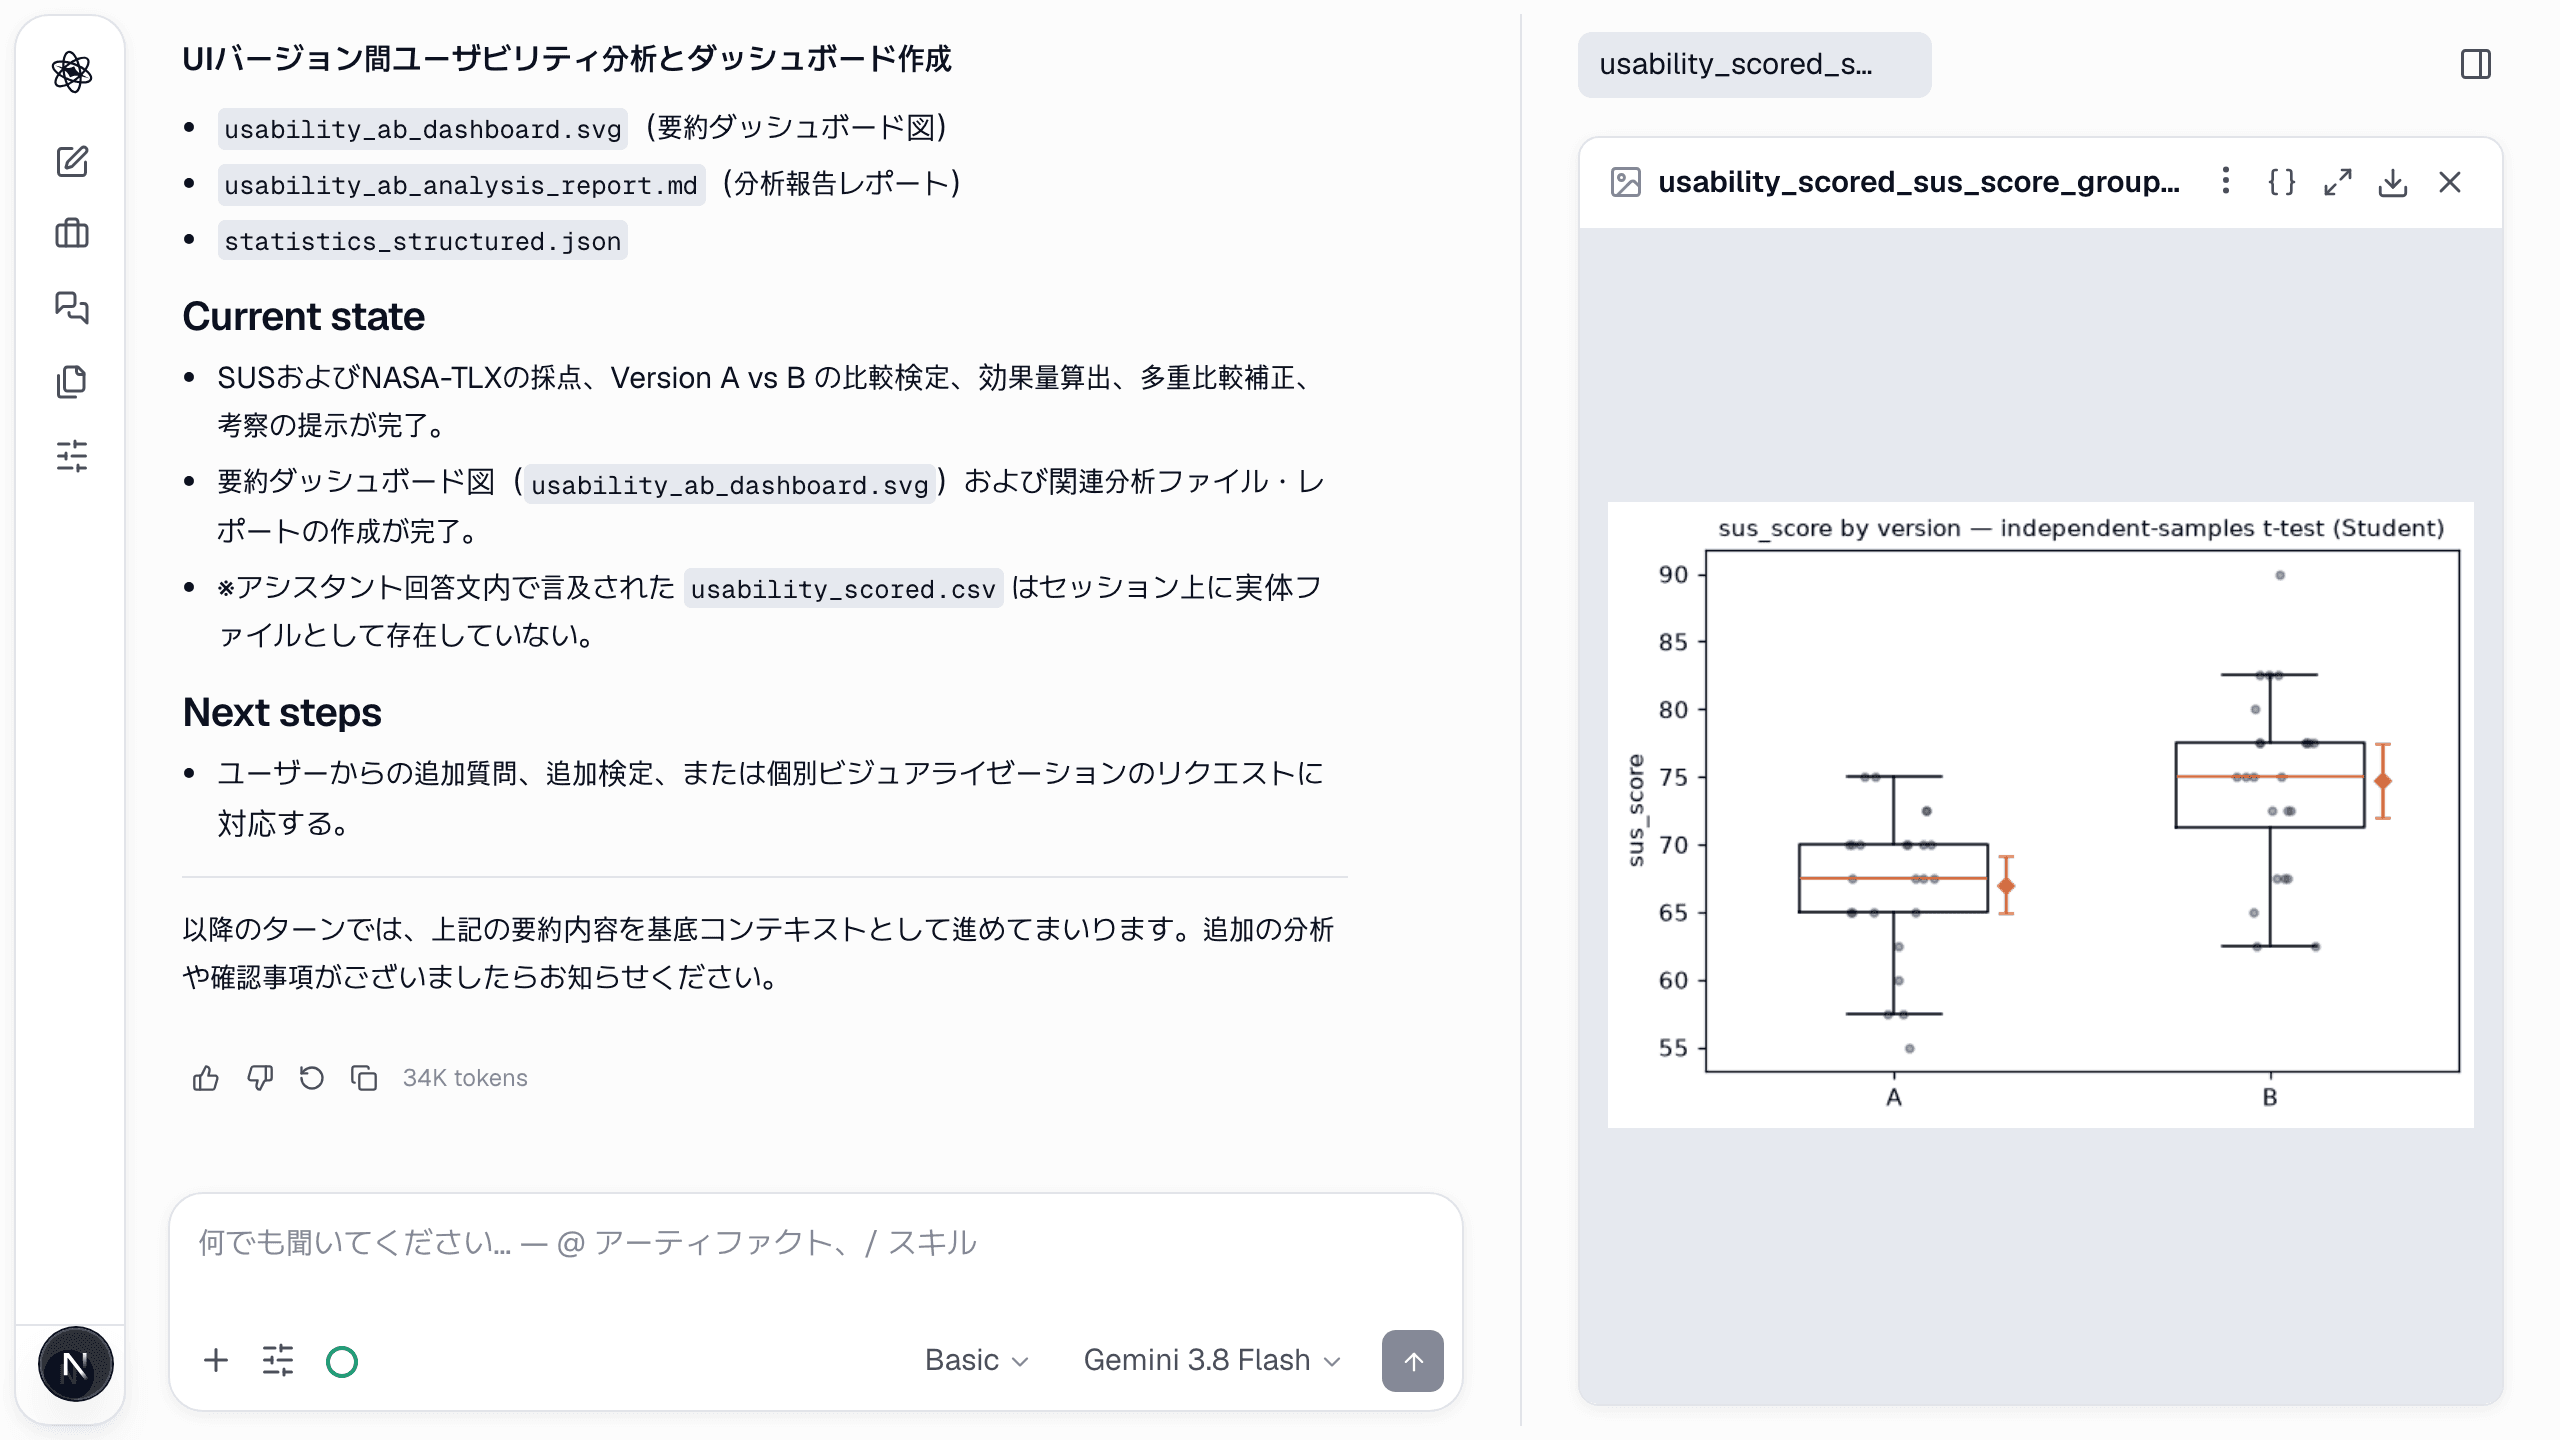
分析レポートは、いかなる比較より先に研究上の問い、データセットとその品質監査(48 行、欠損なし、SUS 項目はすべて範囲内)から始まります——一つのメッセージから 12 の成果物が出てきます:採点表、測定ごとのグループプロット、記述統計、ダッシュボード。
ステップ 3 — 正しい検定を使う A/B テスト
デザイン——被験者間か被験者内か、結果測定、サンプル——を説明すると、エージェントが分析を選んで正当化します。Deep レベルではレビューエージェントがその選択を検証します。結果は p 値だけでなく、信頼区間付きの効果推定値と平易な解釈で返ってきます。
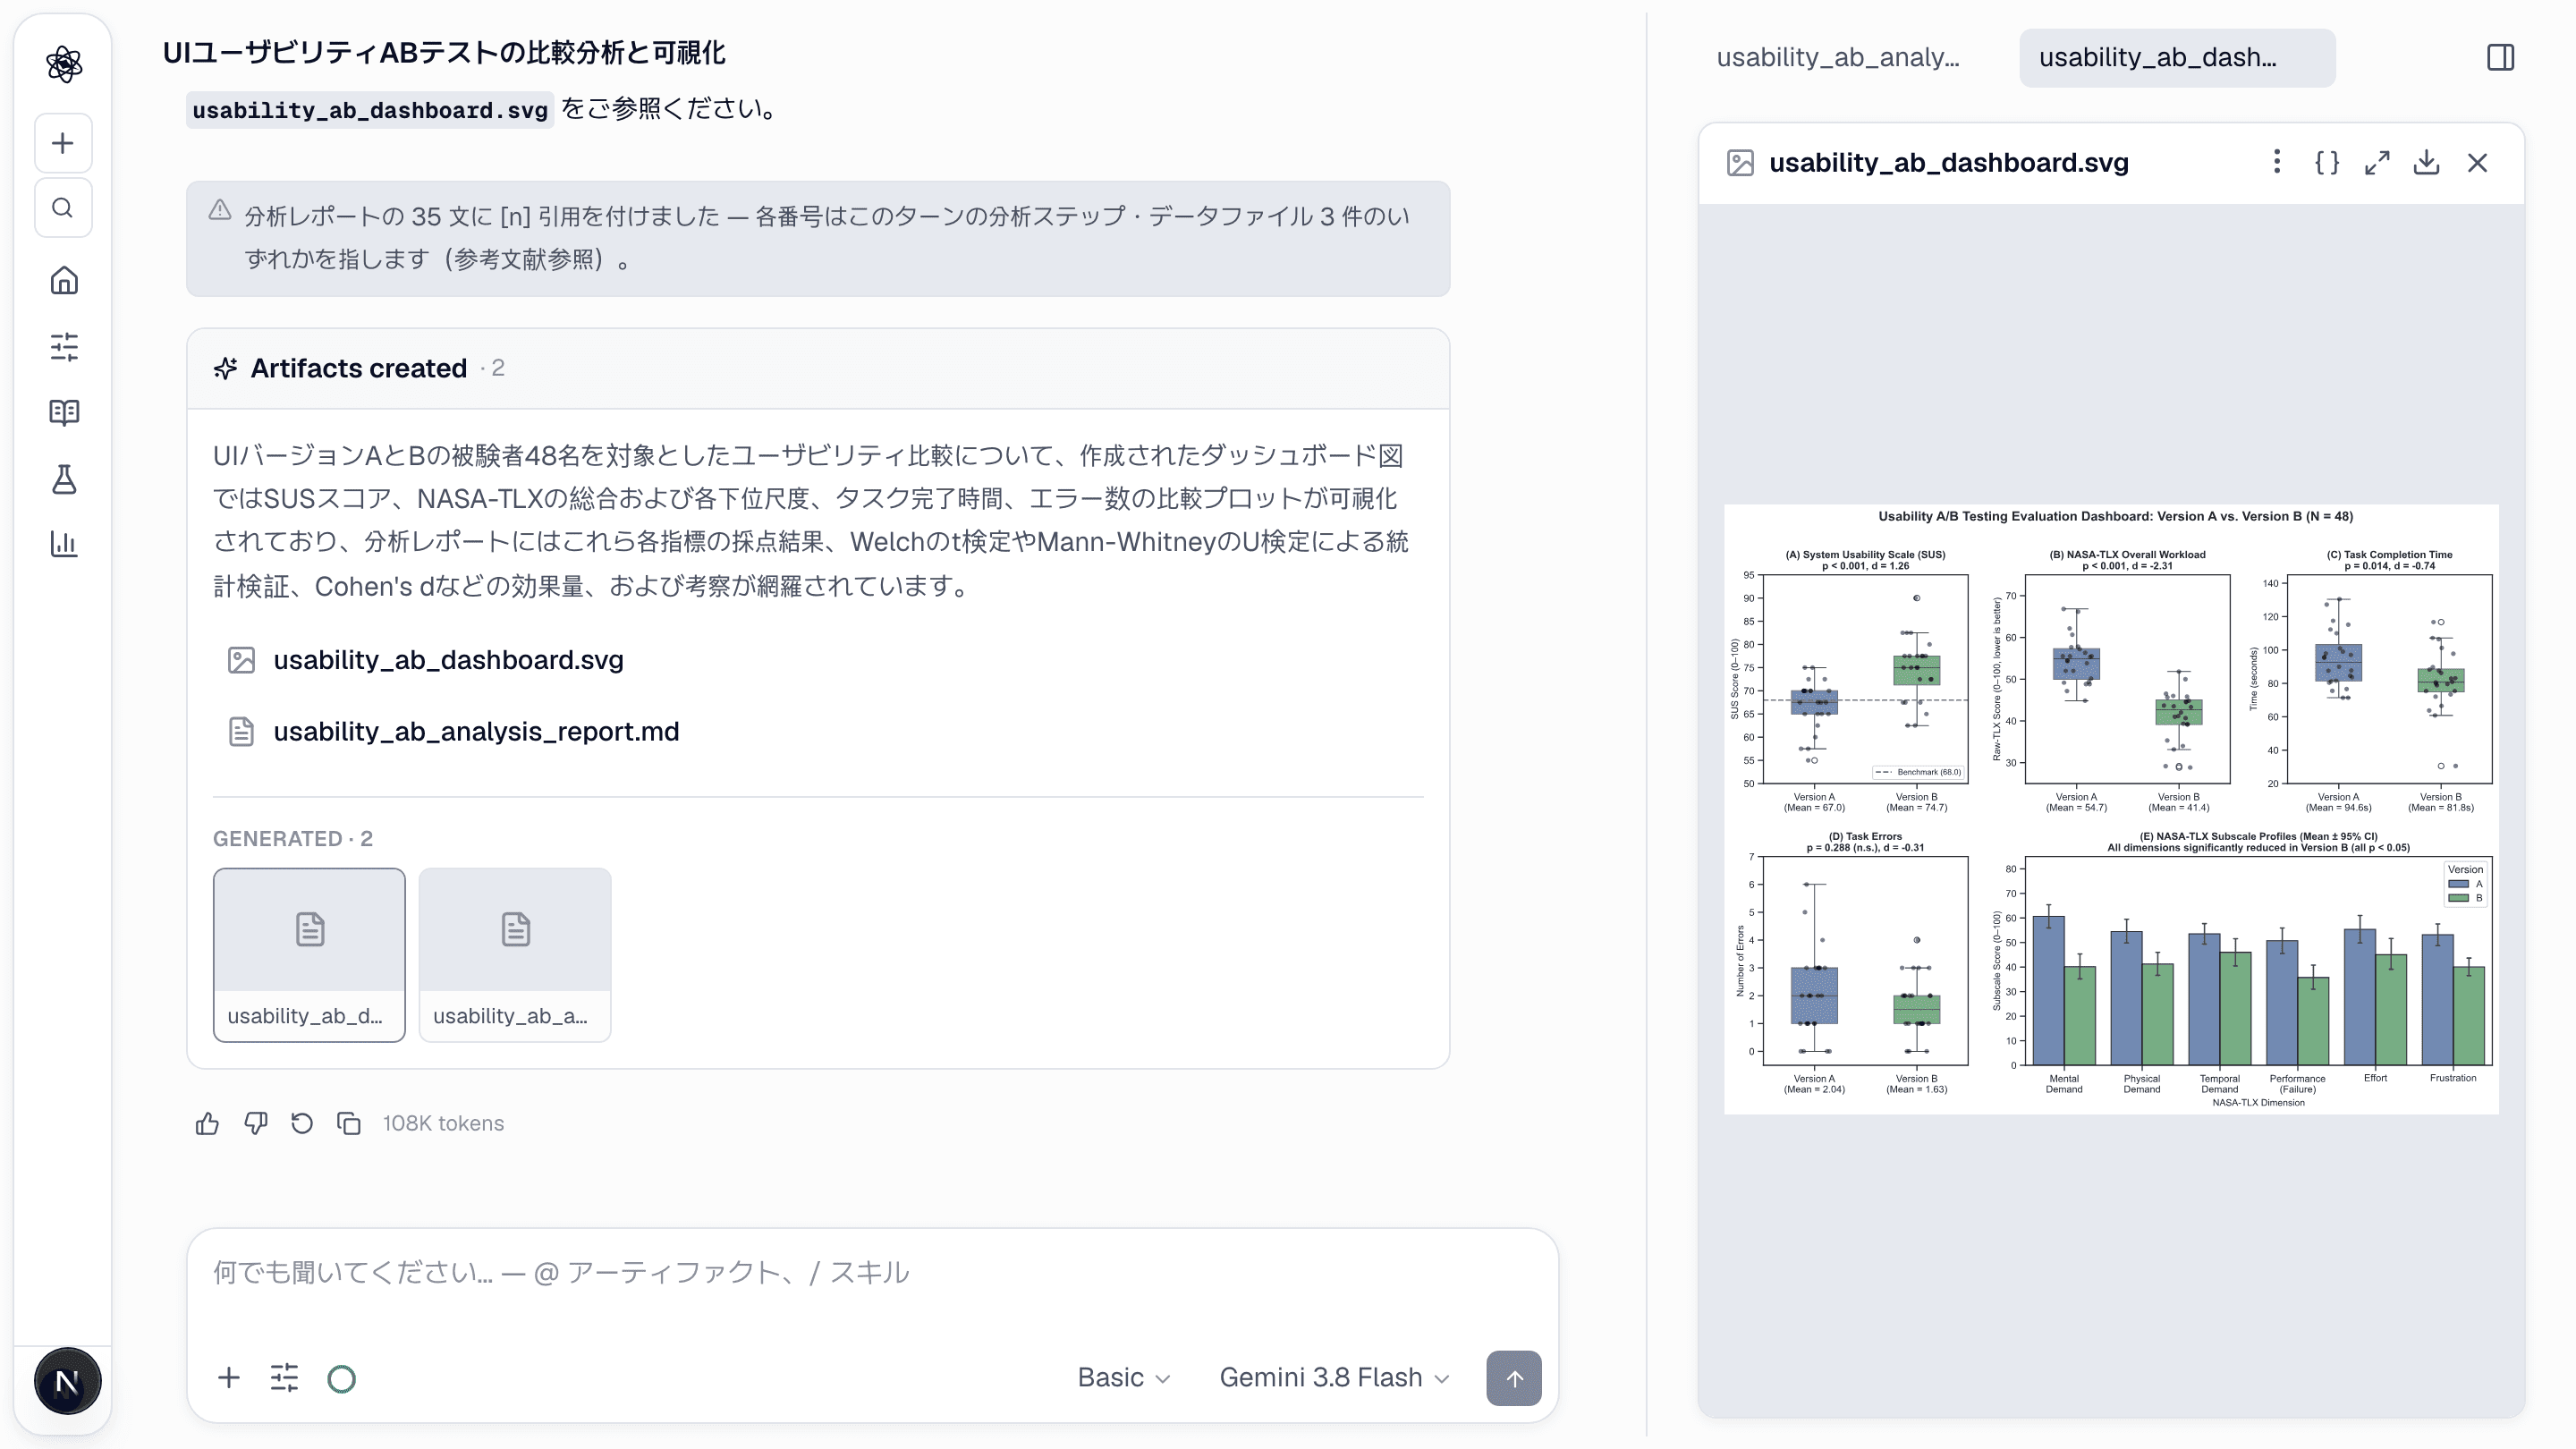
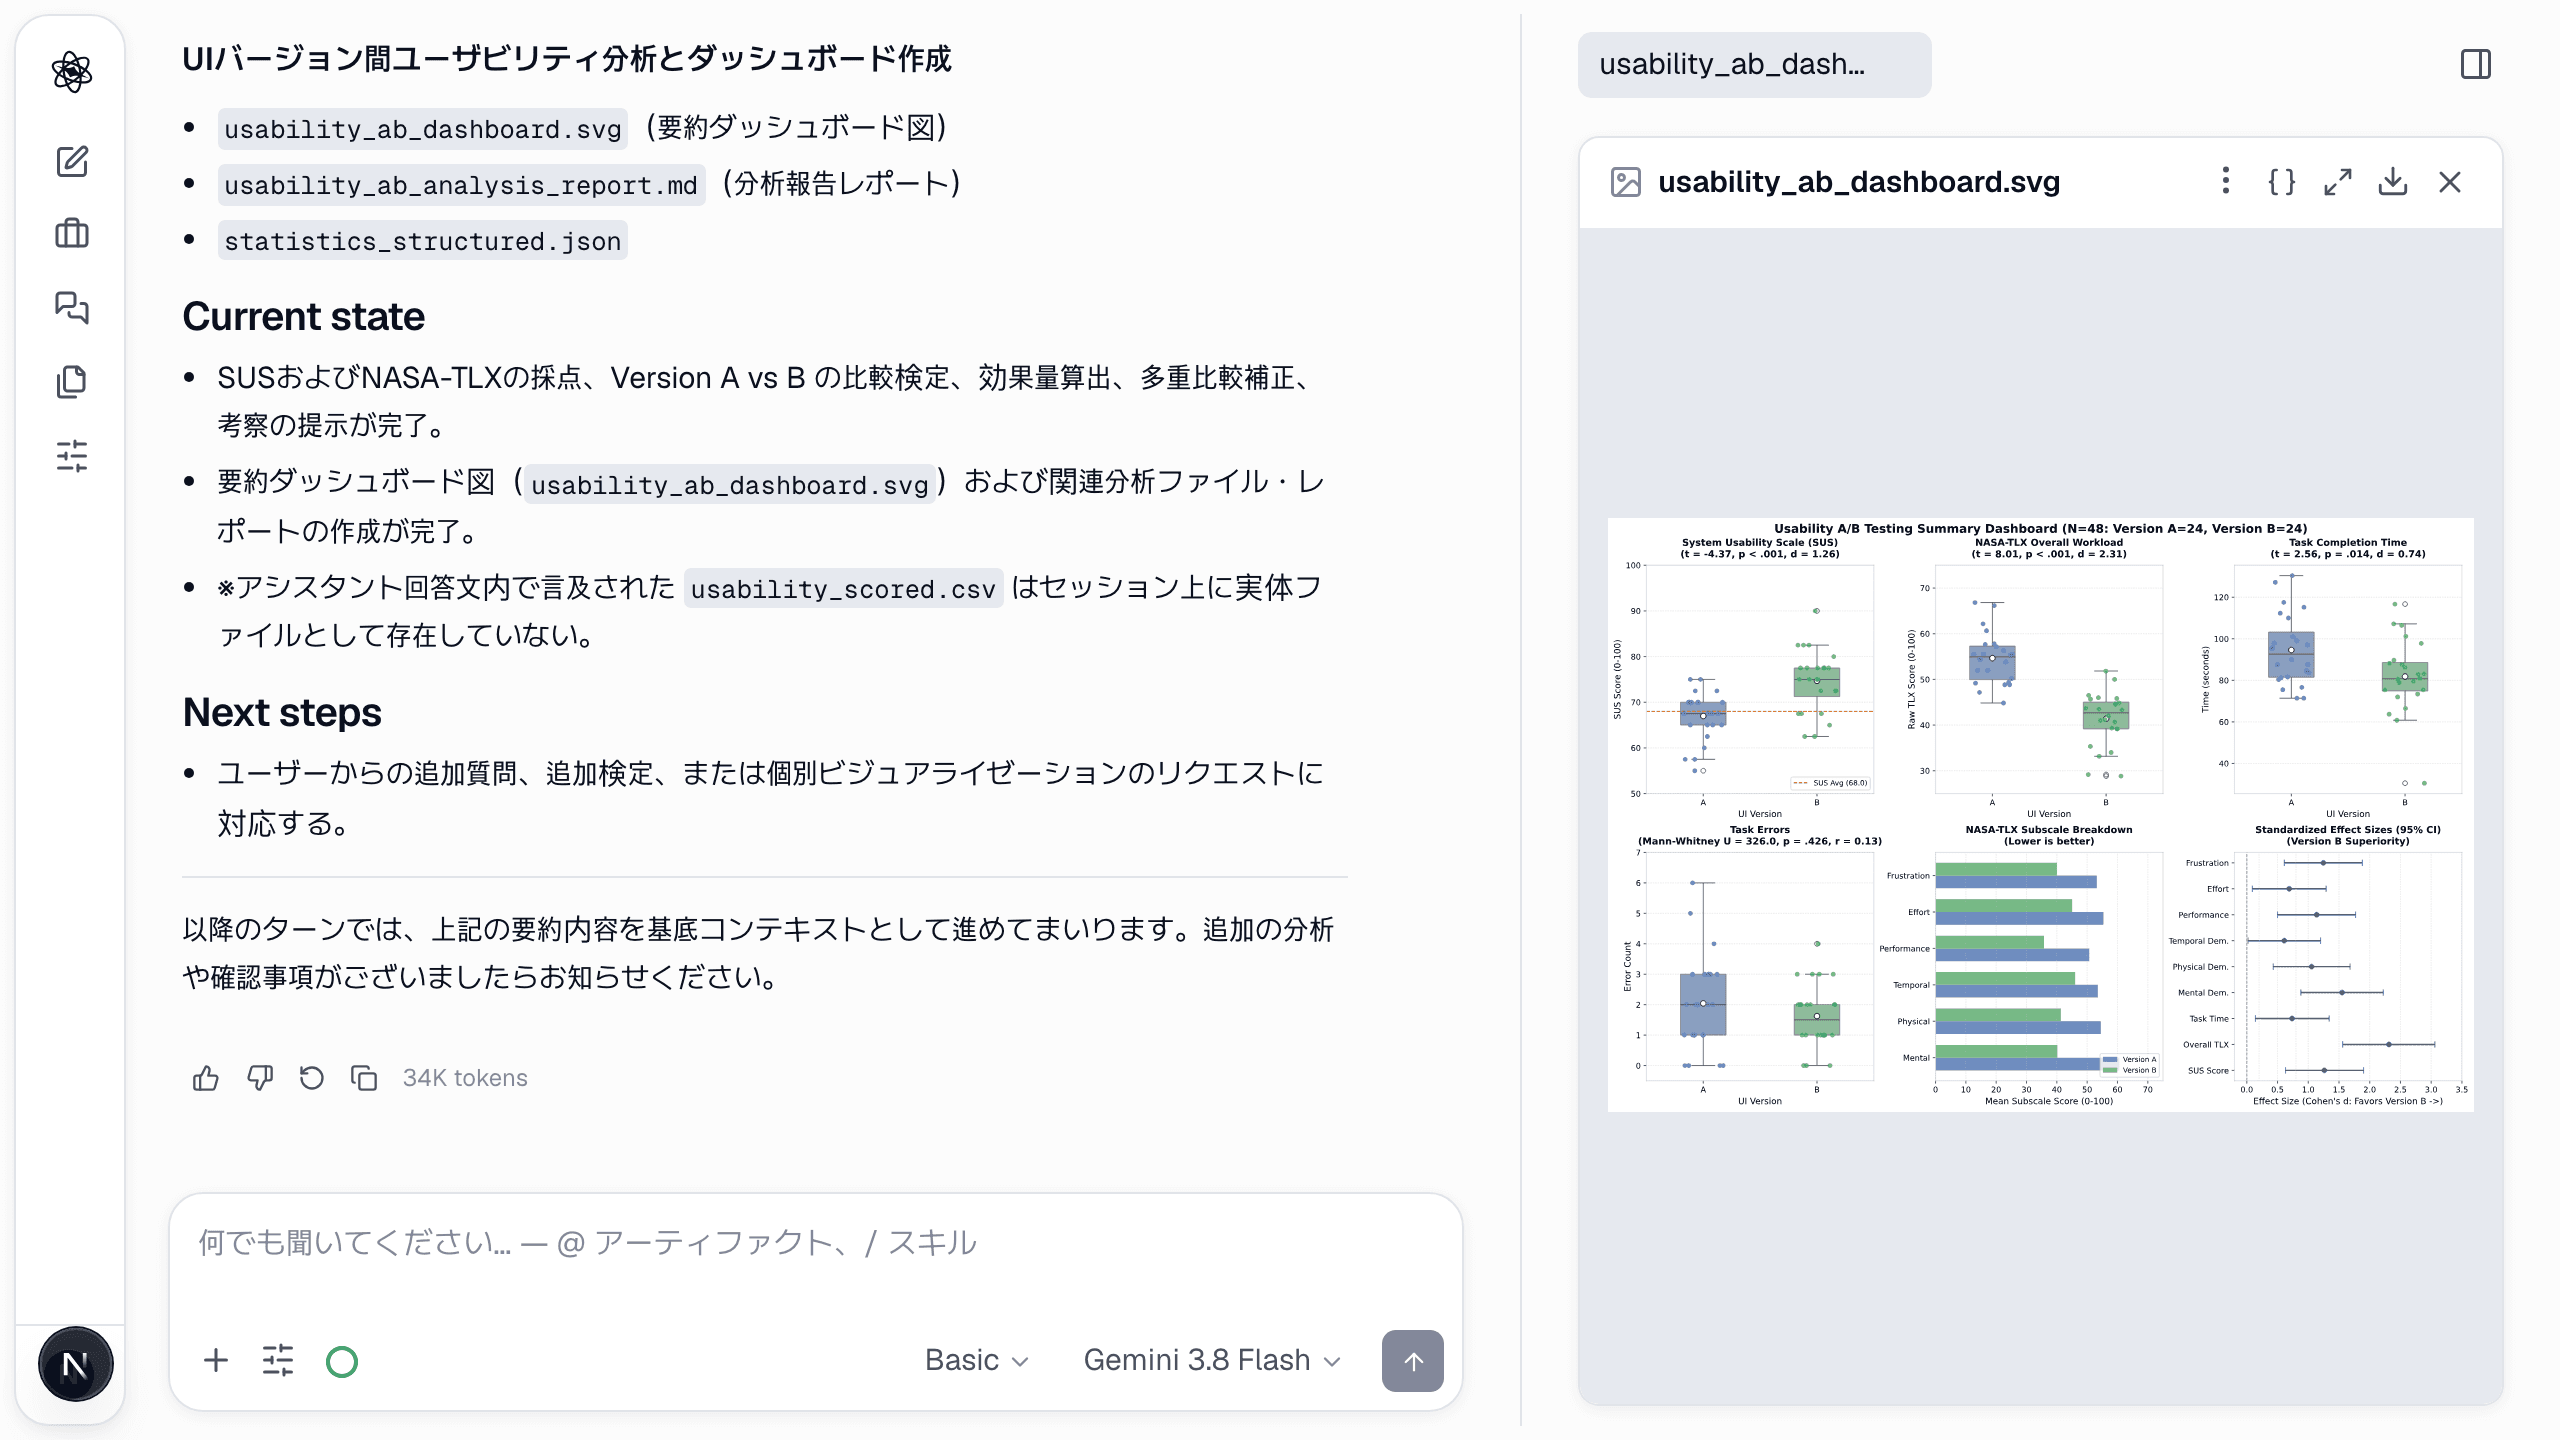
ステップ 4 — デザインレビューのためのダッシュボードひとつ
ダッシュボードを求めると、4 つの結果が一枚の図に構成され、各パネルに検定統計量と効果量が付きます:SUS t(46) = −4.37, d = 1.26;NASA-TLX d = 2.31;タスク時間 d = 0.74;エラー Mann–Whitney, r = 0.13。
インタラクションログと視線
- イベントログのエクスポート(条件ごとのタスク時間・エラー・完了率)は他のデータセットと同じように分析されます — 要約と正しい検定による群間比較が、それを生成したコードとともに保存されます。
- アイトラッキングのエクスポートは注視回数・注視時間とヒートマップになります。どの領域に注視が最も集まったかを尋ねると、数値と図で答えが返ります。
完全に追跡可能なレポートひとつ
最後に、すべての図がそれを生んだコードとデータにリンクしたレポートが得られます——今日のデザインレビューにそのまま使え、一四半期後に誰かが疑問を呈しても再現できます。