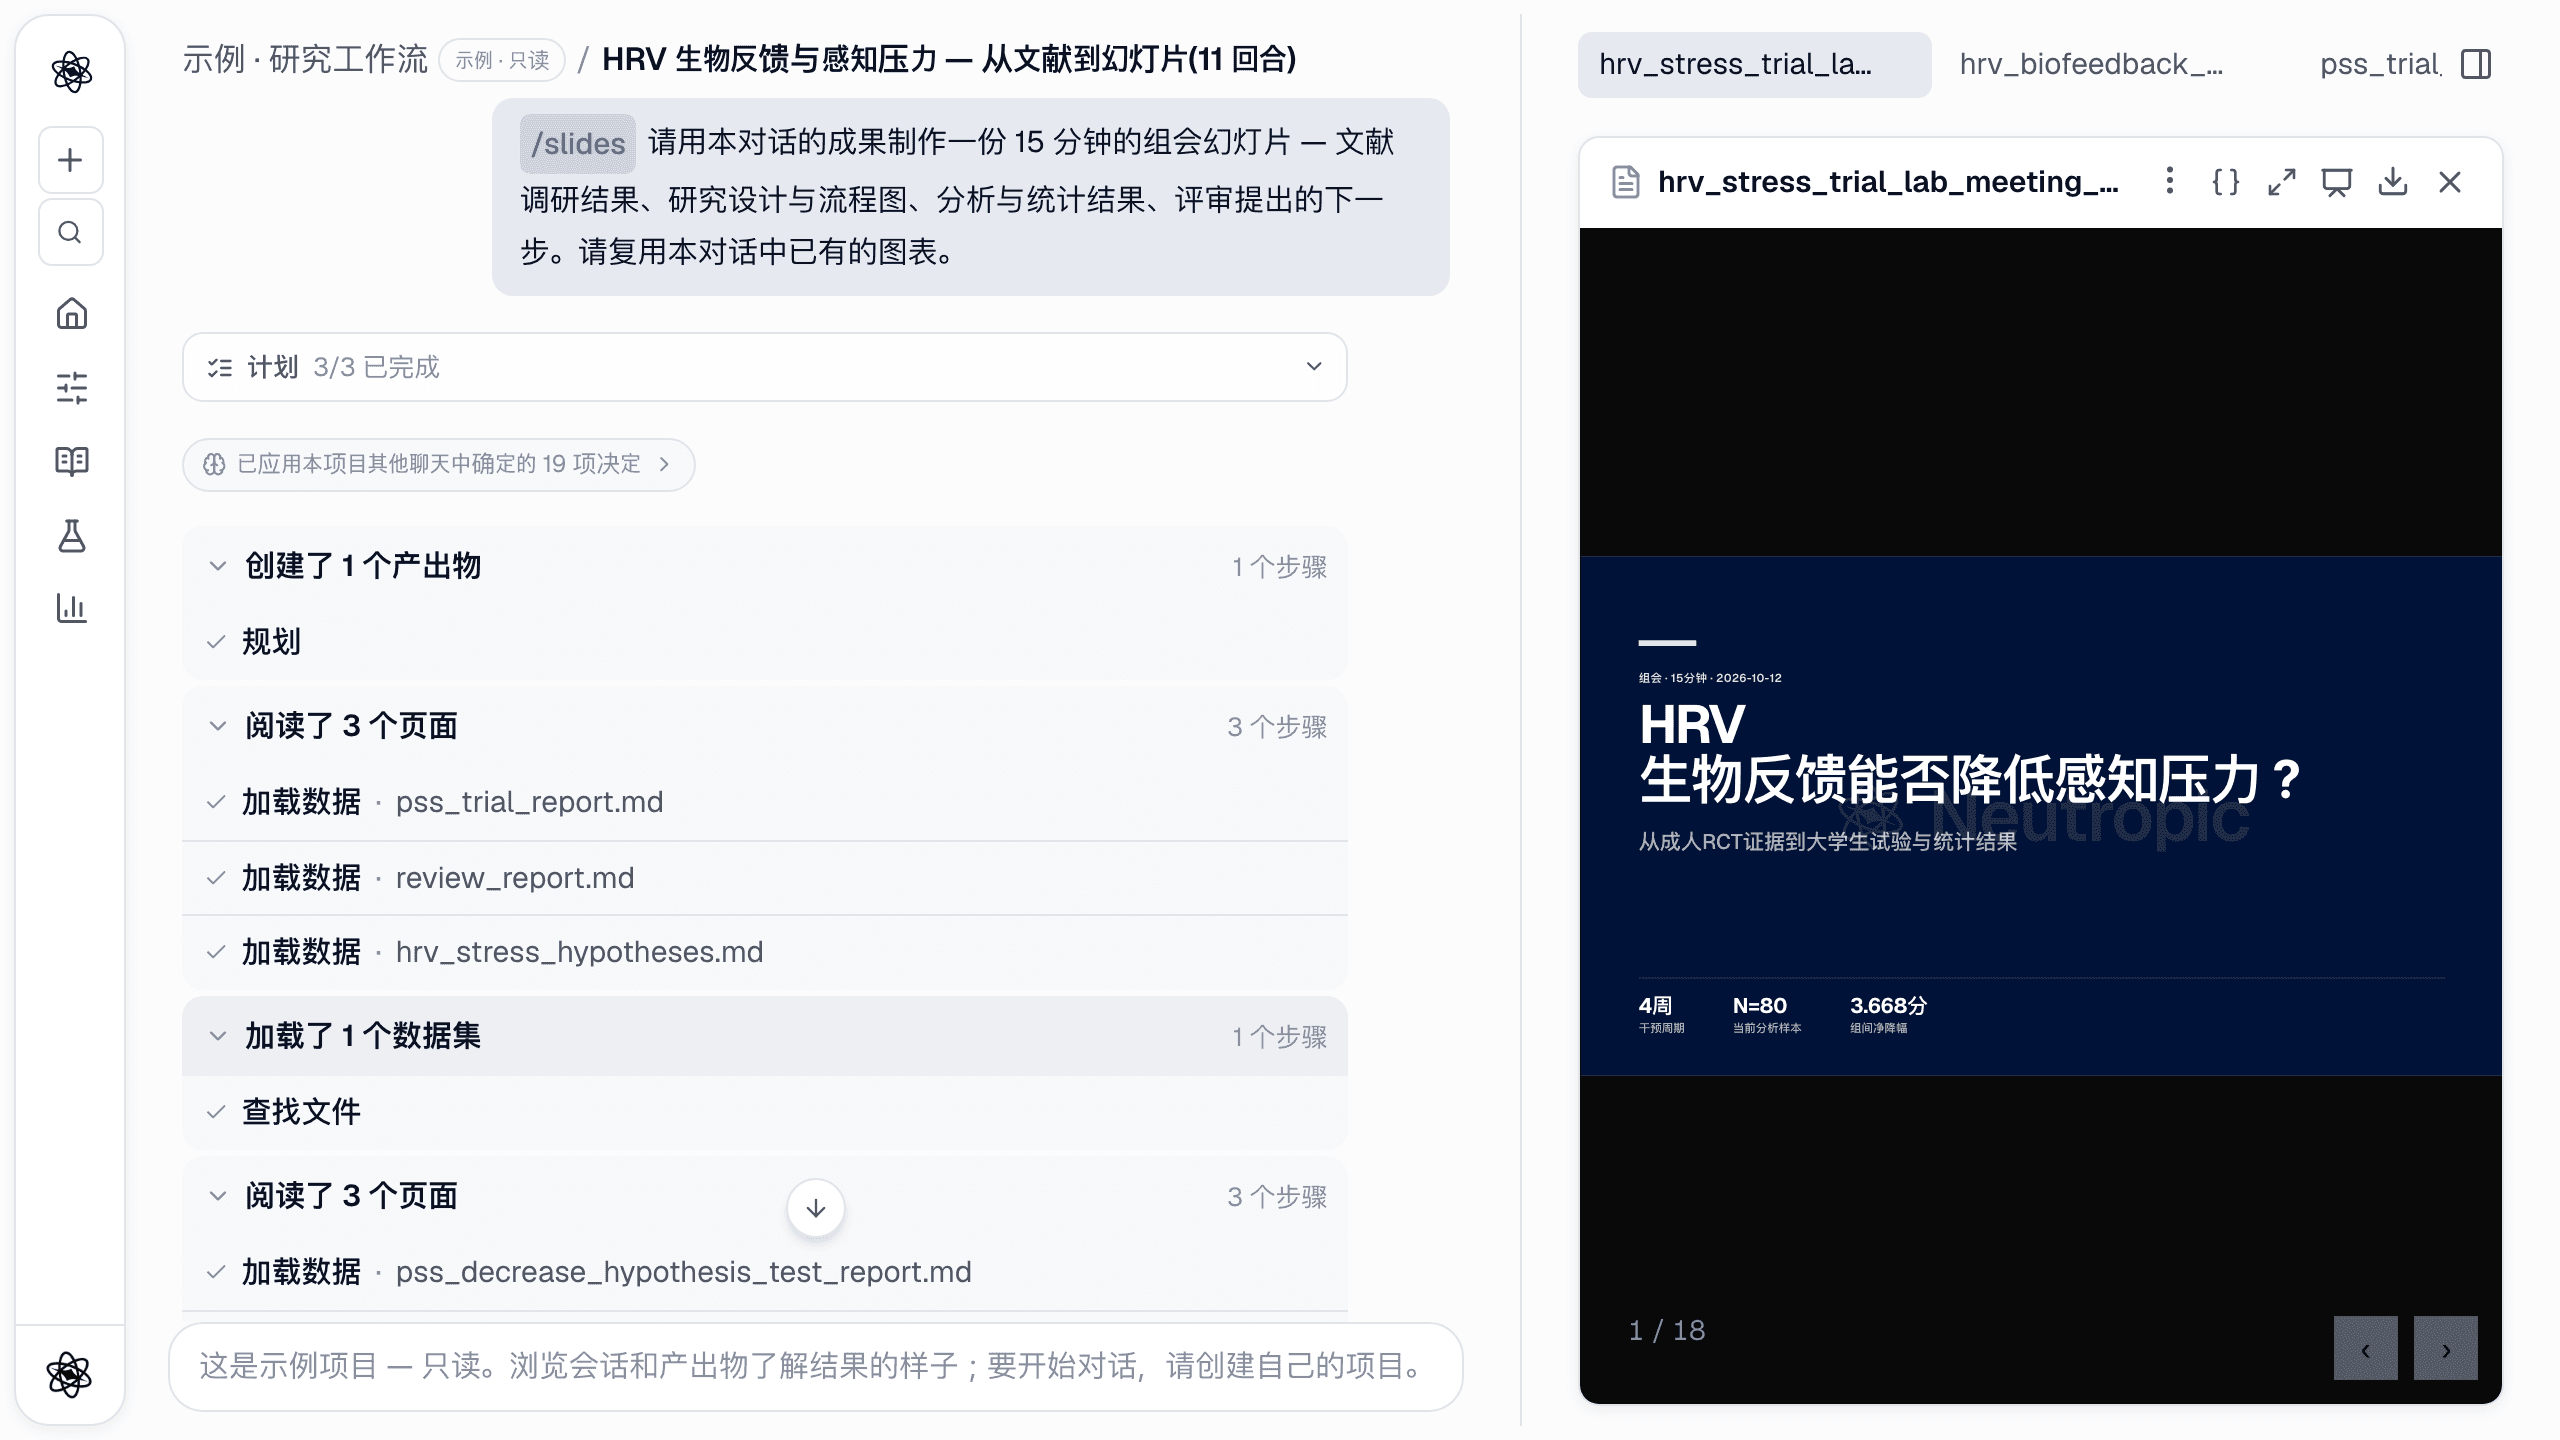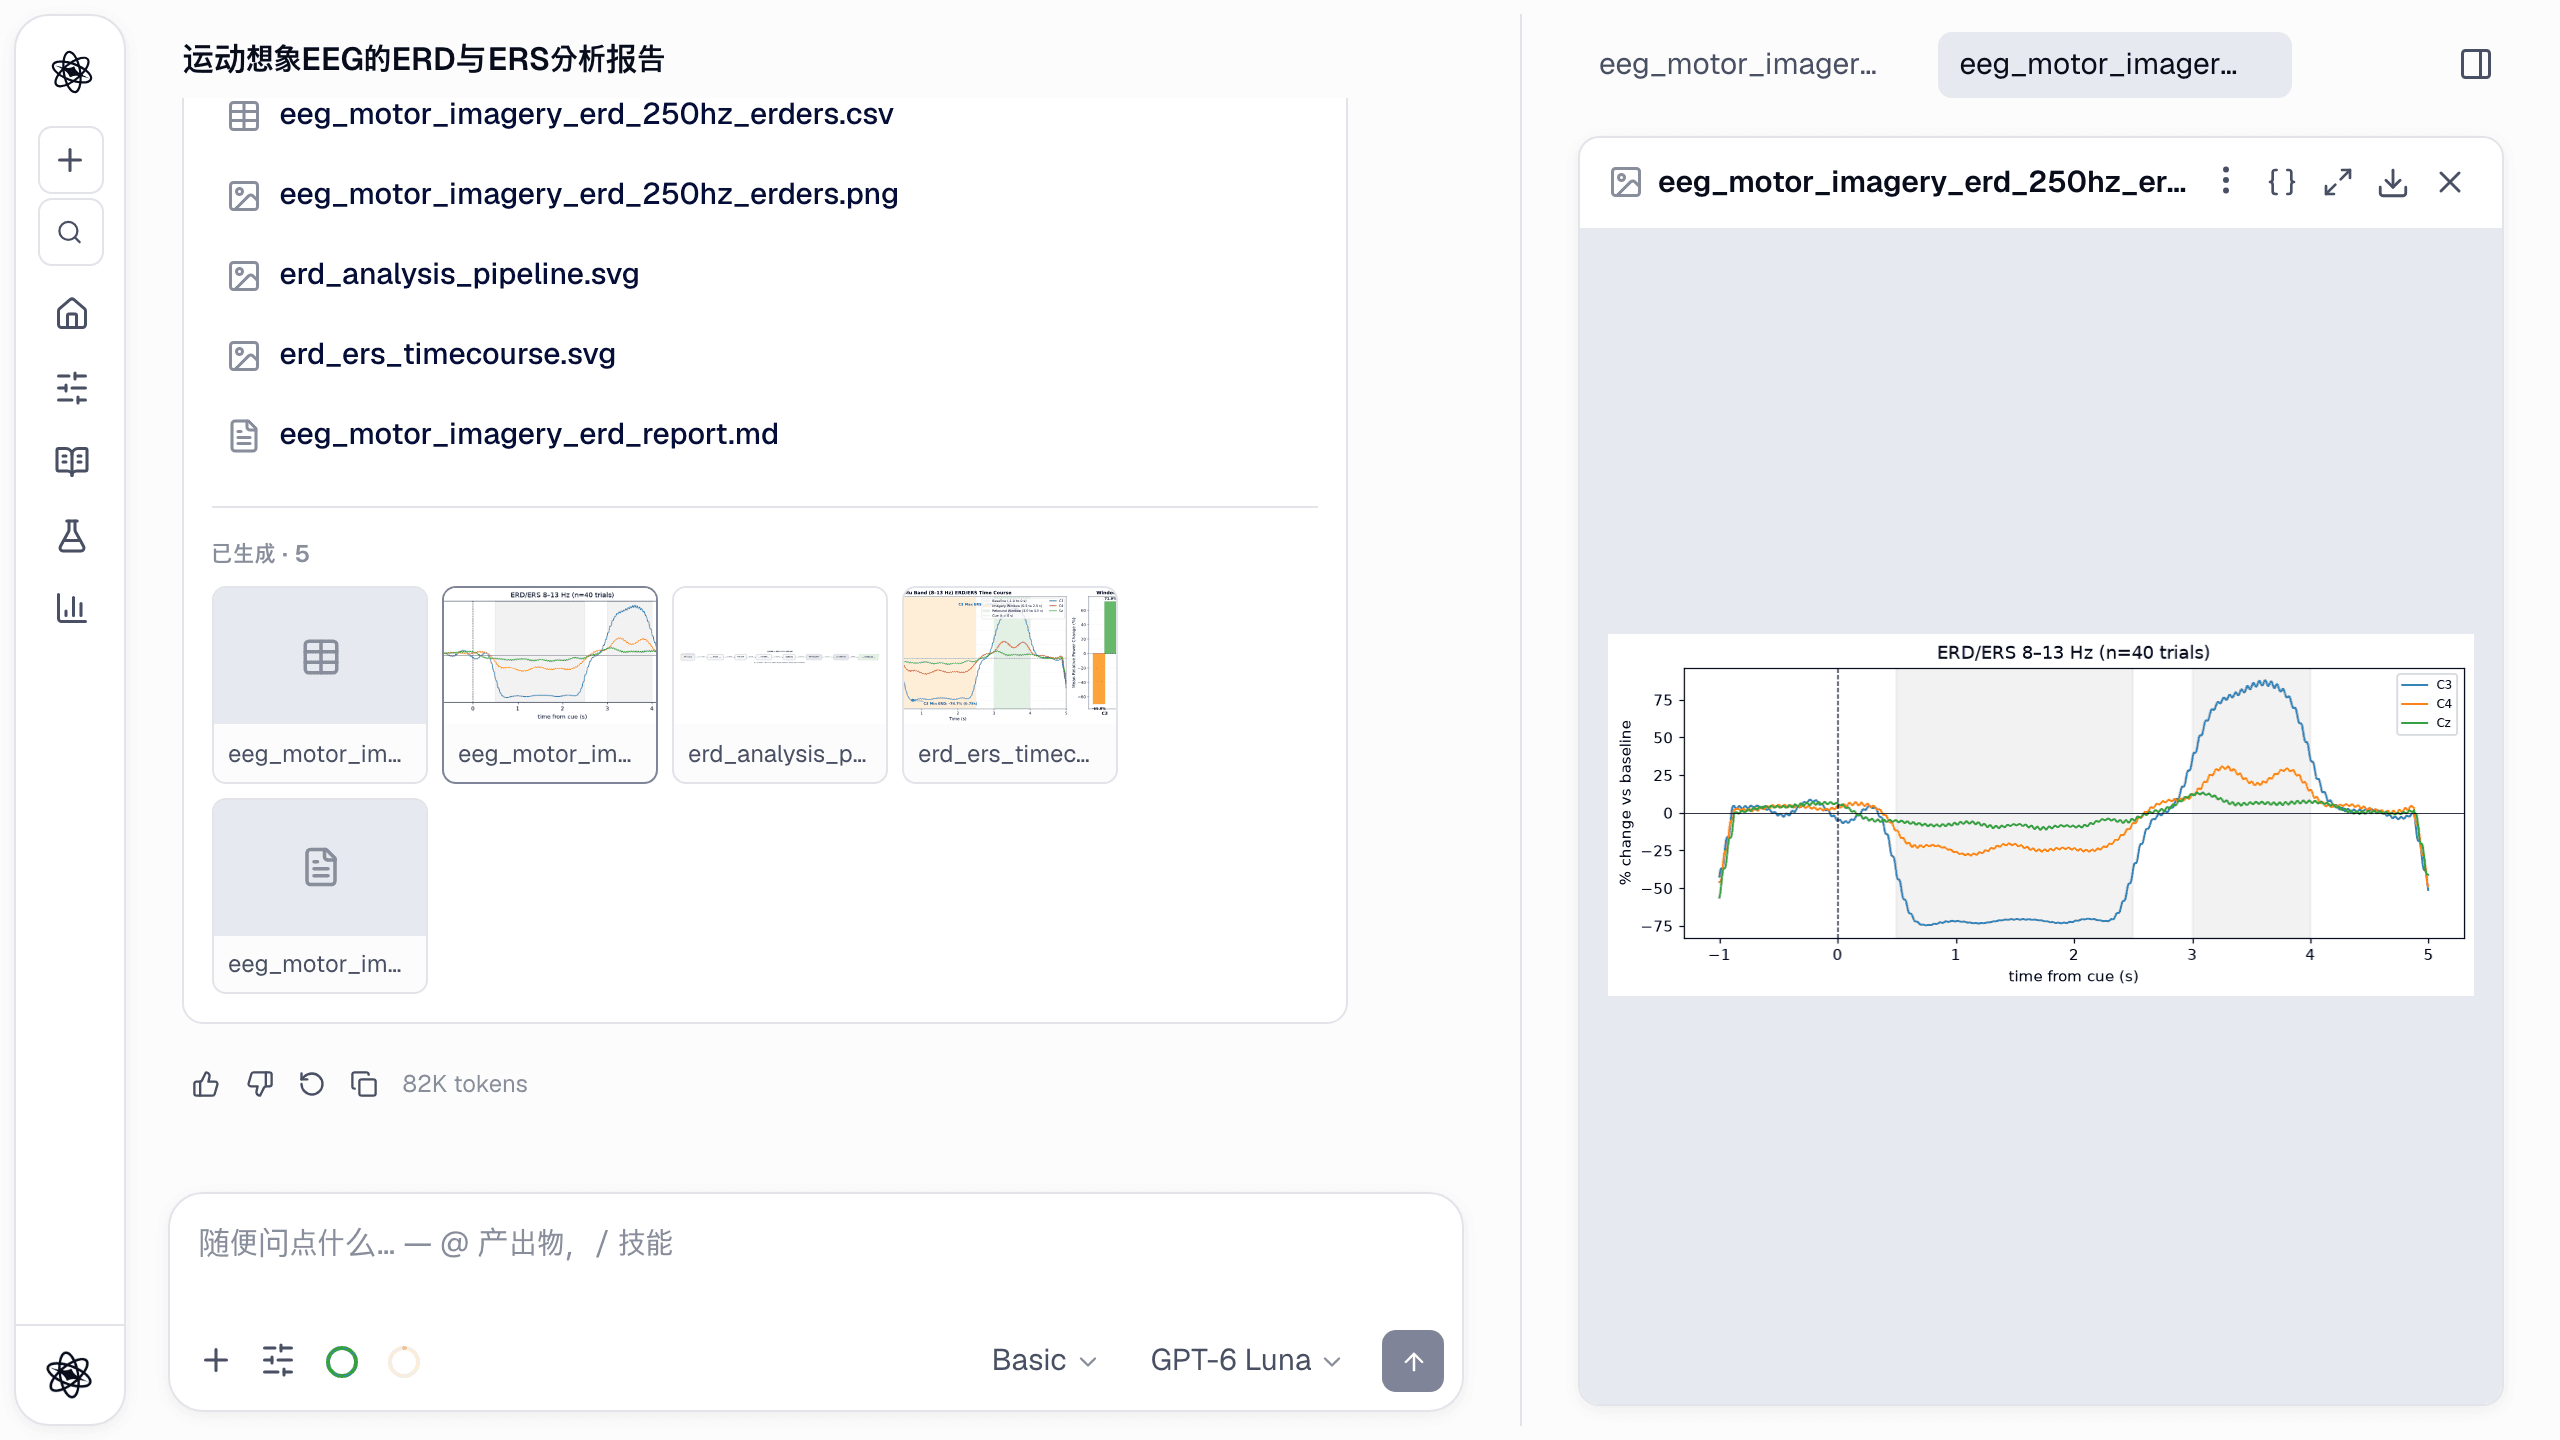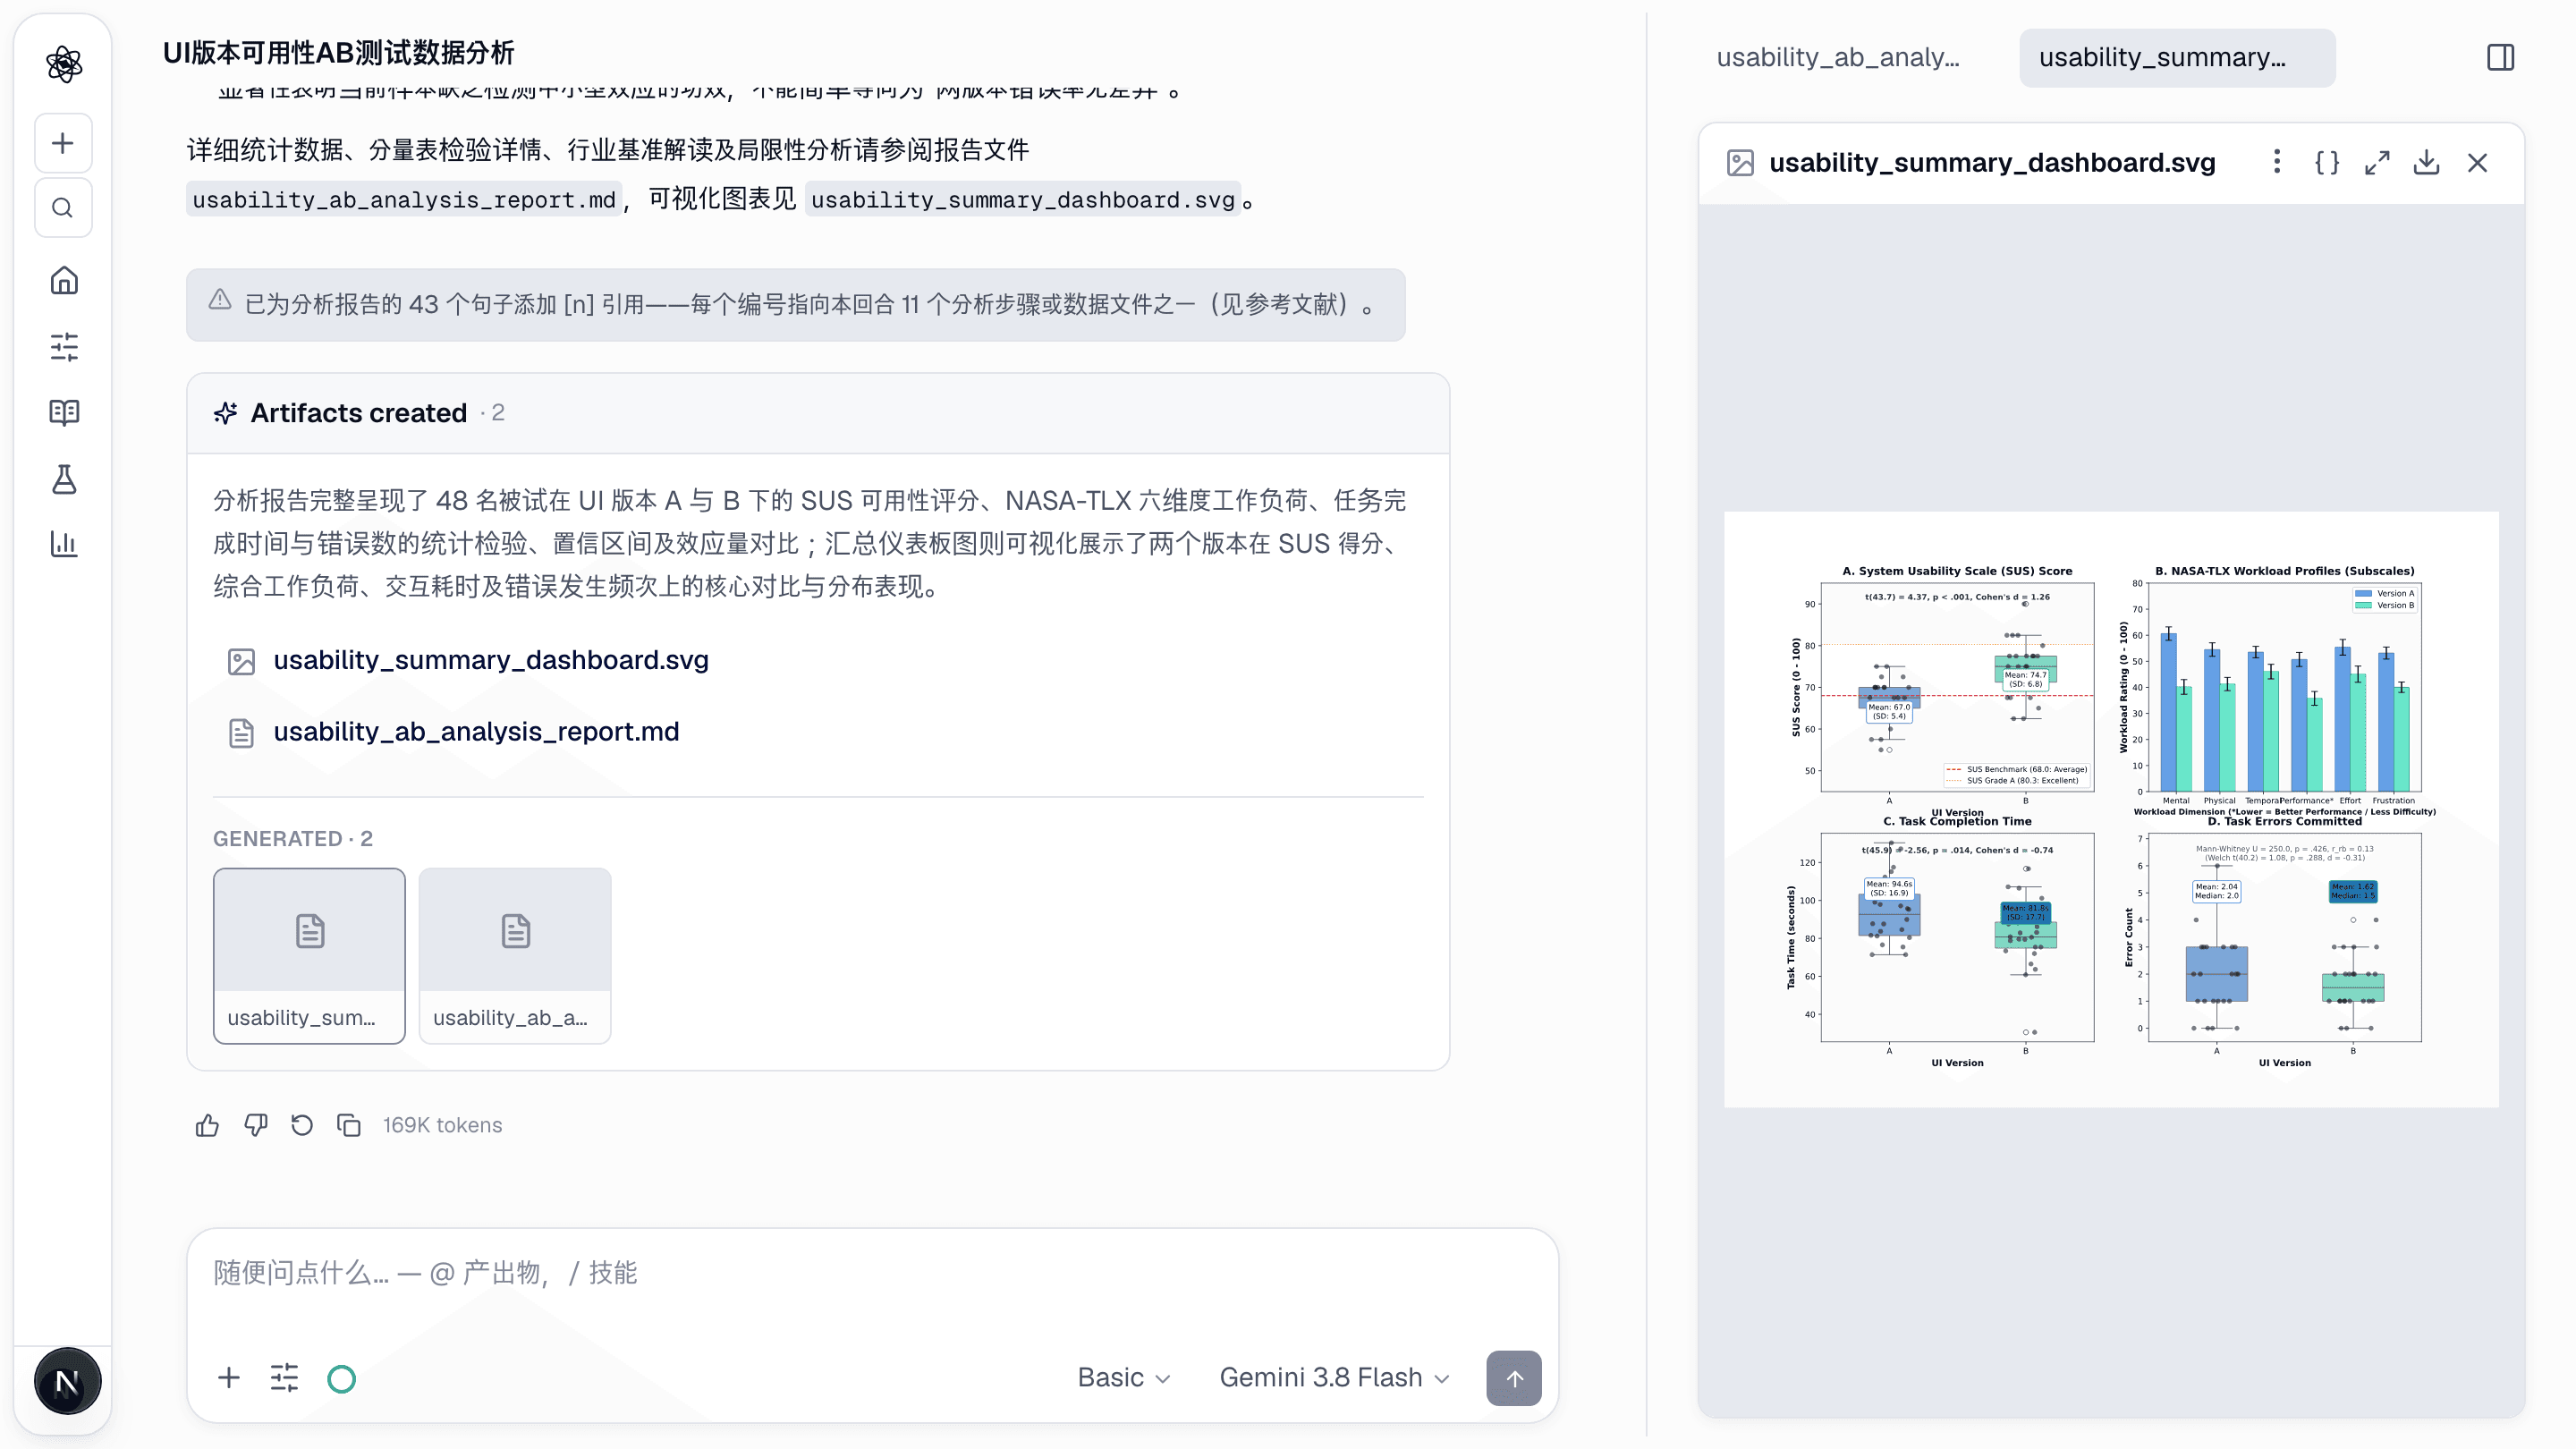
可用性研究会产生一堆杂乱的产物:问卷导出、屏幕录像、交互日志、眼动文件。大多数团队花在把这堆东西拼成可分析形式上的时间,比从中学习的时间还多。以下是 HCI 团队在 Neutropic 中运行整条管道的方式——所有截图都来自一个关于两个 UI 版本 A/B 研究的真实会话(示例数据,48 名被试)。
第 1 步 — 放入导出文件并说明它是什么
附上 Qualtrics 或 CSV 导出,用一条消息描述设计。Neutropic 识别 SUS、NASA-TLX 和 UEQ 的题项结构,应用正确的计分(包括反向题),并在分数之外报告带信度的量表统计——可疑的 alpha 再也藏不进电子表格。
text
/analyze usability_ab_study.csv is a between-subjects usability study of two UI versions (A vs B, 48 participants): SUS items sus1-sus10 (1-5), NASA-TLX subscales (0-100), task_time_s, and errors. Score SUS and NASA-TLX, compare the versions on SUS, workload, task time, and errors with effect sizes, and produce a summary dashboard figure.
第 2 步 — 阅读先陈述问题的报告
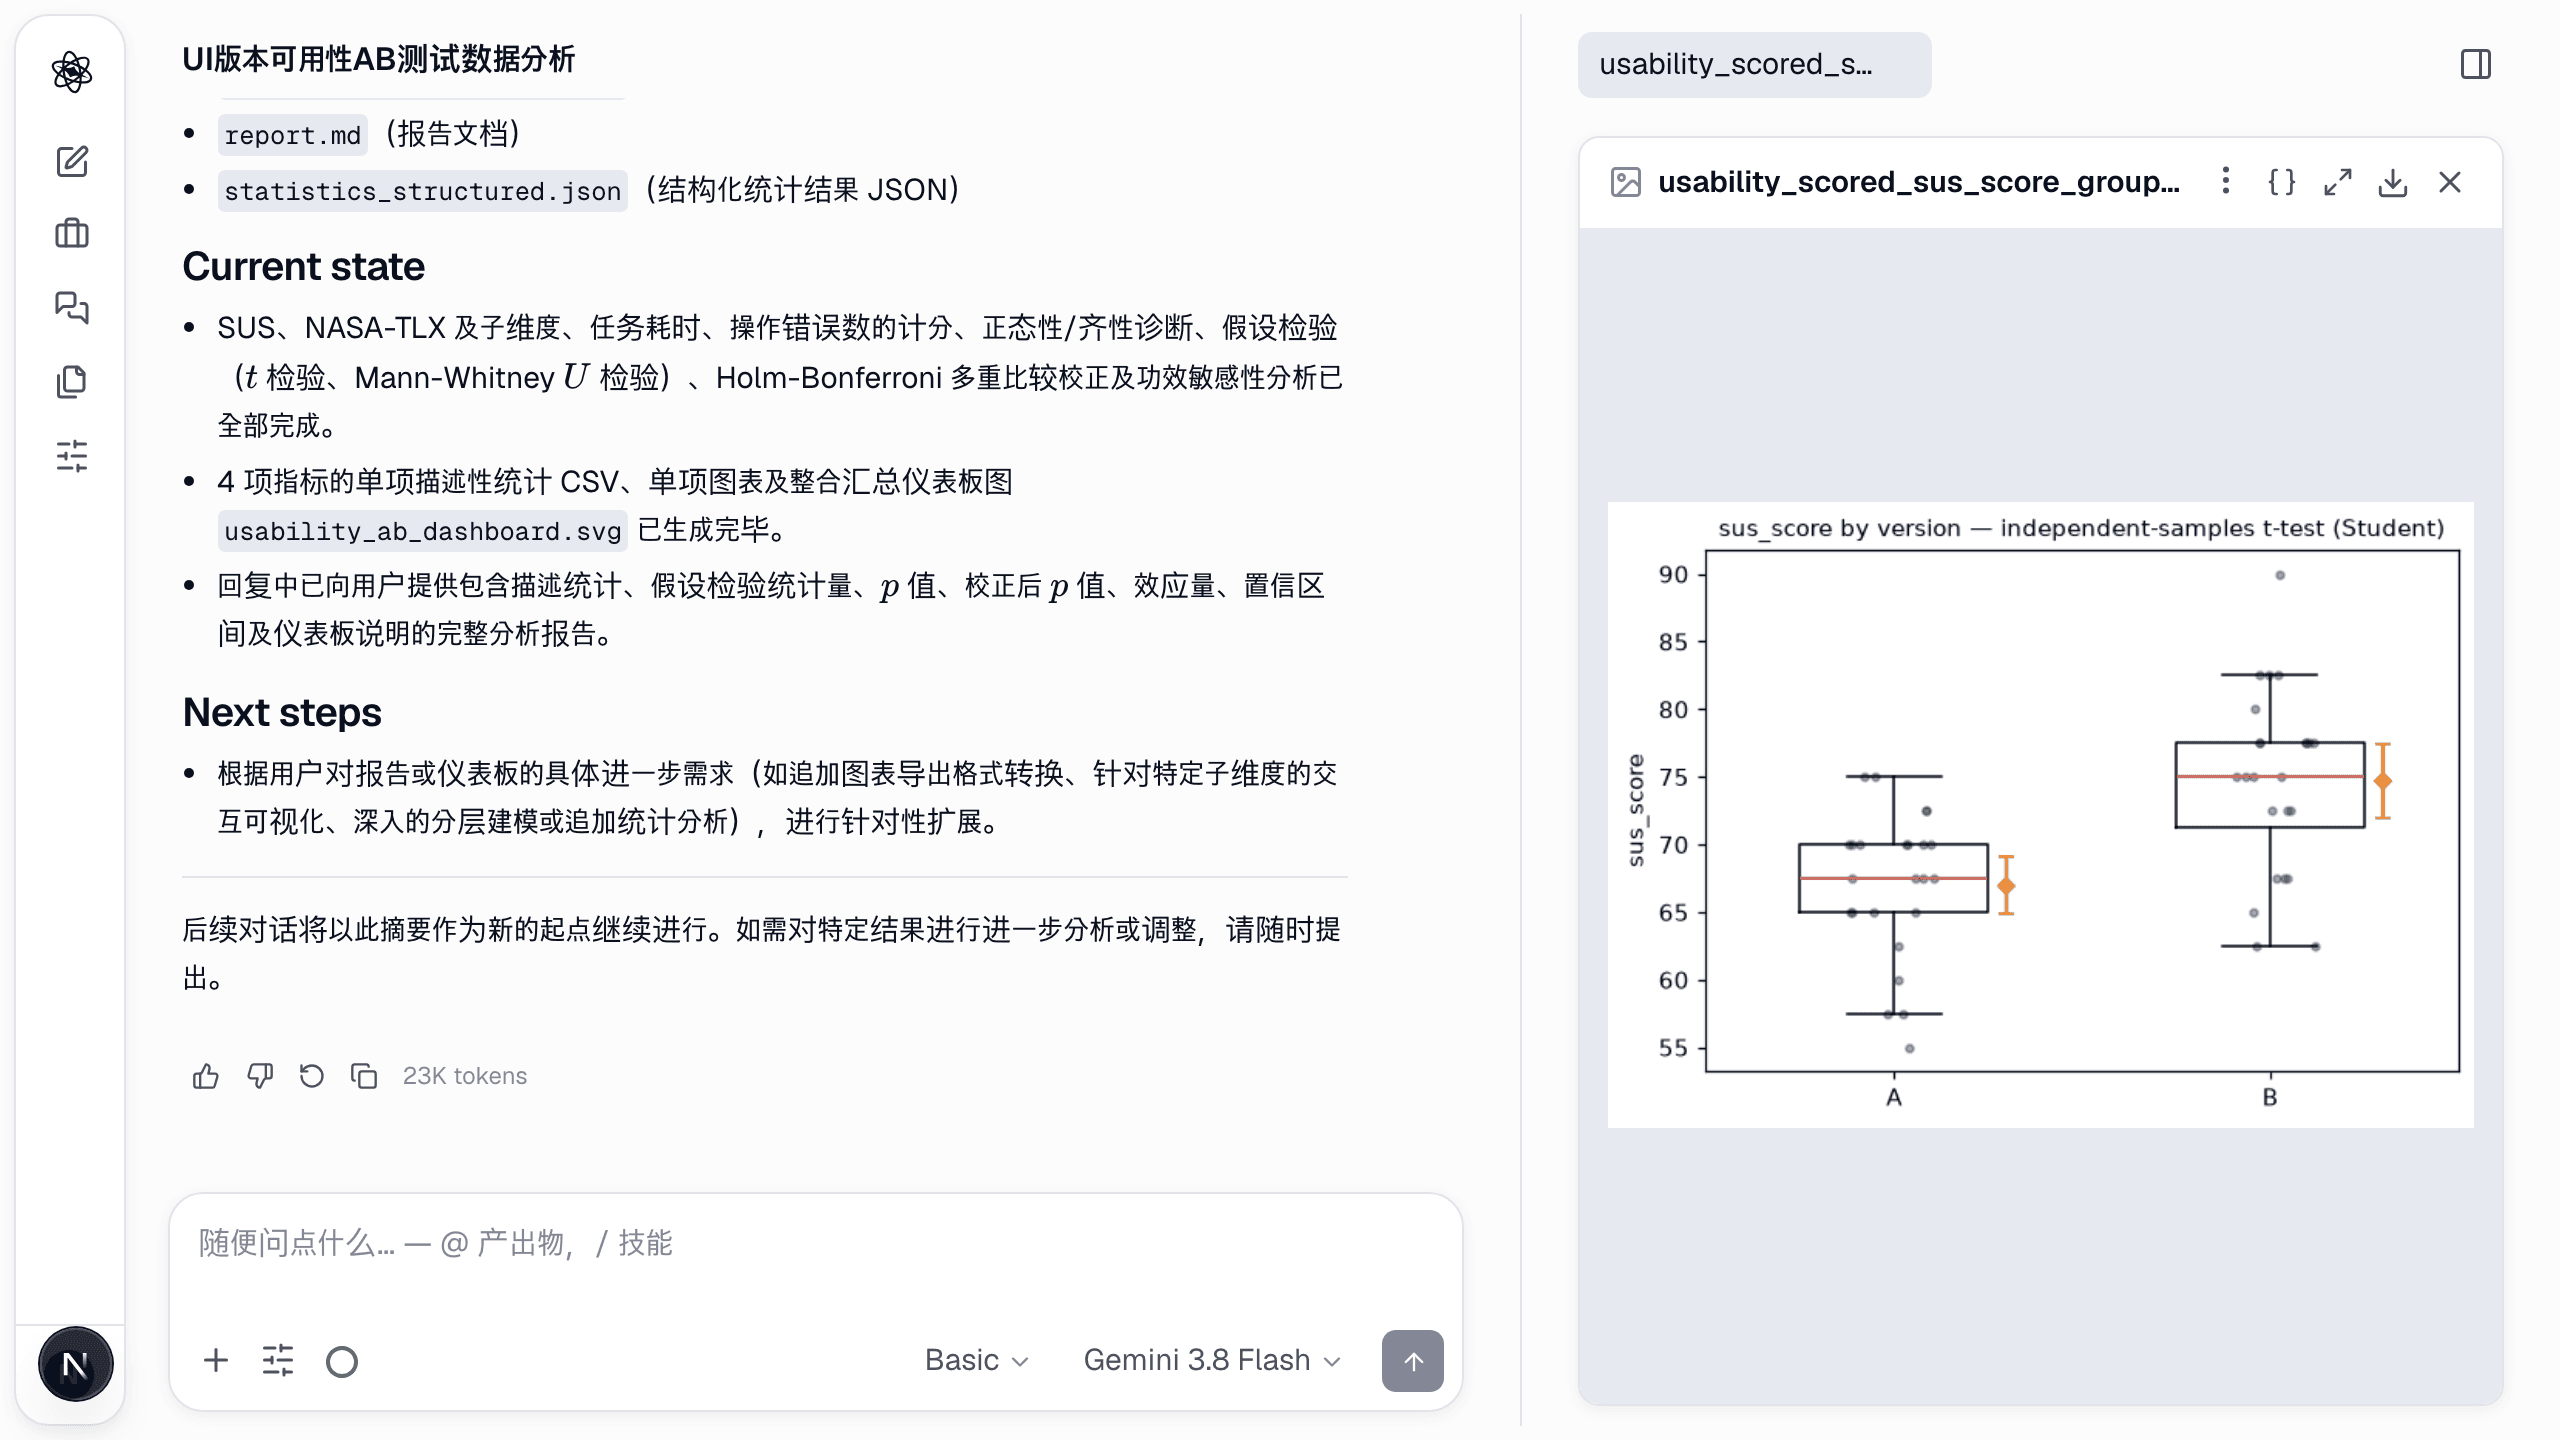
分析报告在任何比较之前,先给出研究问题、数据集及其质量审计(48 行、无缺失、所有 SUS 题项在范围内)——一条消息产出十二个产物:计分表、按测量的分组图、描述统计和一个仪表板。
第 3 步 — 使用正确检验的 A/B 测试
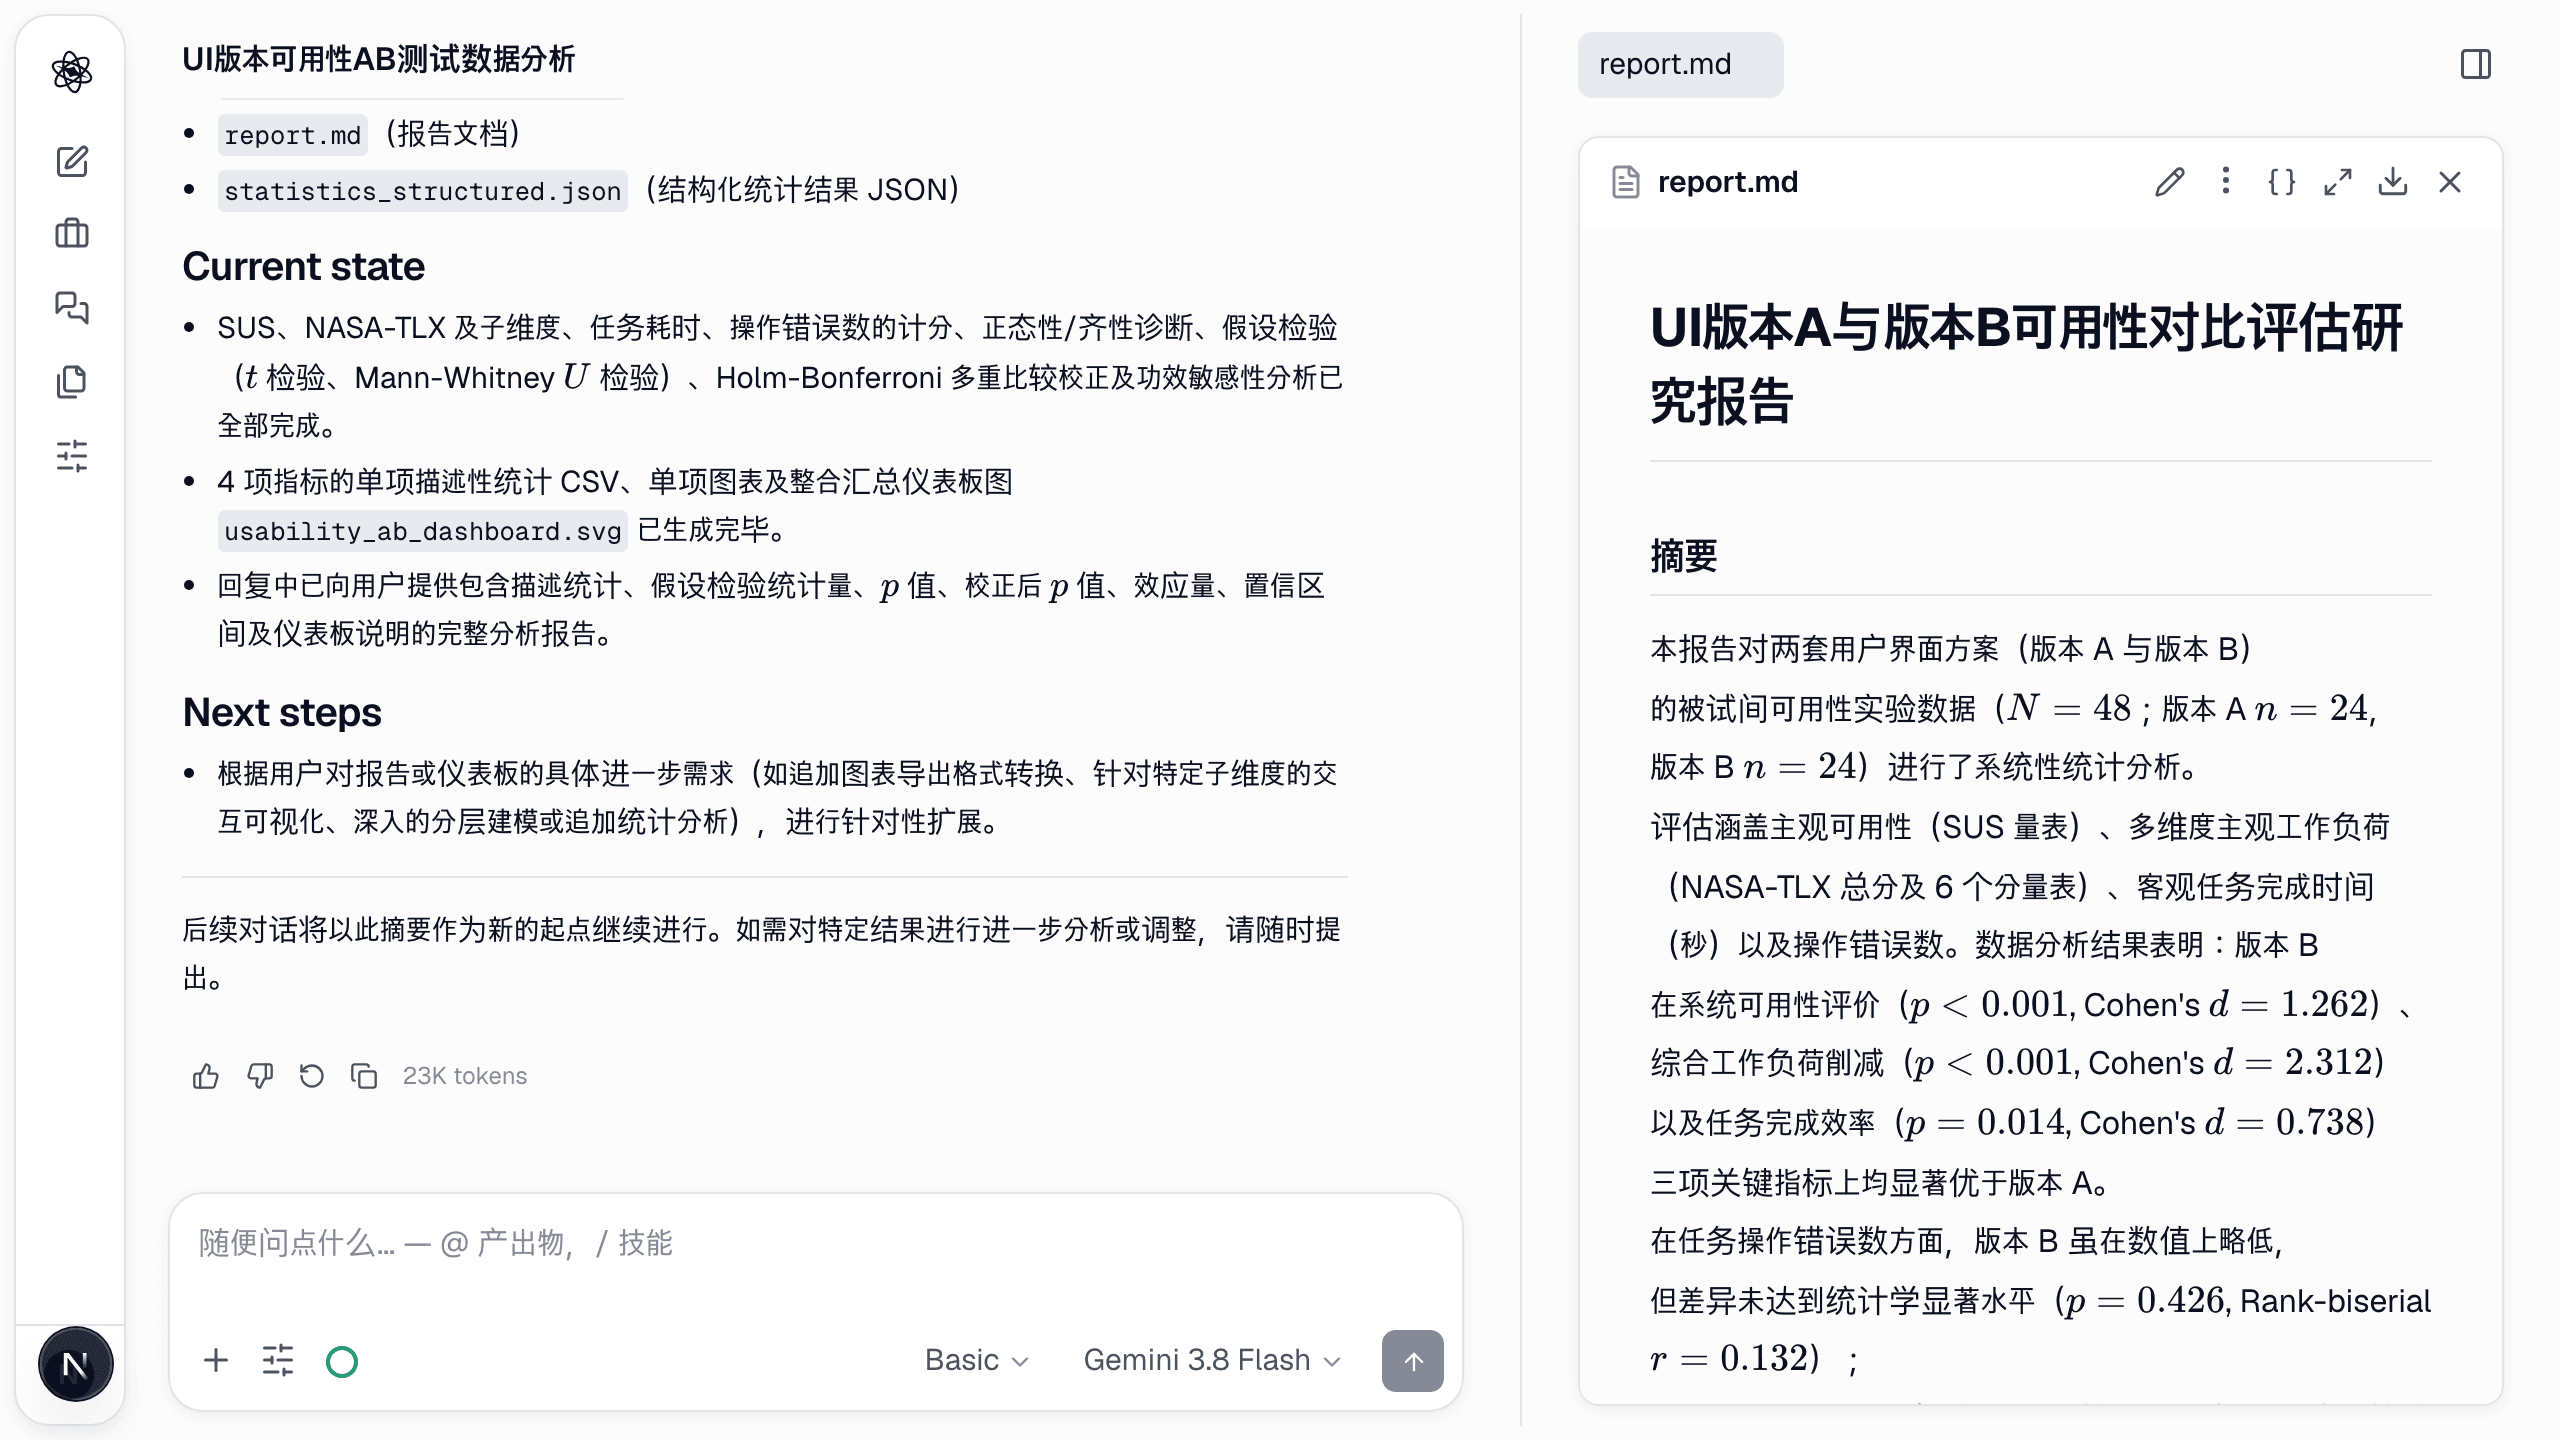
描述设计——被试间或被试内、结果测量、样本——代理选择并论证分析;在 Deep 级别,审查代理会核验这一选择。结果以带置信区间的效应估计和通俗解读返回,而不只是一个 p 值。
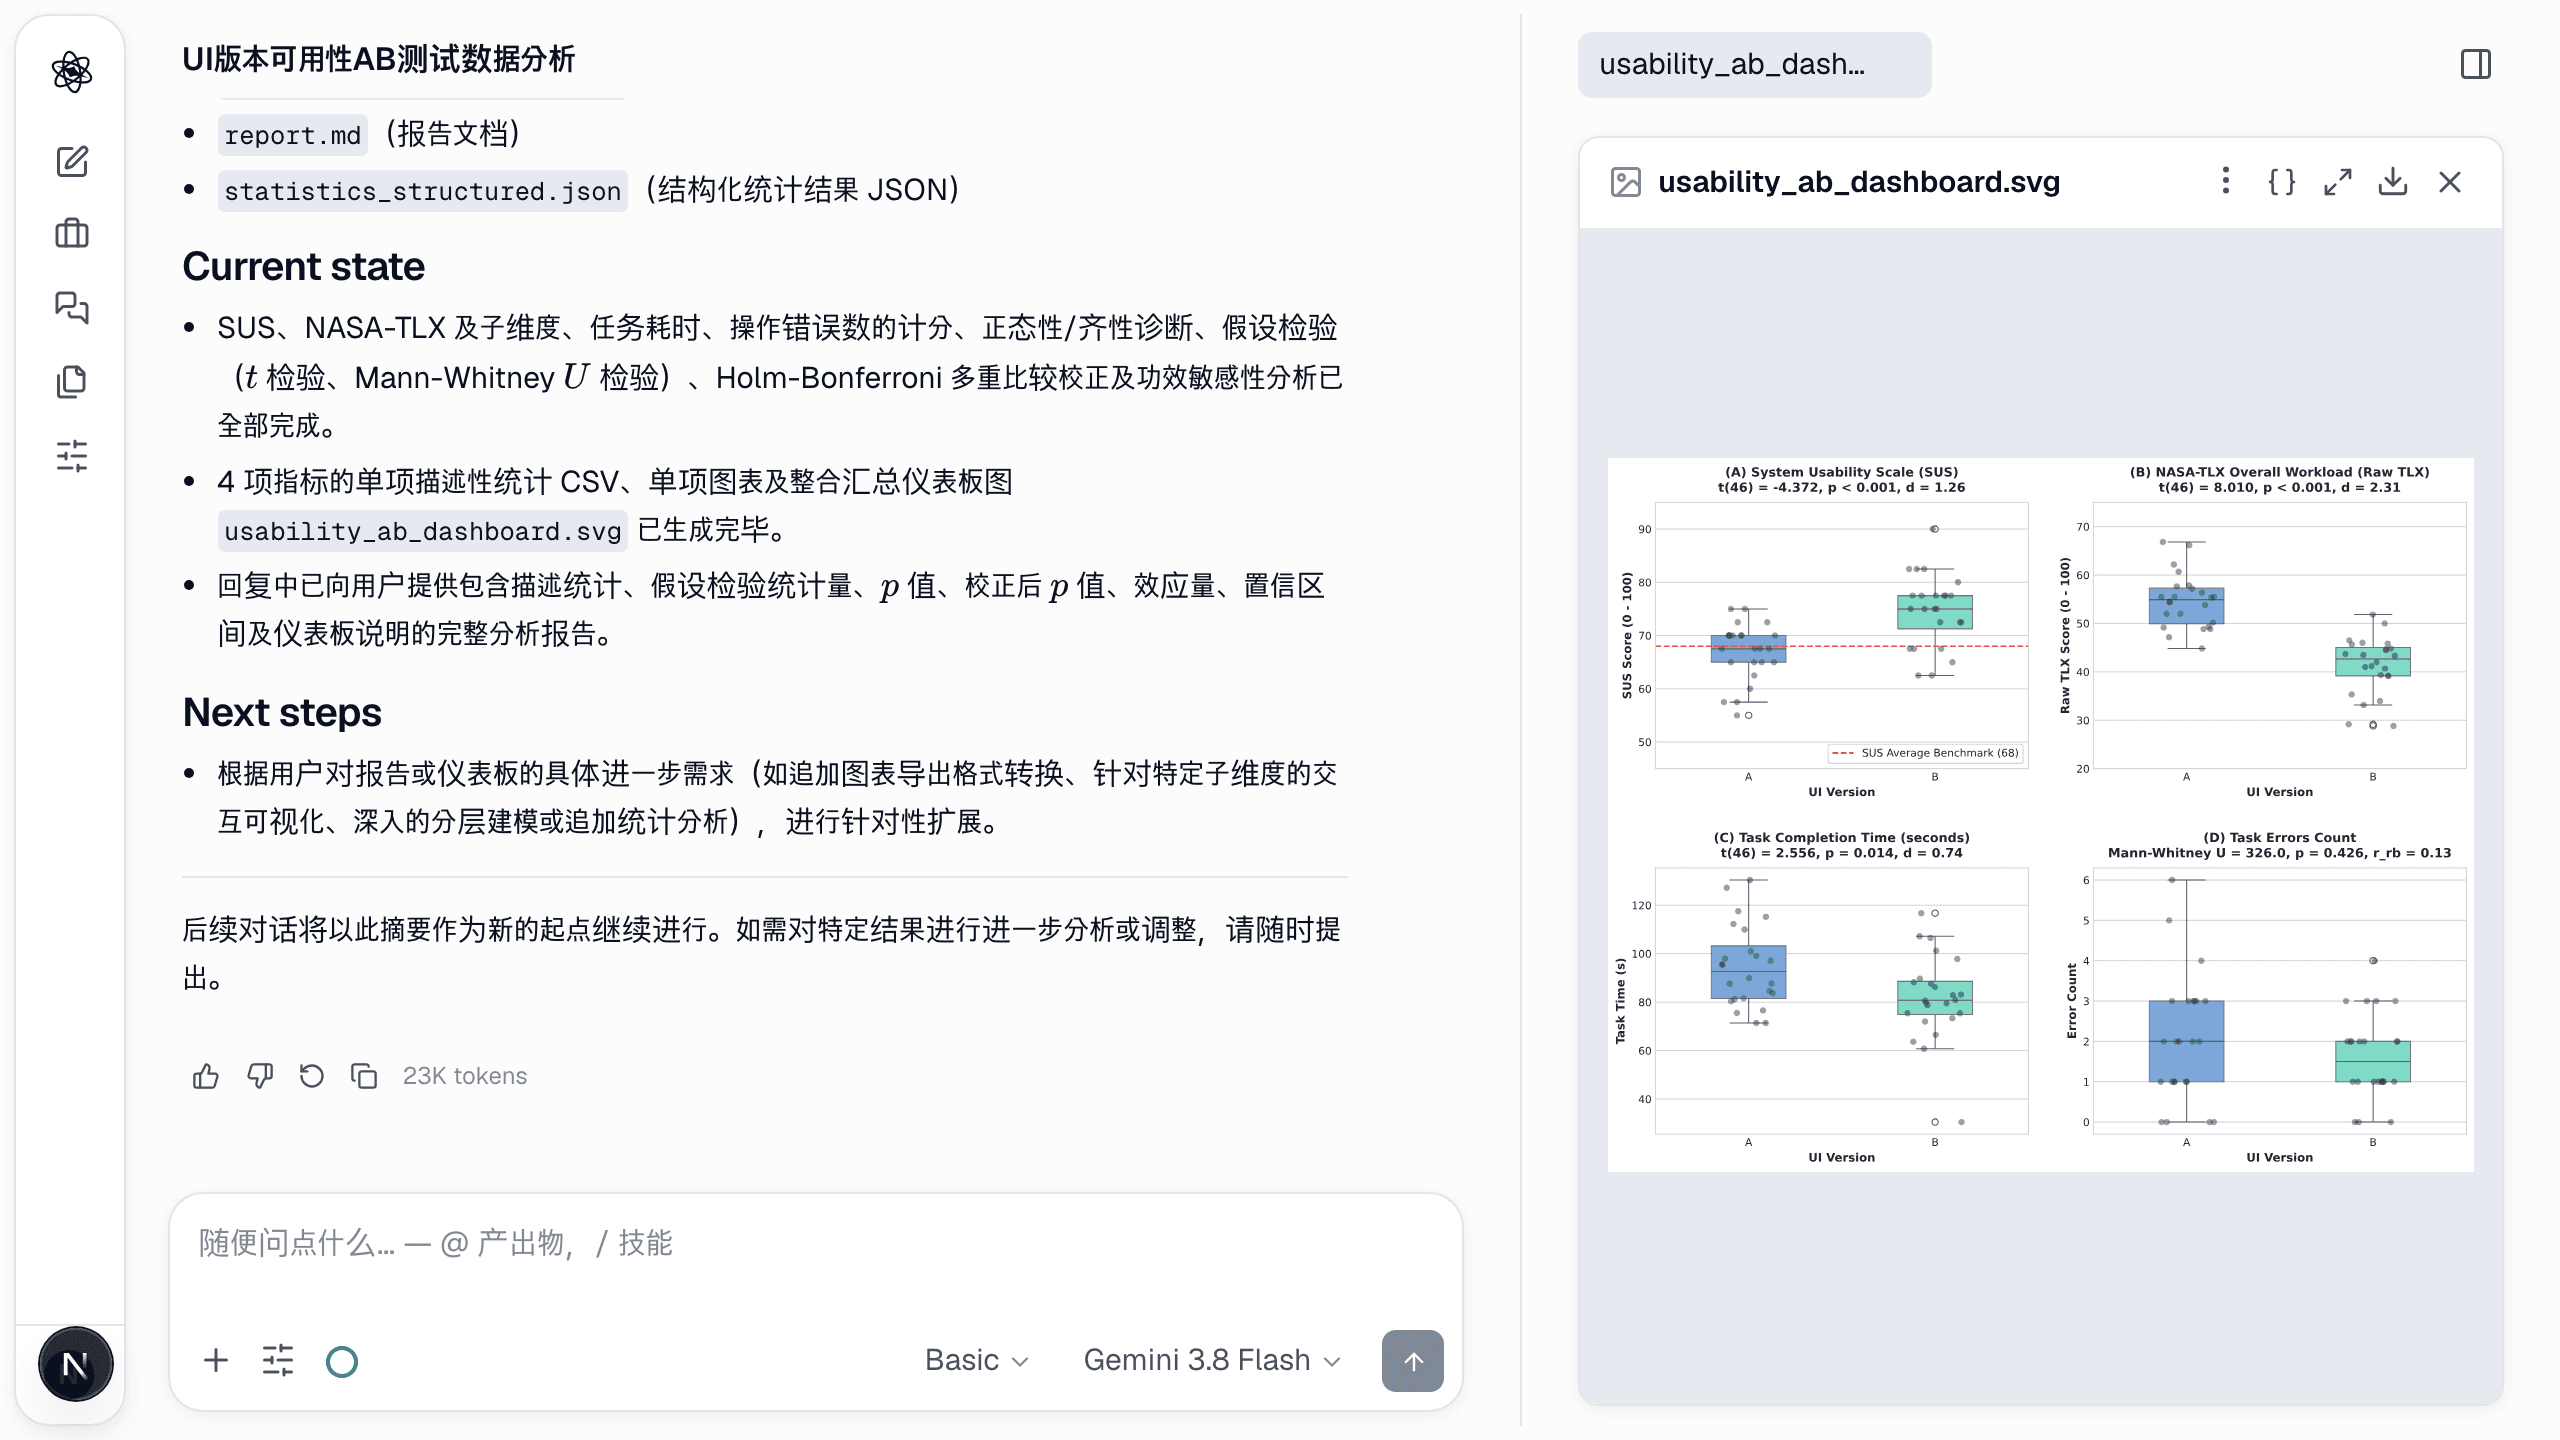
第 4 步 — 一个给设计评审用的仪表板
要求一个仪表板,四个结果被合成为一张图,每个面板带有检验统计量和效应量:SUS t(46) = −4.37,d = 1.26;NASA-TLX d = 2.31;任务时间 d = 0.74;错误 Mann–Whitney,r = 0.13。
交互日志与注视
- 事件日志导出(按条件的任务时间、错误、完成率)像其他数据集一样被分析——摘要和使用正确检验的组间比较,与生成它们的代码一起保存。
- 眼动导出变成注视次数、注视时长和热图。问哪个区域获得最多注视,就能得到数字和图。
一份完全可追溯的报告
最后你得到一份每张图都链接到生成它的代码和数据的报告——今天就能用于设计评审,一个季度后有人质疑时也能复现。