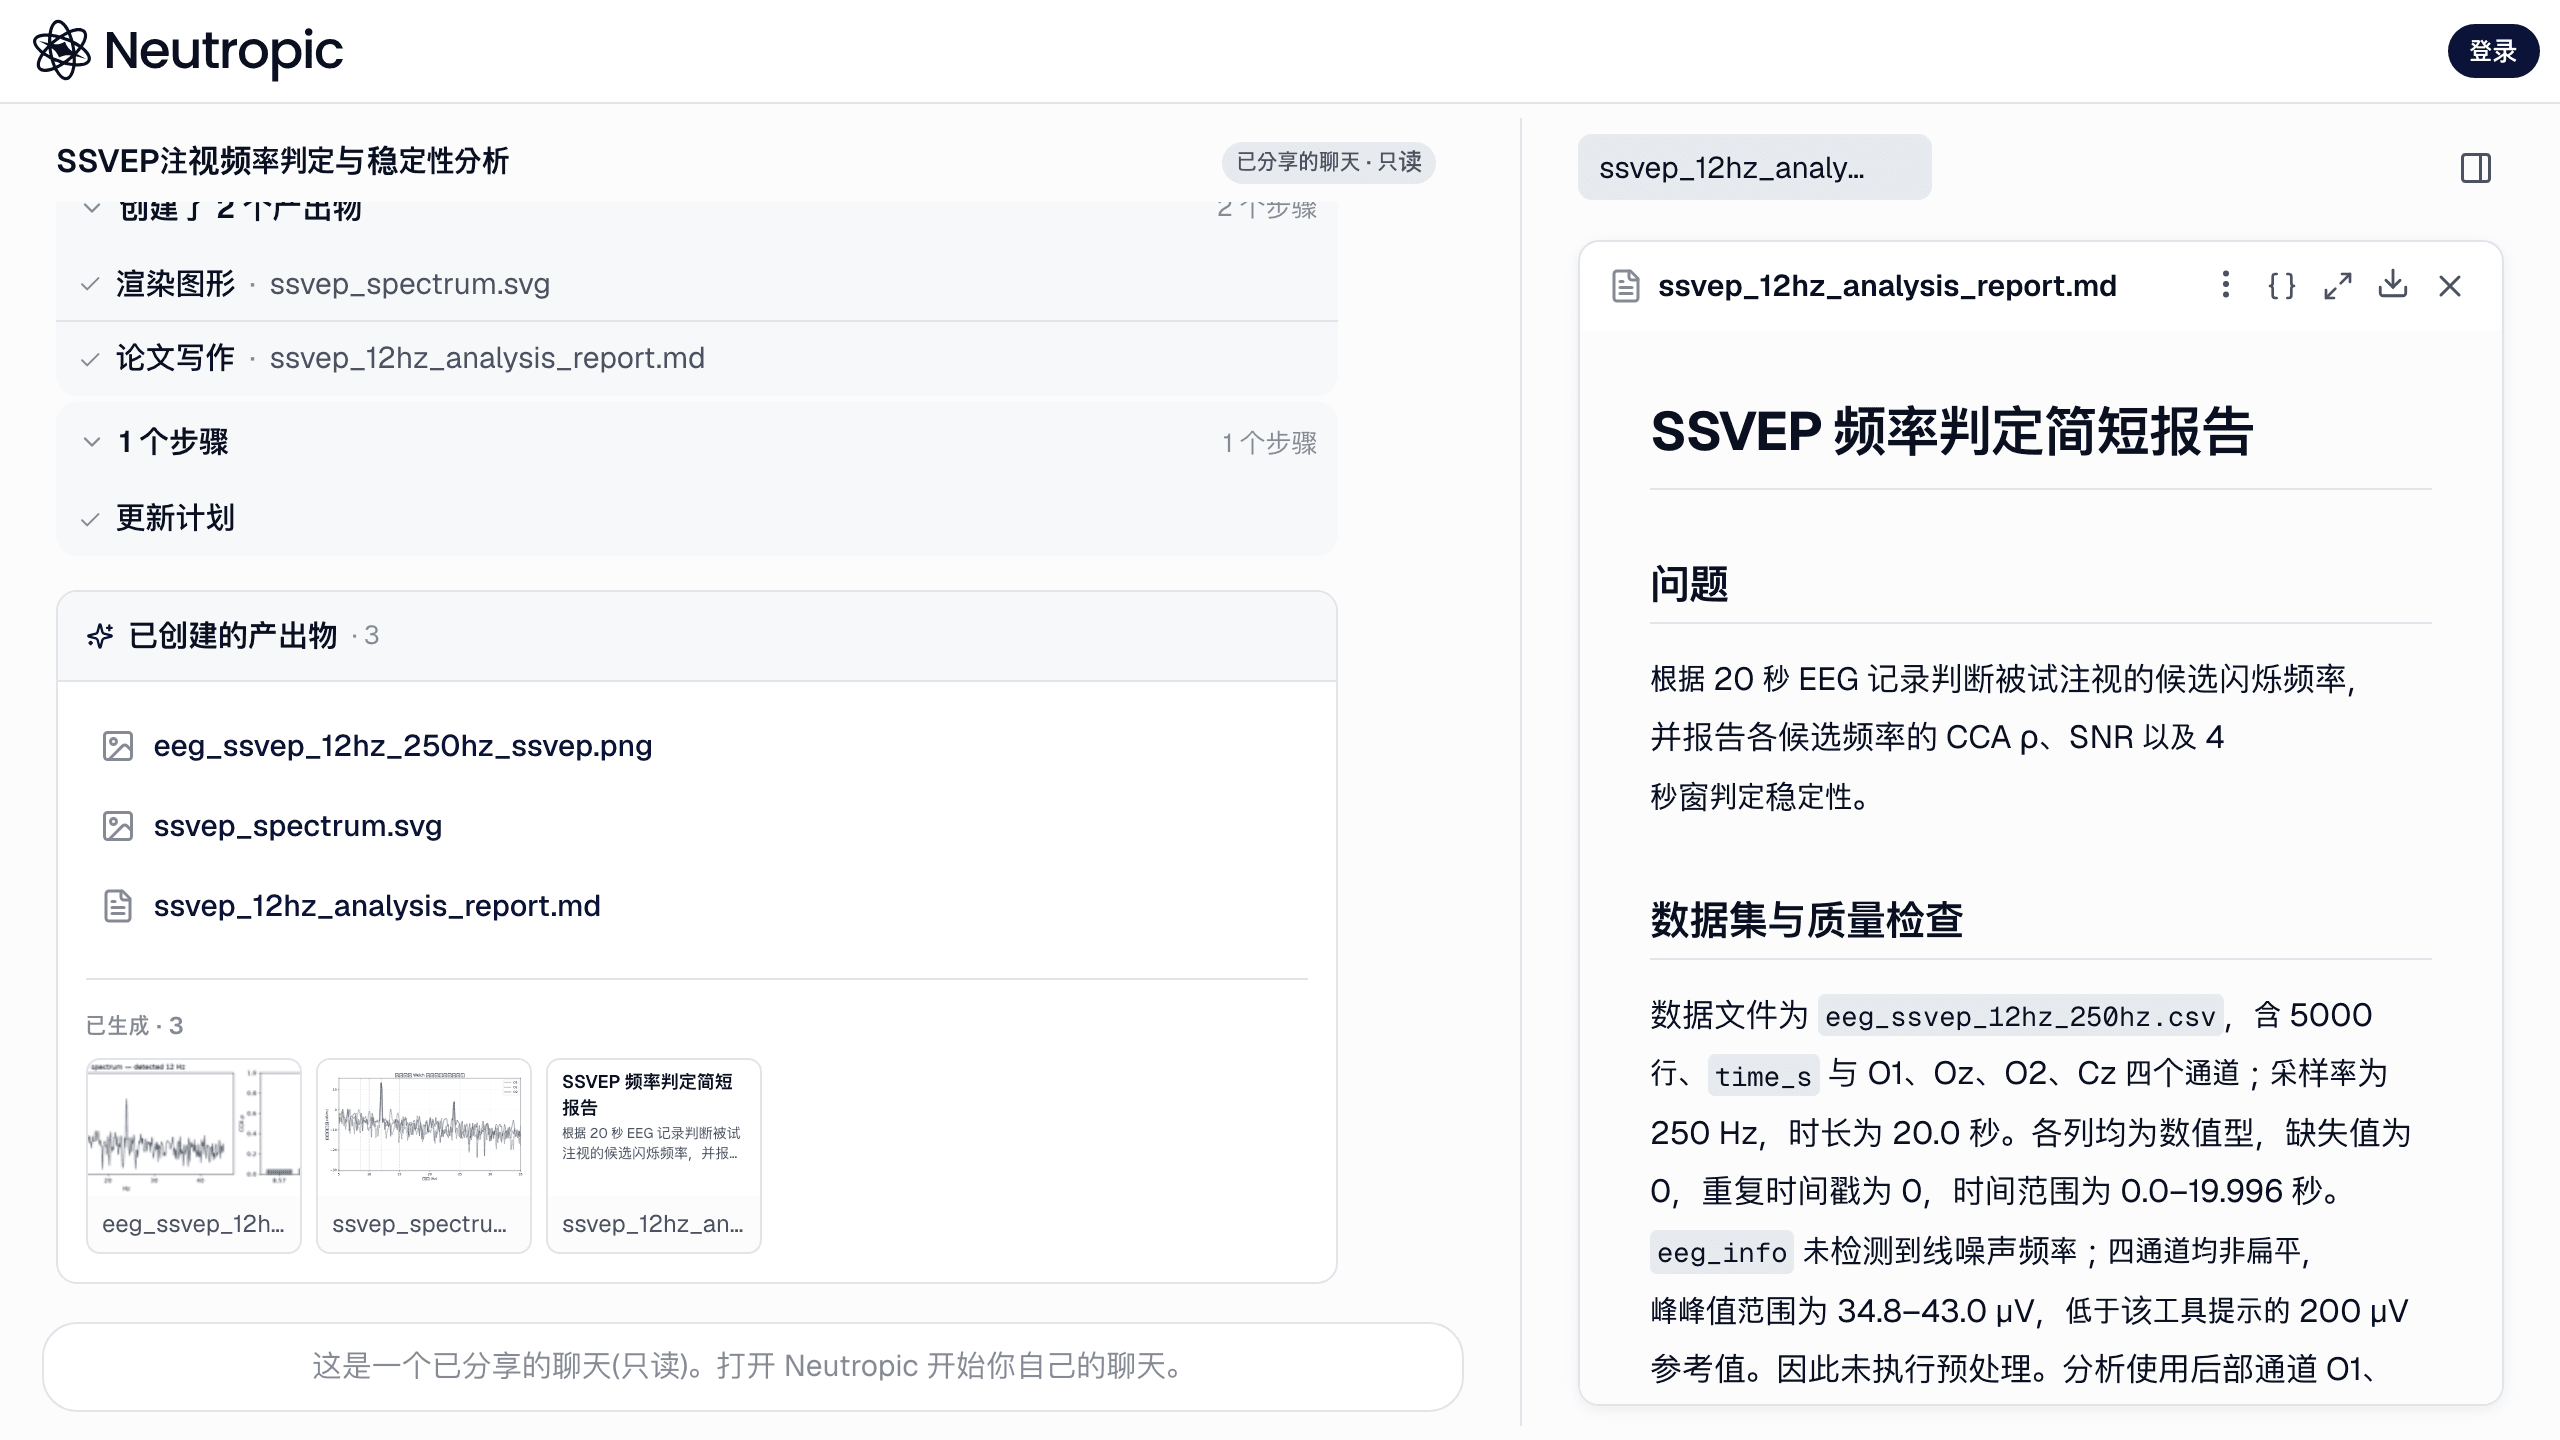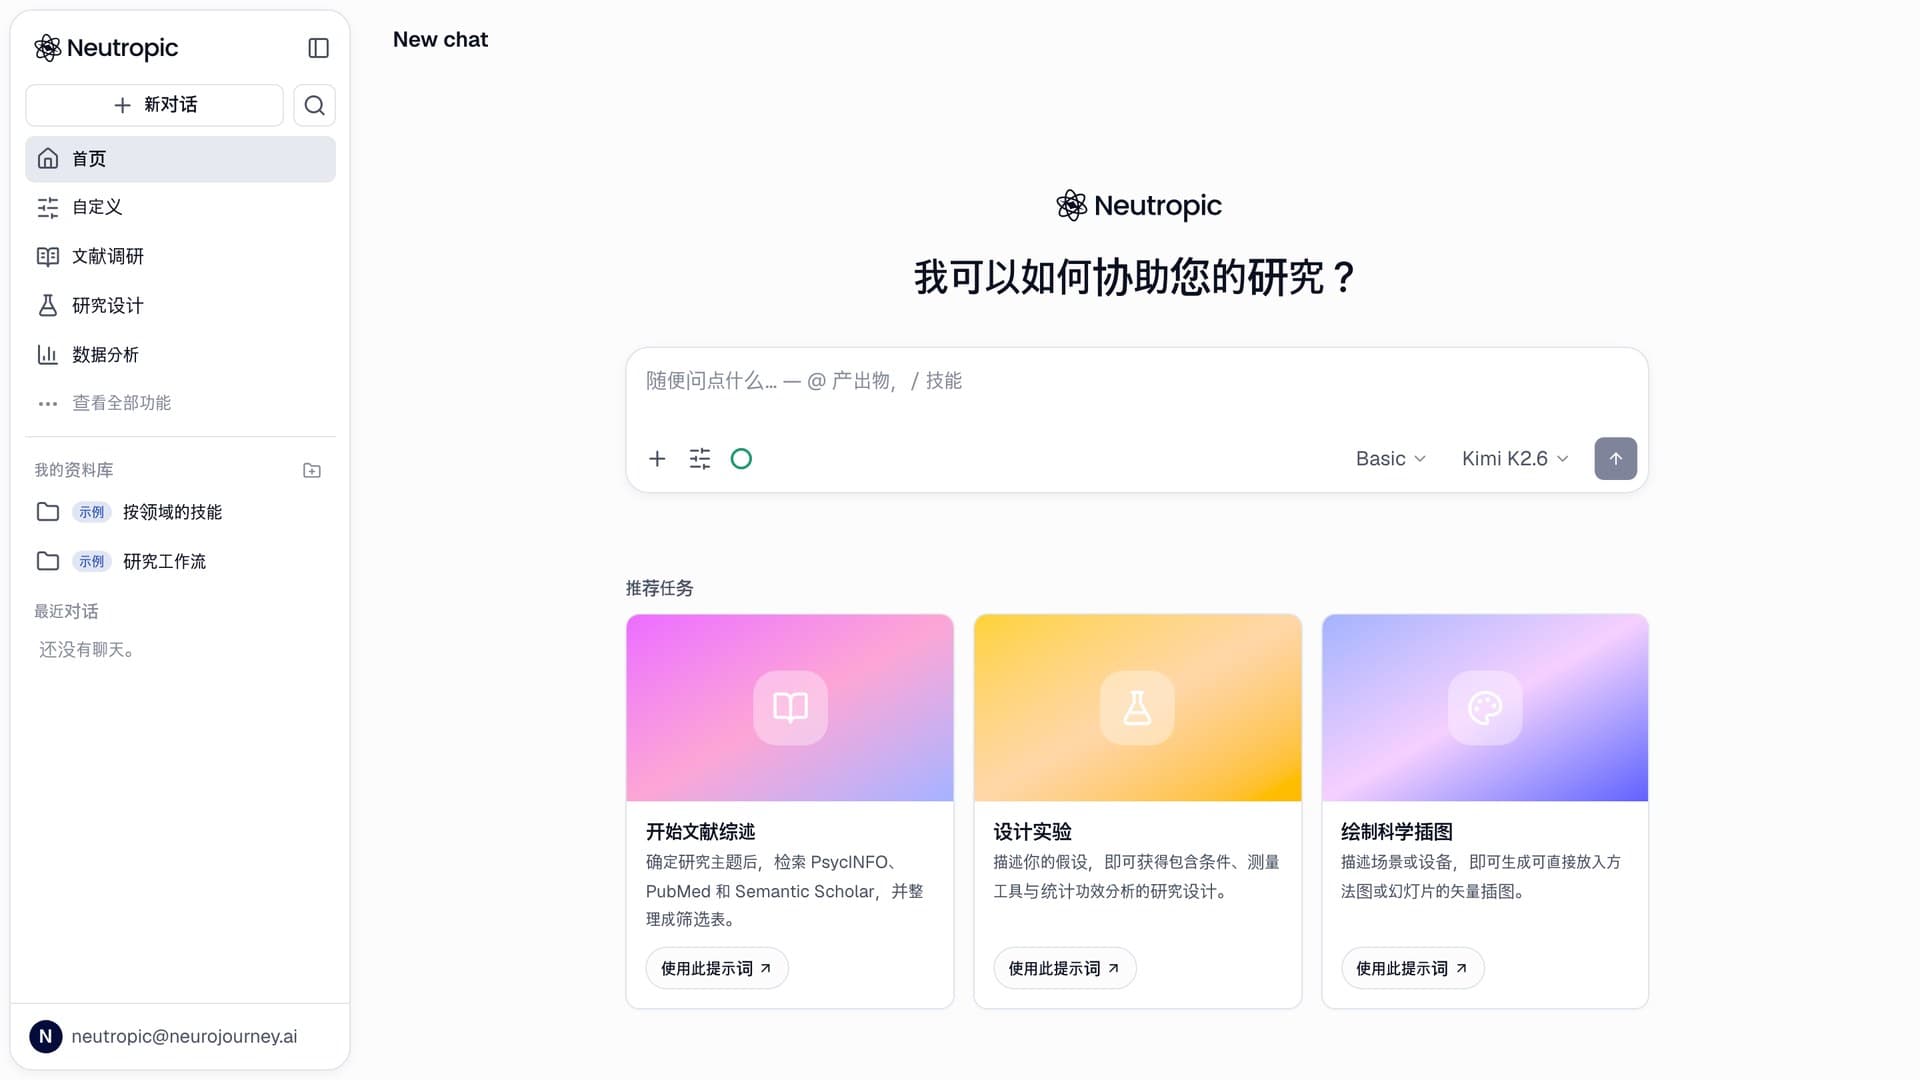
Neutropic 2.0 是我们开始构建面向人文科学的研究代理以来最大的一次发布。它重新思考了当你的数据是"人"——他们的回答、行为和生理——且每一个发表的论断都必须经得起审稿时,研究平台应当如何工作。下面展示的全部是已上线的产品,截图均来自真实会话。
一个对话,完整工作流
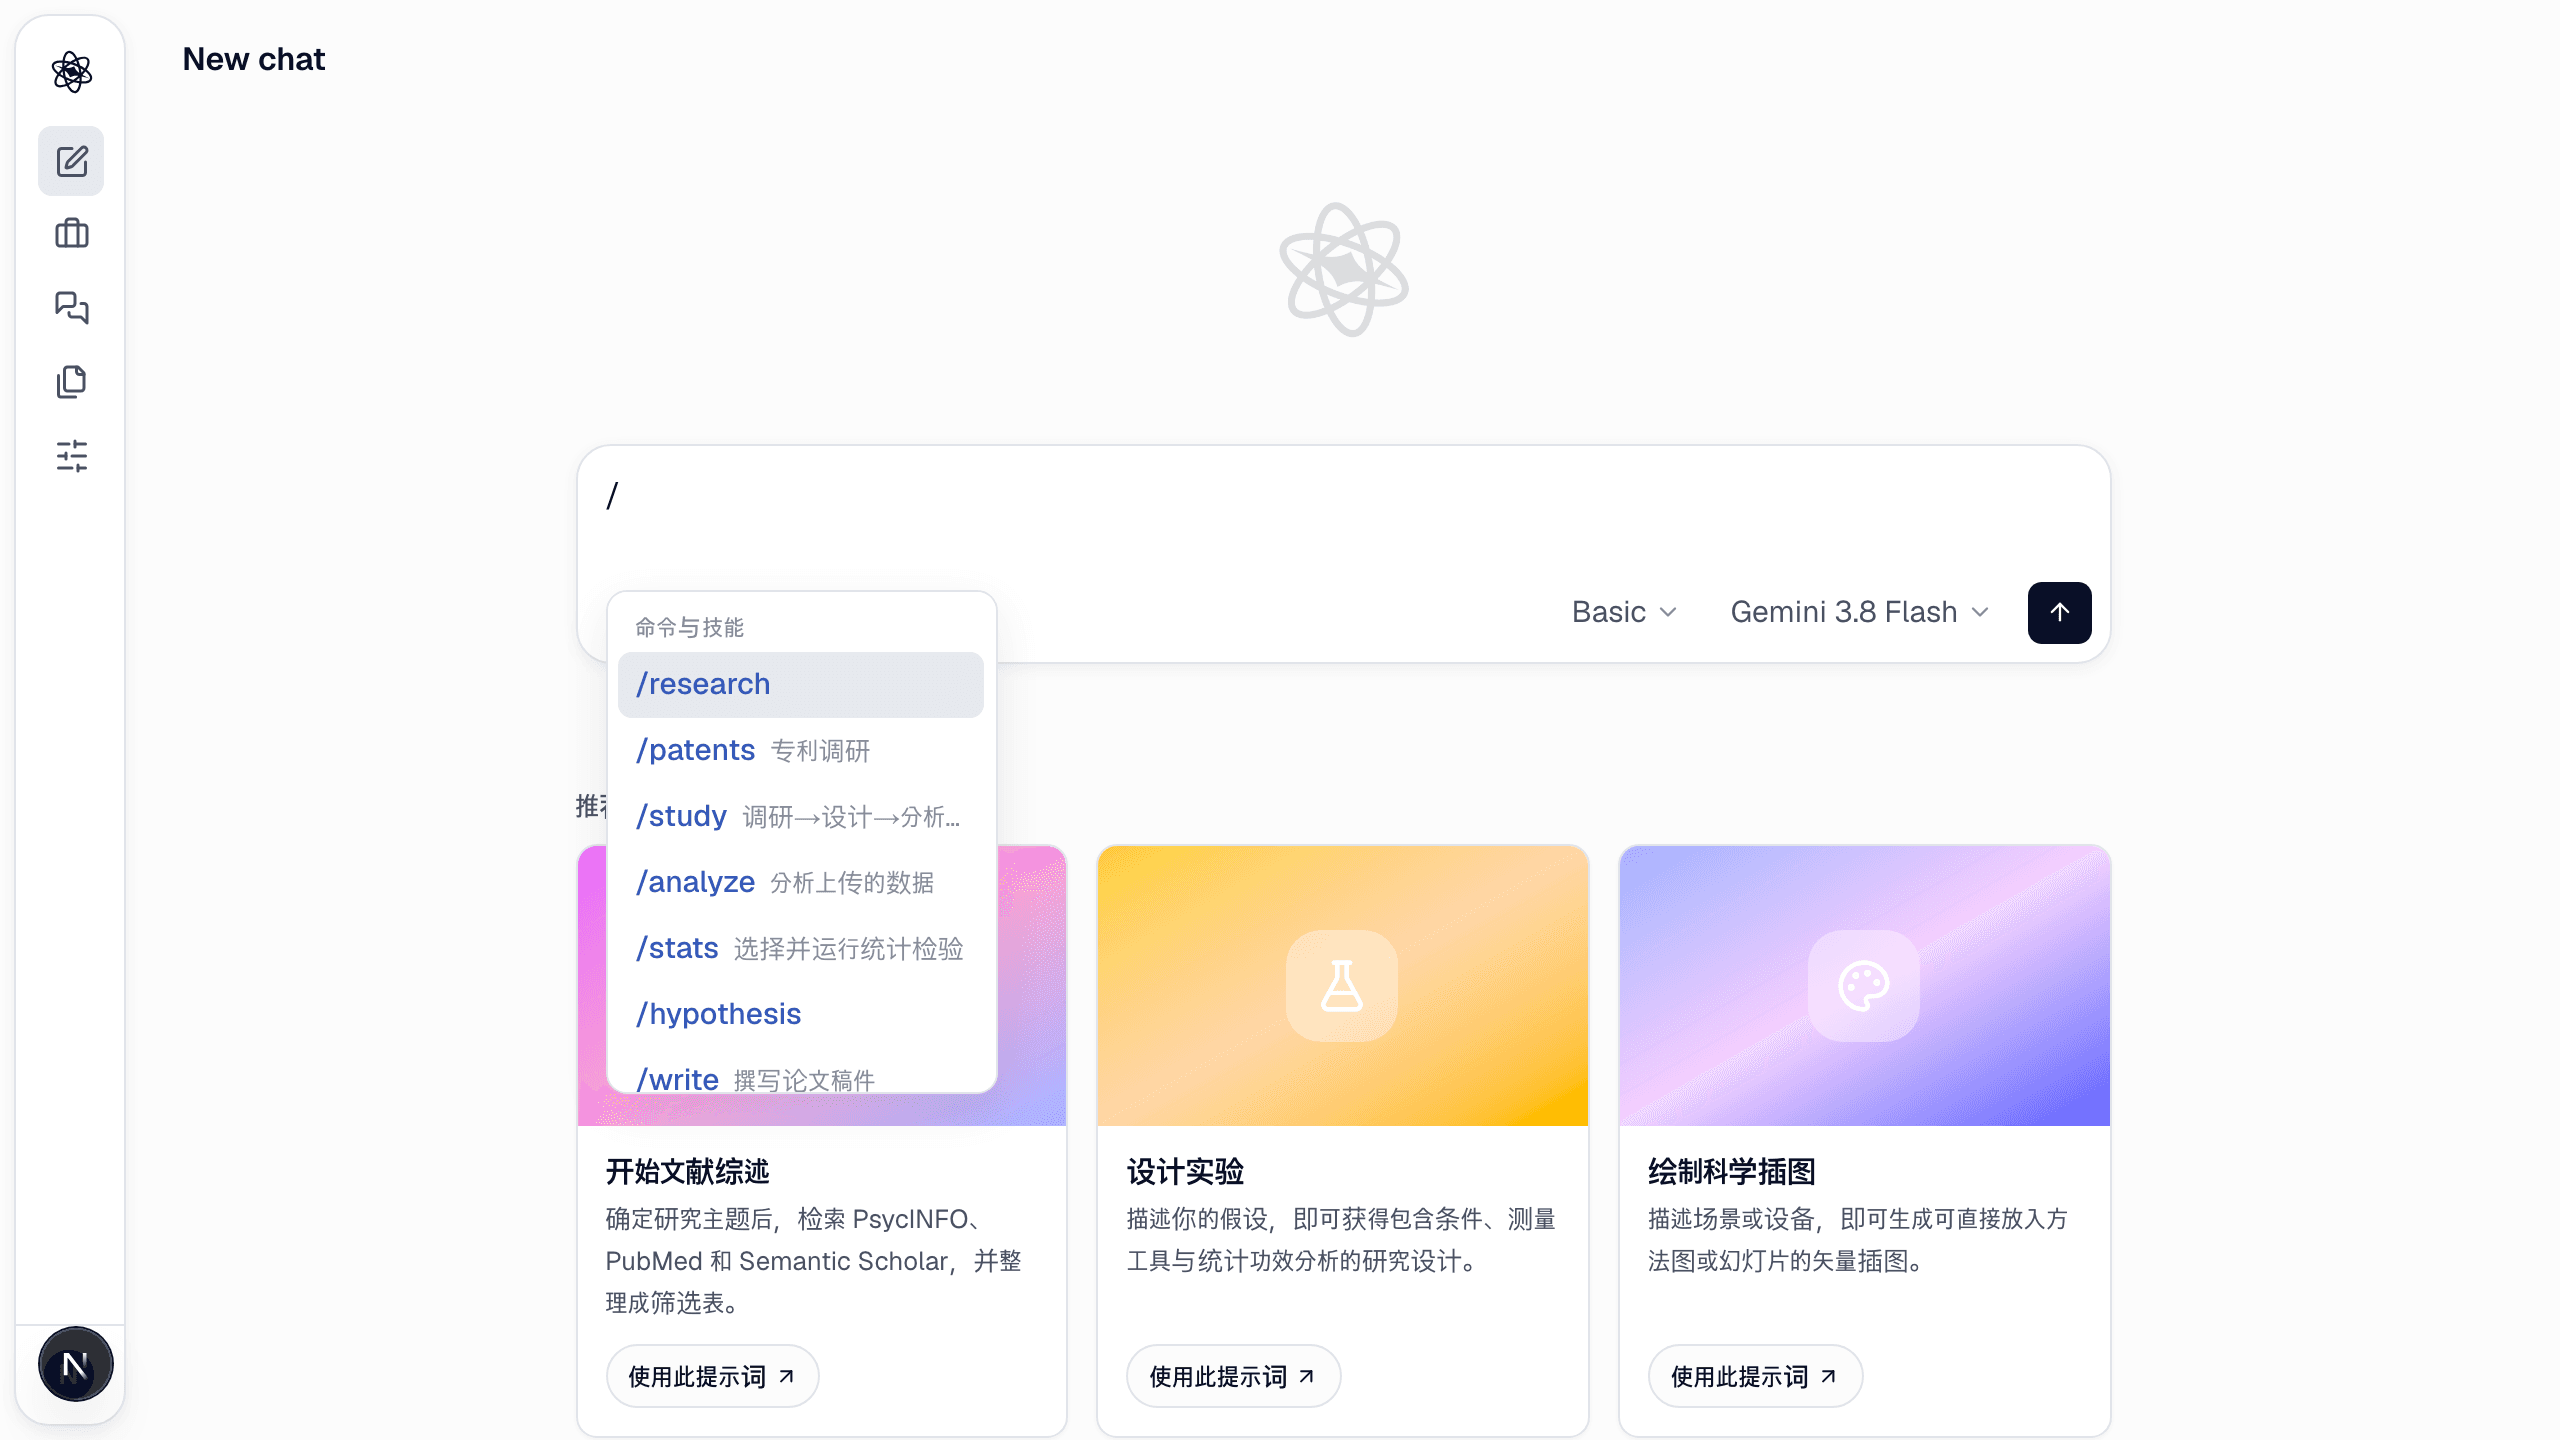
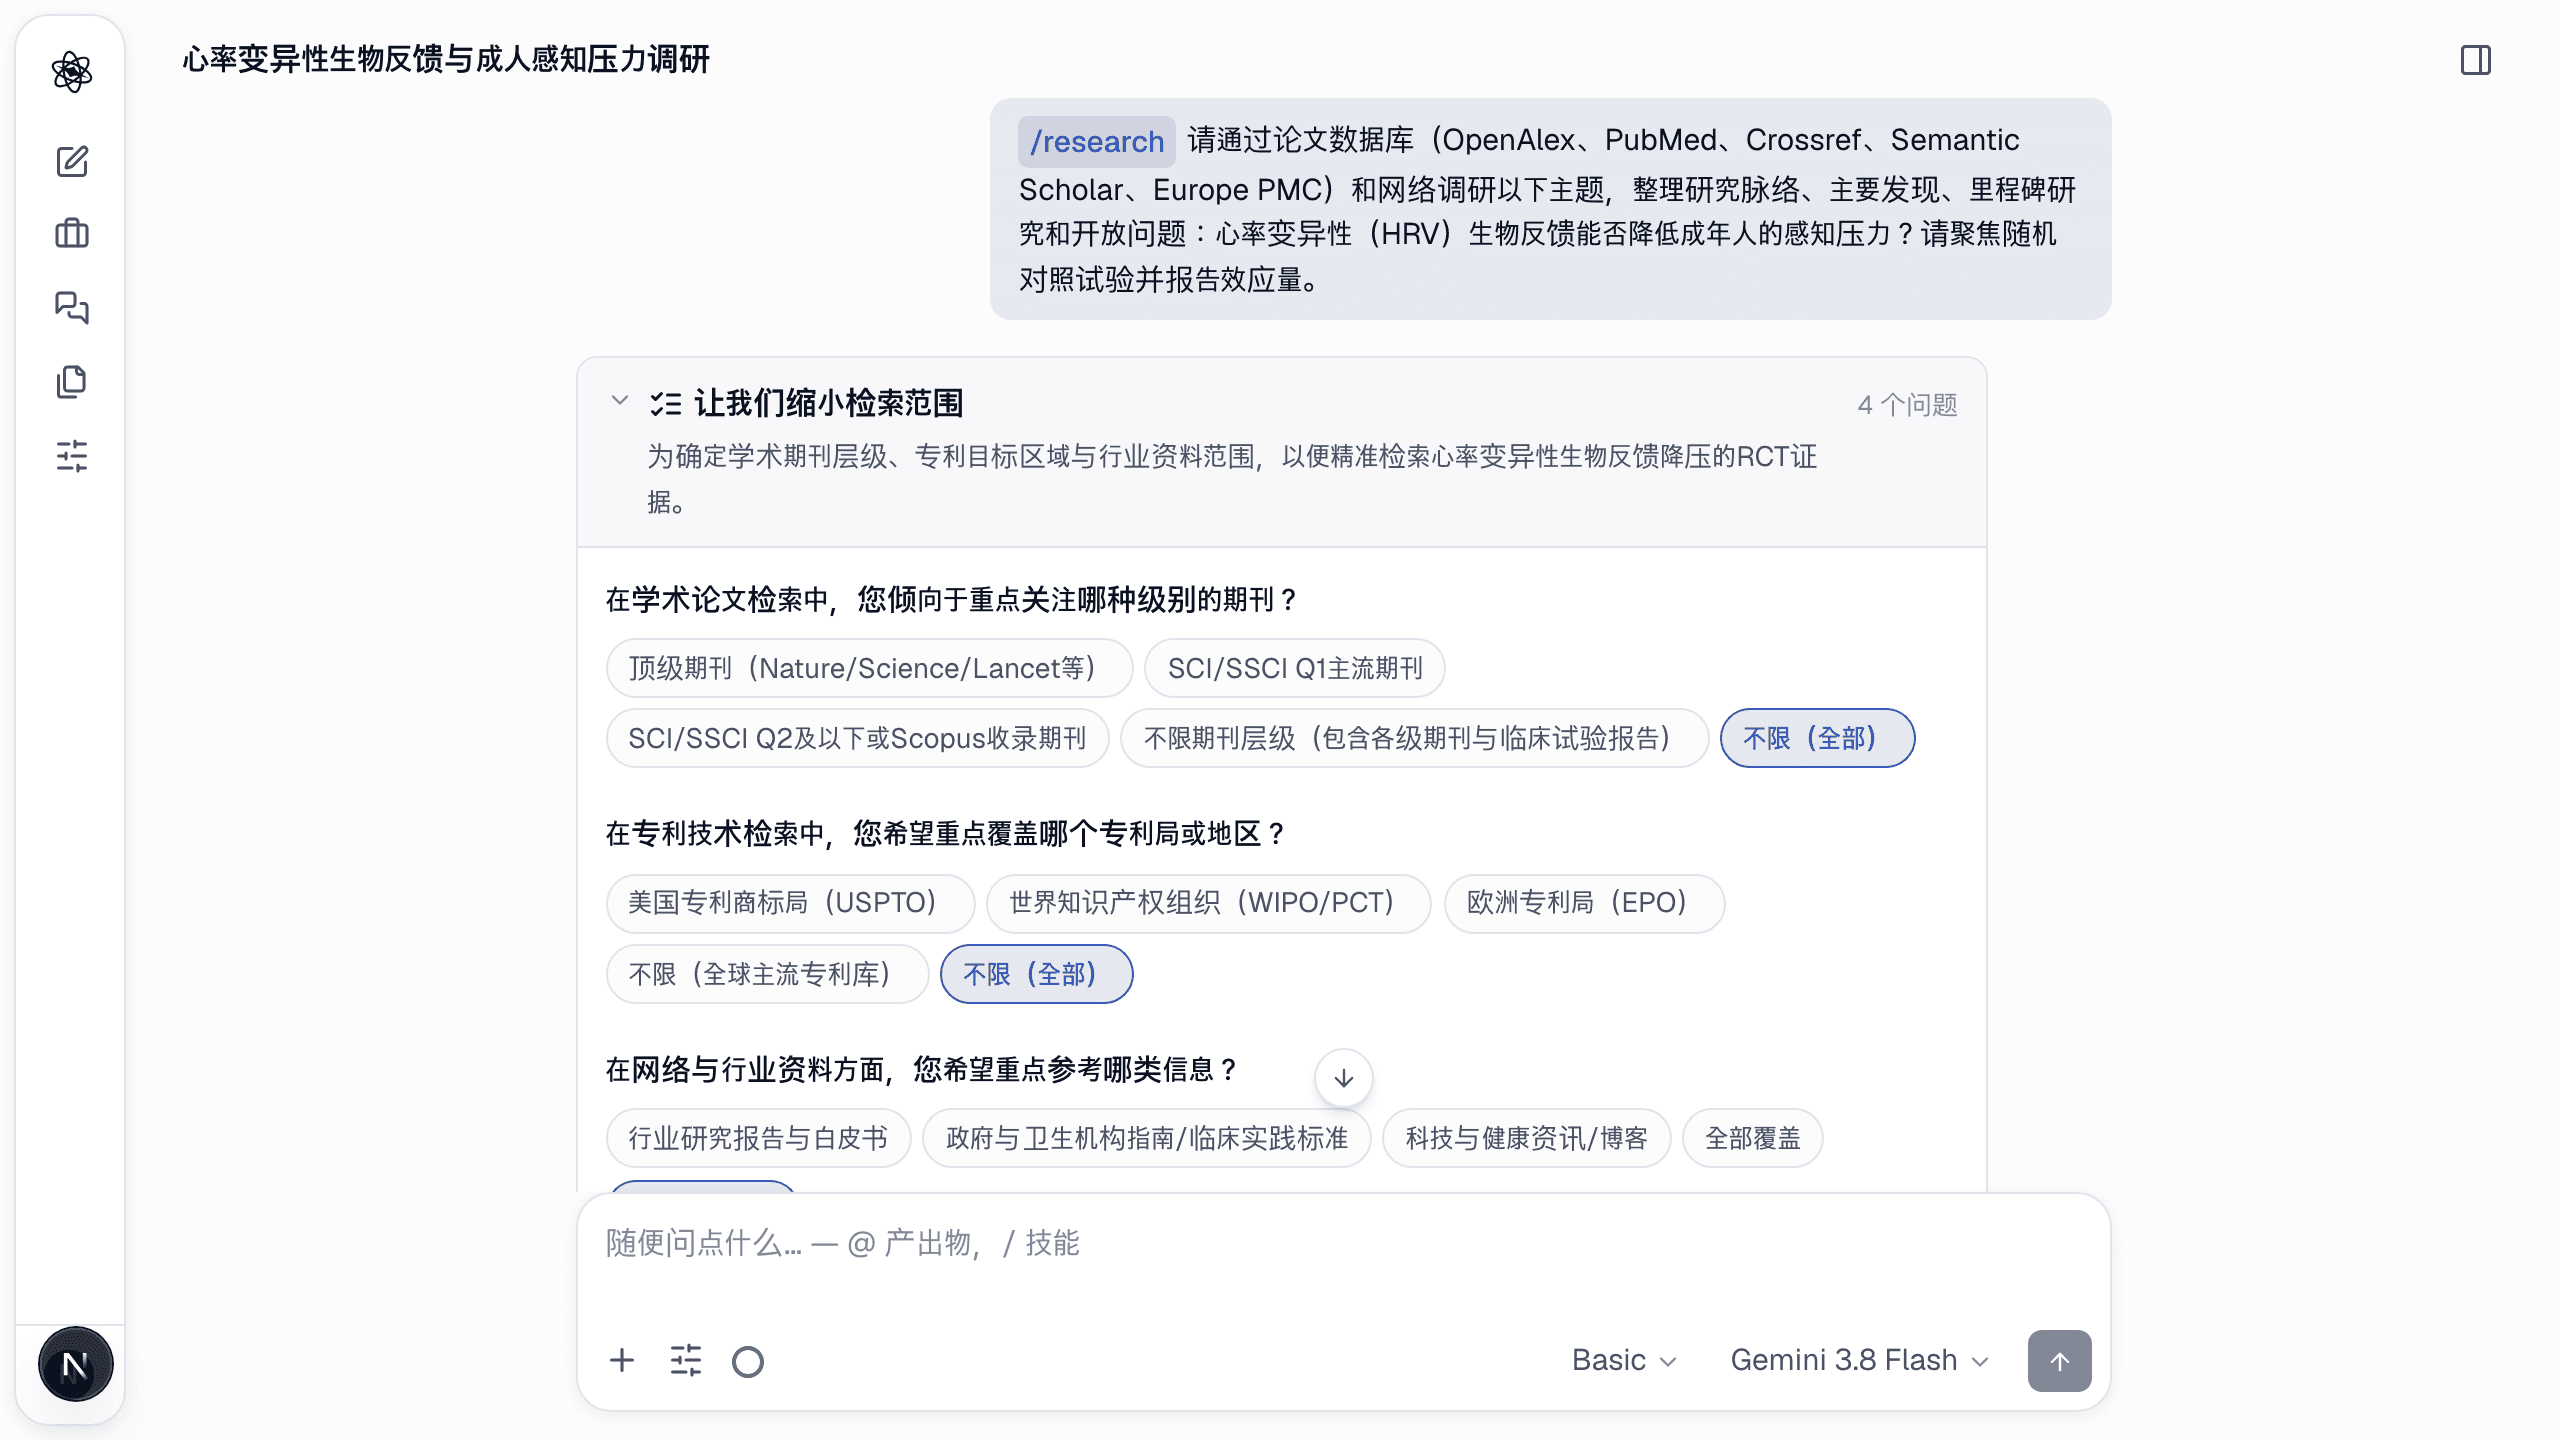
新建对话,输入斜杠:命令本身就是研究工作流——/research、/hypothesis、/analyze、/stats、/figure、/illustrate、/write、/review。也可以直接描述需求,由代理选择技能。投入级别(Lite · Basic · Deep)和模型就在发送按钮旁边。
全新构建的代理循环
代理循环现在从头到尾自研。这意味着:
- 文献检索、研究设计、分析和报告作为一个连贯的工作流运行,而不是彼此断开的对话——设计步骤读取会话中已有的文献,稿件读取分析结果。
- 每一次工具调用——数据库查询、统计运行、图表渲染——都公开显示,你可以审计代理究竟做了什么。
- 独立的审查代理在结果到达你之前检查统计有效性:假设违背、多重比较、样本量和 p-hacking 风险。
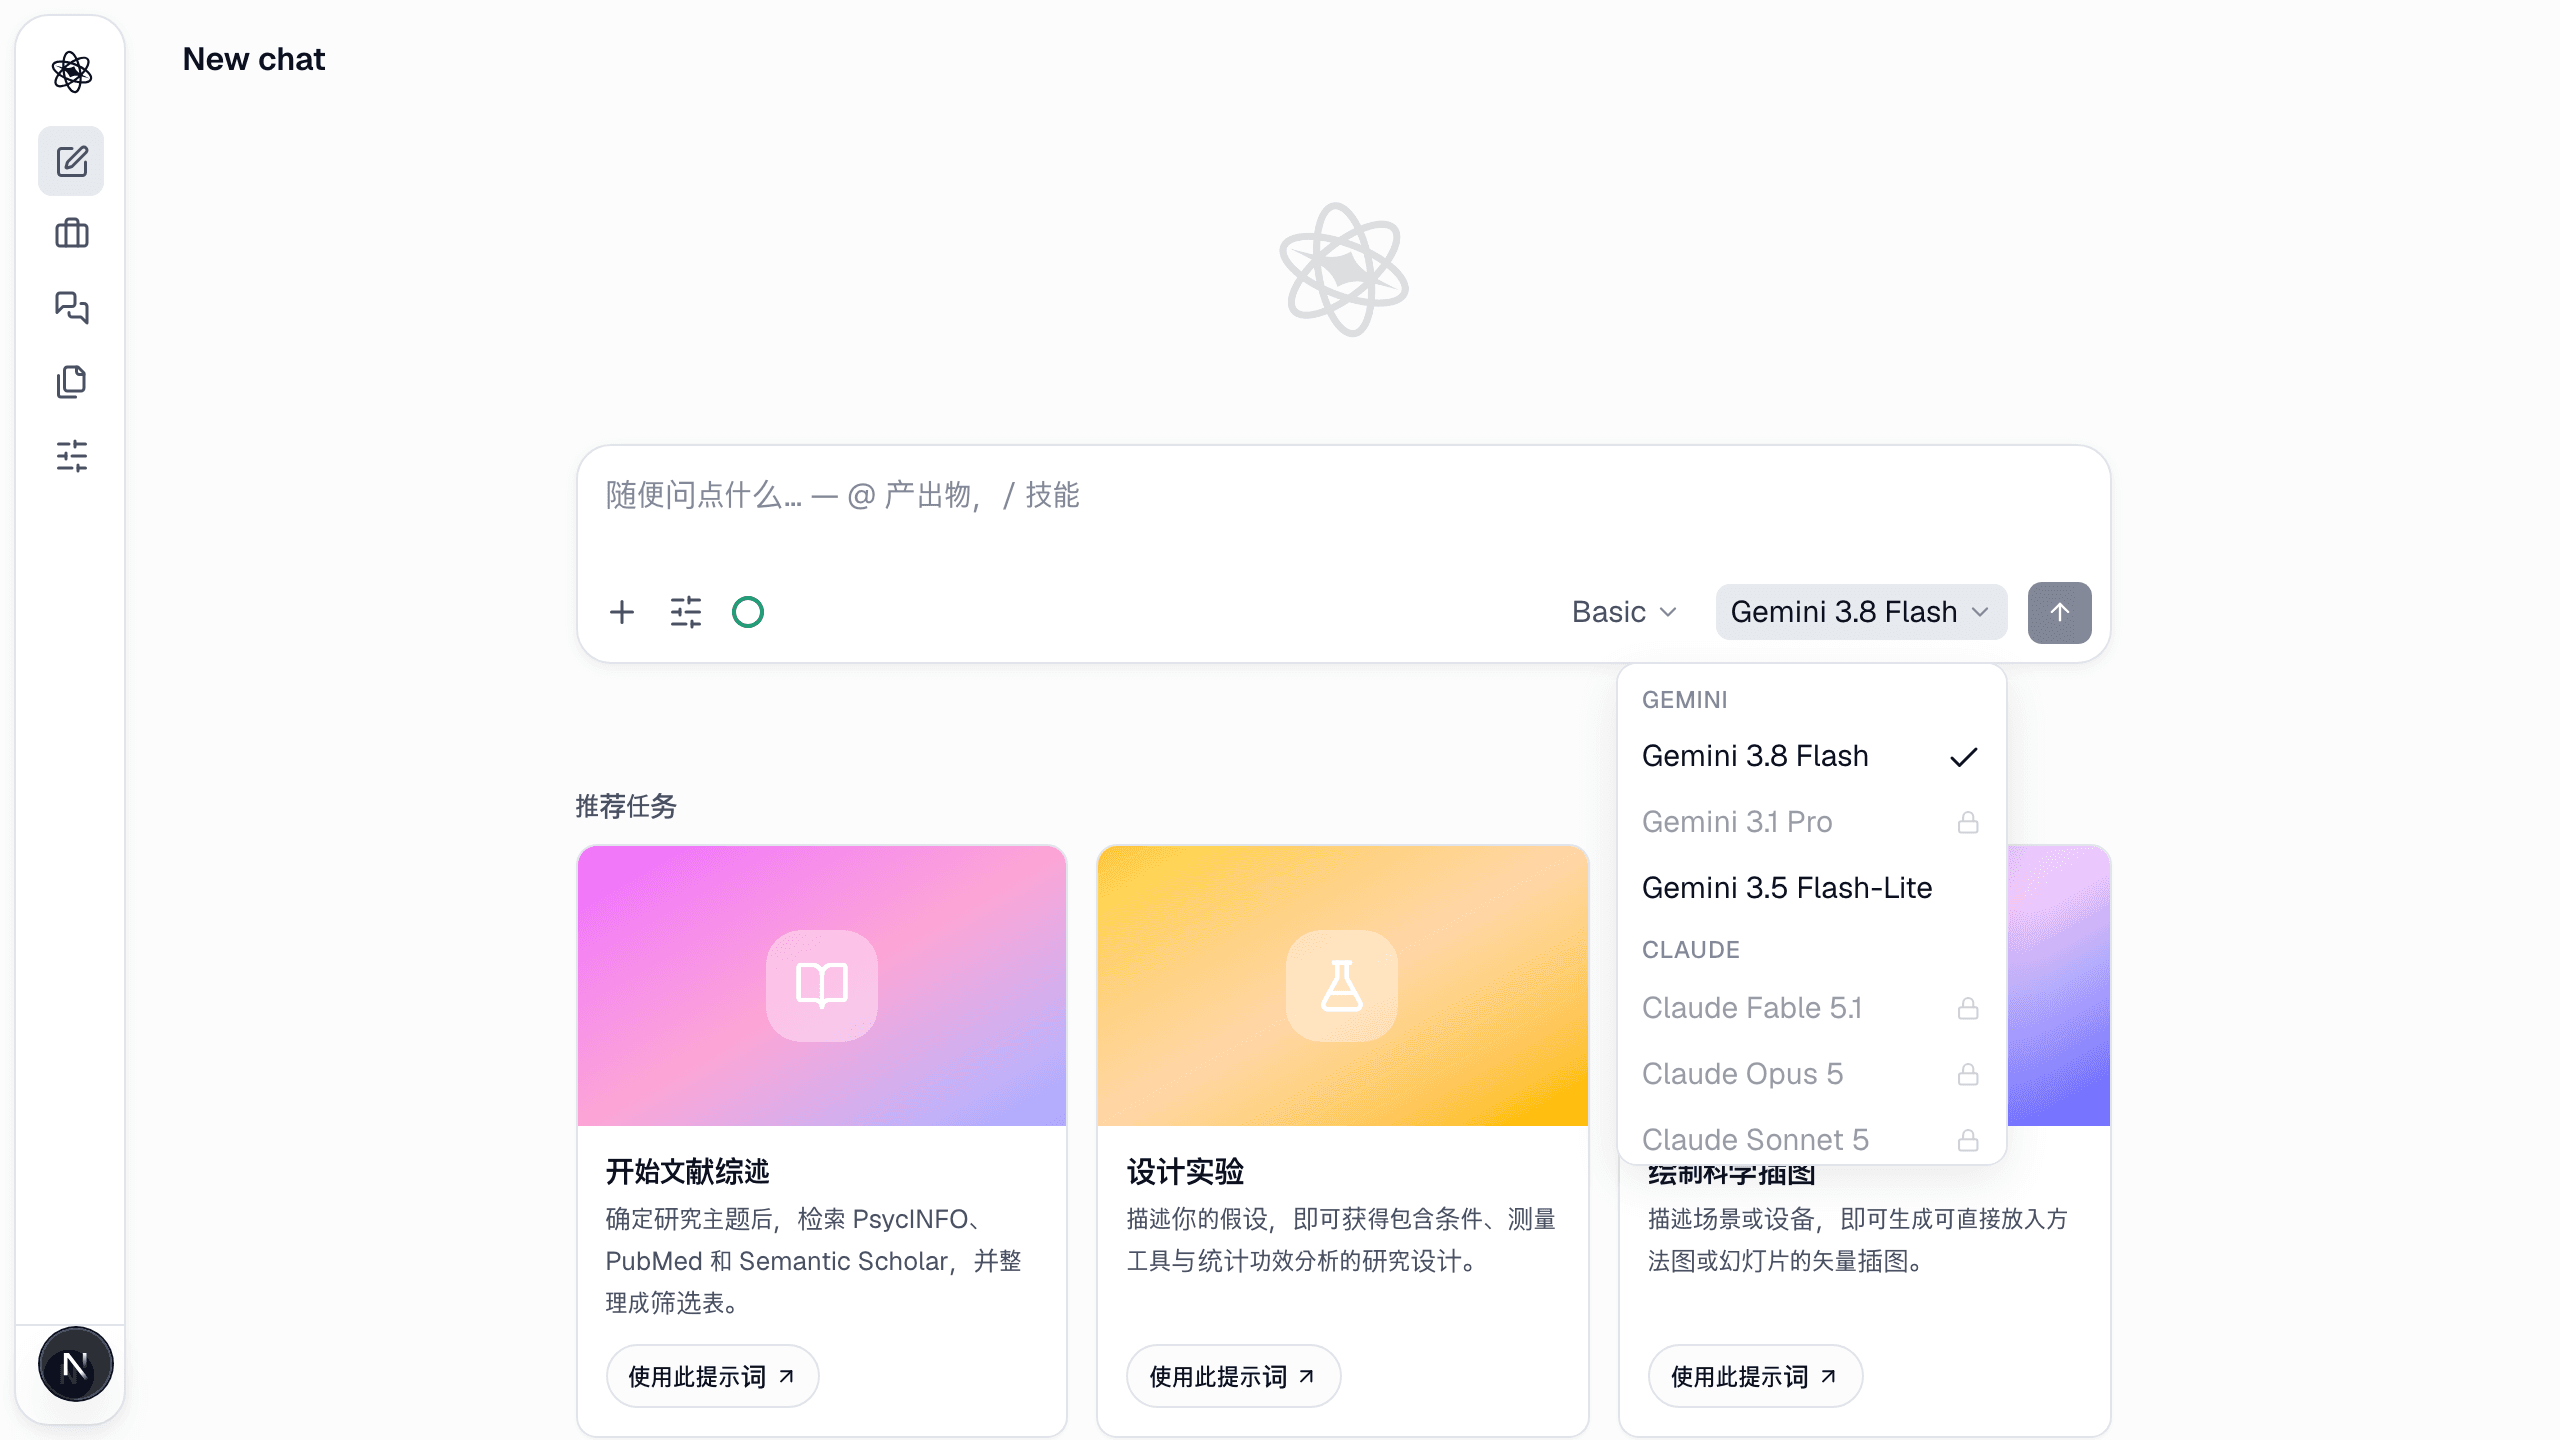
模型由你选择——云端或本地
每条消息都可以在 Gemini、Claude、GPT、DeepSeek 和 Kimi 中选择模型。本地模型以及完全屏蔽云端提供商的敏感项目,将随正在准备发布的桌面应用一同提供。
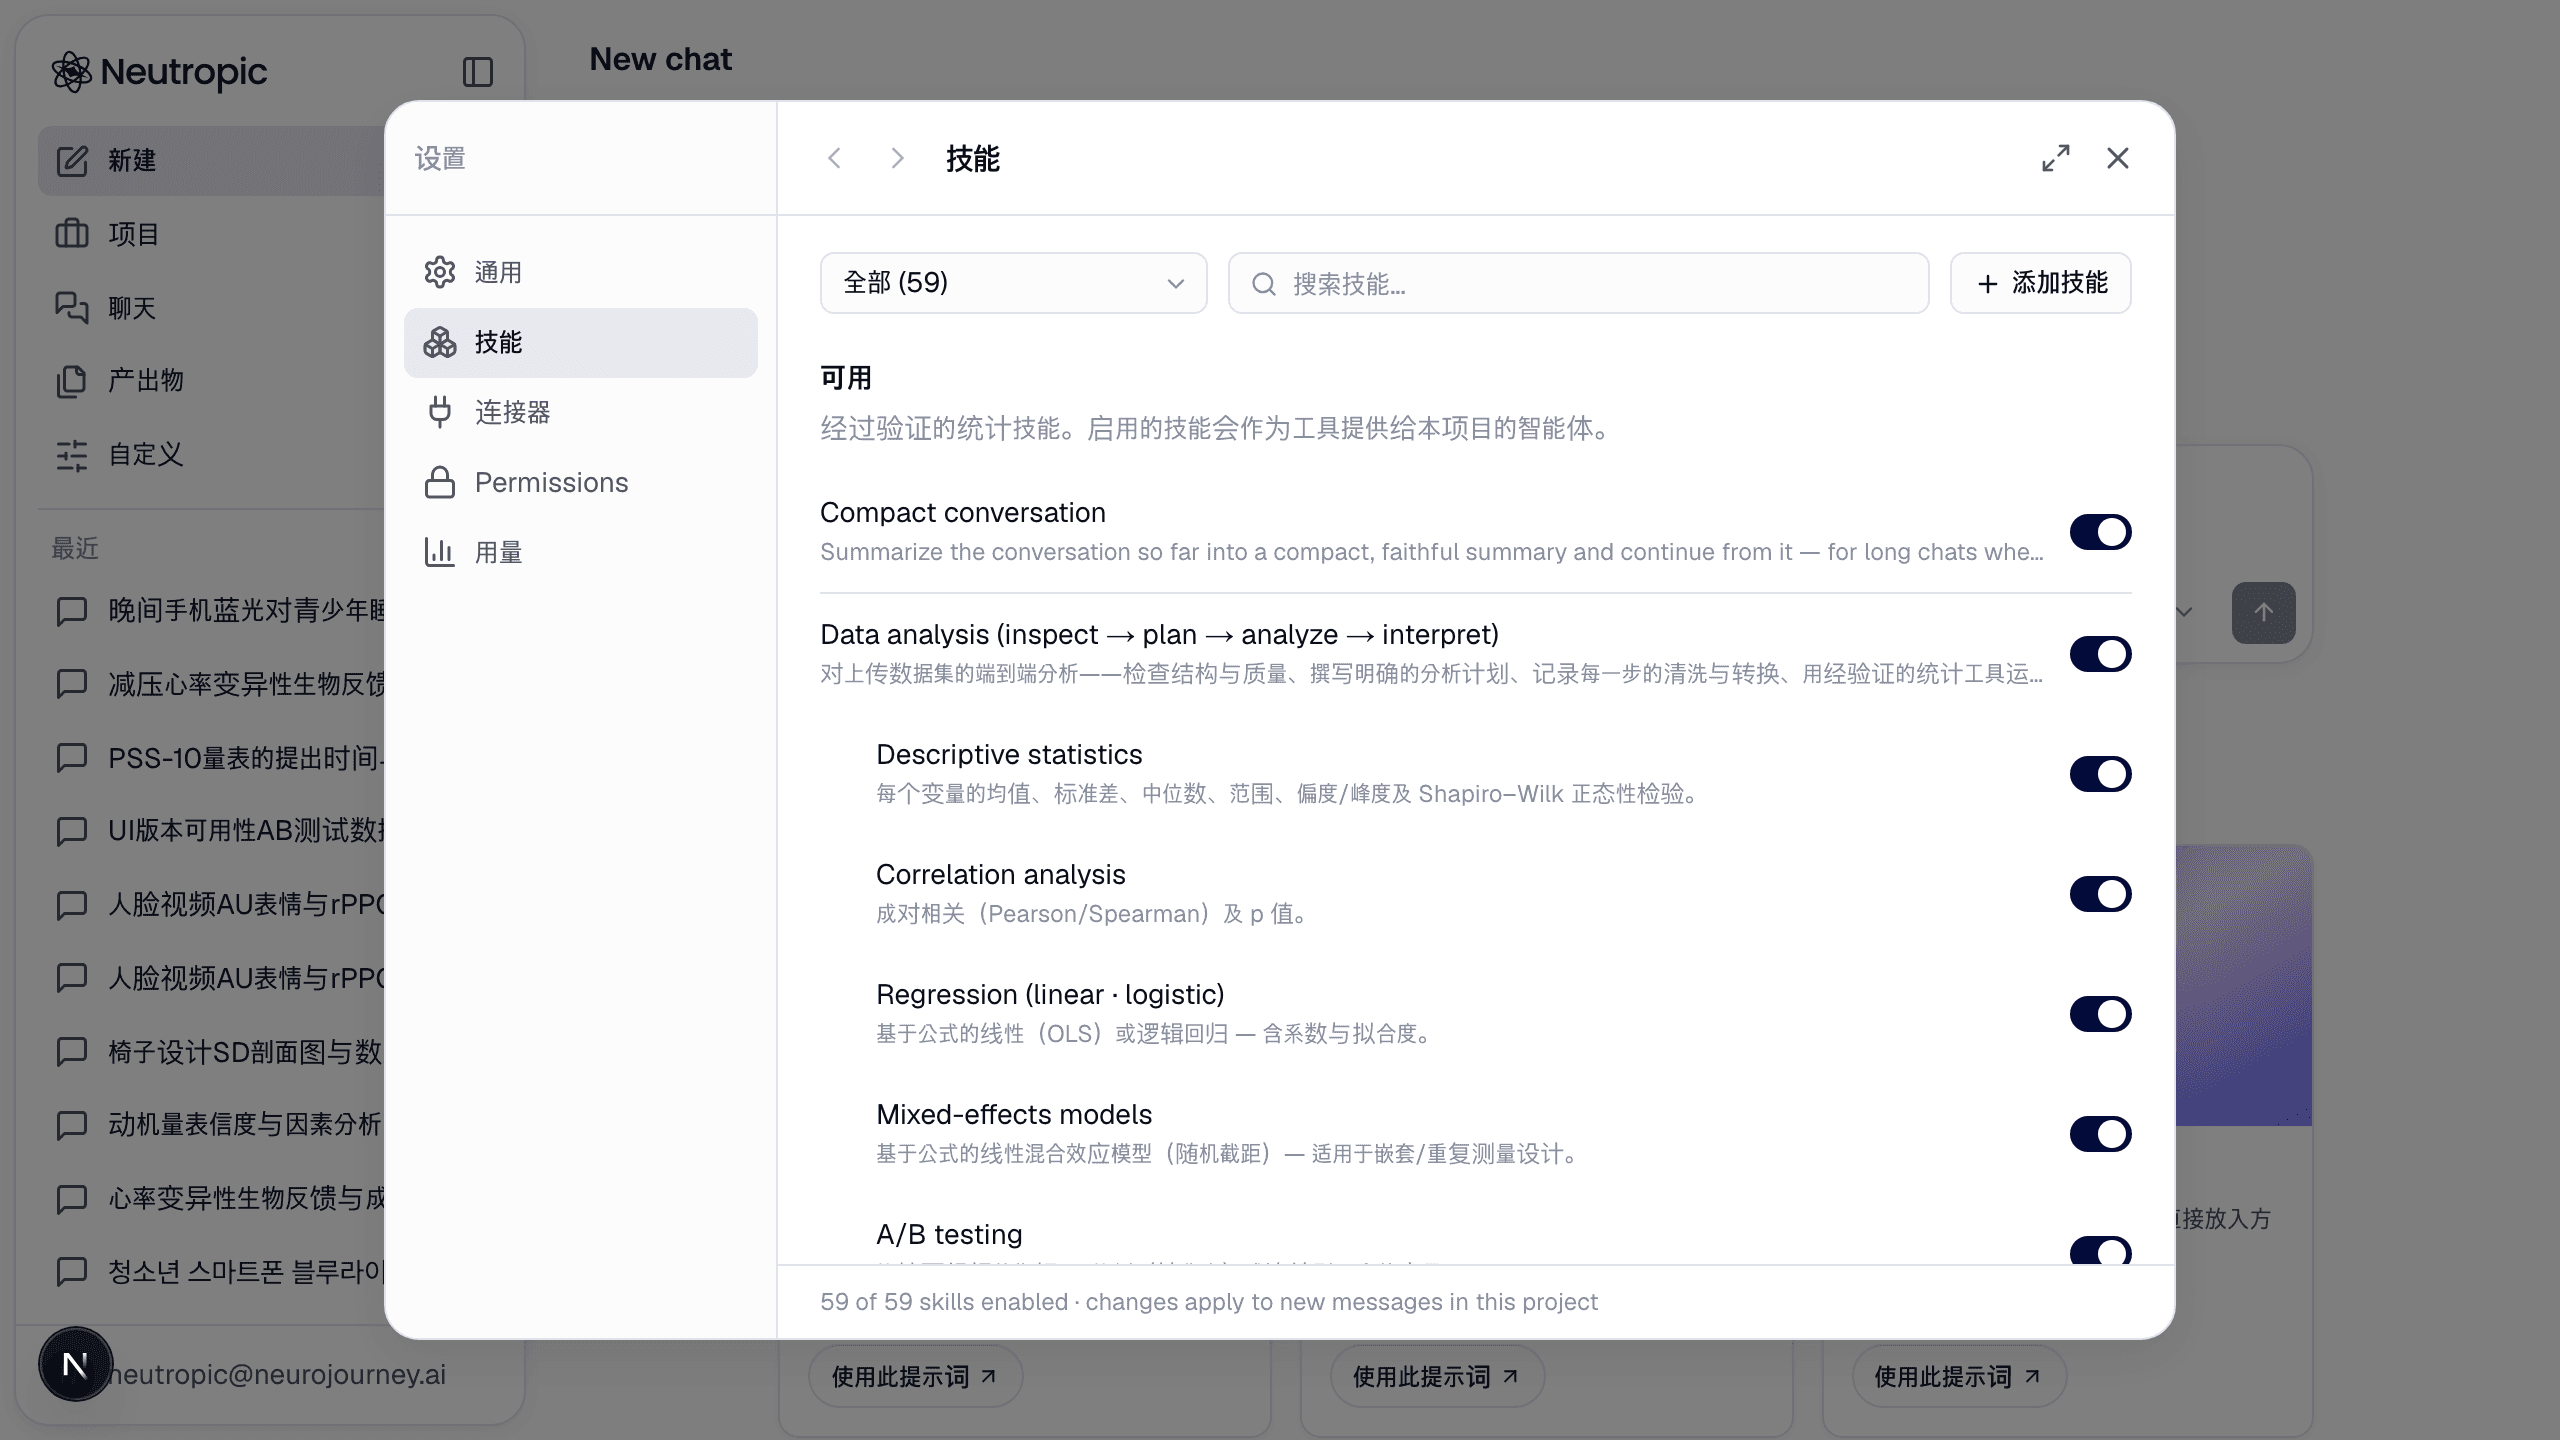
看得见、可开关的技能
从描述统计、混合效应模型到 EEG 频带功率和 rPPG,78 项经验证的技能(其中 46 项为分析方法)在 Customize 中逐一列出并配有开关。关闭项目不该使用的技能;用一个 Markdown 文件添加你自己的技能。
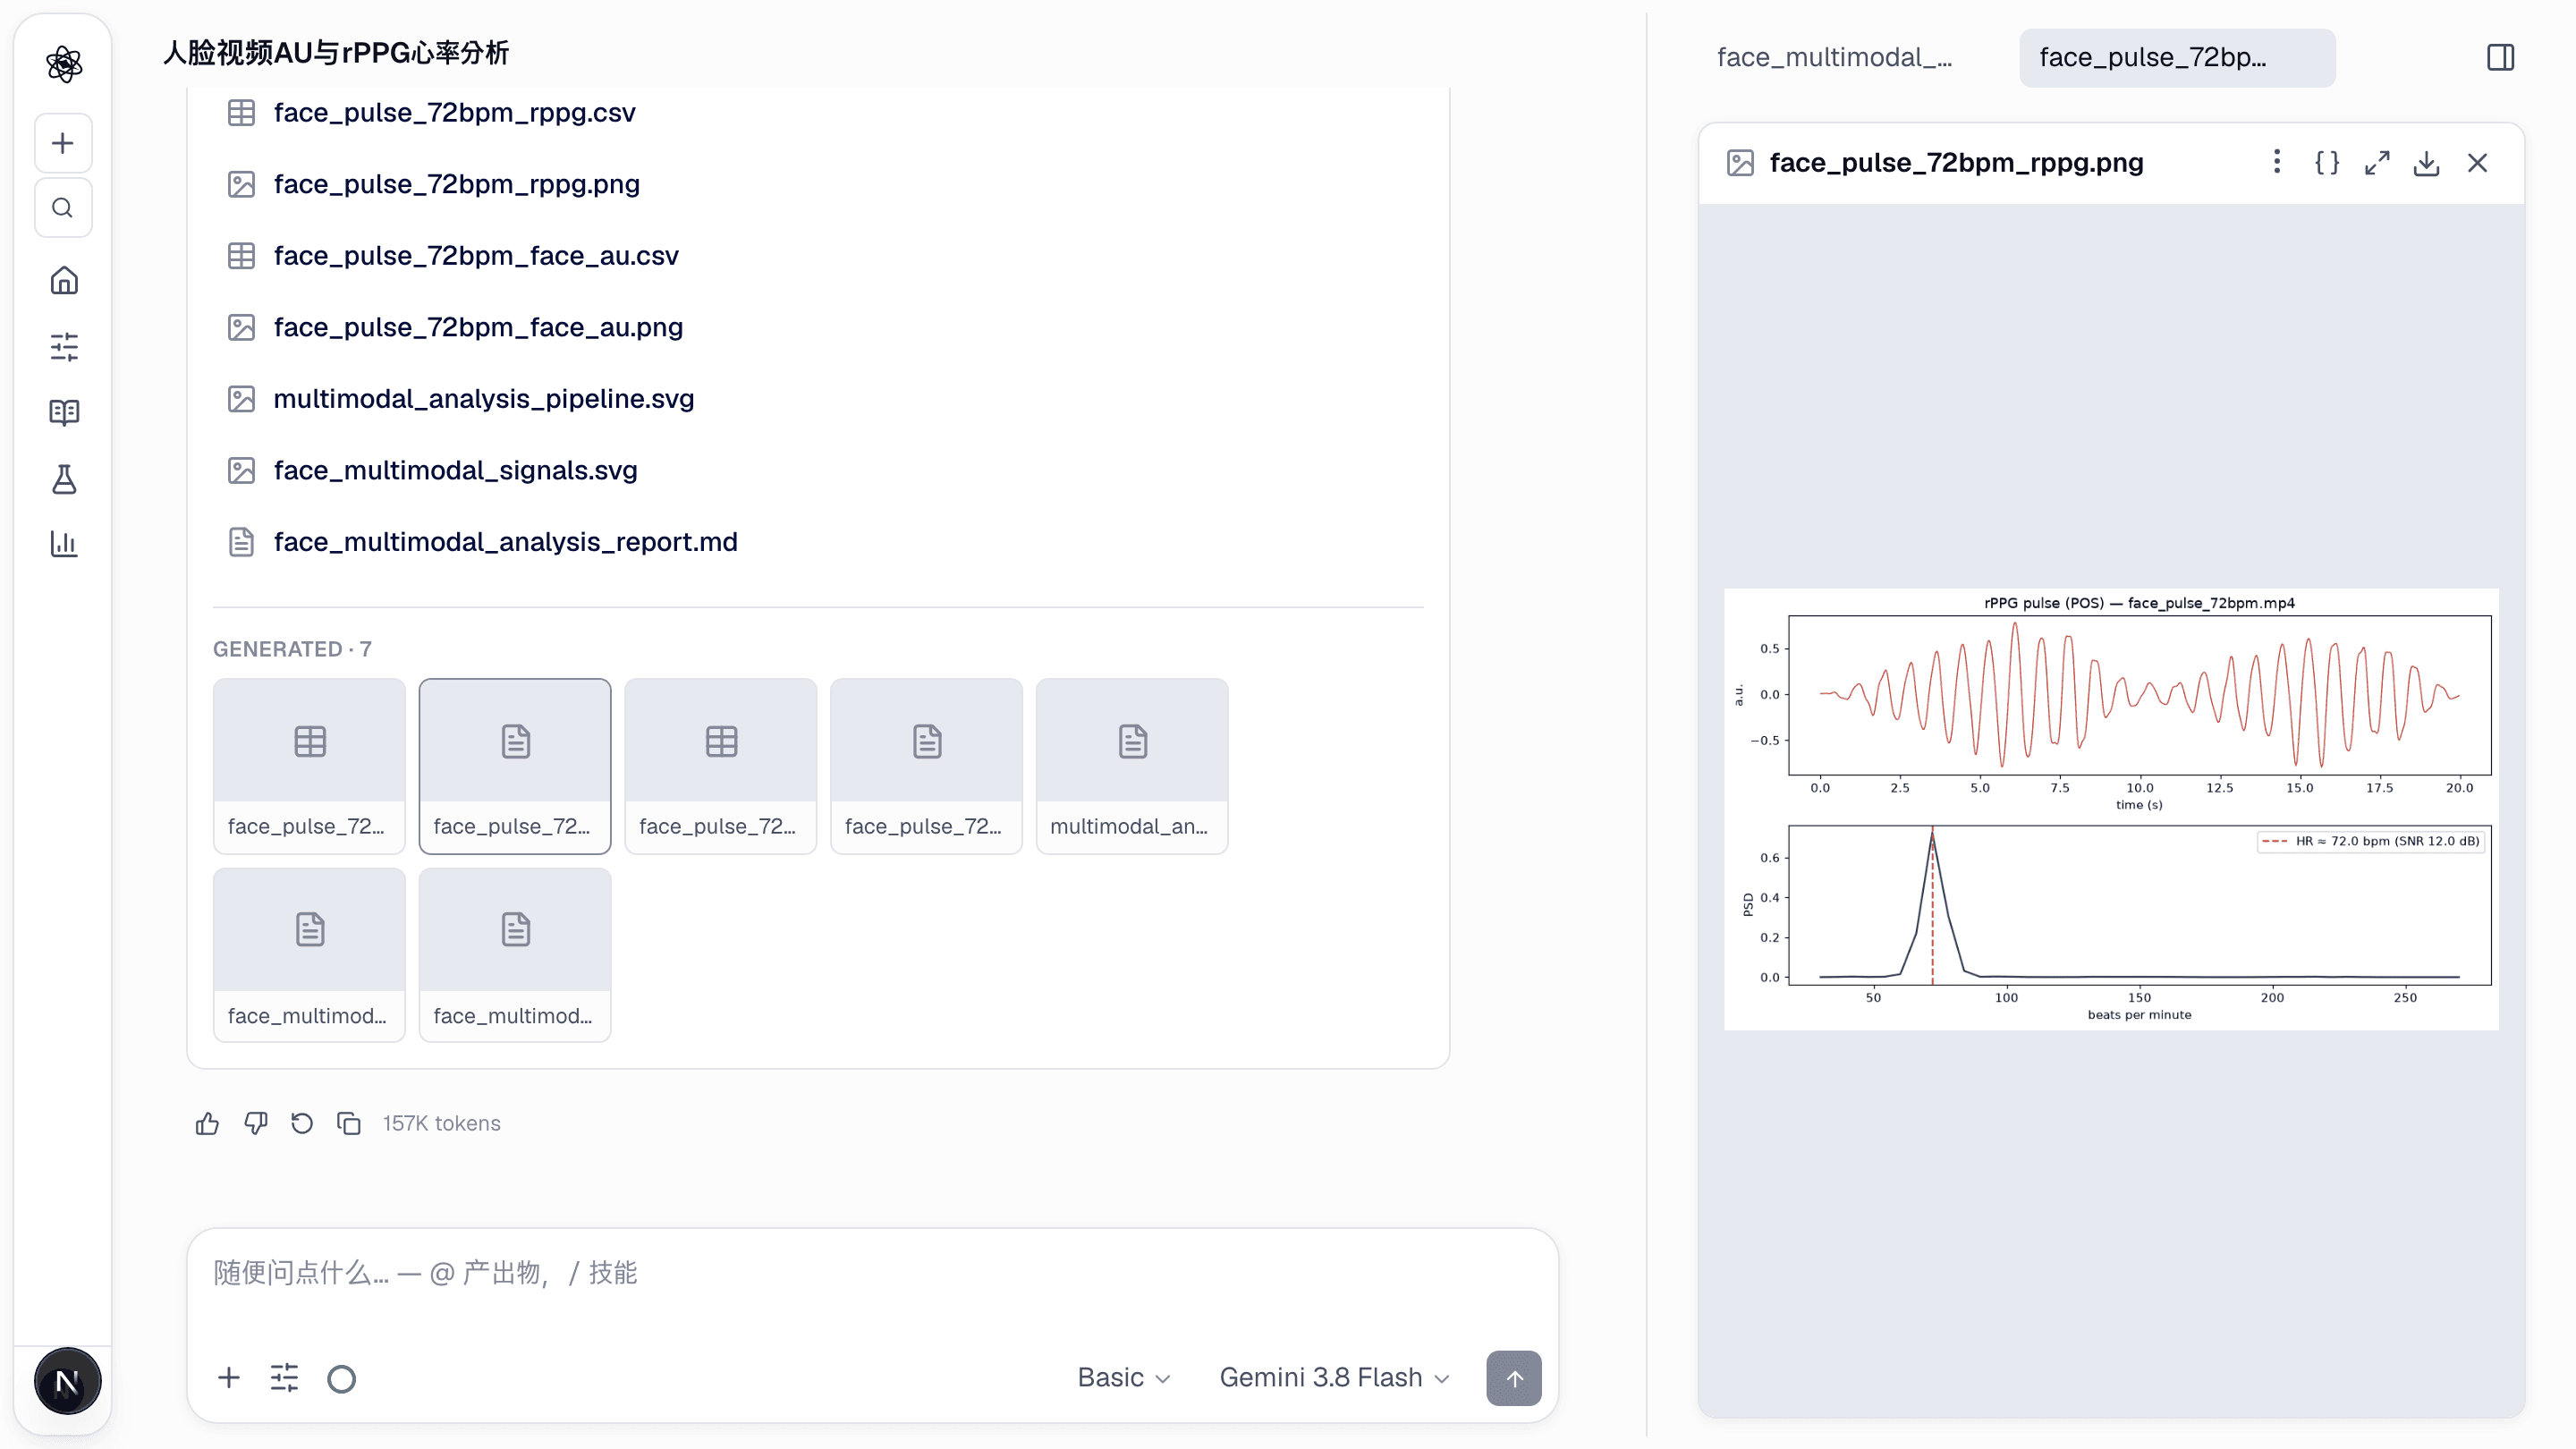
默认多模态
人文科学的数据很少只是一张表。Neutropic 2.0 把面部表情、注视、EDA、HRV 和语音与问卷、行为日志一样当作一等输入,并在同一会话中把每一路信号从原始记录处理到特征与图表。
你的研究,在每一台设备上
项目、会话、对话和产物现在保存在你的账户中,而不是某一台机器上。在实验室工作站、笔记本或合作者的办公室登录,你看到的是同样状态的同样项目。原始上传和代码执行留在执行工作的机器上,产物则随账户保存,不会被困在任何一台设备里。
我们的目标很简单:从研究问题到可辩护答案的距离,应当以对话次数而非周数来衡量。
今日可用
Neutropic 2.0 正在向所有账户推送。打开应用,创建项目,提出你的第一个研究问题——剩下的交给代理。想看一项研究从头到尾的完整运行,请阅读应用场景演示。