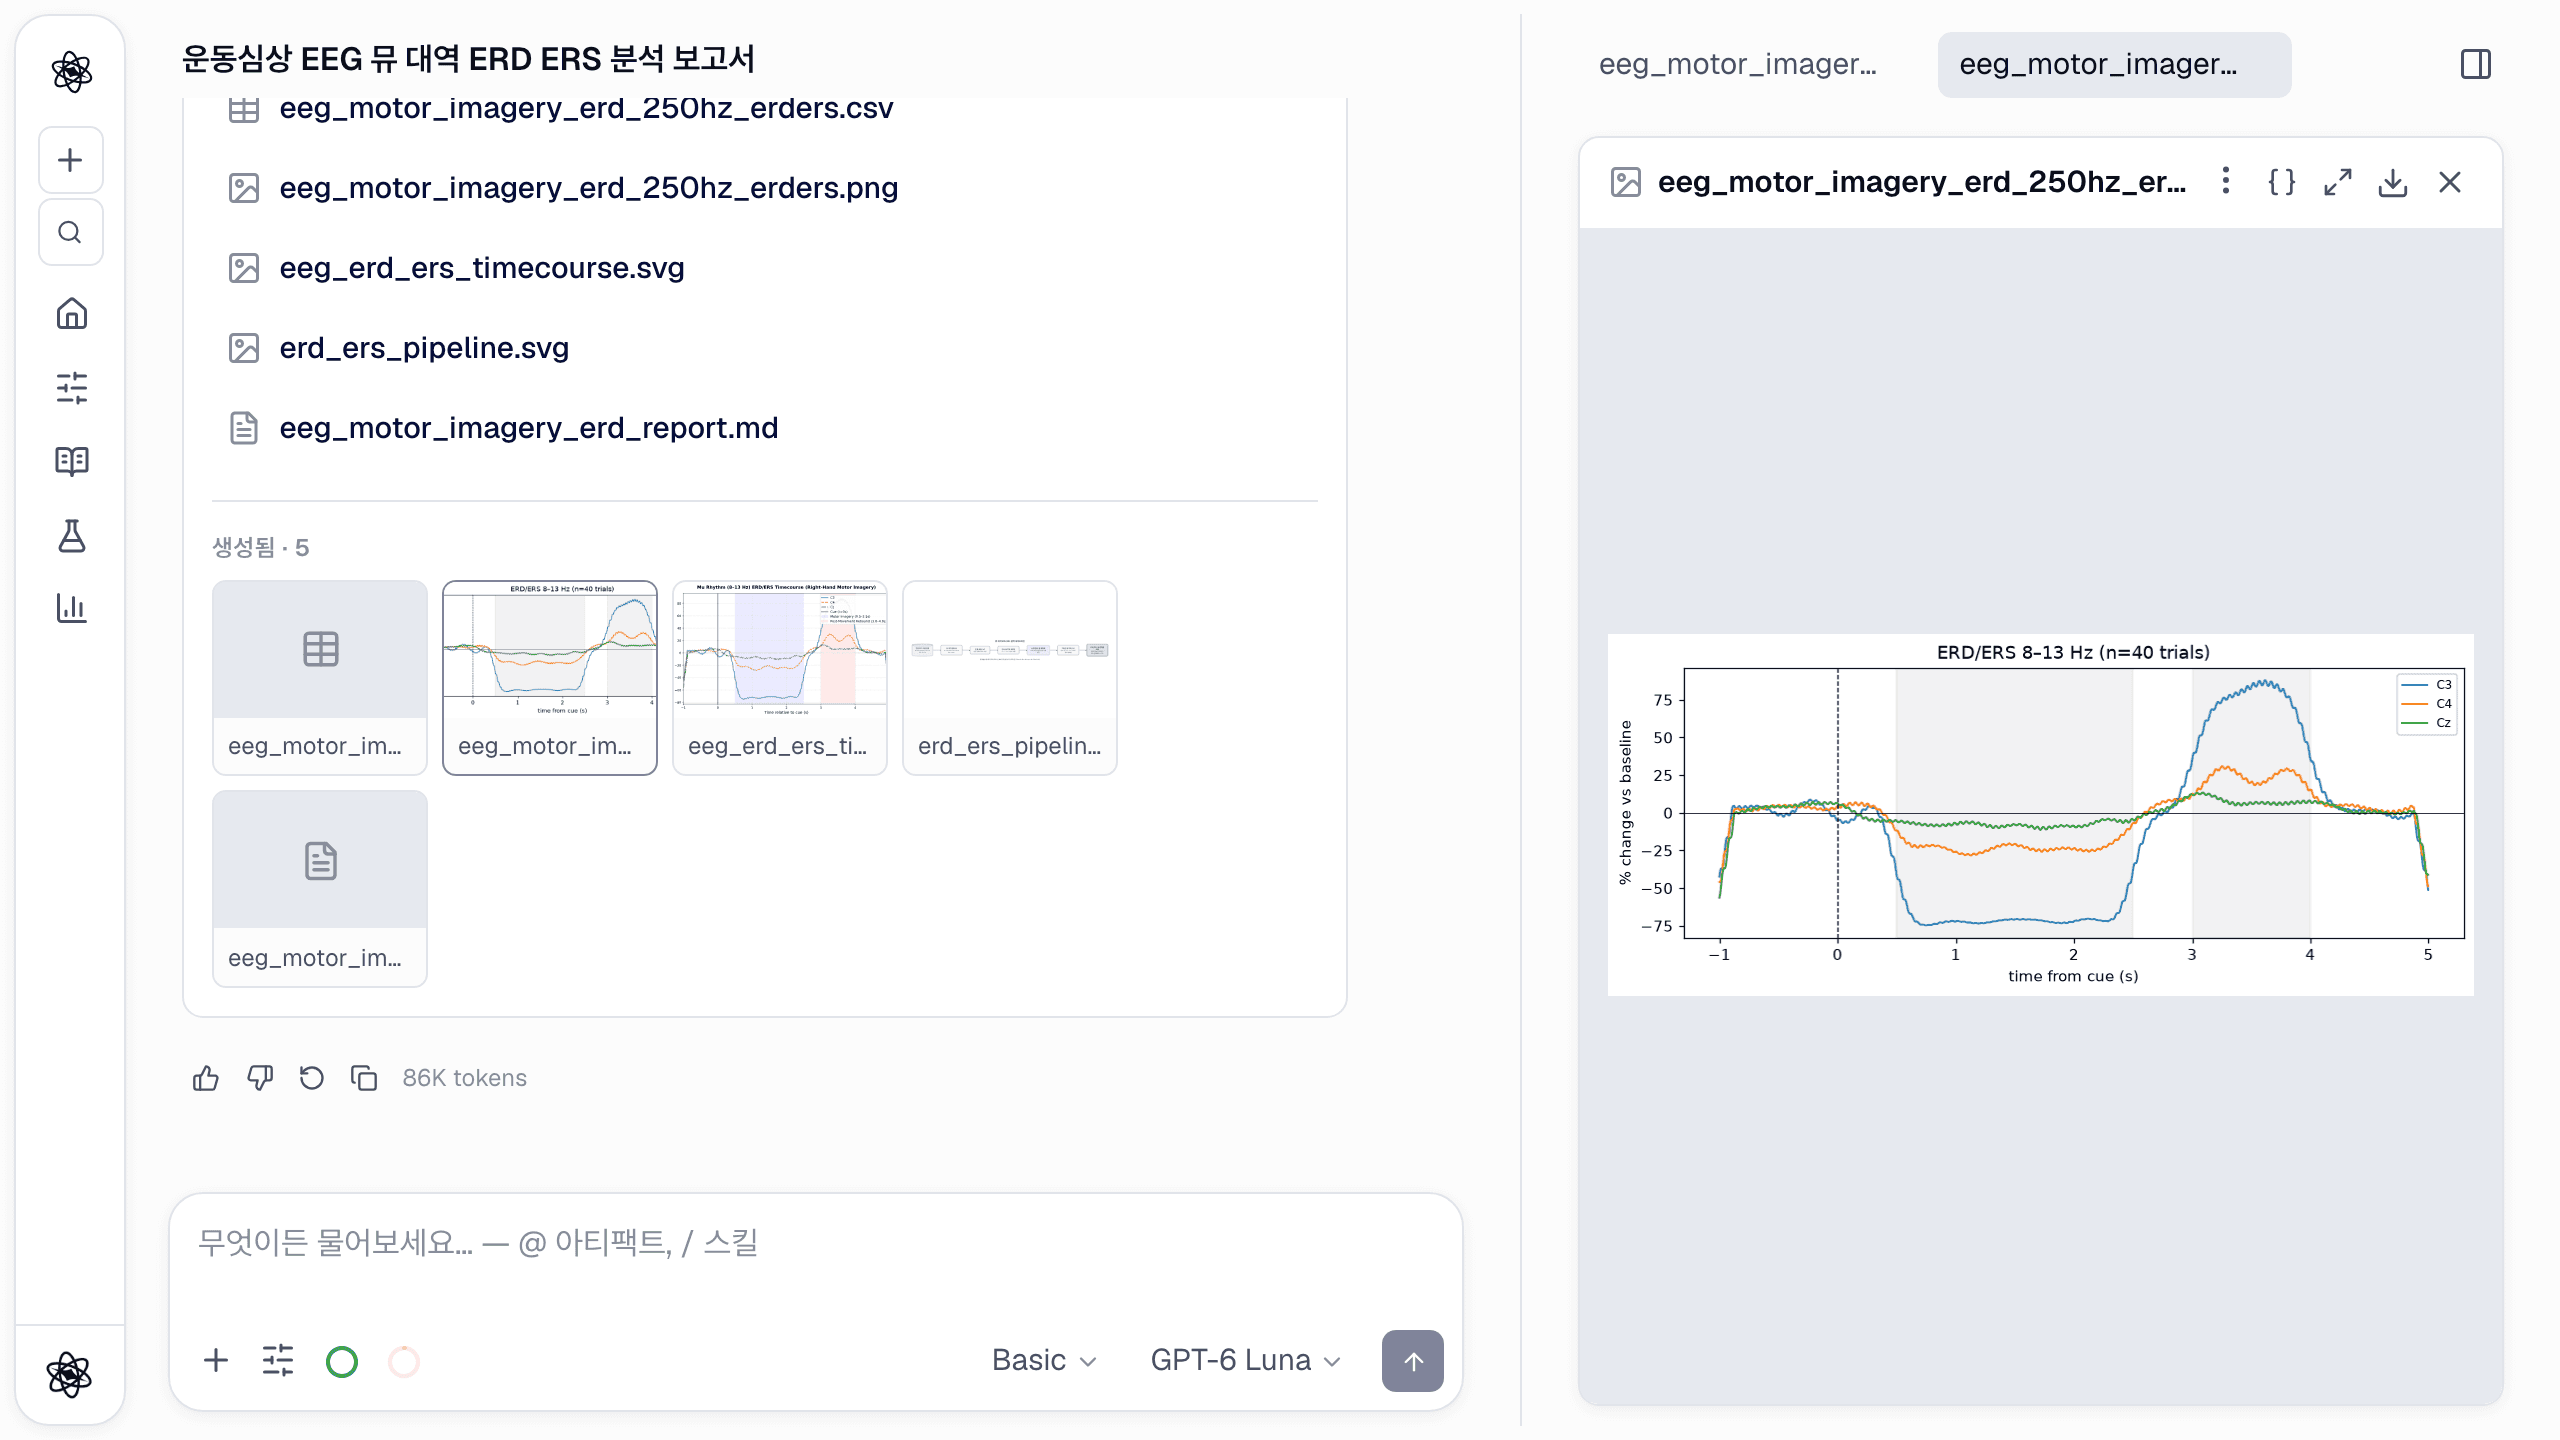
사용성 연구는 지저분한 산출물 더미를 만듭니다. 설문 내보내기, 화면 녹화, 인터랙션 로그, 아이트래킹 파일. 대부분의 팀은 그 더미에서 배우는 것보다 분석 가능한 형태로 조립하는 데 더 많은 시간을 씁니다. HCI 팀이 뉴트로픽에서 전체 파이프라인을 돌리는 방법을 소개합니다 — 모든 스크린샷은 두 UI 버전의 A/B 연구(샘플 데이터, 참가자 48명)를 다룬 실제 세션에서 가져왔습니다.
1단계 — 내보내기 파일을 넣고 무엇인지 말하기
Qualtrics나 CSV 내보내기를 첨부하고 설계를 한 메시지로 설명하세요. 뉴트로픽은 SUS, NASA-TLX, UEQ 문항 구조를 인식해 올바른 채점(역채점 문항 포함)을 적용하고, 점수와 함께 신뢰도가 포함된 척도 통계를 보고합니다 — 의심스러운 알파가 스프레드시트 안에 숨을 수 없습니다.
/analyze usability_ab_study.csv is a between-subjects usability study of two UI versions (A vs B, 48 participants): SUS items sus1-sus10 (1-5), NASA-TLX subscales (0-100), task_time_s, and errors. Score SUS and NASA-TLX, compare the versions on SUS, workload, task time, and errors with effect sizes, and produce a summary dashboard figure.
2단계 — 질문을 먼저 말하는 리포트 읽기
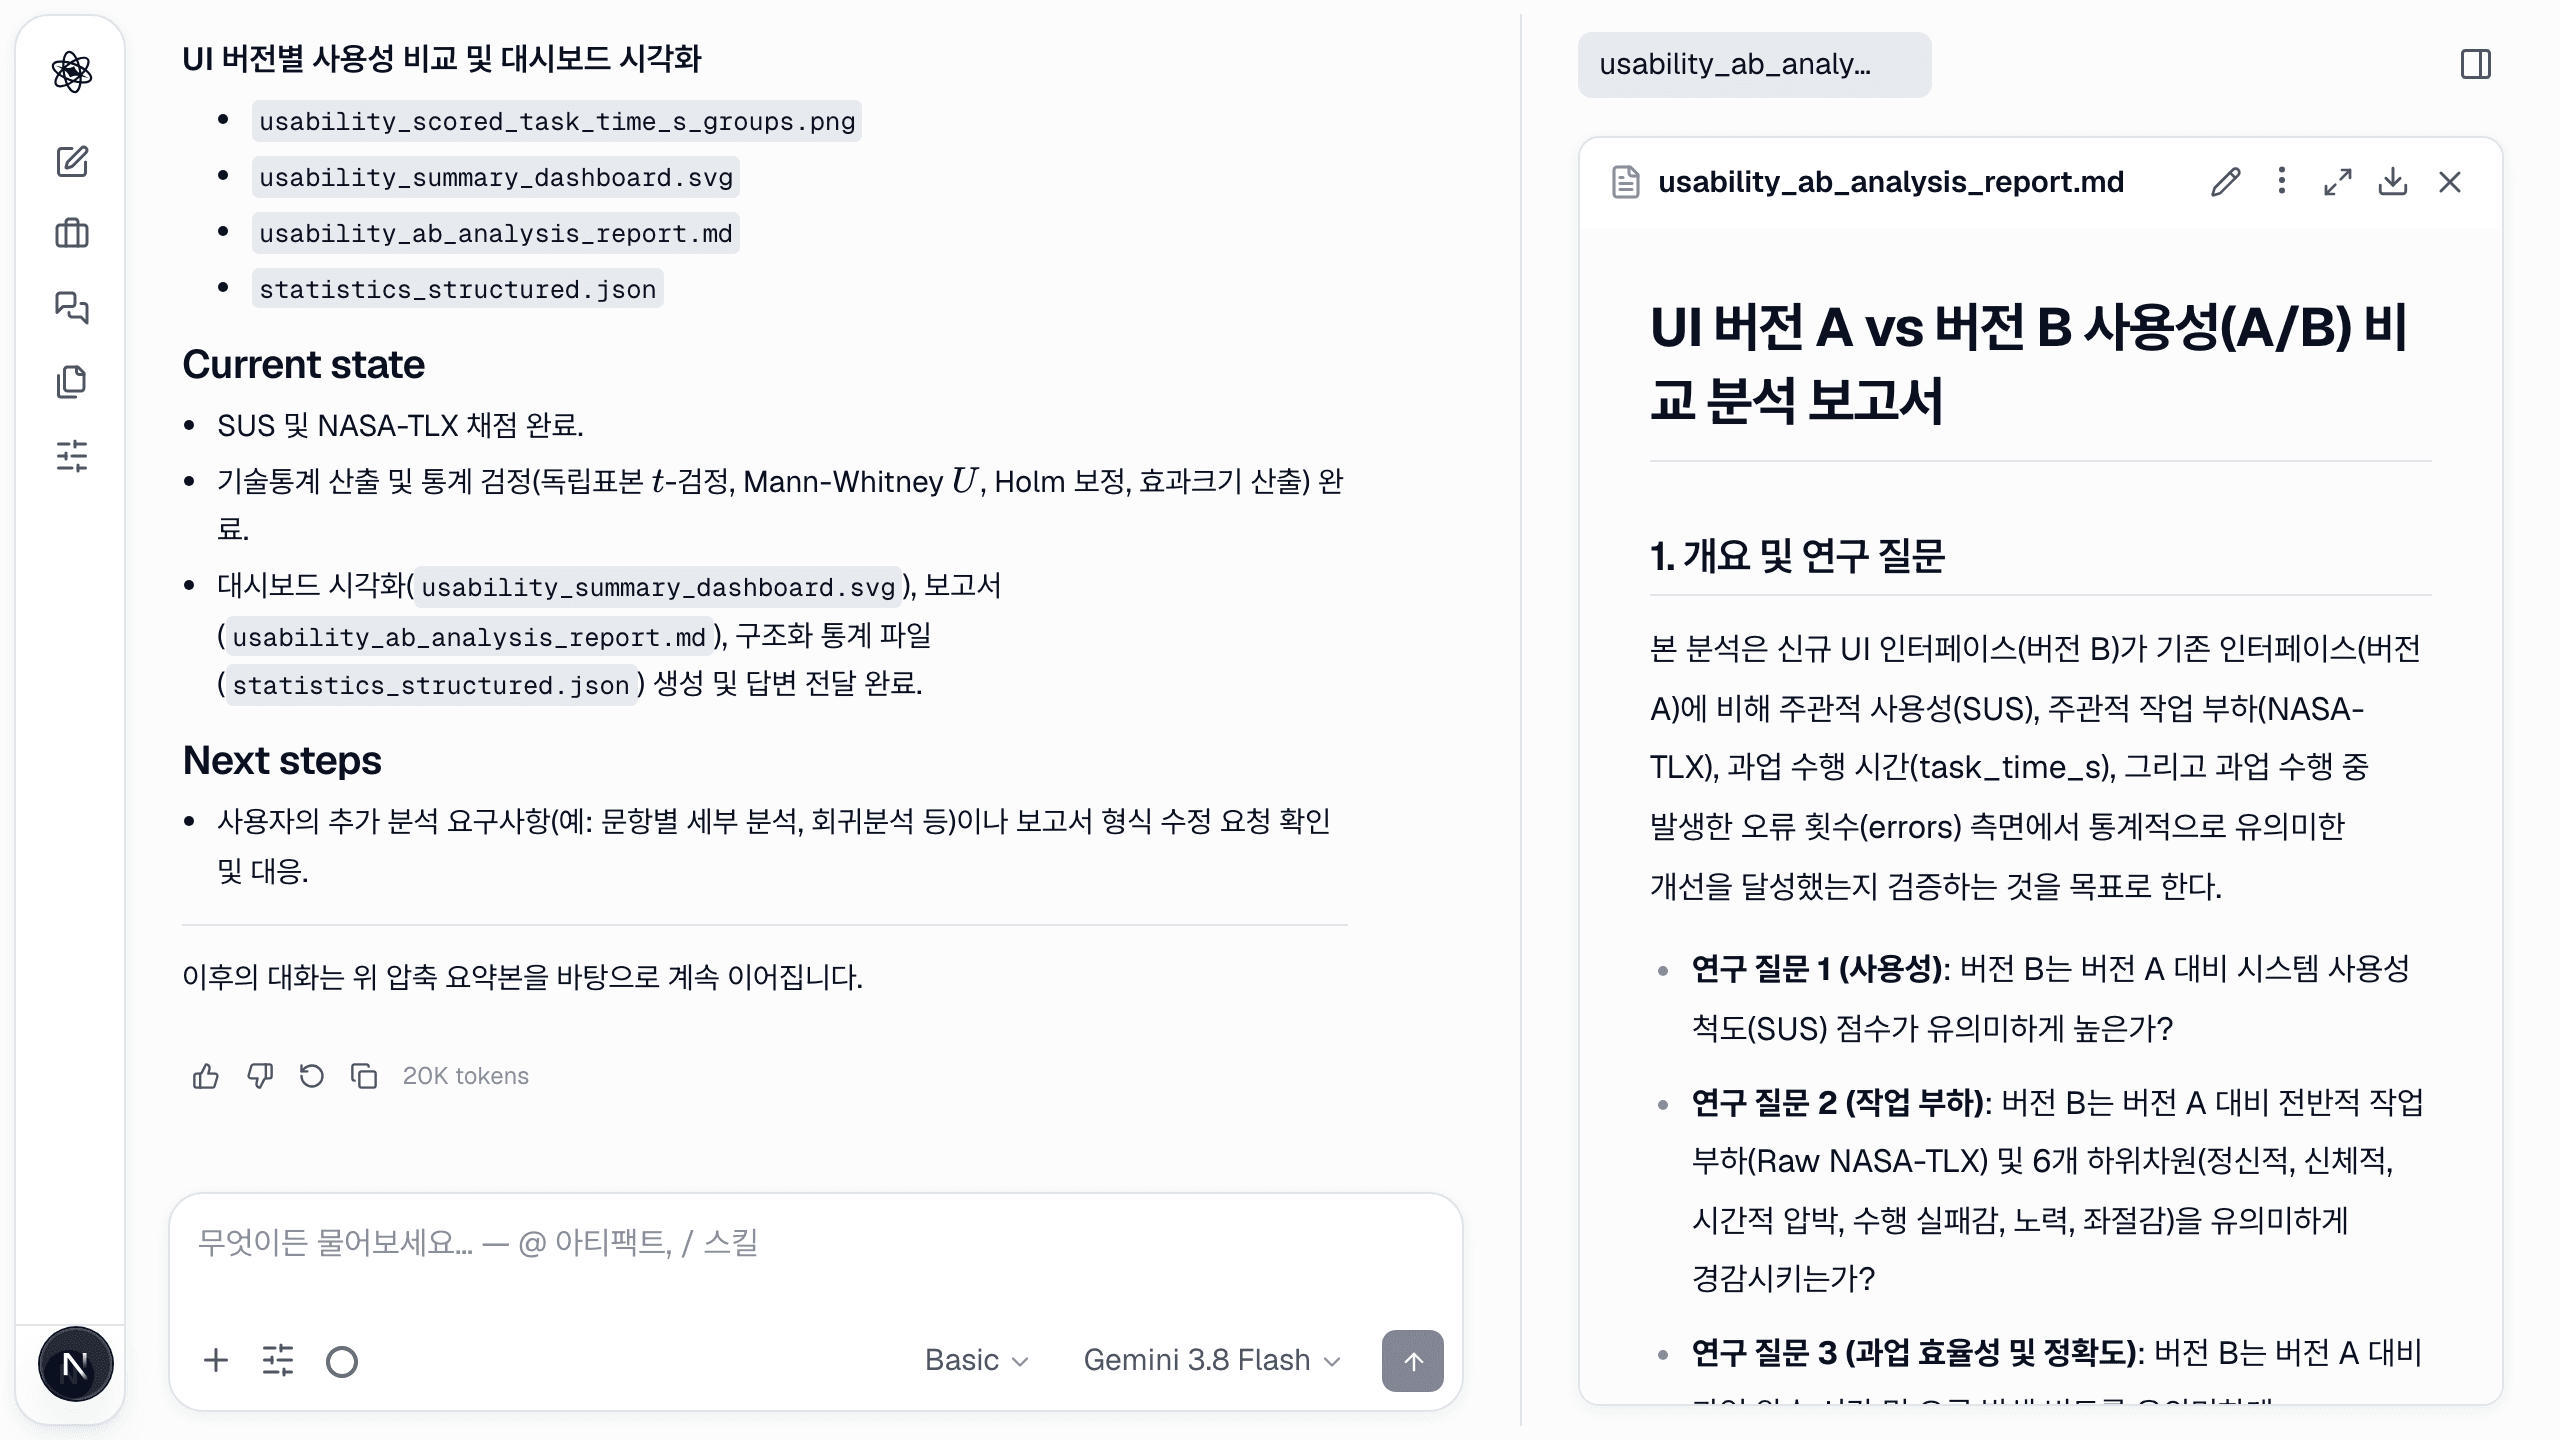
분석 리포트는 어떤 비교보다 먼저 연구 질문, 데이터셋과 품질 감사(48행, 결측 없음, SUS 문항 모두 범위 내)로 시작합니다 — 메시지 하나에서 열두 개의 산출물이 나옵니다: 채점 표, 측정치별 그룹 플롯, 기술통계, 대시보드.
3단계 — 올바른 검정을 쓰는 A/B 테스트
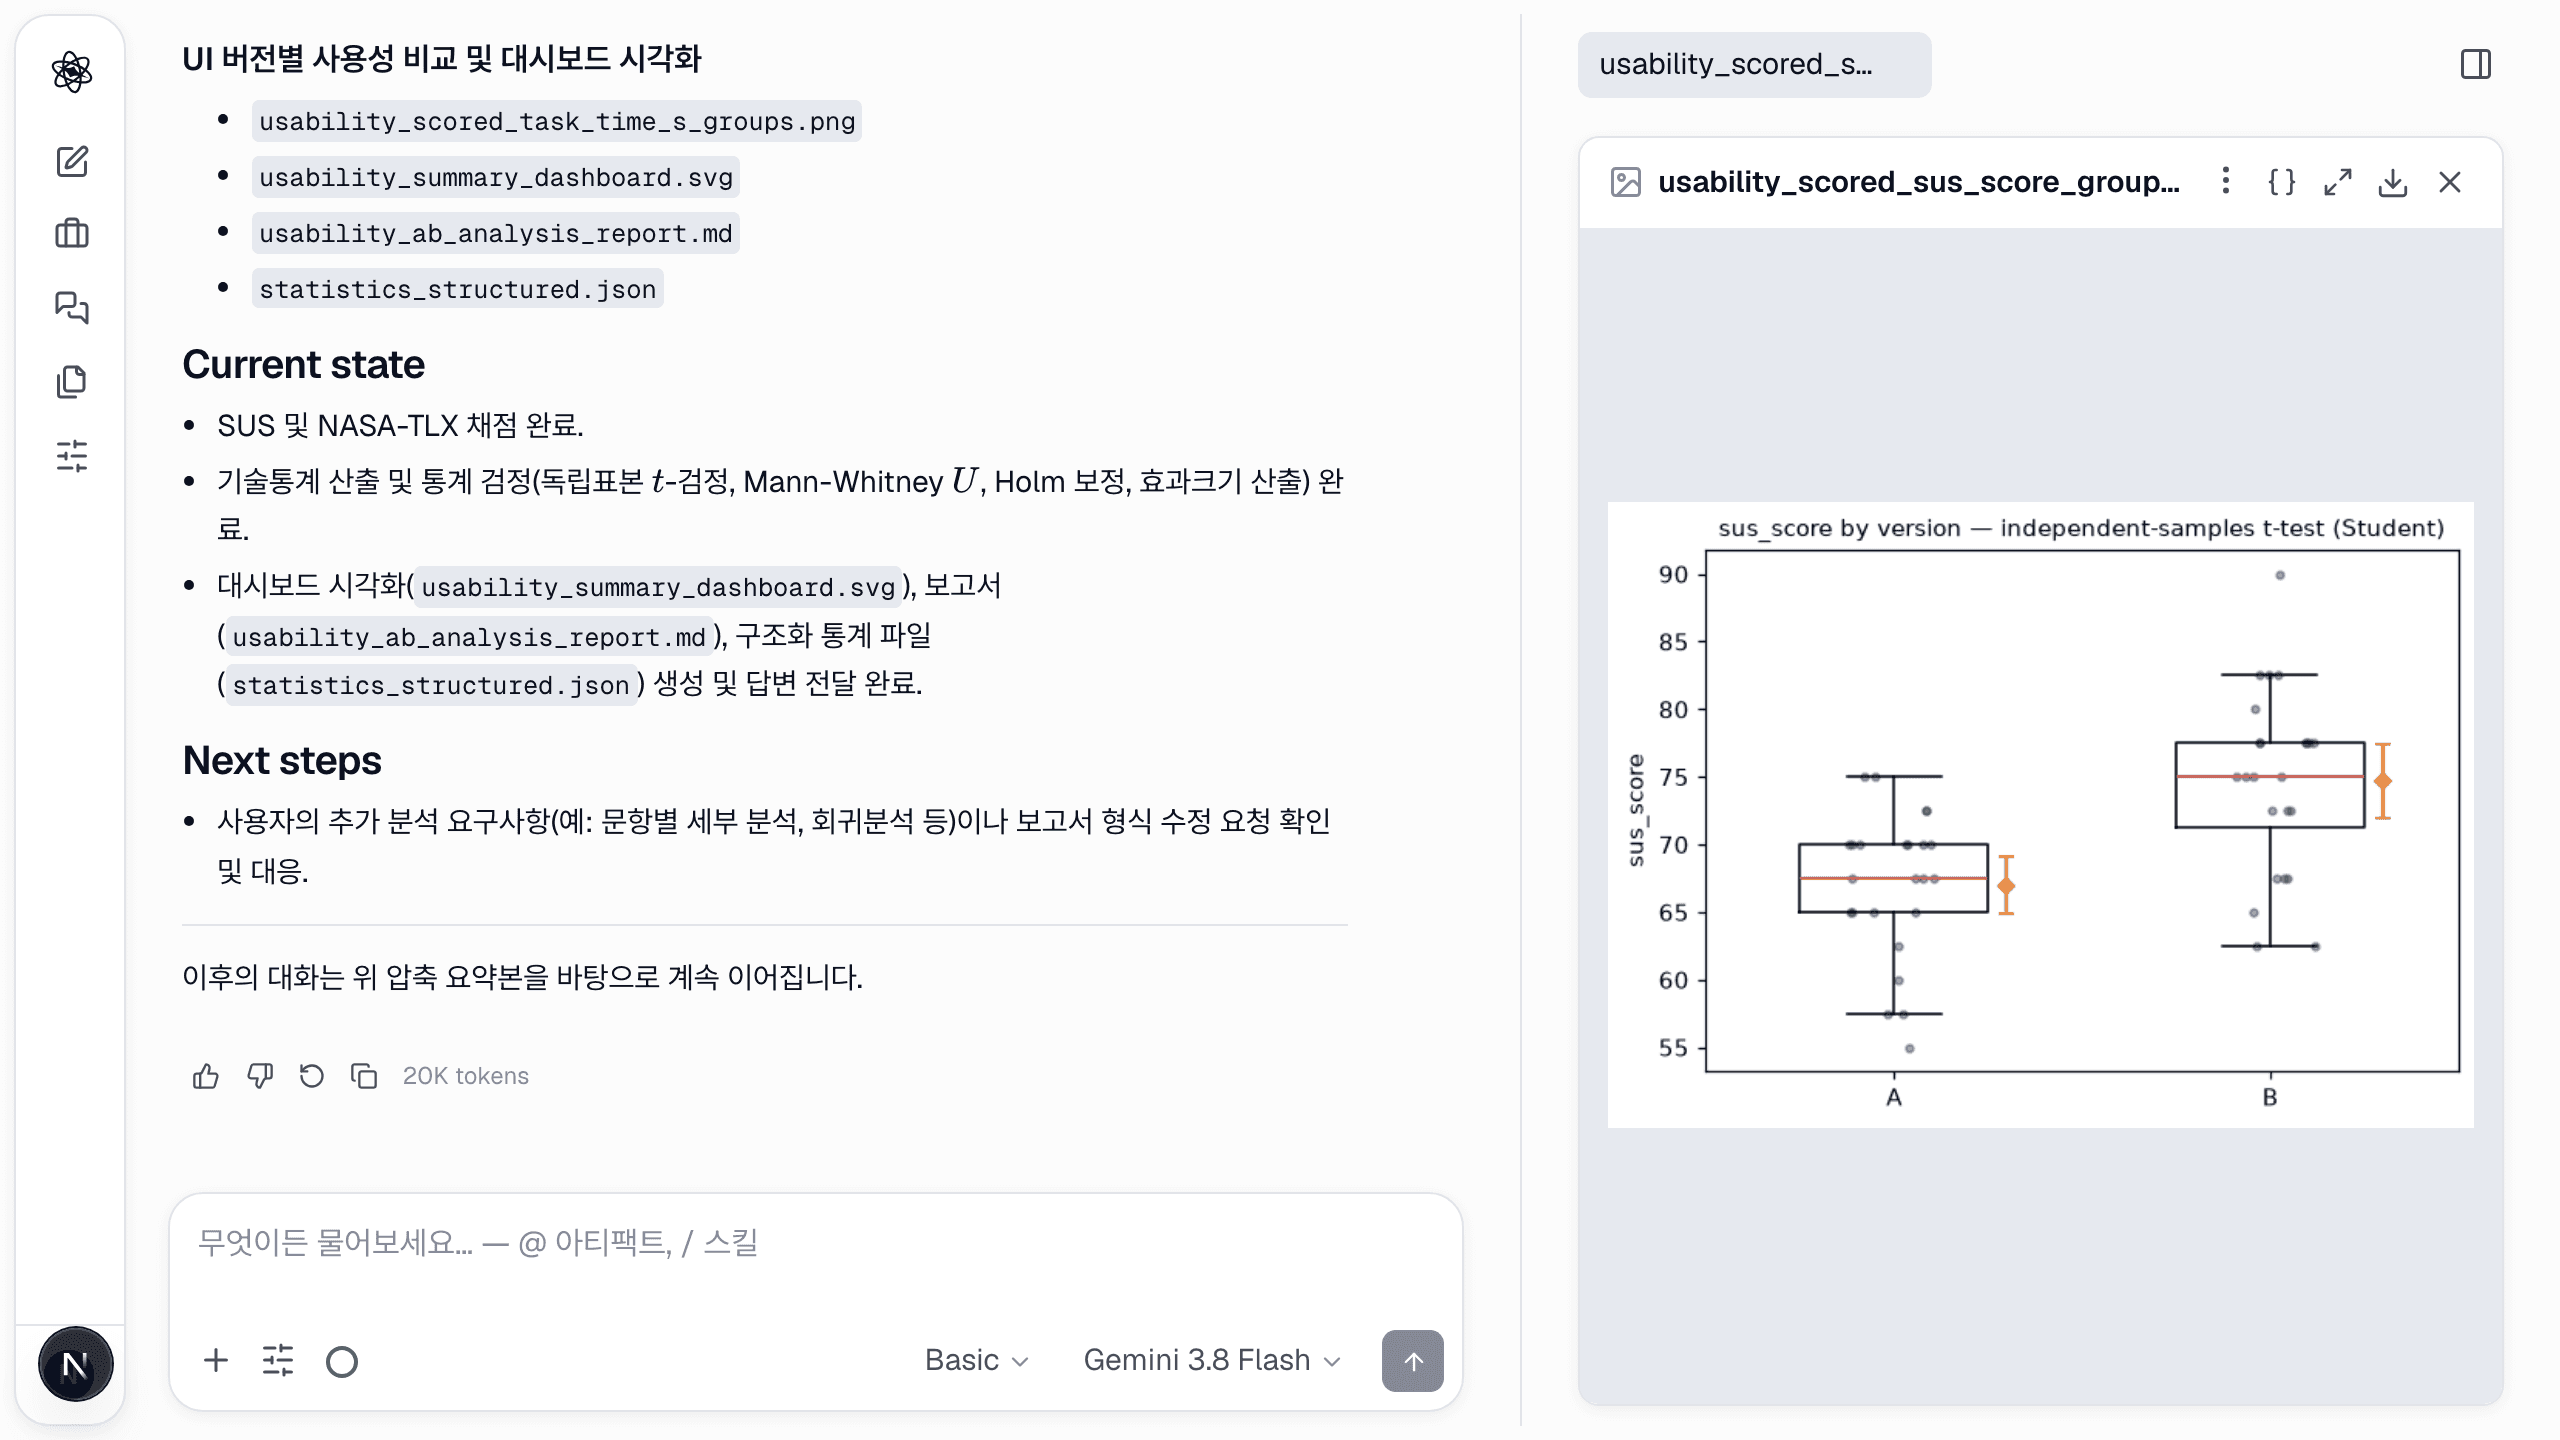
설계 — 피험자 간 또는 내, 결과 측정치, 표본 — 를 설명하면 에이전트가 분석을 고르고 정당화합니다. Deep 수준에서는 검토 에이전트가 그 선택을 검증합니다. 결과는 p값만이 아니라 신뢰구간이 붙은 효과 추정치와 평이한 해석으로 돌아옵니다.
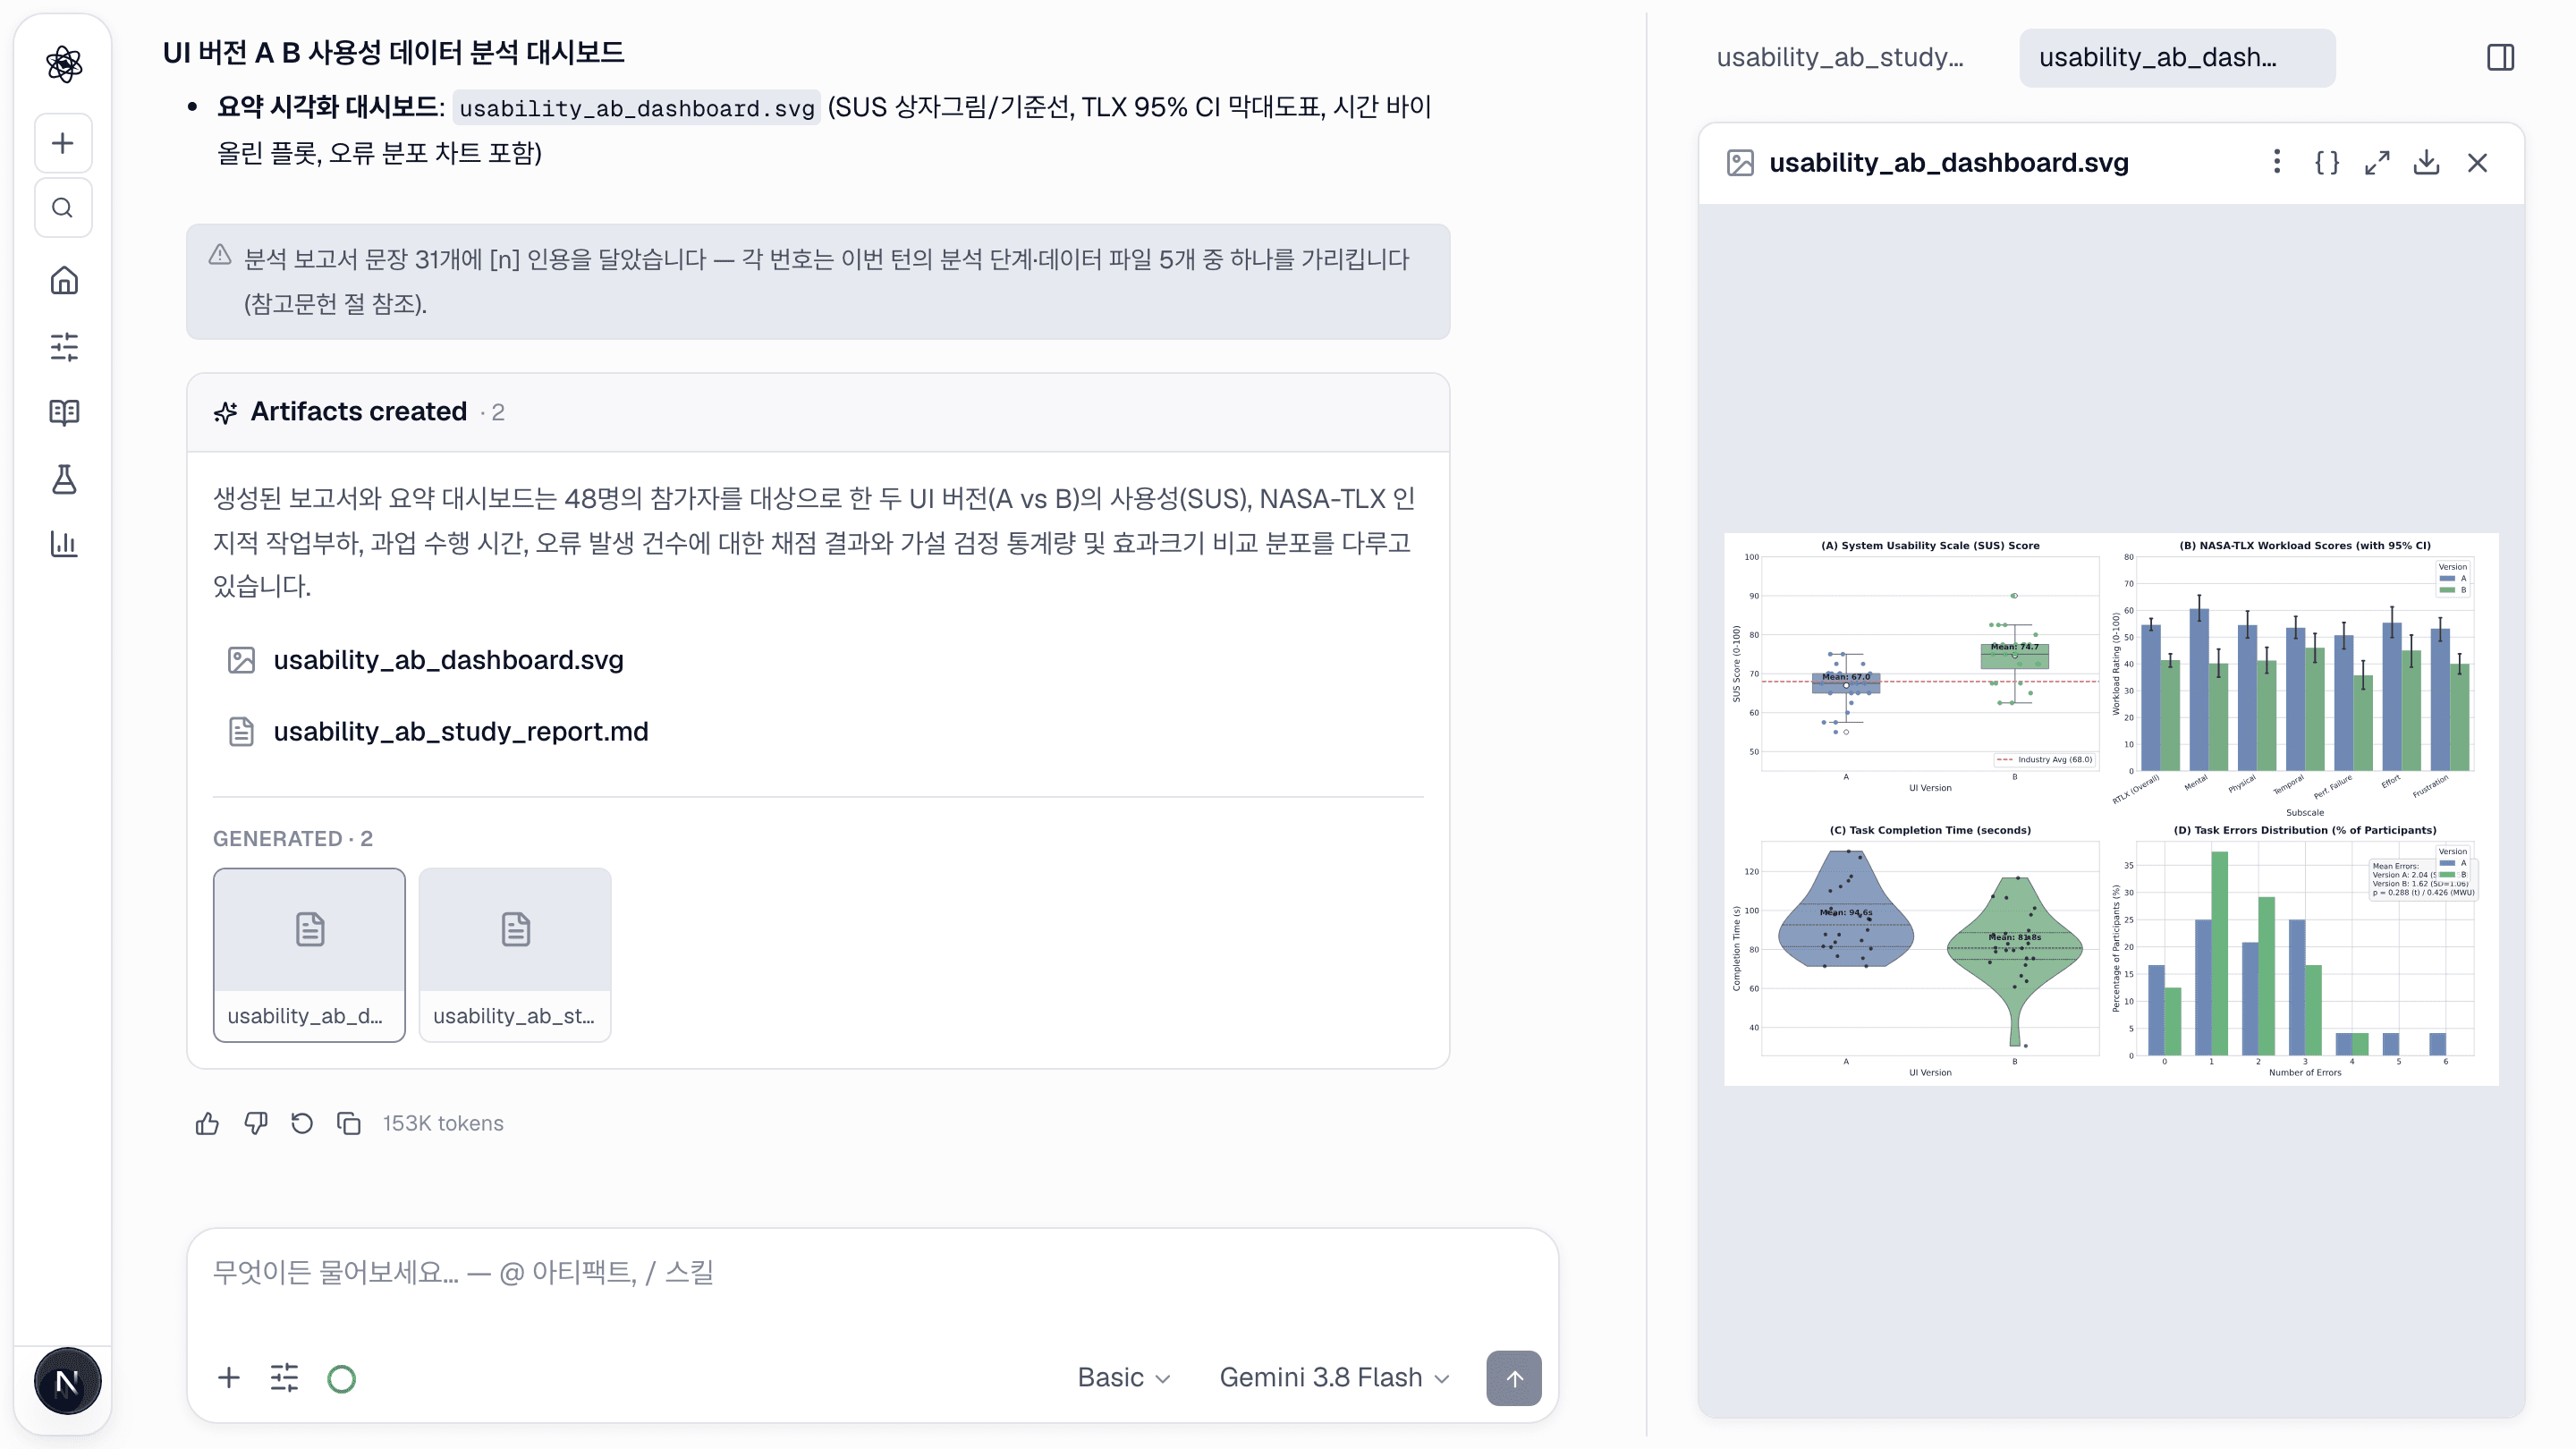
4단계 — 디자인 리뷰용 대시보드 하나
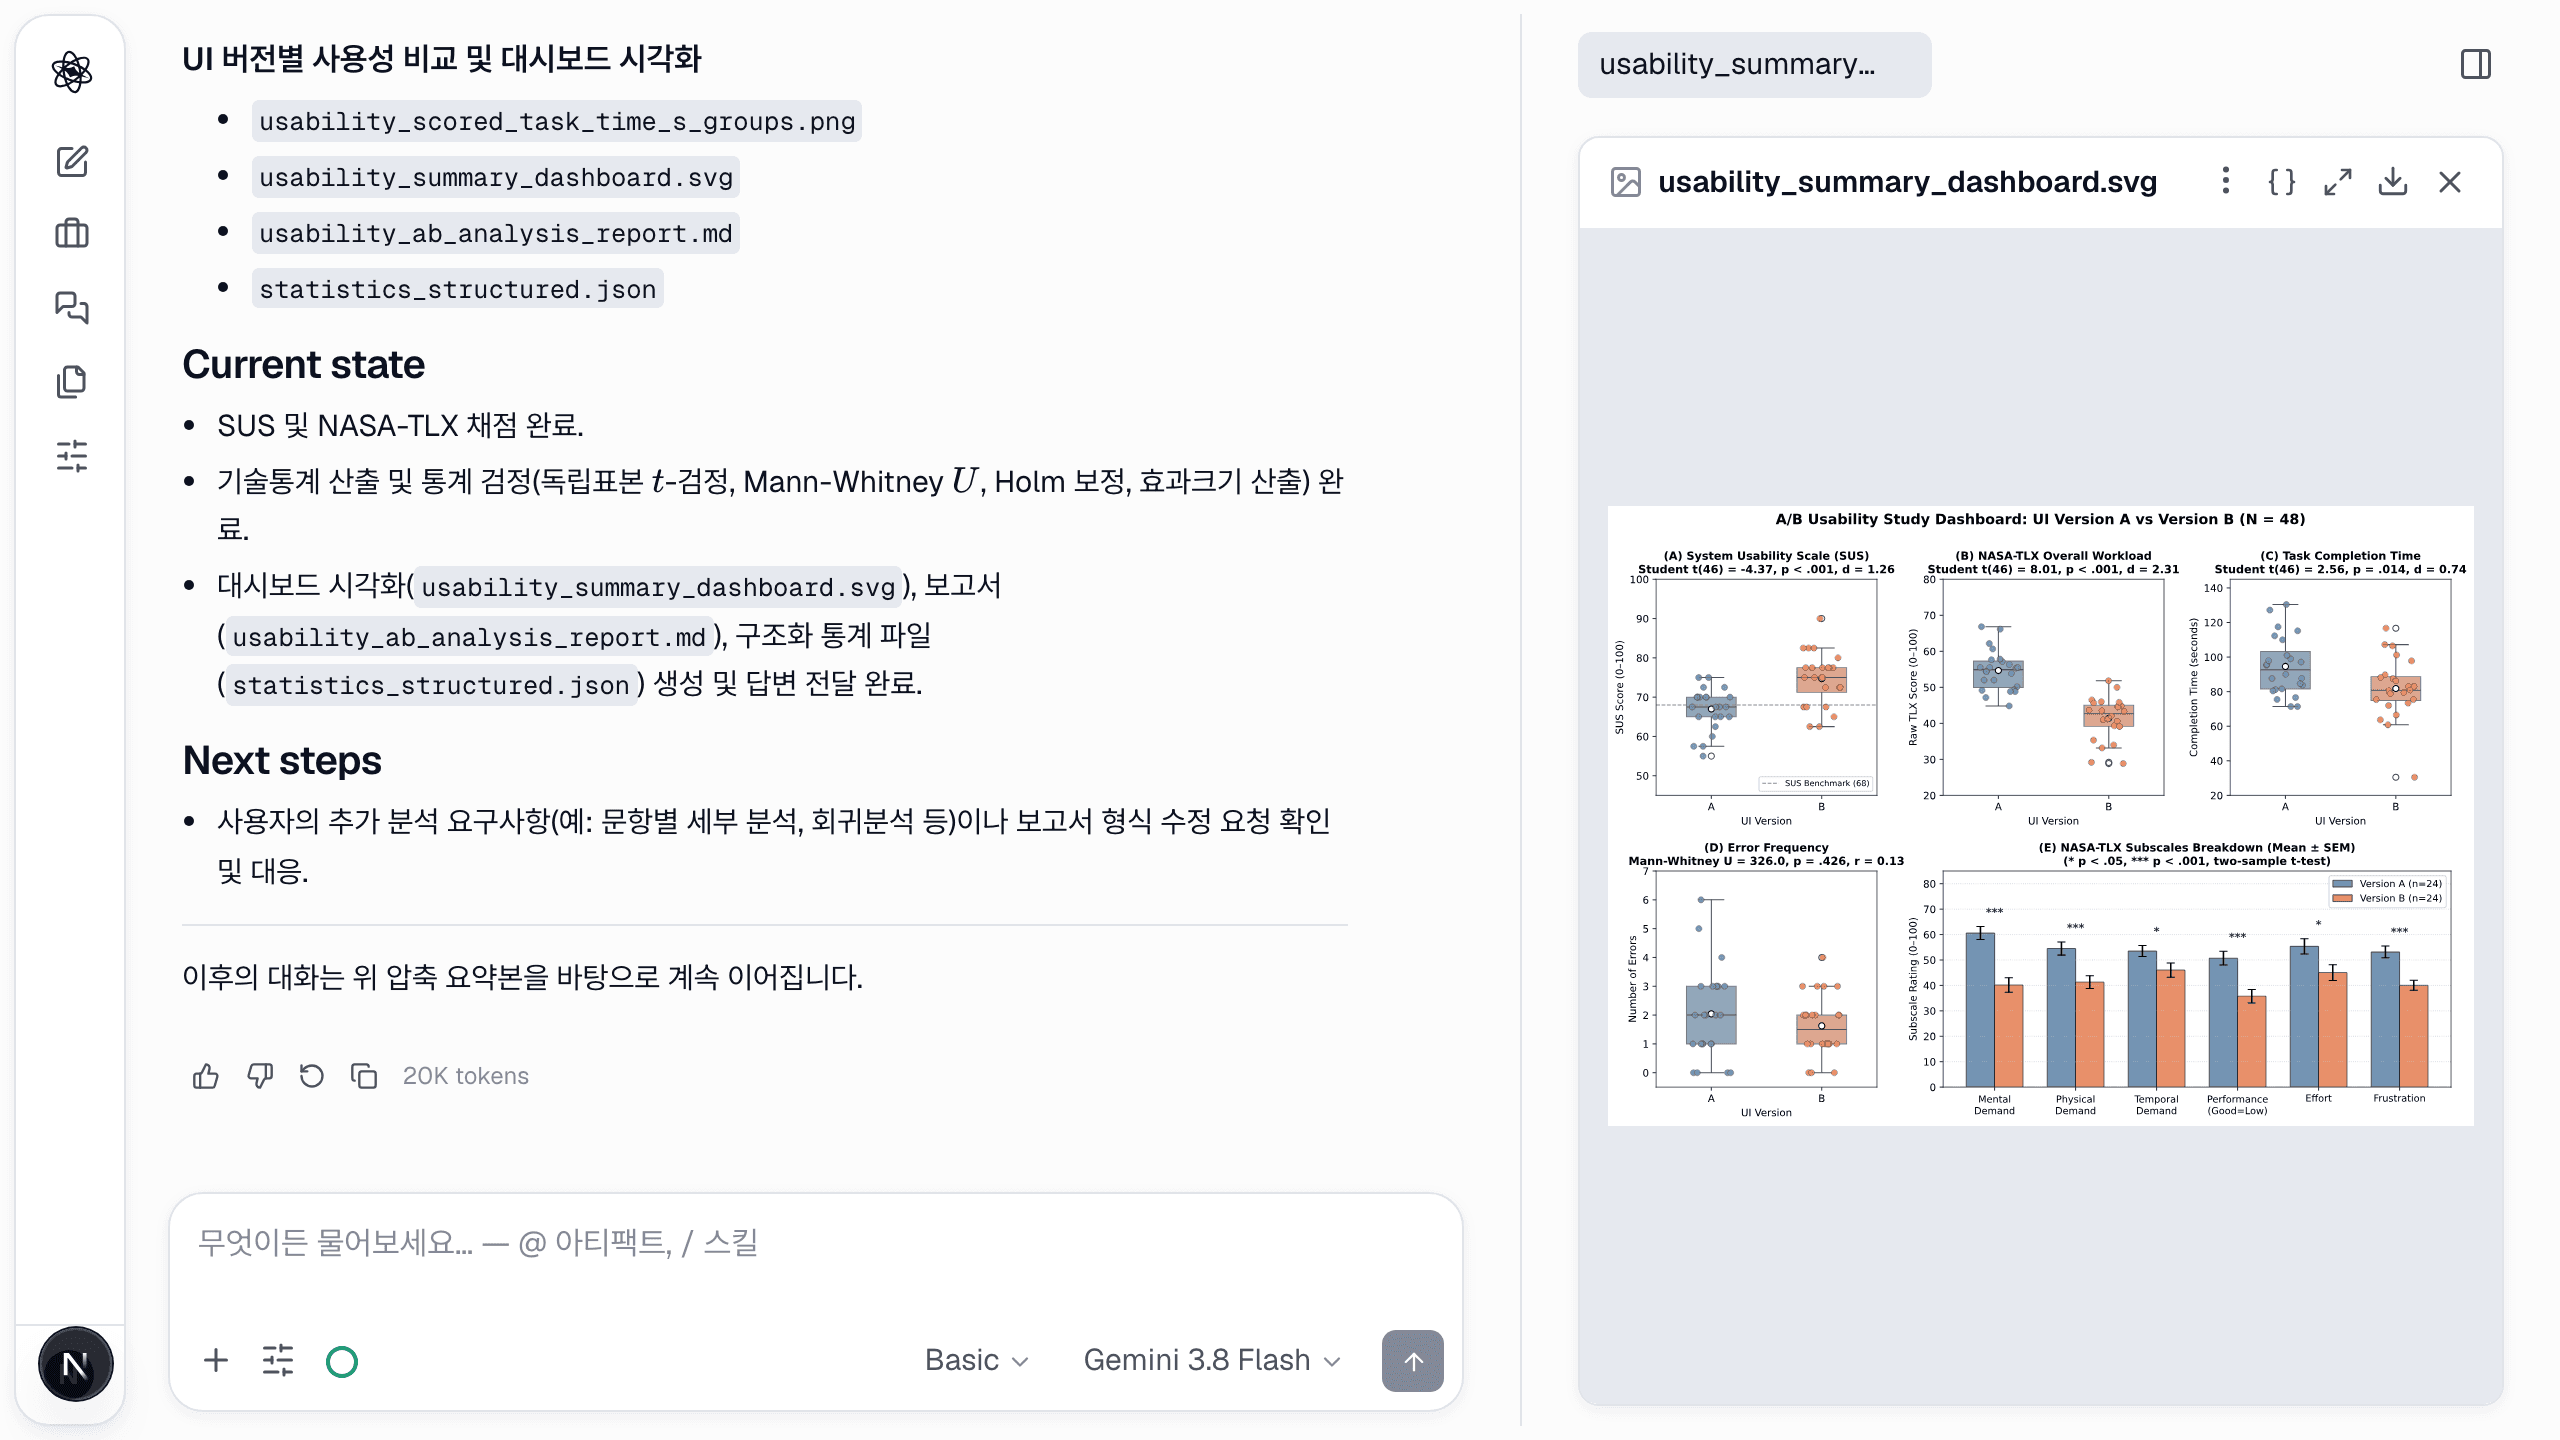
대시보드를 요청하면 네 가지 결과가 하나의 그림으로 구성되고, 각 패널에 검정 통계량과 효과크기가 붙습니다: SUS t(46) = −4.37, d = 1.26; NASA-TLX d = 2.31; 과업 시간 d = 0.74; 오류 Mann–Whitney, r = 0.13.
인터랙션 로그와 시선
- 이벤트 로그 내보내기(조건별 과업 시간·오류·완료율)는 다른 데이터셋처럼 분석됩니다 — 요약과 올바른 검정을 쓴 집단 비교가 그것을 만든 코드와 함께 저장됩니다.
- 아이트래킹 내보내기는 고정 횟수·고정 지속시간과 히트맵이 됩니다. 어느 영역에 고정이 가장 많았는지 물으면 수치와 그림으로 답합니다.
완전히 추적 가능한 리포트 하나
마지막에는 모든 그림이 그것을 만든 코드와 데이터로 연결되는 리포트를 얻습니다 — 오늘 디자인 리뷰에 바로 쓸 수 있고, 한 분기 뒤 누군가 의문을 제기해도 재현됩니다.