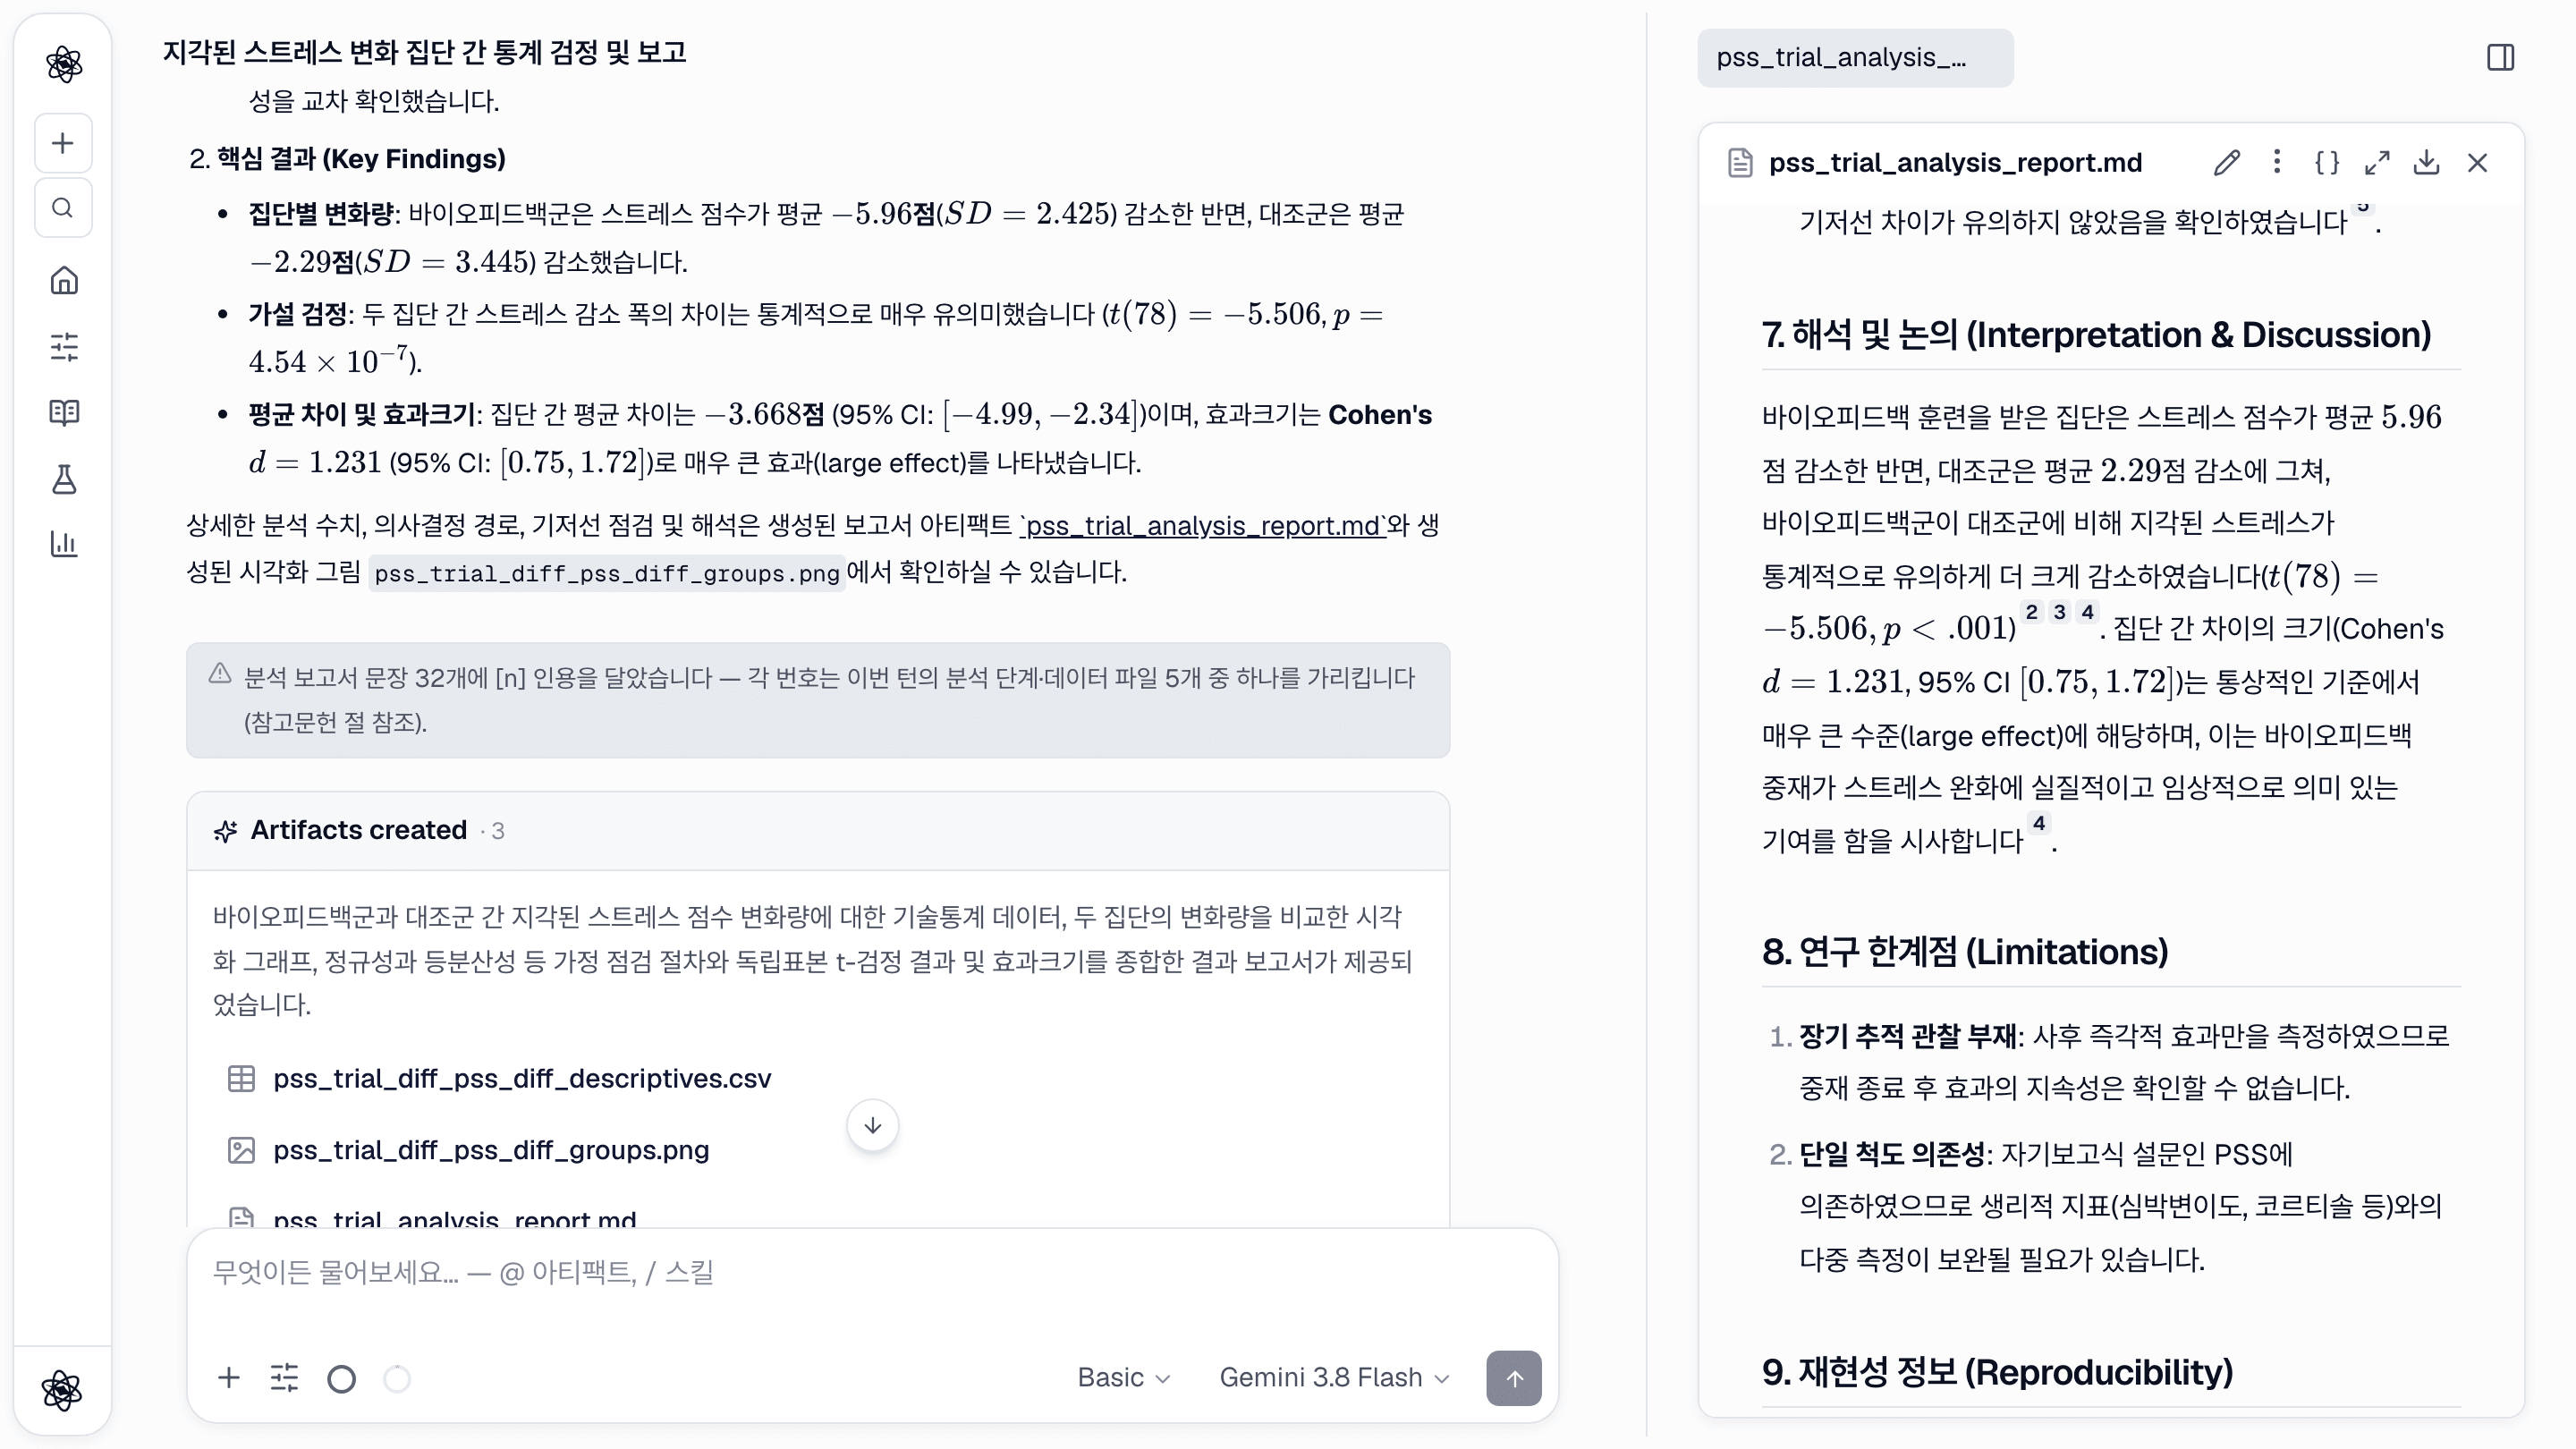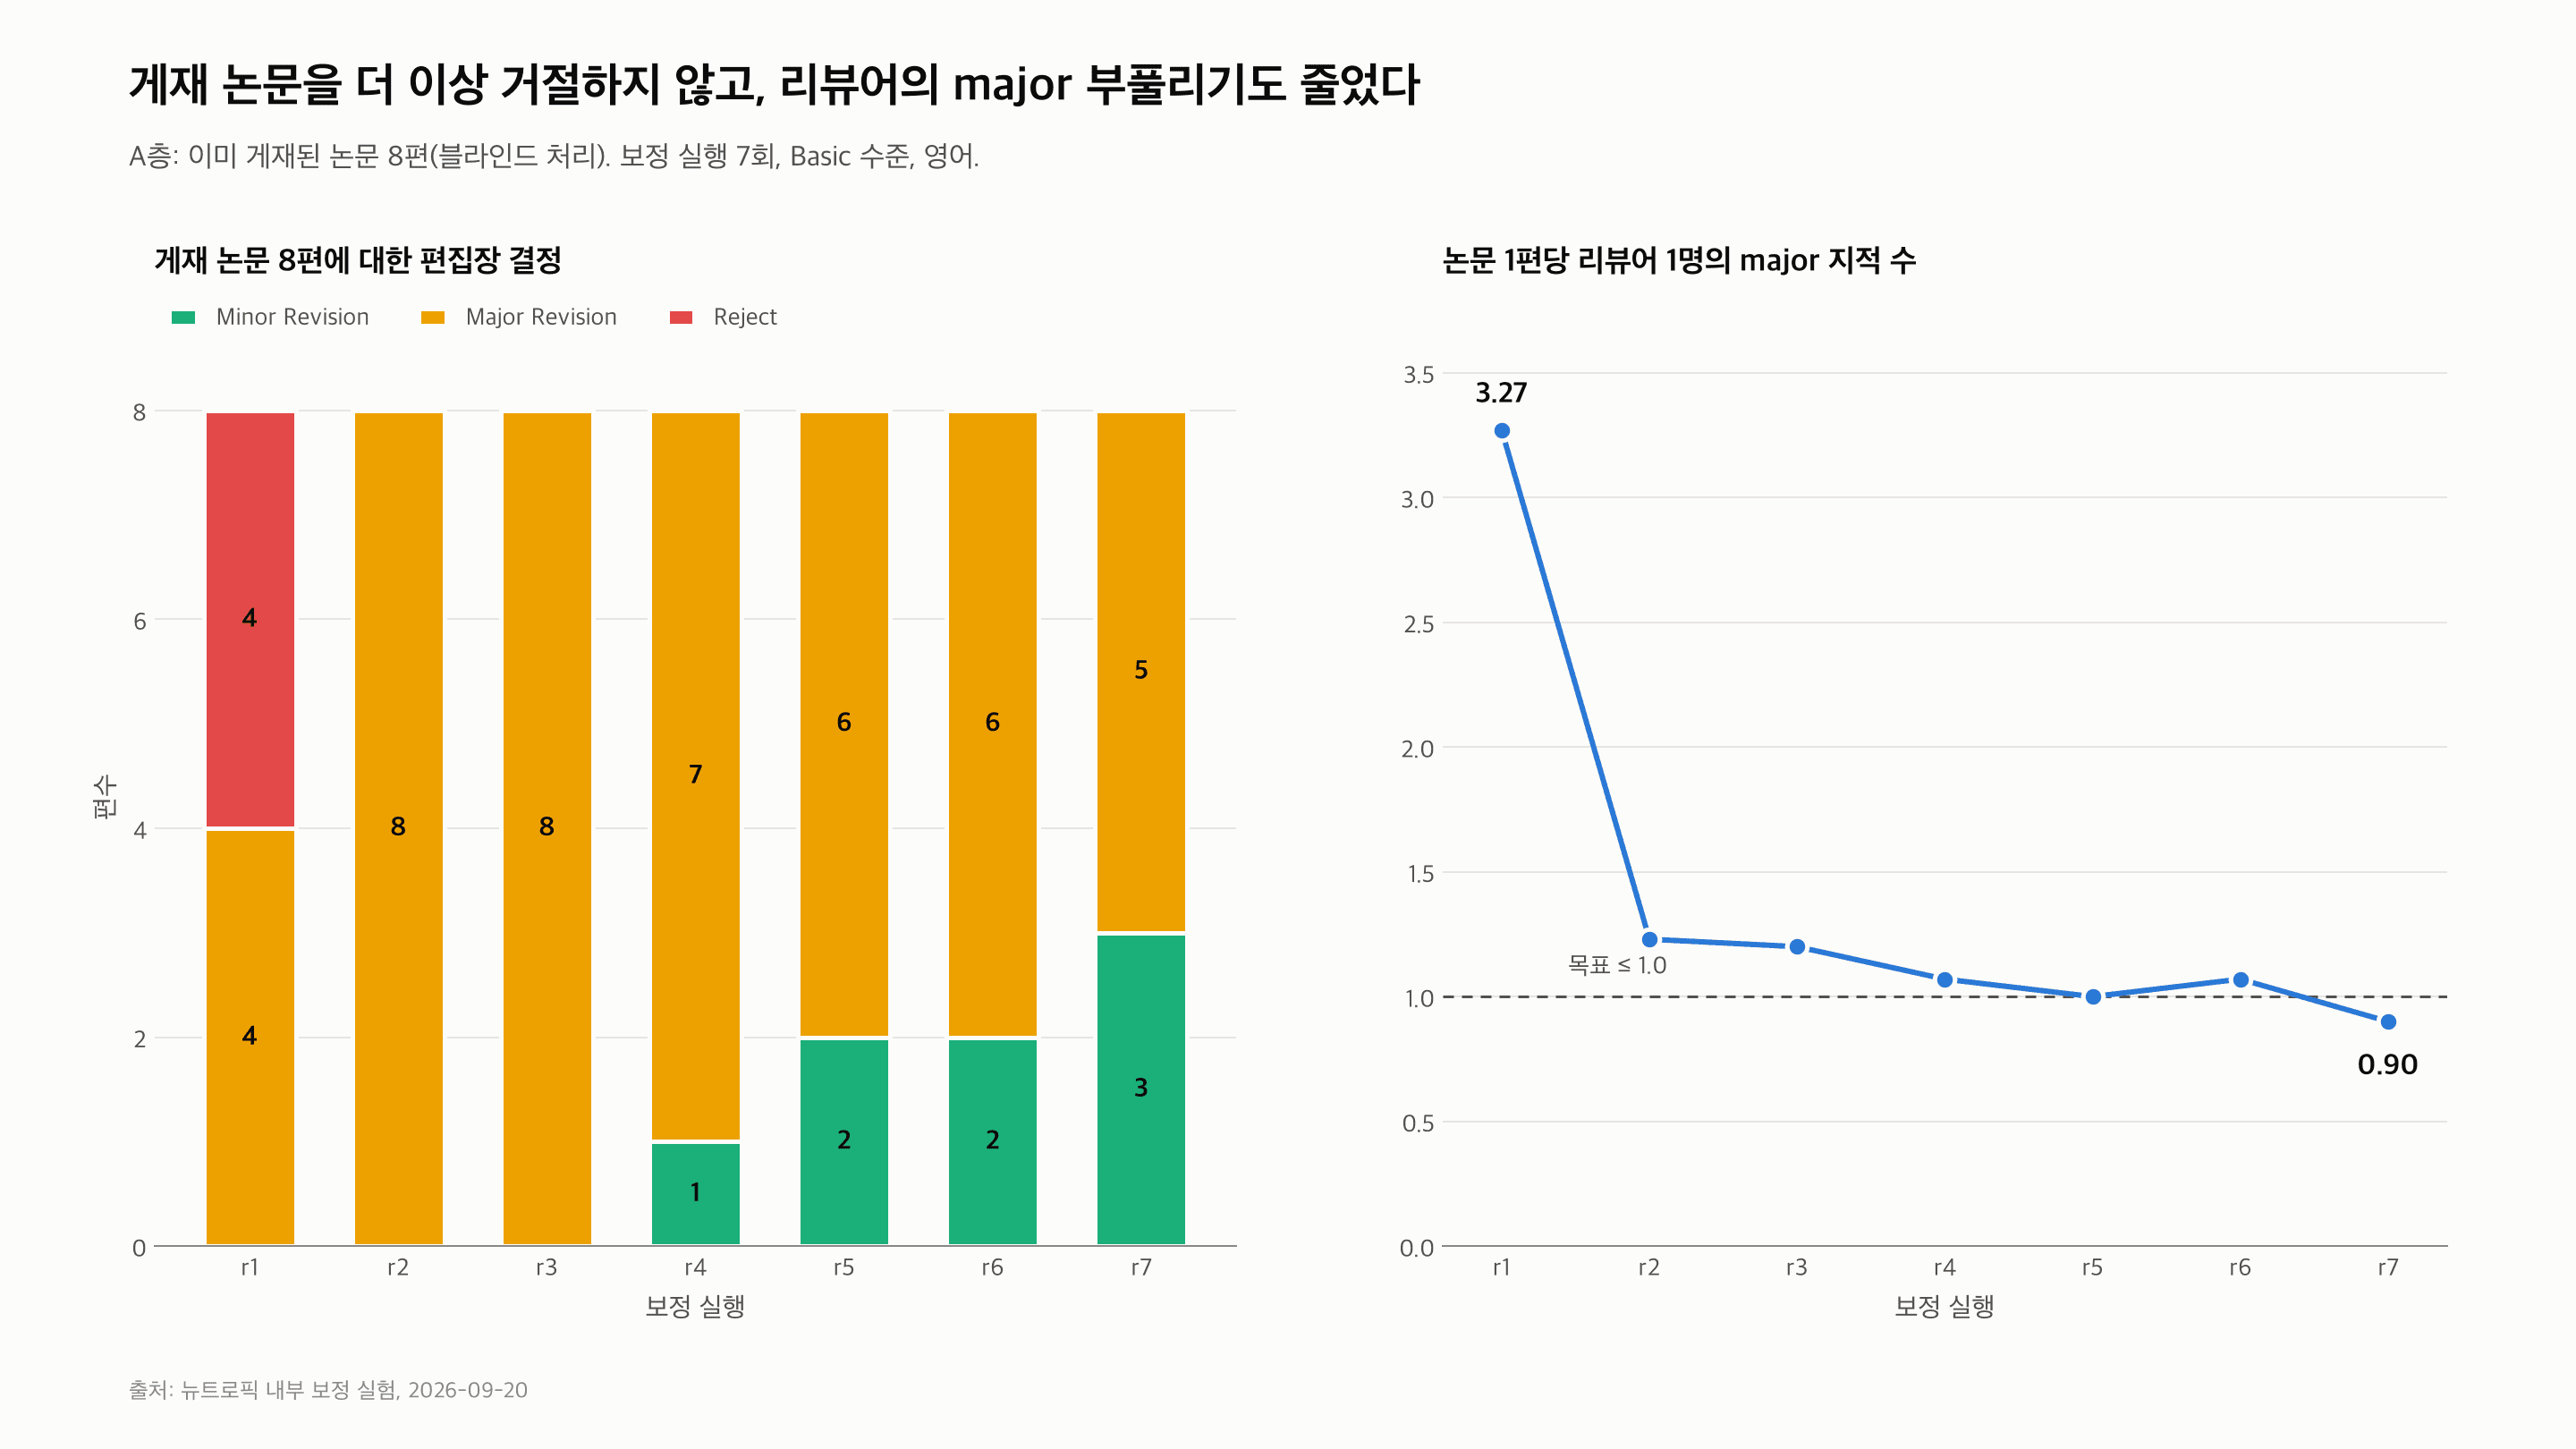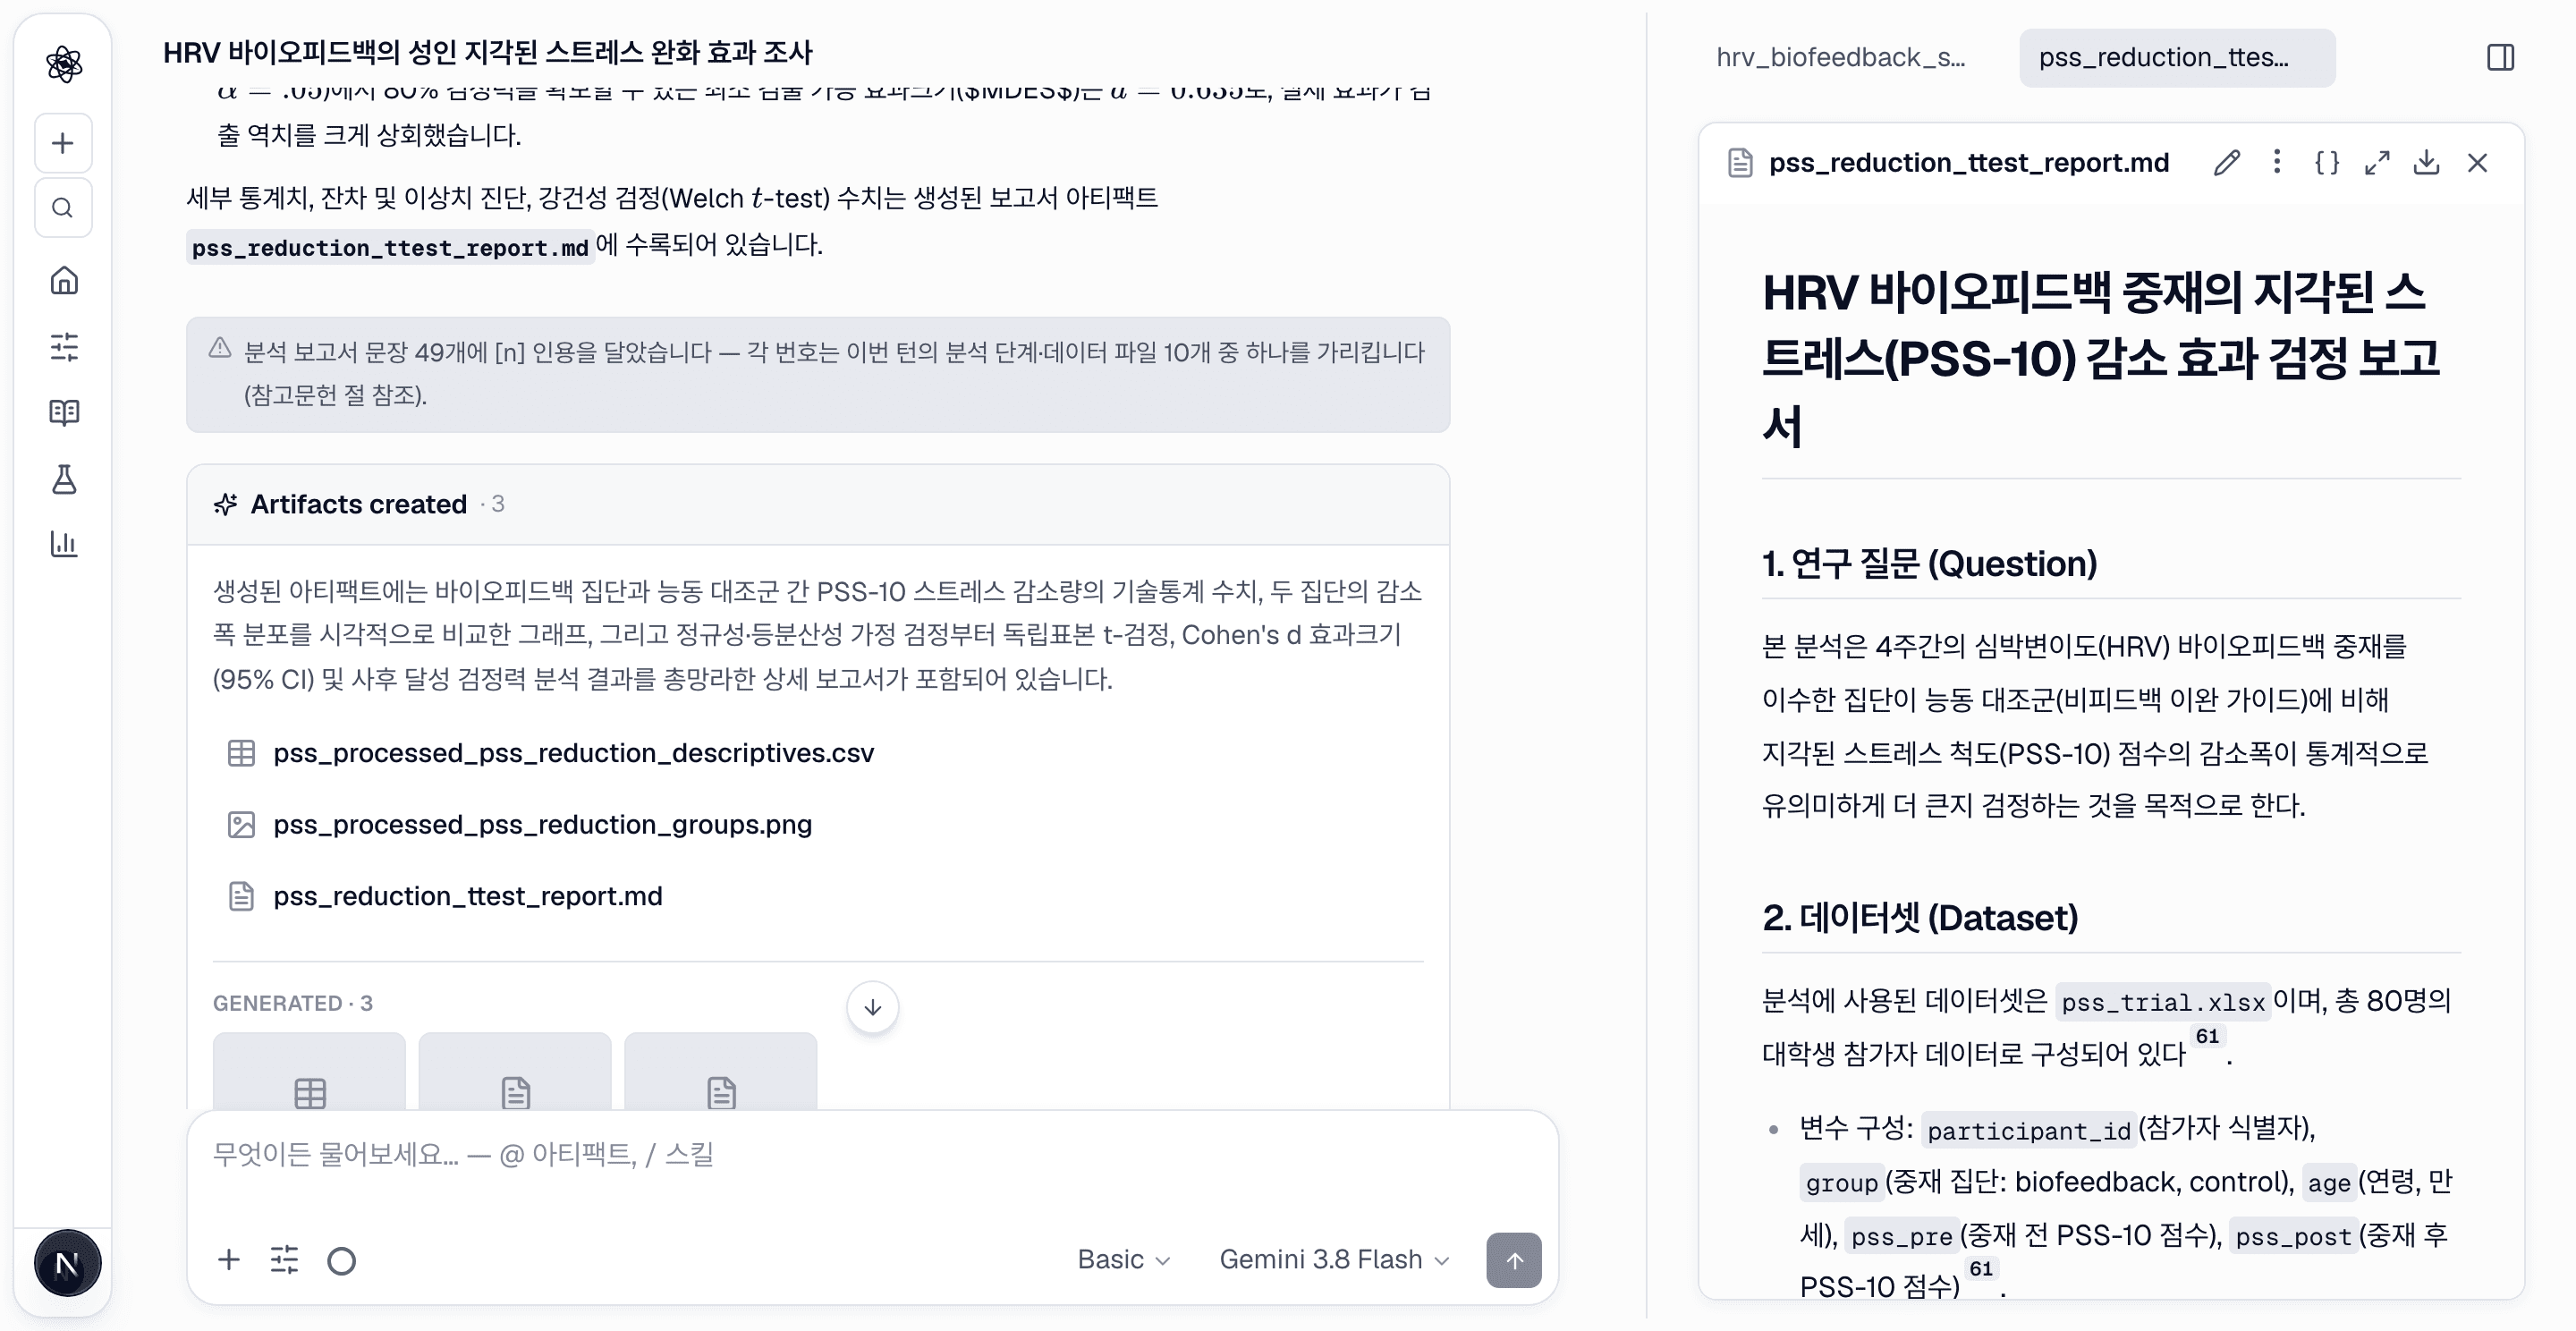
분석을 만들고 자기 작업을 채점까지 하는 단일 모델에는 명백한 이해 충돌이 있습니다. 뉴트로픽은 두 역할을 분리합니다. 생성 에이전트가 분석을 실행하고, 독립적인 검토 에이전트가 당신이 결과에 기대기 전에 그것을 점검합니다. 실제 원고에서 어떻게 보이는지 아래에 있습니다.
검토 에이전트가 점검하는 것
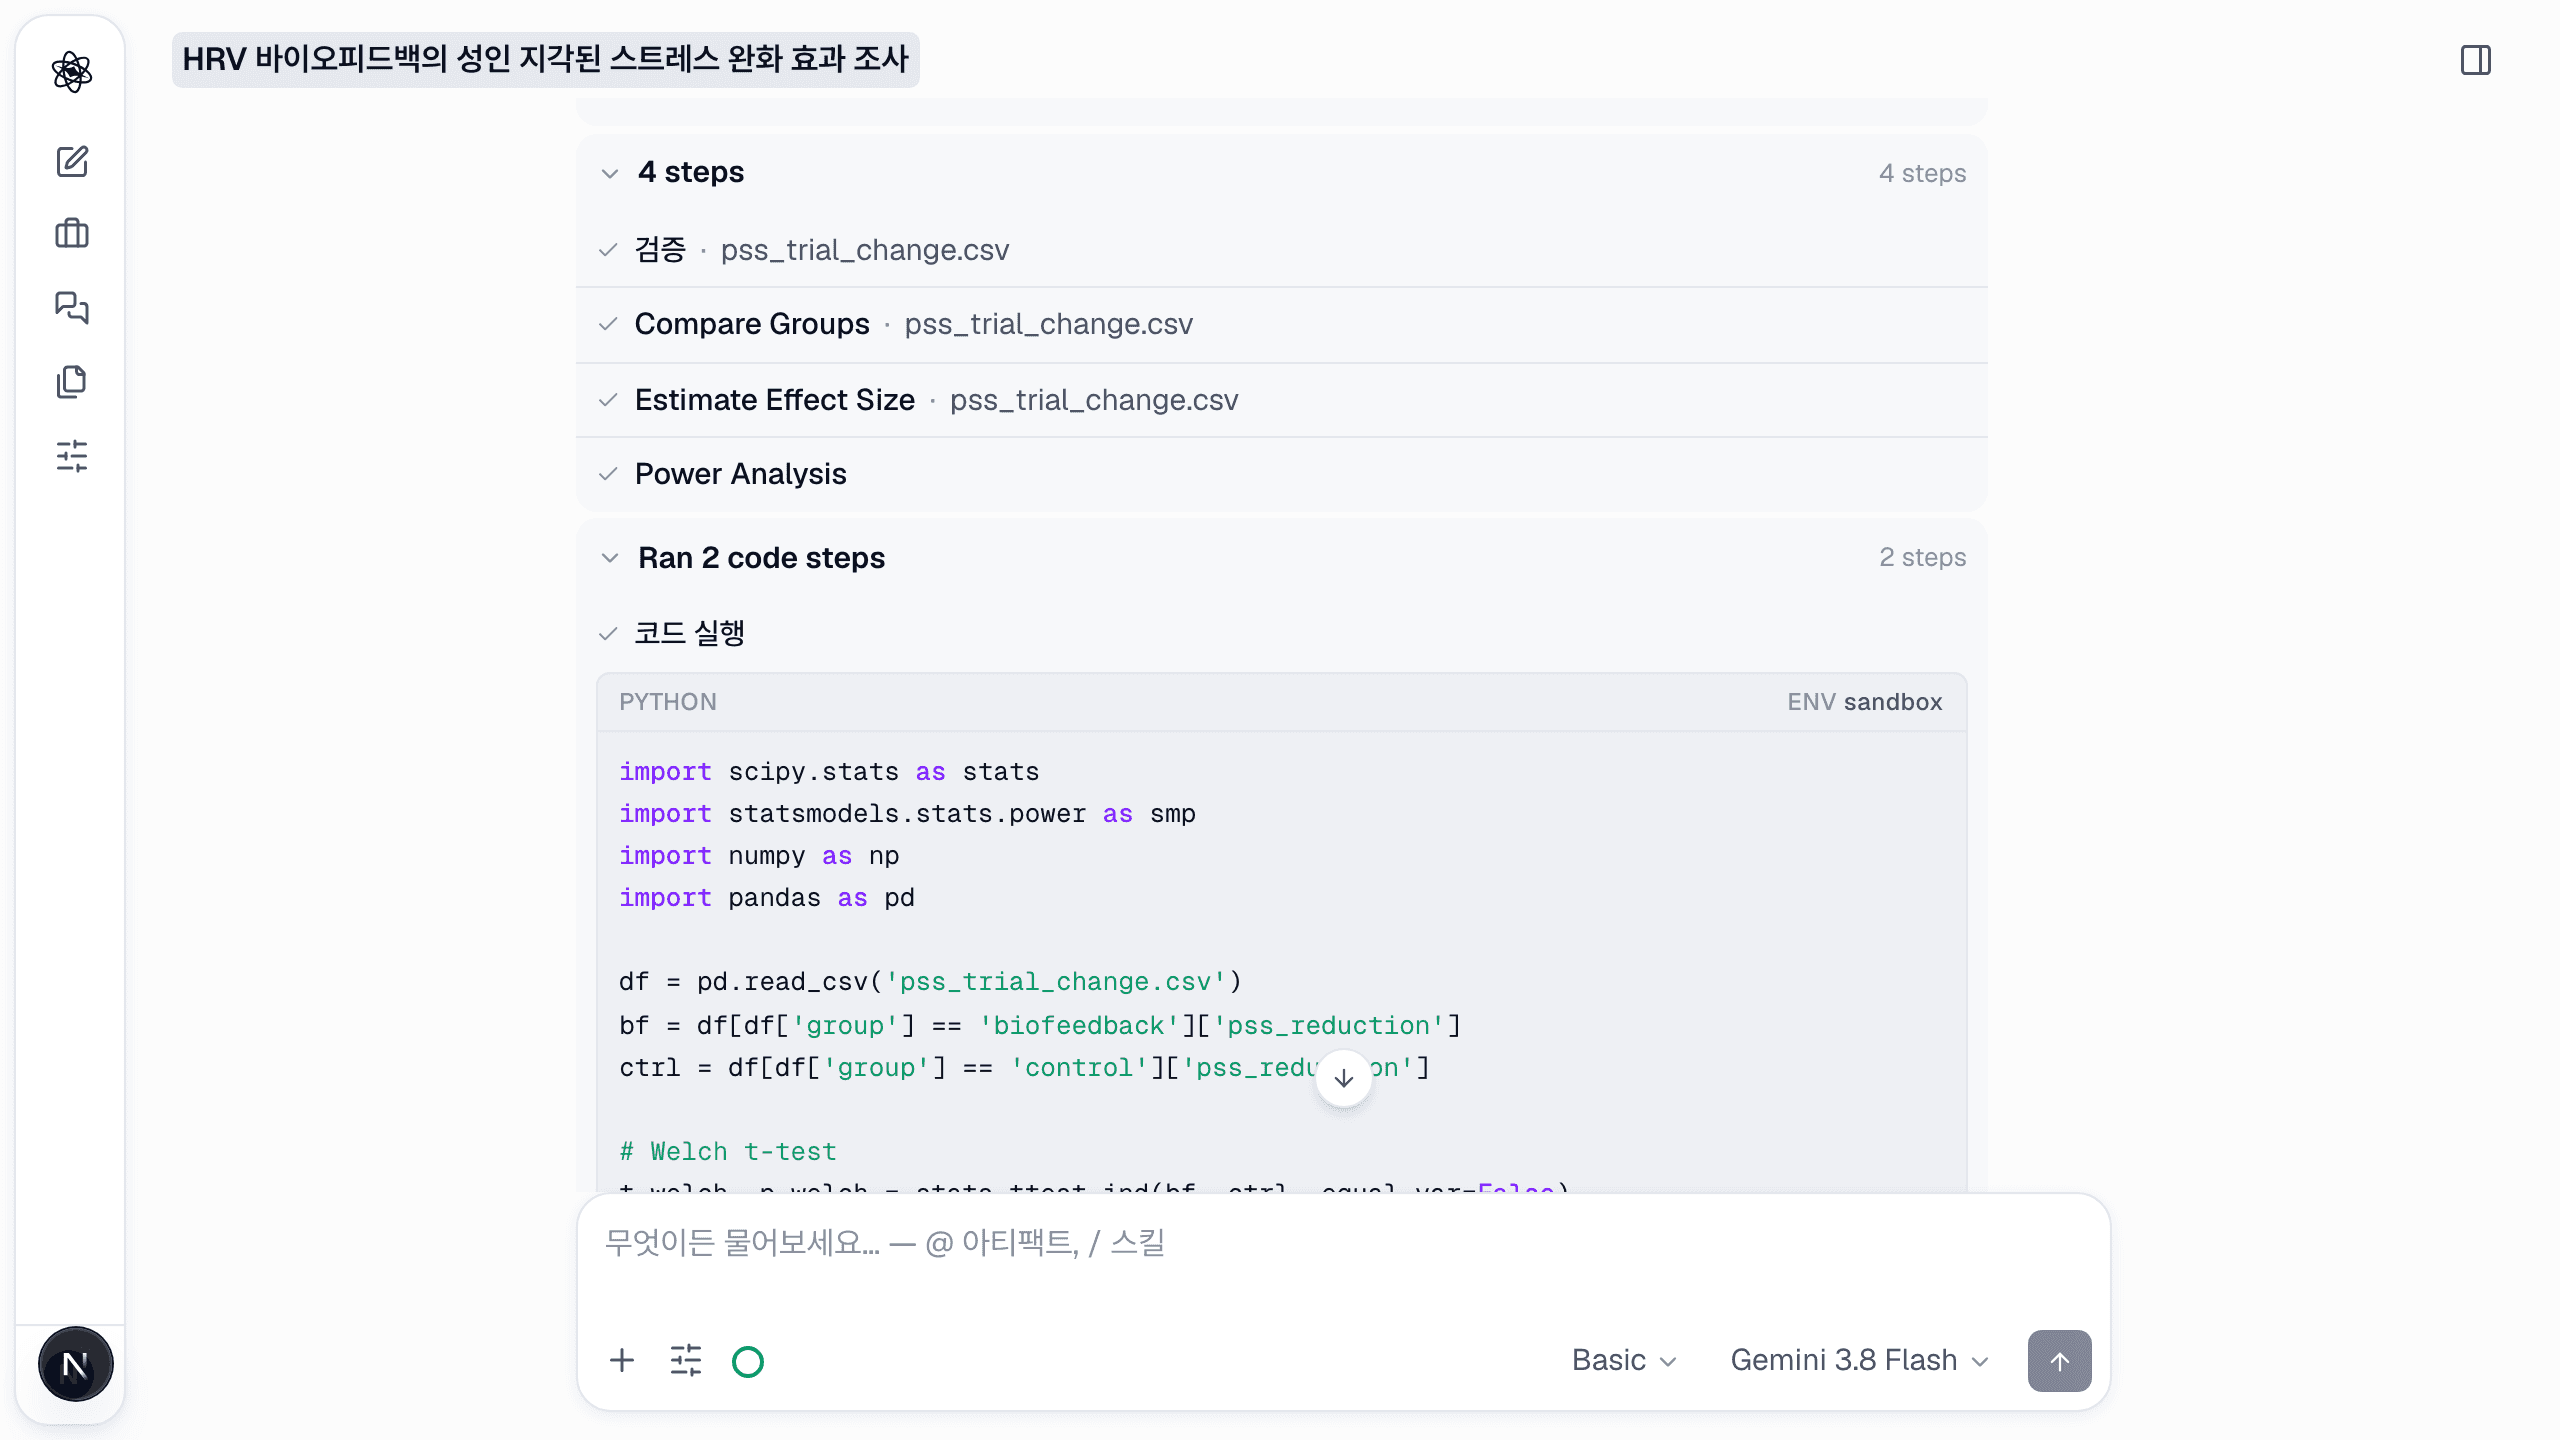
검토 에이전트는 연구 설계와 데이터로부터 분석을 다시 도출한 뒤, 출판된 논문에까지 가장 자주 살아남는 실패 유형을 찾습니다:
- 가정 위반 — 정규성, 등분산성, 구형성, 독립성.
- 분석 계획이 보정하지 않은 다중비교 위험.
- 주장된 효과 대비 검정력과 표본 크기.
- 분석 불일치 — 경로가 보고된 표와 맞지 않는 매개 모형, 본문이 설명하는 것과 다른 부분집합으로 계산된 그림, 데이터셋이 만들어 내지 않는 본문의 숫자.
불일치가 곧 기능입니다
두 에이전트의 의견이 갈리면 뉴트로픽은 조용히 승자를 고르지 않습니다. 양쪽 입장과 근거가 그대로 당신에게 표시됩니다. 내부 연구에서 이렇게 표시된 불일치는 인간 방법론자가 제기할 문제를 가장 잘 예측하는 단일 지표였습니다.
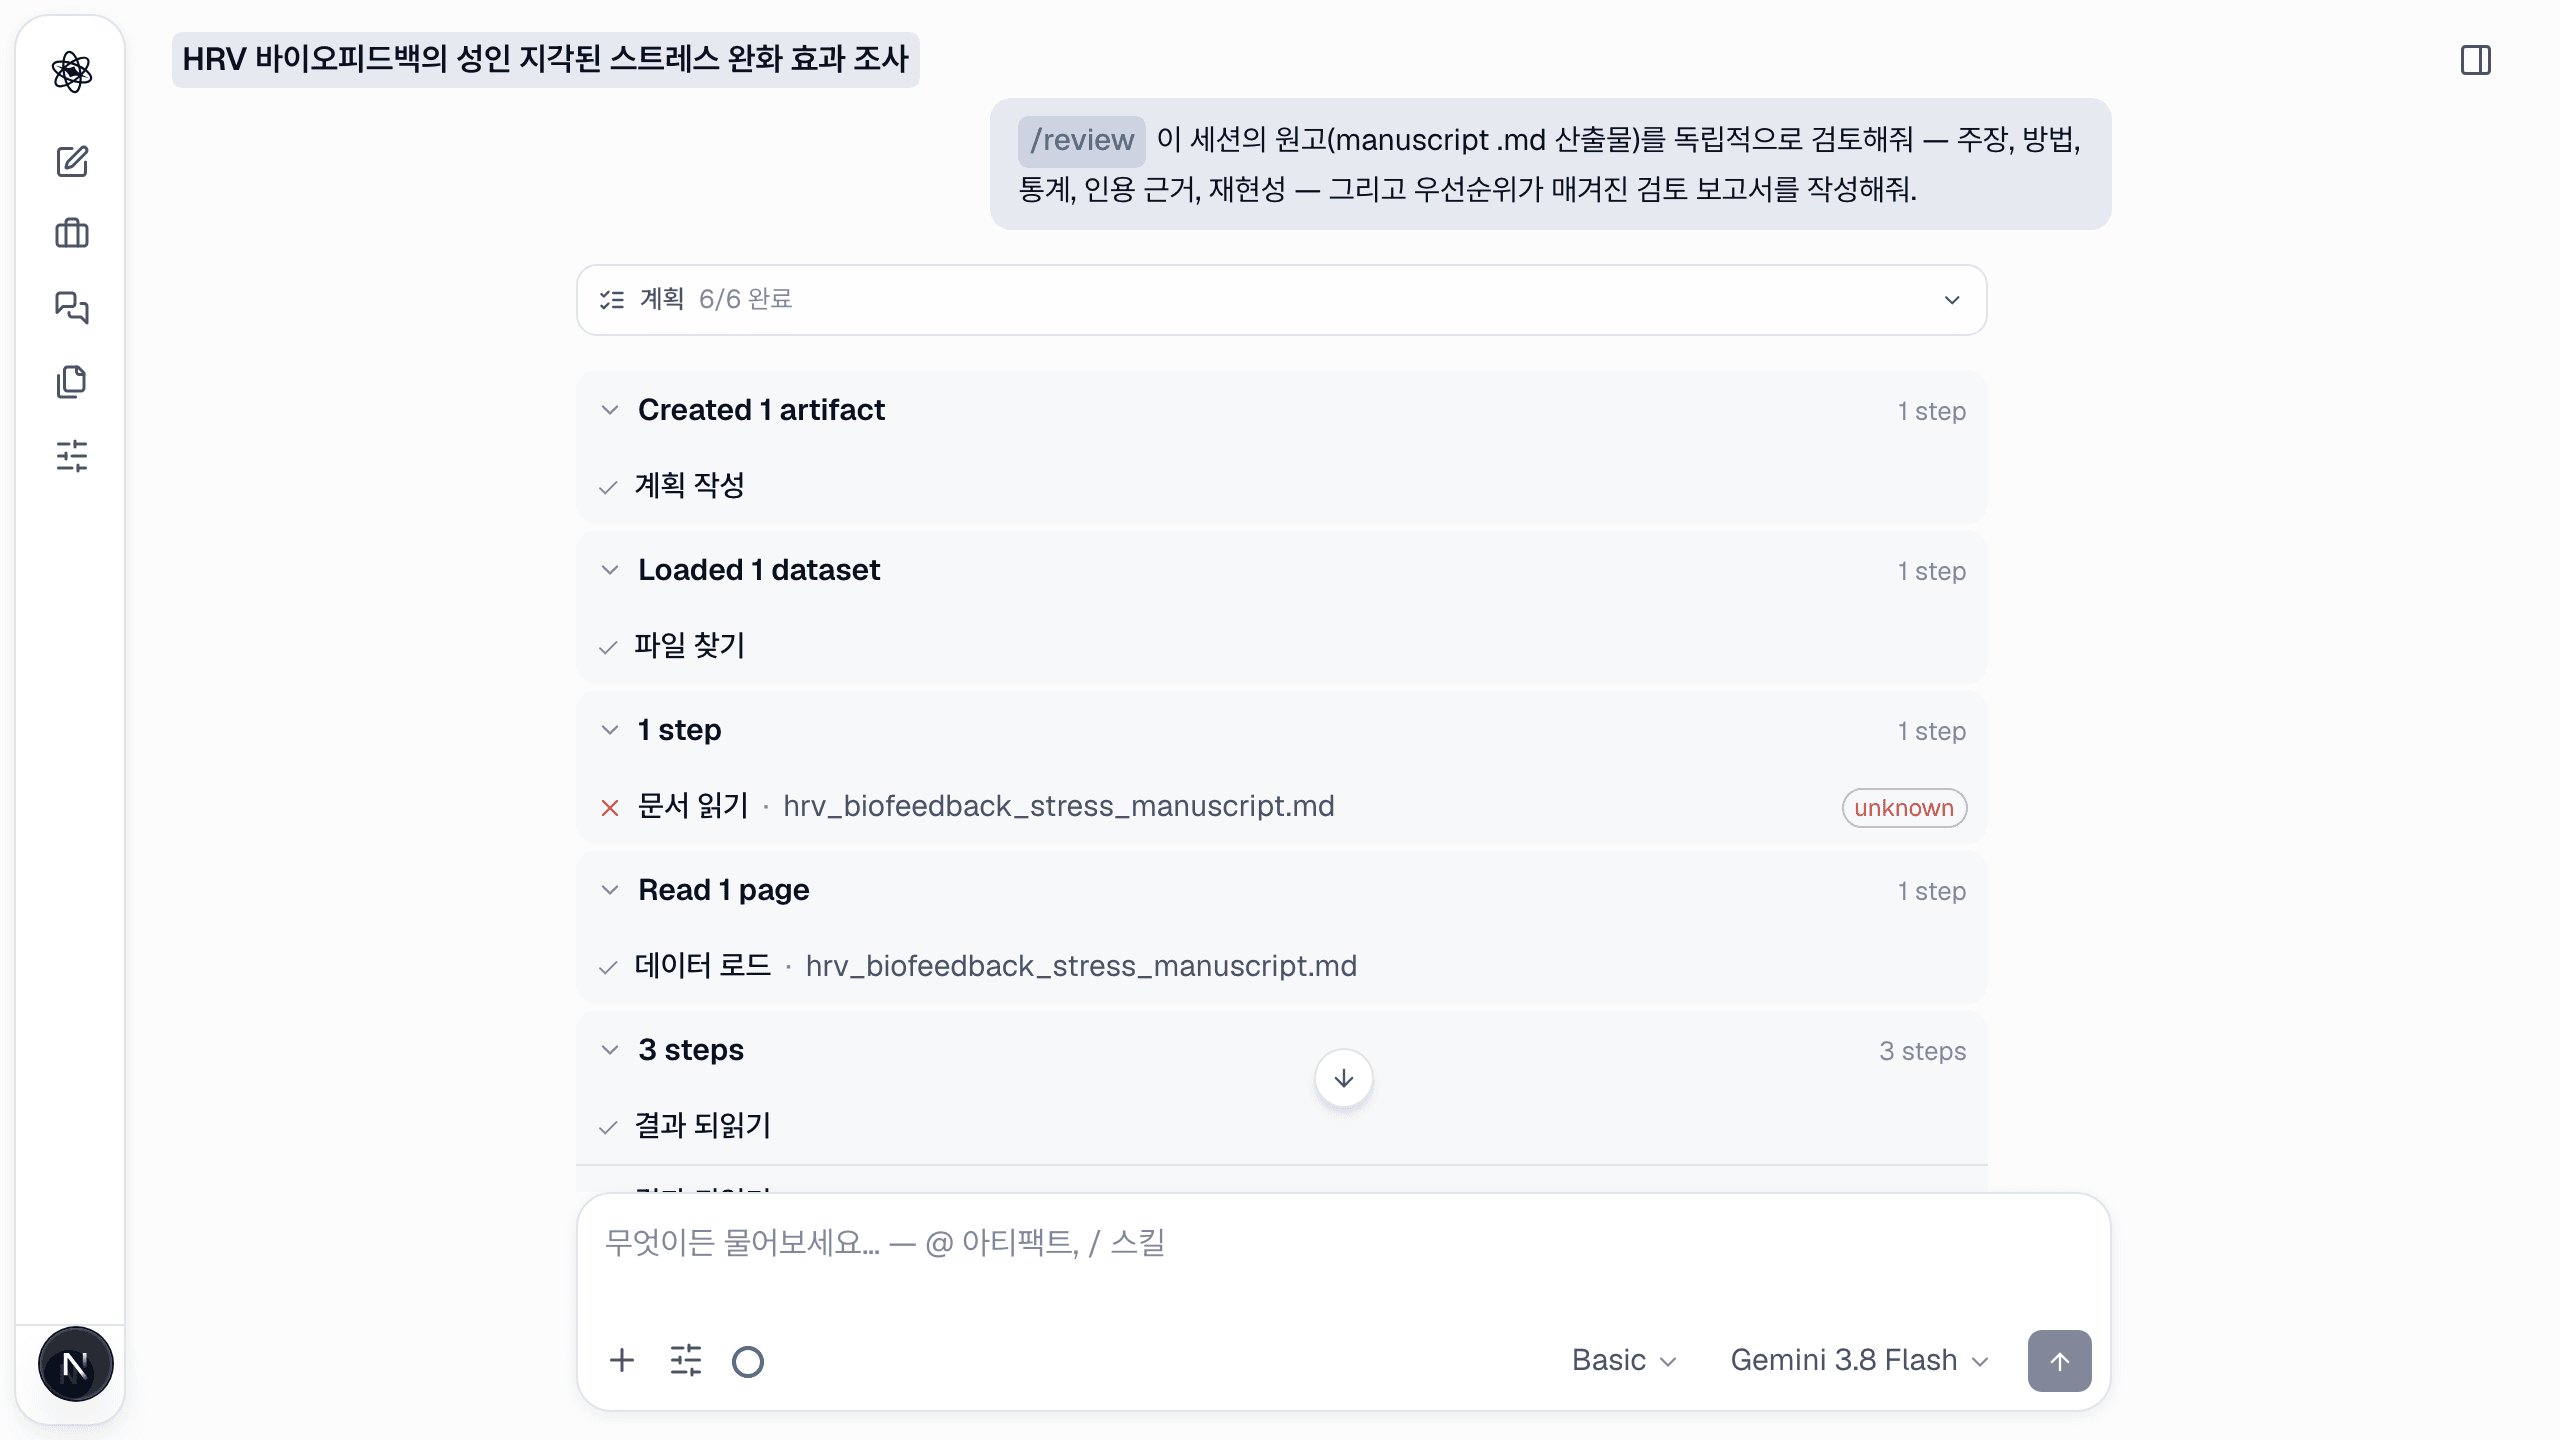
실제로 잡아낸 것
초기 사용자들은 검토 에이전트가 구형성 가정이 깨진 데이터에 돌린 반복측정 ANOVA, 중심화하지 않은 변수로 상호작용항을 계산한 조절 분석, 잘못된 효과크기 계열로 검정력 분석을 보고한 연구를 잡아낸 사례를 공유했습니다. 여기 보이는 세션에서는 Methods에 적힌 인구통계 평균이 시험 데이터셋과 맞지 않는다는 것을 발견했습니다 — 같은 문단의 추론 검정은 데이터로 다시 돌리자 소수점 셋째 자리까지 일치했는데도 말입니다.
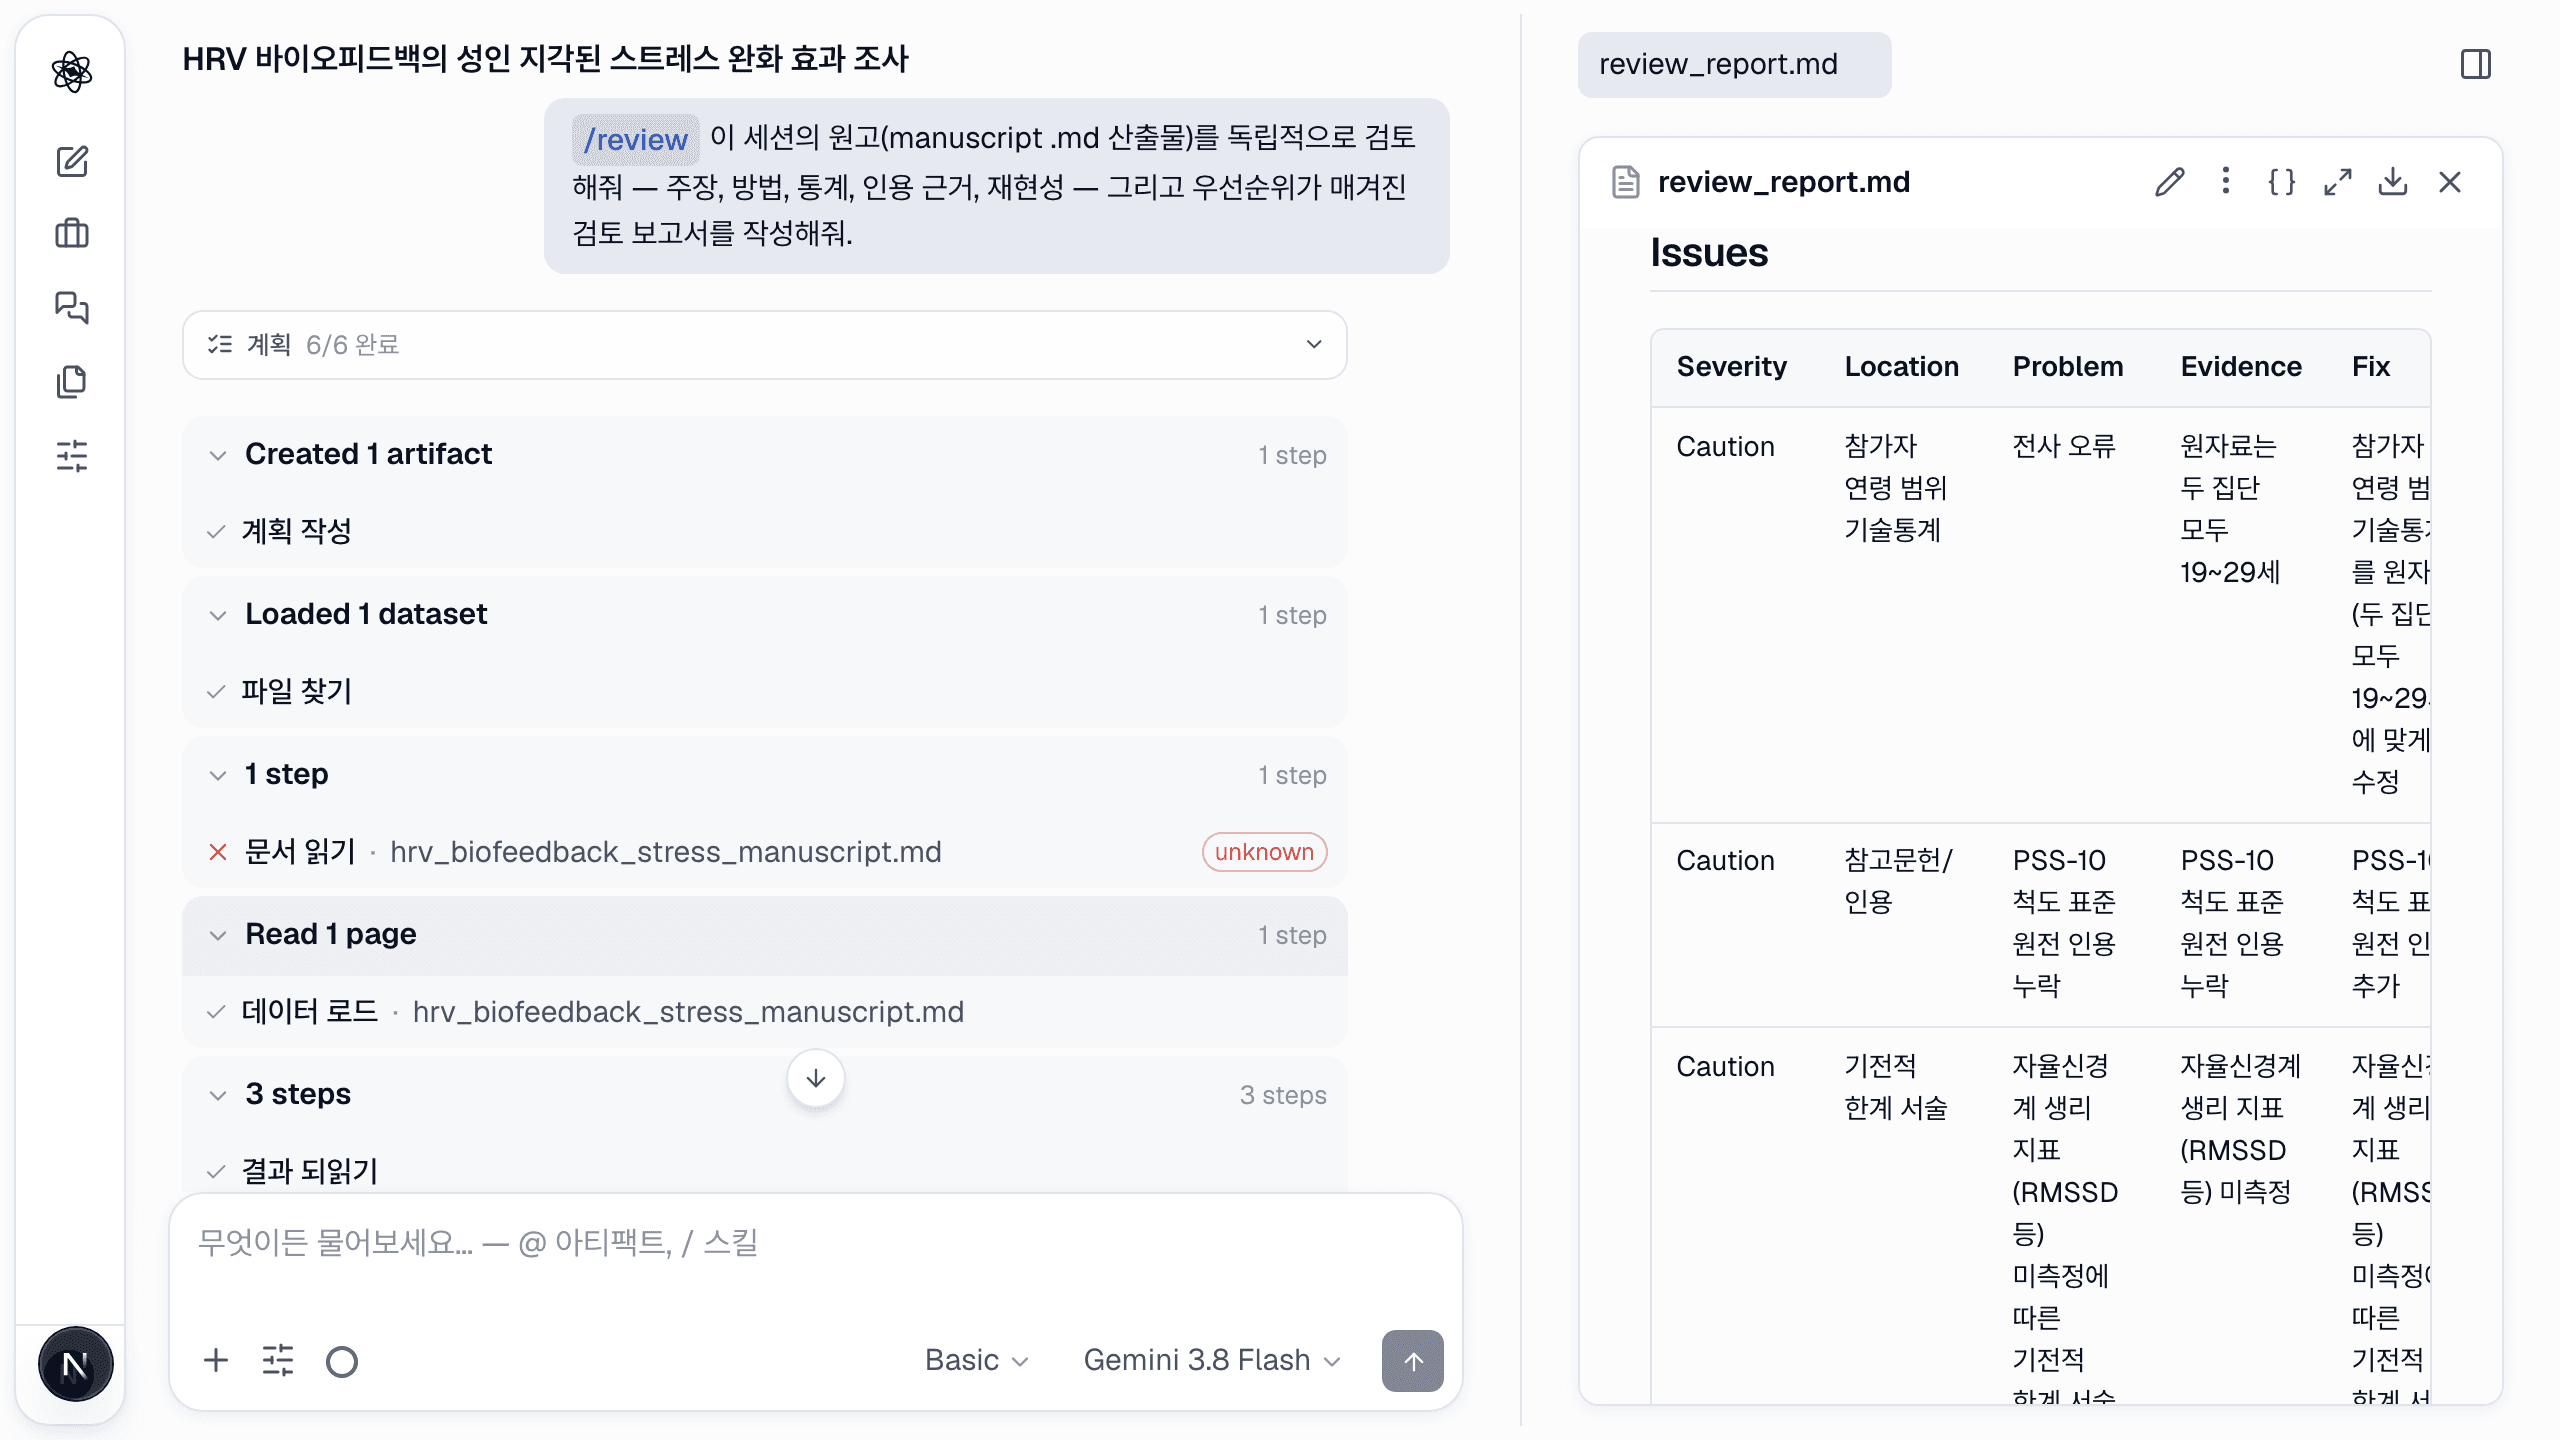
이 중 특이한 것은 하나도 없었습니다. 마감 압박 속의 평범한 실수들 — 두 번째 독자가 존재하는 이유가 바로 그것입니다.
서비스가 아니라 기본값으로서의 엄밀함
검토를 예약하거나 요청할 것을 기억할 필요가 없습니다. Deep 수준에서는 뉴트로픽의 모든 분석이 결과를 발견으로 제시하기 전에 검토를 거칩니다 — 버전 관리가 "코드 백업"을 결정 사항이 아니게 만든 것과 같습니다. 논문 전체에 대한 심사자의 읽기가 필요하면 /review가 메시지 한 번 거리에 있습니다.