大多数数据集都会按差不多的顺序经历同一串问题。里面有什么,数据干净吗?样本是什么样的?组间差异是否如我所料?项目真的带来了变化,还是我只能预测谁会变化?最后——综合这一切,我们该怎么做?
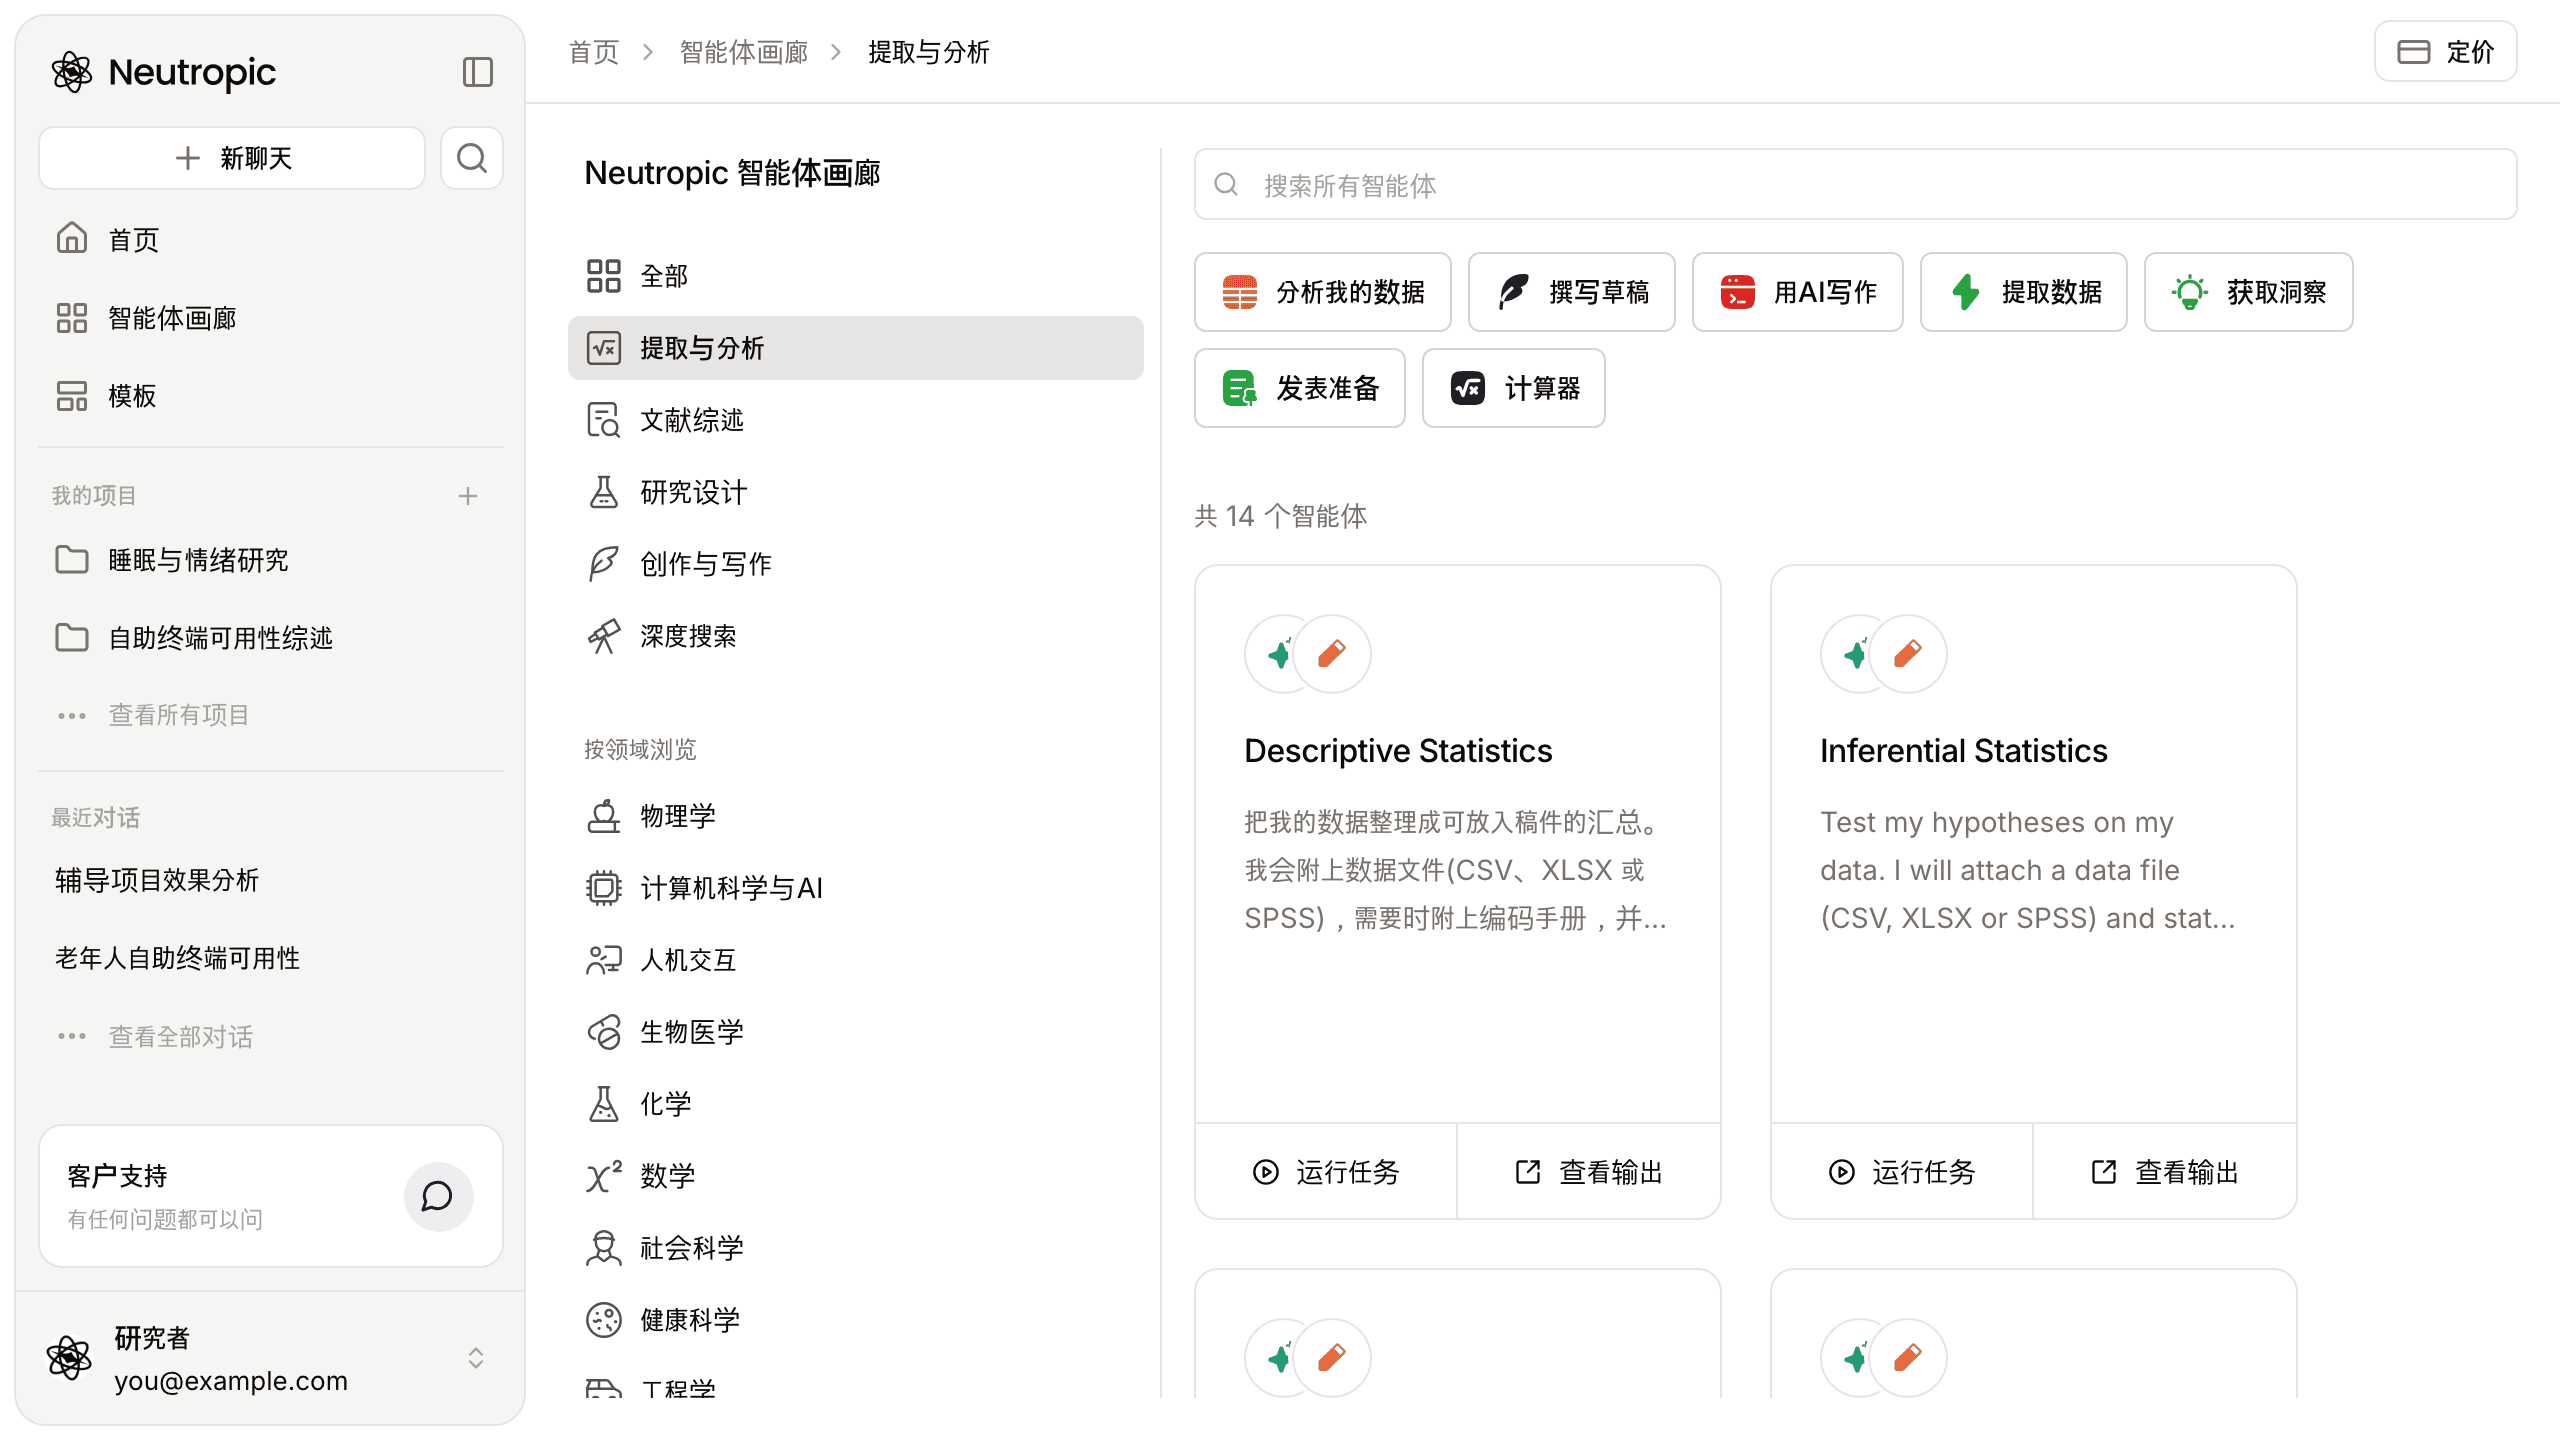
Neutropic 2.5 为每个问题都准备了一个智能体。六个智能体都在智能体画廊的提取与分析类别中,接受同样的数据文件,并按固定步骤运行,所以同一个请求每次都以同样严谨的方式完成分析。
什么问题用哪个智能体
| 你的问题 | 智能体 | 你会得到 |
|---|---|---|
| 我的样本是什么样的? | Descriptive Statistics | 按变量类型选择统计量的 Table 1、带标准化均值差的分组列、缺失数据、分布图和样本描述段落 |
| 还不知道该检验什么 | Exploratory Data Analysis | 按严重程度排序的数据质量问题、缺失模式、分布与异常值、变量间关系(包括在子组内方向反转的关系)、聚类,以及附带下一步分析的假设候选 |
| 我的假设成立吗? | Inferential Statistics | 每个假设:为何选择该检验、假设前提检查、带效应量、95% CI 和 APA 句子的结果,并做多重比较校正 |
| 没有随机分配,X 是否导致了 Y? | Causal Analysis | 因果图与调整集、适合数据的设计(双重稳健调整、双重差分、断点回归或工具变量)、前提检查、带置信区间的效应,以及对未测混杂的敏感性 |
| 谁更可能出现该结果? | Predictive Modeling | 泄漏检查;在相同交叉验证划分上比较基线与惩罚回归、随机森林和梯度提升;校准、阈值、驱动预测的变量、各子组表现和 TRIPOD+AI 清单 |
| 应该选哪个方案? | Prescriptive Analysis | 各方案的证据等级、期望净收益或有限资源的最优分配、显示推荐方案为最优的概率的模拟,以及会改变决策的输入值 |
每个智能体返回两个文件:Markdown 报告,以及包含报告中全部数字的电子表格(XLSX)——视智能体而定,可能是 Table 1 工作表、结果表、模型比较或情景表。
六个智能体的共同点
同样的文件。用 + → 上传文件附加数据表——CSV、TSV、XLSX、SPSS .sav 或 Stata .dta——或用 @ 指定。附上编码手册会更好:值标签、缺失值代码和类别顺序会按写明的执行,而不是从列名猜测。如果附上预注册或分析计划,Inferential Statistics 也会遵循它。见上传数据与引用。
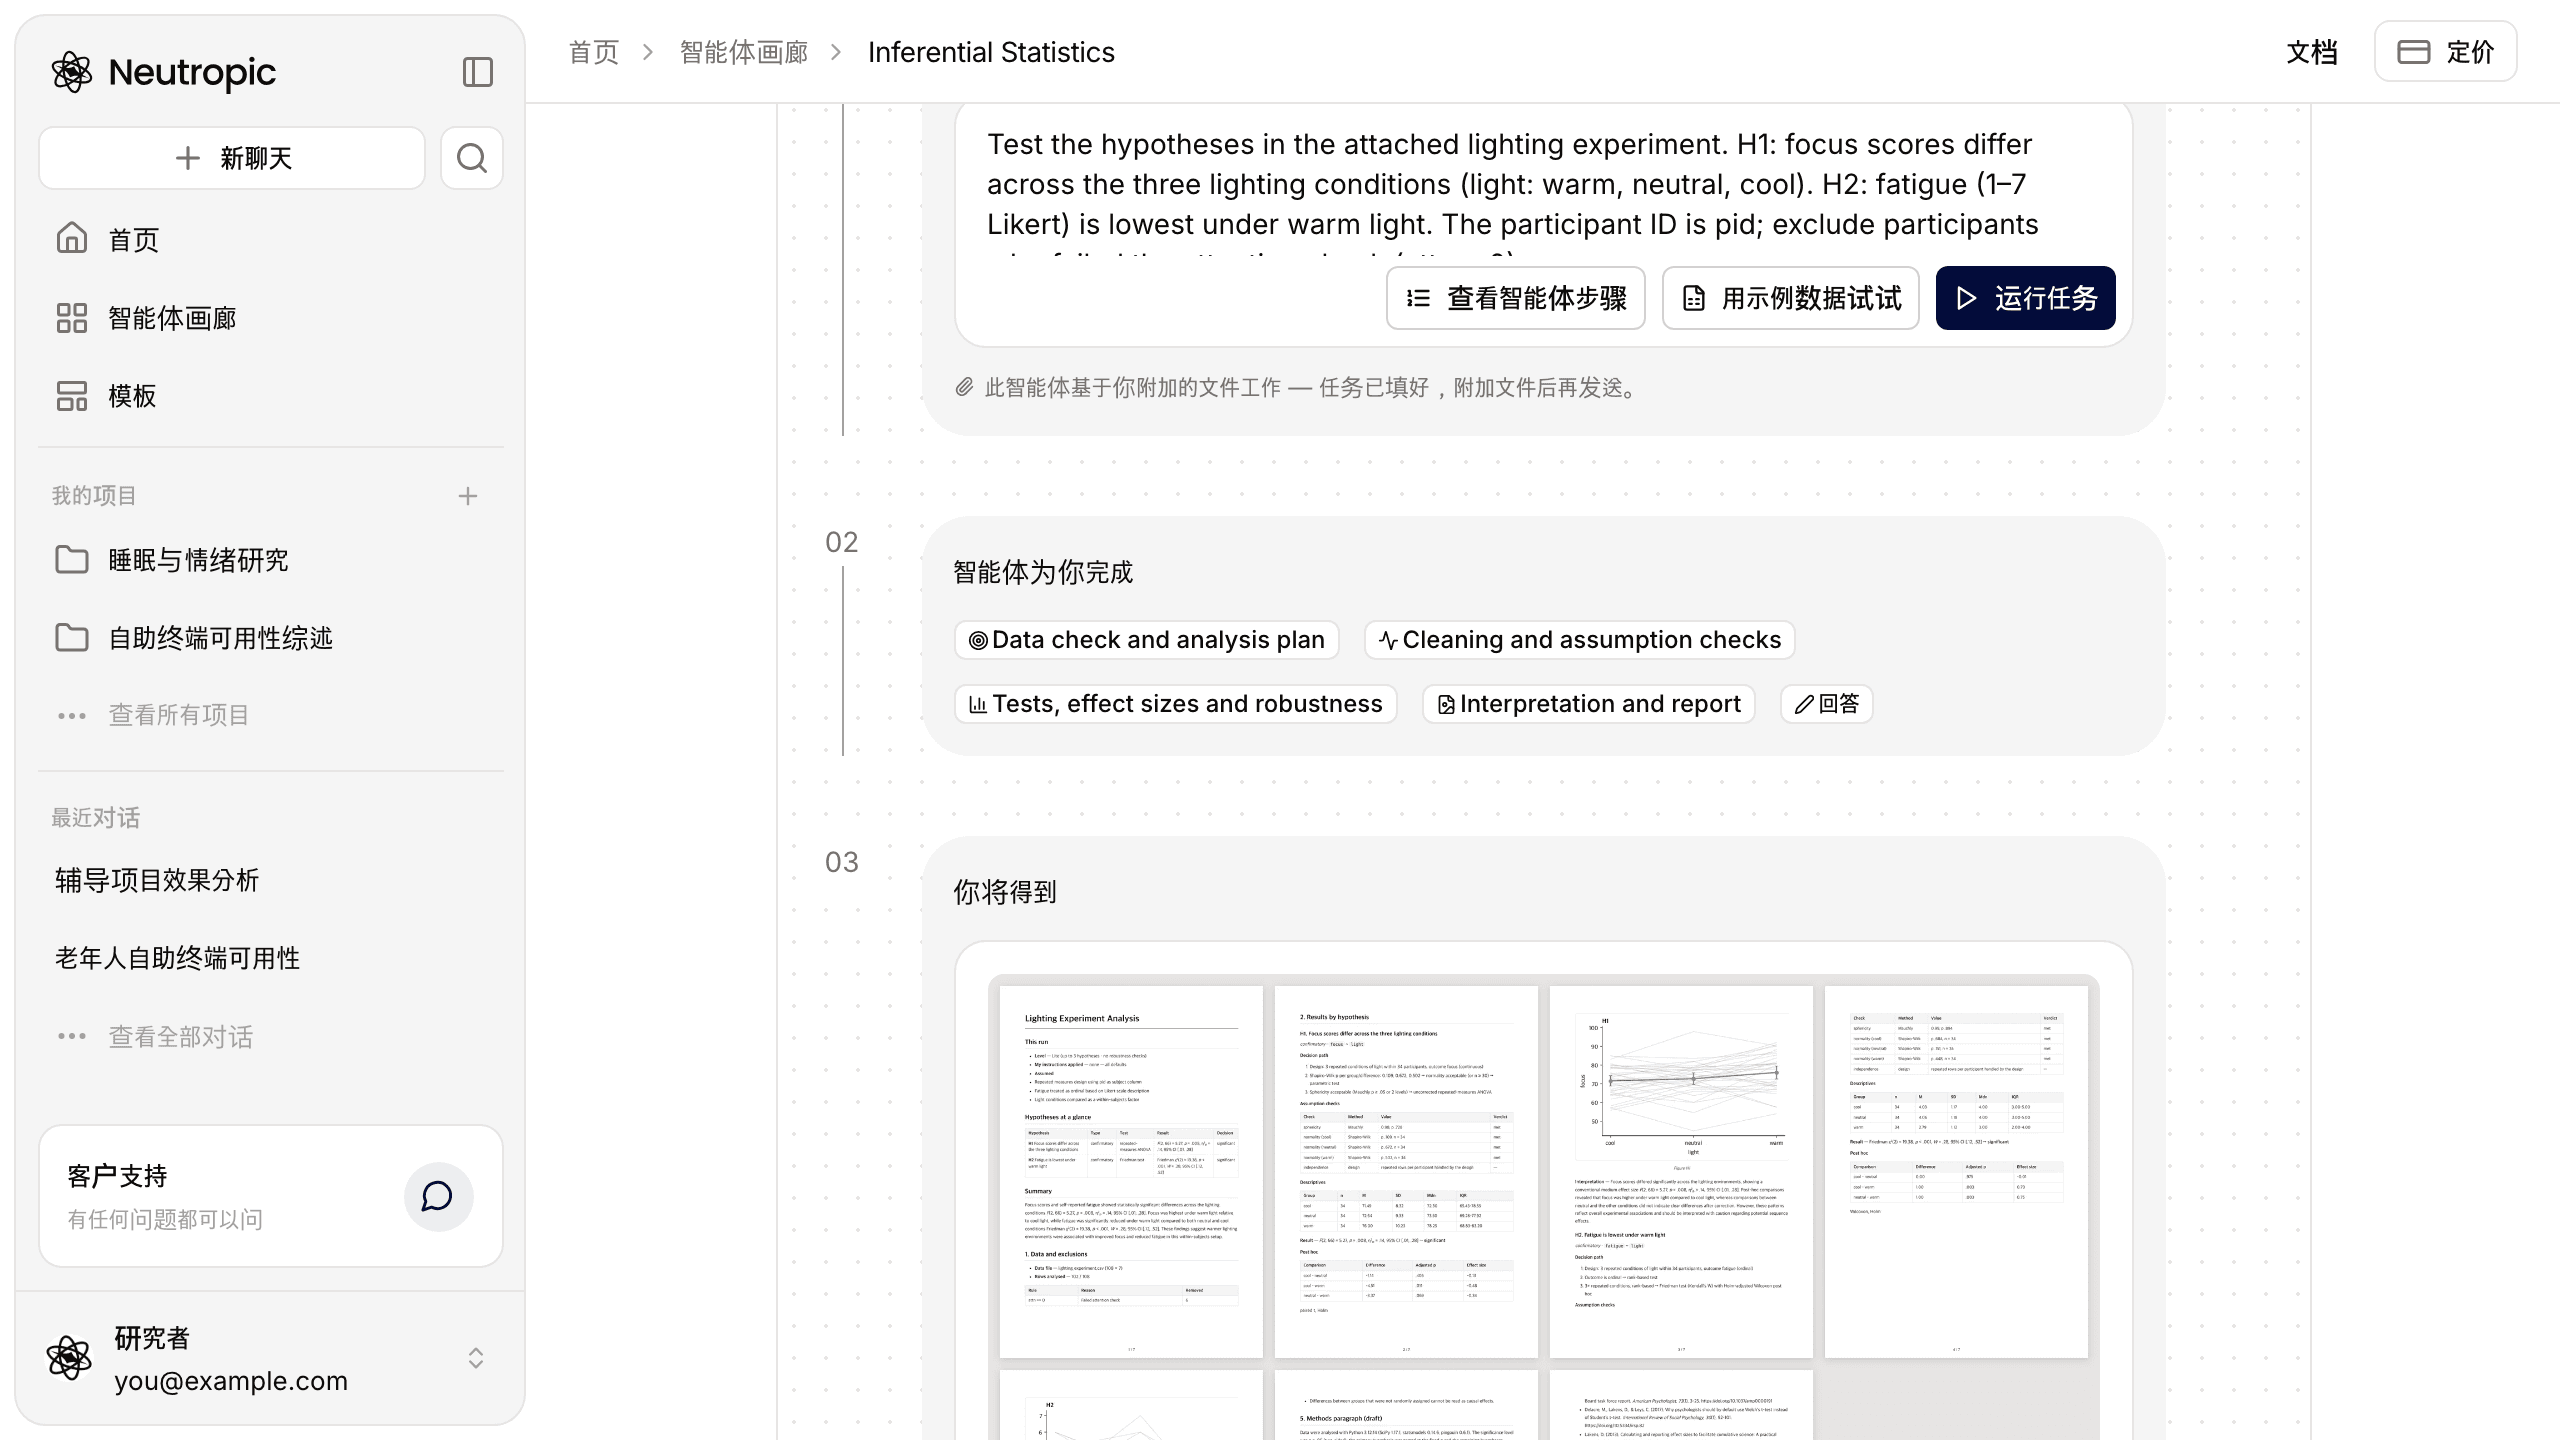
同样的结构。每个智能体先运行四个分析步骤,再写出回答。以 Inferential Statistics 为例:数据检查与分析计划 → 清理与前提检查 → 检验、效应量与稳健性 → 解读与报告。每一步运行时你都能看到。
数字来自代码。所有分析都以代码运行,每一步运行的代码都保留在一个代码框中——点击即可查看代码及其输出。解读文字在模型不亲自写数字的前提下生成,因此正文中的数字与电子表格一致。
前提公开说明。报告开头列出所用级别、应用的指示以及做出的假设——例如任务未说明时某一列是如何解读的。结尾是需要你决定的事项:仍由研究者做出的判断。
它们如何衔接
这些智能体被设计为可以传递结果。处理一个数据集的典型路径如下:
- 还不知道检验什么时,先用 Exploratory Data Analysis。每个假设候选都附带下一步要做的分析。
- 每份稿件都需要的样本表,用 Descriptive Statistics。
- 事先提出的假设,用 Inferential Statistics 检验——也可以检验第 1 步的候选,但在用新数据确认之前,应把它们视为探索性结果。
- 如果问题是观察数据中的效应,用 Causal Analysis;如果目标是预测结果,用 Predictive Modeling。两者回答的是不同的问题:重要的预测变量并不等于原因。
- 用 Prescriptive Analysis 把这些结果变成决策。它为每个方案的证据评级——随机实验为 A、因果估计为 B、预测或非随机分配的比较为 C、假设为 D——并直接使用前面结果表中的效应和不确定性。
在同一个聊天或同一个项目中运行,文件会集中在一起,后面的智能体可以直接基于前一个的输出工作:
Decide which onboarding to launch using the Inferential Statistics results table in this chat. About 200,000 users sign up each month; a user retained at day 7 is worth 4,000 KRW; keeping B running costs 1,200,000 KRW a month and C 3,000,000 KRW.
如果还没有收集数据,就再往前一步,从 Experimental Design 智能体开始,然后附上它的报告,让分析按计划进行。
级别改变的是深度,而不是步骤
在发送旁选择级别:Lite、Pro、Expert 或 Max Thinking。所有级别运行相同的步骤;级别越高,能处理的量和检查越多。例如在 Inferential Statistics 中,Lite 最多检验三个验证性假设,Pro 增加替代分析和敏感性分析,Expert 增加贝叶斯因子和 R 交叉核对(在有 R 的环境中),Max Thinking 可以运行你提出的最多两项自定义分析,并标记为探索性。每个智能体的页面都列出了具体差异。
用示例数据试试
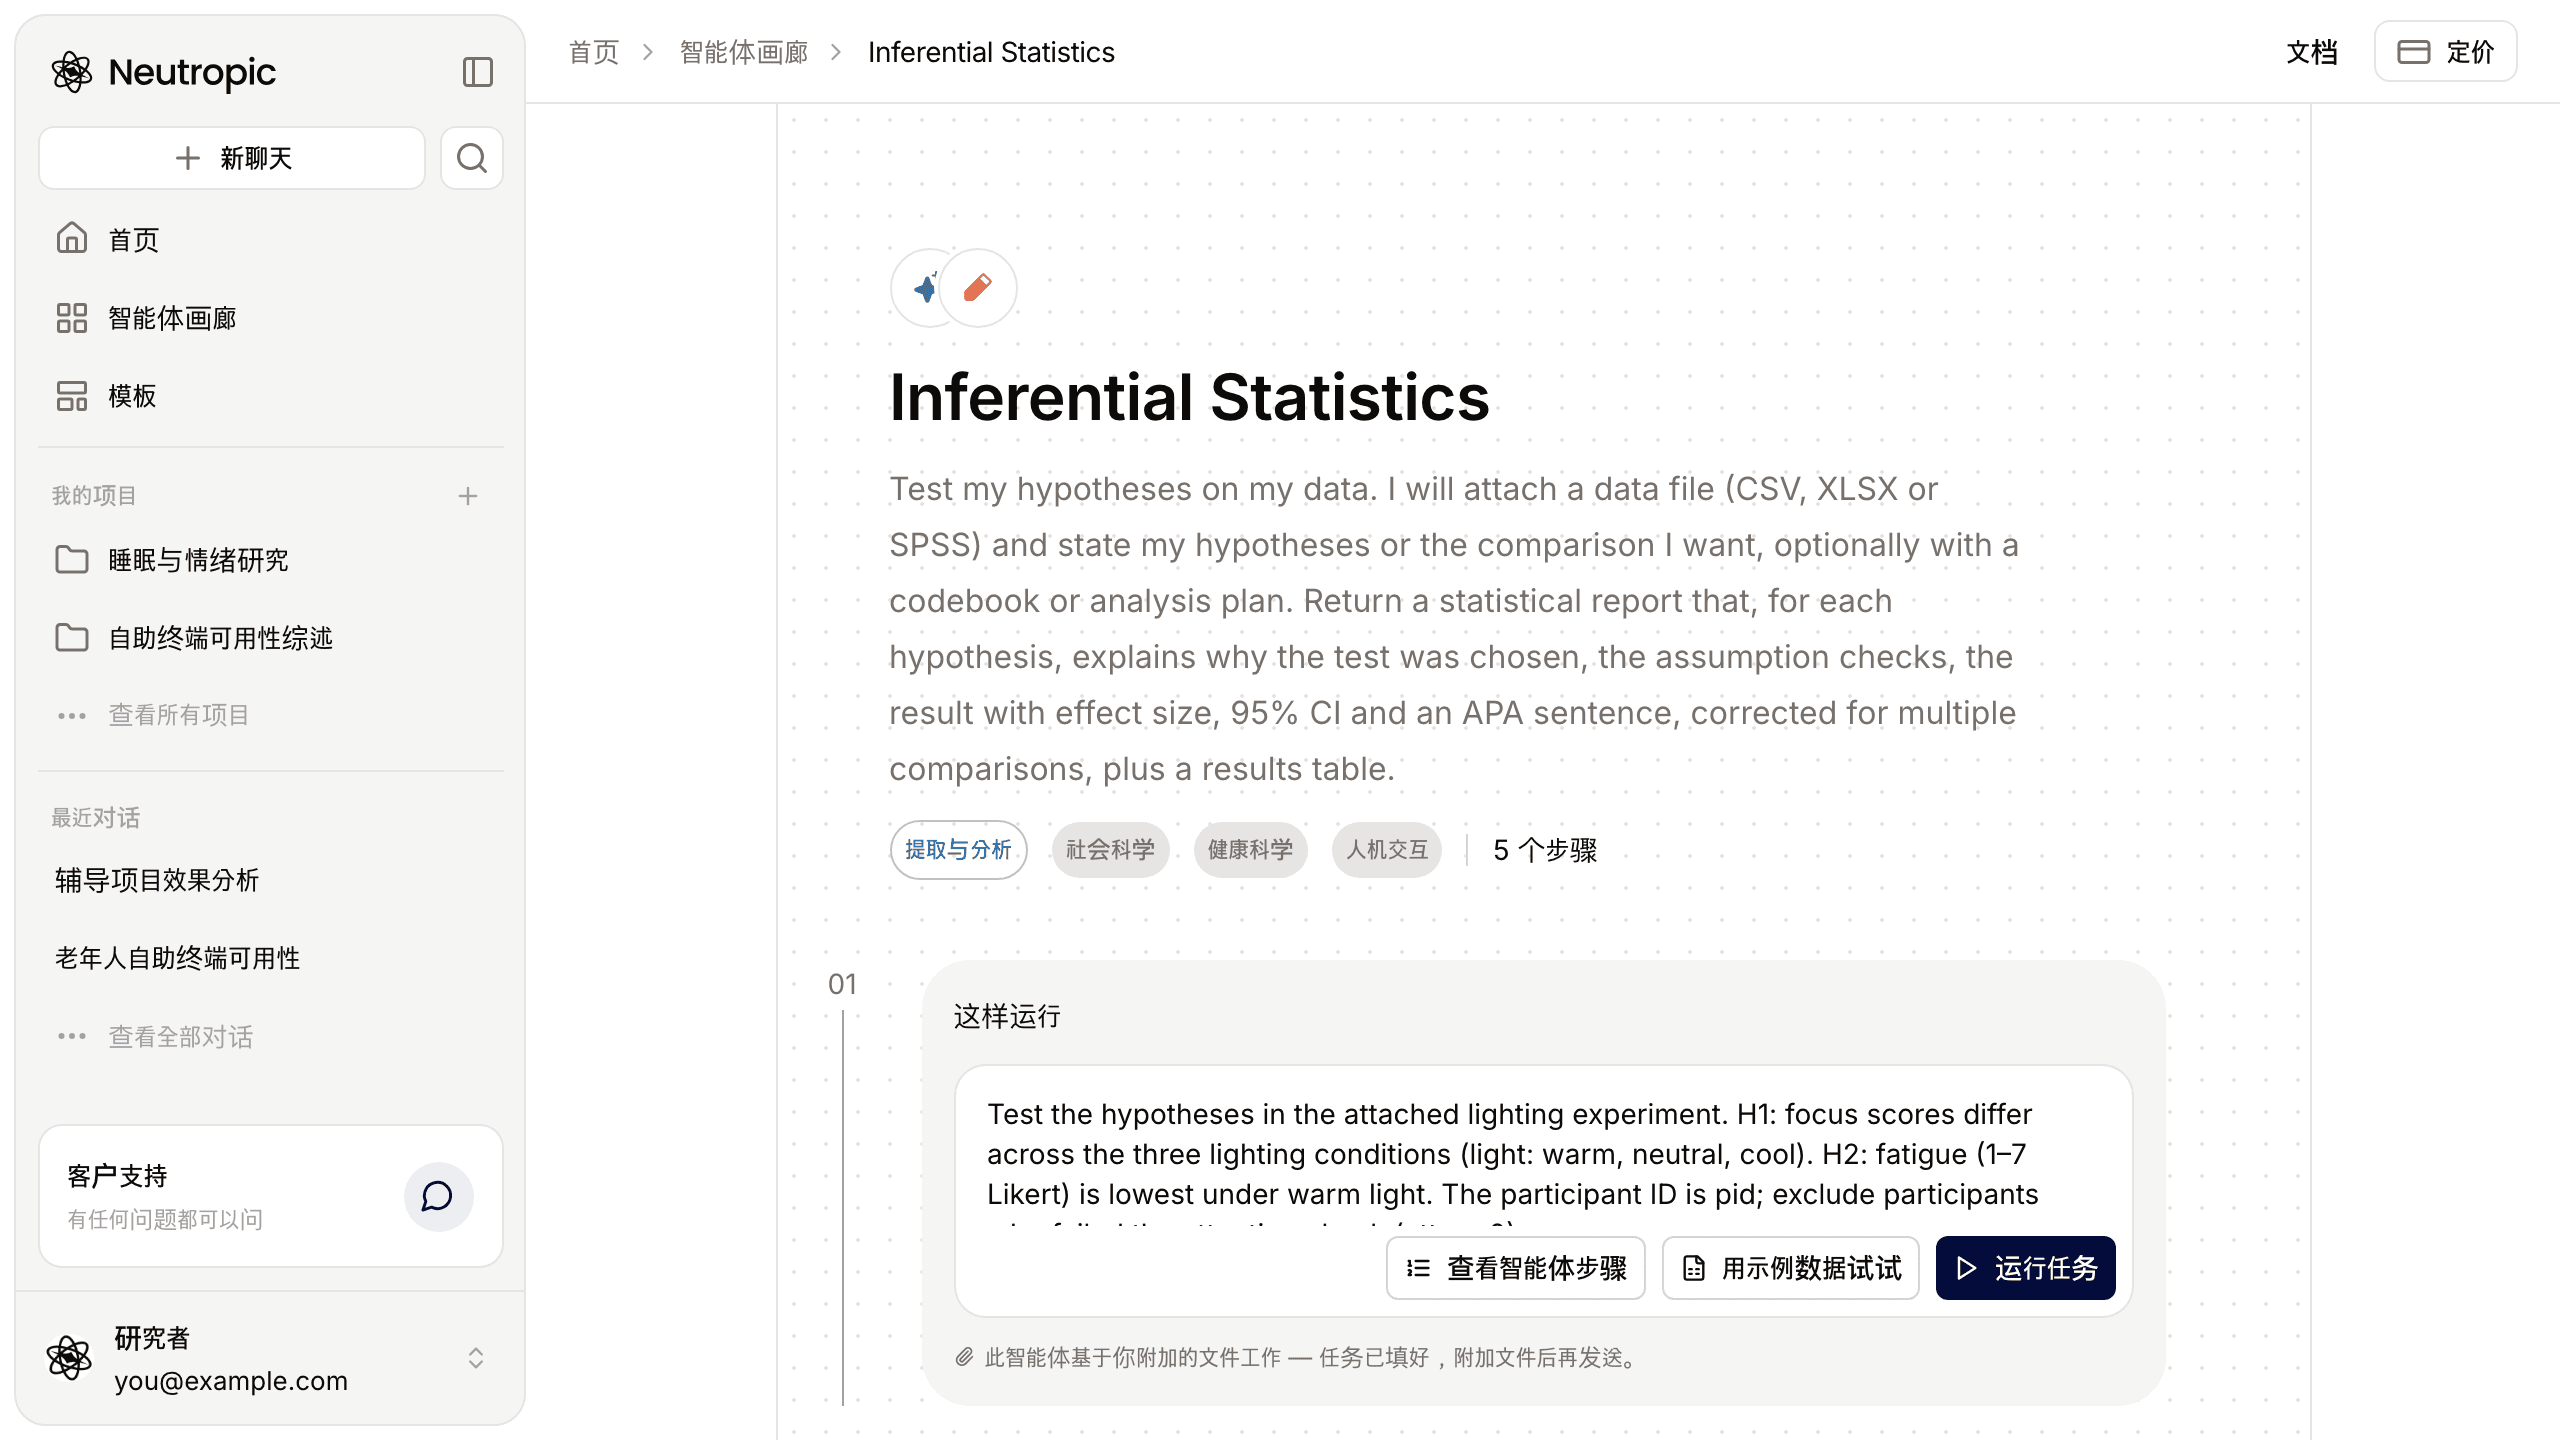
六个智能体都附有示例任务和对应的示例文件——幸福感问卷、照明实验、应用用户调查、学生辍学记录、引导流程实验和辅导项目数据。在智能体页面上:
- 查看输出显示一次真实运行的结果,让你在消耗令牌之前就知道会得到什么。
- 用示例数据试试会打开首页,输入框中已填好示例任务,示例文件也已附加。点击发送,就能看着它运行。
哪些仍由你判断
有些判断仍属于研究者,报告也会如实说明:
- 变量角色与排除标准。请核对第一页列出的设计解读和排除标准。
- 不显著的结果绝不会写成“没有效应”:报告给出效应量及其置信区间,以及该样本能检测到的最小效应。
- 因果图。因果估计取决于图中的箭头。在聊天中让它修改某个箭头,分析会随之更新。
开始使用
打开智能体画廊的提取与分析,选择与你当前问题对应的智能体,点击用示例数据试试,在接近真实的数据上看一次完整运行。每个步骤和设置都记录在模板目录中;如果你的数据是记录下来的信号而不是表格,请看生物信号分析智能体。