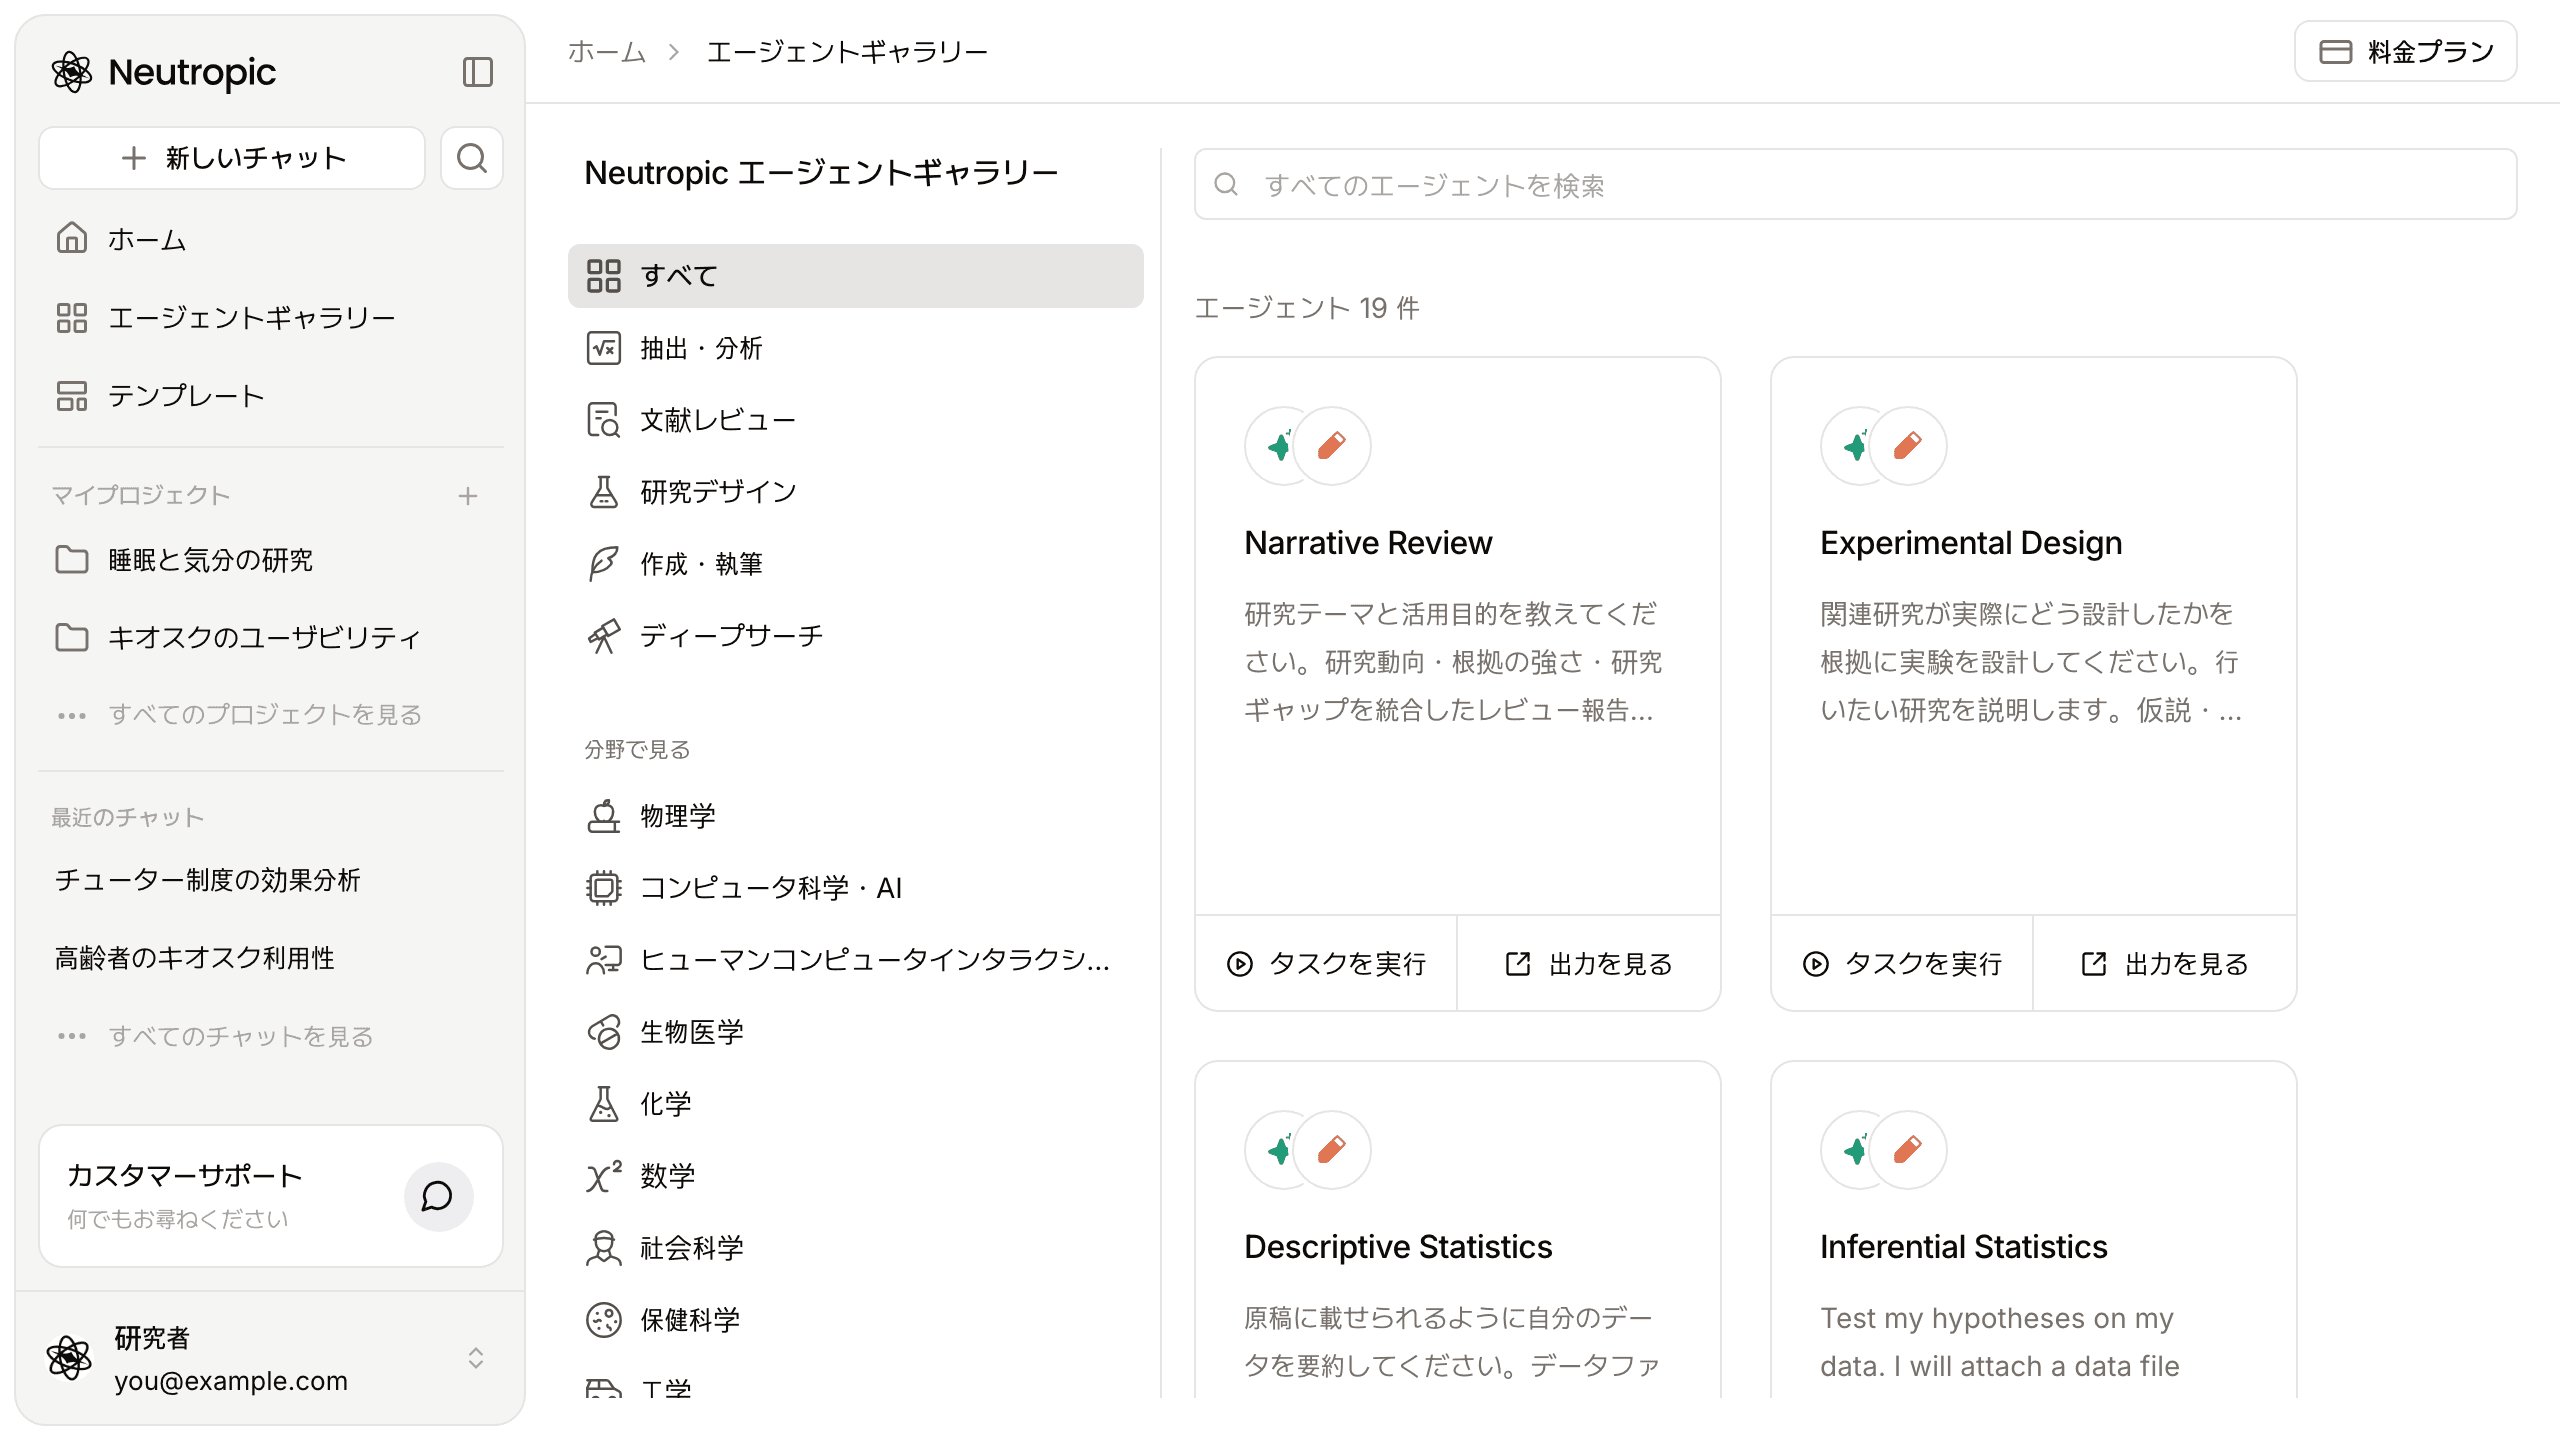
エージェントギャラリーのエージェントはブラックボックスではありません。どれも START から END までステップをつないだワークフローで、私たちがそれらを作ったのと同じエディタをそのまま使えます。ギャラリーのエージェントを自分の研究に合わせることも、どのテンプレートにもない仕事をするエージェントを作ることもできます。研究室向けの週次文献ダイジェスト、独自の採用基準によるスクリーニング、結果を接続済みのツールに保存するパイプラインなどです。
この記事では、自分のエージェントが集まる場所、カスタマイズの 3 つの深さ、構成要素、そして数分で再現できる小さな例を紹介します。
マイエージェント
実行したり作ったりしたエージェントはマイエージェント(/my-agents)に一覧され、それぞれにタスクを実行、出力を見る、設定があります。ここから新しいエージェントを作ったり、既存のエージェントを開いたりします。
カスタマイズの 3 つの深さ
1. 設定して実行。 マイエージェントでタスクを実行を押すとダイアログが開きます。共有テンプレートには触れません。エージェント名、実行するタスク、ナレッジベース(PDF、Word、PowerPoint、HWP、テキスト、Markdown、CSV をドロップすると実行前に索引化されます)、この実行の努力レベル、検索する文献データベースを決めます。購読データベースは先に接続が必要です。
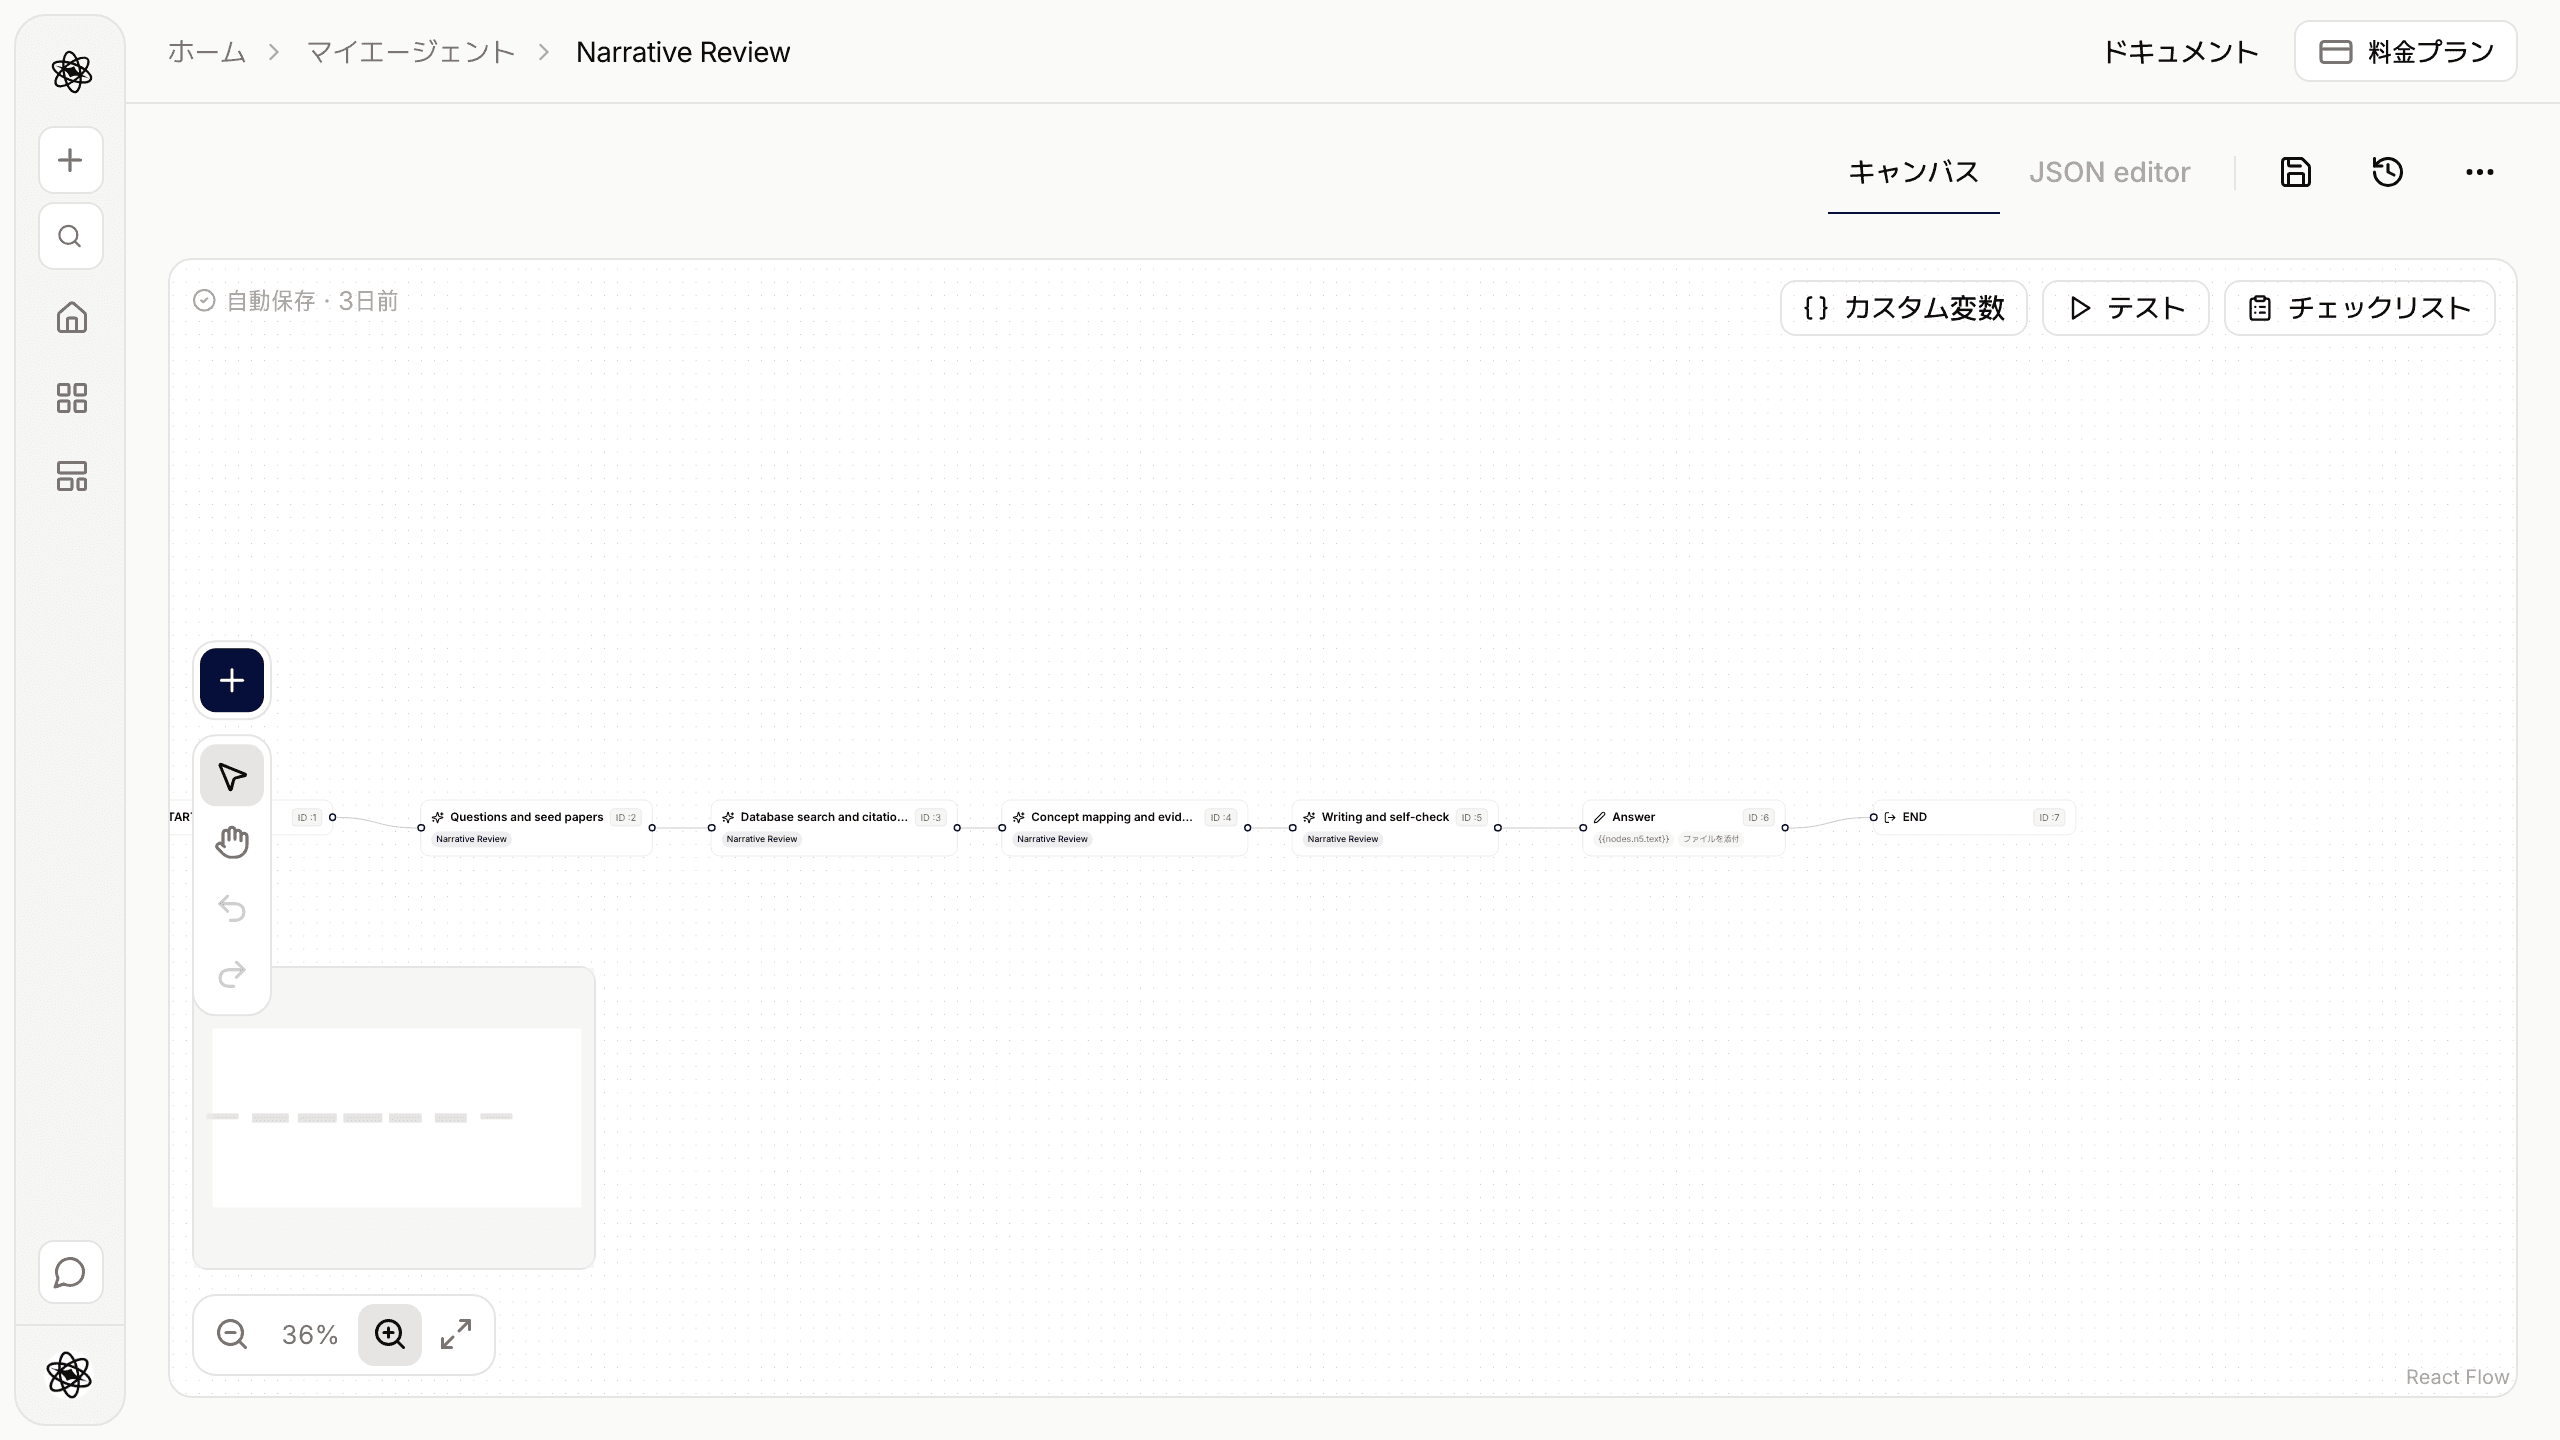
2. ステップを編集。 エージェントを開いてワークフローに移動します。ステップを選ぶと右のインスペクタに設定が表示されます。ギャラリーのエージェントはすべてエージェント RAG ステップでできており、よく変えるのは指示文(範囲、分析の選択、ファイル名)、注意事項(エージェントが厳格な制約として扱うチェックリスト行)、レビュアー(出力が重要なら 1〜3 回の修正でオン)、ナレッジ(自分の文書を読むか)、そしてステップが作るファイルの出力名です。
3. 独自のロジックを追加。 分岐、ループ、承認、Python、HTTP 呼び出し、コネクタ — 下のノードグループです。
構成要素
キャンバスの + メニューから 3 つのグループのステップを追加します。
| グループ | ノード | 用途 |
|---|---|---|
| コア | LLM · 検索 · エージェント RAG | 1 回のモデル直接呼び出し、番号付きで引用できる結果を返すモデルなしの検索、計画・検索・コード実行・ファイル作成まで行うスキルのフル実行 |
| ロジック・変換 | If / Else · 後処理 · ドキュメント · 変数割り当て · レスポンス · ループ · 承認 | 分岐、決定的なテキスト変換、ファイル保存、変数、最終回答、反復、人の承認カード |
| ユーティリティ | API · 関数 · コネクタ | シークレットを使う HTTP 呼び出し、サンドボックス Python、コネクタツールの直接呼び出し |
ドキュメントの目安に従ってください。ツールや判断が必要なステップ(データ分析、引用付きレポートの作成)にはエージェント RAG、明確に定義された 1 回の変換(分類、JSON 抽出、1 つの入力の要約)には LLM、検索そのものにモデル呼び出しを使わずに出典に番号を付けたいときは、その前に検索を置きます。各ノードはワークフローノードで説明しています。
ステップをつなぐ
プロンプト、指示文、クエリ、ファイル内容、条件などのテキスト欄はテンプレートです。{{ … }} はステップの実行前に、モデルを使わずに埋められます。
| 参照 | 意味 |
|---|---|
{{input}} | 送信したタスクのテキスト |
{{input.files}} | 添付したファイル名 |
{{nodes.<id>.text}} | 前のステップのテキスト出力(id は各ステップに表示) |
{{nodes.<id>.items}} · .count | 検索結果のリストとその件数 |
{{nodes.<id>.json}} | JSON 出力をオンにした LLM ステップ、API ステップ、関数ステップの JSON |
{{nodes.<id>.verdict}} | エージェントステップのレビュアー判定:sound、caution、issues |
{{vars.<key>}} | ワークフロー変数 |
{{secrets.<NAME>}} | 設定に登録したシークレット — API ステップ専用、ログではマスク |
フィルターで値を変換できます。{{nodes.n2.items | first:5 | lines}} は最初の 5 件を 1 行ずつ出します。ほかに json、join:", "、truncate:N、upper、lower、count があります。手で打つことはあまりありません。すべてのテキスト欄に、参照を書き込んでくれる挿入ピッカーがあります。
例:週次の文献ダイジェスト
研究室で、毎週月曜にあるテーマの新しい論文の短いダイジェストを受け取りたいとします。新しいエージェントを作り、START と END の間に 5 つのステップをつなぎます。
- 検索(
n2)— クエリ{{input}}、ソースは PubMed + Crossref と OpenAlex、上限 20、年は昨年以降。 - If / Else(
n3)— 条件{{nodes.n2.count}}gt0。false のハンドルは、今週は該当する新しい論文がありませんと書くレスポンスを経て END へ。 - true のハンドルに LLM(
n4)。ユーザープロンプトは次のとおりです。
Below are search results, numbered [n].

{{nodes.n2.text}}

Keep only the studies that directly address: {{input}}
Group them by design (experiment, observational, review). For each, write two sentences: what was done and what was found. Keep the [n] marker after every claim.- ドキュメント(
n5)— 形式 markdown、名前weekly-digest.md、内容{{nodes.n4.text}}。ファイルは検索の出典カードとともにチャットに表示されます。 - レスポンス(
n6)—{{nodes.n4.text | truncate:800}}、ファイル添付をオンにして END へ。
チェックリストが、つながっていないもの — レスポンスの欠落、未知のテンプレート参照、到達できないステップ — を知らせます。問題がなくなったらテストを開き、実際のテーマで Dev バージョンを実行して、各ステップの詳細ログを確認してください。LLM が不要な論文まで残すなら、プロンプトを絞り込んで再テストします。
要約に加えて検証もしたいなら、LLM ステップをレビュアーをオンにしたエージェント RAG ステップに置き換えます。トークンは多くかかりますが、スキルの引用チェックが付いてきます。
Dev、Live、予約実行
すべてのエージェントには 2 つの環境があります。Dev は編集・テストするバージョンで、Live に公開がそのスナップショットを取ります。チャット、タスクを実行、予約実行は Live があれば Live を使います。すべての公開は公開履歴に残って復元でき、公開を取り消すと Live のコピーが削除されます。
設定 → 予約実行でダイジェストを毎週に設定し、曜日・時刻・タイムゾーンを選び、各実行のタスクにテーマを書きます。予約実行は Live を使い承認カードに答えられないので、承認ステップはタイムアウト時に承認にするか削除してください。設定には API ステップ用のシークレット(暗号化、書き込み専用)と、persist を付けた変数(最後に処理した id など)を保持するメモリもあります。ログではすべての実行とステップごとのログを確認できます。
知っておきたい上限
| 上限 | 値 |
|---|---|
| 1 回の実行あたりのモデル直接呼び出し(LLM・ドキュメントステップ) | 40 |
| ループの反復 | 最大 20 |
| If / Else の差し戻し | 最大 5 |
| ステップあたりの検索結果 | 最大 50 |
| API 呼び出しのタイムアウト · 応答サイズ | 30 秒 · 1 MiB |
| 関数コード | 10,000 文字、ネットワークなし |
| エージェントステップあたりのレビュアー修正 | 最大 3 |
エージェントもほかのタスクと同じくトークンを使うので、ループの最大回数は予算に合わせて決めてください。
いちばん簡単な始め方:ギャラリーのエージェントを一度実行し、マイエージェントから開いて 1 か所だけ変えてみてください — 注意事項 1 行、データベース、出力名など。詳しいリファレンスはエージェントのカスタマイズ、ワークフローノード、エージェントギャラリーにあります。