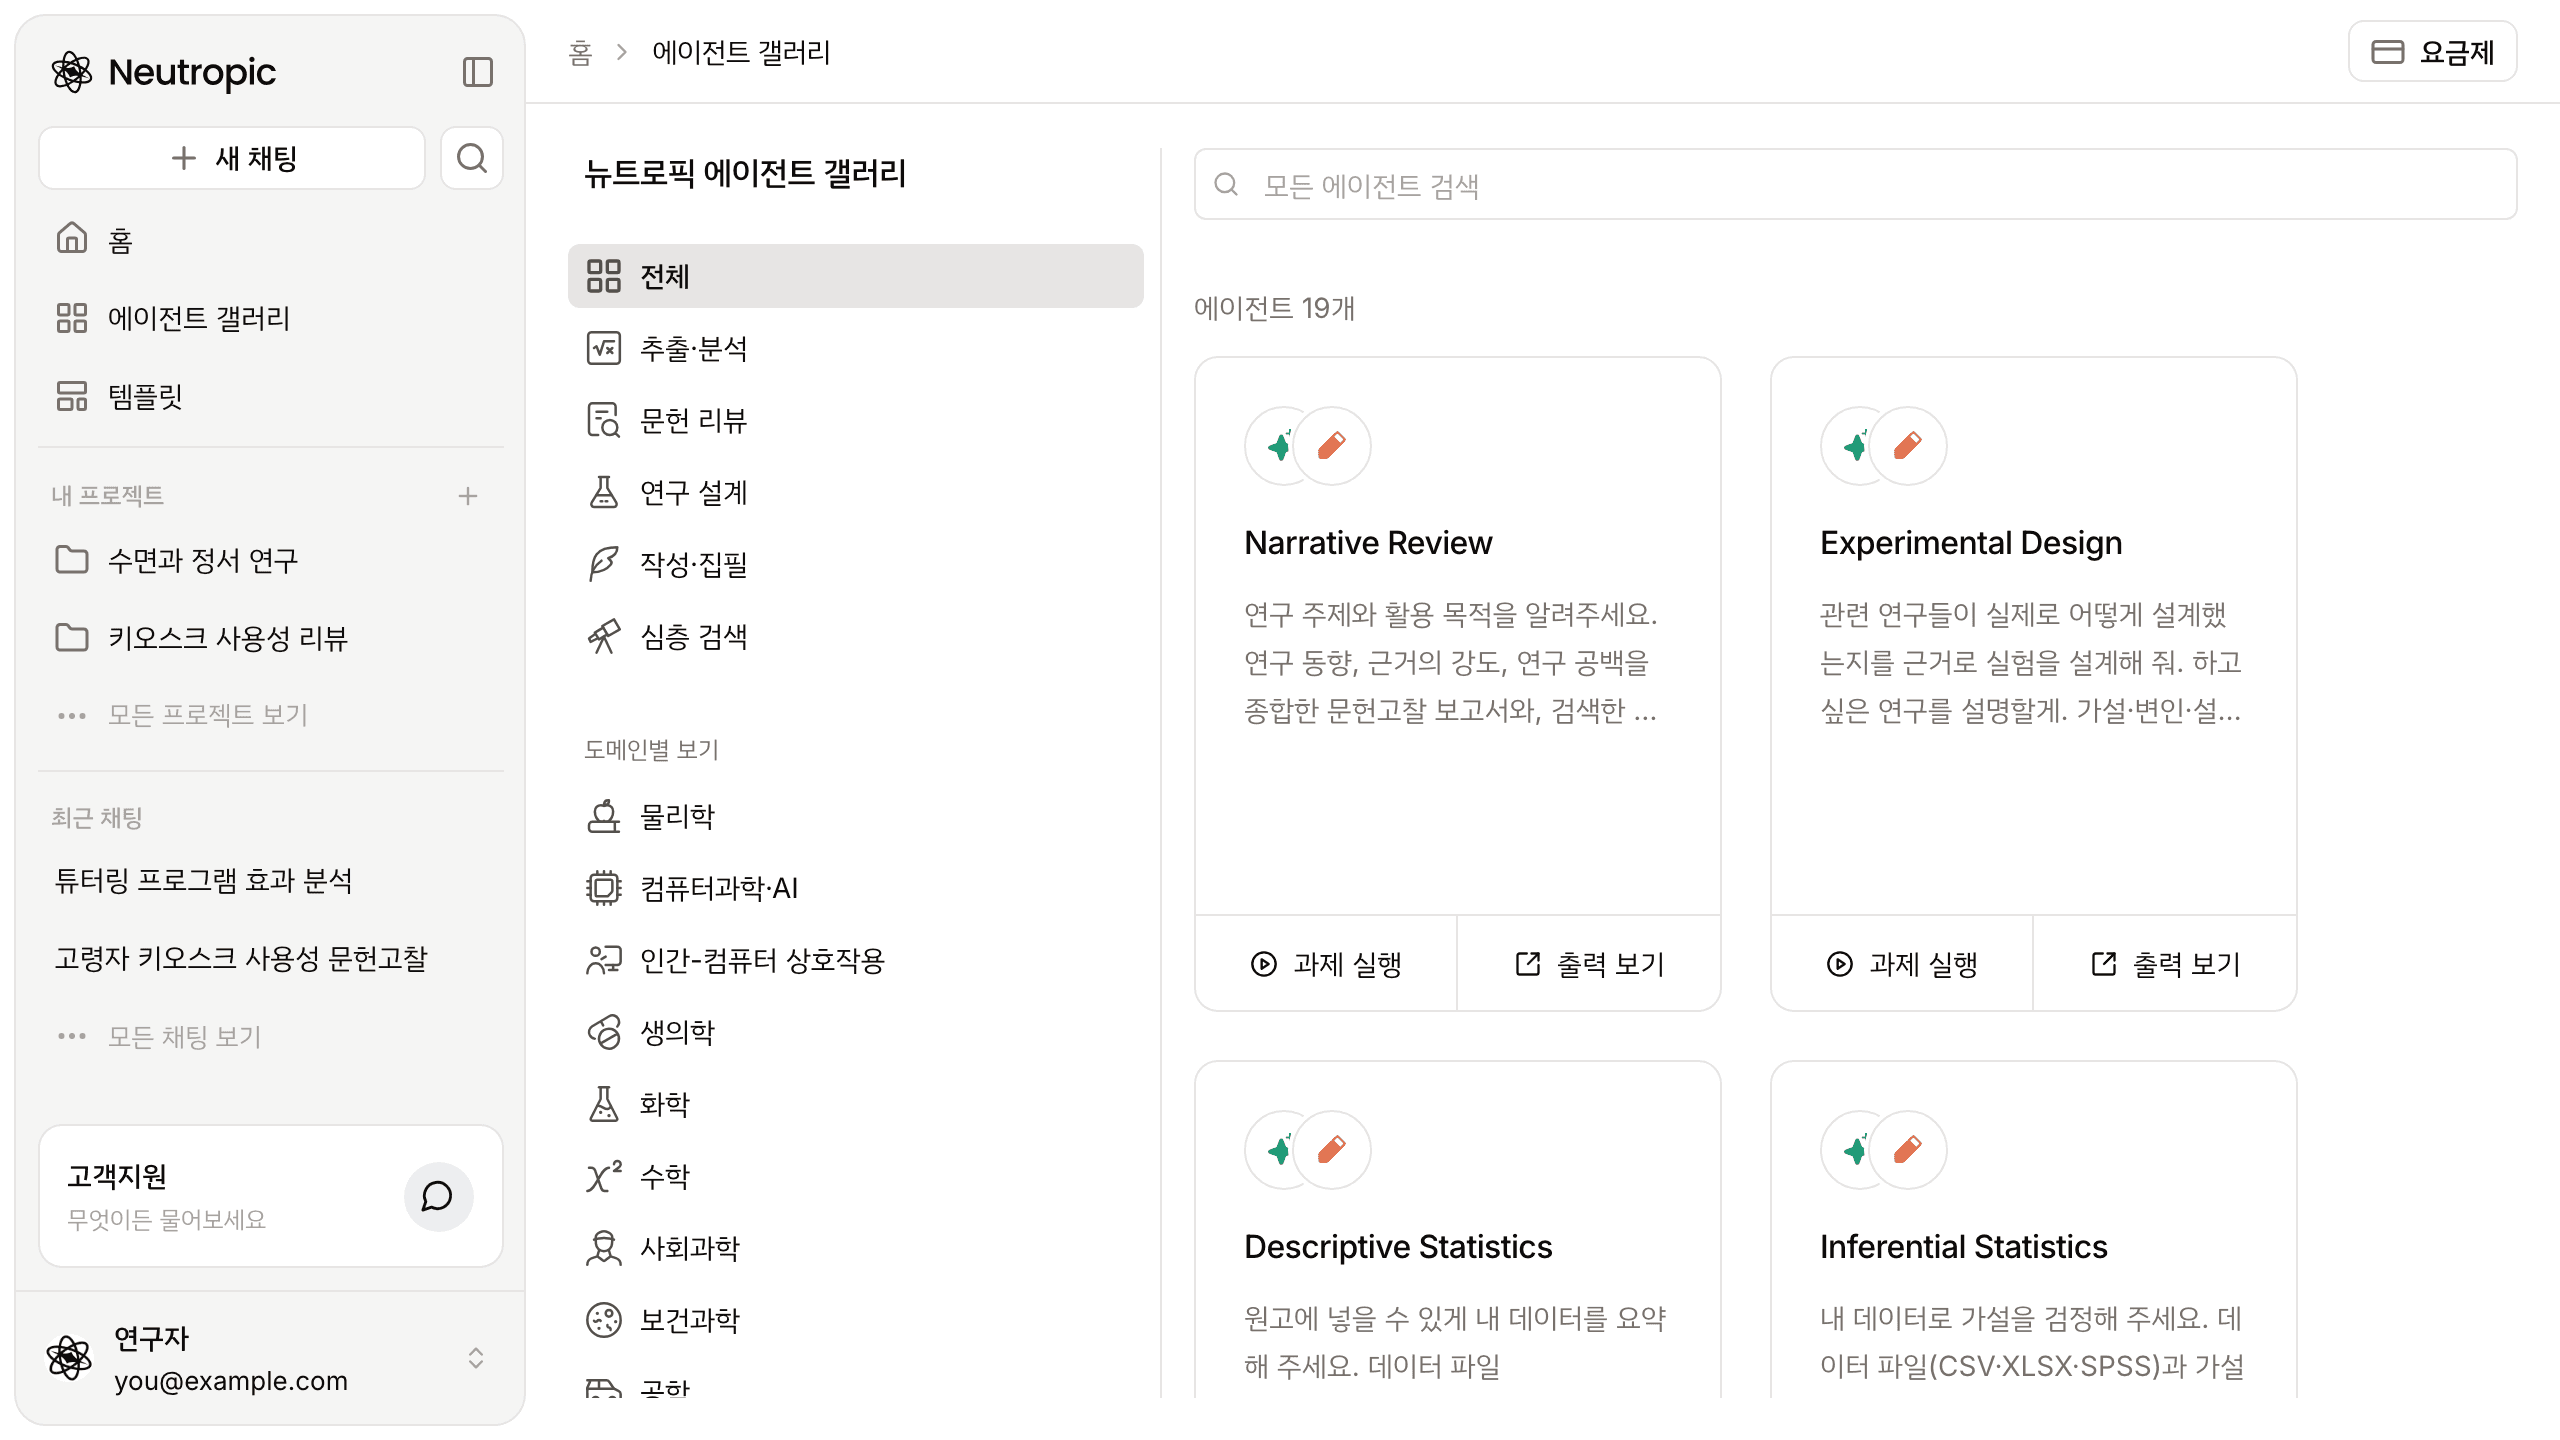
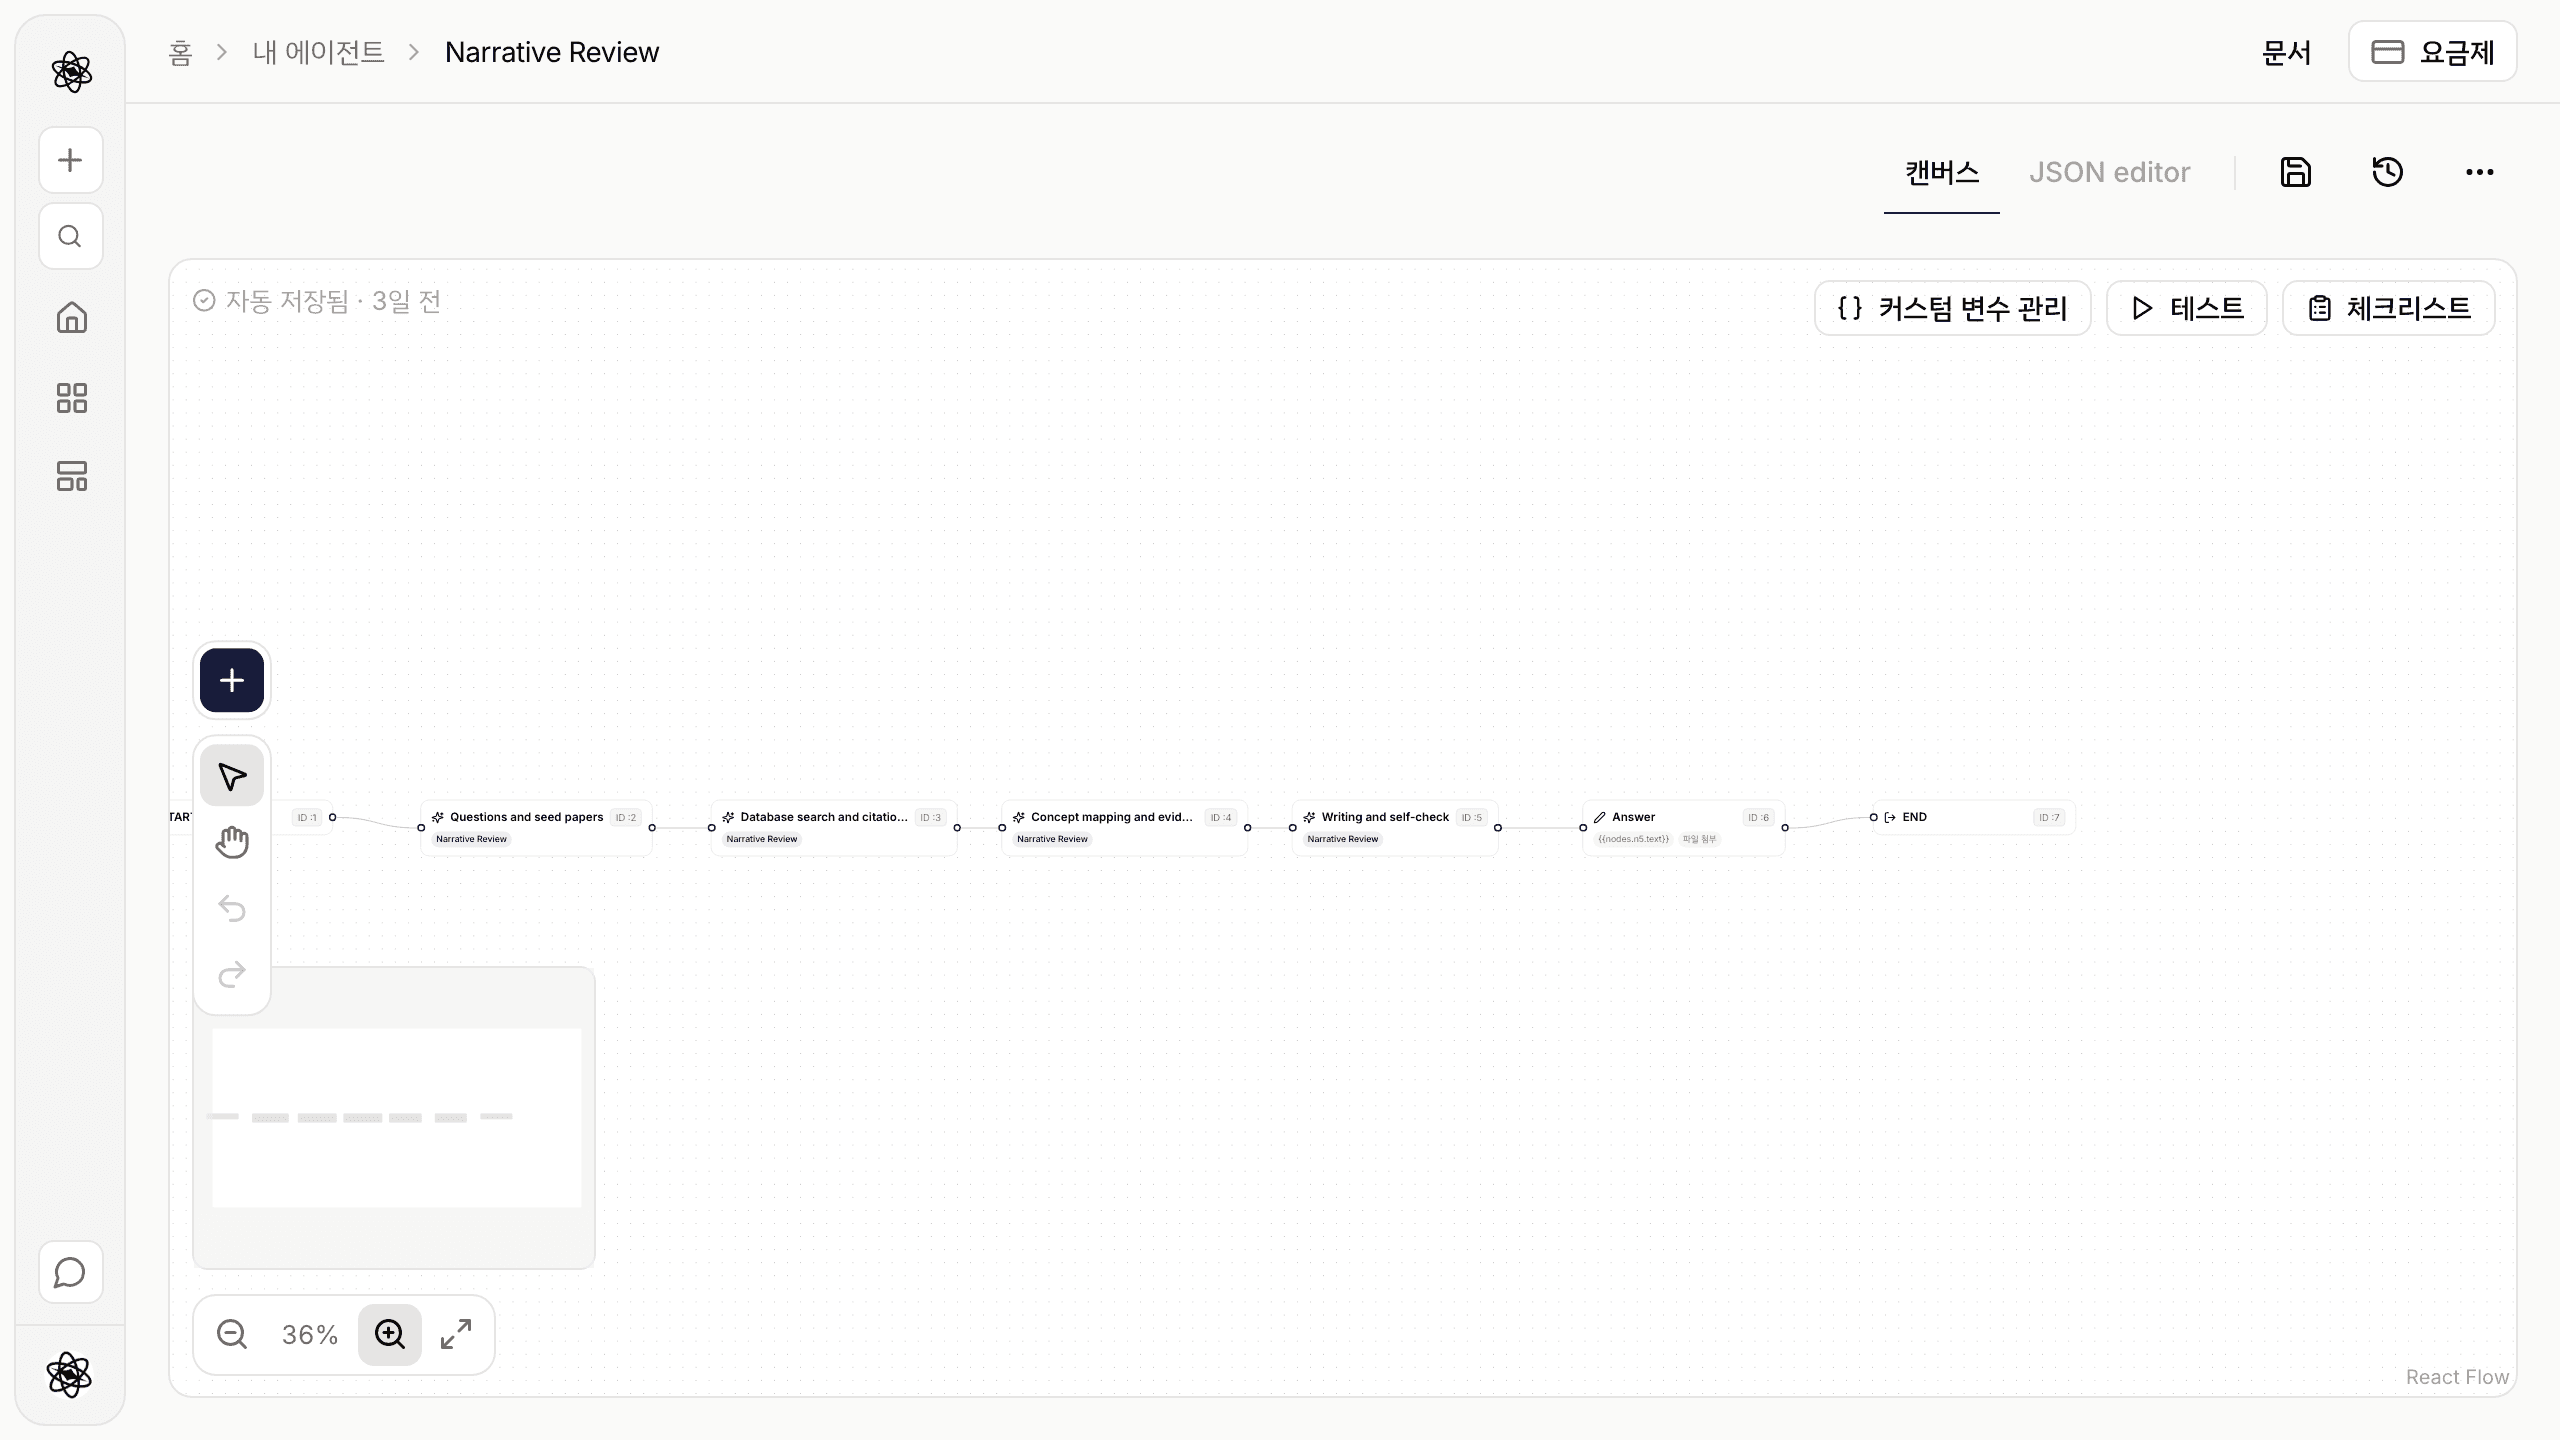
에이전트 갤러리의 에이전트는 블랙박스가 아닙니다. 하나하나가 START에서 END까지 단계를 이은 워크플로이고, 저희가 이 에이전트들을 만들 때 쓴 편집기를 그대로 쓸 수 있습니다. 갤러리 에이전트를 내 연구에 맞게 고칠 수도 있고, 어떤 템플릿에도 없는 일을 하는 에이전트를 만들 수도 있습니다. 연구실용 주간 문헌 요약, 우리만의 포함 기준을 적용하는 스크리닝 단계, 결과를 연결된 도구에 저장하는 파이프라인 같은 것들이요.
이 글에서는 내 에이전트가 모이는 곳, 커스터마이징의 세 단계, 구성 요소, 그리고 몇 분이면 따라 만들 수 있는 작은 예제를 다룹니다.
내 에이전트
실행했거나 만든 에이전트는 내 에이전트(/my-agents)에 나열되며, 각각 과제 실행, 출력 보기, 설정이 있습니다. 여기서 새 에이전트를 만들거나 기존 에이전트를 엽니다.
커스터마이징의 세 단계
1. 설정 후 실행. 내 에이전트에서 과제 실행을 누르면 다이얼로그가 열립니다. 공유 템플릿은 건드리지 않습니다. 에이전트 이름, 실행할 과제, 지식 베이스(PDF, Word, PowerPoint, HWP, 텍스트, Markdown, CSV를 끌어다 놓으면 실행 전에 색인됩니다), 이번 런의 노력 수준, 검색할 문헌 데이터베이스를 정합니다. 구독 데이터베이스는 먼저 연결해야 합니다.
2. 단계 편집. 에이전트를 열고 워크플로로 갑니다. 단계를 선택하면 오른쪽 인스펙터에 설정이 나옵니다. 갤러리 에이전트는 모두 에이전틱 RAG 단계로 만들어져 있는데, 여기서 흔히 고치는 것은 지시문(범위, 분석 선택, 파일 이름), 주의 사항(에이전트가 엄격한 제약으로 받아들이는 체크리스트 줄), 리뷰어(결과가 중요하면 1~3회 수정으로 켜기), 지식(내 문서를 읽을지), 그리고 단계가 만들 파일의 출력 이름입니다.
3. 나만의 논리 추가. 분기, 루프, 승인, Python, HTTP 호출, 커넥터 — 아래의 노드 그룹입니다.
구성 요소
캔버스의 + 메뉴로 세 그룹의 단계를 추가합니다.
| 그룹 | 노드 | 쓰임 |
|---|---|---|
| 코어 | LLM · 검색 · 에이전틱 RAG | 모델 직접 호출 한 번, 번호가 붙어 인용할 수 있는 결과를 내는 모델 없는 검색, 계획·검색·코드 실행·파일 작성까지 하는 스킬 전체 실행 |
| 논리·변환 | If / Else · 후처리 · 문서 · 변수 할당 · 응답 · 루프 · 승인 | 분기, 결정적 텍스트 변환, 파일 저장, 변수, 최종 답변, 반복, 사람의 승인 카드 |
| 유틸리티 | API · 함수 · 커넥터 | 시크릿을 쓰는 HTTP 호출, 샌드박스 Python, 커넥터 툴 직접 호출 |
문서에 나온 기준을 따르면 됩니다. 도구나 판단이 필요한 단계(데이터 분석, 인용이 달린 보고서 작성)는 에이전틱 RAG, 잘 정의된 변환 한 번(분류, JSON 추출, 입력 하나 요약)은 LLM, 검색 자체에 모델 호출을 쓰지 않고 출처에 번호를 붙이고 싶다면 그 앞에 검색을 둡니다. 노드별 설명은 워크플로 노드에 있습니다.
단계 연결하기
프롬프트, 지시문, 질의, 파일 내용, 조건 같은 텍스트 필드는 템플릿입니다. {{ … }}는 단계가 실행되기 전에 모델 없이 채워집니다.
| 참조 | 의미 |
|---|---|
{{input}} | 보낸 과제 텍스트 |
{{input.files}} | 첨부한 파일 이름 |
{{nodes.<id>.text}} | 앞 단계의 텍스트 출력(id는 단계마다 표시됨) |
{{nodes.<id>.items}} · .count | 검색 결과 목록과 개수 |
{{nodes.<id>.json}} | JSON 출력을 켠 LLM 단계, API 단계, 함수 단계의 JSON |
{{nodes.<id>.verdict}} | 에이전트 단계의 리뷰어 판정: sound, caution, issues |
{{vars.<key>}} | 워크플로 변수 |
{{secrets.<NAME>}} | 설정에 등록한 시크릿 — API 단계 전용, 로그에서 마스킹 |
필터로 값을 바꿀 수 있습니다. {{nodes.n2.items | first:5 | lines}}는 첫 다섯 개 결과를 한 줄에 하나씩 냅니다. 이 밖에 json, join:", ", truncate:N, upper, lower, count가 있습니다. 직접 칠 일은 많지 않습니다. 모든 텍스트 필드에 참조를 대신 써 주는 삽입 선택기가 있습니다.
예제: 주간 문헌 요약
연구실에서 매주 월요일 한 주제의 새 논문을 짧게 요약해 받고 싶다고 해 봅시다. 새 에이전트를 만들고 START와 END 사이에 다섯 단계를 잇습니다.
- 검색(
n2) — 질의{{input}}, 소스는 PubMed + Crossref와 OpenAlex, 한도 20, 연도는 작년부터. - If / Else(
n3) — 조건{{nodes.n2.count}}gt0. false 핸들은 이번 주에는 해당하는 새 논문이 없습니다라고 쓰는 응답으로 갔다가 END로 이어집니다. - true 핸들에 LLM(
n4). 사용자 프롬프트는 이렇습니다.
Below are search results, numbered [n].

{{nodes.n2.text}}

Keep only the studies that directly address: {{input}}
Group them by design (experiment, observational, review). For each, write two sentences: what was done and what was found. Keep the [n] marker after every claim.- 문서(
n5) — 형식 markdown, 이름weekly-digest.md, 내용{{nodes.n4.text}}. 파일이 검색에서 나온 출처 카드와 함께 채팅에 나타납니다. - 응답(
n6) —{{nodes.n4.text | truncate:800}}, 파일 첨부를 켜고 END로.
체크리스트가 연결되지 않은 것 — 빠진 응답, 모르는 템플릿 참조, 닿지 않는 단계 — 을 알려 줍니다. 깨끗해지면 테스트를 열어 실제 주제로 Dev 버전을 돌리고, 단계마다 상세 로그를 읽어 보세요. LLM이 원치 않는 논문까지 남긴다면 프롬프트를 더 좁히고 다시 테스트합니다.
요약에 더해 검증까지 원한다면 LLM 단계를 리뷰어를 켠 에이전틱 RAG 단계로 바꾸세요. 토큰은 더 들지만 스킬의 인용 점검이 따라옵니다.
Dev, Live, 예약 실행
모든 에이전트에는 환경이 두 개 있습니다. Dev는 편집하고 테스트하는 버전이고, Live 로 게시가 그 스냅샷을 뜹니다. 채팅, 과제 실행, 예약 실행은 Live가 있으면 Live를 씁니다. 모든 게시는 게시 이력에 남아 복원할 수 있고, 게시 해제로 Live 복사본을 지웁니다.
설정 → 예약 실행에서 요약 에이전트를 매주로 켜고, 요일·시각·시간대를 고르고, 매 실행의 과제에 주제를 적습니다. 예약 실행은 Live를 쓰고 승인 카드에 답할 수 없으므로, 승인 단계는 시간 초과 시 승인으로 두거나 제거하세요. 설정에는 API 단계용 시크릿(암호화, 쓰기 전용)과 persist로 표시한 변수(마지막으로 처리한 id 등)를 보관하는 메모리도 있습니다. 로그에서 모든 런과 단계별 로그를 볼 수 있습니다.
알아 두면 좋은 한도
| 한도 | 값 |
|---|---|
| 런당 모델 직접 호출(LLM·문서 단계) | 40 |
| 루프 반복 | 최대 20 |
| If / Else 되돌림 | 최대 5 |
| 단계당 검색 결과 | 최대 50 |
| API 호출 시간 제한 · 응답 크기 | 30초 · 1 MiB |
| 함수 코드 | 10,000자, 네트워크 없음 |
| 에이전트 단계당 리뷰어 수정 | 최대 3 |
에이전트도 다른 과제처럼 토큰을 쓰므로, 루프의 최대 반복은 예산에 맞게 정하세요.
가장 쉬운 시작: 갤러리 에이전트를 한 번 실행하고, 내 에이전트에서 열어 한 가지만 바꿔 보세요. 주의 사항 한 줄, 데이터베이스, 출력 이름 같은 것이요. 전체 레퍼런스는 에이전트 커스터마이징, 워크플로 노드, 에이전트 갤러리에 있습니다.