你好,我们是 Neutropic 团队!
假设导师让你用实验记录做一个"预测是否答对"的模型。照着 Python 教程打乱行、跑 5 折交叉验证,得到一个像样的数字。可是组会上有人问:"同一个参与者是不是同时出现在训练集和测试集里了?"🥲
人类研究的数据大多是这个样子:一位参与者留下多个试次,一位患者留下多次就诊。按行打乱来划分,模型等于在已经见过的人身上被评分,准确率会比用在新的人身上更好看。要避免这一点,就得一项项确认:哪些列不能当预测变量、折怎么划分、有没有只有在结果出现后才知道的变量。
这篇文章跟着认知心理学博士生 周宁,看看第一次用反应任务的实验记录做预测模型的过程。周宁是虚构人物,但下面的界面全部来自 Neutropic 中真实运行的结果。
上传一个文件,只写了一句话
周宁的文件是 trials.csv:90 名参与者各做 8 个试次,共 720 行,包含参与者编号、试次编号、年龄、基线分数、难度、反应时间和是否答对。在 智能体画廊 里选中 预测建模 智能体,附上文件,只写了一句:
请用附件中的实验记录预测每个试次是否答对(correct)。
很短,但该有的都有:预测什么(correct),一行是什么(一个试次)。周宁没说"每位参与者有多行",因为找出这一点正是智能体的工作。
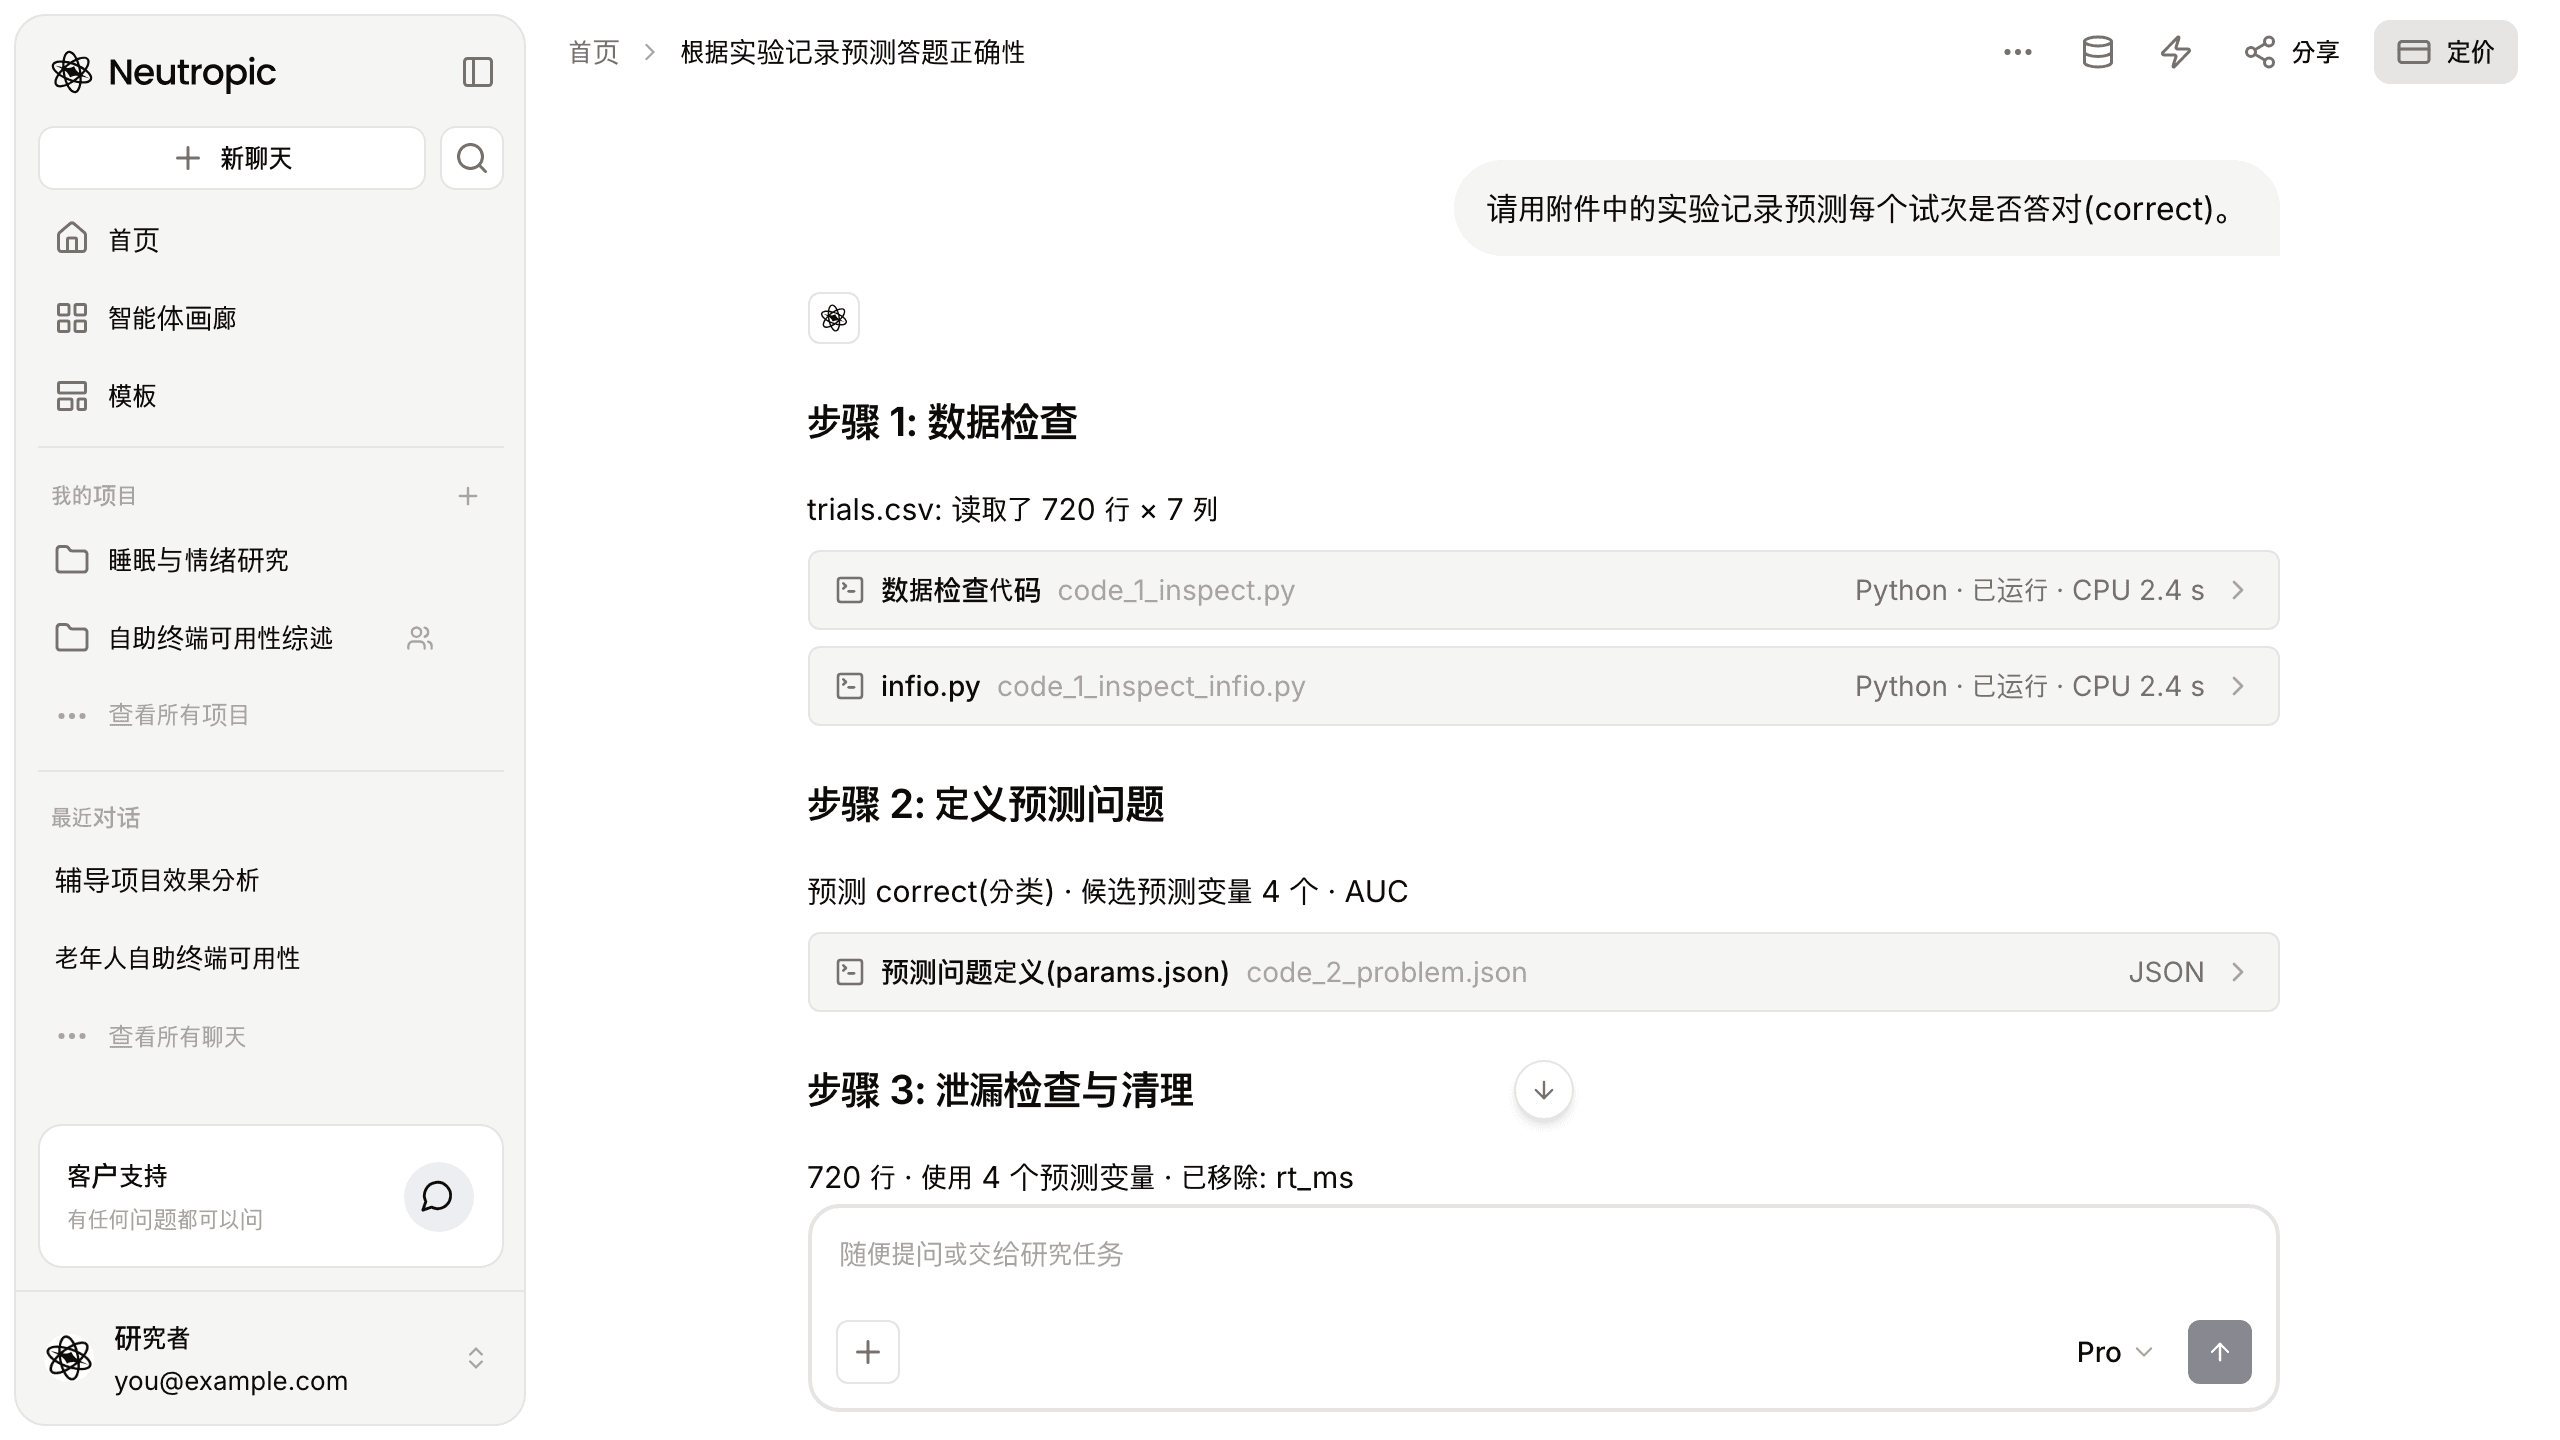
反应时间被当作泄漏变量移除了
智能体按固定的八个步骤依次执行。数据检查 读取了 720 行 × 7 列,定义预测问题 把任务定为"预测 correct(分类)· 候选预测变量 4 个 · AUC"。
关键在第三步 泄漏检查与清理:"720 行 · 使用 4 个预测变量 · 已移除: rt_ms"。反应时间要等参与者作答的那一刻才会记录下来。如果目的是在作答之前预测对错,它就是不该用的信息。
第四步 基线模型 使用了 按 participant_id 分组的 5 折交叉验证。参与者编号不作为预测变量,而是作为划分折的分组单位。同一个人的 8 个试次都在同一折里,所以评估时模型面对的永远是没见过的人。只用结果比例的基线模型 AUC 为 0.500。
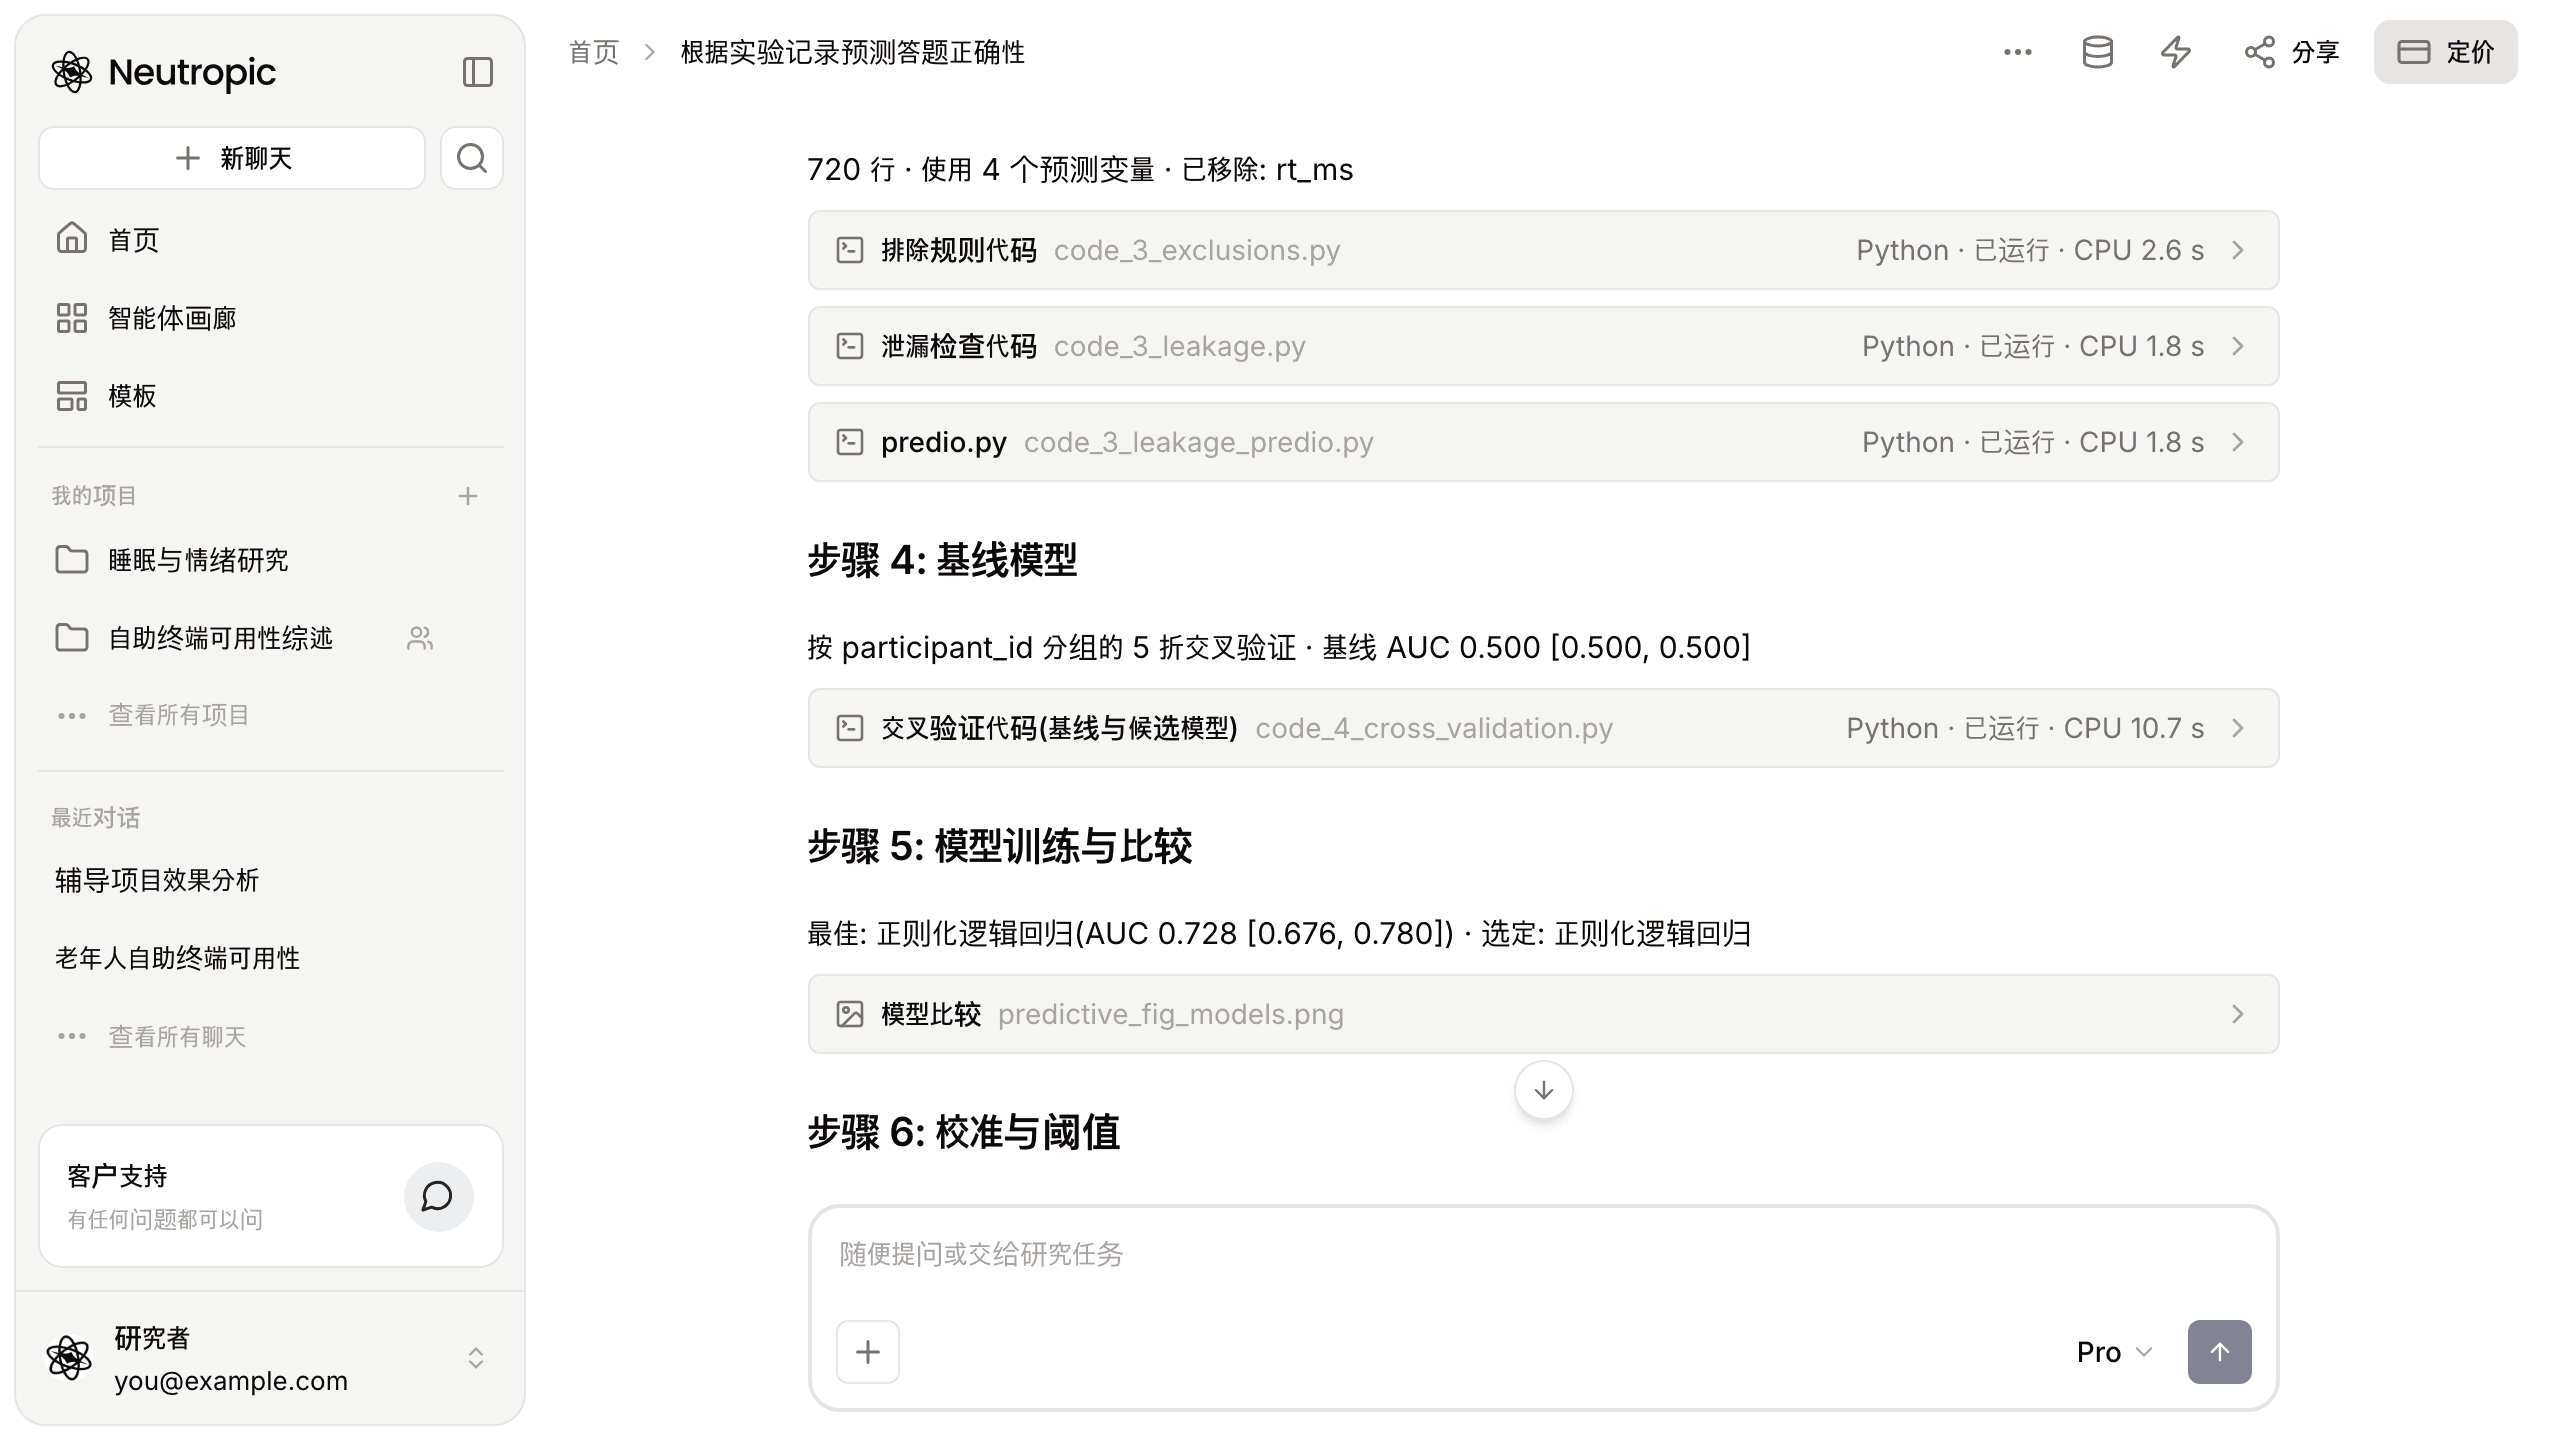
四个模型里,最简单的那个胜出
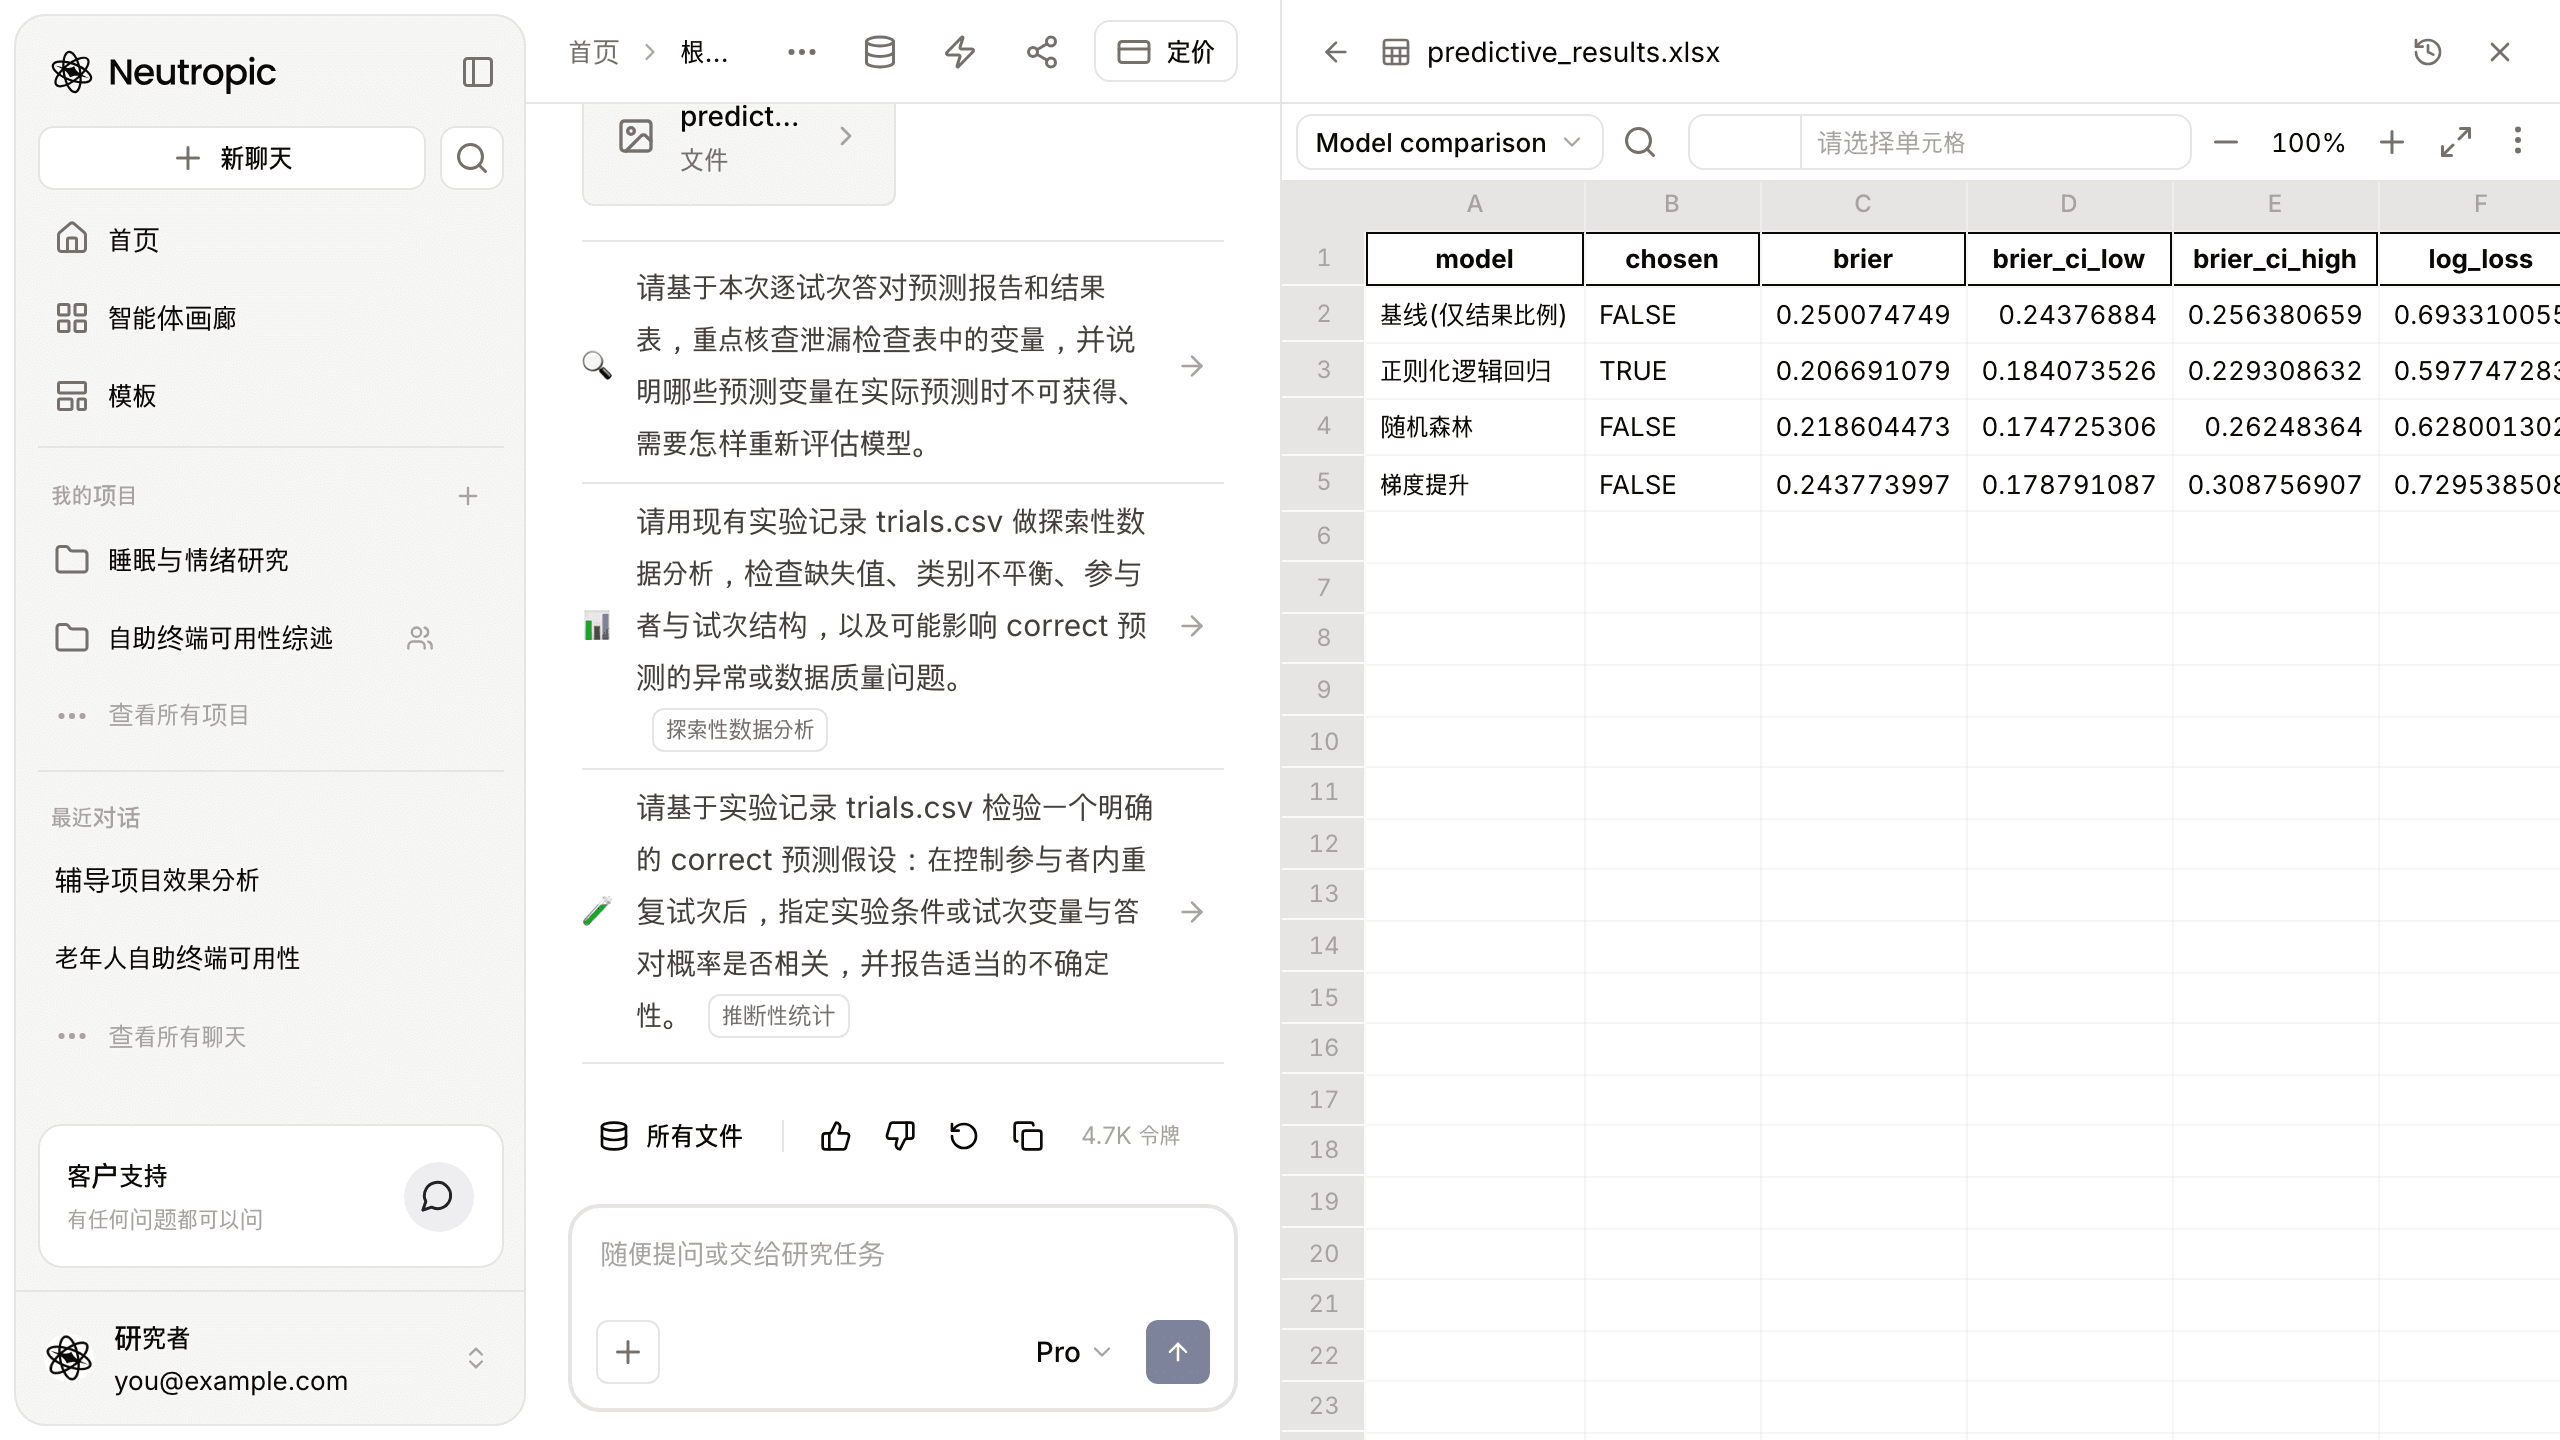
第五步在同样的折上比较了正则化逻辑回归、随机森林和梯度提升。最佳模型是 正则化逻辑回归,AUC 0.728,95% CI [0.676, 0.780]。结果表里的 Brier 分数也是同一个方向:基线 0.250、正则化逻辑回归 0.207、随机森林 0.219、梯度提升 0.244。
接着 校准与阈值 报告:校准斜率 0.98、截距 0.00,阈值 0.501 时灵敏度 0.61、特异度 0.75。贡献与亚组 显示贡献最大的变量是 baseline_score、difficulty 和 age。
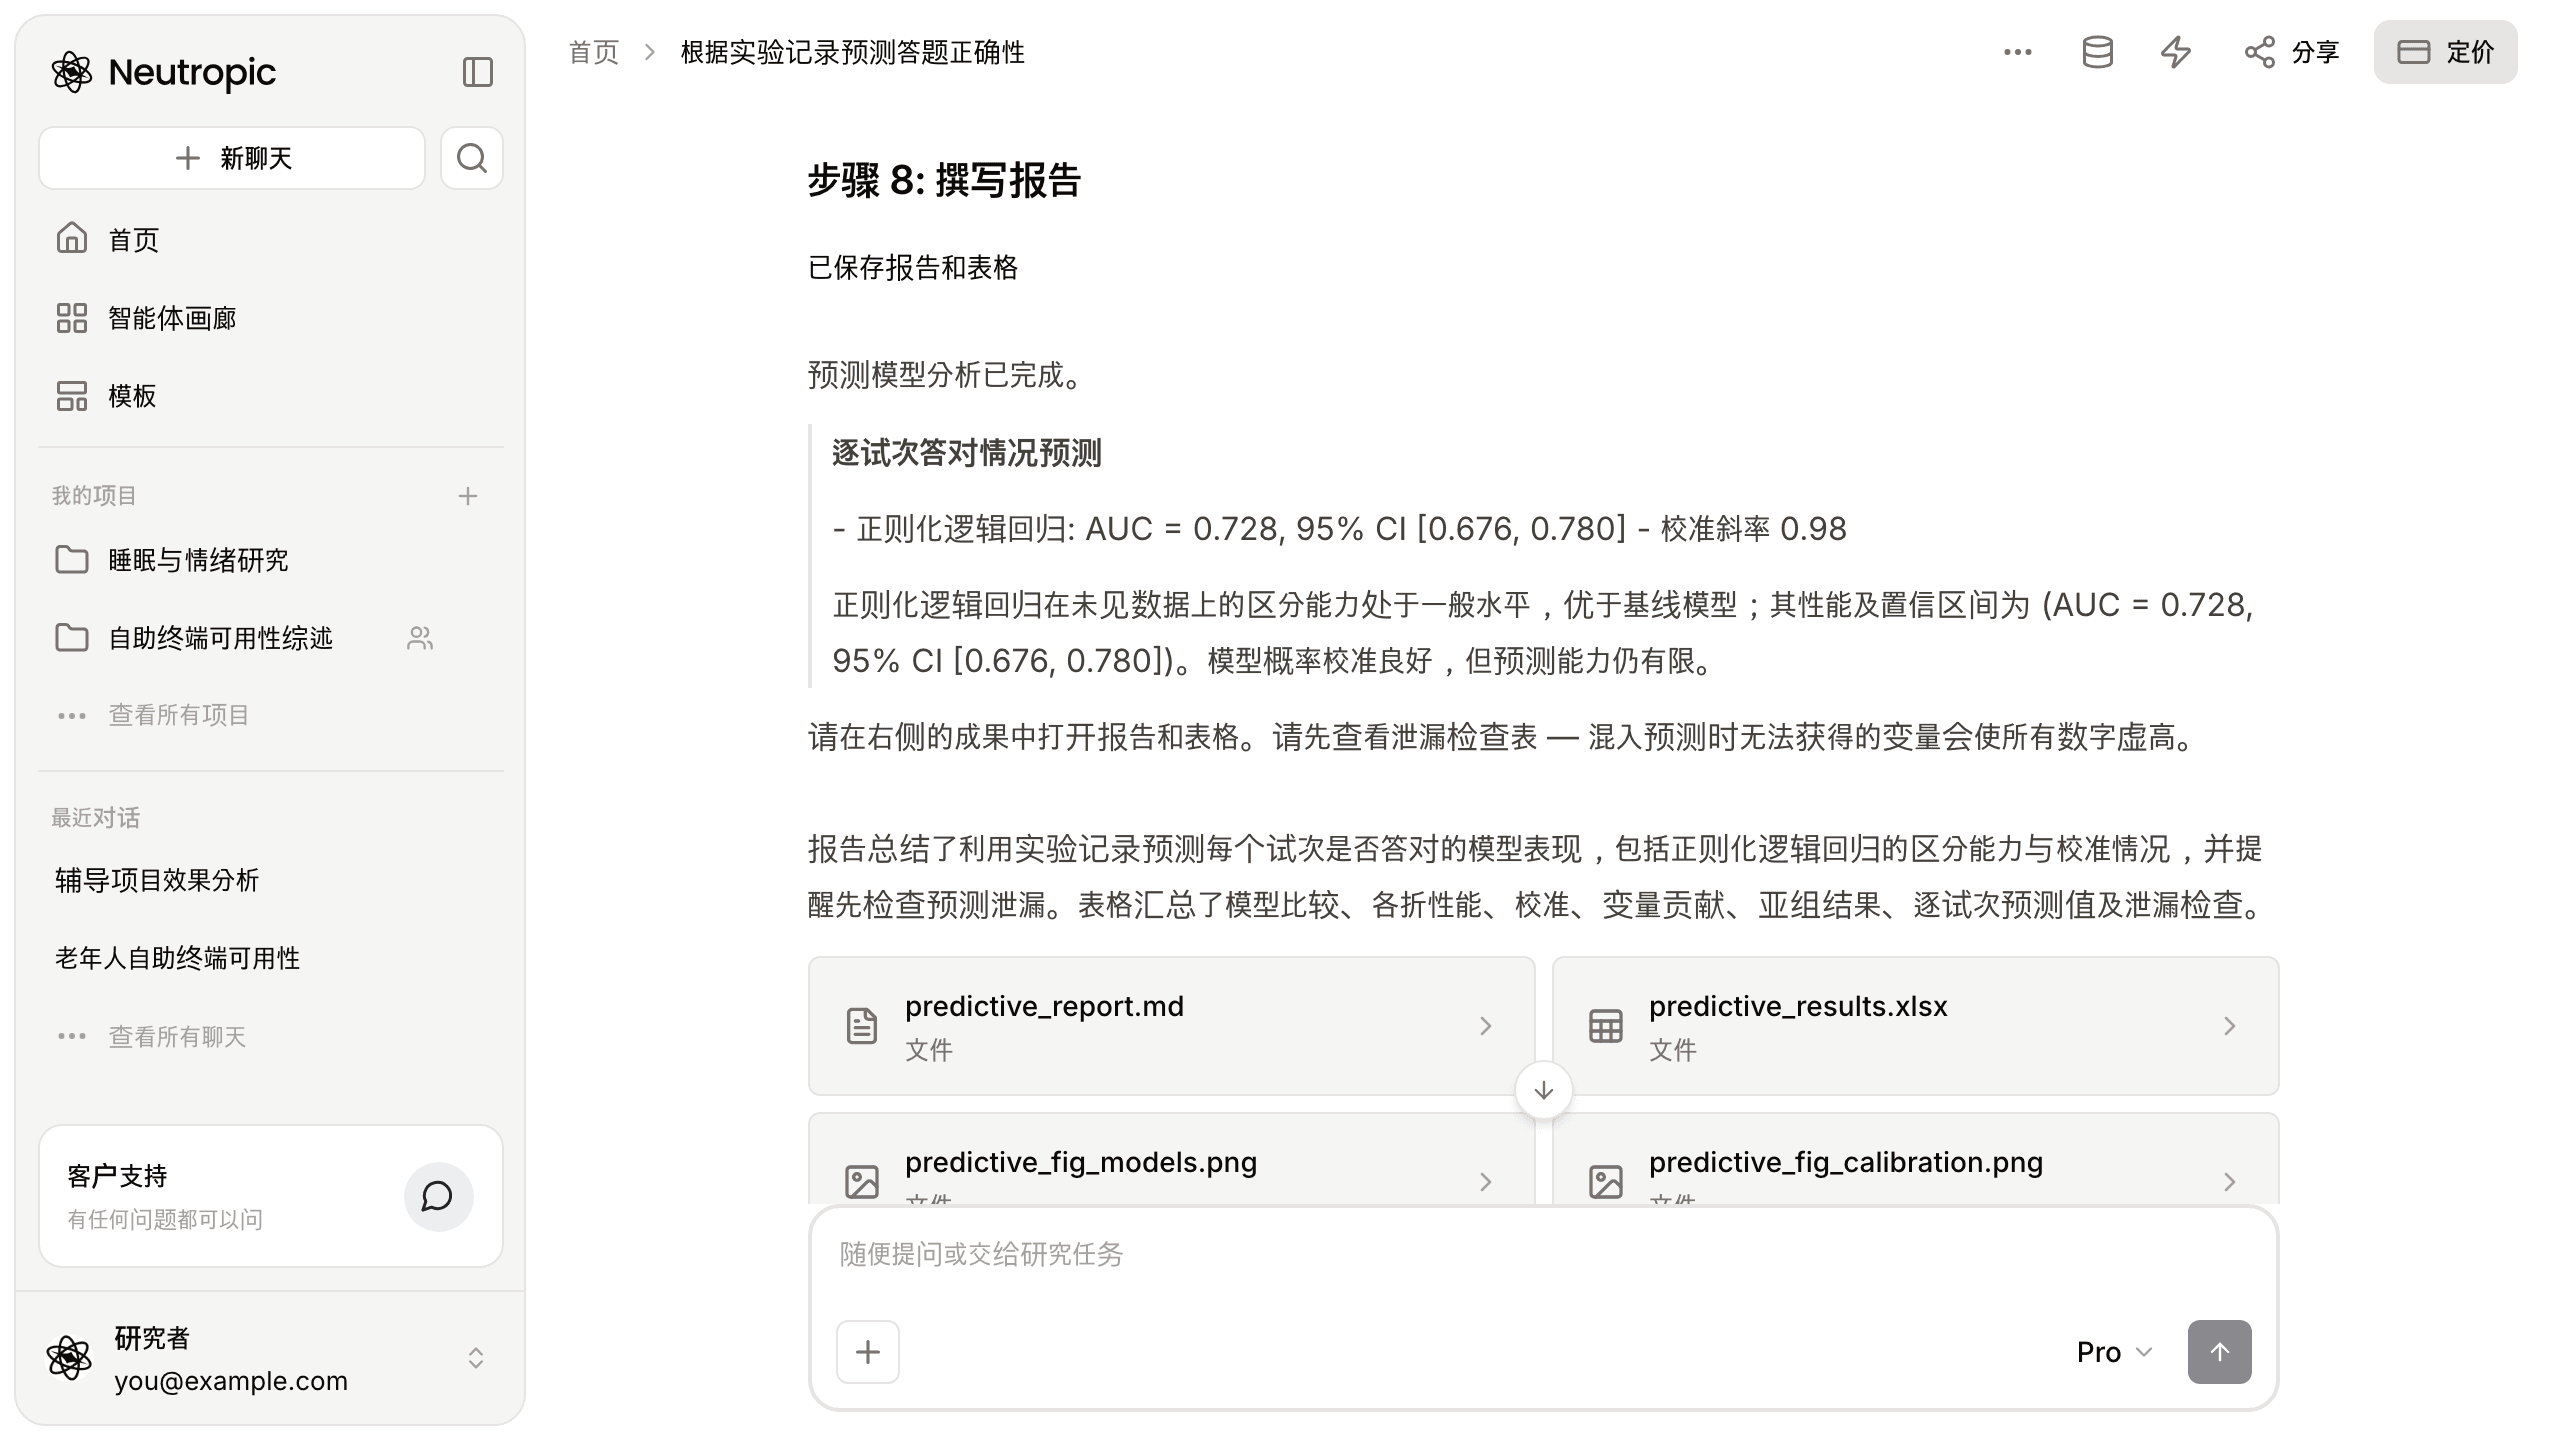
周宁差点写下"模型预测得很好"
看到 0.728,周宁很想写"模型能很好地预测答题对错"。但答案恰恰提醒了这一点:正则化逻辑回归优于基线,区分能力处于一般水平;概率校准良好,但预测能力仍有限。
还有一件事。周宁原本觉得反应时间"肯定有用",打算放进模型。要不是智能体把它移除,模型就会用只有作答时才知道的信息来做预测。答案最后也写着:"请先查看泄漏检查表——混入预测时无法获得的变量会使所有数字虚高。"
结果表和下一步建议都拿到了
成果有两个:predictive_report.md 报告和 predictive_results.xlsx 结果表。表格汇总了模型比较、各折性能、校准、变量贡献、亚组结果、逐试次预测值和泄漏检查。点开每一步的代码框,就能看到实际运行的 Python 代码。
答案下方给出了接下来可以做的事:
- 重点核查泄漏检查表中的变量,说明哪些预测变量在实际预测时不可获得、需要怎样重新评估模型
- 用 trials.csv 检查缺失值、类别不平衡、参与者与试次结构等数据质量问题 — 探索性数据分析 智能体
- 在控制参与者内重复试次后,检验试次变量与答对概率的关系 — 推断性统计 智能体
点一下,就在同一个对话里接着做。
可能虚高的数字,变成了以新参与者为准的数字
| 开始时 | 现在 | |
|---|---|---|
| 交叉验证 | 打算按行打乱划分 | 按 participant_id 分组的 5 折交叉验证 |
| 预测变量 | 打算把所有列都放进去 | 移除反应时间后的 4 个 |
| 模型 | 不知道该用哪个 | 含基线在内比较 4 个,选定正则化逻辑回归 |
| 性能 | 只有一个数字 | AUC 0.728 [0.676, 0.780],校准斜率 0.98 |
| 成果 | 没有 | 报告、结果表、每一步的代码 |
当然也有局限。0.73 左右的 AUC 属于中等区分能力,够不够用要根据用途事先确定。分组交叉验证估计的是对新参与者的表现,而不是已知参与者下一个试次的表现。哪些变量在预测时可用,最终也要结合自己的研究问题来判断。
本文使用 Pro,用时约 100 秒。Pro 会增加校准、阈值、变量贡献和亚组分析。Lite(免费方案)只做到模型比较;Expert 还会加入稳健性检查和更长的讨论。
重复测量数据的预测性能,要以"新的人"为准来衡量。一个文件、一句话,就能从这个标准开始。
这周就像周宁一样,上传实验记录,用一句话提问吧。免费开始使用 Neutropic