你好,我们是 Neutropic 团队!
"用正念App能不能减轻考试焦虑?"有了这样的想法,总想马上动手设计实验。可导师的第一个问题几乎是固定的:"已有研究查过了吗?"🥲
真去查才知道不容易。每个检索词都能搜出几百篇,是App研究还是线下课程,是大学生还是上班族,得一篇篇点开摘要才看得出来。好不容易筛出几篇,"到底有没有效果?"这个问题还是很难回答。
这篇文章跟着教育心理学硕士生 林悦,看看设计学位论文实验之前,怎样先梳理已有研究。林悦是虚构人物,但下面的界面全部来自 Neutropic 中的真实运行。
把想知道的四件事写进一段话
林悦在 智能体画廊 打开 叙述性综述 智能体,选择 Pro,发送了这段话,没有附加任何文件:
请帮我梳理关于正念App能否减轻大学生焦虑或压力的已有研究。以随机对照试验为主,我想了解用了哪些App和干预时长、对照组是什么、效果有多大,以及这些研究的局限。
这个请求好在两点:一是把范围收窄了(大学生、正念App、焦虑或压力、随机对照试验),二是明确了要提取的四类信息(App与时长、对照组、效果大小、局限)。这些正是之后设计实验时马上要用到的信息。
问题拆成三个,分 9 个步骤收集文献
运行分 9 个步骤,三分钟左右完成。步骤 1 目的与问题 把请求整理成 3 个核心问题:用了哪些App、干预时长与对照条件;效果大小及其差异如何;研究在设计、测量和报告方面有哪些主要局限。概念也固定为正念App干预、大学生、焦虑、压力、随机对照试验五个。
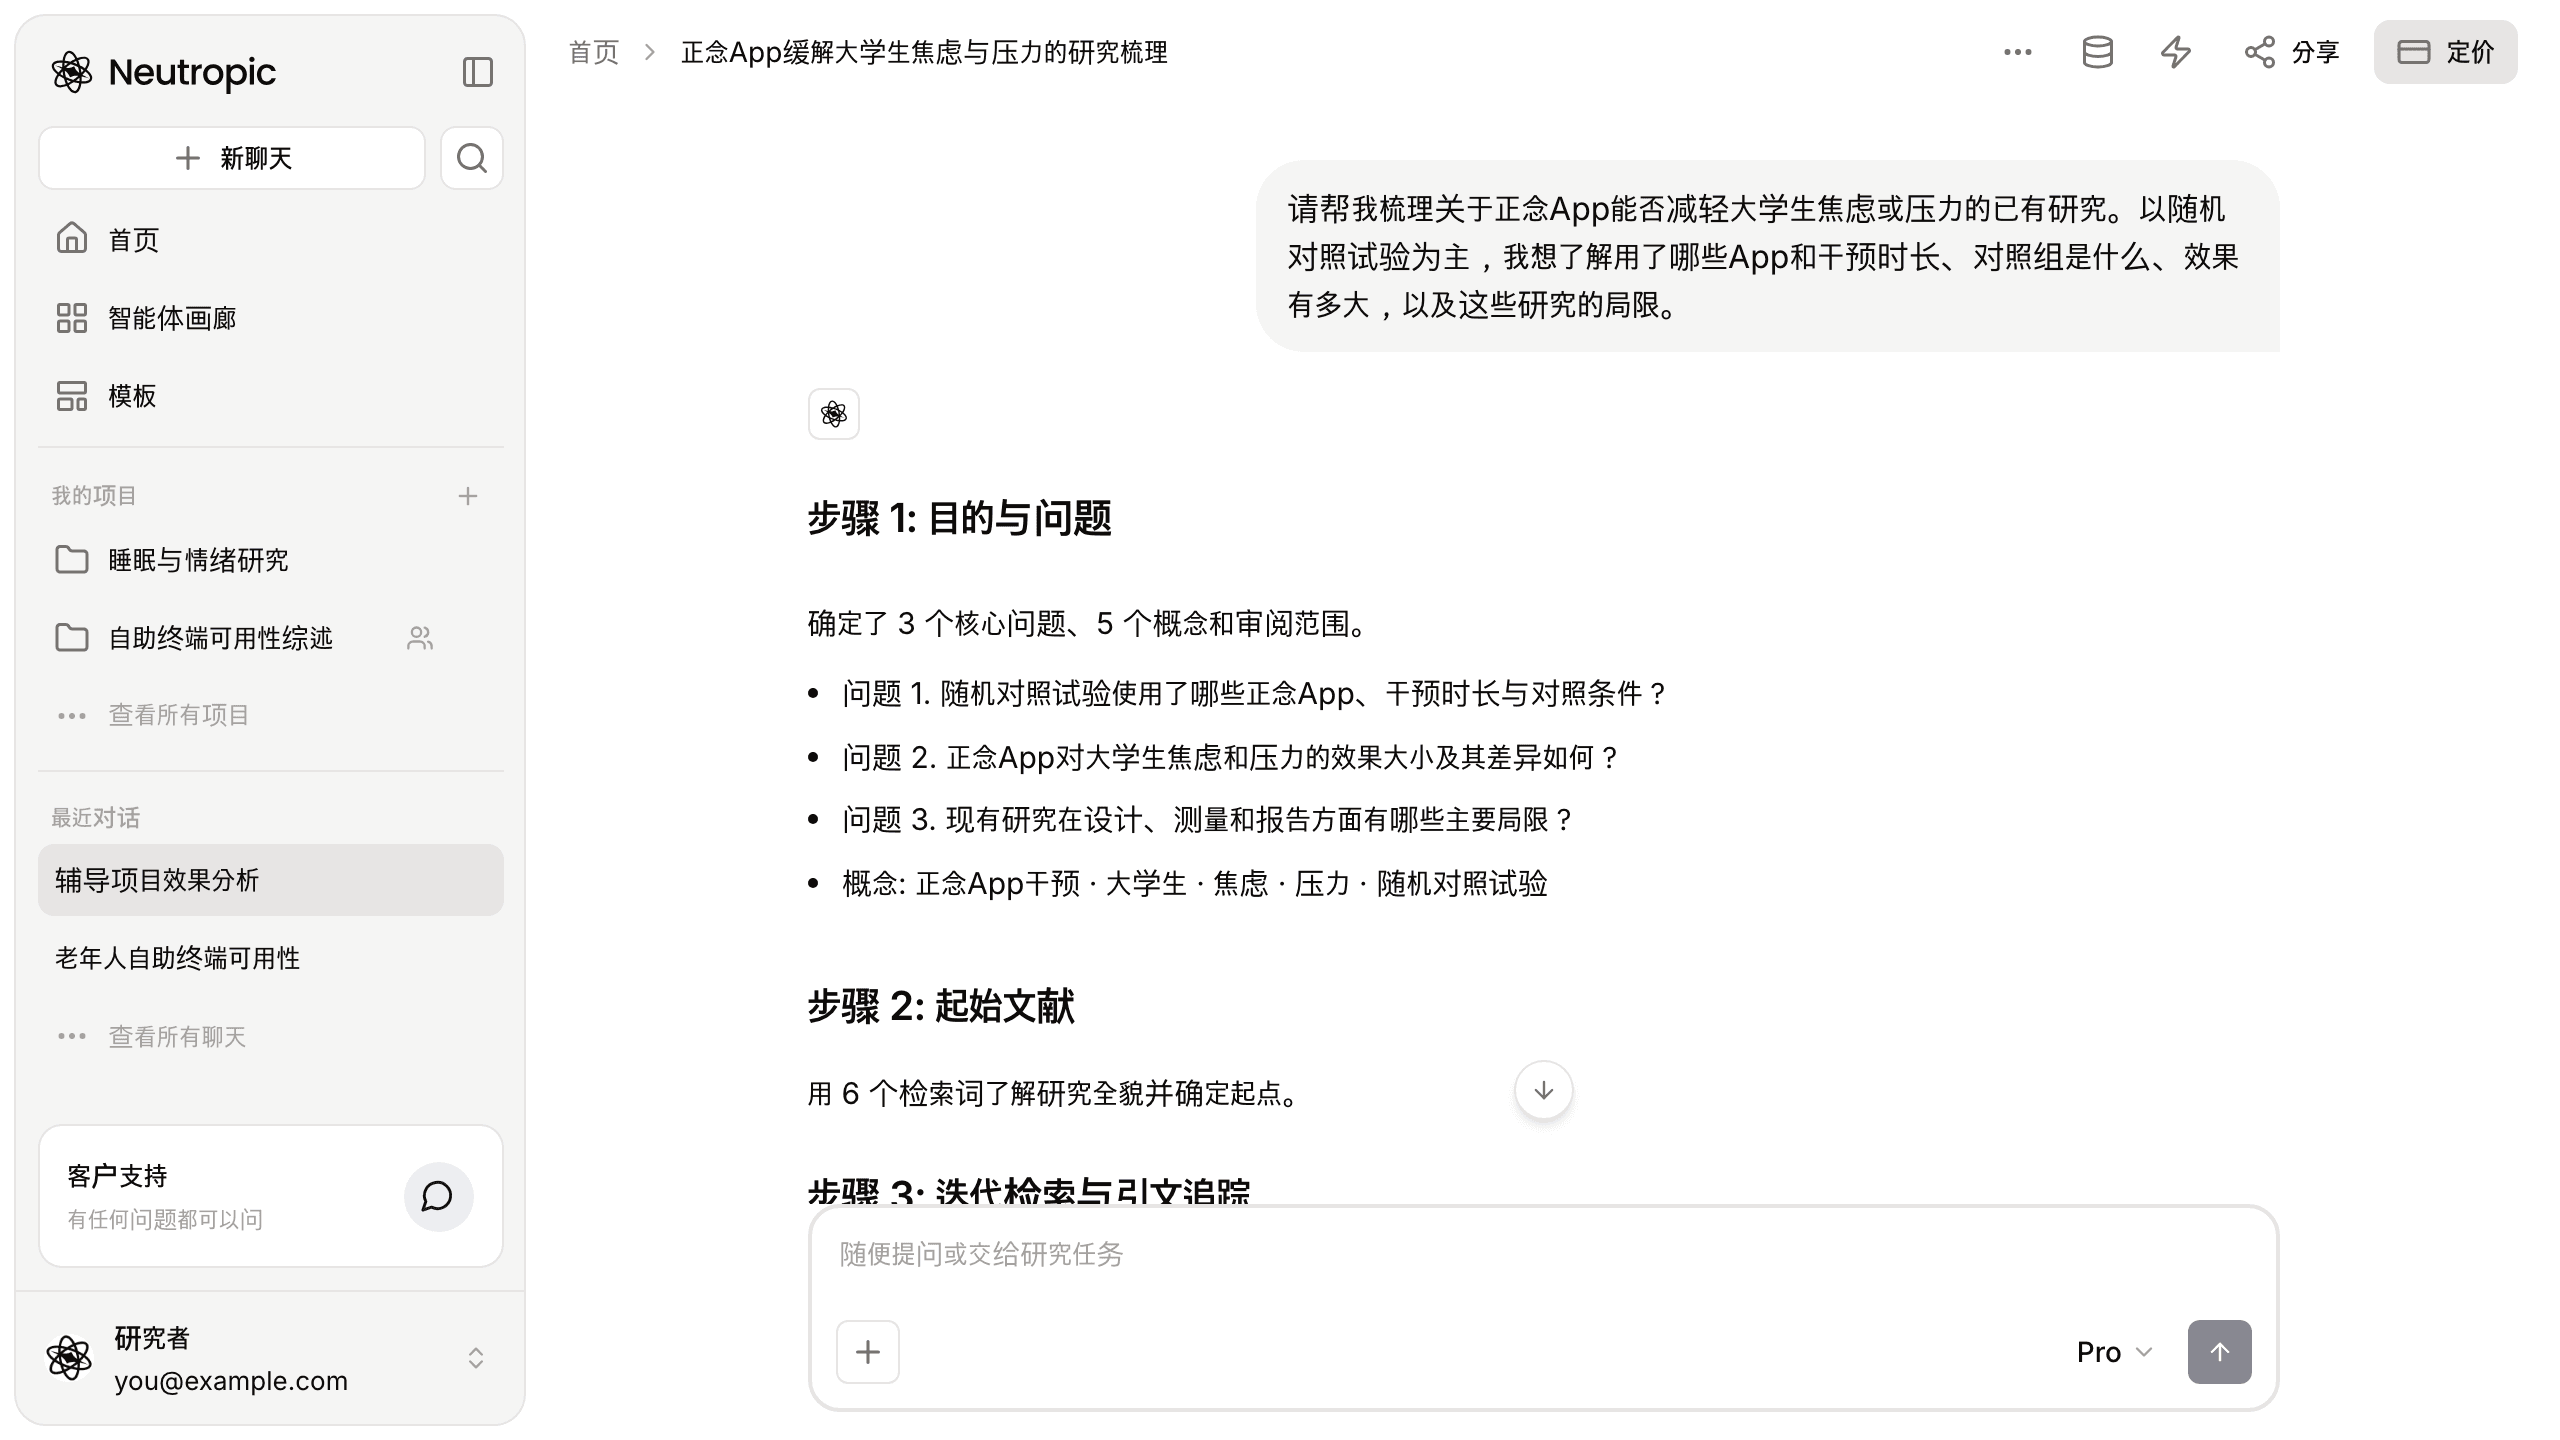
步骤 2、3 先用 6 个检索词确定起点,再从多个数据库收集了 200 篇文献,其中 61 篇是顺着核心论文的参考文献和施引文献找到的(引文追踪)。步骤 4 饱和判断 记录得很坦诚:在这个级别 1 轮引文追踪的上限处停止,尚未达到饱和。
200 篇里留下 15 篇,其余都附上了排除理由
步骤 5 筛选与记录 从 200 篇中选定 15 篇,其余 185 篇都附了理由:对象或情境超出范围 159 篇,与主题无关 16 篇,相关性高但超出本次审阅规模 9 篇。所有判断都保存在"筛选结果"表里,林悦想知道"这篇为什么被排除"时,随时可以查。
步骤 6、7 按概念归类并记录证据水平:随机实验 11 项、准实验 2 项、无结果 1 项、综述 1 项。前两个问题被判为 暂时得到支持(尚未确立),并写明了原因:证据文献中读过全文的不到一半,因此最多只能到这一级。
每条结论都标着证据强度
最终答案列出的试验五花八门:Calm、Sanvello、Ten Percent Happier、Brightmind、Stop, Breathe & Think、Headspace 等App,干预从 4 周到 8 周不等,也有 30 天和至少 6 周的方案;对照条件有等待名单、维持日常作息、不使用App、数学游戏、积极对照和面对面正念训练。
效果有改善信号,但大小并不一致。Sanvello 试验相对积极对照,在特质焦虑和慢性压力上的降幅为小至中等效应;医疗专业学生的试验中,App 相对对照组的特质焦虑效应为 g = 0.85(p = 0.003),而与面对面训练相比为 g = 0.52(p = 0.152),差异不显著。
林悦差点把 g = 0.85 直接当成依据
"效应量 0.85,挺大的!就拿它来算样本量吧。"林悦正想把这个数字写进开题报告。可再看检视规模那一行:选定的 15 篇里只有 2 篇读了全文,13 篇仅依据摘要评阅。
而且 0.85 只来自医疗专业学生的一项试验,和面对面训练相比差异并不显著,也不一定适用于林悦要招募的本科生。答案自己也提醒了:Calm 试验的全文摘录确认了随机等待名单设计、88 名压力较高的本科生和 8 周干预,但结果文本被截断,无法提取具体效应值或置信区间;Sanvello 也只报告了"小至中等效应",没有可核实的分数差和区间。关于研究局限的第三个问题,则被判为"无法判断"。
所以这份综述给出的不是可以直接引用的效应量,而是"哪些数字有据、哪些还要回原文核对"的清单。
报告和文献表一起留了下来
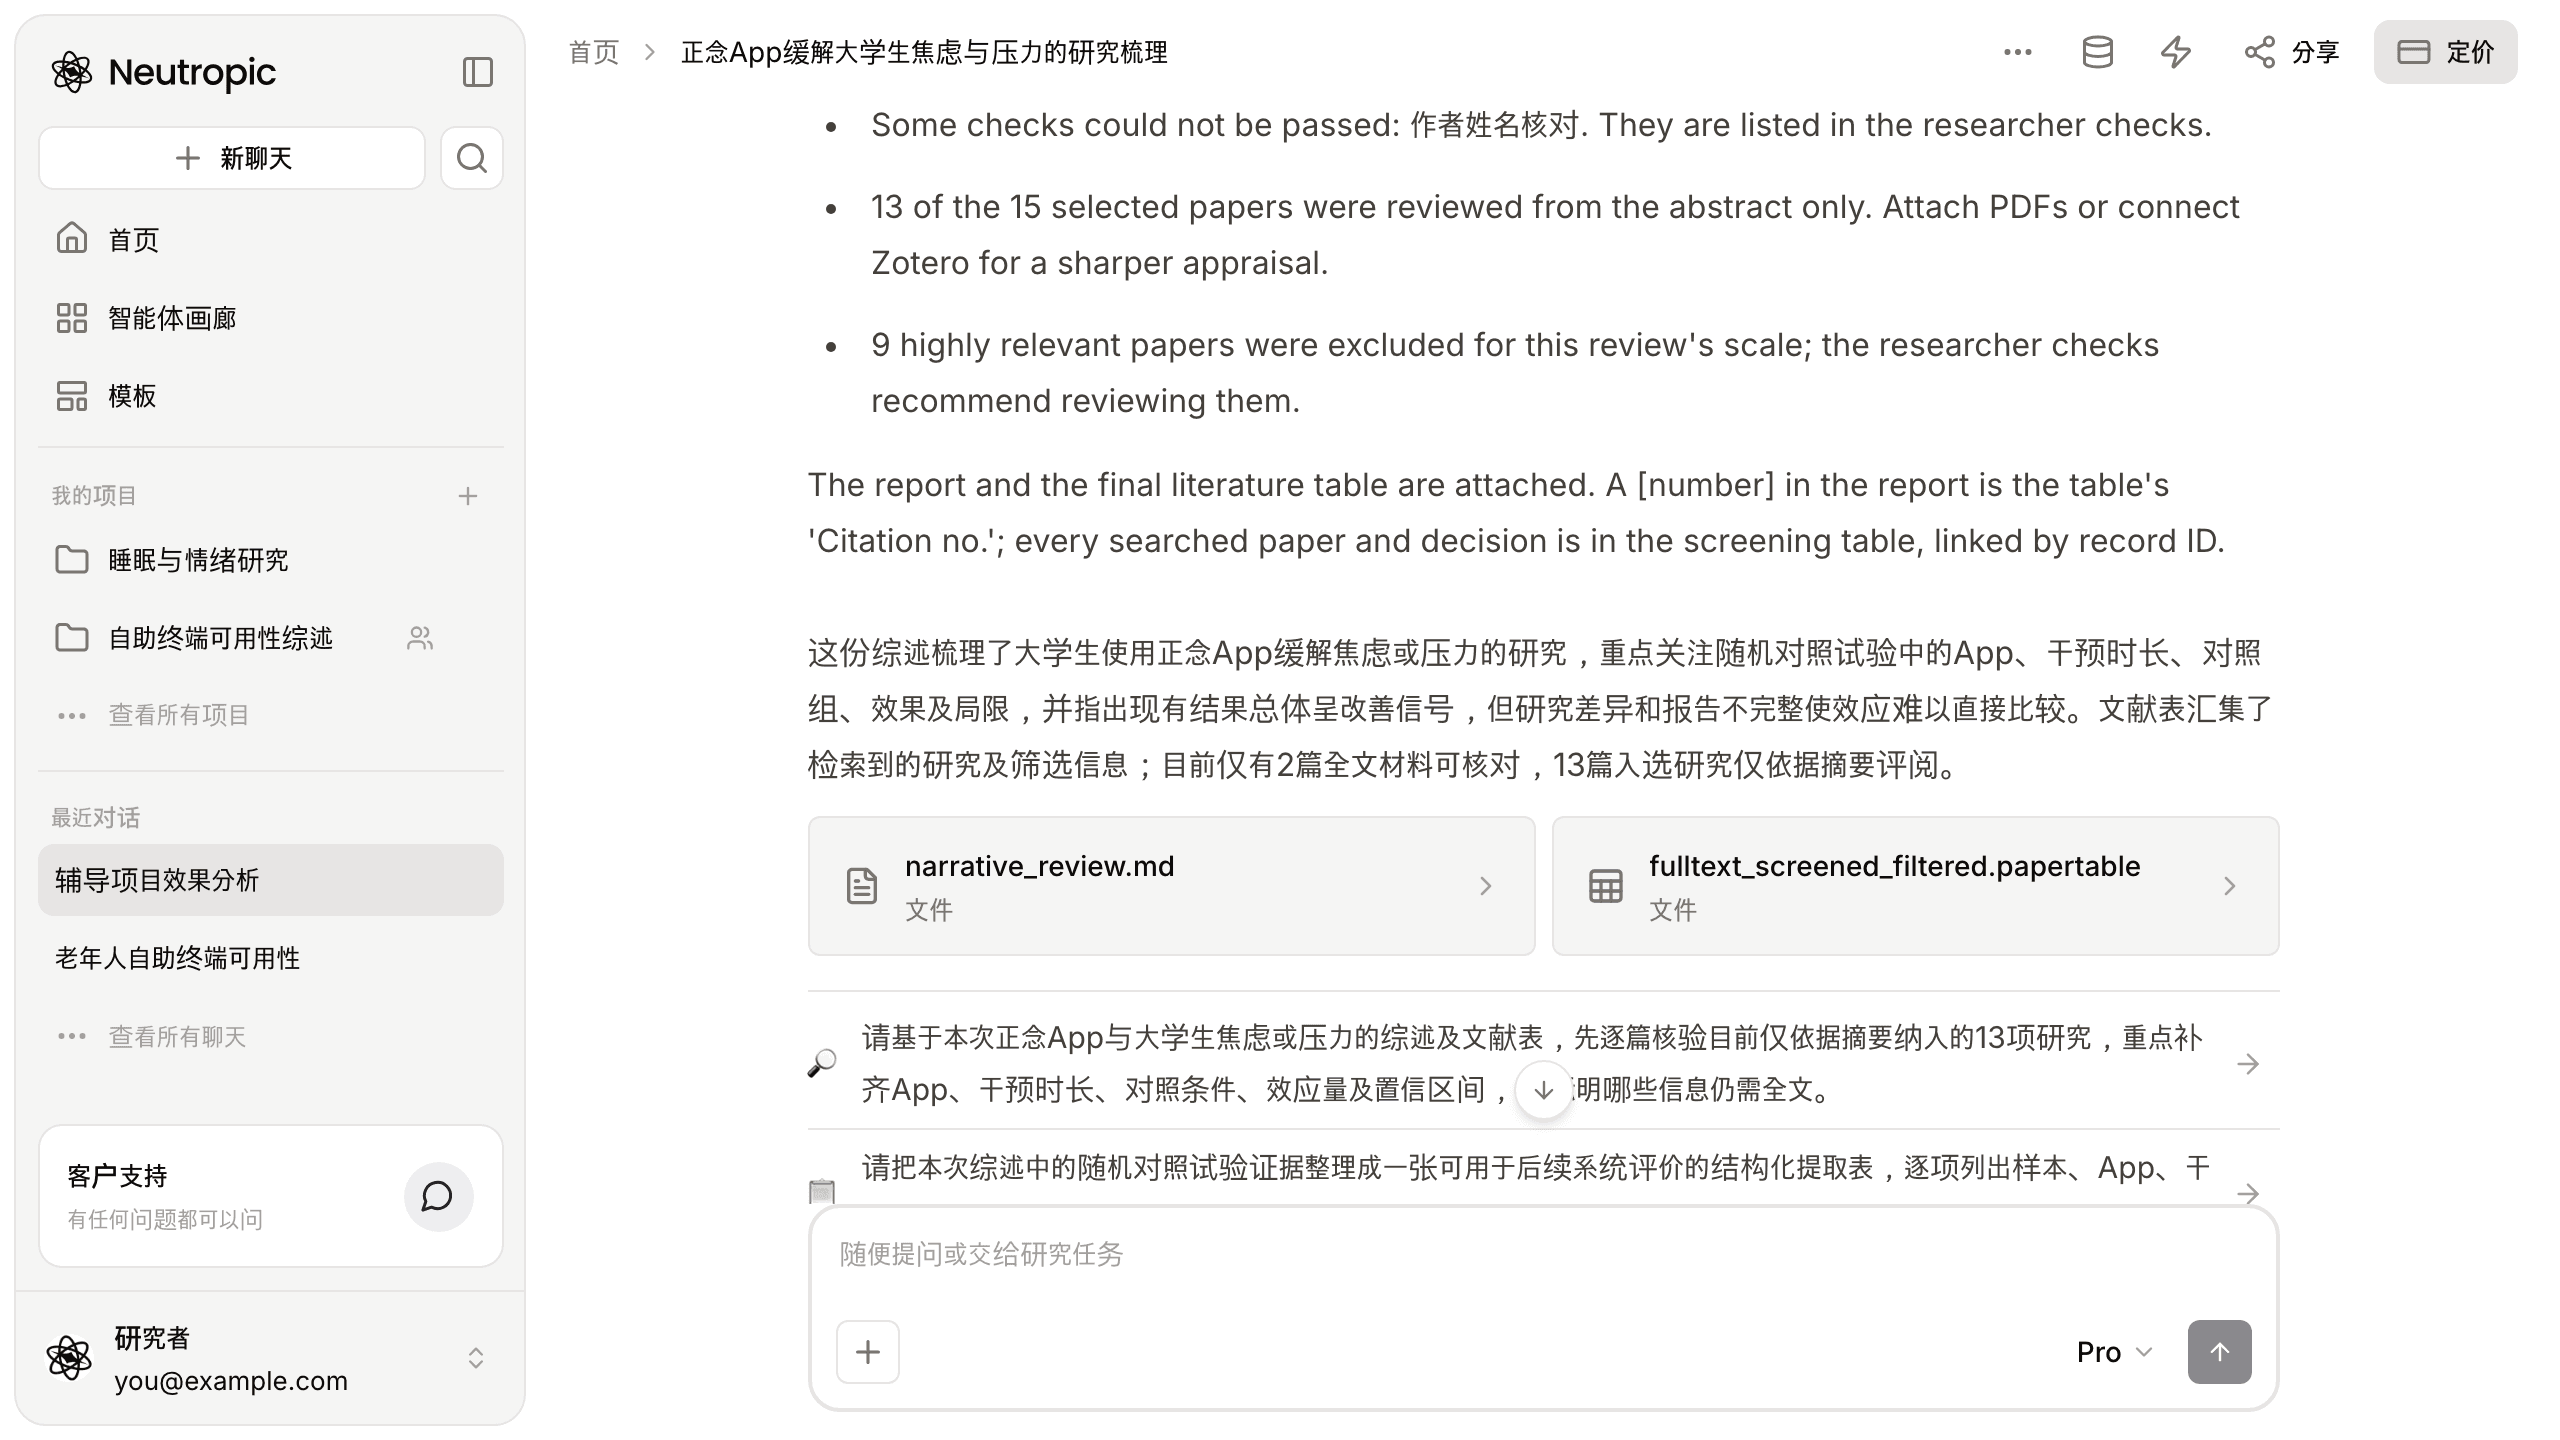
最后的步骤 9 完成了报告撰写和检查,有 3 项检查未通过(包括作者姓名核对),都列在研究者核查事项里。成果有两个:综述报告(narrative_review.md),以及按引用编号排列、报告中引用的 14 篇文献组成的最终文献表。报告里的 [编号] 对应文献表的引用编号,每句话都能追到出处。
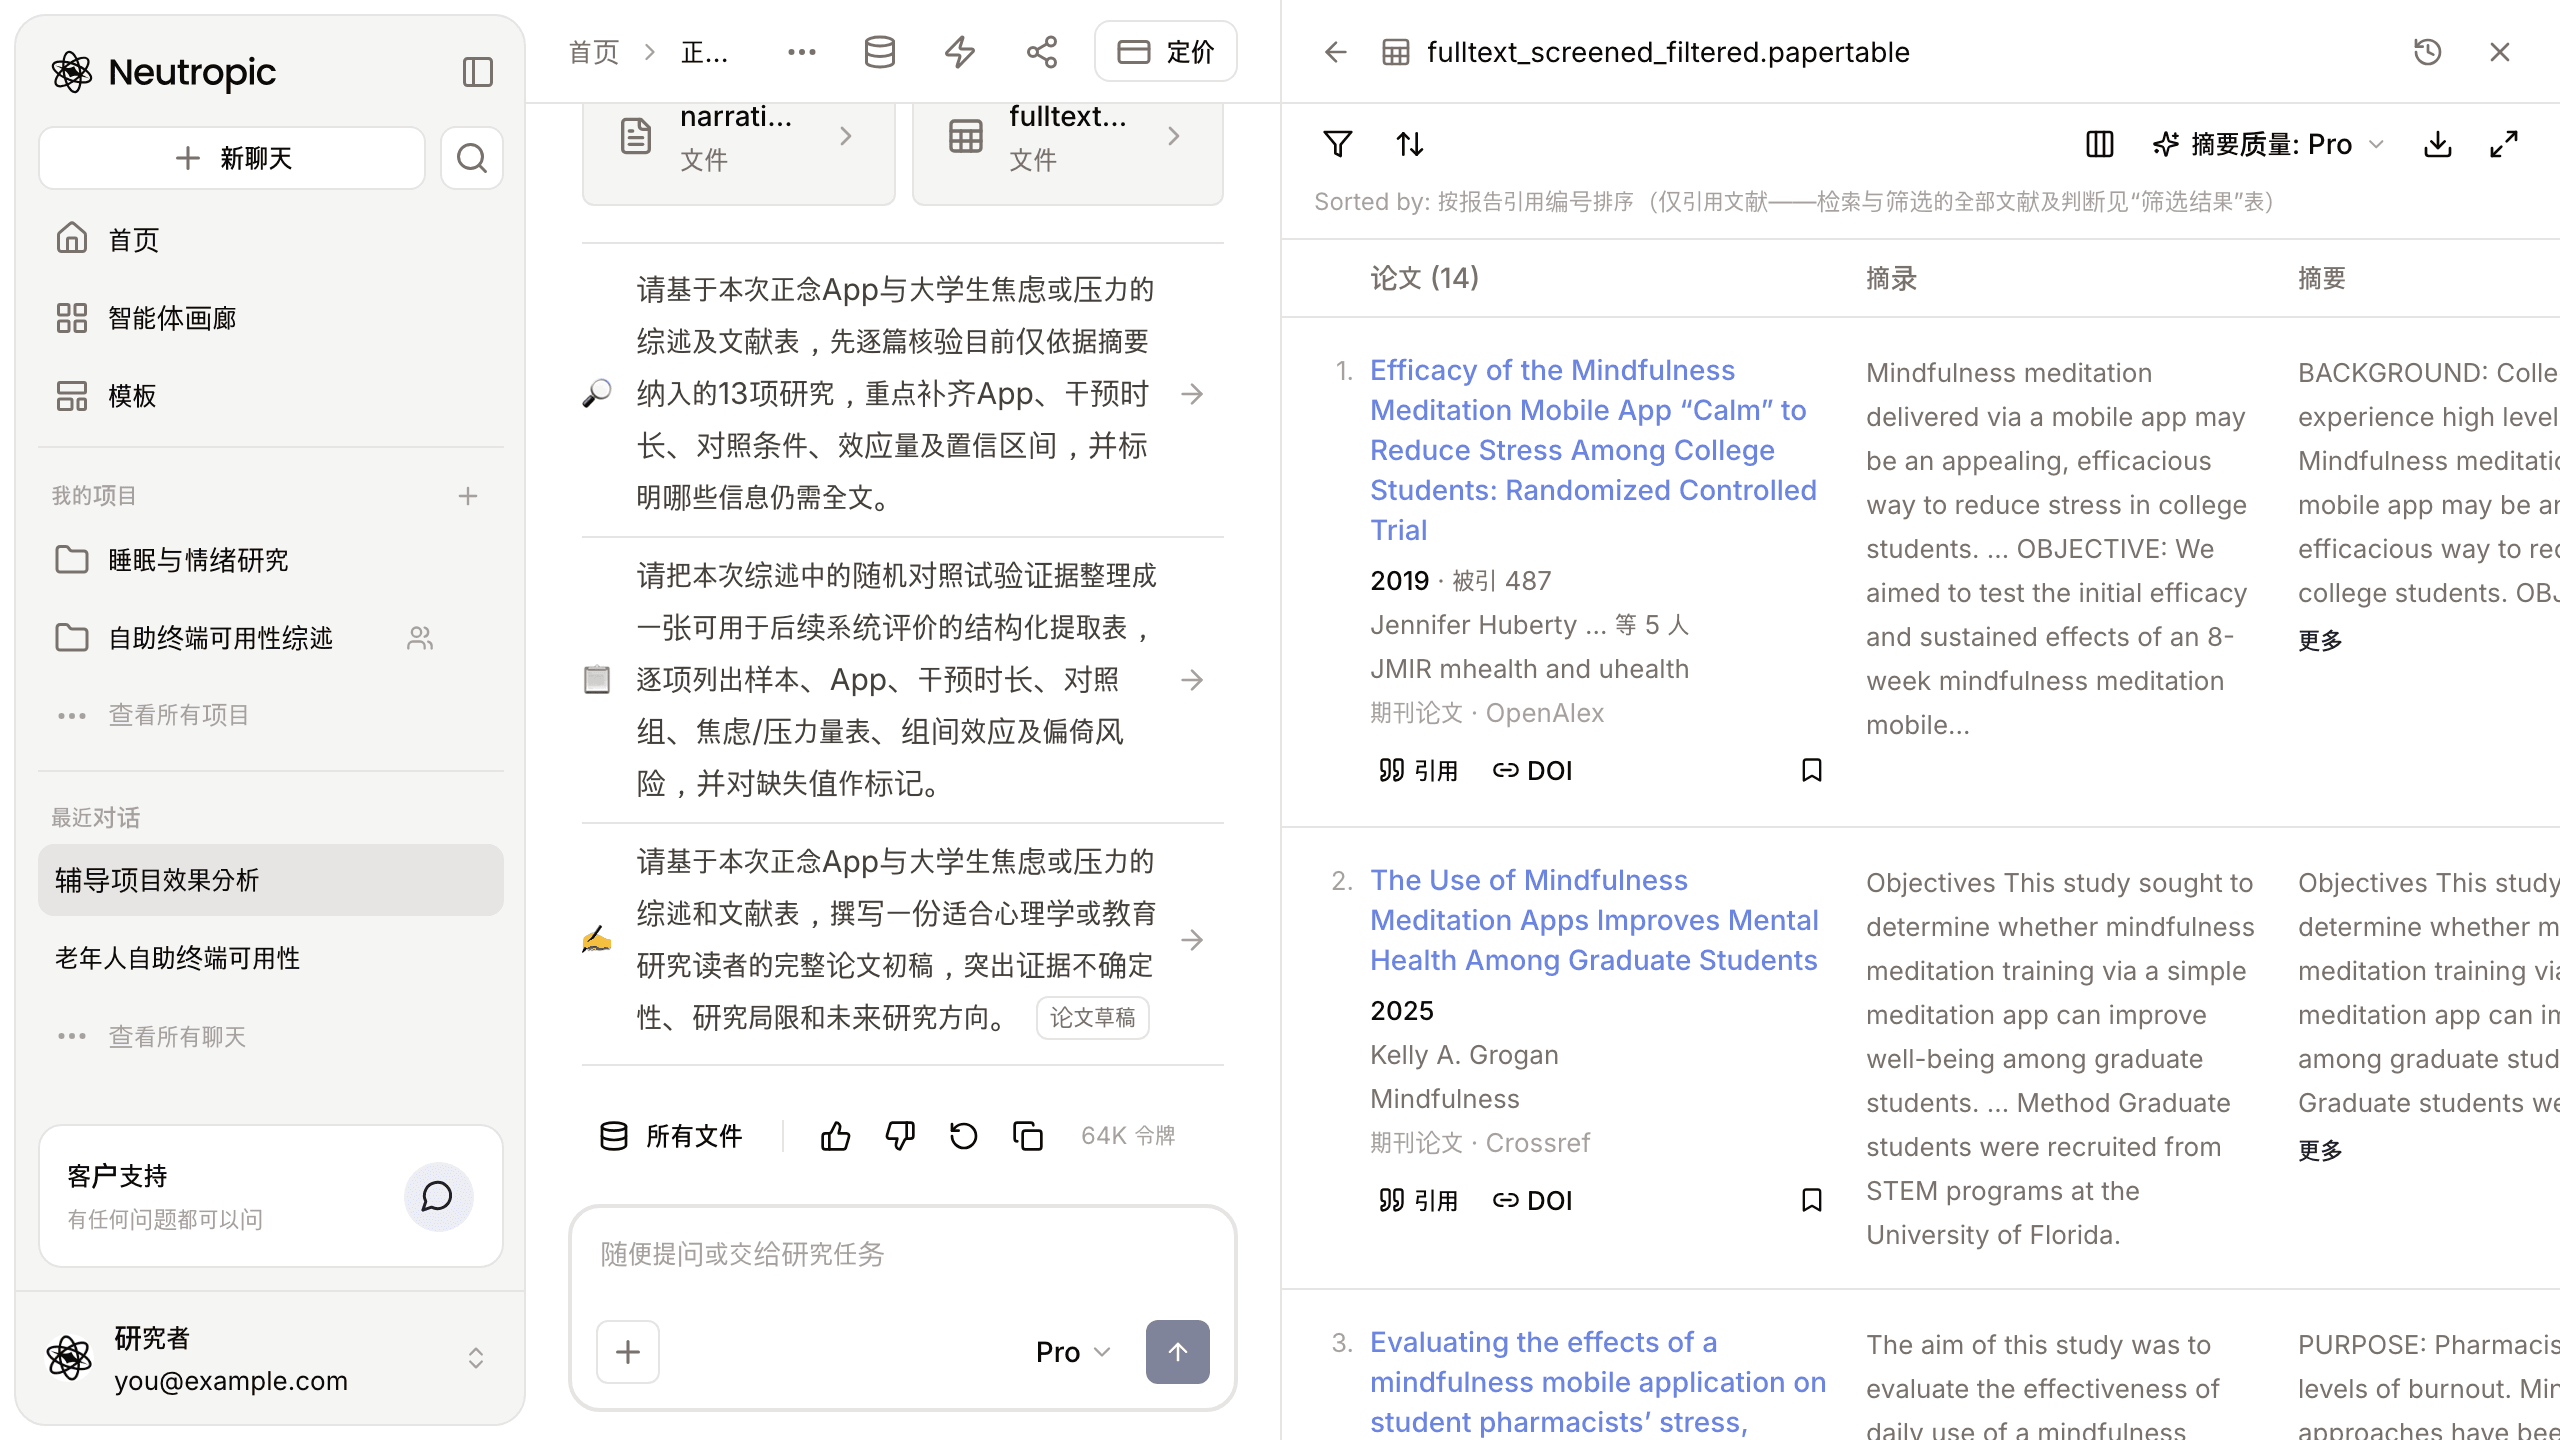
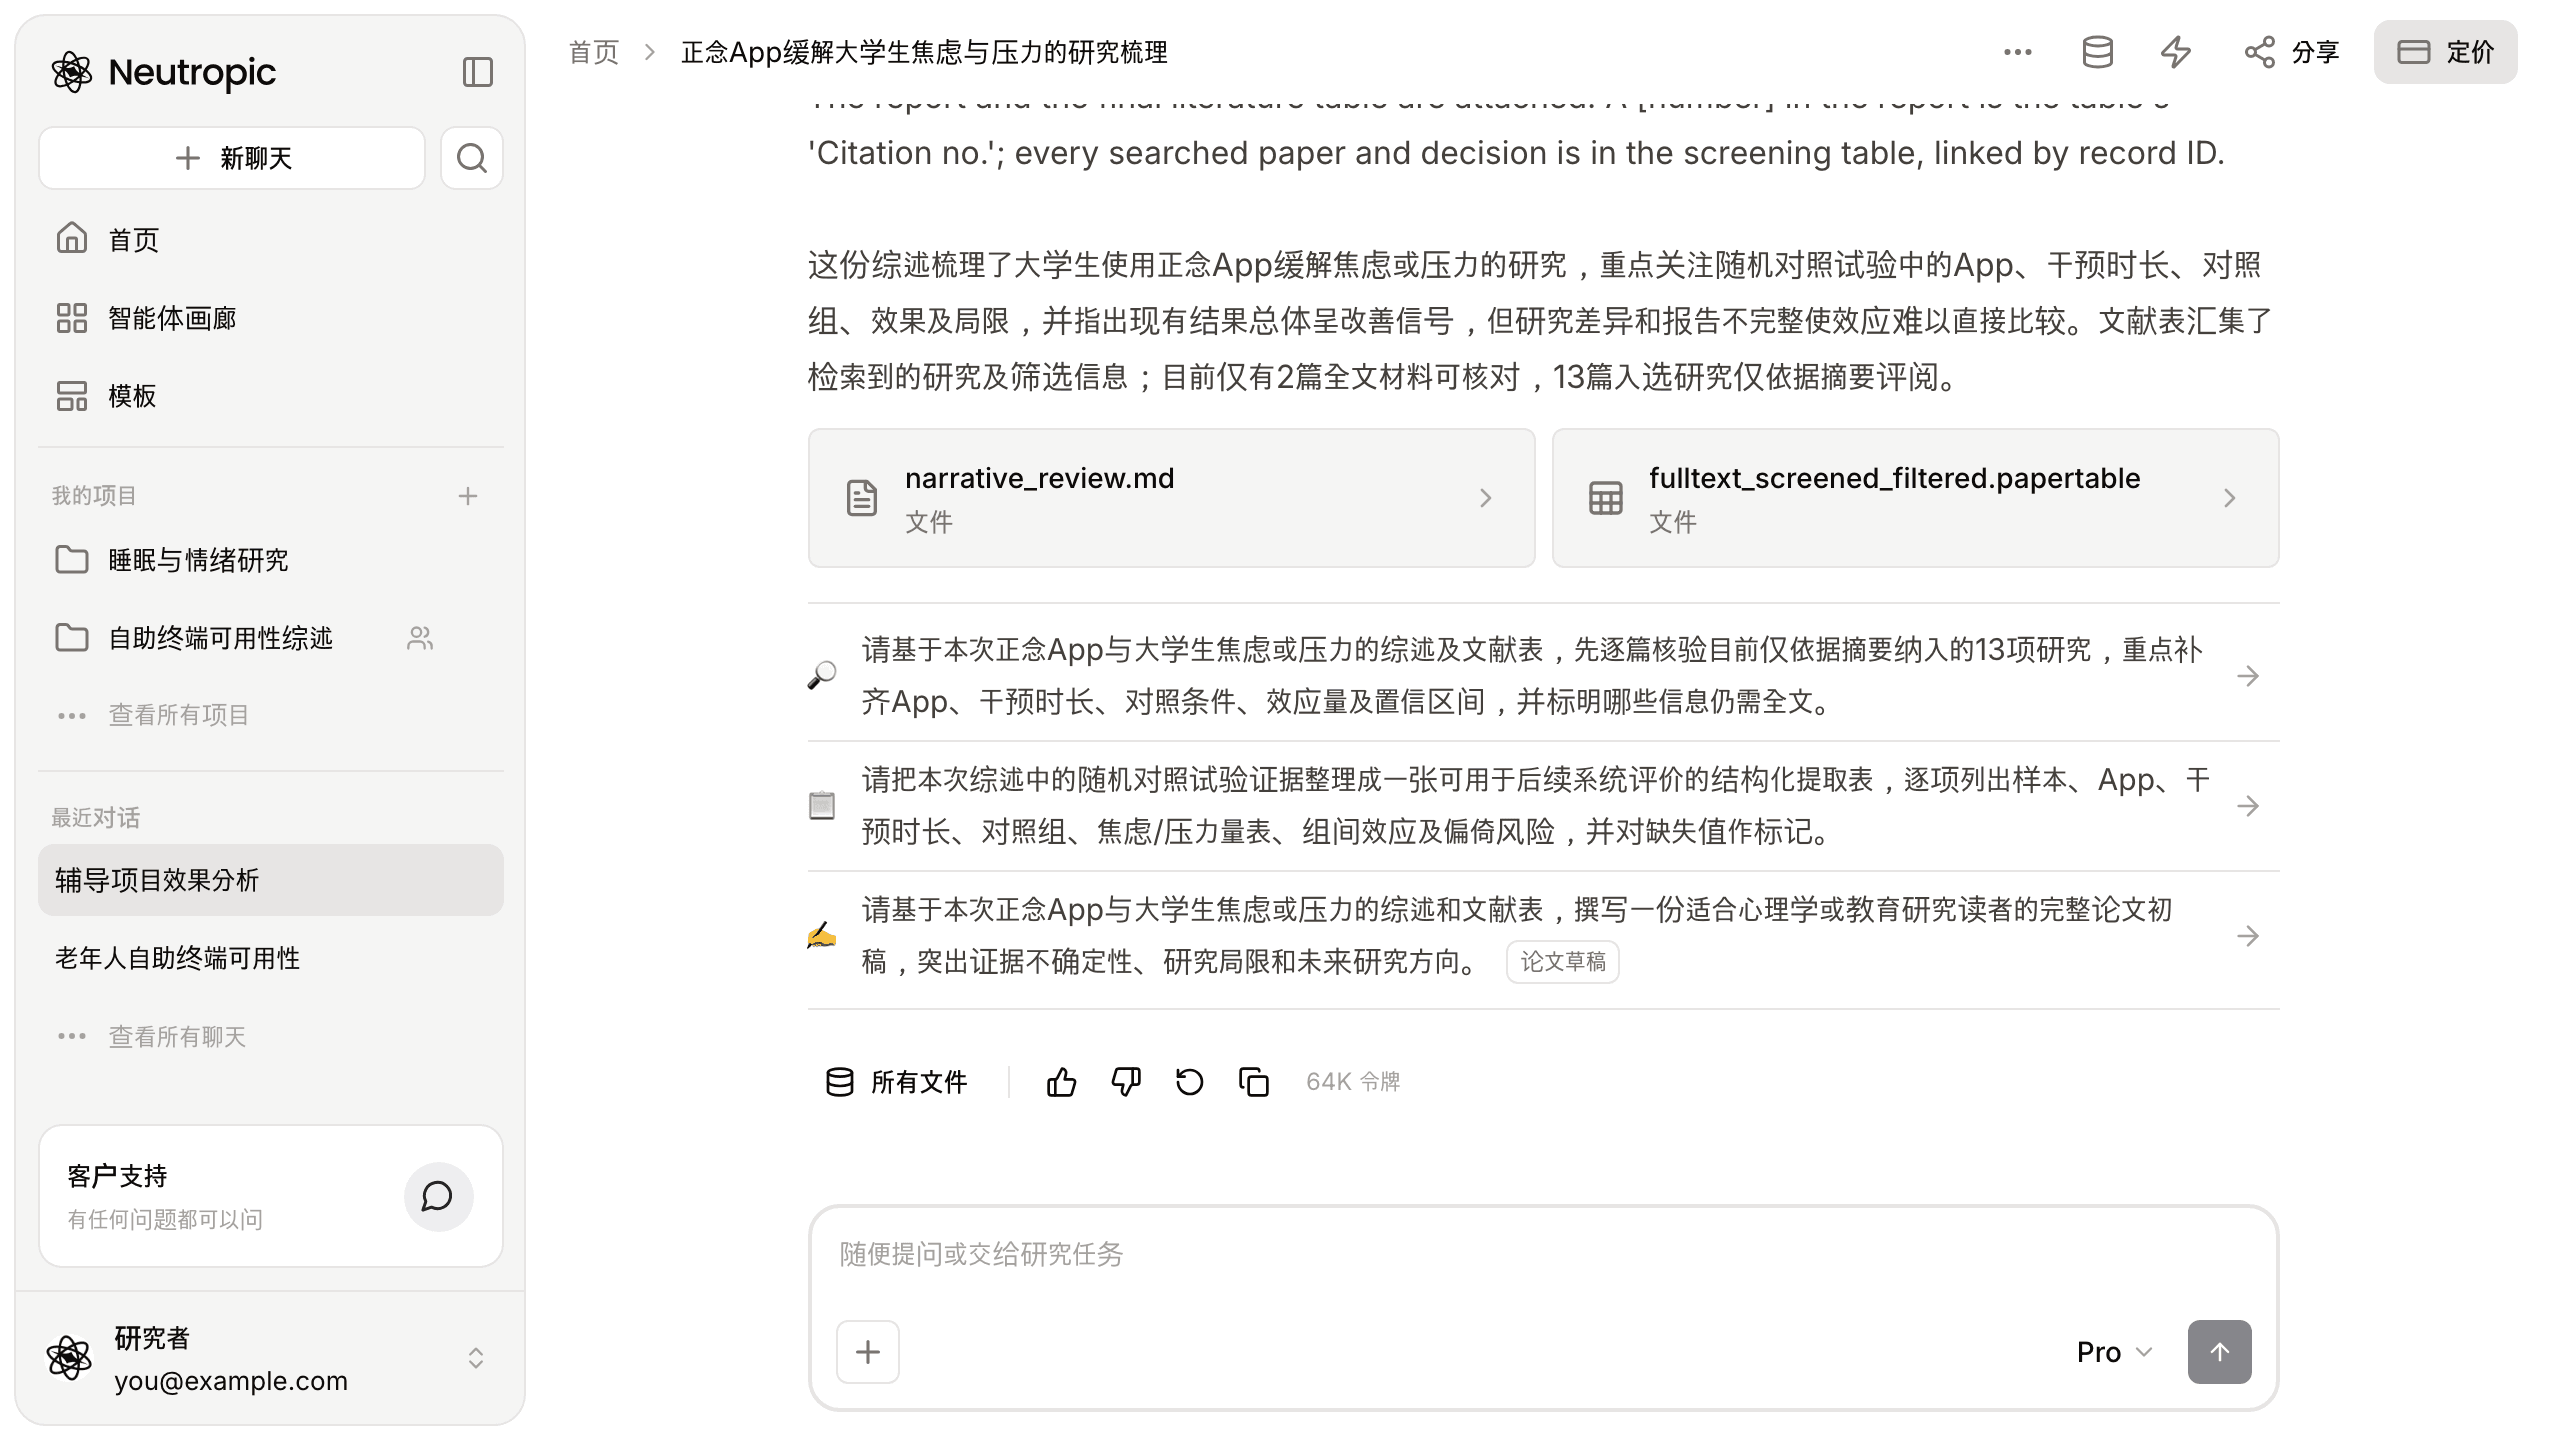
请先核查 里还写着:仅依据摘要评阅的 13 篇,附上 PDF 或连接 Zotero 可以评价得更准确;因规模被排除的 9 篇相关文献,建议再看一看。答案下方有三条下一步建议:逐篇核验这 13 项研究、整理成结构化提取表,以及用 论文草稿 智能体写成完整初稿。
漫无目的的检索,变成了标有证据强度的文献地图
| 开始时 | 现在 | |
|---|---|---|
| 问题 | "用App能减轻焦虑吗?" | 3 个核心问题、5 个概念 |
| 文献 | 不知道从哪里找 | 收集 200 篇,选定 15 篇,185 篇有排除理由 |
| 结论 | "听说有效" | 标有证据强度的结论,暂时得到支持 |
| 效应量 | 心里没底 | 分清哪些有数值、哪些还要回原文核对 |
| 待办 | 无从下手 | 核验 13 篇仅摘要的研究,复查 9 篇排除候选 |
也说说局限。15 篇中有 13 篇只读了摘要,引文追踪 1 轮就停止,没有达到饱和;检索的 10 个数据库中有 9 个返回了结果。所以这份报告与其说是"结论",不如说是一张告诉你先读哪些全文的地图。但面对几百条检索结果发愁,和从 15 篇、每篇都写明取舍理由的文献出发,完全不一样。
本文使用 Pro 运行,文献表最多 200 篇,选定最多 15 篇,全文最多 5 篇,引文追踪 1 轮。Lite(免费方案)以文献表最多 100 篇、选定最多 8 篇、全文最多 2 篇快速过一遍;Expert 扩大到文献表最多 400 篇、选定最多 25 篇、全文最多 10 篇、引文追踪 2 轮,并多做一轮稿件质量检查。
一段话,就能得到一份标有证据强度的文献表。只是在引用任何数字之前,先确认它有没有读过全文。
林悦随后带着这份梳理进入了实验设计,后续请看研究设计那篇文章。这周就像林悦一样,写下范围和想知道的事问一问吧。免费开始使用 Neutropic