你好,我们是 Neutropic 团队!
假设你做了一个模型,用来提前发现可能出现不良事件的患者。一跑,准确率 95%。拿给导师看之前,你突然有点不安:这类事件只占约 5%,那把所有人都预测成"不会发生",准确率不也是 95% 吗?🥲
没错。阳性罕见时,准确率几乎说明不了什么。可是该看什么指标、类别权重和重采样什么时候用、阈值怎么定,要一次理清并不容易。
这篇文章跟着公共卫生专业的博士生 李然,看看如何验证这份不安,并重新搭建评估方法。李然是虚构人物,但下面的界面全部来自 Neutropic 中真实运行的对话。
把疑问原样写成提问
李然没有上传自己的数据,只写了情况、疑问和想要的形式。
我的二分类问题中阳性约占 5%,模型准确率达到 95%。这样的不平衡数据应该如何评估和训练模型?我用 Python,请用模拟数据实际运行并比较。
这个提问好在三点:写明了阳性比例(5%)和眼下看到的数字(95%),问题一目了然;评估和训练都问到了;"用模拟数据实际运行并比较"这句话,让你拿到的是代码跑出来的结果,而不只是建议。
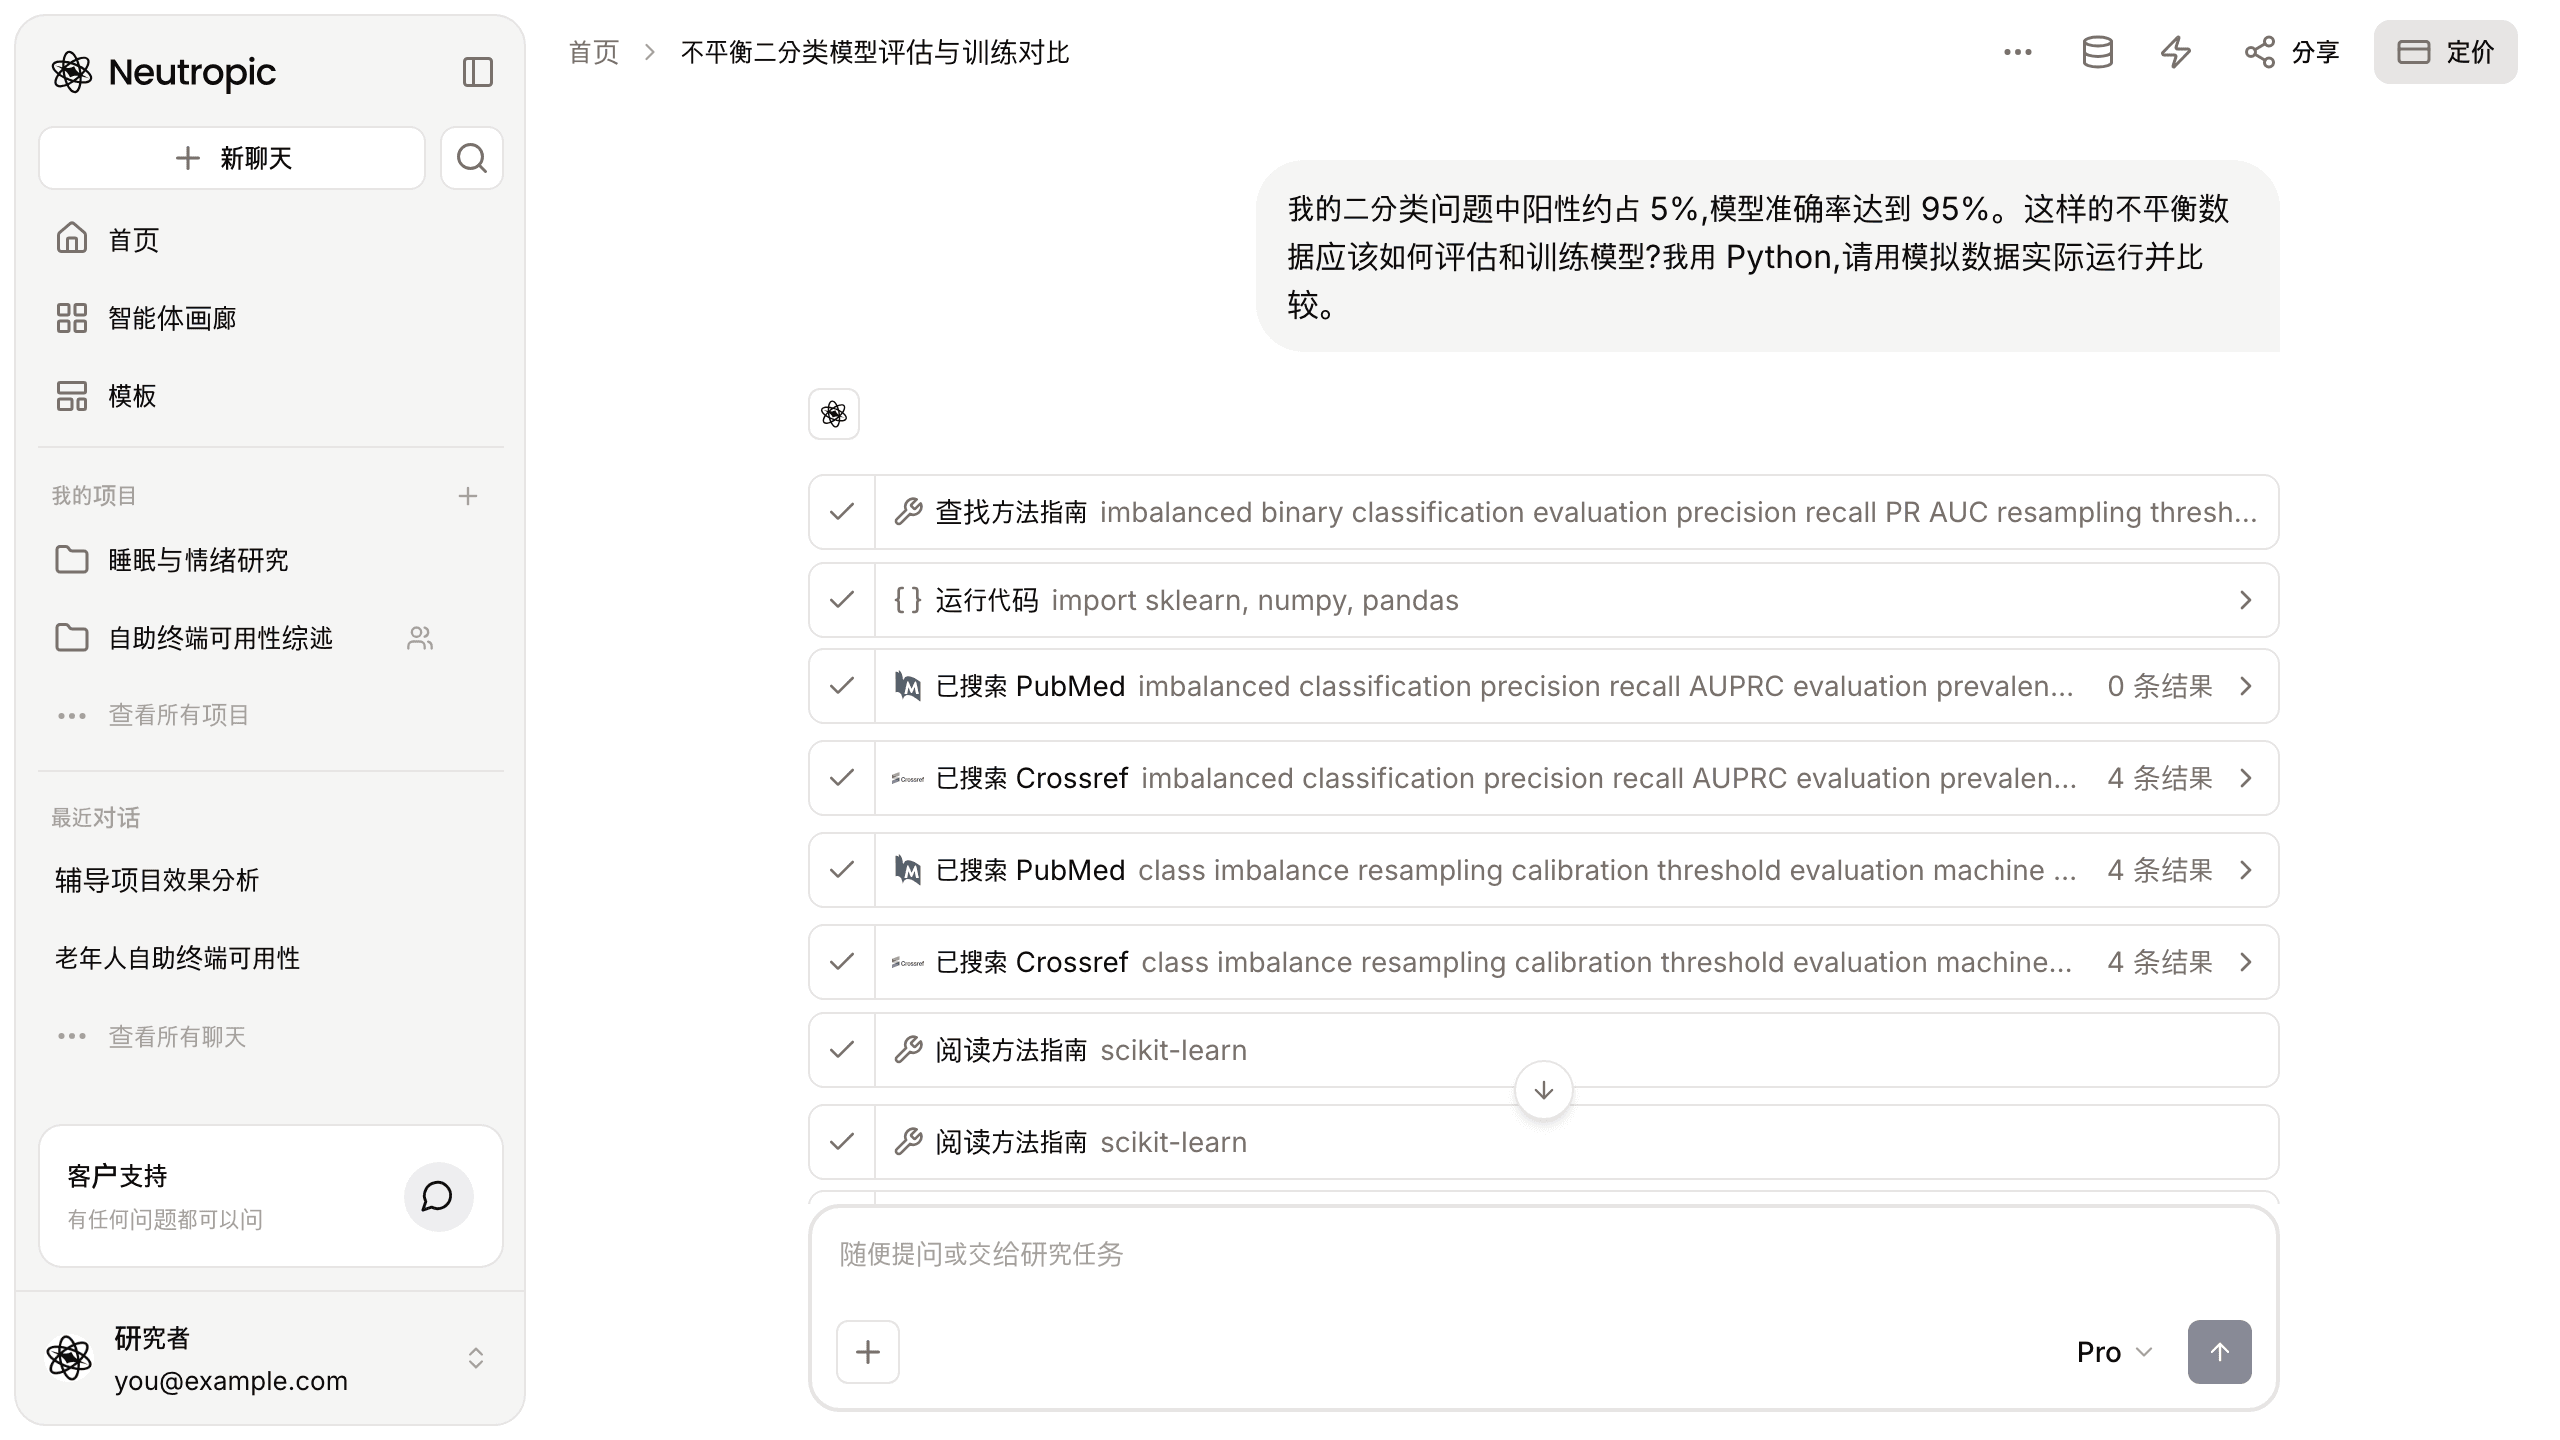
先查指南和文献,再跑对比
界面上的步骤一条条出现:用 查找方法指南 找到适合不平衡分类评估的指南,用 运行代码 跑模拟,在 PubMed 和 Crossref 中检索类别不平衡与 PR-AUC 评估的文献(有的检索结果为 0 条,也照样显示),再阅读 scikit-learn 指南核对评估注意事项。
在同一个测试集上比较了四种做法
模拟数据用固定随机种子生成,共 20,000 条,阳性率约 5.4%,按类别比例分层切分并保留测试集。除"全判阴性"外,下表都使用默认阈值 0.5:
- 全判阴性: 准确率 94.6%,一个阳性也没找到
- 普通逻辑回归: 准确率 97.0%,精确率 96.2%,召回率 46.0%,PR-AUC 0.671
- 类别加权逻辑回归: 准确率 82.7%,精确率 20.3%,召回率 75.2%,PR-AUC 0.631
- 训练集随机过采样: 准确率 82.7%,精确率 20.5%,召回率 75.8%,PR-AUC 0.630
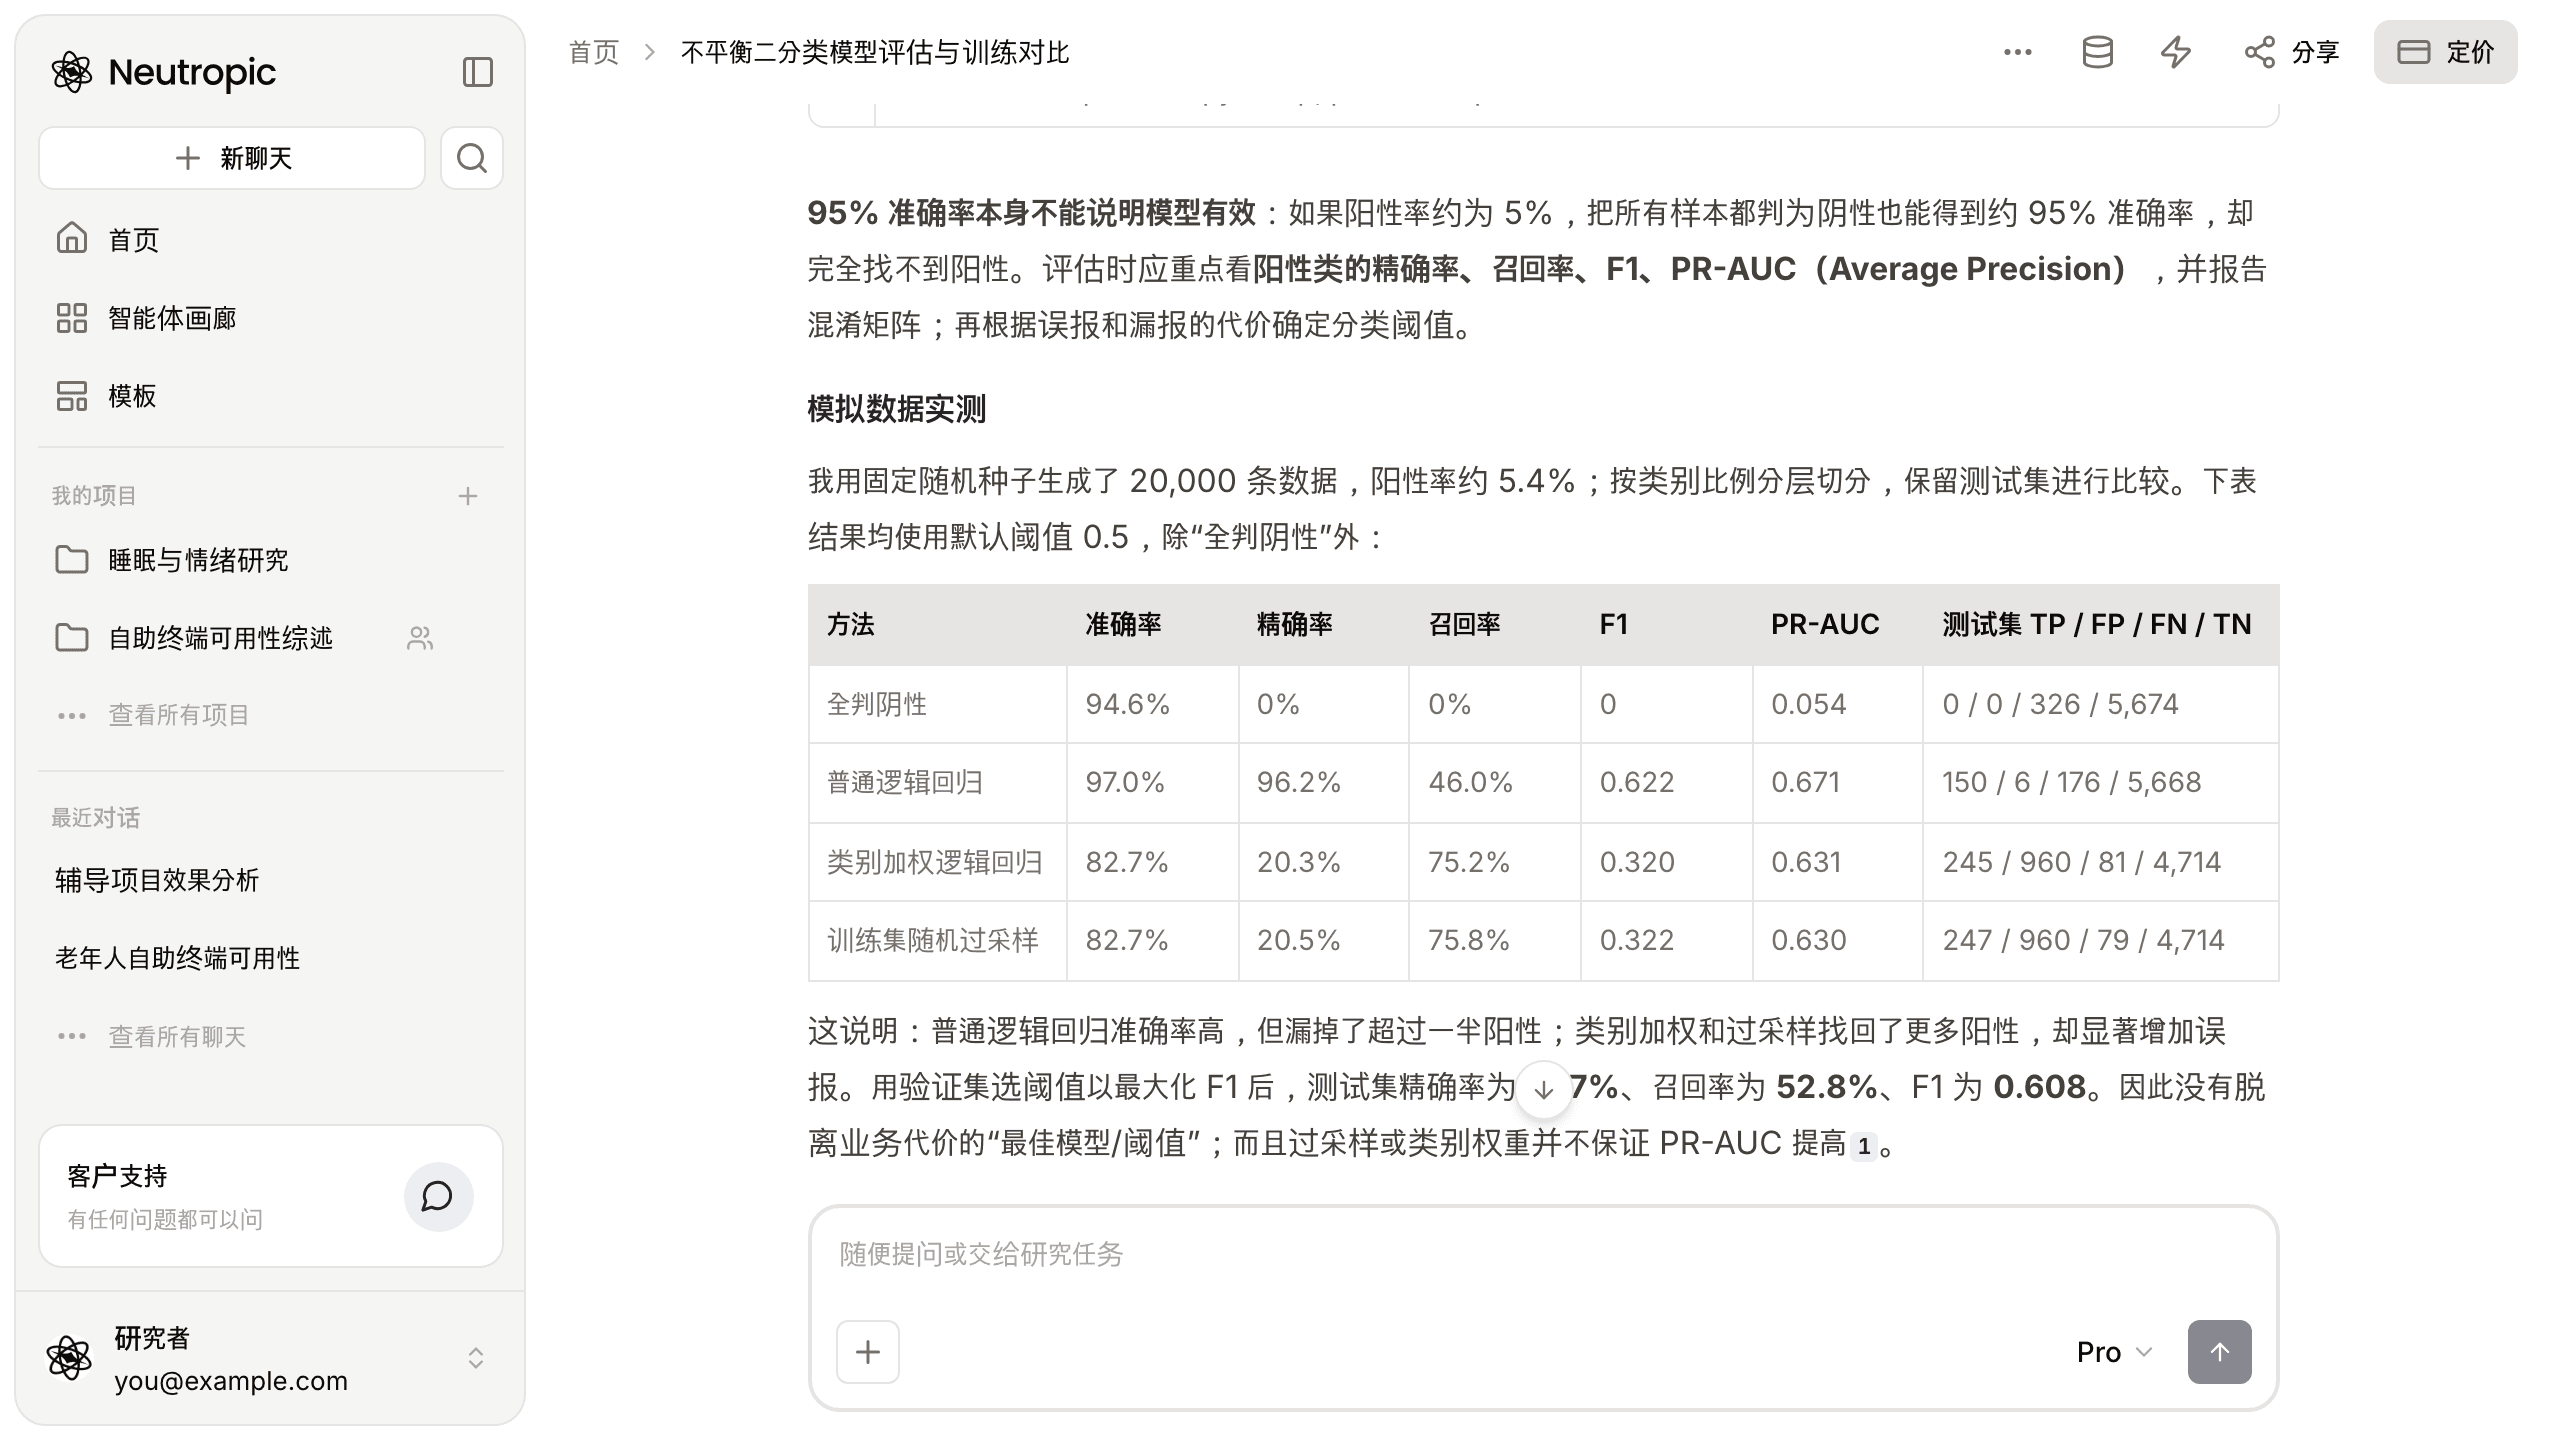
李然在这里差点犯错。普通逻辑回归的准确率 97.0% 是全场最高,精确率也有 96.2%,看起来非常漂亮。可测试集里 326 个阳性,它漏掉了 176 个,超过一半。那换成类别加权或过采样呢?召回率升到约 75%,误报却增加到 960 个。答案还补充:用验证集选择阈值、使 F1 最大后,测试集精确率为 71.7%、召回率为 52.8%、F1 为 0.608。所以没有脱离业务代价的"最佳模型或阈值",而且过采样和类别权重并不保证 PR-AUC 提高——这里两者的 PR-AUC 都低于普通逻辑回归。
生成结果的代码,我们实际跑了一遍
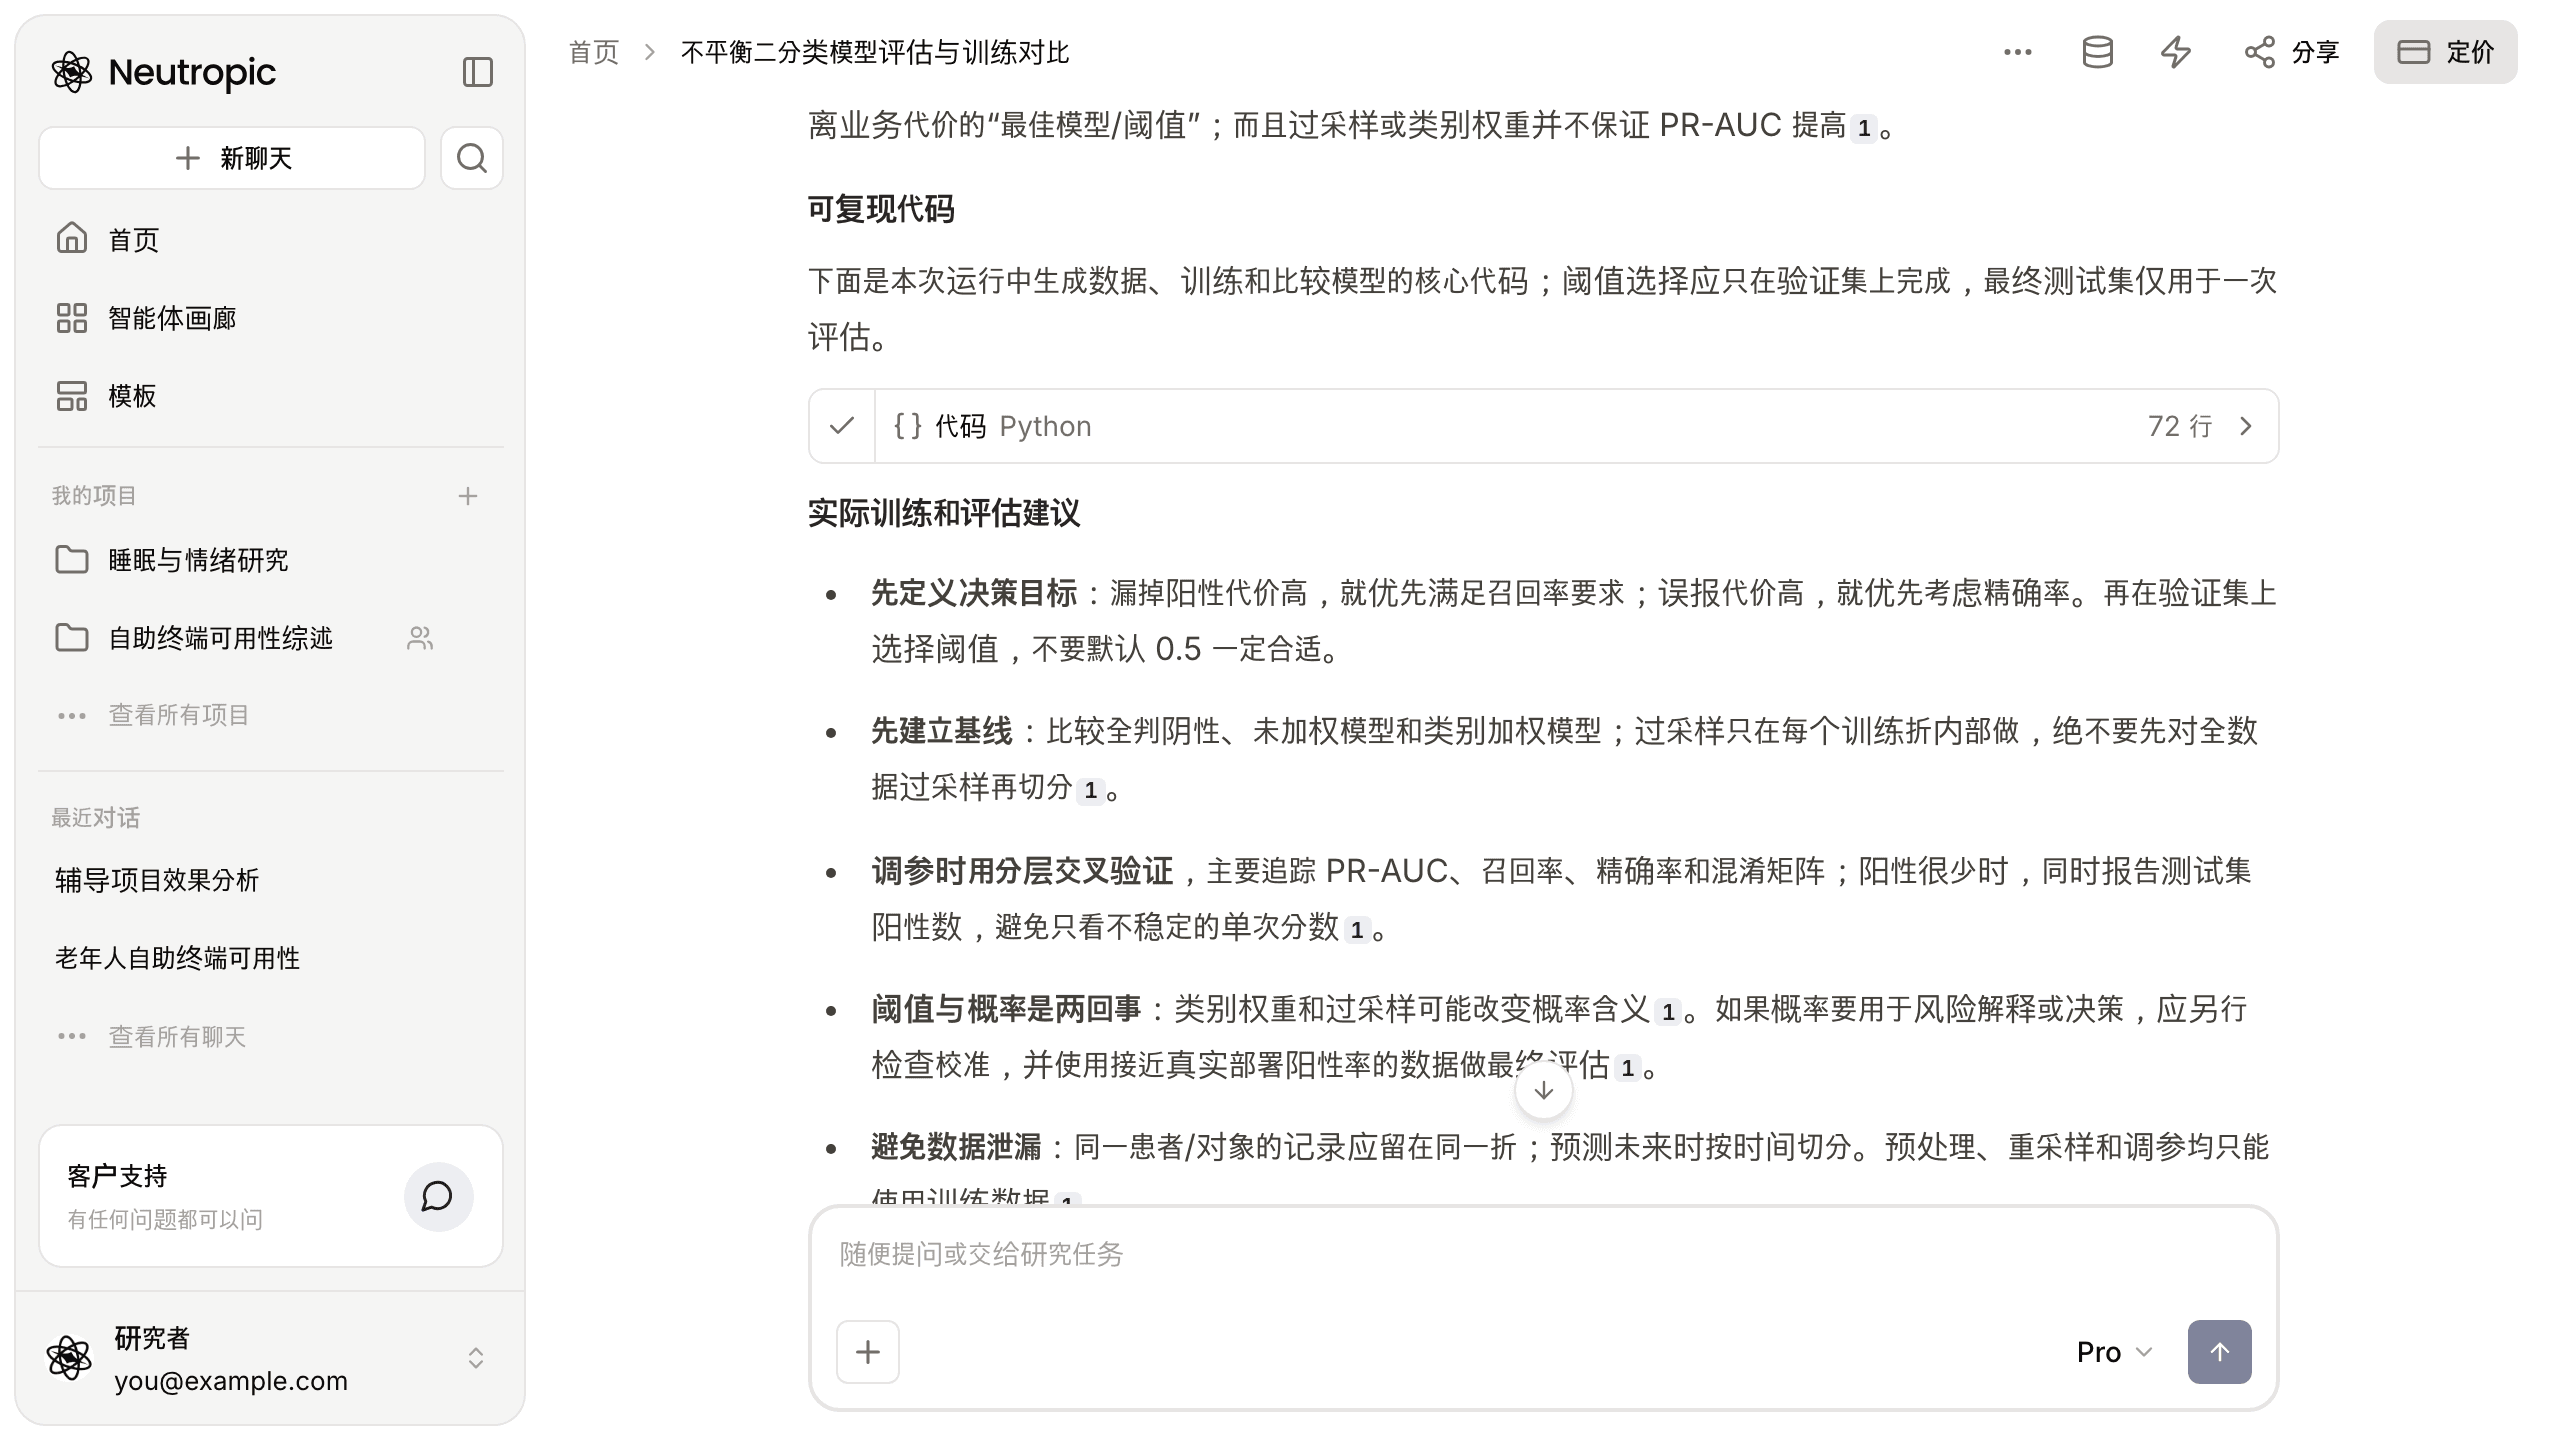
答案附上了"本次运行中生成数据、训练和比较模型的核心代码",共 72 行。点开卡片,代码会在右侧打开,可以一键复制。
我们把这段代码原样运行了一遍,普通逻辑回归、类别加权和过采样三行的数字与表格完全一致;"全判阴性"一行来自同一次切分,同样吻合。😎 唯一没能核对的是验证集选阈值的那组结果(71.7%、52.8%),因为这部分不在附上的代码里。
把建议整理成了可执行的清单
代码下面是实际训练和评估的建议:
- 先定义决策目标: 漏掉阳性代价高,就优先满足召回率;误报代价高,就优先考虑精确率。在验证集上选阈值,不要默认 0.5 一定合适。
- 先建立基线: 比较全判阴性、未加权和类别加权模型;过采样只在每个训练折内部做,绝不要先对全数据过采样再切分。
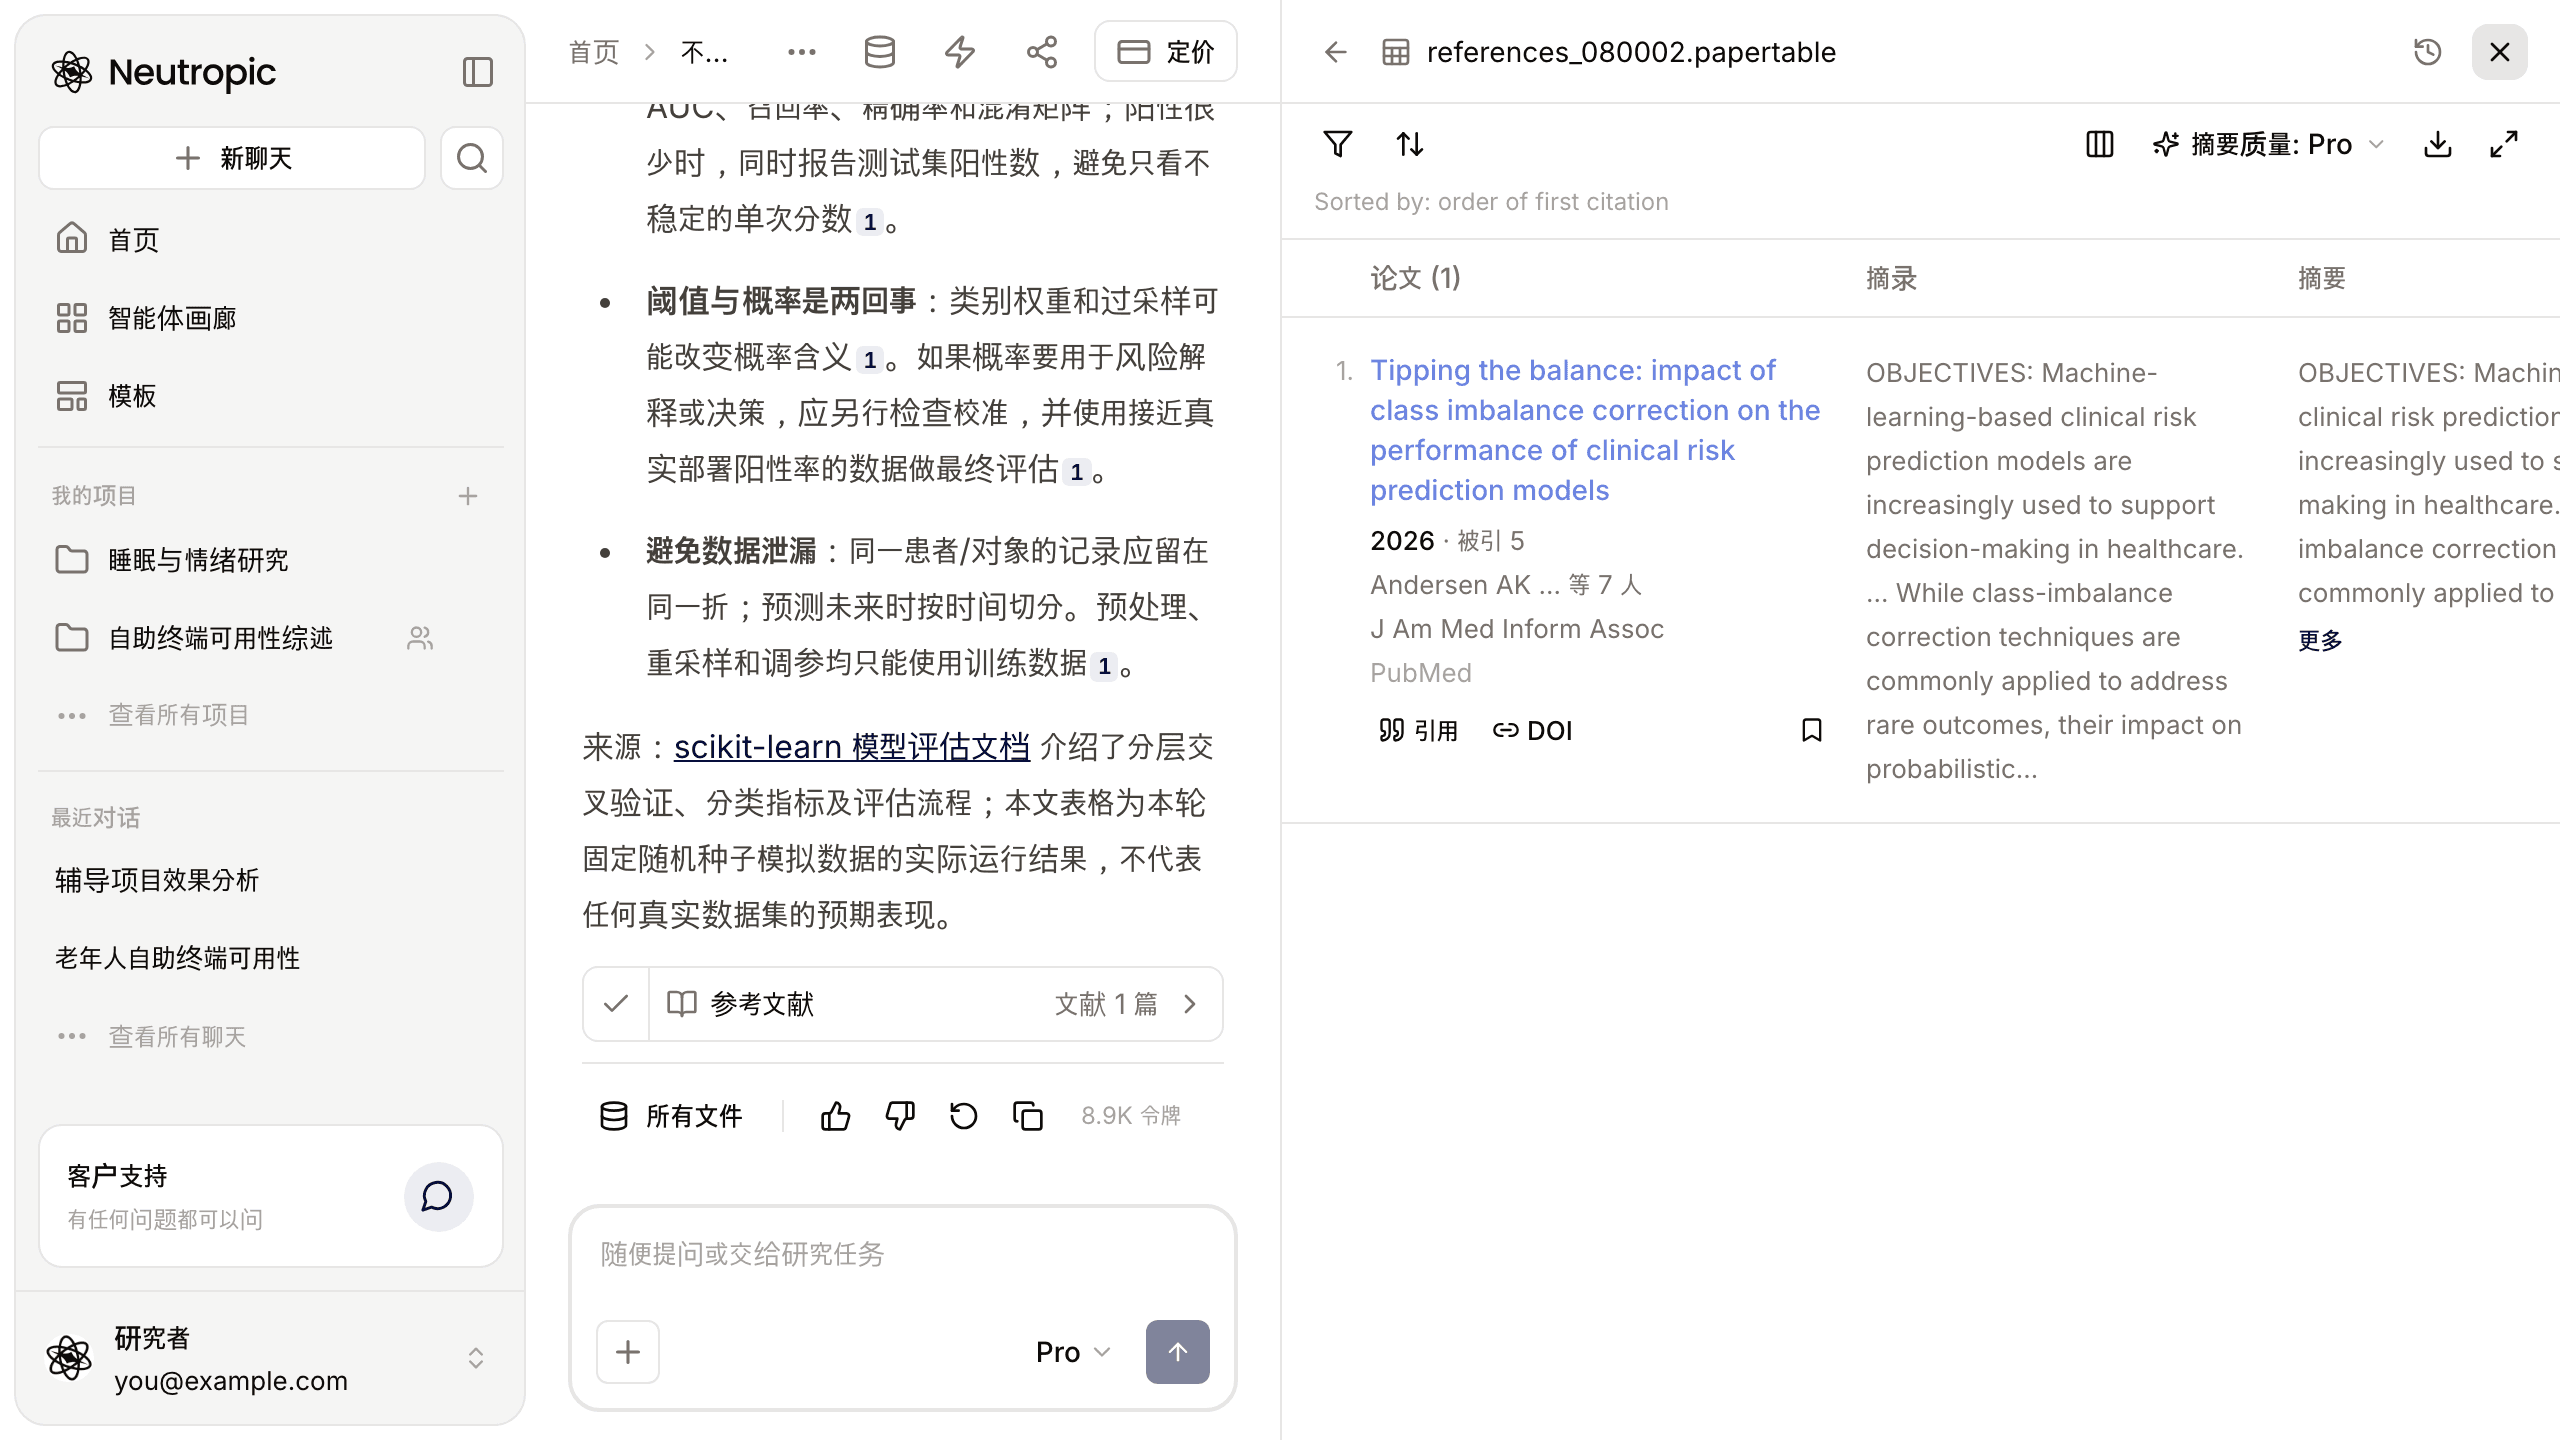
- 阈值与概率是两回事: 类别权重和过采样可能改变概率含义,若要用概率做风险解释,应另行检查校准。
- 避免数据泄漏: 同一患者的记录留在同一折;预测未来时按时间切分。
引用的文献也留了下来
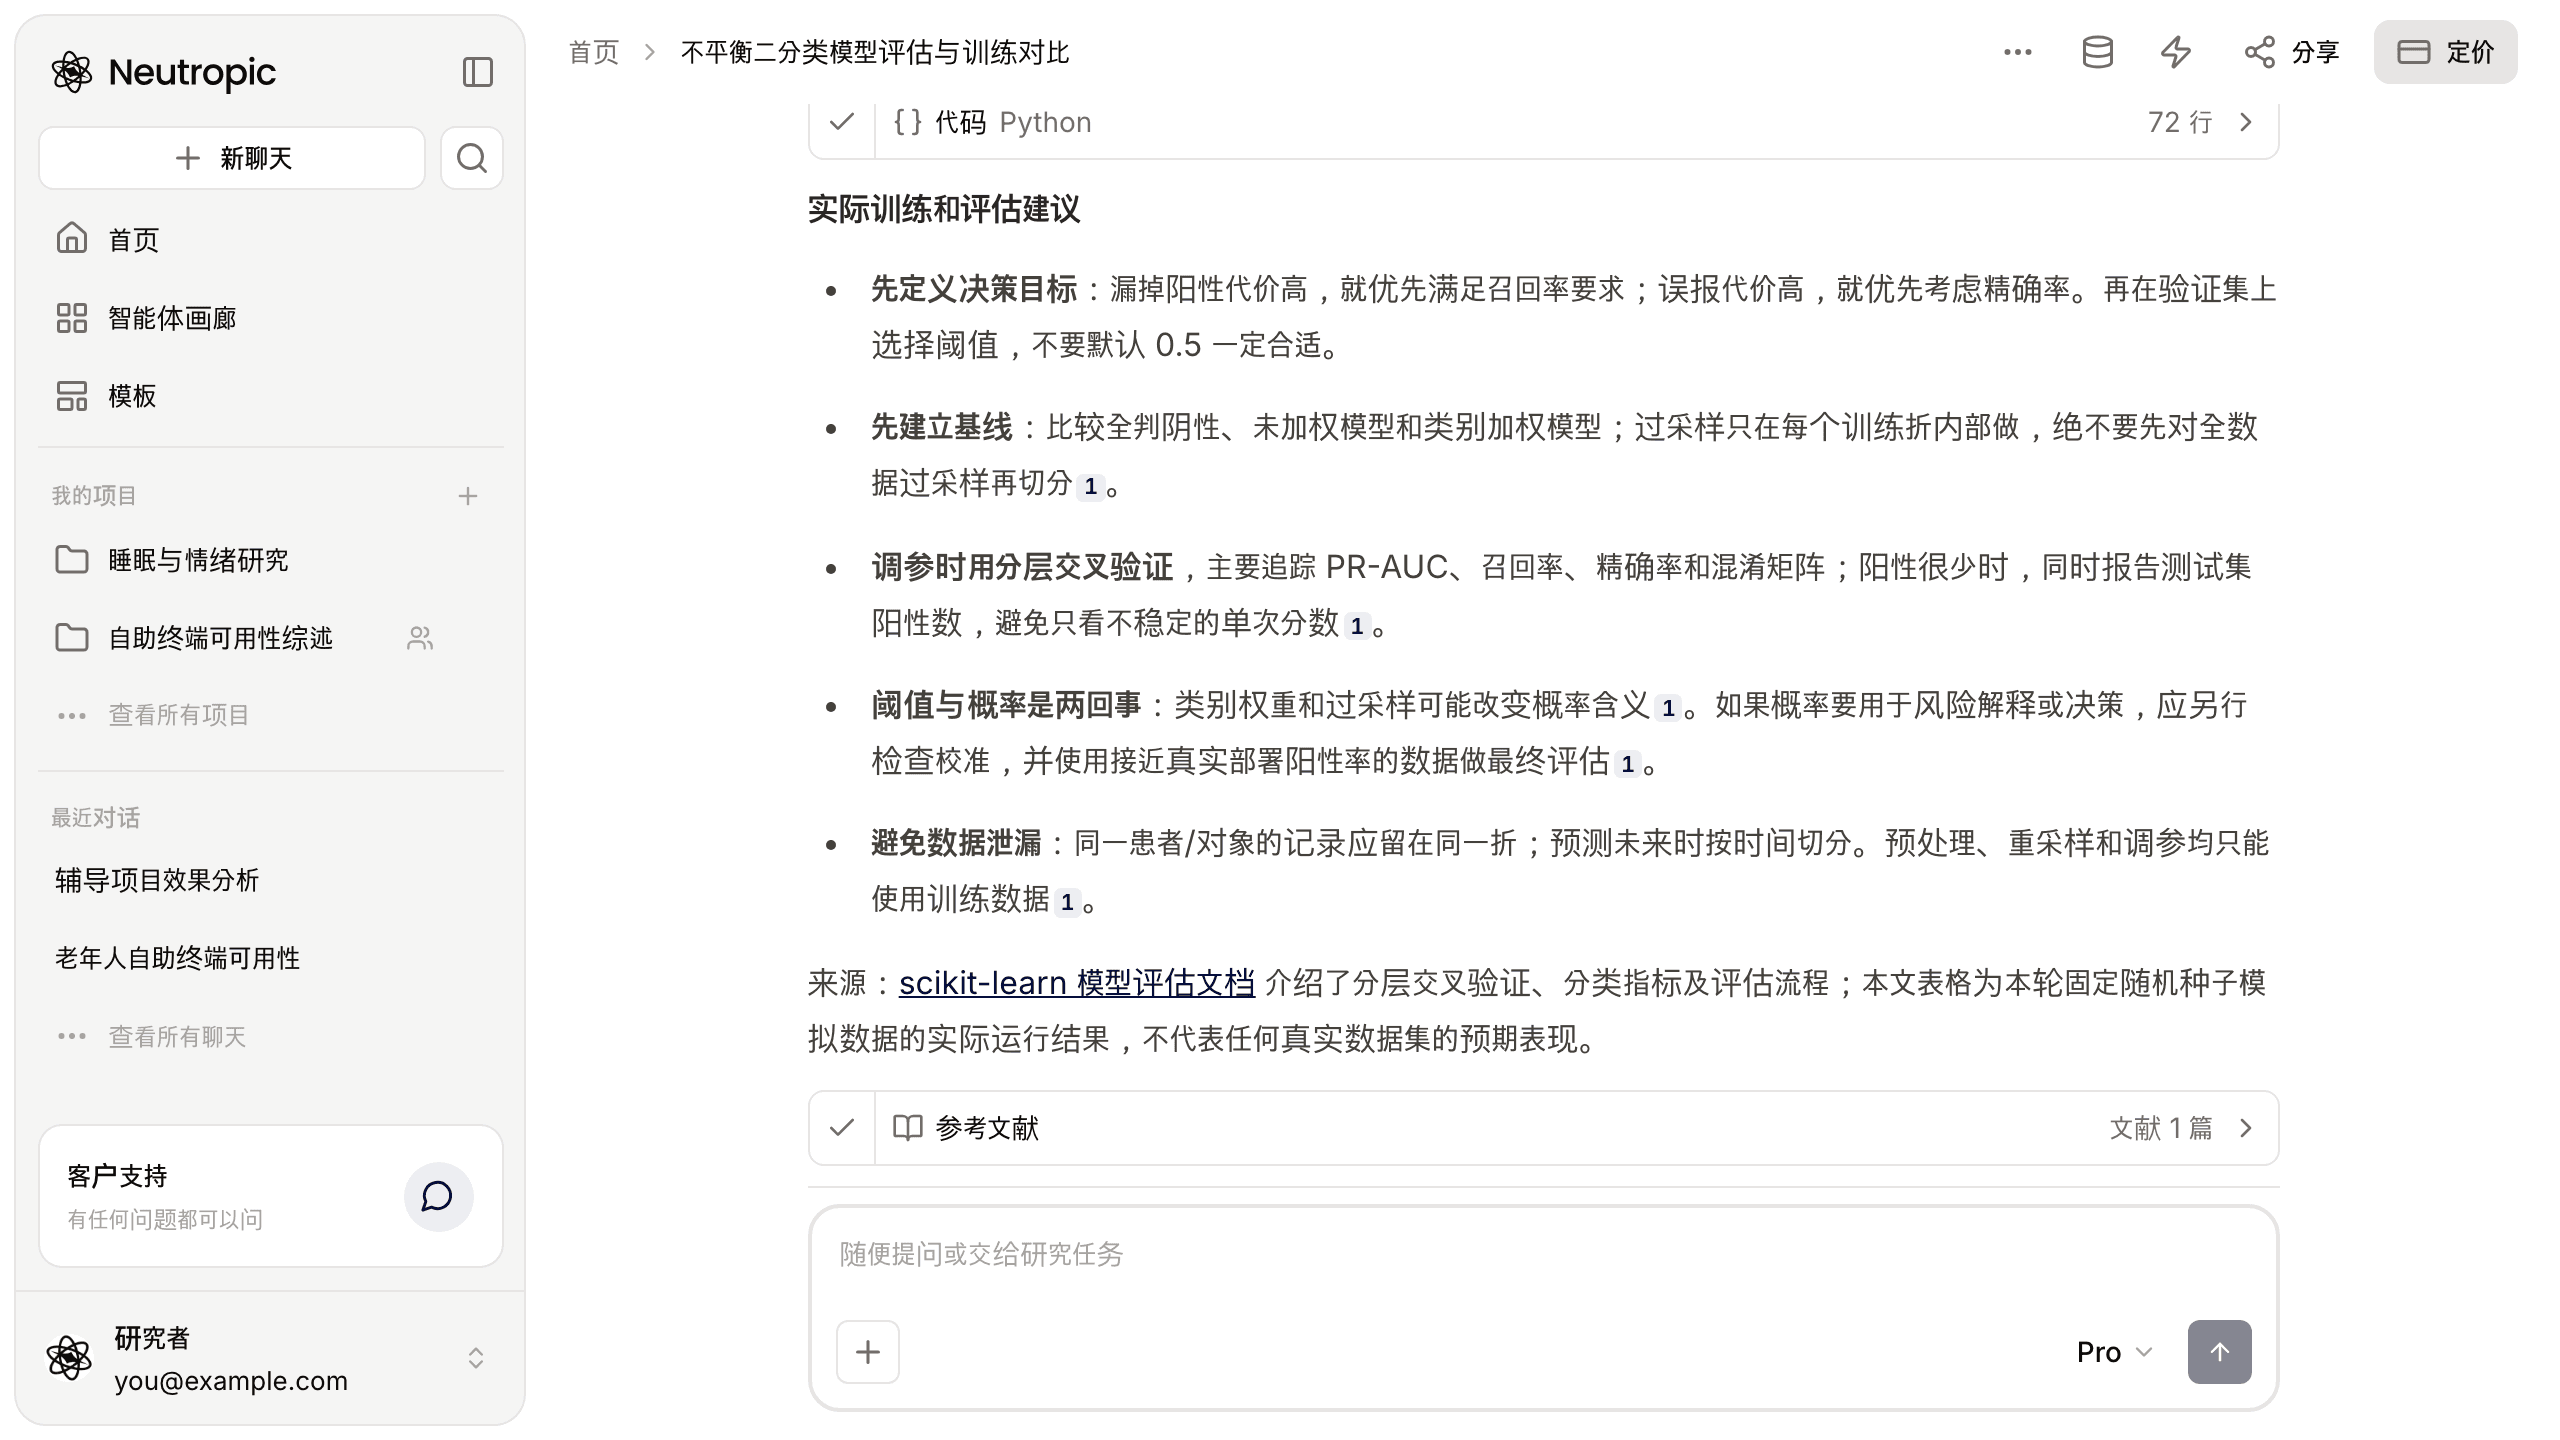
点开 参考文献 卡片,可以看到答案引用的 1 篇文献:2026 年发表在医学信息学期刊上、讨论类别不平衡校正如何影响临床风险预测模型表现的研究。答案末尾也注明,表格是本轮固定随机种子模拟数据的实际运行结果,不代表任何真实数据集的预期表现。
重新读懂了 95% 这个数字
| 开始时 | 现在 | |
|---|---|---|
| 判断标准 | 准确率 95% | 精确率、召回率、F1、PR-AUC、混淆矩阵 |
| 比较 | 只有自己的模型 | 全判阴性、普通、加权、过采样在同一测试集上 |
| 阈值 | 默认 0.5 | 在验证集上按代价选择 |
| 训练方法 | 以为加权或过采样就能解决 | 确认它们是在召回率和误报之间取舍 |
| 代码 | 到处找示例 | 能复现表格三行结果的 72 行代码 |
当然,这只是模拟数据。真实数据的阳性比例、分组或时间结构不同,结果也会不同。这次引用的文献只有 1 篇,写进论文前最好再补充方法学文献。
本文使用 Pro 运行。Lite(免费方案)不运行模拟,只解释指标;Expert 还会比较重采样方法并校准概率。
阳性罕见时,先问模型找到了几个、漏掉了几个,再问它准确率多高。
这周就像李然一样,把阳性比例和让你不安的那个数字写下来问一问吧。免费开始使用 Neutropic