你好,我们是 Neutropic 团队!
用随访数据分析"什么时候发生"时,总会遇到这样的人:关心的事件还没发生,别的事件先发生了。想看退学,学生却先转学了;想看复发,病人却先因其他原因去世了。这些人能直接当作"删失"处理吗?🥲
大多数生存分析课程讲到 Kaplan–Meier 和 Cox 模型就结束了。于是很多人把竞争事件当作普通删失,再把 1 − Kaplan–Meier 当作"发生概率"来报告。可这个值通常会高估关注事件的实际发生概率。把原因特异风险比当作绝对风险来解读,也是常见错误。
这篇文章跟着教育学博士生 许诺:用大一新生的随访数据分析到退学的时间,却在"转学"这个竞争事件面前卡住了。许诺是虚构人物,但下面的界面全部来自 Neutropic 中真实运行的对话。
同时问了"怎么做"和"注意什么"
许诺只确定了要用 Python,于是这样提问:
生存分析中存在竞争风险(competing risk)时,应该怎么分析、需要注意什么?我打算用Python来做。
提问里有三件事:问题的名称(竞争风险)、想要什么(分析方法和注意事项)、工具(Python)。加上"需要注意什么"尤其有用。只问方法,往往得到一段代码就结束了;问陷阱,才会连解读时容易出错的地方一起指出来。
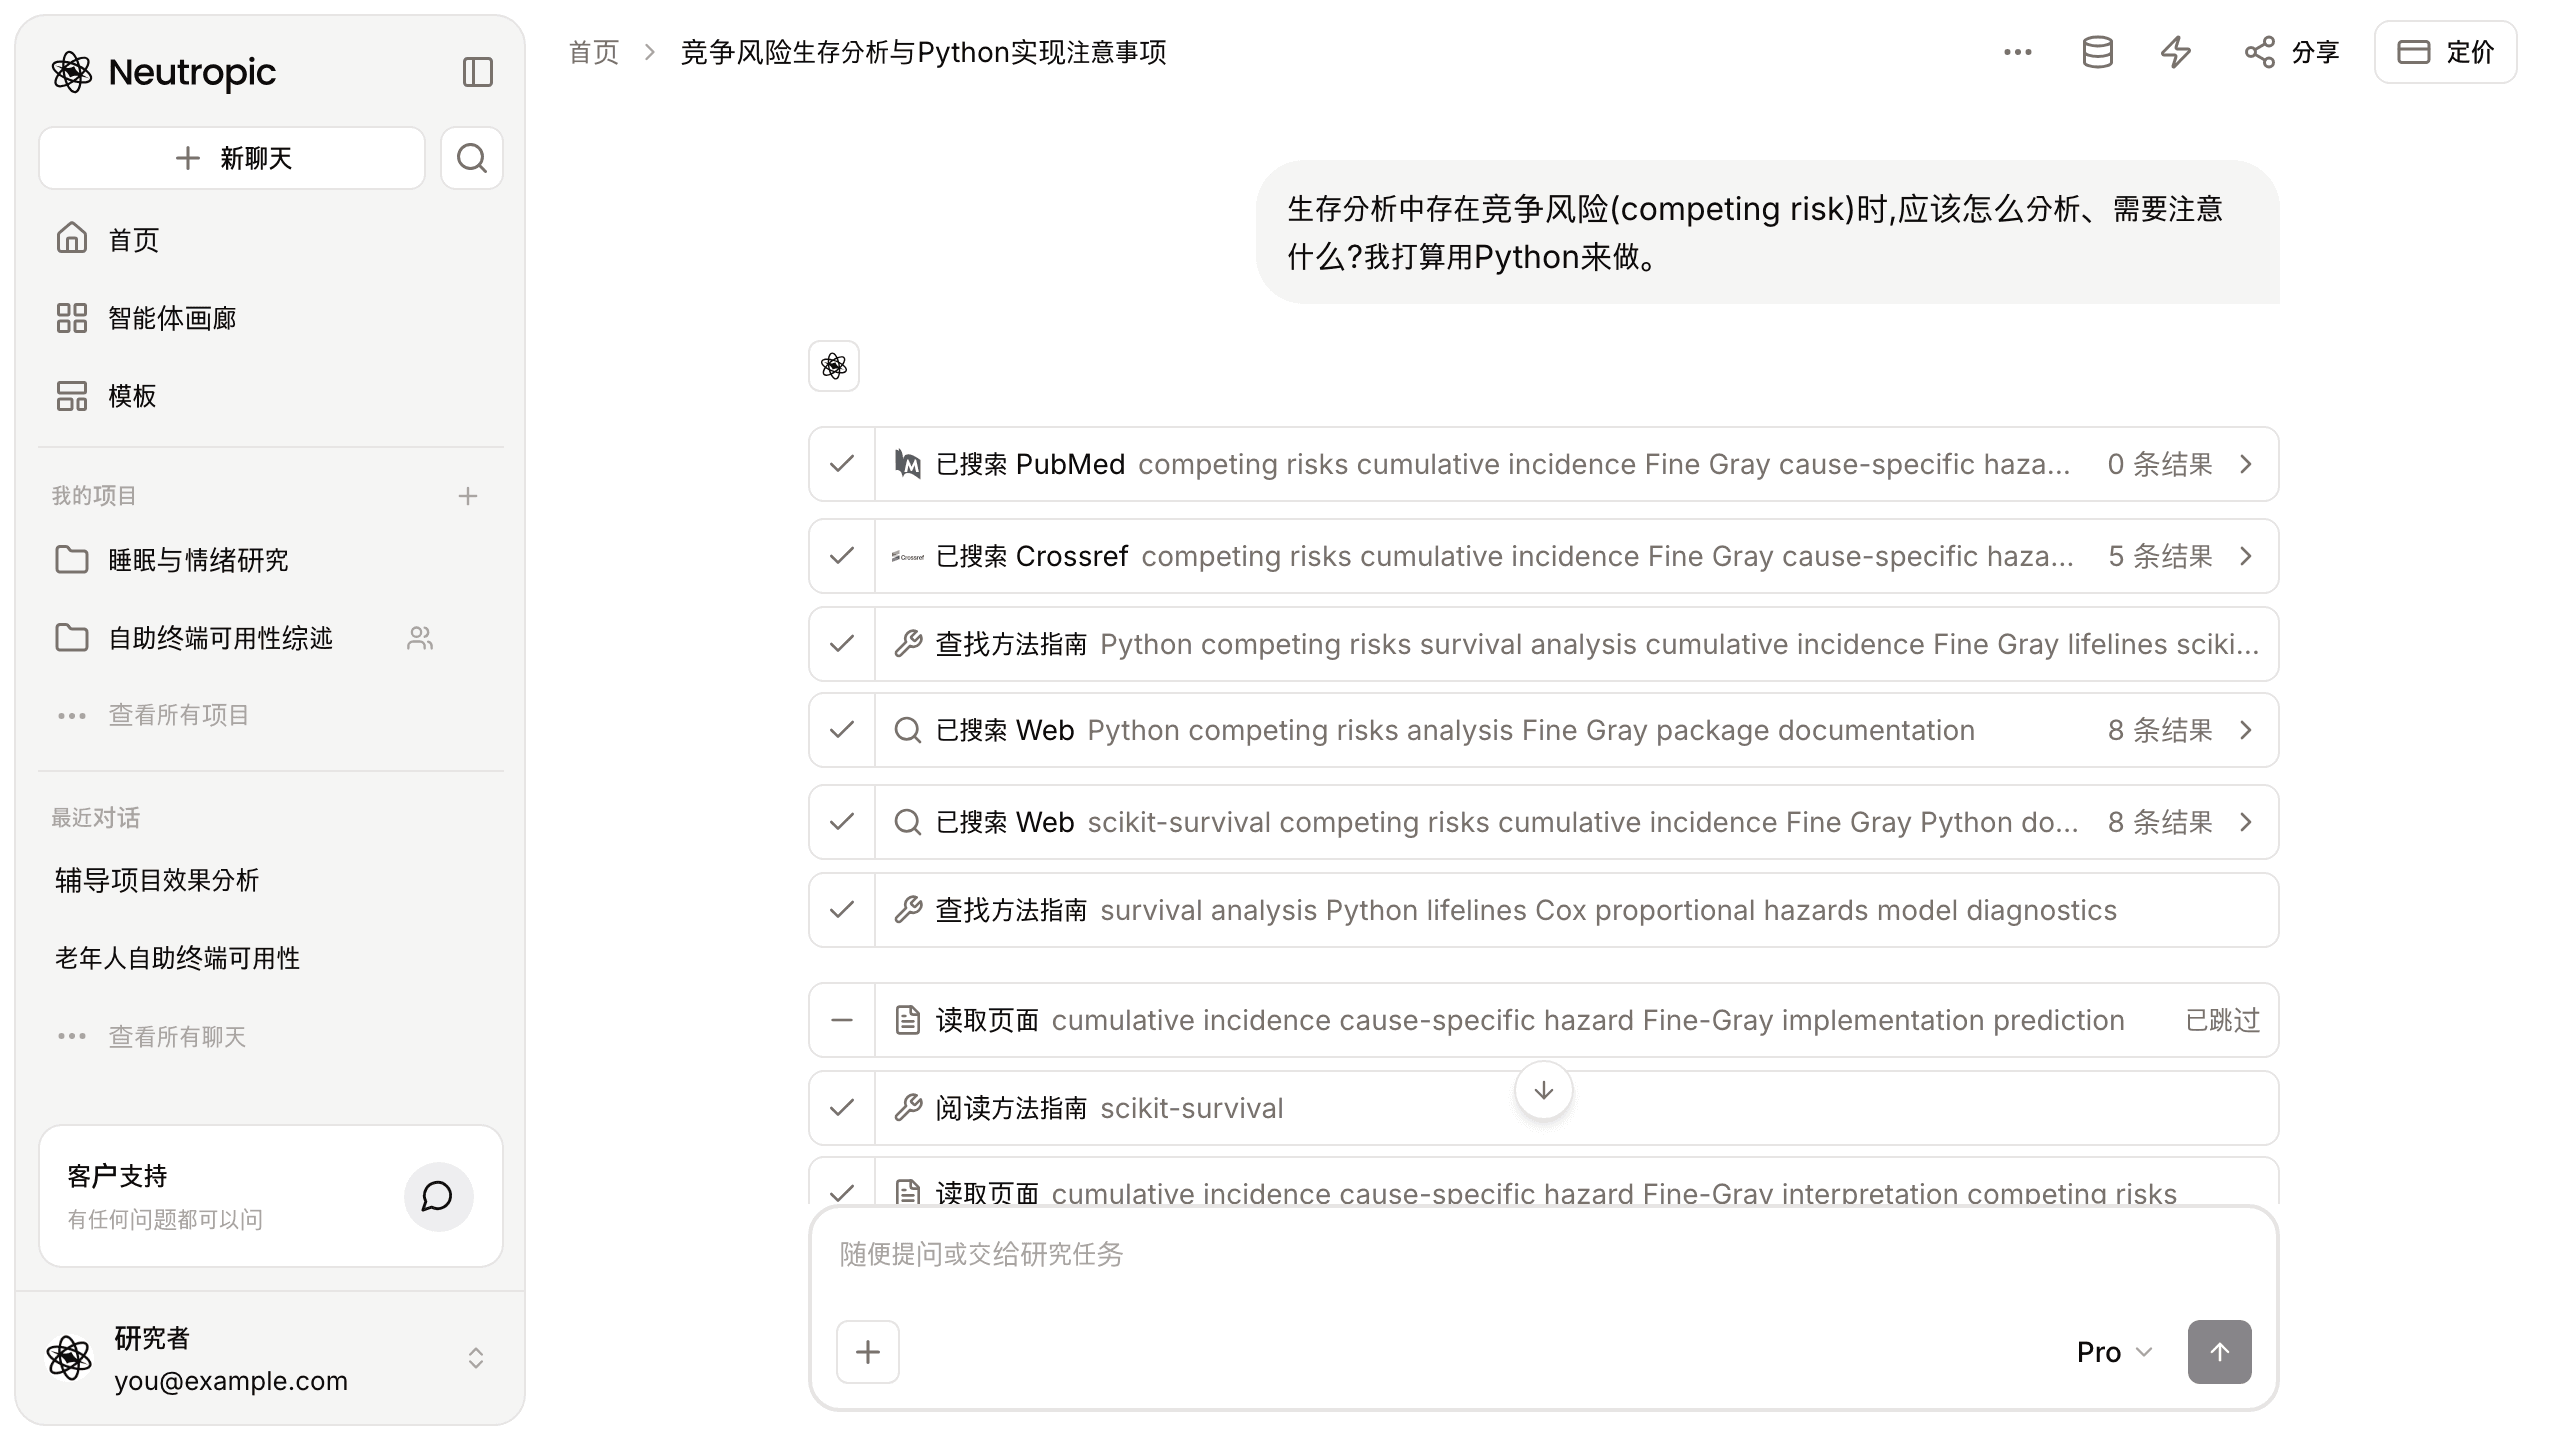
先查文献和文档,再读方法指南
发送后,步骤一条条出现:在 PubMed 和 Crossref 中检索累积发生函数与 Fine–Gray 的文献,两次在网页中查 Python 竞争风险分析包的文档,用 查找方法指南 找到相关指南,再用 阅读方法指南 读了 scikit-survival 指南,并读取了讨论原因特异风险与 Fine–Gray 解读的页面。
方法指南是 Neutropic 事先审核过的分析流程文档。PubMed 一次检索为 0 条结果、一次读取页面被跳过,这些也都如实留在步骤里。
先回答"你要估计什么"
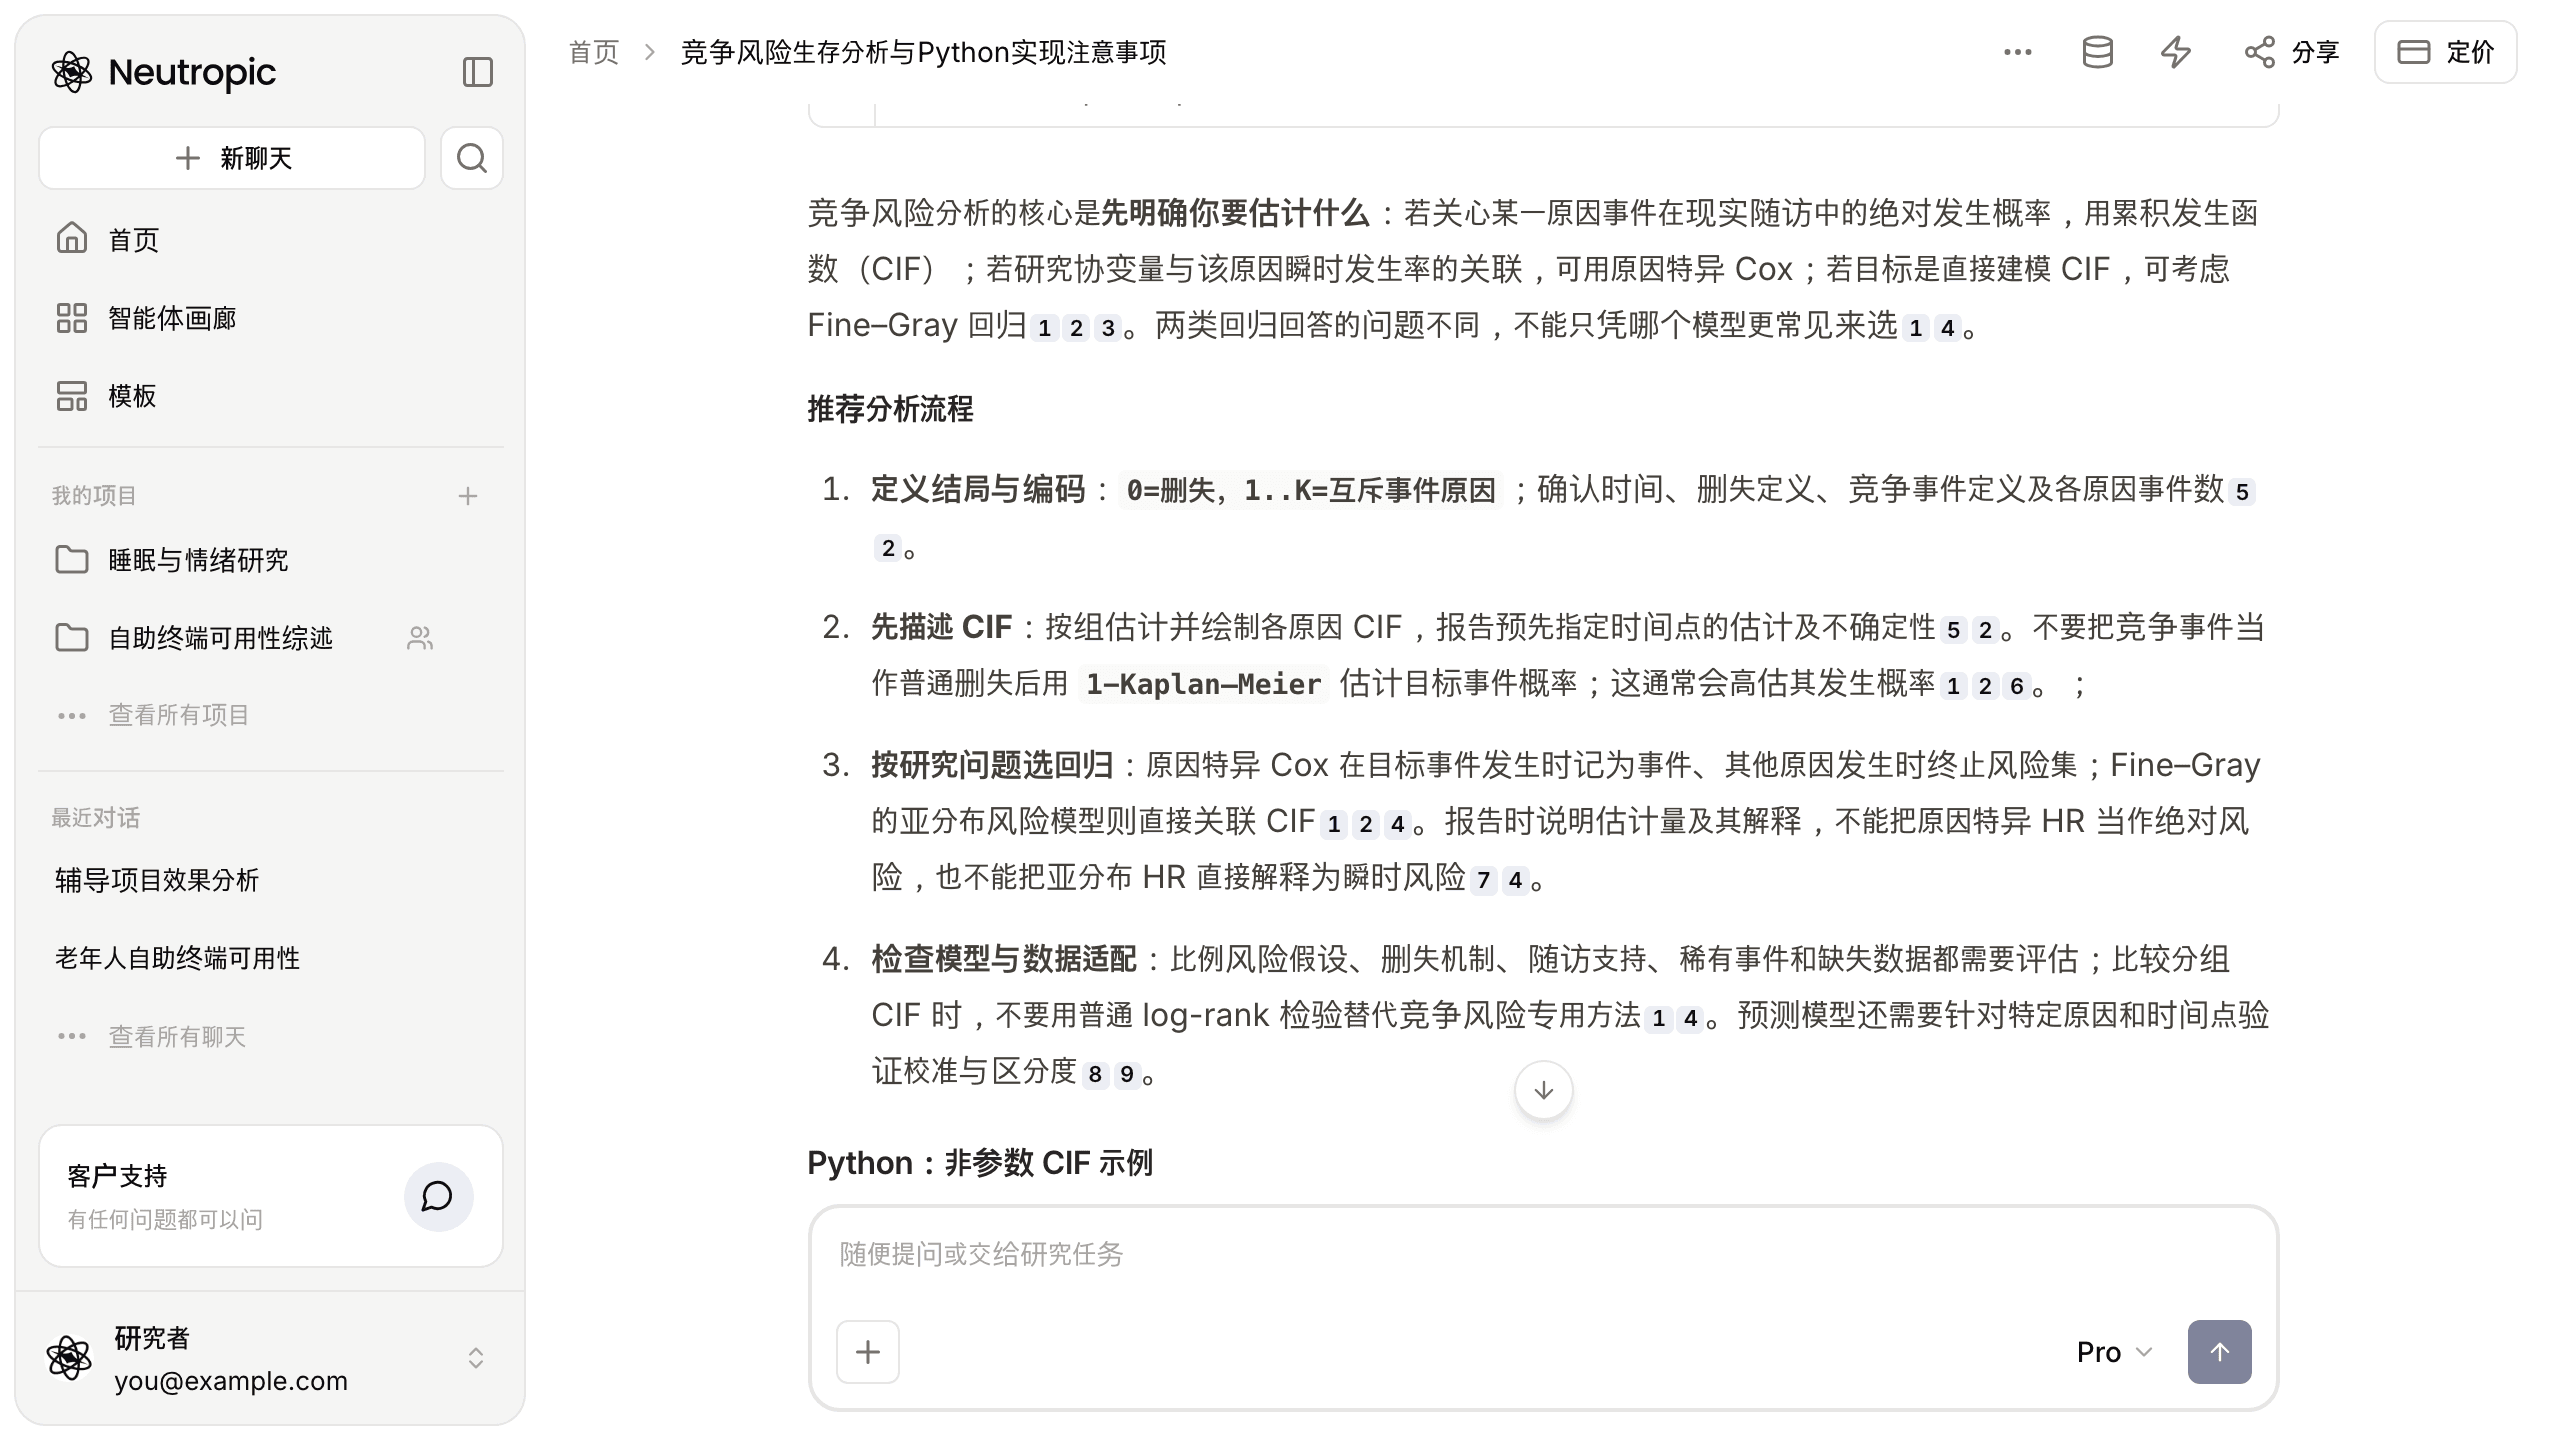
答案的第一句不是方法,而是问题:竞争风险分析的核心是先明确你要估计什么。若关心某一原因事件在现实随访中的绝对发生概率,用累积发生函数(CIF);若研究协变量与该原因瞬时发生率的关联,可用原因特异 Cox;若目标是直接建模 CIF,可考虑 Fine–Gray 回归。两类回归回答的问题不同,不能只凭哪个模型更常见来选。
接着是推荐流程:
- 定义结局与编码:0=删失,1..K=互斥事件原因;确认时间、删失定义和各原因事件数。
- 先描述 CIF:按组估计并绘制各原因 CIF,报告预先指定时间点的估计及不确定性。
- 按研究问题选回归:不能把原因特异 HR 当作绝对风险,也不能把亚分布 HR 直接解释为瞬时风险。
- 检查模型与数据适配:比例风险假设、删失机制、稀有事件;比较分组 CIF 时,不要用普通 log-rank 检验。
对照许诺的研究:想说"四年内退学的概率",用 CIF;想看"奖学金与退学风险的关联",用原因特异 Cox。
许诺差点继续用 1 − Kaplan–Meier
许诺在这里差点犯错。给导师看过的旧稿里,已经写着"用 1 − KM 估计的四年退学率"。答案正好点中这一处:不要把竞争事件当作普通删失后用 1−Kaplan–Meier 估计目标事件概率,这通常会高估其发生概率。
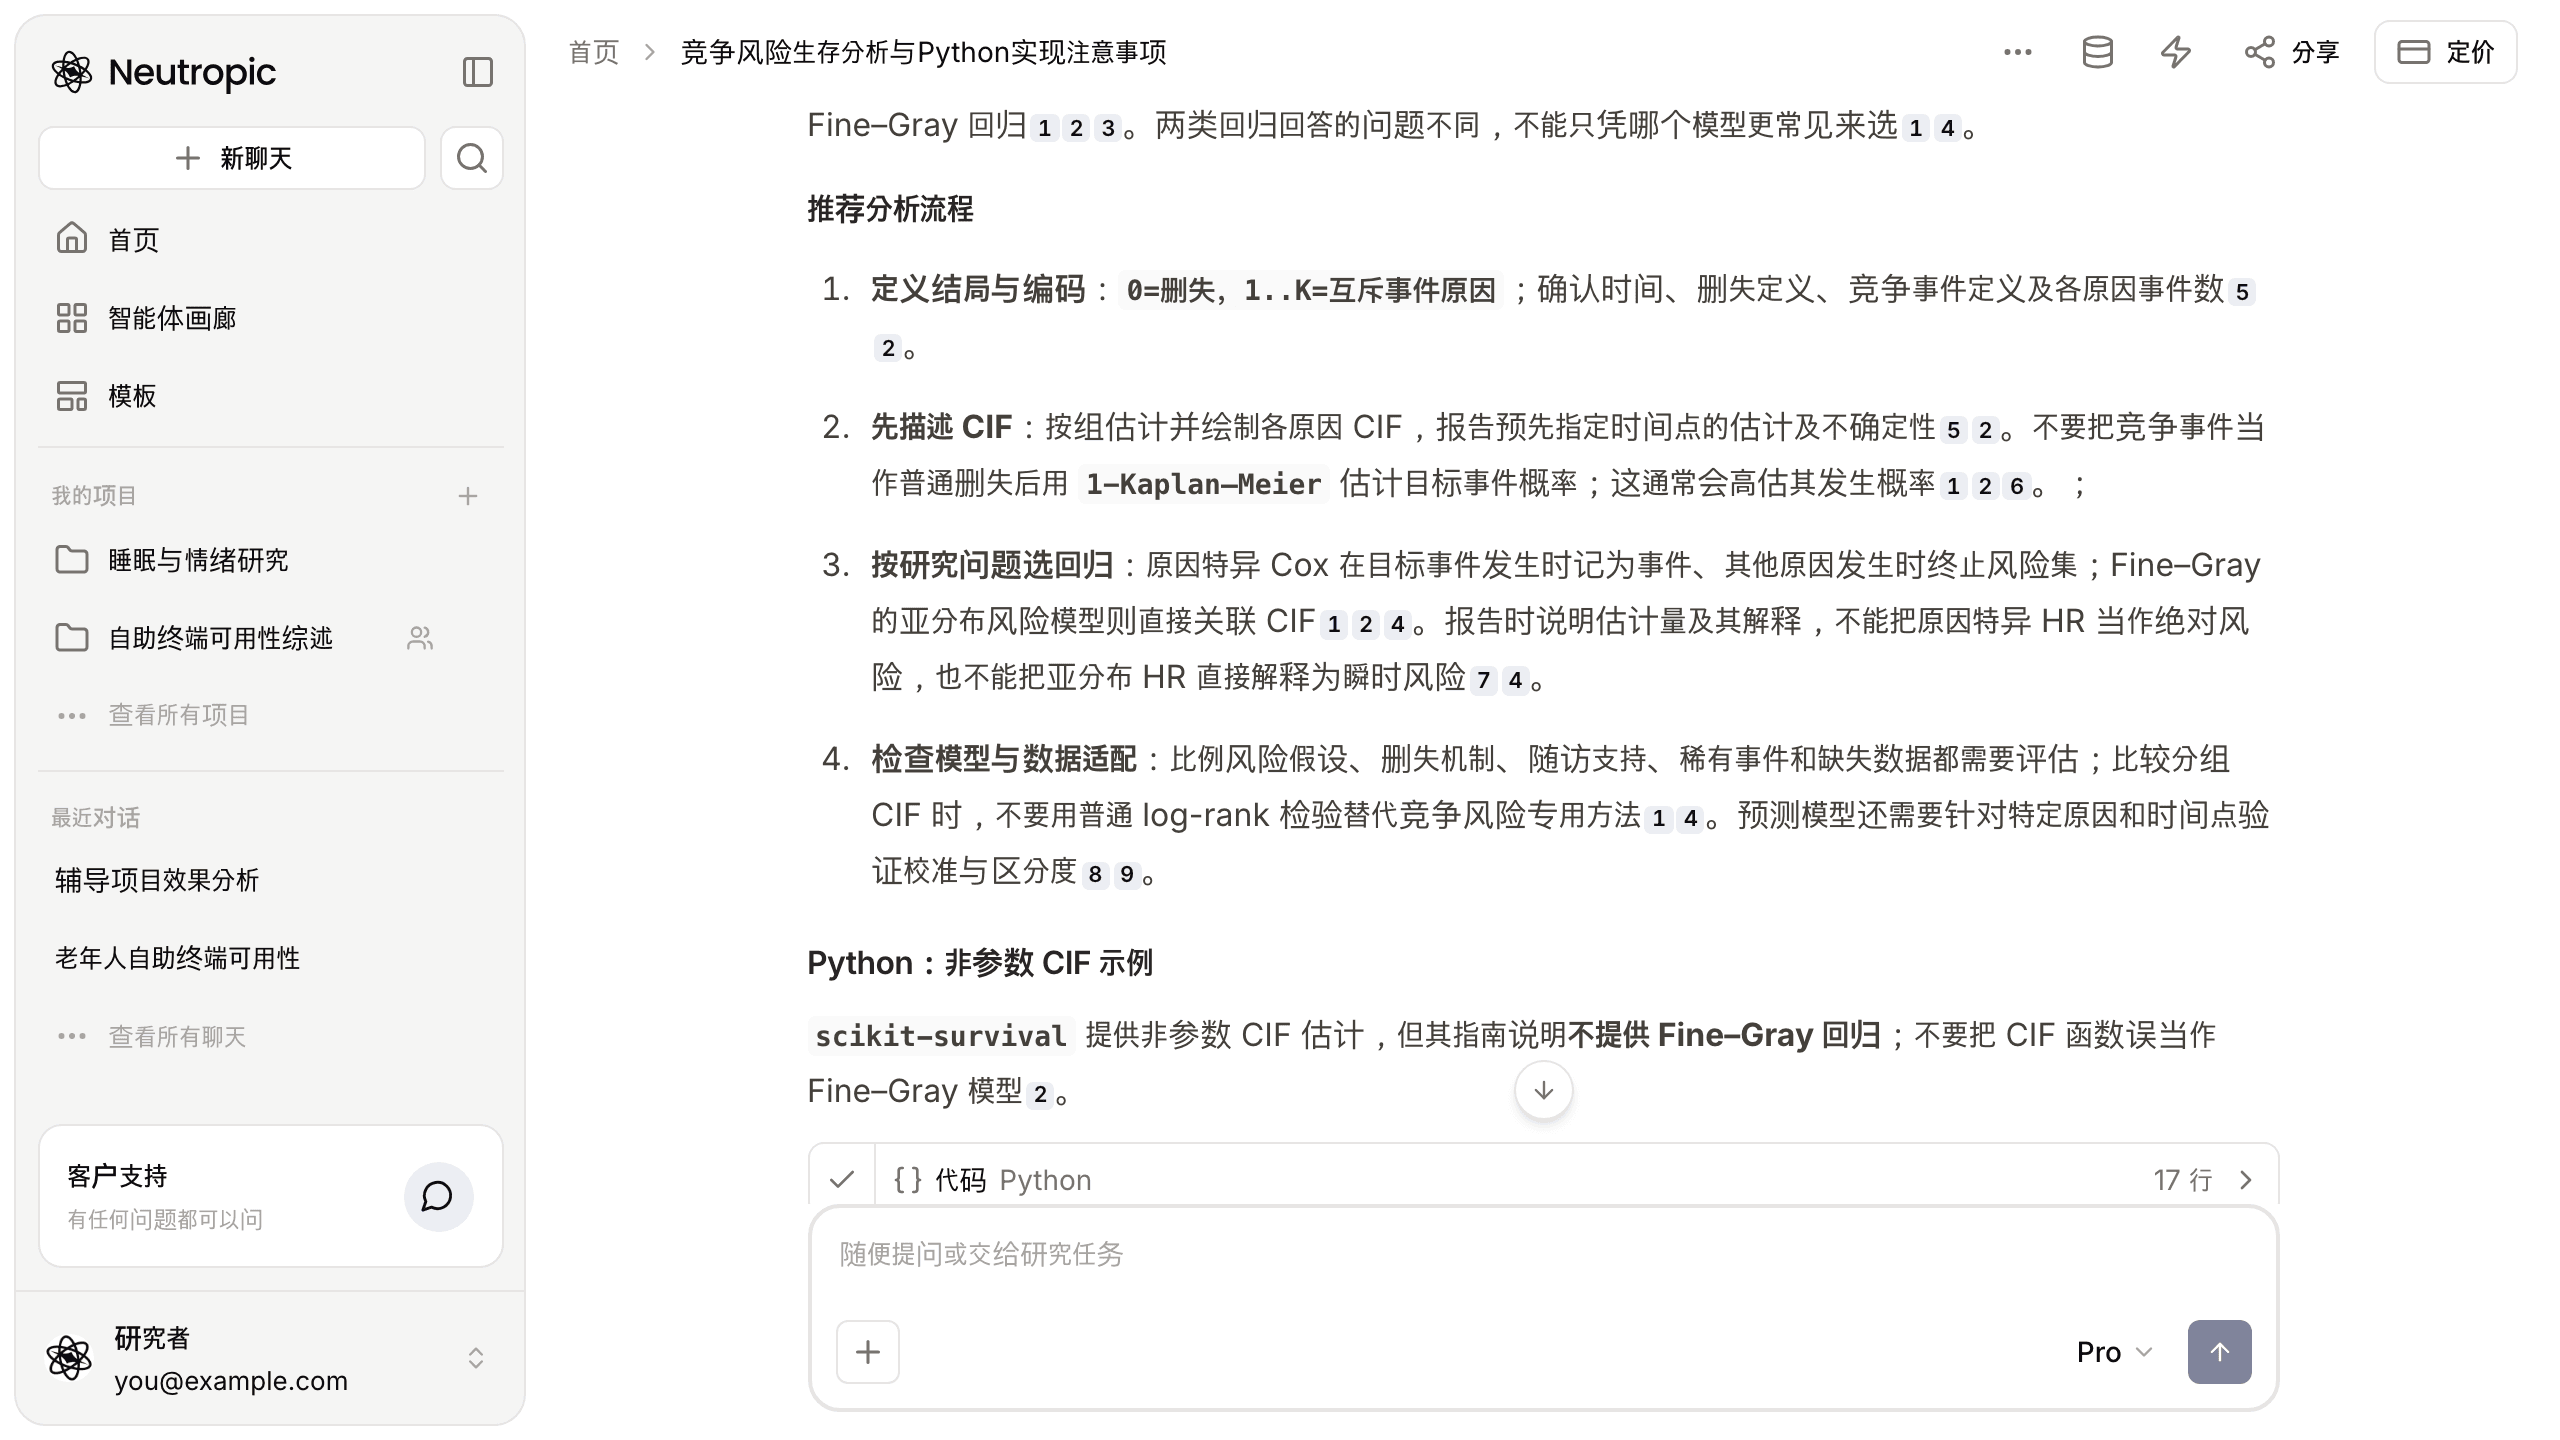
更难得的是,答案对自己的局限也说得很直白。它给出了用 scikit-survival 估计非参数 CIF 的 17 行示例代码,并说明:
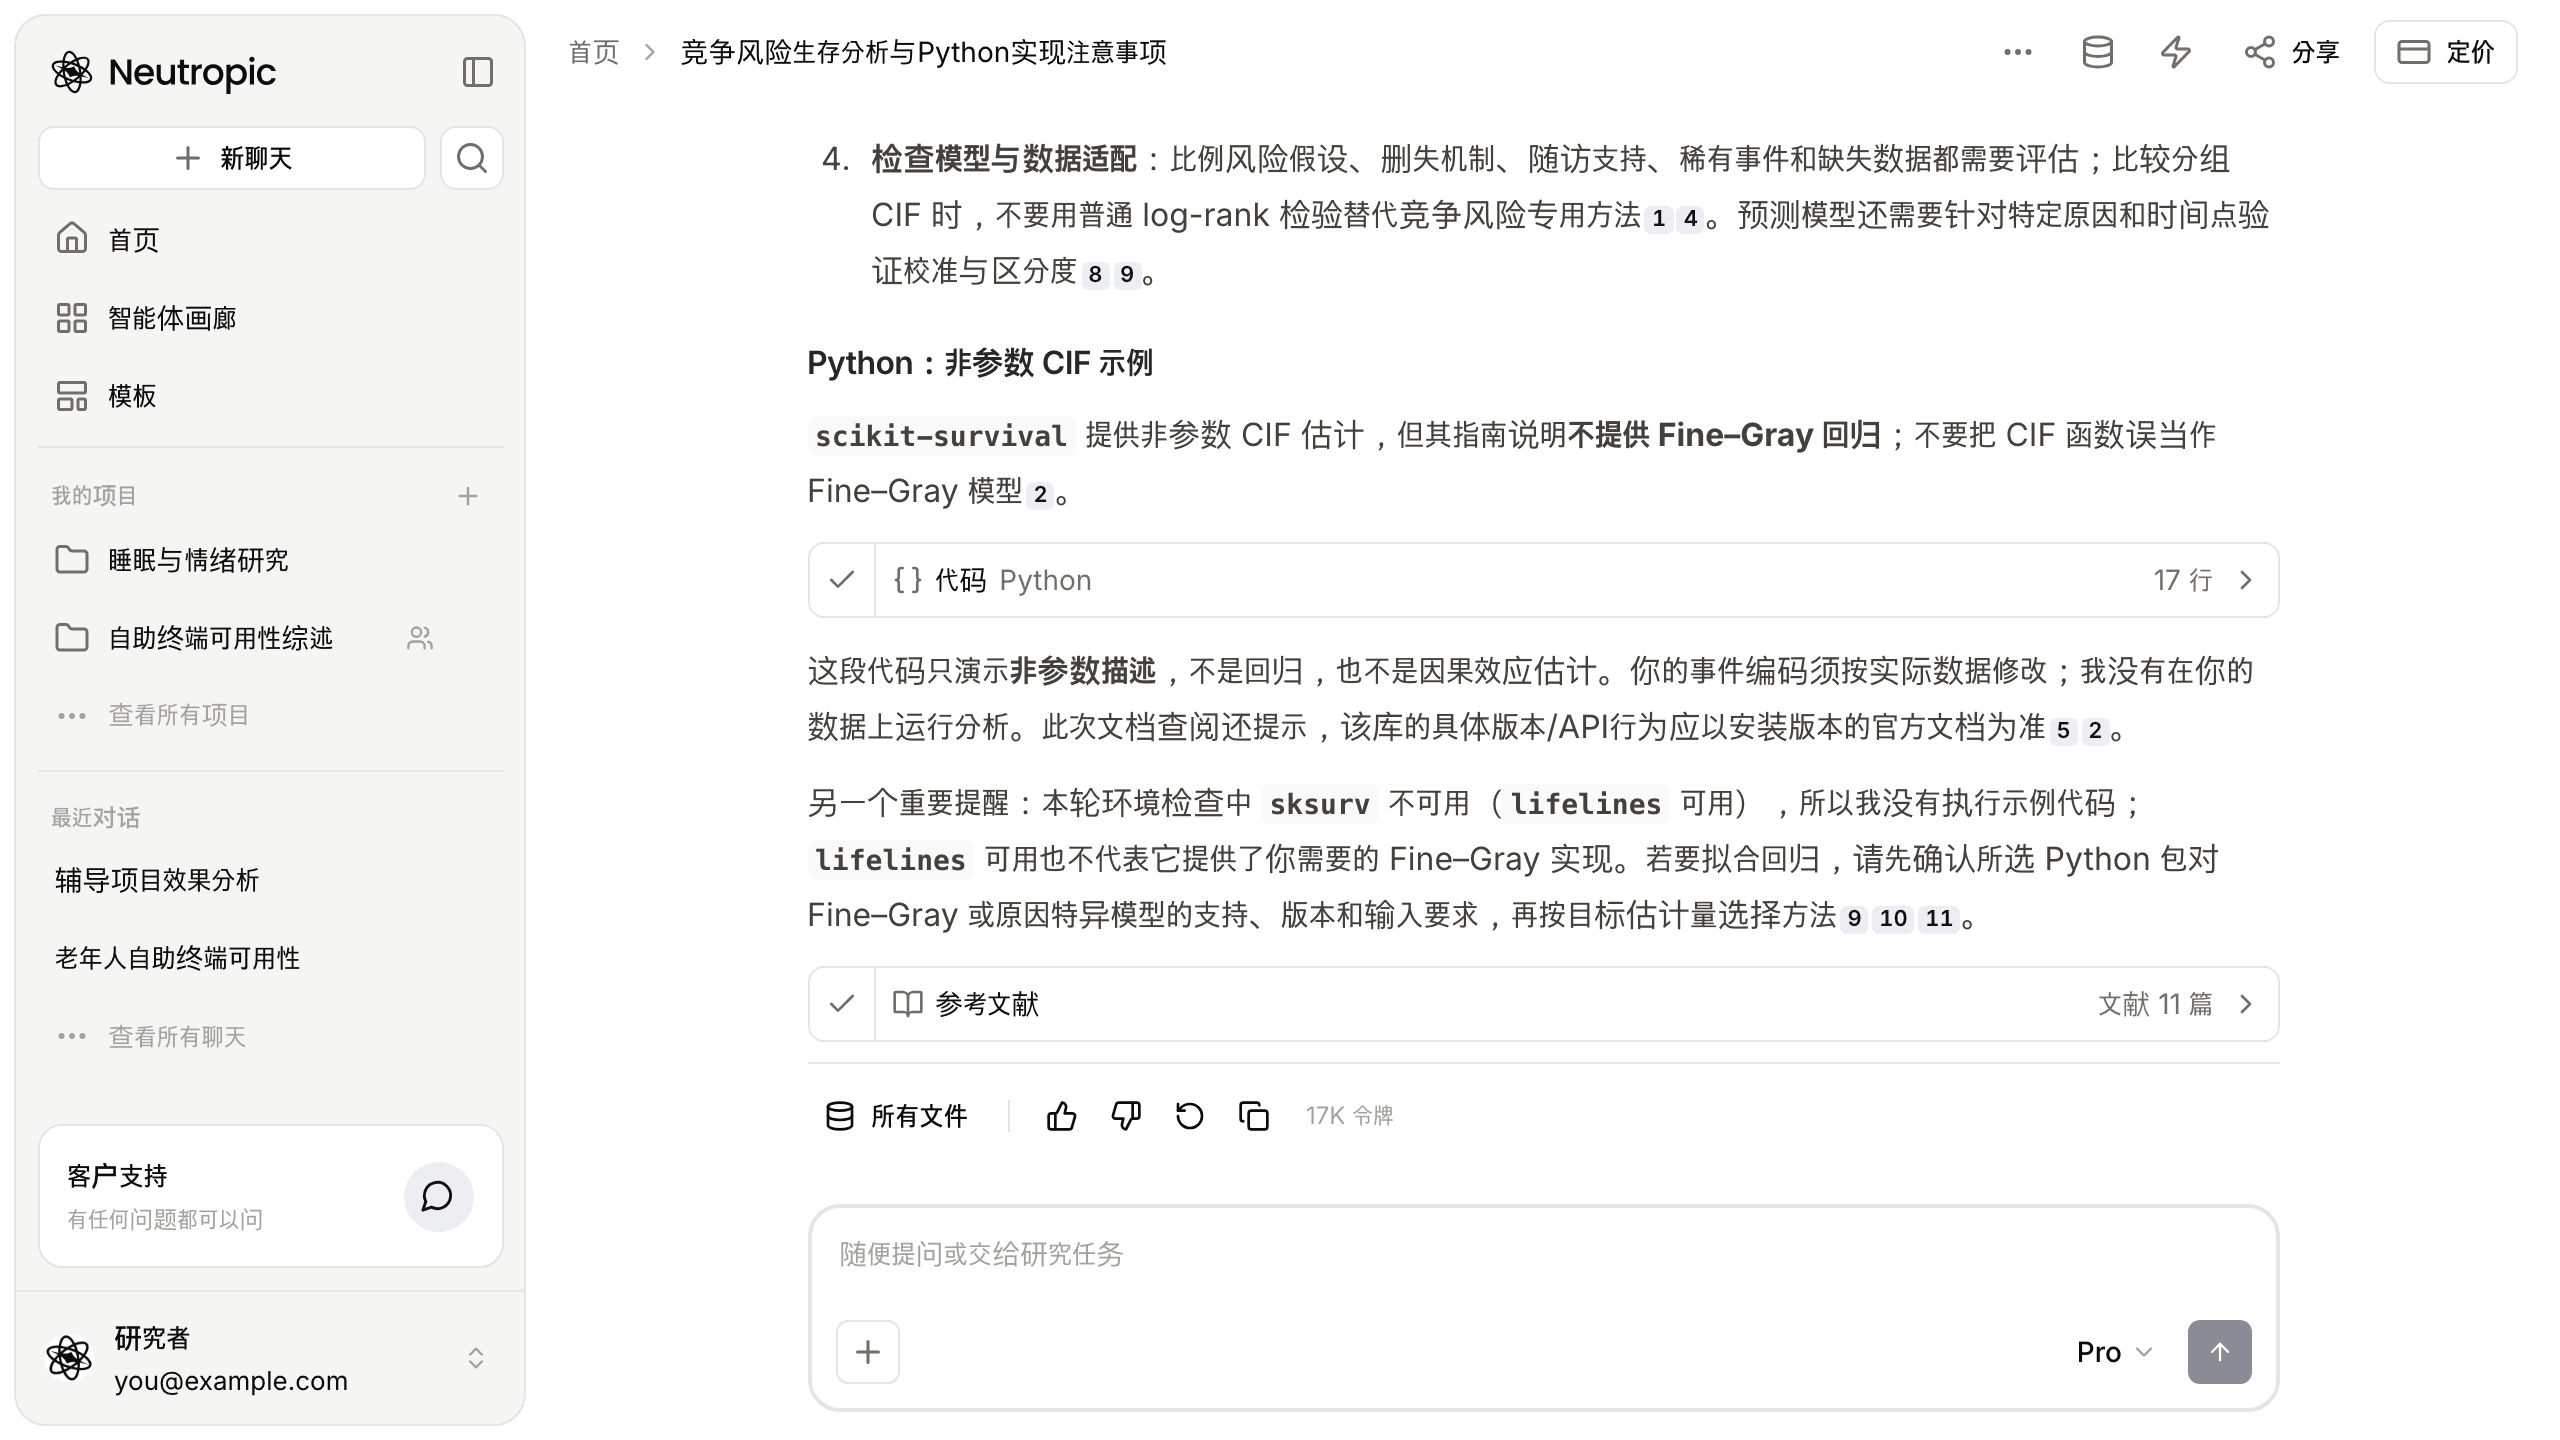
- 这段代码只演示非参数描述,不是回归,也不是因果效应估计;scikit-survival 不提供 Fine–Gray 回归。
- 本轮环境检查中
sksurv不可用(lifelines可用),所以没有执行示例代码,也没有在你的数据上运行分析。 lifelines可用也不代表它提供了你需要的 Fine–Gray 实现;拟合回归前,请先确认所选包的支持情况、版本和输入要求。
所以这段代码是一个起点,而不是跑出来的结果。许诺需要换上自己的数据和事件编码,并在自己的环境里先跑通。
引用的文献也留了下来
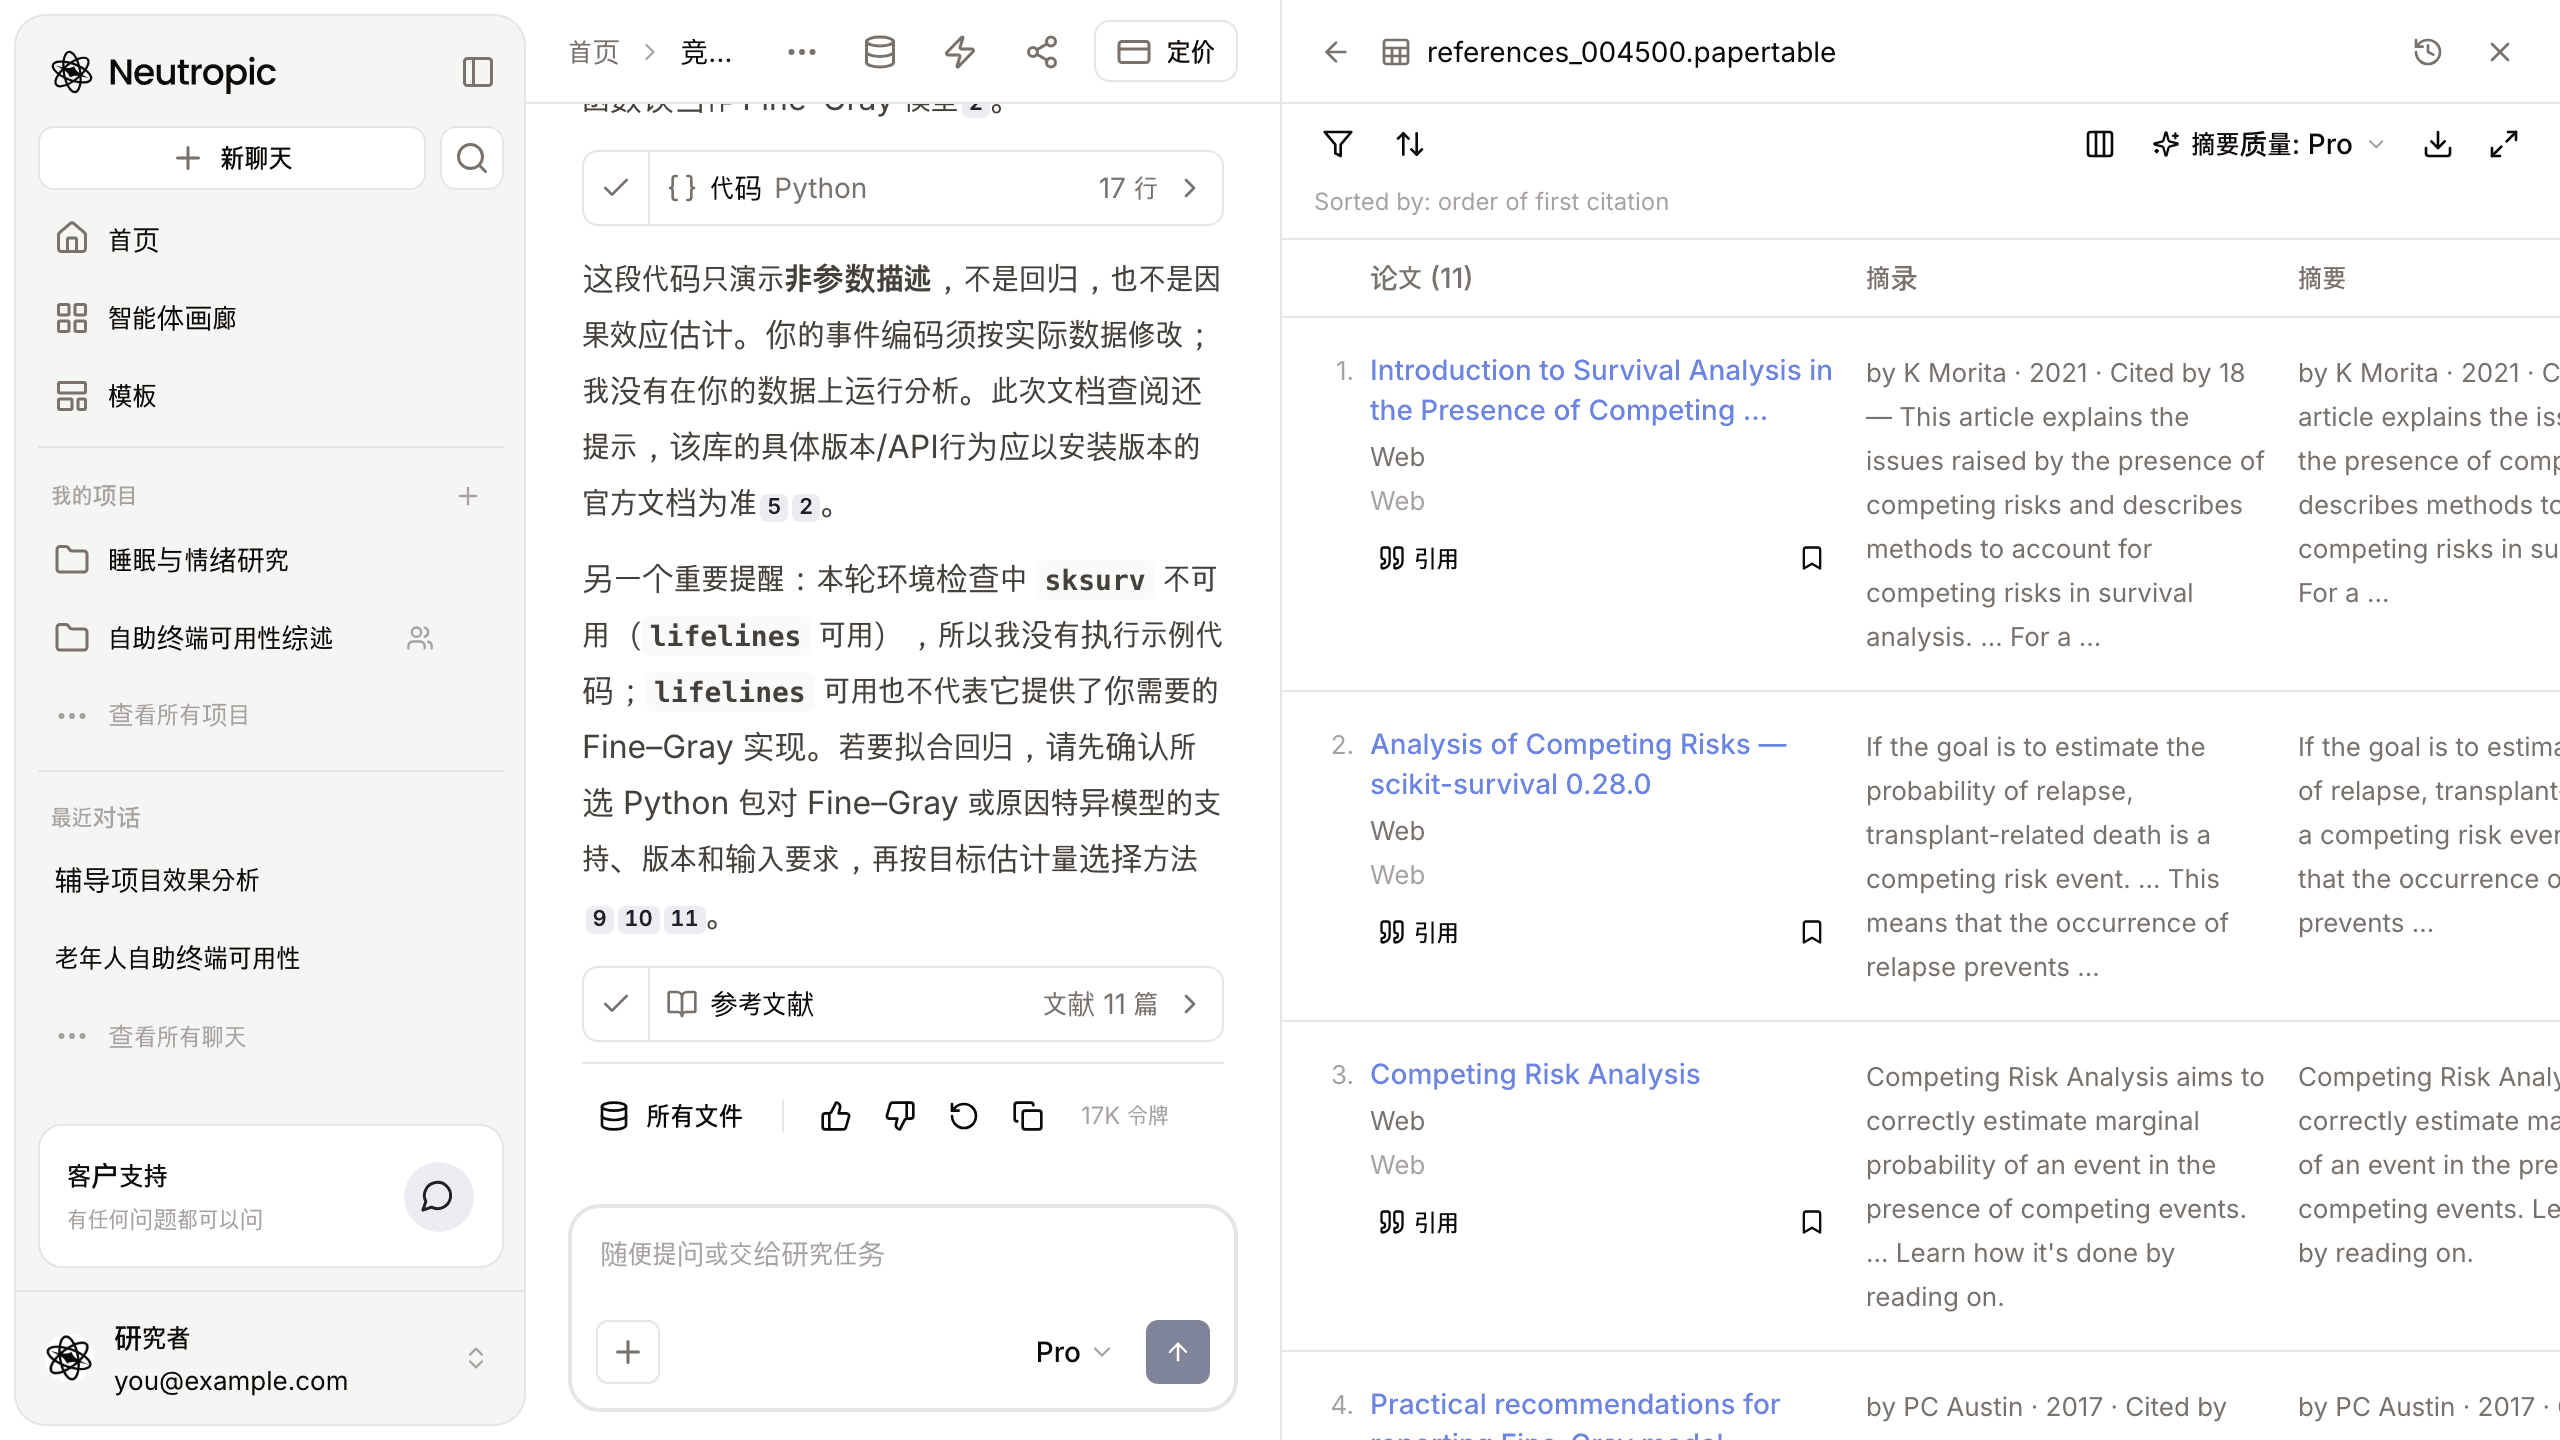
句末的小号数字是引用来源。点开 参考文献 卡片,11 条来源会以表格形式打开,包括介绍存在竞争风险时生存分析的综述、scikit-survival 的竞争风险指南、Fine–Gray 模型的报告建议,以及 Gelber 等人 1991 年主张用累积发生函数的论文。
连下一步都给出了建议
答案最下面给出了接下来可以做的事:
- 结合心理、咨询或教育研究中常见的随访结局,进一步比较原因特异 Cox 与 Fine–Gray 的研究问题、系数解释、假设和报告方式,并补充 Python 中可用的实现及其版本限制
- 基于本轮竞争风险分析资料,整理一份可审计的叙述性文献综述,比较 CIF、原因特异 Cox 和 Fine–Gray 的适用问题、假设、报告建议及 Python 实现限制,并列出纳入文献表 — 叙述性综述 智能体
点一下,就在同一个对话里接着做。
"能不能当删失"变成了"我要估计什么"
| 开始时 | 现在 | |
|---|---|---|
| 问题 | 转学的学生能当删失吗? | 要的是概率(CIF)还是瞬时风险(原因特异 Cox)? |
| 方法 | 只会 Kaplan–Meier 和 Cox | CIF、原因特异 Cox、Fine–Gray 各自的用途 |
| 代码 | 没有 | scikit-survival 的 CIF 示例(未执行) |
| 注意事项 | 用 1 − KM 报告退学率 | 高估、log-rank 误用、各原因事件数 |
| 依据 | 不知道该读什么 | 11 条参考来源和下一步建议 |
当然,代码还没在任何数据上运行过。事件编码、删失规则和各原因事件数需要许诺自己核对;如果要做 Fine–Gray,先确认所选的 Python 包是否支持。但只要"估计什么"定下来,其余的选择就都有了方向。
本文使用 Pro 运行。Lite(免费方案)不给代码,只简要说明估计目标;Expert 还会实际运行示例,讨论模型诊断以及何时更适合用多状态模型。
如果别的事件可能抢先发生,先问"我要估计什么",再问"用哪个模型"。
这周就像许诺一样,写下问题名称和工具问一问吧。免费开始使用 Neutropic