你好,我们是 Neutropic 团队!
假设你手上有一份每位受试者测了好几次的数据,导师说:"这得用分层模型,试试贝叶斯,用 PyMC。"重复测量方差分析你做过,分层模型却是第一次,贝叶斯更是第一次。打开示例笔记本,先验、链、发散这些陌生词一下子全涌了出来。🥲
其实模型本身并不长,难的是后面。不检查链是否混合良好、发散从何而来、模型能否复现数据,就直接读数字,很容易得到一个看似合理的错误结论。
这篇文章跟着心理学博士生 陈晨,看看第一次为重复测量数据搭建 PyMC 分层模型的过程。陈晨是虚构人物,但下面的界面全部来自 Neutropic 中真实运行的对话。
提问只有一句话
陈晨想在上传数据之前先把整体思路理清楚,于是只问了这一句:
如何用 PyMC 为重复测量数据建立并检查贝叶斯分层模型?
句子虽短,该有的都有:工具(PyMC)、数据结构(重复测量),还有两个动词。如果只写"建立",答案大概停在模型代码;加上"检查",答案才延伸到了诊断步骤。
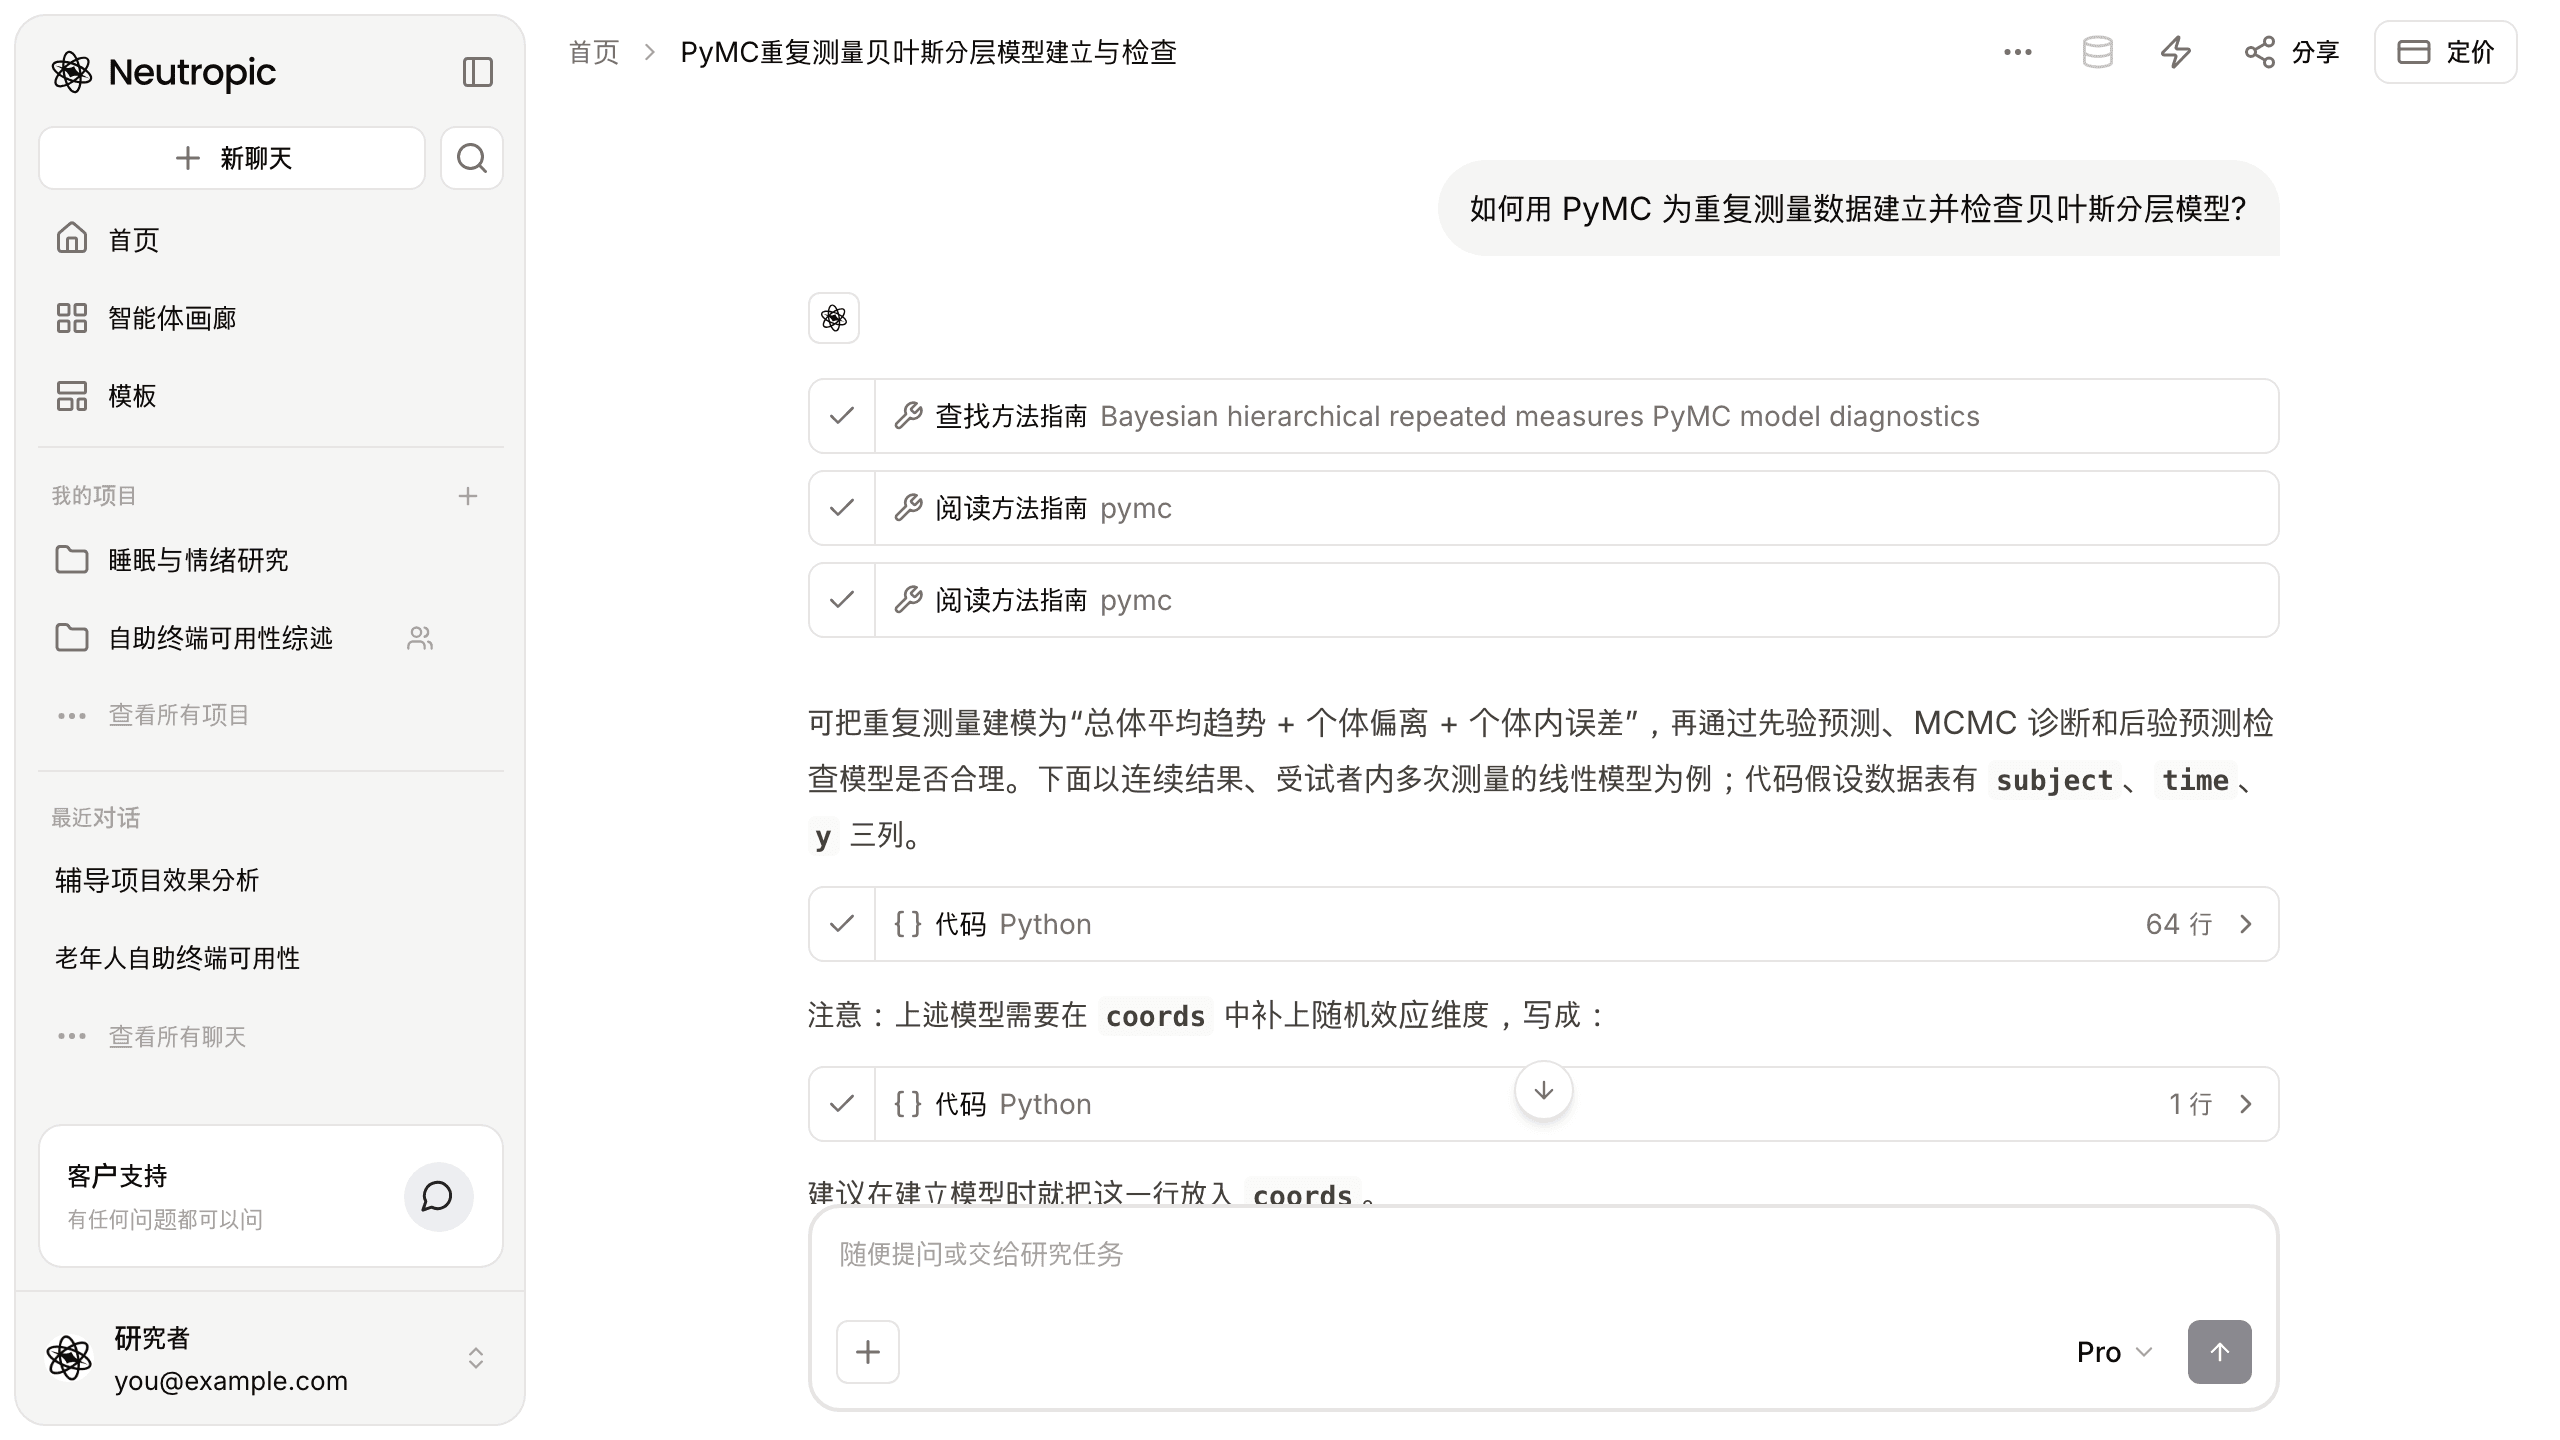
回答之前先读了 PyMC 方法指南
发送后,步骤一条条出现:先用 查找方法指南 找到适合分层模型诊断的指南,再用 阅读方法指南 读了两次 PyMC 指南。这次对话里没有运行代码的步骤,也就没有进行任何抽样。
方法指南是 Neutropic 事先审核过的分析流程文档。模型不凭记忆直接作答,而是先读经过审核的流程,再按顺序执行。
模型是"总体平均趋势 + 个体偏离 + 个体内误差"
答案一开头就给出了思路:把重复测量建模为"总体平均趋势 + 个体偏离 + 个体内误差",再通过先验预测、MCMC 诊断和后验预测检查模型是否合理。
示例假设数据表有 subject、time、y 三列,结果为连续变量。64 行代码先把时间标准化,用随机截距和随机时间斜率描述个体差异,并允许两者相关,采用非中心化参数化;之后依次做先验预测、抽样和后验预测。
陈晨差点直接复制代码就跑
看到完整的代码块,最自然的反应就是整段复制。陈晨也正打算这么做,但答案紧接着写了一条注意:上面的模型需要在 coords 中补上随机效应维度,并给出了要加的那一行,建议在建模时就放进去。
也就是说,64 行代码不能原样运行,得先补上这一行。好在答案自己指出了这一点。答案最下方的第一条建议,正是"把上面的 PyMC 示例修正为可直接运行的完整代码"。
检查步骤单独列了出来
接下来是"检查模型"部分,附了 13 行代码:参数汇总表、MCMC 轨迹与联合后验图、后验预测图。
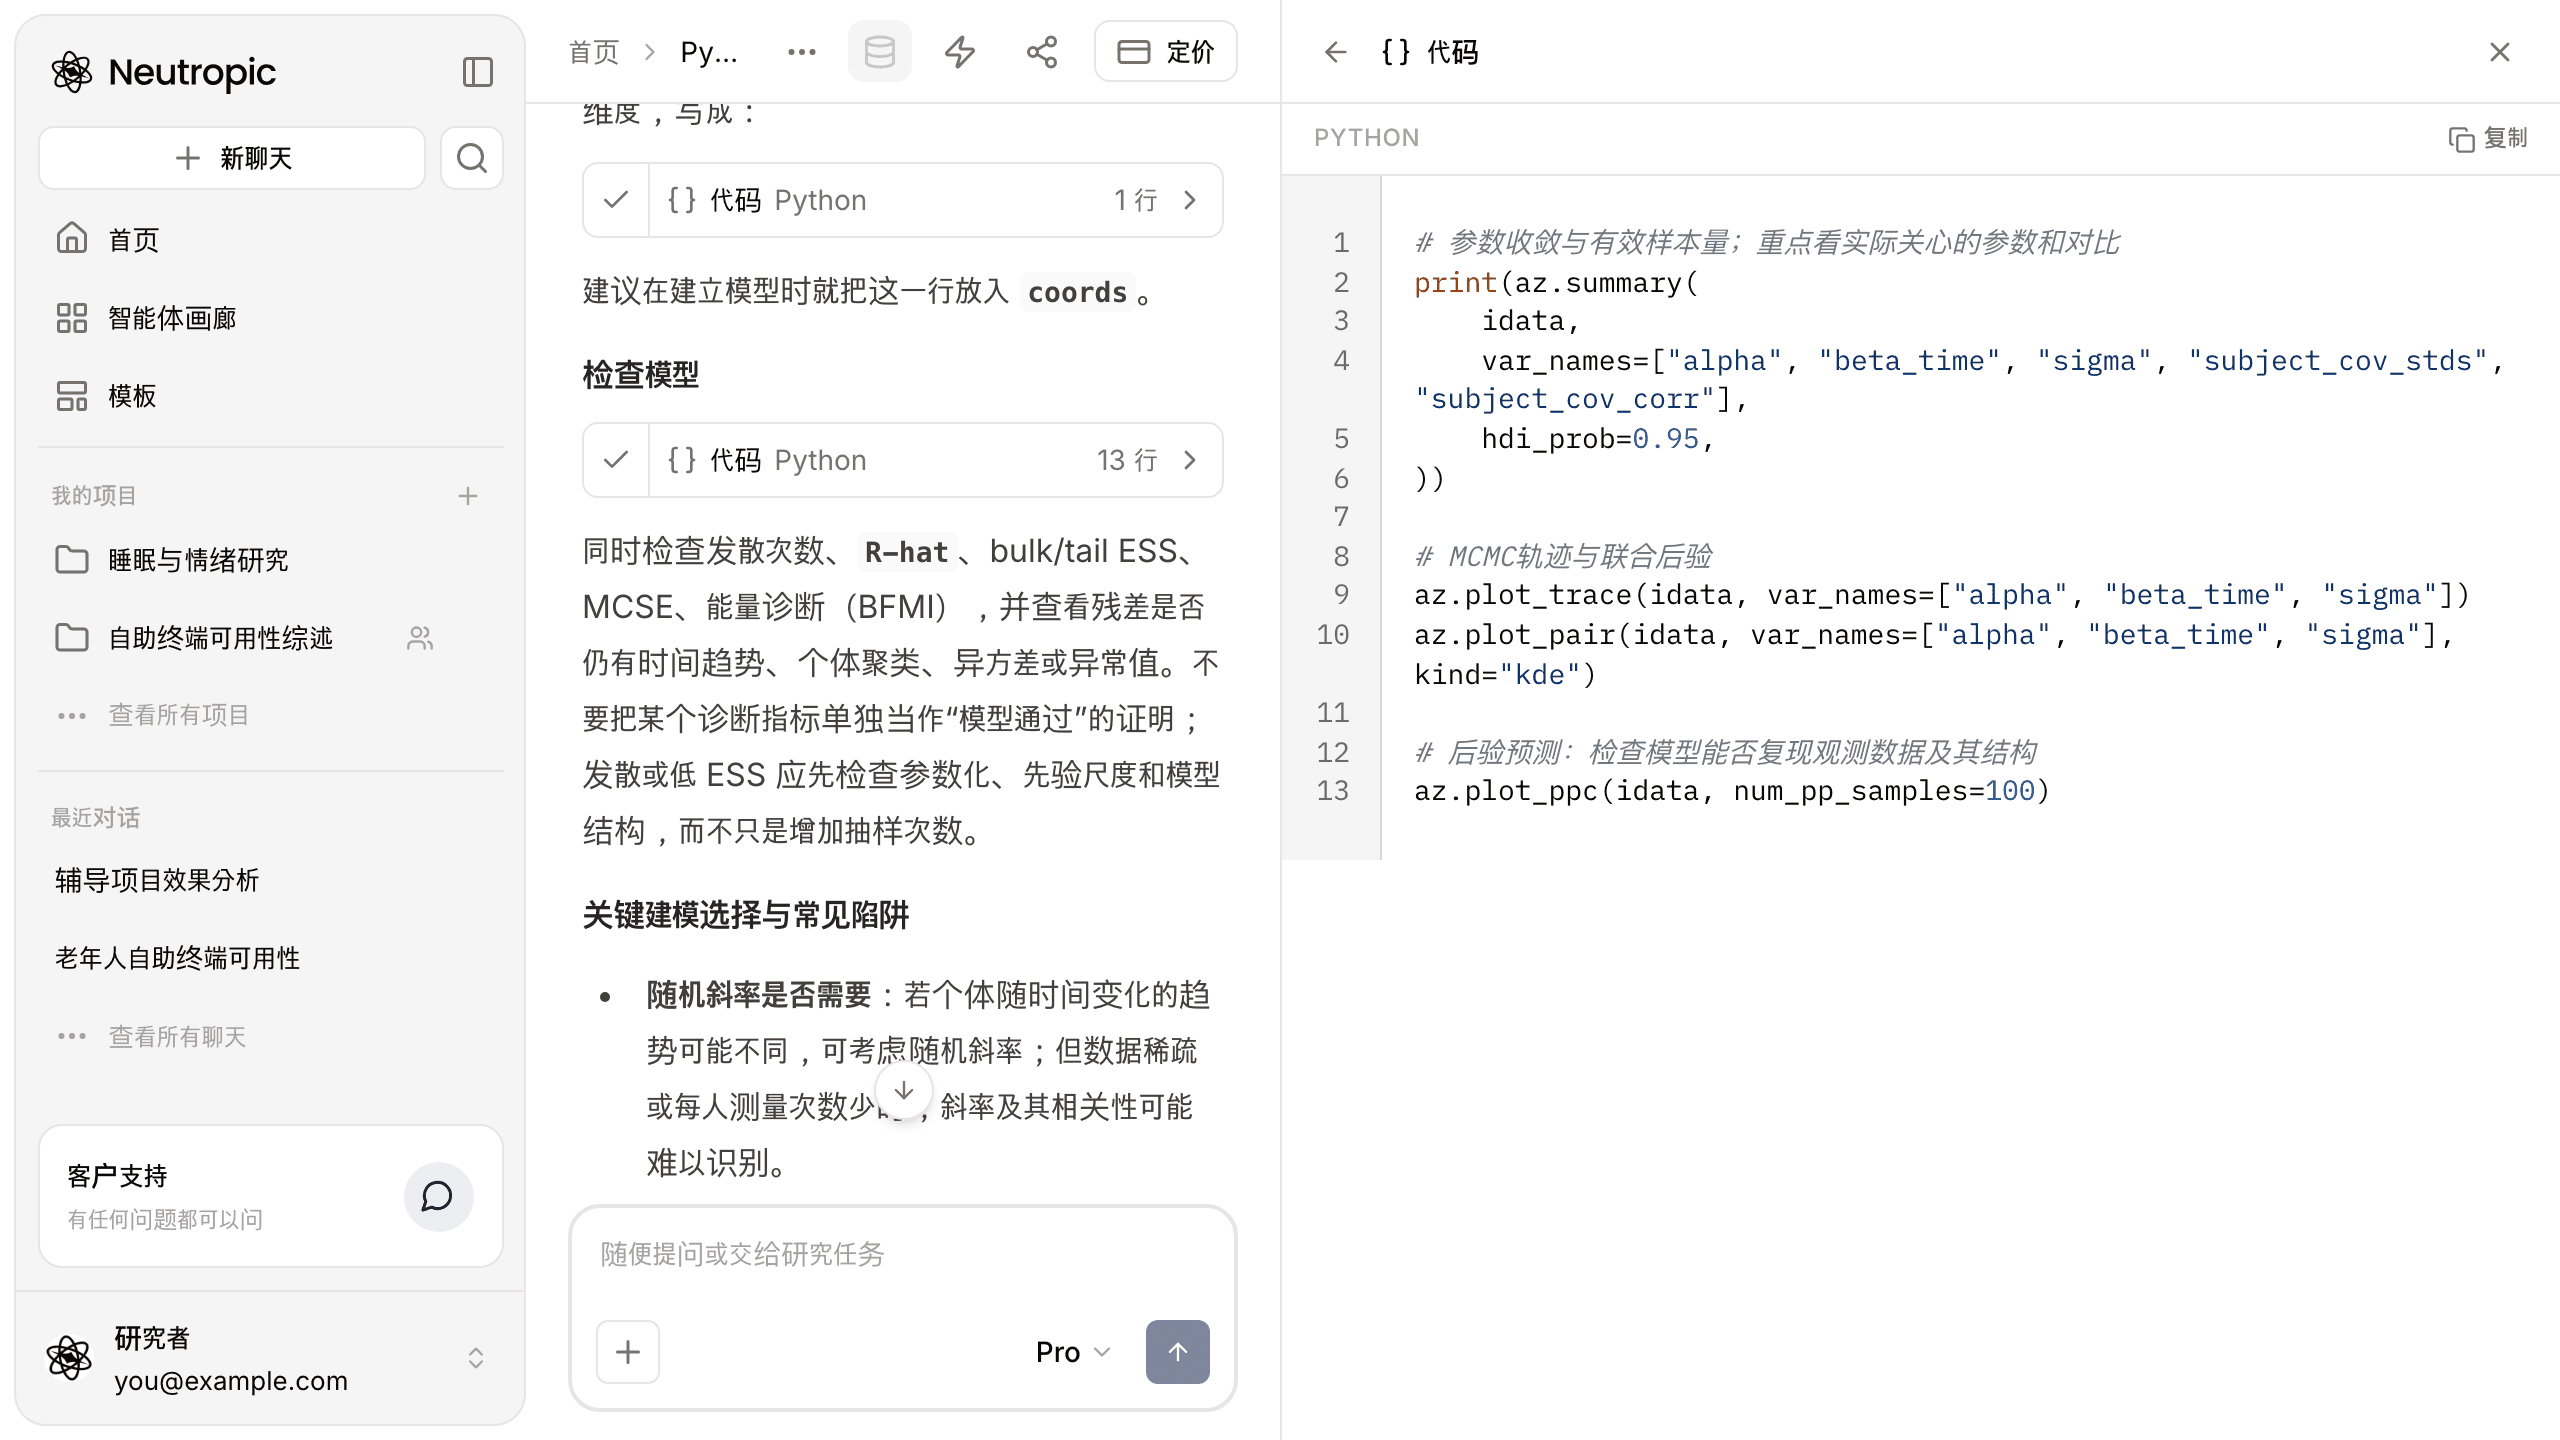
代码下面还写明:同时检查发散次数、R-hat、bulk/tail ESS、MCSE 和能量诊断(BFMI),并查看残差是否仍有时间趋势、个体聚类、异方差或异常值。不要把某个诊断指标单独当作"模型通过"的证明;出现发散或 ESS 偏低时,应先检查参数化、先验尺度和模型结构,而不只是增加抽样次数。
常见陷阱也一并列出
"关键建模选择与常见陷阱"一节列了六条:
- 随机斜率是否需要:每人测量次数少时,斜率及其相关性可能难以识别
- 时间结构:随机截距/斜率不等同于自相关误差
- 结果类型:二分类、计数或偏态结果要选相应的似然
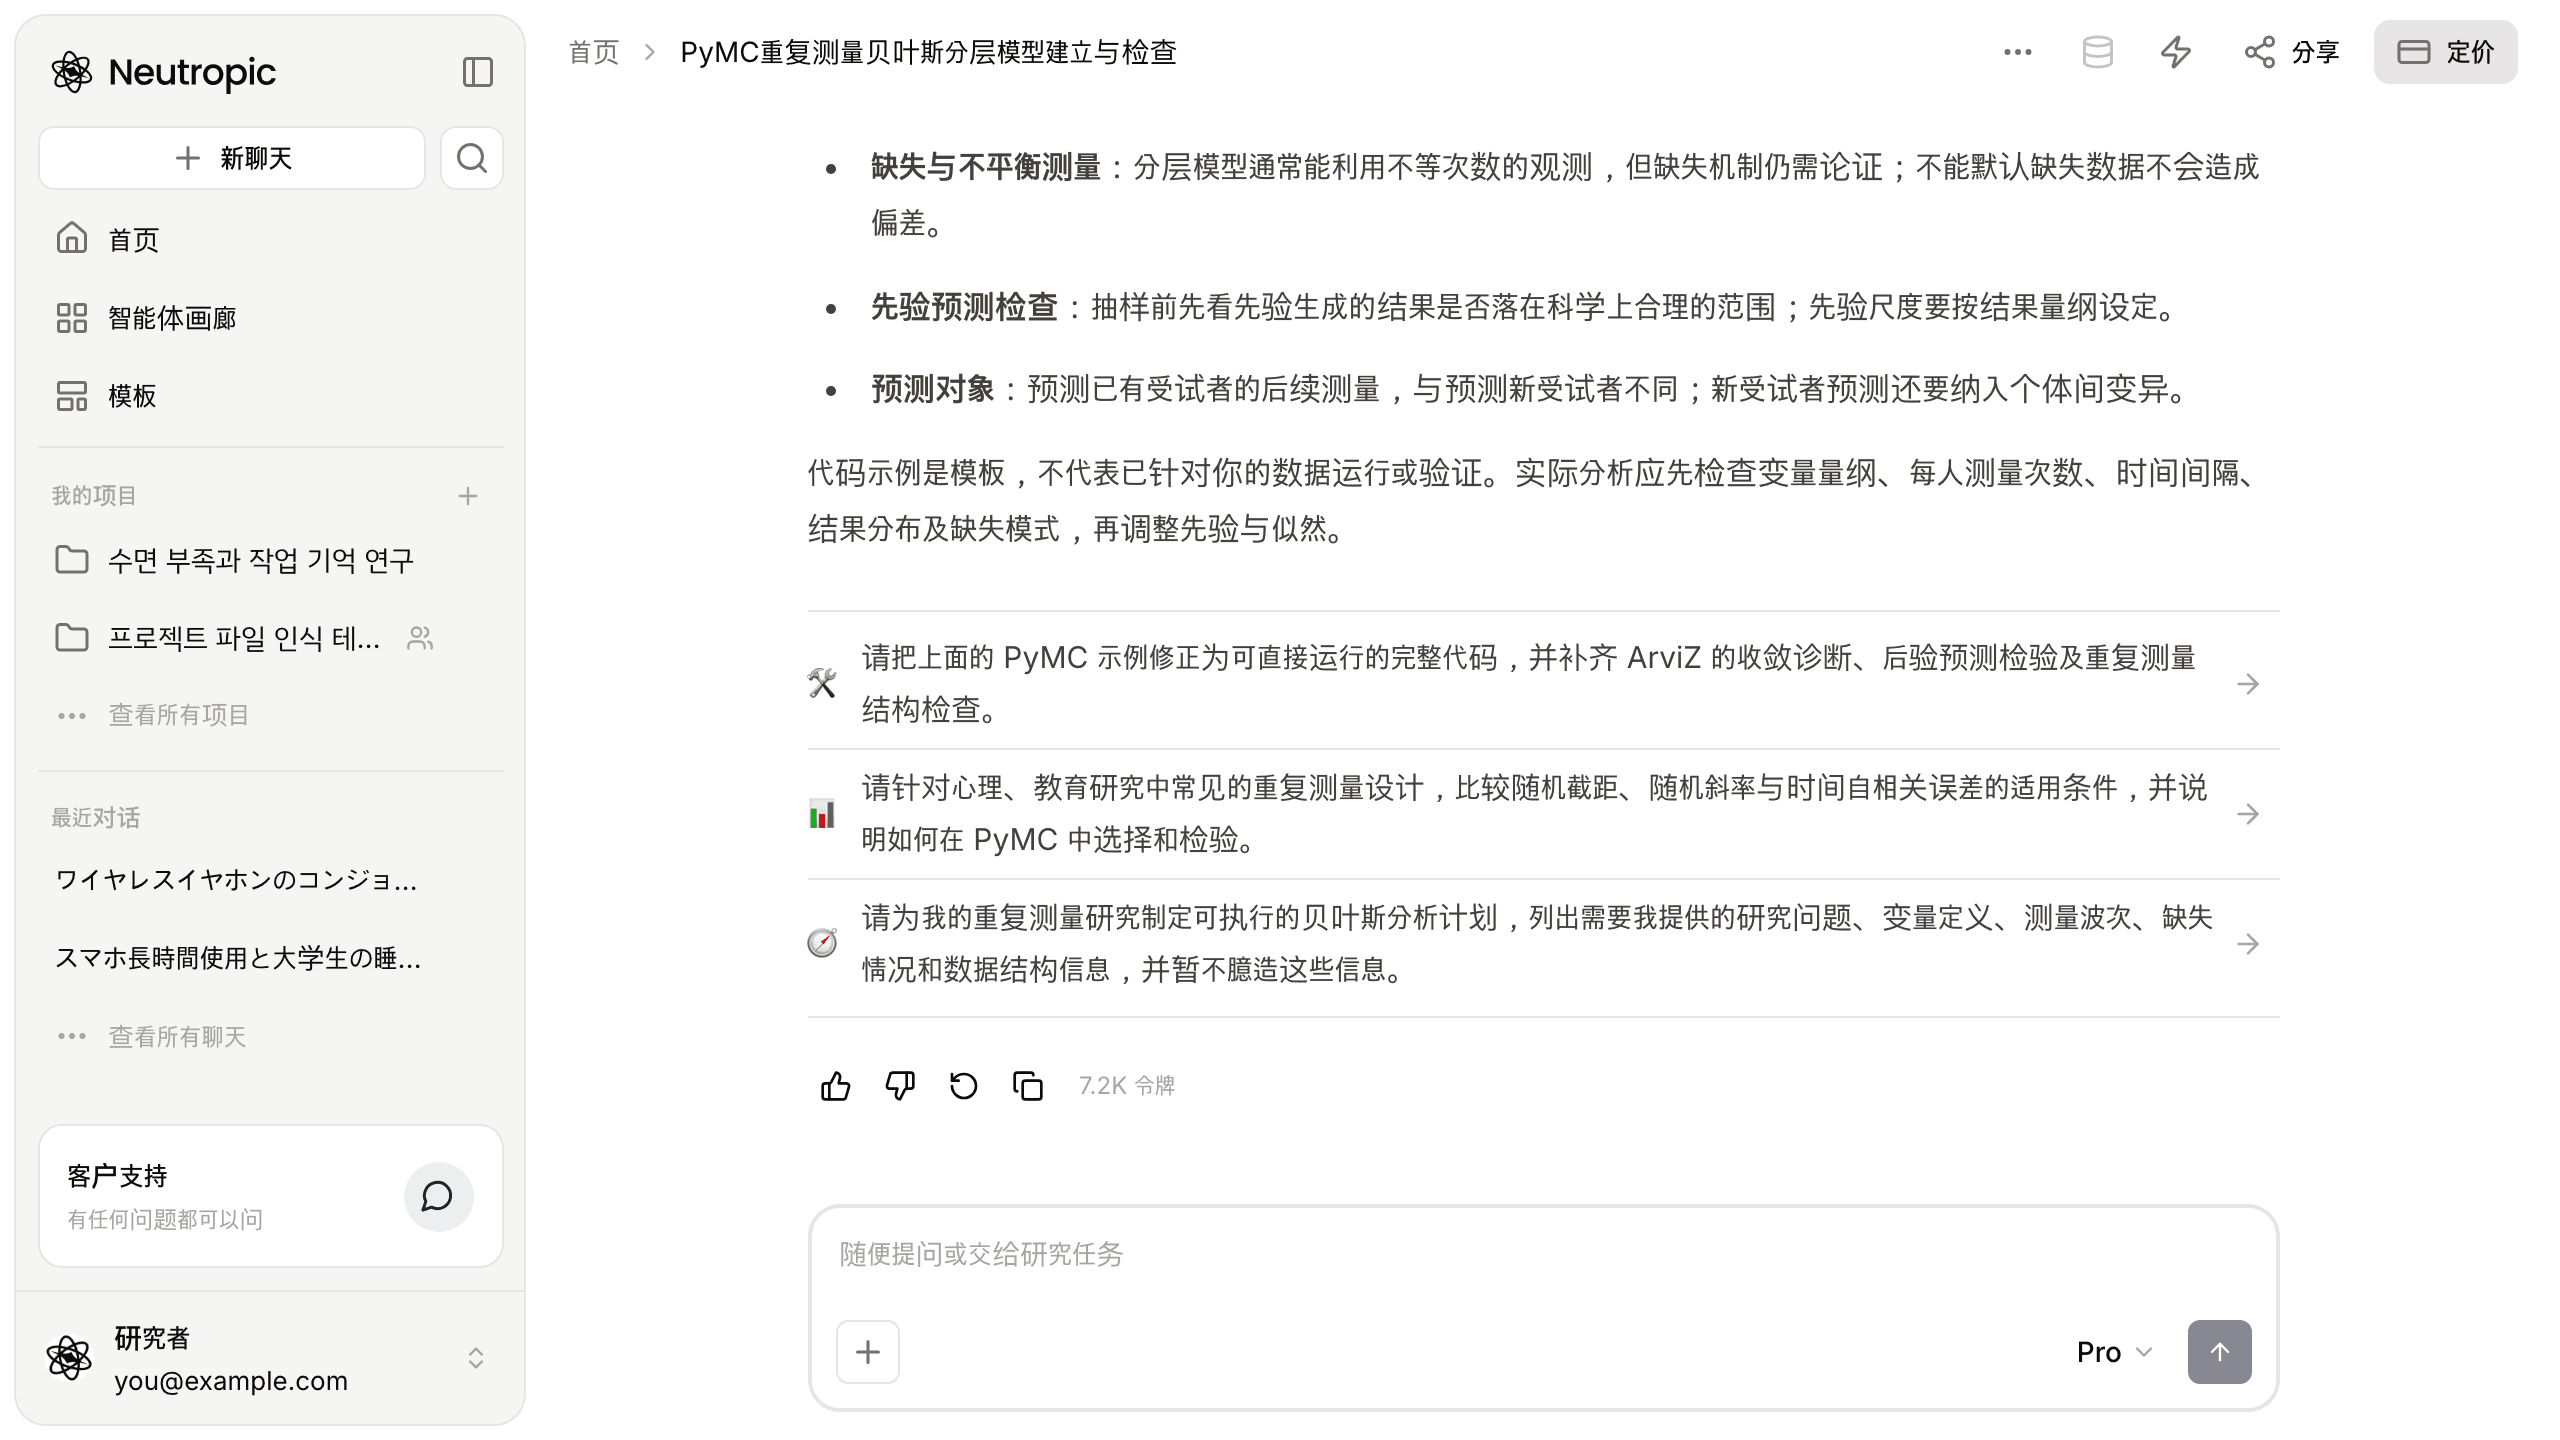
- 缺失与不平衡测量:缺失机制仍需论证
- 先验预测检查:先验尺度要按结果量纲设定
- 预测对象:预测已有受试者的后续测量,与预测新受试者不同
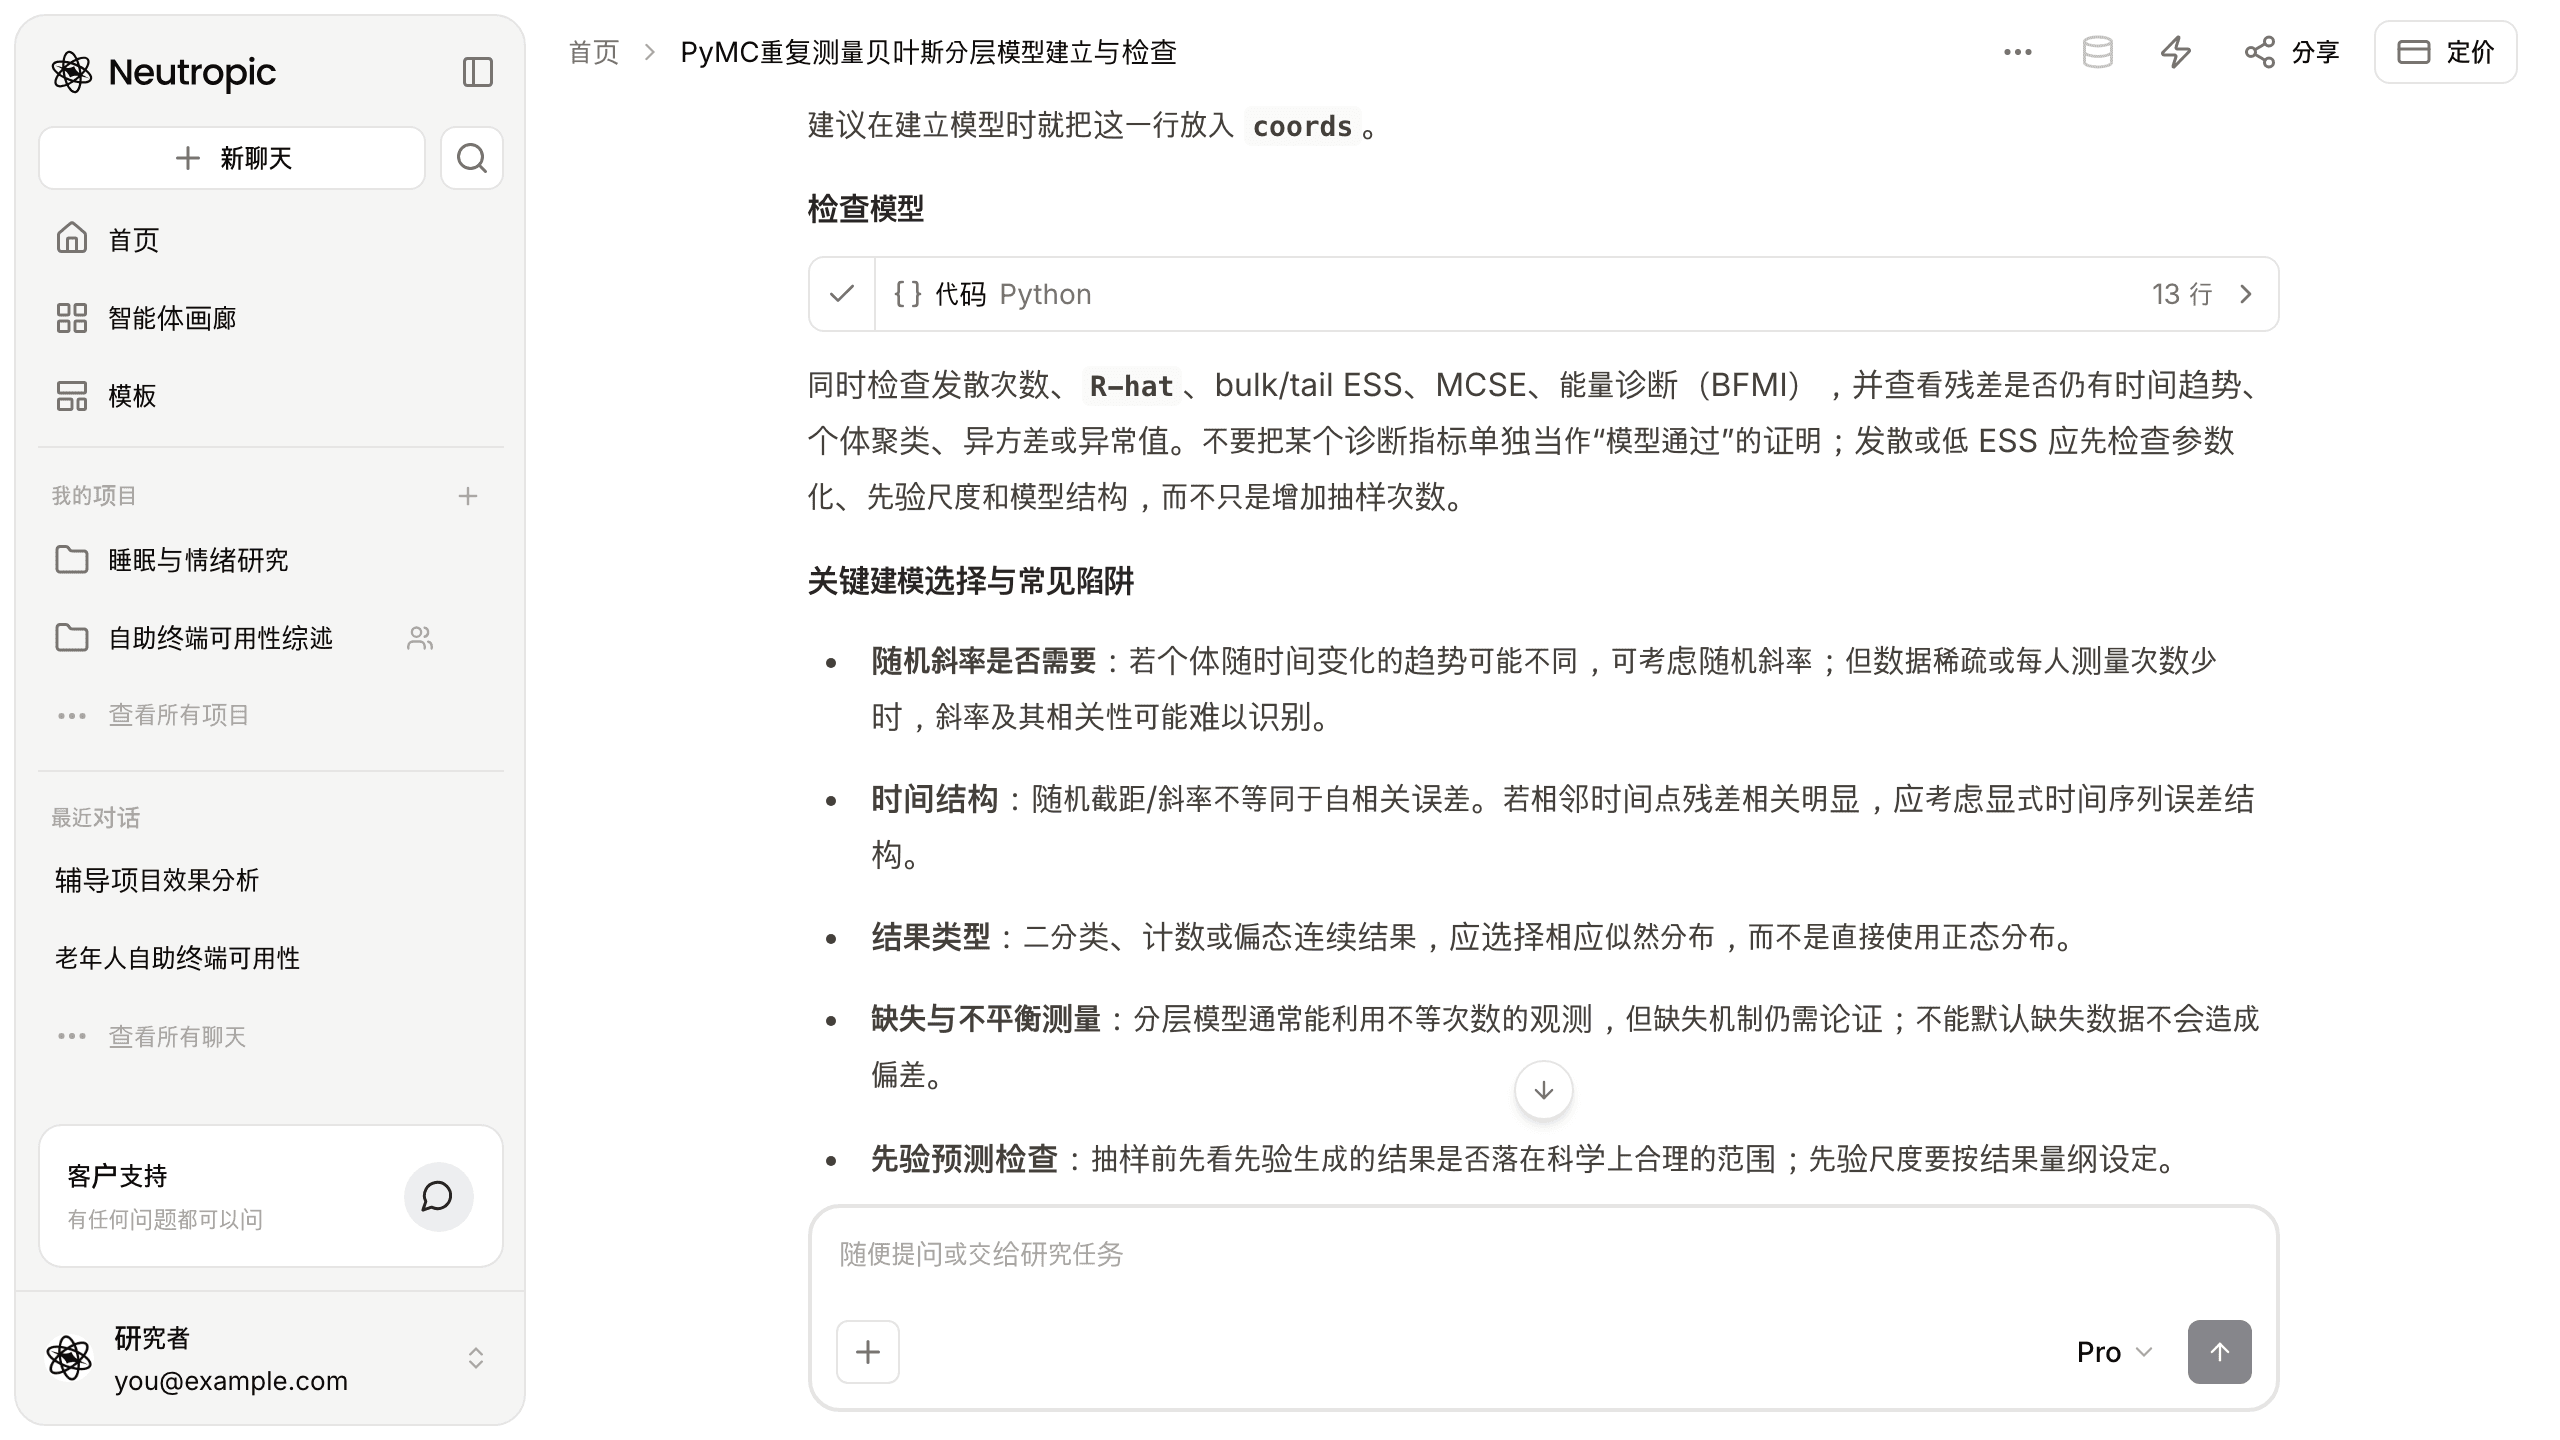
最后一句很明确:代码示例是模板,不代表已针对你的数据运行或验证。这次对话没有在服务器上运行 PyMC,陈晨需要在自己的电脑上安装 PyMC 后再运行。
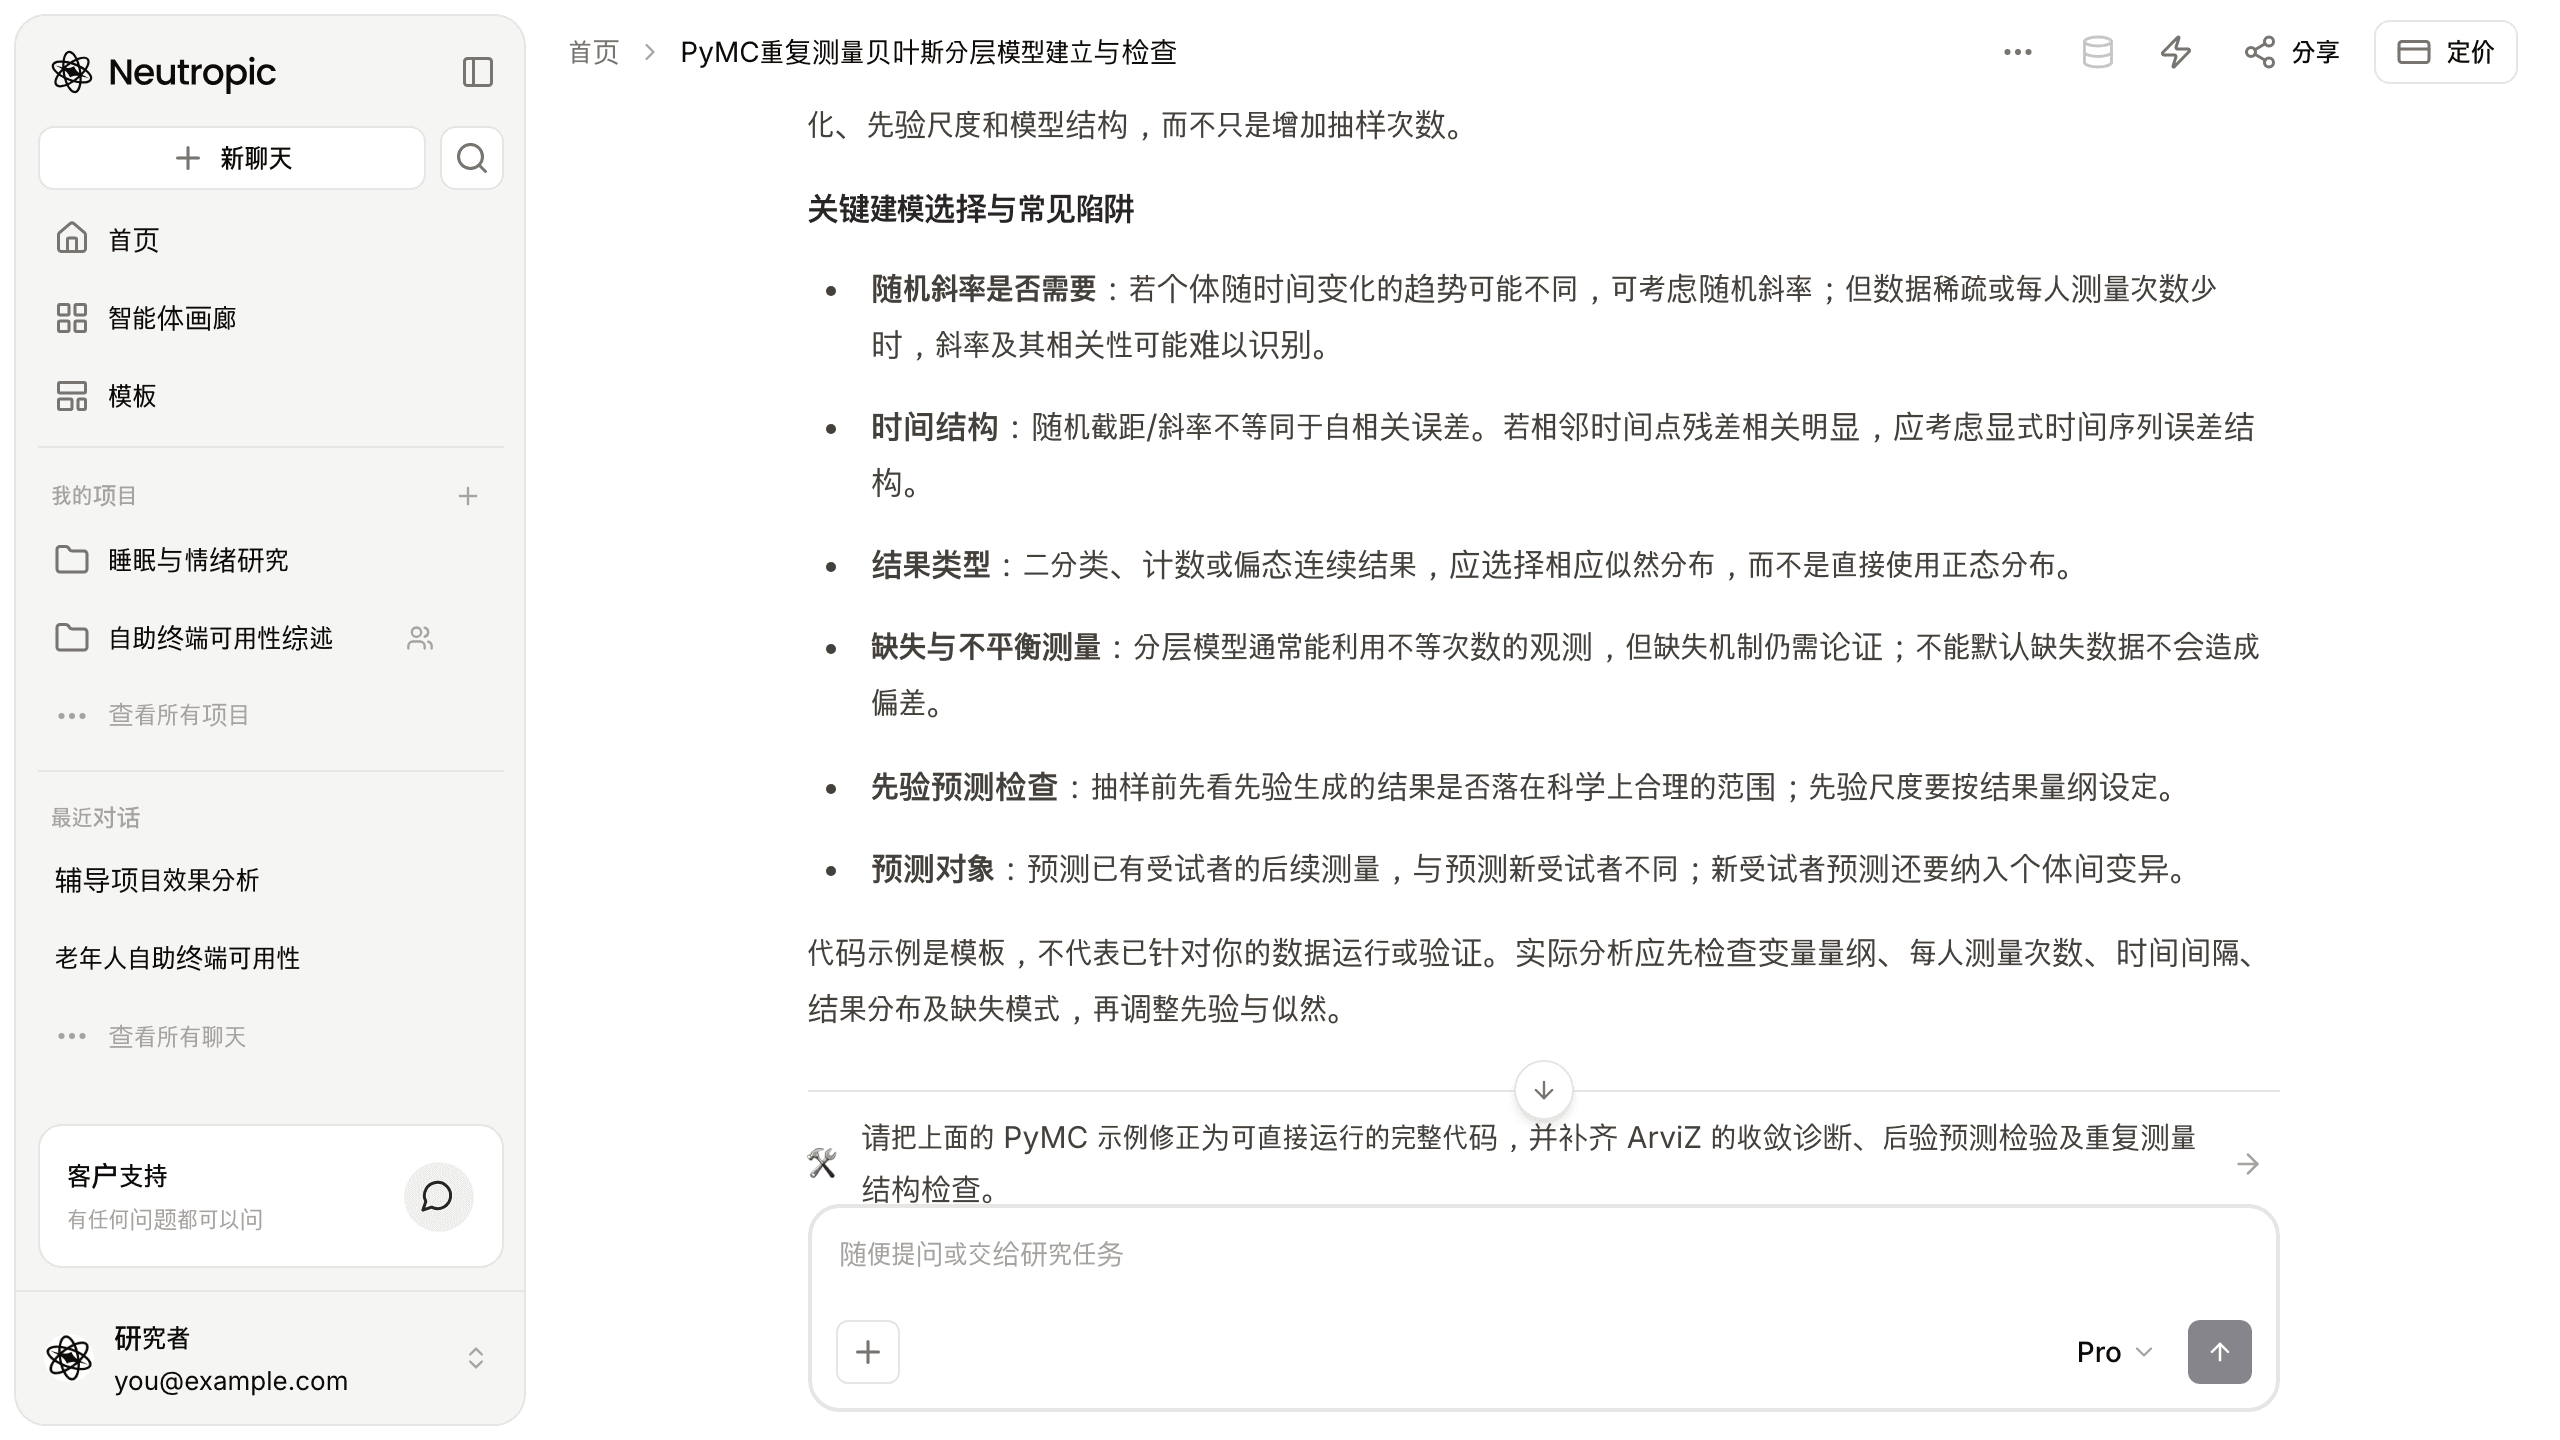
连下一步都给出了建议
答案最下面有三条建议:
- 把上面的 PyMC 示例修正为可直接运行的完整代码,并补齐 ArviZ 的收敛诊断、后验预测检验及重复测量结构检查
- 针对心理、教育研究中常见的重复测量设计,比较随机截距、随机斜率与时间自相关误差的适用条件
- 为我的重复测量研究制定可执行的贝叶斯分析计划,列出需要我提供的信息,并暂不臆造这些信息
点一下,就在同一个对话里接着做。陈晨大概会先点第一个。
模糊的"用 PyMC 试试",变成了带检查清单的代码
| 开始时 | 现在 | |
|---|---|---|
| 模型 | 只听过"分层模型"这个词 | 随机截距 + 随机斜率(允许相关) |
| 代码 | 到处翻示例笔记本 | 64 行模型代码,外加需补上的 1 行 |
| 检查 | 只知道 R-hat | 13 行检查代码与诊断清单 |
| 陷阱 | 不知道该注意什么 | 斜率识别、自相关、似然、缺失、预测对象 |
| 下一步 | 无从下手 | 三条可以直接点的建议 |
坦白说,这不是在服务器上抽样得到的结果。代码要先补上 coords 那一行,再在自己的电脑上运行;先验尺度也要按自己数据的量纲调整。但带着检查清单出发,和从一个空白笔记本出发,完全不一样。
本文使用 Pro 运行。Lite(免费方案)给出简要模型结构和关键诊断;Expert 还会讨论先验敏感性和模型比较。
面对重复测量数据无从下手时,一句提问就能先拿到模型和检查步骤。 😎
这周就像陈晨一样,把"建立并检查"都写进问题里问一问吧。免费开始使用 Neutropic