안녕하세요, 뉴트로픽 팀입니다!
세 집단을 비교하는 분석, 대학원에서 한 번쯤은 해 보셨을 거예요. 통계 수업에서 배운 순서는 대개 이렇죠. Levene 검정을 먼저 하고, 등분산이면 일반 분산분석, 아니면 다른 검정. 그런데 막상 해 보면 Levene 검정의 p값이 0.04인지 0.06인지에 따라 논문의 분석 방법이 통째로 바뀝니다. 그게 정말 맞는 걸까요? 🥲
방법론 연구들은 이 2단계 절차가 오류율을 왜곡한다고 지적해요. 집단 크기와 분산이 다르면 일반 F 검정은 강건하지 않고, 그래서 처음부터 Welch 분산분석을 기본으로 쓰자는 권고가 나와 있습니다(Delacre et al., 2019). 문제는 그걸 알아도 실제로 돌리고, 사후 비교와 효과 크기를 붙이고, 보고서로 정리하는 데 하루가 간다는 거죠.
이 글에서는 교육학 석사과정 하은 씨가 세 가지 수업 방식의 효과를 비교하는 과정을 따라가 봅니다. 하은 씨는 가상의 인물이지만, 아래 화면은 모두 뉴트로픽에서 실제로 실행한 결과예요.
데이터 구조까지 한 문장에 적었습니다
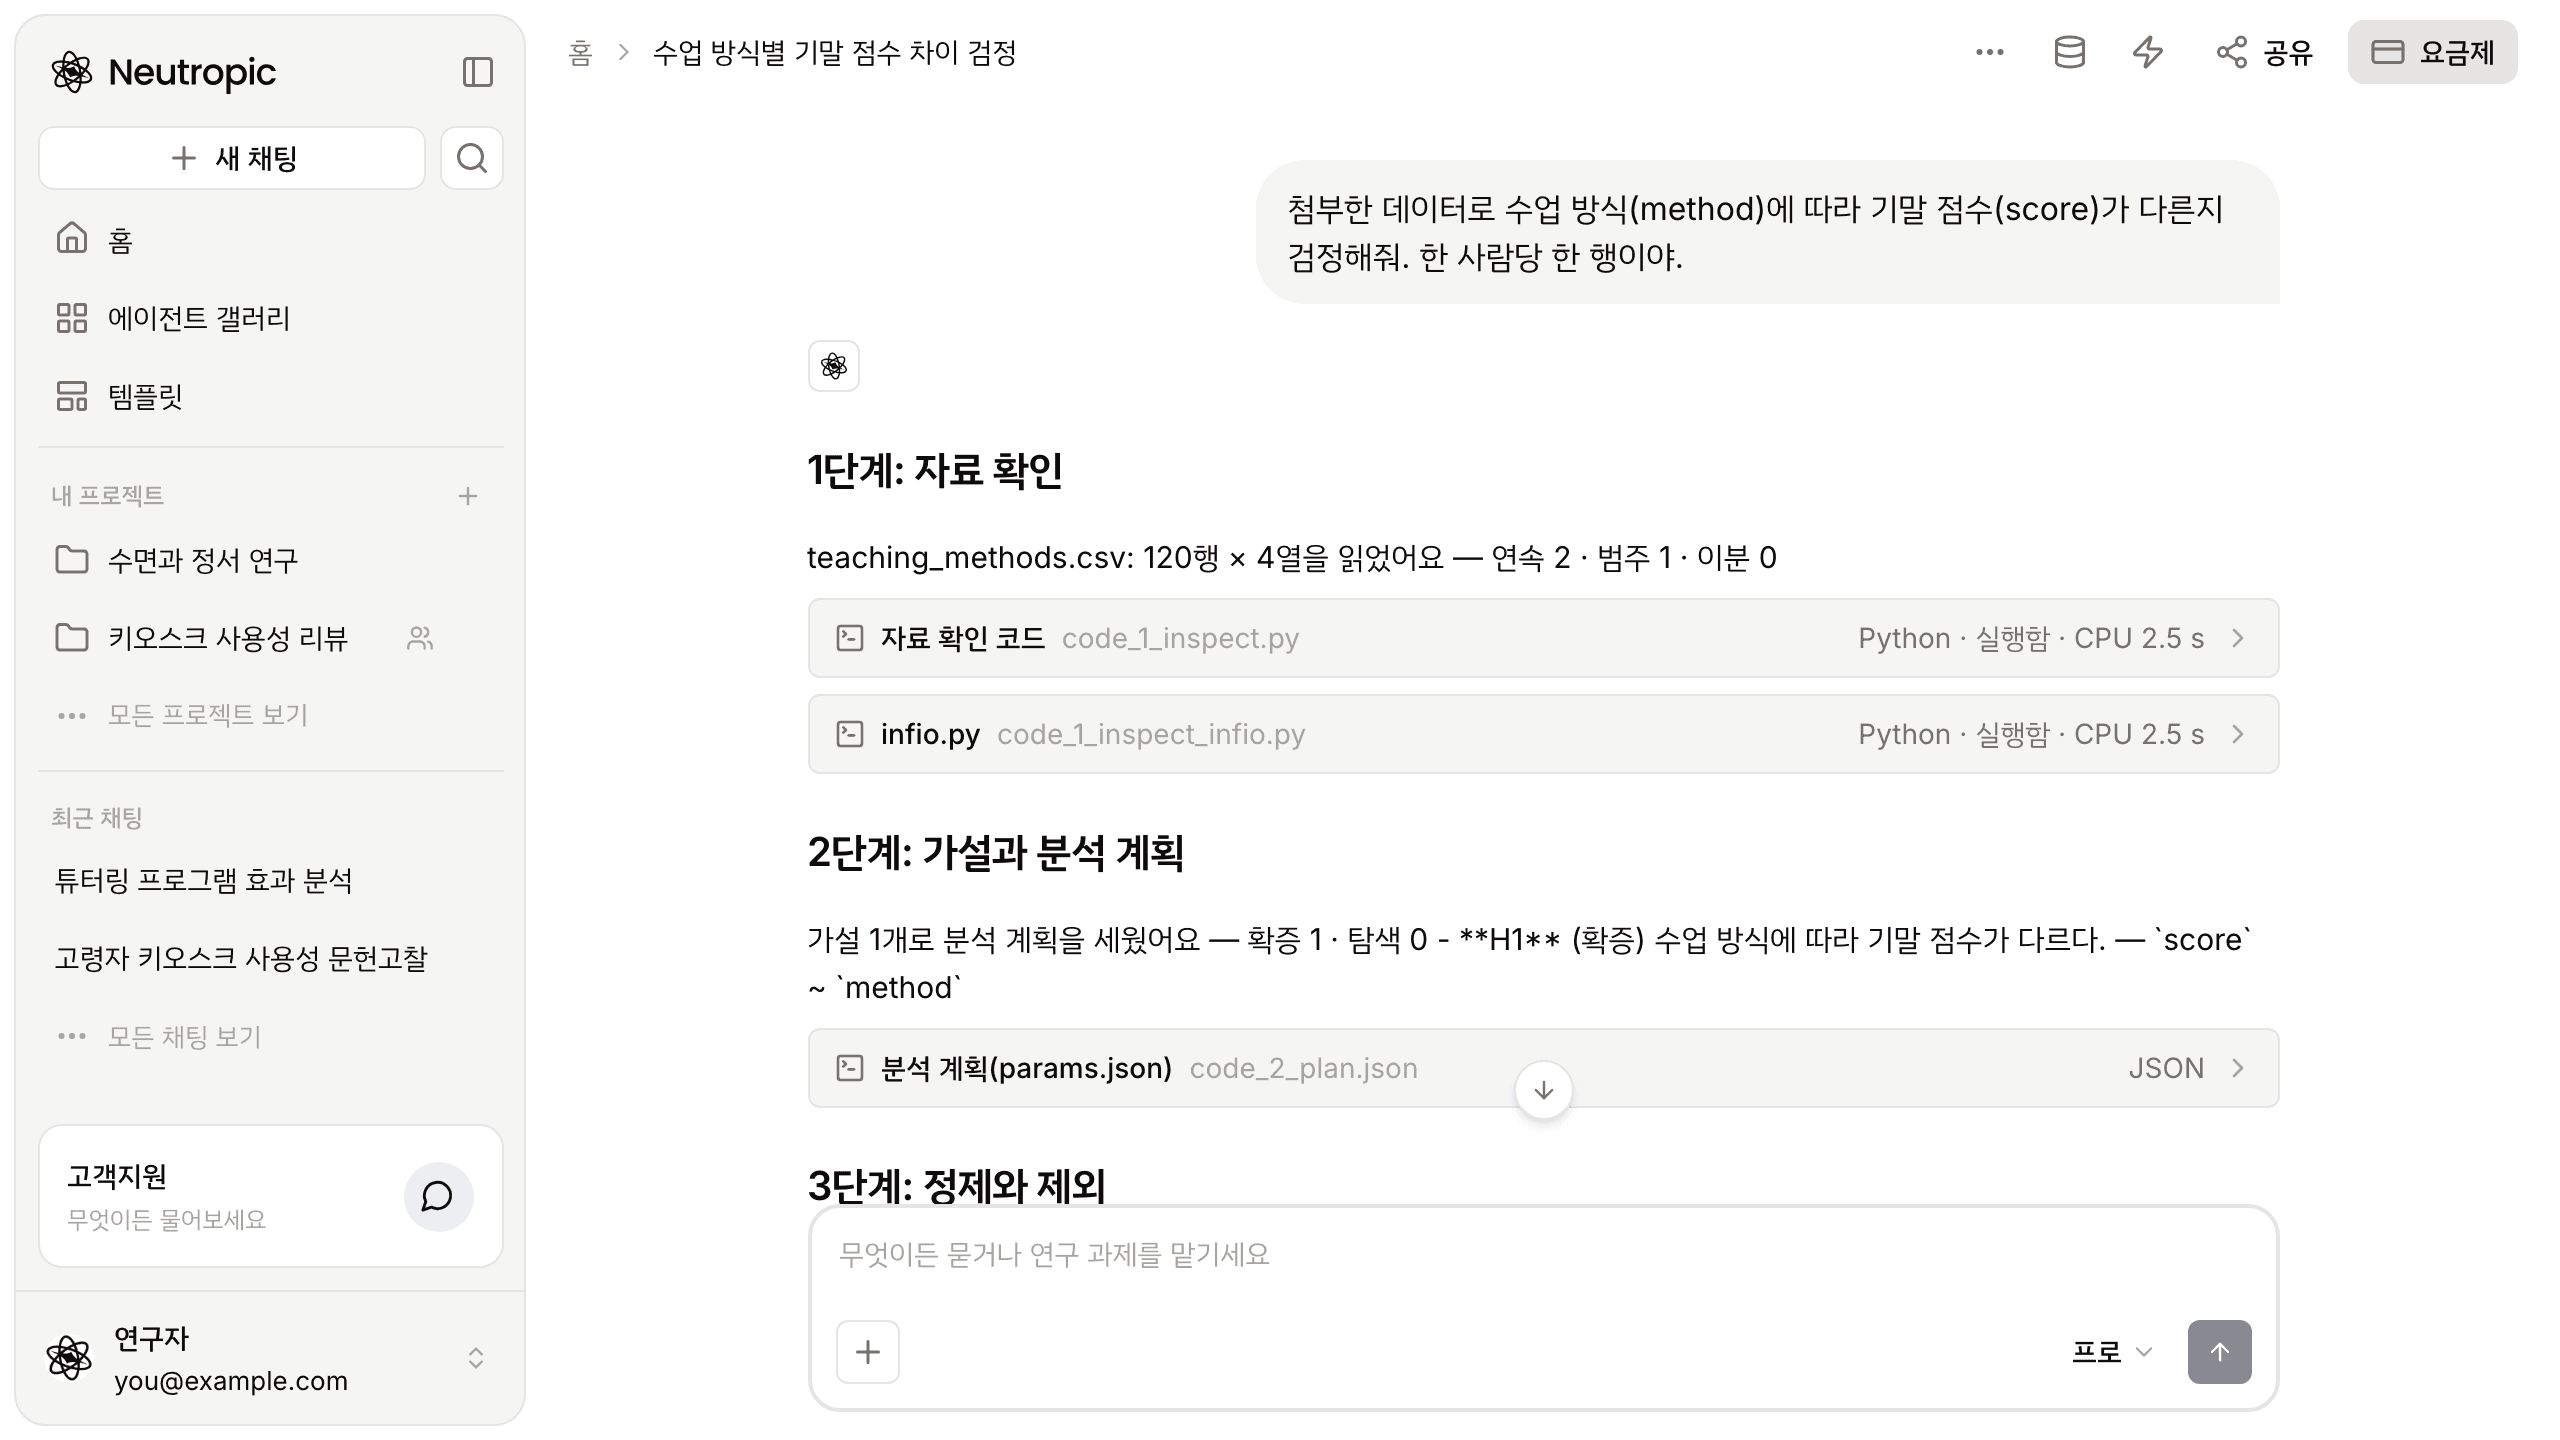
하은 씨의 파일은 teaching_methods.csv였어요. 학생 120명의 수업 방식(lecture·discussion·project), 기말 점수, 나이가 한 사람당 한 행으로 들어 있습니다. 에이전트 갤러리에서 추론통계 에이전트를 고르고, 파일을 첨부한 뒤 이렇게 적었어요.
첨부한 데이터로 수업 방식(method)에 따라 기말 점수(score)가 다른지 검정해줘. 한 사람당 한 행이야.
좋은 요청인 이유는 마지막 문장에 있어요. "한 사람당 한 행"이라고 밝혀 두면 반복측정이 아니라 독립된 집단 비교라는 게 분명해집니다. 열 이름을 괄호로 적어 둔 것도 도움이 됐어요. 무엇이 결과 변수이고 무엇이 집단인지 헷갈릴 일이 없으니까요.
가설부터 적고 시작했습니다
에이전트는 정해진 여덟 단계를 차례로 돌았어요. 자료 확인에서 120행 × 4열을 읽고, 가설과 분석 계획에서 확증 가설 하나를 세웠습니다. "H1 수업 방식에 따라 기말 점수가 다르다 — score ~ method". 정제와 제외에서는 제외 규칙 없이 120행이 그대로 남았어요.
분석 전에 가설을 먼저 적어 두는 건 사소해 보여도 중요해요. 나중에 결과를 보고 가설을 바꾸는 일을 막아 주거든요.
분산이 달랐지만, 그게 검정을 고르지는 않았습니다
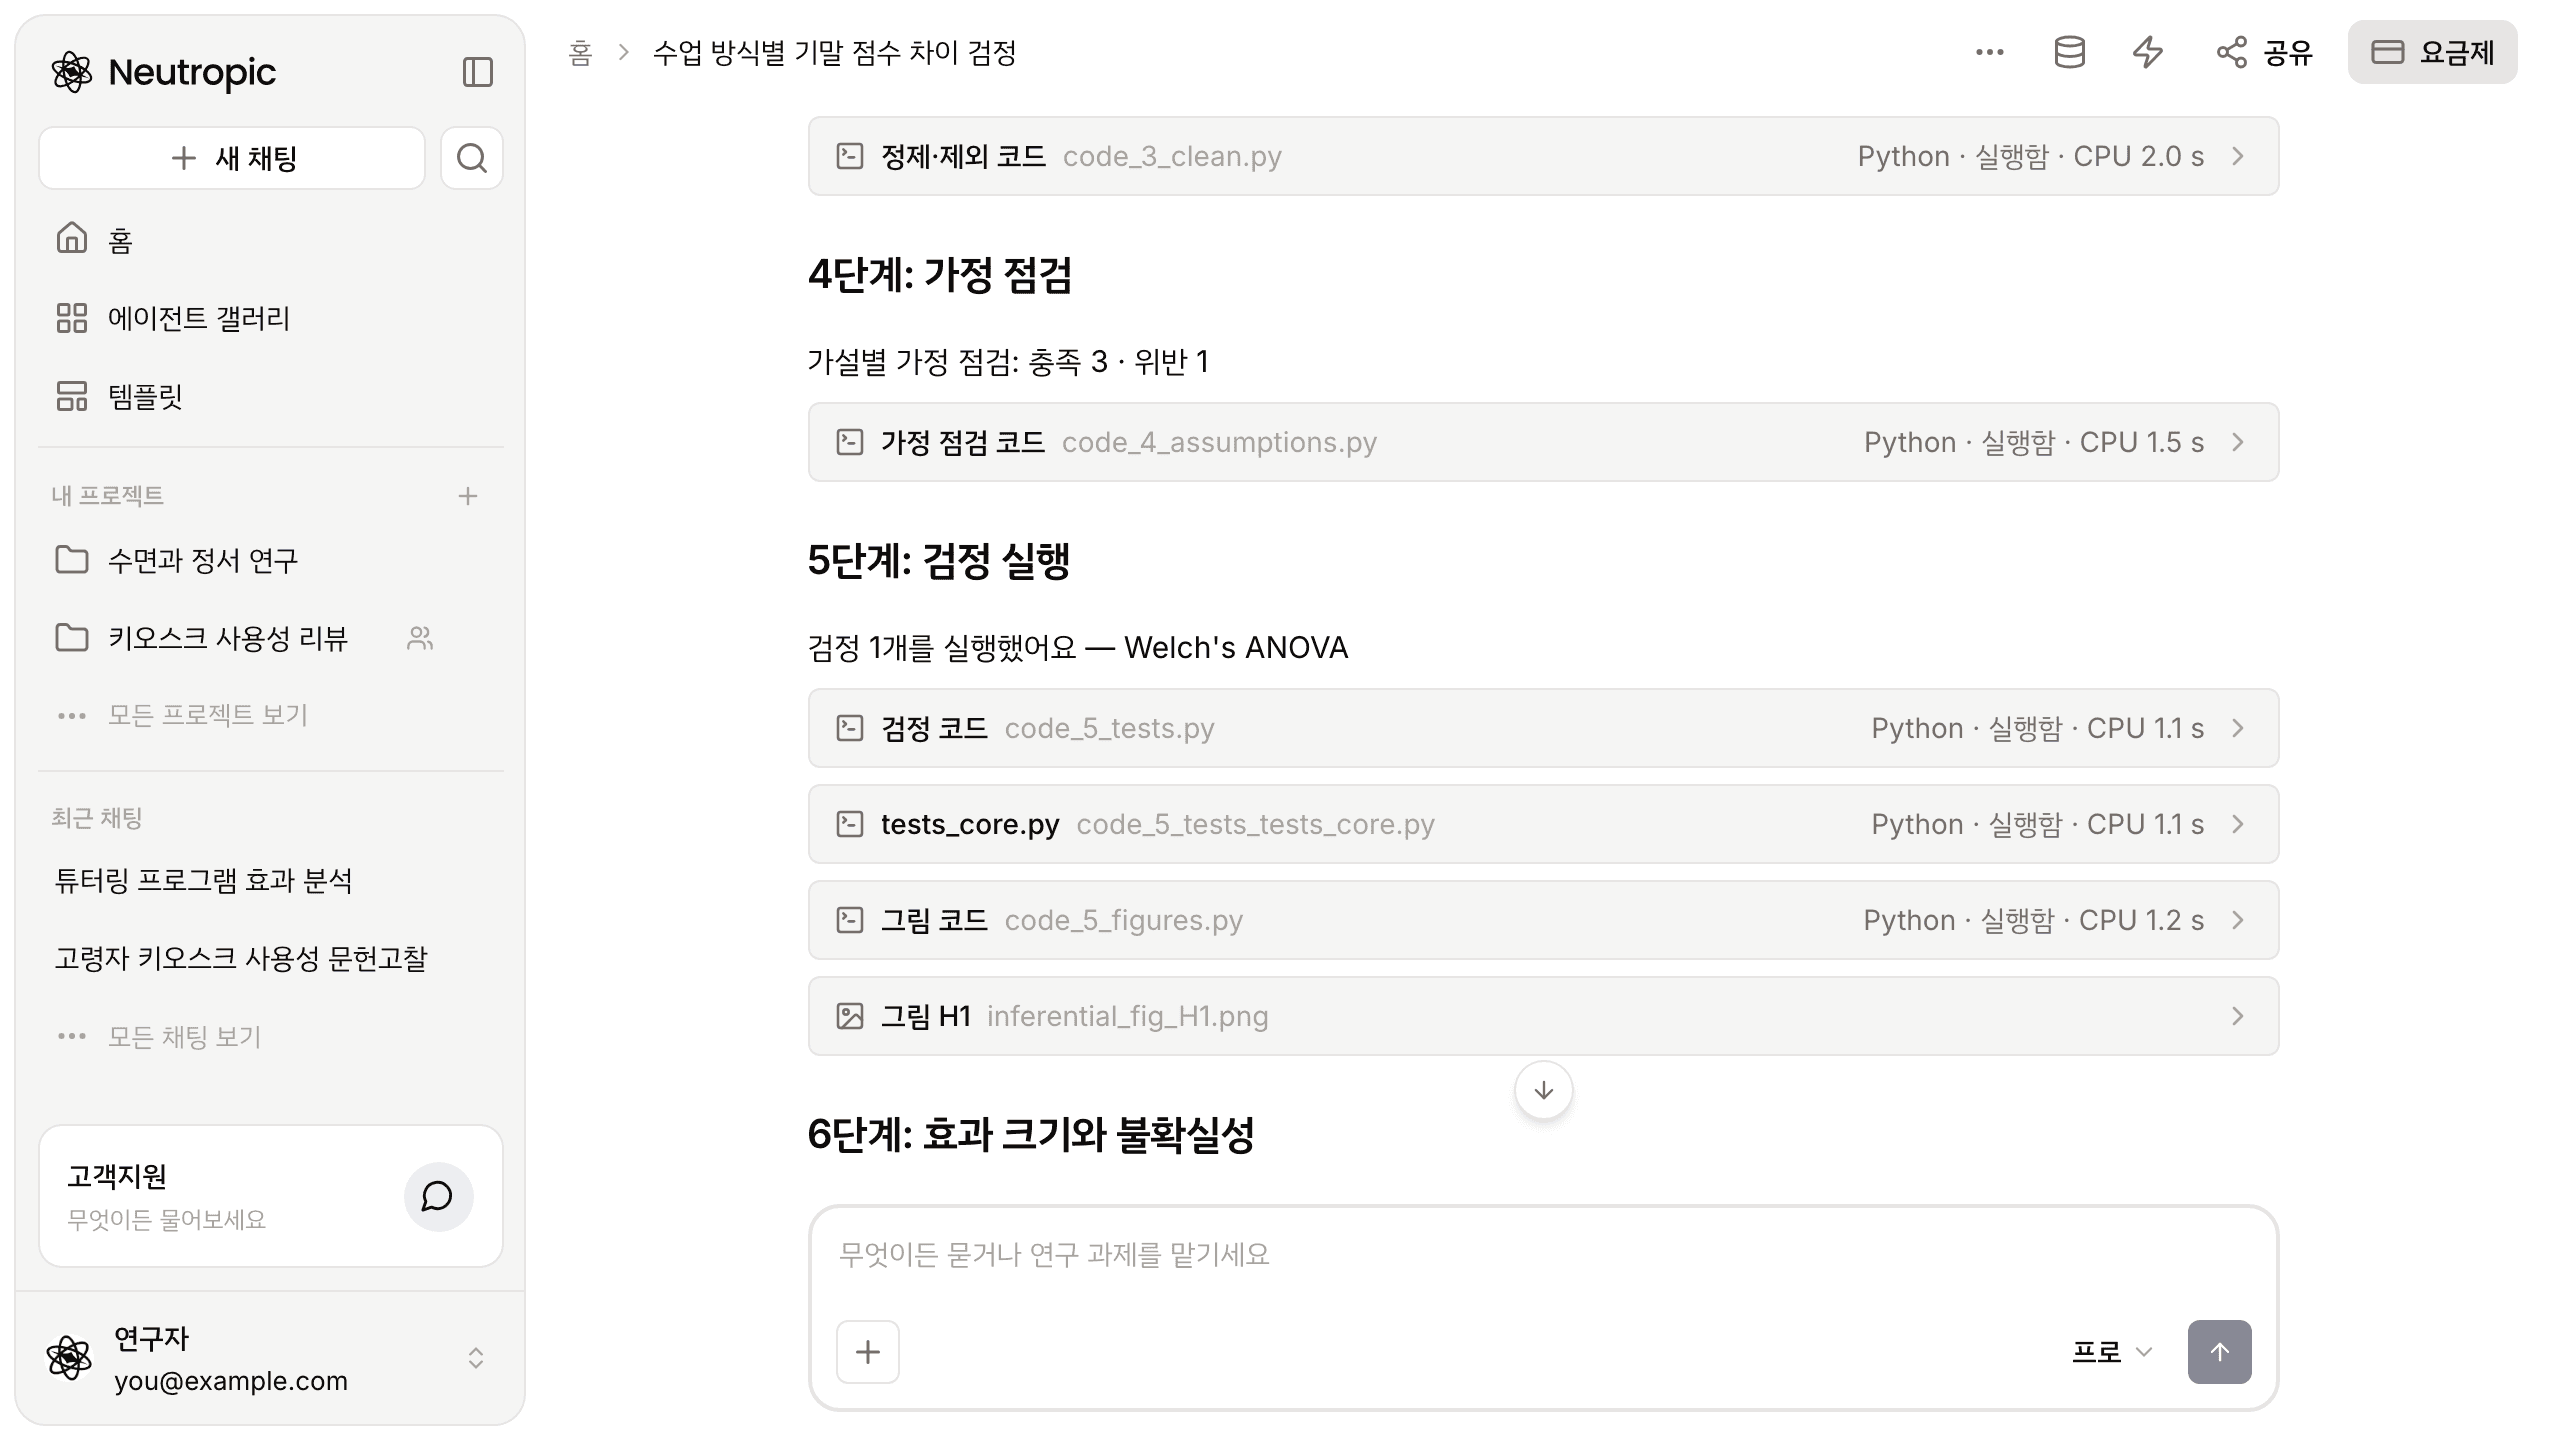
네 번째 단계 가정 점검의 결과는 "충족 3 · 위반 1"이었어요. 저희가 파일을 열어 보니 집단별 표준편차가 lecture 5.5, discussion 8.0, project 11.5로 두 배 넘게 차이가 났습니다. 분산이 같다는 가정이 깨진 거죠.
예전 방식이라면 여기서 검정을 바꿨을 거예요. 하지만 에이전트는 점검 결과를 보고만 하고, 다섯 번째 단계 검정 실행에서 처음부터 정해 둔 Welch 분산분석을 돌렸습니다. 분산이 같든 다르든 같은 검정을 쓰니, Levene 검정의 p값에 분석 방법이 흔들리지 않아요.
수업 방식에 따라 점수가 달랐습니다
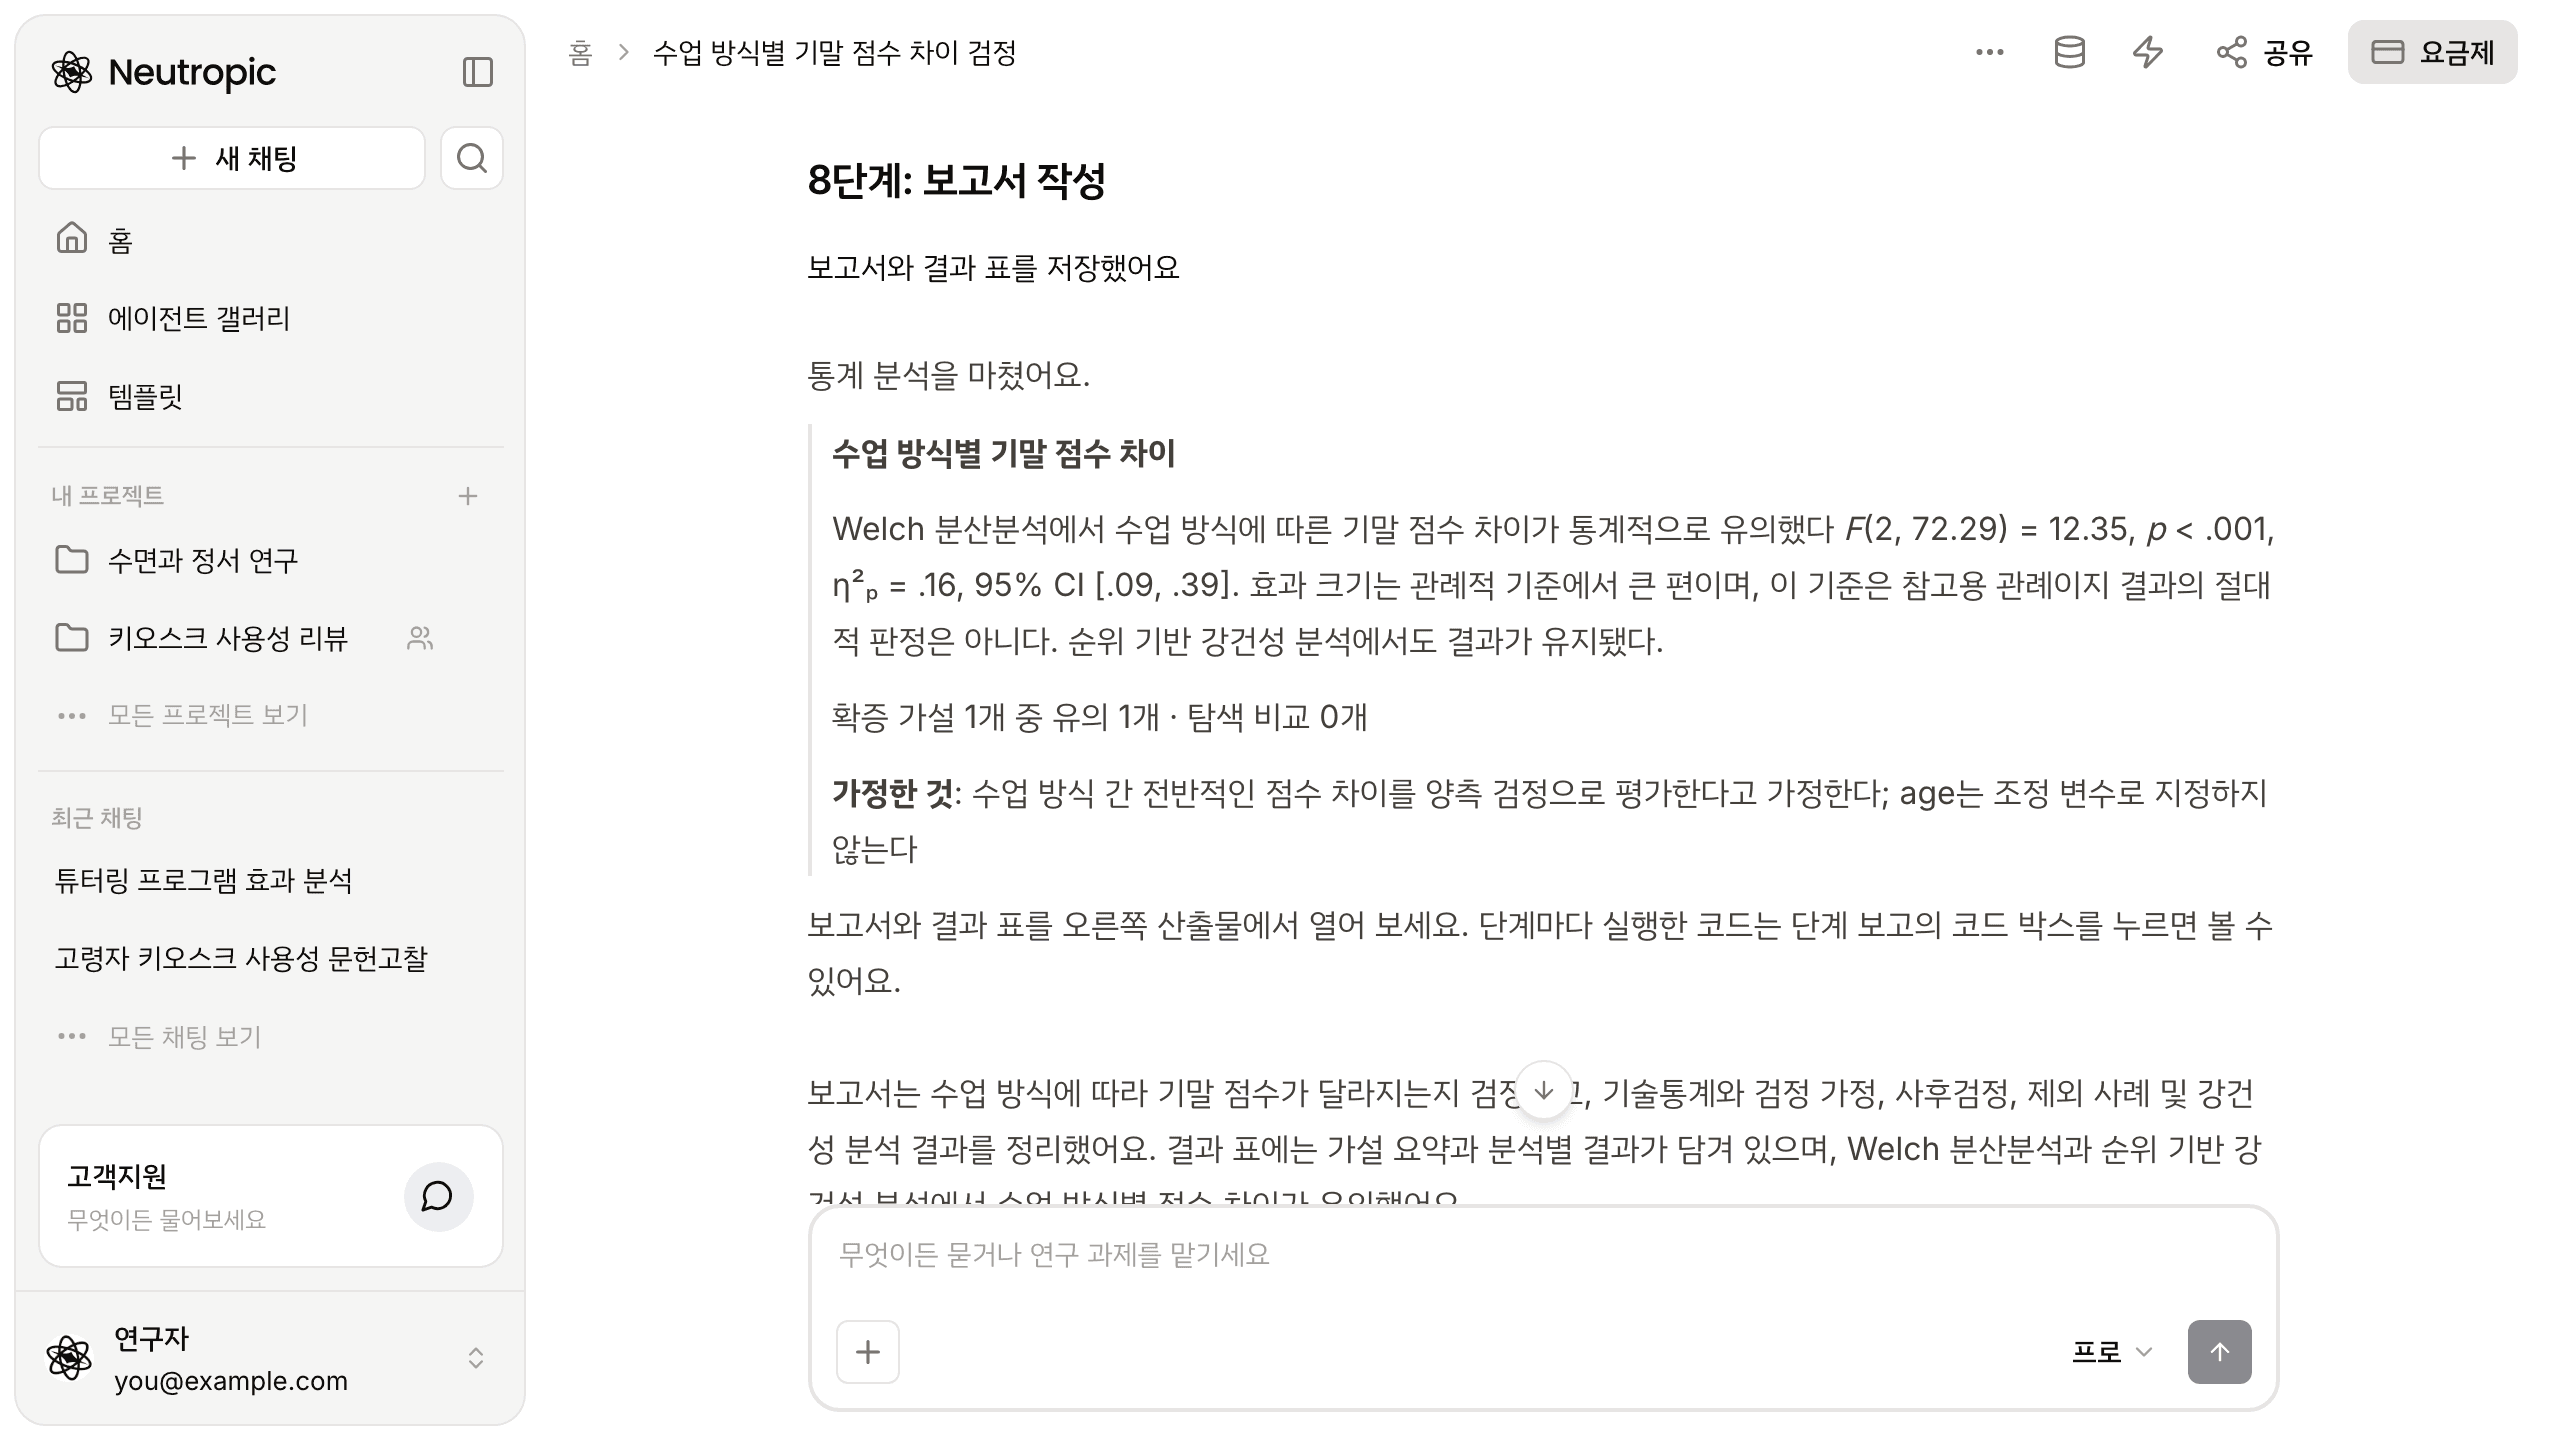
결과는 이렇게 나왔어요. *Welch F(2, 72.29) = 12.35, p* < .001, η²ₚ = .16*. 효과 크기와 불확실성* 단계에서 다중비교 보정 뒤에도 유의했고, 통계 일관성 점검에서 불일치는 없었어요. 강건성 점검에서는 순위 기반 대안 분석에서도 결론이 유지됐습니다.
저희도 같은 파일로 Welch 분산분석을 따로 돌려 봤는데, F값과 자유도가 똑같이 나왔어요. 😎 Games–Howell 사후 비교에서는 discussion과 project가 lecture보다 높았고, discussion과 project 사이에는 뚜렷한 차이가 없었습니다.
"효과가 크다"고 쓸 뻔했습니다
η²ₚ = .16을 보고 하은 씨는 "수업 방식의 효과가 크다"고 결론부터 쓰고 싶었어요. 그런데 답은 이렇게 덧붙였습니다. 효과 크기는 관례적 기준에서 큰 편이지만, 그 기준은 참고용 관례이지 결과의 절대적 판정은 아니라고요. 교육 현장에서 이 정도 점수 차가 의미 있는지는 따로 따져야 한다는 뜻이에요.
답에는 가정한 것도 적혀 있었어요. 수업 방식 간 전반적인 차이를 양측 검정으로 본다는 것, 그리고 age는 조정 변수로 지정하지 않는다는 것. 하은 씨가 나이를 통제하고 싶었다면, 이 줄을 보고 다시 요청하면 됩니다. 에이전트가 무엇을 임의로 정했는지 이렇게 드러나 있으면, 나중에 심사자의 질문에도 답하기 쉬워요.
보고서와 결과 표, 다음 단계까지 받았습니다
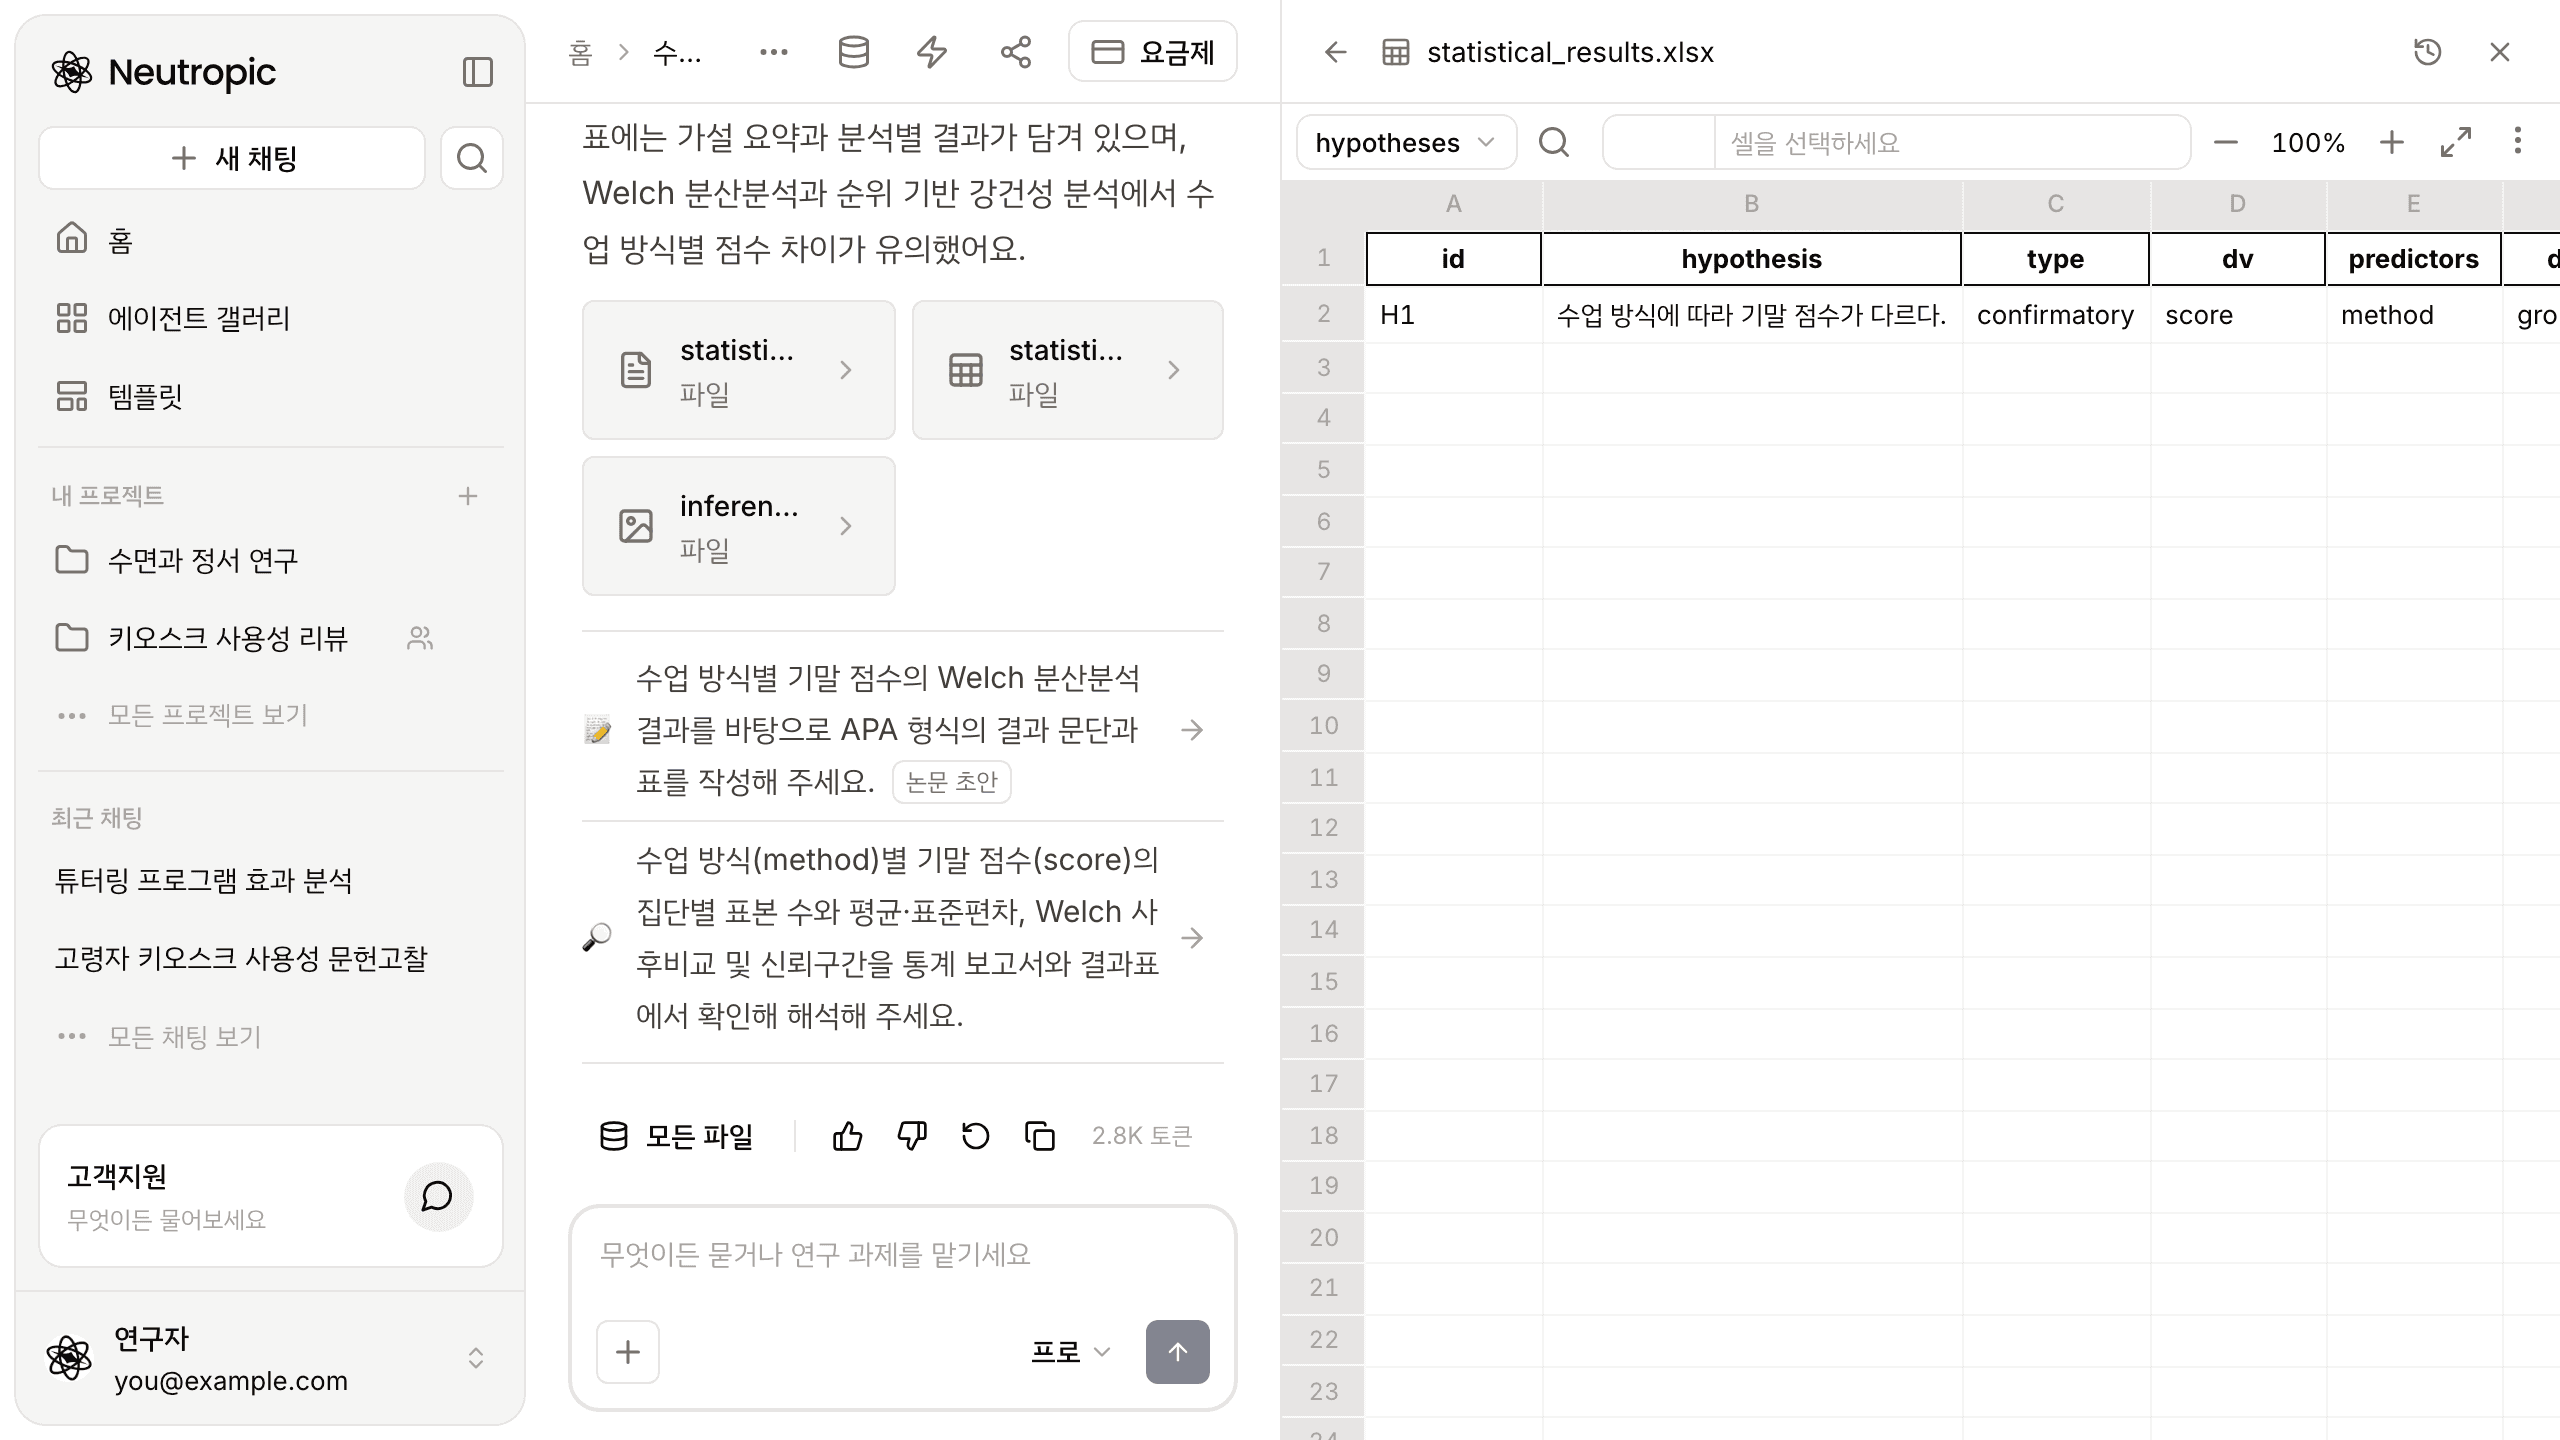
산출물은 statistical_report.md 보고서와 statistical_results.xlsx 결과 표였어요. 보고서에는 기술통계, 검정 가정, 사후검정, 제외 사례, 강건성 분석이 정리돼 있고, 결과 표에는 가설 요약과 분석별 결과가 시트별로 들어 있습니다. 단계마다 붙은 코드 상자를 누르면 실제로 돌린 파이썬 코드도 볼 수 있어요.
답 아래에는 다음 작업 두 가지가 제안돼 있었어요.
- Welch 분산분석 결과로 APA 형식의 결과 문단과 표 쓰기 — 논문 초안 에이전트
- 집단별 표본 수·평균·표준편차, 사후 비교와 신뢰구간을 보고서와 결과 표에서 확인해 해석하기
검정 선택에 쓰던 고민이 해석에 쓰는 시간이 됐습니다
| 시작할 때 | 지금 | |
|---|---|---|
| 검정 선택 | Levene 결과에 따라 바꾸려 함 | 처음부터 Welch 분산분석 |
| 가정 | 위반되면 어쩌나 걱정 | 충족 3 · 위반 1, 보고만 하고 검정은 그대로 |
| 결과 | 없음 | F(2, 72.29) = 12.35, p < .001, η²ₚ = .16 |
| 확인 | 결과가 흔들릴까 불안 | 다중비교 보정, 순위 기반 강건성 분석 |
| 산출물 | 없음 | 보고서, 결과 표, 단계별 코드 |
한계도 분명해요. 전체 검정이 유의해도 끝이 아니라, 어느 쌍이 얼마나 다른지 사후 비교를 읽어야 합니다. 한 사람이 여러 행을 남기는 자료라면 반복측정 모형이 필요하고요. 그리고 이번 자료는 무작위 배정 여부를 알 수 없으니, 점수 차이를 수업 방식의 "효과"로 단정하려면 연구 설계를 함께 봐야 합니다.
이 글은 프로 수준으로 실행했고, 약 80초가 걸렸어요. 프로는 강건성 분석을 더합니다. 라이트(무료 요금제)는 주 검정만, 전문가는 여기에 대안 분석과 더 긴 논의를 더합니다.
세 집단 이상을 비교할 땐 Welch 분산분석을 기본으로. 등분산 검정은 보고하되, 검정을 고르게 두지 마세요.
이번 주에 하은 씨처럼 데이터를 올리고 한 문장으로 물어보세요. 뉴트로픽 무료로 시작하기