안녕하세요, 뉴트로픽 팀입니다!
실험 기록으로 "정답을 맞힐지 예측하는 모델"을 만들어 보라는 과제를 받았다고 해 볼게요. 파이썬 튜토리얼을 따라 행을 섞고 5겹 교차검증을 돌리면 그럴듯한 숫자가 나옵니다. 그런데 학회 발표에서 누군가 이렇게 묻습니다. "같은 참가자가 학습 자료와 평가 자료에 같이 들어간 건 아닌가요?" 🥲
인간 연구 자료는 대부분 이런 모양이에요. 참가자 한 명이 시행 여러 개를, 환자 한 명이 방문 여러 번을 남깁니다. 행 단위로 섞어서 나누면 모델은 이미 본 사람으로 채점을 받고, 정확도는 새로운 사람에게 쓸 때보다 좋아 보이죠. 이걸 피하려면 무엇을 예측변수에서 빼야 하는지, 폴드를 어떻게 나눠야 하는지, 결과 시점 이후에야 알 수 있는 변수는 없는지 하나하나 따져야 합니다.
이 글에서는 인지심리학 박사과정 도현 씨가 반응 과제 실험 기록으로 처음 예측 모델을 만드는 과정을 따라가 봅니다. 도현 씨는 가상의 인물이지만, 아래 화면은 모두 뉴트로픽에서 실제로 실행한 결과예요.
파일 하나를 올리고 한 줄만 적었습니다
도현 씨의 파일은 trials.csv였어요. 참가자 90명이 8번씩 시행한 720행에 참가자 번호, 시행 번호, 나이, 사전 점수, 난이도, 반응 시간, 정답 여부가 담겨 있습니다. 에이전트 갤러리에서 예측 모델링 에이전트를 고르고, 파일을 첨부한 뒤 이렇게만 적었어요.
첨부한 실험 기록으로 시행별 정답 여부(correct)를 예측해줘.
짧지만 필요한 건 다 들어 있어요. 무엇을 예측할지(correct), 한 행이 무엇인지(시행). "참가자마다 여러 행이 있다"는 말은 적지 않았는데, 그걸 찾아내는 게 에이전트의 일이기 때문이에요.
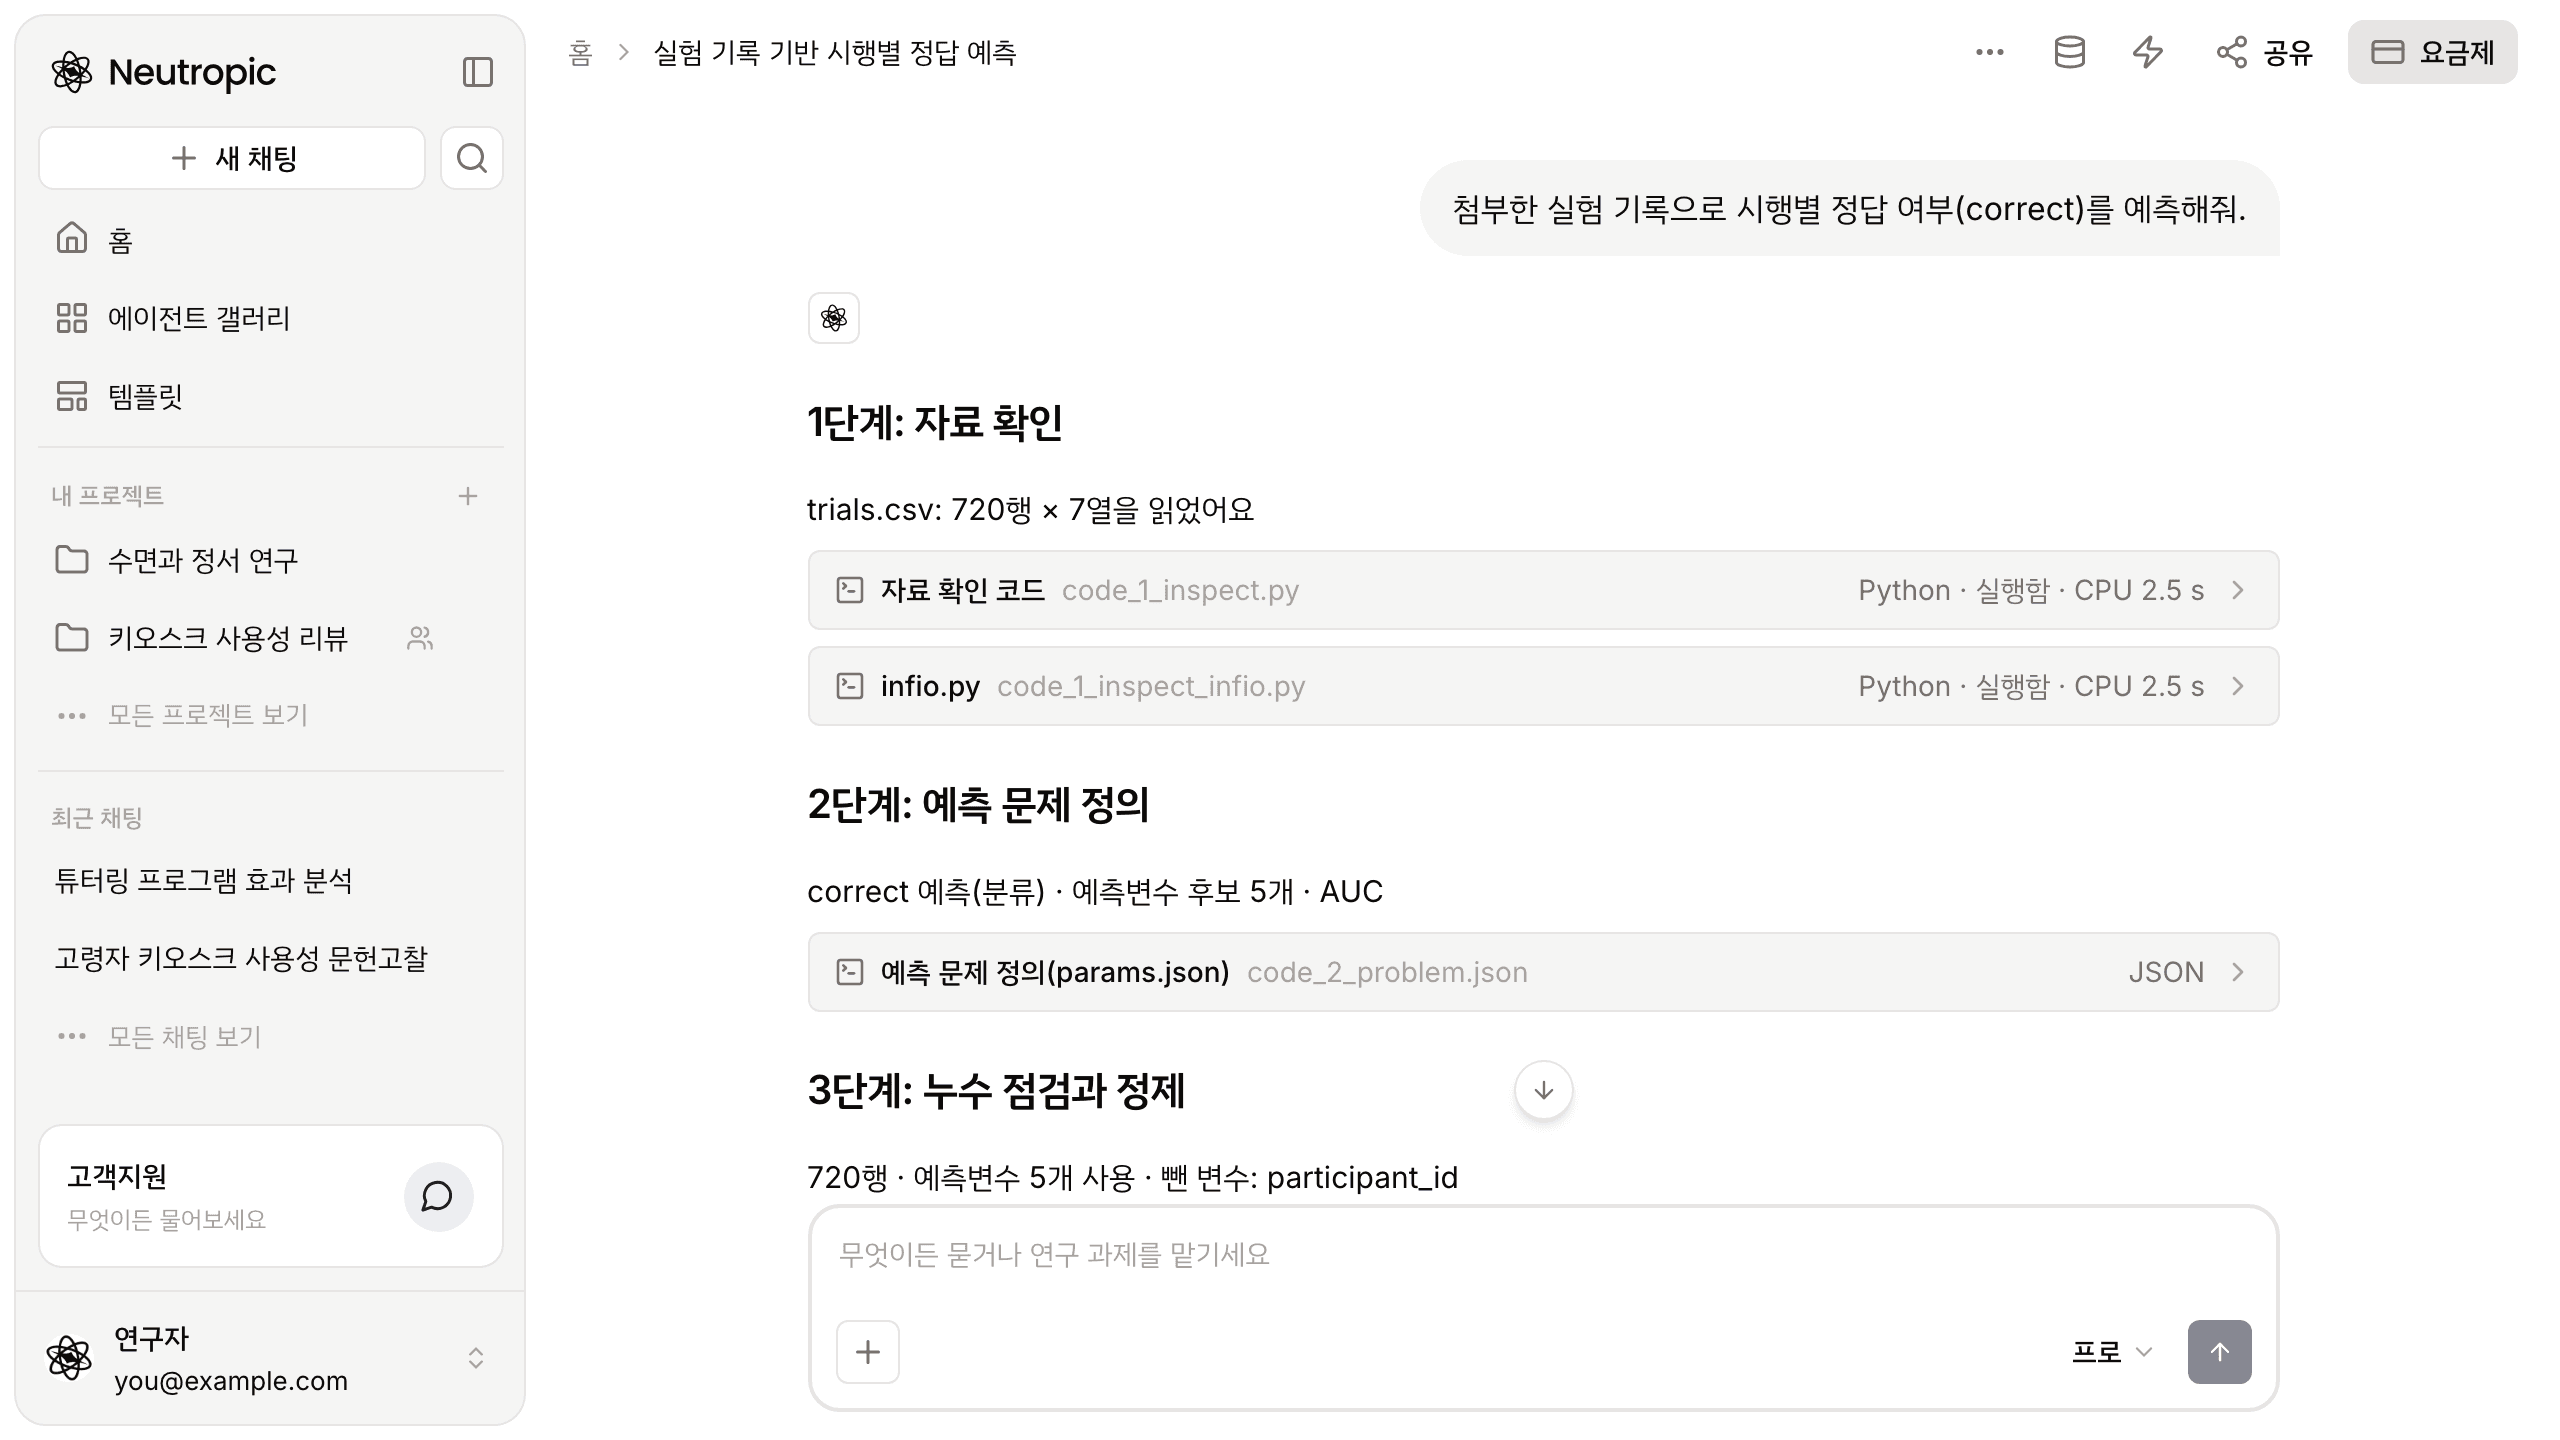
첫 단계에서 참가자 번호를 예측변수에서 뺐습니다
에이전트는 정해진 여덟 단계를 차례로 돌았어요. 자료 확인에서 720행 × 7열을 읽고, 예측 문제 정의에서 "correct 예측(분류) · 예측변수 후보 5개 · AUC"로 문제를 정했습니다.
핵심은 세 번째 단계 누수 점검과 정제였어요. 결과는 "720행 · 예측변수 5개 사용 · 뺀 변수: participant_id". 참가자 번호를 식별자로 알아보고 예측변수에서 뺀 거예요. 번호가 예측변수로 남으면 모델이 "이 사람은 원래 잘 맞힌다"를 외워 버릴 수 있거든요.
네 번째 단계 기준 모델에서는 participant_id 단위로 묶은 5겹 교차검증을 썼습니다. 한 참가자의 시행 8개가 모두 같은 폴드에 들어가니, 평가할 때 모델은 늘 처음 보는 사람을 상대해요. 결과 비율만 쓰는 기준 모델의 AUC는 0.500이었습니다.
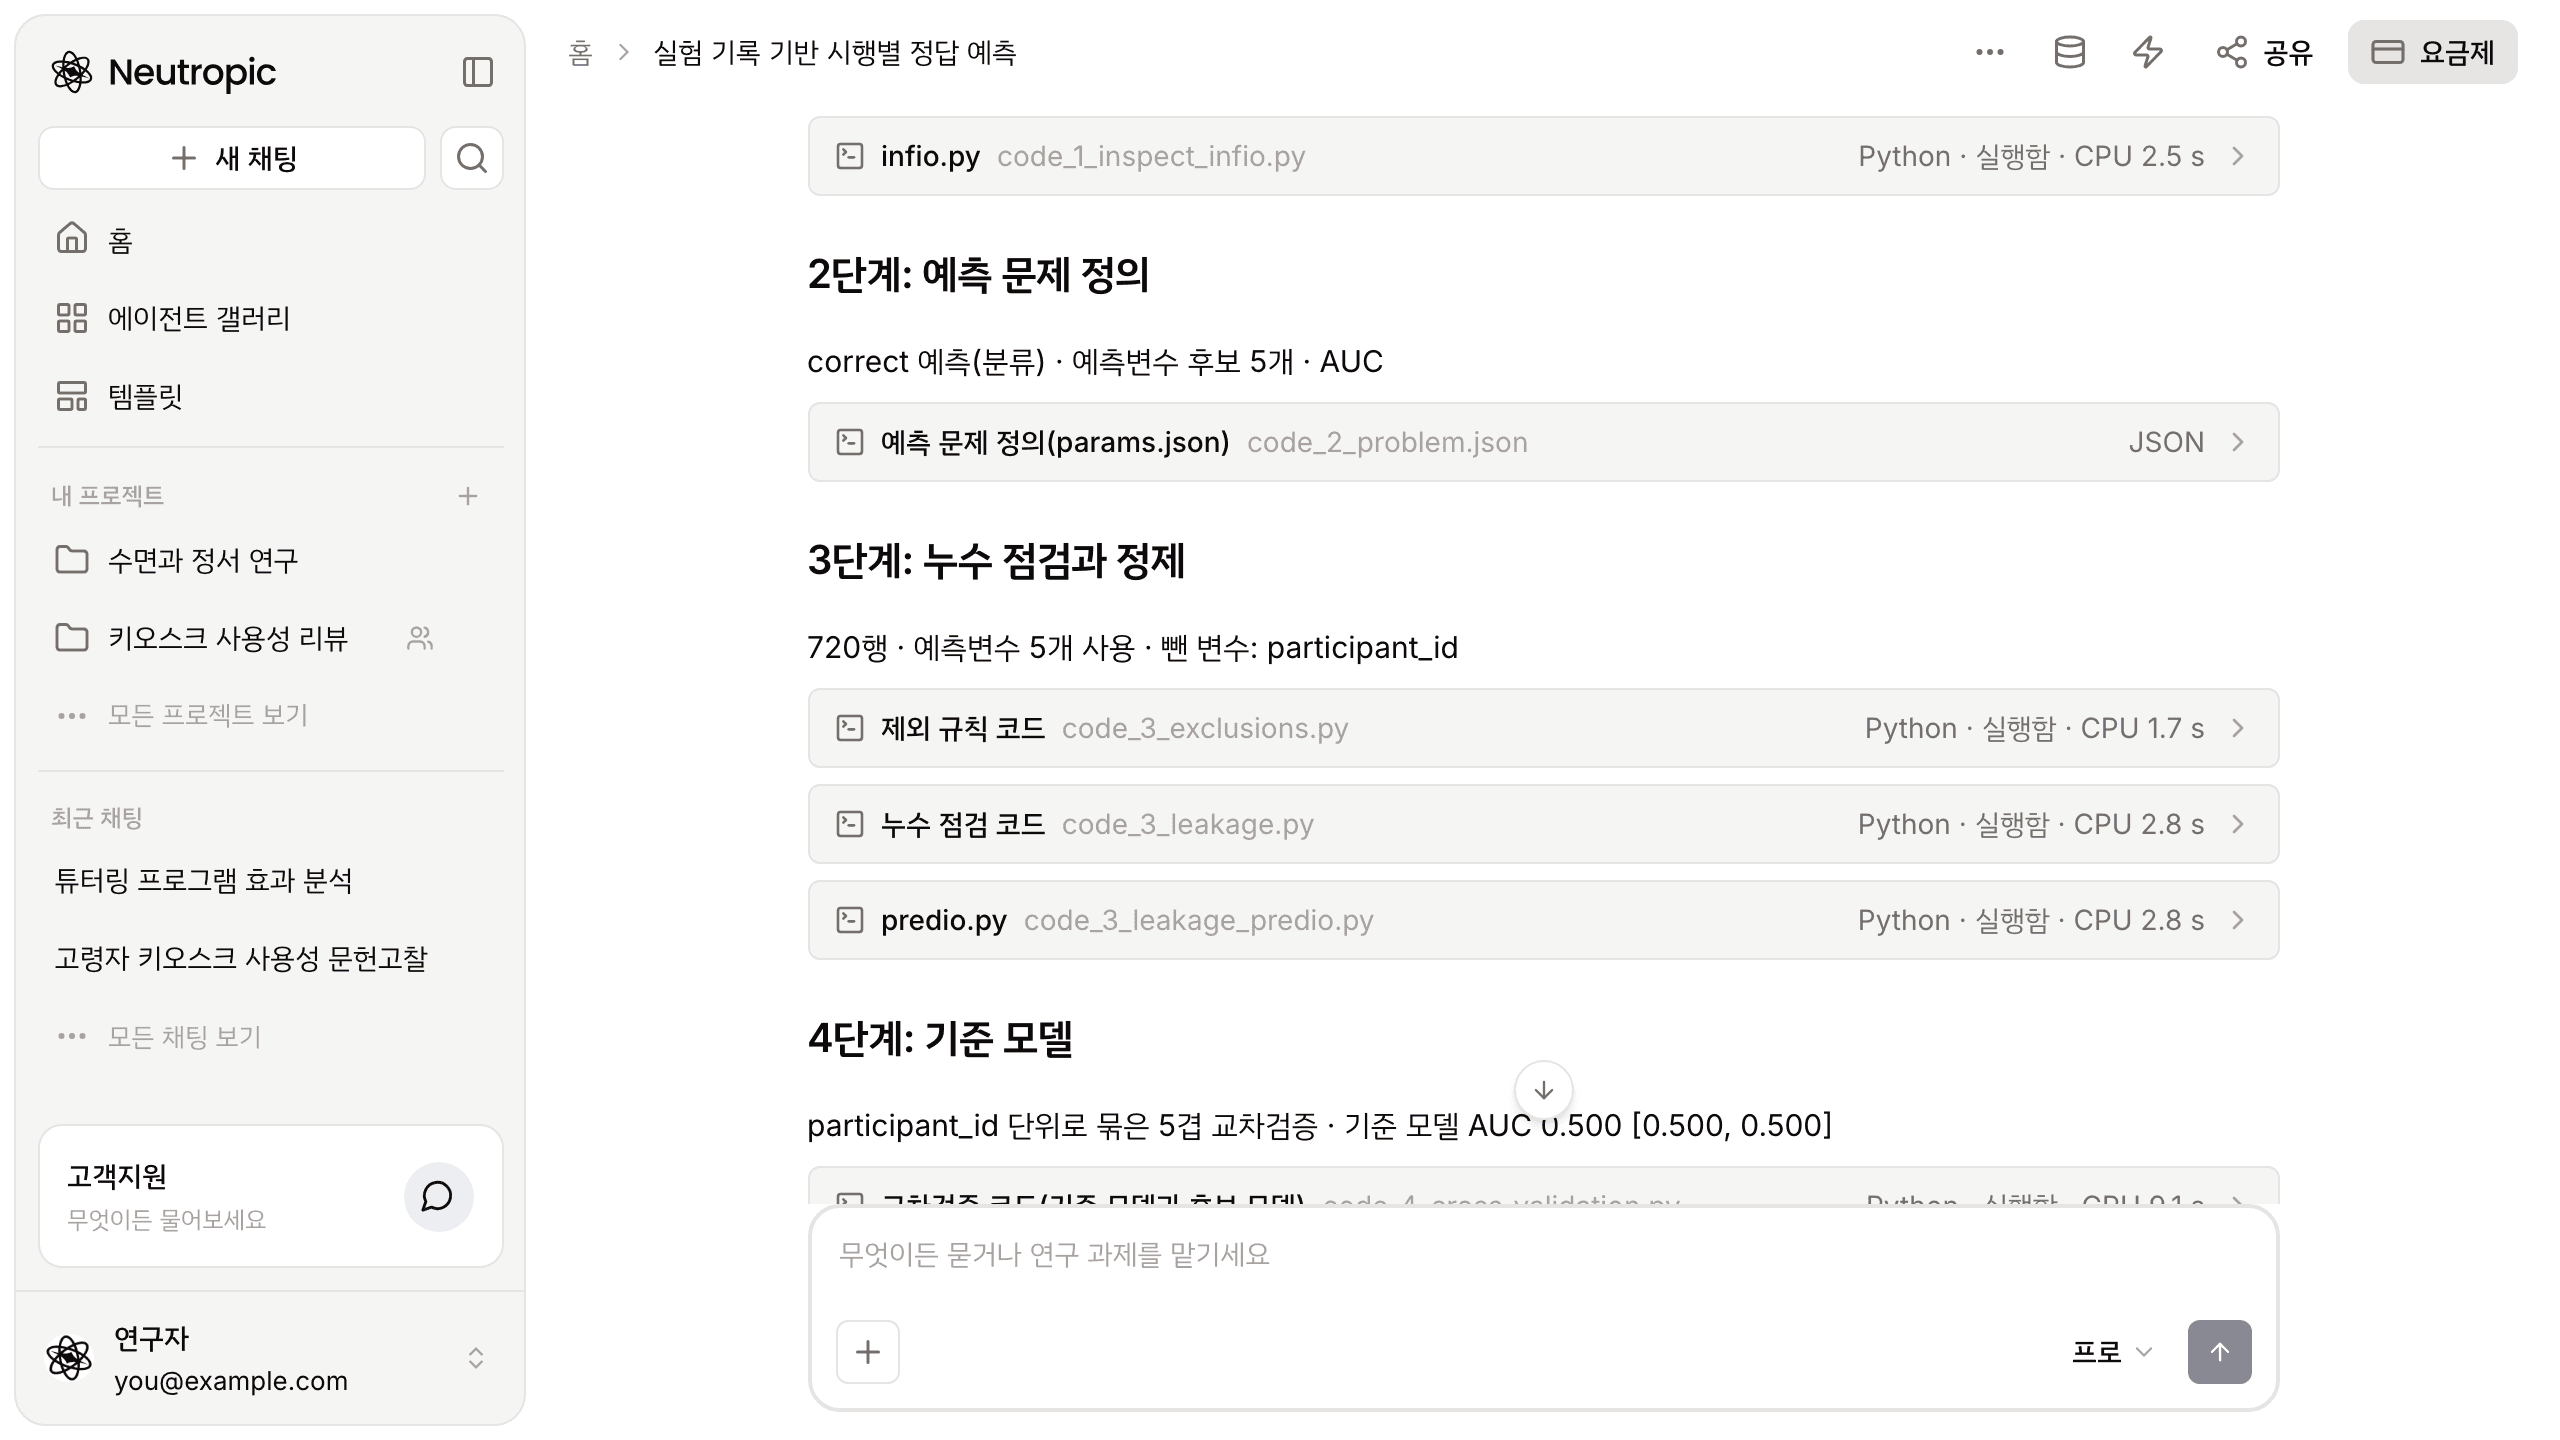
네 모델 중 가장 단순한 모델이 이겼습니다
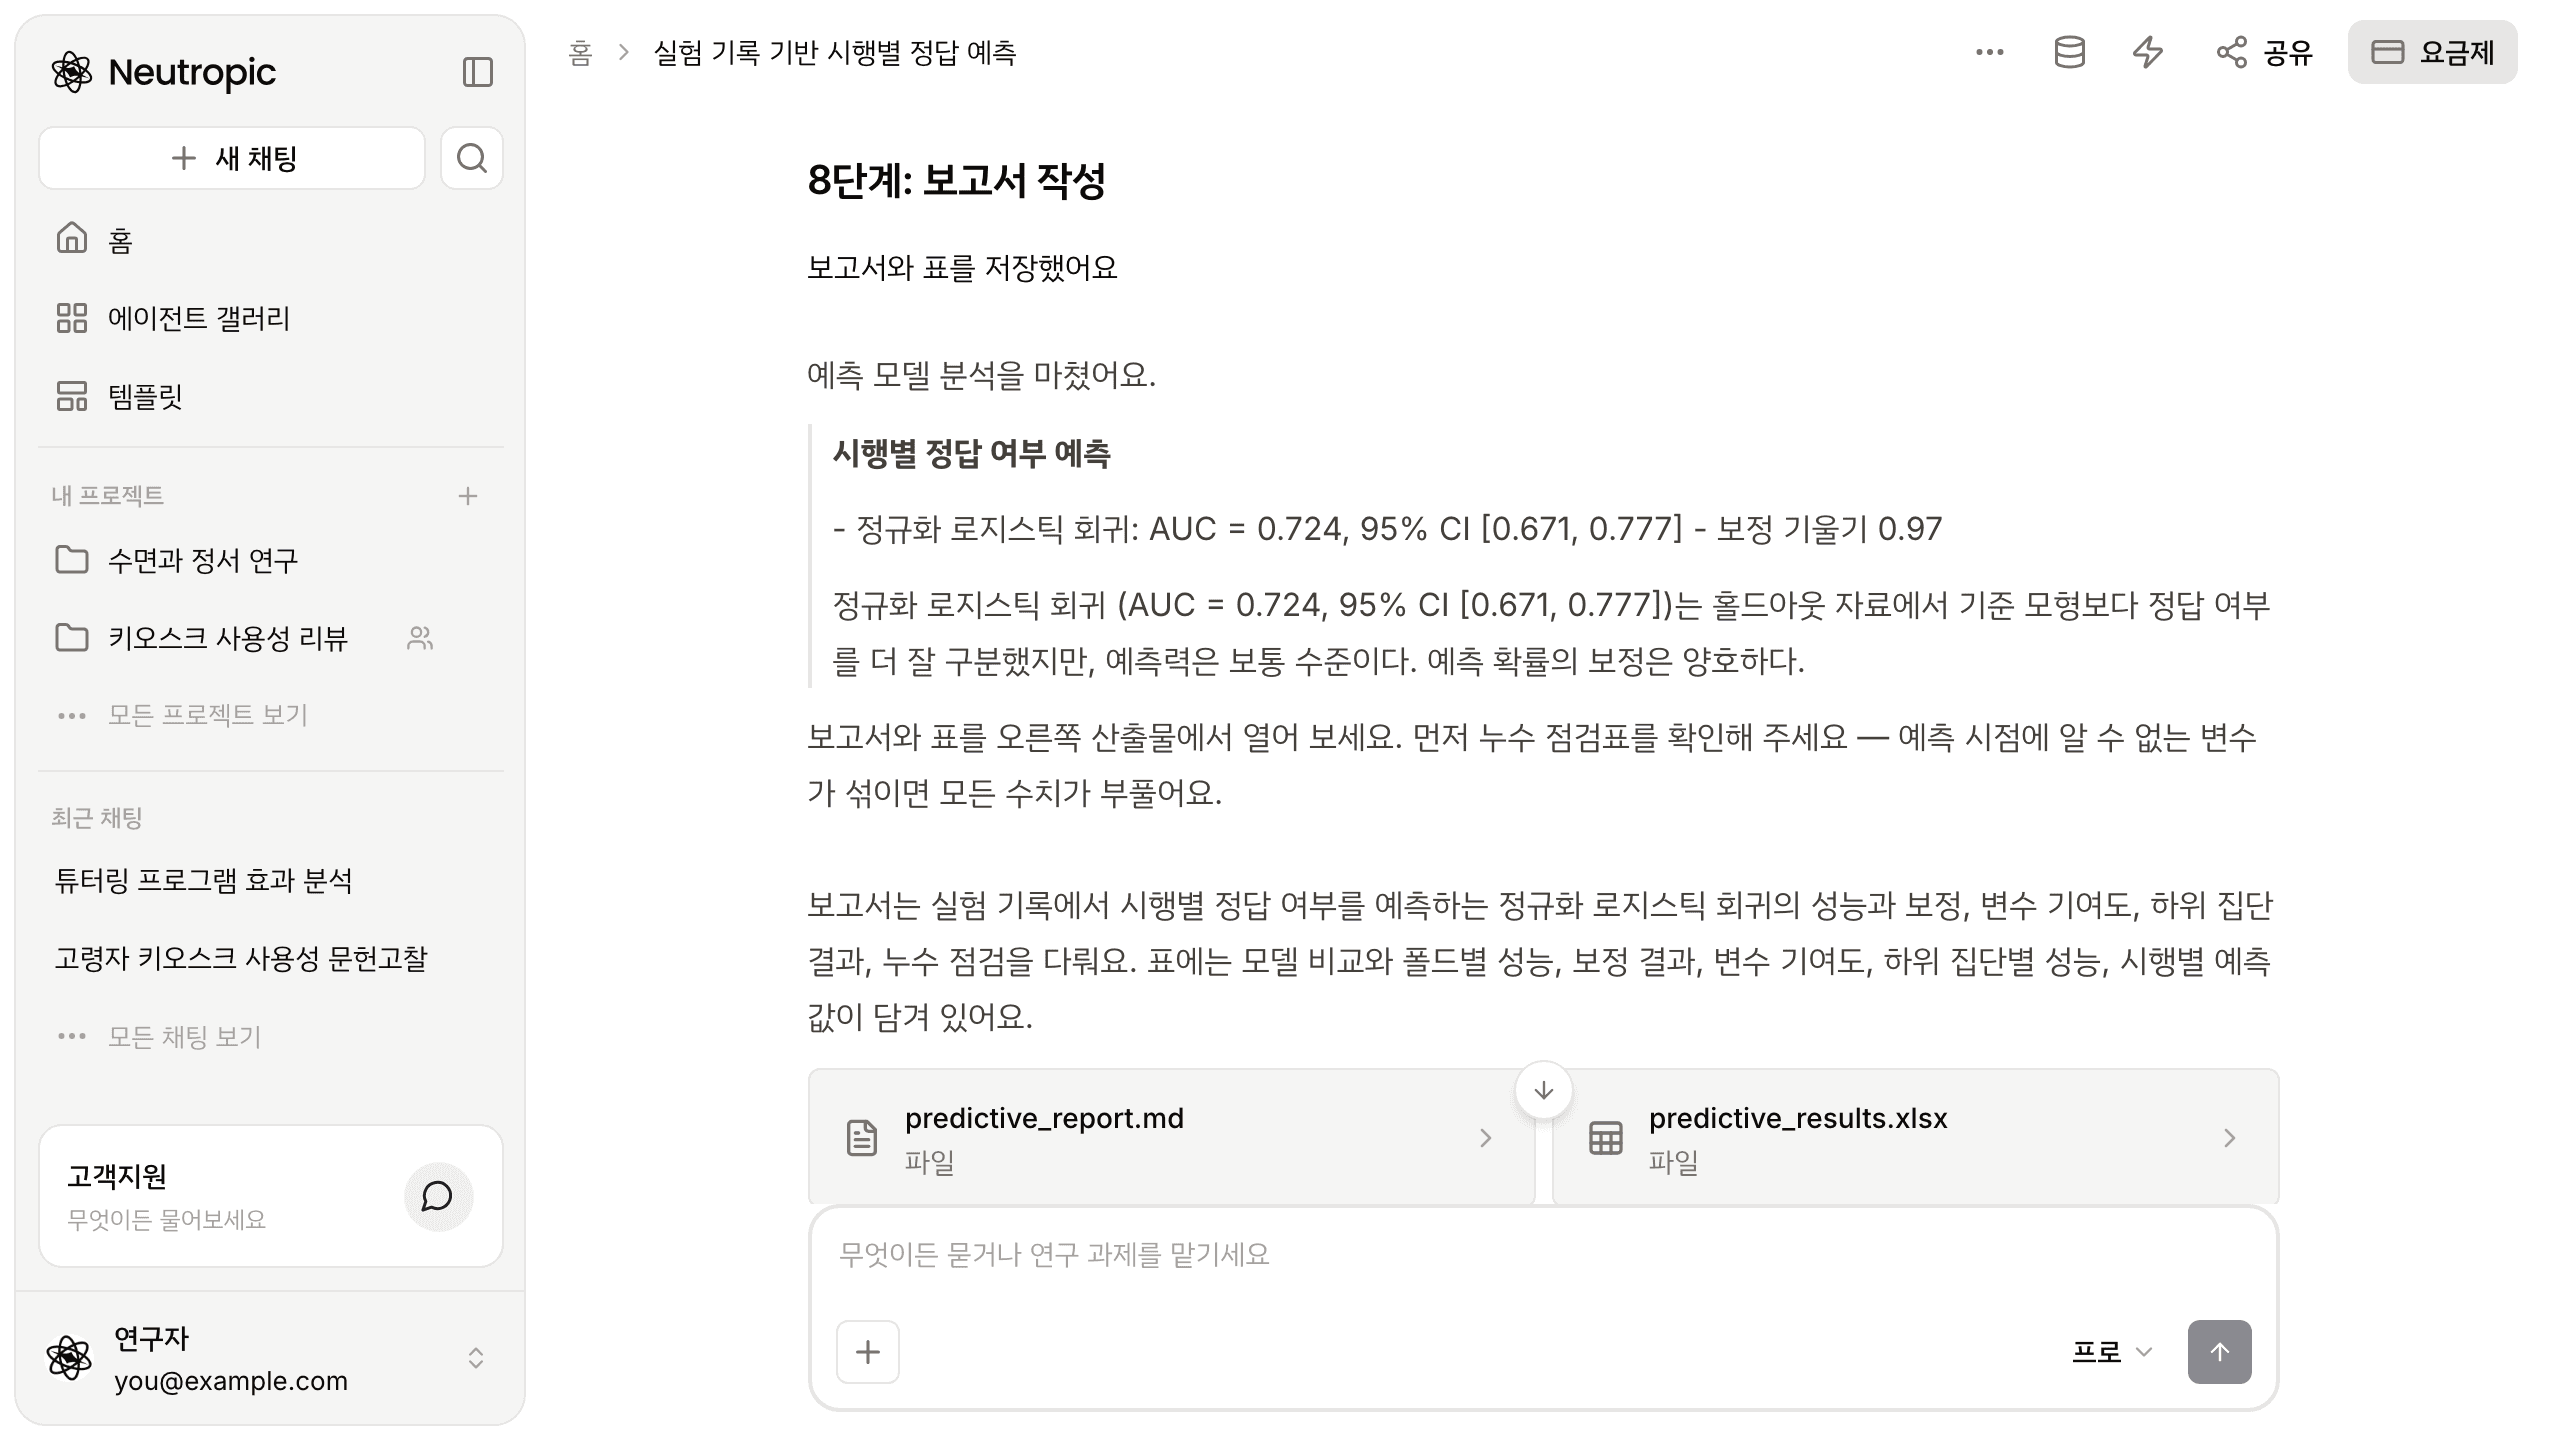
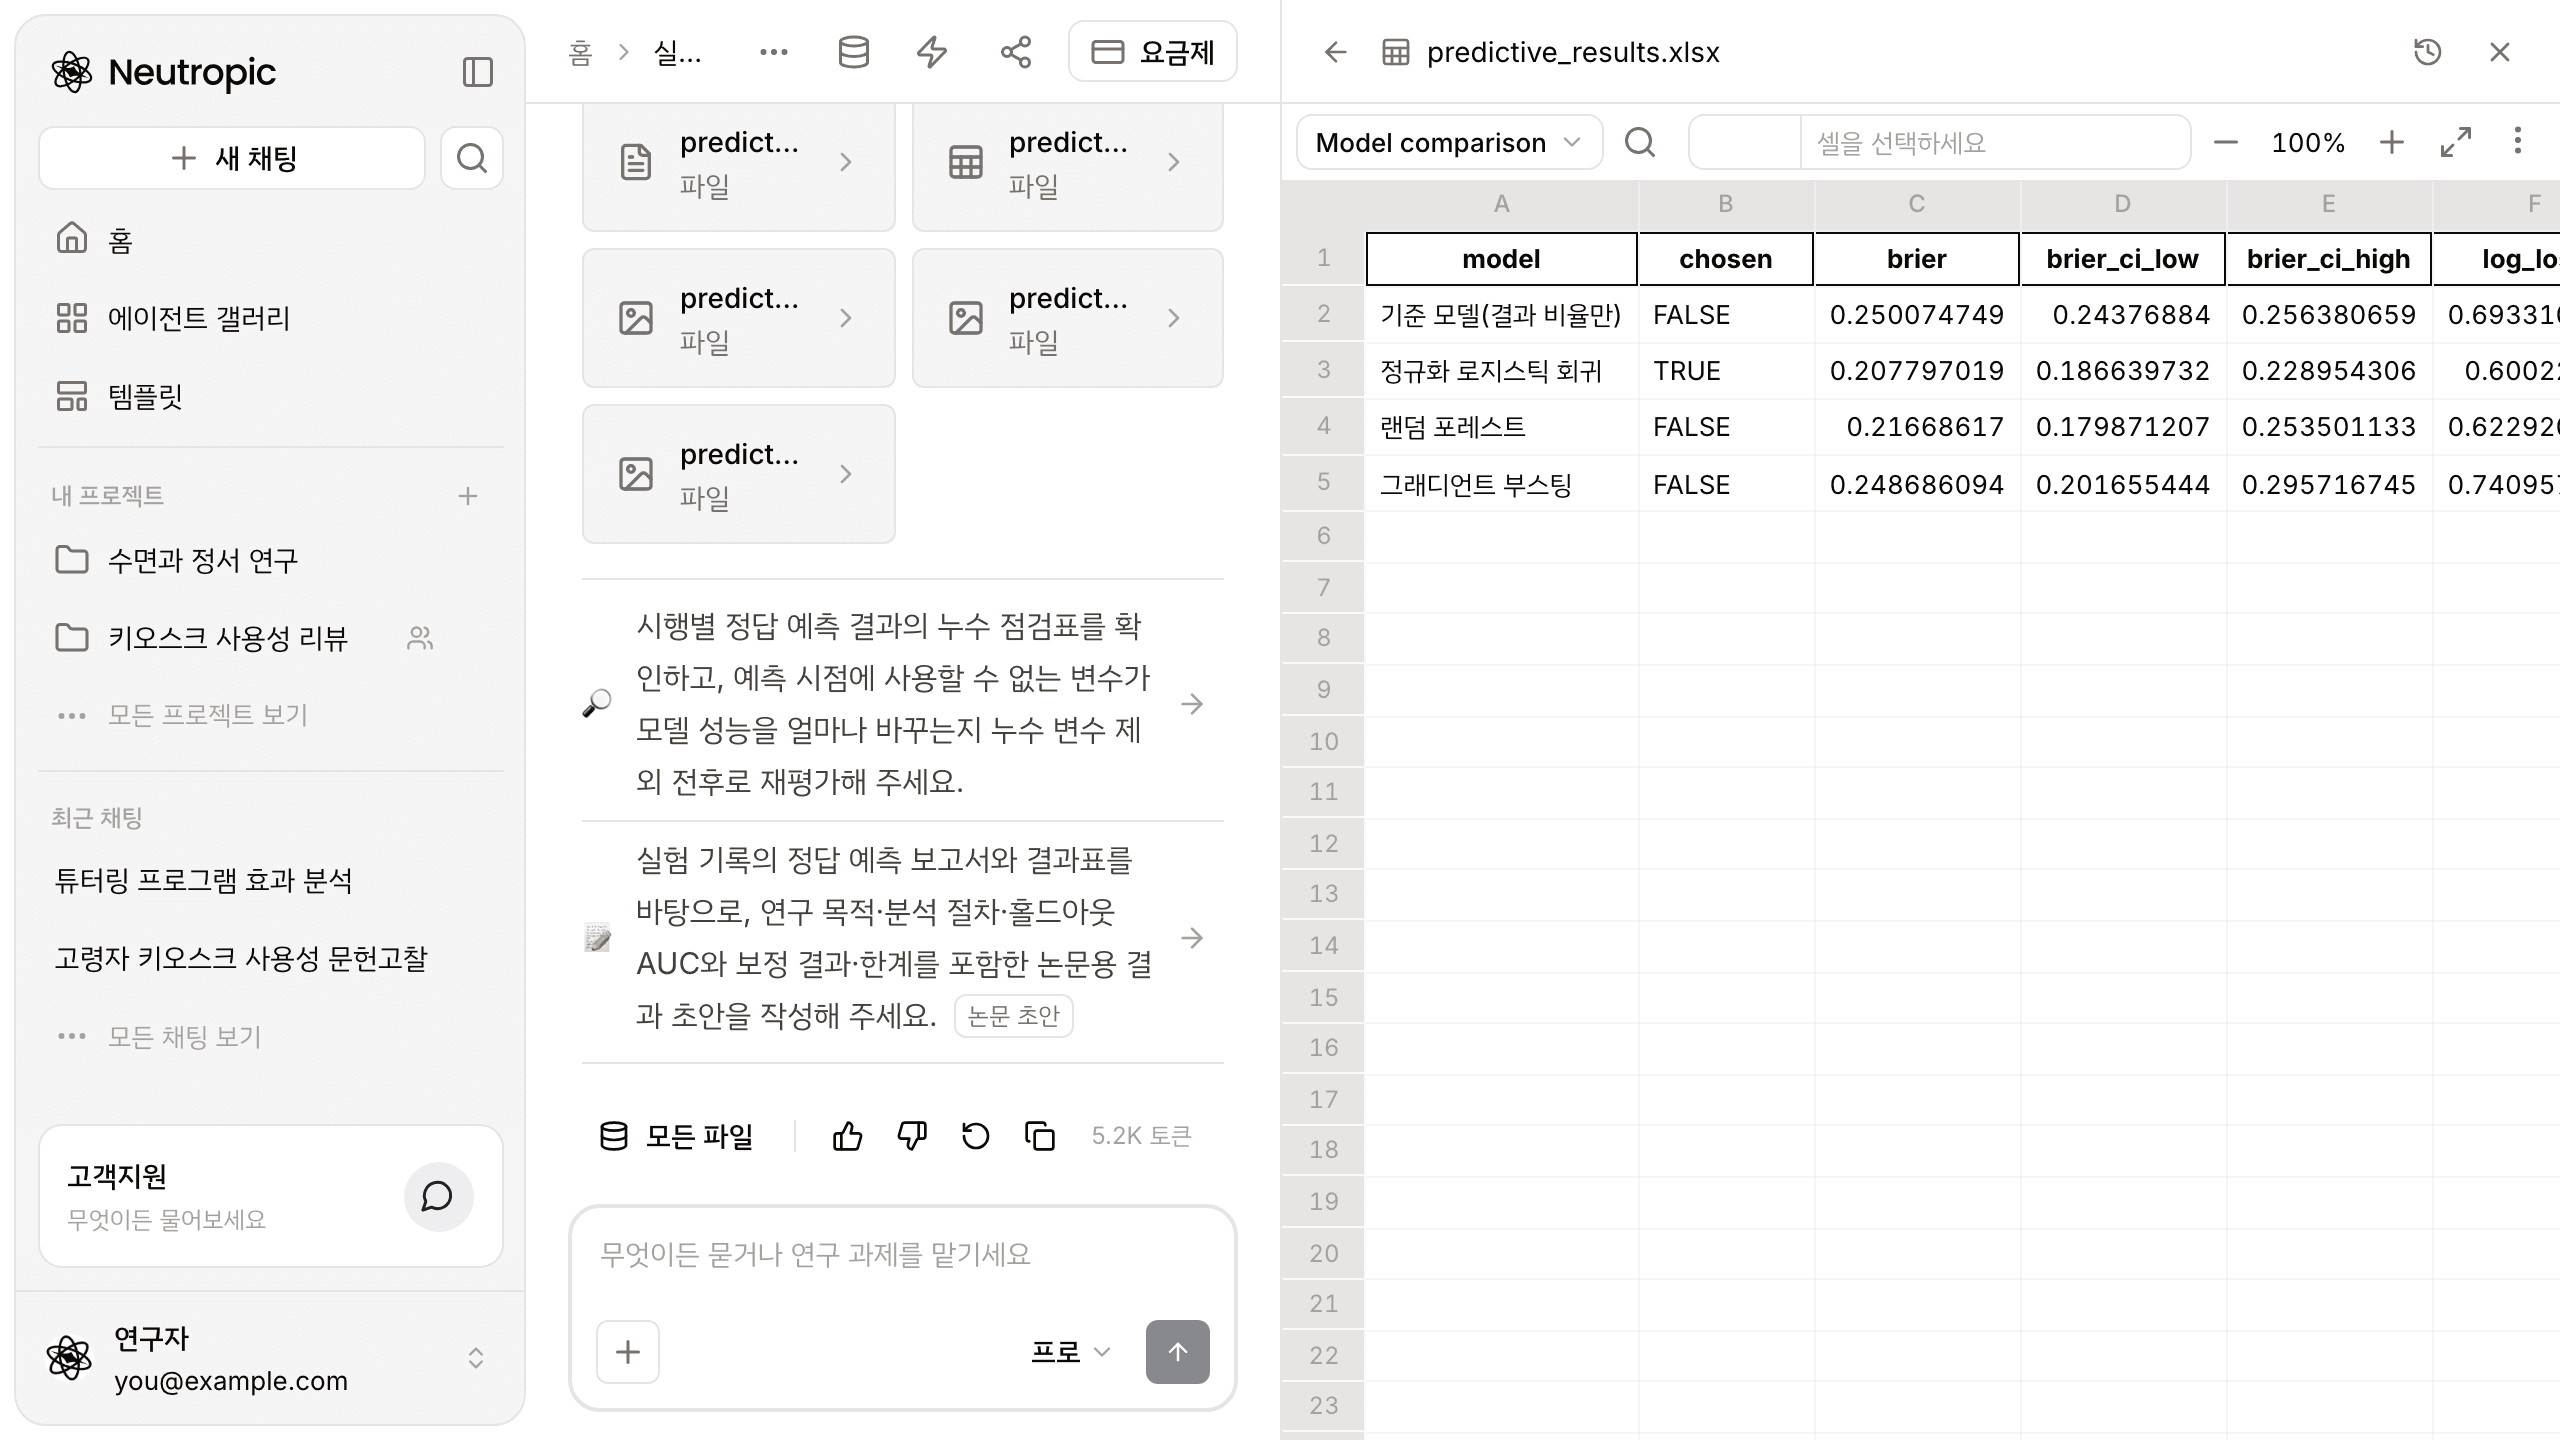
다섯 번째 단계에서 정규화 로지스틱 회귀, 랜덤 포레스트, 그래디언트 부스팅을 같은 폴드로 비교했어요. 가장 좋은 모델은 정규화 로지스틱 회귀, AUC 0.724, 95% CI [0.671, 0.777]였습니다. 결과 표의 Brier 점수도 같은 방향이었어요. 기준 모델 0.250, 정규화 로지스틱 회귀 0.208, 랜덤 포레스트 0.217, 그래디언트 부스팅 0.249.
그다음 보정과 기준점 단계는 보정 기울기 0.97, 절편 -0.00, 기준점 0.504에서 민감도 0.60·특이도 0.75를 보고했어요. 기여와 하위 집단 단계에서는 baseline_score, difficulty, age의 기여가 컸고, 하위 집단 16개를 비교했습니다.
반응 시간이 남아 있다는 걸 도현 씨가 놓칠 뻔했습니다
AUC 0.724를 보고 도현 씨는 바로 결과 문단을 쓰고 싶었어요. 그런데 답의 마지막 문장이 눈에 걸렸습니다. "먼저 누수 점검표를 확인해 주세요. 예측 시점에 알 수 없는 변수가 섞이면 모든 수치가 부풀어요."
예측변수 5개 안에는 rt_ms, 즉 반응 시간이 있었어요. 반응 시간은 참가자가 답하는 순간에야 기록됩니다. "답하기 전에 맞힐지 예측한다"는 게 목적이라면 빼야 할 변수예요. 에이전트가 제안한 다음 작업도 바로 이 점검이었습니다. 누수 점검표를 확인하고, 예측 시점에 쓸 수 없는 변수를 뺀 전후로 다시 평가하라는 거였죠.
저희가 같은 파일로 따로 확인해 보니 이 자료에서는 반응 시간과 정답 여부가 거의 상관이 없어서(r ≈ 0.01), 빼도 AUC가 0.73 안팎으로 그대로였어요. 운이 좋았던 셈이에요. 실제 자료라면 이 한 변수가 숫자를 크게 바꿀 수 있습니다.
결과 표와 다음 단계 제안까지 받았습니다
산출물은 두 개였어요. predictive_report.md 보고서와 predictive_results.xlsx 결과 표입니다. 표에는 모델 비교, 폴드별 성능, 보정 결과, 변수 기여, 하위 집단별 성능, 시행별 예측값이 시트별로 들어 있어요. 단계마다 붙은 코드 상자를 누르면 실제로 돌린 파이썬 코드도 볼 수 있습니다.
답 아래에는 다음 작업 두 가지가 제안돼 있었어요.
- 누수 점검표를 확인하고, 예측 시점에 쓸 수 없는 변수를 뺀 전후로 모델 성능 다시 평가하기
- 보고서와 결과 표를 바탕으로 연구 목적·분석 절차·AUC와 보정 결과·한계를 담은 결과 초안 쓰기 — 논문 초안 에이전트
도현 씨는 첫 번째부터 눌렀겠죠.
부풀 수 있던 숫자가 새로운 사람 기준의 숫자가 됐습니다
| 시작할 때 | 지금 | |
|---|---|---|
| 교차검증 | 행을 섞어 나누려 함 | participant_id 단위로 묶은 5겹 교차검증 |
| 예측변수 | 열을 전부 넣으려 함 | 참가자 번호를 뺀 5개, 누수 점검표 |
| 모델 | 무엇을 써야 할지 모름 | 기준 모델 포함 4개 비교, 정규화 로지스틱 회귀 선택 |
| 성능 | 숫자 하나 | AUC 0.724 [0.671, 0.777], 보정 기울기 0.97 |
| 산출물 | 없음 | 보고서, 결과 표, 단계별 코드 |
물론 한계도 있어요. AUC 0.72 안팎은 보통 수준의 구분력이고, 쓸 만한지는 목적에 따라 미리 정해야 합니다. 묶은 교차검증이 추정하는 건 새로운 참가자에 대한 성능이지, 이미 아는 사람의 다음 시행에 대한 성능이 아니에요. 그리고 반응 시간처럼 결과와 동시에 생기는 변수는 연구 질문에 맞춰 직접 판단해야 합니다.
이 글은 프로 수준으로 실행했고, 약 100초가 걸렸어요. 프로는 보정·기준점·변수 기여·하위 집단을 더합니다. 라이트(무료 요금제)는 모델 비교까지, 전문가는 여기에 강건성 점검과 더 긴 논의를 더합니다.
반복 측정 자료의 예측 성능은 "새로운 사람"을 기준으로 재야 합니다. 파일 하나와 한 줄 요청으로 그 기준부터 세울 수 있어요.
이번 주에 도현 씨처럼 실험 기록을 올리고 한 줄로 물어보세요. 뉴트로픽 무료로 시작하기