안녕하세요, 뉴트로픽 팀입니다!
"마음챙김 앱을 쓰면 시험 불안이 줄어들까?" 이런 연구 아이디어가 떠오르면 바로 실험을 짜고 싶어지죠. 그런데 지도교수님의 첫 질문은 거의 정해져 있어요. "선행연구는 찾아봤어요?" 🥲
막상 찾아보면 쉽지 않습니다. 검색어마다 결과가 수백 편이고, 앱 연구인지 대면 프로그램인지, 대학생 연구인지 직장인 연구인지 초록을 하나하나 열어 봐야 알 수 있거든요. 겨우 몇 편 추려도 "그래서 효과가 있다는 거야, 없다는 거야?"에 답하기가 어렵고요.
이 글에서는 교육심리 석사 과정 하은 씨가 학위논문 실험을 설계하기 전에 선행연구를 정리하는 과정을 따라가 봅니다. 하은 씨는 가상의 인물이지만, 아래 화면은 모두 뉴트로픽에서 실제로 실행한 결과예요.
알고 싶은 네 가지를 한 문단에 적었습니다
하은 씨는 에이전트 갤러리에서 서술적 문헌고찰 에이전트를 열고, 프로 수준으로 이렇게 보냈어요. 첨부한 파일은 없었습니다.
마음챙김 앱이 대학생의 불안이나 스트레스를 줄이는지에 대한 선행연구를 정리해 줘. 무작위 대조 연구를 중심으로, 어떤 앱과 개입 기간을 썼는지, 대조군은 무엇이었는지, 효과가 어느 정도였는지, 연구들의 한계가 뭔지 알고 싶어.
좋은 요청인 이유는 두 가지예요. 하나는 범위를 좁혔다는 것(대학생, 마음챙김 앱, 불안·스트레스, 무작위 대조 연구), 다른 하나는 뽑아낼 정보를 네 가지(앱과 기간, 대조군, 효과 크기, 한계)로 정해 줬다는 것이죠. 나중에 실험을 설계할 때 바로 필요한 정보들이기도 하고요.
질문을 세 개로 나누고, 9단계로 문헌을 모았습니다
실행은 9단계로 진행됐고 3분 정도 걸렸어요. 1단계 목적과 질문 설정에서 요청이 핵심 질문 3개로 정리됐습니다. 어떤 앱과 기간·대조군을 썼는지, 효과가 어느 정도였는지, 반복해서 보고된 한계는 무엇인지예요. 개념도 마음챙김 앱, 대학생, 불안, 스트레스, 무작위 대조 연구 다섯 가지로 고정됐고요.
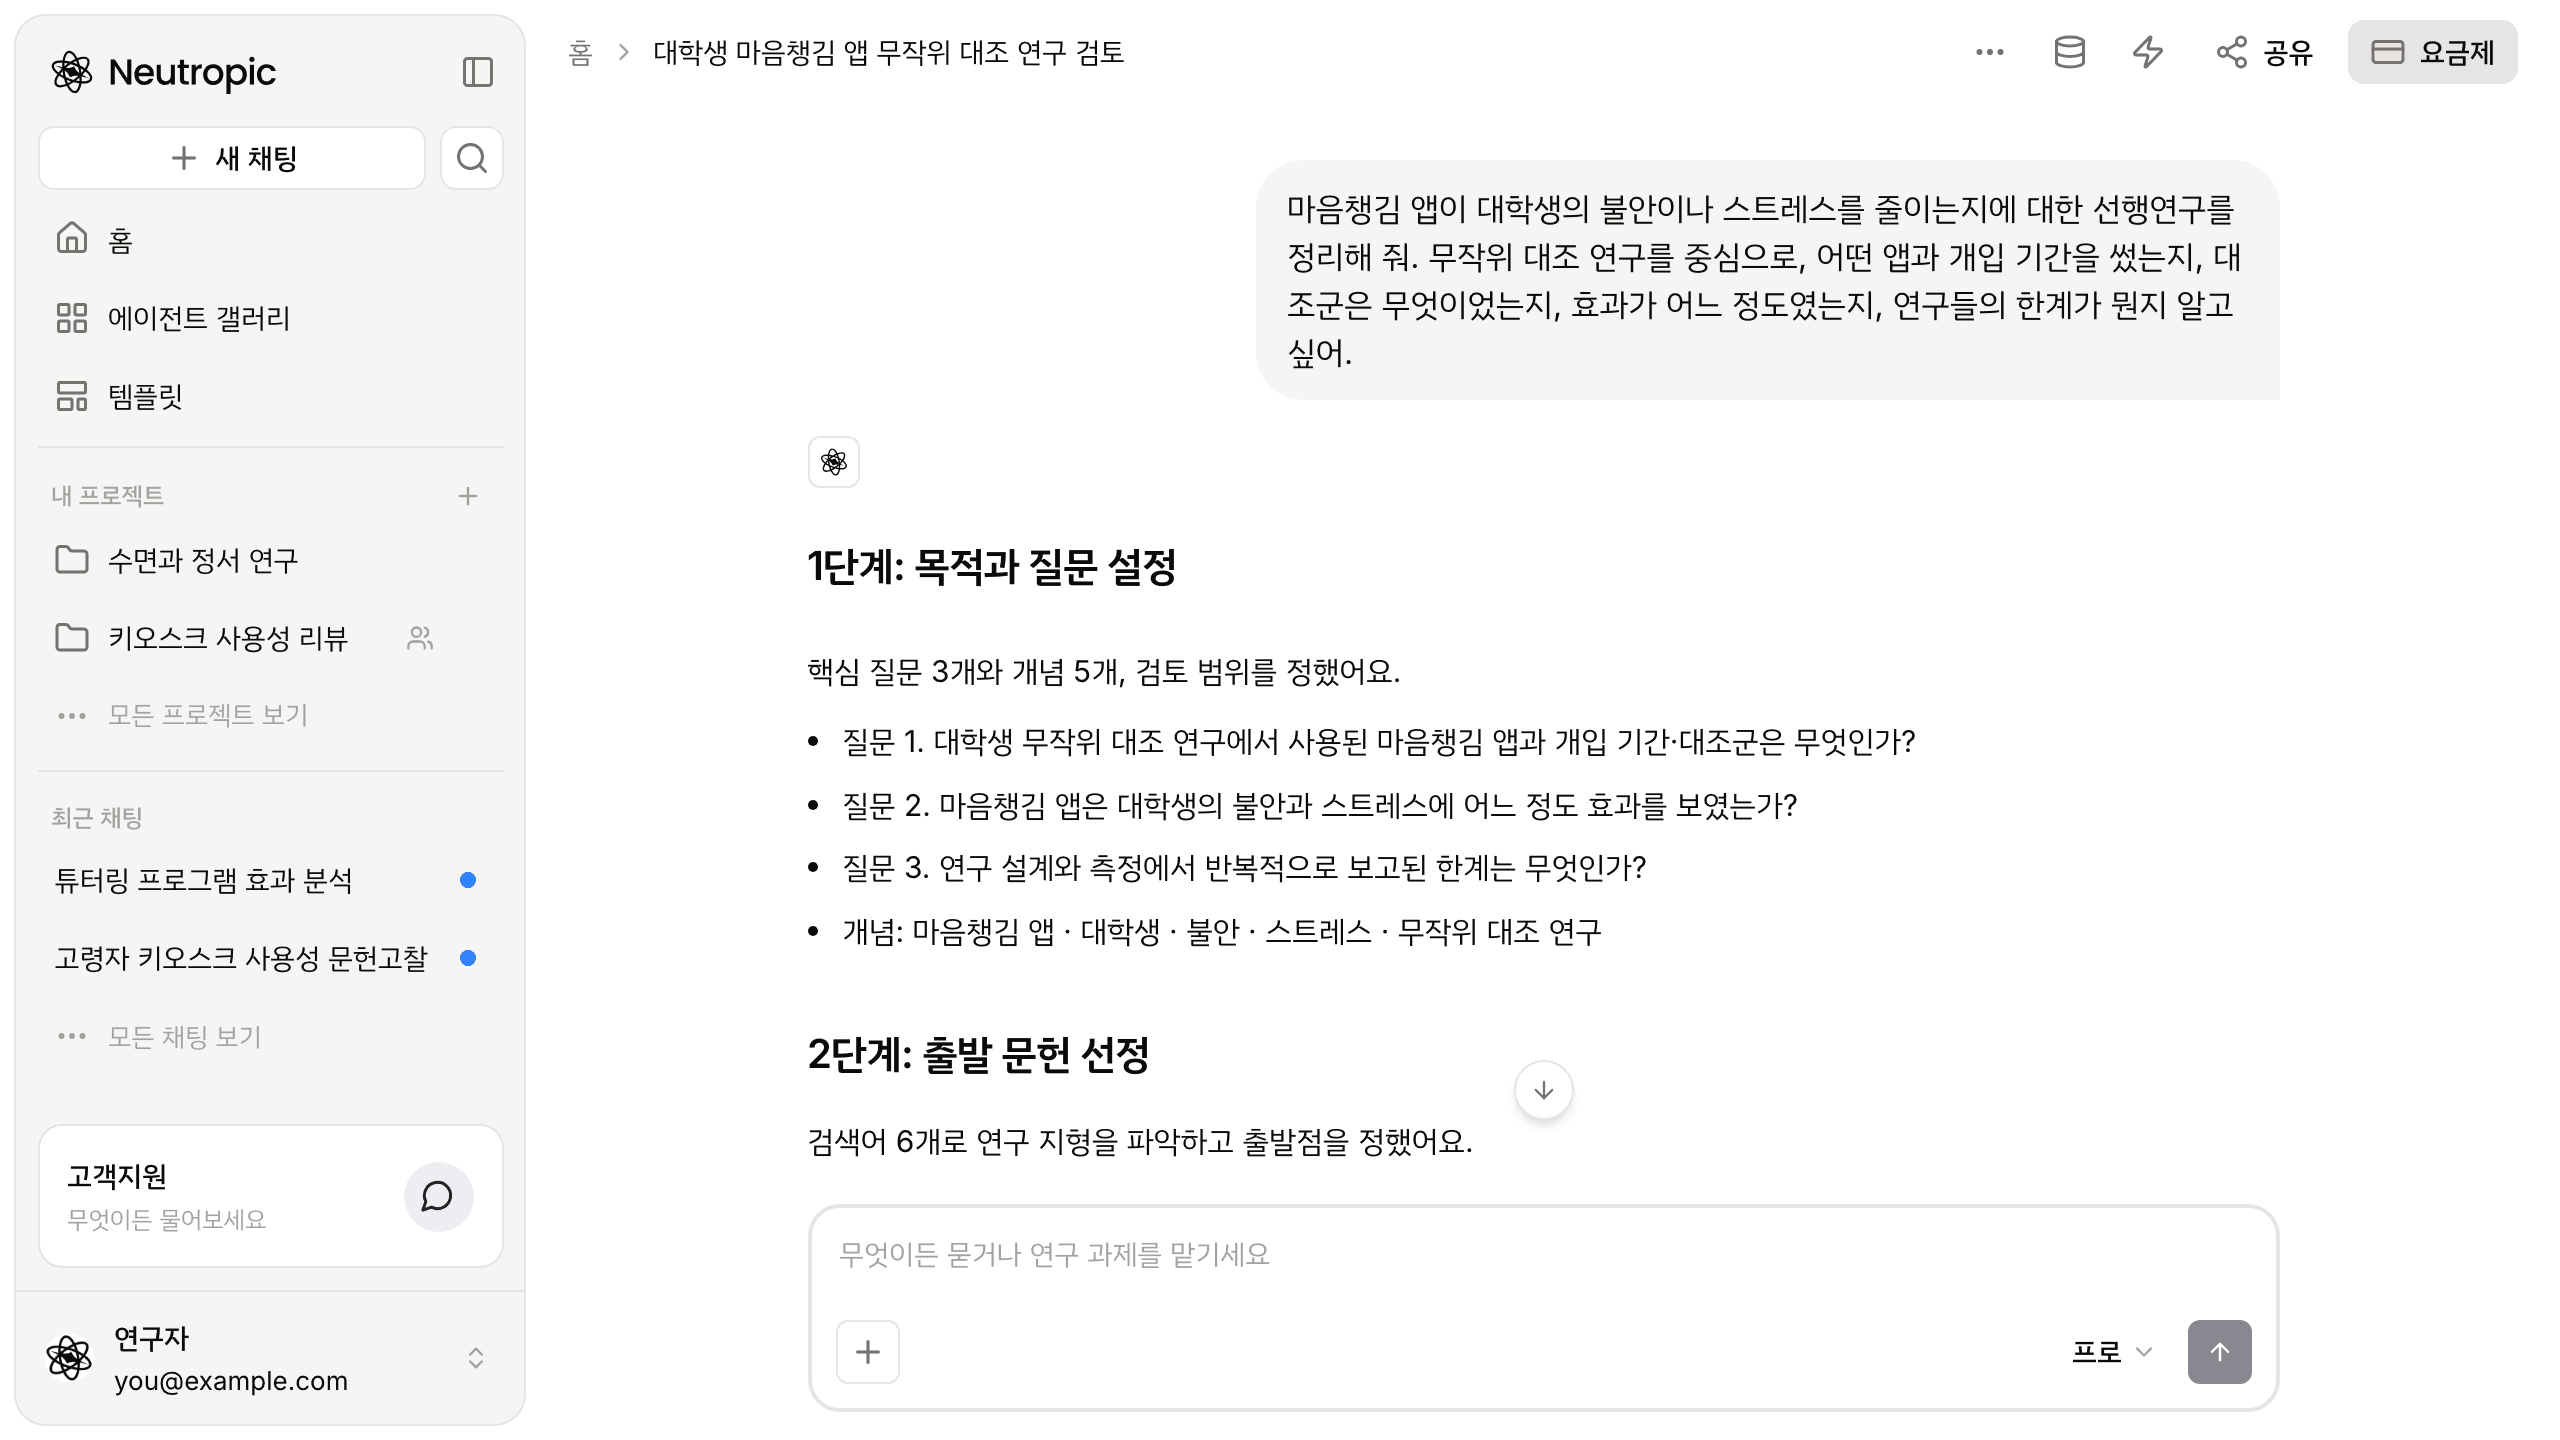
2·3단계에서는 검색어 6개로 출발점을 정한 뒤, 여러 데이터베이스에서 문헌 200편을 모았어요. 이 중 56편은 핵심 논문의 참고문헌과 피인용 문헌을 따라가는 인용 추적으로 찾은 것이었습니다. 4단계 포화 판단에서는 솔직한 기록이 남았어요. 이 수준의 인용 추적 한도(1회)에서 멈췄고, 새 문헌이 더 나오지 않는 포화 상태에는 이르지 못했다고요.
200편 중 15편만 남기고, 나머지는 이유와 함께 기록했습니다
5단계 문헌 선정과 기록에서 200편 중 15편이 선정됐어요. 나머지 185편은 제외 사유가 붙었습니다. 대상·맥락이 범위 밖인 문헌이 141편, 주제와 무관한 문헌이 34편, 관련성은 높지만 이번 검토 규모를 넘어 뺀 문헌이 10편이었어요. 전체 판단은 '선별 결과' 표에 남아서, 하은 씨가 "이 논문은 왜 빠졌지?" 싶을 때 바로 확인할 수 있습니다.
6·7단계에서는 선정 문헌을 개념별로 묶고 근거 수준을 매겼어요. 무작위 실험이 13편, 준실험이 2편이었습니다. 그리고 질문마다 근거 강도를 잠정적으로 지지됨(확립되지 않음)으로 판단했는데, 이유도 함께 적혀 있었어요. 근거 문헌 중 원문까지 읽은 것이 절반이 안 되면 이 이상으로 올리지 않는다는 규칙이에요.
결론마다 근거 강도가 붙어서 나왔습니다
최종 답의 핵심 메시지는 이랬어요. 대학생 대상 연구들은 Sanvello를 4주간 긍정적 대조군과, Calm을 8주간 대기자 대조군과 비교했고, Headspace를 30일간 쓴 연구와 마음챙김 앱을 11주간 식이·운동 자기기록 전자일기와 비교한 시험도 있었습니다. 앱도, 기간도, 대조군도 제각각이었던 거죠. (Headspace 연구는 제목만으로는 무작위 대조시험인지 확인되지 않아, 인용하기 전에 원문 설계를 확인해 보세요.)
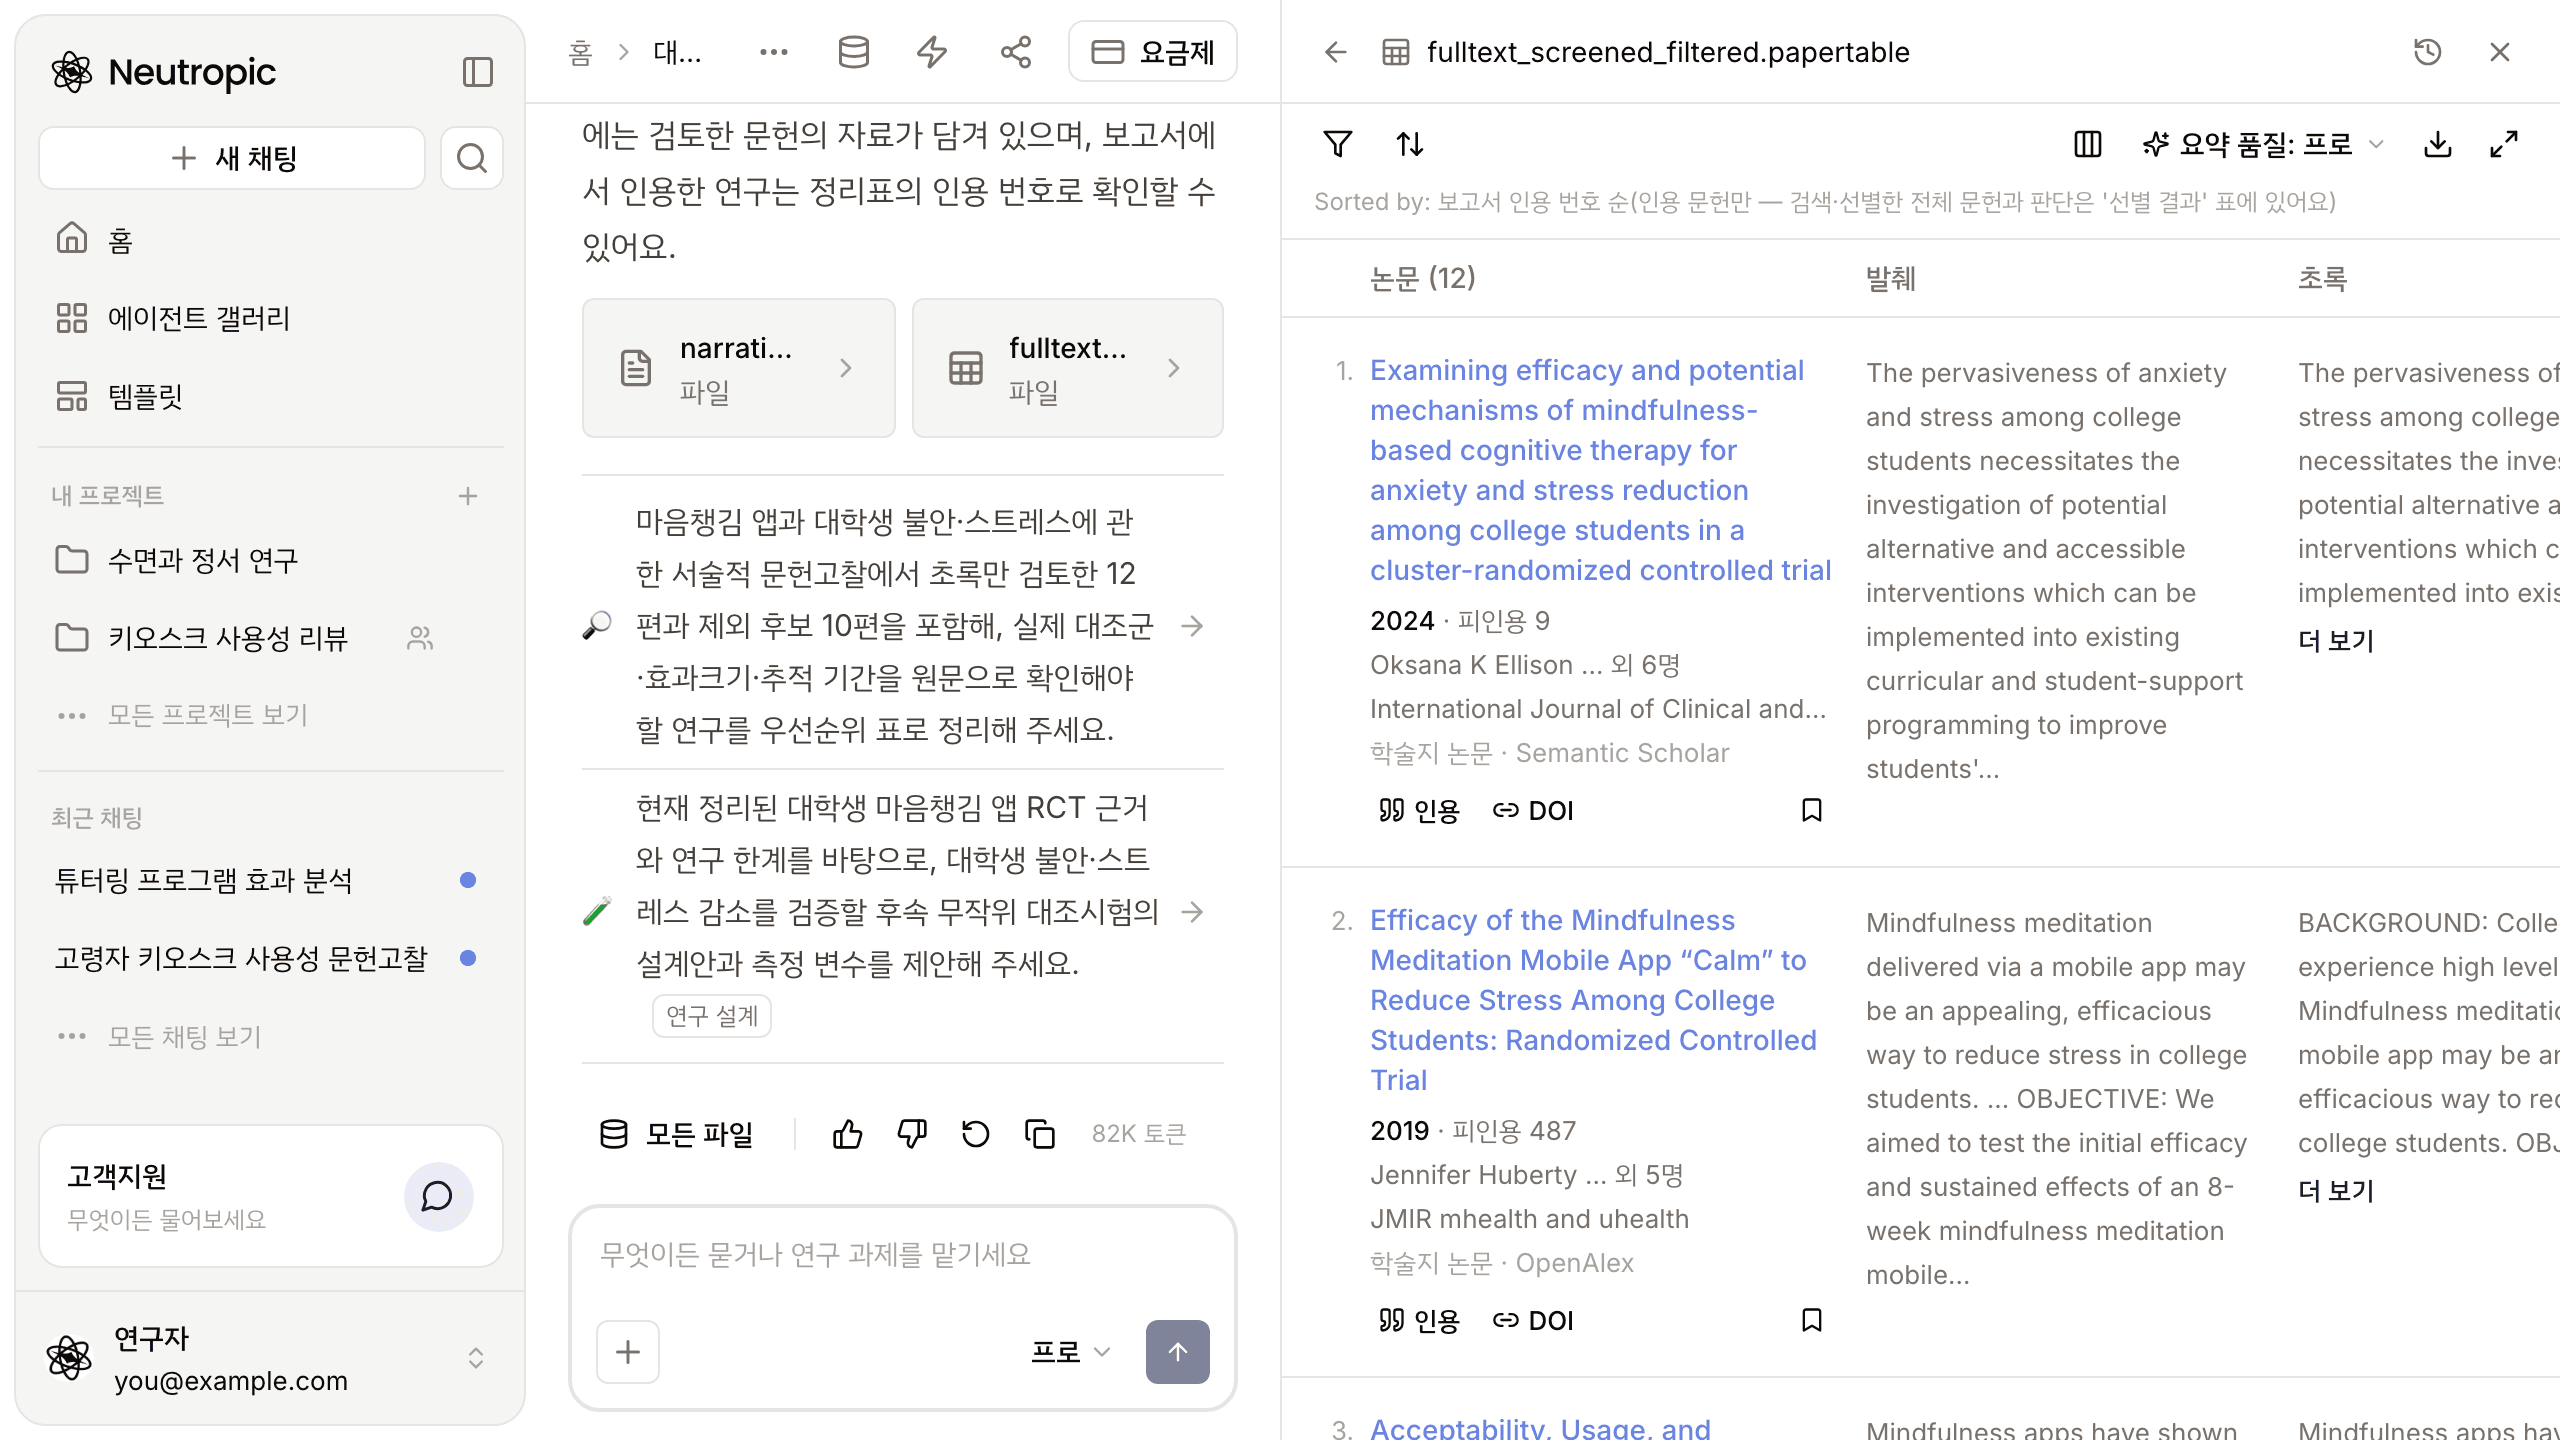
효과는 일관되지 않았어요. Sanvello 시험은 특성 불안과 만성 스트레스가 대조군보다 더 크게 줄었다고 보고했고(효과는 작거나 중간 수준), 보건의료계열 학생 대상 앱 시험은 대조군보다 불안이 줄었다고 보고했습니다(g = 0.85, p = 0.003). 반면 두 앱을 대기자 대조군과 비교한 연구는 유의한 집단 차이를 보고하지 않았어요. 반복되는 한계로는 특정 학생 집단(보건의료계열, 상담 대기 학생)에 치우친 표본, 23명 규모의 예비시험 같은 작은 연구, 제각각인 결과 측정과 대조 조건이 꼽혔습니다.
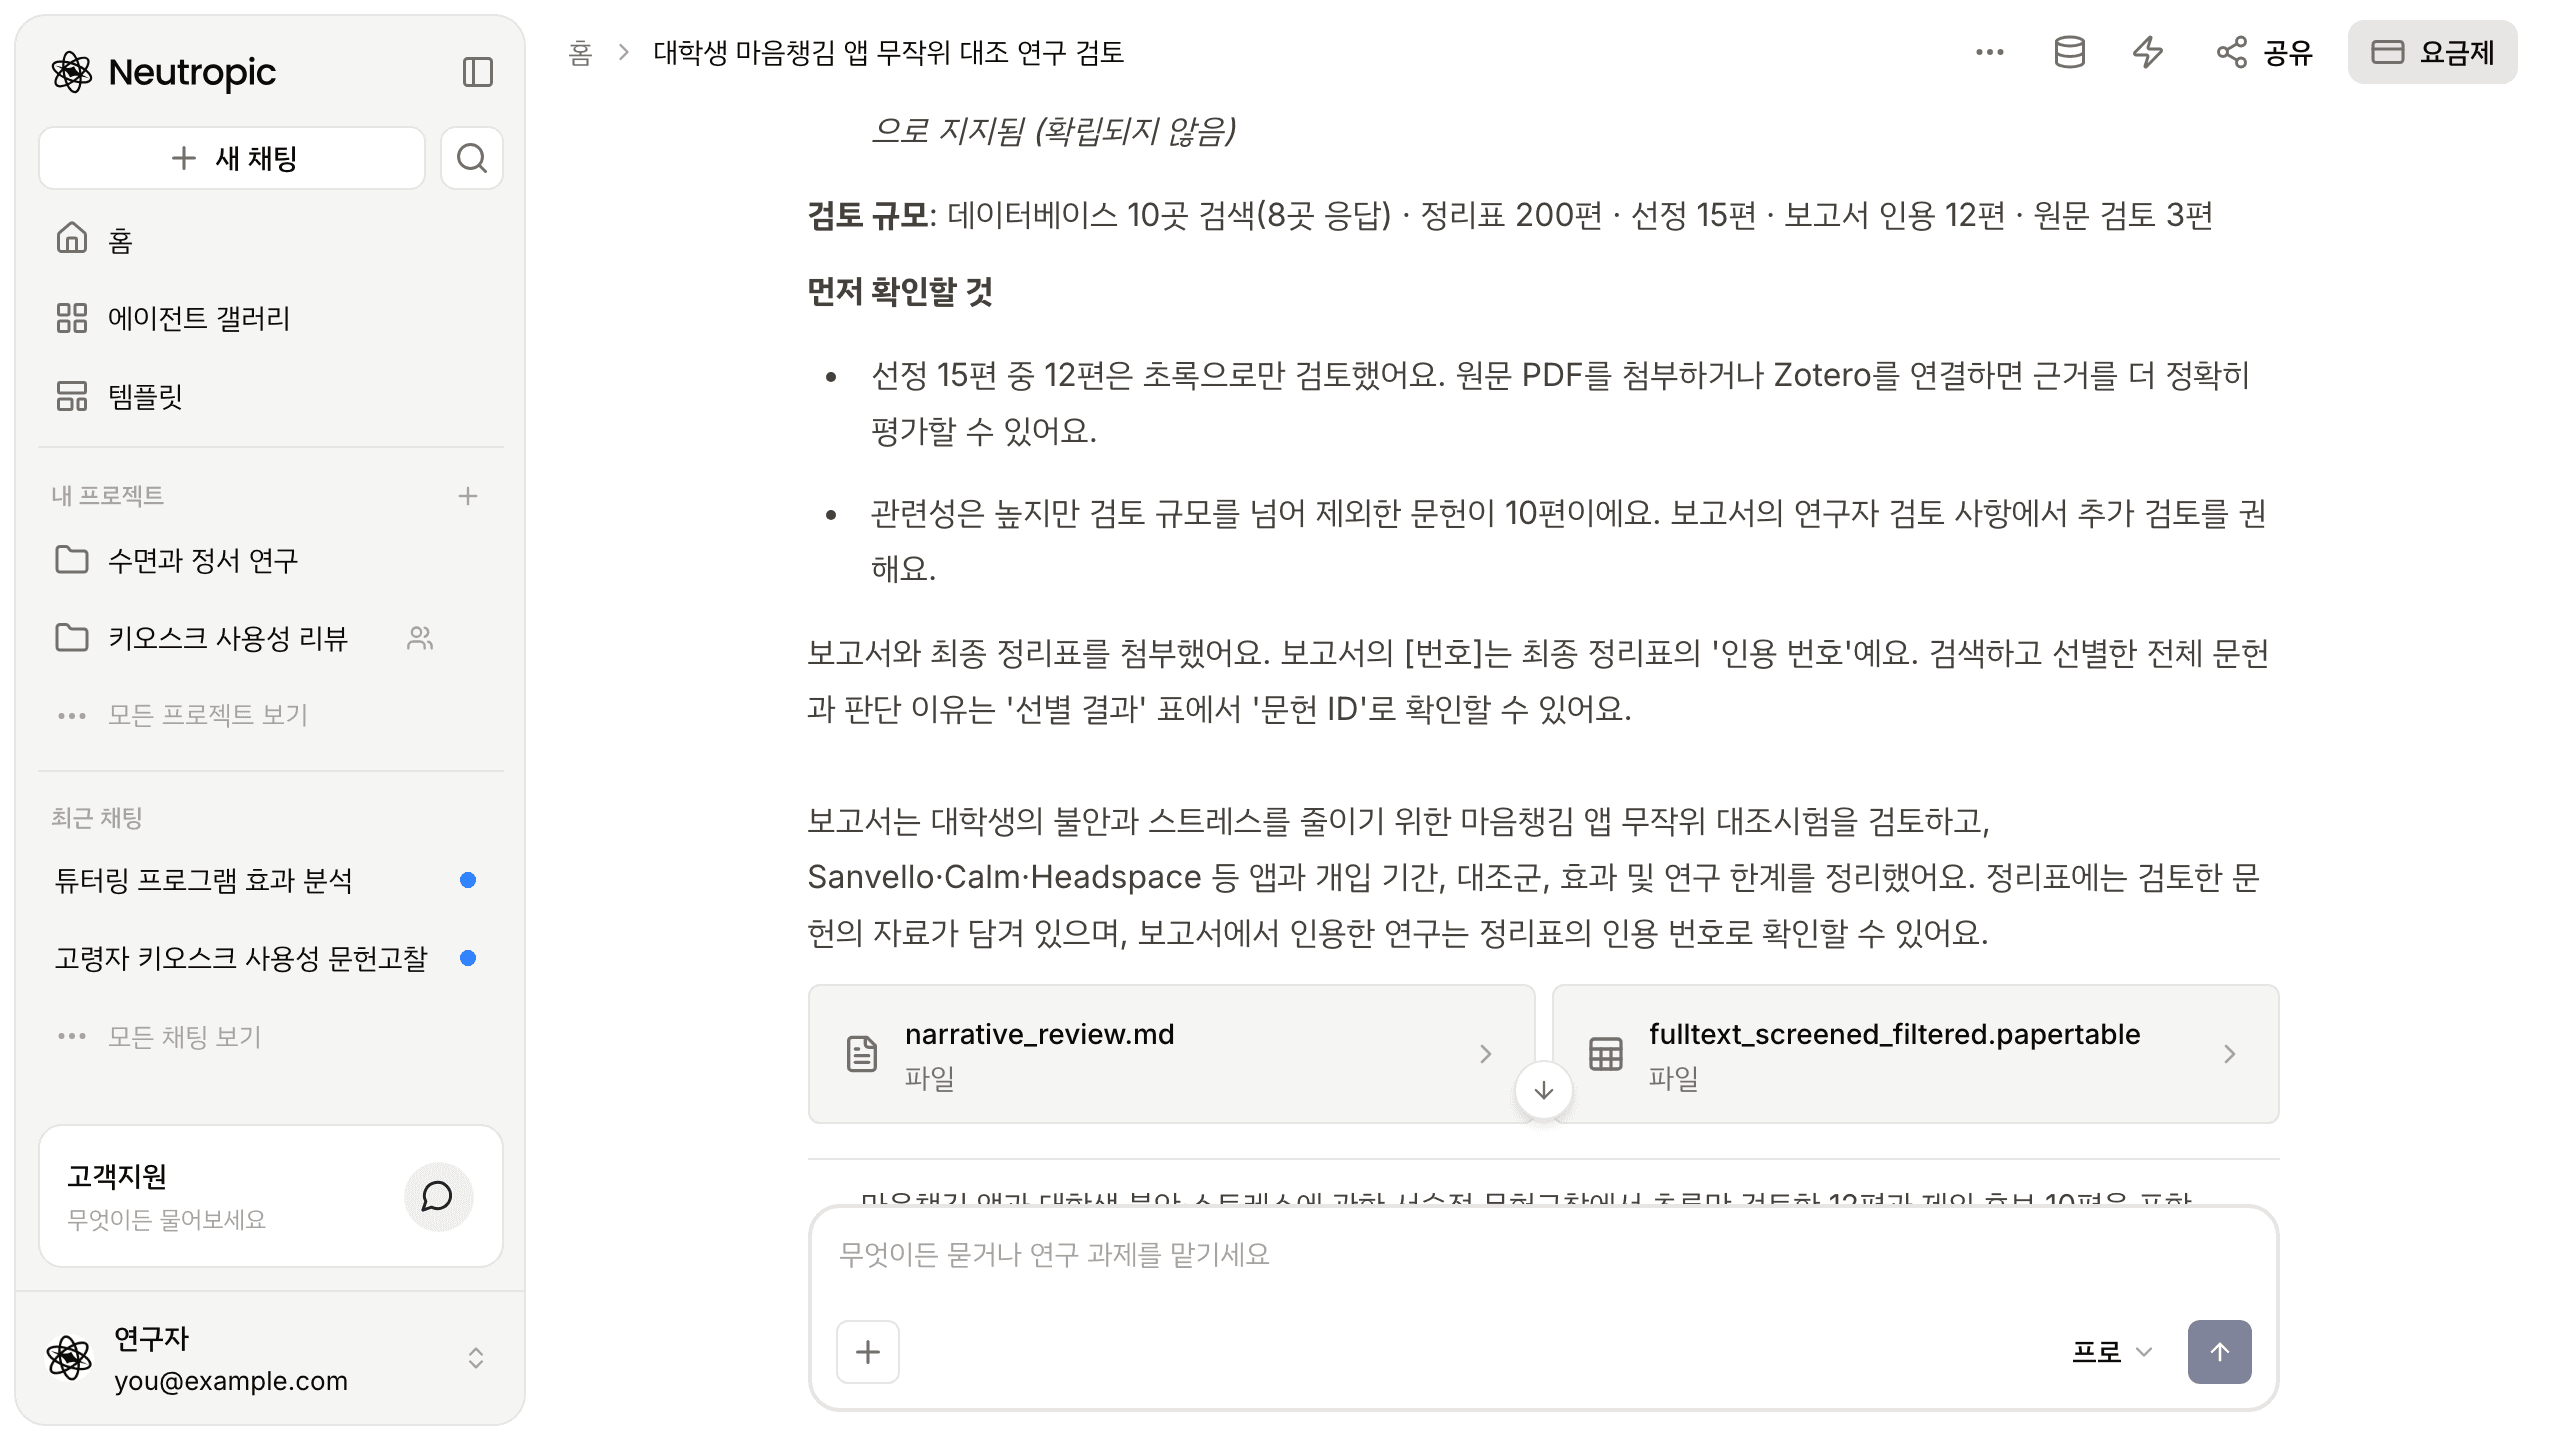
하은 씨가 하마터면 g = 0.85를 그대로 옮겨 적을 뻔했습니다
"효과 크기가 0.85면 꽤 크네. 이걸 근거로 표본 수를 잡으면 되겠다!" 하은 씨는 이 숫자를 연구계획서에 바로 옮기려 했어요. 그런데 검토 규모 줄을 다시 읽어 보면 이야기가 달라집니다. 선정 15편 중 원문을 검토한 건 3편이고, 12편은 초록으로만 검토했어요.
게다가 0.85는 보건의료계열 학생을 대상으로 한 시험 하나에서 나온 값이에요. 하은 씨가 모집할 학부생 전체에 그대로 적용된다고 보기 어렵고, 다른 연구들의 효과는 방향조차 일관되지 않았죠. 그래서 에이전트도 모든 결론에 잠정적으로 지지됨을 붙이고 "현재 확인 가능한 자료만으로 앱의 효과 크기를 확정하기 어렵다"고 적었습니다.
하나 더 있어요. 답에는 Calm 시험이 불안·스트레스 결과의 방향과 수치를 보고하지 않았다고 적혀 있는데, 이 연구는 제목부터 Calm 앱의 스트레스 감소 효능을 검증한 무작위 대조시험이에요. 에이전트가 확인할 수 있었던 자료에서 수치를 찾지 못했다는 뜻이지, 논문에 결과가 없다는 뜻은 아닐 수 있습니다. 이런 문헌은 원문을 직접 확인해야 해요.
보고서와 문헌 정리표가 함께 남았습니다
마지막 9단계에서 보고서가 작성되고 점검을 거쳤어요(통과하지 못한 점검 1개는 보고서의 연구자 검토 사항에 정리). 결과물은 두 가지입니다. 문헌고찰 보고서(narrative_review.md)와, 보고서에서 인용한 12편을 인용 번호 순으로 모은 최종 문헌 정리표예요. 보고서의 [번호]가 정리표의 인용 번호와 이어져 있어서, 문장의 근거를 바로 찾아갈 수 있어요.
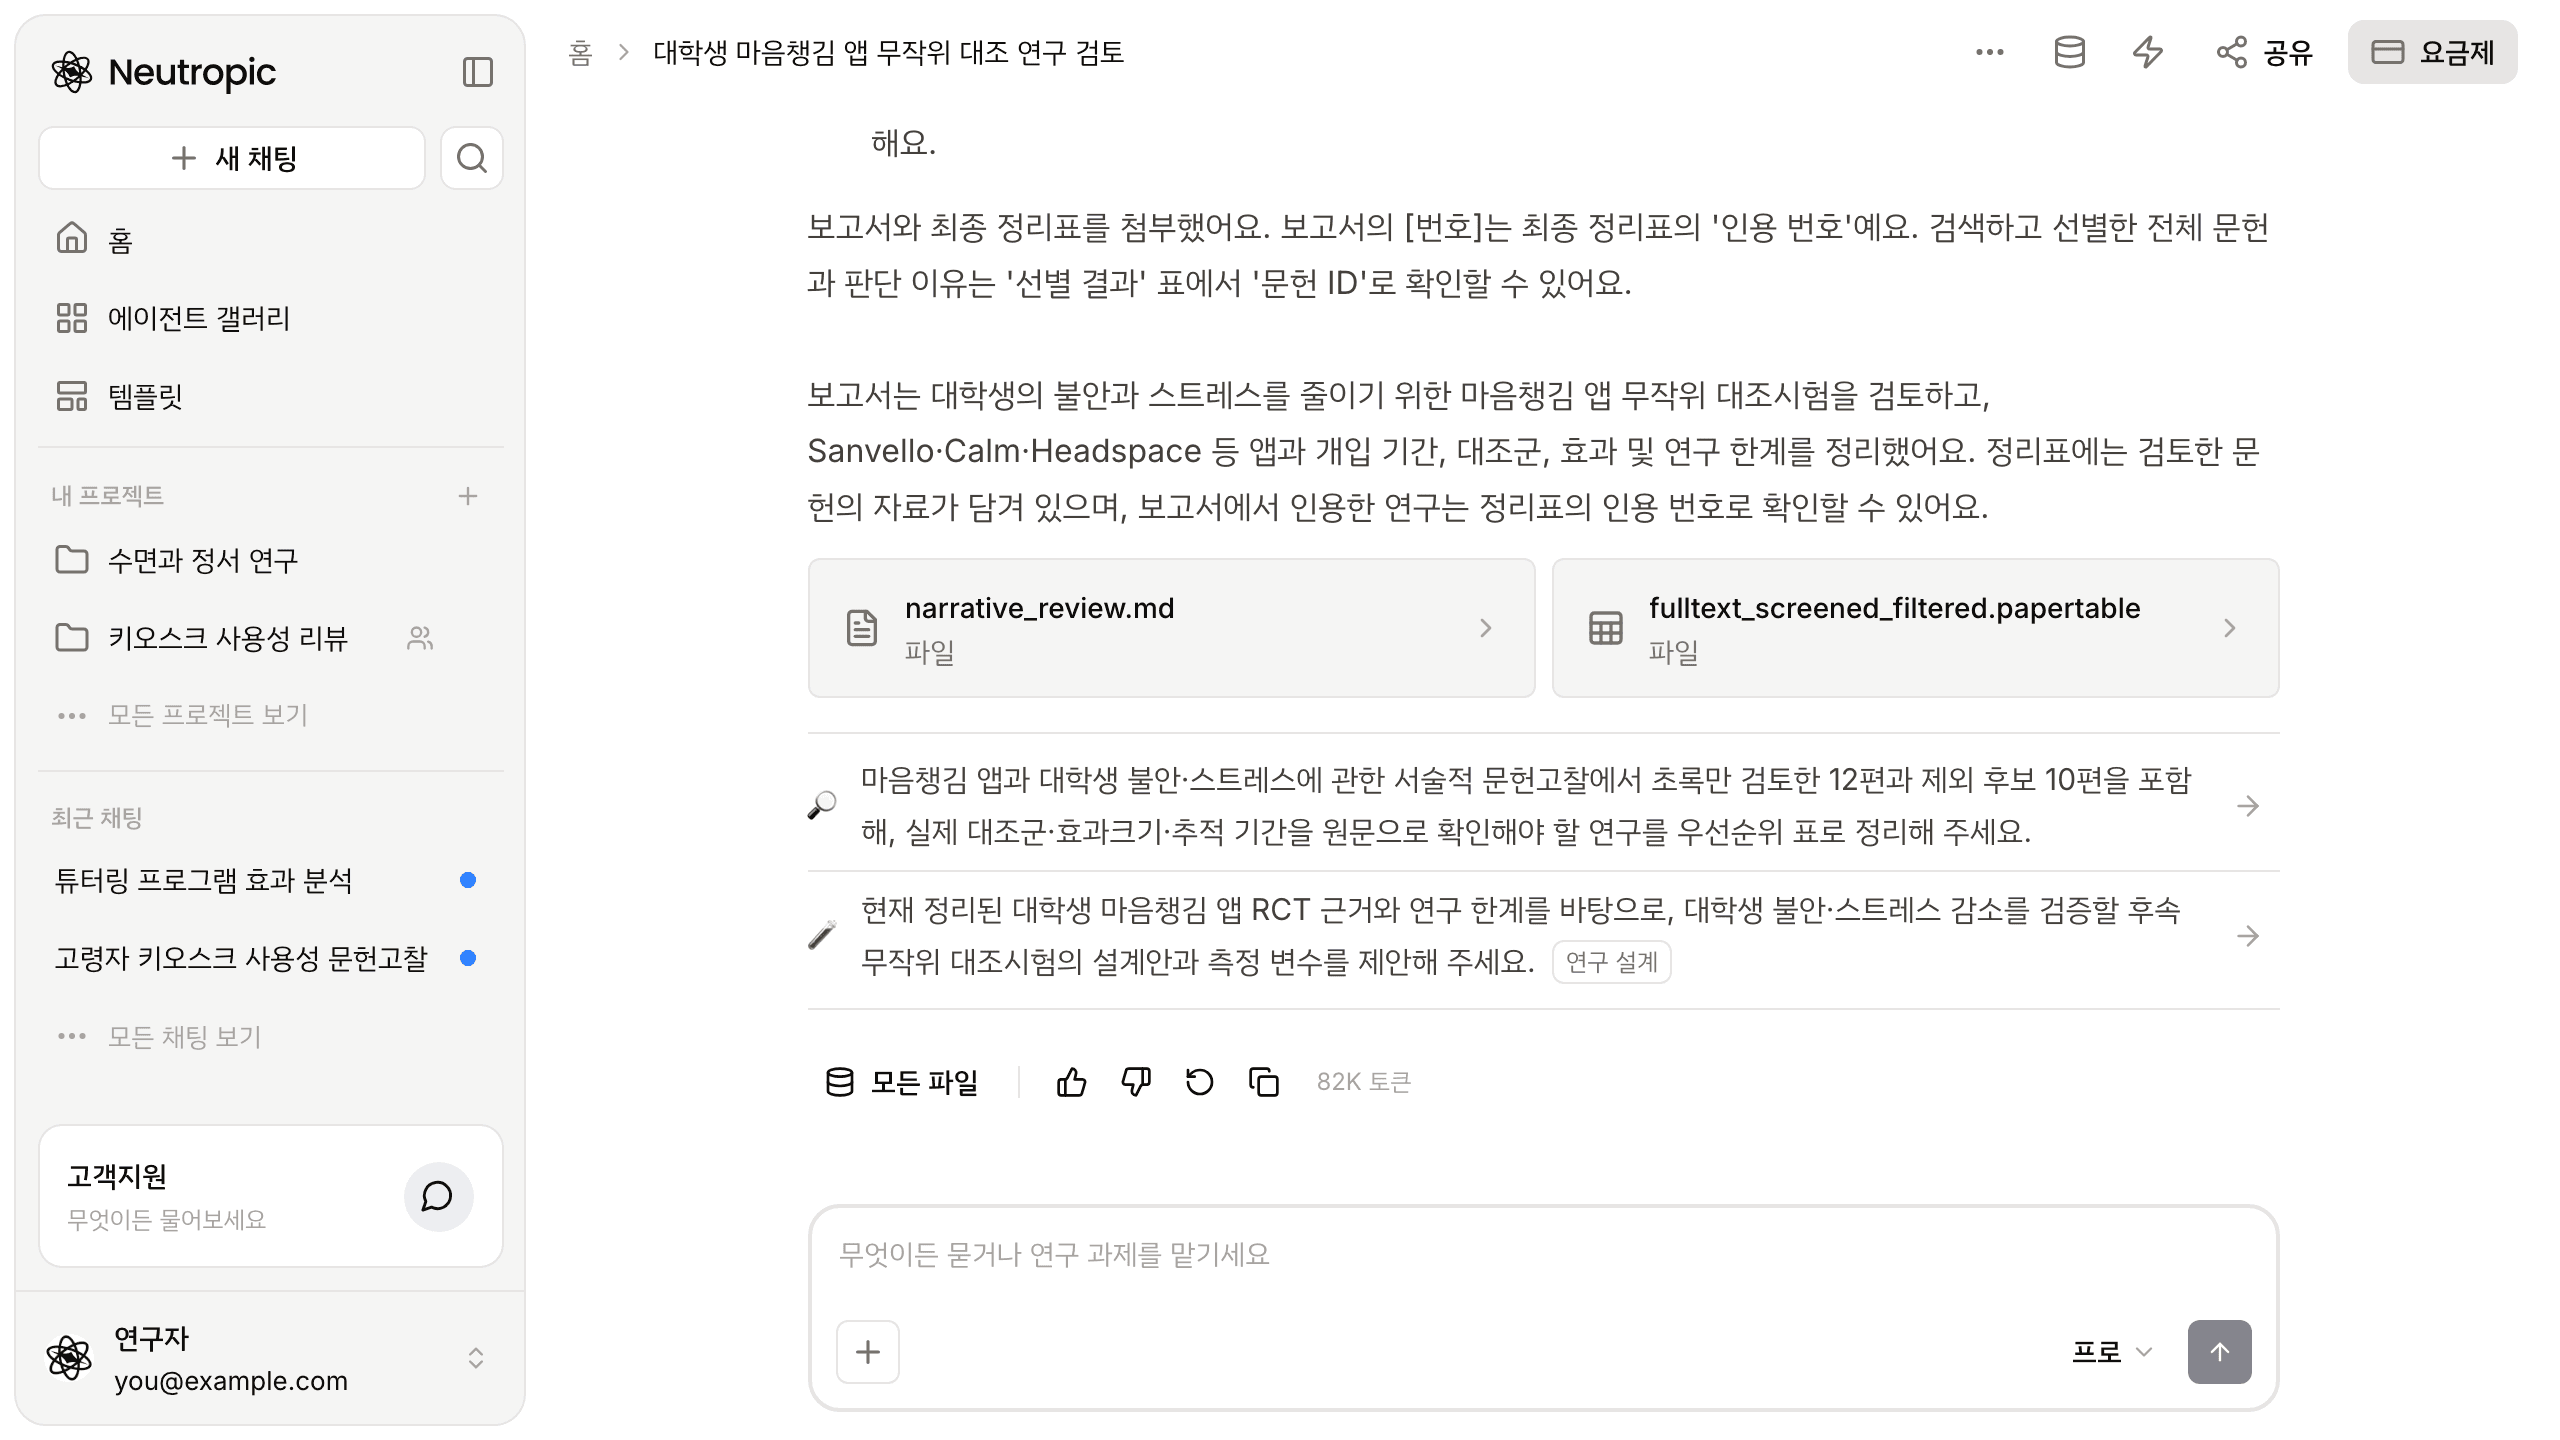
먼저 확인할 것도 두 가지 남았어요. 초록만 검토한 12편은 원문 PDF를 첨부하거나 Zotero를 연결하면 더 정확히 평가할 수 있다는 것, 그리고 규모 때문에 뺀 관련 문헌 10편을 추가로 검토해 보라는 것이요. 답 아래에는 원문으로 확인해야 할 연구를 우선순위 표로 정리하자는 제안과, 이 근거를 바탕으로 후속 무작위 대조시험을 설계하자는 제안(연구 설계 에이전트)이 나란히 있었습니다.
막연한 검색이 근거 강도가 붙은 선행연구 지도가 됐습니다
| 시작할 때 | 지금 | |
|---|---|---|
| 질문 | "앱이 불안을 줄일까?" | 핵심 질문 3개, 개념 5개 |
| 문헌 | 어디서부터 찾을지 모름 | 200편 수집, 15편 선정, 185편 제외 사유 기록 |
| 결론 | "효과 있다던데?" | 근거 강도가 붙은 결론, 모두 잠정적으로 지지됨 |
| 효과 크기 | 감이 오지 않음 | 보고된 값과 보고되지 않은 연구의 구분 |
| 남은 일 | 막막함 | 초록만 본 12편 원문 확인, 제외 후보 10편 검토 |
한계도 적어 둘게요. 15편 중 12편은 초록만 검토했고, 인용 추적은 1회에서 멈춰 포화에 이르지 못했습니다. 검색을 보낸 데이터베이스 10곳 중 응답한 곳은 8곳이었고요. 그래서 이 보고서는 "결론"이라기보다 원문을 확인할 순서를 정해 주는 지도에 가깝습니다. 그래도 수백 편의 검색 결과 앞에서 막막해하는 것과, 왜 남기고 왜 뺐는지 기록된 15편에서 출발하는 건 완전히 다르죠.
이 글은 프로 수준으로 실행했고, 문헌 정리표 최대 200편, 선정 최대 15편, 원문 최대 5편, 인용 추적 1회까지 진행해요. 라이트(무료 요금제)는 정리표 최대 100편, 선정 최대 8편, 원문 최대 2편으로 빠르게 훑어봅니다. 전문가는 정리표 최대 400편, 선정 최대 25편, 원문 최대 10편, 인용 추적 2회까지 늘리고 원고 품질 점검도 한 번 더 해요.
질문 한 문단이면, 근거 강도가 붙은 선행연구 정리표까지 갈 수 있습니다. 숫자를 옮기기 전에 원문을 읽었는지만 꼭 확인하세요.
하은 씨는 이 정리를 바탕으로 실험 설계로 넘어갔어요. 그 과정은 연구 설계 글에서 이어집니다. 이번 주에 하은 씨처럼 범위와 알고 싶은 것을 적어서 물어보세요. 뉴트로픽 무료로 시작하기