안녕하세요, 뉴트로픽 팀입니다!
학위논문 계획서 발표를 2주 앞둔 어느 날, 지도교수님이 이렇게 말씀하셨다고 해 볼게요. "소비자가 뭘 보고 고르는지 알고 싶으면 컨조인트로 해 봐." 대학원에 계신 분이라면 한 번쯤 겪어 보셨을 장면일 것 같은데요. 이름은 들어 봤지만 막상 시작하려니 막막합니다. 강의 영상은 R로, 블로그 예제는 SPSS로 되어 있고, 논문은 공식만 보여 줍니다. 🥲
막막한 이유는 공식이 어려워서가 아니에요. 공식 앞뒤로 정해야 할 것이 줄줄이 이어지기 때문이죠. 어떤 조합을 보여 줄지, 응답자 한 명에게 과제를 몇 개 낼지, 수준을 어떻게 코딩할지, 어떤 모형으로 추정할지, 결과를 어디까지 해석해도 되는지.
이 글에서는 마케팅 전공 석사 과정 서연 씨가 무선 이어폰 컨조인트 분석을 처음 준비하는 과정을 따라가 봅니다. 서연 씨는 가상의 인물이지만, 아래 화면은 모두 뉴트로픽에서 실제로 실행한 채팅이에요.
아는 것을 전부 한 문단에 적었습니다
서연 씨가 정해 둔 건 제품과 속성 네 가지뿐이었어요. 수준을 몇 개로 할지 고민하다가, 일단 생각해 둔 값을 그대로 적어 보냈습니다.
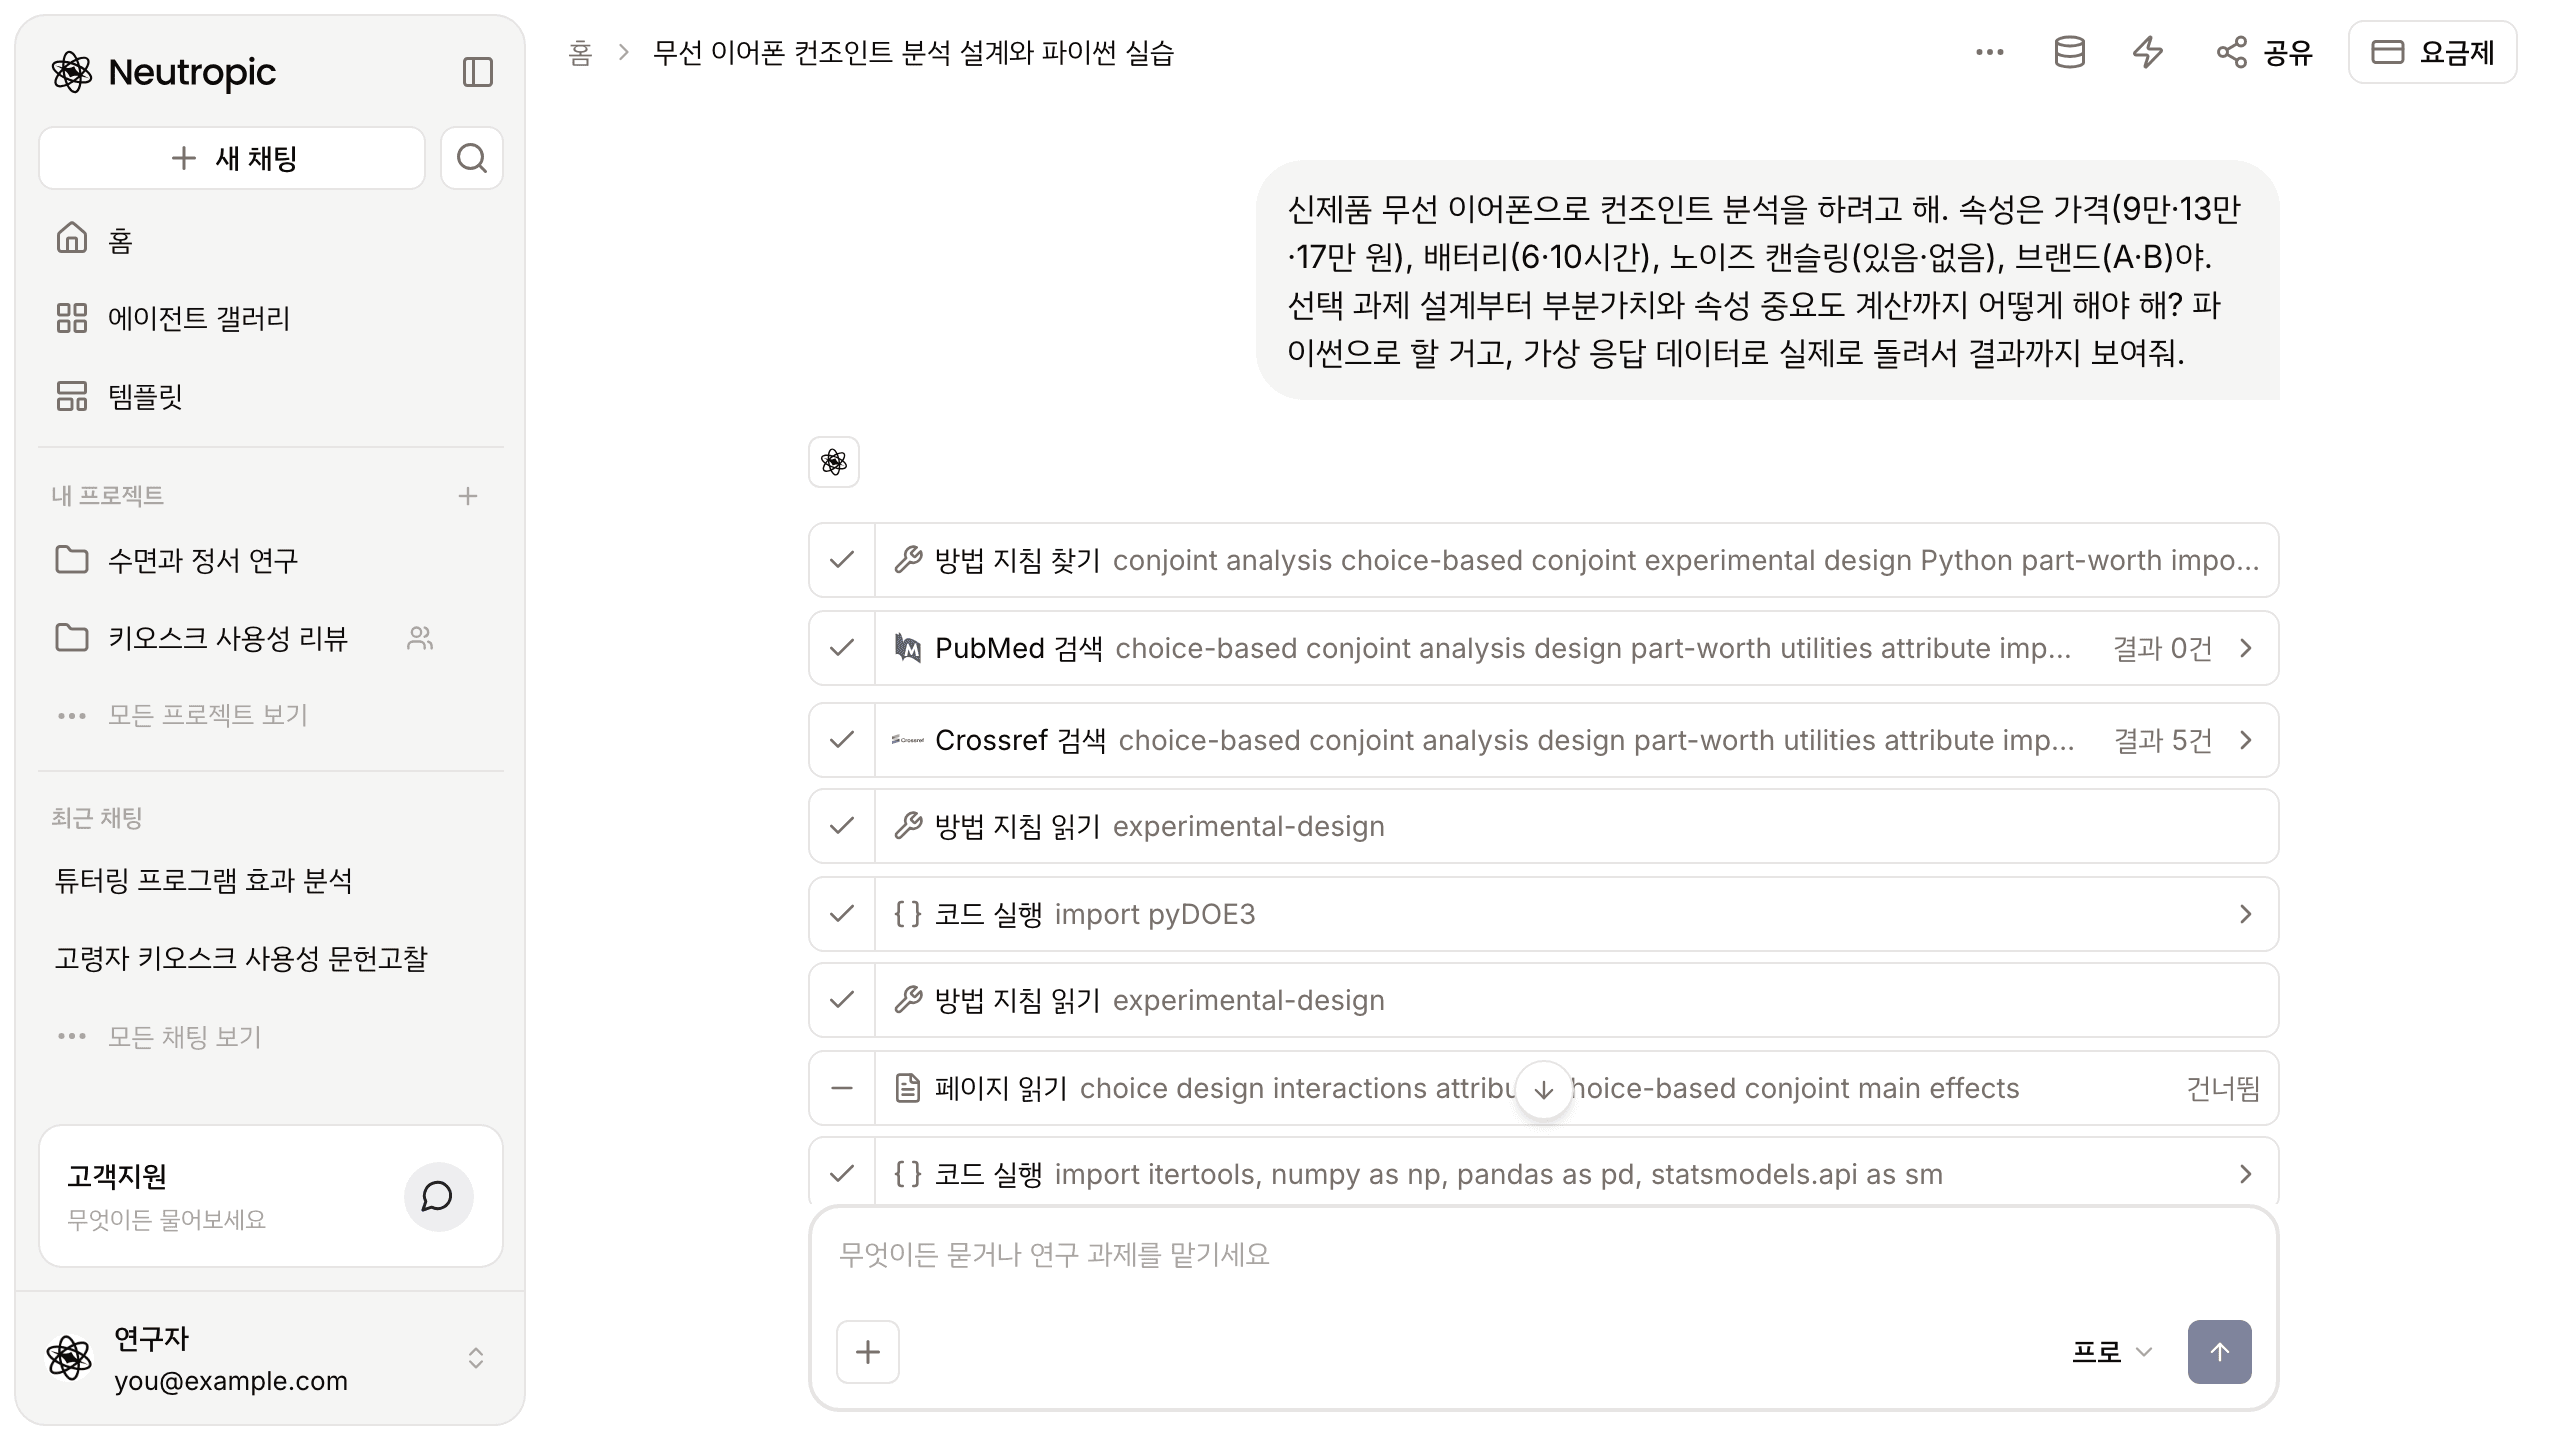
신제품 무선 이어폰으로 컨조인트 분석을 하려고 해. 속성은 가격(9만·13만·17만 원), 배터리(6·10시간), 노이즈 캔슬링(있음·없음), 브랜드(A·B)야. 선택 과제 설계부터 부분가치와 속성 중요도 계산까지 어떻게 해야 해? 파이썬으로 할 거고, 가상 응답 데이터로 실제로 돌려서 결과까지 보여줘.
질문에 들어간 건 세 가지예요. 무엇을 분석하는지(제품, 속성과 수준), 어디까지 원하는지(과제 설계부터 중요도까지), 어떻게 보여 달라는지(파이썬, 가상 데이터로 실제 실행). 특히 마지막 문장이 중요합니다. "실제로 돌려서"라고 적으면 설명으로 끝내지 않고 코드를 실행해 숫자까지 보여 줘요.
답하기 전에 실험 설계 지침부터 읽었습니다
보내자마자 화면에 단계가 하나씩 쌓였어요. 먼저 방법 지침 찾기로 컨조인트에 맞는 지침을 찾고, PubMed와 Crossref에서 관련 문헌을 검색했습니다. 그다음 방법 지침 읽기로 실험 설계 지침을 읽고, 코드 실행으로 분석을 돌렸어요.
방법 지침은 뉴트로픽이 미리 검토해 둔 분석 절차 문서입니다. 모델이 기억에 기대어 바로 답하는 대신, 검증된 절차를 먼저 읽고 그 순서를 따르게 하는 거죠. 단계를 하나씩 눌러 보면 무엇을 검색했고 어떤 코드를 돌렸는지 그대로 확인할 수 있어요.
24개 조합을 12개 과제로 줄였습니다
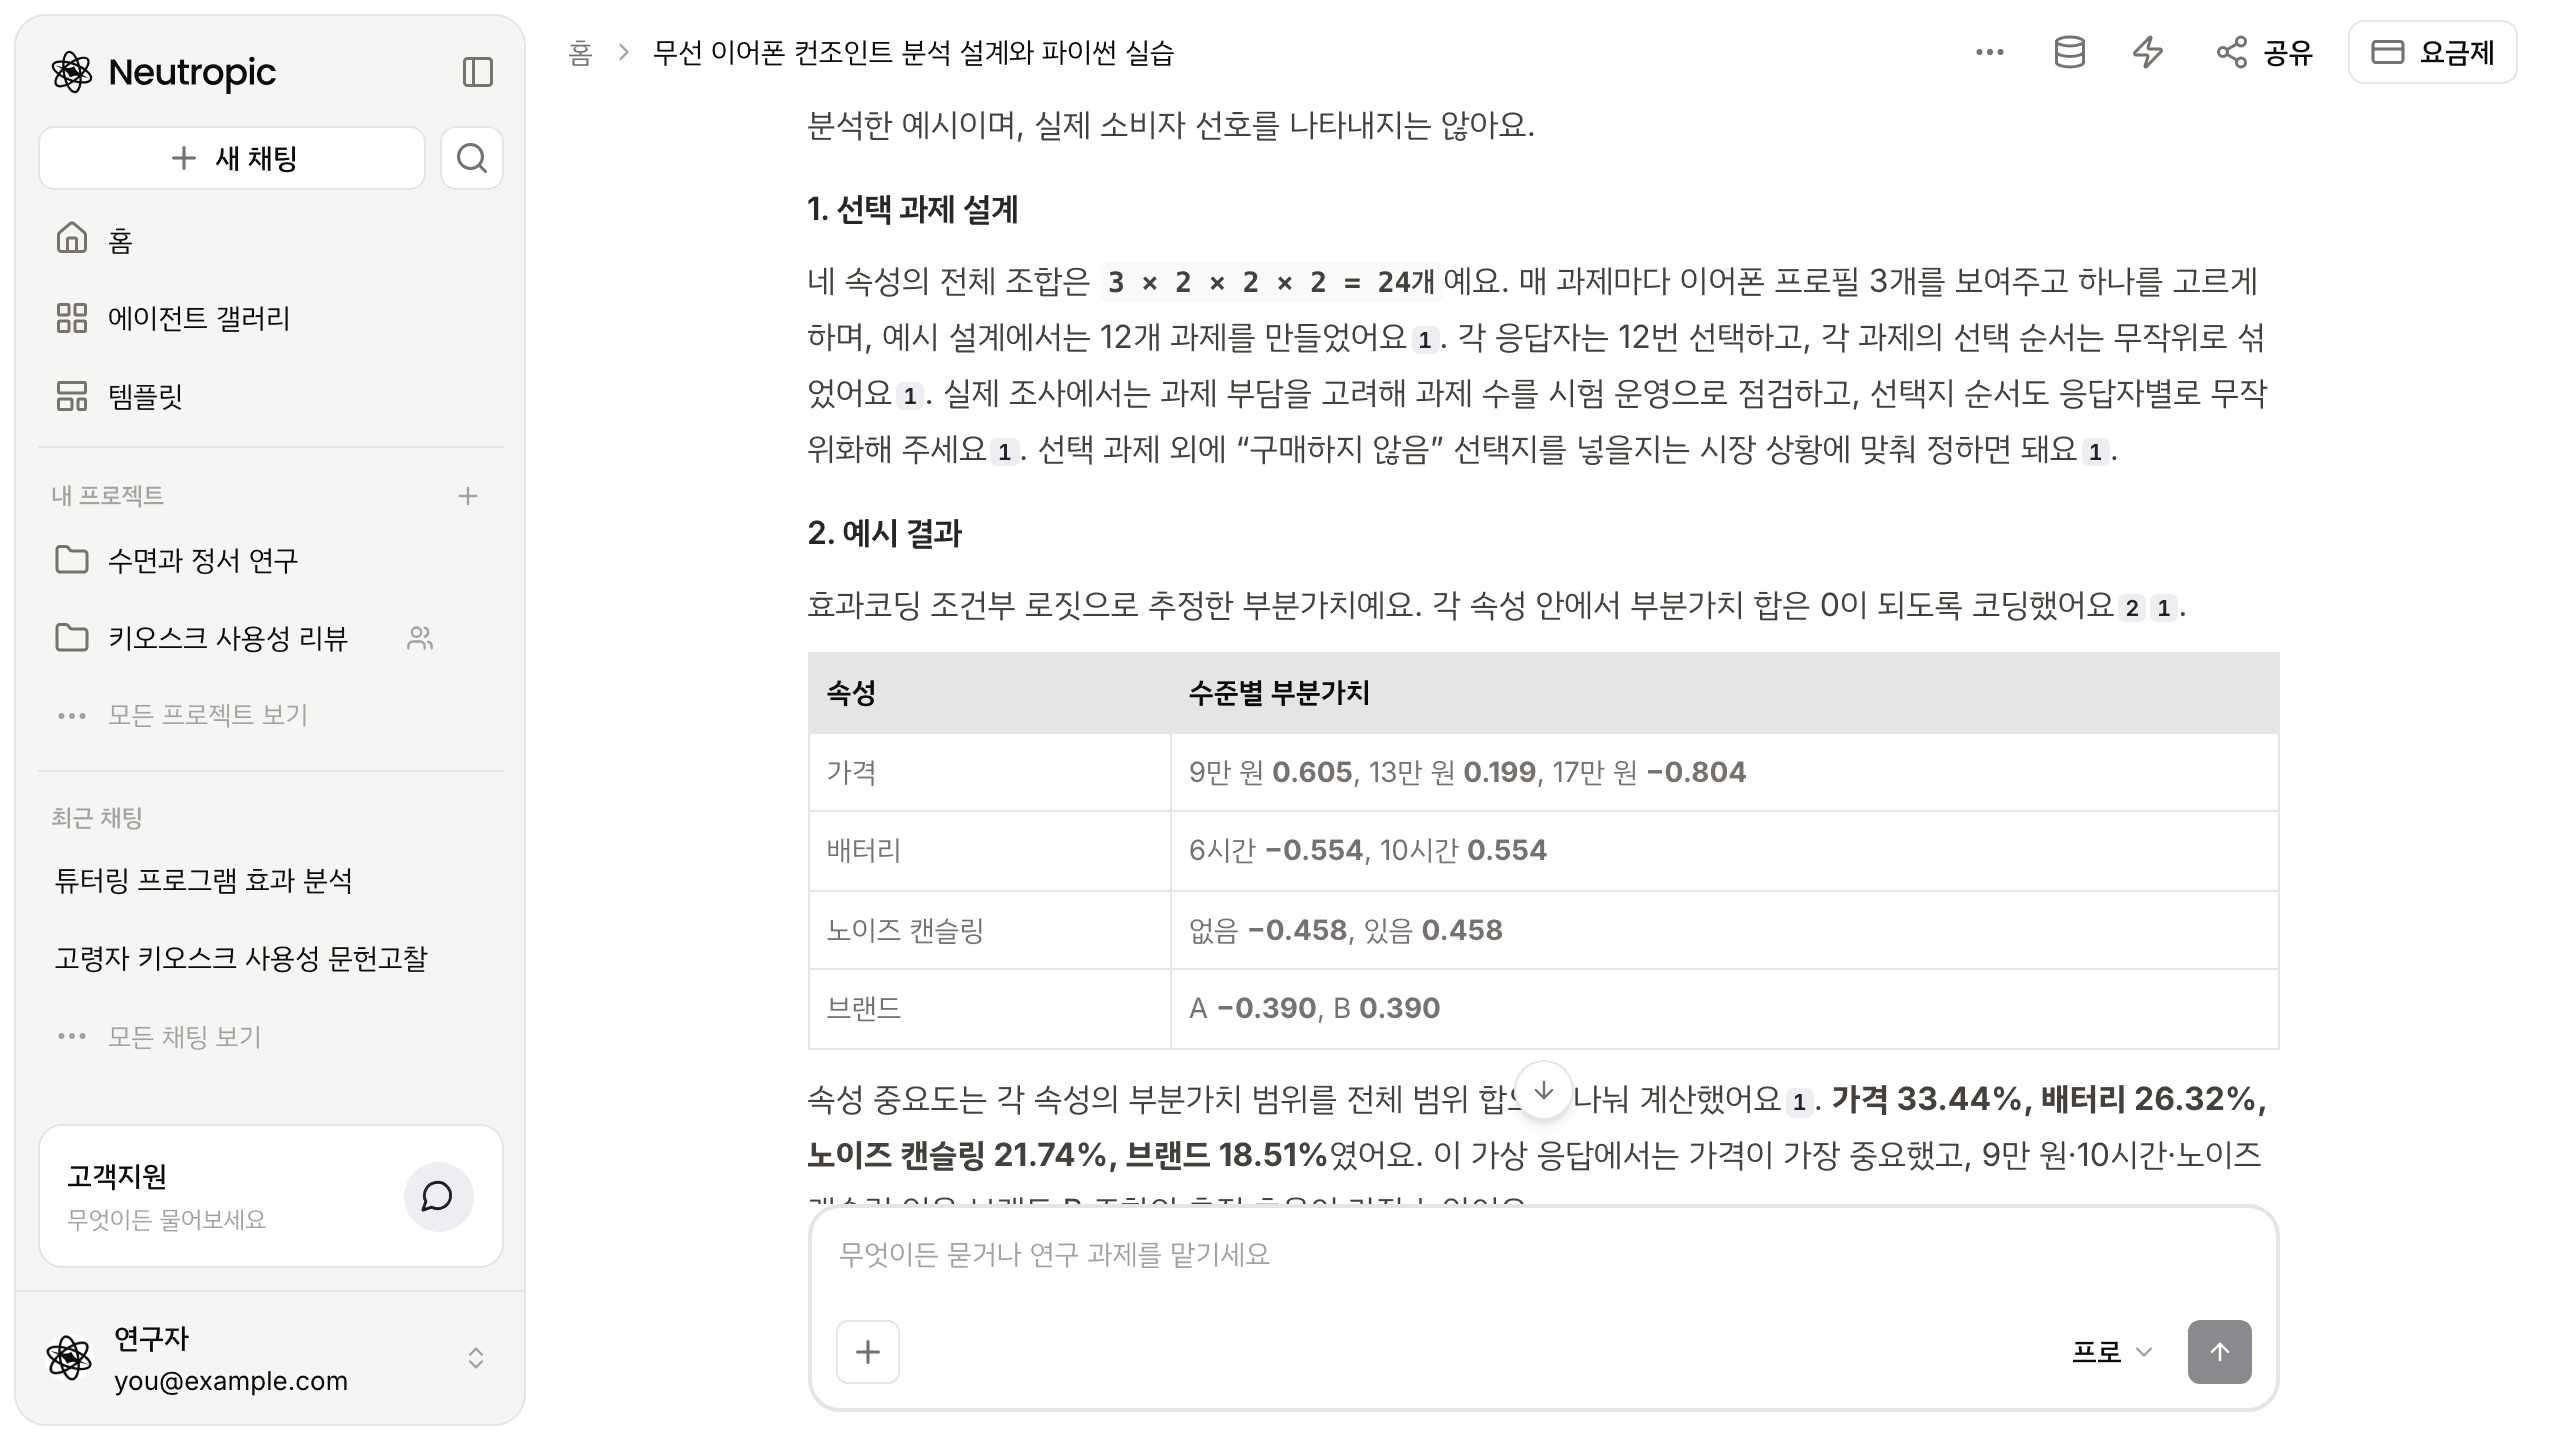
답의 첫 부분은 선택 과제 설계였어요. 네 속성의 수준을 곱하면 3 × 2 × 2 × 2 = 24개 조합이 나옵니다. 응답자에게 24개를 한꺼번에 보여 줄 수는 없으니, 과제마다 이어폰 세 개를 보여 주고 하나를 고르게 하는 과제 12개를 만들었어요.
서연 씨가 미처 생각하지 못한 부분도 짚어 줬습니다.
- 선택지 순서는 응답자마다 무작위로 섞을 것
- 과제 수는 응답자 부담을 고려해 시험 운영(파일럿)으로 확인할 것
- "구매하지 않음" 선택지를 넣을지는 실제 시장 상황에 맞춰 정할 것
가격이 가장 중요하다고 나왔지만, 단서가 붙었습니다
다음은 가상 응답자 300명이 12과제씩 답했다고 가정한 결과예요. 효과코딩 조건부 로짓으로 수준별 부분가치를 추정하고, 속성마다 부분가치 범위를 전체 범위 합으로 나눠 중요도를 구했습니다.
중요도는 가격 33.44%, 배터리 26.32%, 노이즈 캔슬링 21.74%, 브랜드 18.51%였어요. 효용이 가장 높은 조합은 9만 원·10시간·노이즈 캔슬링 있음·브랜드 B였고요.
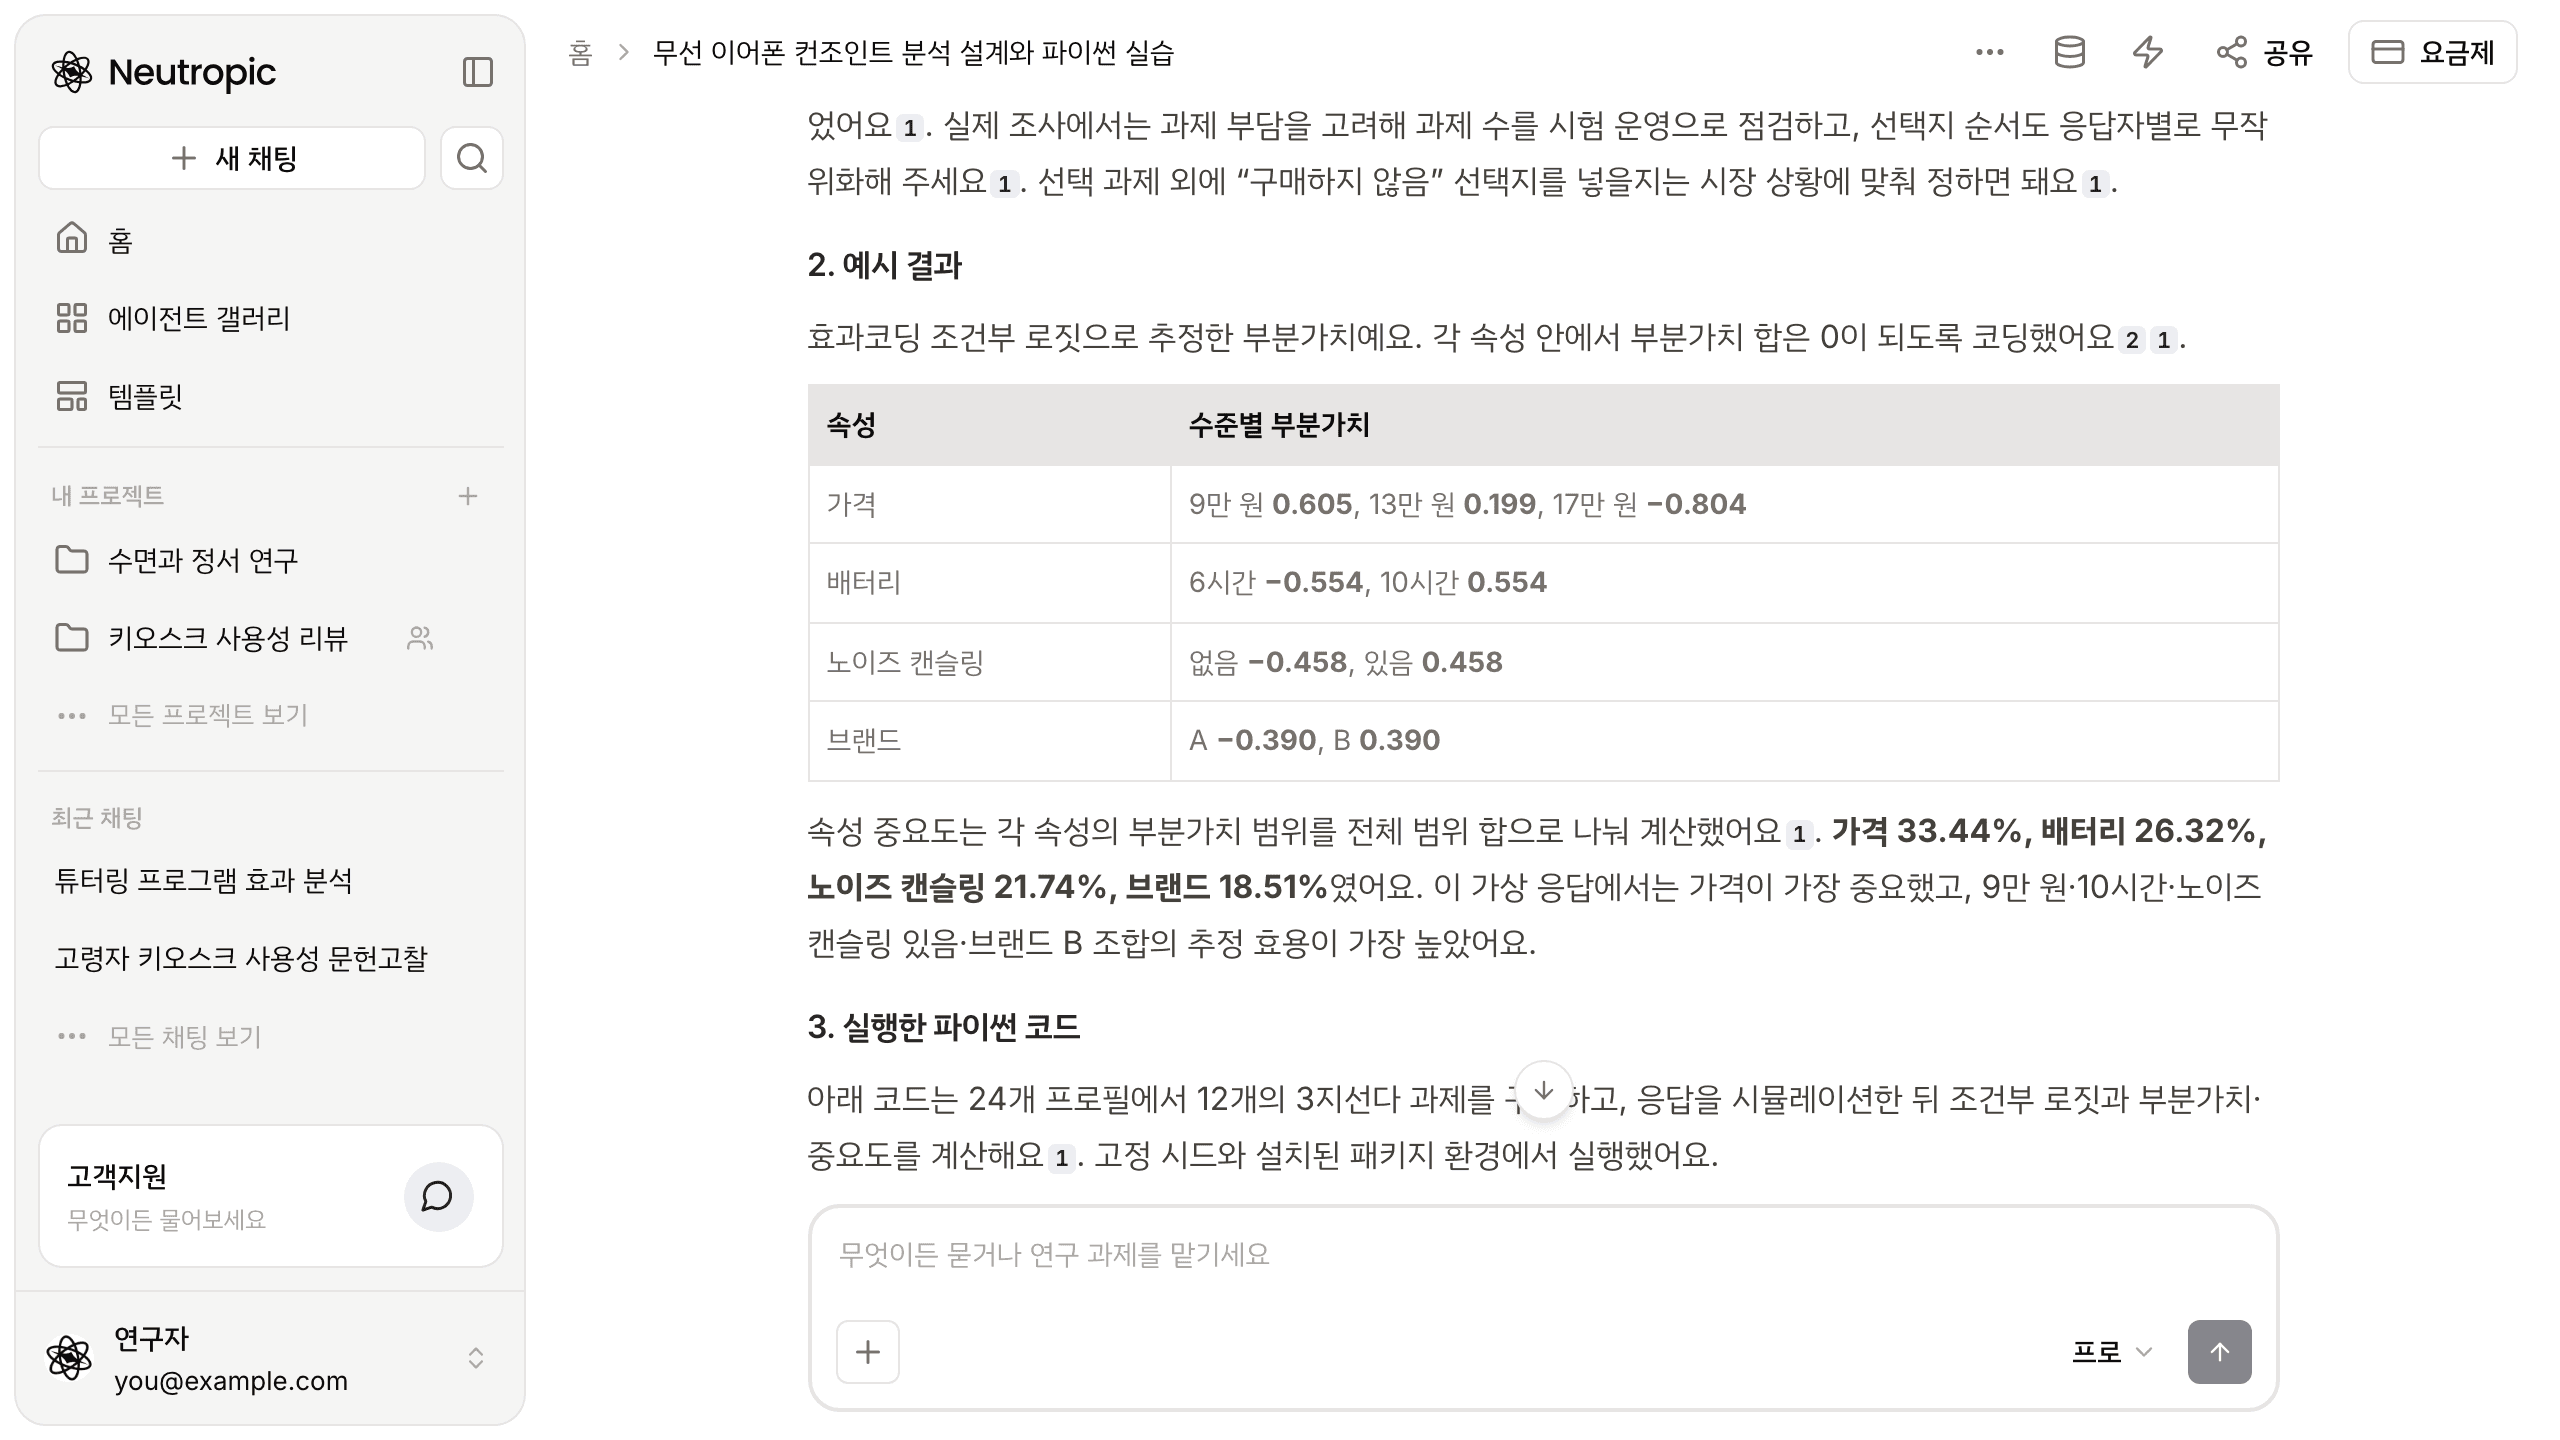
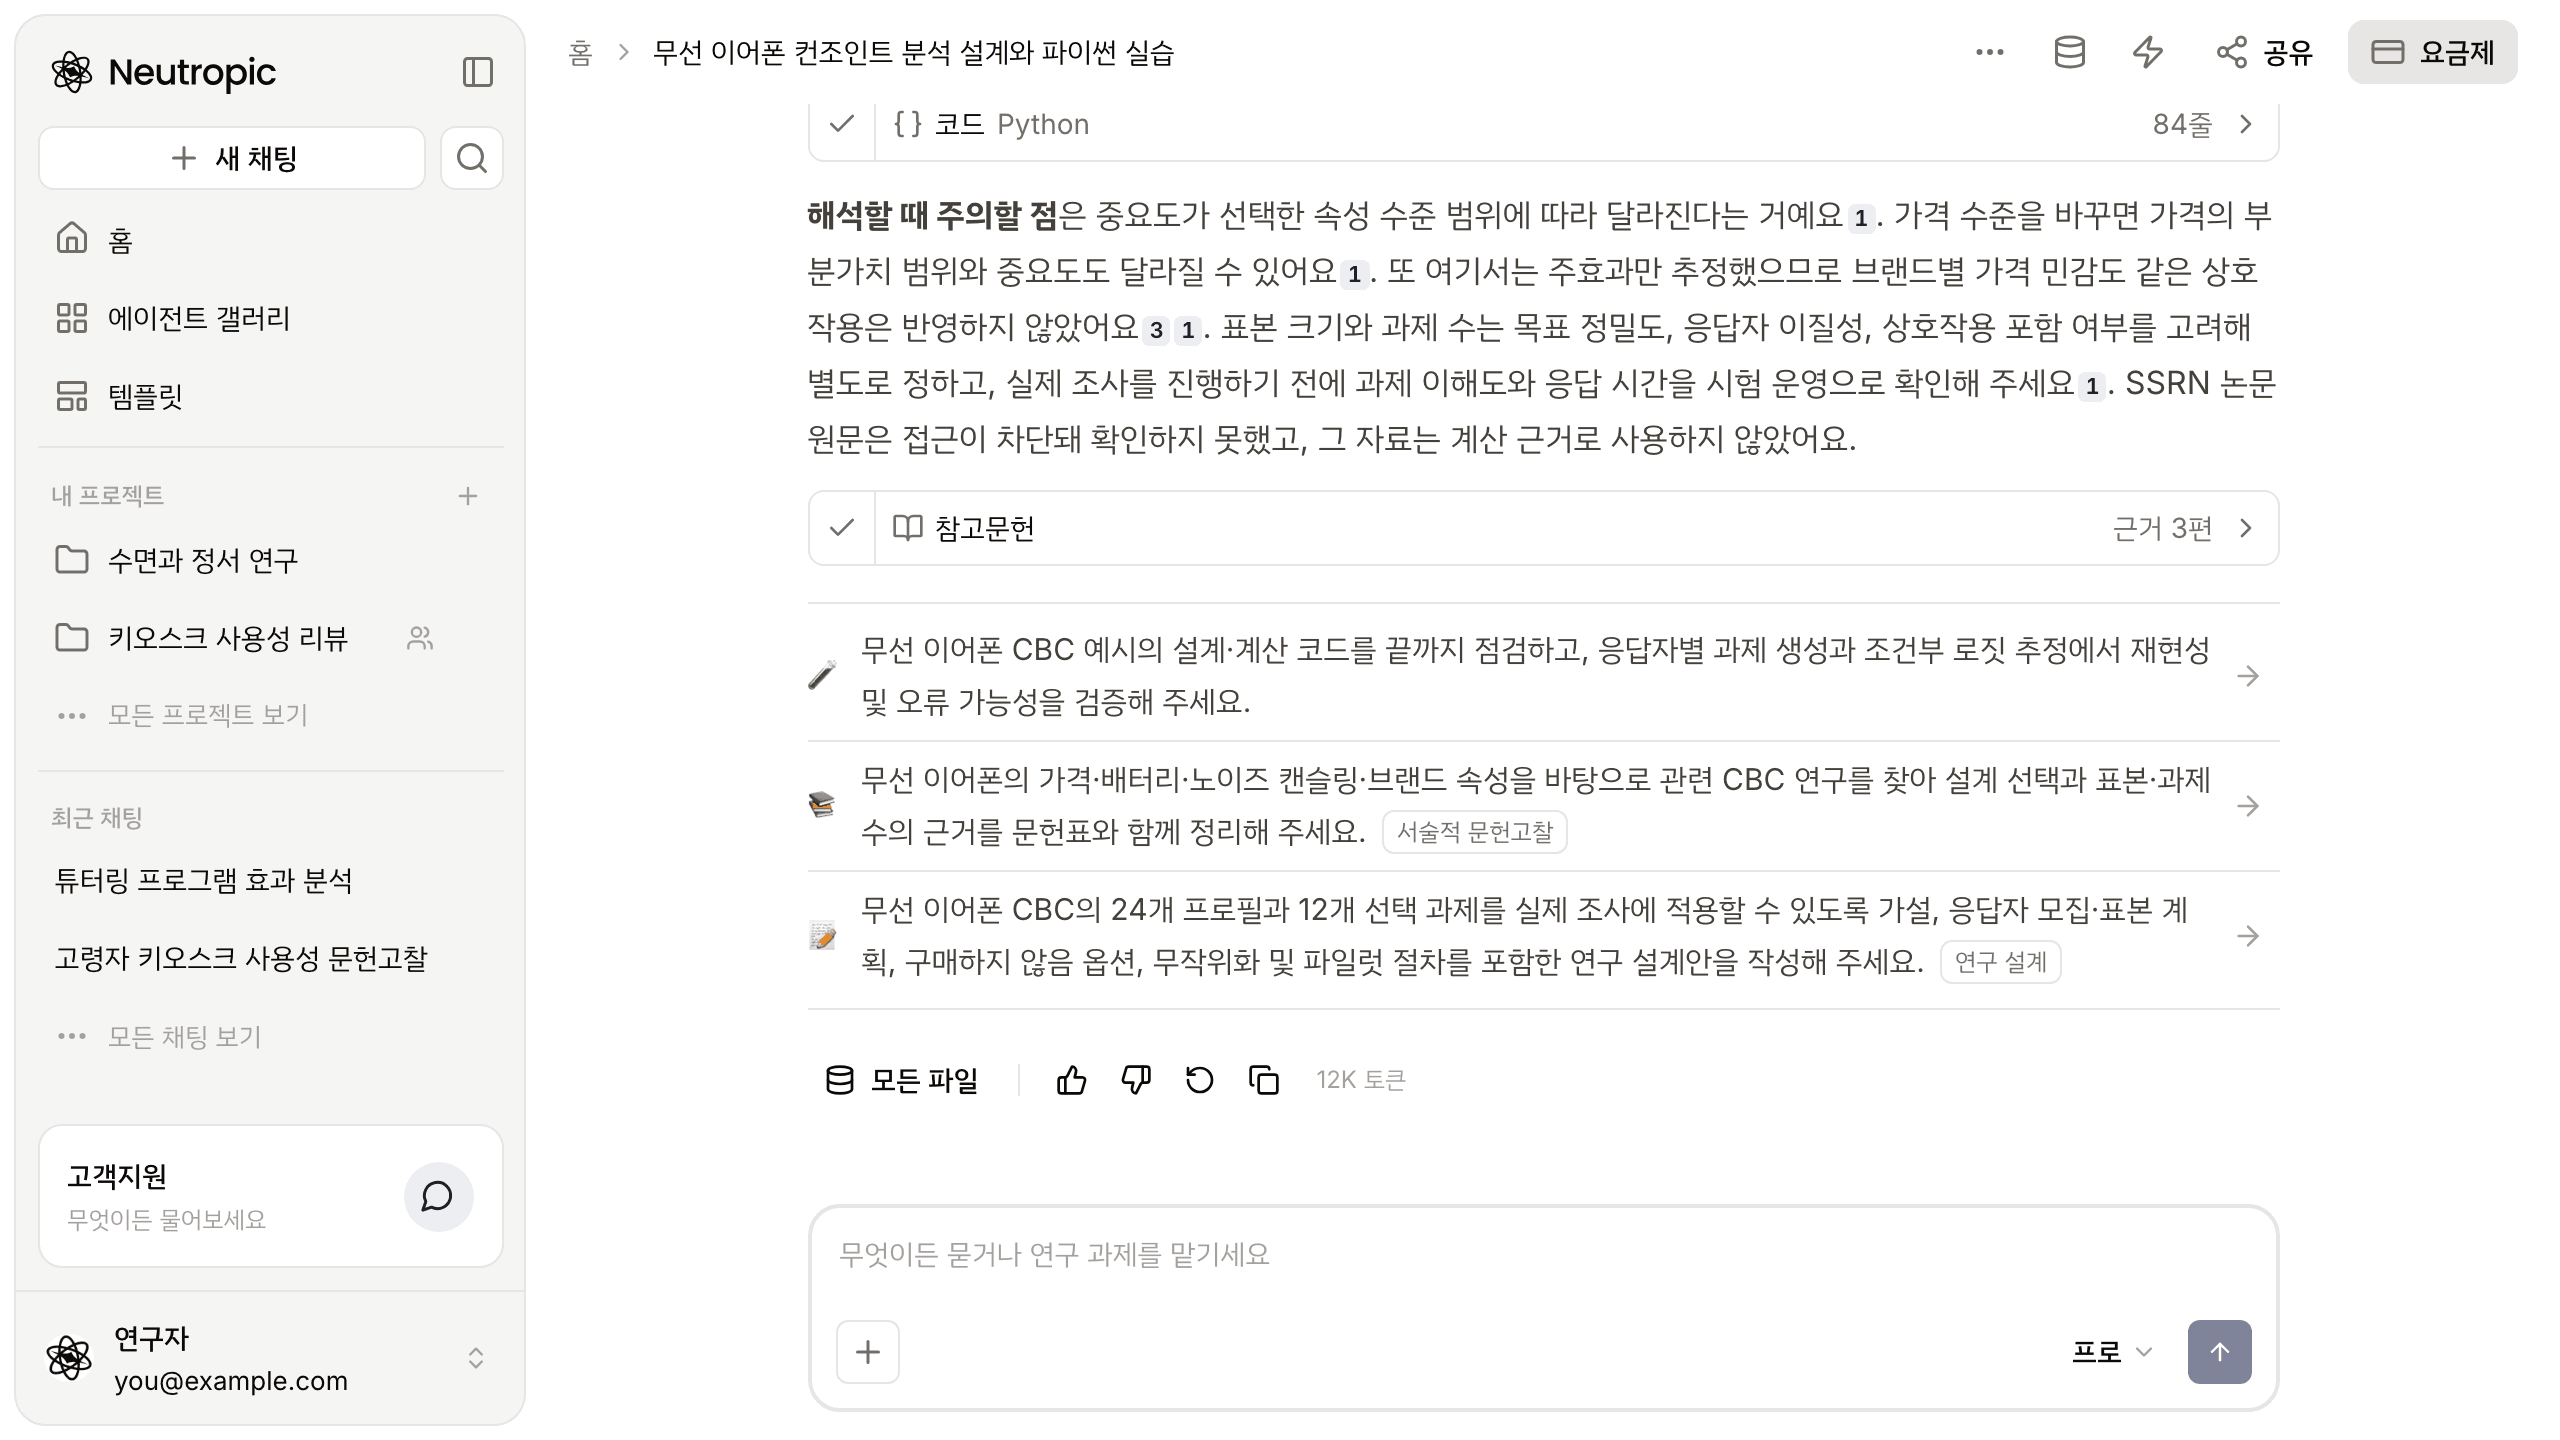
여기서 서연 씨가 하마터면 실수할 뻔했어요. 결과를 보자마자 "소비자는 가격을 가장 중시한다"고 쓰고 싶어지는데, 답은 바로 그 해석을 경계합니다. 중요도는 실험에 넣은 수준의 범위에 따라 달라지기 때문이에요. 가격 범위를 9만~17만 원이 아니라 9만~25만 원으로 넓혔다면 가격은 더 "중요해" 보였을 겁니다.
게다가 이 숫자는 가상 데이터에서 나온 값이라 실제 소비자의 선호가 아니에요. 답에도 그 점이 분명히 적혀 있습니다. 주효과만 추정했기 때문에 브랜드에 따라 가격 민감도가 달라지는 상호작용은 반영되지 않았다는 점도요.
표를 만든 코드를 그대로 받았습니다
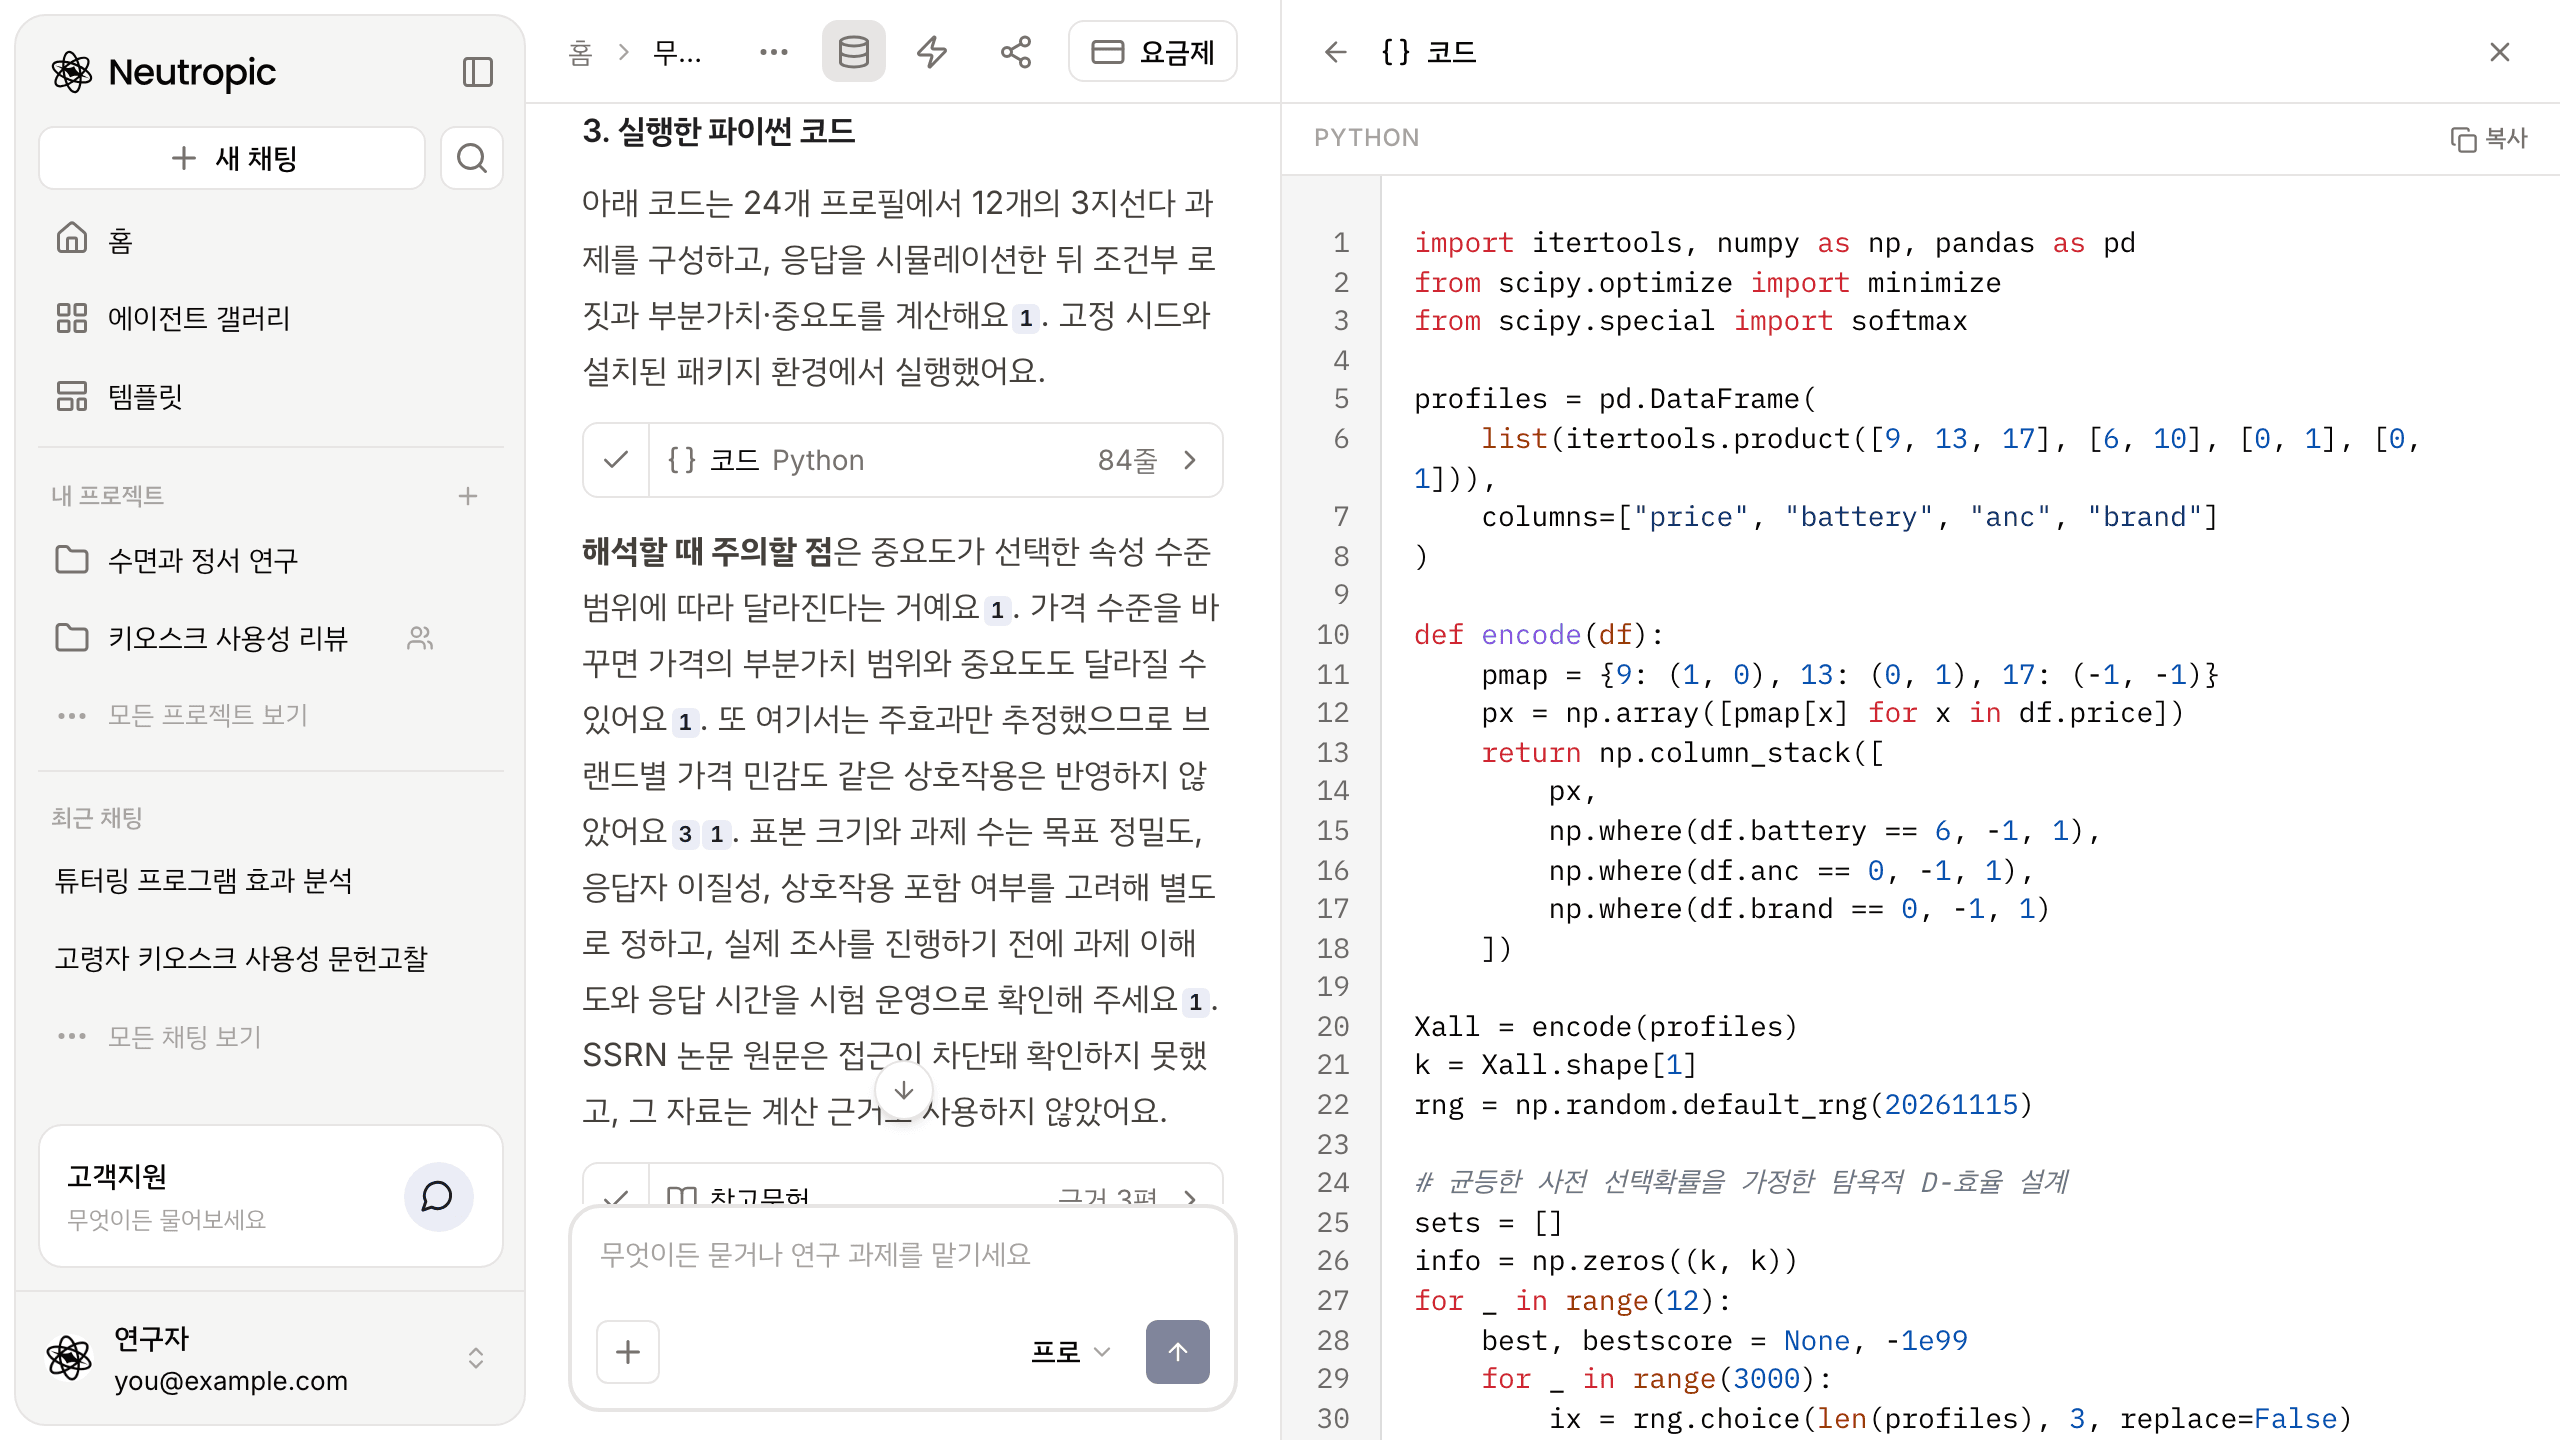
답에는 표를 만든 파이썬 코드 84줄이 그대로 붙어 있었어요. 카드를 누르면 오른쪽 창에 코드가 열리고, 복사 버튼으로 바로 가져갈 수 있습니다. 시드를 고정해 두어서, 그대로 돌리면 표의 숫자가 똑같이 나와요. 저희도 직접 돌려서 확인했습니다. 😎
이게 왜 중요하냐면, 논문 방법 절에는 "어떻게 계산했는가"를 적어야 하기 때문이에요. 숫자만 있고 코드가 없으면 나중에 실제 설문 자료로 다시 돌릴 수가 없죠. 서연 씨는 이 코드에서 가상 응답을 만드는 부분만 실제 자료로 바꾸면 됩니다.
근거로 쓴 문헌도 함께 남았습니다
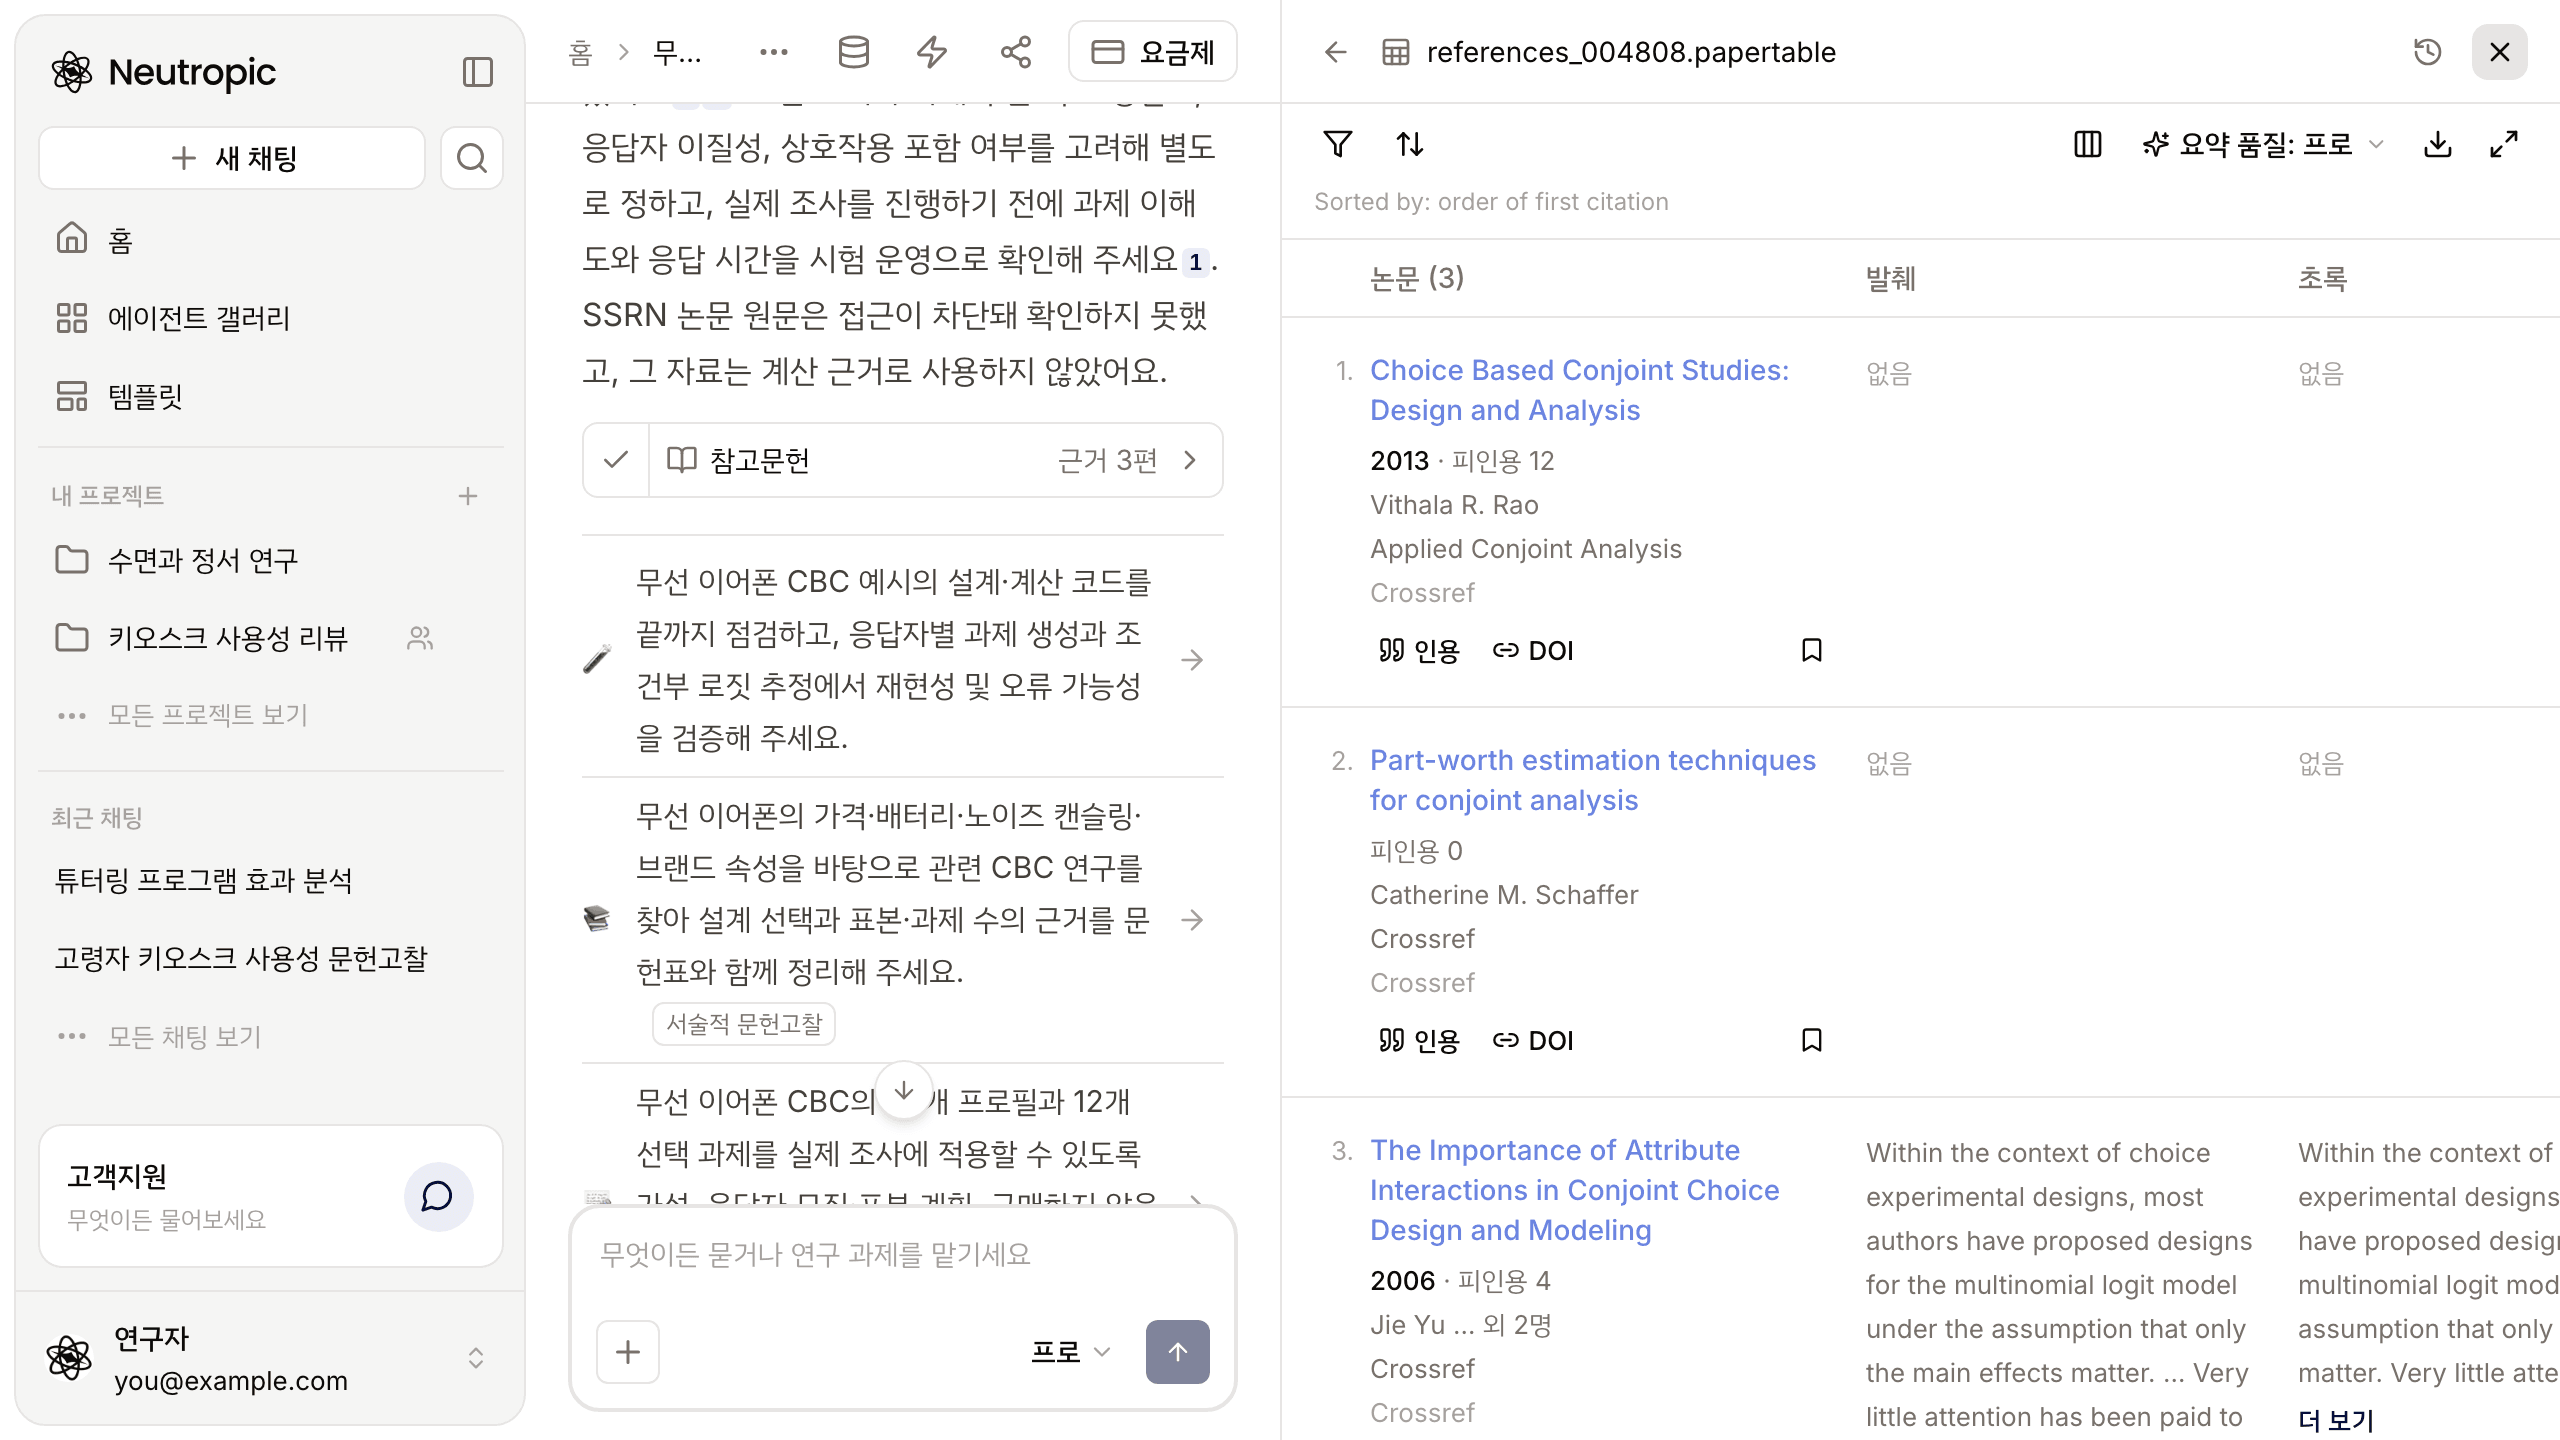
답 문장 끝의 작은 번호는 근거 문헌이에요. 참고문헌 카드를 누르면 실제로 인용한 문헌 3편이 표로 열립니다. 선택형 컨조인트 설계와 분석을 다룬 책의 한 장, 부분가치 추정 기법을 다룬 글, 속성 간 상호작용을 다룬 논문이었어요.
원문에 접근하지 못한 자료는 계산 근거로 쓰지 않았다는 문장도 답에 있었습니다. 이런 표시가 있으면 논문에 옮길 때 어느 주장에 어떤 출처를 붙여야 하는지 헷갈리지 않아요.
다음에 할 일까지 제안받았습니다
답 맨 아래에는 이어서 할 일 세 가지가 제안돼 있었어요.
- 이번 코드를 끝까지 점검해 재현성과 오류 가능성을 검증하기
- 비슷한 선택형 컨조인트 연구를 찾아 문헌표로 정리하기 — 서술적 문헌고찰 에이전트
- 실제 조사에 쓸 가설, 표본 계획, 무작위화, 파일럿 절차를 담은 연구 설계안 쓰기 — 연구 설계 에이전트
누르면 같은 대화에서 바로 이어집니다. 계획서 발표가 2주 남은 서연 씨라면 아마 세 번째부터 누르겠죠.
막막했던 질문이 돌려 볼 수 있는 분석이 됐습니다
| 시작할 때 | 지금 | |
|---|---|---|
| 설계 | 속성 네 개만 정해 둠 | 24개 조합, 과제당 세 개, 과제 12개 |
| 분석 방법 | 컨조인트라는 이름만 앎 | 효과코딩 조건부 로짓, 범위 기반 중요도 |
| 결과 | 없음 | 가상 응답 300명의 부분가치·중요도 표 |
| 코드 | R·SPSS 예제를 찾아다님 | 그대로 재현되는 파이썬 코드 |
| 근거 | 무엇부터 읽어야 할지 모름 | 인용 문헌 3편과 다음 단계 제안 |
물론 가상 데이터로 해 본 예행연습이에요. 결론은 실제 설문 자료를 넣고 내려야 하고, 선호가 사람마다 크게 다르면 혼합 로짓이나 잠재 계층 모형도 함께 검토해야 합니다. 그래도 빈 화면에서 시작하는 것과 돌아가는 코드에서 시작하는 건 완전히 다르죠.
이 글은 프로 수준으로 실행했어요. 라이트(무료 요금제)는 시뮬레이션 없이 핵심 절차와 공식을 알려 주고, 전문가는 여기에 대안 모형 비교와 가정에 대한 민감도 점검을 더합니다.
지도교수님이 "컨조인트로 해 봐"라고 하셨다면, 질문 한 문단으로 첫 분석까지 가 볼 수 있습니다.
이번 주에 서연 씨처럼 아는 것만 적어서 물어보세요. 뉴트로픽 무료로 시작하기