안녕하세요, 뉴트로픽 팀입니다!
참가자 한 사람을 여러 번 측정한 자료를 받아 들고, 지도교수님께 "이건 계층모형으로 봐야지, 베이지안으로 PyMC 한번 써 봐"라는 말을 들었다고 해 볼게요. 반복측정 분산분석까지는 해 봤는데, 계층모형은 처음이고 베이지안은 더 처음입니다. 예제 노트북을 열면 사전분포, 체인, 발산 같은 낯선 단어가 한꺼번에 쏟아지죠. 🥲
사실 모형 자체는 생각보다 짧아요. 어려운 건 그다음입니다. 체인이 제대로 섞였는지, 발산이 왜 나왔는지, 모형이 자료를 제대로 재현하는지 확인하지 않고 숫자를 읽으면 그럴듯한 오답이 나옵니다.
이 글에서는 심리학 박사과정 지훈 씨가 반복측정 자료에 PyMC 계층모형을 처음 세워 보는 과정을 따라가 봅니다. 지훈 씨는 가상의 인물이지만, 아래 화면은 모두 뉴트로픽에서 실제로 실행한 채팅이에요.
질문은 한 줄이었습니다
지훈 씨는 자료를 올리기 전에 큰 그림부터 잡고 싶었어요. 그래서 이렇게만 물었습니다.
반복측정 자료에 PyMC로 베이지안 계층모형을 세우고 점검하려면 어떻게 해야 해?
짧지만 필요한 건 다 들어 있어요. 도구(PyMC), 자료 구조(반복측정), 그리고 동사 두 개입니다. "세우고"만 적었다면 모형 코드로 끝났을 텐데, "점검하려면"을 붙인 덕분에 답이 진단 순서까지 이어졌어요.
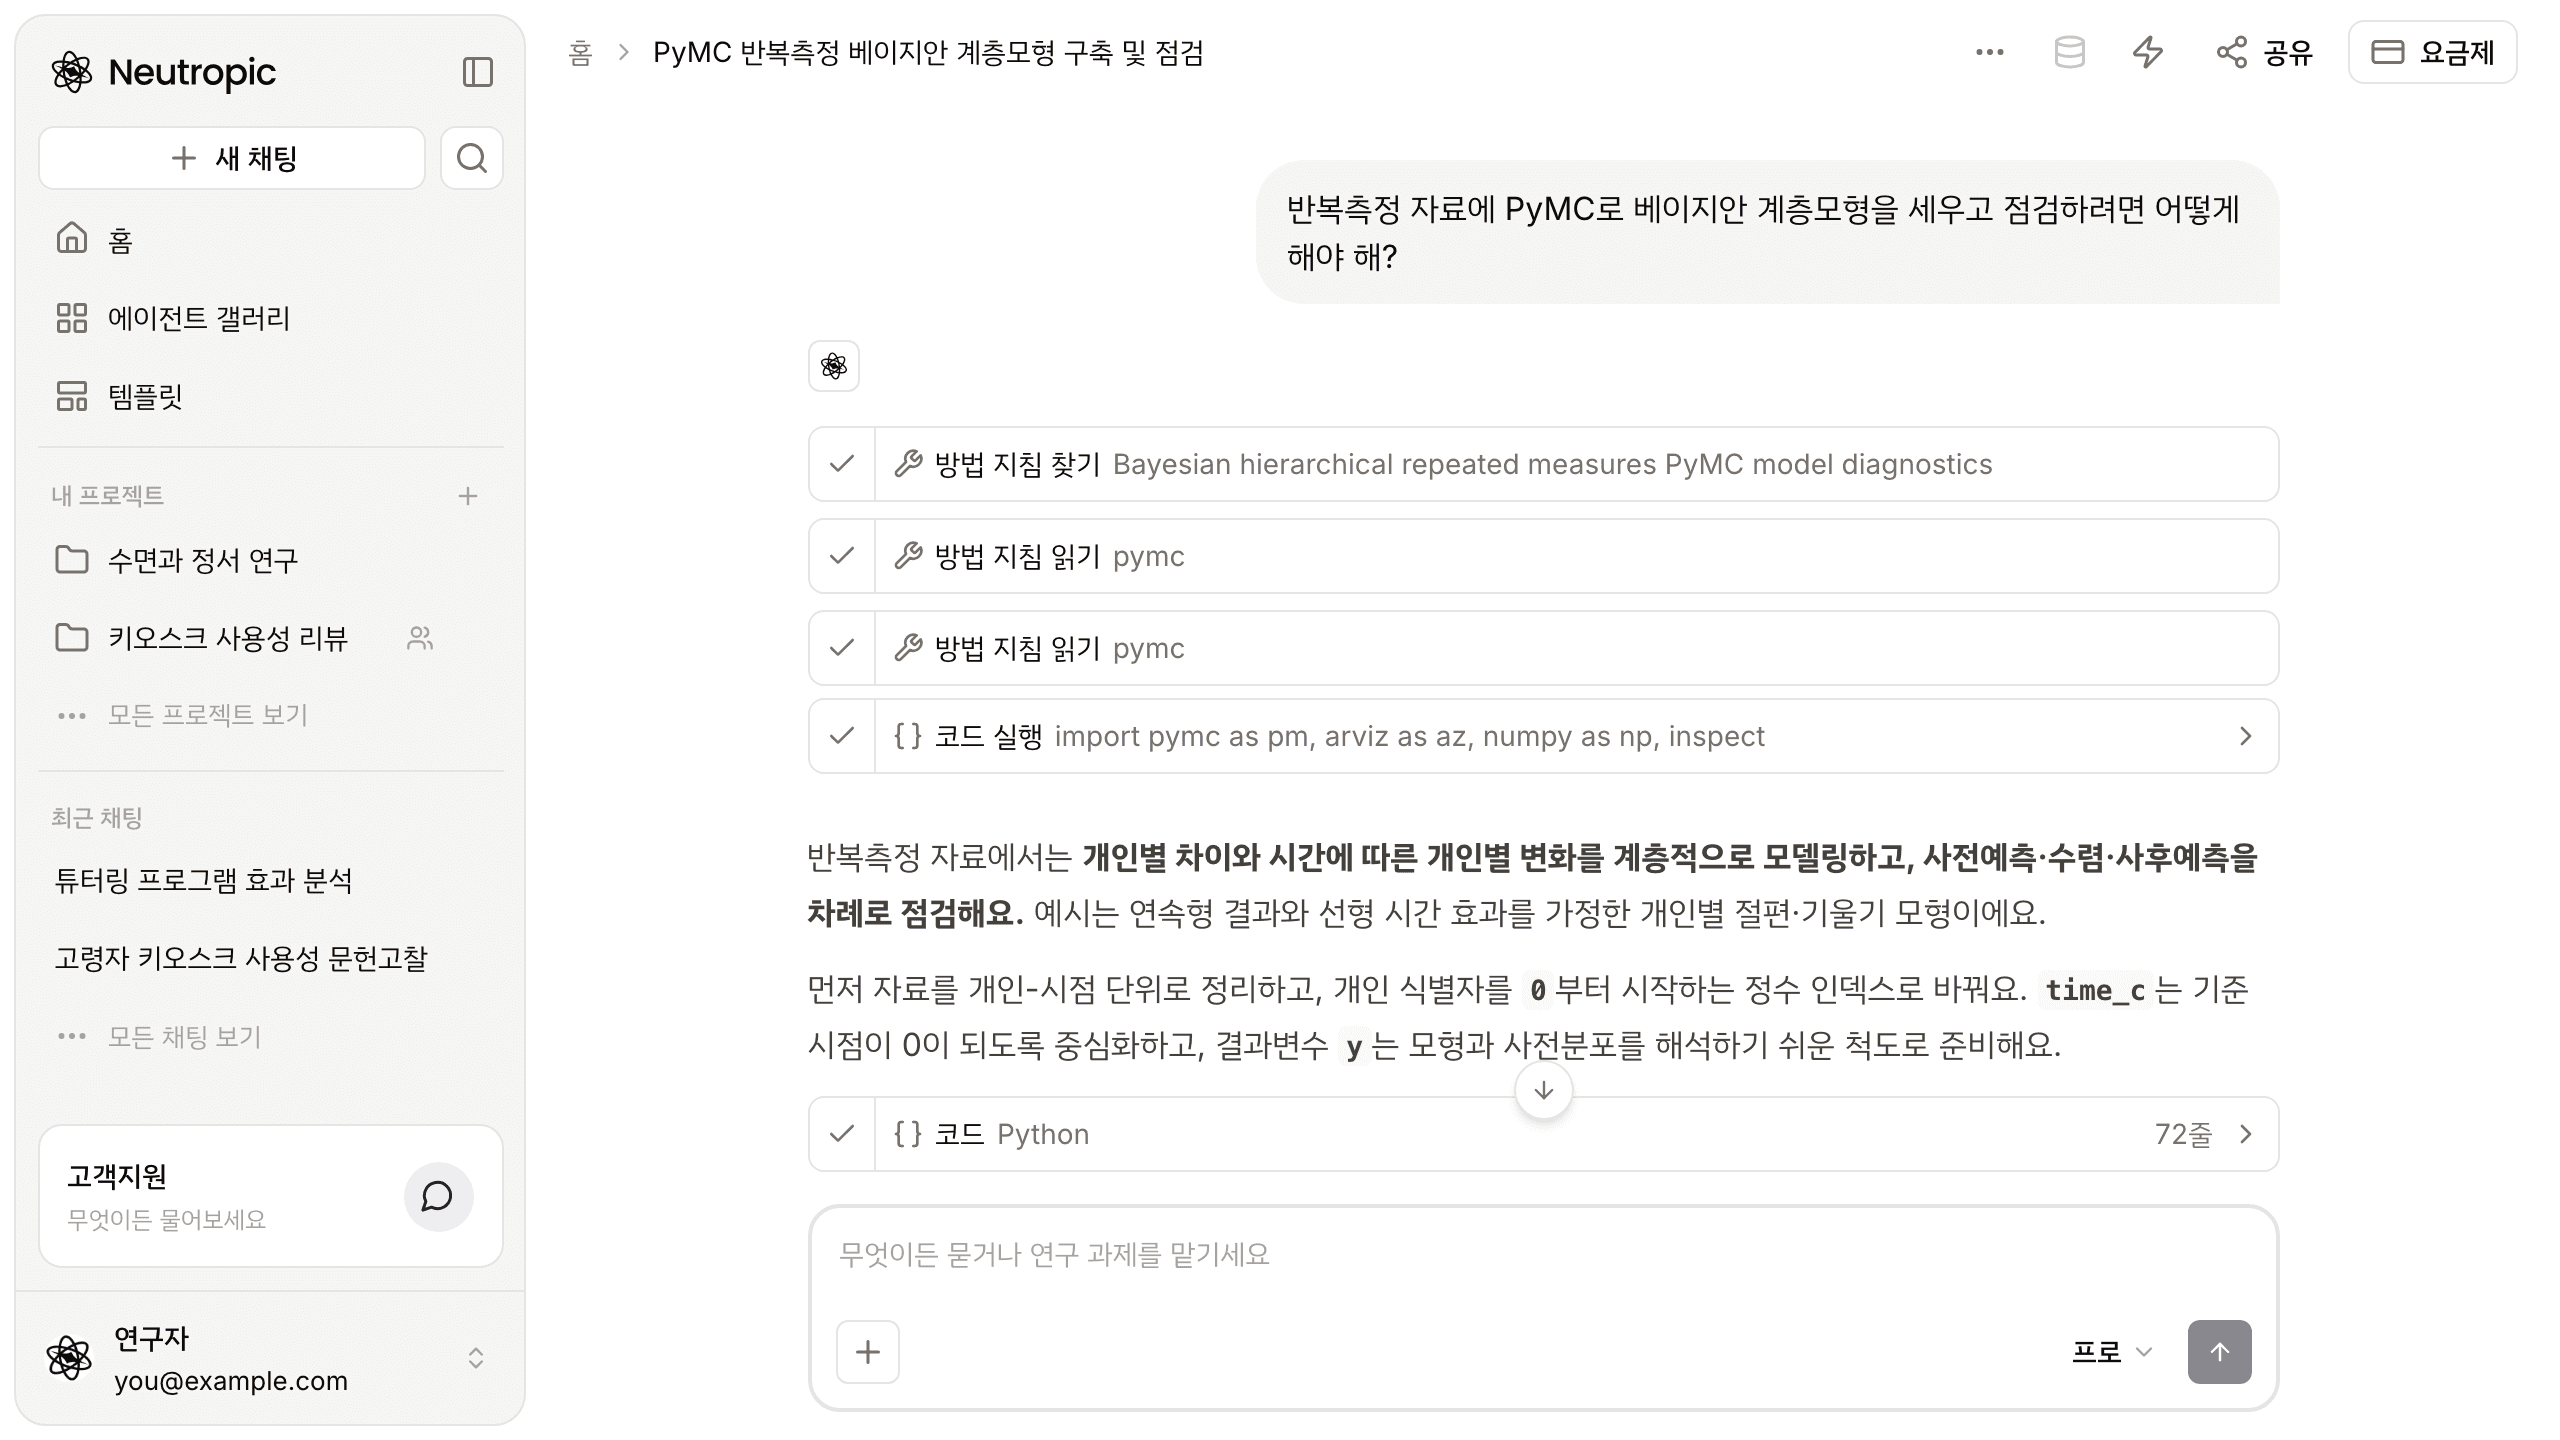
답하기 전에 PyMC 방법 지침부터 읽었습니다
보내자마자 화면에 단계가 쌓였습니다. 방법 지침 찾기로 계층모형 진단에 맞는 지침을 찾고, 방법 지침 읽기로 PyMC 지침을 두 번 읽었어요. 이어서 코드 실행 단계에서 PyMC를 불러오려 했지만, 실행 환경에 PyMC가 설치돼 있지 않았습니다. 이 이야기는 아래에서 다시 할게요.
방법 지침은 뉴트로픽이 미리 검토해 둔 분석 절차 문서예요. 모델이 기억에 기대 바로 답하는 대신, 검토된 절차를 먼저 읽고 그 순서를 따르게 합니다.
개인마다 절편과 기울기를 따로 두는 모형이 나왔습니다
답의 첫 문장은 방향부터 잡아 줬어요. 개인별 차이와 시간에 따른 개인별 변화를 계층적으로 모형화하고, 사전예측·수렴·사후예측을 차례로 점검하라는 거였죠.
예시는 연속형 결과와 선형 시간 효과를 가정한 모형이었습니다. 자료를 개인-시점 단위로 정리하고, 개인 번호를 0부터 시작하는 정수로 바꾸고, 기준 시점이 0이 되도록 시간을 중심화하라고 했어요. 코드는 72줄이었고, 개인별 절편과 기울기 사이의 상관까지 허용하도록 짜여 있었습니다. 사전예측 표본, 사후 표본, 사후예측 표본을 한 번에 뽑는 구성이고요.
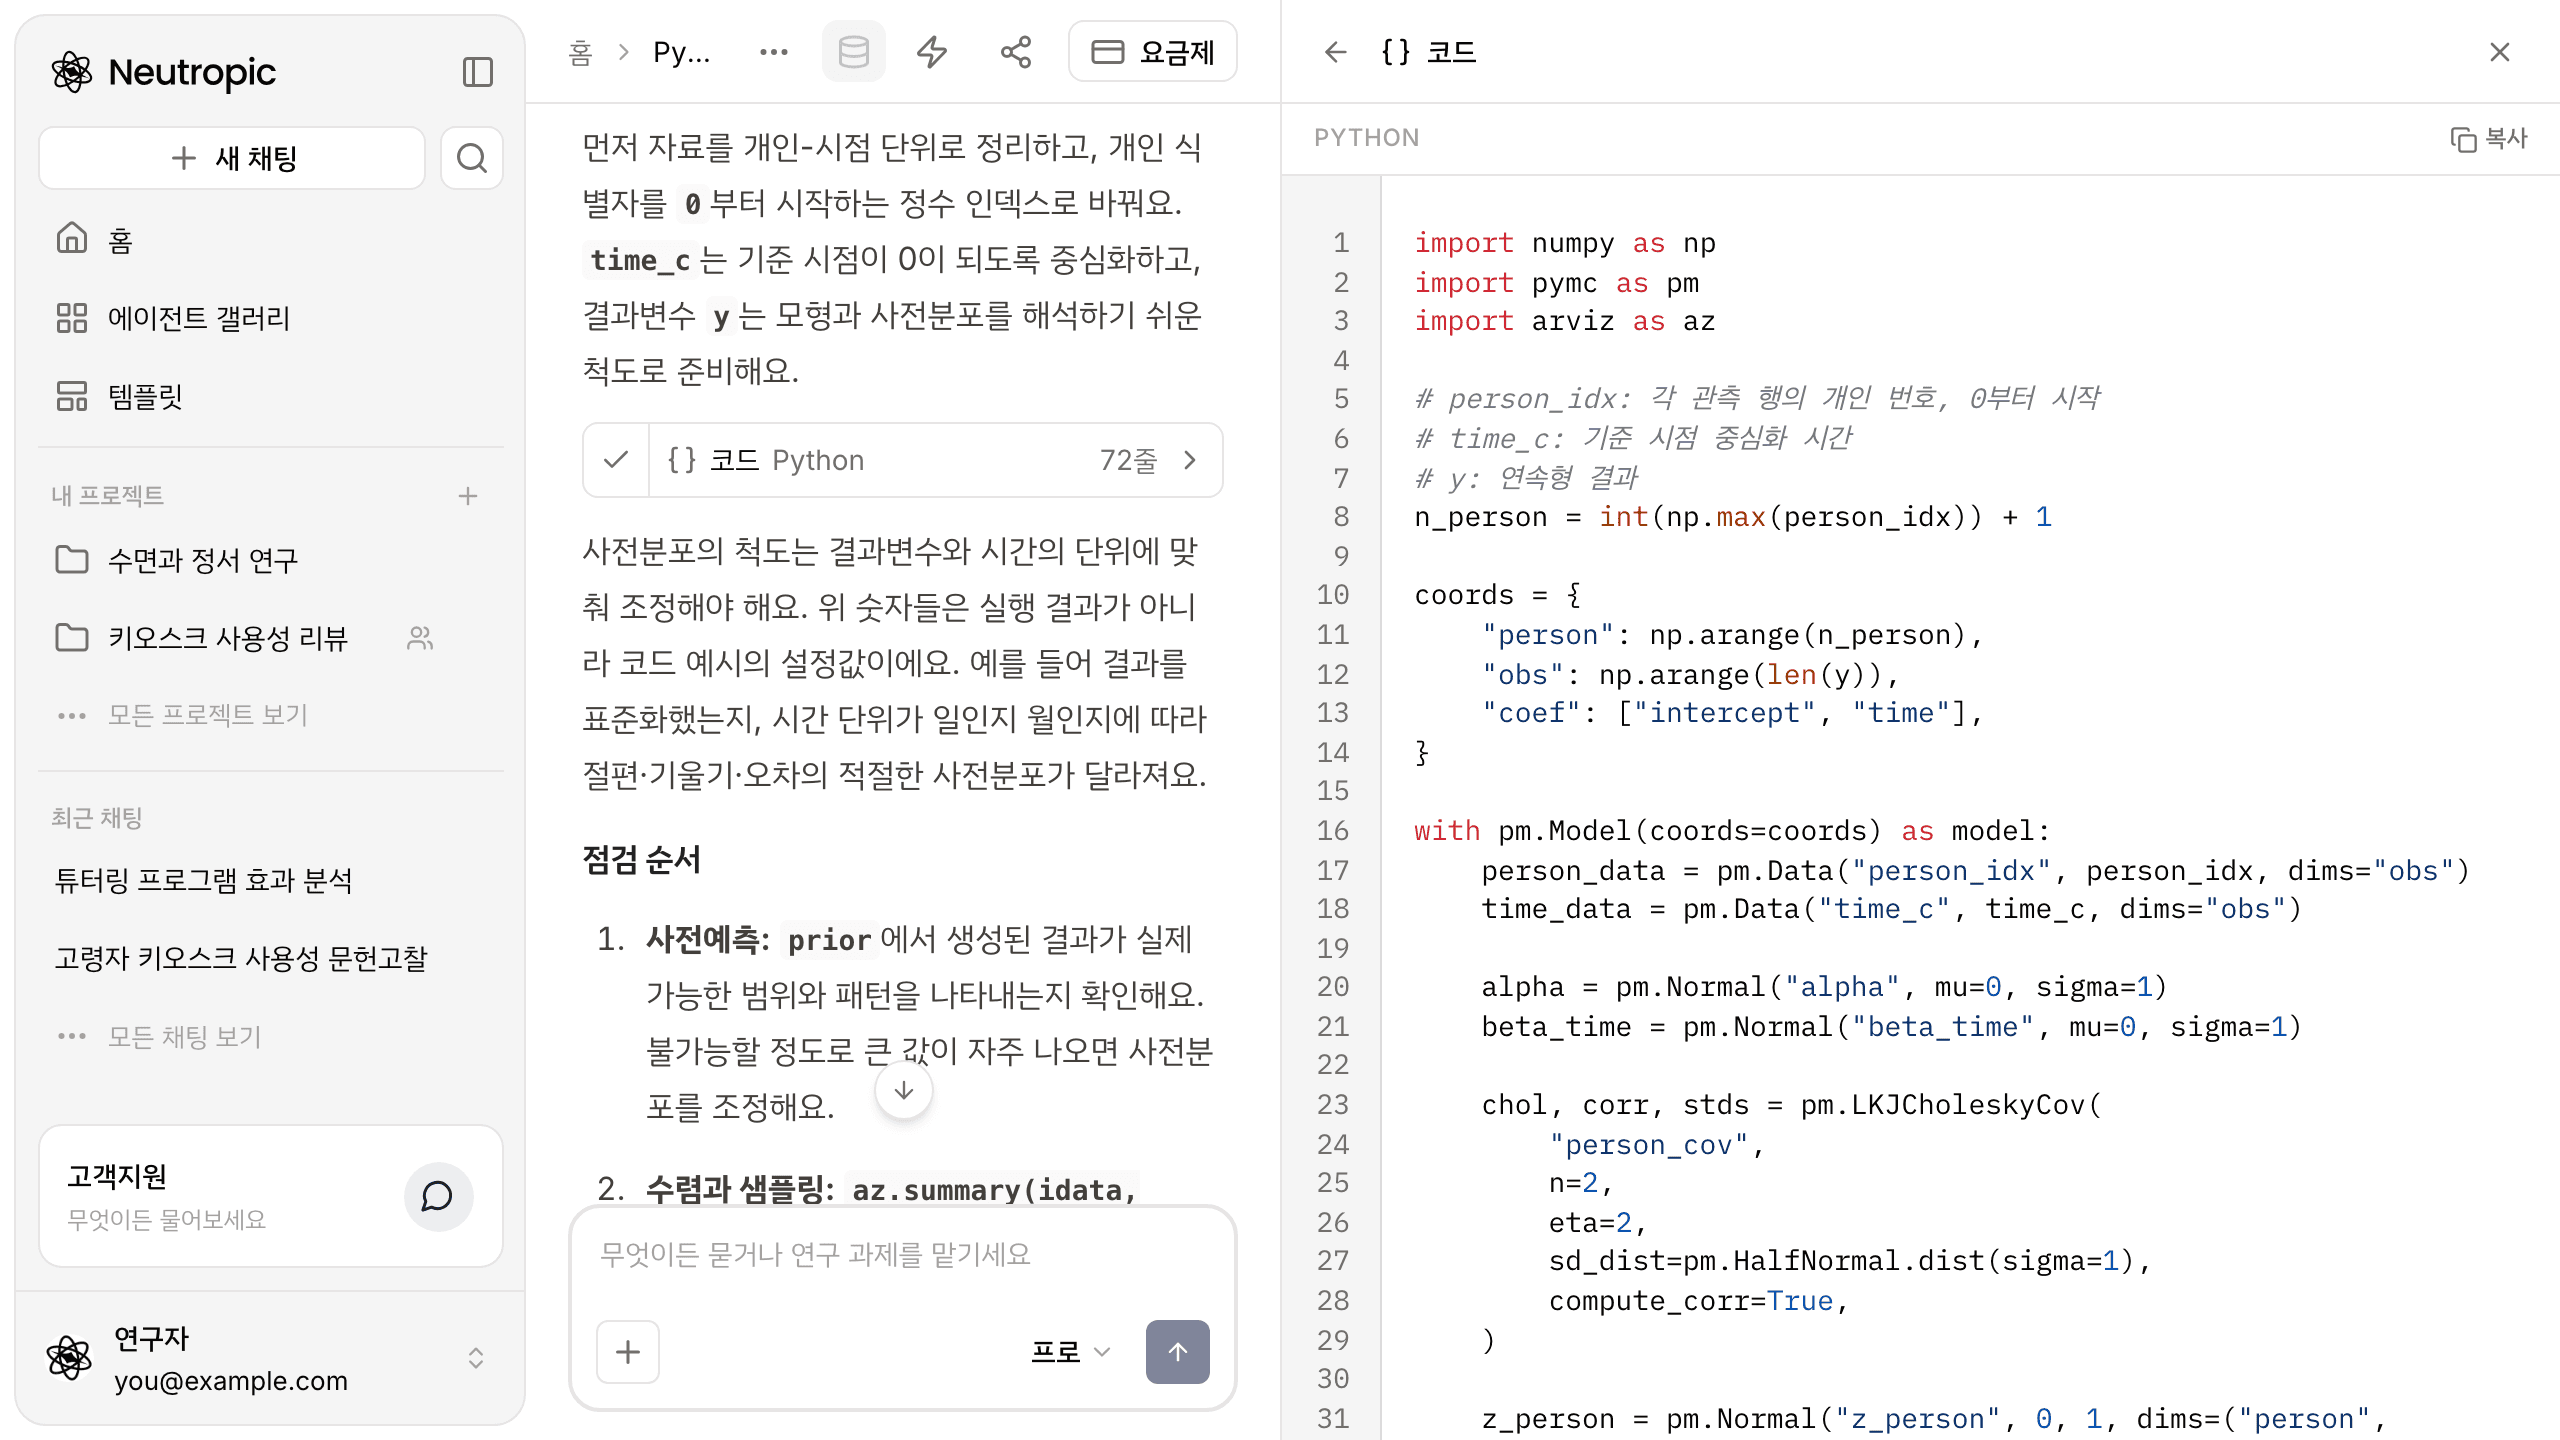
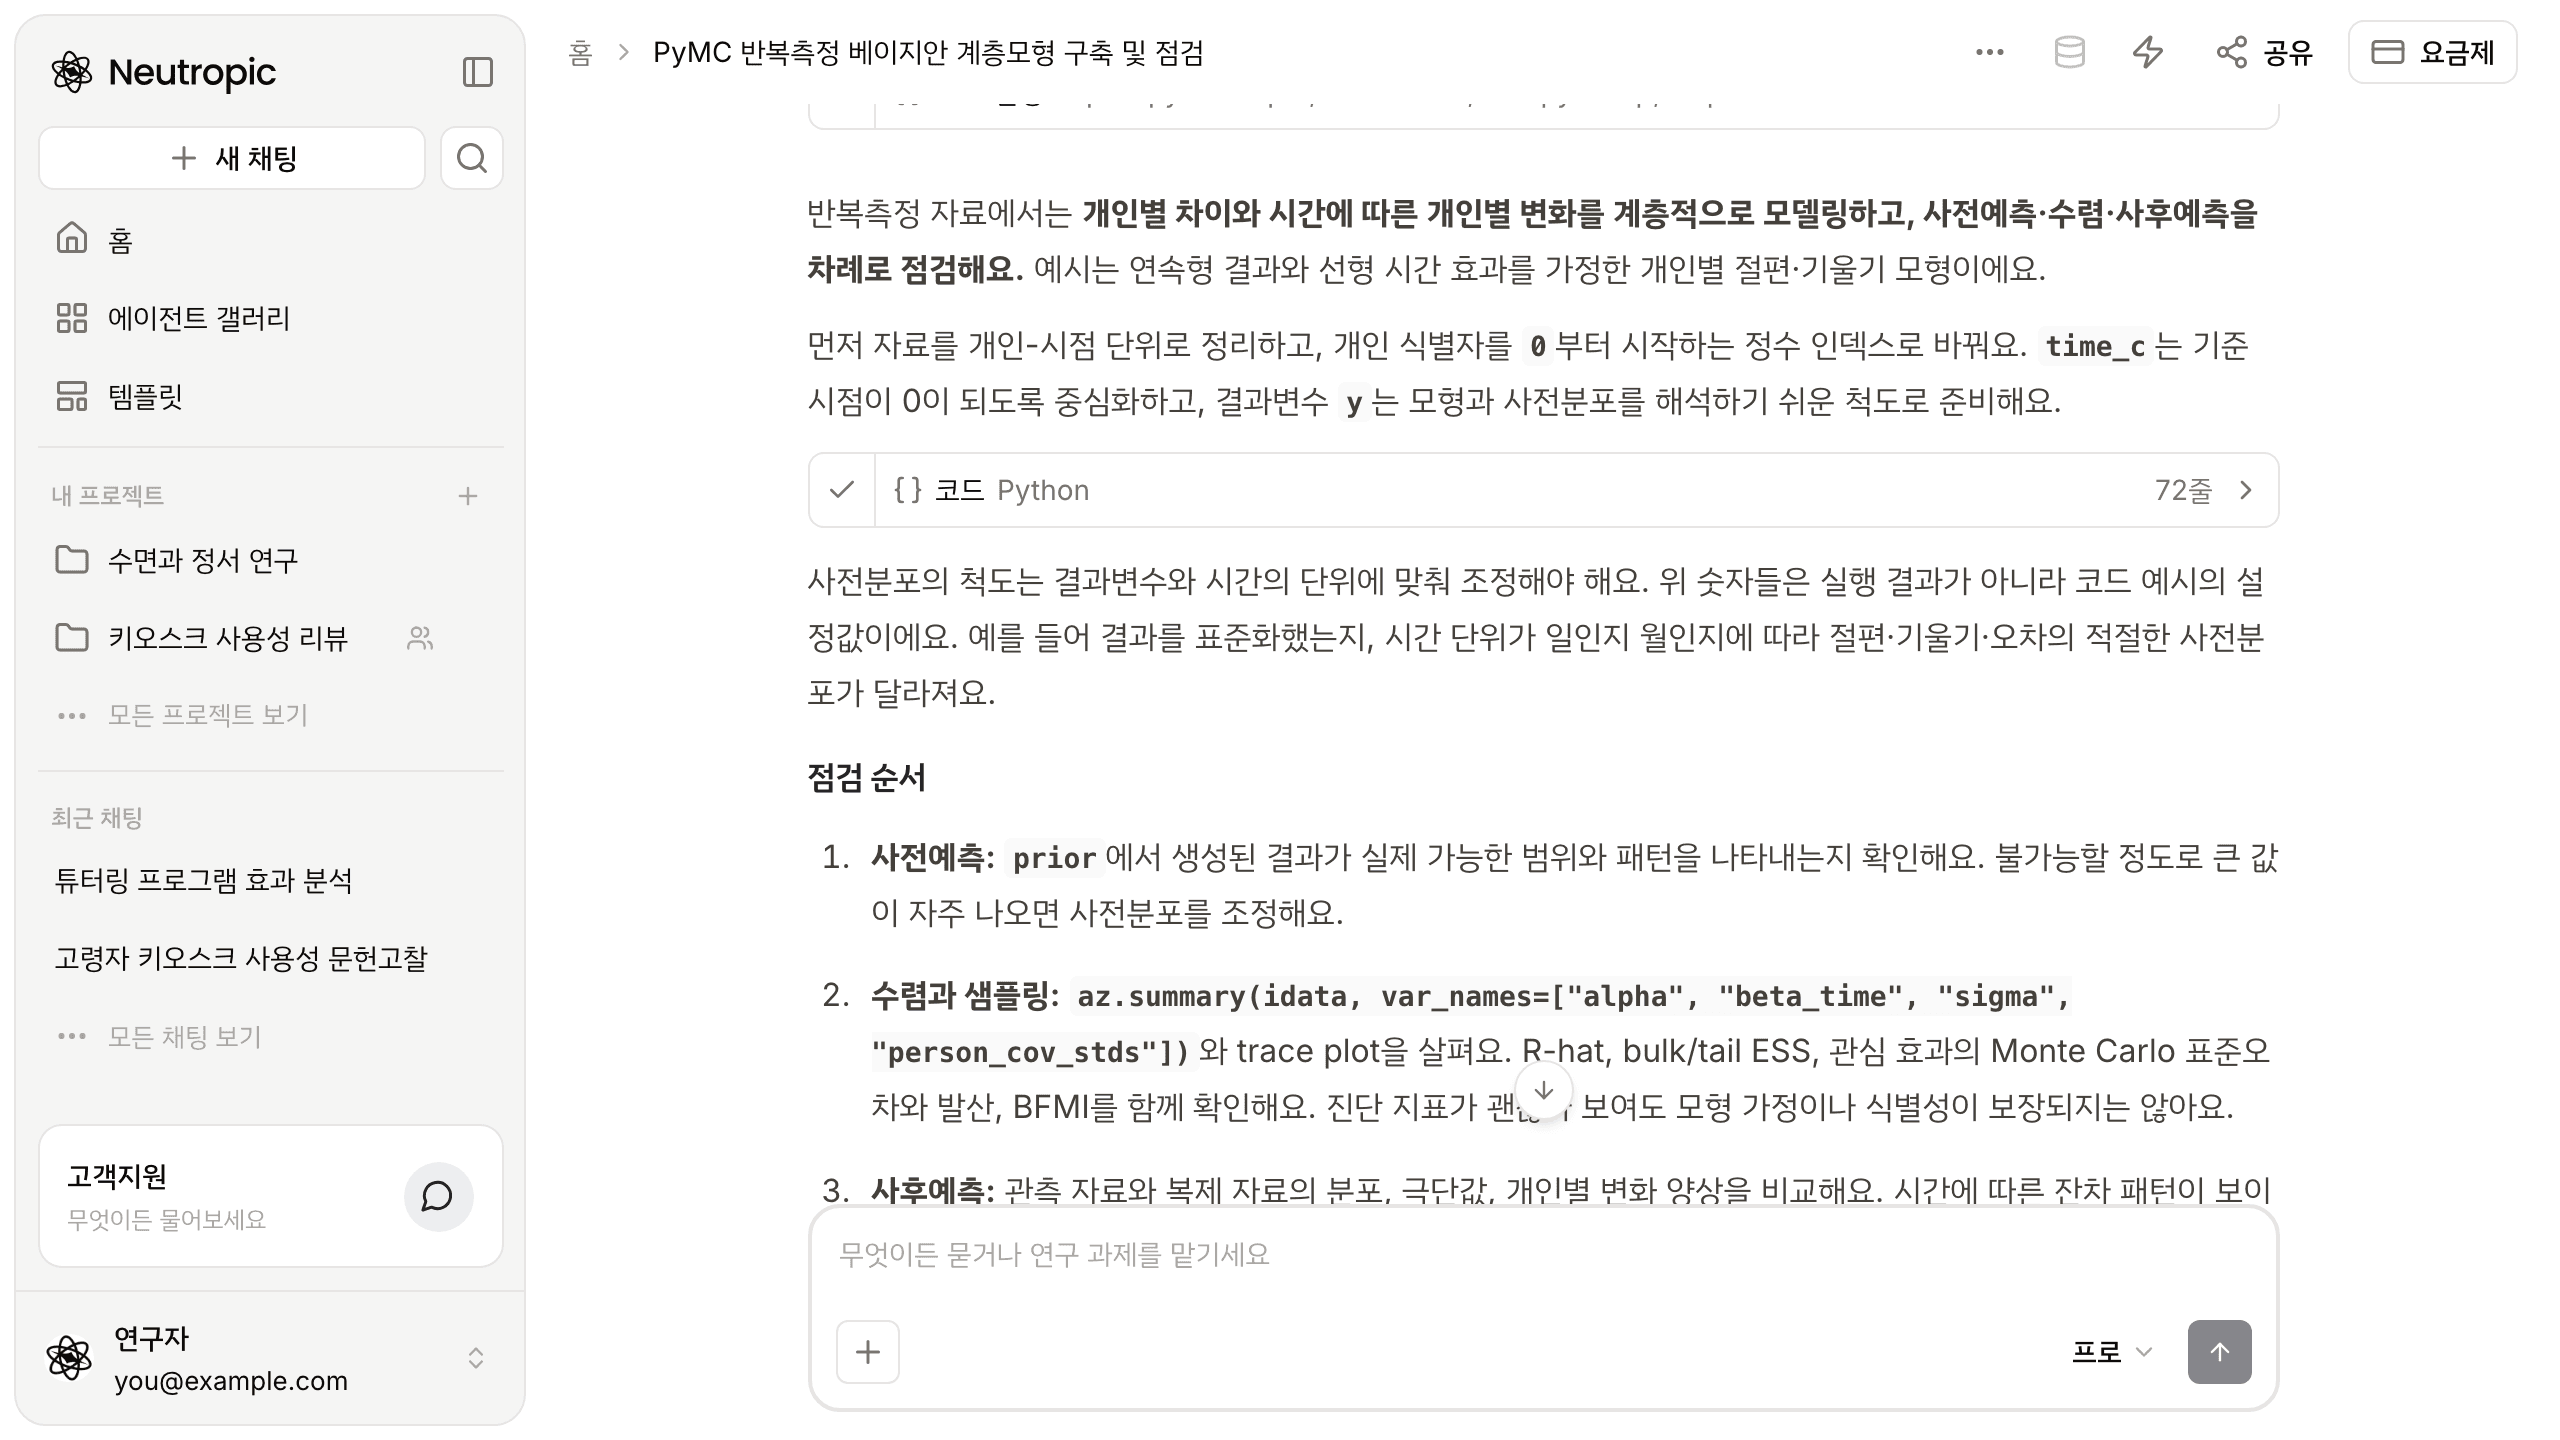
코드 아래에는 단서가 붙어 있었어요. 사전분포의 척도는 결과변수와 시간 단위에 맞춰 조정해야 하고, 코드 속 숫자들은 실행 결과가 아니라 예시 설정값이라는 것이었습니다. 결과를 표준화했는지, 시간 단위가 일인지 월인지에 따라 적절한 사전분포가 달라지니까요.
점검은 네 단계로 나눠 알려 줬습니다
지훈 씨가 가장 반가웠던 부분은 점검 순서였어요.
- 사전예측: 사전분포에서 만든 결과가 실제로 가능한 범위인지 본다. 터무니없이 큰 값이 자주 나오면 사전분포를 조정한다.
- 수렴과 샘플링: trace plot과 요약표로 R-hat, bulk/tail ESS, Monte Carlo 표준오차, 발산, BFMI를 함께 본다.
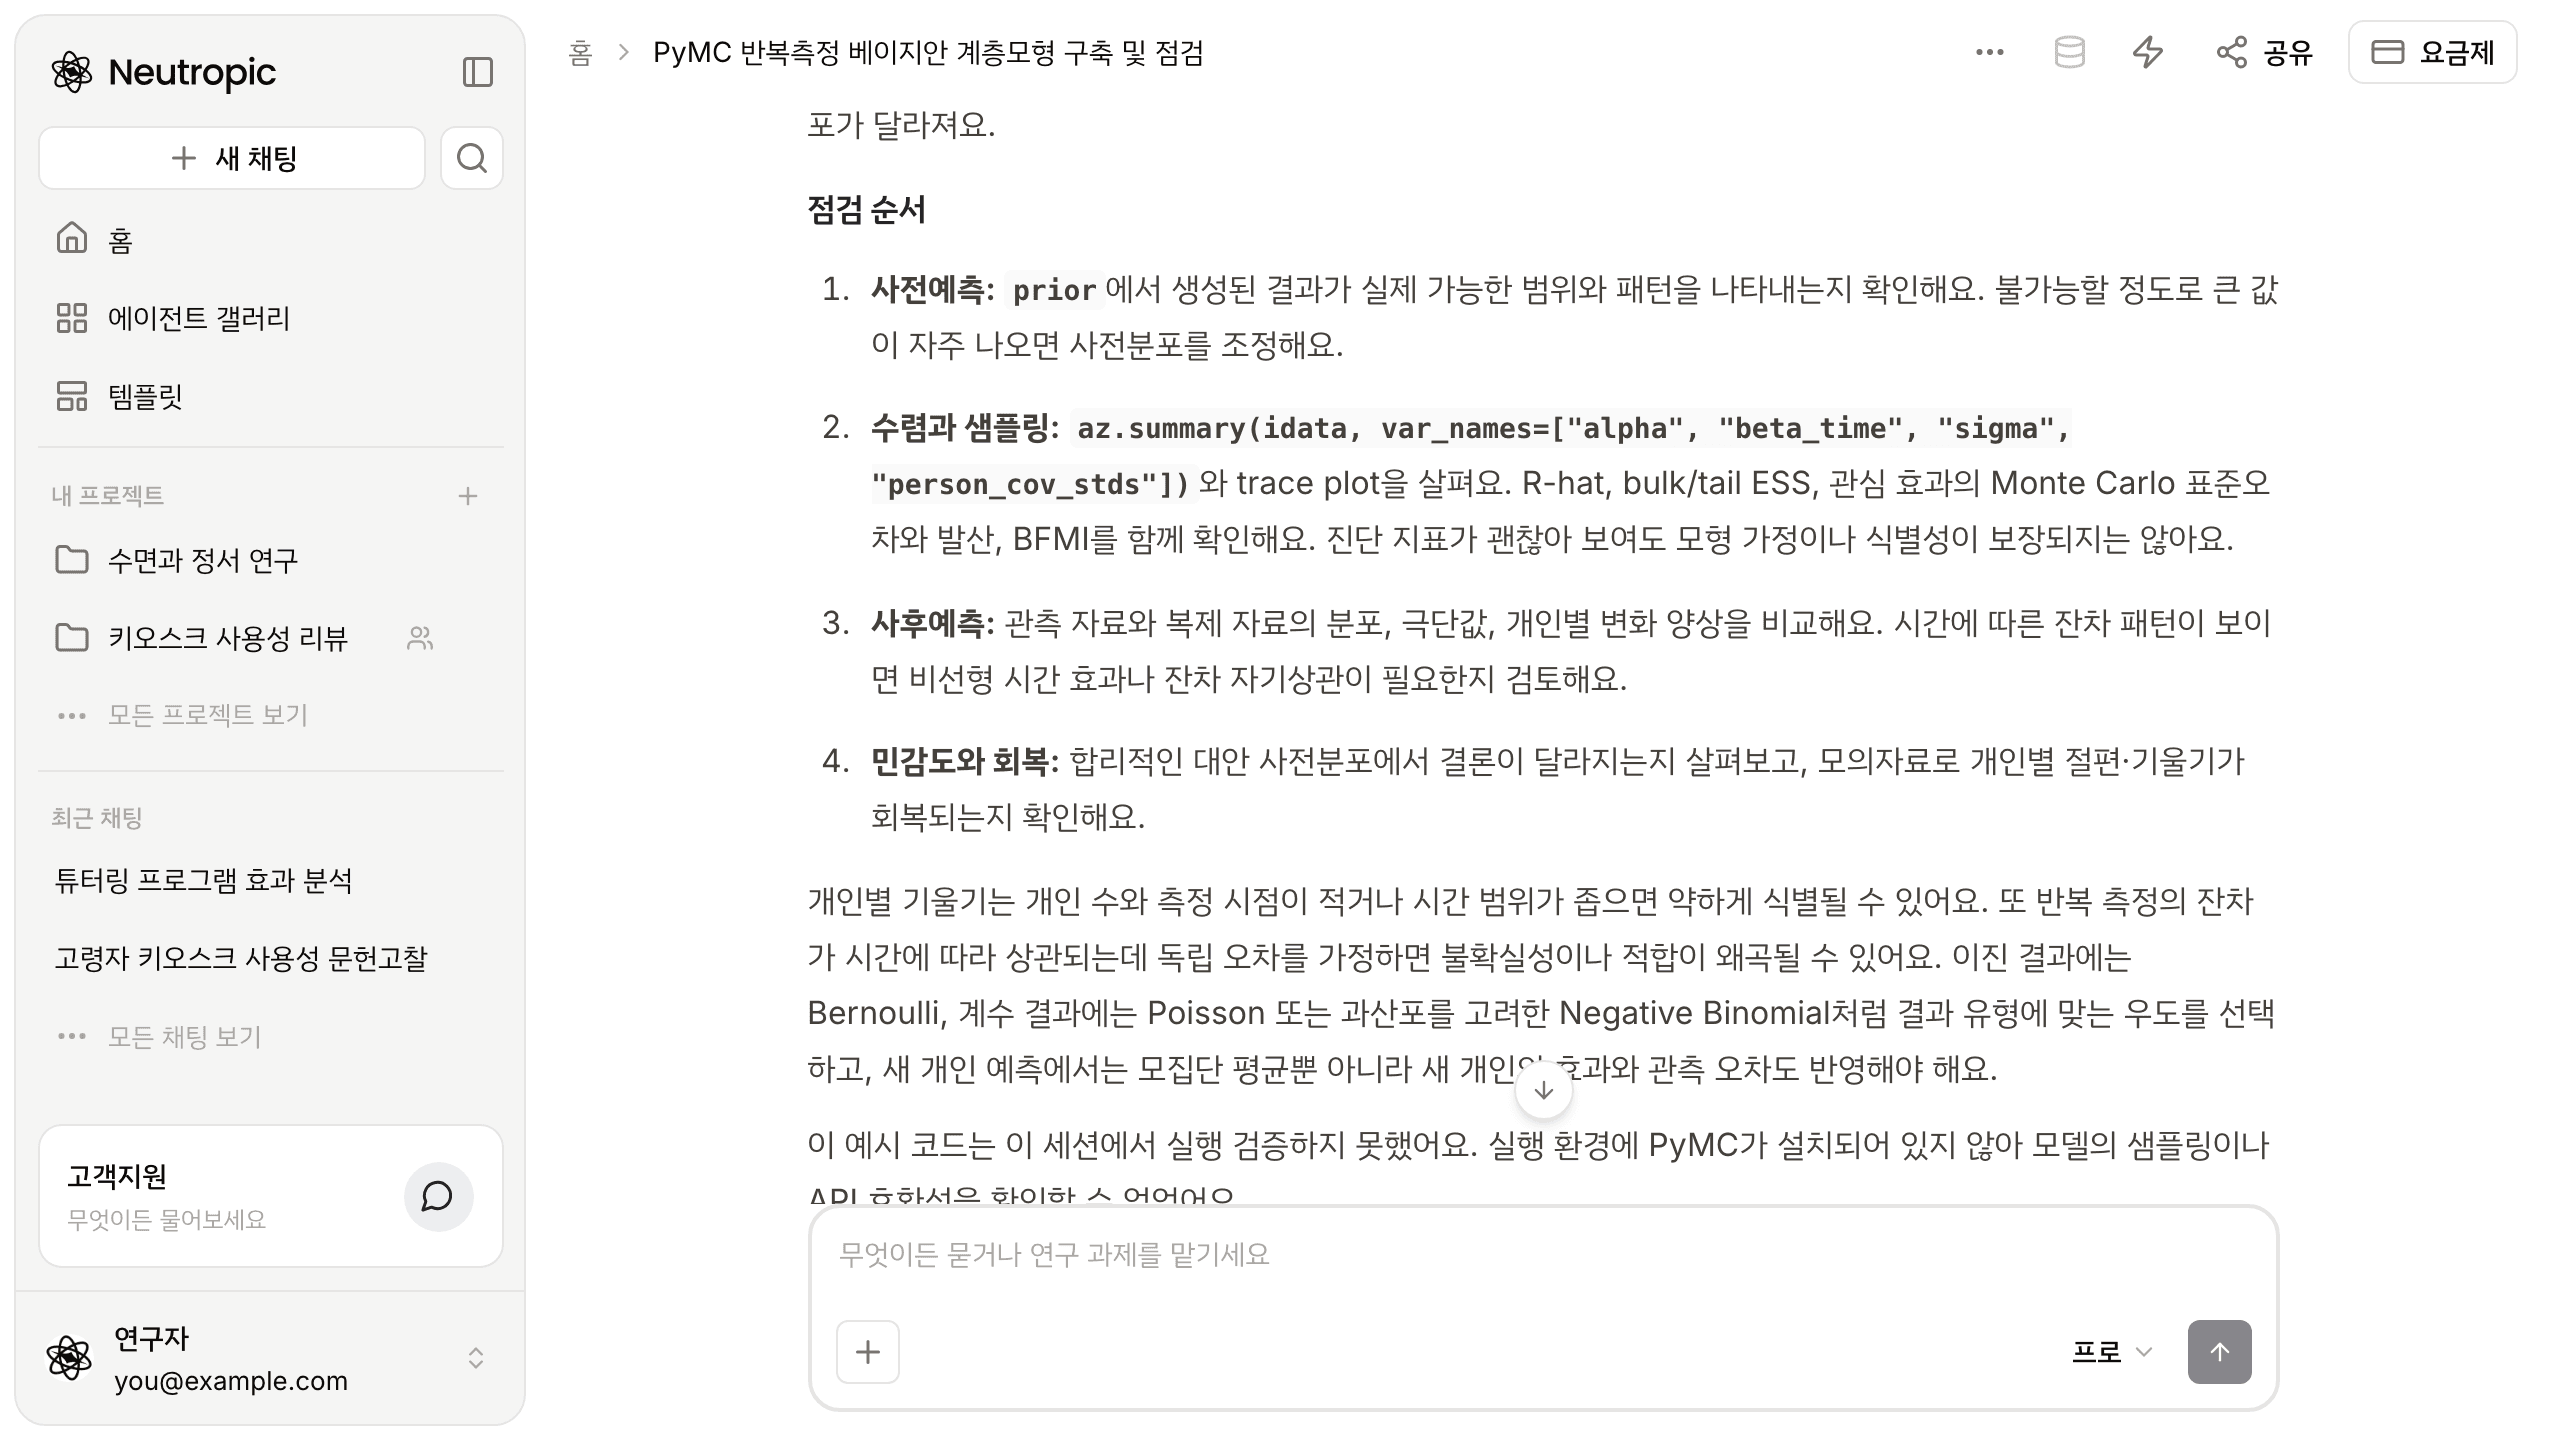
- 사후예측: 관측 자료와 복제 자료의 분포, 극단값, 개인별 변화 양상을 비교한다. 시간에 따른 잔차 패턴이 남으면 비선형 시간 효과나 잔차 자기상관을 검토한다.
- 민감도와 회복: 대안 사전분포에서도 결론이 유지되는지, 모의자료로 개인별 절편·기울기가 회복되는지 확인한다.
지훈 씨가 하마터면 R-hat만 보고 넘어갈 뻔했습니다
처음 베이지안을 하면 R-hat이 1에 가까우면 끝났다고 생각하기 쉬워요. 지훈 씨도 그럴 생각이었는데, 답은 바로 그 지점을 짚었습니다. 진단 지표가 괜찮아 보여도 모형 가정이나 식별성까지 보장되지는 않는다고요.
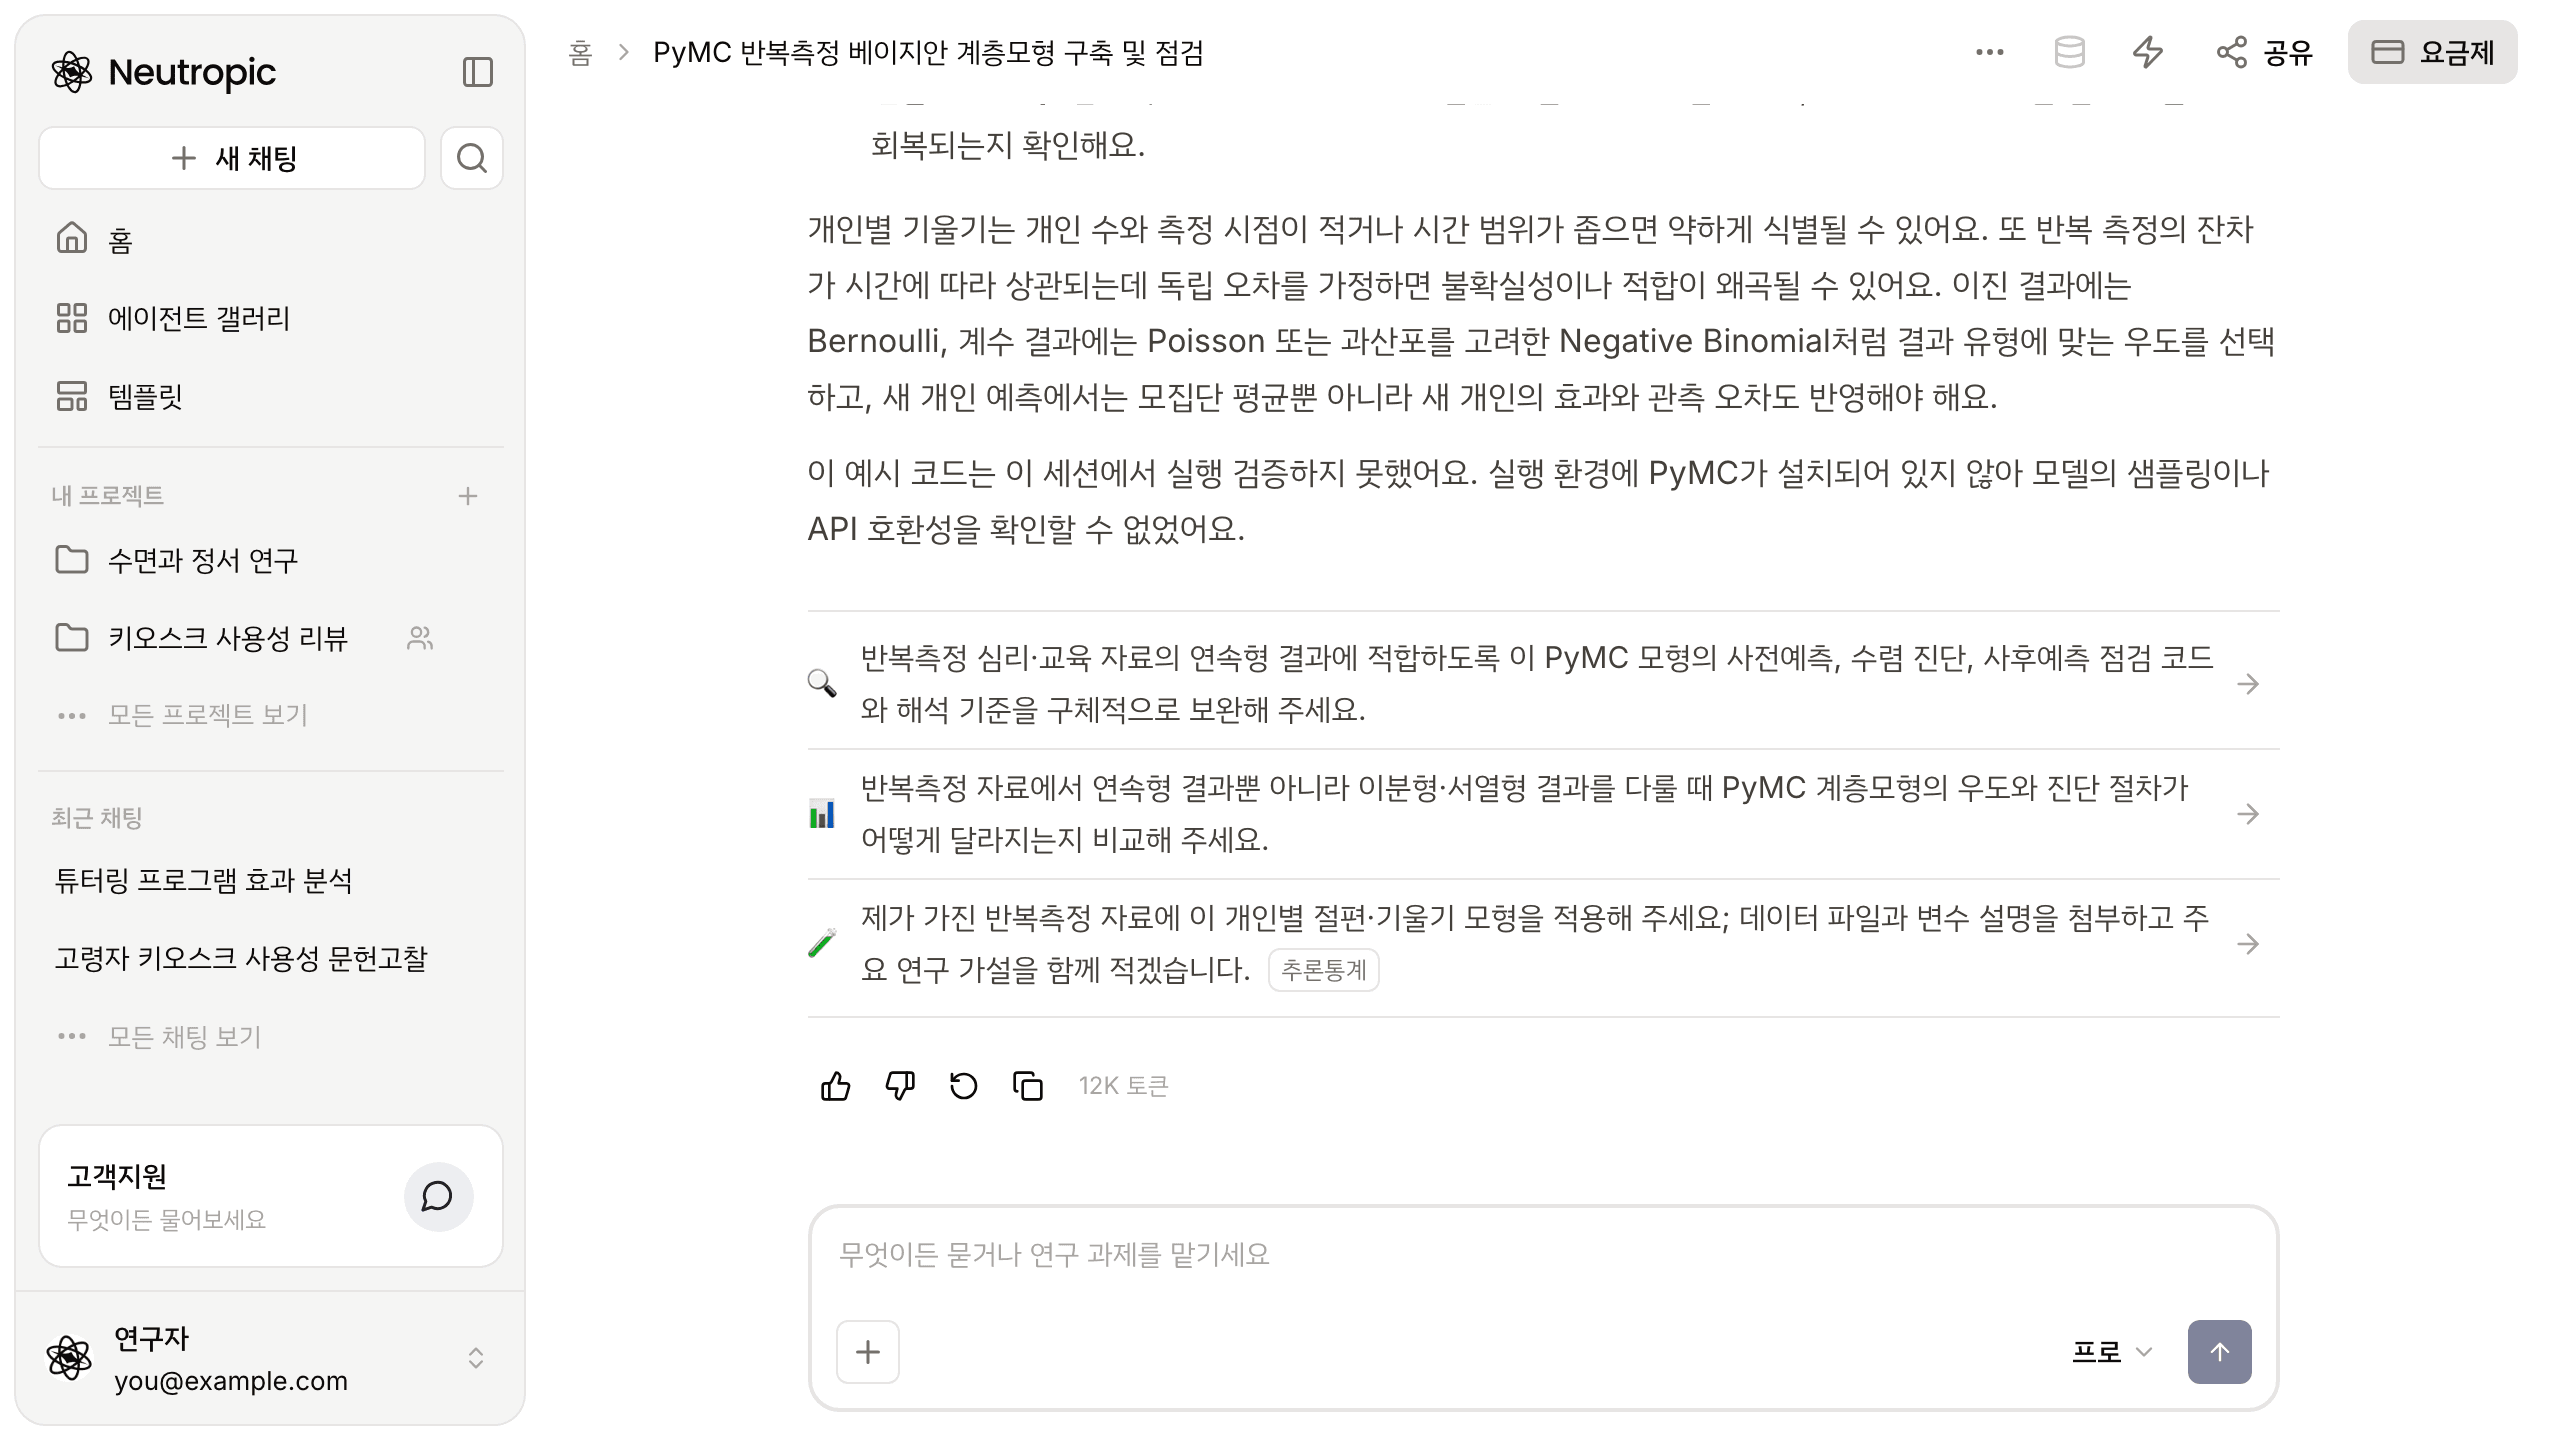
흔한 함정도 함께 적혀 있었어요. 개인 수나 측정 시점이 적으면 개인별 기울기가 약하게 식별될 수 있고, 반복측정의 잔차가 시간에 따라 상관되는데 독립 오차를 가정하면 불확실성이 왜곡될 수 있다는 것. 이진 결과에는 Bernoulli, 계수 결과에는 Poisson이나 Negative Binomial처럼 결과 유형에 맞는 우도를 골라야 한다는 것도요.
그리고 답의 마지막 문장은 이랬습니다. 이 예시 코드는 이 세션에서 실행 검증하지 못했고, 실행 환경에 PyMC가 설치돼 있지 않아 샘플링이나 API 호환성을 확인할 수 없었다고요. 그러니까 이 답은 서버에서 모형을 돌린 결과가 아니라, 직접 돌려 볼 코드와 점검 순서예요. 돌리지 않은 결과를 지어내지 않고 그 사실을 그대로 밝힌 셈이죠.
다음에 할 일도 제안받았습니다
답 아래에는 이어서 할 일 세 가지가 있었어요.
- 심리·교육 분야 반복측정 자료에 맞춰 사전예측·수렴 진단·사후예측 점검 코드와 해석 기준을 구체적으로 보완하기
- 이분형·서열형 결과일 때 우도와 진단 절차가 어떻게 달라지는지 비교하기
- 내 반복측정 자료에 이 모형을 적용하기 — 추론통계 에이전트
누르면 같은 대화에서 바로 이어집니다. 자료가 준비된 지훈 씨라면 세 번째를 누르겠죠.
막연했던 계층모형이 점검 목록이 붙은 코드가 됐습니다
| 시작할 때 | 지금 | |
|---|---|---|
| 모형 | "계층모형"이라는 말만 들음 | 개인별 절편·기울기(상관 허용) 모형 |
| 코드 | 예제 노트북을 뒤적임 | 복사해서 쓸 수 있는 PyMC 코드 72줄 |
| 점검 | R-hat만 알고 있음 | 사전예측→수렴→사후예측→민감도 4단계 |
| 함정 | 무엇을 조심할지 모름 | 약한 식별, 잔차 자기상관, 우도 선택, 새 개인 예측 |
| 다음 | 막막함 | 바로 누를 수 있는 제안 세 가지 |
솔직히 말씀드리면, 이 답은 모형을 실제로 샘플링한 결과가 아니에요. 코드는 지훈 씨 컴퓨터에서 PyMC를 설치하고 직접 돌려야 하고, 사전분포 척도도 자기 자료 단위에 맞게 고쳐야 합니다. 그래도 무엇을 어떤 순서로 확인할지 아는 상태에서 시작하는 것과 빈 노트북에서 시작하는 건 많이 다르죠.
이 글은 프로 수준으로 실행했어요. 라이트(무료 요금제)는 간단한 모형 구조와 핵심 진단을 알려 주고, 전문가는 여기에 사전분포 민감도와 모형 비교를 더합니다.
반복측정 자료 앞에서 막막하다면, 한 줄 질문으로 모형과 점검 순서부터 받아 보세요. 😎
이번 주에 지훈 씨처럼 "세우고 점검하려면"까지 적어서 물어보세요. 뉴트로픽 무료로 시작하기