こんにちは、Neutropicチームです!
実験記録から「正解するかどうかを予測するモデル」を作ってみて、と言われたとしましょう。Pythonのチュートリアル通りに行をシャッフルして5分割交差検証を回すと、それらしい数値が出ます。ところが研究室のミーティングで、こう聞かれます。「同じ参加者が学習データと評価データの両方に入っていませんか?」🥲
人を対象とする研究のデータは、たいていこの形です。参加者1人が複数の試行を、患者1人が複数回の来院を残します。行単位で分けると、モデルはすでに見た人で採点され、新しい人に使うときより精度が良く見えてしまいます。避けるには、どの列を予測変数から外すか、分割をどう作るか、結果のあとにしか分からない変数はないかを、ひとつずつ確かめる必要があります。
この記事では、認知心理学の博士課程 遥さん が、反応課題の実験記録で初めて予測モデルを作る流れを追います。遥さんは架空の人物ですが、以下の画面はすべてNeutropicで実際に実行した結果です。
ファイルを1つ添付して、一行だけ書きました
遥さんのファイルはtrials.csvでした。参加者90人が8試行ずつ行った720行に、参加者番号、試行番号、年齢、事前得点、難易度、反応時間、正誤が入っています。エージェントギャラリー で 予測モデリング エージェントを選び、ファイルを添付して、こう書きました。
添付した実験記録から、試行ごとの正誤(correct)を予測してください。
短くても必要なことは入っています。何を予測するか(correct)、1行が何か(試行)。「参加者ごとに複数行ある」とは書いていませんが、それを見つけるのがエージェントの仕事です。
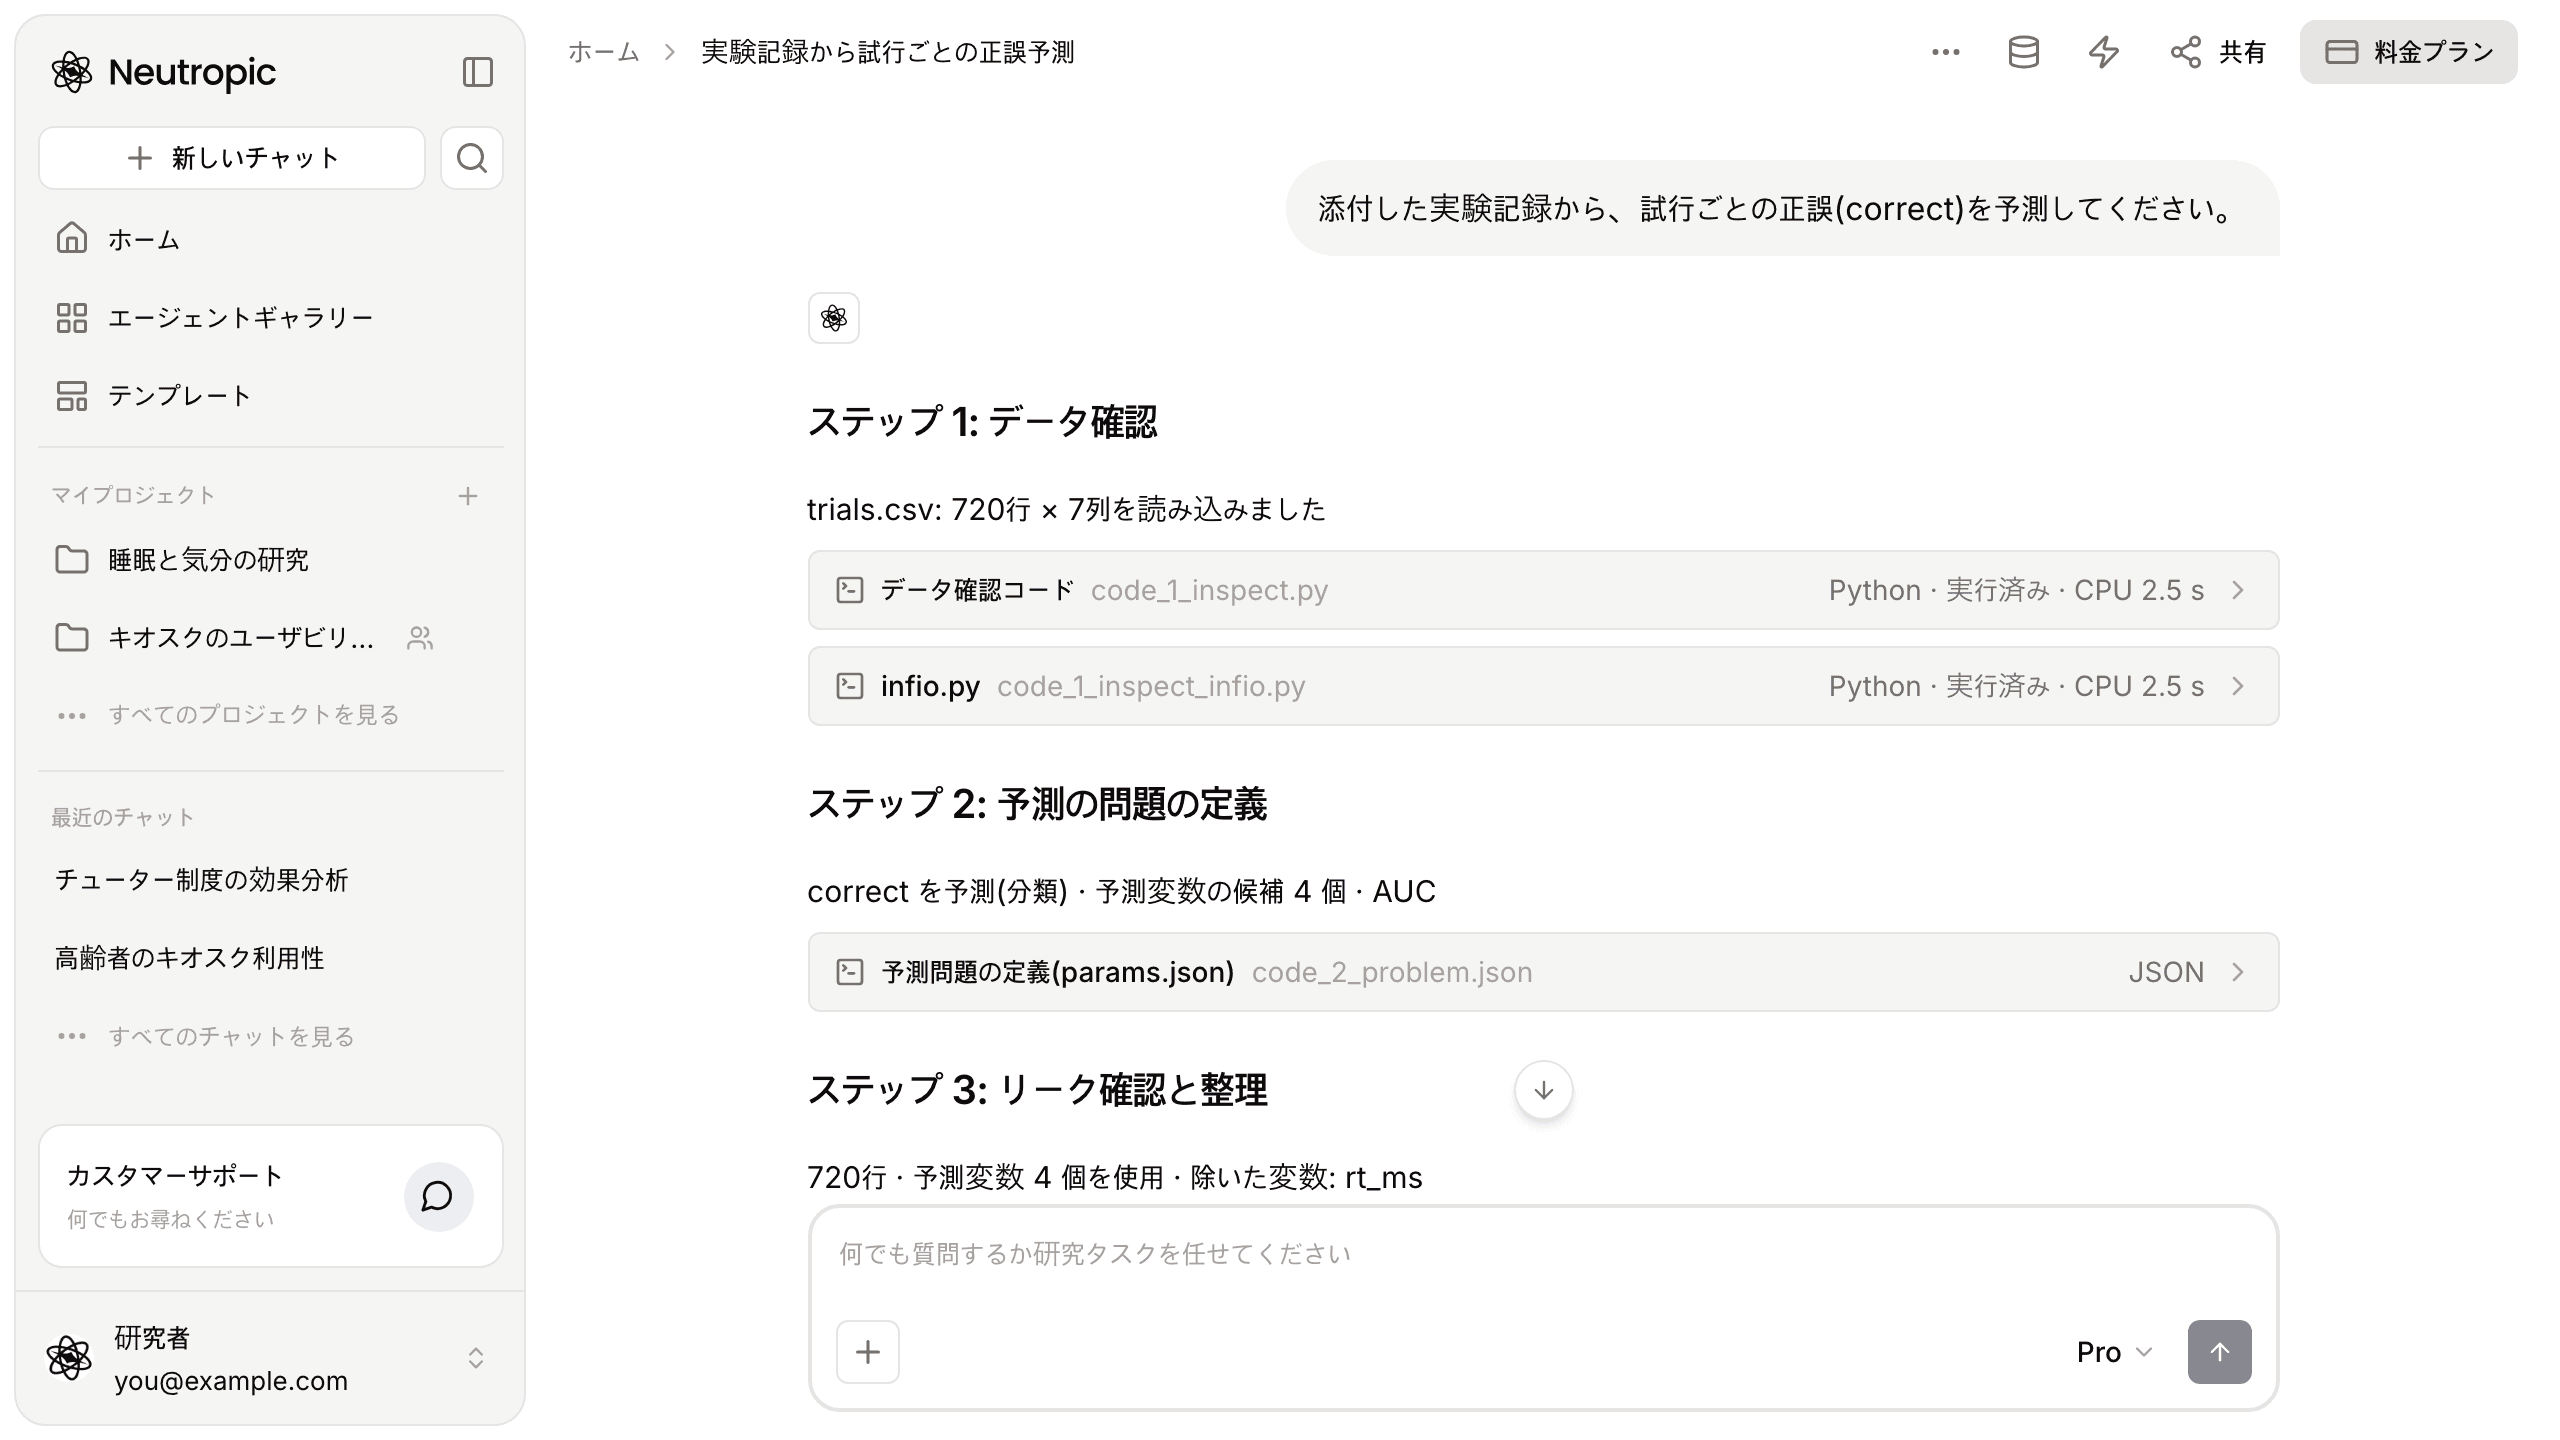
反応時間をリークとして予測変数から外しました
エージェントは決まった8つのステップを順に進めました。データ確認 で720行 × 7列を読み込み、予測の問題の定義 で「correct を予測(分類)· 予測変数の候補 4 個 · AUC」と問題を決めました。
要は3つ目の リーク確認と整理 でした。結果は「720行 · 予測変数 4 個を使用 · 除いた変数: rt_ms」。反応時間は、参加者が答えた瞬間に初めて記録される値です。回答前に正誤を予測するなら、使ってはいけない情報なんですね。
4つ目の 基準モデル では、participant_id 単位でまとめた5分割交差検証 を使いました。参加者番号は予測変数ではなく、分割をまとめる単位として使われます。1人の8試行がすべて同じ分割に入るので、評価のときモデルは常に初めて見る人を相手にします。結果の割合だけを使う基準モデルのAUCは0.500でした。
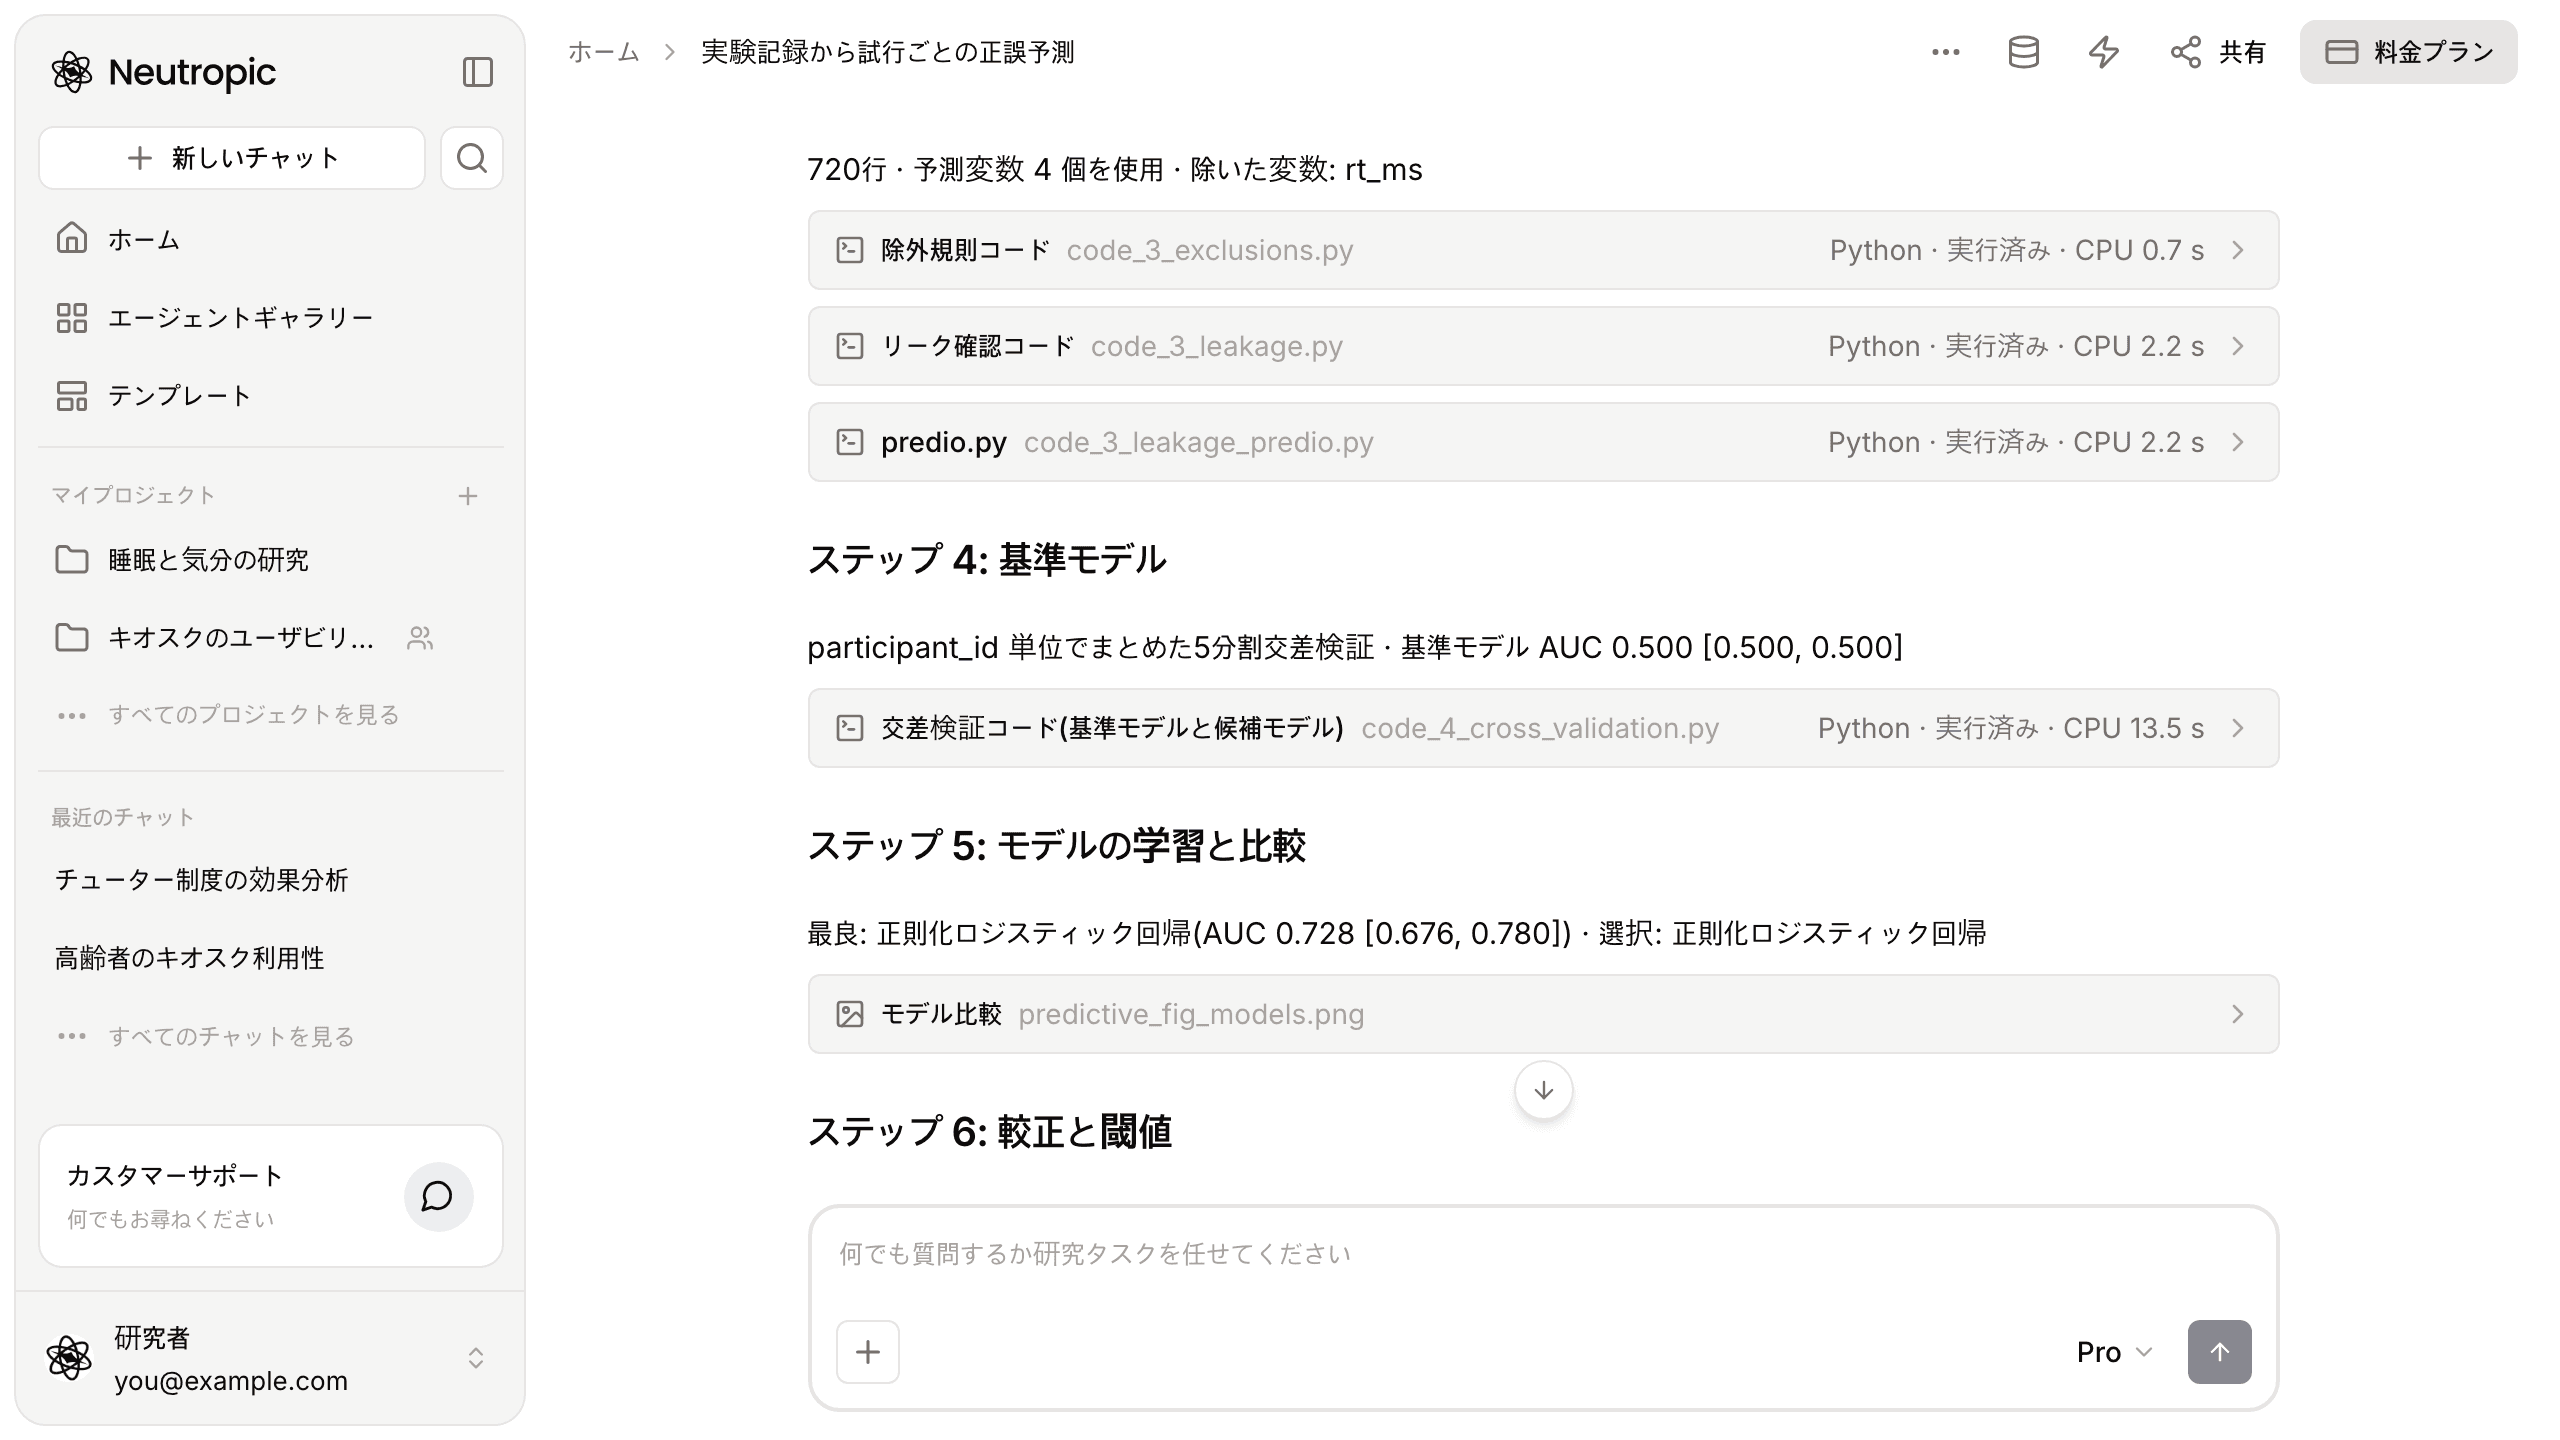
4つのモデルのうち、いちばん単純なモデルが勝ちました
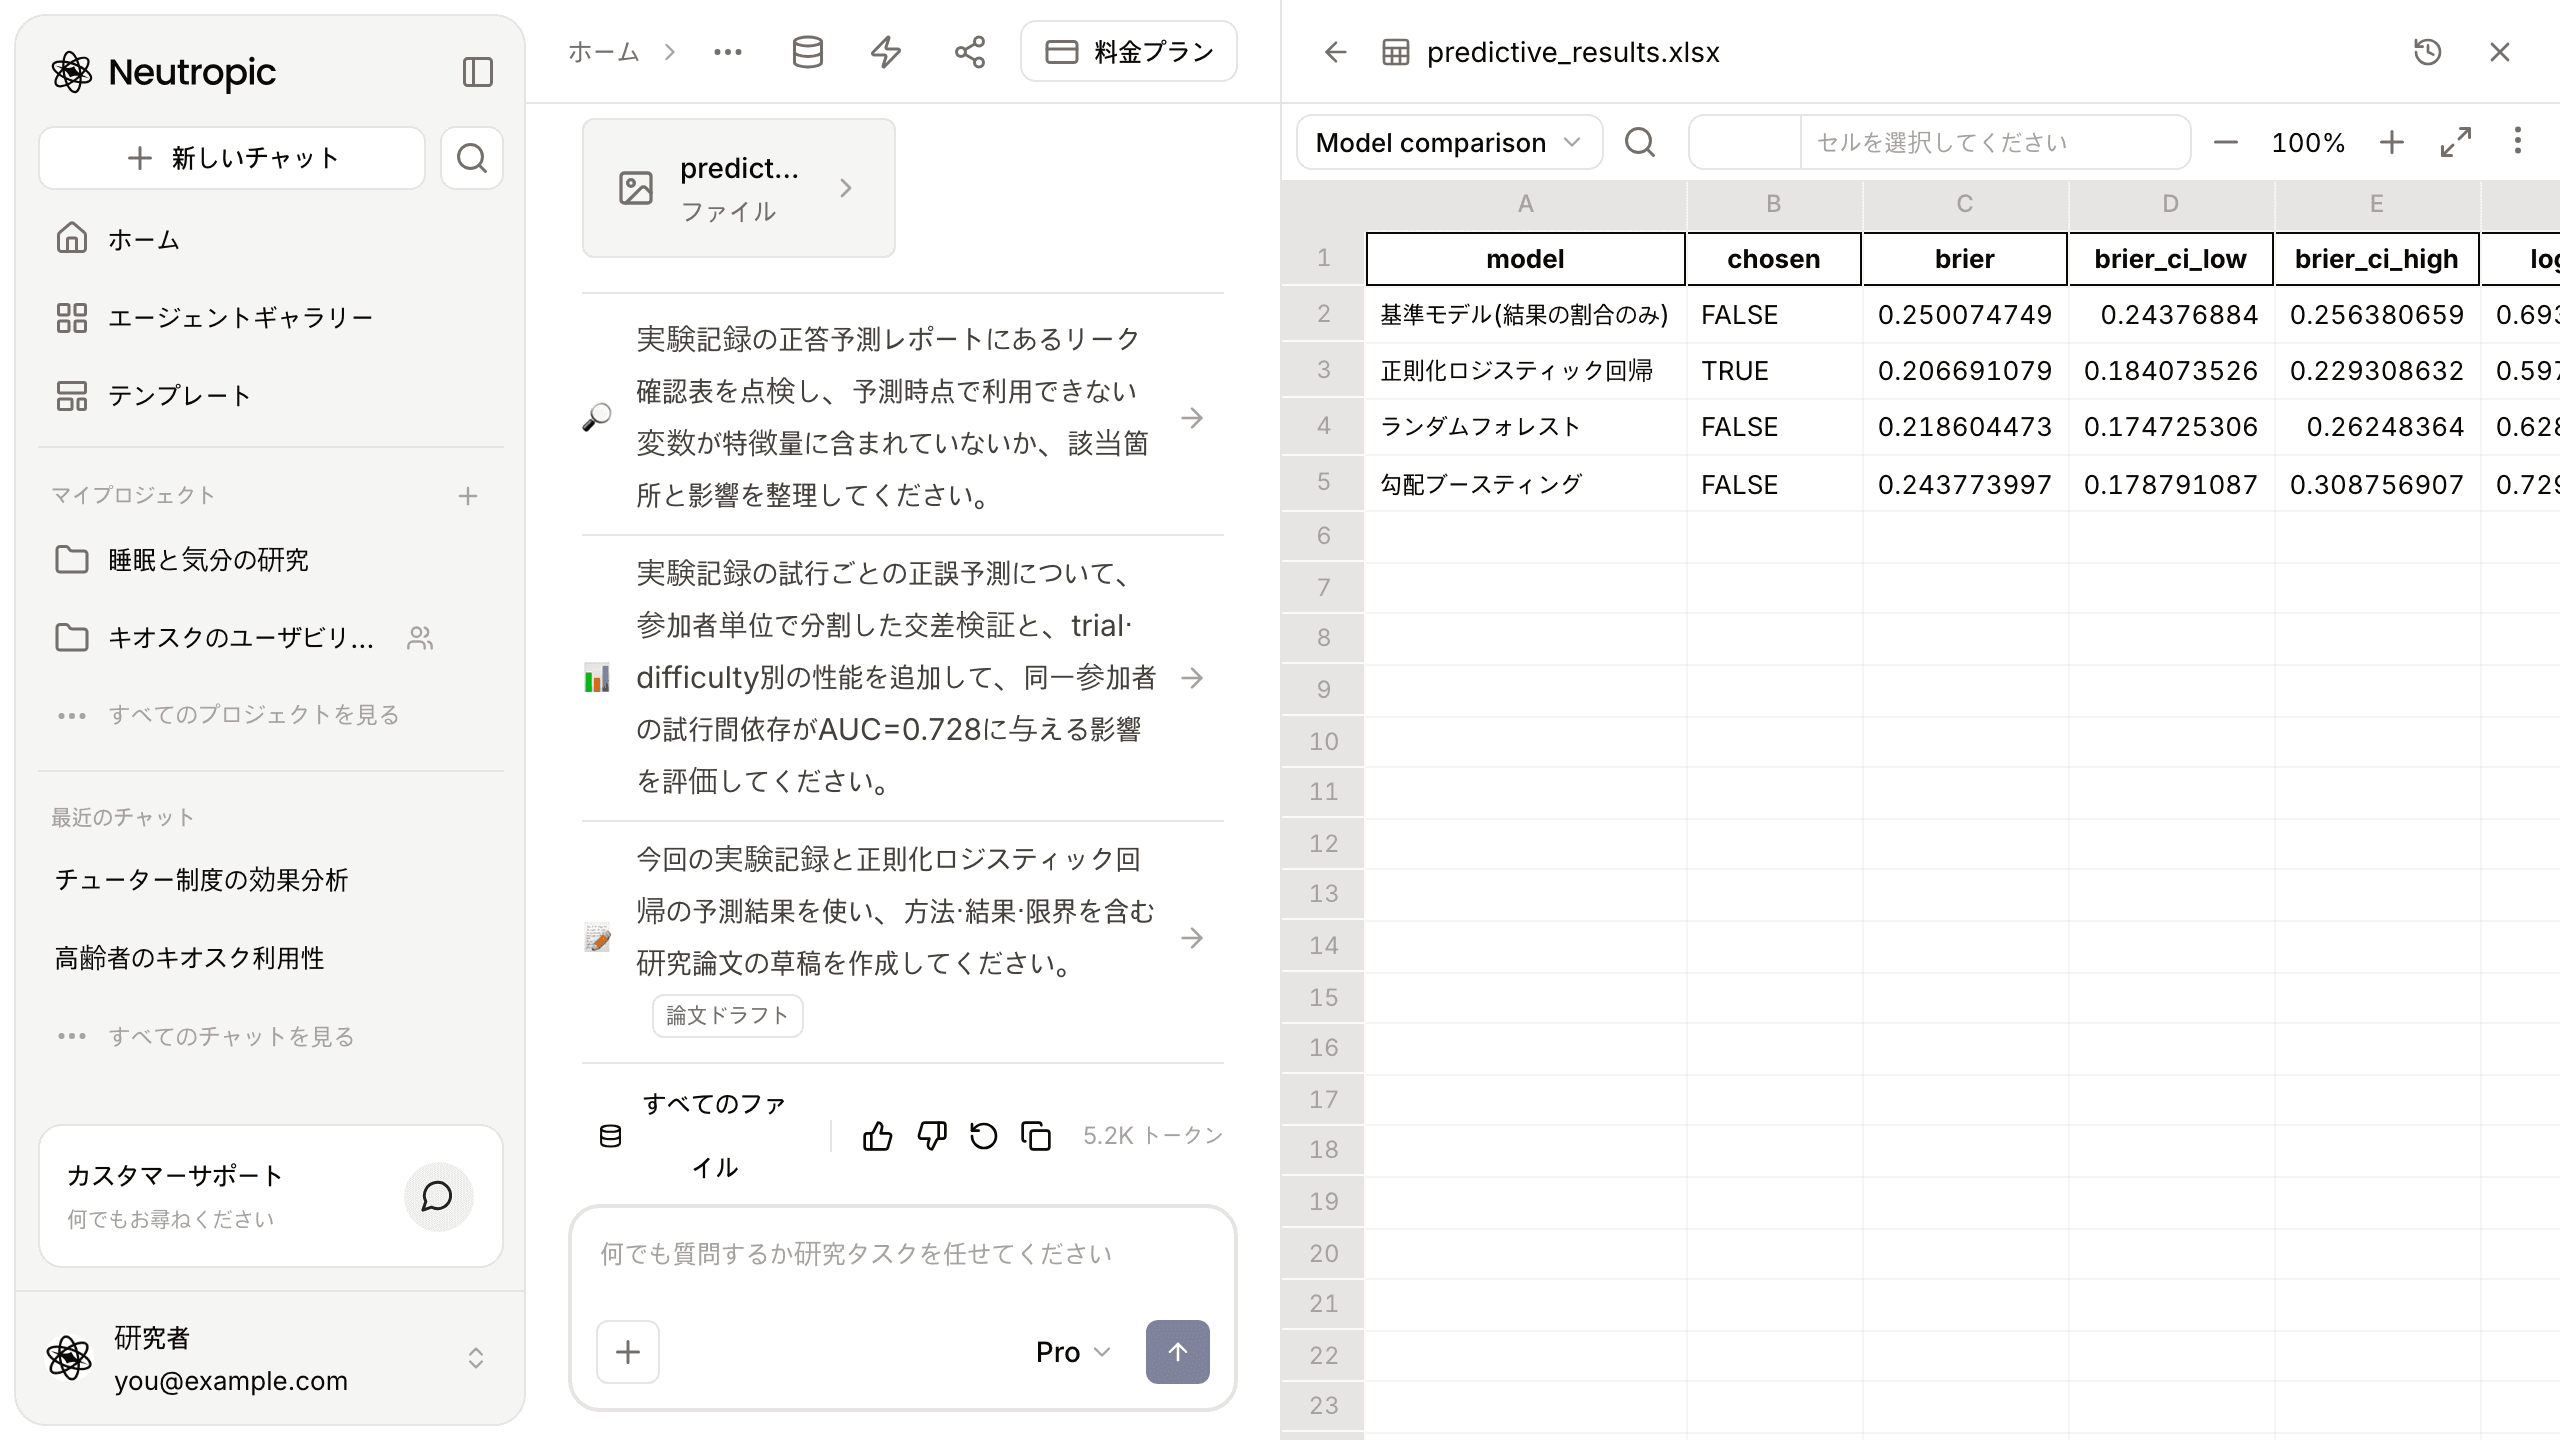
5つ目のステップで、正則化ロジスティック回帰、ランダムフォレスト、勾配ブースティングを同じ分割で比べました。最良は 正則化ロジスティック回帰、AUC 0.728、95% CI [0.676, 0.780] です。結果の表のBrierスコアも同じ傾向でした。基準モデル 0.250、正則化ロジスティック回帰 0.207、ランダムフォレスト 0.219、勾配ブースティング 0.244。
続く 較正と閾値 では、較正の傾き 0.98、切片 0.00、閾値 0.501 で感度 0.61・特異度 0.75。寄与と下位集団 では baseline_score、difficulty、age の寄与が大きく、下位集団16件を比較しました。回答の要約では trial も寄与の大きい指標に挙がっています。
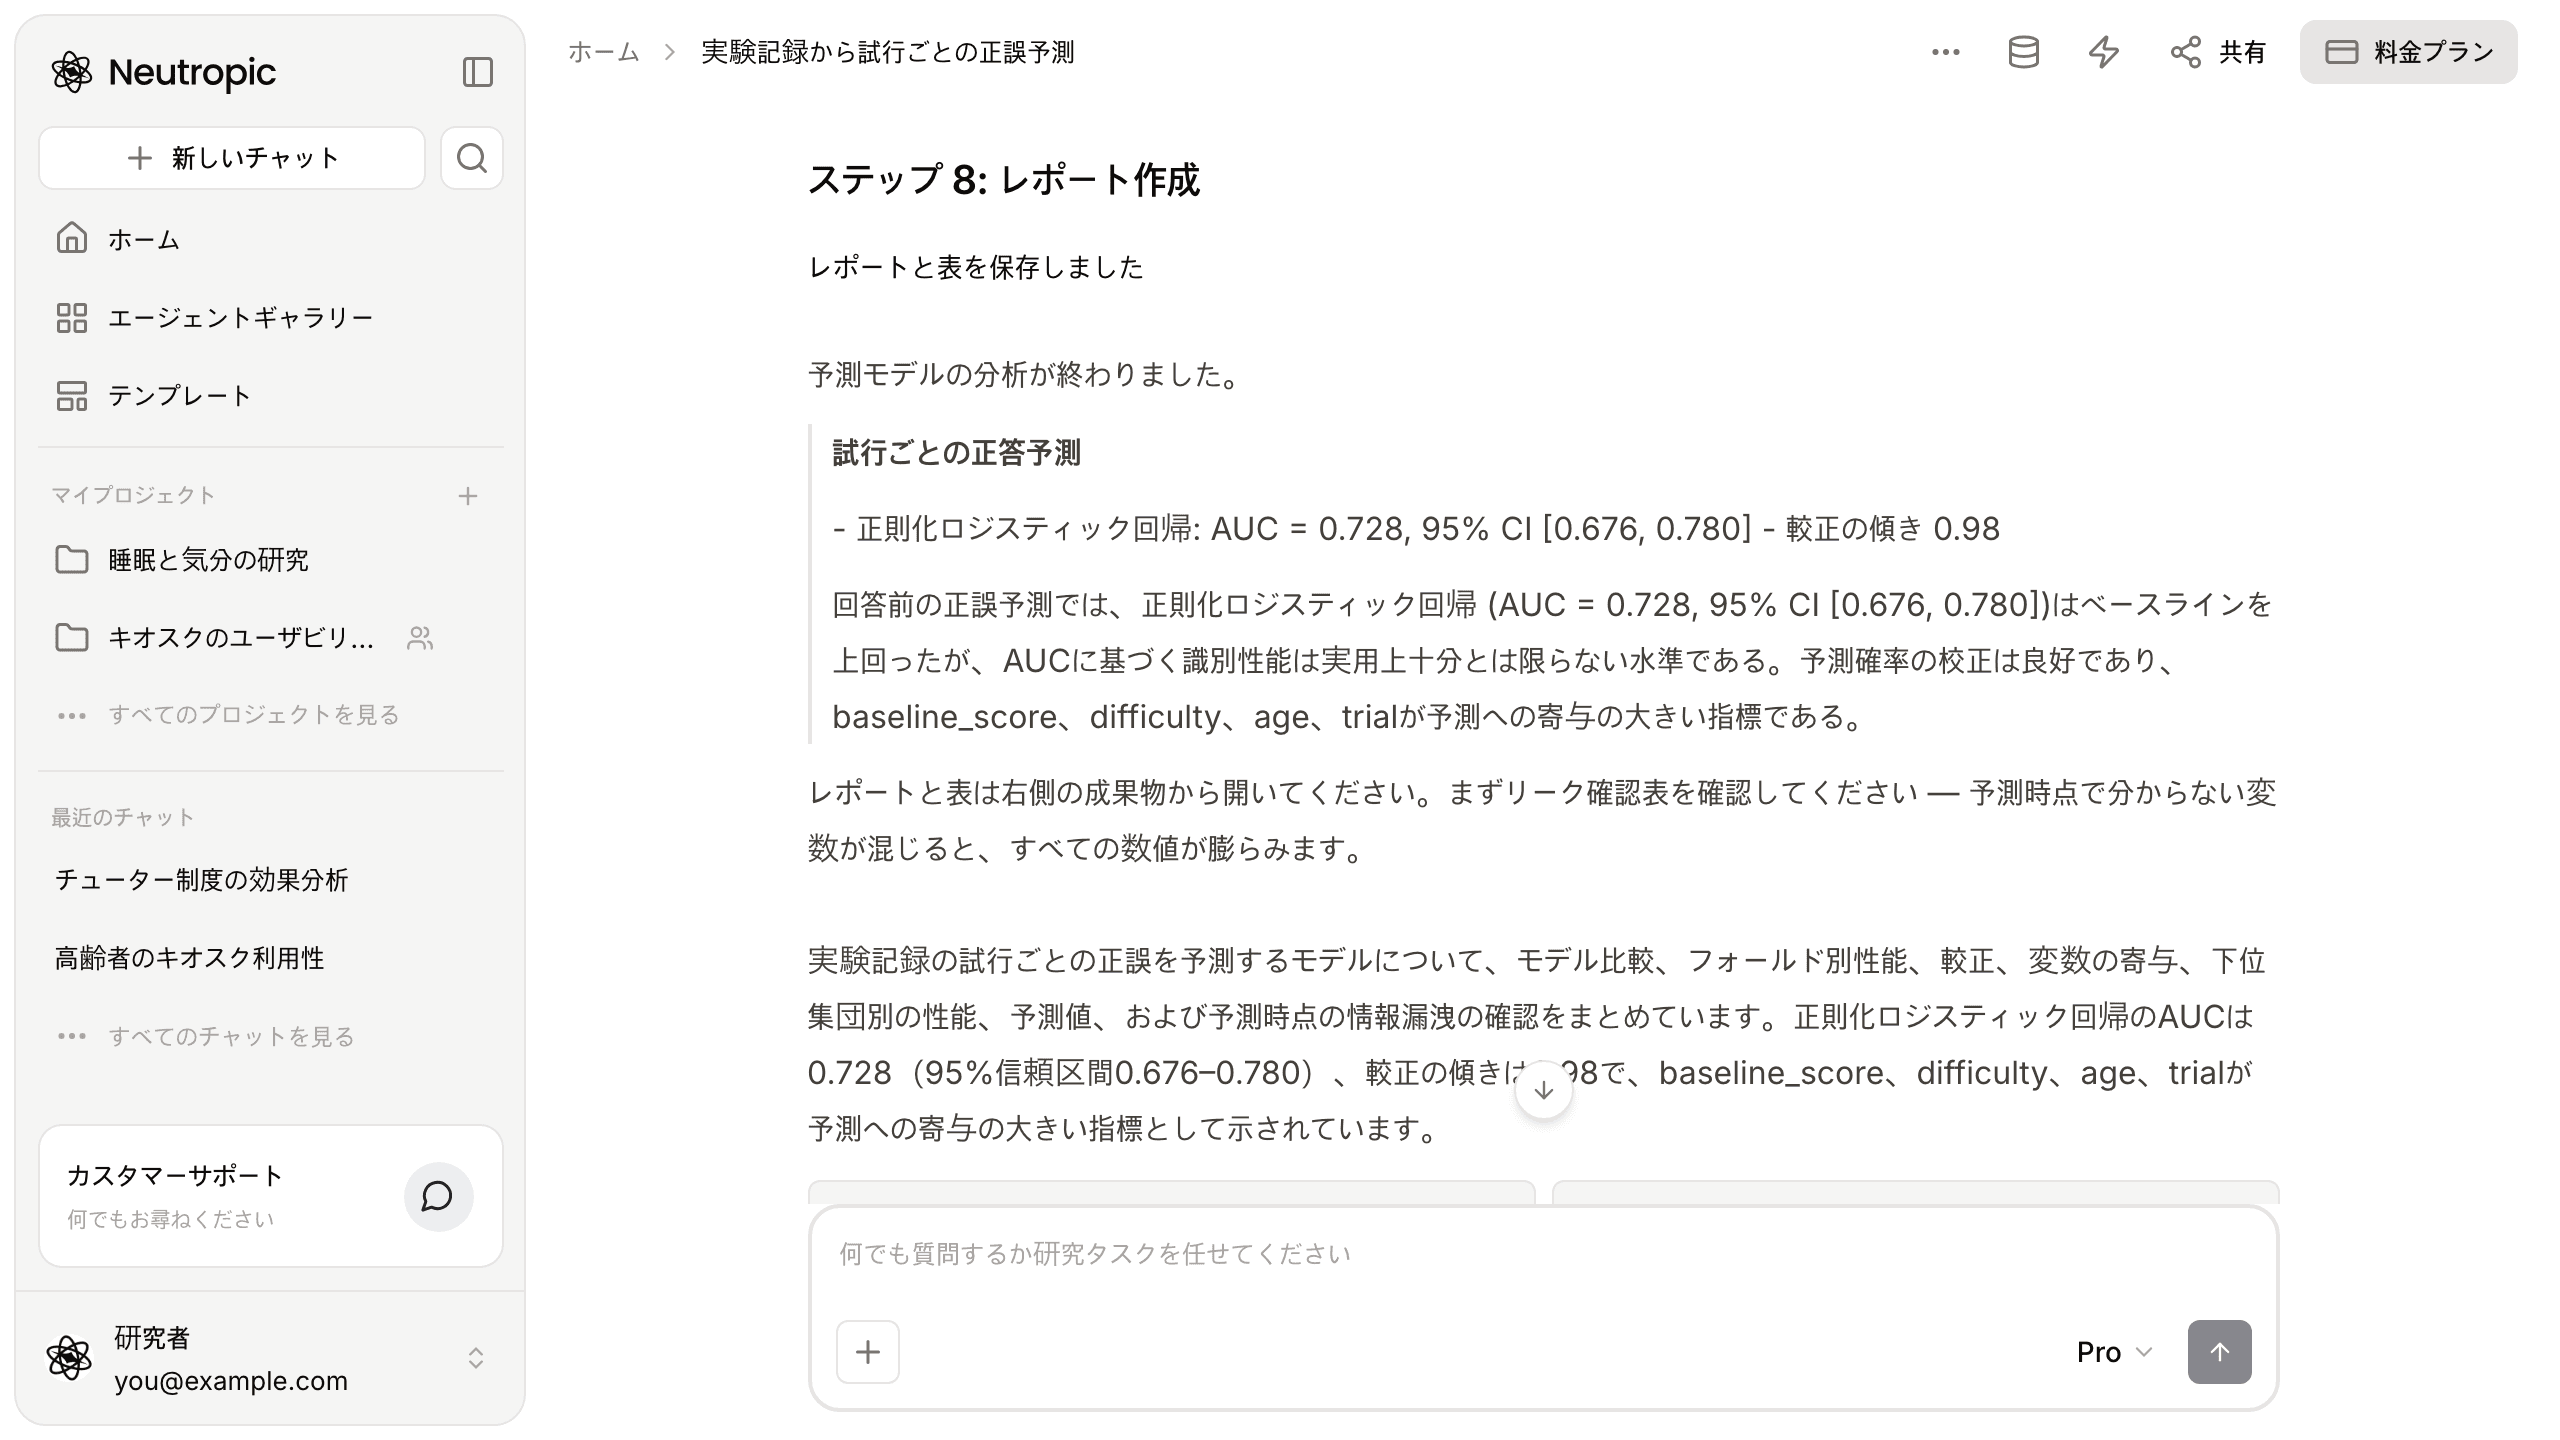
遥さんは「AUC 0.728なら十分」と書きかけました
数値を見て、遥さんは「予測できた」と書きたくなりました。でも回答はそこに釘を刺しています。正則化ロジスティック回帰はベースラインを上回ったものの、AUCに基づく識別性能は「実用上十分とは限らない水準」だと。較正は良好でも、正解と不正解を見分ける力そのものは控えめです。
もうひとつ、遥さんは反応時間を「効きそうな変数」として入れるつもりでした。エージェントが外していなければ、回答と同時にしか分からない情報で予測することになっていたわけです。回答の最後にも「まずリーク確認表を確認してください。予測時点で分からない変数が混じると、すべての数値が膨らみます」とありました。
結果の表と、次の一手まで受け取りました
成果物は2つです。predictive_report.md のレポートと、predictive_results.xlsx の結果の表。表にはモデル比較、分割ごとの性能、較正、変数の寄与、下位集団別の性能、予測値、リーク確認がまとまっています。ステップごとのコードボックスを押せば、実際に実行したPythonコードも見られます。
回答の下には、続けてできることが提案されていました。
- リーク確認表を点検し、予測時点で使えない変数が特徴量に含まれていないか、該当箇所と影響を整理する
- 今回の実験記録と予測結果を使い、方法・結果・限界を含む論文の草稿を作る — 論文ドラフト エージェント
遥さんなら、まず1つ目を押すでしょう。
膨らみかねなかった数値が、新しい人を基準にした数値になりました
| 始めたとき | 今 | |
|---|---|---|
| 交差検証 | 行をシャッフルして分けるつもりだった | participant_id 単位でまとめた5分割交差検証 |
| 予測変数 | 列を全部入れるつもりだった | 反応時間をリークとして外した4つ |
| モデル | 何を使えばいいか分からない | 基準モデルを含む4つを比較、正則化ロジスティック回帰を選択 |
| 性能 | 数値がひとつだけ | AUC 0.728 [0.676, 0.780]、較正の傾き 0.98 |
| 成果物 | なし | レポート、結果の表、ステップごとのコード |
限界もあります。AUC 0.73前後は中程度の識別力で、役に立つかどうかは目的に合わせて事前に決める必要があります。まとめた交差検証が推定するのは新しい参加者に対する性能で、既知の人の次の試行に対する性能ではありません。どの変数が予測時点で使えるかも、最終的には研究の問いに照らして自分で判断します。
この記事は Pro で実行し、約110秒かかりました。Proは較正・閾値・変数の寄与・下位集団を加えます。Lite(無料プラン)はモデル比較まで、Expert はさらに頑健性の確認とより長い考察を加えます。
反復測定データの予測性能は「新しい人」を基準に測るもの。ファイル1つと一行の依頼で、その基準から始められます。
今週、遥さんのように実験記録を添付して、一行で聞いてみてください。Neutropicを無料で始める