こんにちは、Neutropicチームです!
「マインドフルネスアプリを使えば試験不安は減るのでは?」そんなアイデアが浮かぶと、すぐにでも実験を組みたくなりますよね。でも指導教員の最初の質問は、たいてい決まっています。「先行研究は調べた?」🥲
実際に調べてみると、これが大変です。検索語ごとに結果は数百件。アプリの研究なのか対面プログラムなのか、大学生が対象なのか社会人なのか、抄録をひとつずつ開かないとわかりません。何件か絞り込めても、「結局、効果はあるの?ないの?」に答えるのは意外と難しいものです。
この記事では、教育心理学専攻の修士課程 千尋さん が、修士論文の実験を設計する前に先行研究を整理する流れを追います。千尋さんは架空の人物ですが、以下の画面はすべてNeutropicで実際に実行した結果です。
知りたいことを4つ、ひとつの段落にまとめました
千尋さんは エージェントギャラリー で ナラティブレビュー エージェントを開き、Pro を選んでこう送りました。添付ファイルはありません。
マインドフルネスアプリが大学生の不安やストレスを減らすかについての先行研究をまとめてください。ランダム化比較試験を中心に、どのアプリと介入期間を使ったか、対照群は何か、効果の大きさ、研究の限界を知りたいです。
よい依頼である理由は2つあります。範囲を絞ったこと(大学生、マインドフルネスアプリ、不安・ストレス、ランダム化比較試験)、そして取り出したい情報を4つ(アプリと期間、対照群、効果の大きさ、限界)に決めたことです。どれも、後で実験を設計するときにそのまま必要になる情報です。
質問を3つに分け、9ステップで文献を集めました
実行は9ステップで、3分ほどで終わりました。ステップ1 目的と質問 で、依頼が核心質問3件に整理されました。どのアプリ・介入期間・対照条件が用いられているか、不安・ストレスをどの程度軽減し、その効果は追跡時にも認められるか、どのような限界があるか、の3つです。
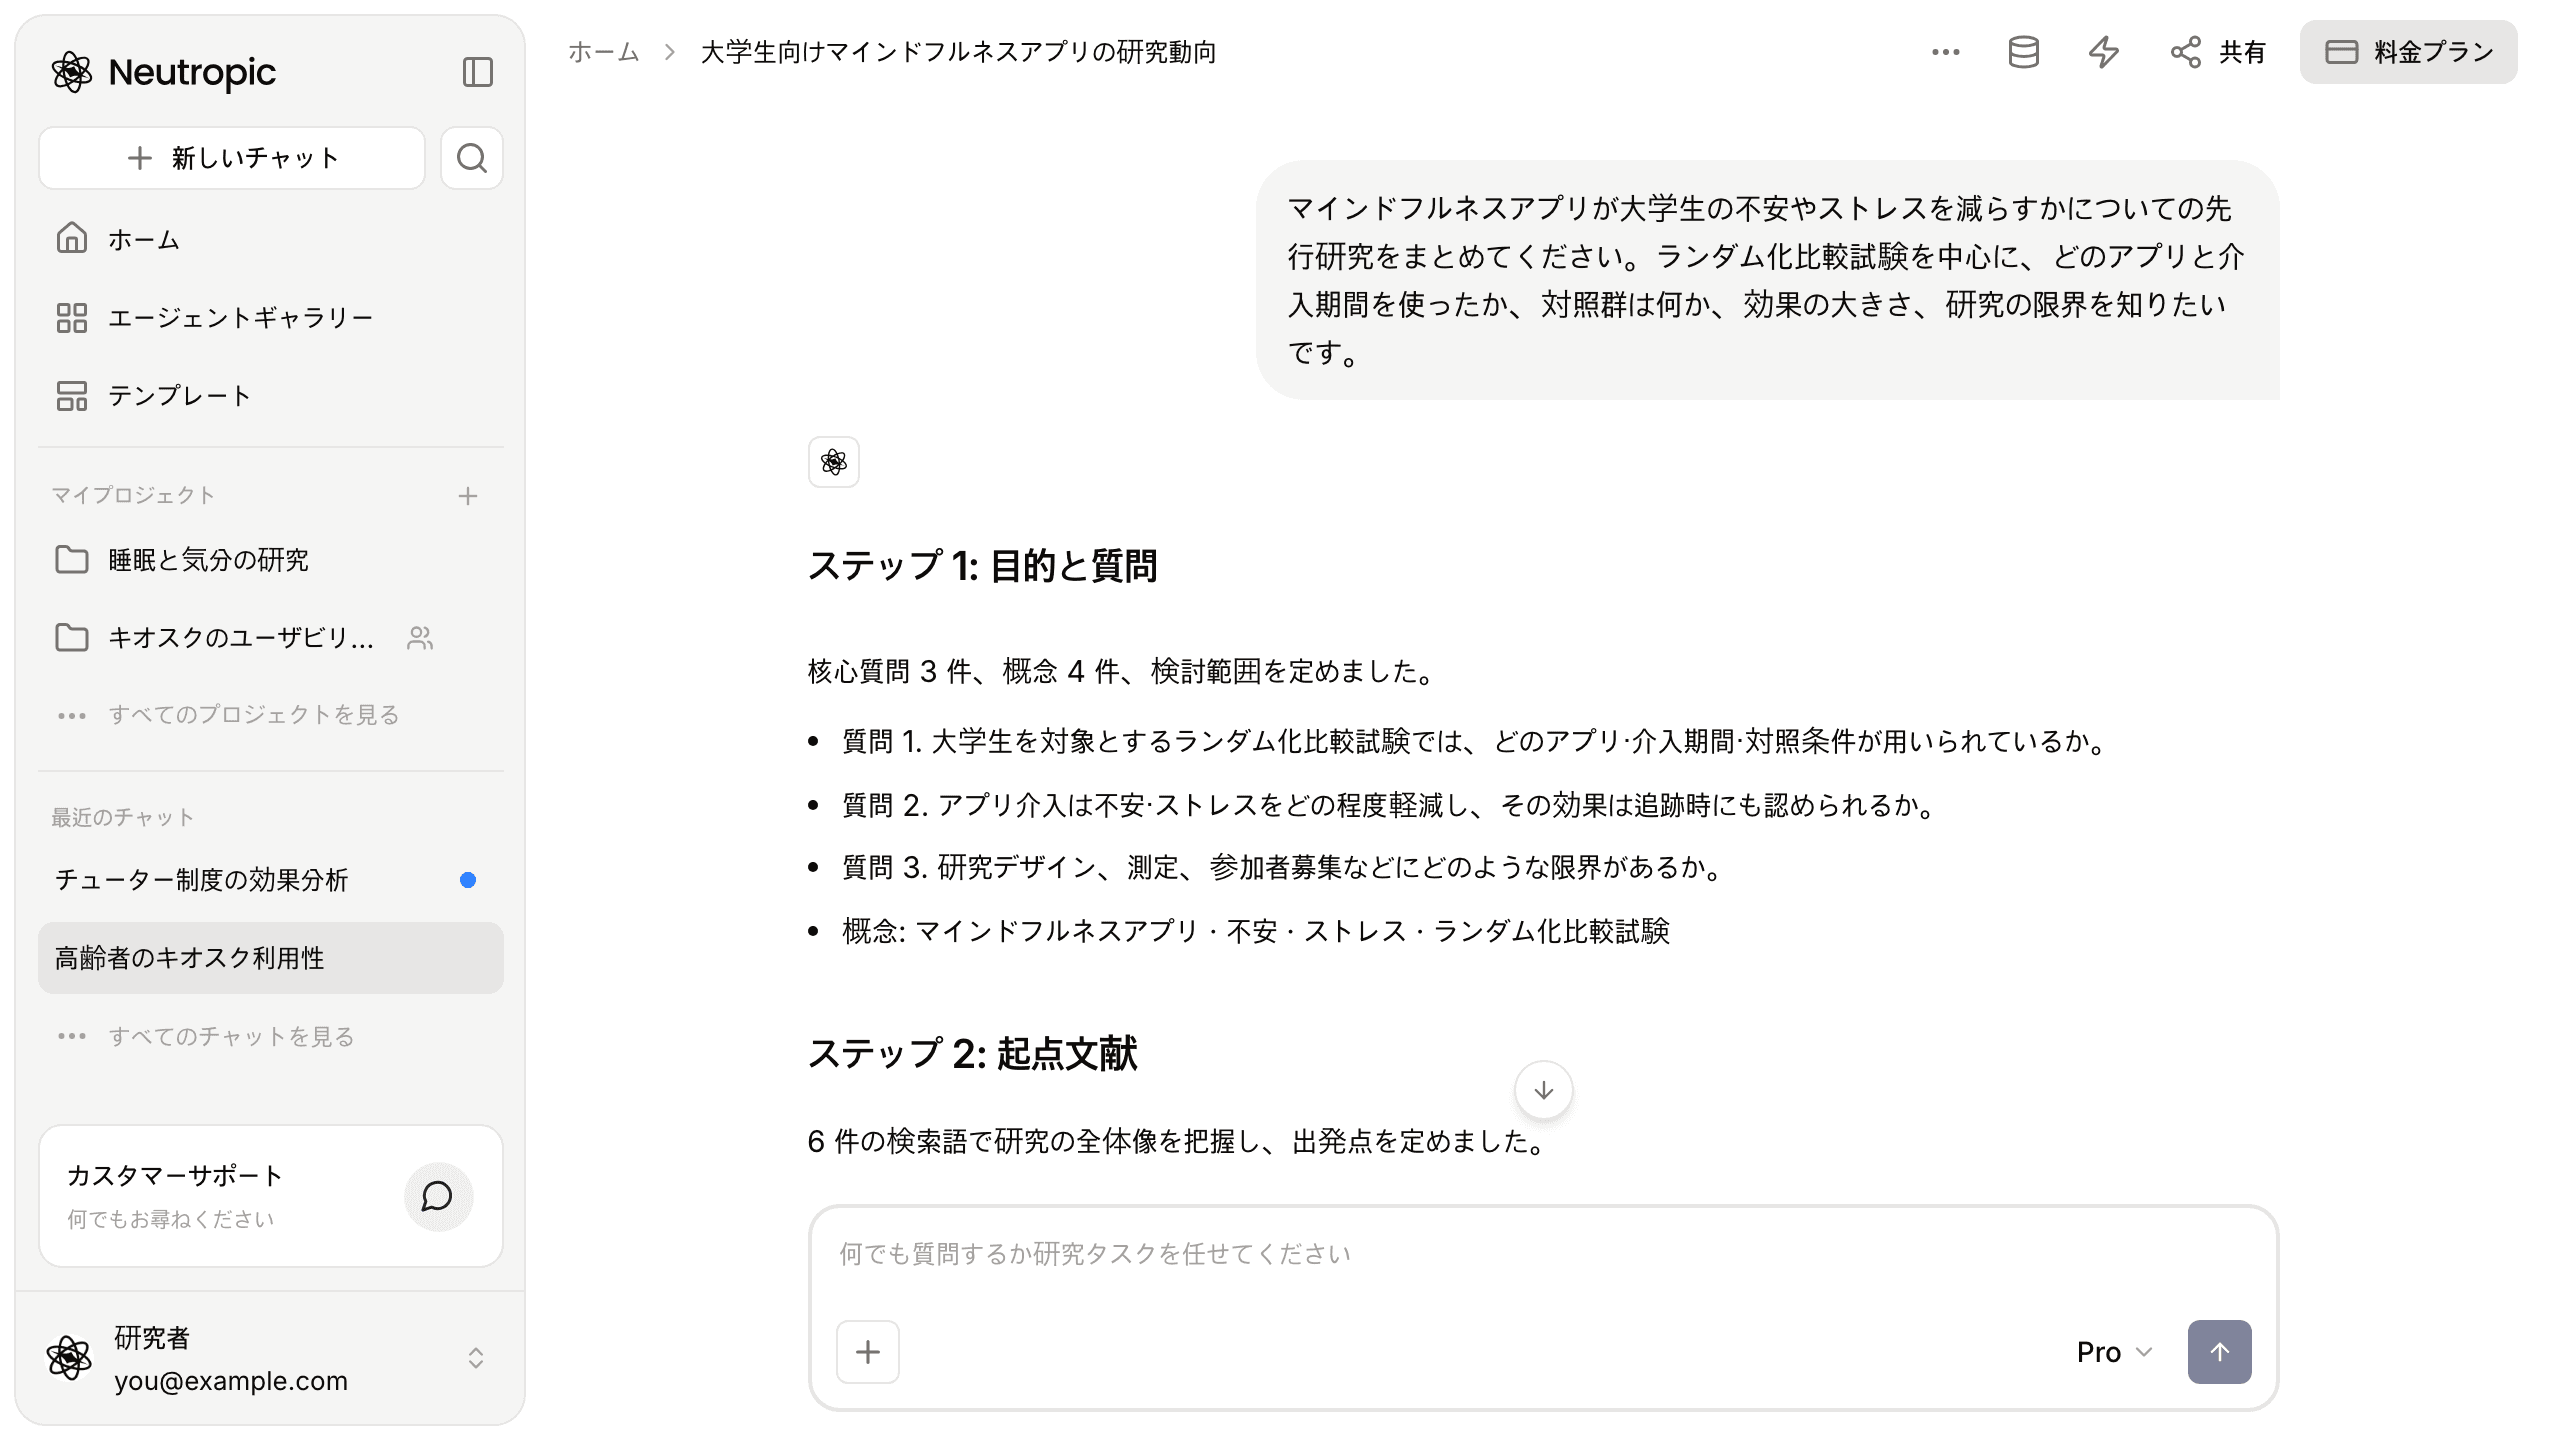
ステップ2と3では、検索語6件で出発点を決めてから、複数のデータベースで文献200件を集めました。うち59件は、重要な論文の参考文献や被引用文献をたどる 引用追跡 で見つけたものです。ステップ4 飽和判断 の記録は正直でした。このレベルの引用追跡の上限(1回)で終了し、新しい文献が出てこなくなる飽和には達していない、とあります。
200件から15件を選び、残りは理由とともに記録しました
ステップ5 選定と記録 で、200件中15件が選ばれました。残る185件には除外理由が付いています。対象・文脈が範囲外が147件、主題と無関係が20件、関連性は高いが検討規模を超えたため外したものが18件です。すべての判断は「選別結果」の表に残るので、「この論文はなぜ外れたの?」と思ったらすぐ確かめられます。
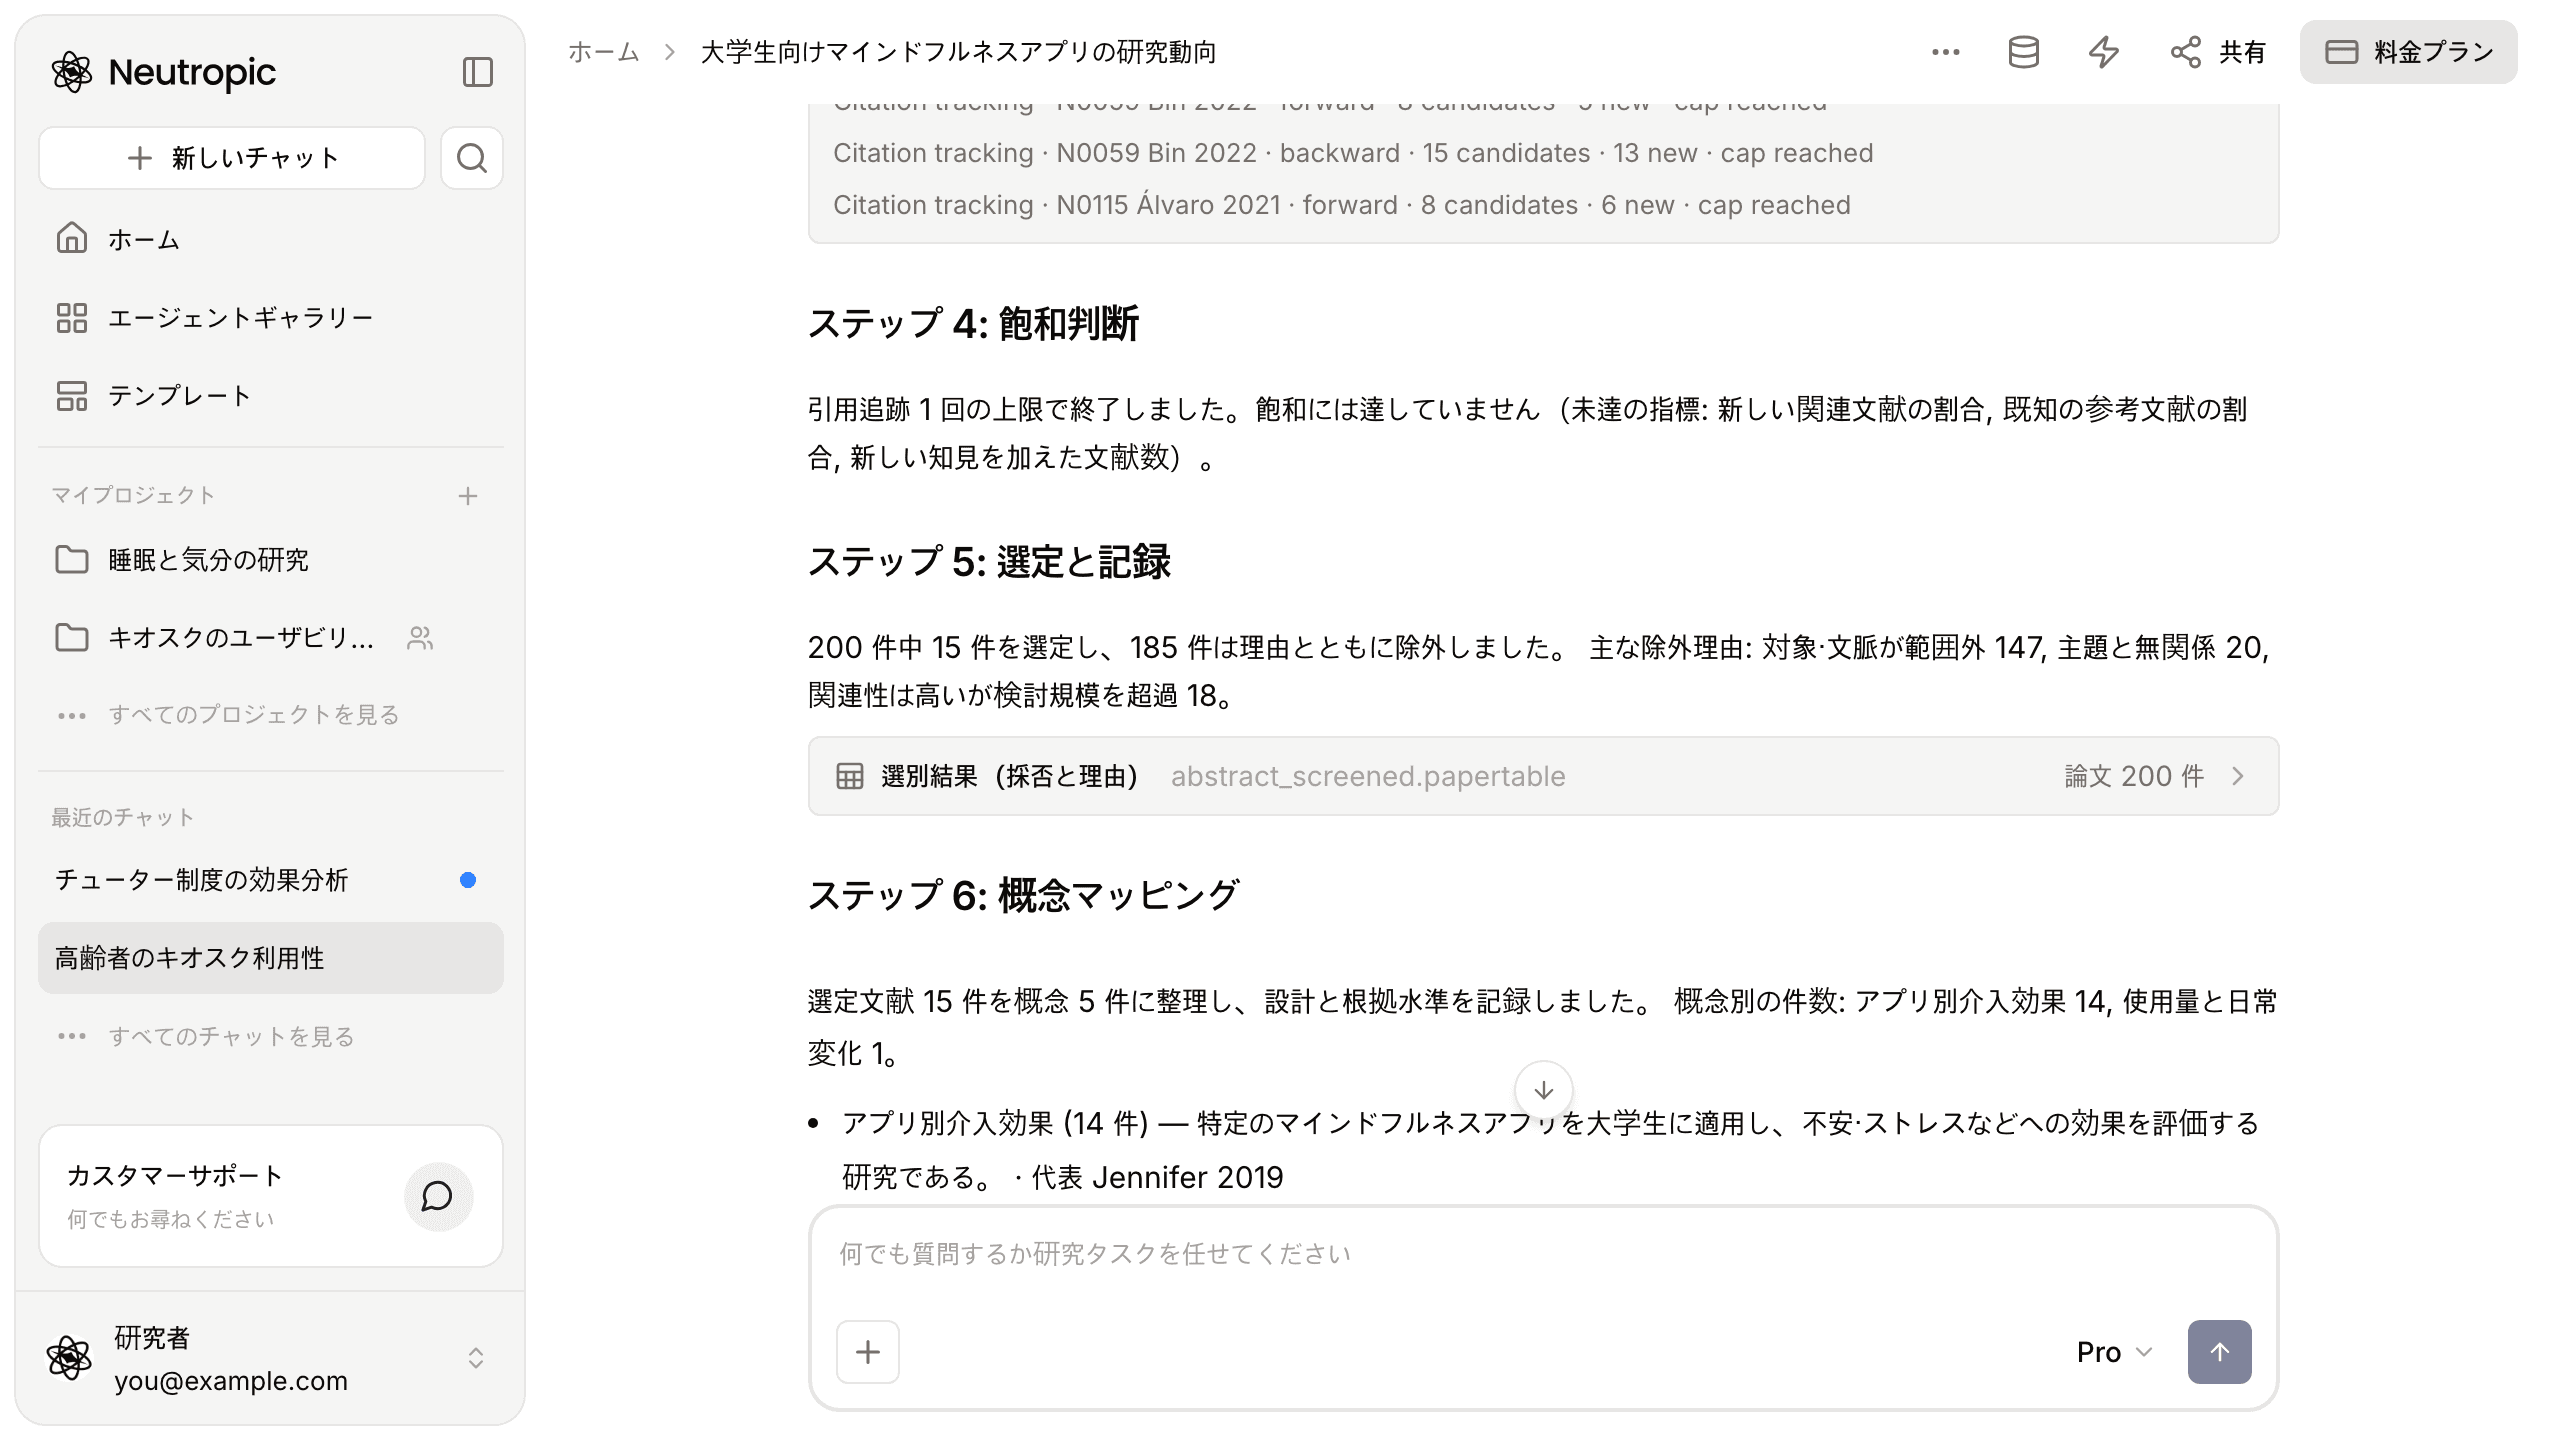
ステップ6と7では、選定文献を概念ごとにまとめ、根拠水準を記録しました。無作為化実験12件、準実験2件、縦断研究1件です。3つの質問はどれも 暫定的に支持(確立していない) と判断されました。
結論ごとに根拠の強さが付いていました
最終回答では、試験の条件が具体的に並びました。Brightmindを4週間毎晩使って2048ゲームと比べた試験、Calmを8週間使って待機リストと比べた試験、Sanvelloによる4週間のMBCTをポジティブ対照と比べたクラスター試験、医療系学生を対象にアプリ介入を対面介入・対照と比べた試験などです。
効果は試験によって一致しませんでした。Sanvelloの試験(大学生年代の289人)では、MBCT群のほうが特性不安と慢性ストレスの低下が大きかった一方、大学アスリート288人の試験では、どの不安アウトカムにも有意な群間差がありませんでした。医療系学生の試験(解析対象84人)では、アプリ群は対照群より特性不安が下がりましたが、対面マインドフルネス群との差は有意ではありませんでした。限界としては、40人規模の予備的試験、平均利用が7.91セッションにとどまった新入生の試験などが挙げられています。
千尋さんは危うく「効果は追跡時も続く」と書くところでした
千尋さんは、介入後だけでなく追跡時点も測る実験を考えていました。「アプリの効果はしばらく続くはず」と、計画書に先行研究の裏付けとして書こうとしたのです。でもレビューの結論ははっきりしていました。追跡時の持続性は確立していない。 Calmの試験は抄録で群間に有意差があったとしつつ、アウトカム別の結果や追跡結果の詳細は示されておらず、医療系学生の試験も評価は介入後の時点だけで、長期の持続を示すものではありませんでした。
さらに検討規模の行には、選定15件のうち全文を確認したのは3件、12件は抄録のみ とあります。だからこそ、すべての結論に「暫定的に支持」が付いているわけです。効果の大きさや持続性を計画書に書くなら、まず全文を読んで確かめる必要があります。
レポートと文献整理表が一緒に残りました
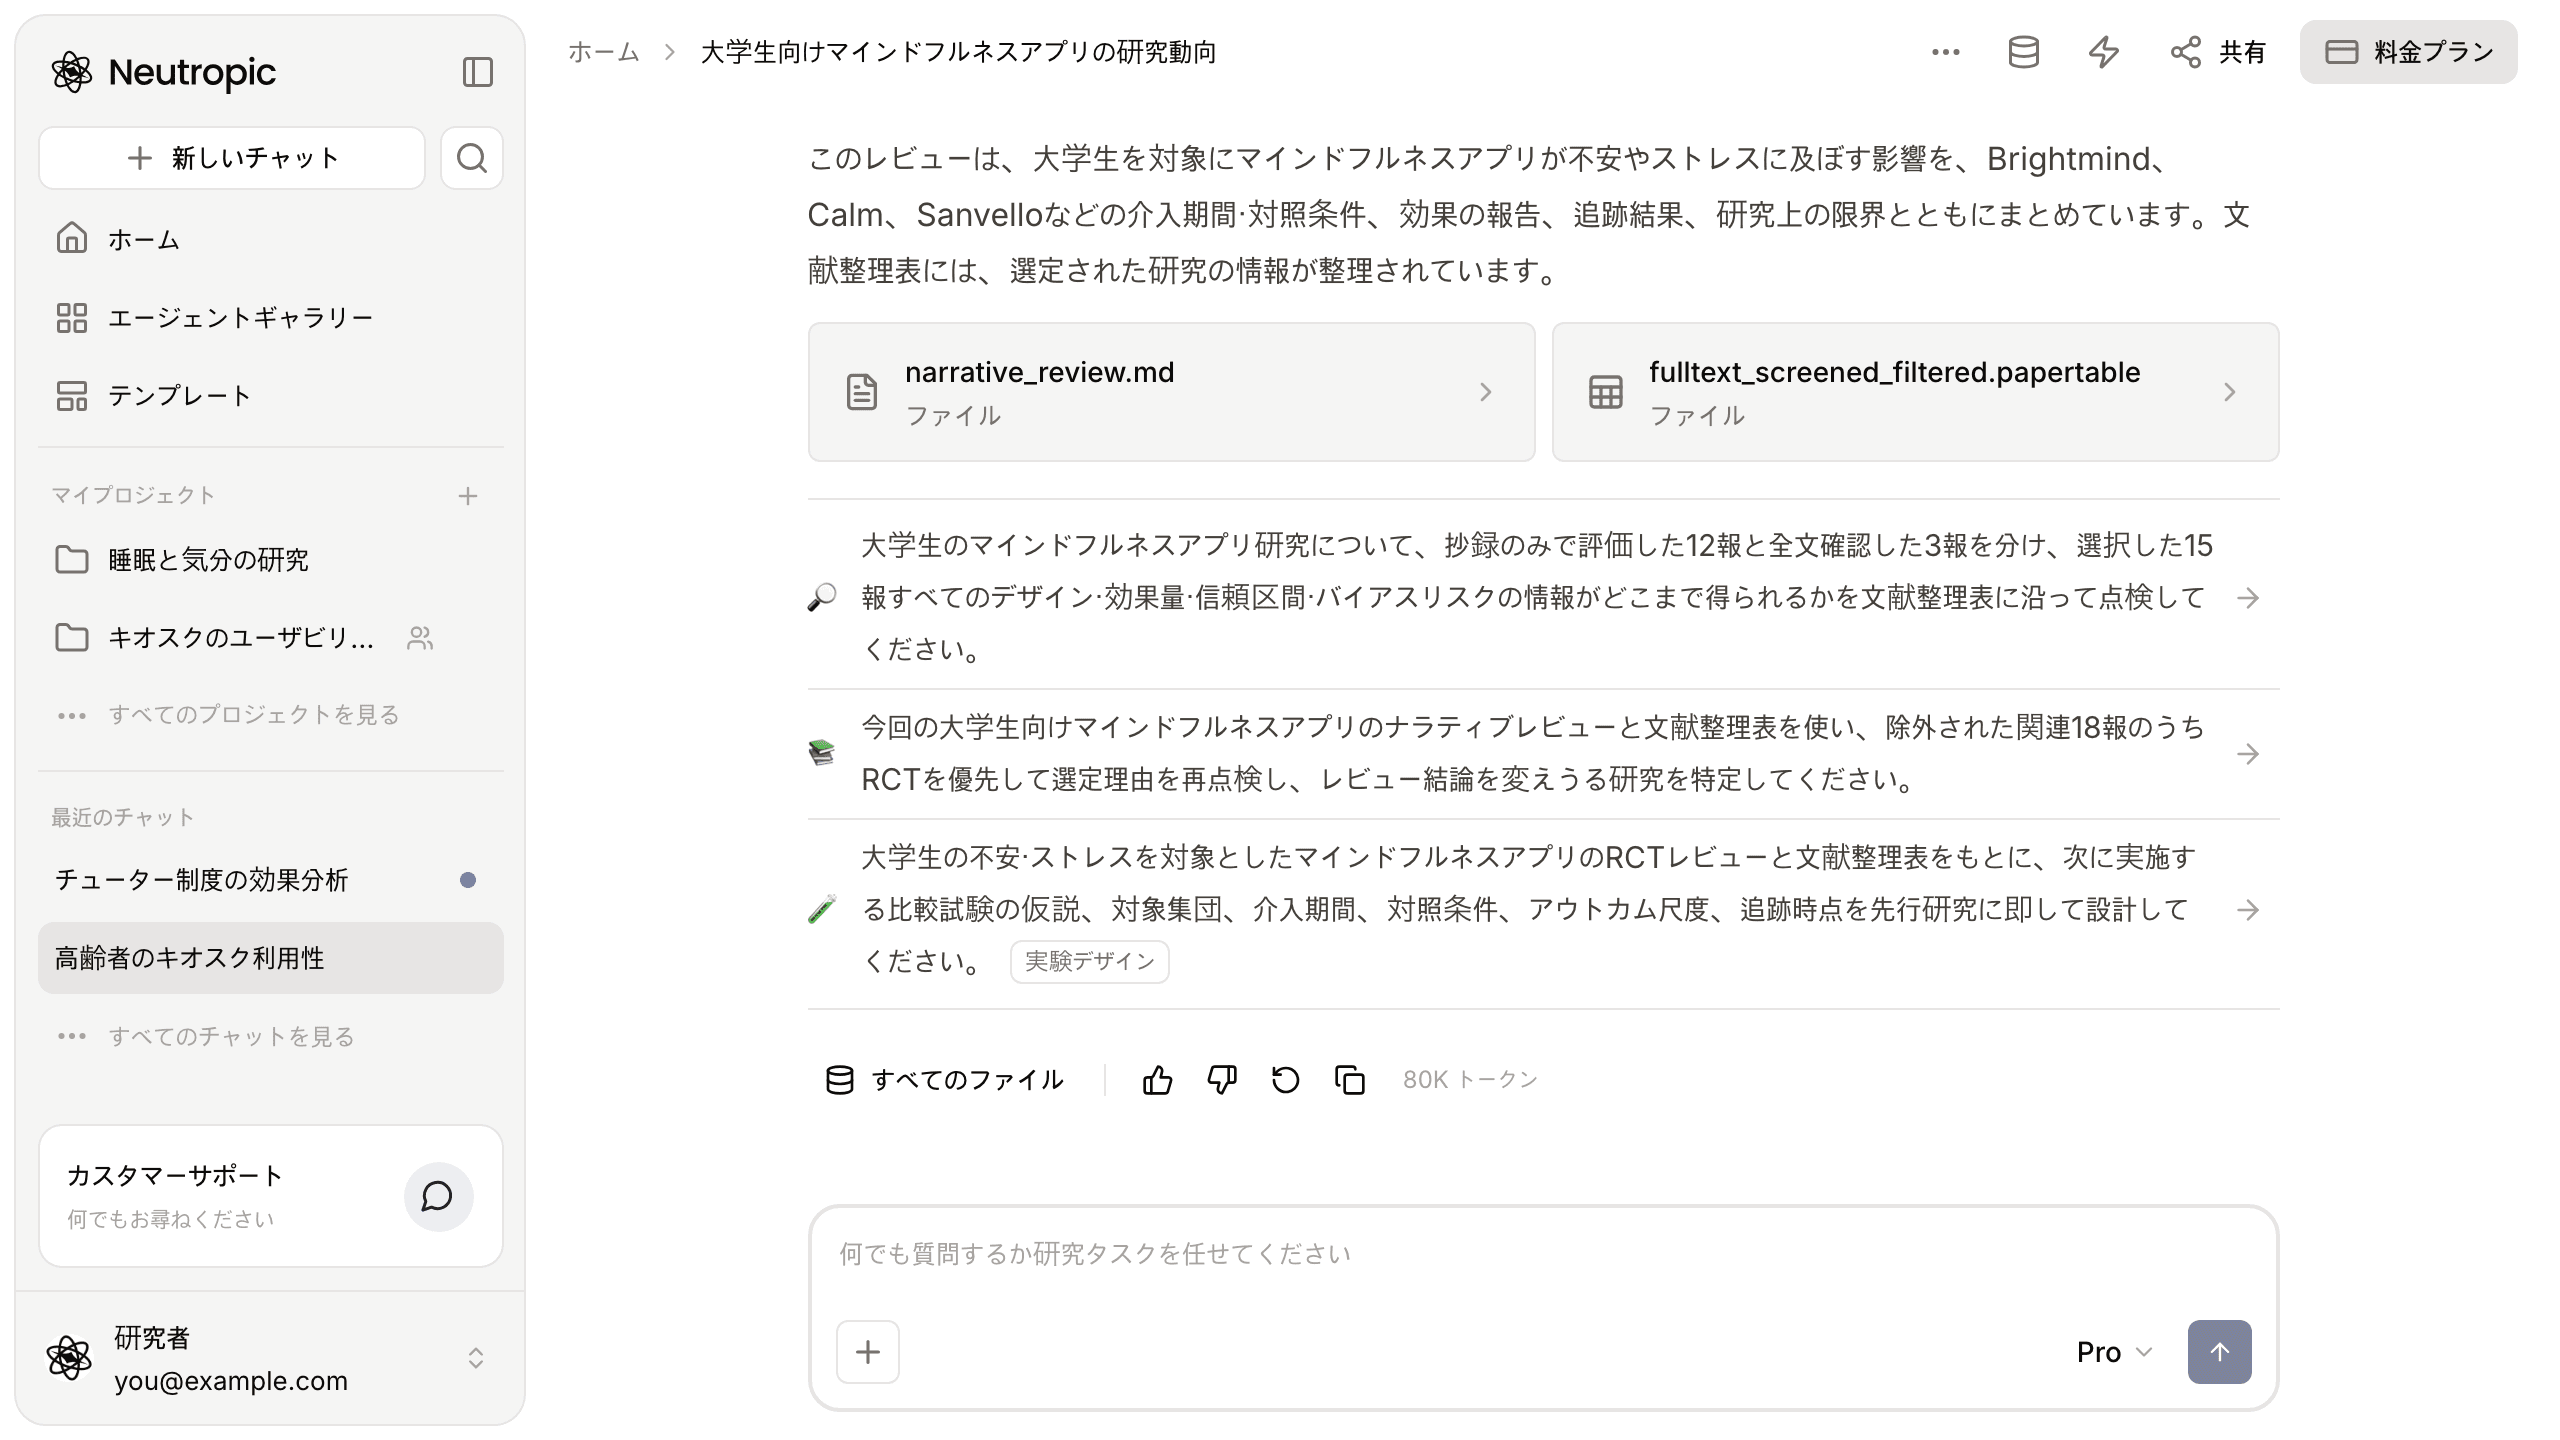
最後のステップ9でレポートが作成され、点検を終えました。成果物は2つです。レビュー報告書(narrative_review.md)と、レポートで引用した15件を引用番号順に並べた最終の文献整理表です。レポートの[番号]が整理表の引用番号とつながっているので、文の根拠をすぐたどれます。
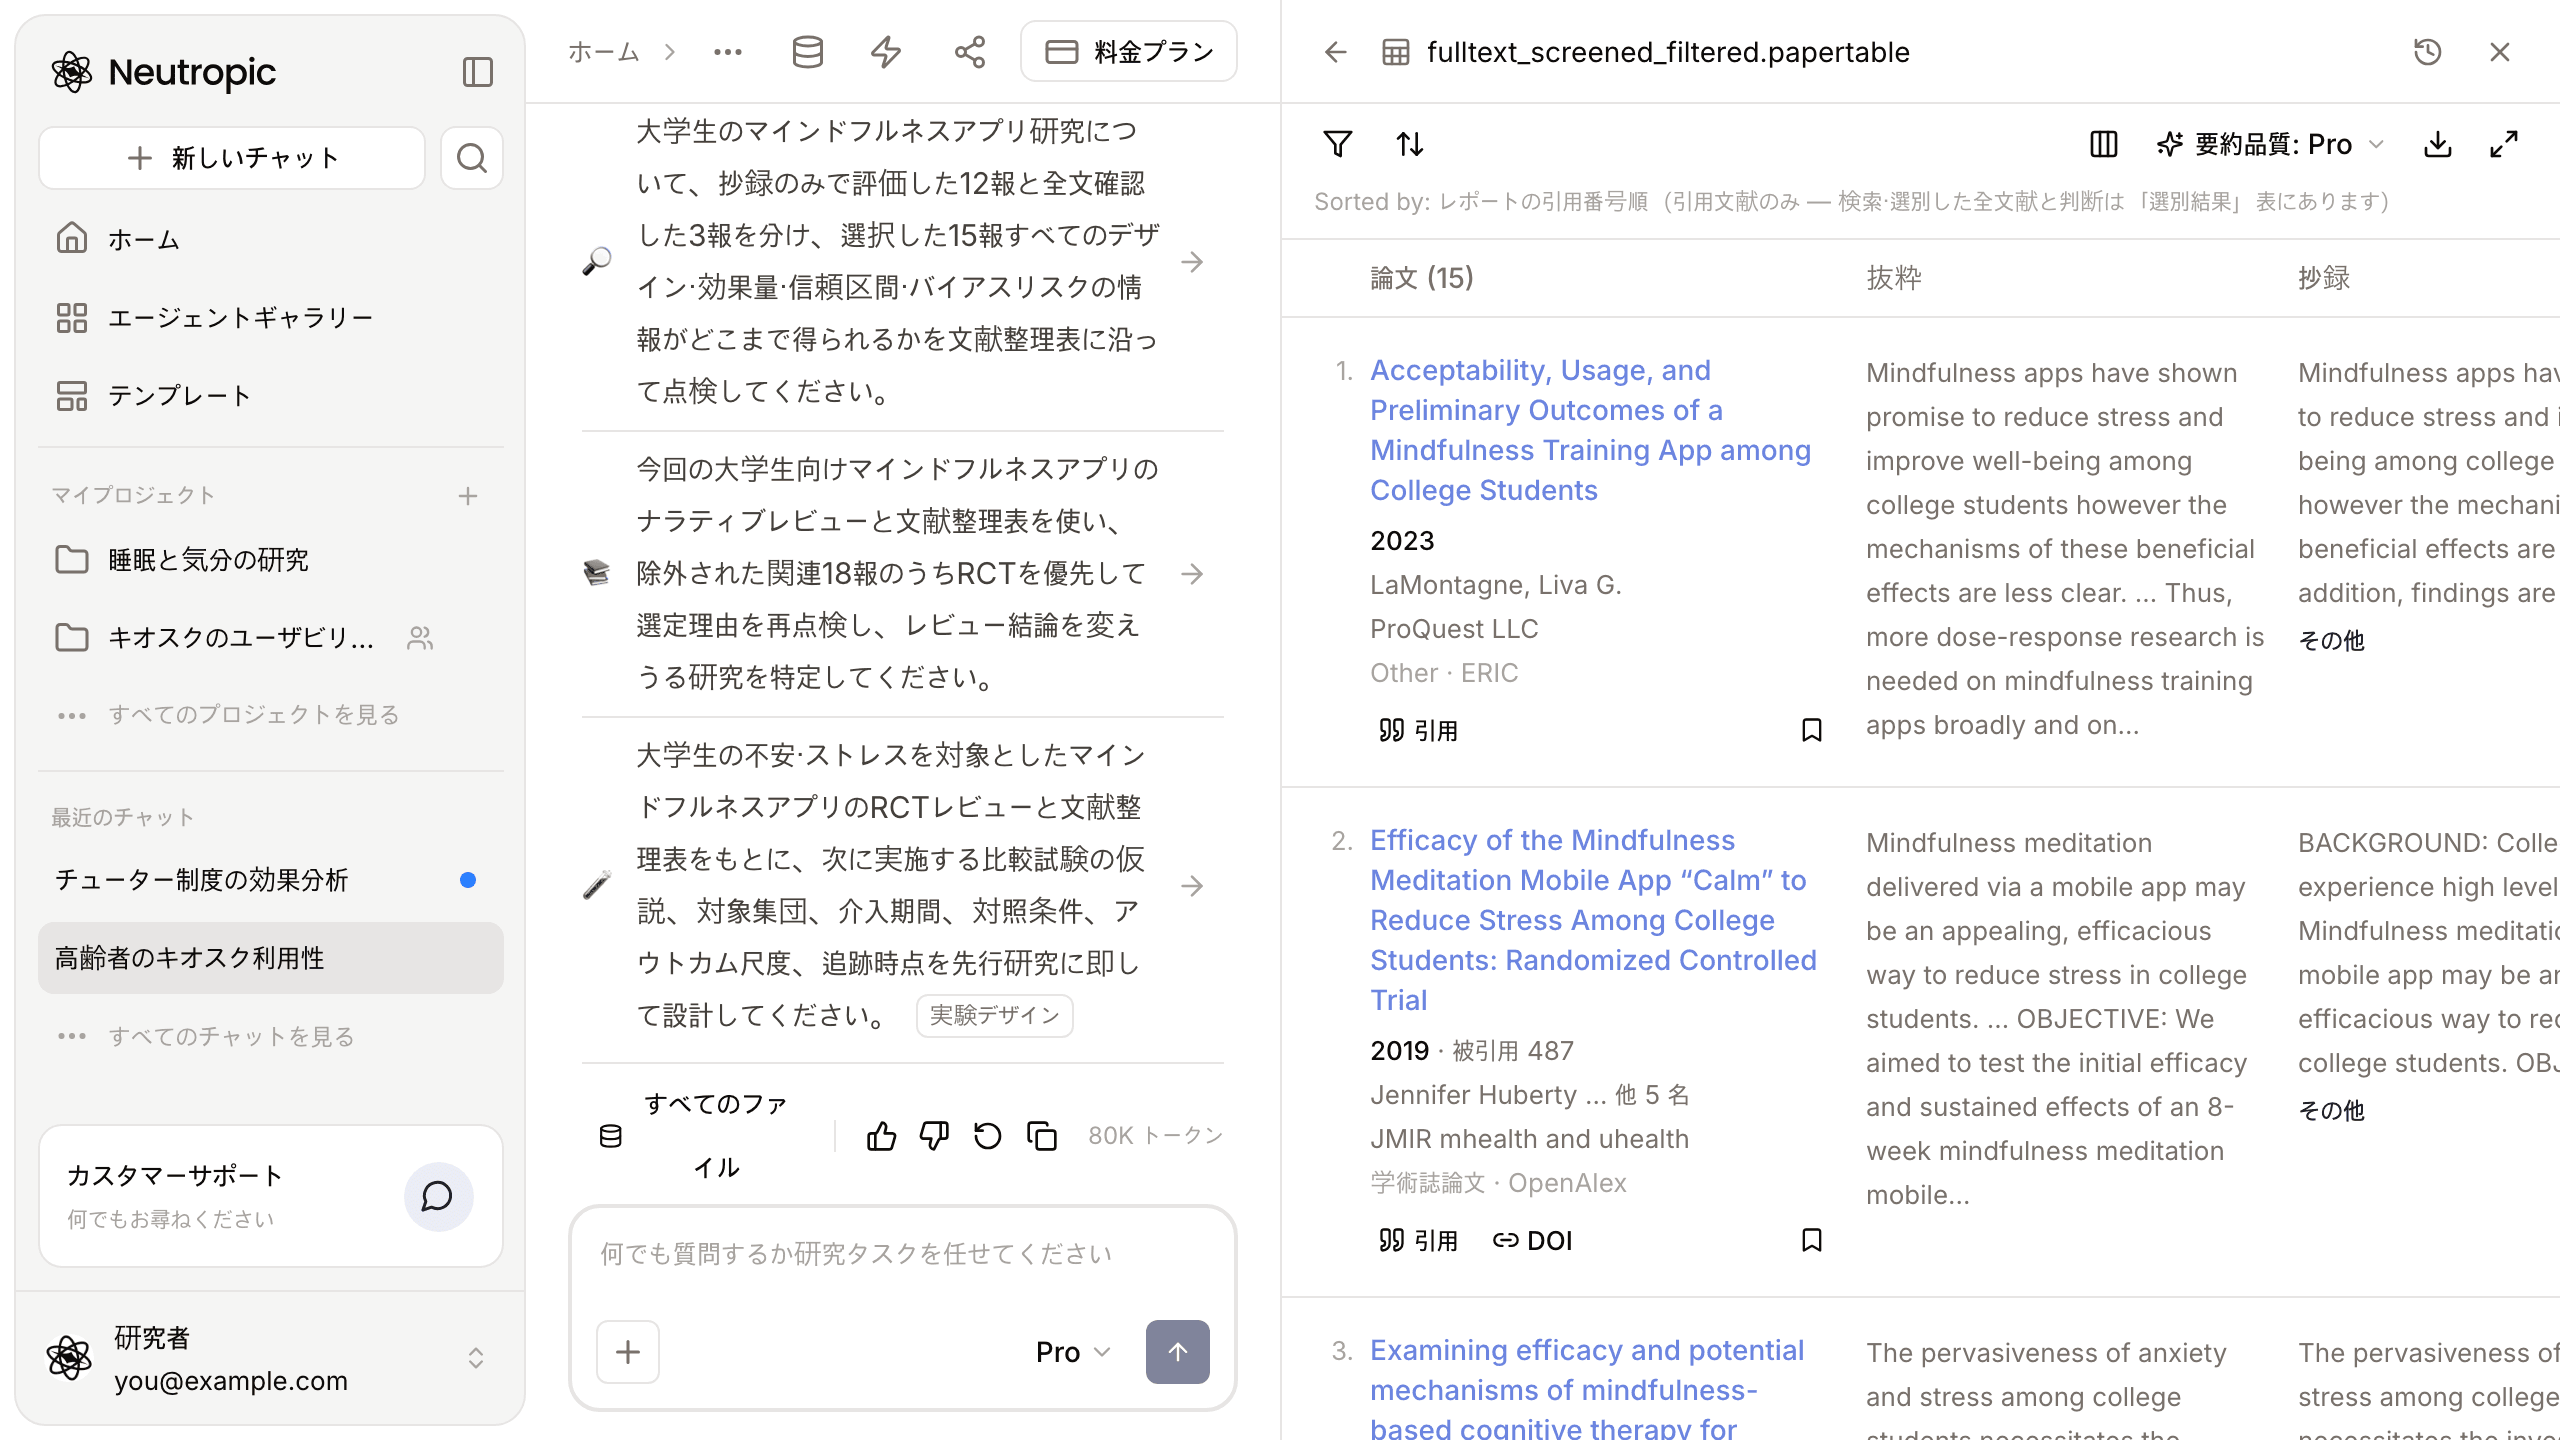
まず確認 には、抄録だけで評価した12件はPDFを添付するかZoteroを連携すればより正確に評価できること、規模のため除外した関連文献18件の再検討を勧めることが書かれていました。回答の下には次の提案が3つ並び、そのうちひとつは、このレビューをもとに次の比較試験を設計しようという 実験デザイン エージェントの提案でした。
漠然とした検索が、根拠の強さ付きの先行研究マップになりました
| 始めたとき | 今 | |
|---|---|---|
| 質問 | 「アプリで不安は減る?」 | 核心質問3件 |
| 文献 | どこから探せばいいかわからない | 200件を収集、15件を選定、185件に除外理由 |
| 結論 | 「効果があるらしい」 | 根拠の強さ付きの結論、すべて暫定的に支持 |
| 追跡効果 | 続くと思っていた | 持続性は確立していないとわかった |
| 残る作業 | 途方に暮れる | 抄録のみの12件の全文確認、除外候補18件の再検討 |
限界も書いておきます。15件中12件は抄録だけで評価しており、引用追跡は1回で止まって飽和には達していません。検索したデータベース10件のうち応答したのは9件でした。ですからこのレポートは「結論」というより、全文を読む順番を決めるための地図に近いものです。それでも、数百件の検索結果の前で途方に暮れるのと、採否の理由が記録された15件から始めるのとでは、まったく違います。
この記事は Pro を使っており、文献整理表は最大200件、選定は最大15件、全文は最大5件、引用追跡は1回までです。Lite(無料プラン)は整理表最大100件、選定最大8件、全文最大2件で手早く全体を見渡します。Expert は整理表最大400件、選定最大25件、全文最大10件、引用追跡2回まで広げ、原稿の品質点検ももう1回行います。
ひとつの段落で、根拠の強さ付きの文献整理表までたどり着けます。数字を書き写す前に、全文を読んだかどうかだけは必ず確認しましょう。
千尋さんはこの整理をもとに実験の設計へ進みました。その続きは研究設計の記事で紹介しています。今週、千尋さんのように範囲と知りたいことを書いて聞いてみてください。Neutropicを無料で始める