こんにちは、Neutropicチームです!
相談につながりにくい学生を早めに見つけるモデルを作ったとしましょう。回してみると正解率は95%。指導教員に見せる前に、ふと不安になります。該当する学生は全体の5%ほど。だったら「誰も該当しない」と答えるだけでも、正解率は95%になるのでは?🥲
その通りです。陽性がまれな問題では、正解率はほとんど何も教えてくれません。とはいえ、代わりに何を見るべきか、クラス重みやリサンプリングはいつ使うのか、しきい値はどう決めるのかを一度に整理するのは簡単ではありません。
この記事では、臨床心理学の博士課程 沙織さん がこの不安を確かめ、評価の方法を立て直す流れを追います。沙織さんは架空の人物ですが、以下の画面はすべてNeutropicで実際に実行したチャットです。
疑いをそのまま質問にしました
沙織さんは自分のデータを上げませんでした。状況と疑い、欲しい形だけを書いています。
陽性が約5%の二値分類で、正解率が95%になります。このような不均衡データでは、モデルをどう評価し学習すべきですか?Pythonを使います。仮想データで実際に比較してください。
良い依頼である理由は3つです。陽性率(5%)と今見ている数値(正解率95%)が入っているので、何が問題かがすぐ分かります。評価と学習の両方を聞いています。そして「仮想データで実際に比較して」と書いたので、説明だけでなく実行した結果が返ってきます。
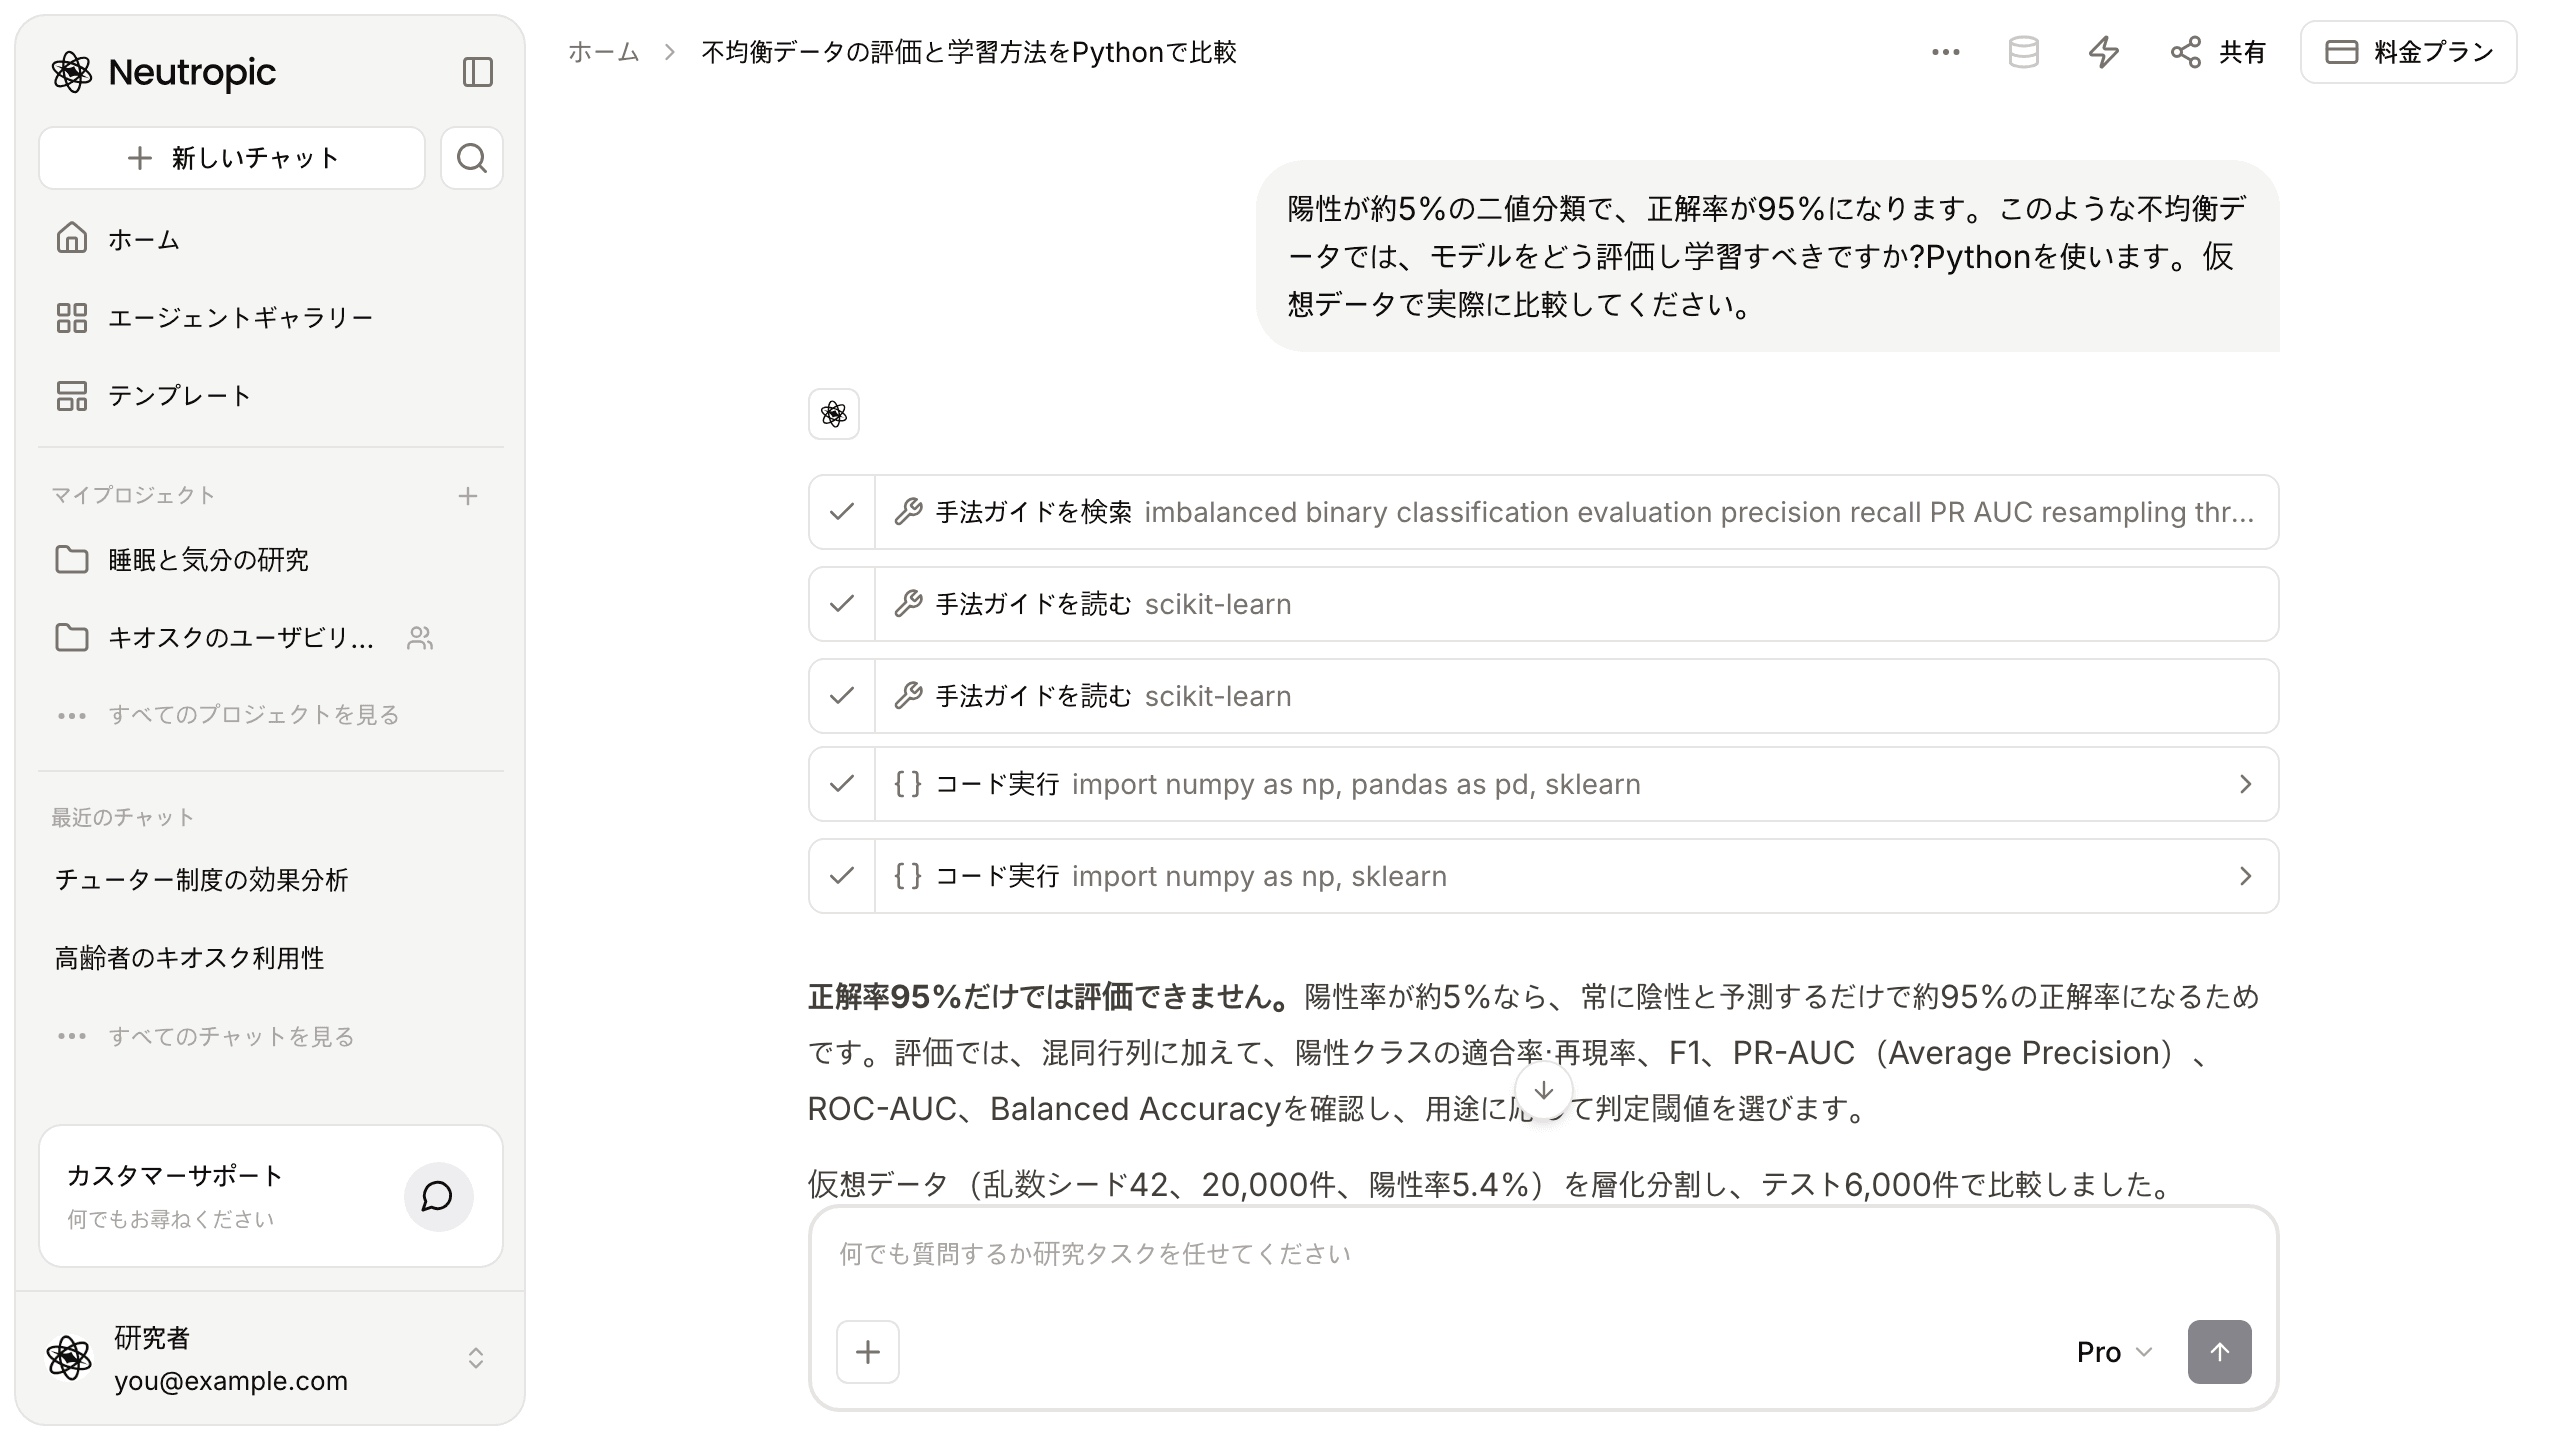
答える前にscikit-learnのガイドを読みました
ステップが積み上がりました。手法ガイドを検索 で不均衡データの評価に合うガイドを探し、手法ガイドを読む でscikit-learnのガイドを読み、コード実行 で比較を回しています。途中経過も正直でした。1回目は実行結果が出力制限で欠けたため、内容を絞って短く再実行した、と書いています。
同じテスト集合で3つを比べました
仮想データは乱数シード42、20,000件、陽性率5.4%。層化分割して、テスト6,000件で比較しました。
- 全件陰性: 正解率94.6%、陽性は1件も見つけられない
- ロジスティック回帰: 正解率94.4%、適合率0.292、再現率0.022、PR-AUC 0.189
- クラス重み付き回帰: 正解率76.7%、適合率0.151、再現率0.714、PR-AUC 0.160
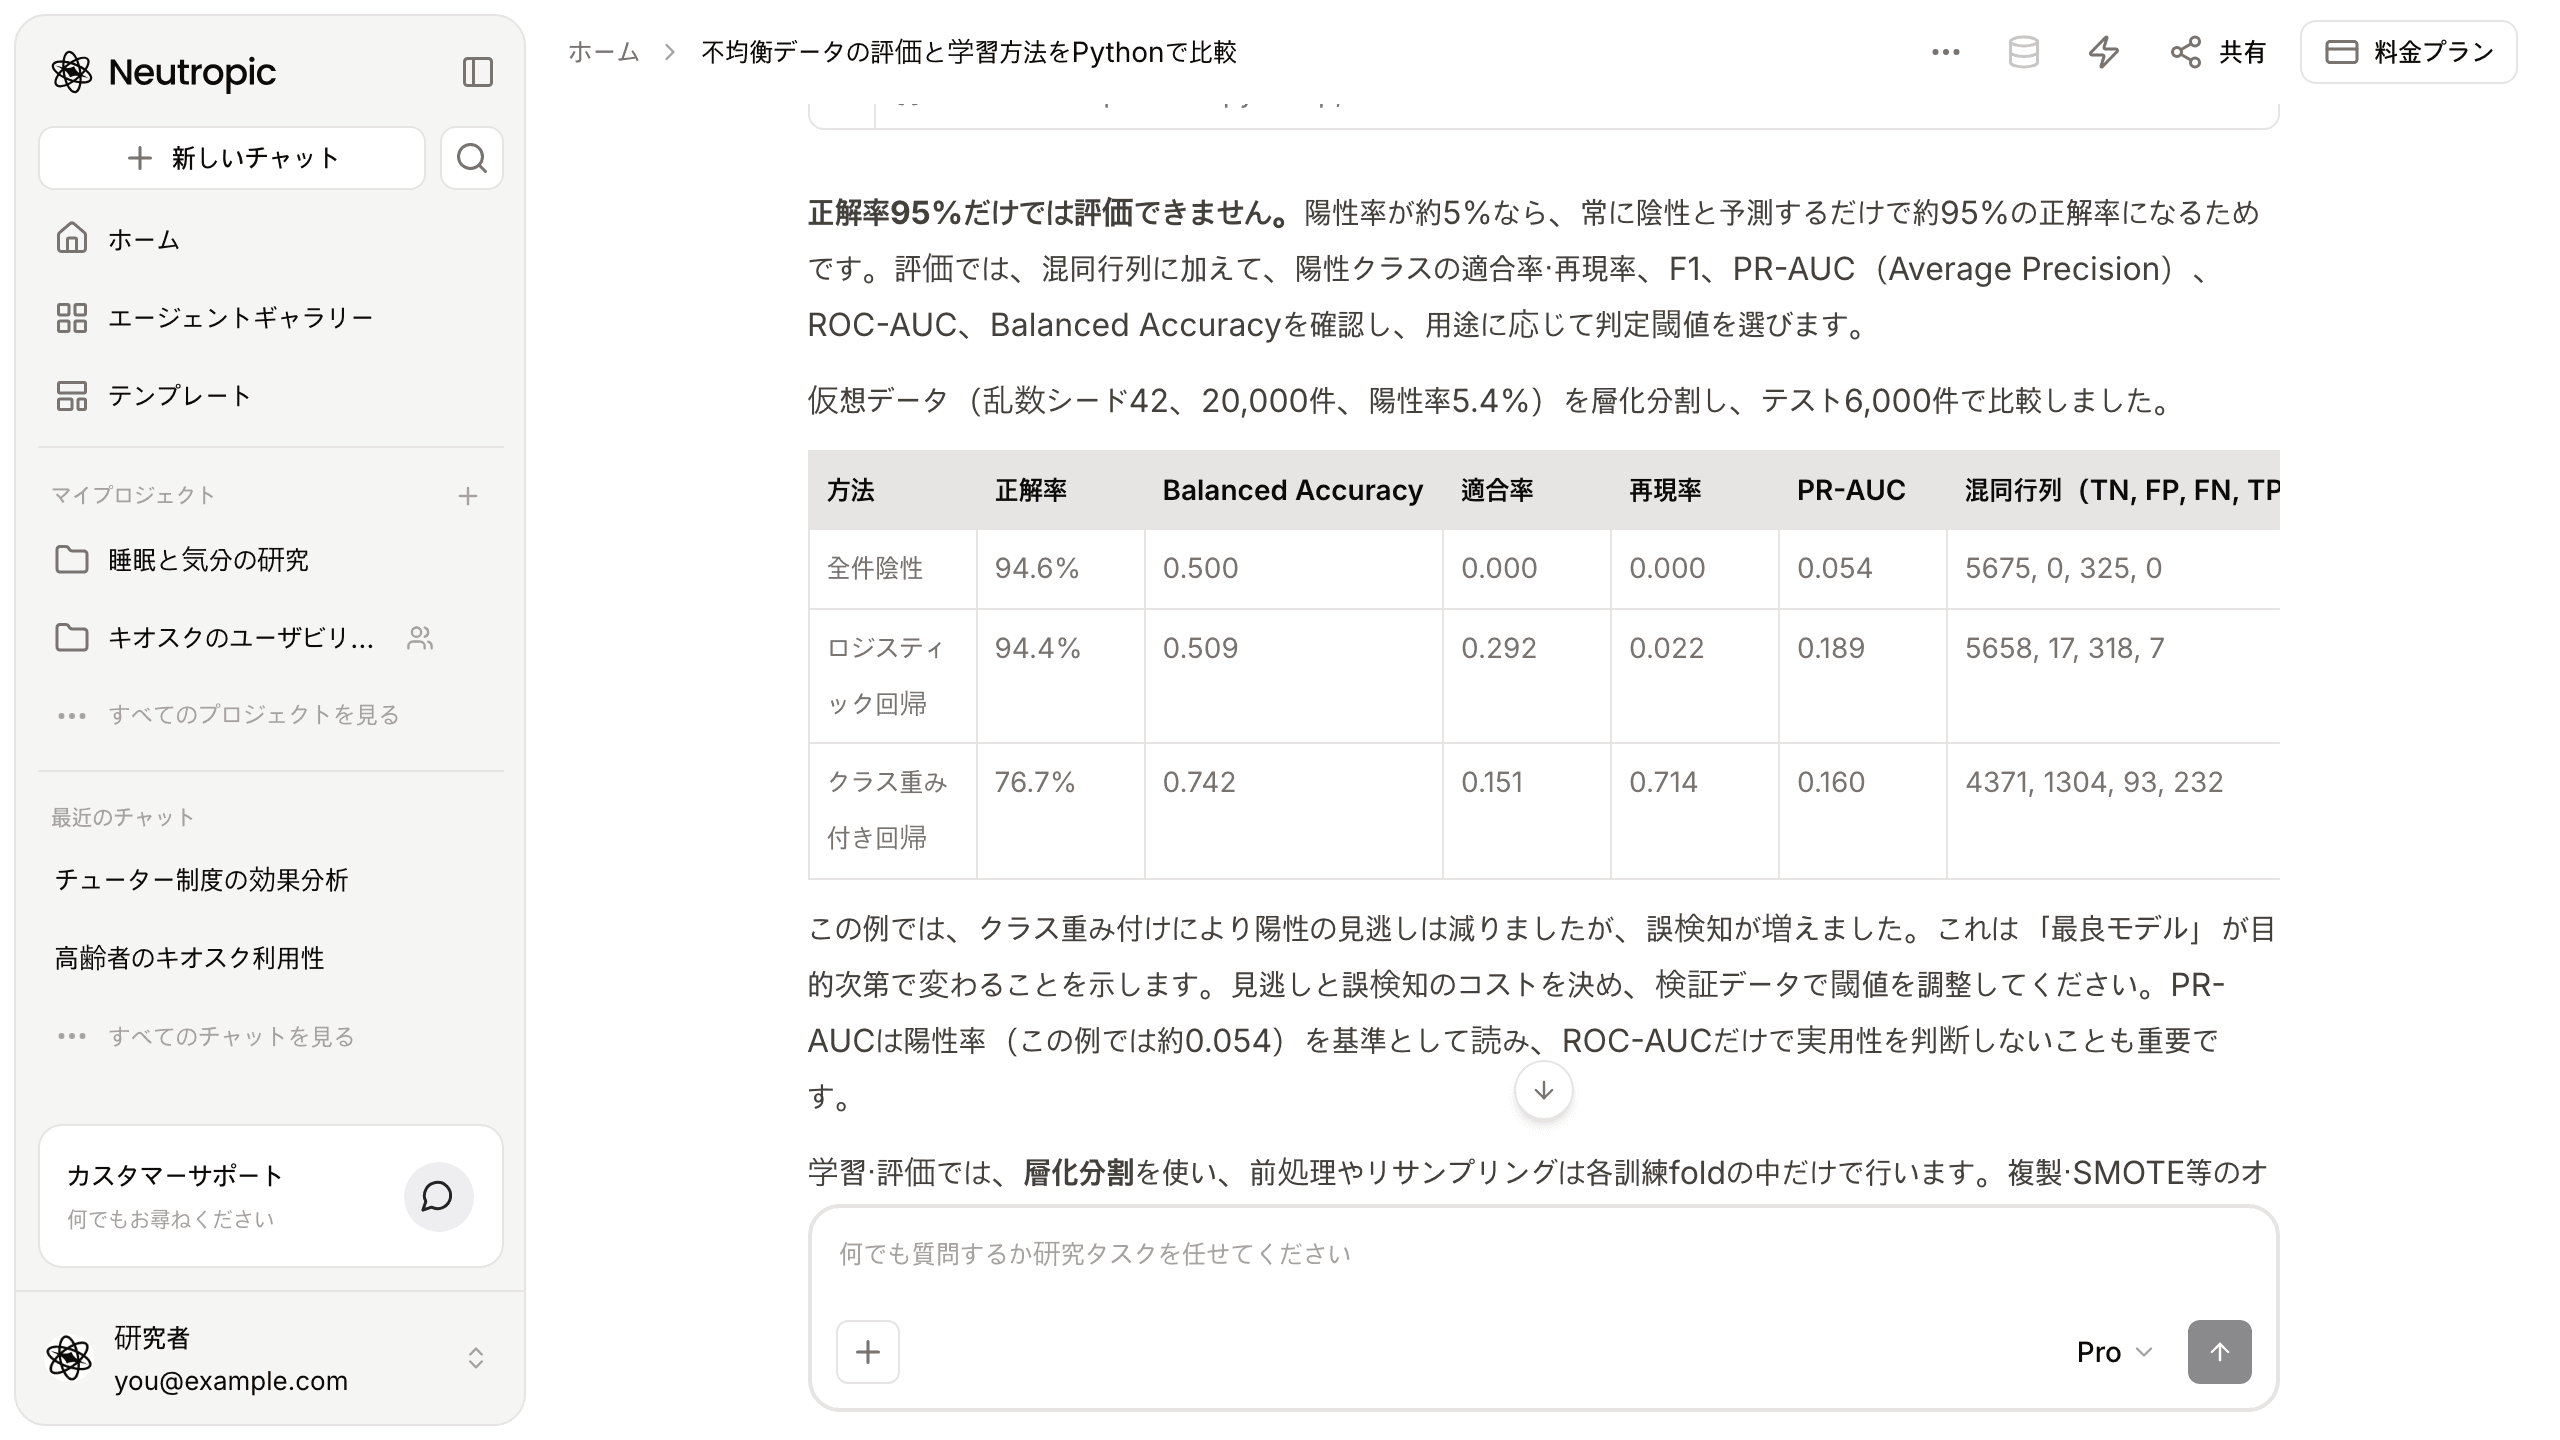
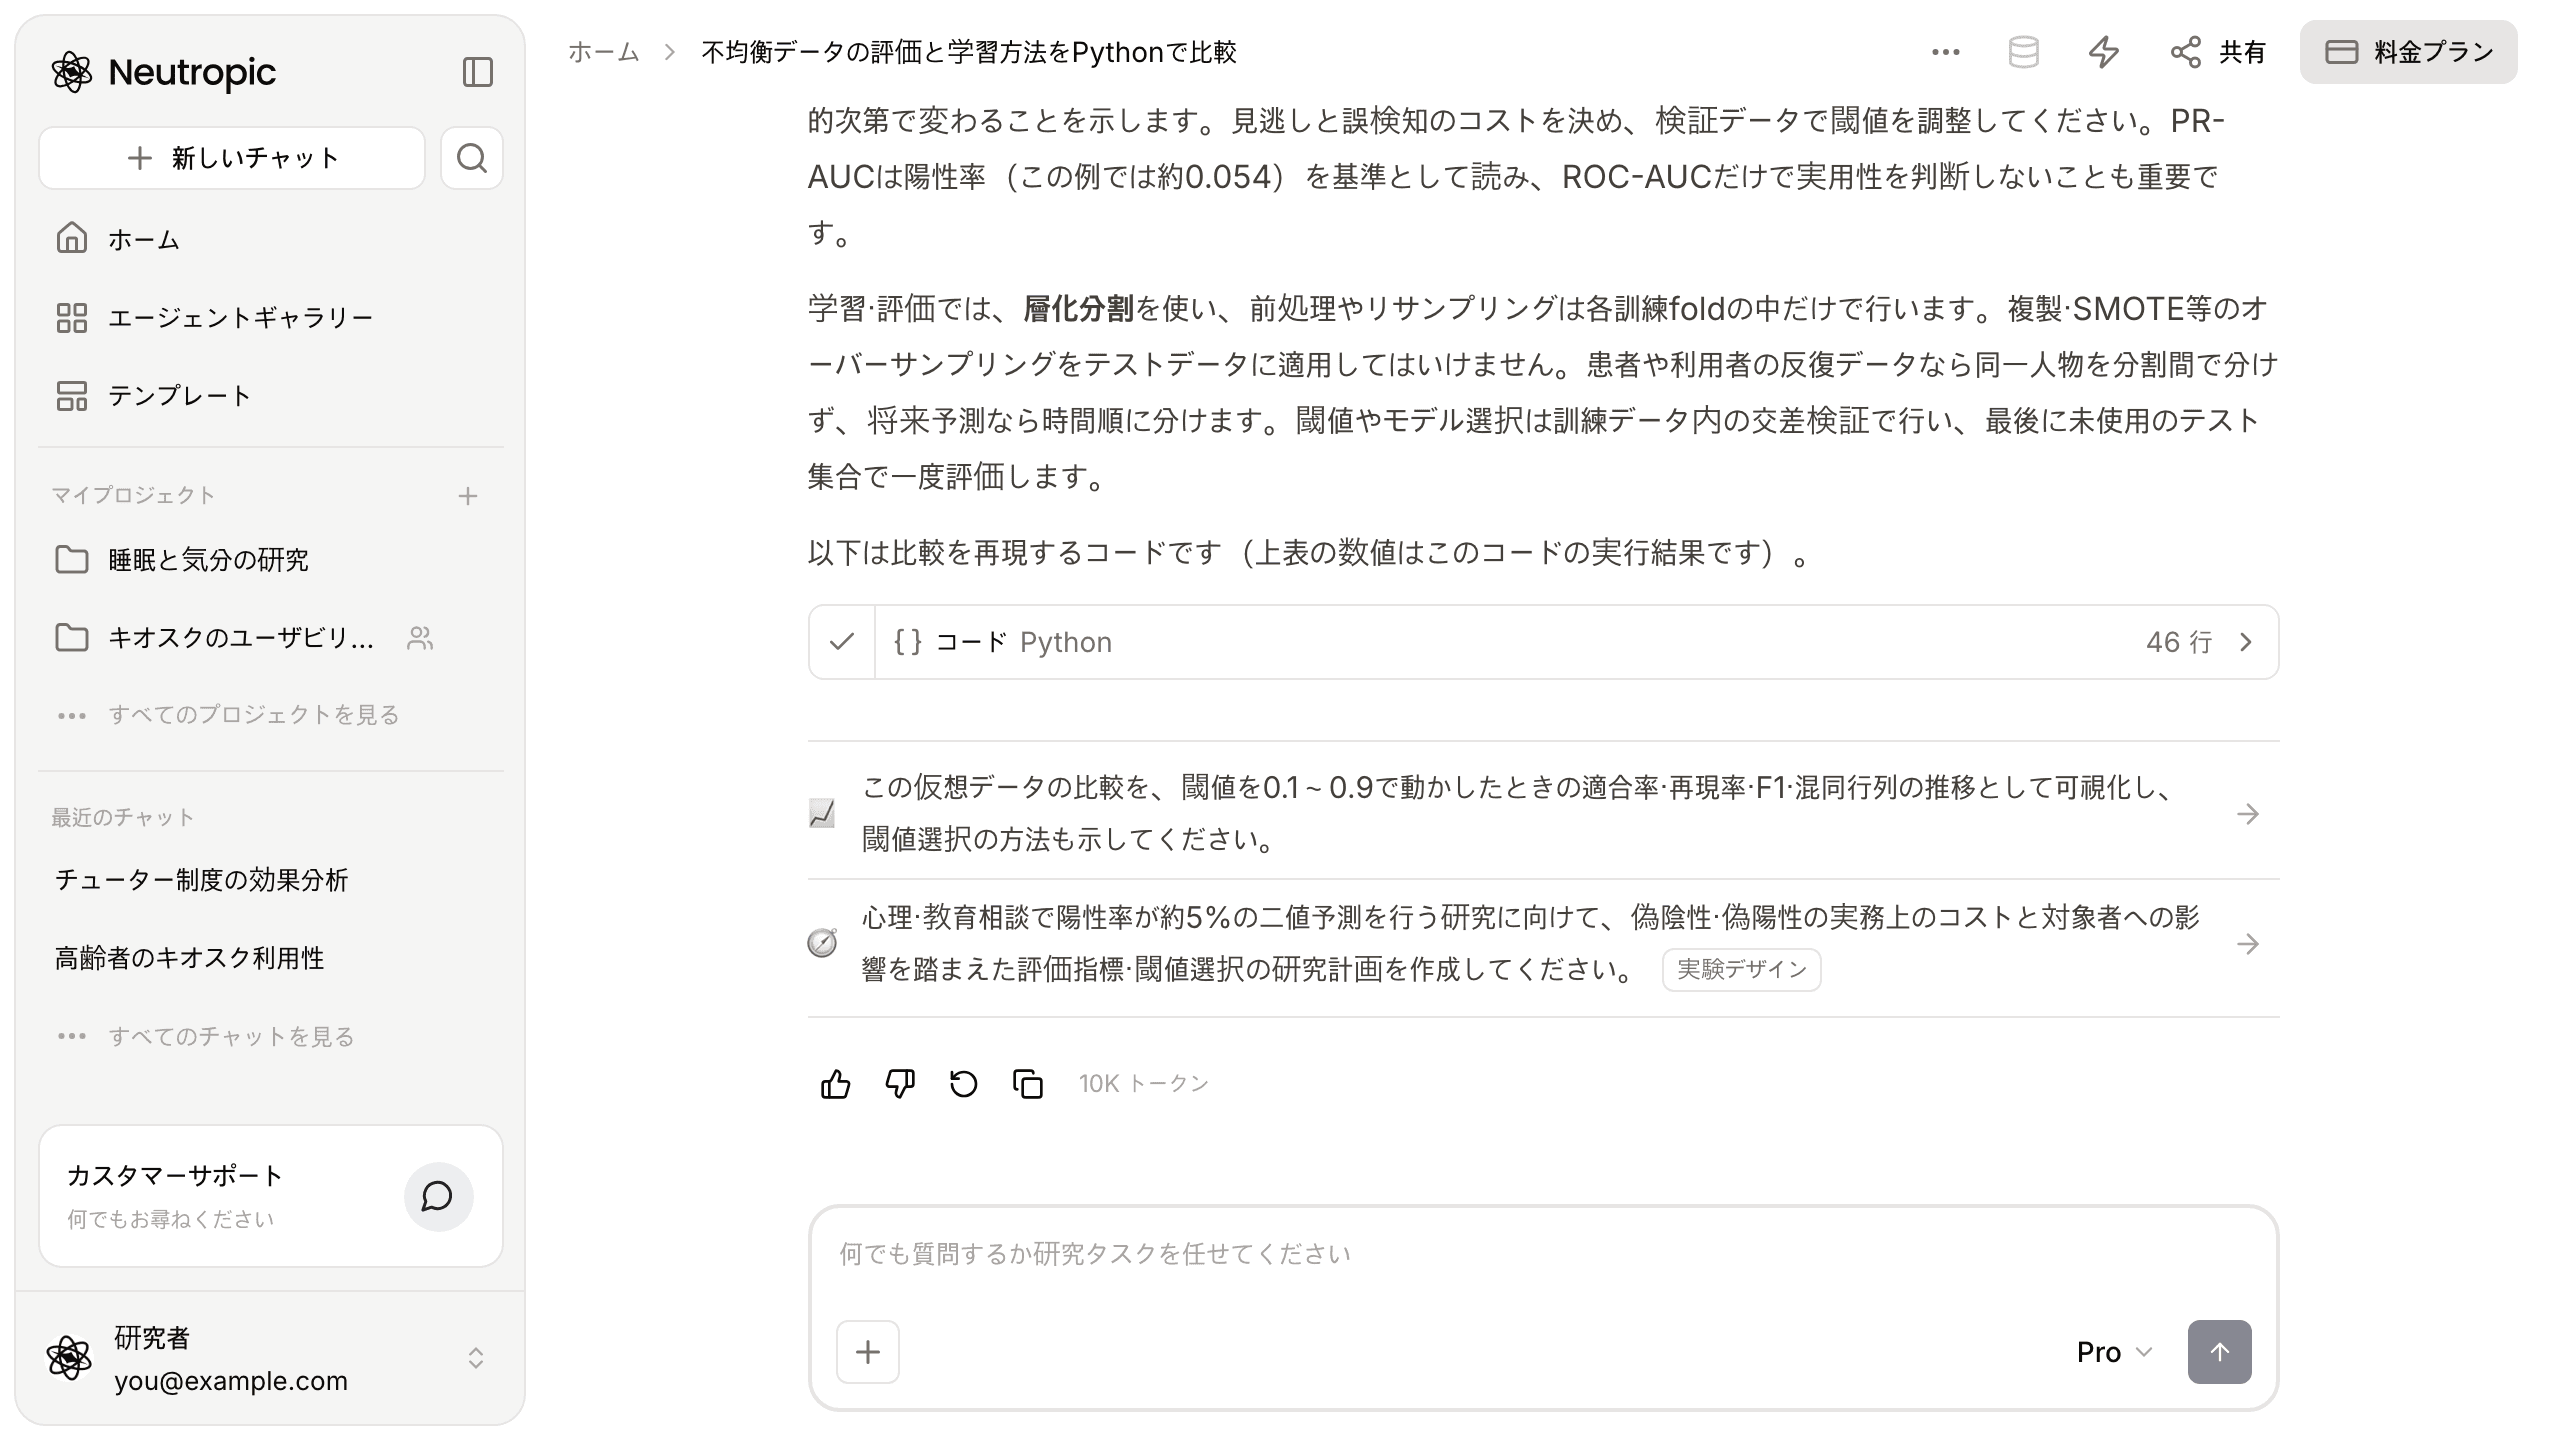
ここで沙織さんは危うく間違えるところでした。普通のロジスティック回帰の正解率は94.4%で、「全件陰性」の94.6%より低いんです。テストの陽性325件のうち見つけたのは7件だけ。沙織さんの「95%」も、実はこれと同じ状態かもしれません。では、クラス重みを付ければ解決するかというと、再現率は0.714まで上がったものの、誤検知が1,304件に増えました。回答はこう書いています。「最良モデル」は目的次第で変わる。見逃しと誤検知のコストを決め、検証データでしきい値を調整すること。PR-AUCは陽性率(この例では約0.054)を基準に読み、ROC-AUCだけで実用性を判断しないこと。
学習と評価の手順も整理されました
表の下には、実際の進め方がまとめられていました。層化分割を使い、前処理やリサンプリングは各訓練foldの中だけで行うこと。複製やSMOTEなどのオーバーサンプリングをテストデータに適用しないこと。同じ人の反復データなら同一人物を分割間で分けず、将来予測なら時間順に分けること。しきい値やモデル選択は訓練データ内の交差検証で行い、最後に未使用のテスト集合で一度だけ評価すること。
付いてきたコードで、同じ数値が出ました
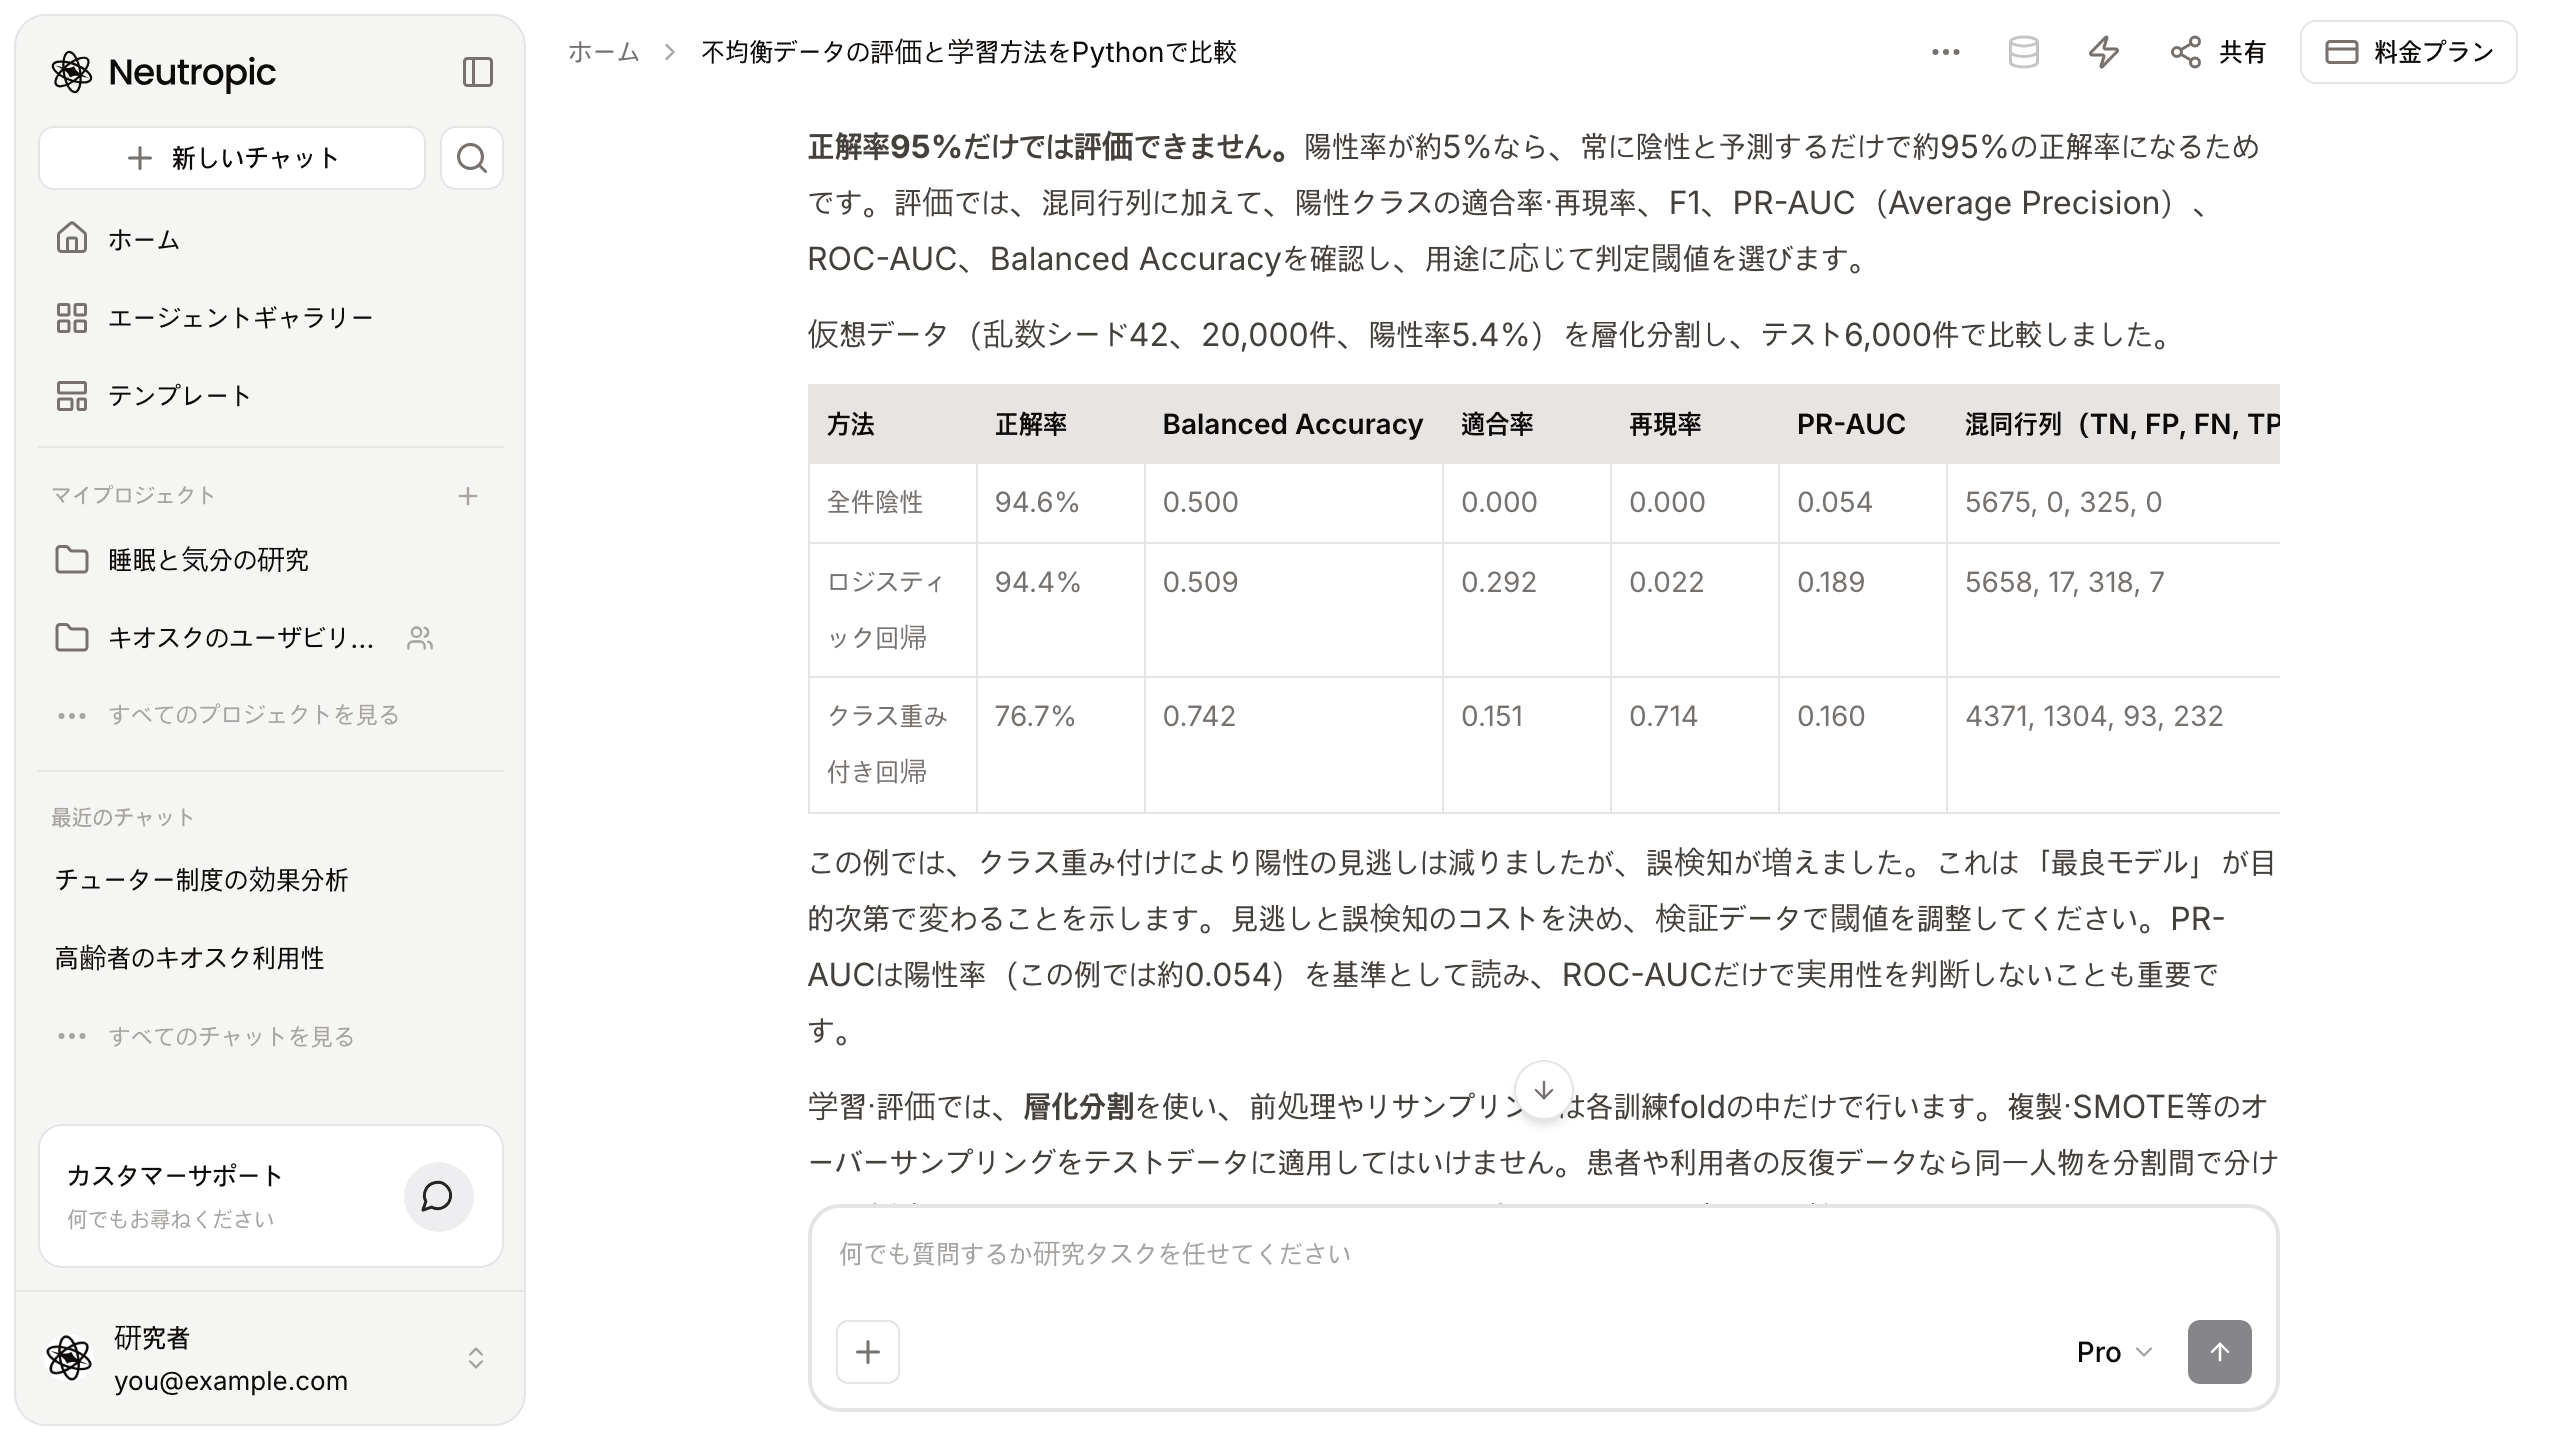
回答には46行のPythonコードが付いていて、「上表の数値はこのコードの実行結果です」と書かれていました。カードを押すと右側にコードが開き、コピーボタンで持ち帰れます。
私たちもこのコードをそのまま実行してみましたが、表の3行とまったく同じ数値が出ました。😎 シードが固定されているので、沙織さんは仮想データを作る部分を自分のデータに差し替えるだけで、同じ比較を回せます。
次にやることまで提案されました
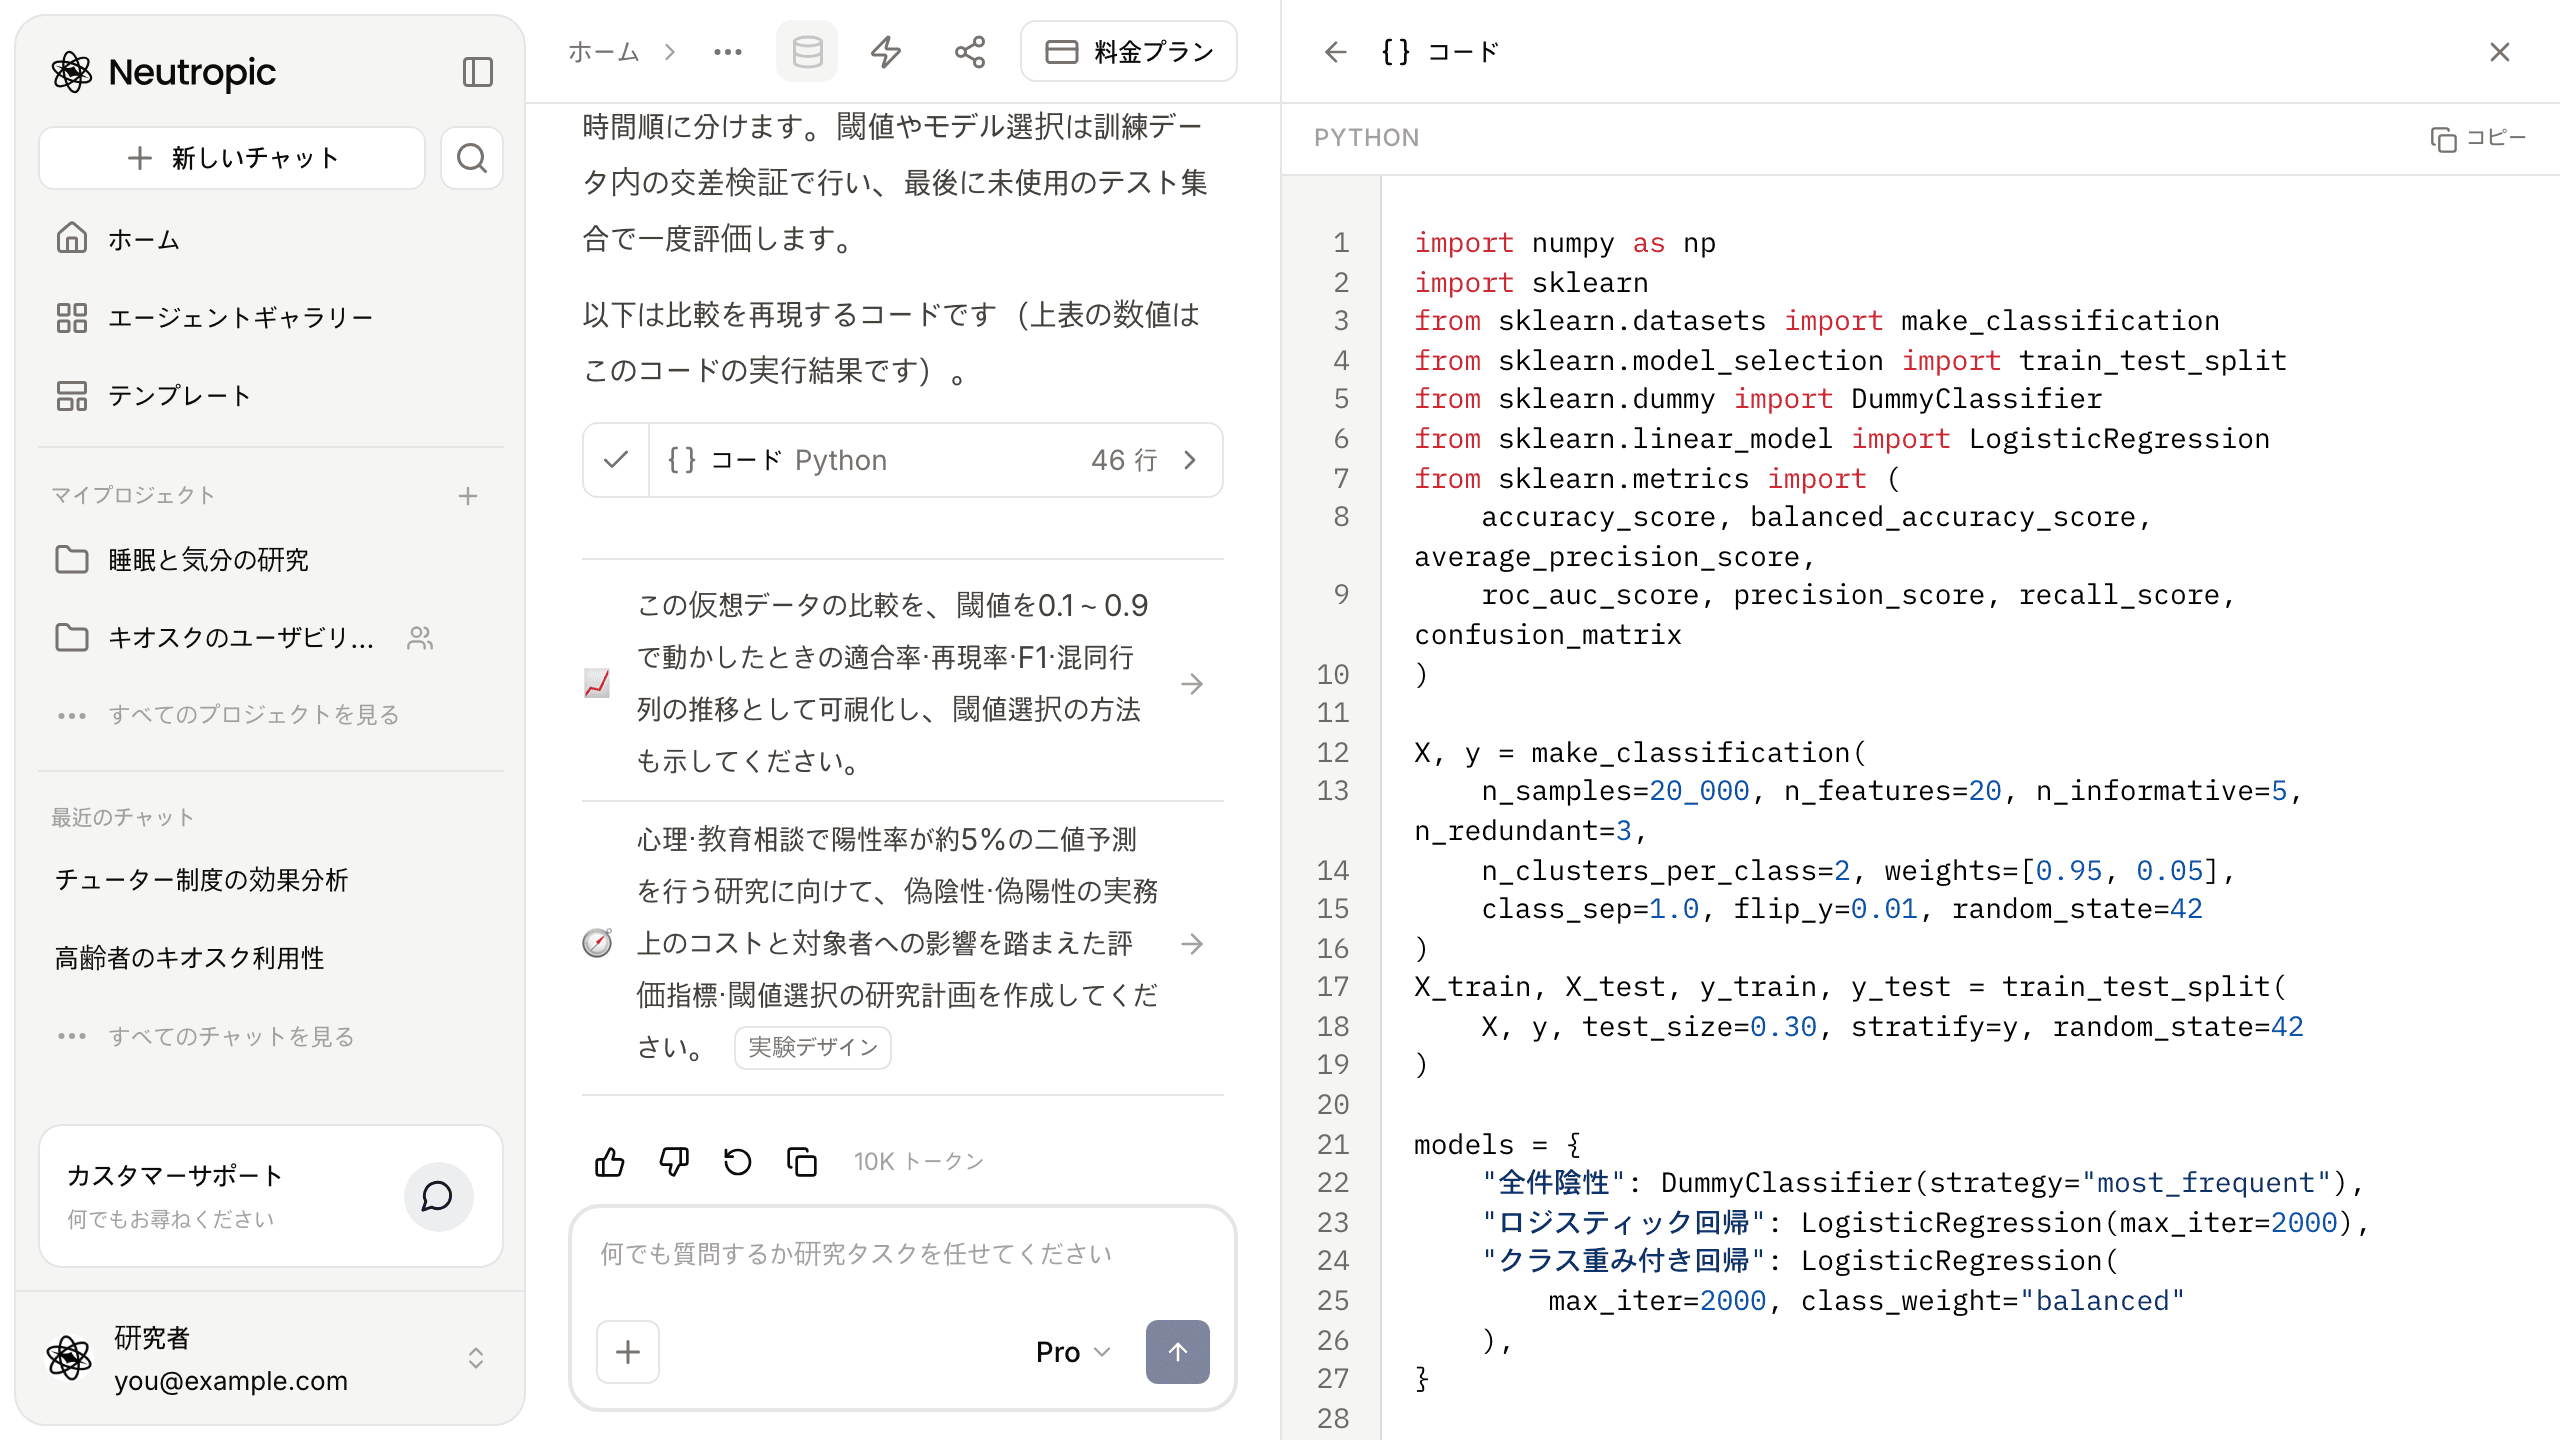
回答のいちばん下には、続けてできることが2つありました。
- この仮想データの比較を、しきい値を0.1〜0.9で動かしたときの適合率・再現率・F1・混同行列の推移として可視化し、しきい値選択の方法も示す
- 心理・教育相談で陽性率が約5%の二値予測を行う研究に向けて、偽陰性・偽陽性の実務上のコストと対象者への影響を踏まえた評価指標・しきい値選択の研究計画を作る — 実験デザイン エージェント
押すと同じチャットでそのまま続きます。見逃しのコストが大きい沙織さんなら、1つ目から押すでしょうか。
正解率95%という数字を読み直せるようになりました
| 始めたとき | 今 | |
|---|---|---|
| 判断の基準 | 正解率95% | 適合率・再現率・PR-AUC・混同行列 |
| 比較 | 自分のモデルひとつ | 全件陰性・通常・クラス重み付きを同じテスト集合で |
| 学習方法 | 重みを付ければ良くなると期待 | 見逃しと誤検知のトレードオフを確認 |
| 手順 | ランダムに分けてすぐ評価 | 層化分割、fold内リサンプリング、検証データでしきい値 |
| コード | 例を探し回っていた | 同じ数値が再現される46行のコード |
もちろん、仮想データでの例です。実際の陽性率やデータの構造が違えば結果も変わります。また、今回の実行では文献検索をしておらず、回答に引用文献はありません。根拠はscikit-learnのガイドと実行結果です。
この記事は Pro で実行しました。Lite(無料プラン)はシミュレーションなしで指標を説明し、Expert はさらにリサンプリング手法の比較と確率の較正を加えます。
陽性がまれな問題では、正解率より先に「何件見つけて何件見逃したか」を見ましょう。
今週、沙織さんのように、今見ている数値と疑いをそのまま書いて聞いてみてください。Neutropicを無料で始める