こんにちは、Neutropicチームです!
修士論文の計画発表まであと2週間というある日、指導教員にこう言われたとしましょう。「消費者が何を見て選んでいるか知りたいなら、コンジョイントでやってみたら」。大学院にいる方なら、一度は経験したことのある場面かもしれません。名前は聞いたことがあっても、いざ始めようとすると途方に暮れます。講義動画はR、ブログの例はSPSS、論文は数式だけ。🥲
難しいのは数式そのものではありません。その前後で決めることが次々に出てくるからです。どの組み合わせを見せるか、1人に何問出すか、水準をどうコード化するか、どのモデルで推定するか、結果をどこまで解釈してよいか。
この記事では、マーケティング専攻の修士1年 美咲さん が、ワイヤレスイヤホンのコンジョイント分析を初めて準備する流れを追います。美咲さんは架空の人物ですが、以下の画面はすべてNeutropicで実際に実行したチャットです。
知っていることを全部ひとつの段落に書きました
美咲さんが決めていたのは、製品と4つの属性だけでした。水準をいくつにするか迷ったものの、ひとまず考えていた値をそのまま書いて送りました。
新しいワイヤレスイヤホンでコンジョイント分析をしたいです。属性は価格(9,000円・13,000円・17,000円)、バッテリー(6時間・10時間)、ノイズキャンセリング(あり・なし)、ブランド(A・B)です。選択課題の設計から部分効用と属性重要度の計算までどう進めればいいですか?Pythonを使います。仮想の回答データで実際に計算して結果まで見せてください。
質問に入れたのは3つです。何を分析するか(製品、属性と水準)、どこまで欲しいか(課題設計から重要度まで)、どう見せてほしいか(Python、仮想データで実際に計算)。特に最後の一文が大事です。「実際に計算して」と書くと、説明だけで終わらず、コードを実行して数値まで見せてくれます。
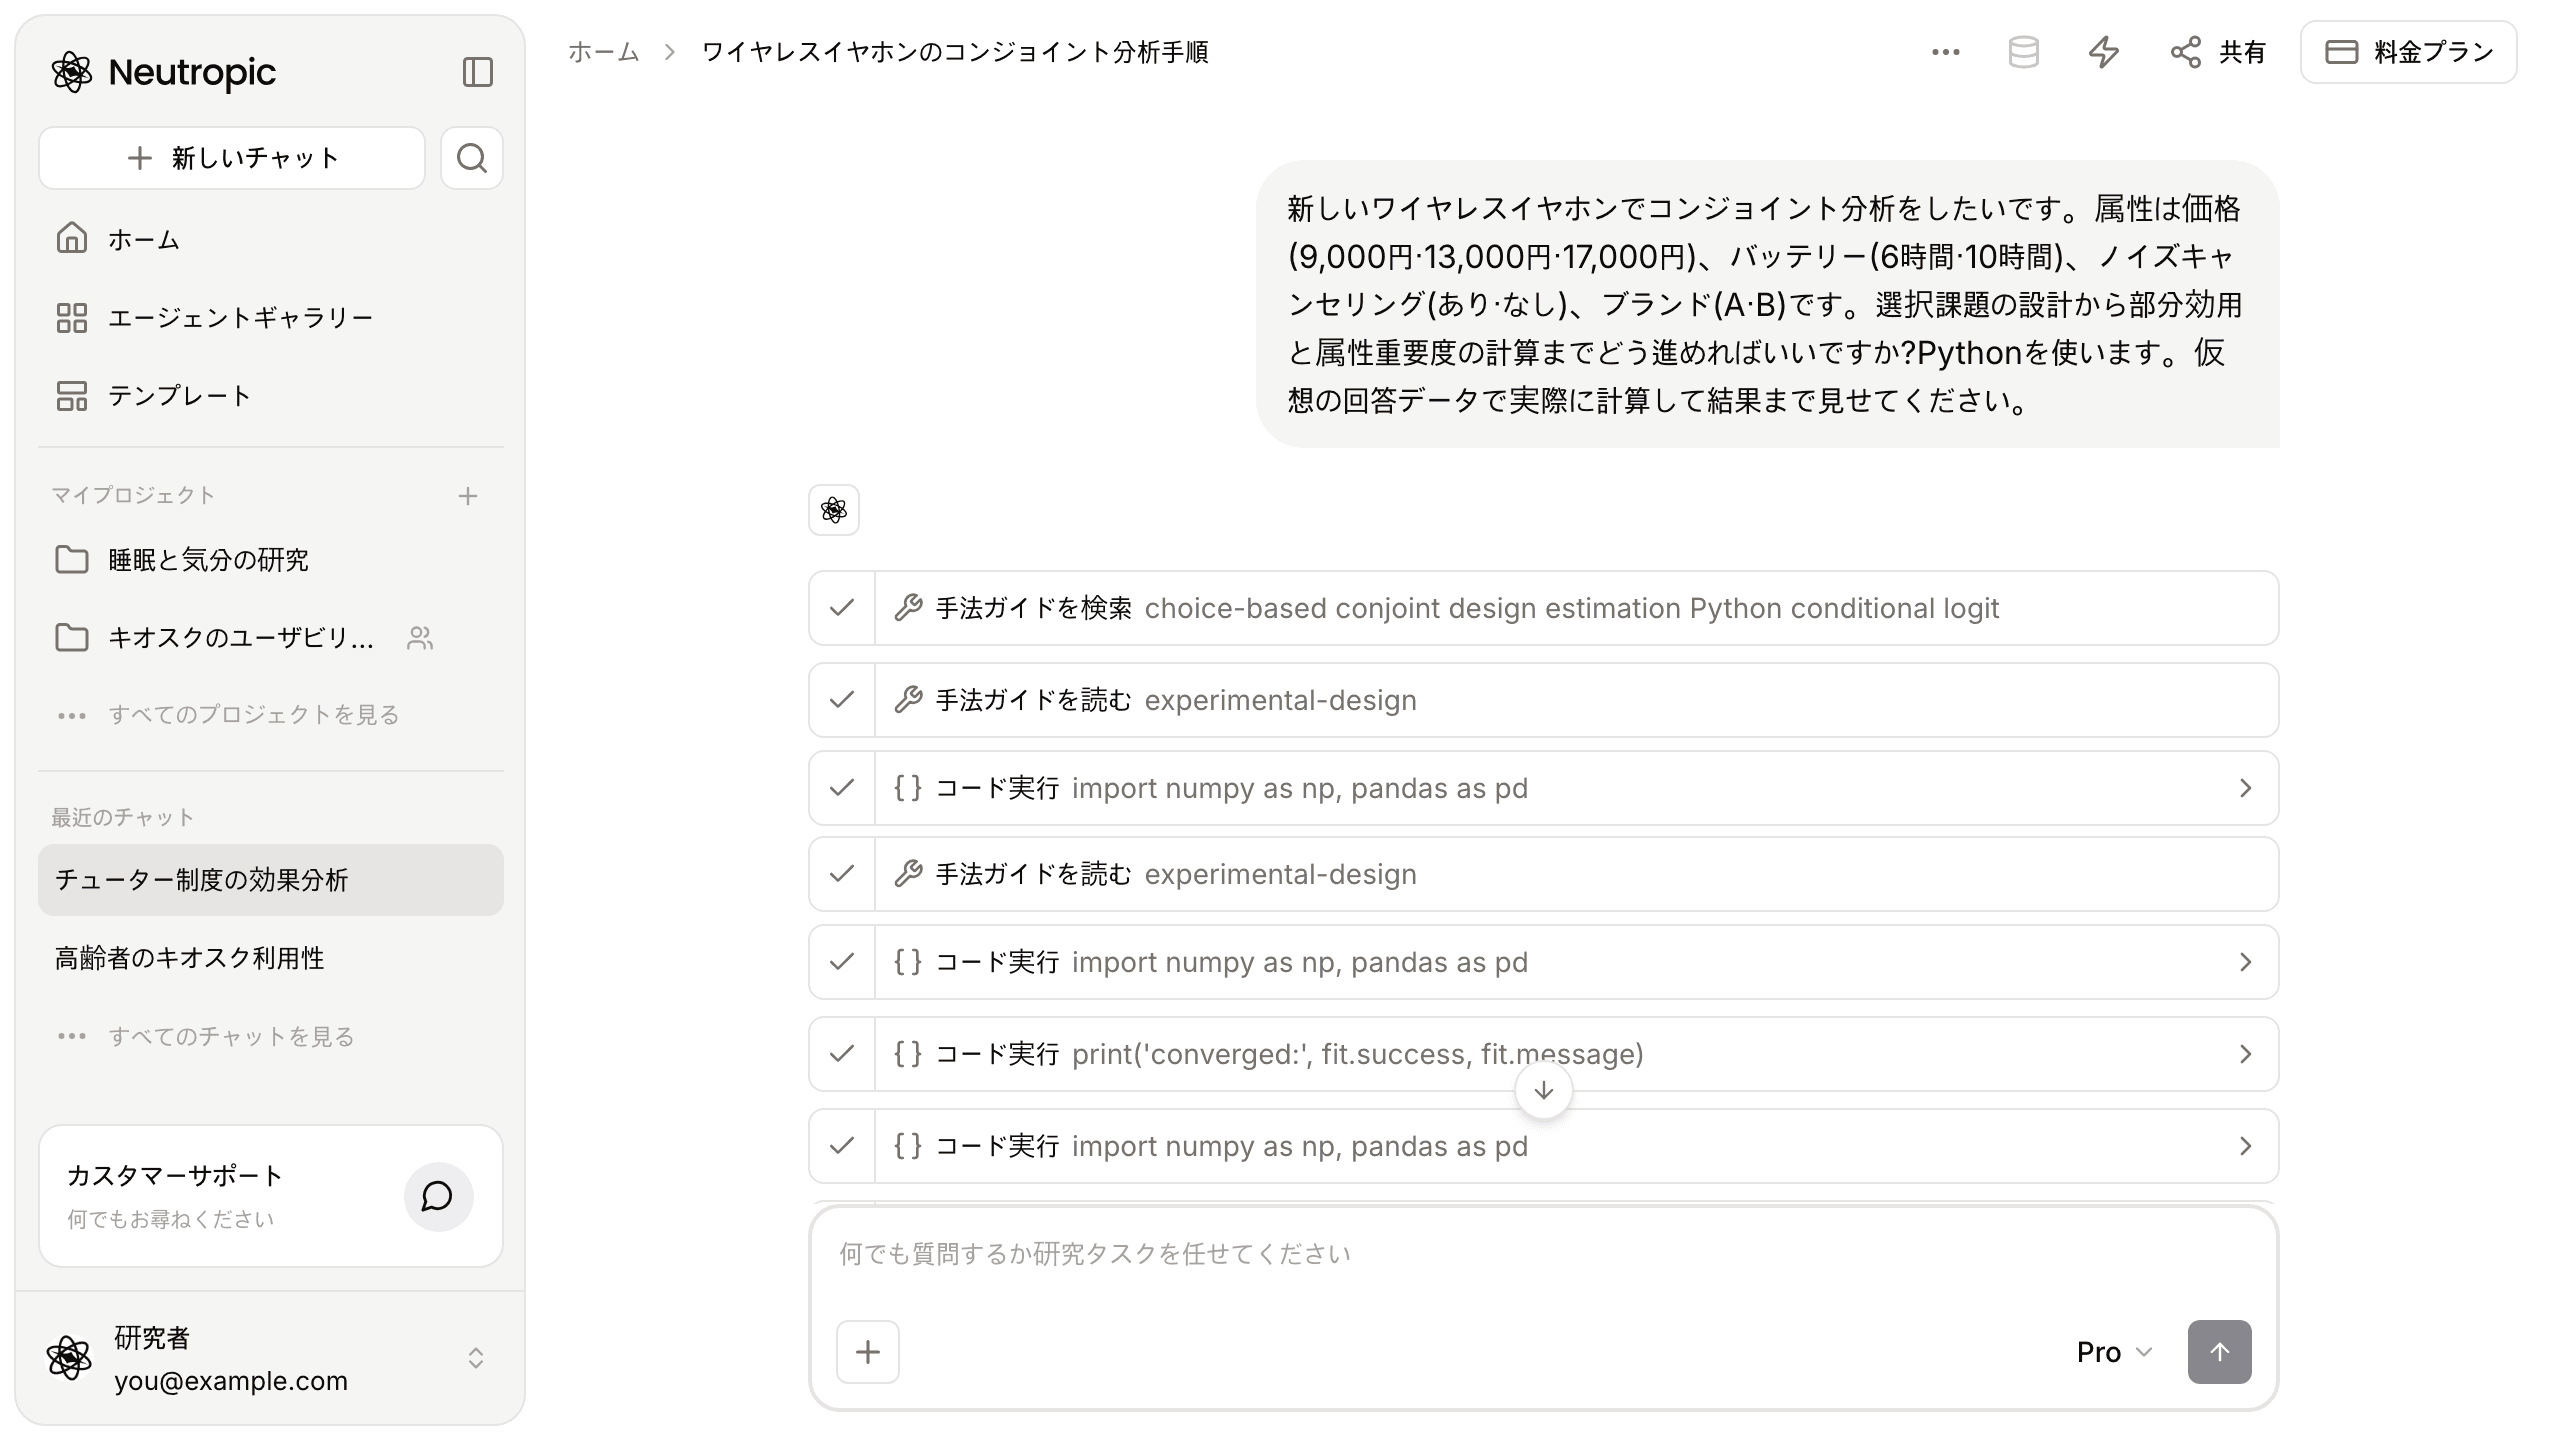
答える前に実験デザインのガイドを読みました
送るとすぐに、画面にステップが積み上がっていきました。まず 手法ガイドを検索 でコンジョイントに合うガイドを探し、手法ガイドを読む で実験デザインのガイドを読み、コード実行 で分析を回しました。
手法ガイドは、Neutropicがあらかじめ確認しておいた分析手順の文書です。モデルが記憶に頼ってすぐ答えるのではなく、検証済みの手順を先に読んで、その順番に従うようにしています。ステップをひとつずつ開けば、何を読み、どんなコードを実行したかをそのまま確認できます。
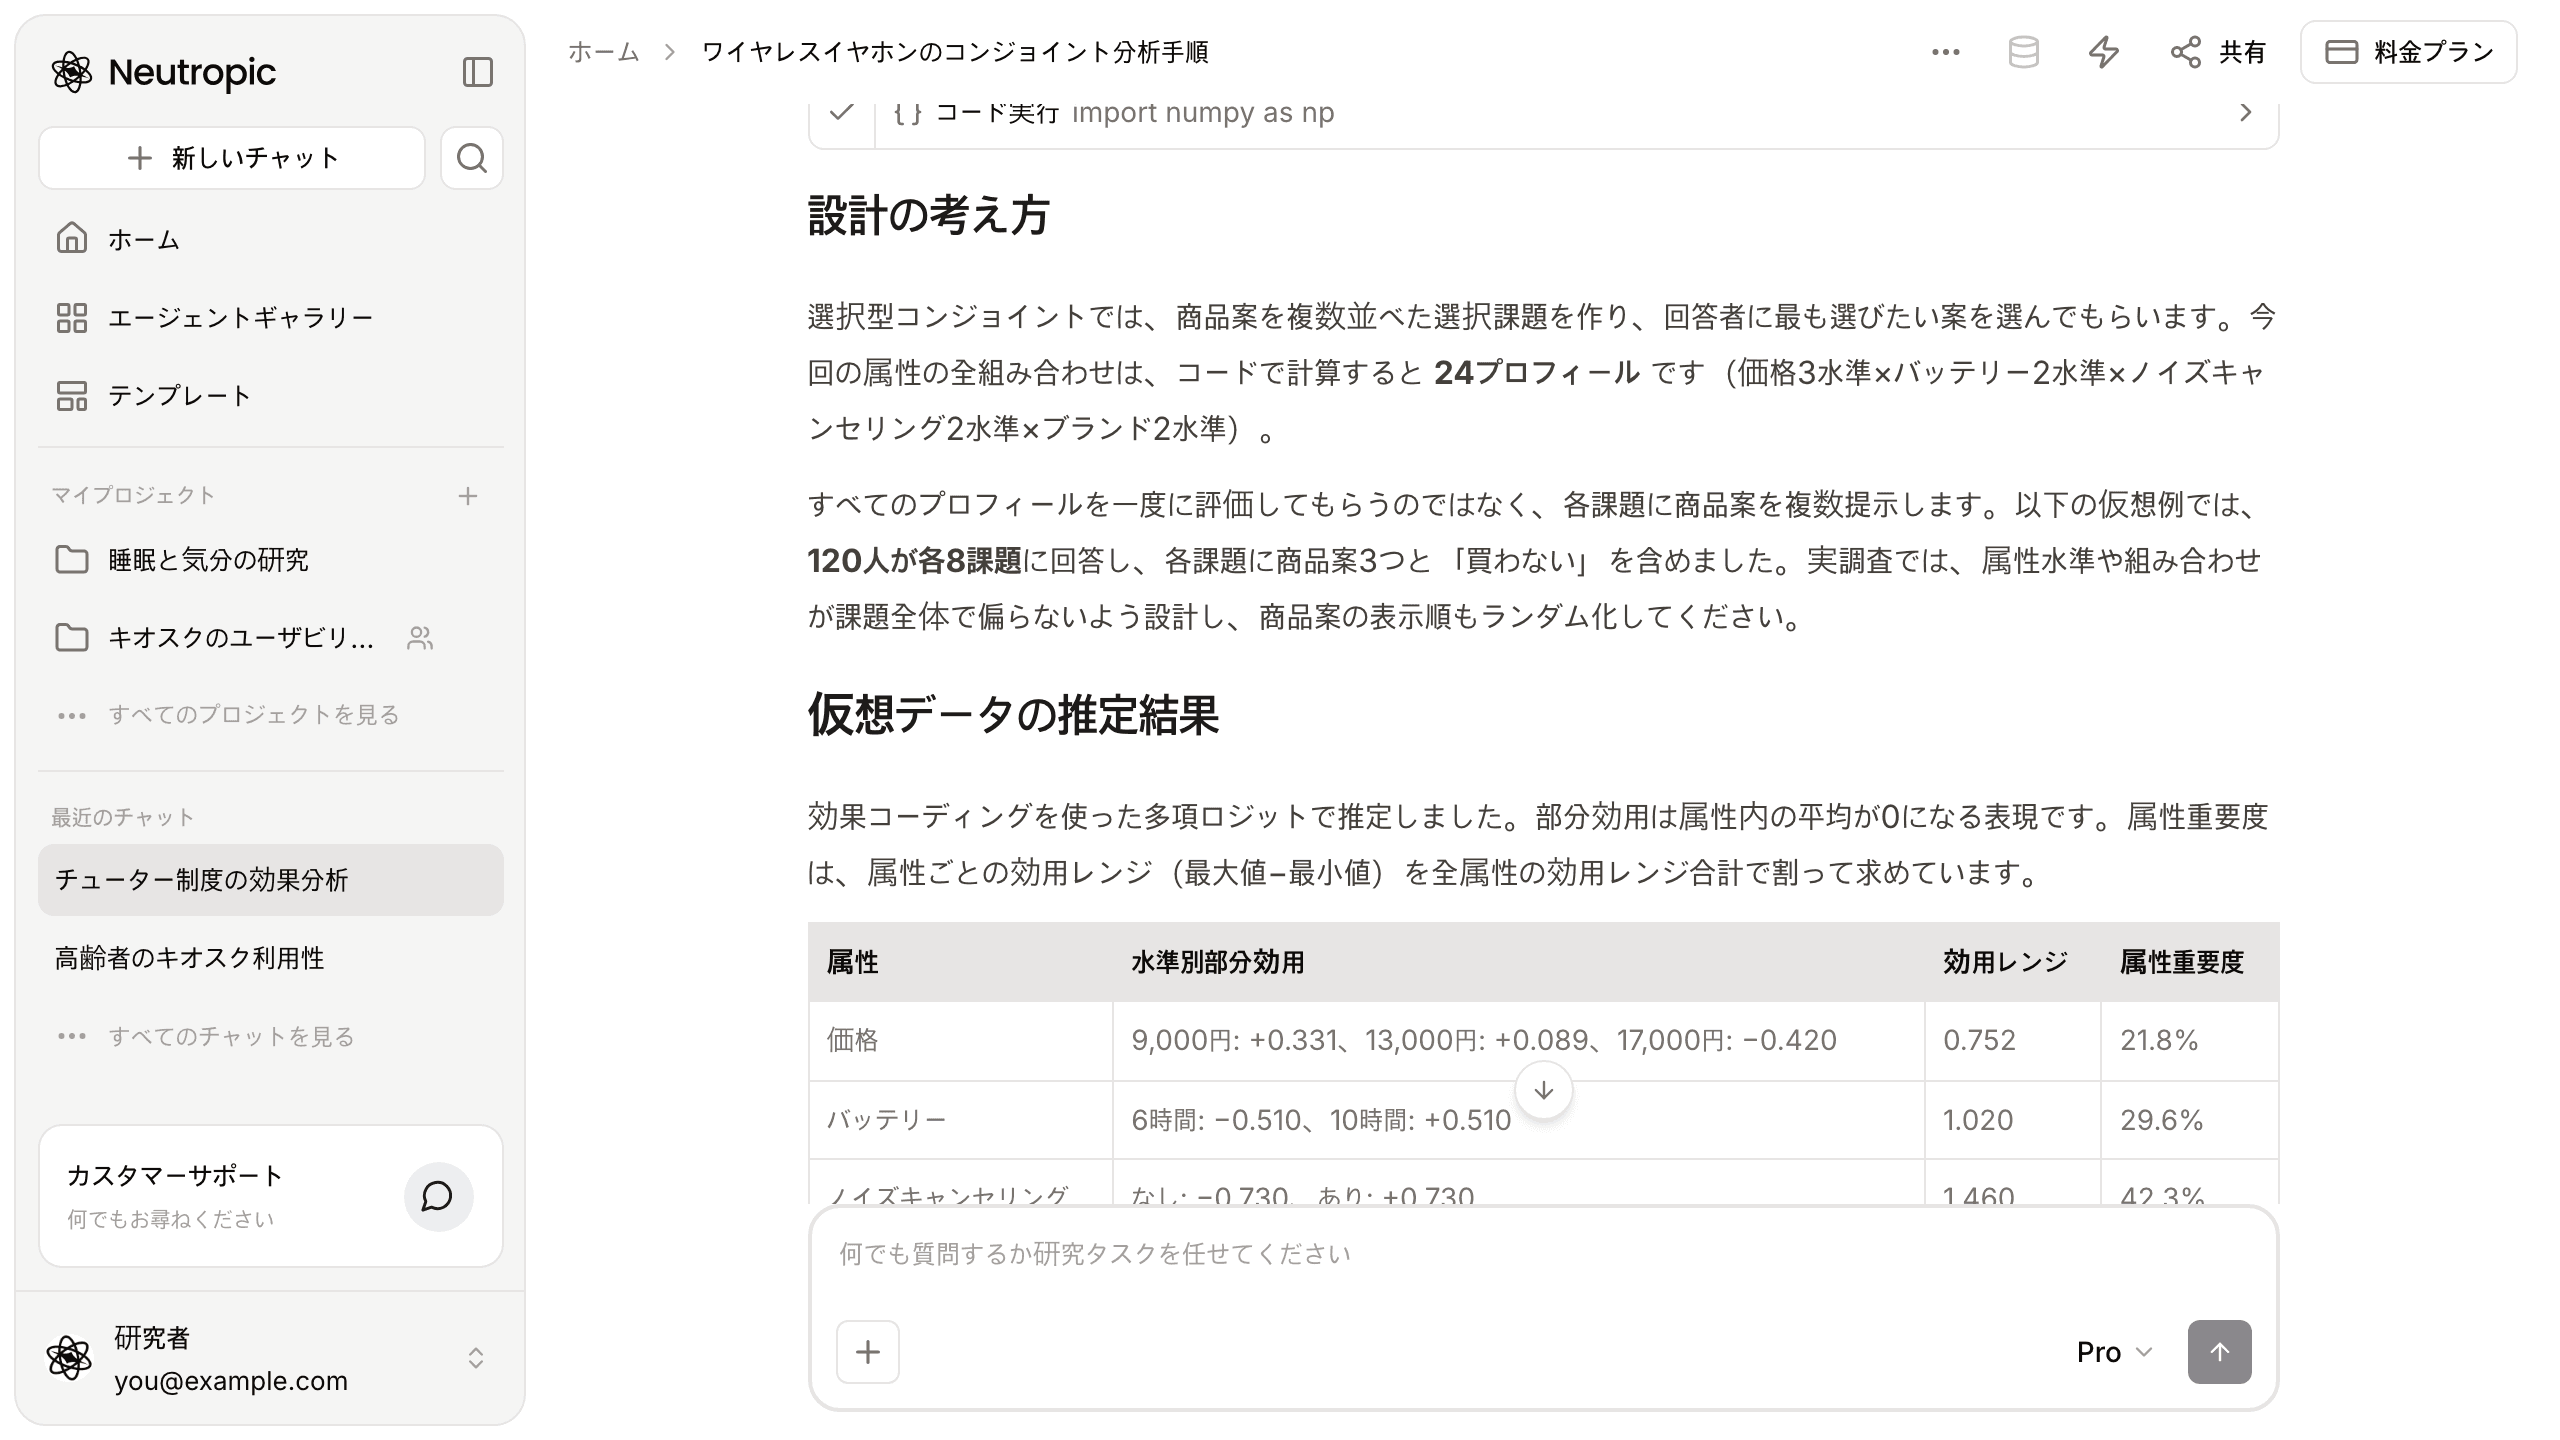
24通りの組み合わせから課題を作りました
回答の最初は選択課題の設計でした。4つの属性の水準を掛け合わせると 3 × 2 × 2 × 2 = 24 通り。仮想例では、120人がそれぞれ8課題に答え、各課題に商品案3つと「買わない」を入れる設定にしました。
美咲さんが考えていなかった点も指摘してくれました。
- 属性水準や組み合わせが課題全体で偏らないように設計すること
- 商品案の表示順をランダム化すること
一番重要なのはノイズキャンセリング。ただし条件付きです
次は推定結果です。効果コーディングを使った多項ロジットで水準ごとの部分効用を推定し、属性ごとの効用レンジを全属性のレンジ合計で割って重要度を求めました。
重要度は ノイズキャンセリング 42.3%、バッテリー 29.6%、価格 21.8%、ブランド 6.3% でした。
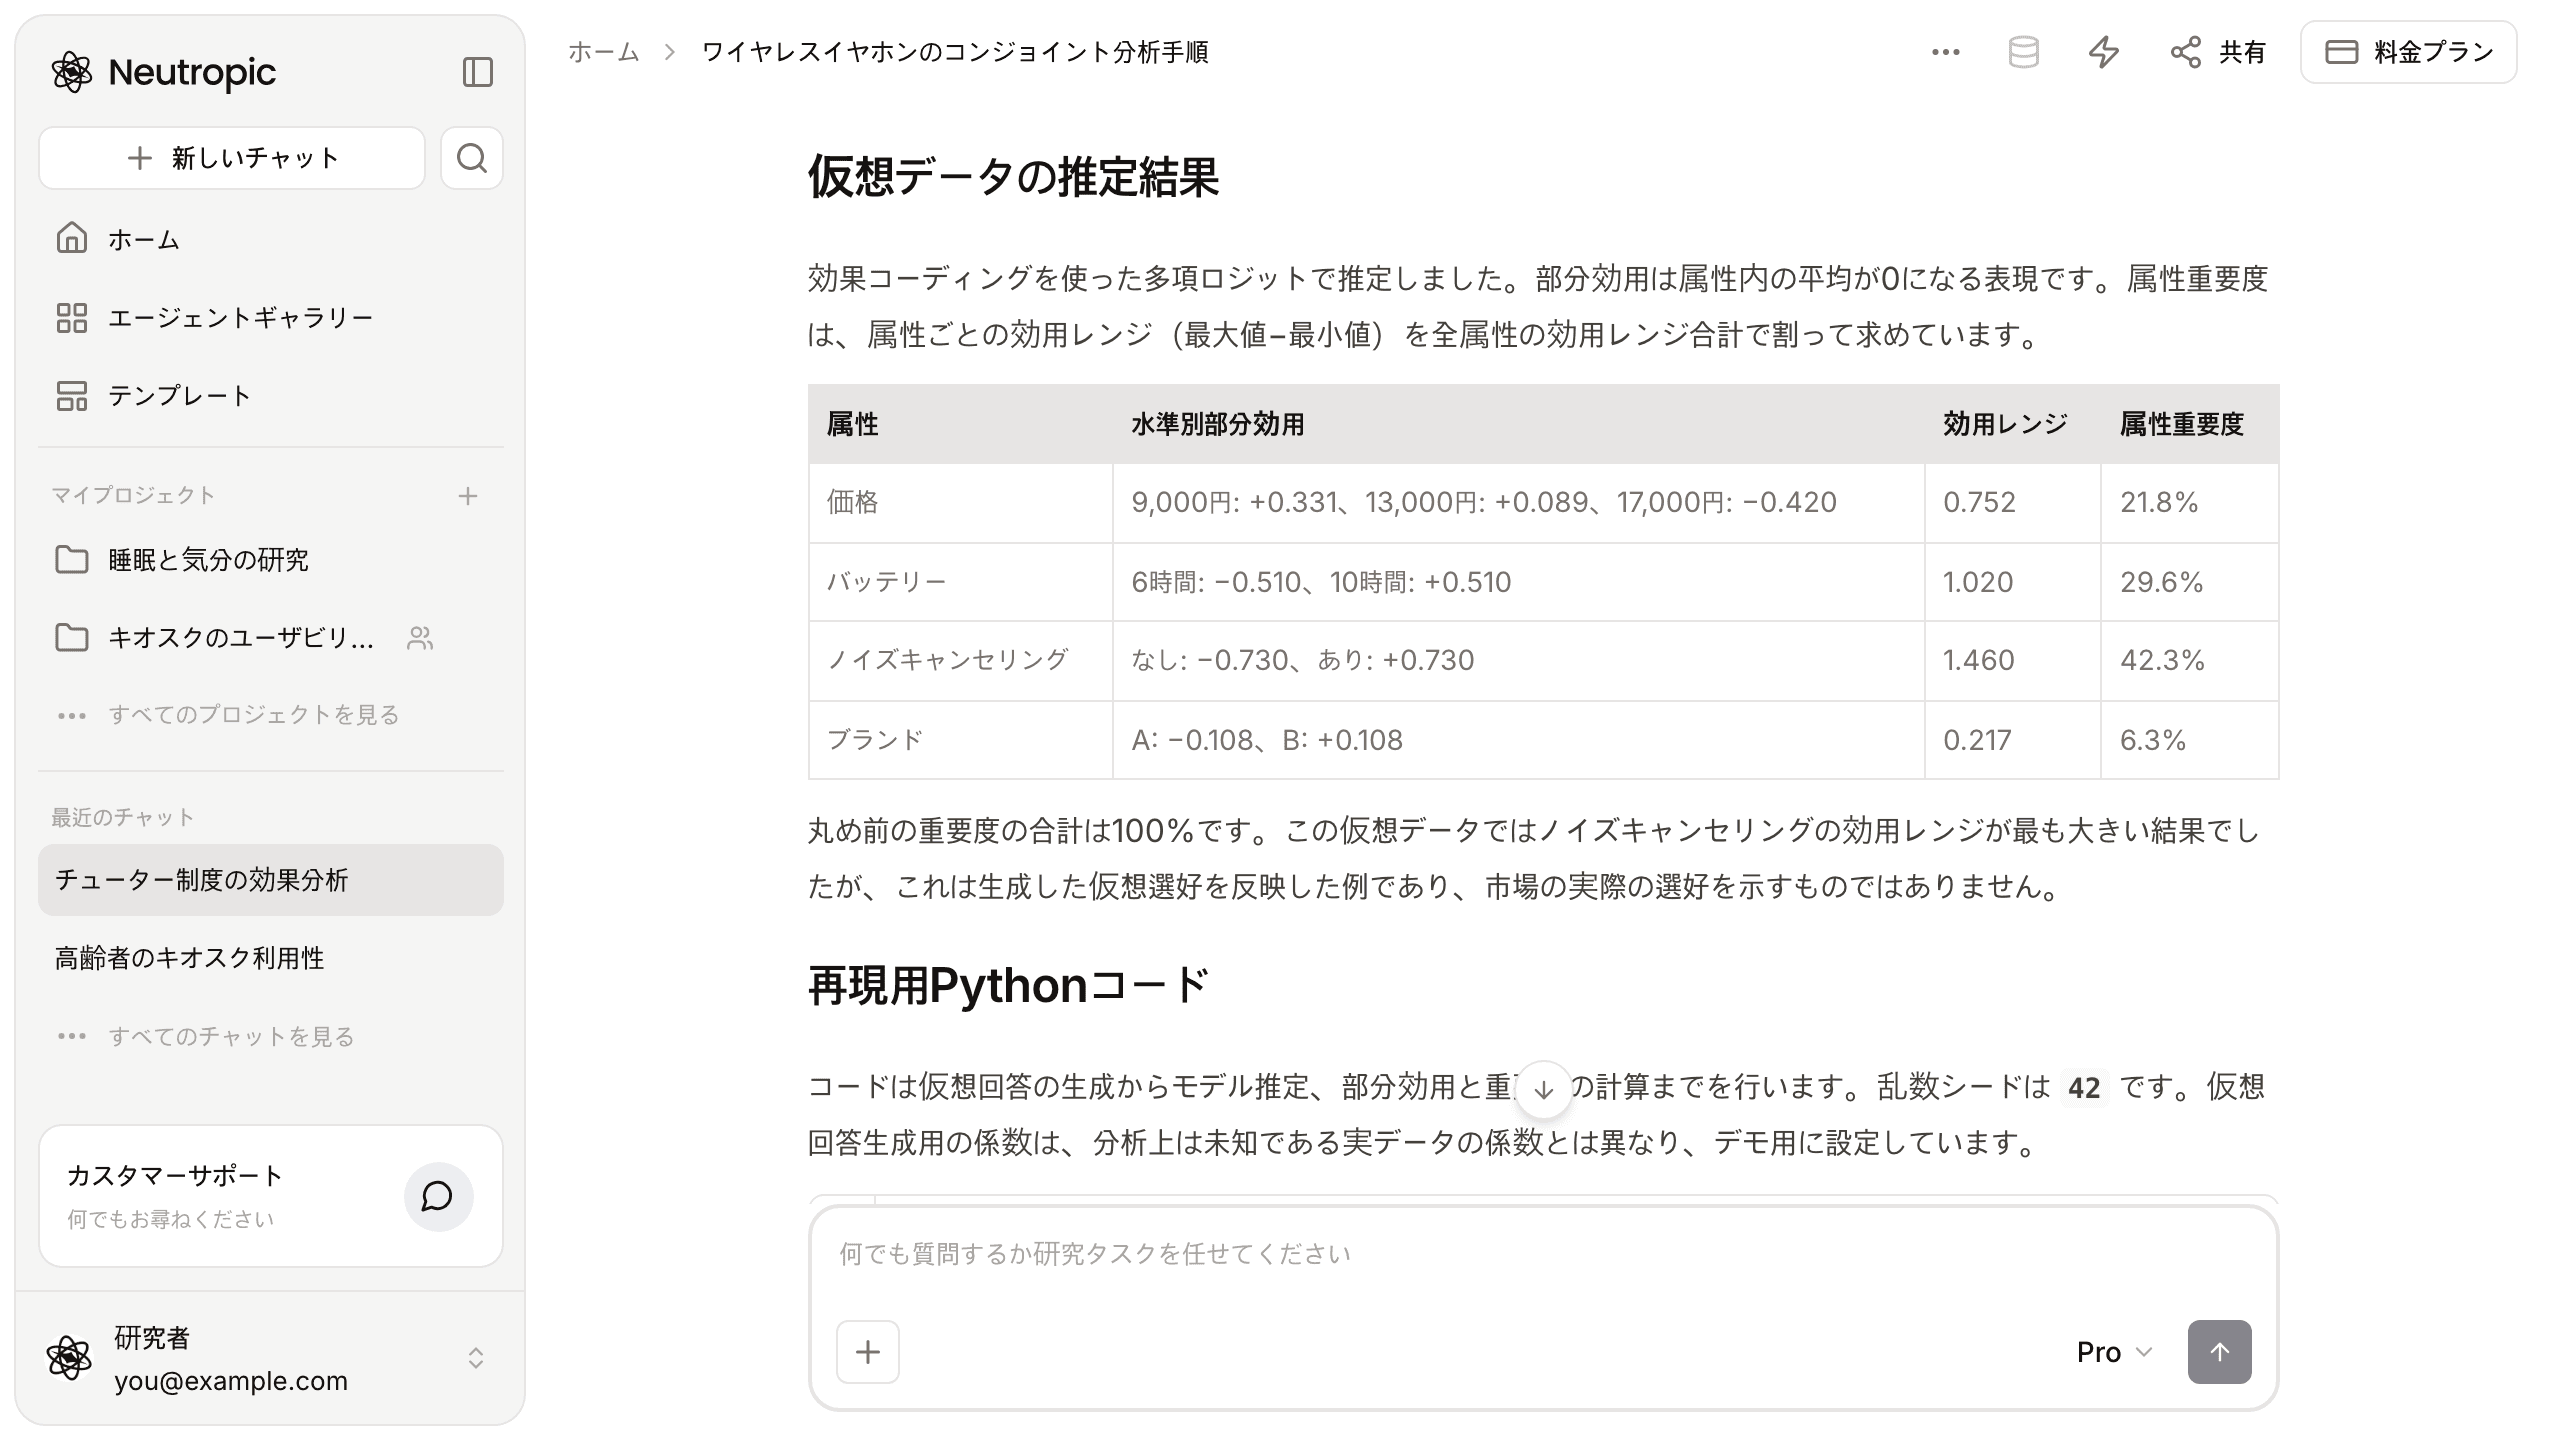
ここで美咲さんは危うく間違えるところでした。「消費者はノイズキャンセリングを最も重視する」と書きたくなりますが、回答はまさにその解釈に注意を促します。重要度は、実験に入れた水準の範囲で変わるからです。価格の幅を9,000〜17,000円ではなく9,000〜25,000円に広げていたら、価格はもっと「重要」に見えたはずです。
そもそもこれは仮想データの数値で、実際の消費者の好みではありません。回答にもはっきり書かれています。
表を作ったコードもそのまま受け取りました
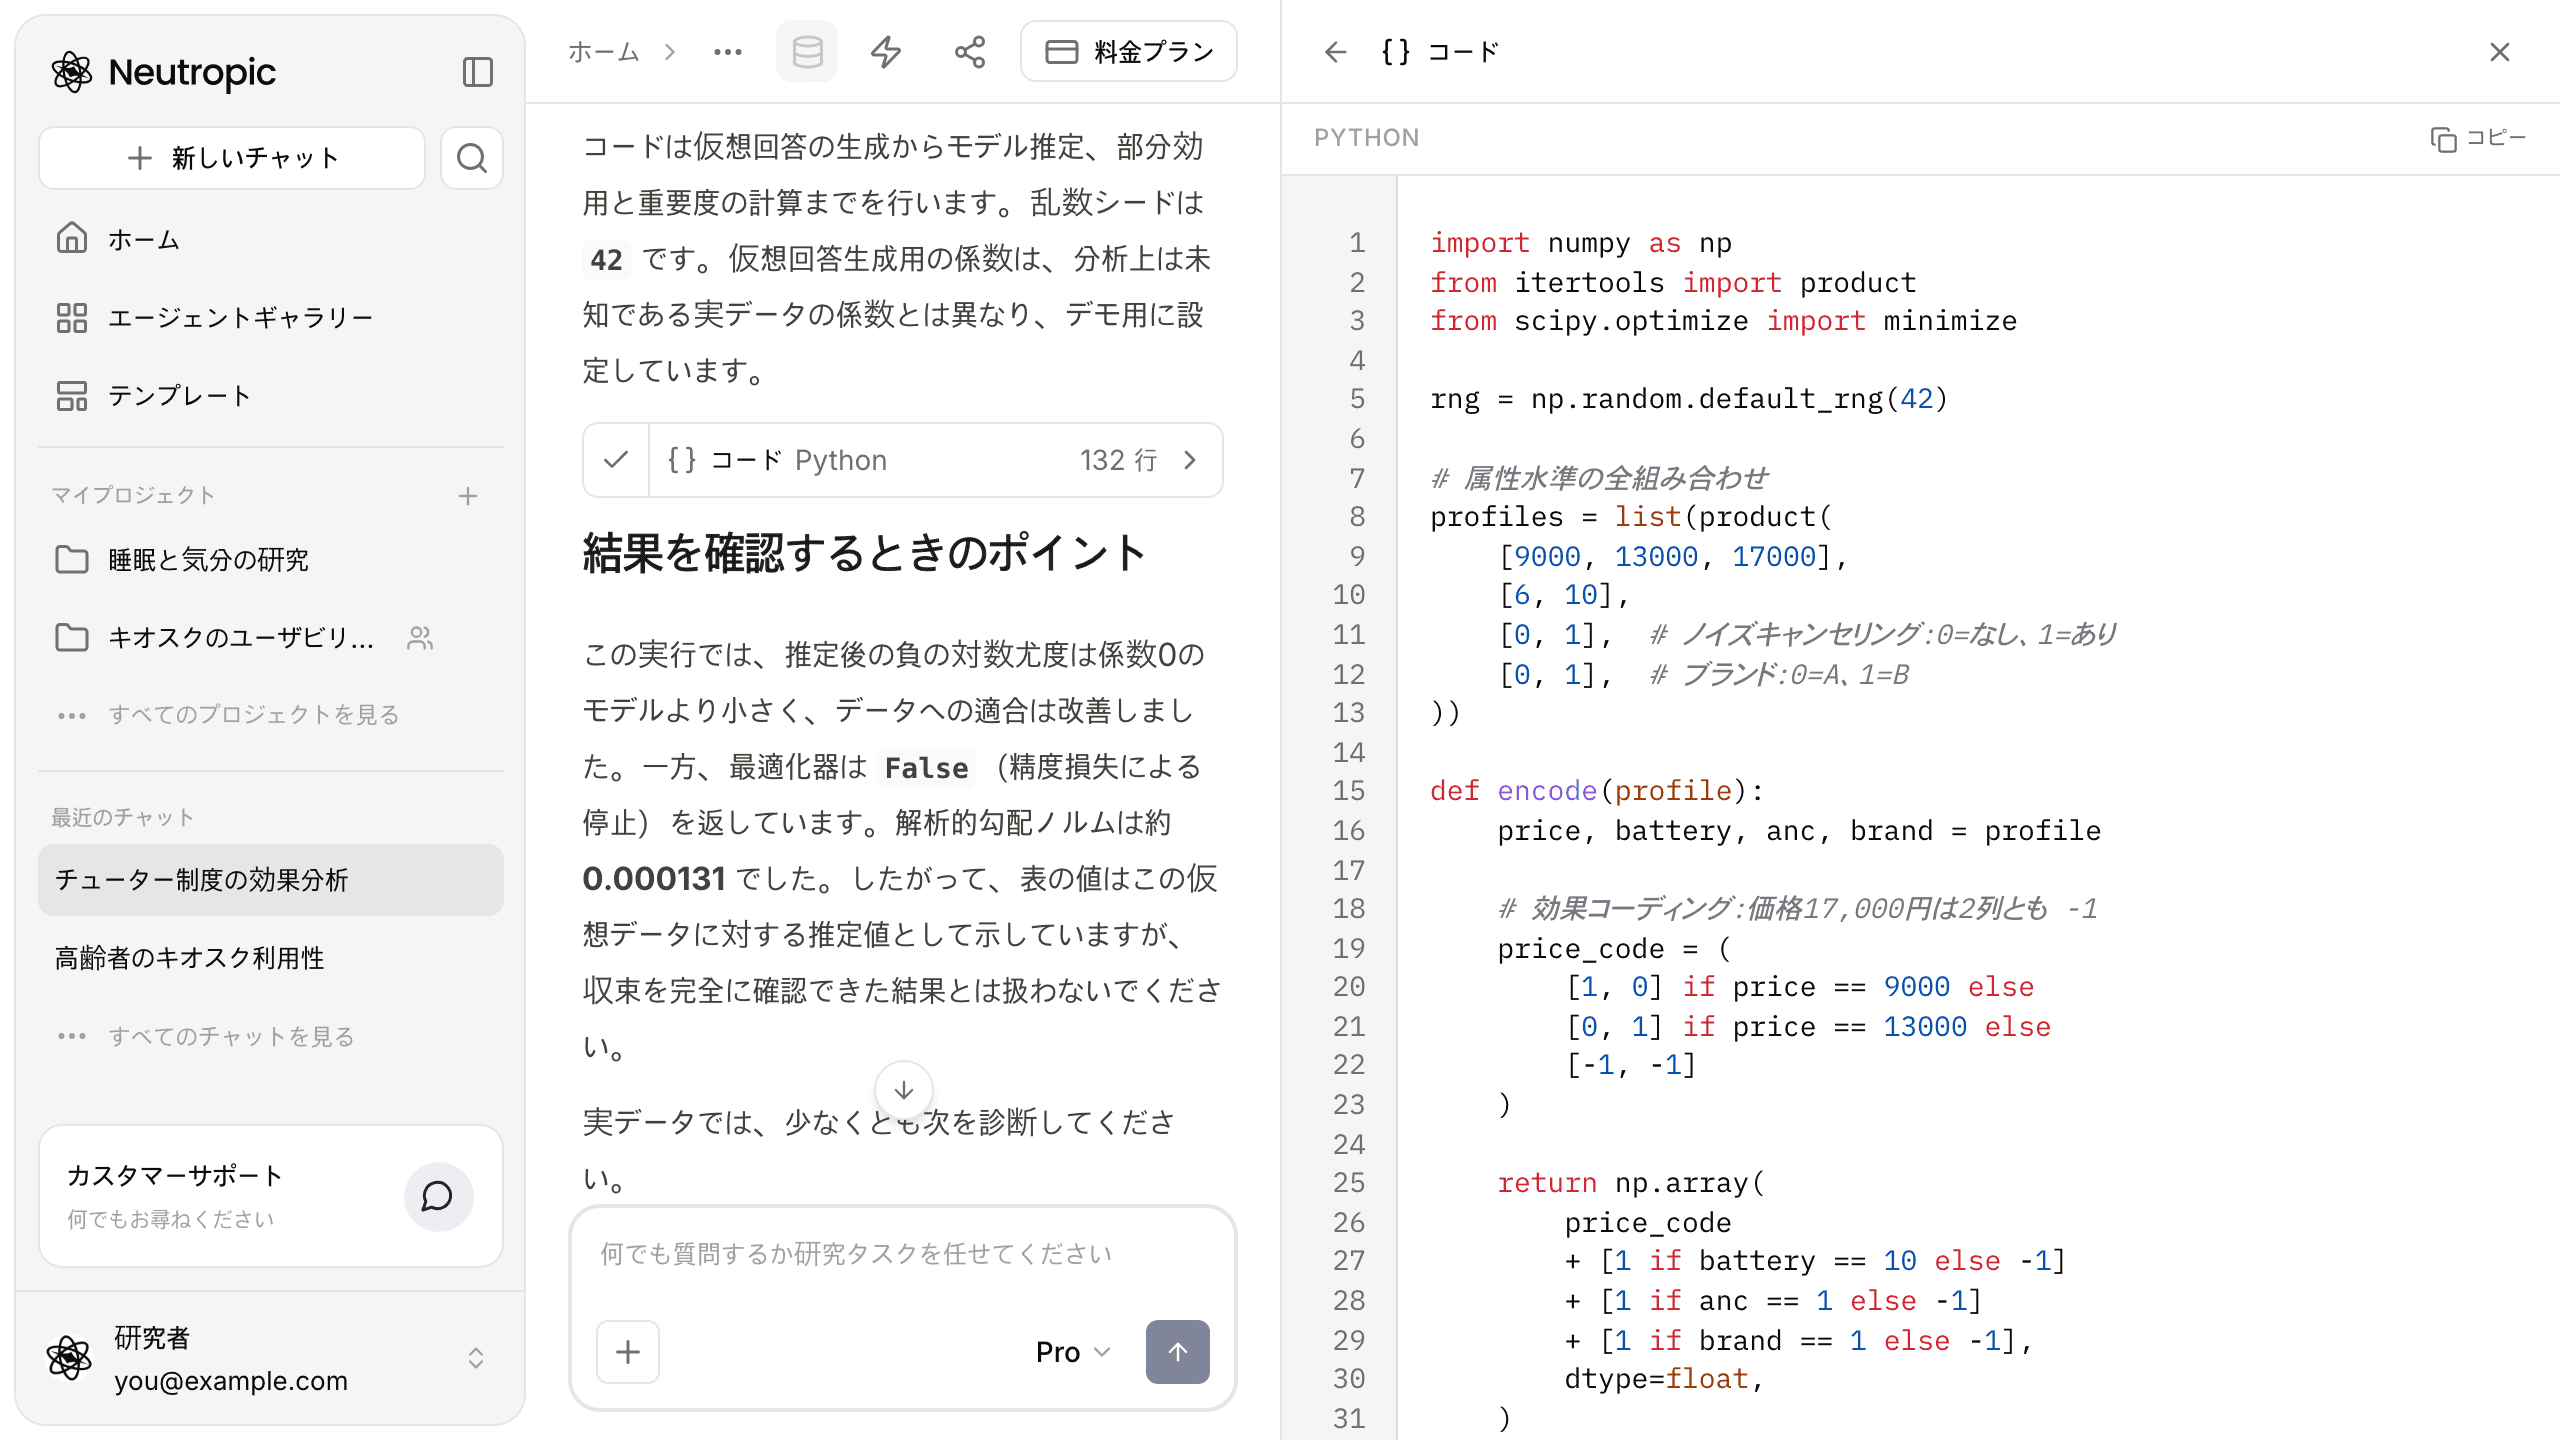
回答には、表を作ったPythonコードがそのまま付いていました。カードを押すと右側にコードが開き、コピーボタンで持ち帰れます。乱数シードが固定されているので、そのまま実行すると表と同じ数値が出ます。私たちも実際に実行して確かめました。😎
回答は、都合の悪い点も隠しませんでした。最適化器が精度の損失で停止したため、表の値は収束を完全に確認できた結果としては扱わないこと、実データでは初期値を変えても推定値が安定するか確かめること、と書いています。
なぜコードが大事かというと、論文の方法の節には「どう計算したか」を書く必要があるからです。数値だけでコードがなければ、後で実際の調査データで計算し直せません。美咲さんは、仮想回答を作る部分を実データに差し替えるだけで済みます。
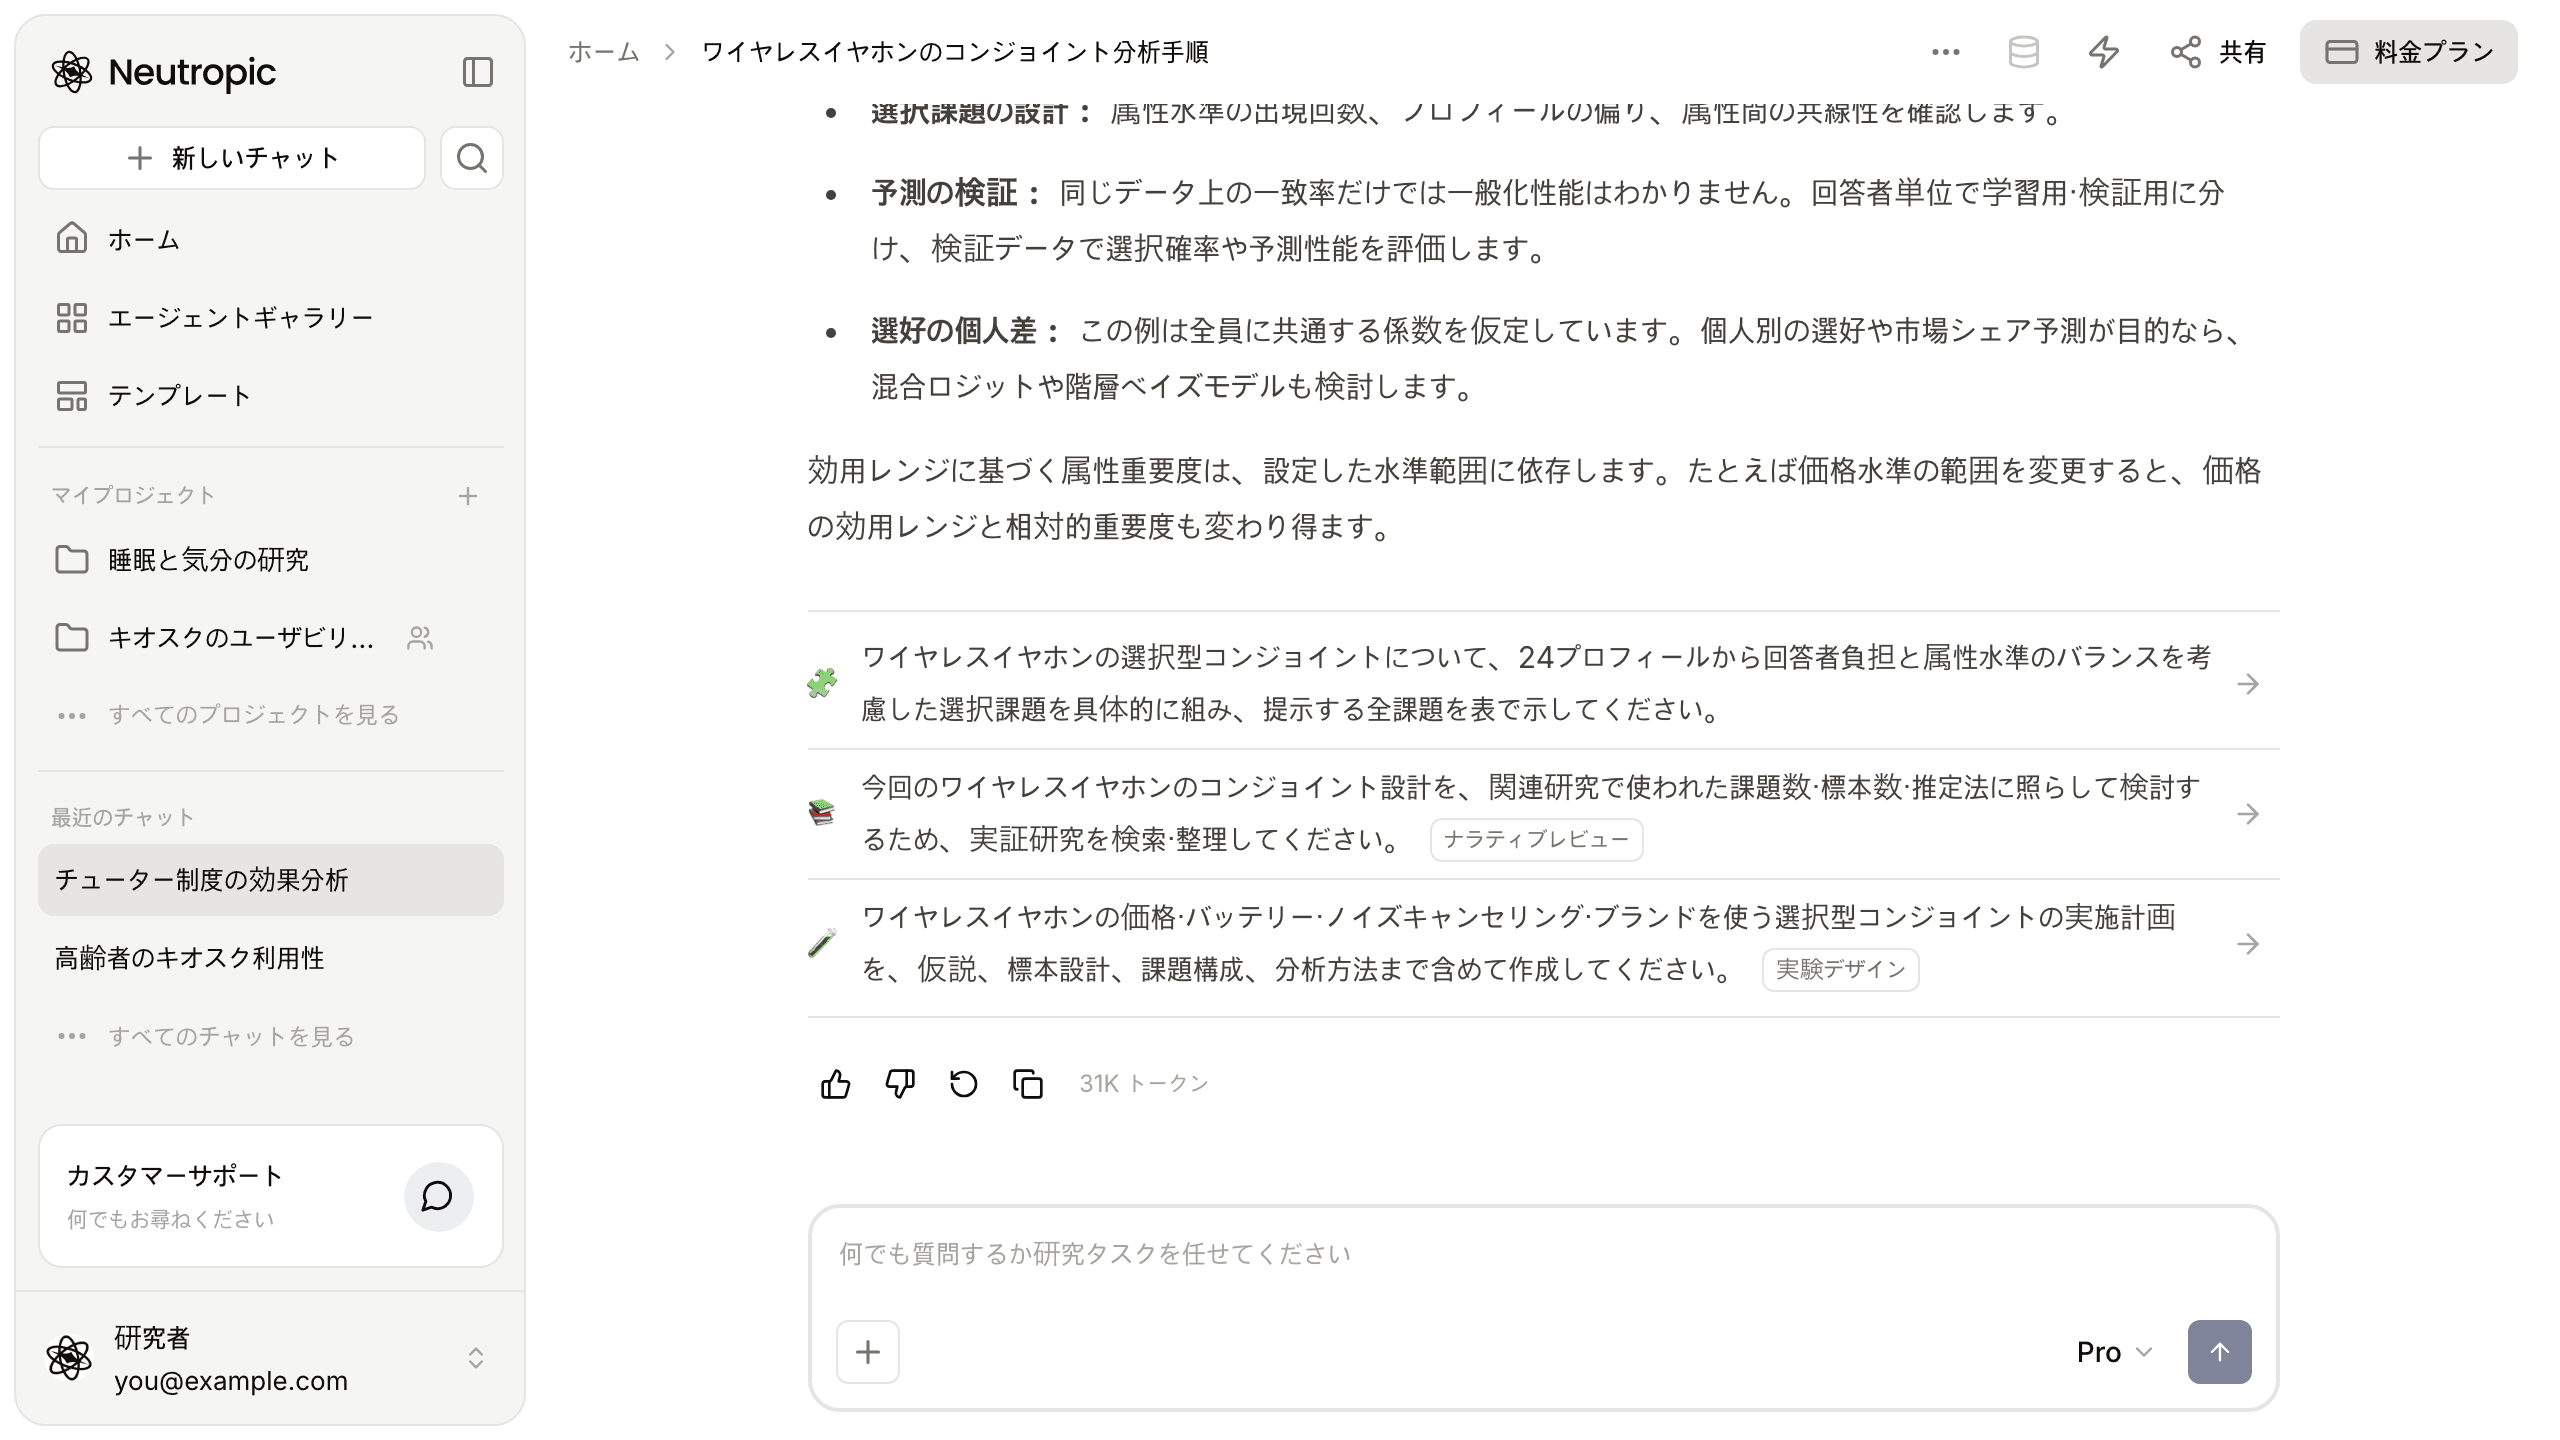
次にやることまで提案されました
回答のいちばん下には、続けてできることが3つ提案されていました。
- 24通りから、回答者の負担と水準のバランスを考えた選択課題を具体的に組み、全課題を表で示す
- 関連研究で使われた課題数・標本数・推定法と比べるため、実証研究を検索して整理する — ナラティブレビュー エージェント
- 仮説、標本設計、課題構成、分析方法まで含めた実施計画を作る — 実験デザイン エージェント
押すと同じチャットでそのまま続きます。発表まで2週間の美咲さんなら、3つ目から押すでしょうか。
途方に暮れていた質問が、回せる分析になりました
| 始めたとき | 今 | |
|---|---|---|
| 設計 | 属性4つだけ決めていた | 24通り、120人×8課題、商品案3つ+「買わない」 |
| 分析方法 | コンジョイントという名前だけ | 効果コーディングの多項ロジット、レンジによる重要度 |
| 結果 | なし | 部分効用と重要度の表 |
| コード | RやSPSSの例を探し回っていた | 同じ数値が再現されるPythonコード |
| 次の一手 | 何から手を付けるか分からない | 押すだけで続けられる3つの提案 |
もちろん、仮想データでのリハーサルです。結論は実際の調査データで出す必要があり、好みが人によって大きく違うなら混合ロジットや階層ベイズモデルも検討します。それでも、白紙から始めるのと動くコードから始めるのとでは、まったく違います。
この記事は Pro で実行しました。Lite(無料プラン)はシミュレーションなしで主要な手順と数式を示し、Expert はさらに代替モデルとの比較や仮定の感度チェックを加えます。
指導教員に「コンジョイントでやってみたら」と言われたら、質問ひとつで最初の分析までたどり着けます。
今週、美咲さんのように、知っていることだけを書いて聞いてみてください。Neutropicを無料で始める