こんにちは、Neutropicチームです!
追跡データで「いつ起きるか」を分析していると、必ずこういう人が混ざっています。関心のあるイベントの前に、別のイベントが先に起きてしまった人です。中退を見たいのに、その前に編入してしまった学生。再発を見たいのに、その前に別の理由で亡くなった患者。こうした人を、ただの「打ち切り」として扱っていいのでしょうか。🥲
多くの生存時間分析の授業は、Kaplan–MeierとCoxモデルで終わります。そのため、競合イベントを通常の打ち切りとして扱い、1 − Kaplan–Meierを「発生確率」として報告してしまうことがよくあります。でもこの値は、関心のあるイベントの実際の確率を過大評価し得ます。原因別ハザード比を絶対リスクのように読むのも、よくある誤りです。
この記事では、教育学の博士課程の 健太さん が、大学1年生の追跡データで中退までの時間を分析しようとして、編入という競合イベントで立ち止まった場面を追います。健太さんは架空の人物ですが、以下の画面はすべてNeutropicで実際に実行したチャットです。
「どう分析するか」と「何に気をつけるか」を一緒に聞きました
健太さんが決めていたのは、Pythonを使うことだけでした。そこでこう聞きました。
生存時間分析で競合リスクがあるとき、どう分析し、何に気をつければいいですか?Pythonでやるつもりです。
入っているのは3つです。問題の名前(競合リスク)、ほしいもの(分析方法と注意点)、道具(Python)。とくに「何に気をつければいいか」を入れたのが良かった点です。方法だけ聞くとコードのかたまりで終わりがちですが、落とし穴を聞くと、解釈で間違えやすいところまで指摘してくれます。
ガイドを読み、論文と公式資料を探しました
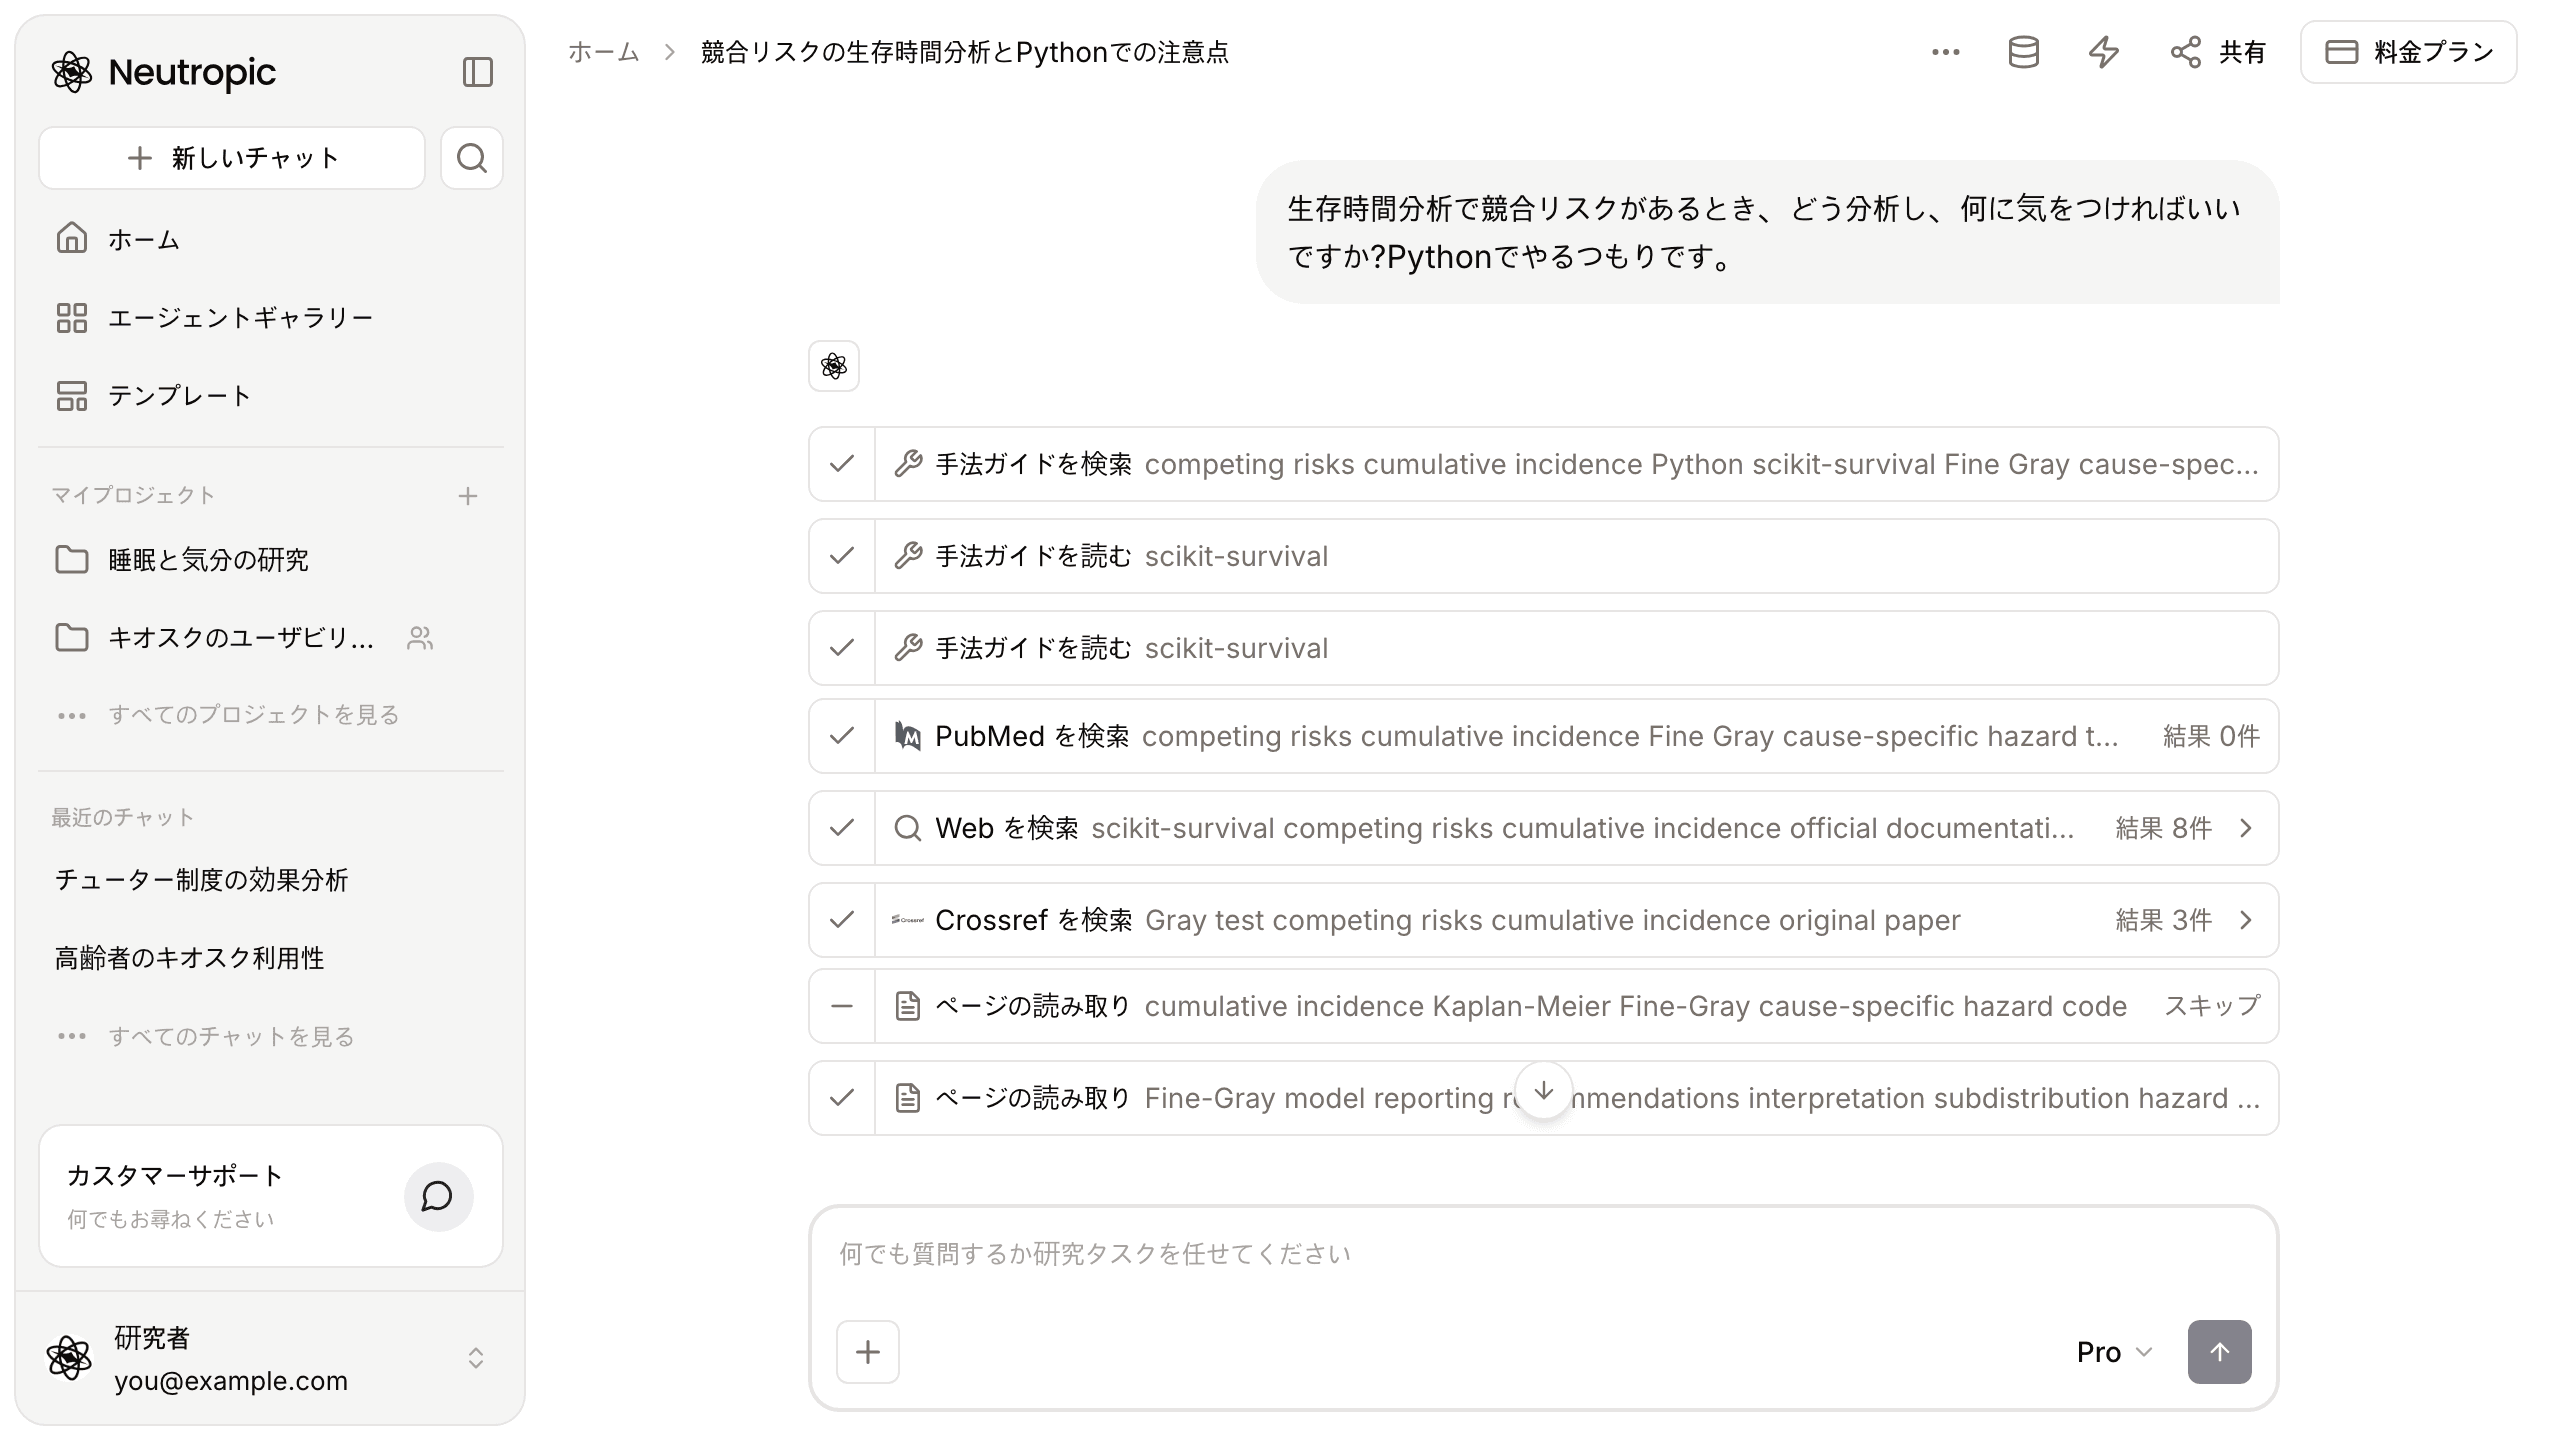
送るとすぐにステップが積み上がりました。手法ガイドを検索 でPythonの競合リスク分析に合うガイドを探し、手法ガイドを読む でscikit-survivalのガイドを読みました。続けてPubMedで論文を、Webでscikit-survivalの公式ドキュメントを、CrossrefでGray検定の原論文を検索し、Fine–Grayモデルの報告に関する推奨のページを読んでいます。
手法ガイドは、Neutropicがあらかじめ確認しておいた分析手順の文書です。PubMedの検索が0件だったことや、ページの読み取りを1件スキップしたことも、ステップにそのまま残ります。
まず「何を知りたいか」を決めるよう言われました
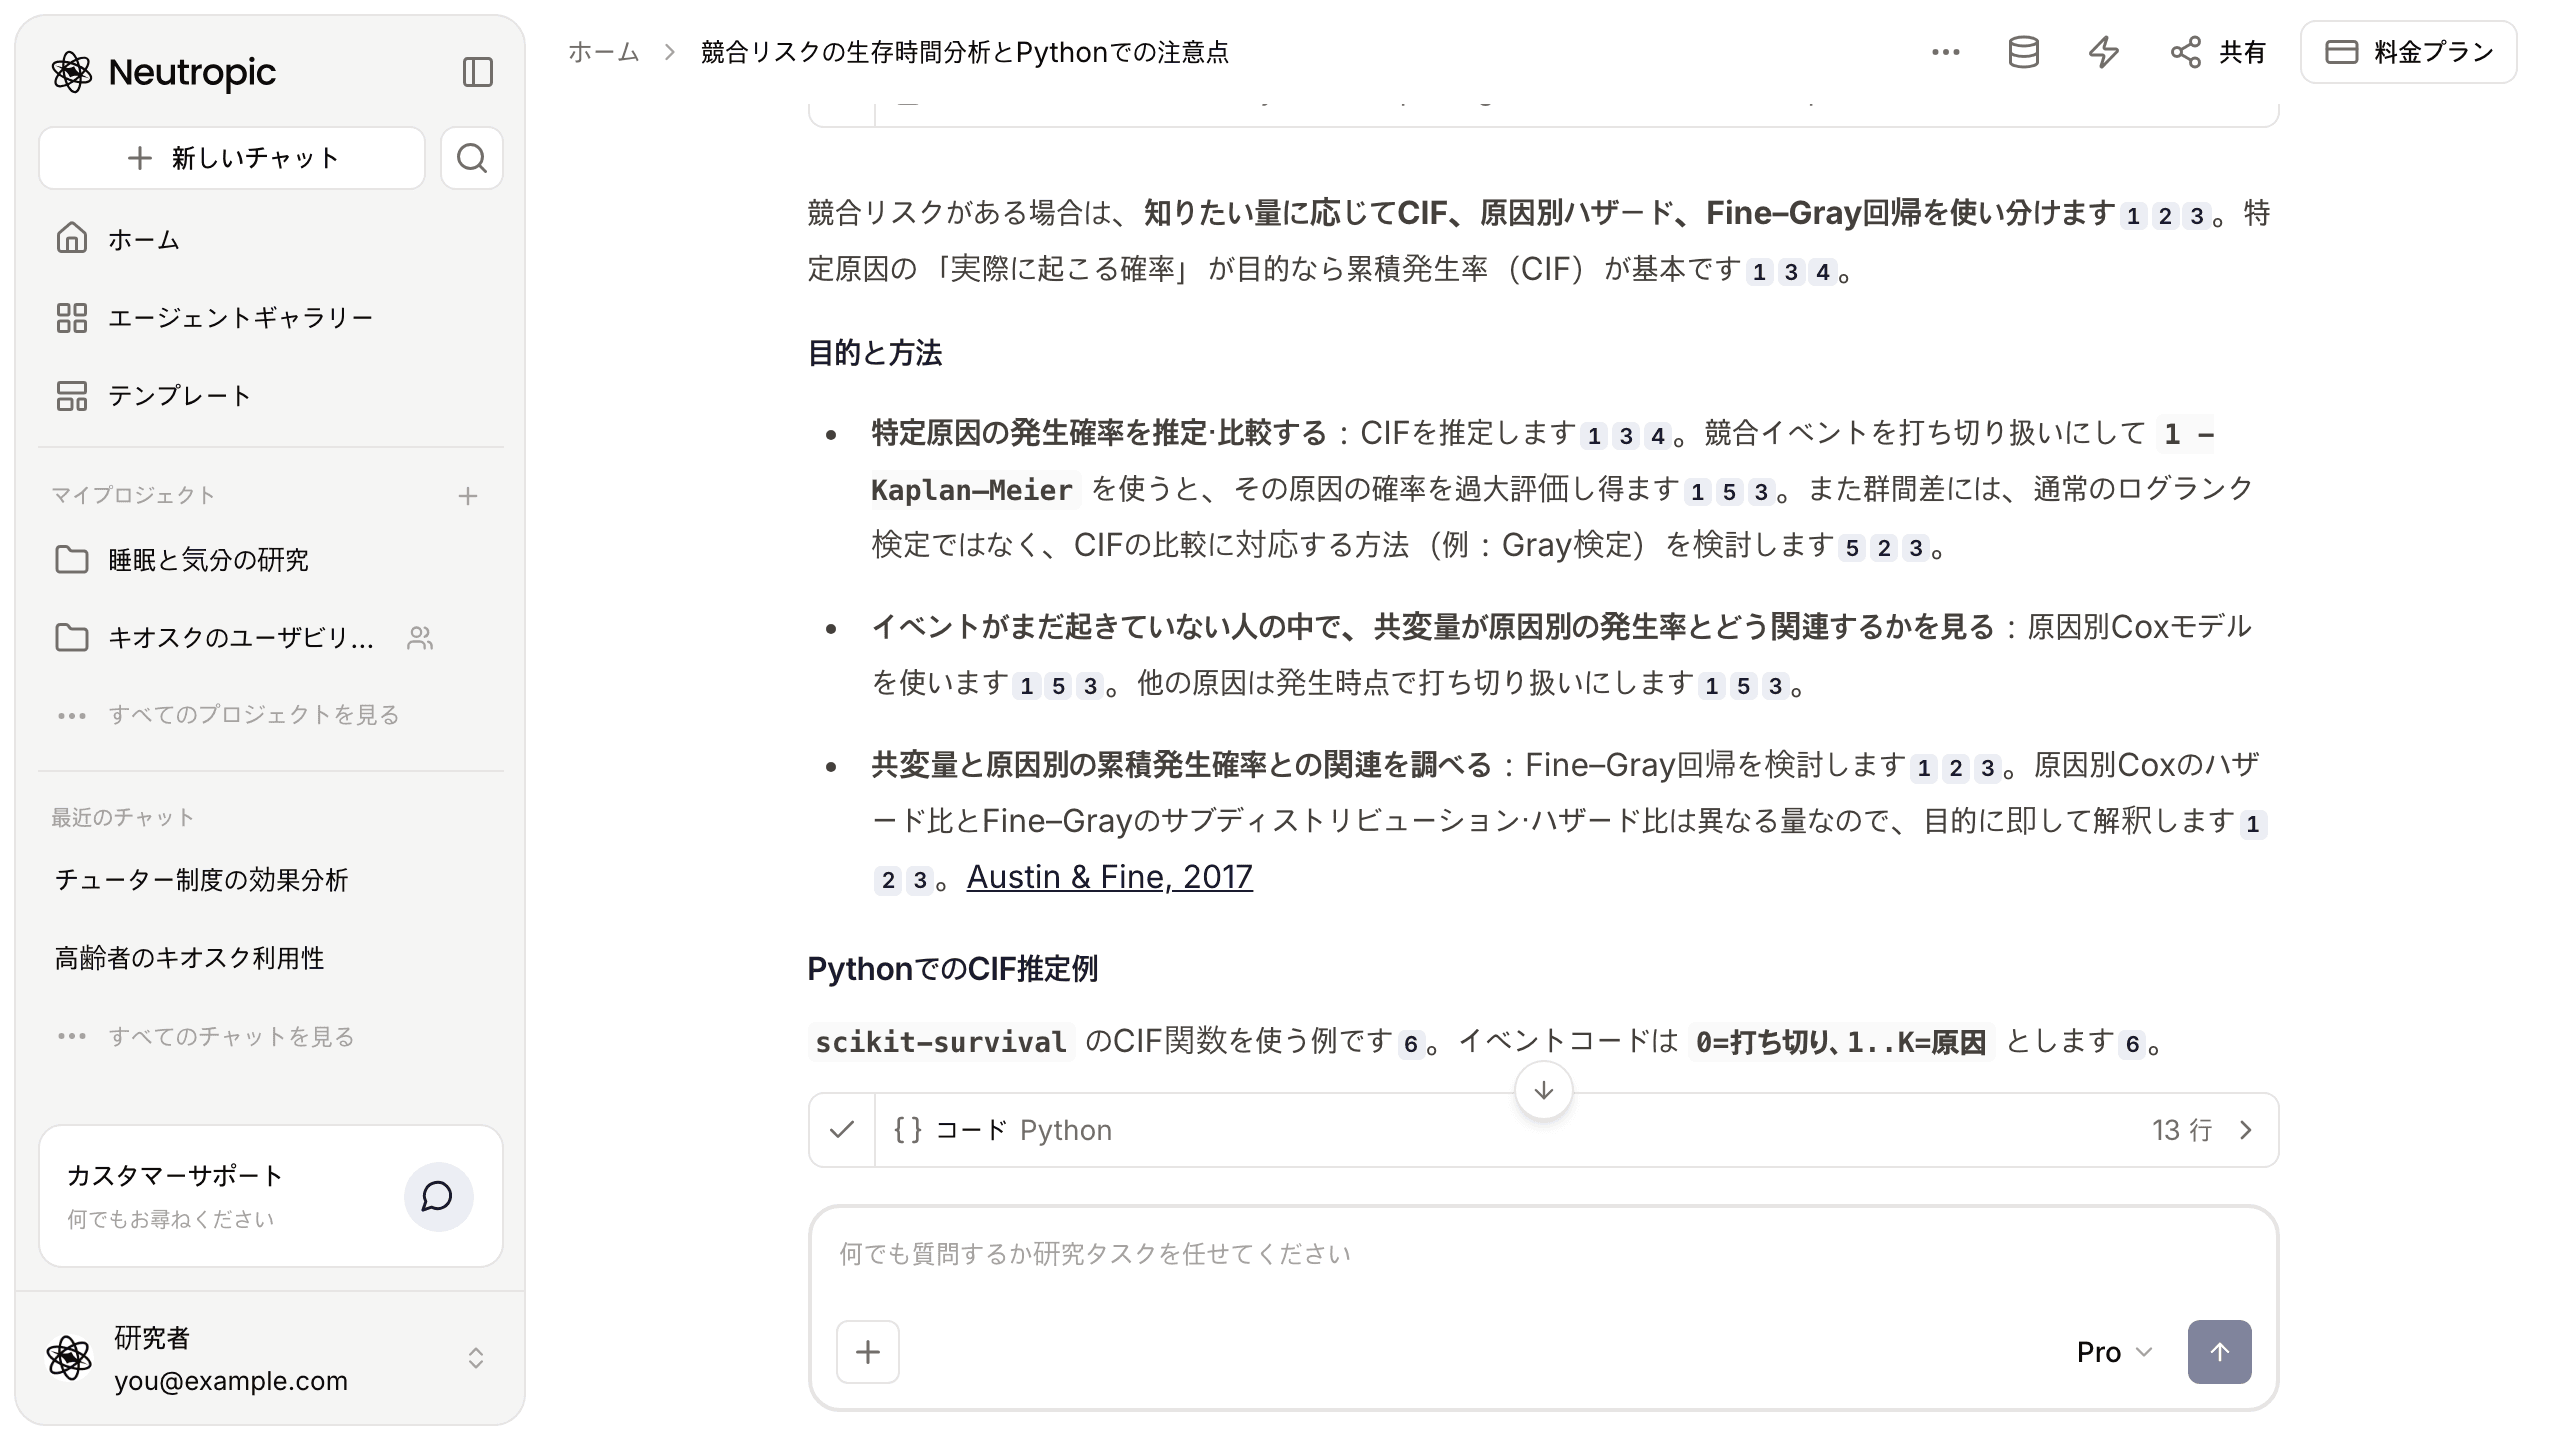
回答の最初の一文は、方法ではなく問いでした。競合リスクがあるときは、知りたい量に応じてCIF、原因別ハザード、Fine–Gray回帰を使い分ける。特定原因の「実際に起こる確率」が目的なら、累積発生率(CIF)が基本だということです。
- 特定原因の発生確率を推定・比較する:CIFを推定します。群間差には通常のログランク検定ではなく、CIFの比較に対応する方法(例:Gray検定)を検討します。
- イベントがまだ起きていない人の中で、共変量が原因別の発生率とどう関連するかを見る:原因別Coxモデルを使い、他の原因は発生時点で打ち切り扱いにします。
- 共変量と原因別の累積発生確率との関連を調べる:Fine–Gray回帰を検討します。原因別Coxのハザード比とは異なる量です。
健太さんの研究に当てはめると、「4年以内に中退する確率」ならCIF、「奨学金が中退の起こりやすさとどう関連するか」なら原因別Coxです。
Pythonのコードは「CIFだけ」と明記されていました
回答には、scikit-survivalの cumulative_incidence_competing_risks で非パラメトリックなCIFを求める13行のコードが付いていました。イベントコードを 0=打ち切り、1..K=原因 とし、原因別CIFの合計が全原因の累積発生率と一致するかを確かめる行も入っています。
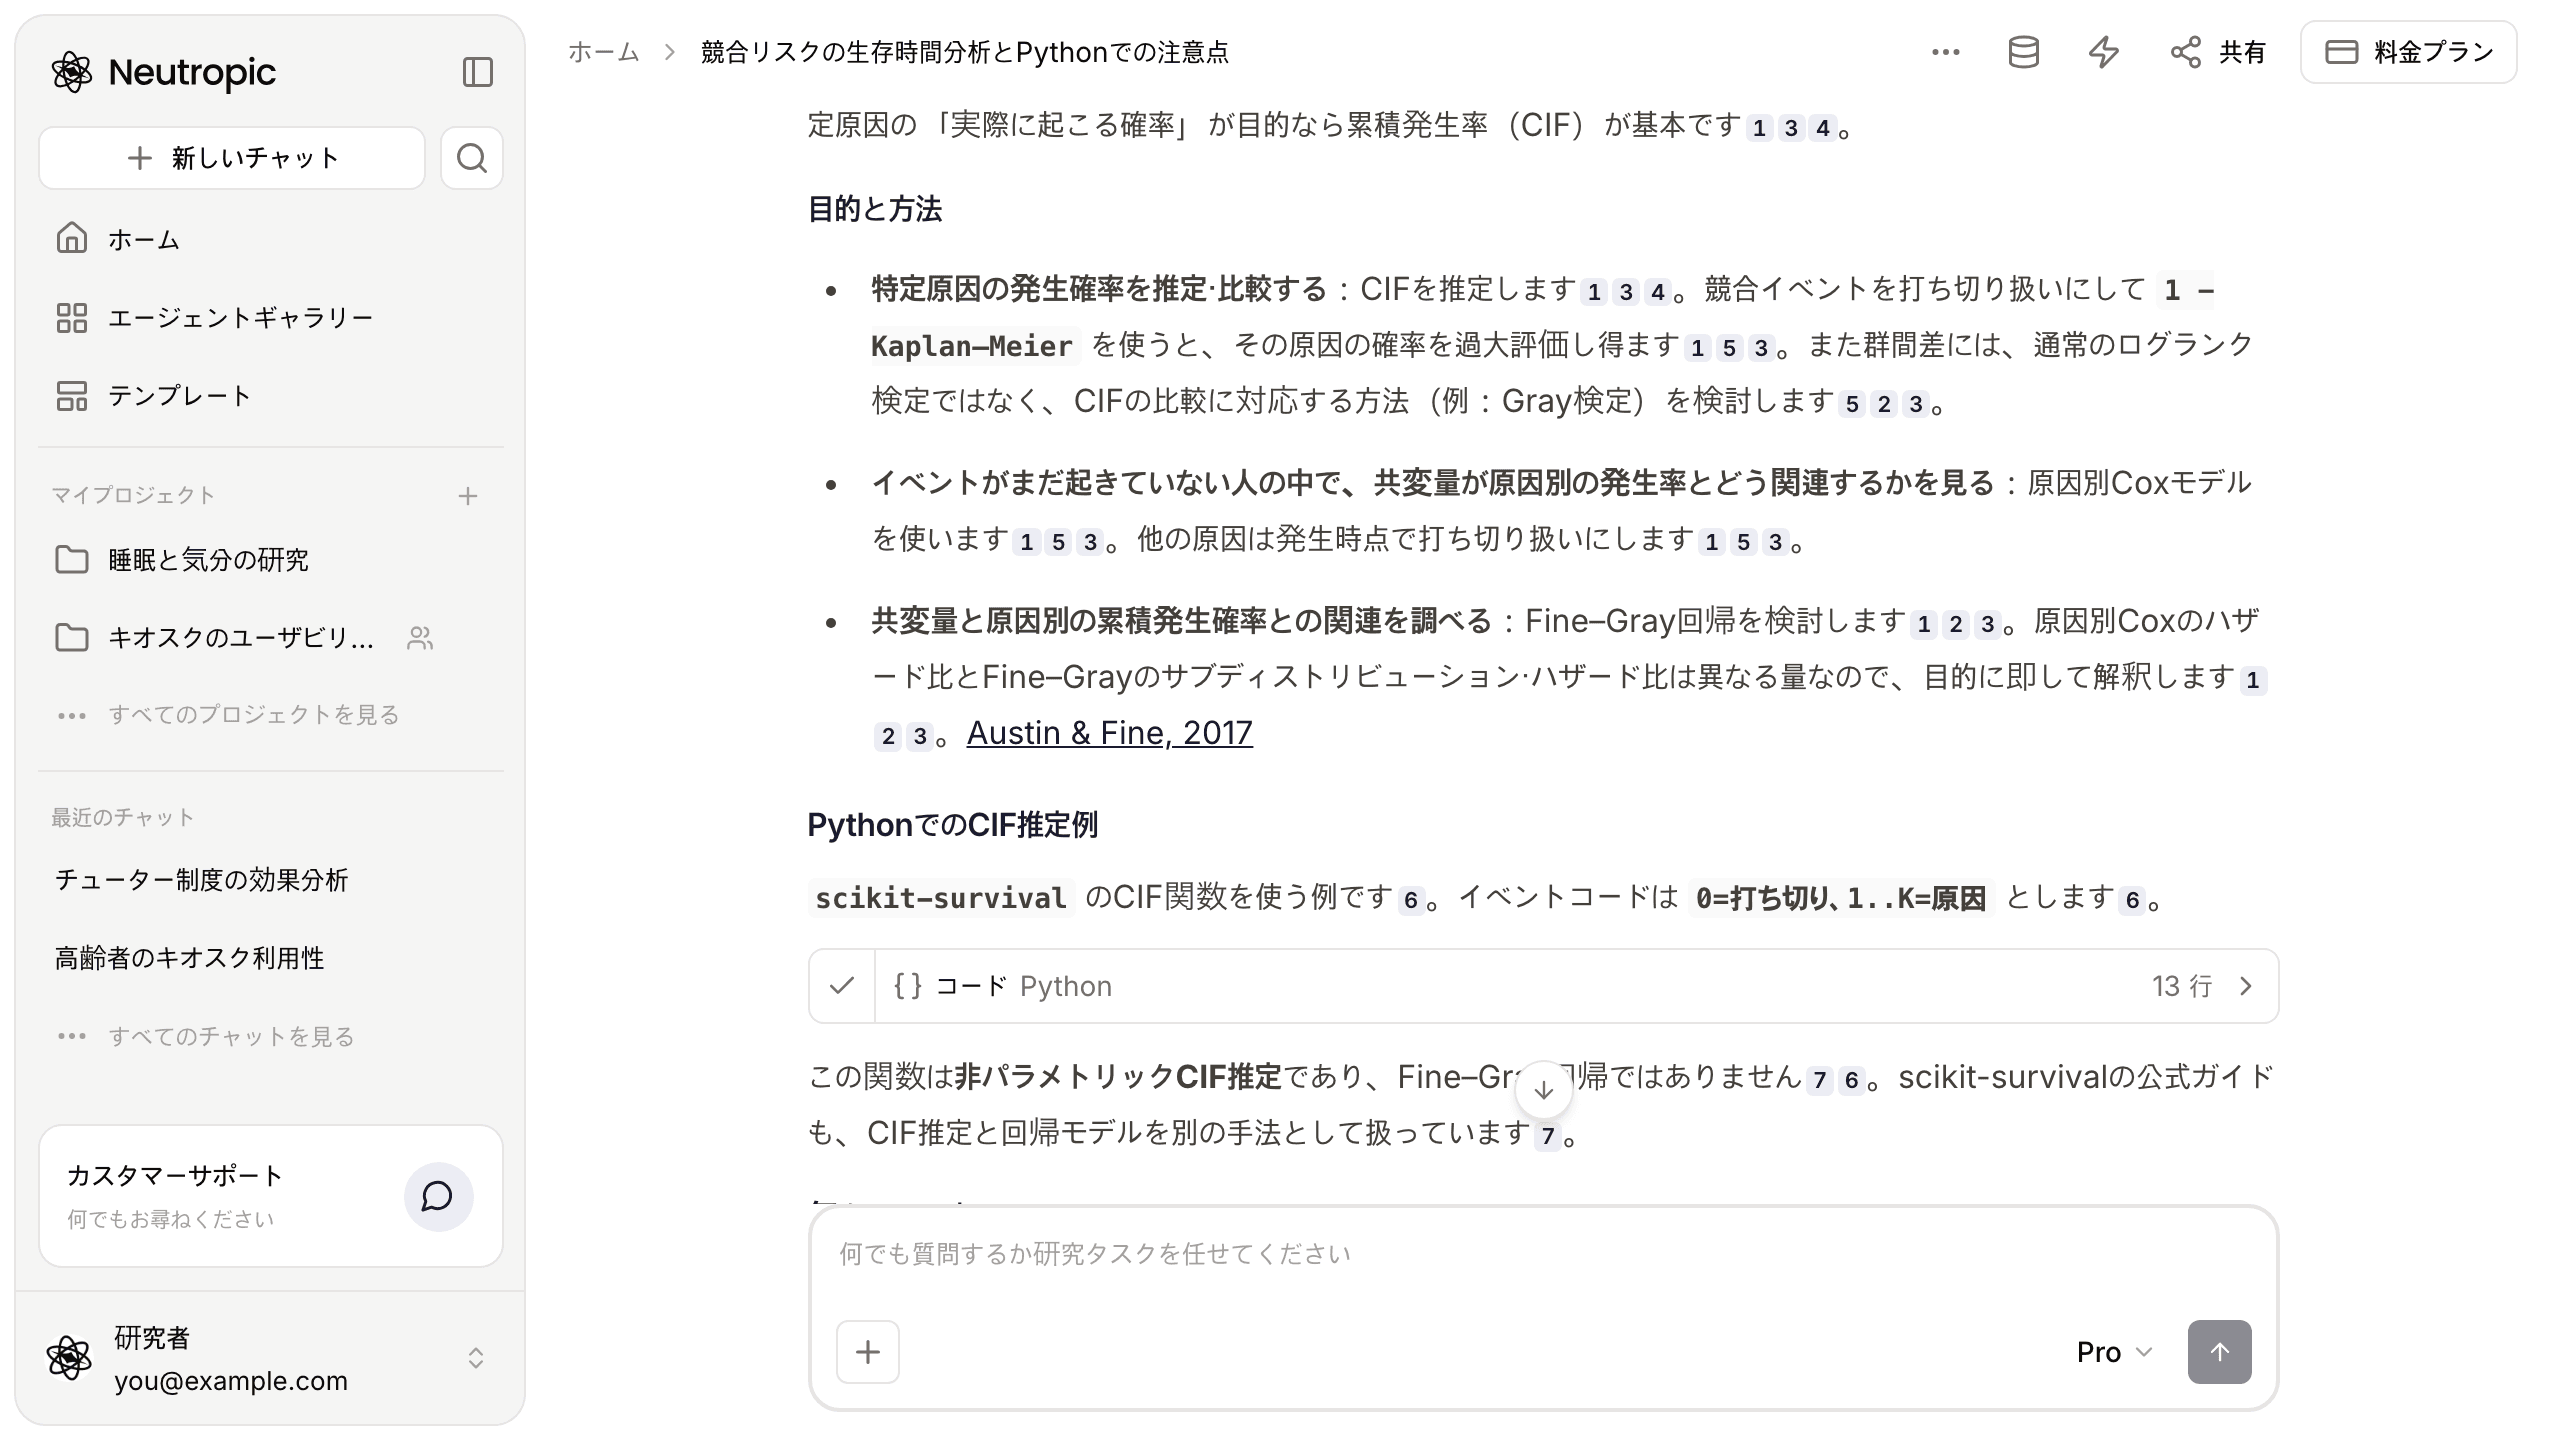
そのうえで、この関数は 非パラメトリックCIF推定であり、Fine–Gray回帰ではない とはっきり書かれていました。コードはデータなしの雛形なので、健太さんは自分の df を入れるだけです。
1 − Kaplan–Meierを使い続けるところでした
ここで健太さんは危うく間違えるところでした。指導教員に見せた以前の草稿に、もう「1 − KMで推定した4年中退率」が入っていたのです。回答の注意点は、まさにそこを突いていました。
- 競合イベントを打ち切り扱いにして
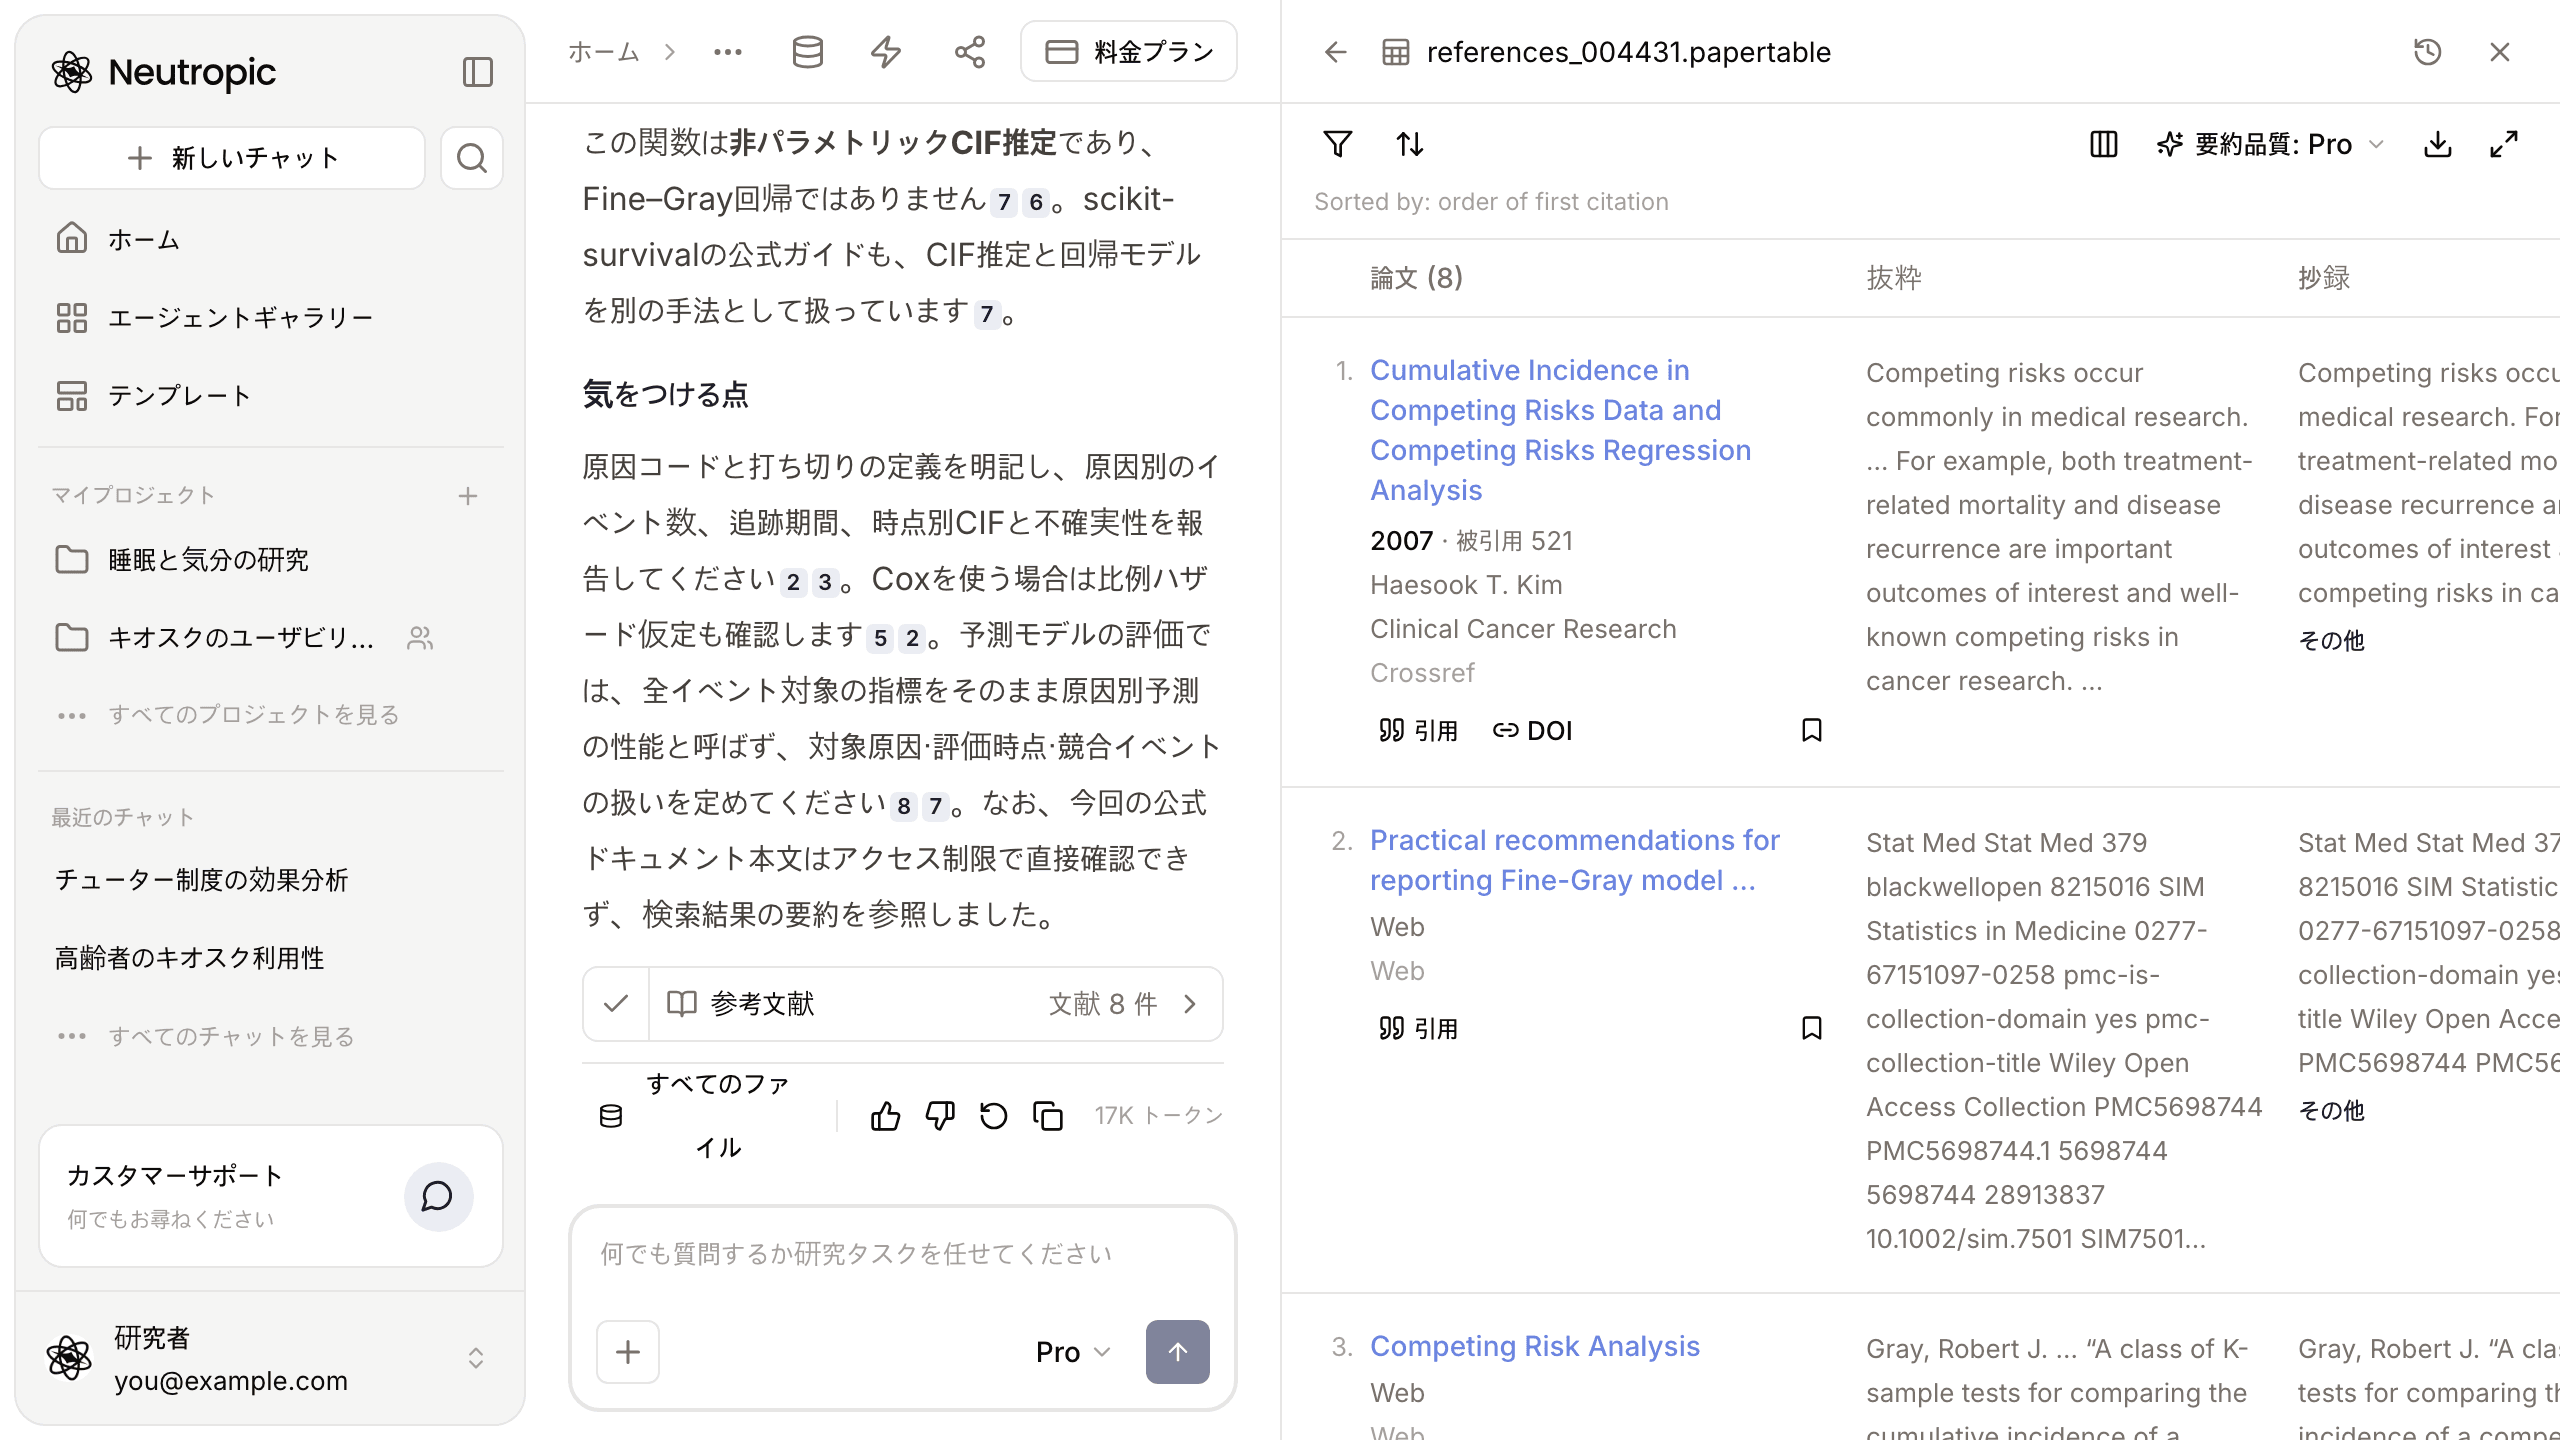
1 − Kaplan–Meierを使うと、その原因の確率を 過大評価し得ます。 - 原因コードと打ち切りの定義を明記し、原因別のイベント数、追跡期間、時点別CIFと不確実性を報告します。
- Coxを使う場合は比例ハザード仮定も確認します。
- 予測モデルの評価では、全イベント対象の指標をそのまま原因別予測の性能と呼ばないこと。
回答は自分の限界も書いていました。今回、公式ドキュメントの本文はアクセス制限で直接確認できず、検索結果の要約を参照した、と。どこまで信じてどこから確かめるべきかが、これで分かります。
出典も一緒に残りました
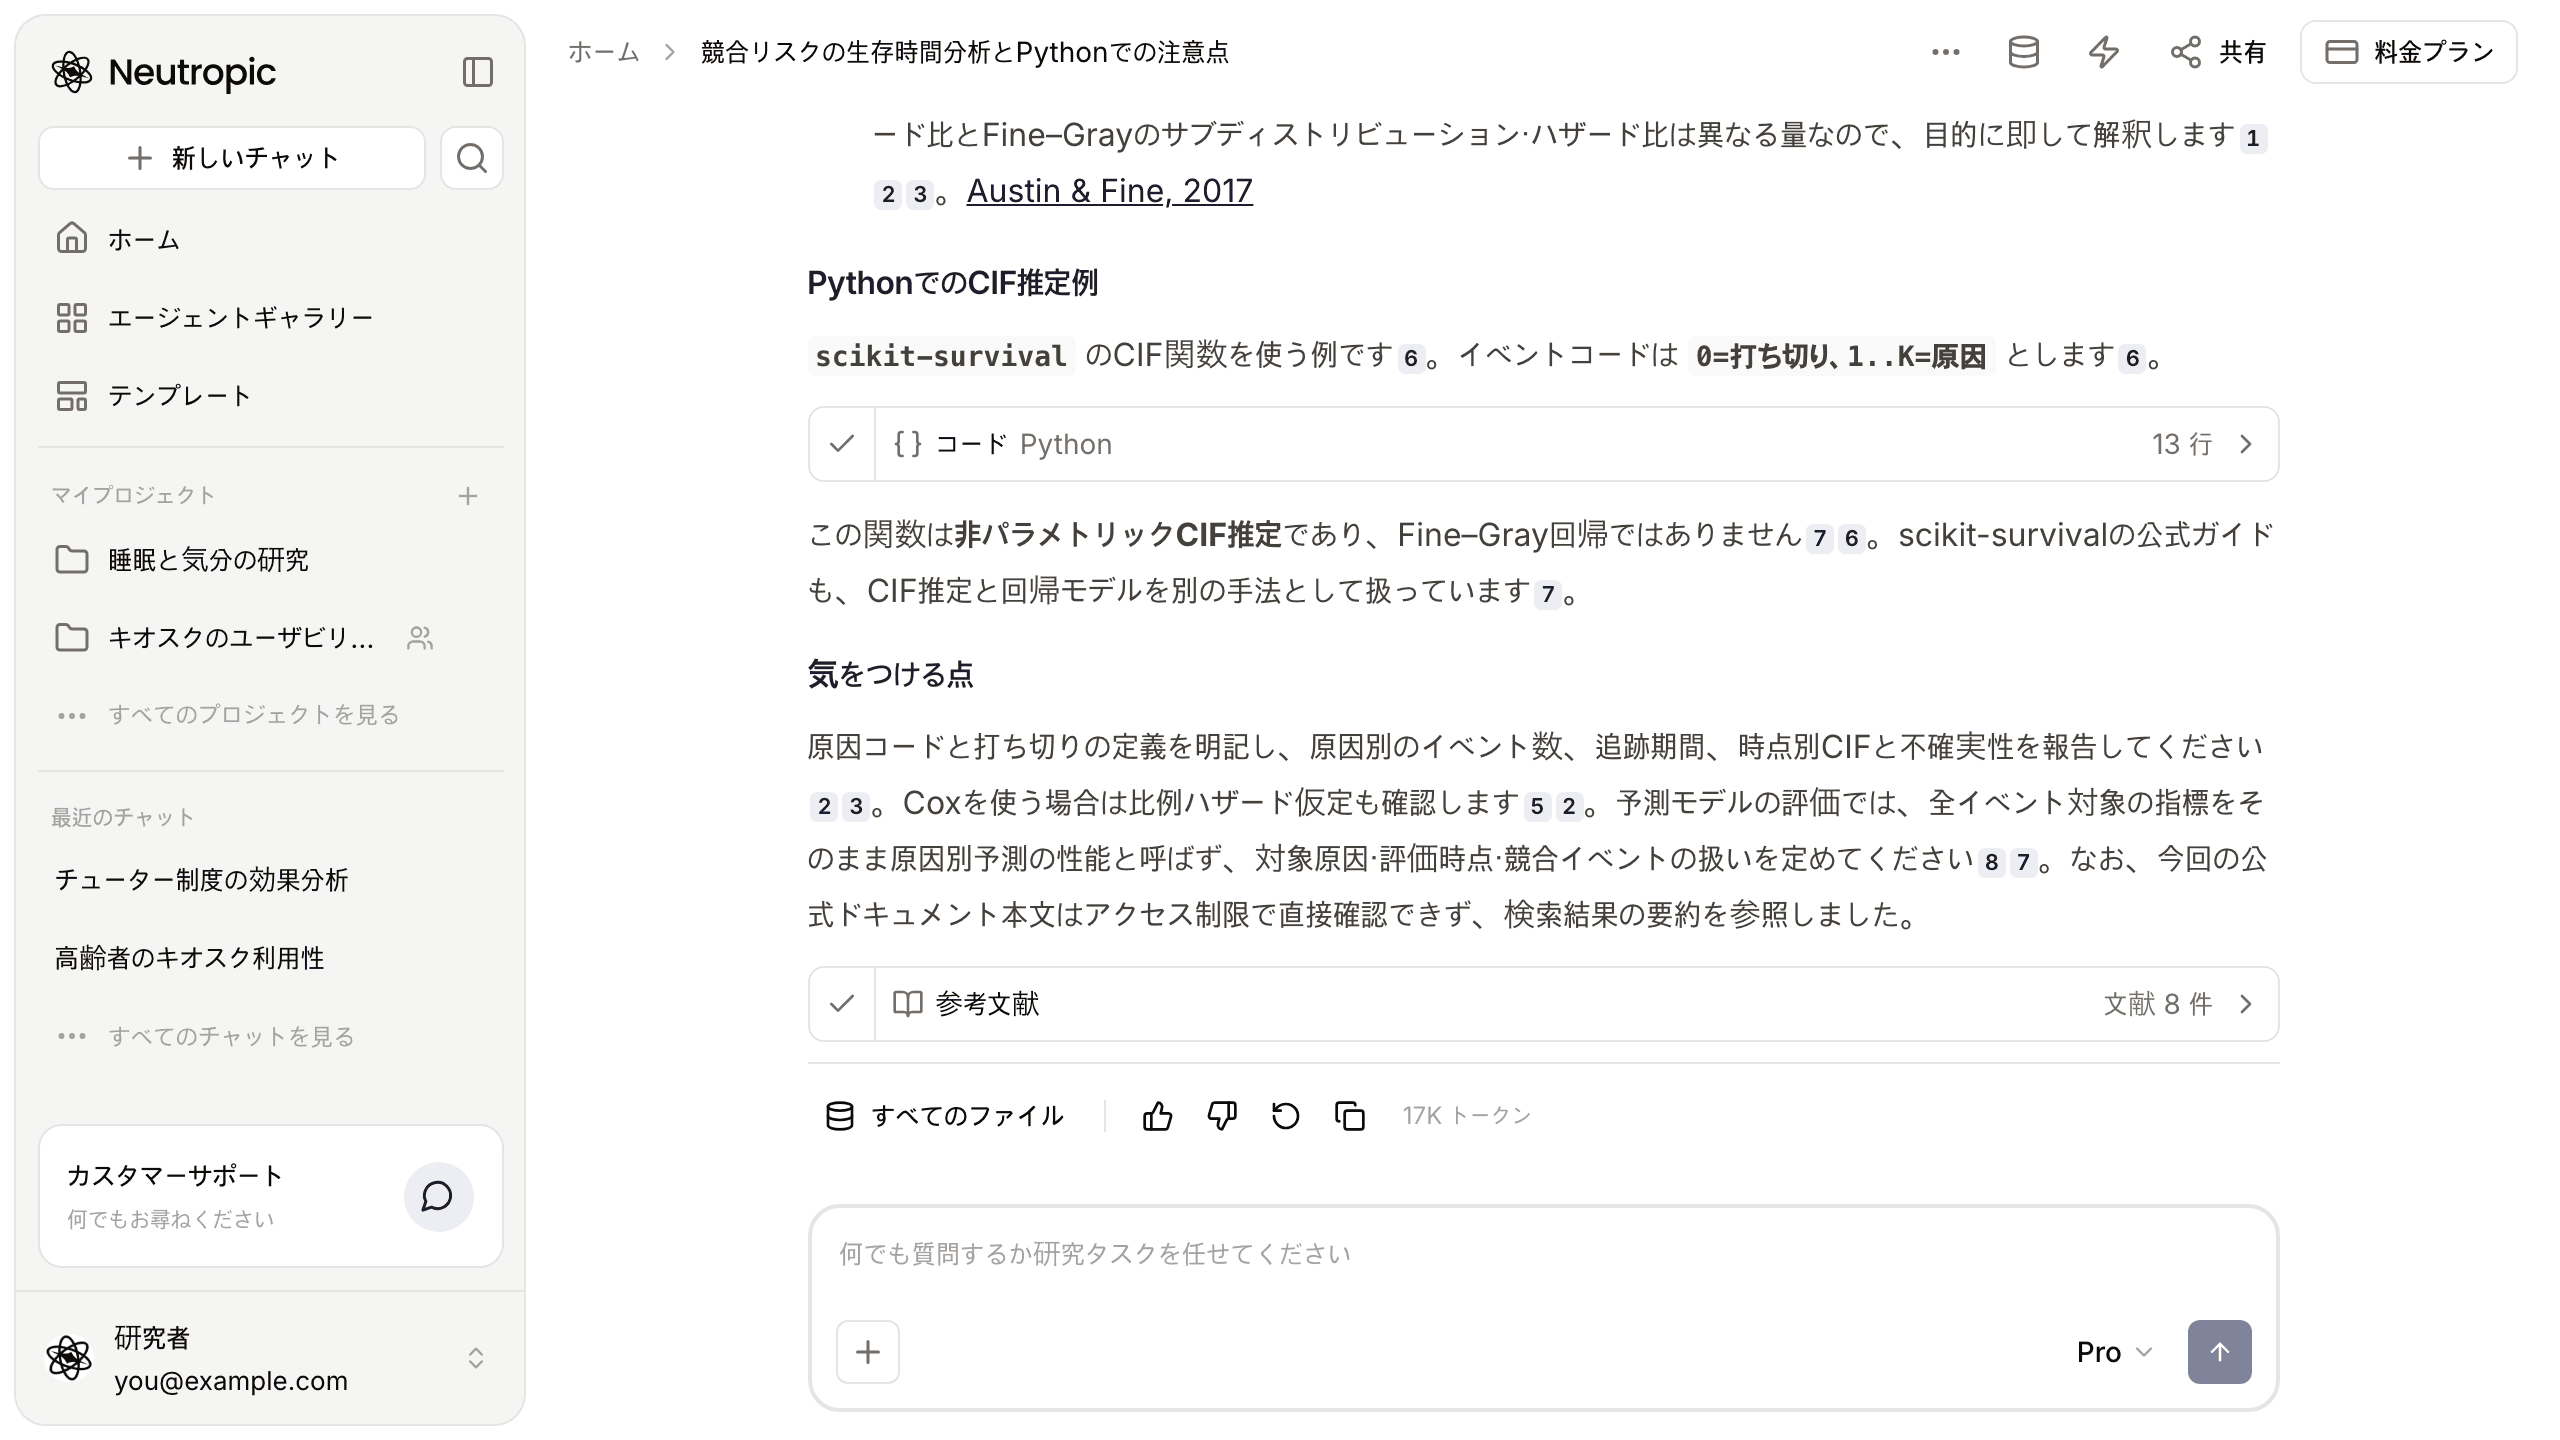
文末の小さな番号は出典です。参考文献 カードを開くと、8件が表で開きます。競合リスクの累積発生率と回帰分析を扱ったKim(2007)の論文、Fine–Grayモデルの報告に関する実践的な推奨、Gray検定に触れた解説ページ、scikit-survivalの関数ドキュメントなどです。
次にやることまで提案されました
回答のいちばん下には、続けてできることが2つありました。
- 教育・心理領域の競合リスク分析について、Gray検定、原因別Cox、Fine–Gray回帰の前提・解釈・Python実装を比較する文献レビューを作る — ナラティブレビュー エージェント
- Pythonで実データを分析できるよう、イベントコード・追跡時間・打ち切り定義・共変量を確認する入力チェックリストと、CIF推定から群間比較・回帰までのコード雛形を示してもらう
押すと同じチャットでそのまま続きます。データの整理から始めたい健太さんなら、2つ目を押すでしょう。
「打ち切りでいいの?」が「何を推定する?」になりました
| 始めたとき | 今 | |
|---|---|---|
| 問い | 編入した学生を打ち切りにしていい? | 確率(CIF)か、発生率(原因別Cox)か |
| 方法 | Kaplan–MeierとCoxだけ | CIF・原因別Cox・Fine–Grayの使い分け |
| コード | なし | scikit-survivalのCIF推定の雛形 |
| 注意点 | 1 − KMを中退率として報告 | 過大評価、群間比較の検定、イベント数の報告 |
| 出典 | 何から読むか分からない | 引用された8件と次の提案 |
もちろん、コードはまだ実データで回した結果ではありません。イベントのコード化、打ち切りの定義、原因ごとのイベント数は健太さん自身が確認する必要があり、Fine–Grayが必要なら、使うPythonパッケージが対応しているかをまず確かめます。それでも「何を推定するか」が決まれば、あとはその問いに合わせて選ぶだけです。
この記事は Pro で実行しました。Lite(無料プラン)はコードなしで推定対象を簡潔に説明し、Expert は例を実際に実行して、モデル診断や多状態モデルが適する場合まで扱います。
別のイベントが先に起きるなら、モデルを選ぶ前に「何を推定するか」を聞いてください。
今週、健太さんのように、問題の名前と道具だけ書いて聞いてみてください。Neutropicを無料で始める