こんにちは、Neutropicチームです!
授業の介入効果を確かめる実験を計画すると、たいていこの壁にぶつかります。学校では生徒を一人ずつ無作為に分けられません。時間割も教室も決まっているので、できるのは「この学級は新しい授業、あの学級は従来の授業」くらいです。それでも審査ではこう聞かれます。「で、サンプルサイズは何人ですか?」🥲
よくある誤りは、生徒を独立した個人として扱い、普通の2群の検出力分析をしてその数字を使うことです。同じ学級の生徒は先生も教室も雰囲気も共有しているので、結果が似てきます。そのため8学級200人は、一人ずつ無作為に割り付けた200人よりずっと情報が少なくなります。
この記事では、教育学の修士課程の 結衣さん が、学級単位の実験のサンプルサイズを初めて決める流れを追います。結衣さんは架空の人物ですが、以下の画面はすべてNeutropicで実際に実行したチャットです。
数字は入れず、大事な事実をひとつだけ書きました
結衣さんは、効果量も学級の人数もまだ決めていませんでした。そこで、分かっていることだけを送りました。
2群を比較する実験ですが、学級単位で割り付けます。サンプルサイズはどう計算すればいいですか?
短くても良い質問です。「学級単位で割り付ける」という一言が、計算方法をまるごと変える事実だからです。これがなければ、普通の2群の計算が返ってきたでしょう。入力値がなくても、Neutropicは仮定を明示した例で計算してくれるので、最初から数字をそろえる必要はありません。
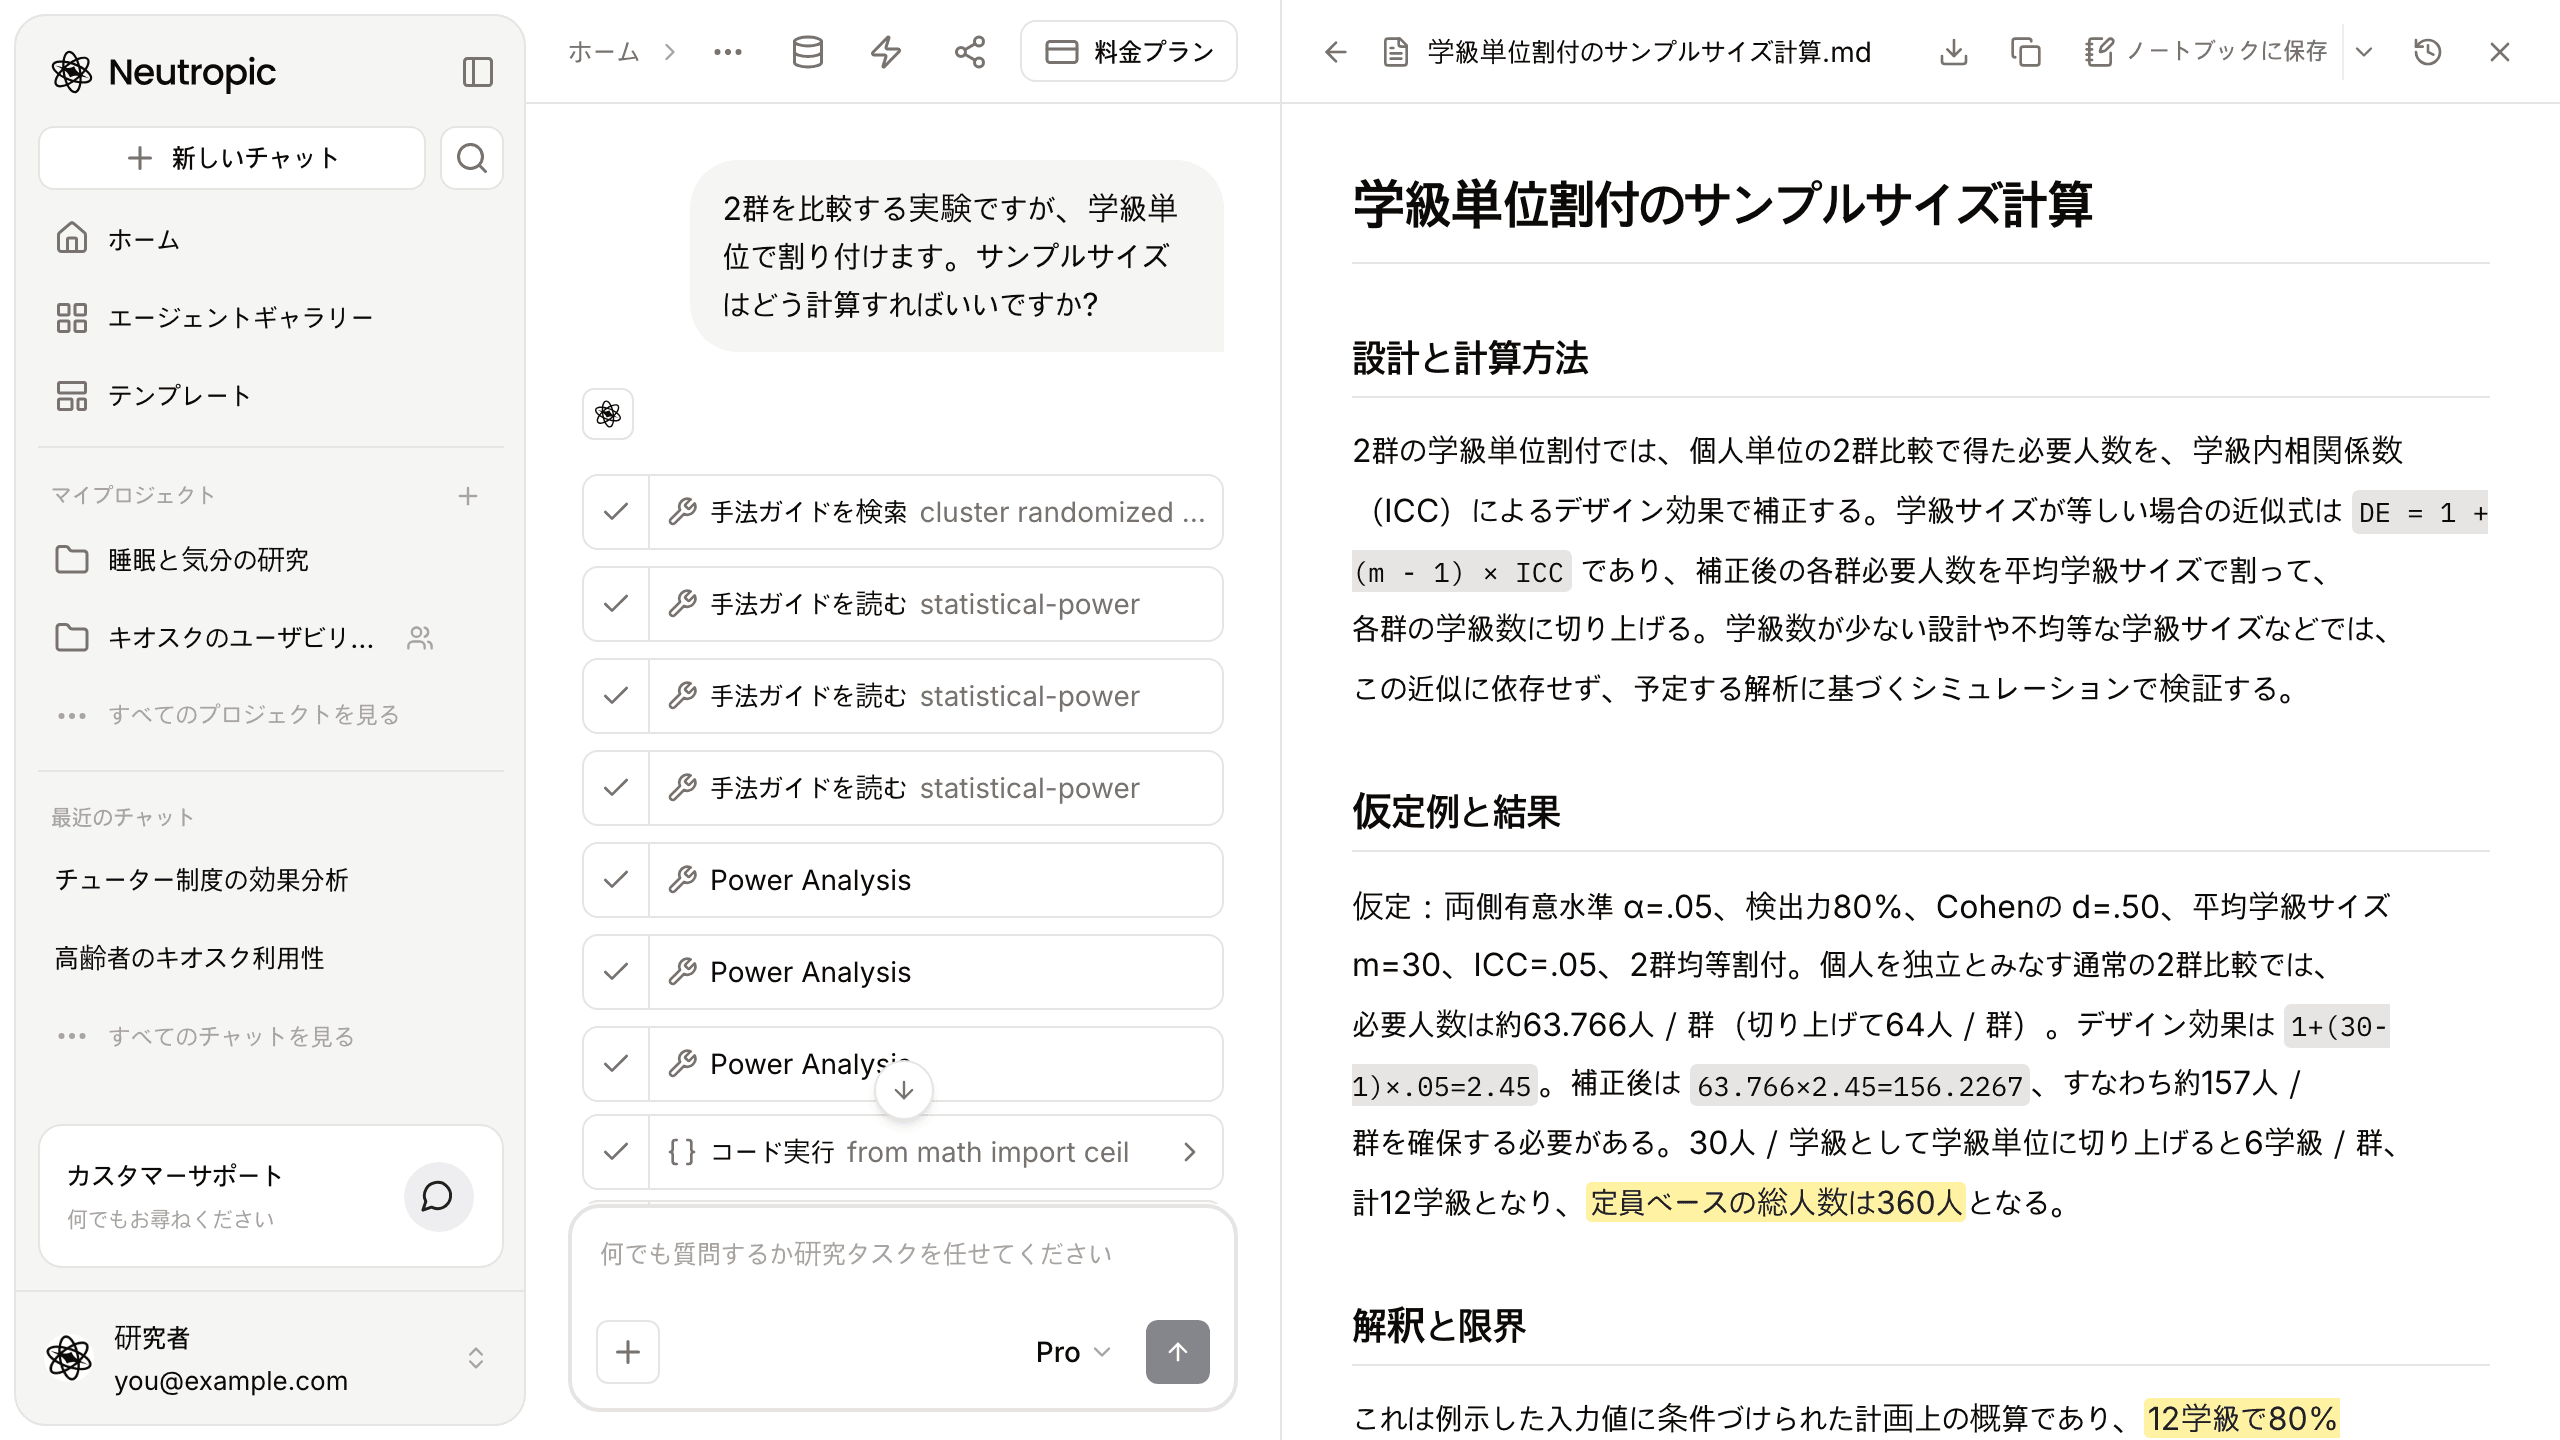
答える前に検出力のガイドを読みました
送るとすぐに、ステップが積み上がりました。手法ガイドを検索 でクラスター無作為化試験のサンプルサイズに合うガイドを探し、手法ガイドを読む で検出力(statistical-power)のガイドを読みました。続いて Power Analysis のステップで個人単位の必要人数を求め、コード実行 で補正の計算を回しています。
手法ガイドは、Neutropicがあらかじめ確認しておいた分析手順の文書です。記憶に頼ってすぐ答えるのではなく、検証済みの手順を先に読んで、その順番に従います。ステップを開けば、何を読み、どんなコードを実行したかをそのまま確認できます。
各群64人が、計12学級になりました
回答の骨組みは3段階でした。まず個人単位の2群比較で必要な人数を出します。次にデザイン効果 DE = 1 + (m − 1) × ICC を掛けます。m は平均学級サイズ、ICC は同じ学級の生徒どうしがどれだけ似ているかを表す級内相関です。最後に、補正後の人数を学級サイズで割って学級数に切り上げます。
結衣さんは数字を出していないので、回答は説明用の仮定を明記して計算しました。両側有意水準 .05、検出力80%、Cohen の d = .50、平均30人/学級、ICC = .05 です。
個人単位では約63.766人/群、切り上げて 64人/群。デザイン効果は 1 + (30 − 1) × .05 = 2.45、補正後は 63.766 × 2.45 = 約156.2人/群 です。30人学級として切り上げると 各群6学級、計12学級、定員どおりなら計360人になります。
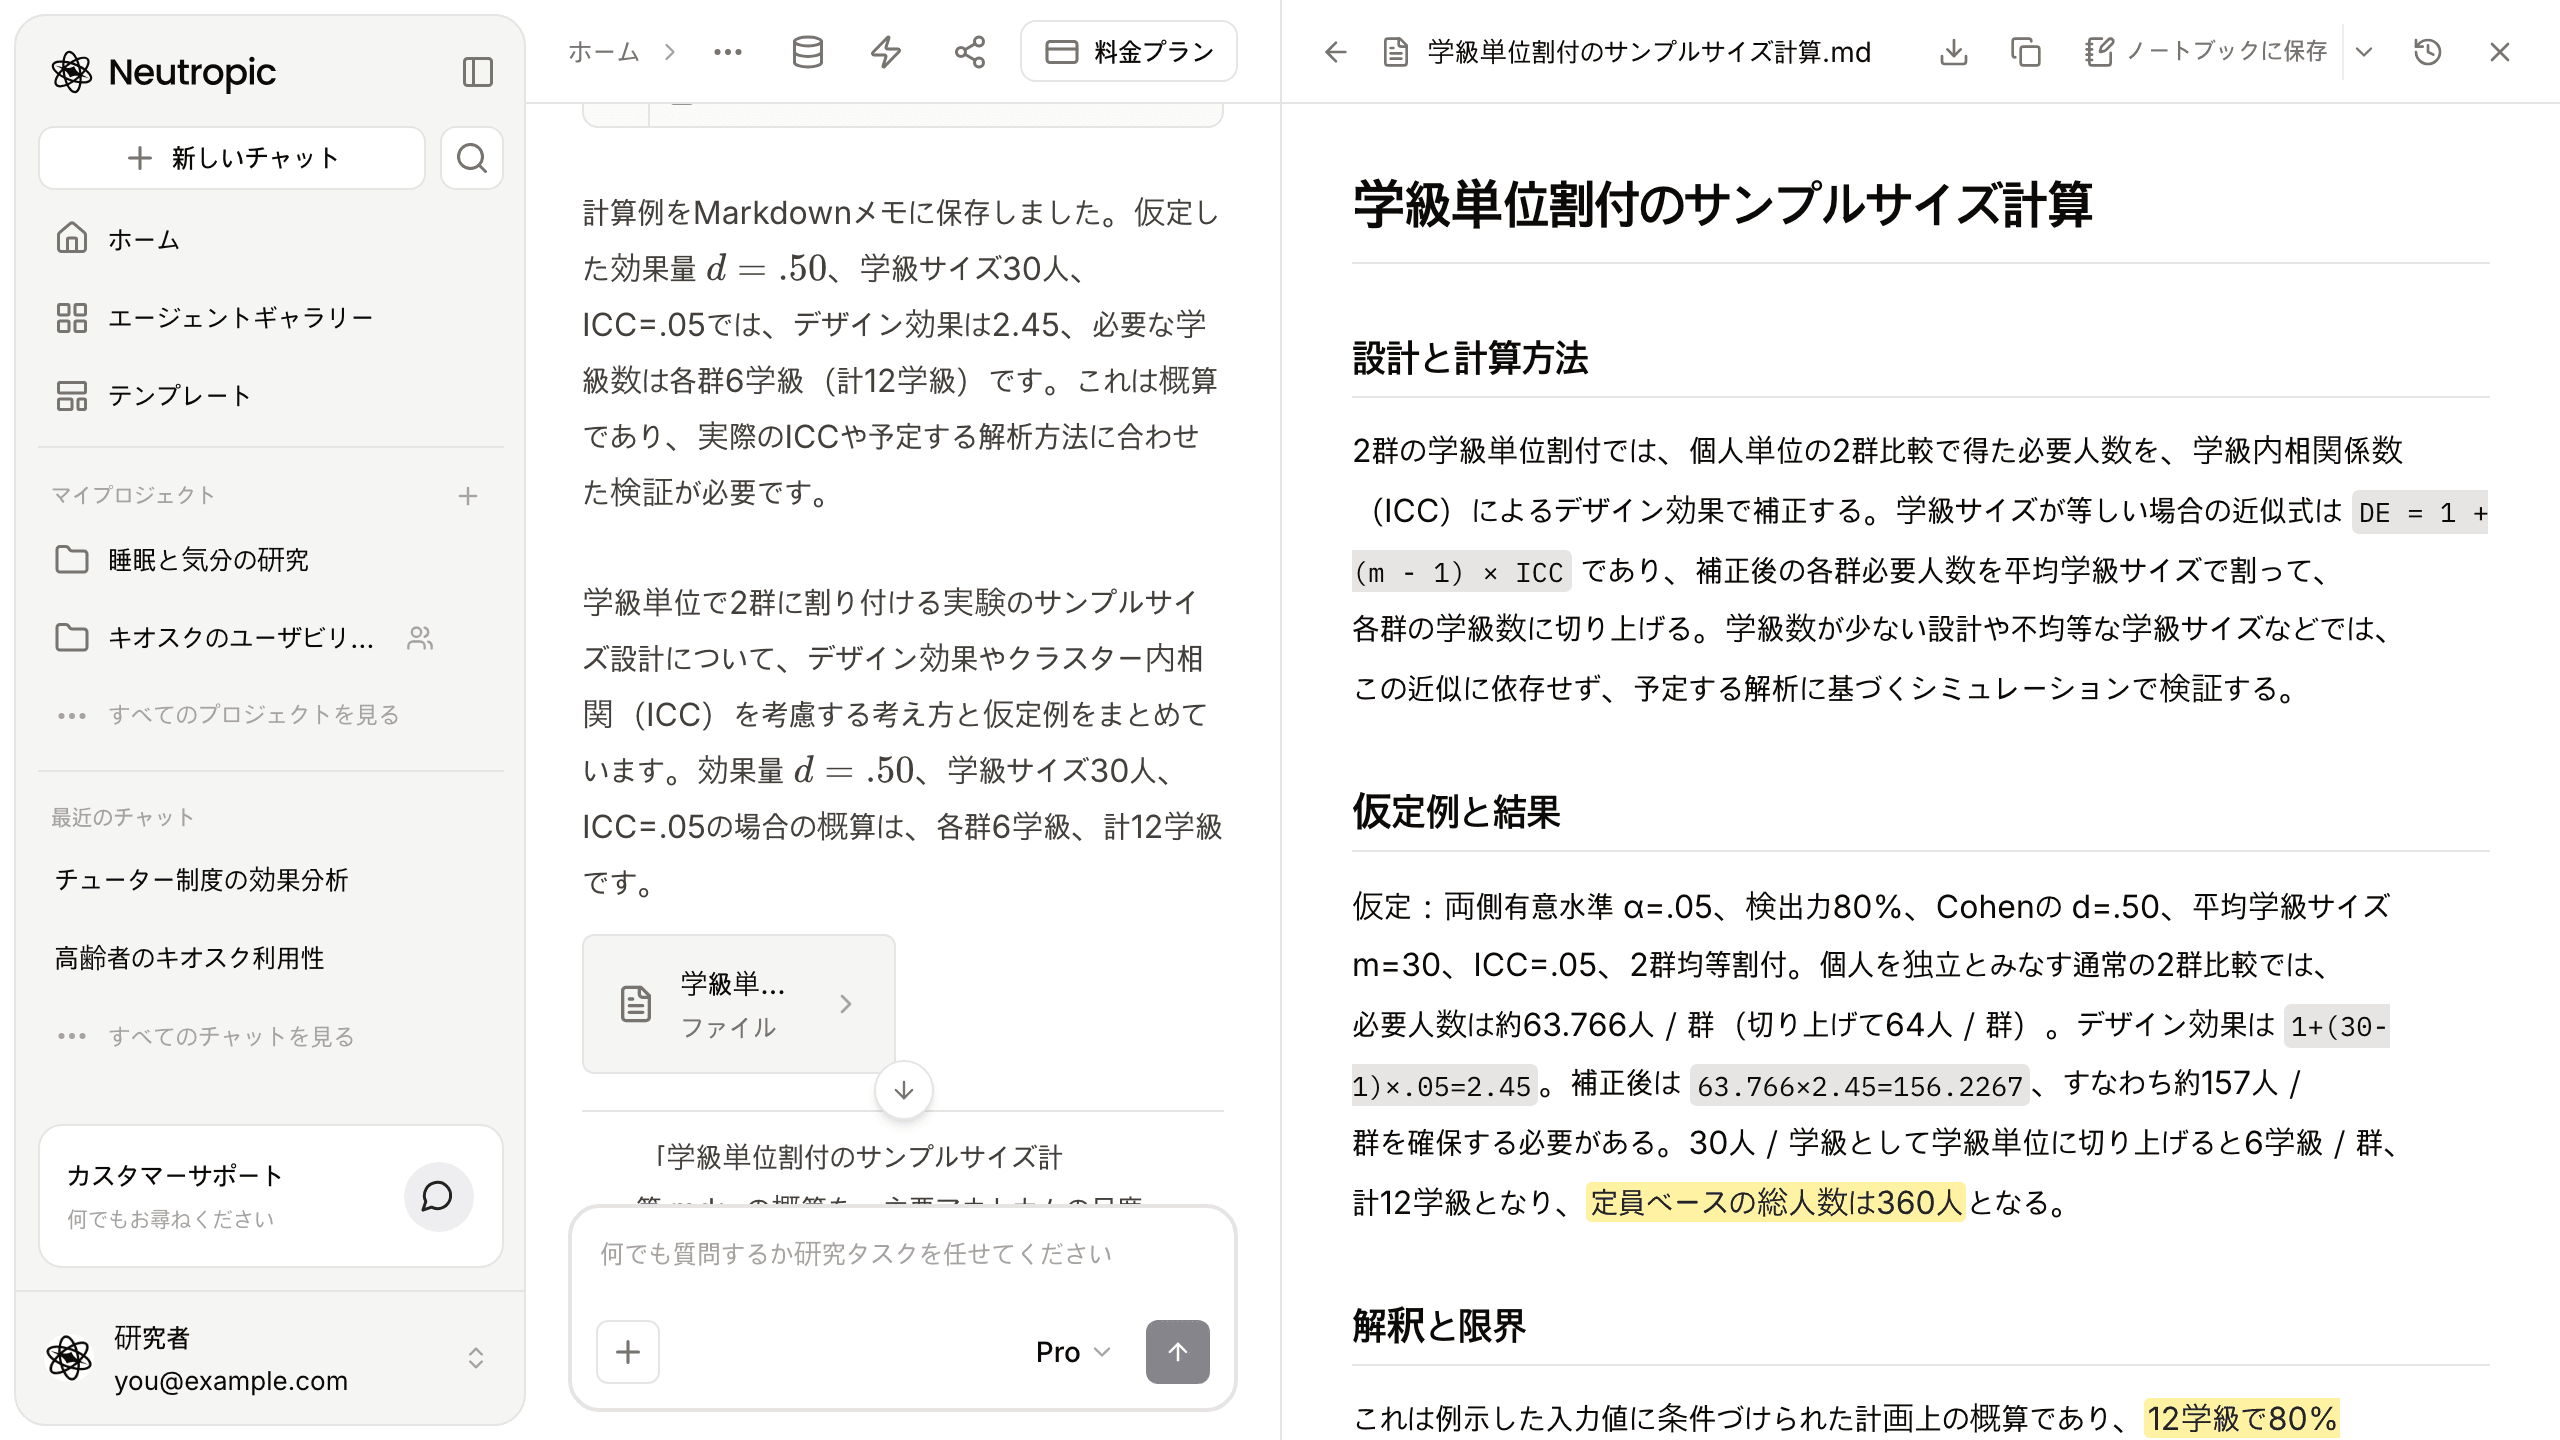
計算例は「学級単位割付のサンプルサイズ計算.md」というMarkdownメモにも保存されました。メモには補正計算を再現するPythonのコードと、その出力「2.45 156.2267 6 12」が載っています。私たちもそのコードを実行して、同じ出力になることを確かめました。😎
「12学級で大丈夫」と書きそうになりました
ここで結衣さんは危うく間違えるところでした。「各群6学級、計12学級」は、そのまま計画書に書けそうに見えます。でも、回答もメモもはっきり注意しています。
- これは仮定した入力値に基づく概算で、12学級で80%の検出力が実際に達成される保証ではありません。
- この補正は学級サイズがほぼ等しい場合の近似です。学級数が少ない、学級サイズにばらつきがある、といった場合は 予定する分析(混合効果モデルなど)に合わせたシミュレーション で確認します。
- ICCや学級サイズが不確かなら、複数の妥当な値で感度分析 をします。各群の学級数が少ないと、生徒数を増やすだけでは補えません。
結衣さんは「12学級」と言い切る代わりに、「概算であり、先行研究のICCの範囲とシミュレーションで確認する」と書くことにしました。
次にやることまで提案されました
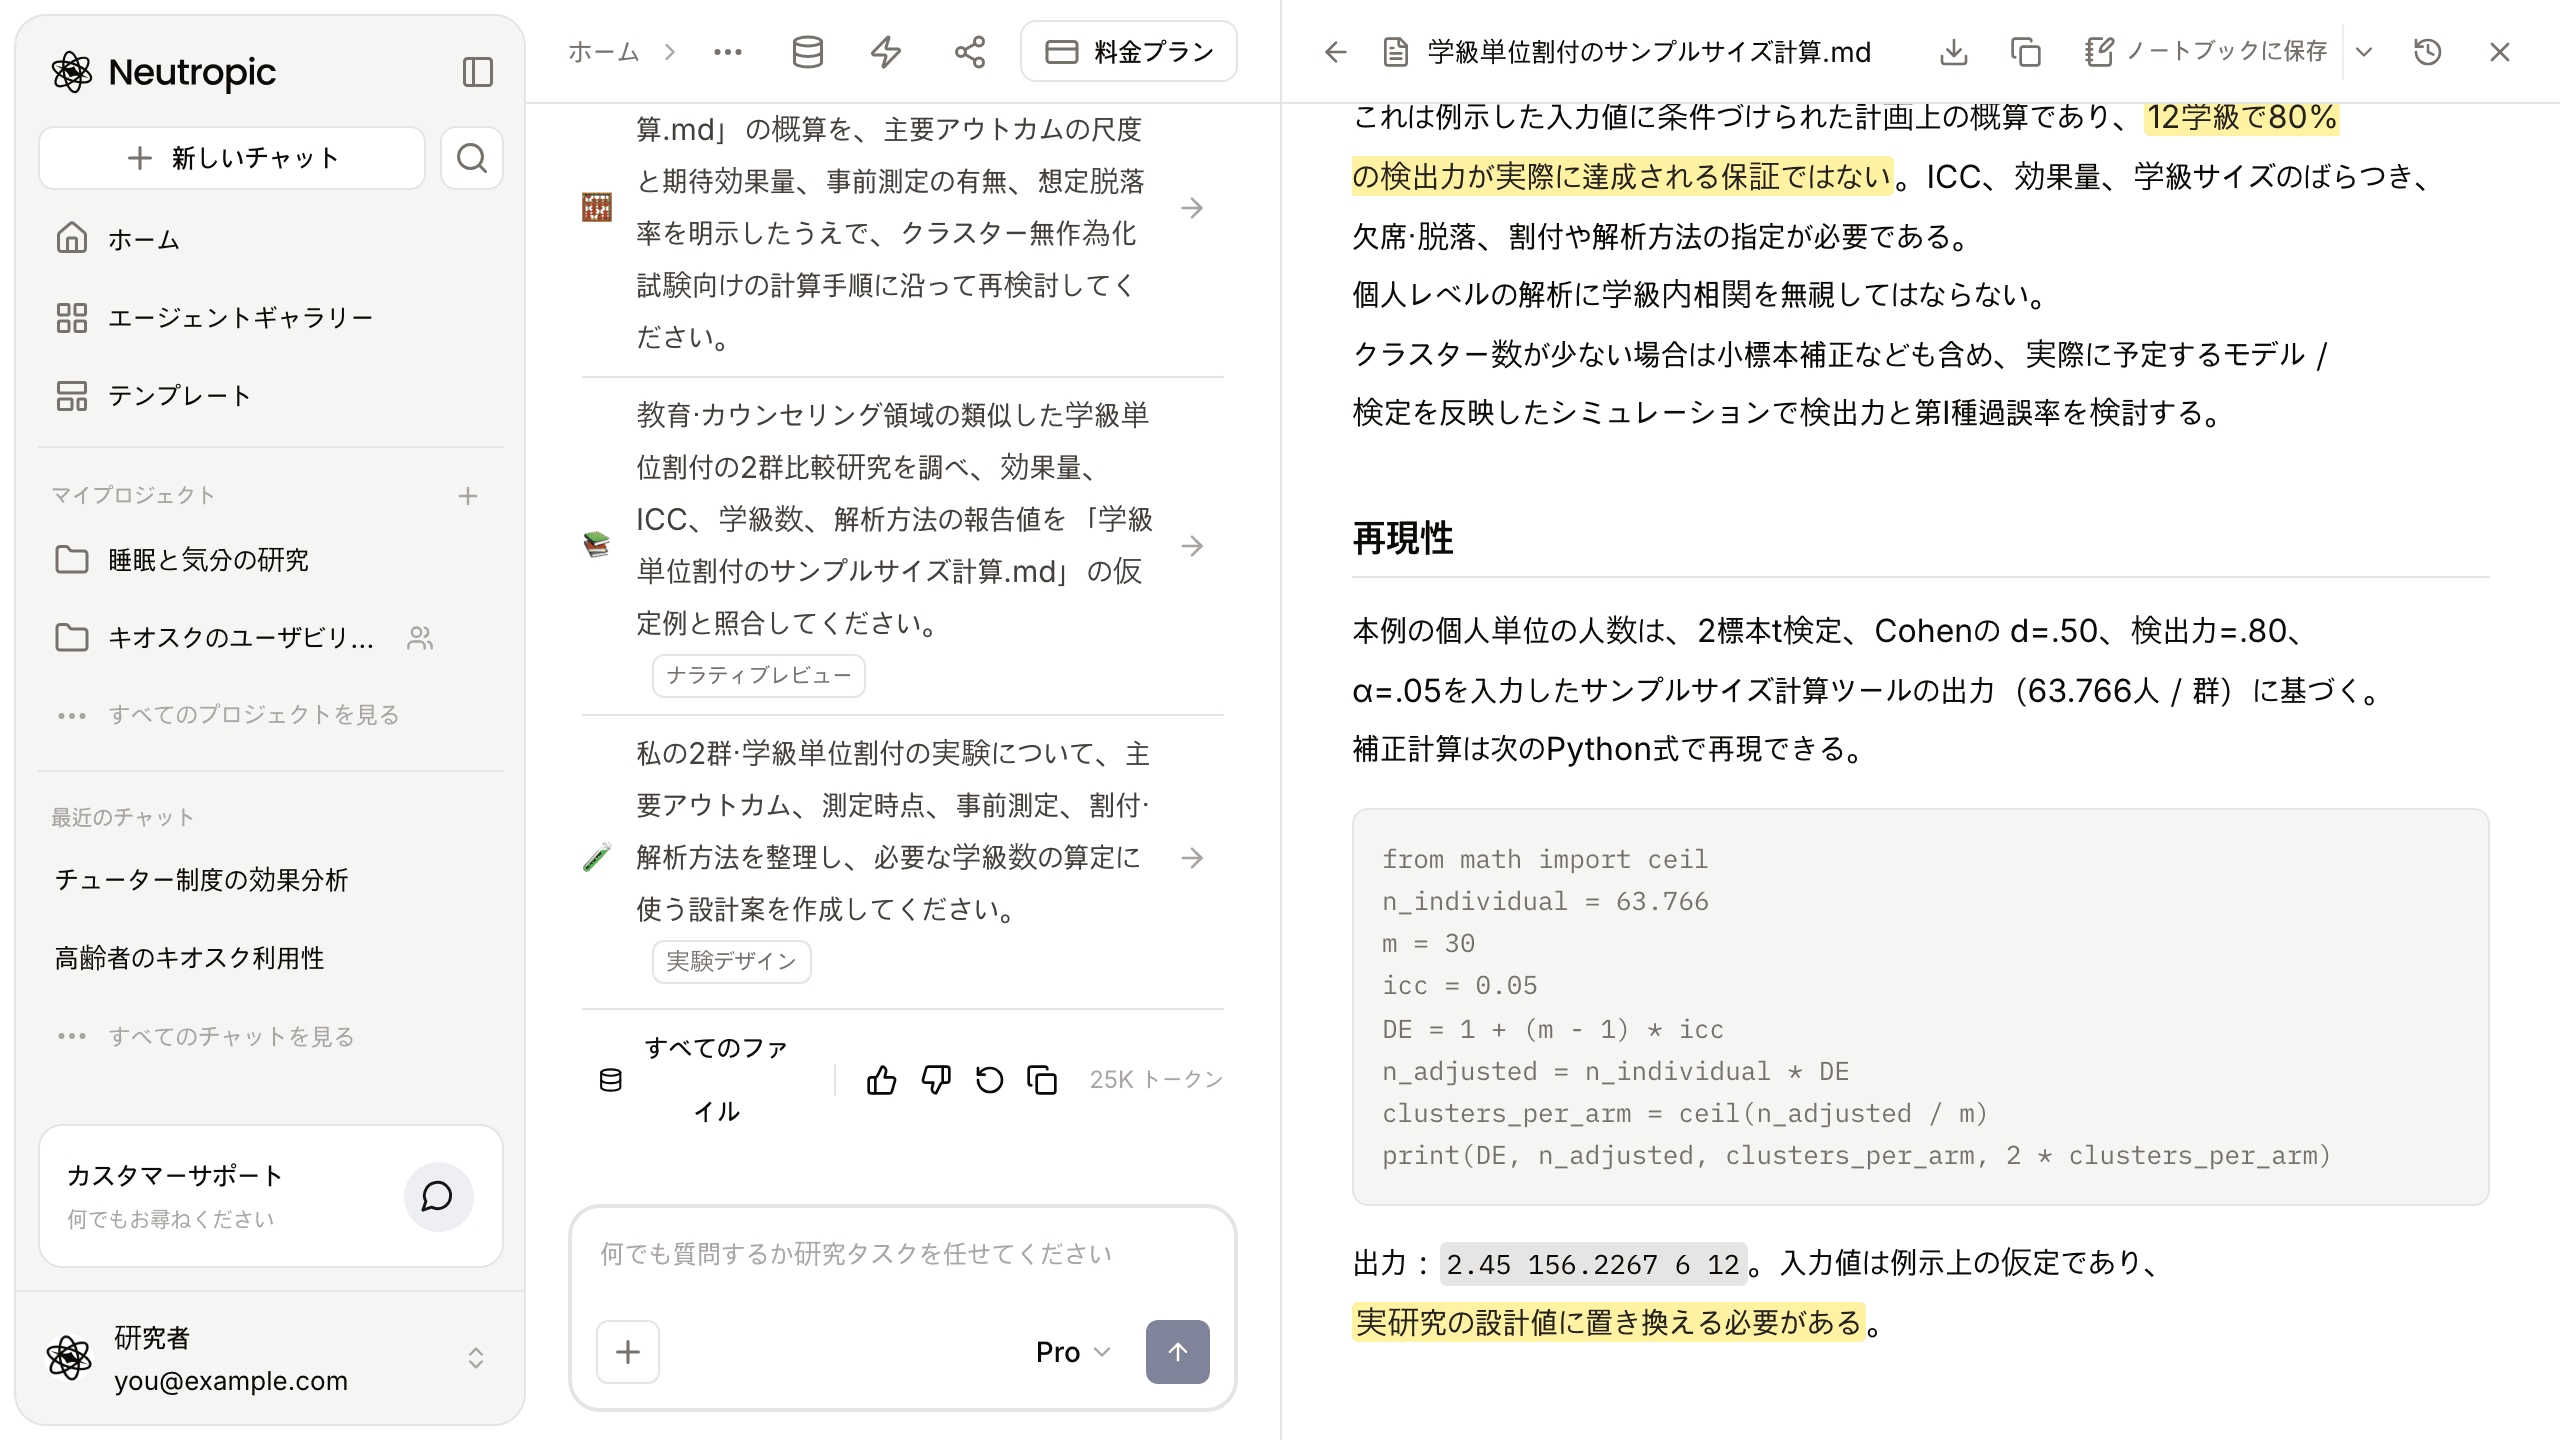
回答のいちばん下には、続けてできることが3つ提案されていました。
- メモの概算を、主要アウトカムの尺度と期待効果量、事前測定の有無、想定脱落率を明示したうえで、クラスター無作為化試験向けの計算手順に沿って再検討する
- 教育・カウンセリング領域の類似研究を調べ、効果量、ICC、学級数、解析方法の報告値をメモの仮定例と照合する — ナラティブレビュー エージェント
- 主要アウトカム、測定時点、事前測定、割付・解析方法を整理し、必要な学級数の算定に使う設計案を作る — 実験デザイン エージェント
押すと同じチャットでそのまま続きます。実験デザイン エージェントは エージェントギャラリー から単独でも実行でき、学級数で自由度を数えて検出力を計算し、各群に最低4学級以上を確保して、サンプルサイズの根拠をデザイン報告書に書きます。
漠然とした「何人?」が、根拠のある「何学級?」になりました
| 始めたとき | 今 | |
|---|---|---|
| 問い | 「生徒は何人必要?」 | 「何学級必要で、根拠は何か」 |
| 計算方法 | 普通の2群の検出力分析 | 個人単位の人数 × デザイン効果 → 学級数に切り上げ |
| 計算例 | なし | 64人/群 → DE 2.45 → 各群6学級(計12学級) |
| 記録 | なし | 再現コード付きのMarkdownメモ |
| 注意点 | 知らなかった | 学級数が少ないと近似は楽観的、シミュレーションで確認 |
もちろん、これは仮定値による計算例です。実際の計画には、類似研究や予備データのICC、実際の学級サイズとそのばらつき、想定脱落率が必要です。それでも、問いが「何人」から「何学級」に変わっただけで、計画書の半分は整理できます。
この記事は Pro で実行しました。Lite(無料プラン)は公式と必要な入力値を示し、Expert はさらにICCのシナリオ比較と、クラスターが少ない場合の補正を加えます。
学級単位で割り付けるなら、その一言を必ず質問に入れてください。計算が最初から変わります。
今週、結衣さんのように、分かっていることを一行で聞いてみてください。Neutropicを無料で始める