こんにちは、Neutropicチームです!
参加者ごとに条件を変えて何度も測ったデータを前に、指導教員から「それは階層モデルだね。ベイズでPyMCを使ってみたら」と言われたとしましょう。反復測定の分散分析まではやったことがあっても、階層モデルは初めて、ベイズはもっと初めて。サンプルのノートブックを開くと、事前分布、チェーン、発散といった見慣れない言葉が一気に押し寄せてきます。🥲
実はモデルそのものは意外と短いんです。難しいのはその後。チェーンがきちんと混ざったか、モデルがデータを再現できるかを確かめずに数値を読むと、もっともらしい誤答になります。
この記事では、心理学の博士課程 健太さん が、反復測定データにPyMCの階層モデルを初めて立てる流れを追います。健太さんは架空の人物ですが、以下の画面はすべてNeutropicで実際に実行したチャットです。
質問は一行だけでした
健太さんは、データを上げる前に全体像をつかみたいと思っていました。そこで、こう聞きました。
反復測定データにPyMCでベイズ階層モデルを立てて確認するにはどうすればいいですか?
短くても必要なものは入っています。道具(PyMC)、データの構造(反復測定)、そして動詞が二つ。「立てて」だけならモデルのコードで終わったはずですが、「確認するには」を加えたことで、回答が確認手順まで伸びました。
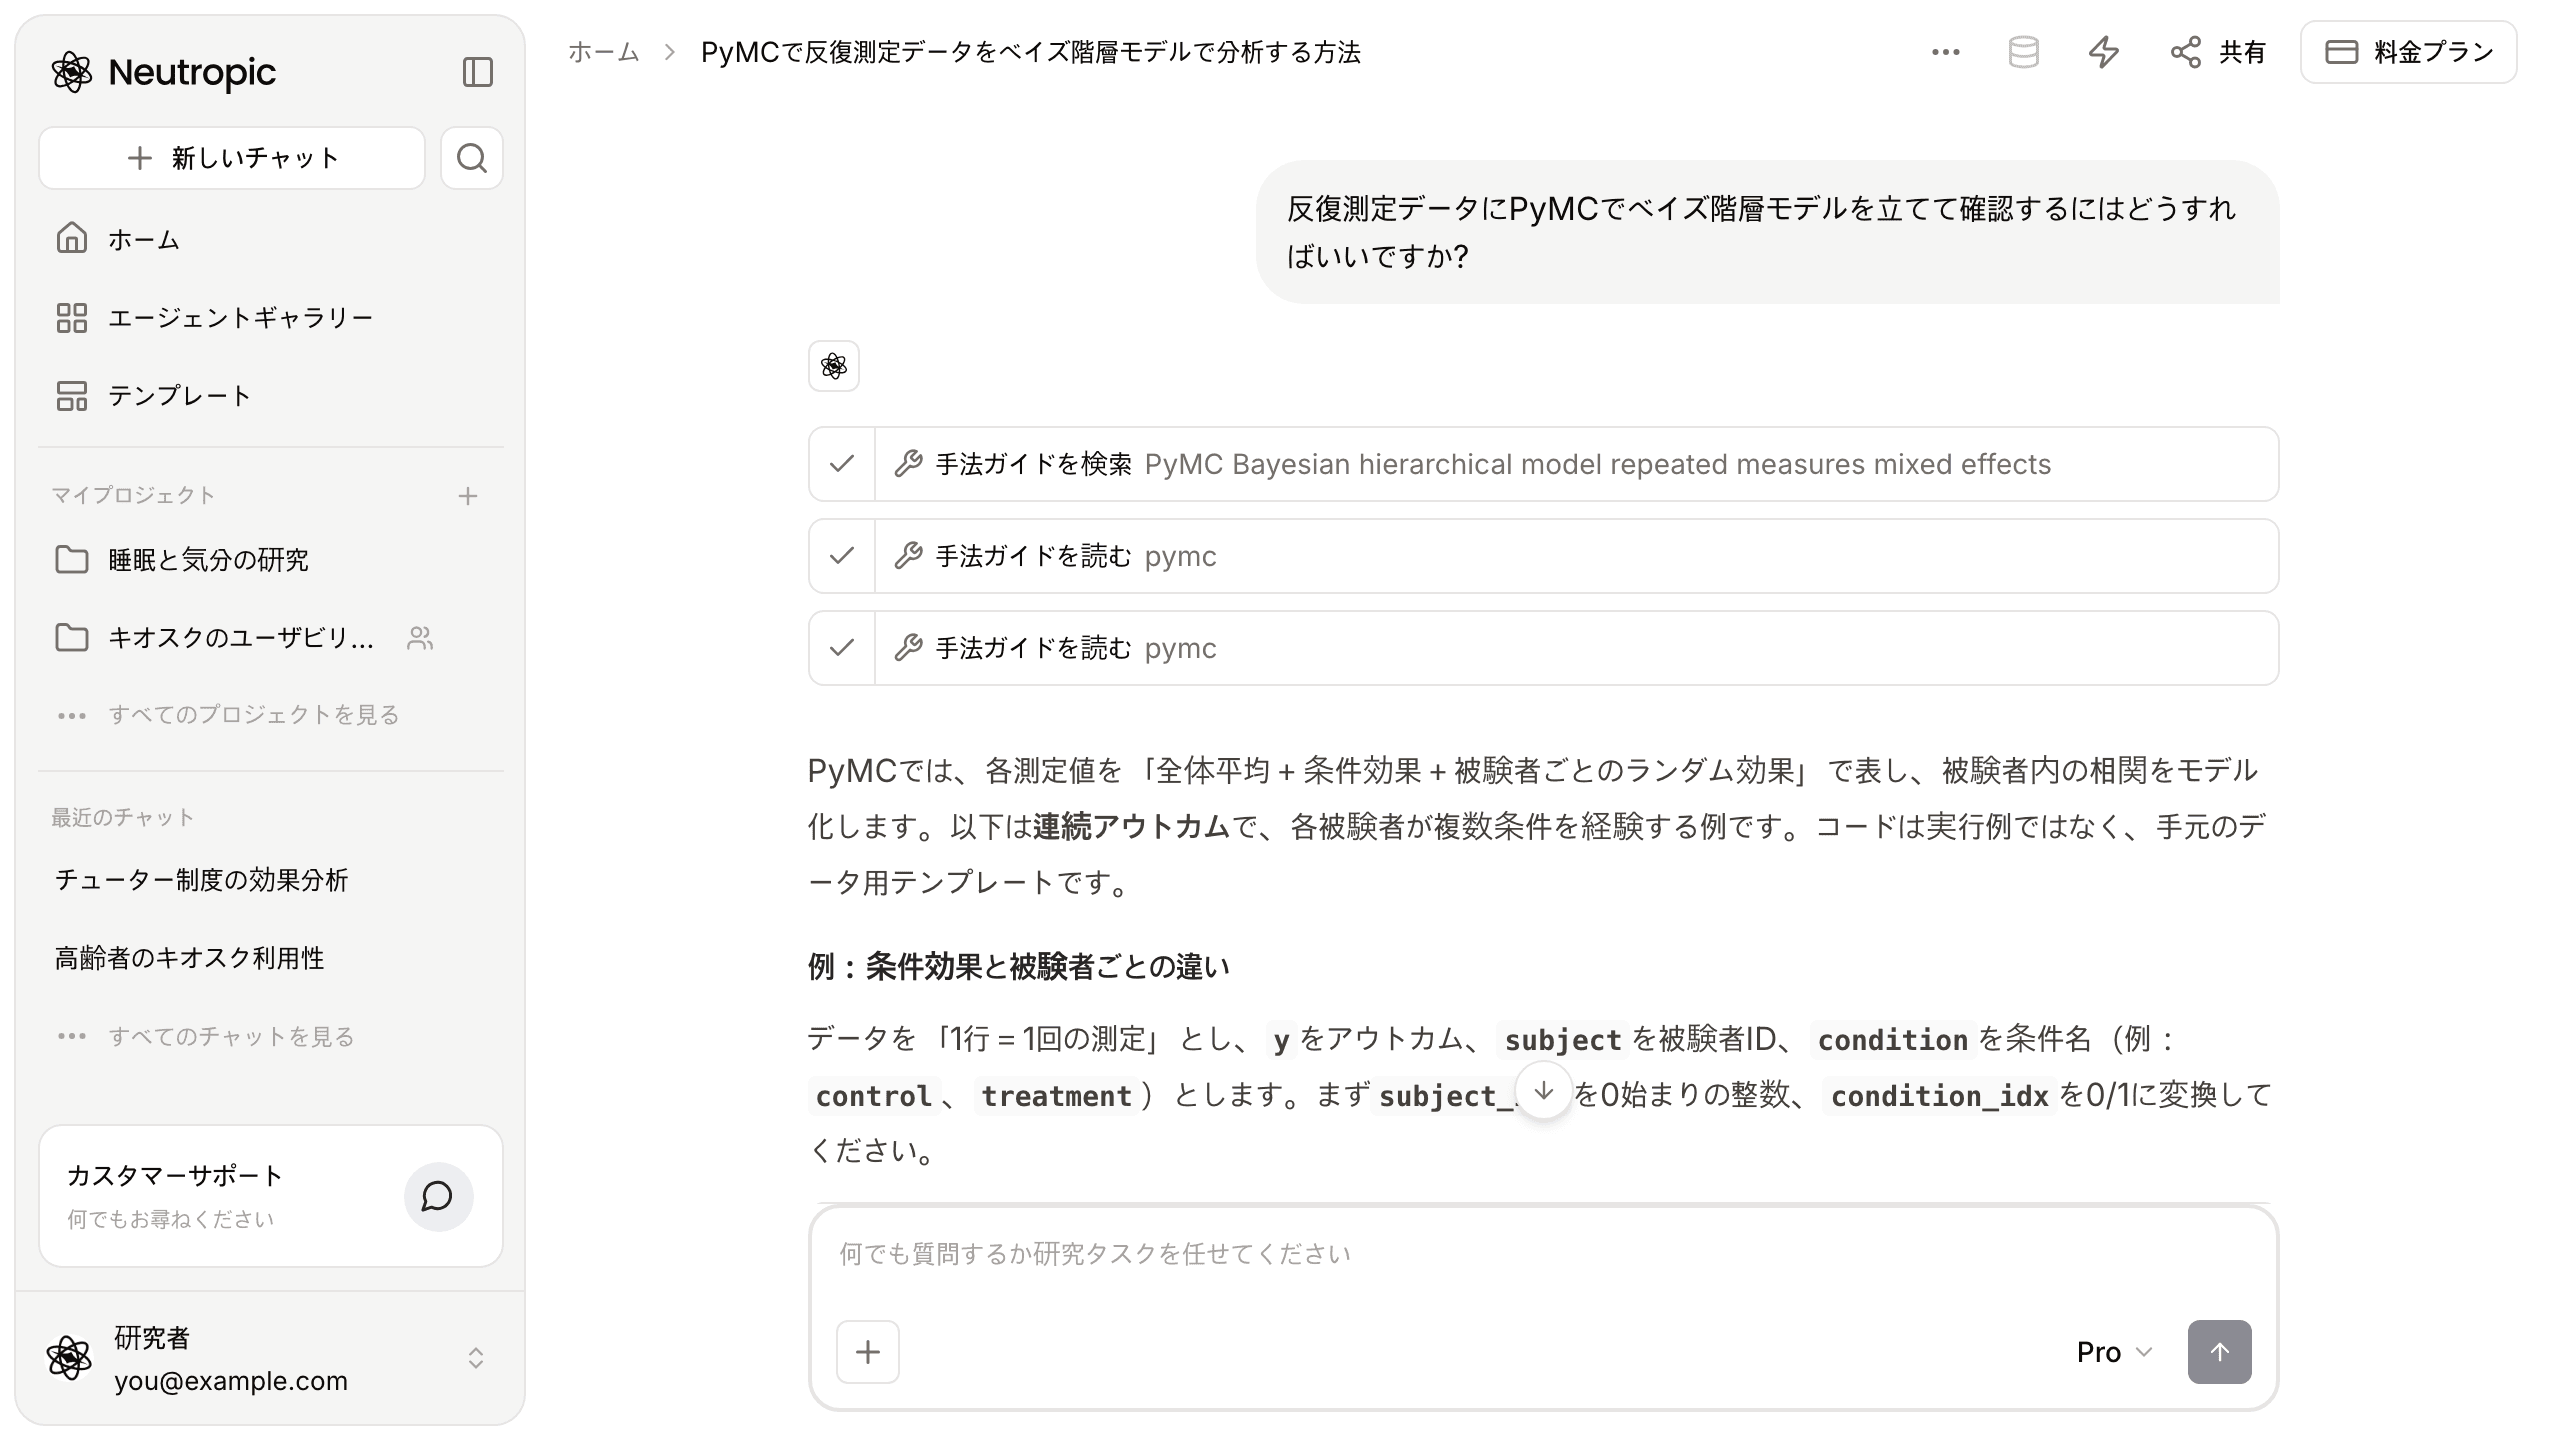
答える前にPyMCの手法ガイドを読みました
送るとすぐにステップが積み上がりました。手法ガイドを検索 で階層モデルに合うガイドを探し、手法ガイドを読む でPyMCのガイドを二度読みました。このチャットにはコード実行のステップはなく、サンプリングは行われていません。
手法ガイドは、Neutropicがあらかじめ確認しておいた分析手順の文書です。モデルが記憶に頼ってすぐ答えるのではなく、確認済みの手順を先に読んで、その順番に従うようにしています。
被験者ごとのランダム切片を入れたモデルが出てきました
回答はまず考え方を示しました。各測定値を「全体平均+条件効果+被験者ごとのランダム効果」で表し、被験者内の相関をモデル化する、というものです。そして冒頭にはっきり書いてありました。コードは実行例ではなく、手元のデータ用のテンプレートです、と。
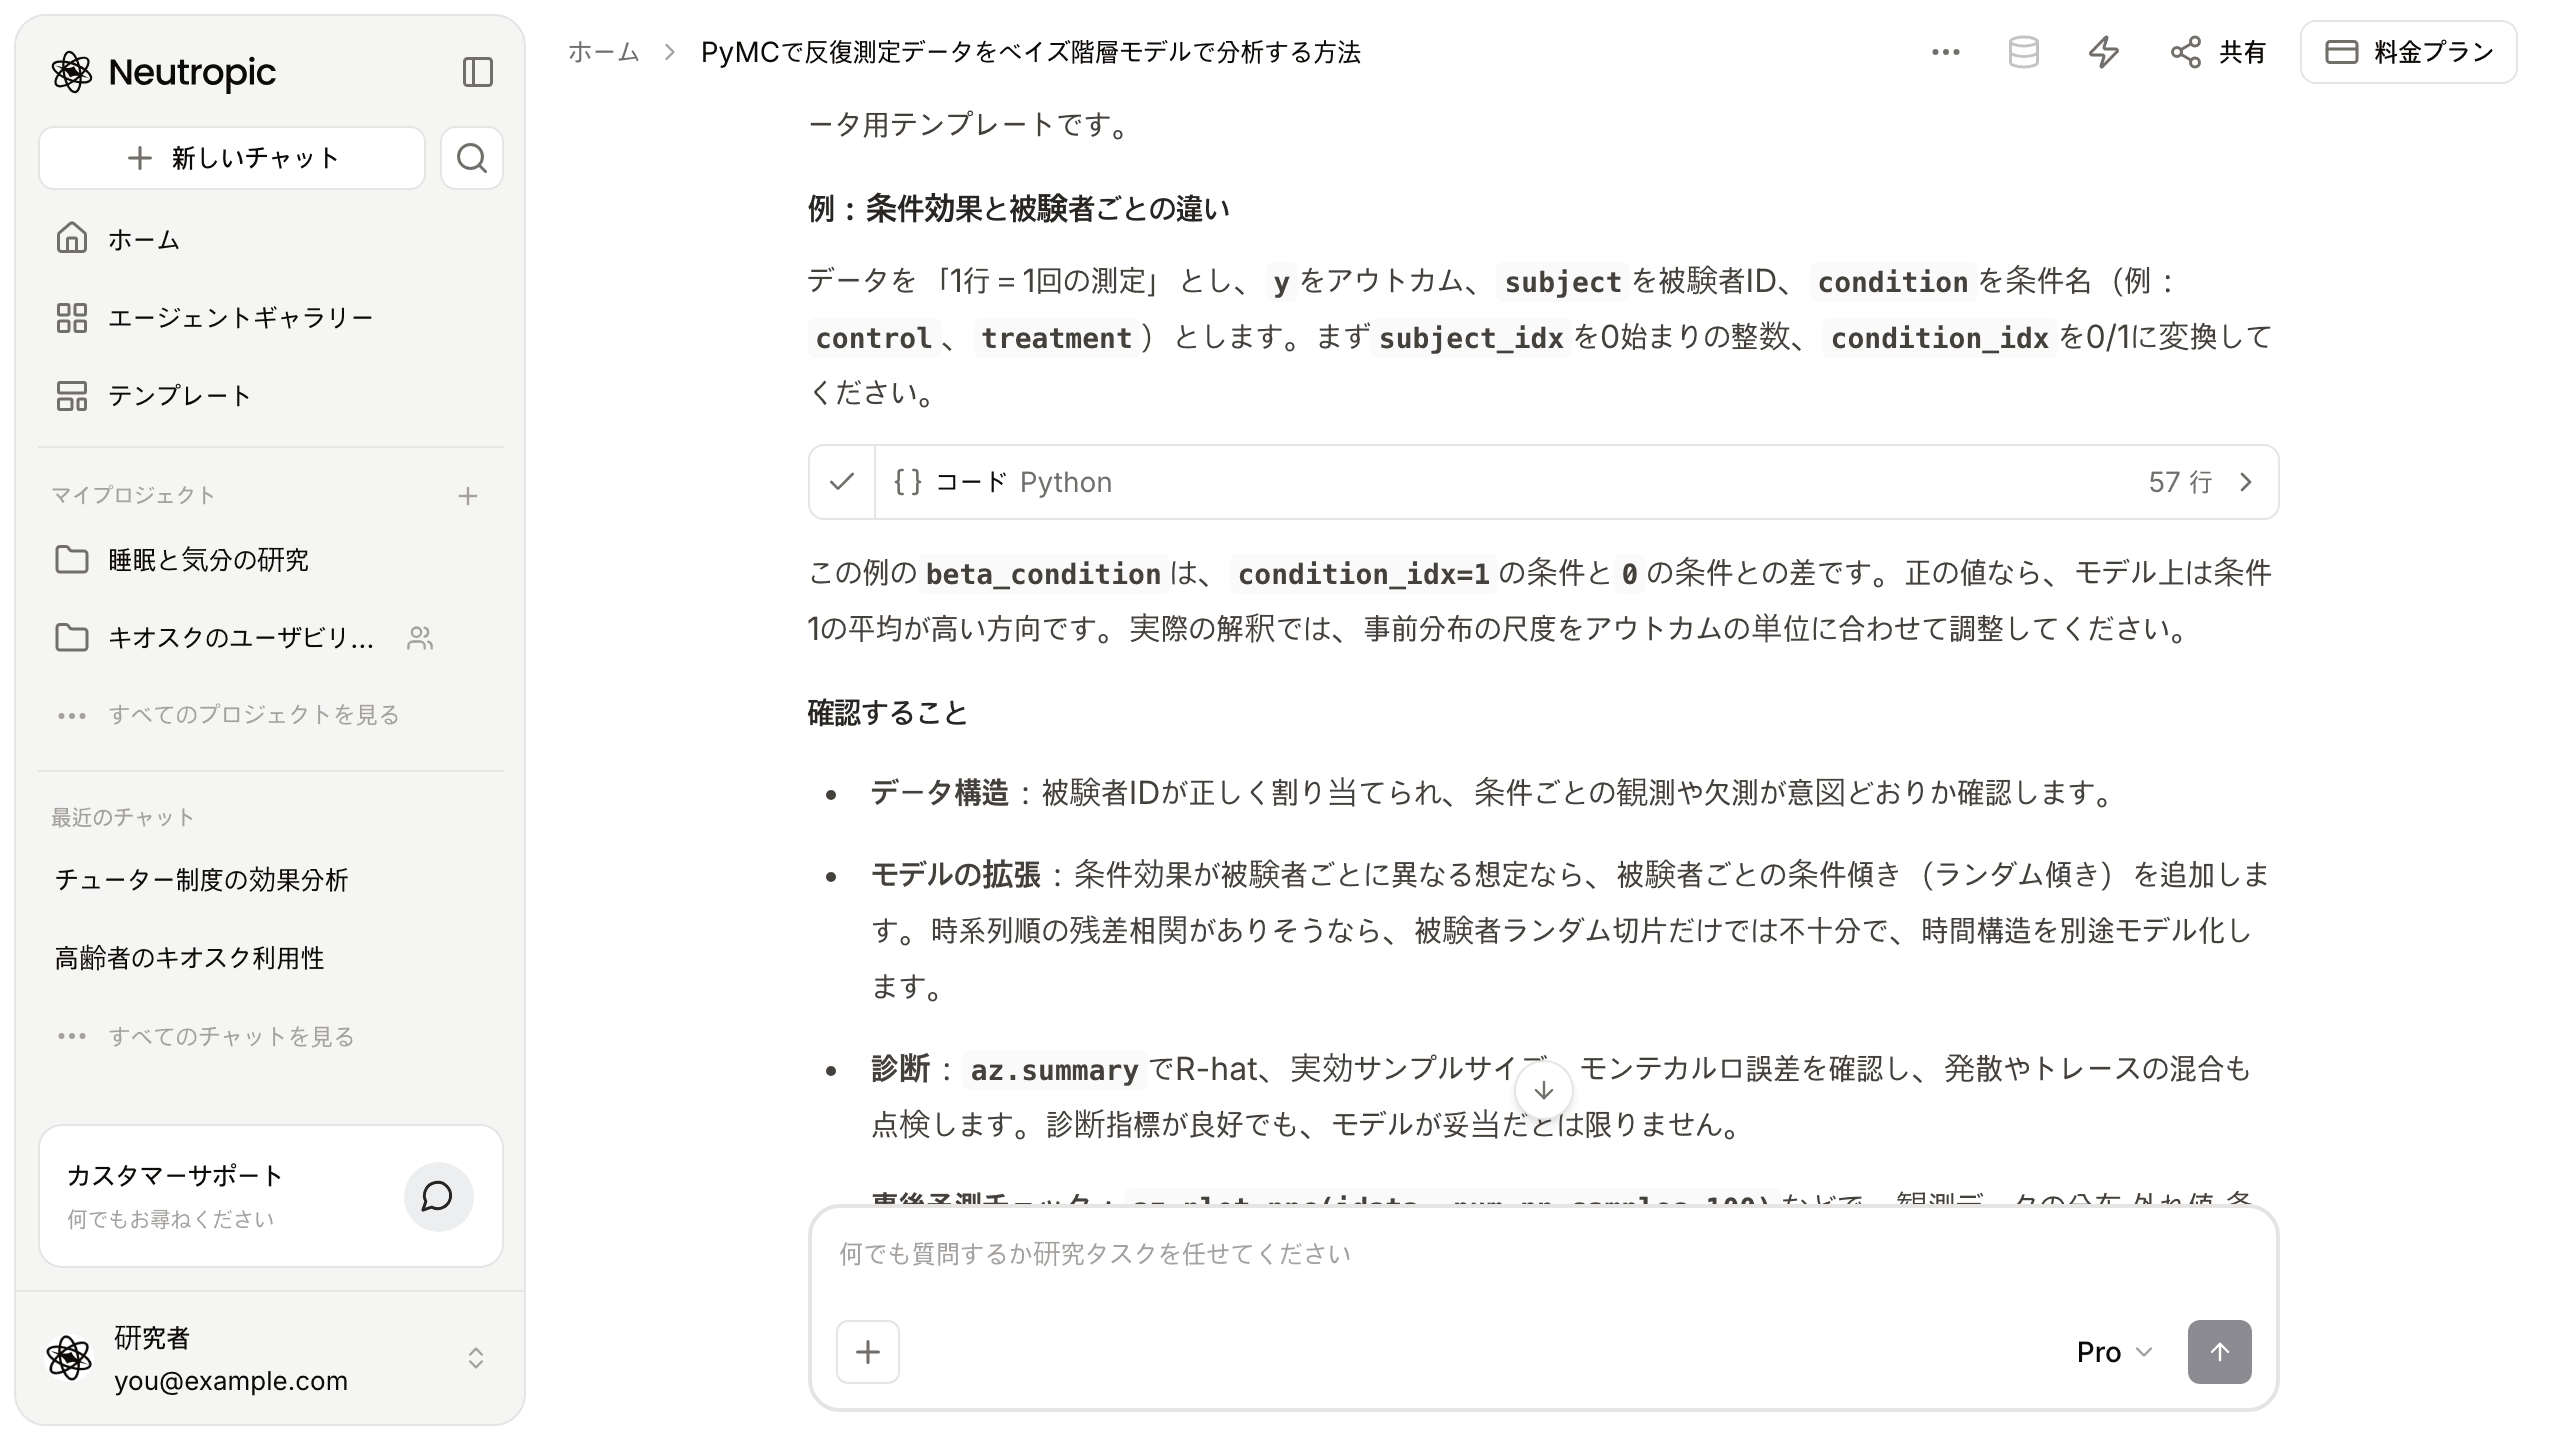
例は、各被験者が複数の条件を経験する連続アウトカムのデータです。データを「1行=1回の測定」に整え、被験者IDを0始まりの整数に、条件を0/1に変換します。57行のコードには、全体の切片と条件効果、非中心化した被験者ごとの切片、事前予測・推定・事後予測までが入っていました。
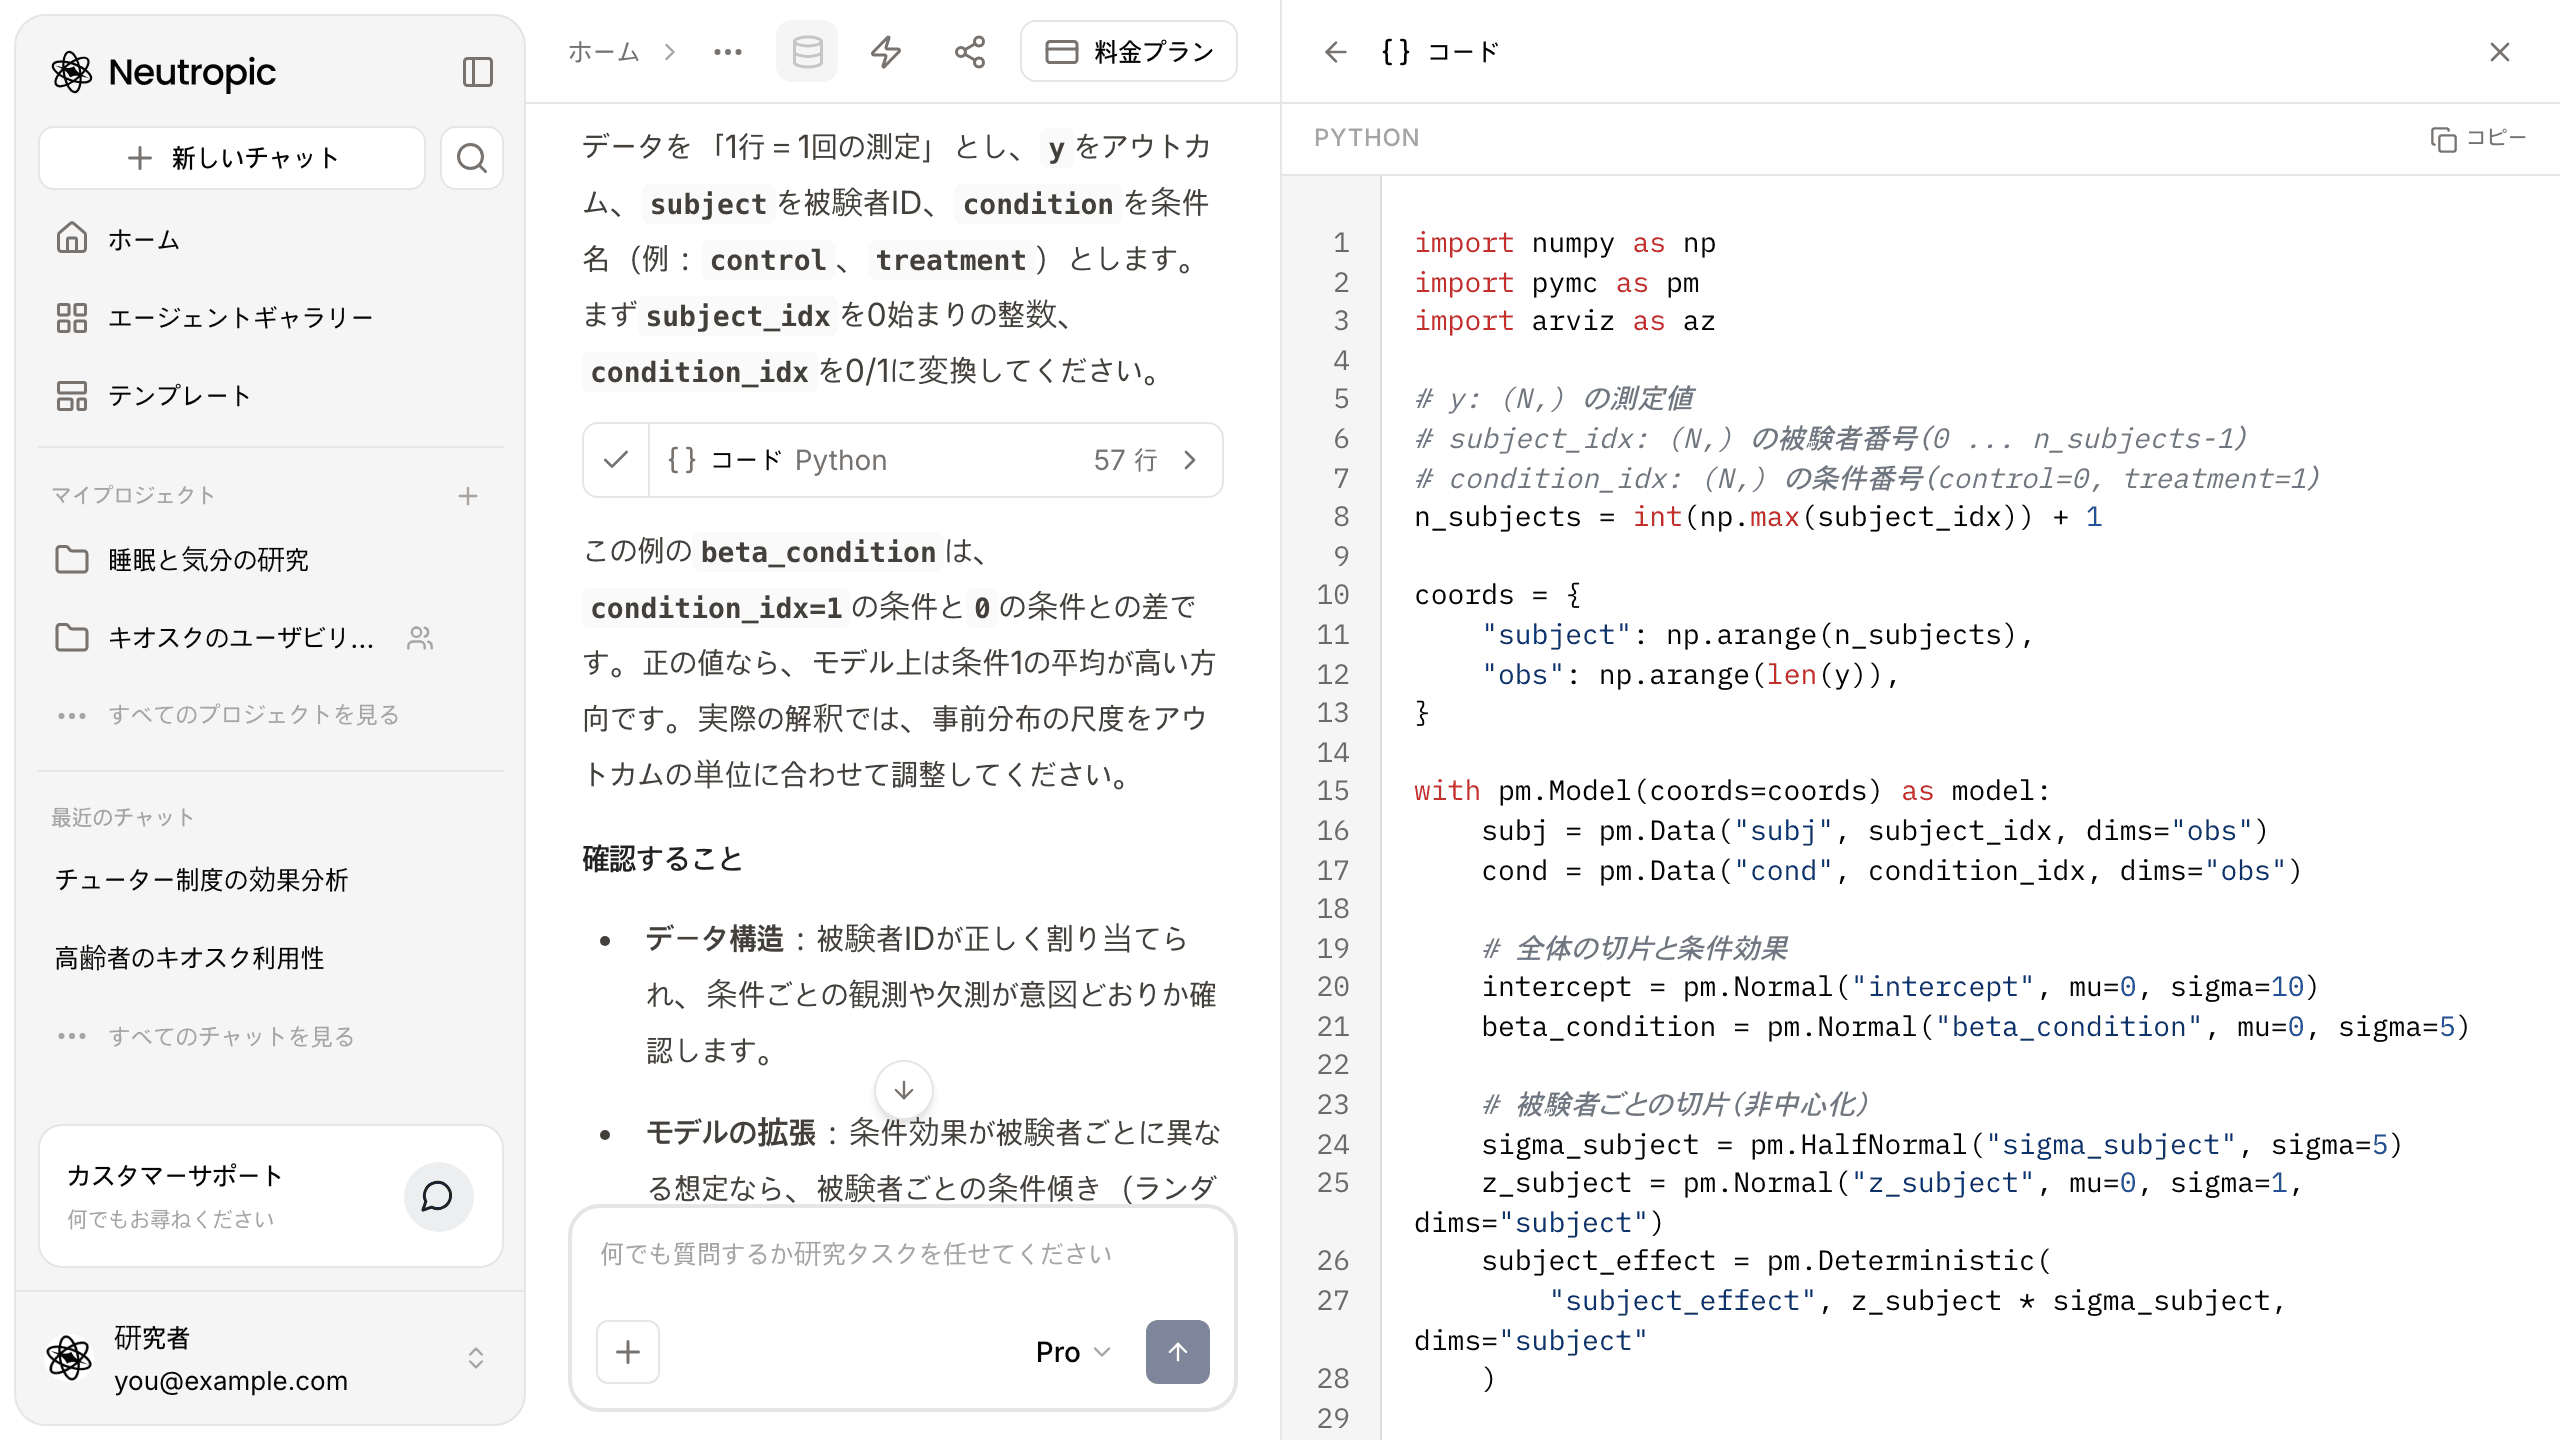
コードの下には、条件効果の読み方と注意書きがありました。条件1と条件0の差を表す係数で、事前分布の尺度はアウトカムの単位に合わせて調整すること、と。
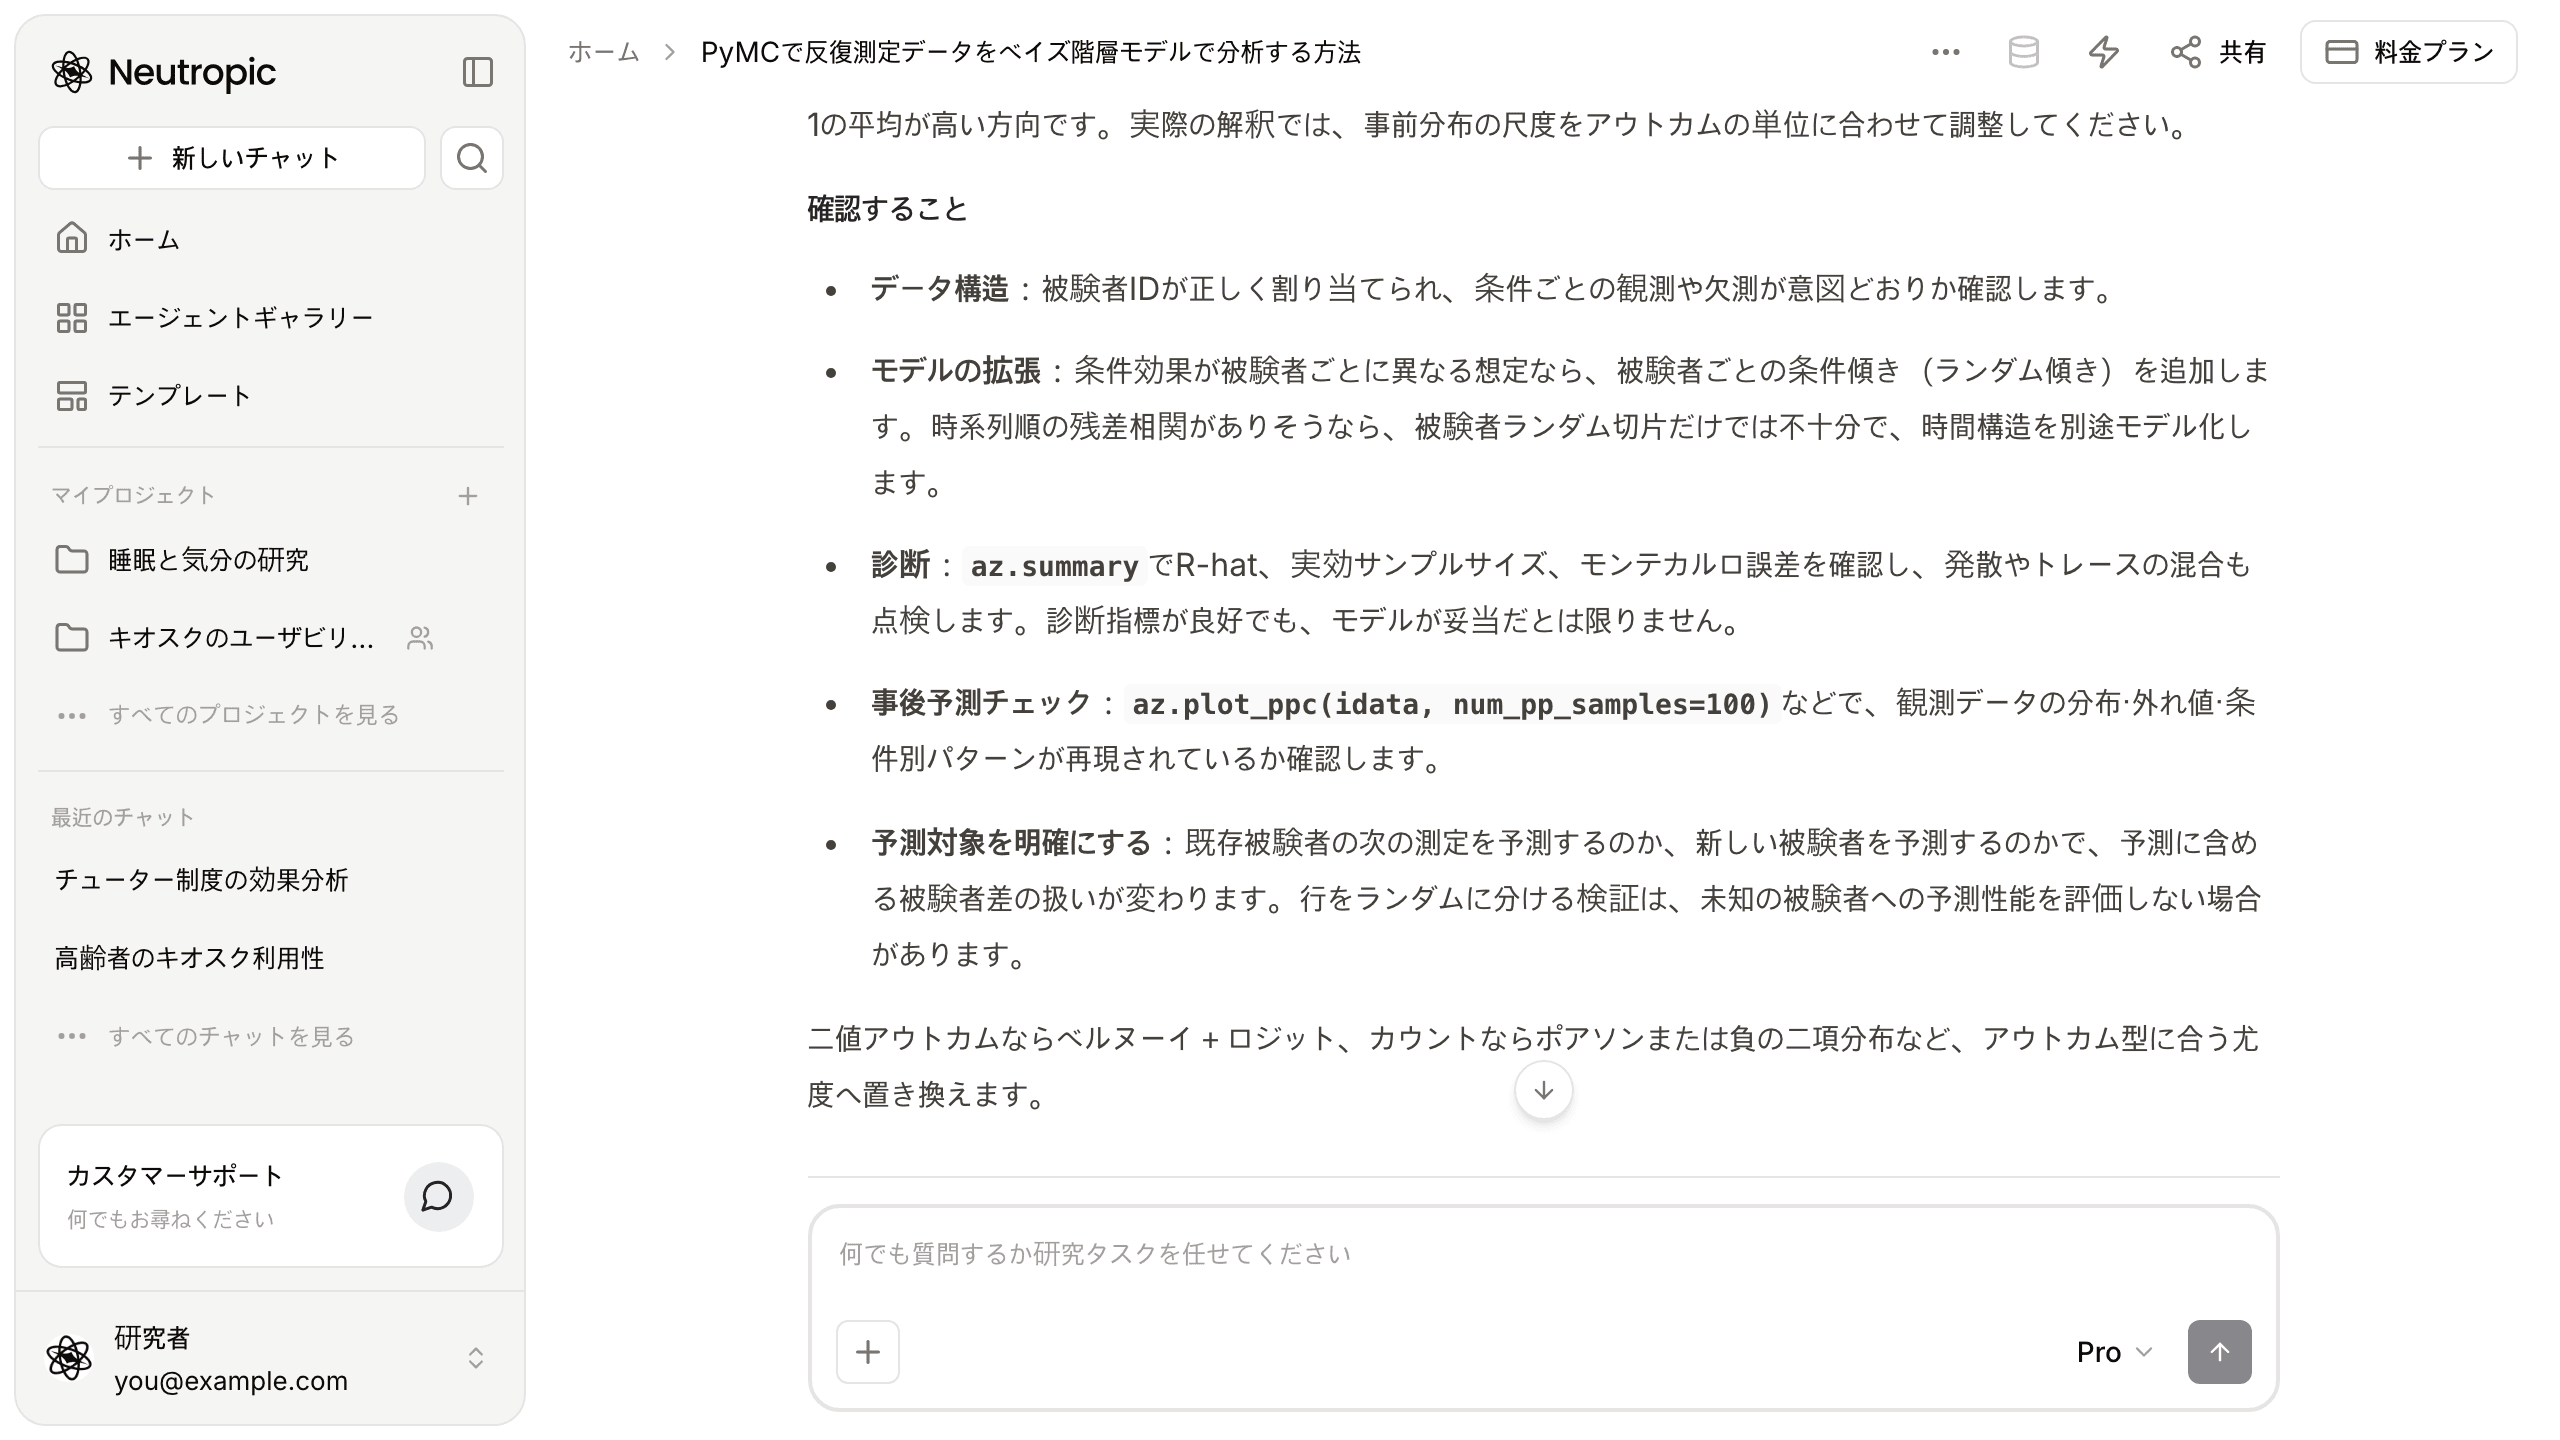
確認することが五つ並びました
健太さんがいちばん助かったのは、確認項目の一覧でした。
- データ構造: 被験者IDが正しく割り当てられ、条件ごとの観測や欠測が意図どおりか
- モデルの拡張: 条件効果が被験者ごとに違うならランダム傾きを加える。時系列順の残差相関がありそうなら、時間構造を別にモデル化する
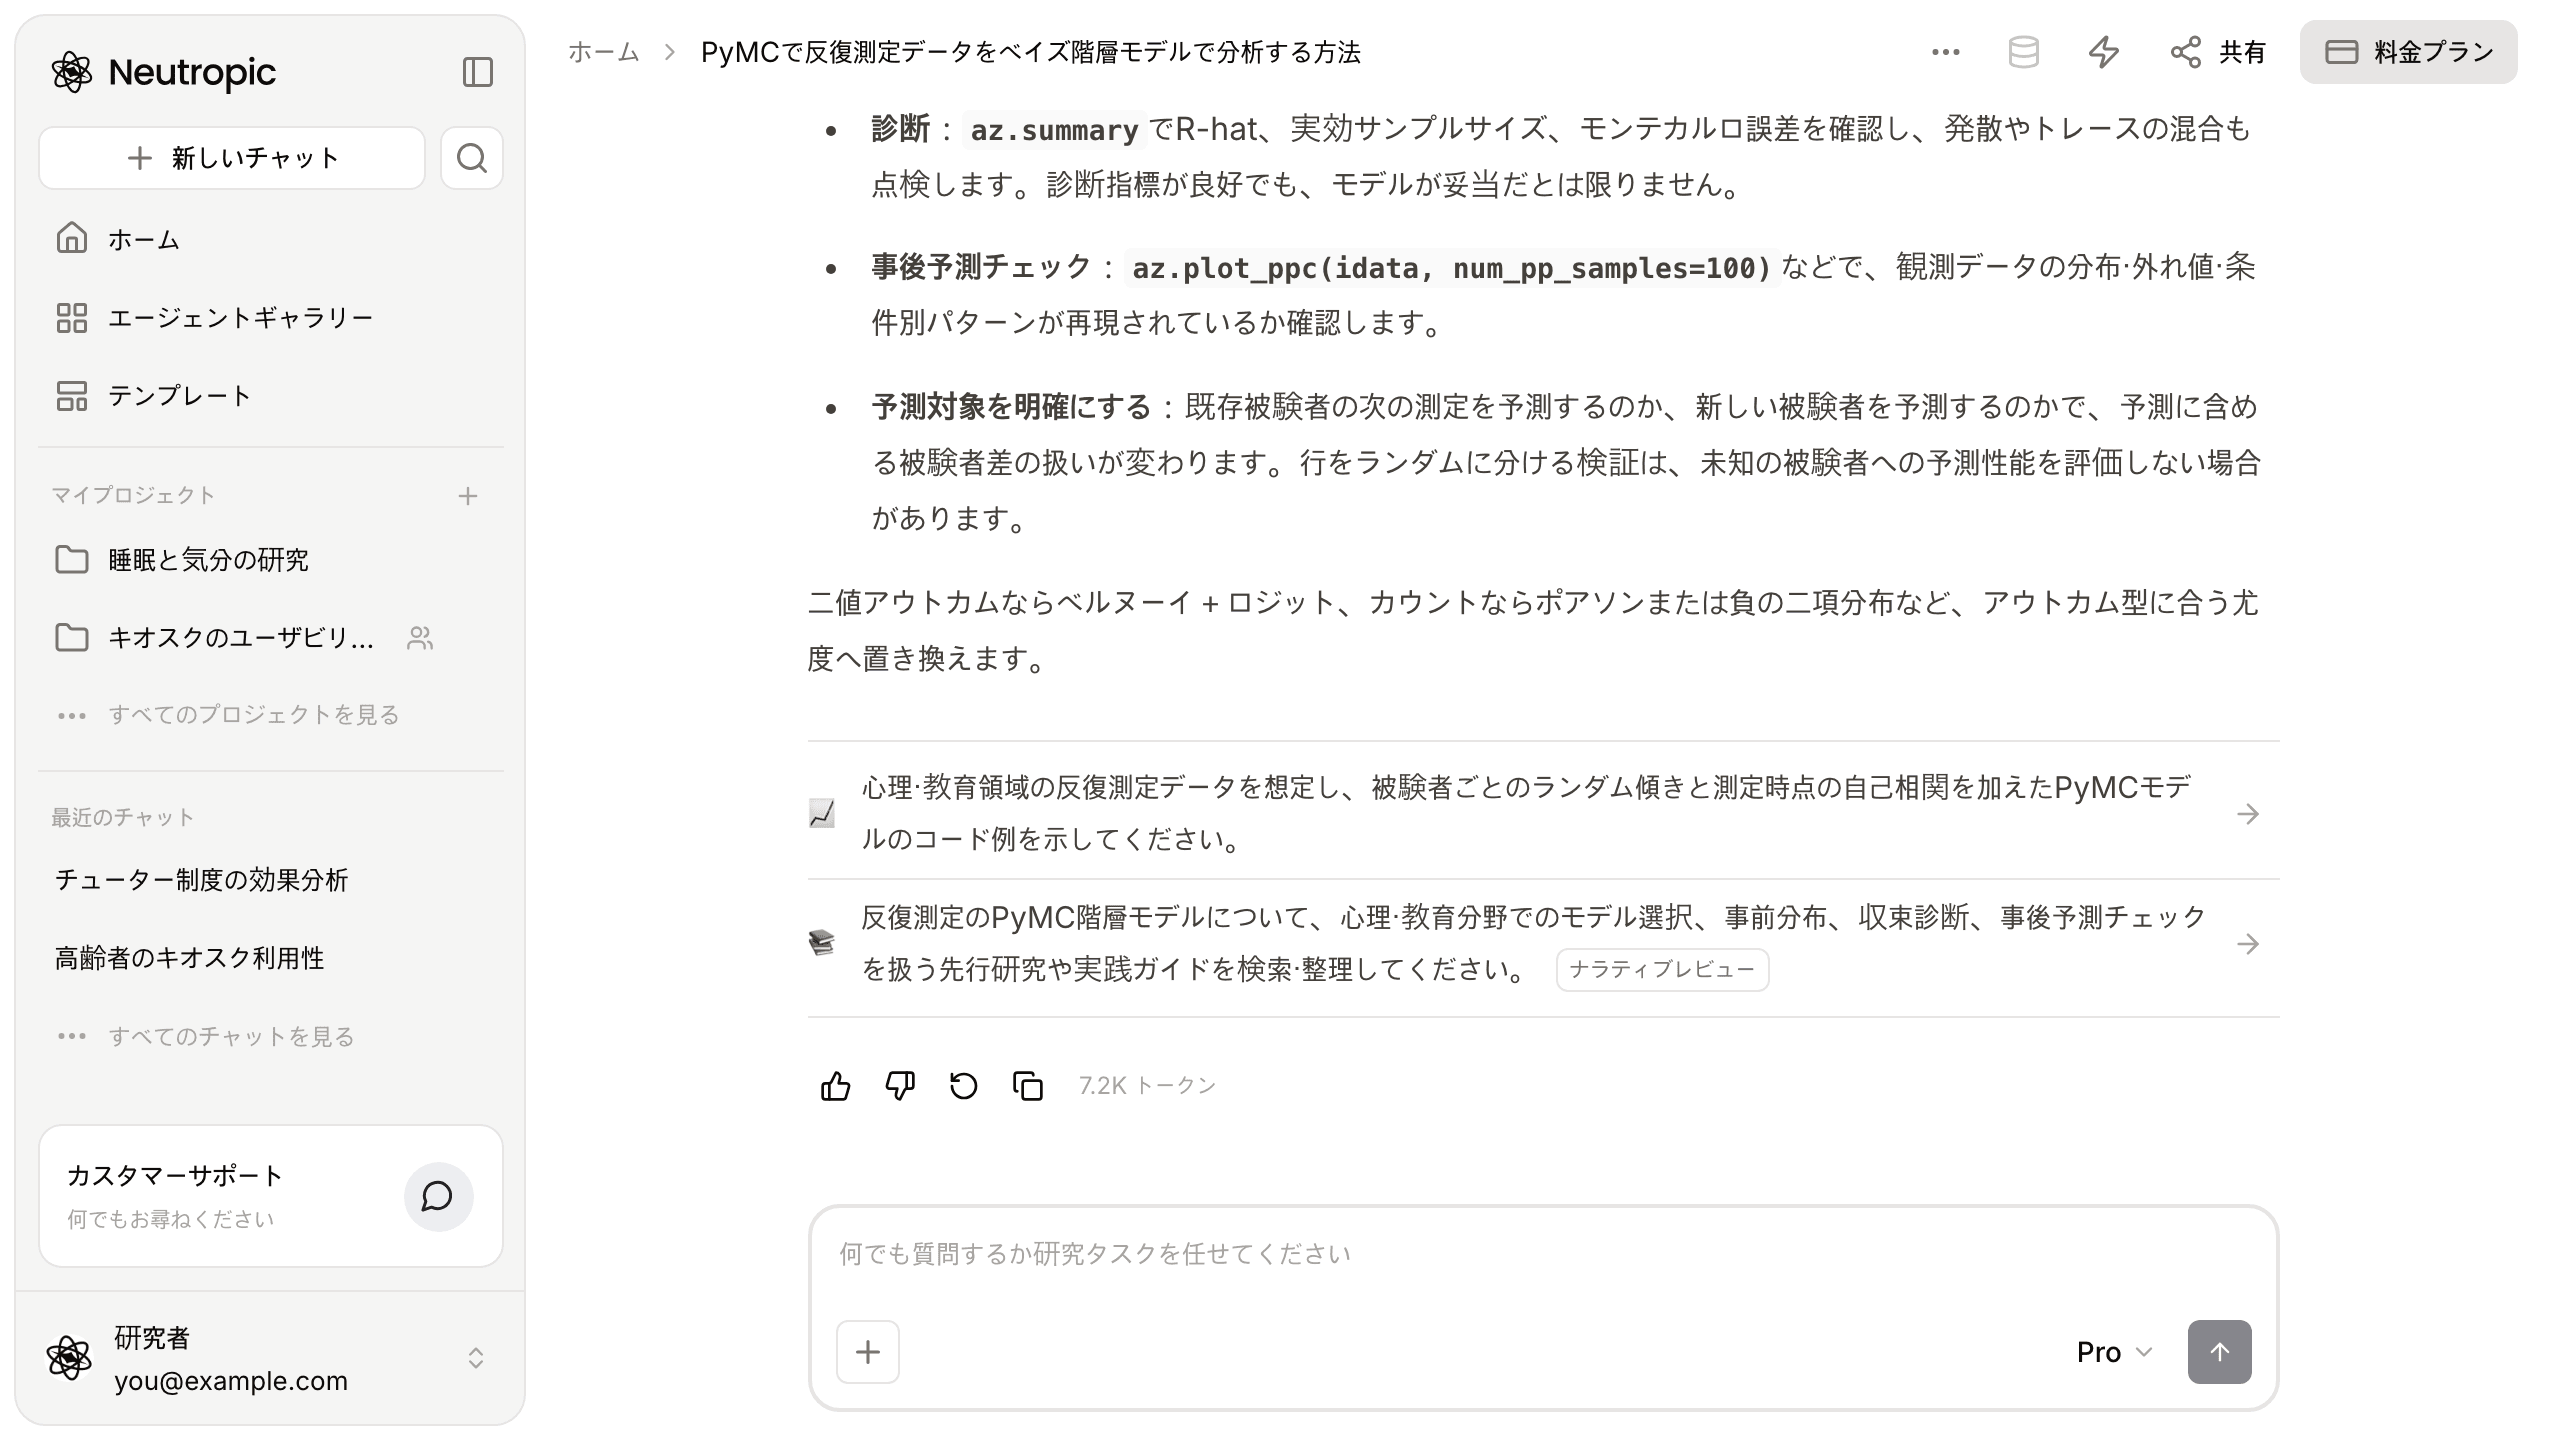
- 診断: R-hat、実効サンプルサイズ、モンテカルロ誤差、発散やトレースの混合を確かめる
- 事後予測チェック: 観測データの分布・外れ値・条件別パターンが再現されているか
- 予測対象: 既存の被験者の次の測定を予測するのか、新しい被験者を予測するのか
健太さんは危うく診断指標だけで安心するところでした
ベイズを始めたばかりだと、R-hatが1に近ければ終わりだと思いがちです。健太さんもそのつもりでしたが、回答はまさにそこを押さえていました。診断指標が良好でも、モデルが妥当だとは限りません、と。
もう一つ見落としそうだったのが予測対象です。行をランダムに分けて検証しても、未知の被験者への予測性能は評価できない場合がある、と回答は注意していました。同じ人のデータが学習側と検証側の両方に入るからです。
そして、このチャットではモデルを動かしていません。回答自身がテンプレートだと明言していて、コードの中の数値は設定値であって結果ではありません。健太さんは自分のパソコンにPyMCを入れて、実際に回す必要があります。
次にやることまで提案されました
回答のいちばん下には、続けてできることが二つありました。
- 心理・教育領域の反復測定データを想定し、被験者ごとのランダム傾きと測定時点の自己相関を加えたPyMCモデルのコード例を示す
- 反復測定のPyMC階層モデルについて、モデル選択、事前分布、収束診断、事後予測チェックを扱う先行研究や実践ガイドを検索・整理する — ナラティブレビュー エージェント
押すと同じチャットでそのまま続きます。
漠然とした「PyMCで」が、確認項目付きのコードになりました
| 始めたとき | 今 | |
|---|---|---|
| モデル | 「階層モデル」という言葉だけ | 条件効果+被験者ごとのランダム切片 |
| コード | サンプルのノートブックを探し回っていた | コピーして使えるPyMCコード57行 |
| 確認 | R-hatをなんとなく知っていた | データ構造・拡張・診断・事後予測・予測対象 |
| 注意点 | 何に気をつけるか分からない | 診断の限界、検証の分け方、尤度の選び方 |
| 次の一手 | 手が止まっていた | 押すだけで続けられる二つの提案 |
正直に言うと、これはモデルを実際にサンプリングした結果ではありません。コードは手元で回す必要があり、事前分布の尺度も自分のデータの単位に合わせて直す必要があります。それでも、何をどの順番で確かめるか分かった状態で始めるのと、白紙のノートブックから始めるのとでは、まったく違います。
この記事は Pro で実行しました。Lite(無料プラン)は簡単なモデル構造と主要な診断を示し、Expert はさらに事前分布の感度とモデル比較を加えます。
反復測定データを前に手が止まったら、一行の質問でモデルと確認手順から受け取ってみてください。 😎
今週、健太さんのように「立てて確認するには」まで書いて聞いてみてください。Neutropicを無料で始める